同样叫一辆车,上班、回家和偶尔外出有多不一样?
论文名片|Jiechao Zhang、Samiul Hasan、Kamol Chandra Roy、Xuedong Yan,Predicting Individual Mobility Behavior of Ride-Hailing Service Users Considering Heterogeneity of Trip Purposes,Data Science for Transportation,6,29,2024。DOI。
一个人每天从家打车去公司,另一个人只在聚餐结束后偶尔叫车。两人使用同一个平台,历史记录却包含很不一样的规律。把他们放进一套平均模型,可能既低估通勤的可预测性,也掩盖偶发出行的困难。
这篇研究先问某天会不会使用网约车,再问如果使用,会从个人常去的哪类地点出发、到哪类地点结束。它发现通勤模式下提升最明显;但这个结论必须连同用户筛选、家与工作地的推断,以及地点排名的预测口径一起理解。
先说结论
- 样本来自北京六环内 2017 年 3—6 月订单,从随机抽取的 50,000 名用户中筛出活跃至少 10 天的 34,311 人;它描述网约车活动,不能恢复这些人的全部出行。
- 根据订单时段推断能否识别家和工作地,将用户分为四组。分组是行为规则的结果,不是问卷核实的逐次出行目的。
- 是否叫车的日决策模型,四组准确率中位数均约 65%;起点与终点排名预测中,通勤组中位数分别为 71% 与 67%,明显高于普通 HMM。
- 不规律组仍难预测,而且终点预测的原图显示 IOHMM 低于 HMM。用熵估计的可预测性提供参照,不能证明所有人都已达到不可改进的理论上限。
为什么有精确订单,仍然看不见完整生活?
原始平台数据涉及超过 500 万用户,含匿名乘客、司机与订单标识,起终点坐标、时间、距离与费用。研究为降低计算量随机抽取 50,000 人,再删除活跃天数少于 10 的用户,留下 34,311 人。
低活跃者可能是访客,也可能是很少打车的本地居民;直接按活跃天数删除,选择的是平台记录较充足的人,而不是经过核实的常住人口。没有平台订单的日子也不等于没有出门,可能选择步行、公交、自驾或另一平台。
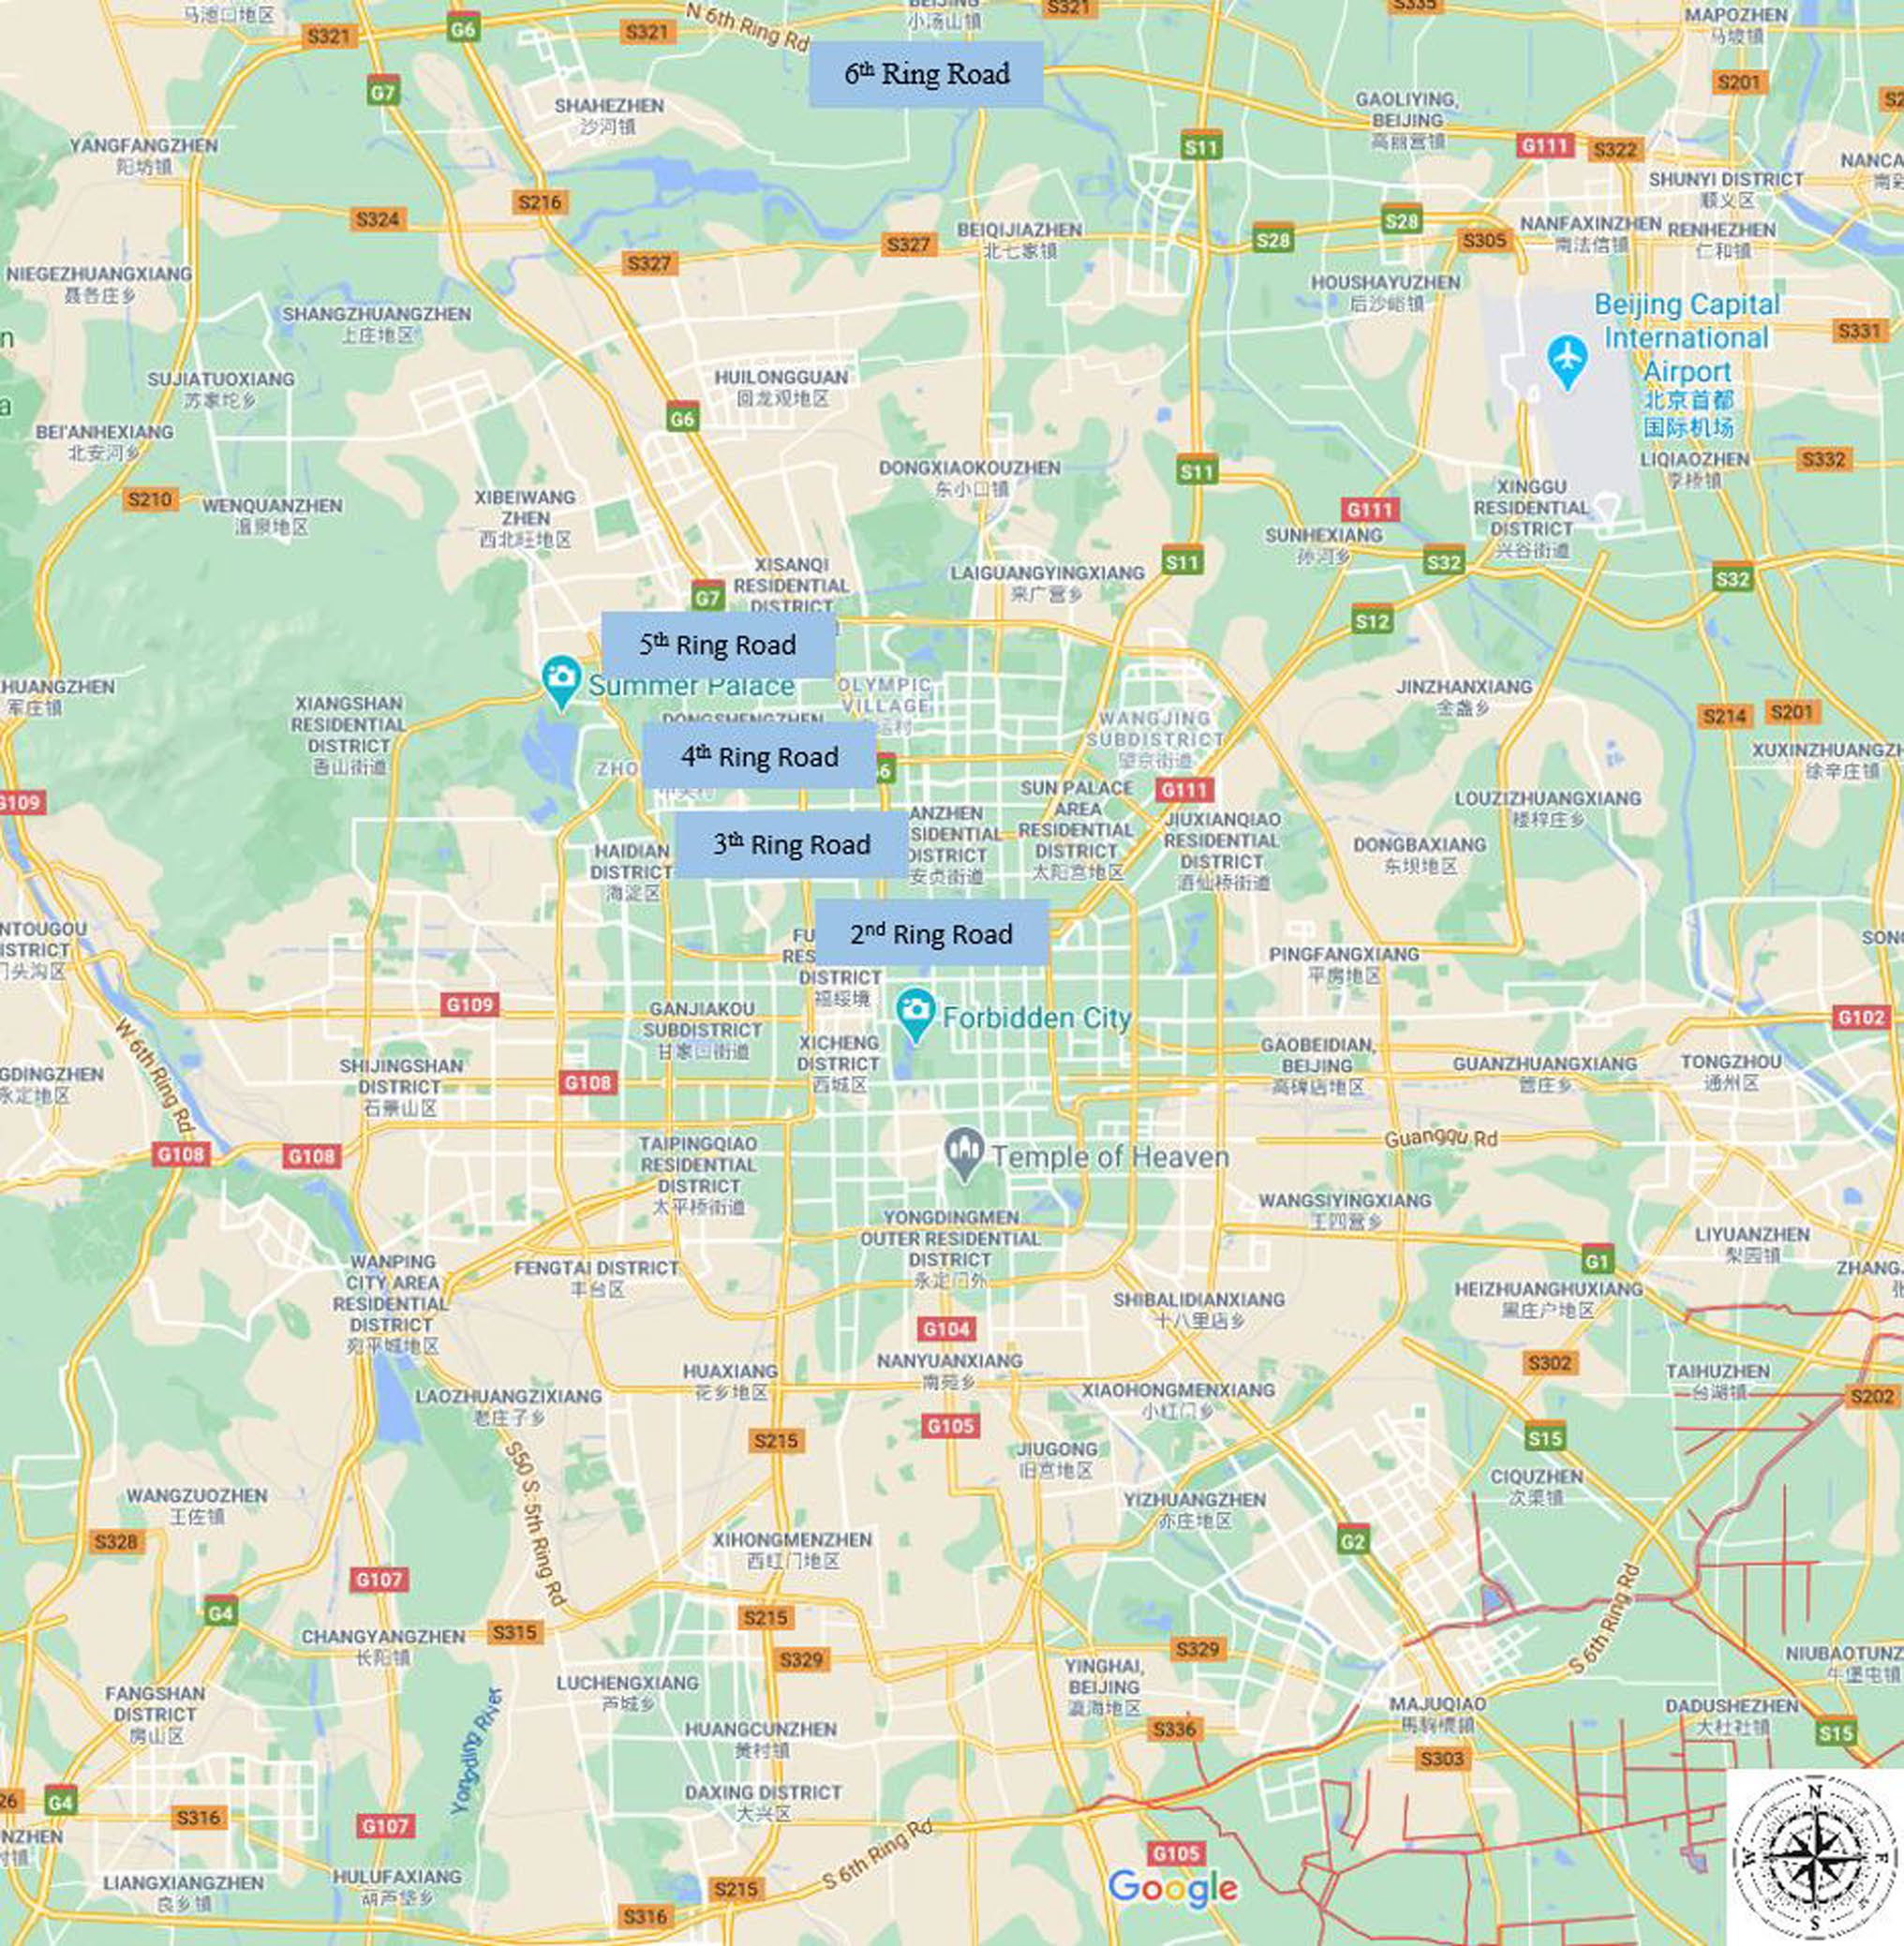
图 1|结论对应什么地理范围?单面板地图展示北京六环及内部地区,并标出二环至六环、道路与地名。它界定平台样本的研究空间,不是全北京全部交通方式的完整观测。来源:原论文 Fig. 1。
Table 1 说明订单与天气字段:天气和空气质量各分正常、轻度、重度三档。Table 2 的平均行程时间为 1,467 秒、行程距离约 7,507 米,说明这些是一次明确乘车的记录,区别于电话或推文端点;但它们仍只覆盖所选平台。
预测地点排名,和预测真实坐标差多少?
同一建筑附近多次上车,坐标不一定完全相同。研究按每人历史起终点之间 300 米以内的关系合并地点,再按访问频率给地点排序。模型输出的是这个人常去地点的排名类别,并不是直接输出经纬度。
排名超过前十的地点被并到一个低频类别。预测落入这个类别,只说明可能去某个低频地点,不能指出究竟是哪一家新餐馆、哪个商场,也无法区分同组中所有较少到访地点。
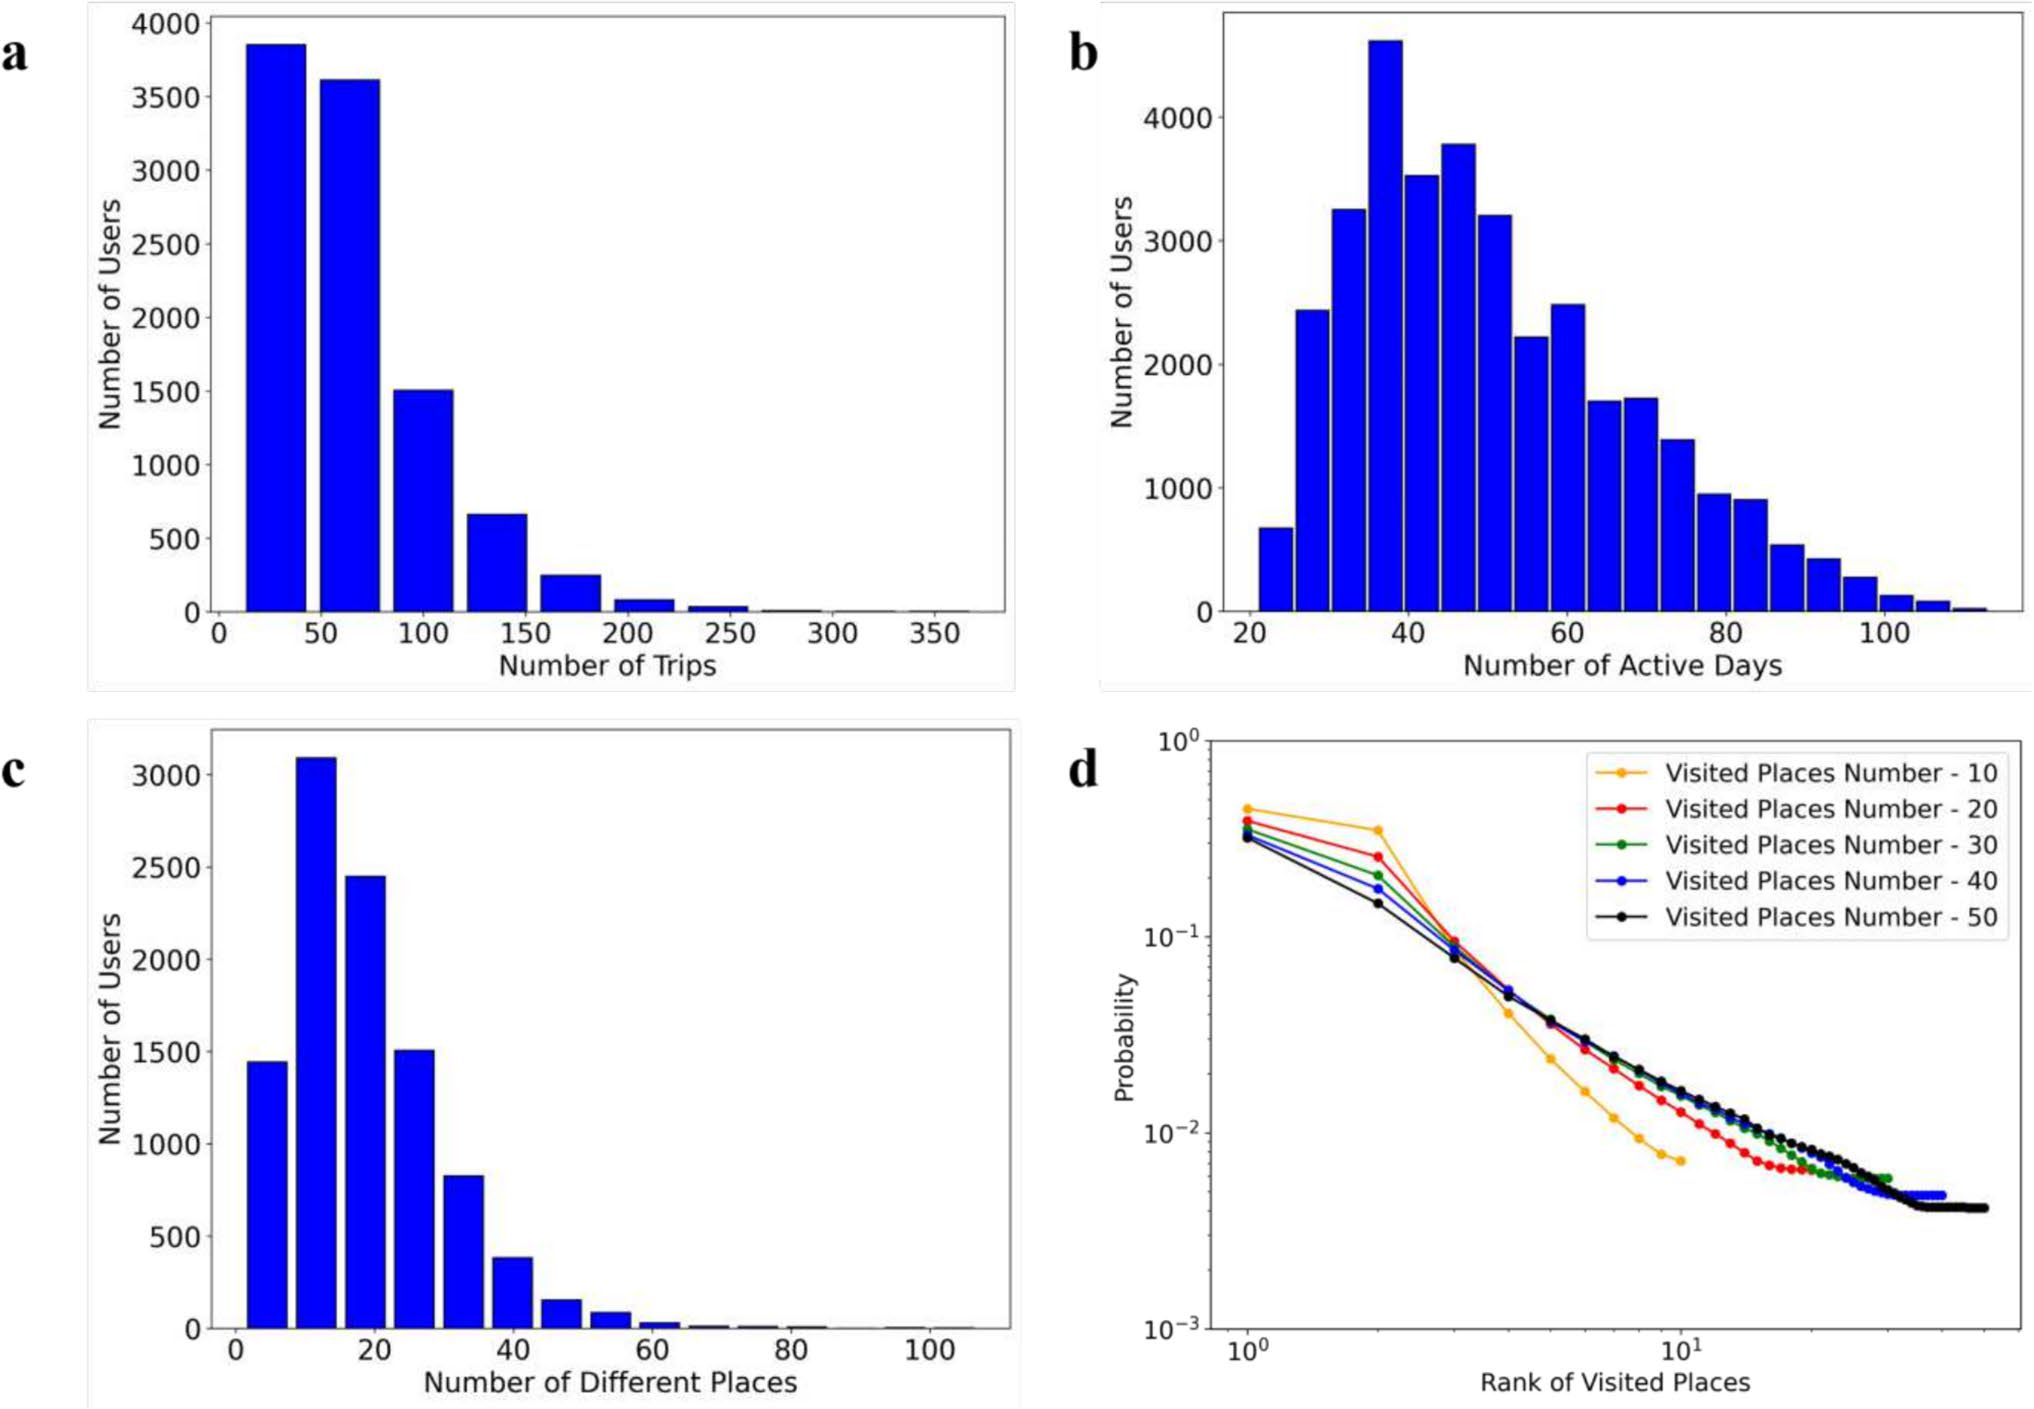
图 2|平台记录有多少规律可供学习?(a)每人订单数,横轴次数、纵轴人数,多数记录量有限;(b)每人活跃天数分布,很多人并非天天打车;(c)个人不同地点数,较少地点更常见;(d)按到访频次排序的地点概率,颜色区分不同地点总数用户,前两处常去地点概率较高,后续快速下降。地点排名是每人内部编号,不同人的第一名不代表同一个地理位置。来源:原论文 Fig. 2。
将低频地点合并可以减轻稀疏性,却也使任务比精确预测全部原始地点更粗。所有准确率都应在这个目标定义下比较,不能由 71% 推导为 71% 的订单能精确落到某栋楼。
家、工作地与通勤组,怎样从订单里推断?
家庭候选地点看早间 6—11 时的出发,加下午至晚间 15—20 时的到达;工作地候选地点则反过来,看早间到达与晚间出发。分别取总数最大的地点,计算其相关订单占个人全部订单的比例。
最终门槛为家 0.4、工作地 0.25。只识别出家、只识别出工作地、两者都识别出、两者都未识别出,形成四组:
| 分组 | 人数 | 在这套规则下代表什么 |
|---|---|---|
| 家庭锚点组 Home-based | 6,100 | 只满足家的识别门槛 |
| 工作锚点组 Work-based | 4,985 | 只满足工作地门槛 |
| 通勤锚点组 Commute-based | 11,048 | 家与工作地都满足门槛 |
| 未识别锚点组 Random | 12,178 | 两处都未满足门槛 |
未识别出工作地,不等于没有工作;未识别锚点,也不等于这个人的生活本质随机。轮班、单程叫车、低频使用和缺少其他方式记录,都可能改变识别结果。
Table 3 显示门槛敏感性。例如家门槛固定 0.4,工作地门槛从 0.2 提至 0.3,通勤组人数由 12,911 降至 9,062。最终分组取决于这些启发式选择,不能当作天然不变的四种人群。
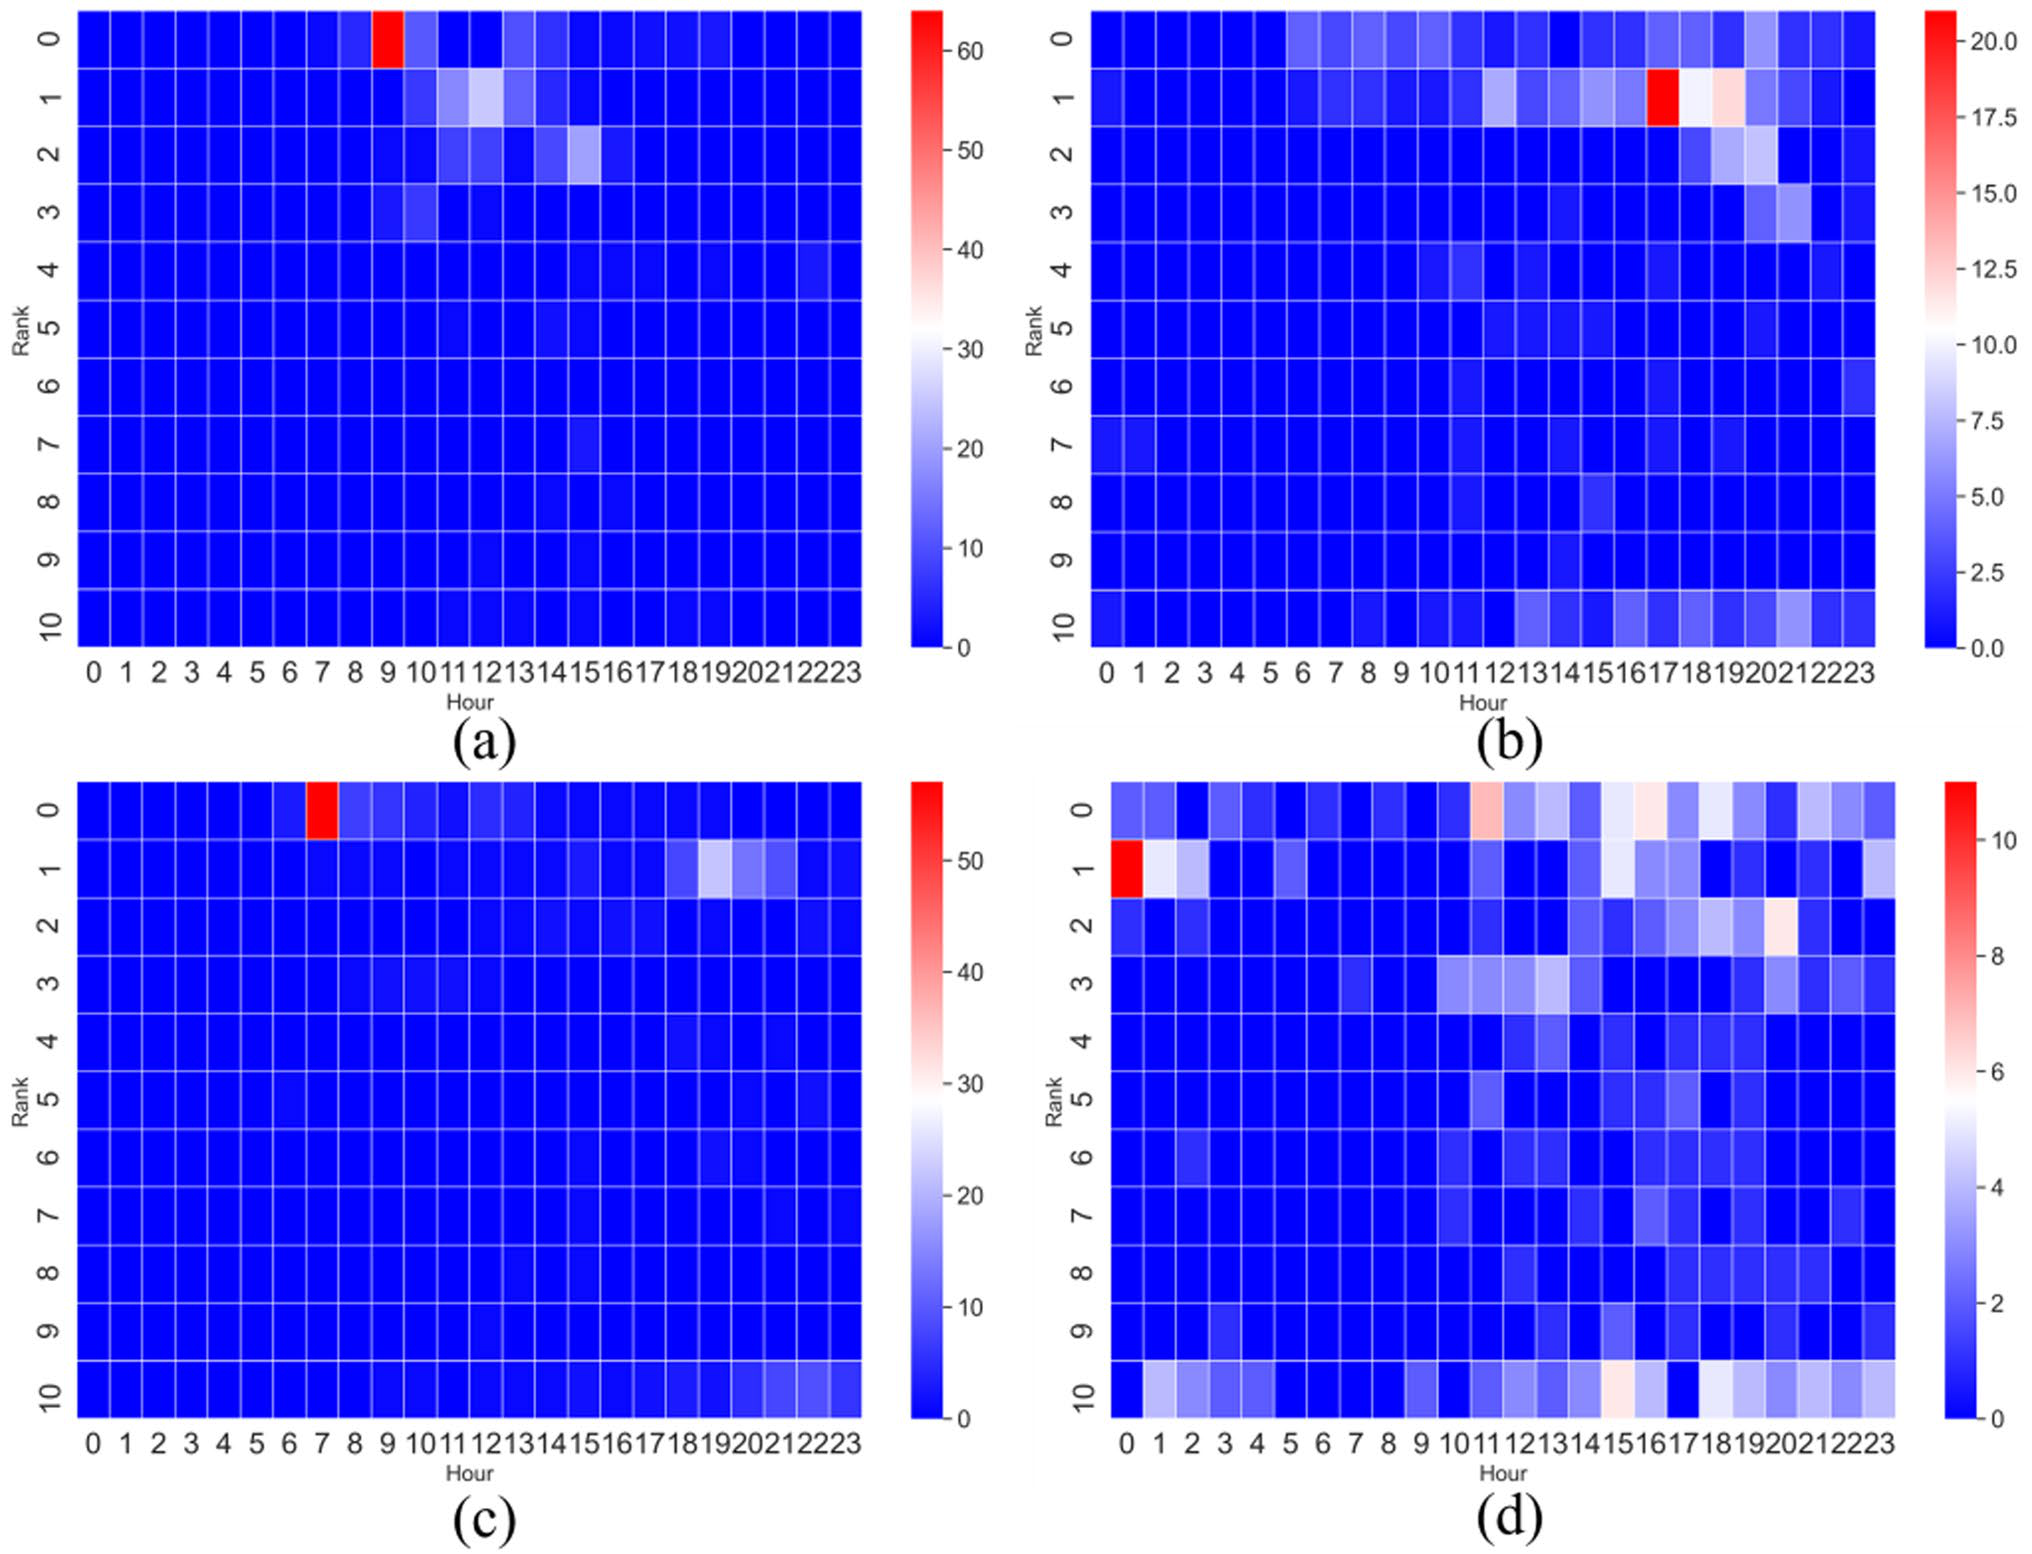
图 3|这些组在订单中呈现什么区别?(a)家庭锚点组示例;(b)工作锚点组示例;(c)通勤锚点组示例;(d)未识别锚点组示例。横轴为小时,纵轴为个人地点排名,颜色越暖表示从该排名地点出发的次数越多。(a、c)早间常从高频地点出发,(b)傍晚起点较集中,(d)较分散。每幅是一个用户示例,色标不同,不能直接比较各组总需求。来源:原论文 Fig. 3。
一天叫不叫车,和叫车后去哪里,为什么分两层?
不使用网约车的日子,没有需要预测的订单起终点。研究因此采用两部分输入—输出隐马尔可夫模型 IOHMM:一部分处理日级决策及订单数,另一部分处理发生订单后的起终点排名序列。
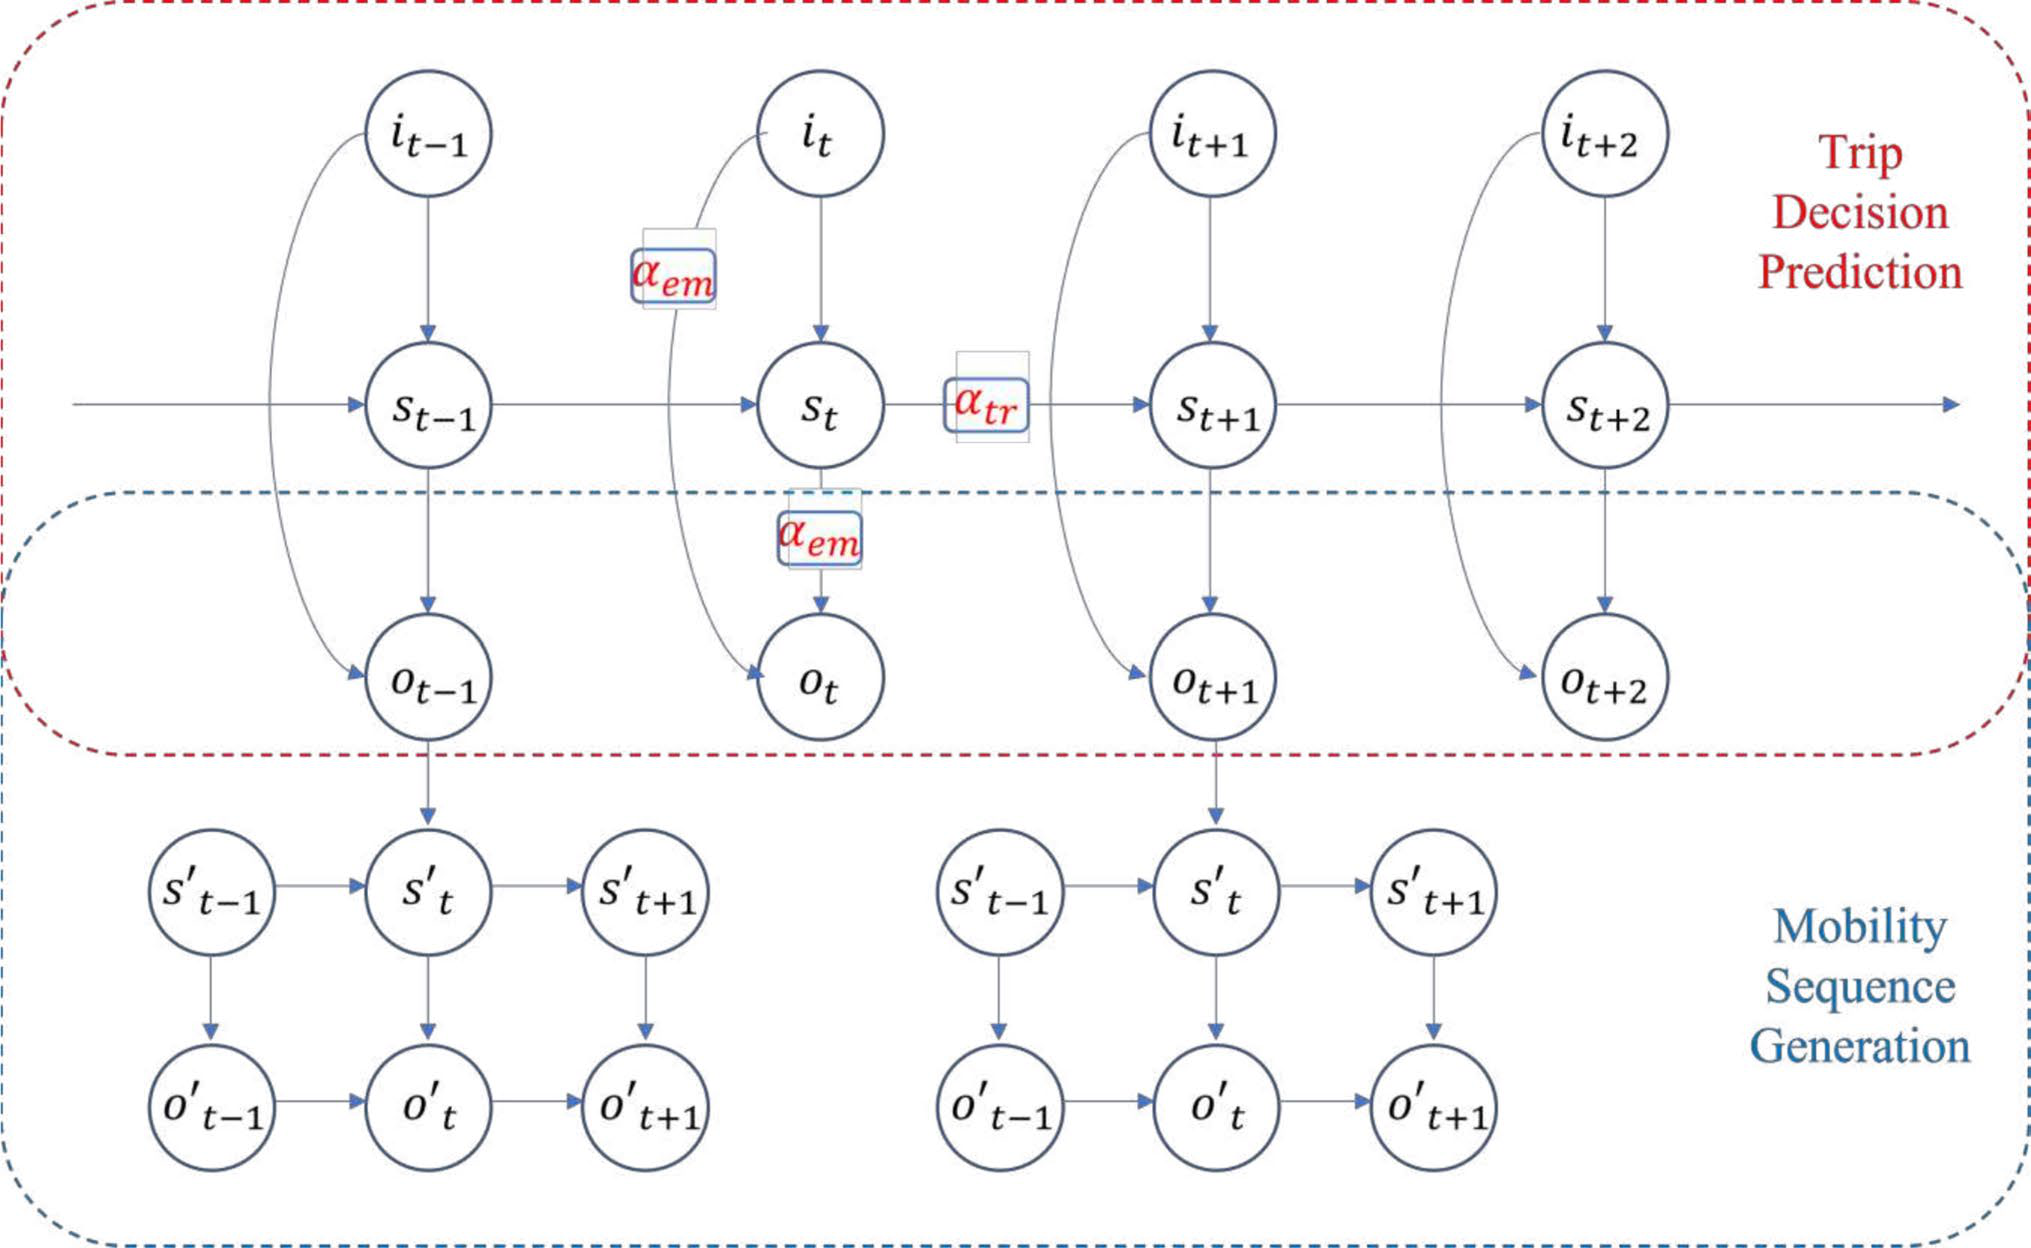
图 4|两个预测如何接起来?上方红框是日决策:输入 i 包括星期、天气及用户历史特征,状态 s 表示是否发生平台行程,输出 o 表示订单数;下方蓝框在需要生成订单的日期处理起点状态 s′和终点输出 o′。时间相邻的状态相连,同时允许上下层信息传递。这里没有分图字母,完整保留两层结构。来源:原论文 Fig. 4。
历史特征包括订单总数、活跃天数、回转半径、平均费用、行程距离与时间、上周活跃天数等。IOHMM 让状态转移与输出概率依赖上下文,区别于不显式使用这些输入的普通 HMM。
分类性的初始、转移和地点输出采用多项逻辑模型,日订单数的输出采用线性回归形式。论文以监督状态和期望最大化 EM 方法说明估计过程,给出相应似然与迭代公式。各组分别训练,每人约 70% 历史序列用于训练、30% 用于测试;准确率为相应目标预测正确数除以全部预测数。
文章没有明确交代这一 70/30 划分是否严格按时间前推,也未完整说明地点排序、家与工作地识别及汇总特征是否仅使用训练段。若用于未来部署,这些步骤都应只用当时已经存在的记录,以免完整历史信息进入未来预测。
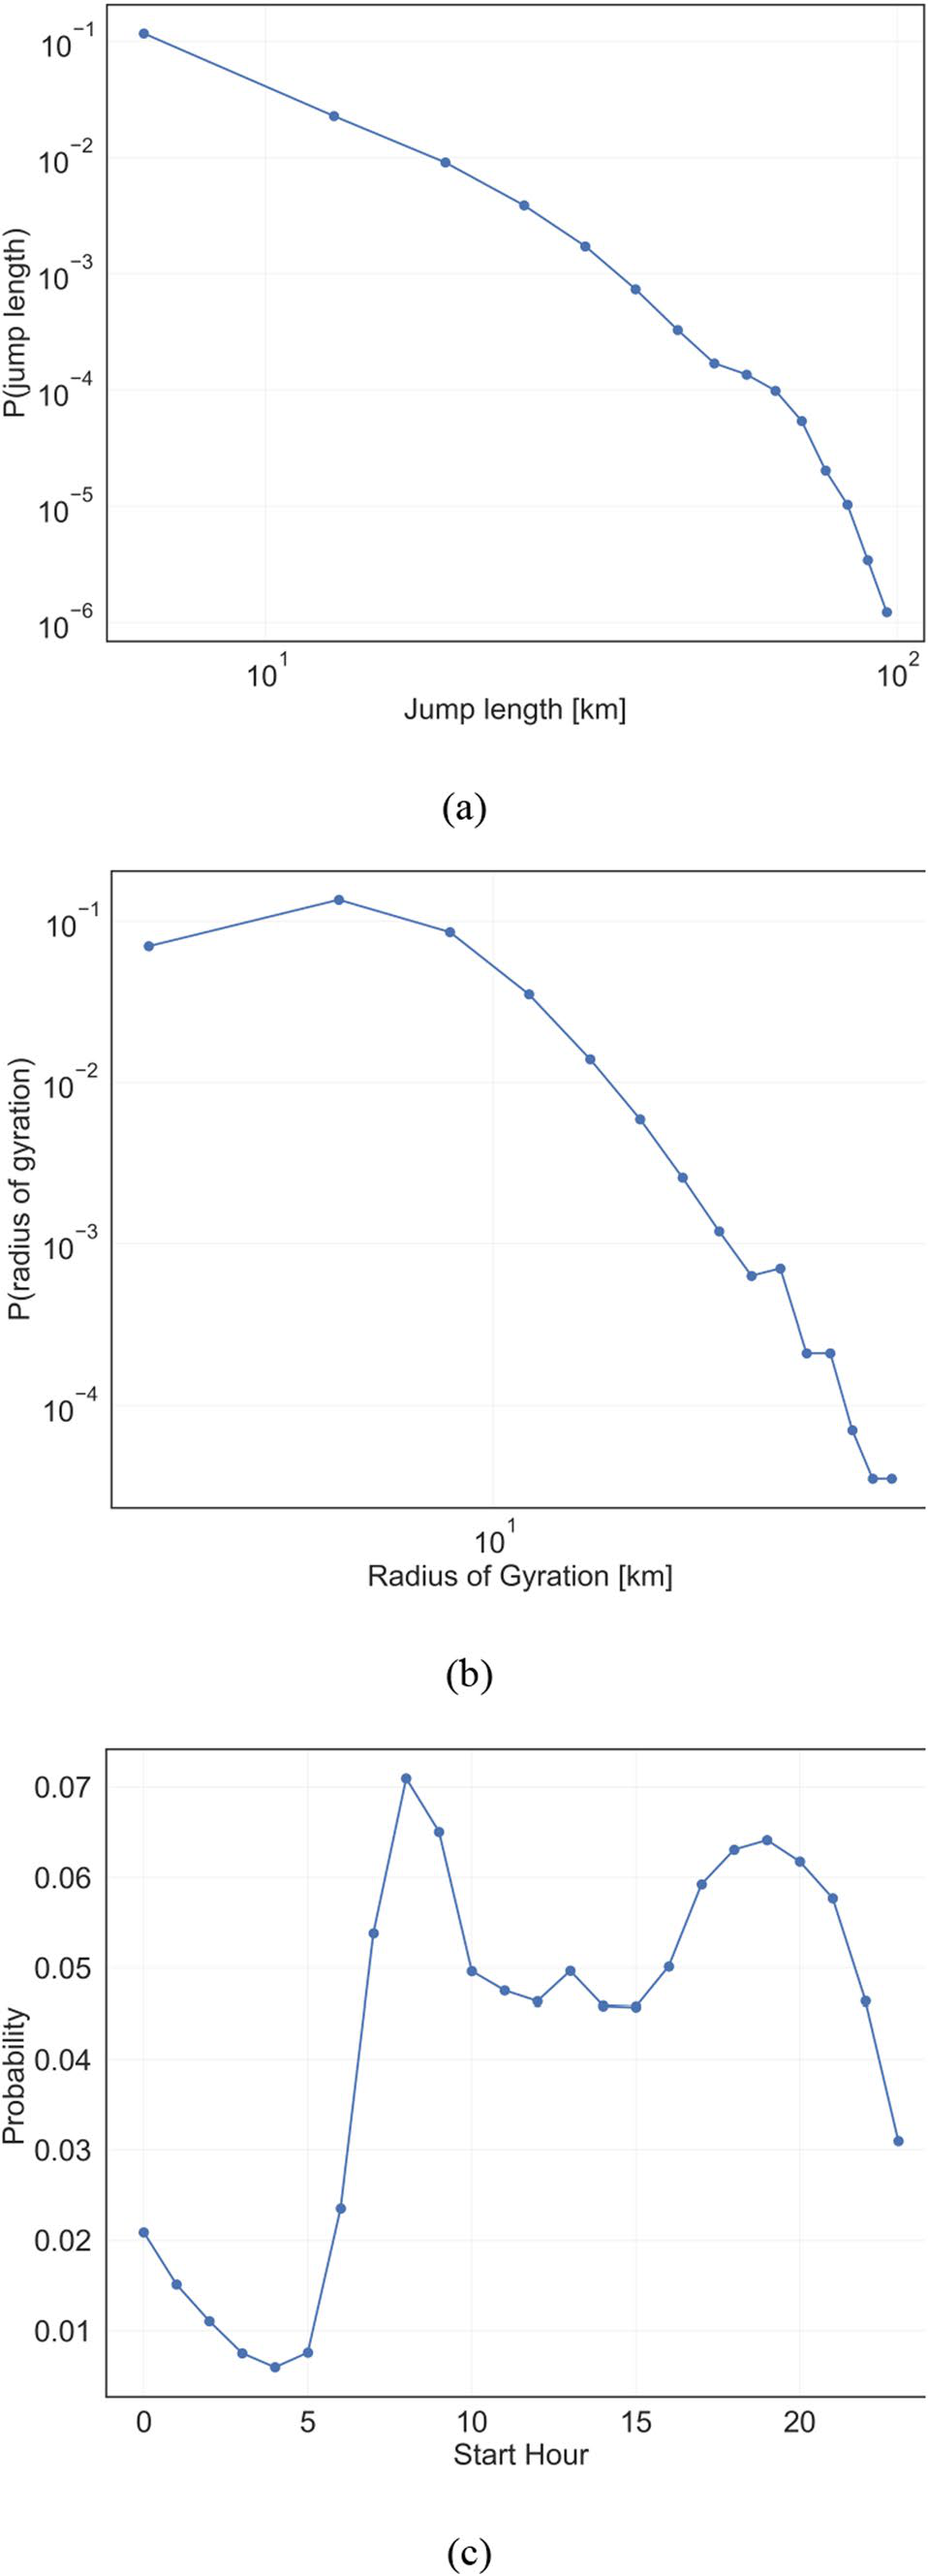
图 5|模型要捕捉哪些基本规律?(a)单次行程距离分布,横轴千米;(b)个人回转半径分布,横轴千米,衡量访问地点围绕活动中心的展开;(c)各小时订单产生份额,早间和傍晚存在高峰。前两幅使用对数坐标,不能把视觉直线直接当作某种行为机制已被证明。来源:原论文 Fig. 5。
约 65% 的日决策准确率,高在哪里?
四组日决策 IOHMM 的准确率中位数分别约为 0.652、0.646、0.650、0.650,普通逻辑回归分别为 0.630、0.633、0.645、0.629。提升存在,但通勤组只增加约 0.5 个百分点,不能将所有组都描述为大幅提升。
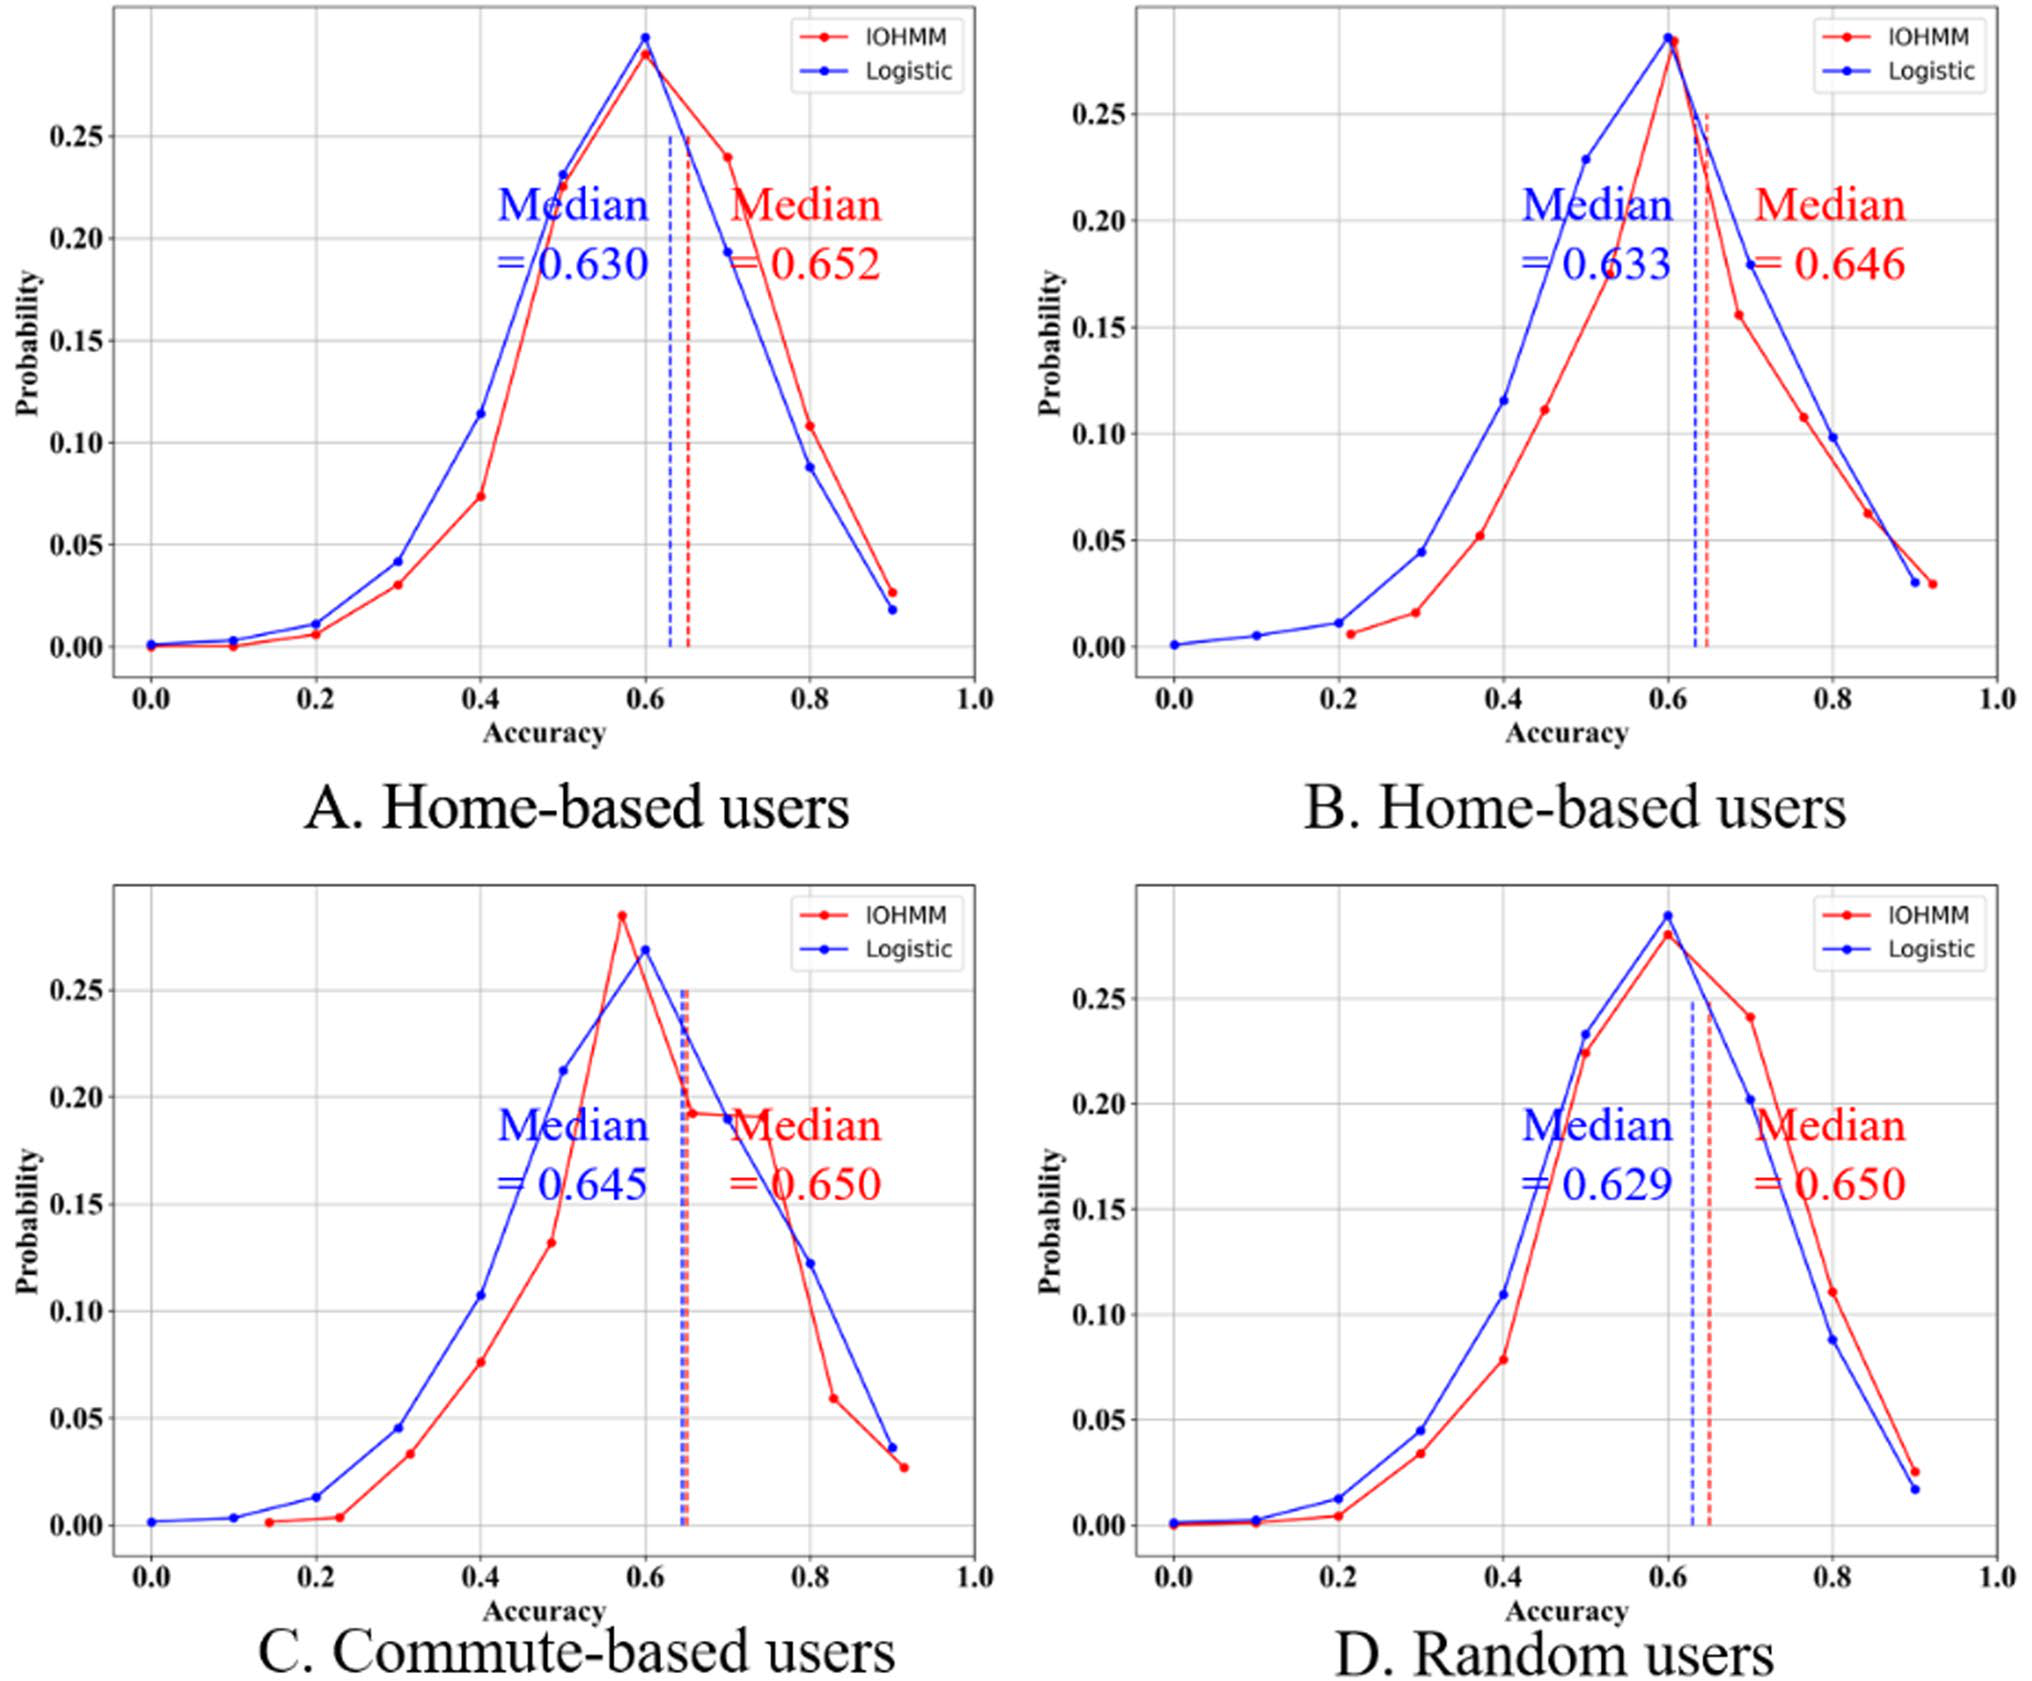
图 6|是否用平台叫车,四组是否一样容易预测?(A)家庭锚点组;(B)按总图注为工作锚点组;(C)通勤锚点组;(D)未识别锚点组。横轴为个人日决策准确率,纵轴为分布概率;红色 IOHMM、蓝色逻辑回归,虚线给中位数。四组红线中位数都在约 65% 附近,不能据分布相近证明真实出行目的没有作用。来源:原论文 Fig. 6。
对于这种叫车日与不叫车日可能不平衡的任务,还需要报告始终预测多数类别的基线、召回率或平衡准确率,才能判断漏掉多少实际叫车日。仅有 65% 的总准确率,不足以回答系统是否能有效识别需求发生。
Table 4 给出日订单数输出的系数。历史订单数系数为正,部分组的平均行程距离与接驾距离系数为负,但不同组显著性并不相同。接驾距离是接单时车辆与乘客的距离,不能直接等同于乘客必须步行的距离;表内常数项也不能脱离其他变量直接当作模型平均日订单数。天气系数更不能用于证明恶劣天气导致用户由其他方式转向网约车。
通勤组的地点预测,究竟提高了多少?
起点预测中,IOHMM 与 HMM 的个人准确率中位数如下:家庭锚点组 0.52 对 0.50,工作锚点组 0.50 对 0.46,通勤锚点组 0.71 对 0.51,未识别锚点组 0.31 对 0.30。最明显的改善发生在有两处可识别锚点的群体。
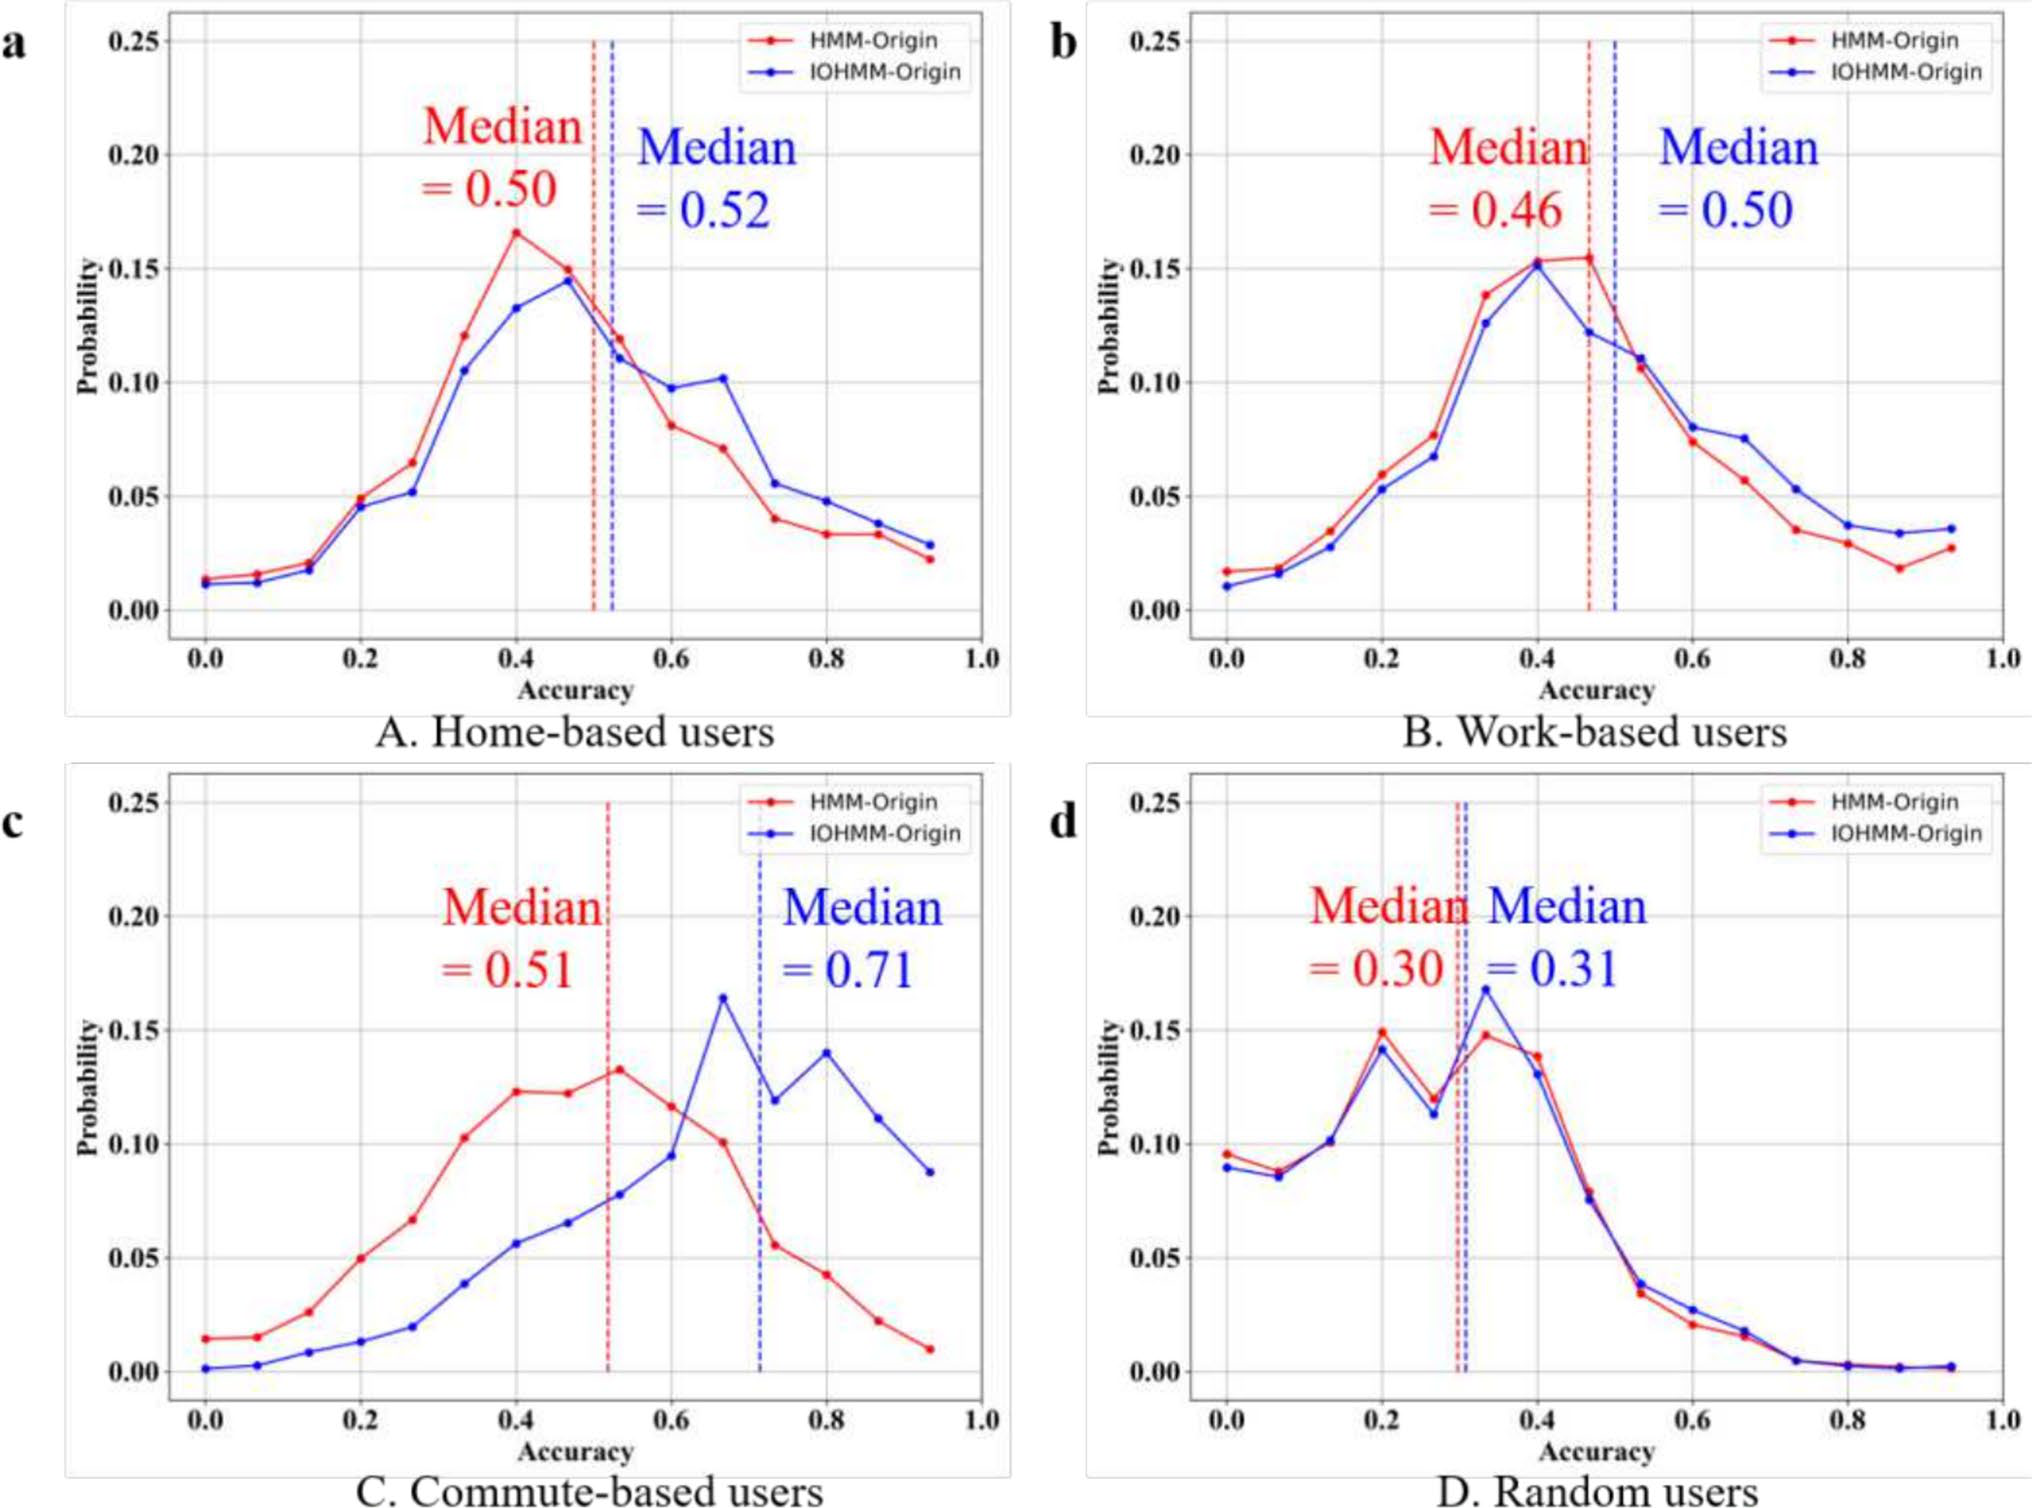
图 7|上下文对哪组起点最有帮助?(a)家庭锚点组;(b)工作锚点组;(c)通勤锚点组;(d)未识别锚点组。横轴为个人起点排名准确率、纵轴为分布概率;红色普通 HMM、蓝色 IOHMM。注意颜色与图 6 的模型对应不同。(c)中位数由 0.51 到 0.71,而(d)基本接近,体现了收益差异。来源:原论文 Fig. 7。
71% 是通勤组个人准确率分布的中位数,不是全体订单加权平均,也不是起终点同时猜中的比例。起点从常去地点开始的规律,比临时目的地通常更明显。
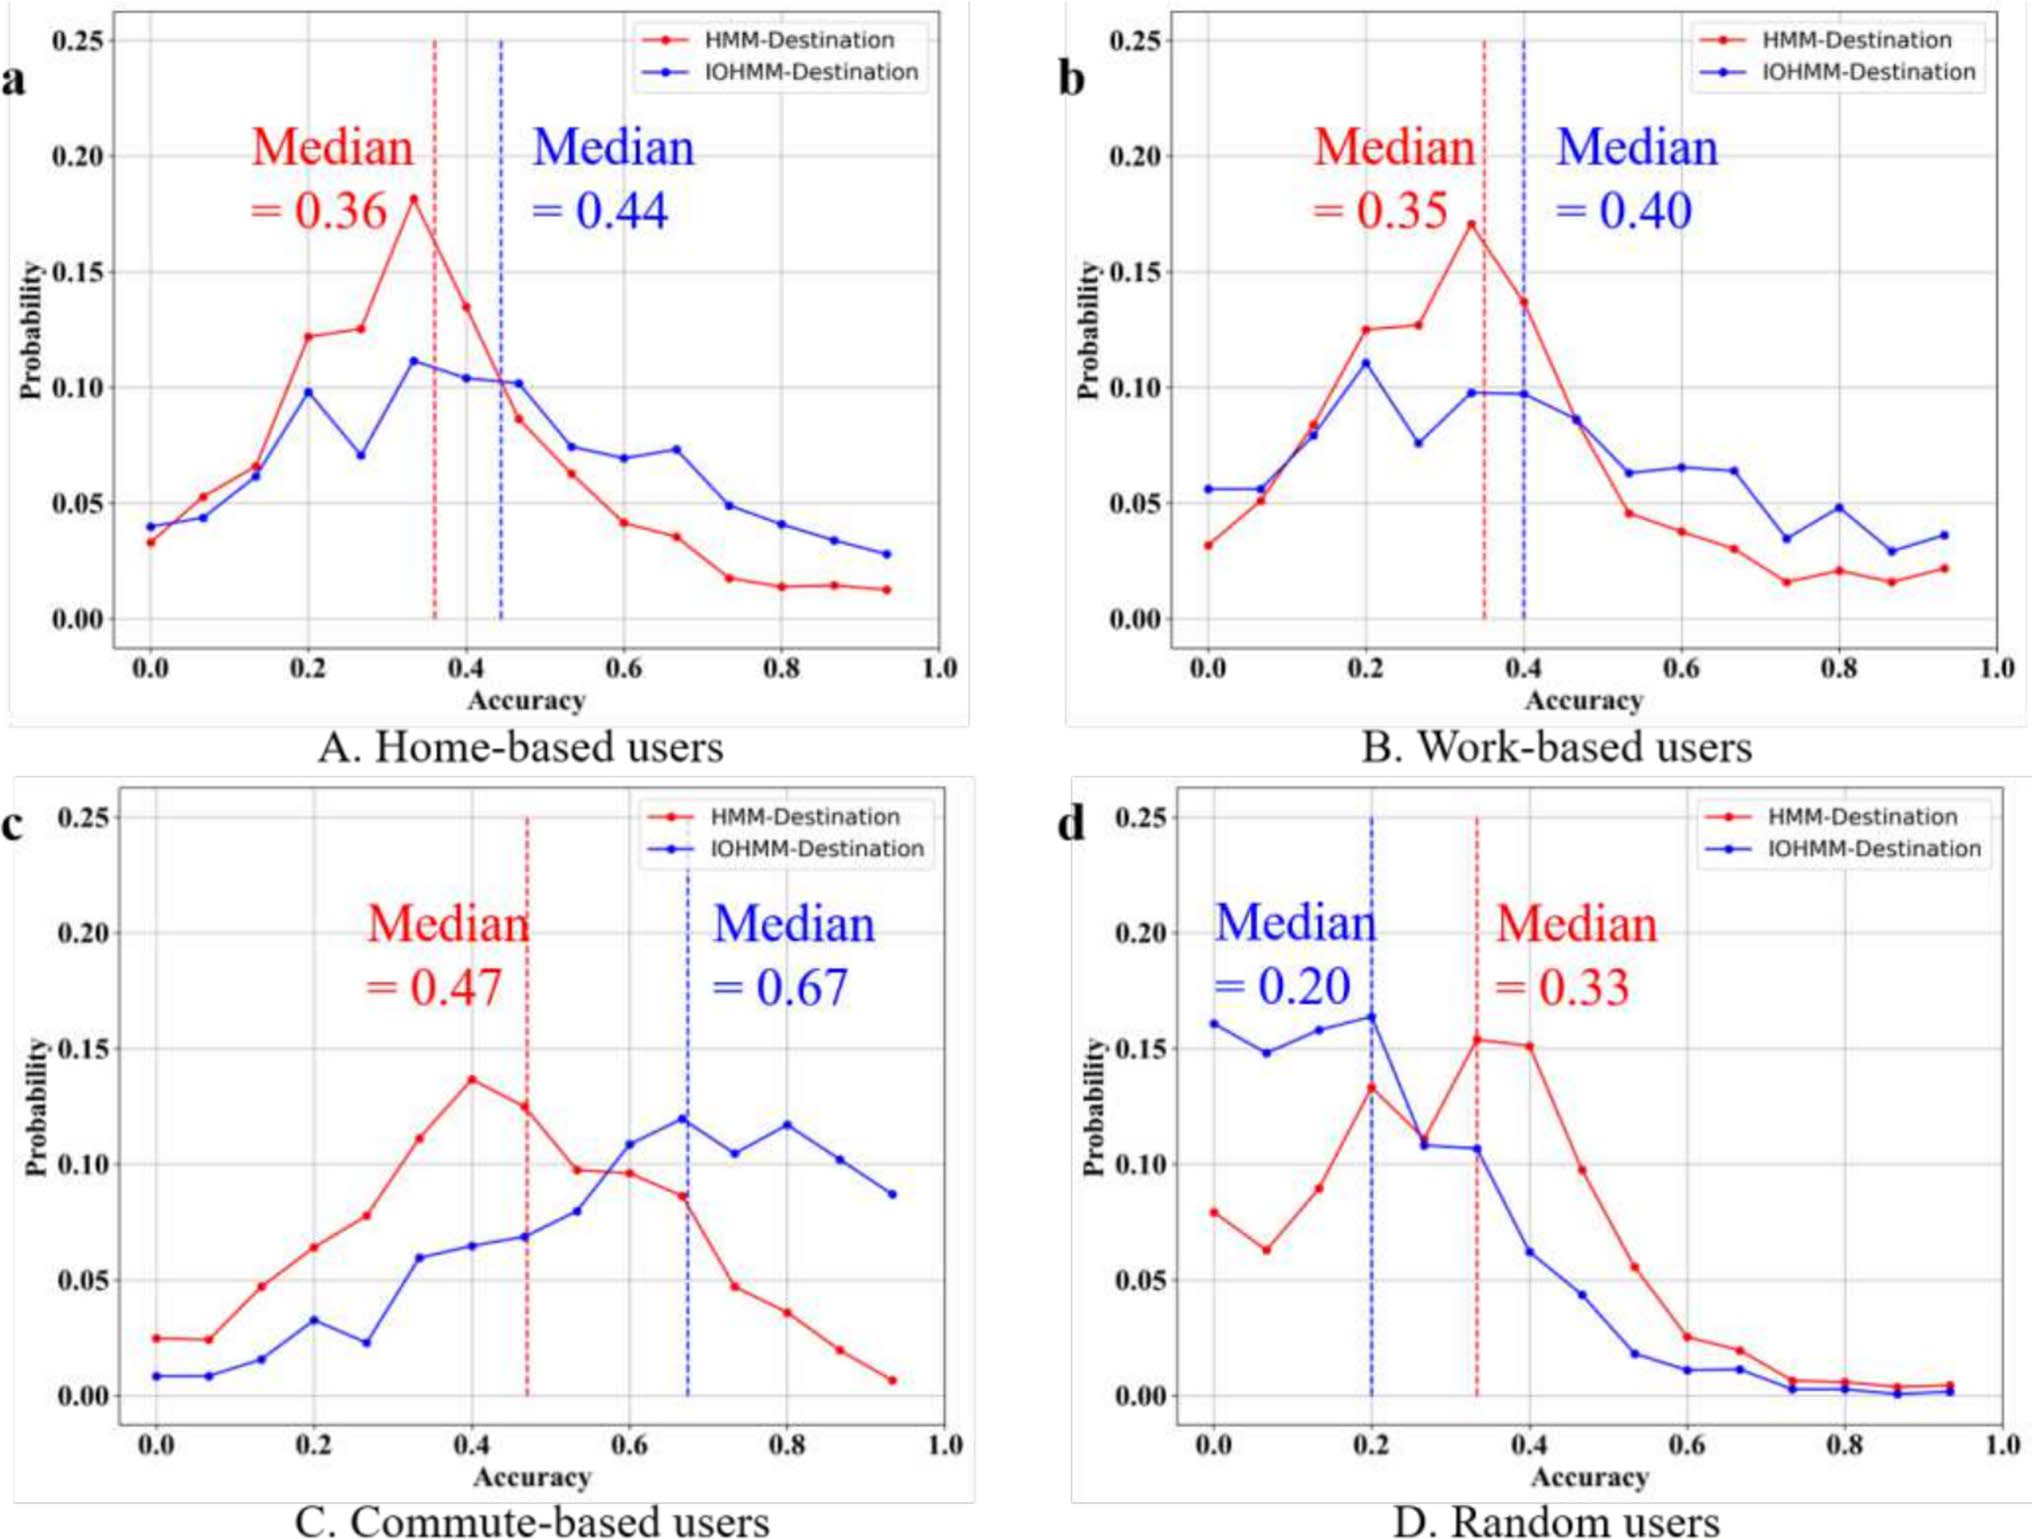
图 8|终点是否也同样容易猜?(a)家庭锚点组;(b)工作锚点组;(c)通勤锚点组;(d)未识别锚点组。红色 HMM、蓝色 IOHMM,坐标为个人终点排名准确率及其分布。前三组 IOHMM 中位数分别为 0.44、0.40、0.67,高于 HMM 的 0.36、0.35、0.47;但(d)IOHMM 为 0.20,低于 HMM 的 0.33,是重要反例。来源:原论文 Fig. 8。
正文将未识别组的 33% 列作该组目的地成绩,但原图图例明确把 0.33 标为 HMM、0.20 标为 IOHMM。这里按图中模型标识解读,不能把 33% 写成本方法在该组的中位数,也不能因此宣称新方法对每组都有提升。
这些订单条件下的结果,也不等于完整系统从未知一天开始的端到端成绩。第一层可能误判当天是否叫车,第二层还可能预测错订单数、起点或终点,实际部署需要把这些误差放在同一流程中评估。
工作日与高峰更好猜,是否说明其他时间不重要?
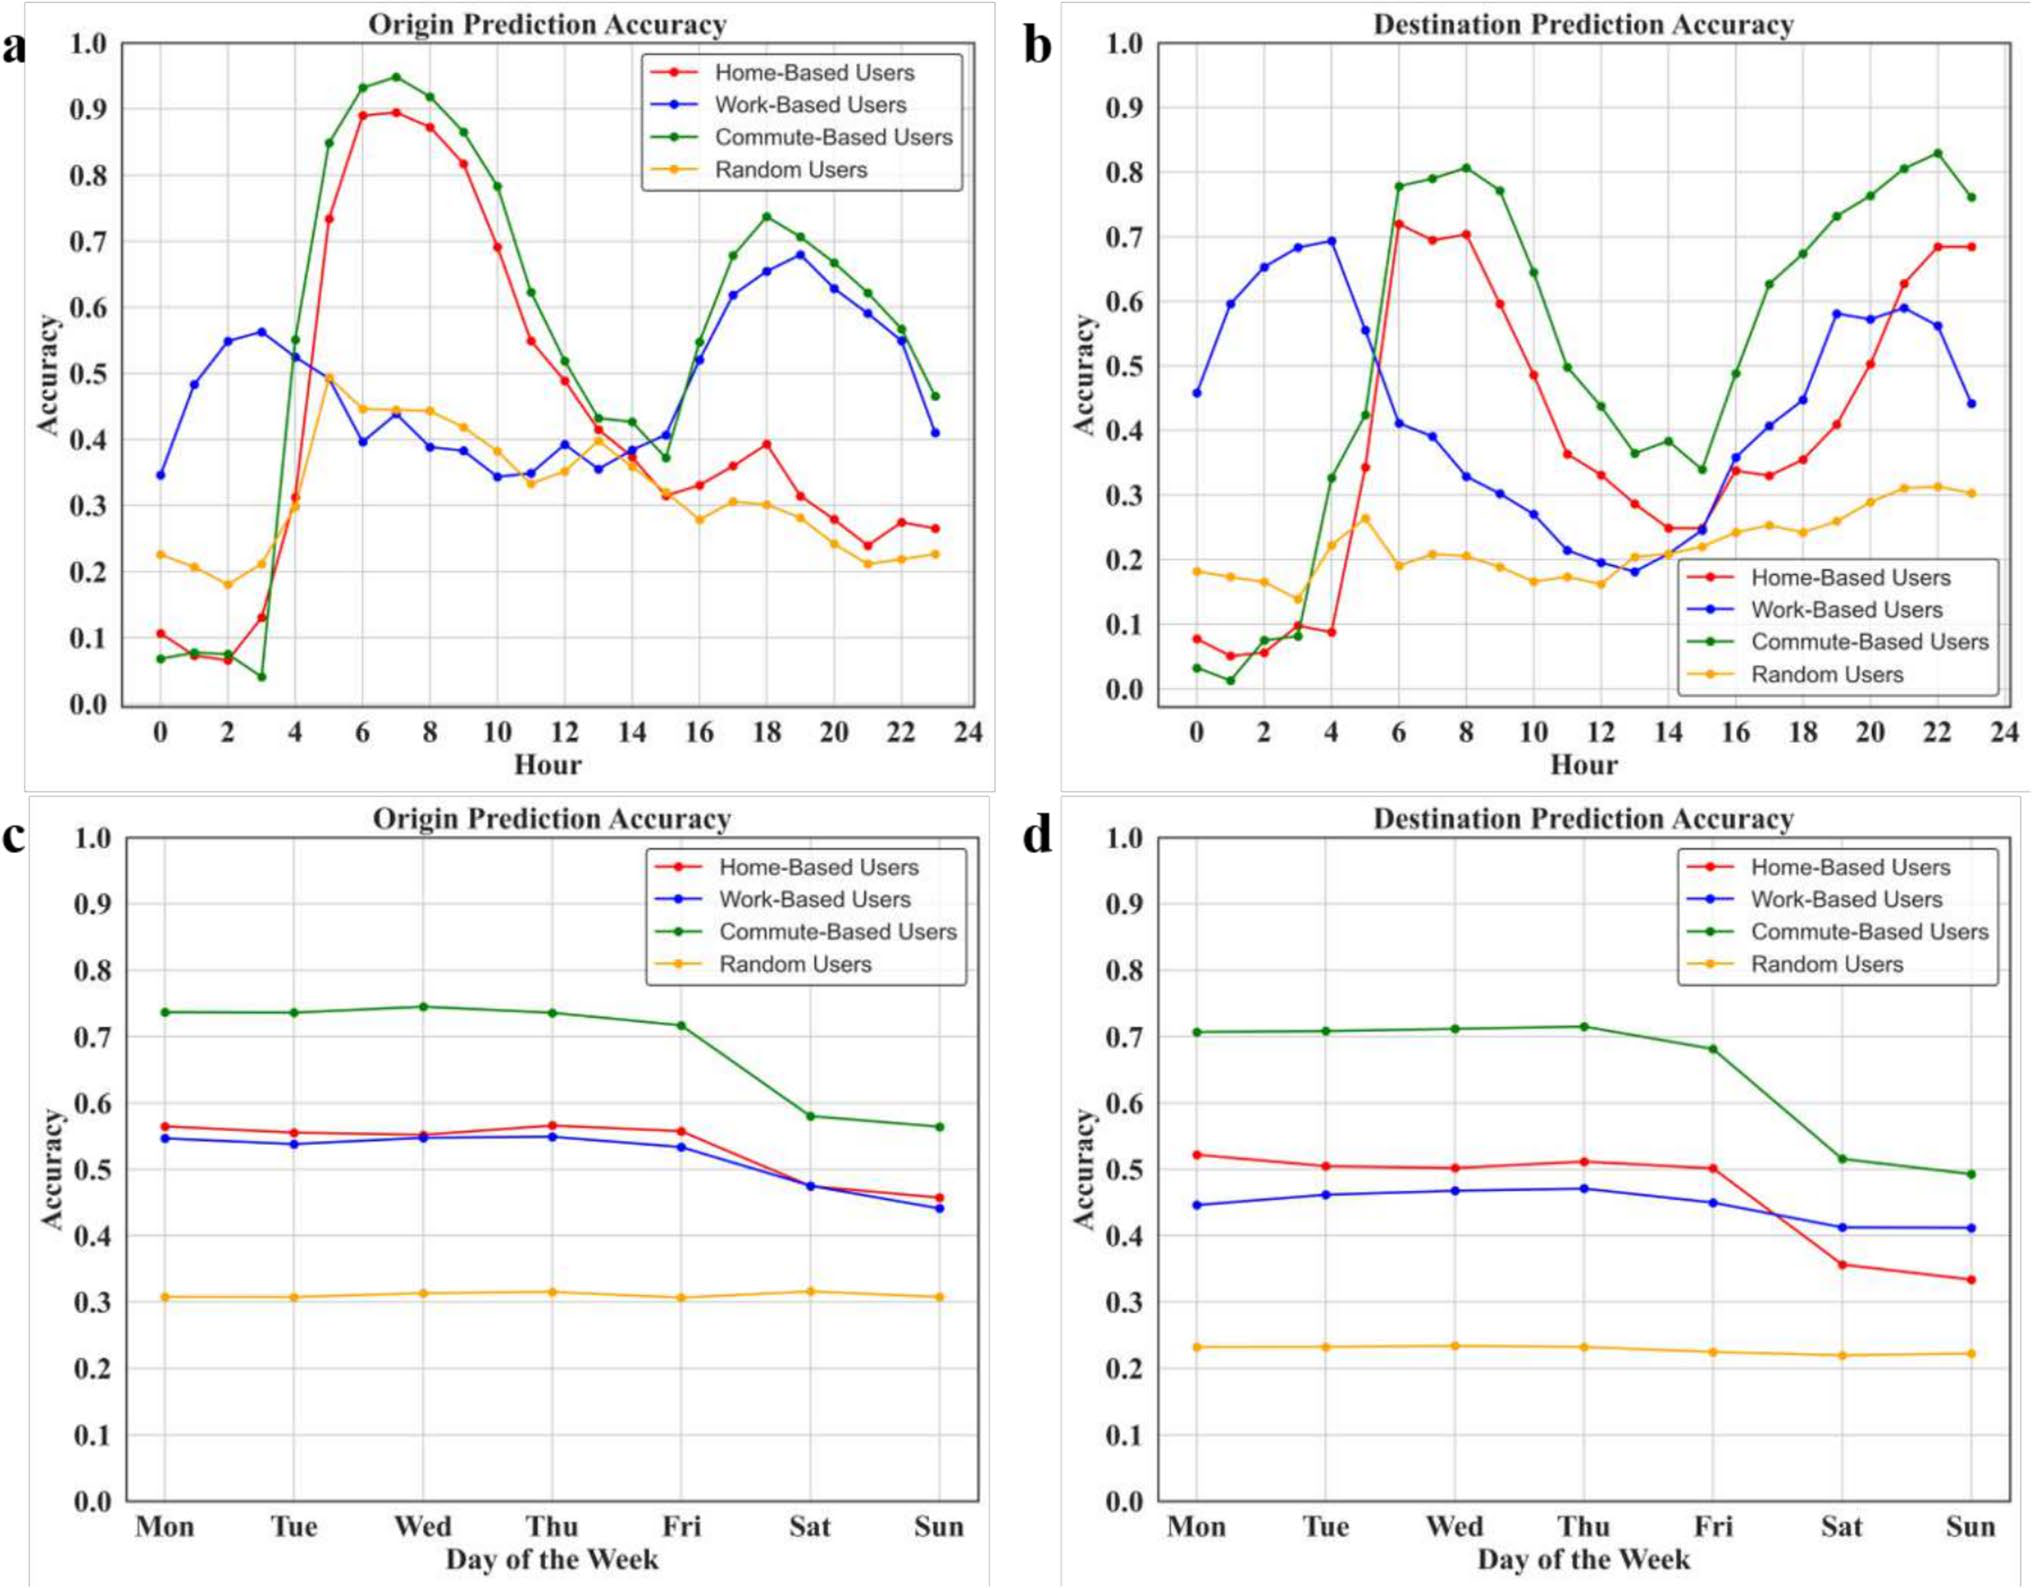
图 9|平均数掩盖了哪些时间差异?(a)各小时起点准确率;(b)各小时终点准确率;(c)星期一至周日的起点准确率;(d)相应终点准确率。红为家庭锚点、蓝为工作锚点、绿为通勤锚点、橙为未识别锚点。通勤组在高峰与工作日更高,周末明显下降;未识别组整体较低,波动相对小。曲线没有给各时段样本量或置信范围,不能把每次小幅起伏都当成显著变化。来源:原论文 Fig. 9。
图中通勤组早间起点可超过 90%,但这针对特定时段,不代表全天、所有用户或目的地也达到同样数值。高峰中较稳定的行程更容易预测,并不降低非高峰、临时出行对于调度服务的重要性。
接近可预测性,等于模型已经到顶了吗?
研究用保留访问顺序信息的熵估计,结合地点数与 Fano 关系求最大可预测比例;另与忽略访问顺序的估计比较。前者利用了序列结构,通常高于只看地点频率的结果。
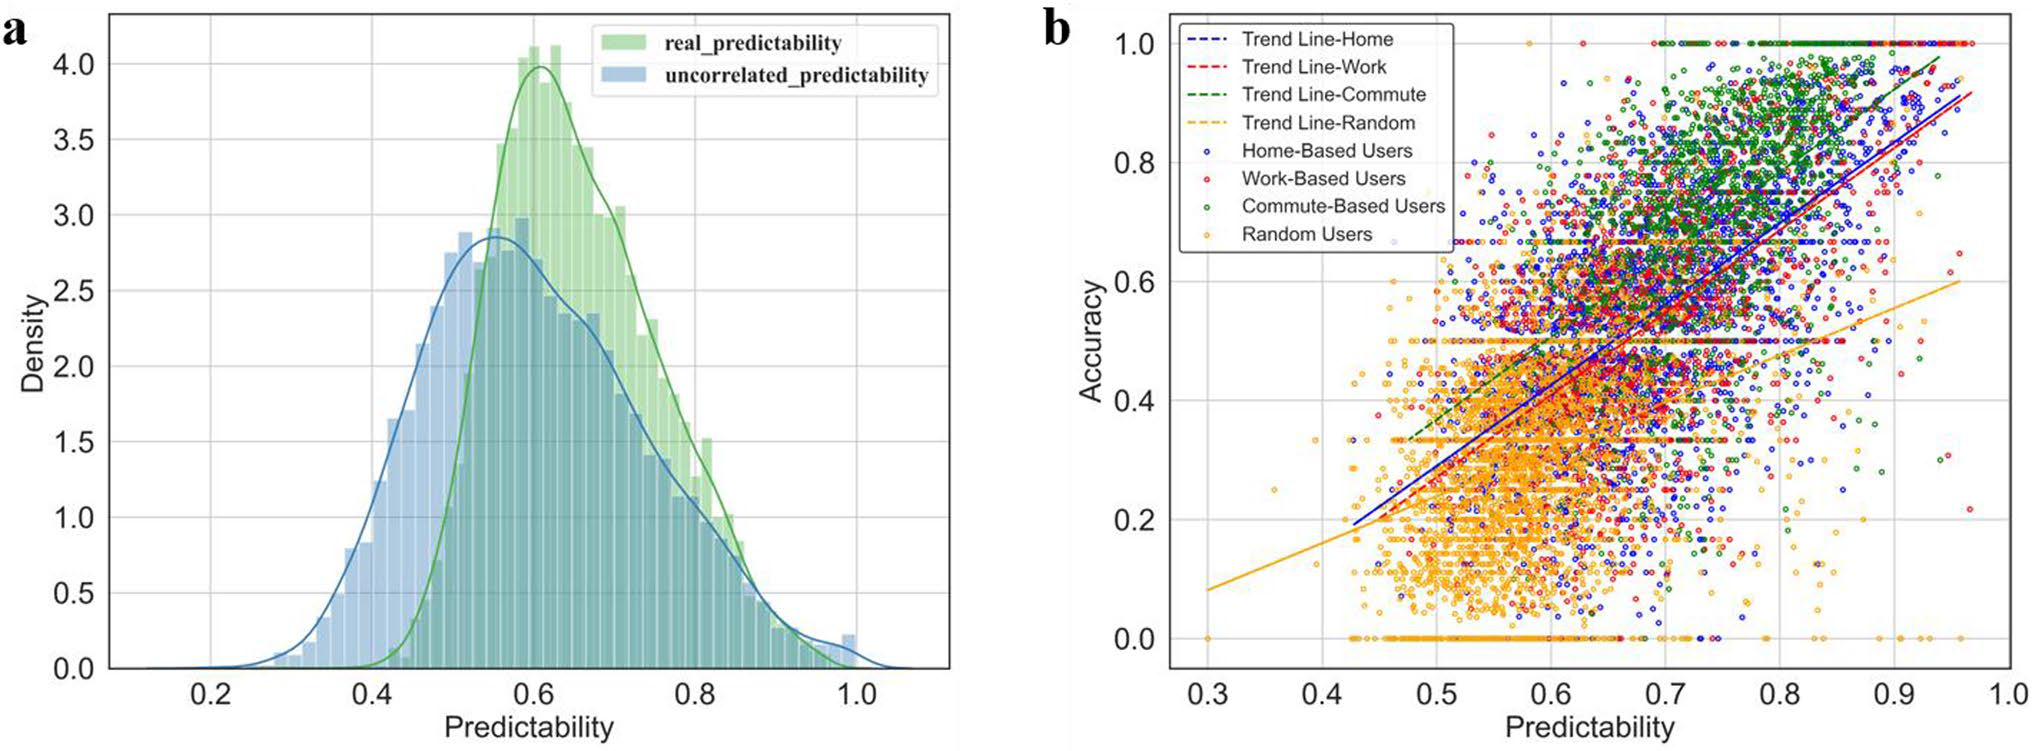
图 10|轨迹越有规律,模型是否也越容易预测?(a)横轴为估计可预测性、纵轴密度,绿色为考虑顺序的估计、蓝色为忽略顺序,前者在约 0.6 附近集中;(b)横轴估计可预测性、纵轴起点预测准确率,颜色区分四组,趋势线大体向上,通勤组更多位于右上方。散点仍很分散,有些个人准确率也高于对应估计,不能将趋势线当作逐人严格边界。来源:原论文 Fig. 10。
论文报告通勤组平均估计可预测性约 73%,未识别锚点组约 58%。通勤组 71% 的预测中位数与前者接近,支持其行为更有规律、模型更容易利用,但两者一个均值一个中位数,不能直接相减后宣称只剩两个百分点改进空间。
估计上限取决于有限序列、熵估计与地点字母表。地点排名合并和上限计算应采用可比口径,才适合做严格边界对照;散点图本身不能证明当前实现已经达到不可超越的上限,也没有证明改用其他模型一定无益。
一句话总结
先区分平台用户的锚点规律,再分别预测是否叫车与地点排名,能明显改善通勤群体的结果;对低频、非固定目的地及整个日级预测流程,证据仍有限。
核心来源
Jiechao Zhang, Samiul Hasan, Kamol Chandra Roy, Xuedong Yan. Predicting Individual Mobility Behavior of Ride-Hailing Service Users Considering Heterogeneity of Trip Purposes. Data Science for Transportation, 6, 29, 2024。论文与 DOI。本文依据全文、Table 1—4 与方法公式;Fig. 1—10 均保留完整原图。数据受平台保密约定限制,论文未公开原始订单。
作者介绍
- Jiechao Zhang:论文署名为美国中佛罗里达大学土木、环境与建筑工程系,列为通讯作者。
- Samiul Hasan:论文署名为美国中佛罗里达大学土木、环境与建筑工程系。
- Kamol Chandra Roy:论文署名为 CPCS Transcom Inc. 基础设施分析部门,身份列为空间数据科学家。
- Xuedong Yan:按论文机构署名为西南交通大学;参与研究构思与数据收集。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
可以把每个用户按时间向前滚动:只用此前订单识别锚点、排序地点与生成特征,然后预测下一周。将结果与使用全期画像的版本比较,才能看清分组带来的改善有多少能在真实未来保留。
对于难预测的低频终点,单一其他地点标签可能并不适合调度。可以先预测活动类型或粗区域,再在候选中估计概率,同时允许模型表达不确定。这样既不把低频地点合并后的命中误当精确定位,也能检验概率信息是否比单一最高分地点更有服务价值。