猜你今晚回家,和猜你旅行时下一站去哪,需要同一种线索吗?
论文名片|Xiaojie Yang、Zipei Fan、Hangli Ge、Takashi Michikata、Ryosuke Shibasaki、Noboru Koshizuka,Causality-Aware Next Location Prediction Framework based on Human Mobility Stratification。作者与实验室将论文列为 IEEE UIC 2024 工作;本文解读其 2025 年 3 月 23 日提交的八页版本 arXiv:2503.18179v1,arXiv DOI。
你晚上从公司出发,先吃饭、再去超市,最后仍然回家。另一天,你在陌生城市旅游,刚离开车站,接下来去哪可能更依赖眼前位置。对这两种情境,历史轨迹里同一项“上一地点”信息,未必承担相同作用。
这篇论文按个人常去程度区分目的地,再用模型内部的反事实对照改变训练方式。它将设计称为因果感知框架,但实验直接检验的是下一地点预测表现,并没有通过真实出行干预识别人类移动的因果效应。
主要发现有四点:
- 锚点按每个用户的访问次数定义,火车站等同一类地点,对不同人可以分别是常去锚点或少去地点。
- 框架把用户—时间信息与包含历史地点的状态分开,训练时只对非锚点目的地使用反事实状态差。
- 在 GRU、DeepMove、Flashback 等多种模型与三套数据上,多数设置改善;强基线 GETNext 的提升较小。
- 改进并非普遍:HSTLSTM 在 Blogwatcher 上所有三种策略的 Recall@5 都下降。预测收益和消融不足以证明所画因果图就是真实出行机制。
哪些目的地算锚点,哪些不算?
锚点地点(anchor location)在这里是个人层面的频繁访问地点,可能对应家、工作地或学校,但并不需要先给地点贴上这些语义标签。对某个用户,访问一个地点的次数超过阈值,就把它归为该用户的锚点。
训练样本再按真实目的地是否属于该人的锚点分组。模型不必提前知道用户下一站是什么,才能在部署时选择分支:这一分组用于训练,测试时使用统一预测输出。
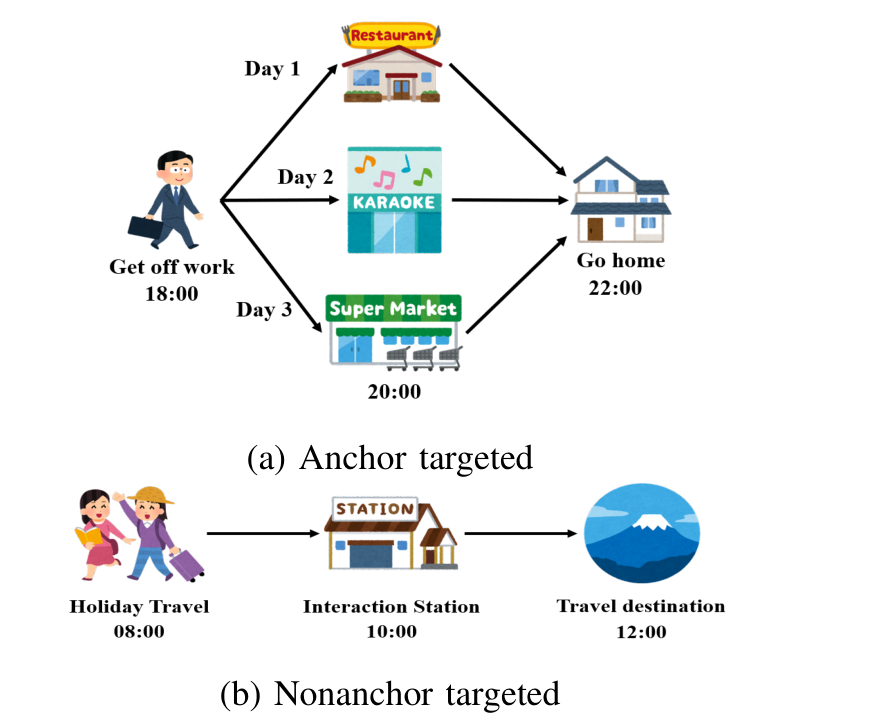
图 1|目的地的规律性为什么会改变线索价值?(a)展示不同下班活动最终返回同一锚点“家”的例子;(b)展示旅行中经车站前往非日常目的地的例子。图中的时刻帮助解释情境,不是实验中已测出的普遍出行时间。它说明分层的动机,不表示所有回家行程都不受上一地点影响。
论文用 Foursquare 的条件概率例子进一步说明这个想法:比较只知道时段,与还知道上一地点是商场时,目的地分布怎样变化。
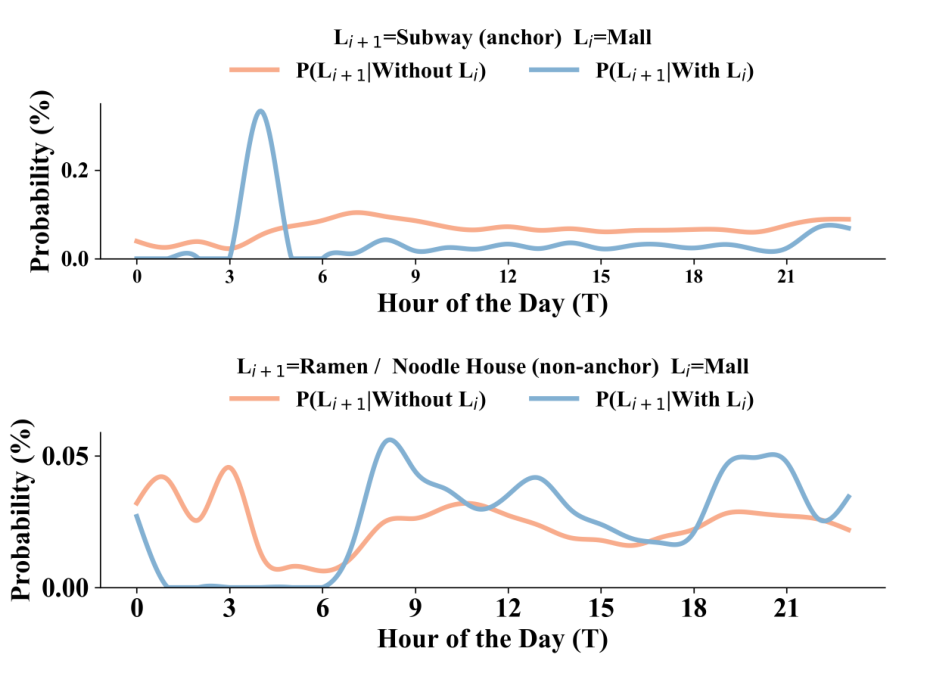
图 2|知道上一站,是否在所有时段都同样有帮助?原图上下无子图字母,上面以 Subway 为锚点示例,下面以 Ramen/Noodle House 为非锚点示例,上一地点均为 Mall。横轴为一天内小时,纵轴为目的地条件概率%,橙线不加入上一地点、蓝线加入。两类曲线变化方式不同,且同一类也随时段变化;下图蓝线并不是全天高于橙线。这是条件概率的描述比较,不能直接当成预测准确率提升或因果效应。
因果图在模型里增加了什么结构?
传统融合方式把用户 U、历史地点 L、时间 T 一起送入隐藏状态,再预测下一地点 Y。新框架先只用用户与时间产生 H,再将 H 与地点历史结合产生 G,并保留 H 和 L 到输出的直接分支。
H 的含义是结构上未直接输入地点的表示,不代表它在统计上与地点绝对独立——一个人的身份、时段本来就可能与常去地点有关。
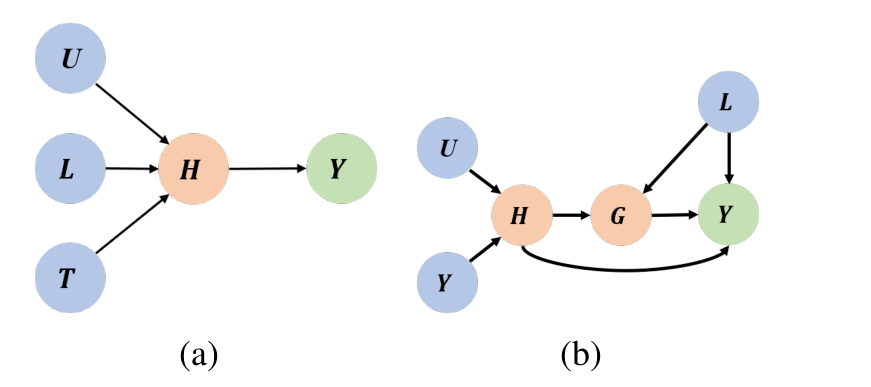
图 3|哪些信息走直接分支,哪些通过中间状态?(a)U、L、T 融合成 H 后输出 Y。(b)用户与时间先形成 H,H 与 L 形成 G,输出同时接收 H、G、L。H→Y 与 L→Y 是直接分支,经过 G 的路径是作者关注的间接分支。原图(b)左下输入写作 Y,按正文定义应为 T;这里依正文解释,不把它视为输出反向进入网络。
这张图是研究者提出的结构假设。隐藏状态由神经网络定义,箭头反映模型计算安排;图画出来、预测变好,并不自动证明现实中不存在遗漏混杂,或这些隐藏状态具有唯一可识别的因果含义。
反事实不是让同一个人重新出行,而是怎样做模型内对照?
模型先算正常输出 Y(H,G,L)。随后构造一个替代隐藏状态 G,在保留原来的 H 与 L 直接分支时,替换经过中介状态的部分,得到 Y(H,G,L)。作者将两者之差作为总间接效应(total indirect effect,TIE):
TIE = Y(H,G,L) − Y(H,G*,L)。
直观上,它想扣掉不通过真实地点融合状态 G 仍能给出的部分,使模型更重视非日常目的地预测中有用的历史地点关系。
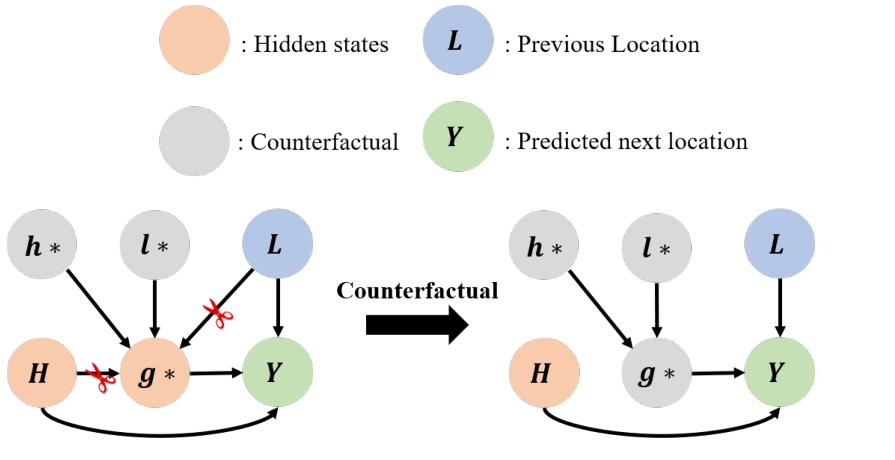
图 4|对照中到底替换了什么?原图左右无字母。橙色为正常隐藏状态,蓝色 L 为历史地点,绿色 Y 为输出,灰色为构造的反事实值;剪刀表示切断正常 H、L 到待替换状态的输入,改由 H、L 构造 G*。右图仍保留正常 H→Y 与 L→Y,因而两次输出的区别集中在中间状态。它是计算图干预,不是让用户在现实中访问另一个地点的随机试验。
反事实地点嵌入 L 有三种构造策略:I 用 0–1 均匀随机向量;II 置零;III 用其他观测嵌入的均值。H 始终使用随机策略 I。策略 III 的“其他观测”不是给每个用户新增一段真实出行,而是构造替代表示。
对锚点目的地,训练目标使用正常输出;对非锚点目的地,使用正常与替代输出之差。两组共享参数,最终测试时不再运行反事实替换,只用正常模型输出。
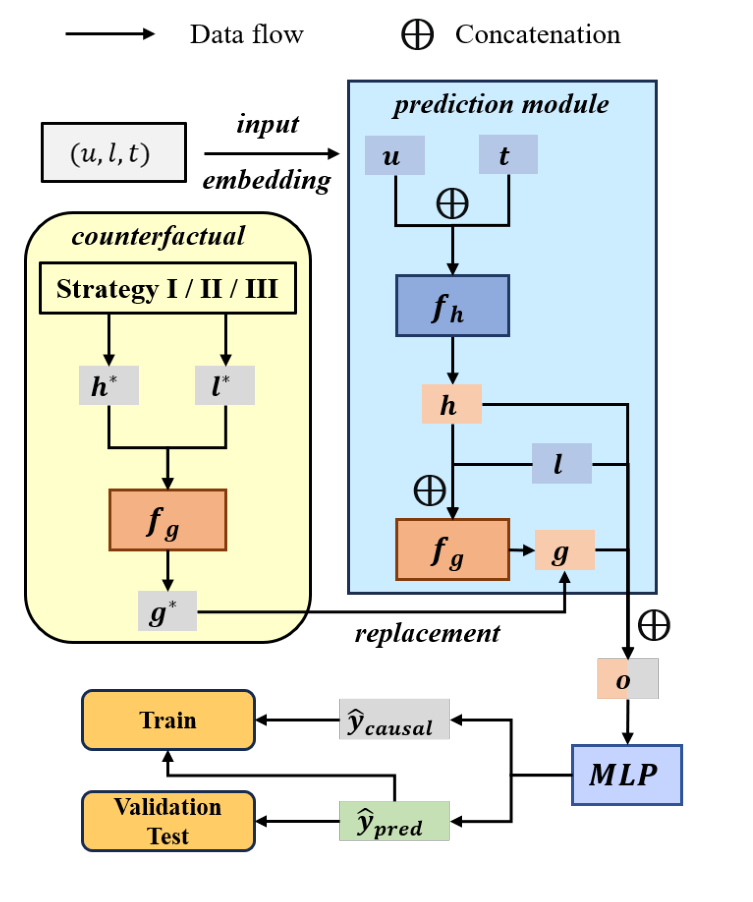
图 5|额外对照只在训练,还是预测时也需要?无子图字母的架构图右侧蓝区是正常模块:用户和时间经过 fh 形成 h,再与地点经 fg 形成 g,h、g、l 拼接后由 MLP 输出。左侧黄区生成 h、l 和 g*,用于训练对照;下方明确区分 Train 与 Validation/Test。正常输出承担验证与测试,不能把它讲成部署时先知道下一站类别再选模型。
公式还留下一个复现细节:正文把正常输出描述成 softmax 概率,再对两个输出做差并送入分类损失。两个概率向量的差可能有负值、总和为零,不能直接当作标准概率分布;实际使用 logits、重新归一化还是其他处理,文中没有完整展开。理解训练思想与严格复现损失实现,是两件需要分别完成的事。
三套数据的预测任务怎样设置?
论文表 I 报告以下规模,包含两套签到数据与一套 GPS 停留位置数据:
| 数据 | 用户数 | 地点数 | 记录数 |
|---|---|---|---|
| Foursquare 东京 | 2,293 | 61,858 | 537,703 |
| Foursquare 纽约 | 1,083 | 38,333 | 227,428 |
| Blogwatcher | 4,991 | 159,513 | 2,859,572 |
Foursquare 按时间排序,以 72 小时间隔切分轨迹,过滤少于五条记录的轨迹和少于五条轨迹的用户。Blogwatcher 为 2022 年 10–11 月关东地区 GPS,覆盖东京、千叶、神奈川、埼玉,位置汇总为 125 米网格,先检测停留点,再按两小时间隔切分。主动签到与被动位置检测记录的生活侧面不同,不能把两者同名地点频率当作完全可比的行为测量。
训练、验证、测试比例为 0.7/0.1/0.2,使用验证集选参数。文中称同组比较保持模型结构与参数数量一致;未完整说明按时间还是用户划分,也没有明确锚点访问次数是否只由训练段统计,因此不能额外宣称已实现严格未来时段或新用户的无泄漏泛化验证。
评价使用 Recall@5、MRR@5、NDCG@5。单一正确下一地点下,Recall@5 看答案是否进入前五,MRR@5 更重视正确答案排得靠前,NDCG@5 也对排名进行折扣。它们衡量候选地点排名,不是距离误差,表中按百分数尺度展示。
哪些模型获益,哪些没有?
下表摘取主表的 Recall@5:箭头前为原模型,后为三种策略中表内最高值。它用于看可能收益的范围,不表示可以在测试集上事后挑最优策略作为实际部署流程。
| 模型 | 东京:原始 → 表内最佳 | 纽约:原始 → 表内最佳 | Blogwatcher:原始 → 表内最佳 |
|---|---|---|---|
| GRU | 39.76 → 44.42 | 35.00 → 41.68 | 68.57 → 71.19 |
| DeepMove | 41.36 → 44.66 | 39.27 → 44.41 | 66.23 → 67.72 |
| Flashback | 36.82 → 43.18 | 34.37 → 42.08 | 70.01 → 72.94 |
| HSTLSTM | 39.08 → 39.86 | 37.38 → 38.12 | 80.24 → 78.05 |
| GETNext | 55.42 → 55.95 | 53.53 → 55.49 | 80.05 → 80.16 |
例如,东京 GRU 从 39.76% 到 44.42%,增加 4.66 个百分点,按表值计算相对增加约 11.72%;纽约 Flashback 从 34.37% 到 42.08%,增加 7.71 个百分点。这是不同模型在各自基线上的改进,不能把最高增幅描述成所有模型都提高相同幅度。
排名质量也有类似改善。东京 GRU 策略 I 的 MRR@5 为 30.88、NDCG@5 为 34.26,分别高于原始 26.83、30.05;但东京 HSTLSTM 某些策略的 MRR 略降或持平,说明不是每个指标都改善。
尤其要保留 Blogwatcher 的 HSTLSTM:原始 Recall@5 为 80.24,策略 I、II、III 分别为 71.89、78.03、78.05,全部更低。最佳策略也下降 2.19 个百分点,策略 I 更下降 8.35 个百分点。作者仍总结多数情形有效,不能将其扩写为“即插即用必然增强所有基线”。
GETNext 在 Blogwatcher 的最高提升只有 0.11 个百分点;论文没有给重复训练波动或置信区间,不能确认这种极小差别具有统计稳定性。不同结构原有的时空建模能力,也可能影响额外模块的收益。
锚点阈值怎样影响结果?
阈值太低,大部分地点都被当作锚点,反事实训练很少发挥作用;阈值太高,又把很多熟悉地点分进非锚点组,未必有利。
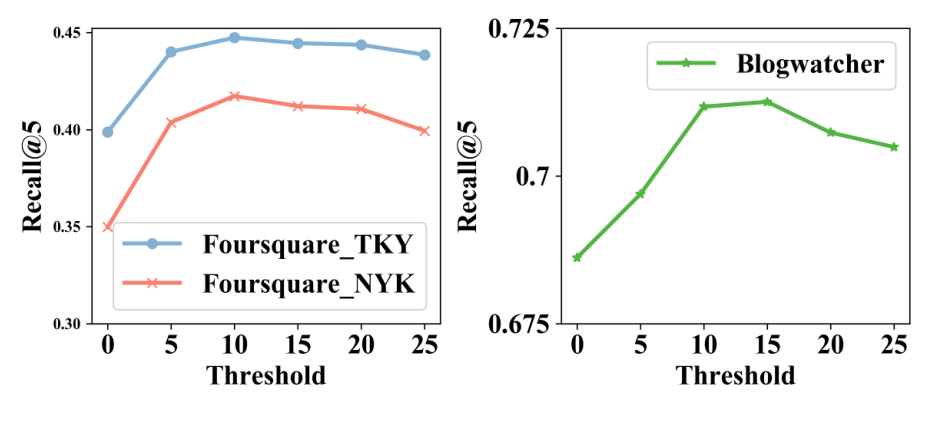
图 6|频繁访问至少多少次,才适合分为锚点?无字母双图,横轴为个人访问次数阈值,纵轴 Recall@5,以 0–1 小数显示。左图蓝色东京、红色纽约,右图绿色 Blogwatcher,均以 GRU 测试。候选阈值为 0、5、10、15、20、25,Foursquare 在 10 附近较好,Blogwatcher 在 15 附近较好;继续增加阈值会下降。图中未给误差区间,最优数值应按数据与实验设置解释。
阈值是访问次数,不是 10% 或 15%。它还受平台采样频率和观测长度影响,因此不能直接解释成一个人的固定习惯强度。
图中的两个直接分支有必要吗?
东京 GRU 的消融实验分别移除 H→Y、L→Y,再与完整框架比较:
| 设置 | Recall@5 | MRR@5 | NDCG@5 |
|---|---|---|---|
| 完整框架 | 44.42 | 30.88 | 34.26 |
| 去掉 H→Y | 43.90 | 30.44 | 33.80 |
| 去掉 L→Y | 41.44 | 28.46 | 31.70 |
| 两条都去掉 | 41.10 | 28.37 | 31.55 |
两条同时去掉,Recall@5 比完整框架低 3.32 个百分点;单独去掉历史地点的直接分支,损失比去掉用户—时间直接分支更大。即便训练目标强调间接部分,直接分支在整个模型学习中仍有用途,不能理解成“所有直接地点信息都应删除”。
这项消融支持网络结构对预测有价值,不足以验证现实的因果图唯一正确。不同结构还可能改变表示能力、优化难度和归纳偏好;识别真实因果效应需要另外的假设与证据。
非锚点目的地究竟改善了什么?
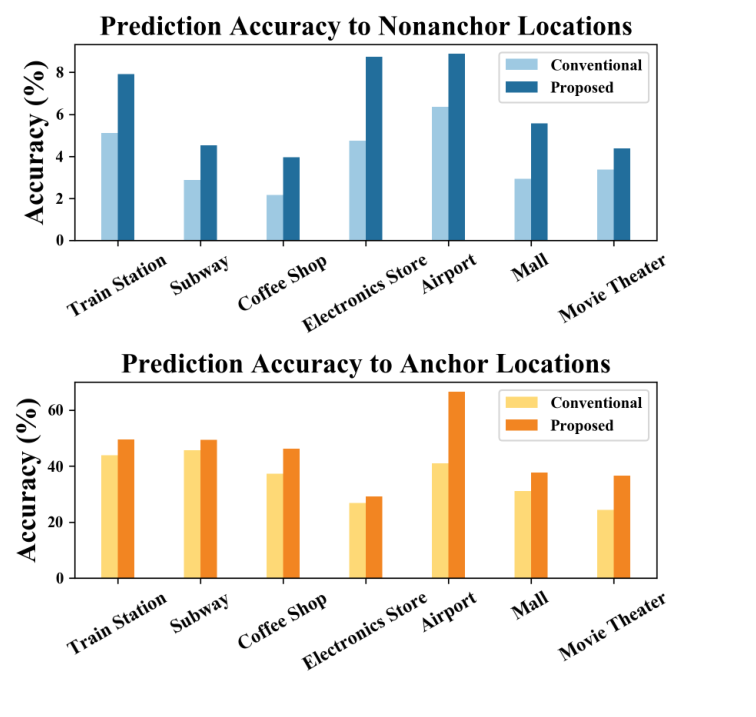
图 7|总分改善是否也出现在较少去的地点?原图上下无字母,使用东京 GRU 与策略 I。上图为非锚点目的地,浅蓝传统、深蓝新框架;下图为锚点,黄色传统、橙色新框架。横轴依次为 Train Station、Subway、Coffee Shop、Electronics Store、Airport、Mall、Movie Theater,纵轴为图中标示的 Accuracy%。两组各类别总体都有改善,但上下纵轴范围差很多,不能凭柱高直接比较两类收益。该图未把 Accuracy 的 top-k 口径完整写明,不直接等同于主表 Recall@5。
同一类别可以对甲是锚点、对乙不是。图中的分层不是说所有机场都属于非日常地点,也不是按建筑用途一次性决定。
这项工作对预测研究的启发是什么?
它提醒模型评估不要只看一个总分:容易预测的常去目的地,与更依赖当前位置的非日常目的地,可能需要不同训练信号。以共享模型承接不同目标,是这项工作的实用方向。
证据支持的是多个数据与结构中经常出现的预测改善,以及明确的例外。模型内随机、置零或均值替换的对照,不能等同于现实世界的自然直接效应和间接效应已经被无偏识别;论文也未提供随机出行实验、完整混杂排除或跨域因果稳定性检验。
复现时,还需要明确数据划分、锚点统计范围、反事实均值来自哪些观测、概率差如何进入损失,以及重复训练的不确定性。只有这些细节明确,才更容易判断提升来自何种机制,以及模块在新场景是否值得采用。
一句话总结
按个人目的地熟悉程度分层,再用反事实隐藏状态对照训练,能改善不少下一地点预测模型,但收益依赖结构与数据,“因果感知”也不等于真实出行因果关系已被证明。
核心来源
- Yang X, Fan Z, Ge H, Michikata T, Shibasaki R, Koshizuka N. Causality-Aware Next Location Prediction Framework based on Human Mobility Stratification. arXiv:2503.18179v1,2025 年 3 月 23 日;全部图 1–7、表 I–II 和方法来自该八页版本。
- 作者实验室论文目录,将该文列入 2024 年 IEEE UIC 会议工作;arXiv 页面也注明 Accepted by IEEE UIC 2024。
- Niu Y et al. Counterfactual VQA: A Cause-Effect Look at Language Bias. CVPR 2021,本文借鉴模型内反事实效应构造的来源,见原文参考文献 25。
作者介绍
以下仅采用论文首页的署名机构与通讯标记。
- Xiaojie Yang:The University of Tokyo 署名作者,本文第一作者、通讯作者之一。
- Zipei Fan:Jilin University 署名作者,本文通讯作者之一。
- Hangli Ge:The University of Tokyo 署名作者、本文共同作者。
- Takashi Michikata:The University of Tokyo 署名作者、本文共同作者。
- Ryosuke Shibasaki:The University of Tokyo 署名作者、本文共同作者。
- Noboru Koshizuka:The University of Tokyo 署名作者、本文共同作者。
延伸思考:不要让“多数时候猜对”掩盖陌生目的地
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个模型每天都猜家和公司,总命中率可能很好。但旅游、就医、临时办事等不常见活动,可能正是服务最需要提供帮助的时候。若只优化总分,模型容易把这些少见目的地当作无关紧要的尾部。
可以在评估中同时报告常去与少去地点的结果,并检查阈值变化、用户活跃度和不同类别。再进一步,比较同样增加训练扰动、但不采用因果表述的普通正则化方法,能帮助判断收益是否确实来自特定图结构与差分目标。
把预测收益与机制解释分开检验,可以更清楚地认识两类贡献:预测是否变好,以及为什么会变好。它们各自需要相应证据。