一座城市定位太少,能借另一座城市的生活规律生成轨迹吗?
论文名片|Yu Wang、Tongya Zheng、Yuxuan Liang、Shunyu Liu、Mingli Song,COLA: Cross-city Mobility Transformer for Human Trajectory Simulation,Proceedings of the ACM Web Conference 2024,3509—3520,WWW ’24,新加坡,2024年5月13—17日。DOI:10.1145/3589334.3645469,作者预印本。
一座城市可能只有少量签到记录,却需要一批可供出行研究使用的合成轨迹。另一座城市的数据比较多,但直接搬来那里的地点编号没有意义:一个编号在纽约指向餐馆,在新加坡可能对应住宅。
COLA的想法是,把能跨城借用的序列规律与必须留给本地的地点表示分开。生成时再调整热门地点过强的吸引力,避免模型反复困在少数地点。四组数据上的结果支持这套组合,但它生成的是总体统计相似的轨迹,并不等于恢复具体居民的真实行程。
先说结论
- COLA保留各城市自己的地点嵌入和部分注意力参数,共享用于计算历史位置关联的参数;目标城市仍需要本地训练数据。
- 四组数据、六项分布指标中,COLA有21项最优,另外3项第二;这里比较的是分布差异,不是个人下一地点的21次预测成功。
- 多个来源城市通常能提供有用信息,但更多来源并非逐指标更优。删去共享结构或生成后的频率调整,多数指标变差,也存在例外。
- 合成轨迹可用于下一地点预测的数据增强;论文没有提供差分隐私保证或重识别攻击测试,不能由“合成”直接推出隐私安全。
能借的是访问关联,不能直接借的是地点身份
纽约和日本城市都存在居住、工作、购物等活动,地点访问频率也都有长尾:少数地点频繁出现,大量地点偶尔出现。但城市布局、记录方式及热门程度不相同。共同形态为迁移提供动机,并不证明两座城市的所有行为机制相同。
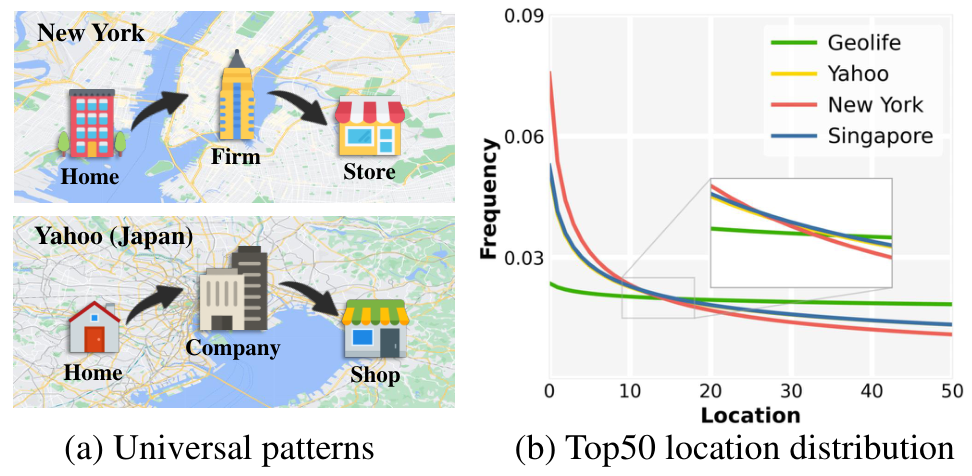
图 1|跨城共享为何有希望,又为何不能整套照搬?
(a)以纽约与日本的活动链作示意,强调相似活动可以发生在不同实际地点,不是对具体受试者行程的还原。(b)横轴为访问频率排序后的前50个地点,纵轴为频率;四条线对应四组数据,局部放大显示长尾细节仍有差异。来源:原论文 Fig. 1。
COLA采用Transformer,把过去去过的地点编码成序列,逐步采样下一个地点。因果注意力只能读取当前及更早的位置,训练时不能偷看后续轨迹。它解决的是生成任务;论文后面的下一地点预测是检验合成数据用途的另一项任务。
在半开放注意力(half-open attention)中,查询Query与键Key用于计算当前记录应关注哪些历史记录,相关变换参数跨城市共享。值Value与地点嵌入保留给各城市,避免把某城地点的含义直接套到另一城。最终输出层的地点权重也与本地嵌入关联。
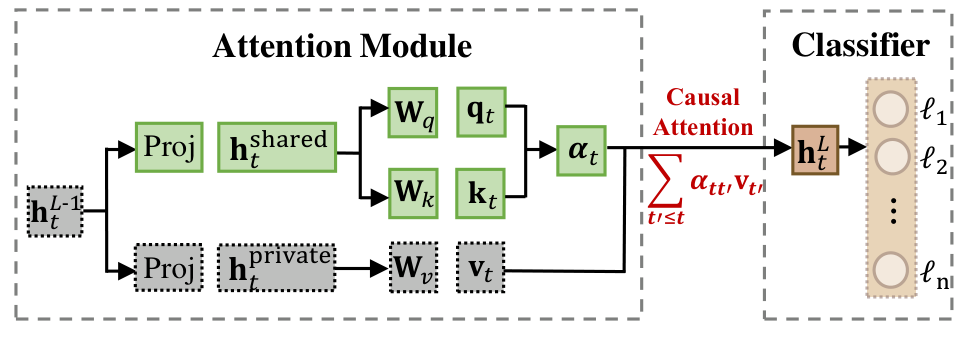
图 3|怎样共享关联计算,又保留本地地点表示?
图中没有字母子图。绿色支路产生跨城共享的Query和Key,灰色支路产生本地Value,右侧按本城市的地点集合输出概率。红色因果注意力表示对历史位置加权,不是识别居民真实意图的独立证据。来源:原论文 Fig. 3。
共享参数也不是把所有城市混在一起直接训练。元学习(meta-learning)先让每个来源城市从共同参数出发,用自身训练集更新,再用其留出的数据计算元梯度,更新共同起点。目标城市取得这个起点后,仍用自己的数据适配;整套过程反复进行。
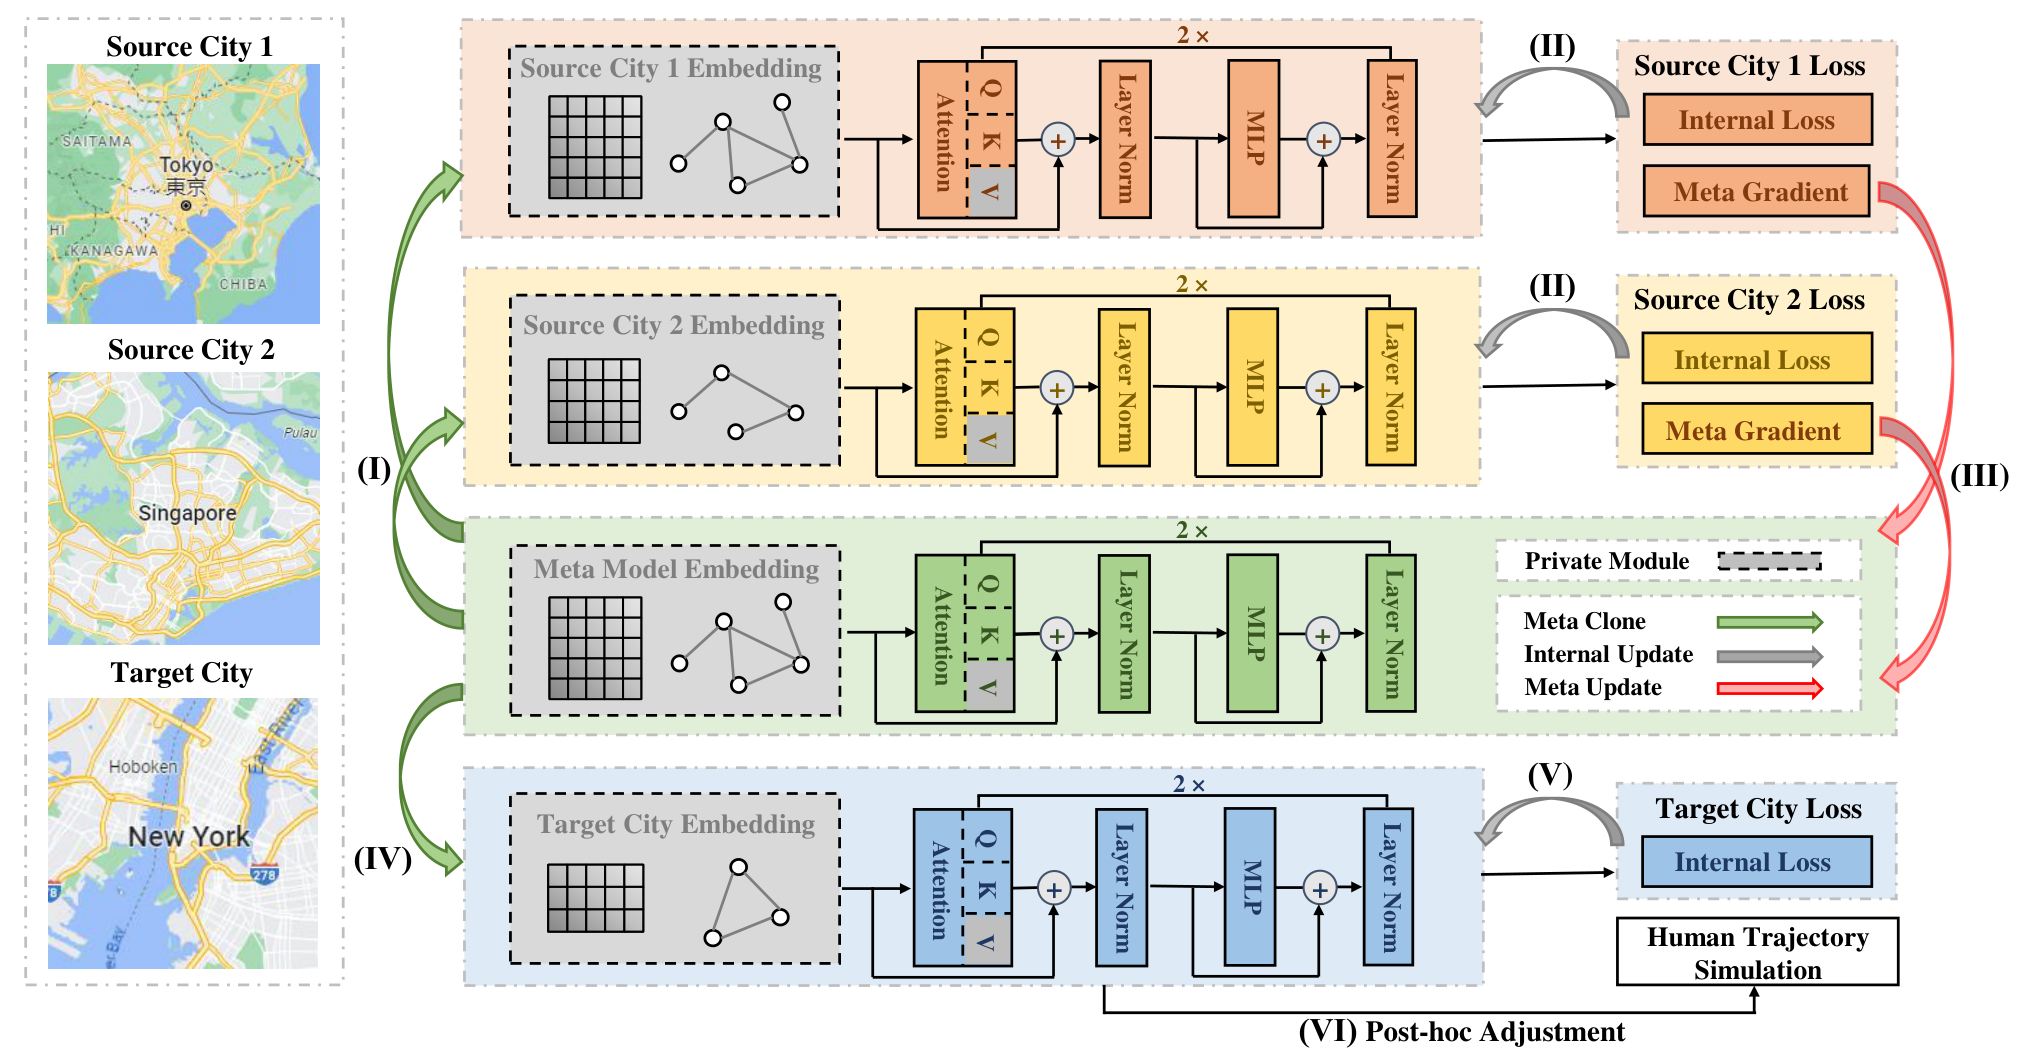
图 2|来源城市的知识怎样进入目标城市?
(I)共享参数从元模型复制到来源模型;(II)在来源城市做内部训练;(III)用来源城市的元梯度更新元模型;(IV)把更新后的共享参数复制到目标城市;(V)目标城市用本地数据训练;(VI)生成时进行事后概率调整。不同底色代表不同模型,虚线灰框表示城市私有模块,箭头颜色区分复制、内部更新与元更新。来源:原论文 Fig. 2。
不让热门地点挤掉所有偶发访问
只学序列仍可能过度偏爱热门地点。COLA在训练结束后的采样阶段做事后调整(post-hoc adjustment):地点i的新权重与“exp(模型输出分数i) ÷ πᵢ的τ次方”成正比,再对全部地点归一化。πᵢ是本地训练数据中地点i的经验访问频率,τ大于0,控制调整力度。
频繁地点的分母较大,相对受到惩罚;偶发地点获得更多被抽到的机会。这个操作没有要求所有地点等概率,也没有把其他城市的地点复制过来。论文在地点频率服从Zipf关系的假设下推导了成对概率比如何变化;这是条件推导,不能当作每组数据都严格服从该定律的证明。
四组数据,到底比较了什么?
数据包括主要位于北京的GeoLife GPS轨迹、日本Yahoo移动轨迹,以及纽约、新加坡的Foursquare签到。定位来源不一样,因此城市间差异同时可能含有采集渠道差异。
模型使用小时级时间单位,仅保留每天至少有6条访问记录的轨迹;Yahoo进一步选择10,000条高质量轨迹。表1报告的预处理后统计如下,不能用原始GeoLife的182名用户替代最终153名。
| 数据 | 用户数 | 地点数 | 访问记录数 | 日均步数 |
|---|---|---|---|---|
| GeoLife | 153 | 32,675 | 34,834 | 8.9 |
| Yahoo | 10,000 | 16,241 | 188,061 | 18.8 |
| 纽约 | 1,189 | 9,387 | 19,040 | 6.9 |
| 新加坡 | 1,461 | 11,509 | 38,522 | 7.0 |
每组数据按7∶1∶2分为训练、验证、测试集;每次选一组为目标,其他三组提供来源数据。论文报告这一划分比例,但没有在附录明确把它描述为严格跨用户或严格按时间向未来外推的测试。因此不能把结果称为对完全陌生人群或未来城市变化的直接验证。
比较对象包括Markov、IO-HMM、LSTM、DeepMove、GAN、SeqGAN、MoveSim、TrajGAIL、CGE、ACT-STD,以及直接采用Transformer的MobFormer;另外把LSTM与SeqGAN放入迁移框架,形成CrossLSTM和CrossSeqGAN。实验每项进行5次,部分最优结果标注配对t检验p<0.05。
六项指标均以Jensen–Shannon散度(JSD)衡量真实与生成分布差异,越小越好:Distance为相邻访问距离,Radius为围绕轨迹中心的回转半径,Duration为停留时长;DailyLoc在本文定义为每日独特地点数相对于轨迹长度的比例;G-rank比较全局访问排序中前100个地点,I-rank比较个人访问偏好排序。表2的AVG是平均名次,不是平均准确率。
总体赢了多少,哪里仍然没赢?
表2中COLA在24项指标上有21项第一、3项第二,四组数据的平均名次分别为1.2、1.0、1.0、1.5。例外是GeoLife的G-rank,MobFormer为0.0776,COLA为0.0780;新加坡的G-rank,CrossSeqGAN为0.0069,COLA为0.0141;新加坡的I-rank,TrajGAIL为0.0430,COLA为0.0534。
优势也有大小之别。Yahoo的Distance,COLA为0.0161,CrossLSTM为0.0223,差距较明显;纽约相同指标COLA为0.0263,MobFormer为0.0264,差距很小。不能把某个指标的相对改善推广为每种出行属性都同幅改善。
迁移本身也会失败:CrossLSTM通常优于单城LSTM,但CrossSeqGAN在Yahoo反而明显变差。共享更多数据不能代替合适的优化和模型结构。
表3的消融实验支持两个组件共同发挥作用。例如新加坡Distance从同时删除两者的0.0133降为完整COLA的0.0067。但Duration去掉半开放注意力时为0.0006,完整模型为0.0007,因此不能说每个组件对每项指标都有正贡献。GeoLife在表2和消融表3的完整模型数值略有不同,两个实验表不应混成同一次运行。
来源城市越多,就一定越好吗?
对GeoLife,所有来源一起用有助于Distance和I-rank,但Duration、DailyLoc等指标存在更好的子组合。图中不同组合的差距提示,来源适配和信息冲突仍需选择,不能只数来源城市的数量。作者关于经济发展、工作习惯和城市地理的解释属于可能原因,实验没有独立识别这些因素的因果作用。
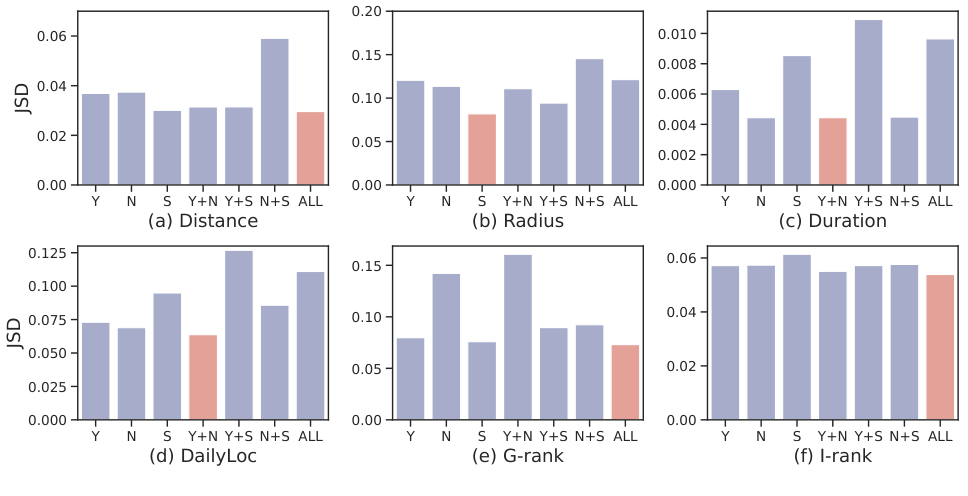
图 4|GeoLife从哪些城市借数据更合适?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank,纵轴均为JSD。横轴Y、N、S分别指Yahoo、纽约、新加坡,ALL为三者;红柱标出各面板的较优组合。全来源并未在所有面板最低,例如Radius以S较低,Duration与DailyLoc以Y+N较低。来源:原论文 Fig. 4。
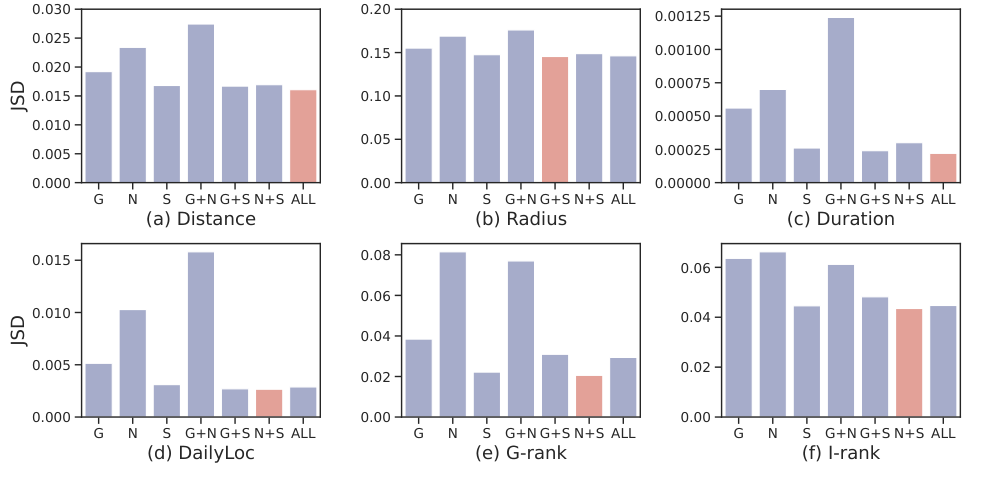
图 A1|以Yahoo为目标时,哪些组合更好?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank,纵轴为JSD;G、N、S为GeoLife、纽约、新加坡。ALL在Distance和Duration有优势,但G-rank、I-rank等仍存在更低的子组合。来源:原论文 Fig. A1。
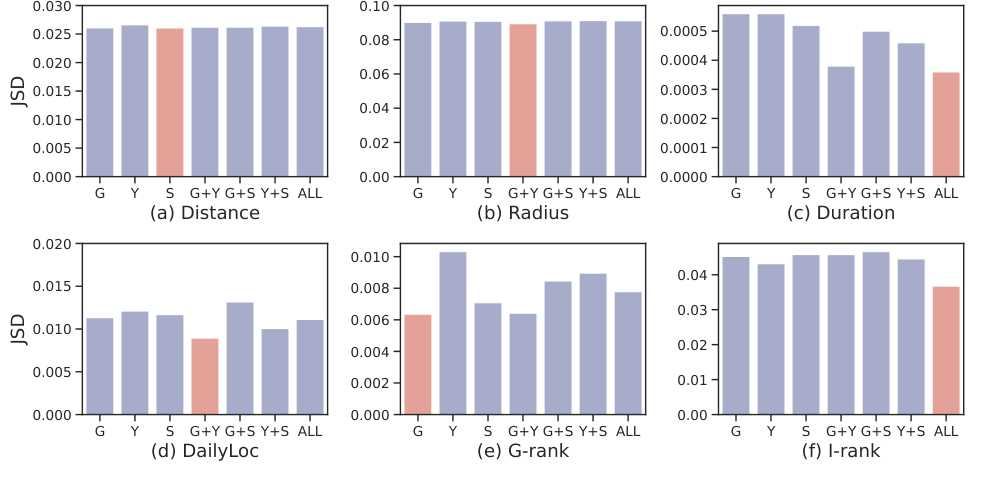
图 A2|纽约的来源选择是否也存在取舍?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank,纵轴为JSD;G、Y、S为GeoLife、Yahoo、新加坡。ALL的Duration和I-rank较低,S的Distance以及G的G-rank更低,不能给所有面板套用同一个最佳组合。来源:原论文 Fig. A2。
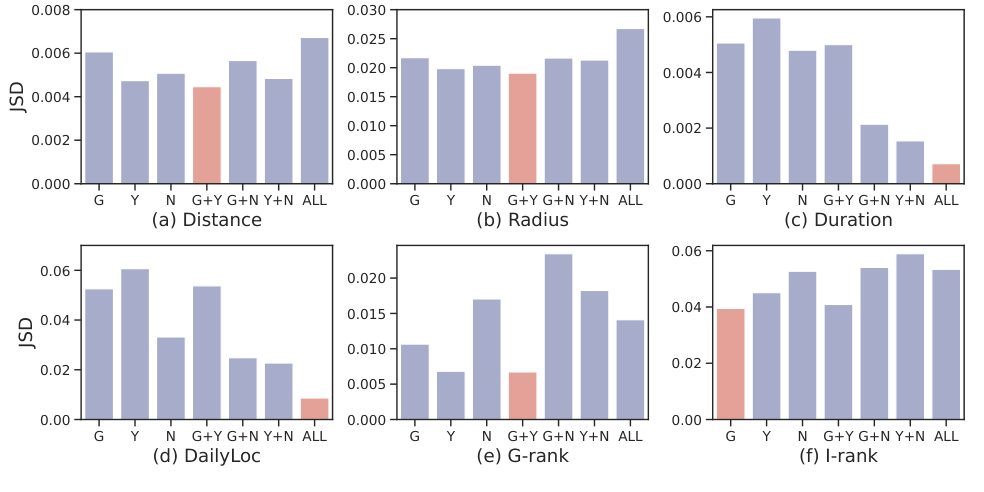
图 A3|新加坡需要所有来源城市吗?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank,纵轴为JSD;G、Y、N分别为GeoLife、Yahoo、纽约。ALL改善Duration与DailyLoc,而G+Y在Distance、Radius及G-rank更低,G在I-rank更低。来源:原论文 Fig. A3。
合成轨迹真的能帮助另一个任务吗?
论文用带注意力的LSTM做下一地点预测。第一种情形,只用500、1,000或1,500条真实或合成轨迹训练;第二种情形,在这些数量的真实轨迹上分别增加1,000条合成轨迹。纵轴是F1分数,越大越好。
GeoLife中COLA合成数据比同量真实记录训练的结果更好;Yahoo中合成数据更接近真实数据表现,并非总能超过它。作者把改善解释为合成数据突出规律、减少噪声,但实验并未单独测量和分解噪声来源。尤其图上F1绝对值仍低,不能把某些柱子的相对增长说成已经达到高精度定位预测。
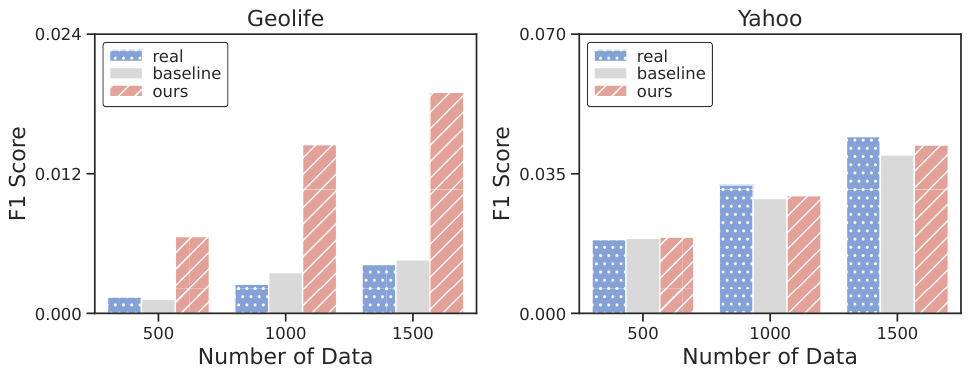
图 5|完全使用合成数据训练,下一地点预测表现如何?
左图GeoLife、右图Yahoo,没有字母子图;横轴为训练数据条数,纵轴F1。蓝色真实数据、灰色基线合成数据、红色COLA合成数据。GeoLife红柱更高;Yahoo在1,000和1,500条时仍低于真实数据。来源:原论文 Fig. 5。
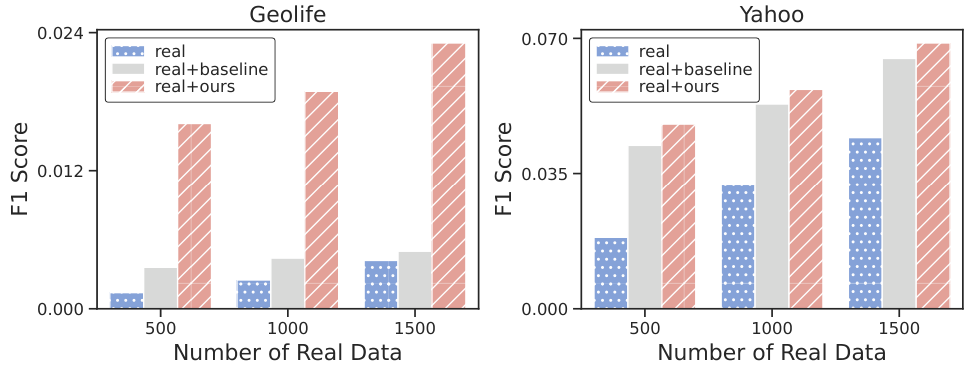
图 6|少量真实数据加上合成数据,能否提高预测表现?
左图GeoLife、右图Yahoo;横轴为真实轨迹数,每个增强组固定额外加入1,000条合成轨迹。蓝柱仅真实,灰柱真实加基线合成,红柱真实加COLA合成;两组数据中红柱均较高。来源:原论文 Fig. 6。
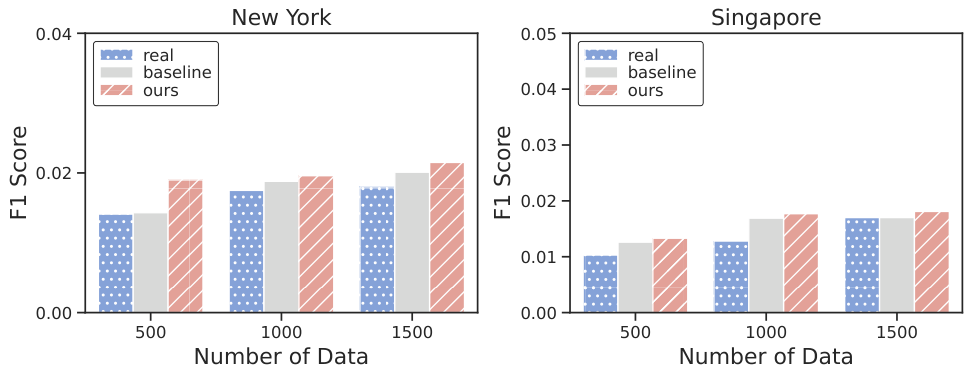
图 A4|纽约与新加坡的全合成训练能否重复上述用途?
左图纽约、右图新加坡;横轴训练数据条数,纵轴F1,颜色同图5。COLA的红柱总体高于真实数据和基线合成数据;这仍只是指定预测器与数据规模下的结果。来源:原论文 Fig. A4。
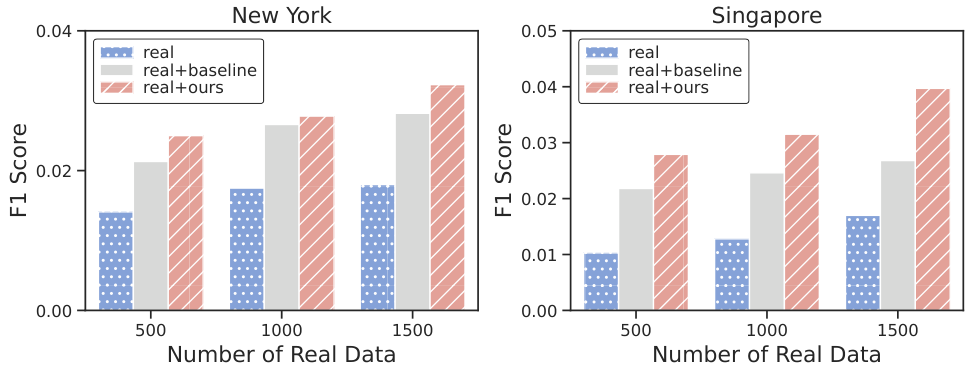
图 A5|纽约与新加坡的数据增强效果如何?
左图纽约、右图新加坡;横轴真实轨迹数,增强组仍各加1,000条合成数据,纵轴F1。红柱均高于仅真实与基线增强;增加合成数据的效用不等于生成轨迹逐条都真实。来源:原论文 Fig. A5。
附录表A1还用SEIR传播模型比较合成数据。COLA的暴露、感染、移出三类MAPE分别为0.4322、0.2332、0.1434,均低于表中LSTM、SeqGAN、MoveSim;例如MoveSim对应0.7518、0.6314、0.4540。这是设定传播模型下的模拟误差比较,附录只简述沿用既有研究的参数,不能据此宣称已经准确预测真实疫情。
调整力度需要因城市、因指标而变
投影层数在1、2、3之间,频率调整τ在0.001、0.01、0.1、0.25、0.5、1.0之间搜索。各面板并不指向一个共同最优值,例如GeoLife三层的Duration与DailyLoc较低,Distance却更高。参数实验说明存在取舍,而非任何参数都同样可靠。
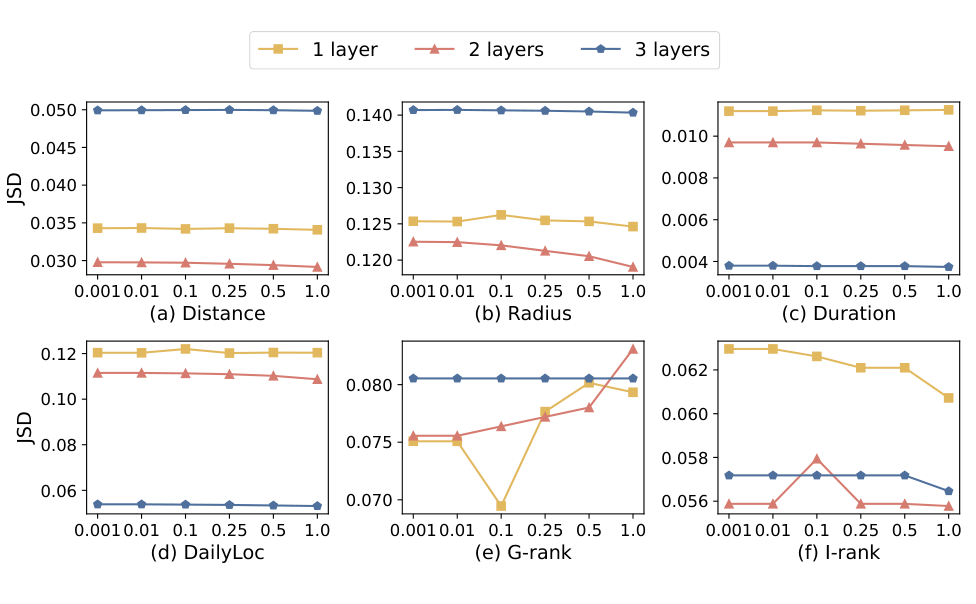
图 7|GeoLife对模型深度与τ有多敏感?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank,横轴τ,纵轴JSD;黄、红、蓝分别为1、2、3层。不同指标偏好的深度不一,G-rank随τ也非单调改善。来源:原论文 Fig. 7。
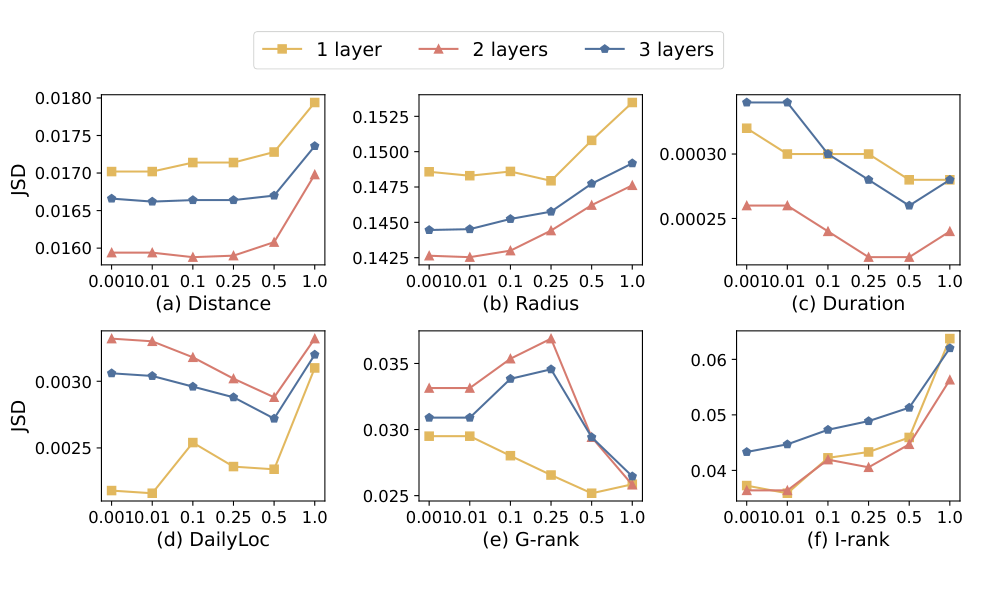
图 A6|Yahoo的参数取舍在哪里?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank;横轴τ、纵轴JSD,颜色同图7。两层在前两项较低,DailyLoc偏好一层;较大τ可能降低G-rank差异,却增大I-rank差异。来源:原论文 Fig. A6。
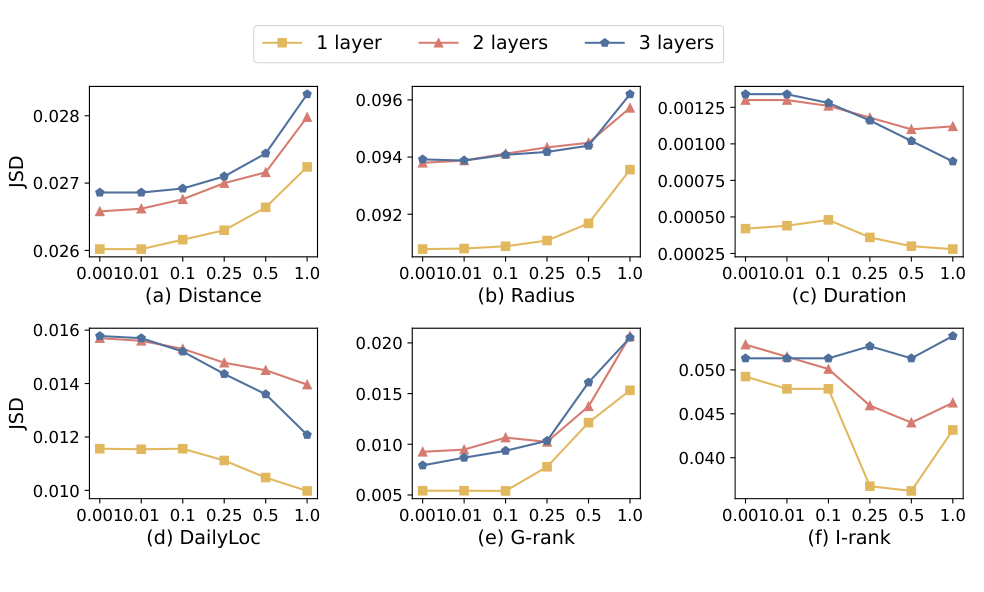
图 A7|纽约为什么不能照搬Yahoo的设置?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank;横轴τ、纵轴JSD,颜色同图7。一层在多项指标较低;提高τ对Duration与DailyLoc有利时,Distance与G-rank可能变差。来源:原论文 Fig. A7。
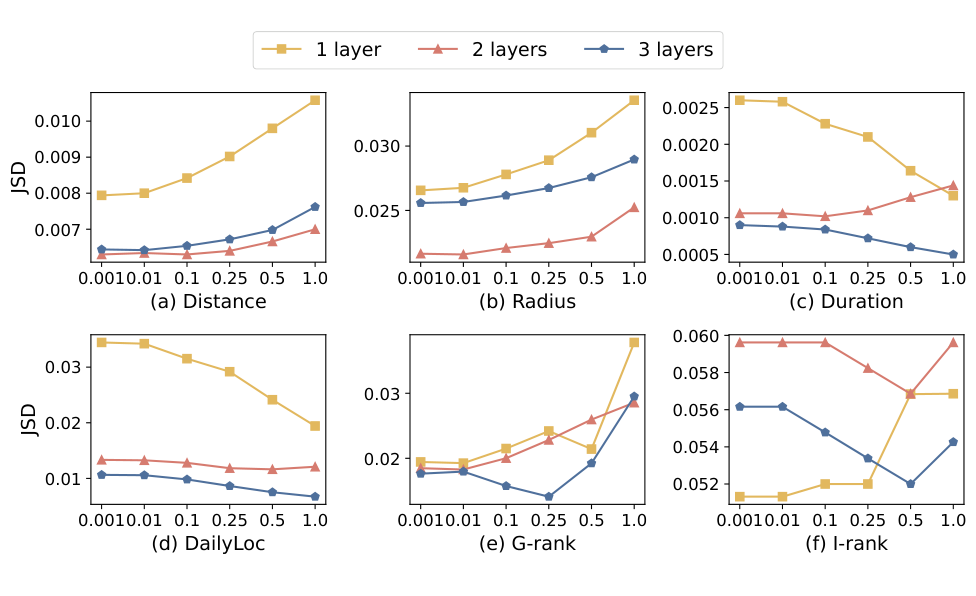
图 A8|新加坡更深的模型改善了哪些方面?
(a)Distance、(b)Radius、(c)Duration、(d)DailyLoc、(e)G-rank、(f)I-rank;横轴τ、纵轴JSD,颜色同图7。三层在Duration、DailyLoc及部分τ下的G-rank较低,但Distance、Radius多由两层占优,I-rank也存在浅层更低的区间。来源:原论文 Fig. A8。
注意力图能解释什么,不能解释什么?
附录按地点对的距离及时间间隔汇总平均注意力。时间上,GeoLife和纽约约1小时处有峰,日本和新加坡则以更近的记录为重;空间上各组表现并不相同。注意力分数属于训练好的模型内部权重,不能直接当作居民选择目的地时的心理权重,也不是跨城普适机制已经被证明。
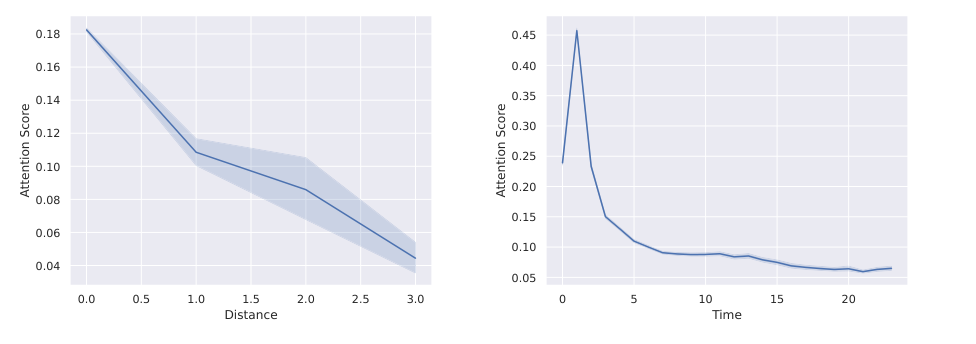
图 A9|GeoLife的模型更关注哪些历史记录?
左图横轴距离、右图横轴时间,附录说明单位分别为公里与小时,纵轴为平均注意力分数;没有字母子图。空间权重随距离下降,时间权重约1小时达到峰值后回落。阴影为原图所示波动带,图注没有明确其置信区间定义。来源:原论文 Fig. A9。
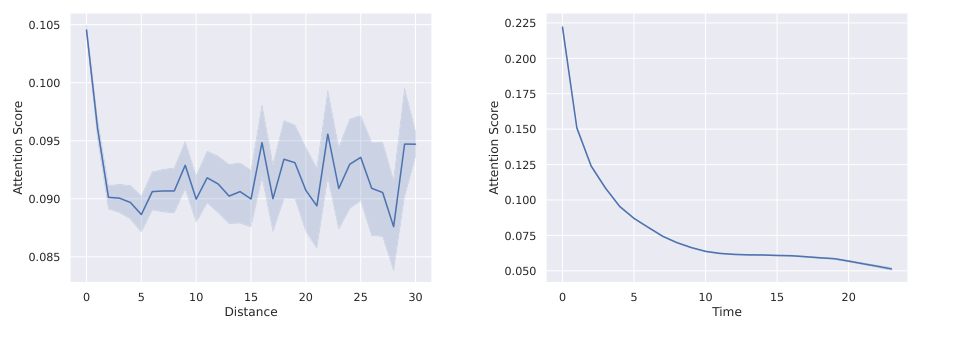
图 A10|日本轨迹也存在同样的空间衰减吗?
左图距离(公里)、右图时间(小时),纵轴平均注意力分数。空间权重在近零距离下降后,大体在较窄范围内起伏,不能说从头到尾持续下降;时间权重总体随间隔下降。来源:原论文 Fig. A10。
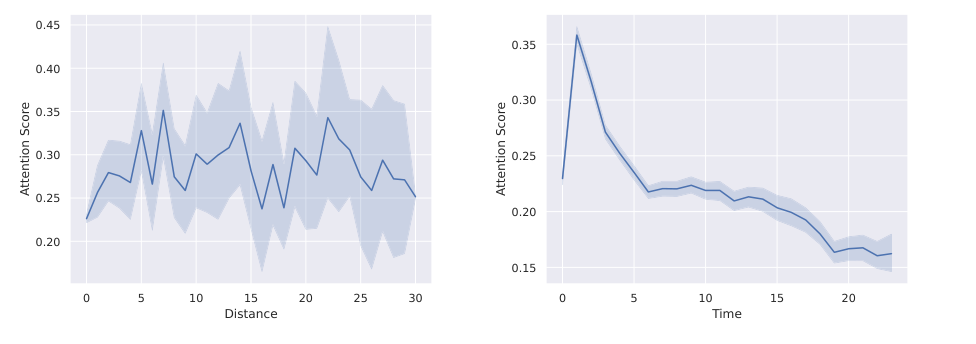
图 A11|纽约稀疏数据的注意力有多稳定?
左图距离(公里)、右图时间(小时),纵轴平均注意力分数。空间曲线明显起伏且阴影较宽;时间上约1小时峰值后总体下降。稀疏记录与这种形态同时出现,不构成稀疏性导致波动的独立因果检验。来源:原论文 Fig. A11。
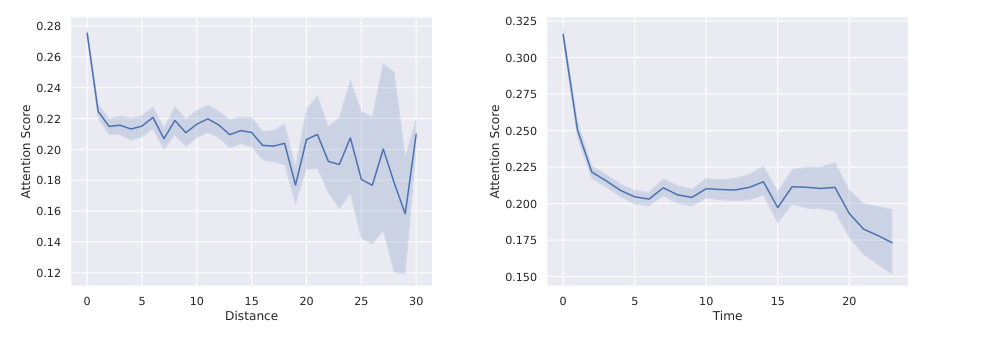
图 A12|新加坡的短程、近期记录获得多少注意?
左图距离(公里)、右图时间(小时),纵轴平均注意力分数。两图近零间隔权重较高,之后总体降低,但空间远端波动与阴影明显,不是平滑一致的规律。来源:原论文 Fig. A12。
这些检验支持将共享关联计算与本地地点表示分离,却仍留下三个实际边界。目标城市不能完全没有训练轨迹;现有四组数据不能代表所有城市与居民;保持六类统计分布及某项预测用途,并不保证保留罕见访问、群体公平或出行链的全部结构。
隐私也需要独立验证。COLA以生成数据替代直接分享真实轨迹作为应用动机,但没有差分隐私预算、成员推断或轨迹重识别实验。城市私有模块中的“私有”指参数不跨城共享,不能理解成已经得到隐私保护认证。
一句话总结
COLA通过共享历史位置关联的计算、保留本地地点表示,再校正热门地点偏好,让跨城数据帮助合成轨迹更接近本地分布;收益需要逐城市、逐指标验证,隐私安全仍需另做测试。
核心来源
- ACM正式论文与DOI,正文、附录A—E、图1—7与A1—A12、表1—3与A1;本文图像均来自该论文。
- 作者预印本。
- 作者官方代码仓库,提供训练、采样入口及环境说明。
作者介绍
以下身份依据论文署名,不延伸为作者现任职位。
- Yu Wang:署名浙江大学,杭州。
- Tongya Zheng:署名浙江大学与杭州城市大学,为本文通讯作者。
- Yuxuan Liang:署名香港科技大学(广州)。
- Shunyu Liu:署名浙江大学,杭州。
- Mingli Song:署名浙江大学与浙江大学上海高等研究院。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
跨城共享的下一步可以从“共享多少参数”转向“什么情况下不该共享”。例如先在目标城市验证集上评估各来源对六类指标的影响,只在确有收益时增加来源;若来源改善热门地点分布,却破坏稀有访问,就保留部分共享、降低其他部分权重。图4与附录A1—A3中不同指标偏好不同组合,为这种有条件迁移提供了具体问题。
还可以把效用、代表性、泄漏风险分开评估。同样的JSD和F1,可能对应不同程度的轨迹记忆;同样的总体分布,也可能掩盖少数居民的出行被抹平。因此在相近预测效用下比较成员推断、罕见地点覆盖与不同人群误差,会比只争夺平均名次更接近真实数据共享需要。