熟悉的路线之外,怎样猜到一个人会去的新地方?
论文名片|Yingzi Wang、Nicholas Jing Yuan、Defu Lian、Linli Xu、Xing Xie、Enhong Chen、Yong Rui,Regularity and Conformity: Location Prediction Using Heterogeneous Mobility Data,KDD 2015,1275—1284。DOI。
一个人常去家附近的咖啡馆,历史记录容易给出候选。但假期第一次去一家从未签到过的餐馆,个人访问次数就失去了直接线索。类似用户爱去哪里,以及这家餐馆通常吸引哪些区域的人,能不能补上这一段信息?
RCH 同时利用个人规律、协同偏好和多种交通数据学习的地点画像,在北京微博签到上进行验证。它的结果尤其提醒我们:整体位置容易预测,与第一次到访的地点容易预测,是两个不同问题。
先说结论
- 主要目标是预测用户在给定时段会签到的地点,样本为 161,794 名用户、7,355,962 条签到,不是连续观测每个人的全天移动。
- 模型结合个人活动枢纽与时变协同过滤;公交、出租车和签到提供不同的区域联系,帮助学习目的地的空间影响。
- 完整模型整体优于多种个人模型和两阶段探索模型,但实验使用六折交叉验证,不能直接当作严格按未来时间留出的预测成绩。
- 工作日总体更容易预测;只看未到访地点时,假日反而较好。即便给出前 60 个候选,新地点命中率仍远低于已到访地点。
一种数据负责预测,另外两种数据怎样帮忙?
微博数据覆盖 2011 年 3 月至 2013 年 9 月的北京签到。原始抓取约 1,213 万条记录,筛去总签到少于 15 条的用户后,保留约 735.6 万条、118,534 个地点。每名保留用户平均只有约 45 条签到、20 个到访地点,数据仍然稀疏。
| 数据 | 论文使用规模及时间 | 在模型中的角色 |
|---|---|---|
| 微博签到 | 161,794 用户、7,355,962 条;2011 年 3 月—2013 年 9 月 | 学习用户偏好并作为预测目标,也学习区域联系 |
| 公交记录 | 约 300 万次乘车;2012 年 8 月—2013 年 5 月 | 学习区域间交通联系与地点画像 |
| 出租车轨迹 | 约 1,940 万次起讫转换;2011 年 3—8 月 | 提供另一种交通方式的区域联系 |
三者时间范围和覆盖人群不同。融合发生在区域与地点联系层面,不要求把同一个人的公交卡、出租车和微博账号逐一匹配。它也不能恢复签到用户所有未记录的旅行。
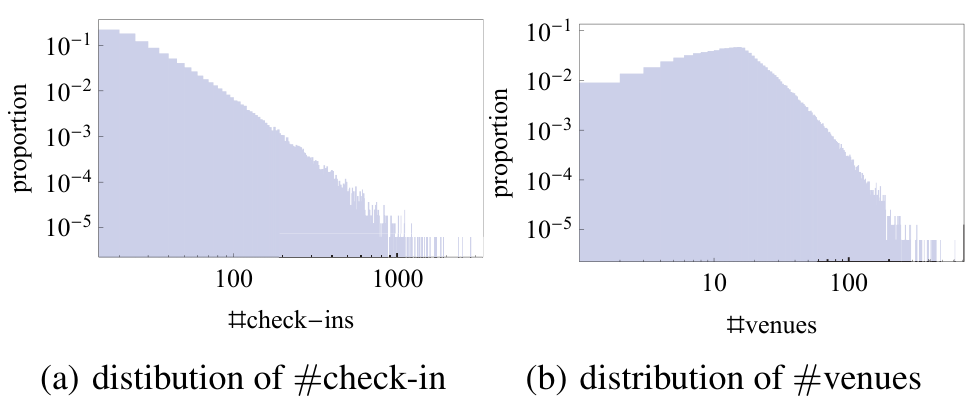
图 4|有很多签到,就意味着每个人都有足够历史吗?(a)每人签到数;(b)每人到访地点数,横纵轴均使用对数尺度,纵轴为比例。长尾表明少数用户数据丰富,多数用户记录较少,所以仅靠个人复杂模型可能难以稳定估计。来源:原论文 Fig. 4。
研究把工作日和假日分开,每天再分为六个四小时时段,总计 12 类时间情境。给定用户与时段,模型对候选地点打分并排序,目标是时段内的地点偏好,而不是利用最近一段道路轨迹预测车辆转弯。
规律不是只记住一个家和一个工作地
个人可能围绕几个主要枢纽活动,再去附近餐馆、商店或健身房等次级枢纽。RCH 将城市划成网格,用个人在各时段的枢纽权重,与候选地点对这些网格的空间影响结合。
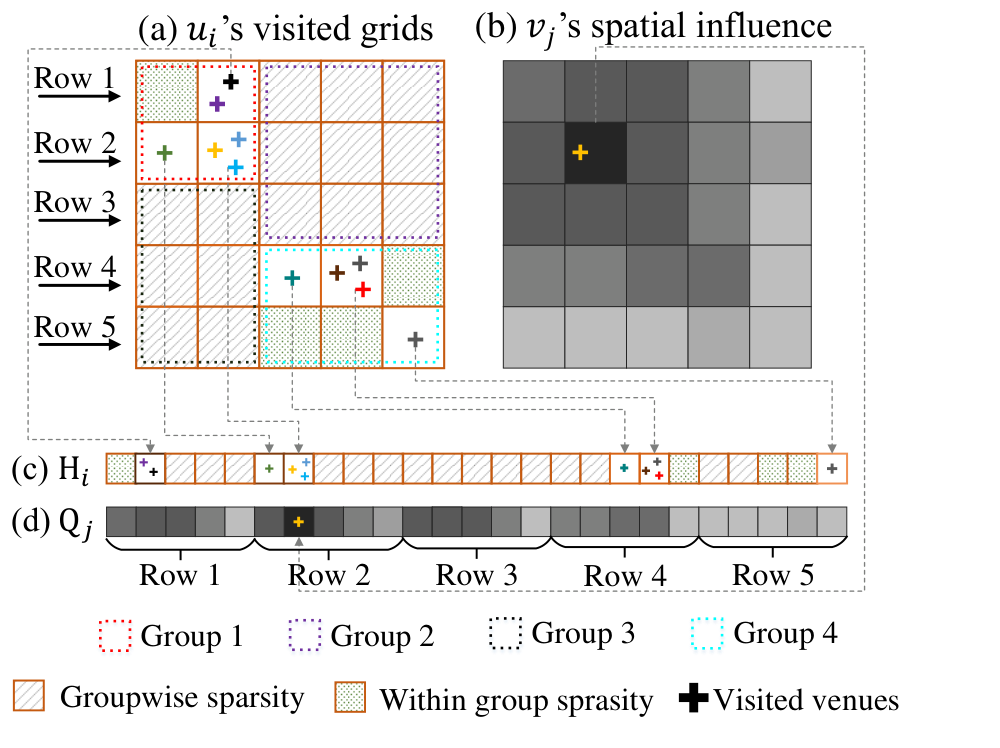
图 1|个人去过哪里,与地点能吸引哪里的人,怎样相乘?(a)个人访问过的网格及其分组;(b)某个地点对不同网格的空间影响;(c)将个人网格记录展开成枢纽向量 H;(d)将地点影响展开成 Q。彩色虚线表示网格组,斜线与点状填充分别示意组间及组内稀疏。完整原图保留全部图例。来源:原论文 Fig. 1。
模型通过稀疏组 Lasso 约束,只保留少数活跃区域组,并在每组内只保留少数活跃网格。这对应两层规律:个人不是均匀分布于全城,也不是在常去区域内每格都同样活跃。
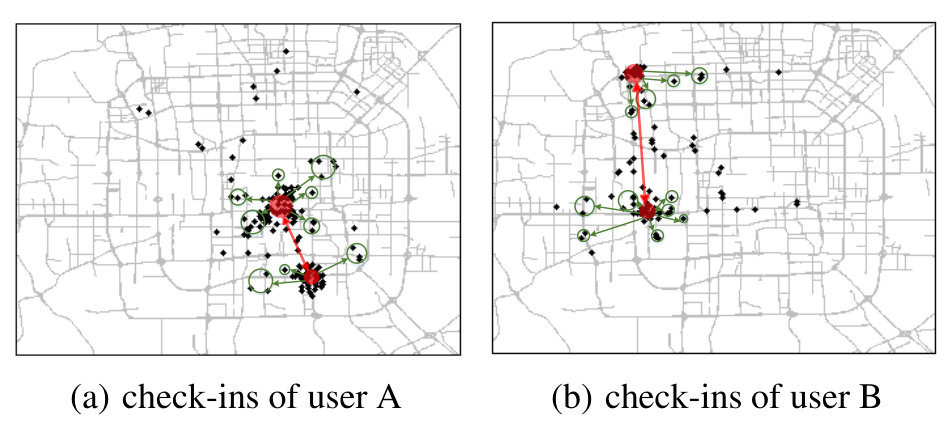
图 2|主要和次要枢纽在真实签到里是什么样?(a、b)分别展示两名用户,黑点为签到位置,红圈强调主要枢纽、绿圈强调次级枢纽。两个人都有集聚,但具体位置和形状不同;这只是示例,不能直接给每个红圈赋予家或工作地的已核实语义。来源:原论文 Fig. 2。
另一项是时变协同过滤:用户与地点都有潜在向量,用户偏好再拆成稳定部分与随时段变化的部分。类似用户在特定时段爱去的地点,可以帮助给个人尚未访问的候选打分。
论文将这项命名为从众(conformity),并以社会心理理论解释,但数据没有直接观测推荐、模仿或朋友影响。它在模型中首先是一项协同预测结构;预测有效不能单独证明某次签到由从众心理造成。
公交和出租车,为什么不只是增加几条记录?
模型用引力关系估计网格间联系:流量由出发量、到达量及距离衰减共同决定,参数按不同数据源拟合,再得到归一化转换矩阵。结合地点在所在网格中的到访分布,构成该地点对其他网格的影响。
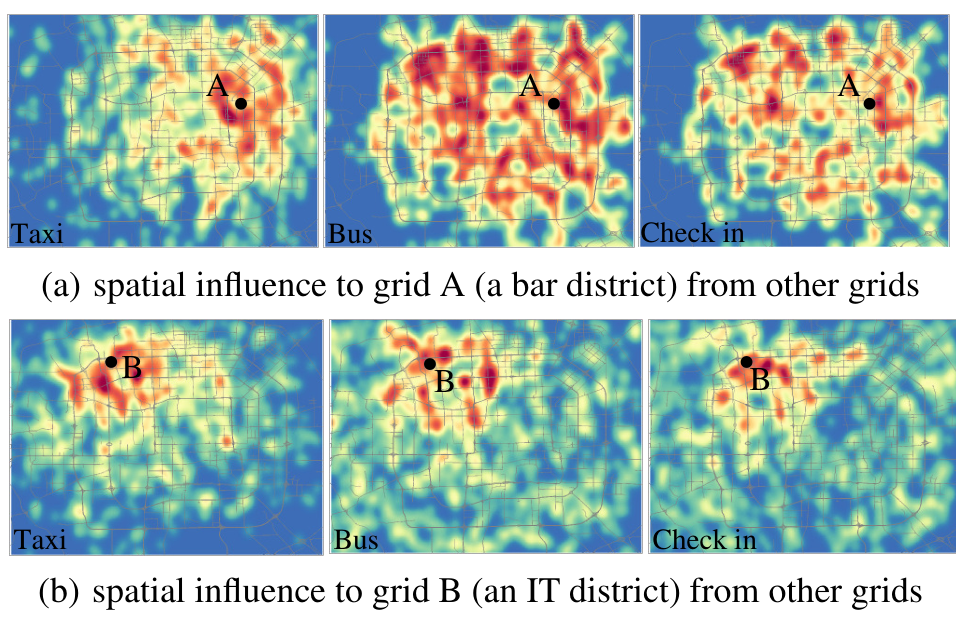
图 3|同一个目的地,在不同交通方式中有同样的联系吗?(a)三里屯酒吧区域 A;(b)中关村 IT 区域 B。每行依次为出租车、公交、签到估计的空间影响,暖色表示图中较强的相对联系,冷色较弱。A 的模式差异较明显,B 更相近;原图没有统一数值色标,不能据颜色读出精确流量。来源:原论文 Fig. 3。
公交和出租车较难反映非常短距离或网格内部移动,签到可补充部分这样的联系;交通方式本身又选择了不同的人群与活动。多源因此提供互补,而不是任何一种都等同于全人口真值。
这些转换关系还用于学习城市网格的功能分组,为前面的组稀疏结构提供基础。规律项、协同项与各数据源权重在共同目标下交替优化。作者另给的一页技术附录推导了组稀疏与组内稀疏更新,并非额外一组预测实验。
评价看前多少个候选,必须先说清楚
Acc@topP 是真实签到地点落在前 P 个候选中的比例。P=60 的成绩不能当作只猜一个地点的准确率。另一个指标为平均百分位排名 APR,按本文定义,真实地点排第一时取 1,排名越靠后越低,越高越好;它与命中率不是同一个量。
对照包括按时段选择个人最常去地点的 MF、周期高斯混合模型 PMM、时空主题模型 W3,以及先判定常去或新探索、再分别预测的 CEPR。W3 是去掉文字内容的 W4 版本,因为这里没有相应推文文本。
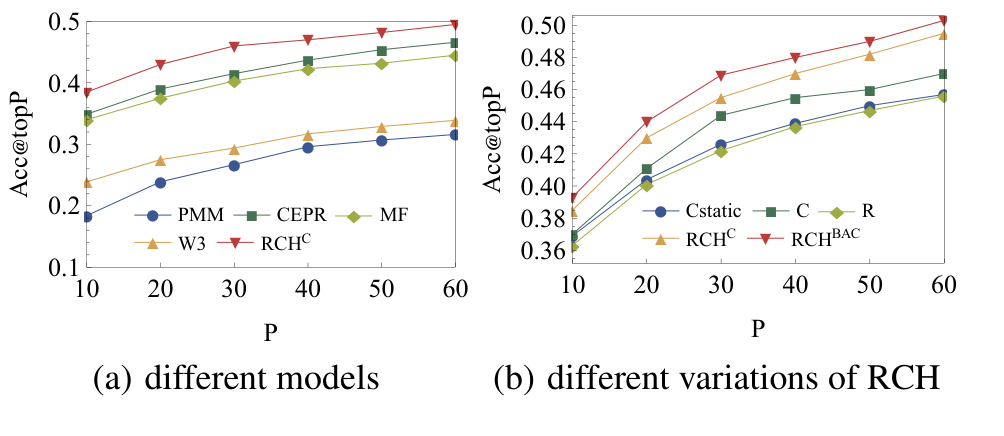
图 5|组合两种线索,比单独用一种更好吗?(a)只用签到的 RCH 与四个基线比较;(b)比较静态协同 Cstatic、时变协同 C、仅规律 R、签到版 RCH,以及三源完整 RCH。横轴均为候选数 P,纵轴为命中率,前者与后者纵轴范围不同。三源版整体较好,组合也优于主要单项变体。来源:原论文 Fig. 5。
P=10 时,论文报告签到版 RCH 与 CEPR 相对 MF 的改善分别约为 13.3% 和 2.6%,这些是相对改善,不能写成增加 13.3 个百分点。P=50 时,签到版组合相对时变协同与静态协同分别改善约 6.5% 和 8.9%。
公交和出租车加入之后还有增益,但不宜把正文的“33%”读成准确率整体上升 33%:原文比较的是相对 C 模型的增益幅度。用 Table 3 更直观地看,三源版相对签到版在 12 个时段的 APR 增量约为 0—0.009;例如假日零点至四点从 0.881 到 0.890,工作日中午至下午四点均为 0.835。
这些比较说明不同线索能互补,尚不能单凭各变体得分估计真实生活中有多大比例的行动属于规律、又有多大比例属于从众。
为什么工作日总体较准,新地点却是假日较准?
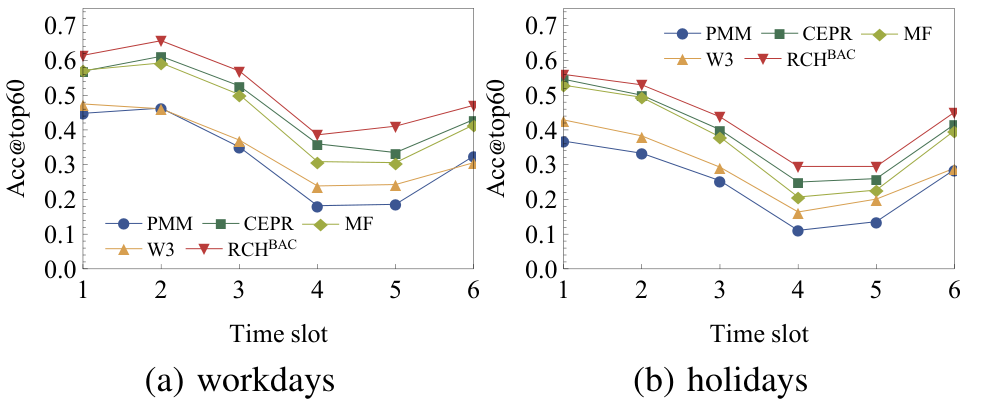
图 6|可预测性随一天改变吗?(a)工作日;(b)假日。横轴 1—6 依次为 00—04、04—08、08—12、12—16、16—20、20—24 时,纵轴为前 60 候选命中率。早间较高,下午较低,完整 RCH 整体优于图中对照。两类日期属于论文的分组,不是独立干预。来源:原论文 Fig. 6。
Table 3 的 APR 也呈现类似日内变化。例如完整模型在工作日 04—08 时为 0.912,12—16 时为 0.835;假日相应为 0.863 和 0.786。这些数值表示排名质量,不是 91.2% 或 83.5% 的地点被准确命中。
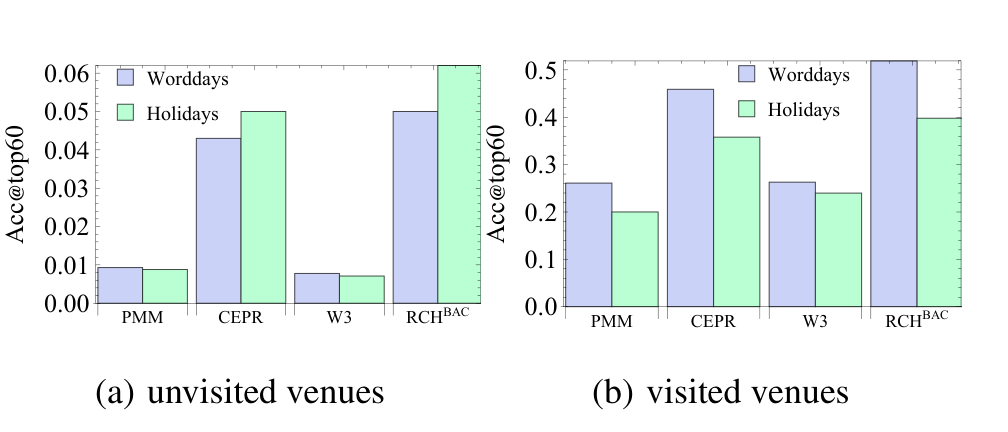
图 9|以前没去过的地方,是否同样容易预测?(a)未到访地点;(b)已到访地点,依原面板标题说明;正文一处把 a、b 顺序写反。纵轴均为 Acc@top60,但左图量级约为 0.01—0.06,右图明显更高,不能混用刻度比较。蓝紫色为工作日、浅绿色为假日。来源:原论文 Fig. 9。
只看未到访地点,协同方法比个人模型更有优势;完整 RCH 在假日相对 CEPR 报告约 24% 的相对提高。但新地点即使允许前 60 个候选,命中仍只是较低的百分比,远低于已到访地点。
工作日的熟悉地点规律更强,可以提高整体成绩;假日的新地点访问可能更符合相似用户的共同选择。这是作者对观察的解释,没有直接隔离日历变化、签到选择和真实心理影响,因而仍是待进一步检验的行为机制。
参数选择告诉我们,这不是无条件的组合收益
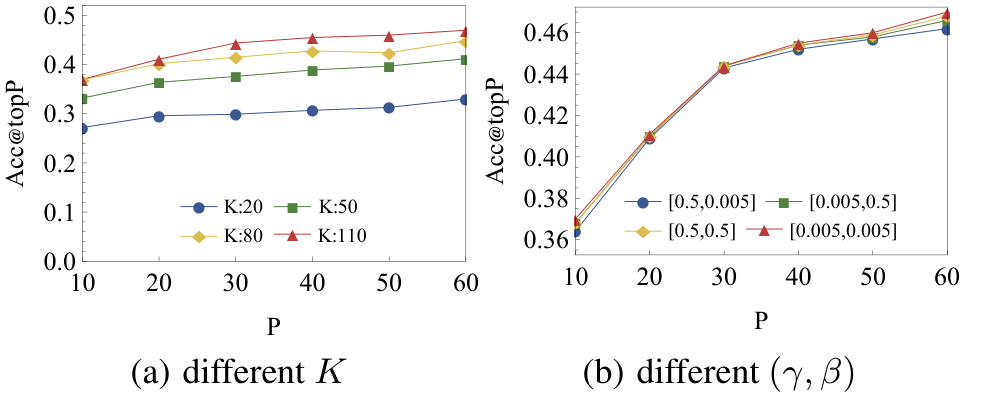
图 7|协同偏好表示需要多大容量?(a)改变潜在向量维度 K;(b)改变稳定与时变向量的正则化参数 γ、β。两图横轴为候选数 P,纵轴为 Acc@topP,颜色区分参数设置。较大的 K 在所测范围整体更好,但收益逐渐减缓;所测 γ、β 组合的曲线差别较小。来源:原论文 Fig. 7。
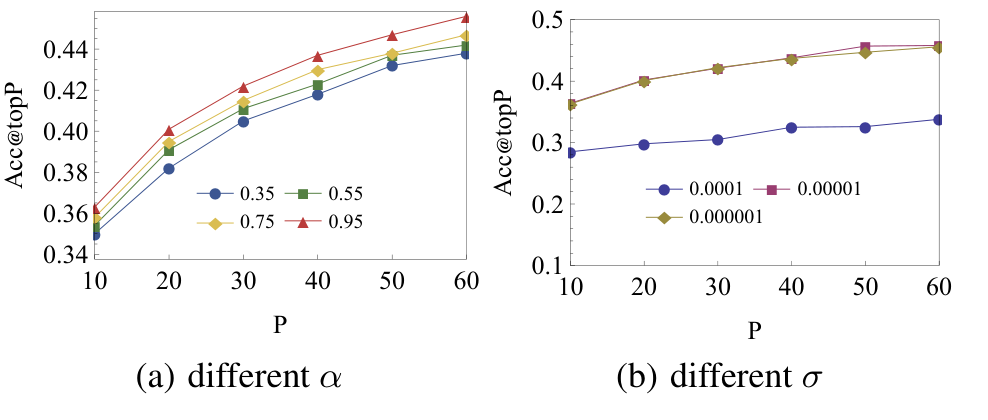
图 8|个人活动区域的稀疏约束有多强才合适?(a)改变 α,即组内稀疏在正则化中的占比;(b)改变正则化总强度 σ。横轴均为候选数,纵轴为命中率。较大 α 在该范围略有改善;σ=10⁻⁴ 明显弱于较小值。这里 α 不是规律项与协同项的混合权重。来源:原论文 Fig. 8。
实验采用六折交叉验证,并分别调节参数。文章没有将其说明为严格按日期前推的测试,也没有验证不同城市、不同交通数据年代对地点画像的影响。公交和出租车样本还具有出行方式选择性,因此三源模型的提升不能自动视为已经校正了签到人群的代表性偏差。
一句话总结
把个人常去区域、相似用户的时变偏好和多源地点联系一起学习,能改善稀疏签到预测,但新地点仍难猜,模型中的从众也不等于被证明的心理因果。
核心来源
Yingzi Wang, Nicholas Jing Yuan, Defu Lian, Linli Xu, Xing Xie, Enhong Chen, Yong Rui. Regularity and Conformity: Location Prediction Using Heterogeneous Mobility Data. KDD 2015, 1275–1284。DOI,微软研究院公开论文。本文依据原论文及其技术附录,Fig. 1—9 均保留原组合图;各表与方法在相应段落说明。
作者介绍
- Yingzi Wang:论文署名为中国科学技术大学计算机科学学院与微软研究院。
- Nicholas Jing Yuan:论文署名为微软研究院。
- Defu Lian:论文署名为电子科技大学大数据研究中心。
- Linli Xu:论文署名为中国科学技术大学计算机科学学院。
- Xing Xie:论文署名为微软研究院。
- Enhong Chen:论文署名为中国科学技术大学计算机科学学院。
- Yong Rui:论文署名为微软研究院。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若预测系统主要服务探索新地点的用户,整体命中率可能掩盖真正的短板。可以把每个用户的熟悉地点与首次到访分开报告,再比较相同候选长度下的收益,避免一个只会重复推荐旧地点的系统获得漂亮总分。
多源地点画像也值得按时间验证:只用预测日前已经存在的公交、出租车与签到记录建立画像,再比较近期与较旧画像。若旧画像依旧有效,说明它捕捉到较稳定的城市联系;若变化很大,则需要把城市功能和交通供给的更新纳入模型。