一家只去过一次的新店,为什么很快又会想去?
论文名片|Hugo Barbosa、Fernando B de Lima-Neto、Alexandre Evsukoff、Ronaldo Menezes,The effect of recency to human mobility,EPJ Data Science 4,21,2015 年 12 月 17 日发表。DOI。本文结合正式论文与官方五页补充材料解读。
假设你最常去的地方是家和公司,昨天却刚发现一家不错的面馆。若只统计半年里去过多少次,面馆几乎排不上号;可要猜下一次午饭去哪里,它未必是可以忽略的选项。
“去得多,所以以后还会去”解释了稳定习惯,却不一定解释一个新地点如何进入习惯。这篇论文把长期访问频率与最近访问顺序分开测量,在两种移动数据中寻找后一种偏好,再把它加入个体移动模型。
主要发现有四点:
- 常去地点与最近去过的地点都更容易被回访,但两个排序相似并不表示它们是同一种统计量。
- 打乱每个人的访问顺序、保留各地点总访问次数后,近期地点的额外回访倾向减弱,说明频率本身不足以解释全部顺序结构。
- 近期效应主要集中在很靠前的近期排名,大约最近四五个位置的范围;这里的尺度按移动序列衡量,不能换成固定几天。
- 混合频率偏好与近期偏好的模型能更好重现短程回访结构,但论文没有验证下一地点预测准确率的实际提升,也没有证明心理记忆是唯一原因。
老地点越去越多,新地点还有机会吗?
探索与优先返回模型(EPR)把每一步移动分成两类:发现新地点,或回到去过的地点。返回时,既往访问越多的地点越容易被选中。这种累积优势能解释少数地点占据多数访问的重尾分布。
问题在于,累计次数会给早发现的地点很大优势。若一个人搬家、换工作,或者发现一家新店,他的实际生活中心可能迅速改变,累计频率却反应迟缓。作者因此提出:返回既受“过去总共去过多少次”影响,也可能受“最近是否刚去过”影响。
两个机制天然相关:一个很常去的地点通常也不会离上次访问太久。所以,看到人们频繁回到刚去过的地方,还不能证明存在独立的近期偏好。研究必须找到能把两者分开的比较。
两套轨迹怎样变成可以比较的排名?
研究使用两套性质不同的观察数据:
| 数据 | 规模与范围 | 位置意味着什么 |
|---|---|---|
| D1 | 巴西一个大都市区,2014 年 1 月 1 日至 6 月 30 日,30,000 名用户、8,898,108 条手机记录 | 与手机通信的基站,近似反映用户位置 |
| D2 | 全球 Brightkite 用户,51,406 人、23,736,435 条签到、772,966 个地点 | 用户主动签到的具体地点 |
上述是论文报告的数据集规模,不能当作每一个后续分析都使用了同样数量的有效回访。补充表 A1 用于比较两个排名分布的样本量分别是 564,228 和 2,267,116。
预处理先把连续停留在同一地点的记录合并。例如,A→B→B→B→C→C→A→A→A→B 变成 A→B→C→A→B。否则在一个地方连续使用手机,就会被误读成一再“返回”最近地点。D1 中相距不足 10 米的基站也被合并,以减少共址天线引起的假位移。
随后,在每一次真正回访发生之前,仅用截至当时的历史,为目标地点排两个名次:
- 频率排名 Kf:累计访问次数最多的地点排第 1,其次排第 2。
- 近期排名 Ks:上一次去过的地点排第 1,按各地点最近一次出现的先后向后排序。
这不是用整段轨迹结束后的信息倒推当时的选择,也不是按相距多少公里排名。它有意忽略钟表时间,观察的是地点访问的顺序。两个地方即使相隔一天或一个月,也可能具有相同的近期排名。
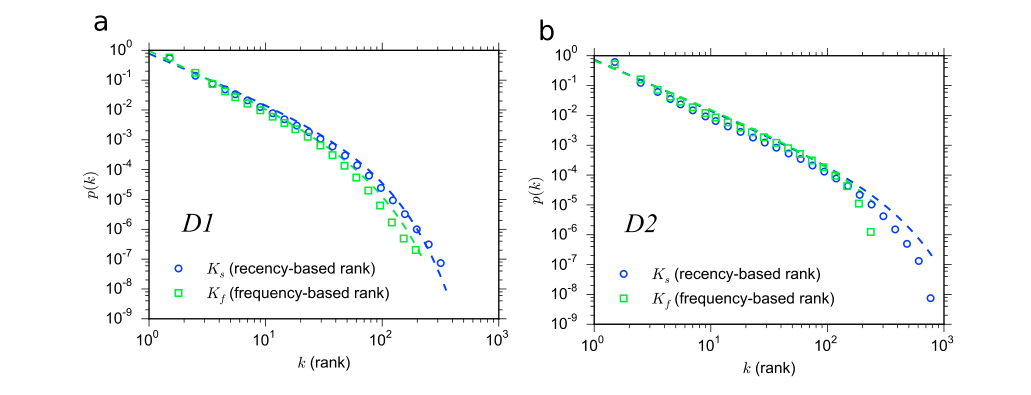
图 1|频率与近期排名,看起来有多像?a 为手机数据 D1,b 为签到数据 D2。横轴是排名,纵轴是回访概率,均采用对数刻度;蓝色圆点为近期排名,绿色方块为频率排名,虚线为截断幂律拟合。两类曲线都表明:靠前的地点很常被选中,靠后的地点迅速变少。形状接近是研究的起点,还不能说明两种机制可以互相替代。
补充材料使用双侧两样本 Kolmogorov–Smirnov(KS)检验:D1 的分布距离为 0.07999,D2 为 0.09708,均高于文中显著性水平 0.001 对应的临界值 0.00367、0.00183,因此拒绝两排名来自同一分布的假设。大样本使微小差异也容易显著;下面仍要看差异具体出在哪里。
只看一条曲线,会漏掉哪种回访?
作者把一次回访同时放到 Kf 与 Ks 构成的二维空间里。一个地点可以既常去又刚去过,也可以很少去、但刚刚去过。后一类尤其有助于区分两种解释。
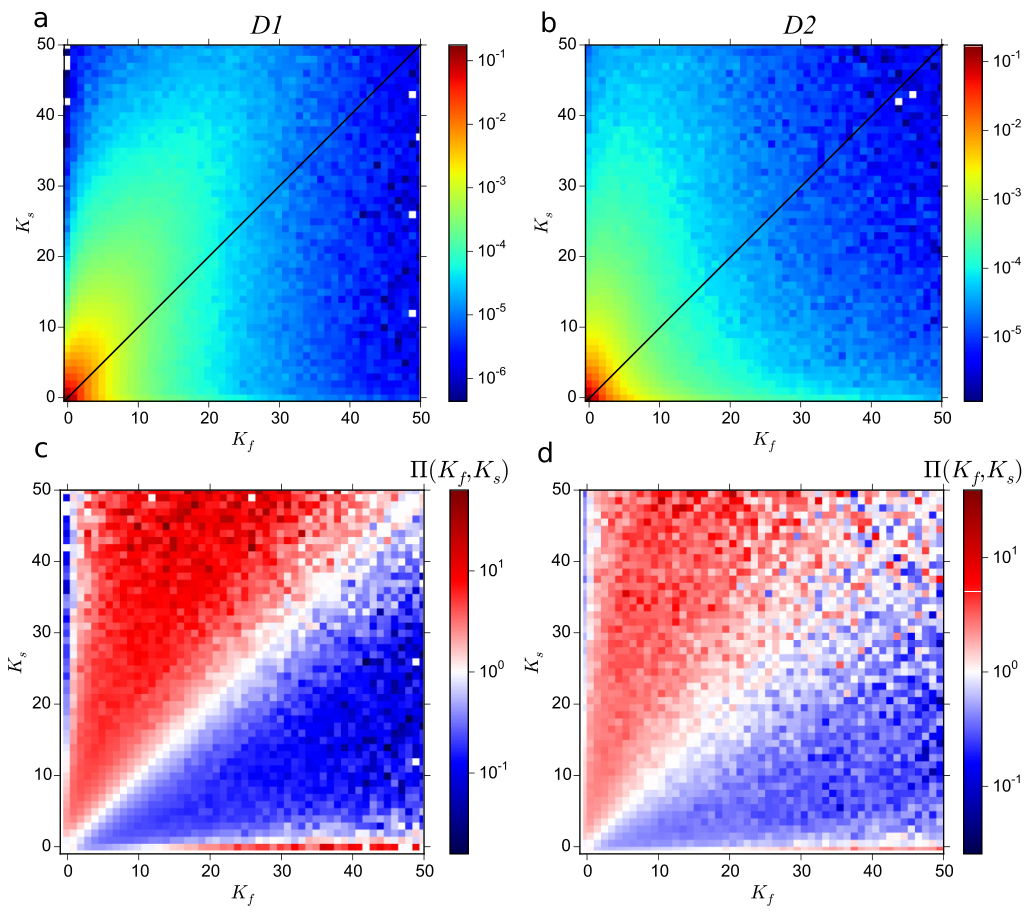
图 2|近期偏好藏在二维分布的什么位置?a、b 分别为 D1、D2 的联合回访分布,颜色越暖,回访越集中。原图把排名平移到从 0 开始,因此图上的 0 对应实际第 1 名。纵轴较低、横轴仍展开的区域,代表近期去过、但累计频率未必靠前的地点。c、d 进一步比较互换频率排名与近期排名后的条件概率比;大于 1 的红色区域与小于 1 的蓝色区域揭示两种维度的不对称。下排纵轴实际标为 Kf、横轴为 Ks,应按原轴读图。
手机数据的整体形状更容易被高频地点主导;签到数据中,低近期排名对应更宽的频率排名范围,近期结构更突出。研究的关键并非否认家、公司等常去地点的重要性,而是指出仅靠长期频率,会漏掉那些暂时还没积累出很多访问次数的新近地点。
接下来,作者问了一个更直观的问题:返回不同频率排名的地点之前,通常会经过多少其他地点?
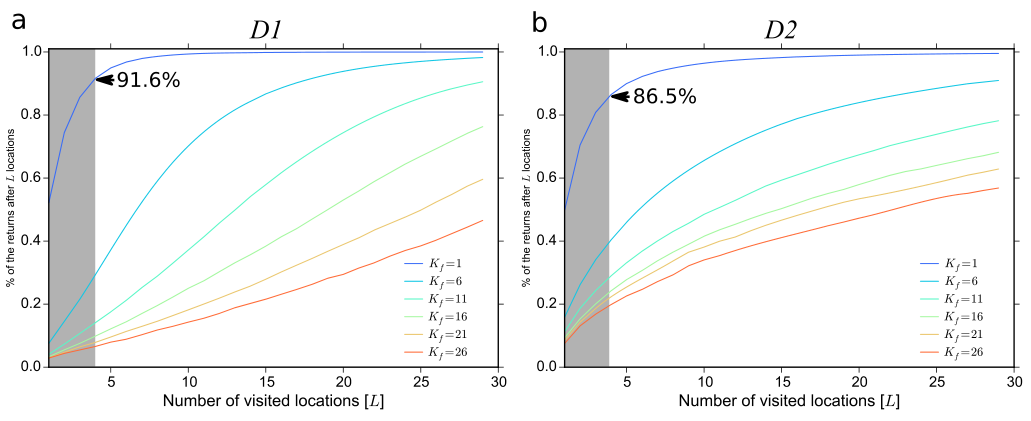
图 3|常去地点的返回通常有多快?a 是 D1,b 是 D2。横轴 L 为两次访问之间经过的不同地点数,纵轴为在该范围内已发生的回访比例;不同颜色对应 Kf=1、6、11、16、21、26。深蓝线是最常去地点,图中标出的累计比例分别为 91.6% 与 86.5%,对应中间经过四个或更少地点的范围。越不常去的地点,曲线上升通常越慢。
这些比例的分母是相应频率排名地点的回访事件,不能解释成“91.6% 的人四天内回家”。而且,常去地点自然间隔更短,这张图本身仍不能排除频率造成的近期表象。真正有辨别力的下一步,是保留频率、拆掉原来的顺序。
把轨迹打乱,近期效应还在吗?
论文设置了三层随机化对照。R1 在每个人内部均匀打乱轨迹,保留每个地点的总访问次数;R2 为每个人重新随机生成轨迹,保留位移次数和不同地点数,但不再保留原来的频率分布;R3 只保留整个数据集的记录总量、用户数与地点数,随机分配用户和地点。
R1 最接近本文要回答的问题:如果频率就足够解释一切,保留频率后,真实与乱序数据在近期排名上的分布应当相近。
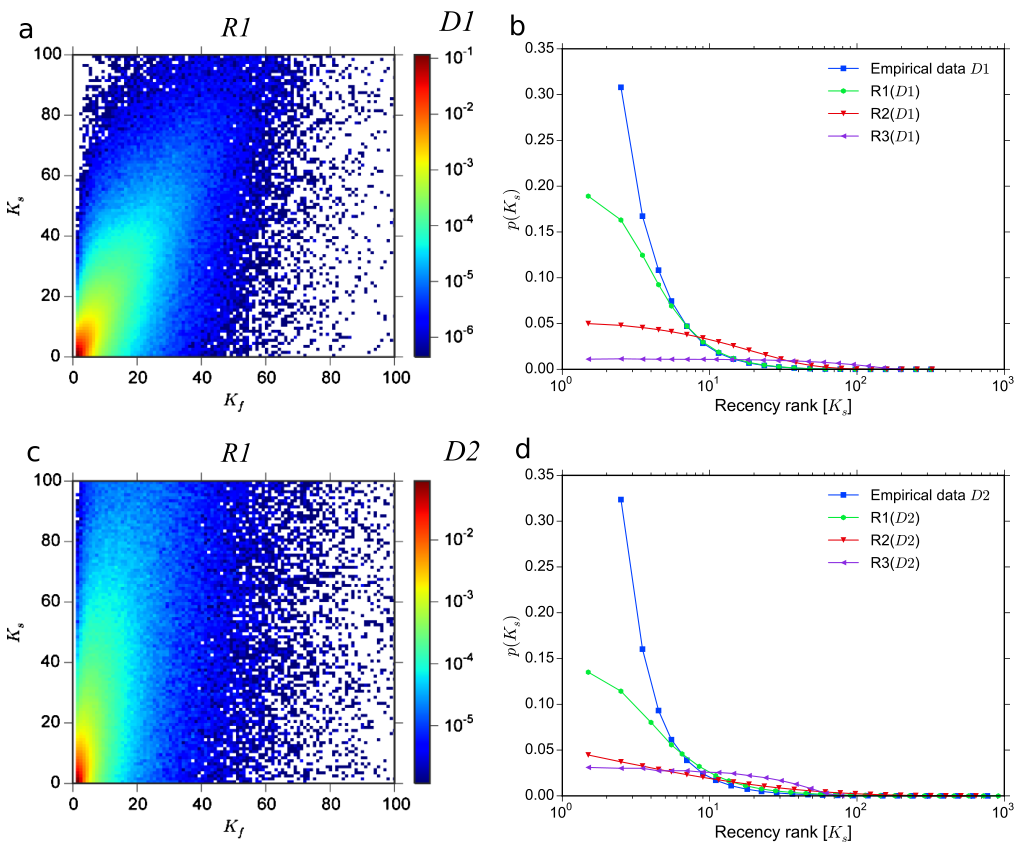
图 4|固定访问次数后,顺序还提供信息吗?a、c 分别是 D1、D2 在 R1 随机化后的联合分布,整体仍保留高频地点主导的轮廓。b、d 分别比较真实数据与 R1、R2、R3 的近期排名分布,横轴对数、纵轴线性。蓝色真实曲线在很小 Ks 处高于保留频率的绿色 R1 曲线;当 Ks 超过约 4,两者趋近。进一步破坏频率的 R2、R3 又呈现不同结构。
这说明累计访问次数不能解释全部近期回访结构:地点访问的先后关系也携带信息。它也限定了效应的范围——差异主要集中在极近的访问历史,不是所有久远访问都具有相同的额外吸引力。
但“打乱后消失”不等于锁定了唯一心理原因。打乱还同时破坏了通勤链、活动安排、地点之间的转移关系等结构。本文识别的是超出总频率的序列特征,若要证明它来自记忆或认知中的近期偏差,还需另外的行为实验或更有针对性的对照。
模型怎样同时保留习惯与近期机会?
为了检验这种机制能否产生观察到的形状,作者保留 EPR 的探索分支,把返回分支拆成两个选择渠道。
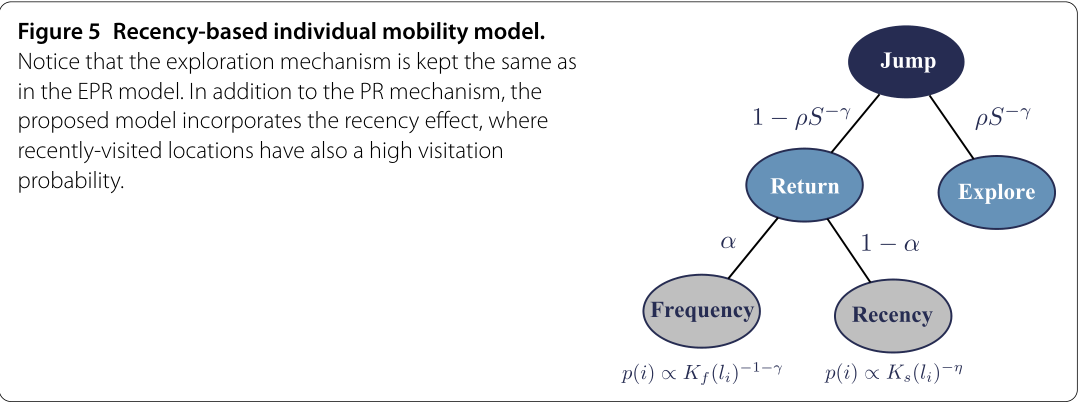
图 5|一次移动如何决定目的地?这张无子图字母的流程图从 Jump 开始:以 ρS^−γ 的概率探索,以其互补概率返回;返回时,以 α 的概率按频率排名选地点,以 1−α 的概率按近期排名选地点。两个返回分支分别使用 Kf^−1−γ 与 Ks^−η 的相对权重,实际选择时需在可选地点间归一化。图中全部分支与公式共同构成模型,不能把两个返回渠道理解成先后执行的两次移动。
S 是到目前为止访问过的不同地点数。随着 S 增加,探索新地点的概率下降。正文估计 D1 的 γ=0.73±0.03、ρ=0.83±0.03,D2 的 γ=0.50±0.08、ρ=0.75±0.03;这是本文处理后的两套数据所对应的参数,不能直接套用为所有人群的固定值。
η 控制近期排名衰减多快,α 决定两种返回机制的混合份额。α=1 时只有频率返回,α=0 时只有近期返回。作者报告,完全依靠近期返回会丢掉访问频率的重尾,而完全依靠频率返回又不能重现近期分布的特点。因而模型要解释的是两种机制共存,而不是宣布新机制取代旧机制。
这里每一步只代表一次地点变换。作者去掉了原模型的连续时间随机游走等待过程,因为连续同地点记录已经被合并,等待时长不会改变当前的排名分析。模型并未由此生成完整的起床时间、到岗时间和停留时长。
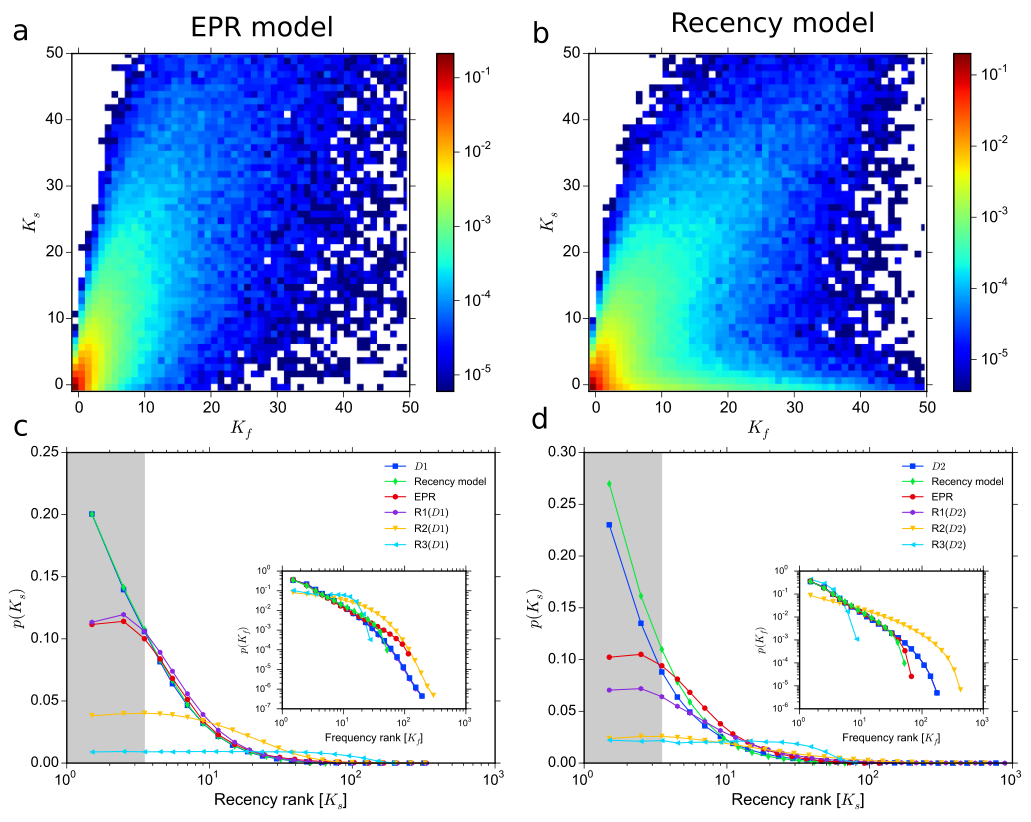
图 6|加上近期分支后,究竟补上了什么?a 是 EPR 的联合分布,b 是加入近期机制的 RM 分布;b 在较低 Ks 处覆盖更宽的 Kf 范围,更接近真实数据中的近期回访。c 对应 D1,d 对应 D2:两幅主图横轴都是近期排名 Ks,灰色区突出靠前排名;小插图才是频率排名 Kf 的分布。蓝色为经验数据、绿色为 RM、红色为 EPR,其余为随机化对照。RM 在靠前 Ks 处更接近经验曲线,同时大体保留频率分布的形状。
整体频率曲线相近,不能保证生成的访问顺序也对。两个模型可以产生相似的“哪些地方常去”统计,却产生不同的“刚去过某地之后怎么走”的局部结构。二维排名和近期分布正是把这一差异暴露出来。
改进有多远,哪里又不再占优?
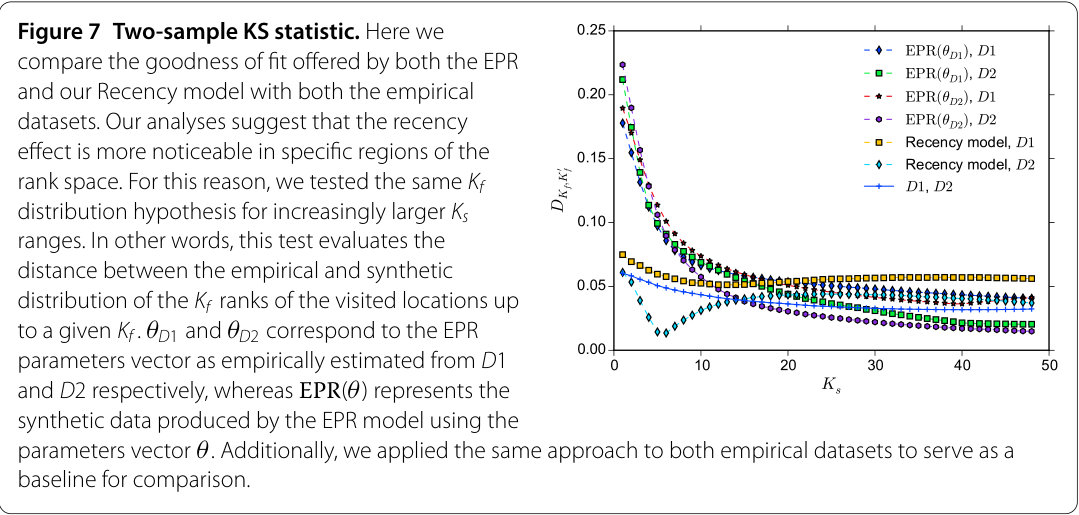
图 7|近期模型的优势是否遍布所有排名?右侧无字母的单幅图横轴为 Ks,纵轴是频率排名分布之间的两样本 KS 距离,越小表示越接近。不同 EPR 曲线分别采用从 D1 或 D2 估计的参数,并与两套经验数据比较;RM 也分别与两套数据比较,蓝色实线是 D1 与 D2 本身的距离,作为参照。小 Ks 区域中,RM 距离明显低于 EPR;随着排名增大,优势减弱,部分 EPR 曲线反而更低。
这支持的是局部改进:作者将明显的近期影响概括为大约最近五个位置的范围,并指出 Ks 大于约 15 后,EPR 对某些分布可以比 RM 更贴近经验数据。这些阈值来自本研究的排序与比较,不能解读成每个人都有严格的“五个地点记忆容量”。
图中的距离也不是预测错误率。例如 KS 距离 0.05 不表示“95% 的下一地点能猜对”。本文比较的是生成分布与经验分布,尚未进行面向未见轨迹的逐步预测评估。
补充材料还检验了分布形式,避免仅凭对数图上一段近似直线就宣布幂律。
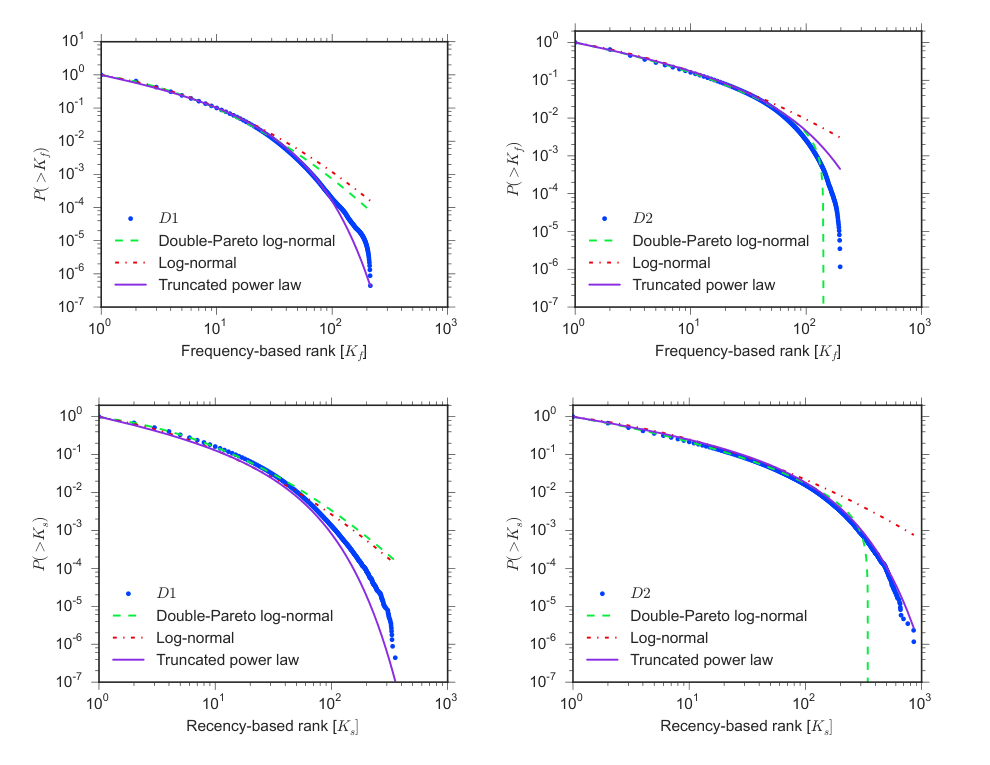
补充图 A1|哪种重尾分布更贴近排名数据?原图四个面板没有字母,上排为频率排名、下排为近期排名,左列 D1、右列 D2。纵轴是超过给定排名的累计尾概率,横轴是排名,均为对数刻度。蓝点是经验分布,绿色虚线是双 Pareto 对数正态、红色点划线是对数正态、紫色实线是截断幂律。补充表 A2 的对数似然比也偏向截断幂律;这是在所比较候选分布中的相对拟合结果,不是对单一普适机制的证明。
正文与补充表 B3 报告的部分拟合参数并不一致,因此不宜把某个精确指数或截断值作为本文的稳定外推结论。核心证据是两维排名的结构、保留频率后的顺序差异,以及模型在靠前近期排名处的局部改善。
这项研究能告诉我们什么,又留下什么?
它提供了一种有用的拆解:长期累计访问和近期访问顺序应分别检查。只拟合访问频率、活动半径等总体统计,可能掩盖生成模型在短程序列上的偏差。
不过,两种数据各有选择偏差。手机记录受通信行为、资费与基站分辨率影响,签到受主动分享和平台用户结构影响。D1 的基站位置与 D2 的具体签到地点也不是同一种空间单位。两者出现相似结构增强了结果的可信度,仍不足以证明所有年龄、城市、生活方式都具有同样强度的近期效应。
模型复现部分分布,说明这种混合机制具备解释力,却没有排除其他能够产生相似序列的机制。论文和公开补充材料也未完整给出全部模拟规模、时长及 α、η 最终取值,精确复现图中曲线仍需要更多实现细节。对公共卫生、城市管理或异常识别的应用,是作者提出的可能方向,本文没有分别验证其实际效果。
一句话总结
人不只反复回到长期常去的地方,也更容易回到刚去过的地方;这份超出累计频率的顺序结构主要集中在很近的访问历史,加入它能改善移动模型的局部回访模式。
核心来源
- Barbosa H, de Lima-Neto FB, Evsukoff A, Menezes R. The effect of recency to human mobility. EPJ Data Science 4, 21 (2015).正式论文与 DOI。
- 同文 官方补充材料:Statistical analysis and parameters estimation,包含排名分布检验、候选分布比较、参数表和随机化定义。
- Song C, Koren T, Wang P, Barabási AL. Modelling the scaling properties of human mobility. Nature Physics 6, 818–823 (2010).DOI,本文扩展的 EPR 模型来源。
图 1–7 与补充图 A1 均来自 Barbosa 等上述论文,保留原图内容;中文讲解由本文撰写。原文以 CC BY 4.0 许可发布。
作者介绍
以下身份采用论文发表时的署名与贡献说明。
- Hugo Barbosa:美国 Florida Institute of Technology 的 BioComplex Lab 署名作者、本文通讯作者;参与研究思想、方法与分析,负责经验数据分析并参与写作。
- Fernando B de Lima-Neto:巴西 University of Pernambuco 理工学院 Computational Intelligence Research Group 署名作者;参与论文写作。
- Alexandre Evsukoff:巴西 Federal University of Rio de Janeiro 的 COPPE 署名作者;参与经验数据分析。
- Ronaldo Menezes:Florida Institute of Technology 的 BioComplex Lab 署名作者;参与研究思想、方法、分析及写作。
延伸思考:新习惯可能需要一个短暂的进入窗口
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个社区新开了图书馆。若推荐系统只按过去半年的访问频率排序,它可能一直推荐旧商场与旧咖啡馆,新图书馆很难获得位置。本文提示一种值得测试的设计:把长期偏好与短期探索历史分开,让刚接触的新地点拥有适度、暂时的再次出现机会,再根据后续真实选择更新。
这里的“暂时”不该直接照搬为五天或五次推荐。论文的近期排名来自实际访问轨迹,推荐曝光是另一个过程。实际实验应比较持续使用、满意度与选择多样性,并检验是否只是把一次偶然访问放大成了重复打扰。
这也提醒我们,轨迹上的短程规律会增加对近期活动的推断能力。设计便利服务时,应让用户能够关闭这类个性化、清除短期历史,并避免把一次新地点访问固化成长期身份标签。