群里认识很多人,为什么还不一定是最好的消息中继?
论文名片|Zunnun Narmawala、Sanjay Srivastava,Improved Heterogeneous Human Walk Mobility Model with Hub and Gateway Identification,收录于 Distributed Computing and Networking, ICDCN 2014,LNCS 8314,469–483,2014 年 1 月 4–7 日,印度 Coimbatore。DOI。
假设两个人都能接触到一个工作群体里的许多成员。甲大多数时候待在本群体,乙同时属于好几个圈子,经常去别处。要把消息发给本群体多数人,甲可能更合适;要把消息带到其他圈子,乙又可能更有价值。
这篇论文围绕这种区别改进人类移动的合成模型,并提出从重叠社区结构预先识别两类节点:群内枢纽与跨群网关。它服务于设备随人移动、利用相遇转发数据的机会网络,不是在社交平台上直接评选有影响力的人。
主要发现可以概括为四点:
- 旧 HHW 模型虽有重叠社区和不同连接度,仍可能产生过多长距离跨群移动,以及不合理的群内高人气节点。
- IHHW 同时修改目的地距离选择、群体人数与空间面积的关系、速度与距离的关系。
- 群内枢纽不能只看连接多,还要考虑在该群体停留的份额;网关则更看重跨群活动与回访本群体。
- 合成仿真中,预先估计的局部与全局人气排序同模拟排序高度相关,但本文未验证真实转发协议的送达率或延迟改善。
为什么社区结构还不够描述人的移动?
机会网络中的设备只有接近时才可能交换数据,人的移动决定了谁遇到谁。完全独立的随机游走忽略家庭、朋友、同事等关系;只给每个人一个群体,又忽略一个人同时属于多个圈子。
Heterogeneous Human Walk(HHW,异质人类游走)先生成重叠社区,再把社区映射到相连的地理网格,每个人被分配若干可访问格子。不同社区大小、成员同时属于多少社区、社区之间重叠人数,以及局部连接度,均按照从既有社会网络研究中借用的统计形式生成。
本文使用的是合成社区,不是把一份真实社会图逐人重建。k-clique 社区是由相邻完全子图连接而成的结构,彼此可共享成员;它为可控仿真提供组织方式,不代表每一处真实生活圈都严格满足同一种生成规则。
问题出在映射与移动:若一人分属多个圈子,旧模型从所有关联格子中均匀选下一个目标,不区分距离。跨群的格子较多时,就容易反复跑远。即使连接度分布合理,空间移动仍可能不合理。
改进模型改了哪三件事?
第一,目的地按距离偏向近处。IHHW 先计算当前格子到所有关联格子的距离,抽取截断幂律距离,再选距离最接近该抽样值的格子。短距离更常见,偶尔出现长距离。论文称其引入 Lévy walk 特征,具体实现是有限关联格子上的距离选择,不是无边界数学 Lévy 飞行。
第二,群体人数与空间格数分开控制。旧模型把社区人数 N 和格数 C 设成相同,连接度 μ 大时,同一格子上容易聚集较多节点,让许多成员都显得很受欢迎。改进后设置 C = mμN,m 控制空间稀疏程度;m 越大,同样人数分散在更多格子,接触机会一般减少。
第三,速度不再独立于距离均匀抽样,而按既有实测关系决定飞行时长:t = p·l^(1−η),从而速度 l/t 随距离变化。论文借用的分段参数为 l < 500 米时 p = 30.55、η = 0.89;l ≥ 500 米时 p = 0.76、η = 0.28。这是外部研究的经验式,不是本篇重新测出的普适速度规律,也没有显式给每段轨迹标注交通工具。
谁适合在群内广播,谁适合把消息带出去?
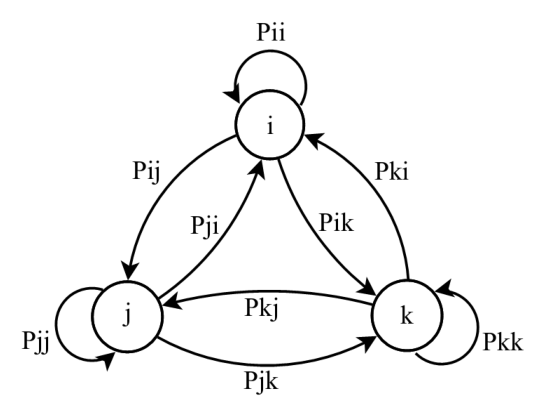
图 1|同一成员怎样在多个社区间移动?
i、j、k 是该节点所属的三个社区,自环表示下一次移动仍在同一社区,定向边表示转往另一社区,各 P 为相应转移概率。原图无子图字母。来源:原论文 Fig. 1。
作者按距离选择规则估计跨社区转移矩阵 P,再求满足 wP = w、各分量和为 1 的稳态向量 w,将其解释为在各社区的长期份额。
对群内枢纽(hub),评分为 LPt = wᵢ × Localᵢ,即在本群体的份额乘以局部连接度。即使一个人连接很多成员,若很少留在这里,也不应仅凭连接度排在最前。评分主要用来排序,不是对真实接触人数的精确预测。
对跨群网关(gateway),评分综合三件事:平均自转移概率较低,意味着经常换群;从其他群体回到目标群体的稳态转移量较高;所属群体数 M 较多。原式为 GPt = (1 − 平均自转移概率) × M × Tᵢ × M,Tᵢ 是从其他群体进入 i 的加权转移量。
这是模型内的网关排序指标,不是已证明对任何网络都最优的中心性公式。离线识别也以已知社区、位置与模型参数为前提:省去了运行中积累相遇记录的过程,并未消除获取这些先验信息的成本。
“永久枢纽”同样有条件。它指社区结构与行为机制不变时长期使用,社区一旦变化,排名就可能需要重算。一次移动步上的稳态与真实驻留时间如何对应,也取决于飞行与等待的时长机制,不能只靠一个稳态向量就假定所有情形精确成立。
仿真比较把哪些条件固定了?
研究在 ONE 仿真器实现 HHW 与 IHHW,使用相同社区结构,以减少结构差异对比较的影响。
| 设置 | 论文取值 |
|---|---|
| 移动节点 | 200 个 |
| 空间范围 | 5 × 5 公里 |
| 格子 | 20 × 20 米,共 62,500 个 |
| 通信范围 | 20 米 |
| 旧 HHW 速度 | 1–6 米/秒均匀分布 |
| IHHW 速度 | 由距离—飞行时间关系计算 |
| 暂停 | 截断幂律,指数 2,给定范围 0–1,000 秒 |
| 预热 | 1,000 秒 |
| 社区构造 | k = 4 |
| 成员数、重叠、社区大小、局部度指数 | 分别为 3、2、1.2、2.5 |
| 距离分布指数 | 2 |
检验接触间隔时模拟两天,每天分三个八小时时段,三个时段有各自的重叠结构并按日重复。论文说 IHHW 与 HHW 的接触间隔尾部相近,但因篇幅未给对应图;这不是本文呈现的一套真实轨迹逐点验证。
近距离偏好是否真的改变了轨迹?
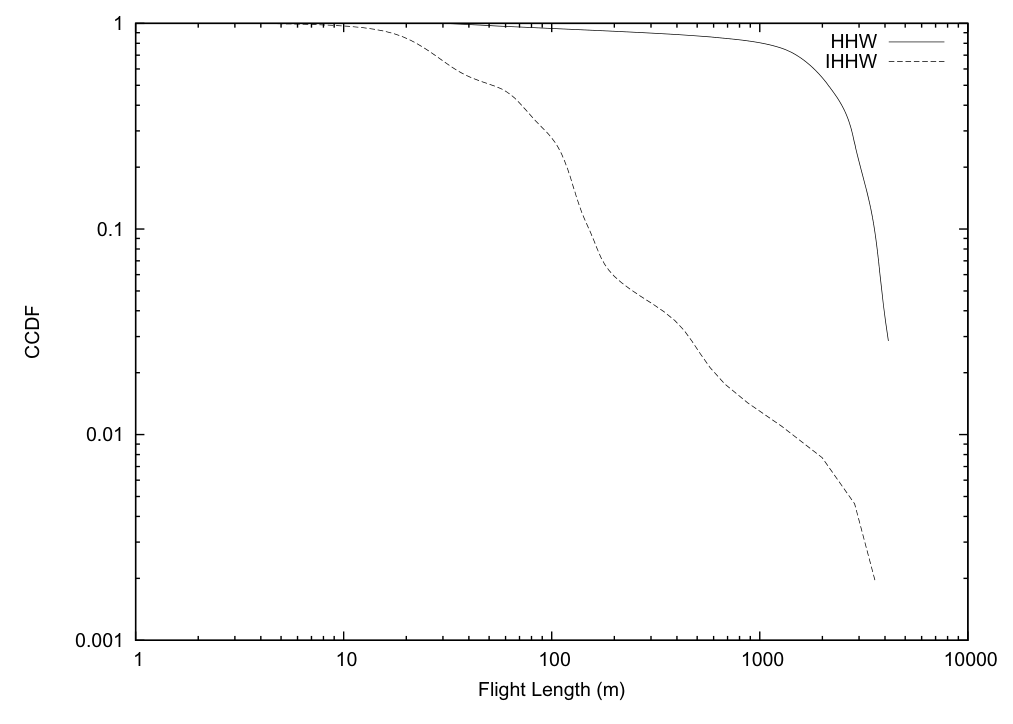
图 2|改进模型是否减少了长跳跃占比?
横轴为飞行长度、单位米,纵轴为超过该长度的概率 CCDF,双轴对数;实线为 HHW,虚线为 IHHW。选取的示例节点属于 11 个社区,IHHW 曲线体现更多短距离和较少长距离移动。来源:原论文 Fig. 2。
这里的 flight 指两次暂停之间的一段位移,不是航空出行。图 2 展示一个多社区节点的模型对照,不能直接说它代表全部 200 个节点,更不能把人为输入的距离幂律再当成独立发现了人类步长幂律。
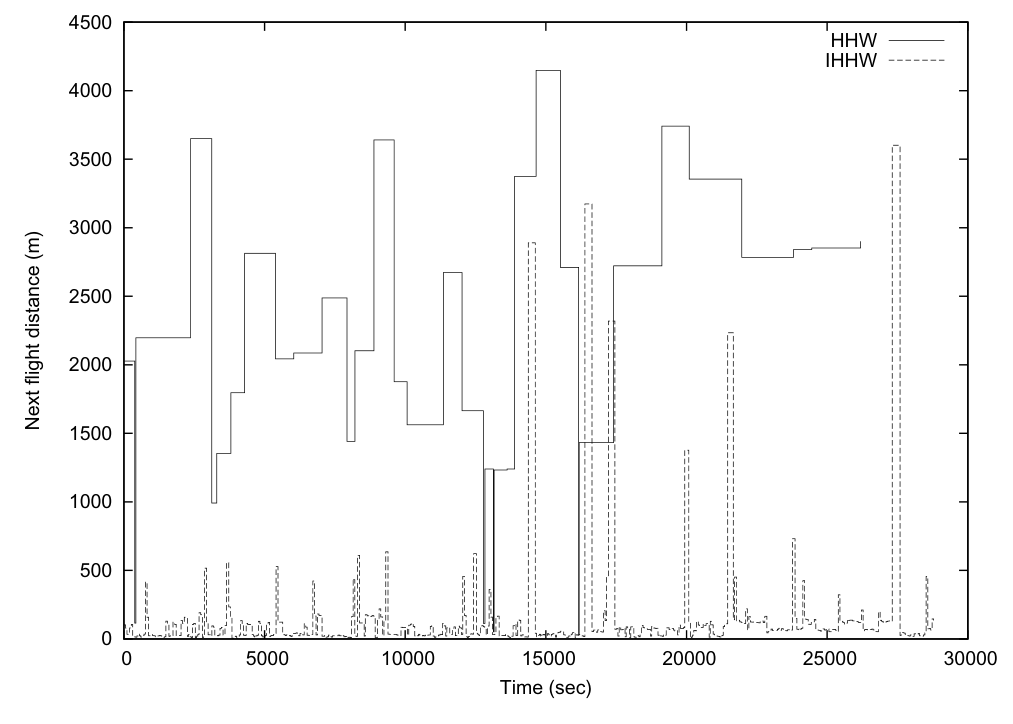
图 3|相同节点是否还在不停跨群跳跃?
横轴秒、纵轴下一段飞行距离米,实线 HHW 出现连续的较长移动,虚线 IHHW 多数时间保持短距离,偶尔跨较远距离。来源:原论文 Fig. 3。
图 3 将分布差异还原为时间上的直观变化:IHHW 更常在一个社区附近活动一阵,再换到别处。它支持所修改规则在该示例中的预期效果,却不验证每次移动的真实动机或日程。
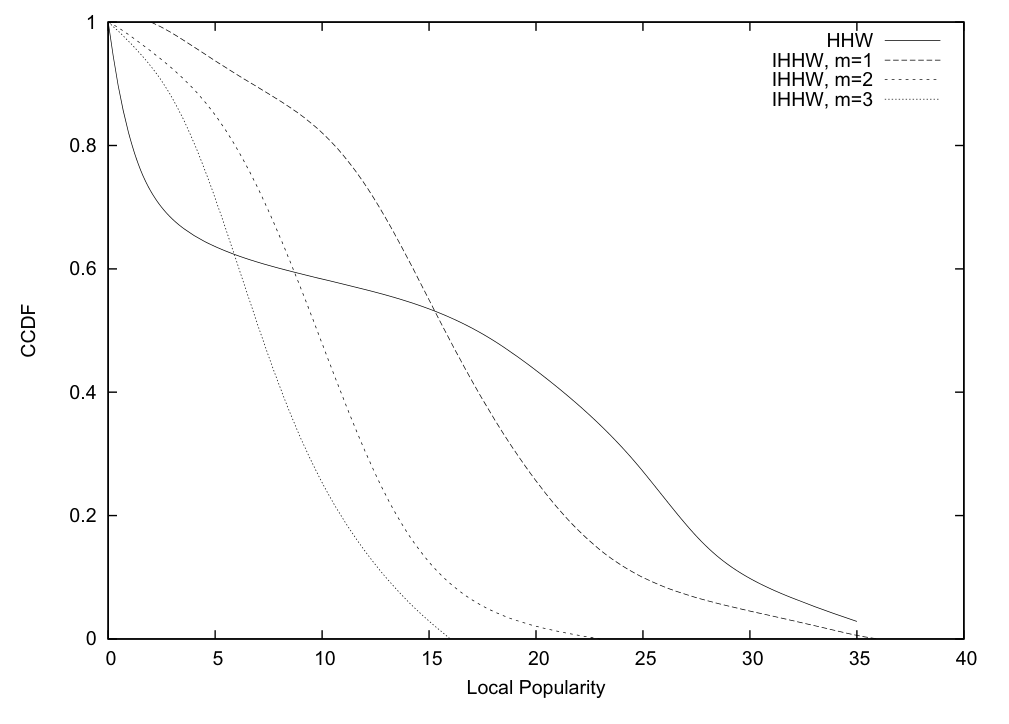
图 4|改变人数与空间关系,怎样改变群内人气?
横轴为局部人气、纵轴 CCDF,选取大小为 70 的社区;对照 HHW 与 IHHW 的 m = 1、2、3。m 增大后,曲线整体向较低人气移动。来源:原论文 Fig. 4。
局部人气有特定定义:在群内,该节点与多少其他节点的相遇次数超过社区平均水平。它不等于总相遇次数,也不等于社交好感。分析还排除短于 50 秒的接触,以减少经过格子时的短暂相遇;这个阈值会影响哪个节点显得重要。
图 4 支持模型能调节局部人气分布,但没有在同图叠加真实群体分布,也没有报告距离、密度和速度三项修改各自贡献多少。不能从这组曲线推断所有现实社区都应采用同一个 m。
接近 1 的排序相关,说明了什么?
离线识别验证的一次社区生成得到 13 个社区。作者分别把理论评分与仿真测得的人气排成列表,再计算 Spearman 秩相关;各社区平均局部相关为 0.9890,全局相关为 0.9987。
这说明在该合成结构和相应移动机制下,理论指标对模拟排序的一致性很高。它并不表示选出的每个前几名都完全相同,也不是 98.9% 的转发成功率。文章未给随机种子间的不确定性、跨场景置信区间或固定前 k 名的选择错误率。
更重要的是,全局人气的模拟定义也按跨群次数、社区成员数和回访目标社区次数构造,与评分采用的因素接近。因此,它首先是模型内部指标与实现的一致性检验,尚需真实相遇轨迹验证外部有效性。
本文没有实施一套消息转发协议来比较送达率、端到端延迟、缓存、带宽或能量开销。所以离线方法可能减少身份交换开销是一项设计动机,并非论文已量化给出的部署收益。
这项工作的适用范围是什么?
IHHW 的价值在于提供一个同时包含重叠社区、接触异质性和距离偏好的可控合成环境。它提醒我们:合理的社会结构不自动产生合理的地理移动;判断中继能力,也要区分群内接触与跨群流动。
但社区被合成并映射到规则格子,群体结构在时段内相对固定,主要验证集中于少数参数和示例。现实道路、目的地功能、日程约束、社区变化以及无线连接质量,都可能改变排名与转发效果。
因此,用它评价协议时,需要把移动生成的假设与协议的改进分开。如果一个协议特别依赖本文设定的“网关人气”指标,只在同一种合成机制下表现好,还不能认定它更适合所有真实人群。
一句话总结
适合群内传播的人,要既连接多又经常在场;适合跨群接力的人,要能往返多个圈子。IHHW 把这一区别写进可控移动模型,并在模型内部验证了排序,而非直接证明真实转发收益。
核心来源
- ICDCN 2014 原文:模型三项修改、枢纽与网关评分、图 1–4 及仿真设置。四张图片均为对应完整原图,论文未列独立补充材料。
- 作者机构书目记录:核对两位作者、会议日期、页码和 DOI。
作者介绍
按论文署名介绍,作者为以下两位。
- Zunnun Narmawala:印度 Nirma University 的 Institute of Technology,本文研究移动模型及重叠社区中的节点识别。
- Sanjay Srivastava:印度 Dhirubhai Ambani Institute of Information and Communication Technology,本文共同作者。原文未提供进一步作者分工,故不作推断。
延伸思考:选对排名,是否就能把消息送得更快?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个节点长期人气很高,却可能刚刚离开目标社区,短时间内不会回来;另一个总体排名较低的人,反而马上就要到达。长期排名适合识别稳定骨干,具体消息的期限却可能需要“现在在哪里、下一次何时见面”的信息。
可以固定同一组轨迹,对比离线骨干、在线相遇统计和加入当前状态的策略,再分别报告短期限与长期送达率、延迟和消息副本开销。如果离线策略只在长期平均上接近,而短期限落后,就说明模型排序与具体服务目标之间还差一层时序决策。