地图上没有房子,是那里没人住,还是还没人画?
论文名片|Benjamin Herfort、Sven Lautenbach、João Porto de Albuquerque、Jennings Anderson、Alexander Zipf,A spatio-temporal analysis investigating completeness and inequalities of global urban building data in OpenStreetMap,Nature Communications 14, 3985(2023)。原论文。
想象一支救援队要根据建筑地图估计受灾家庭。地图上,一片街区满是建筑轮廓,另一片几乎空白。若空白来自尚未完成的制图,而你把它当成没有房屋,最需要帮助的人就可能在计算中消失。
OpenStreetMap(OSM)是一份由公众协作维护的开放地图。它的建筑数据可用于人口分配、交通可达性与灾害暴露分析,但各地绘制程度不同。这篇论文研究的正是地图的空白:哪些城市缺得最多,缺失是否在地理上成片,又会不会藏在一个看似完整的城市内部。
先说结论
- 在全球 13,189 个城市中心中,估计建筑完整性超过 80%的有 1848 个;低于 20%的有 9163 个,约占所分析城市的 69%。
- 各城市完整性的算术平均约为 24%。它是按城市平均的面积覆盖指标,不能读成全球所有建筑只有 24%被逐栋登记。
- 差距既存在于地区之间,也存在于城市内部:一座城市可以整体达到中等覆盖,同时整片街区仍然缺失。
- 人道主义制图与部分低人类发展水平地区的覆盖提高相伴,但这种观察性分解并不能识别制图行动的净因果效果。
没有全球建筑普查,怎样知道缺了多少?
研究对象是欧盟全球人类住区层定义的城市中心:连续高密度网格组成的聚集区,基本门槛为每平方公里至少 1500 人、总人口至少 5 万。城市不是直接按各国行政市边界划定,结论也不覆盖全部农村。
研究将城市拆成一平方公里的等面积网格,共得到 665,641 个格。OSM 部分来自完整编辑历史,提取带 building=* 标签的建筑多边形,可以还原 2008 年初至 2023 年初的地图内容。这里的建筑面积指建筑轮廓在地面的投影面积,不是把楼层相加后的总建筑面积。
外部参考来自政府及商业开放建筑数据,覆盖 162 个国家的 6633 个城市中心、404,982 个网格;同地若同时有官方和微软数据,优先采用官方数据。随机森林(random forest)用这些参考训练,结合人口、夜间灯光、土地覆盖、次国家级人类发展指数及道路网络,预测每格应有多少建筑占地面积。
完整性再由 OSM 已绘建筑占地面积除以预测建筑占地面积得到。采用面积而非栋数,是为了降低表达方式不同带来的偏差:一排联排住宅在一个来源里是一个多边形,在另一个来源里却可能拆成多栋。
分母因此是模型预测,不是全球逐栋实查。模型若把真实建筑总面积估得太低,OSM 完整性就会被高估。
这个分母,至少经过了哪些检验?
直接随机抽取训练和测试网格,可能让隔壁街区同时出现在两边,从而高估模型推广能力。研究采用基于空间分组的 20 折交叉验证,把地理相近的观测划在一起,减少这种空间泄漏。
表 3 报告,网格建筑面积预测的全球 R² 为 0.74,平均绝对误差为 0.034 平方公里;城市尺度完整性比较的 R² 为 0.90,平均绝对误差为 0.055,即完整性比例上的约 5.5 个百分点。城市汇总后的表现不能当作每格都达到同样精度。论文方法段另报过一组不同汇总数值,因此不应脱离表 3 的尺度与口径,笼统宣称模型有 90%准确率。
补充表 1 用 Geo-Wiki 影像判读样本检验微软建筑参考数据,在研究所涉城市样本中,各地区召回率约为 81.2%—86.4%;它并非无误差真值。补充表 3 还显示部分国家、包括中国,缺少训练参考,这些地方的预测不确定性无法由同地验证充分约束。
补充图 4 的分地区预测—参考散点与残差分布显示,部分地区仍有误差结构:东亚与太平洋、撒哈拉以南非洲的一些高完整性估计,其残差更大。所谓完整性地图,应该连同这样的不确定性使用。
地图越来越丰富,为什么仍有那么多空白?
截至 2023 年 1 月 1 日,完整性超过 80%的 1848 个城市约占样本城市的 14%;低于 20%的 9163 个约占 69%。表 2 中按城市平均,欧洲与中亚为 71%、北美为 64%、撒哈拉以南非洲为 30%、南亚为 9%。这些值不是按建筑总量或人口加权后的全球份额。
很高人类发展水平地区总体覆盖最好,但关系不是简单的越富越完整。低人类发展水平组平均完整性为 28%,反而高于中等组的 15%与高组的 17%。论文将其与 2015 年以来人道主义制图在低、中发展水平地区的贡献联系起来。
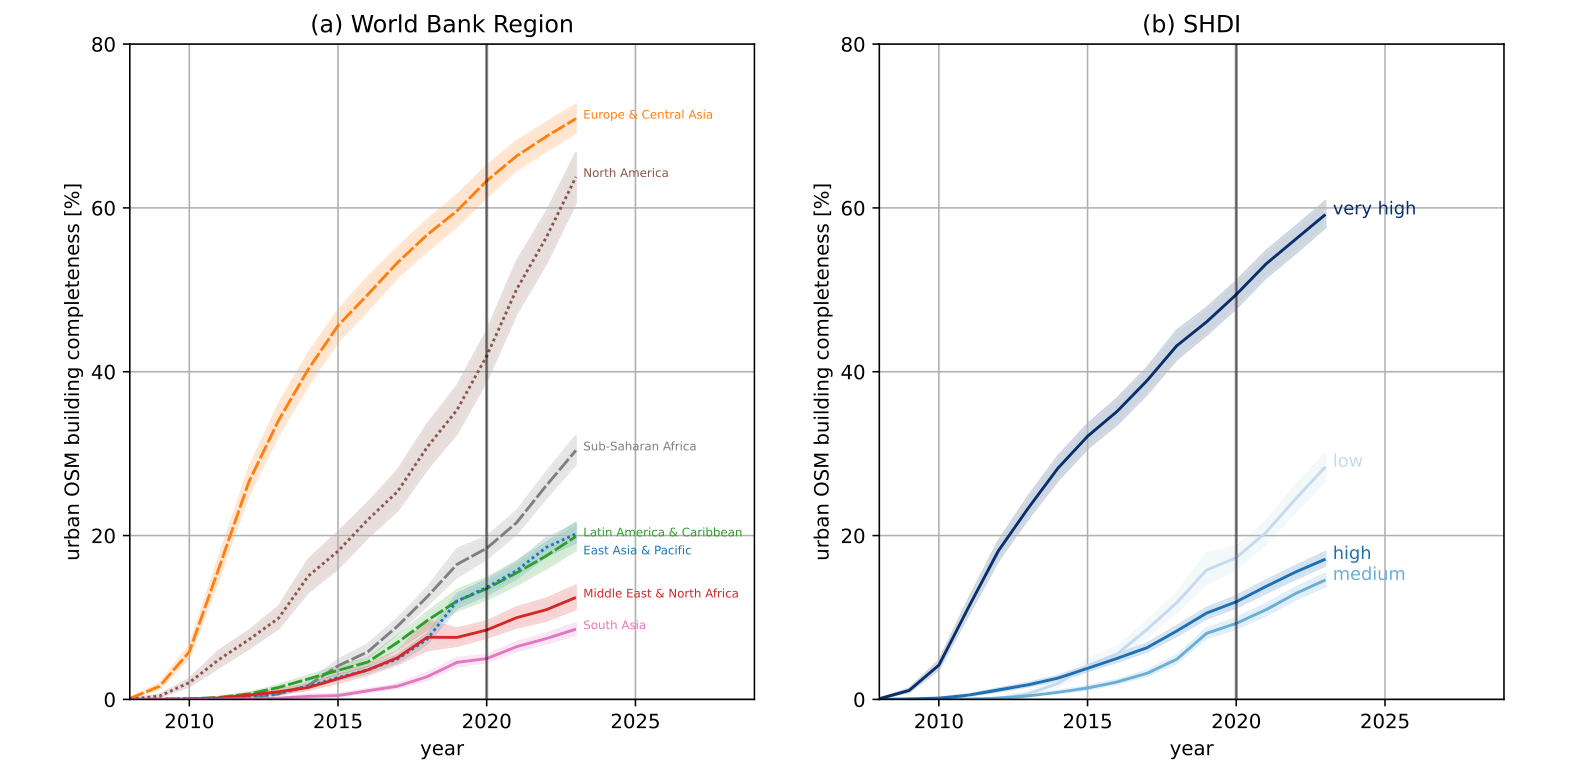
图 1|制图增长是否缩小了地区差距?
(a)横轴为年份、纵轴为城市平均建筑完整性,曲线区分世界地区;欧洲与中亚、北美的水平高于多数地区。
(b)相同坐标下按次国家级人类发展指数(SHDI)分组,很高发展组最高,低发展组近年来又高于中、高组。阴影为各线的 95%置信区间,但没有涵盖固定建筑基准所带来的全部历史不确定性。来源:原论文 Fig. 1。
历史曲线还有一个重要边界:模型主要使用 2020 年的解释变量估计建筑存量,再与各年 OSM 数据比较。它不能完整恢复过去真实建筑存量的变化。快速城市化地区 2020 年后的完整性可能被高估,较早年份则可能被低估;地图数据的增长也不能直接等同于真实城市建筑的增长。
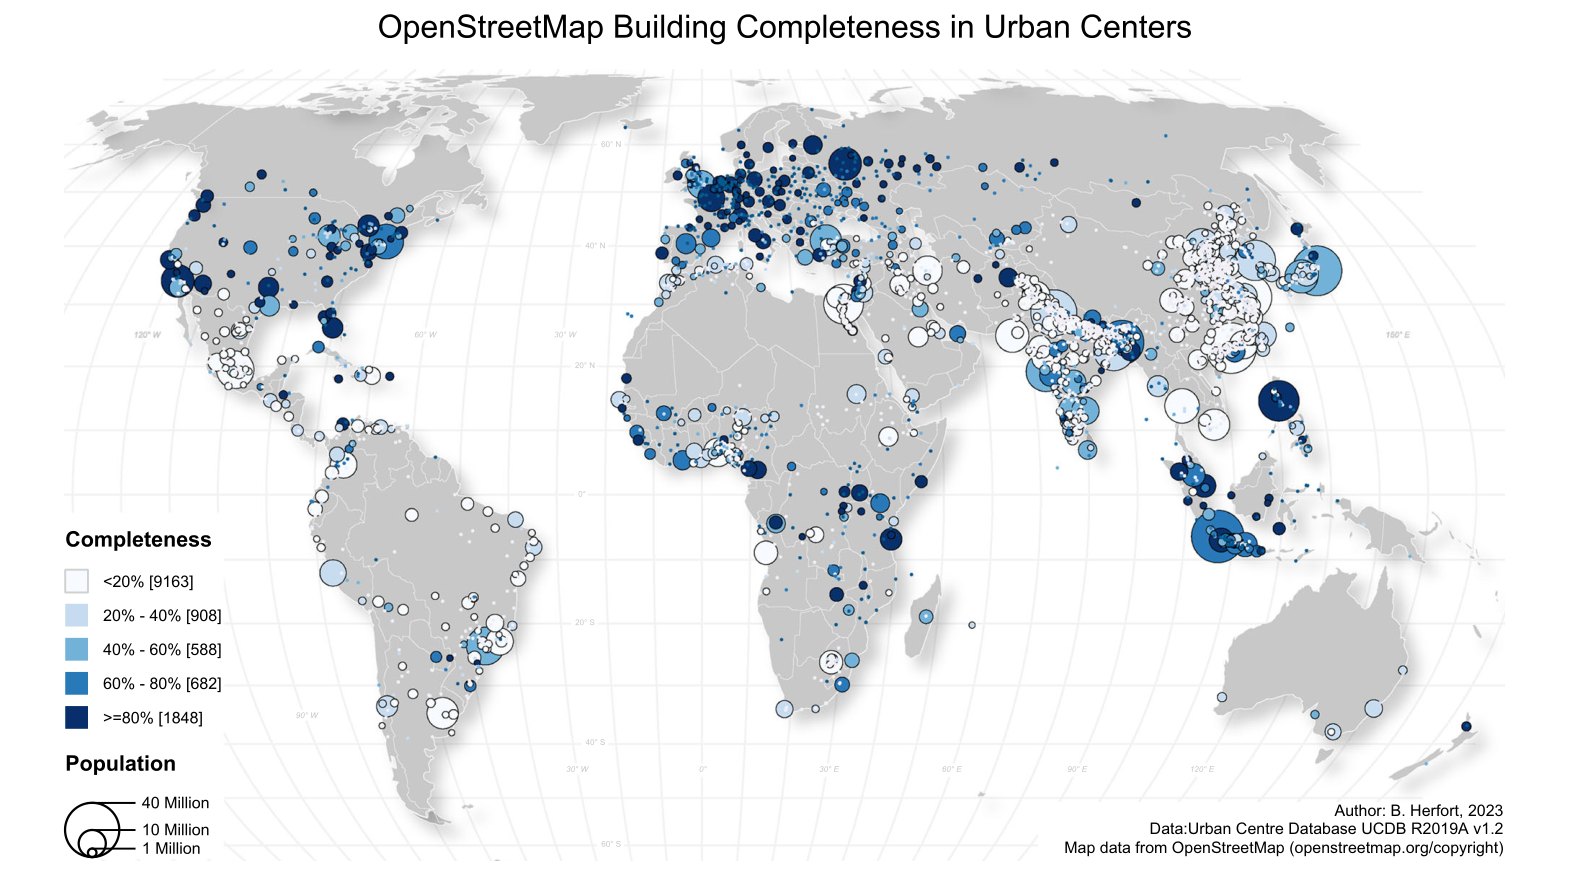
图 2|低覆盖是零散出现,还是在空间上成片?
本图没有字母子图。每个圆代表一个城市中心,圆大小对应人口,颜色对应完整性分档,图例方括号为各档城市数。深蓝与浅色都有明显区域聚集,同一区域内部也有差异;它画的是建筑被收入 OSM 的程度,并不是城市发展程度排名。来源:原论文 Fig. 2。
不平等变小,为什么地图还可能更分裂?
研究用两个指标区分这个问题。基尼系数(Gini coefficient)衡量已绘与缺失建筑面积分布的不均衡程度,不告诉我们缺失地区彼此是否挨着。莫兰指数(Moran’s I)则衡量空间聚集:一个覆盖较好的城市周围,是否也大多是覆盖较好的城市。
全球空间聚集在 2008—2014 年增强,意味着制图更集中于已有覆盖城市的邻近地区;2014 年以后,全球 Moran’s I 从约 0.71 降至 2023 年的 0.56。也就是说,差距和聚集是两种不同的结构,不能用一条平均增长曲线替代。
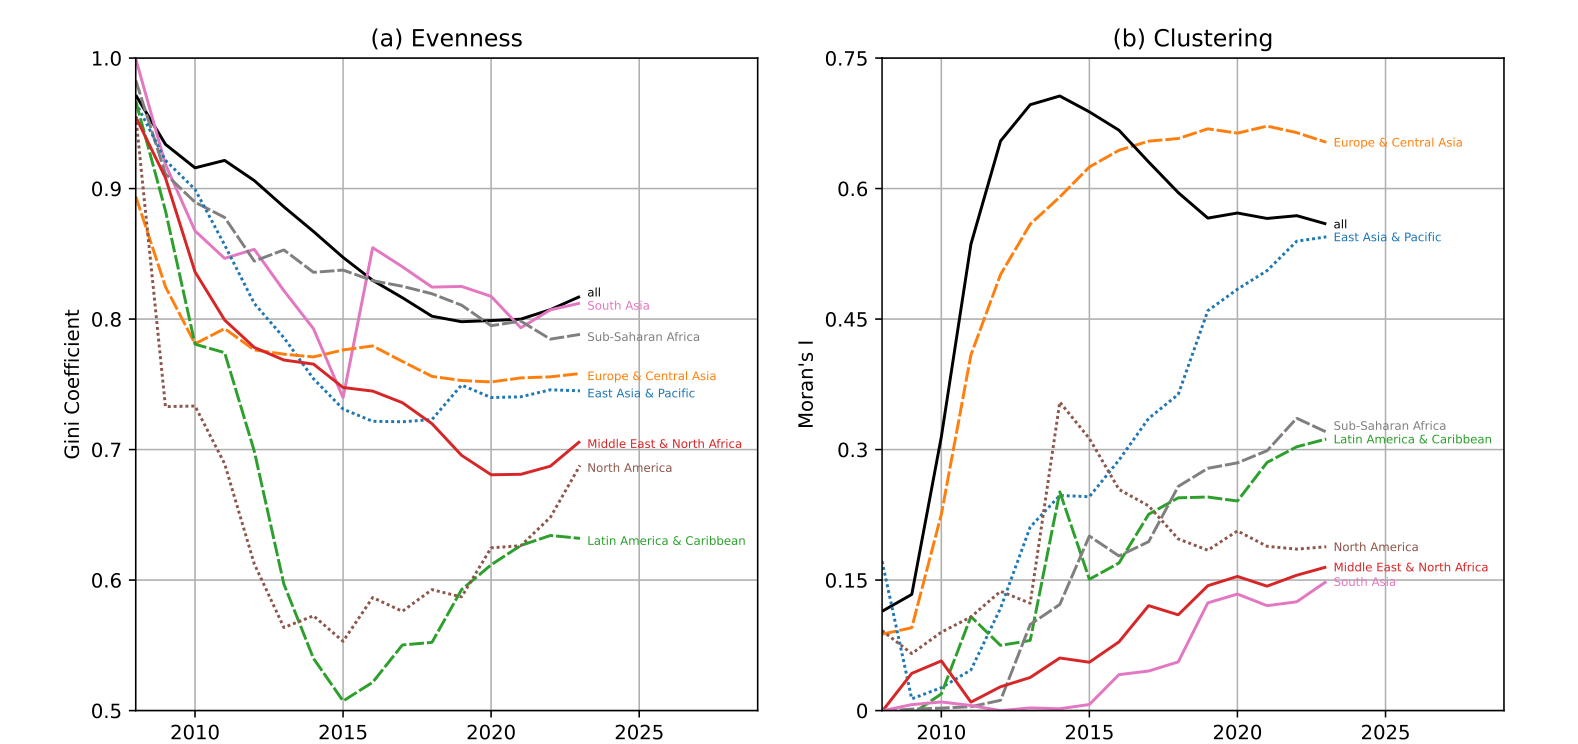
图 3|数量分布与地理位置,怎样讲出不同的故事?
(a)横轴为年份,纵轴为基尼系数;数值较高意味着更不均衡,黑色全球线在下降后仍保持较高水平。
(b)横轴相同,纵轴改为 Moran’s I;正值越大表示同类完整性在空间上聚得更紧。全球聚集先增强后减弱,各地区走势并不相同。来源:原论文 Fig. 3。
全局改善还可能掩盖区域内部的聚集。欧洲与中亚的 Moran’s I 从 2010 年的 0.23 增至 2023 年的 0.65;撒哈拉以南非洲的比较也显示高、低覆盖各自形成成片区域。不能把全球跨区域结构与某一区域内部结构混为一谈。
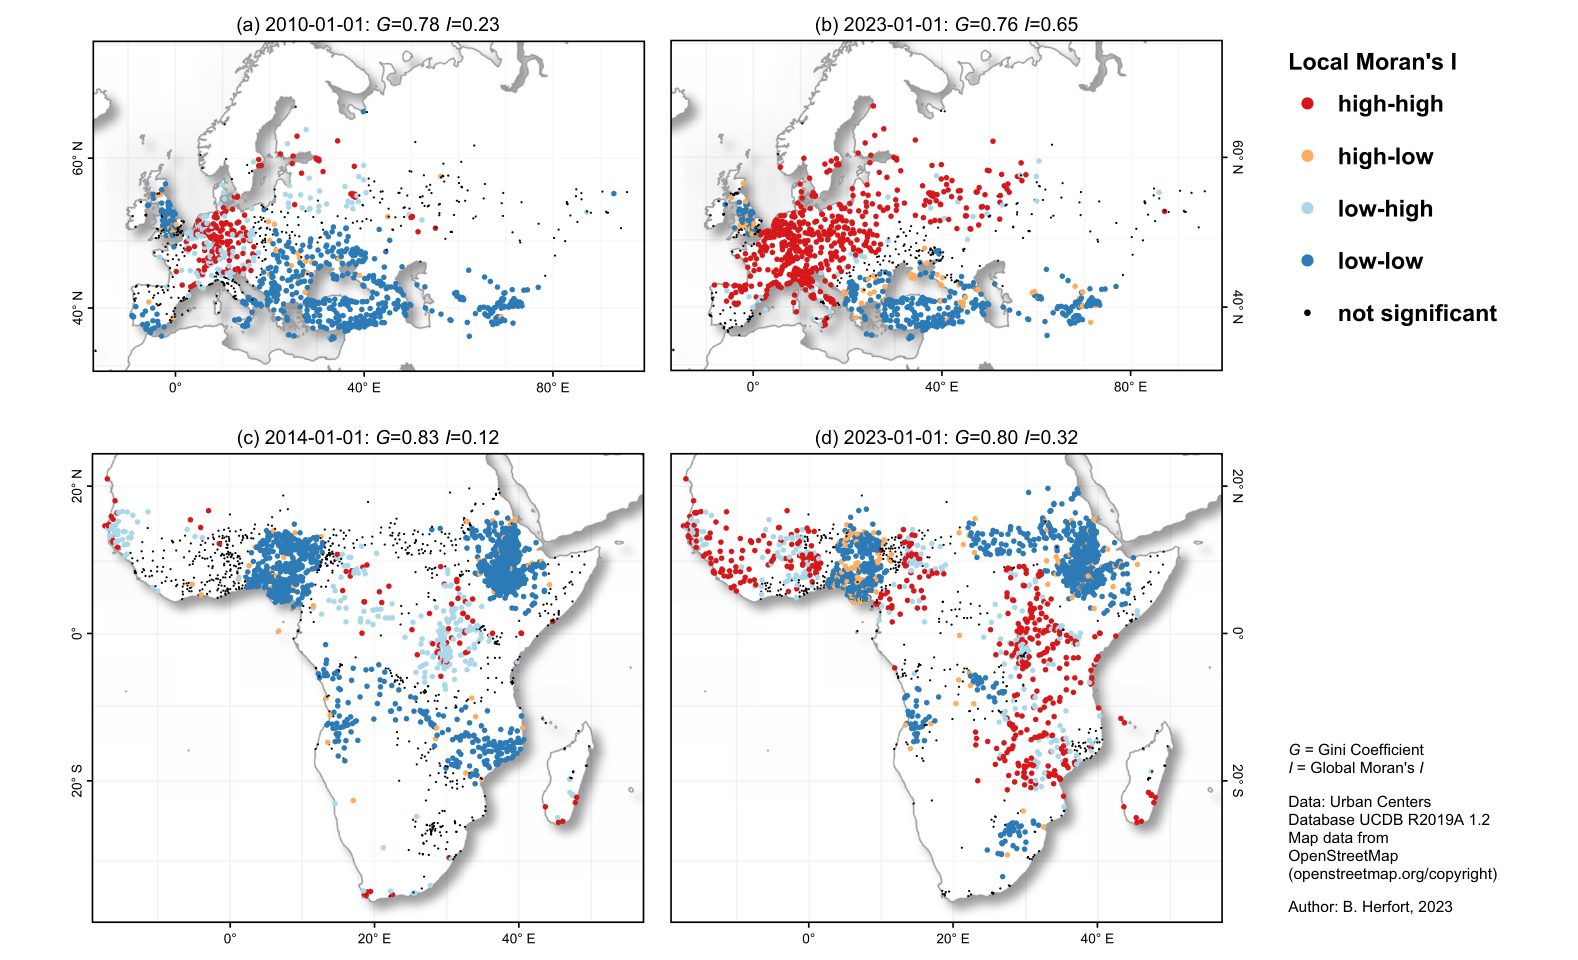
图 4|周围城市的制图水平,与自己有什么关系?
(a、b)分别为欧洲与中亚在 2010 年和 2023 年的局部空间自相关;(c、d)分别为撒哈拉以南非洲在 2014 年和 2023 年的结果。
红色高—高表示城市与邻居均为较高完整性,蓝色低—低表示共同较低;高—低与低—高表示与邻居不同的空间异常,黑点表示未达显著。判别采用相对全局均值的高低,并对多重检验调整,不能把不显著区域当作没有问题。来源:原论文 Fig. 4。
全市覆盖七成,是否就可以放心分析每个街区?
城市内部分析只纳入足够大的城市,以一平方公里网格估计完整性、基尼系数和空间聚集。图示聚类分析最终包含 4647 个城市,面积至少为 25 平方公里,以免网格太少导致不均衡指标不稳定。这个分母与全球 13,189 个城市不同。
聚类同时使用整体完整性、均衡程度和空间聚集,归为三个主类,并把前两类再细分。补充表 7 的聚类评价支持两类或三类较为清楚的分组;这些类别是帮助阅读数据的经验分类,不是城市必然依次经过的发展阶段。
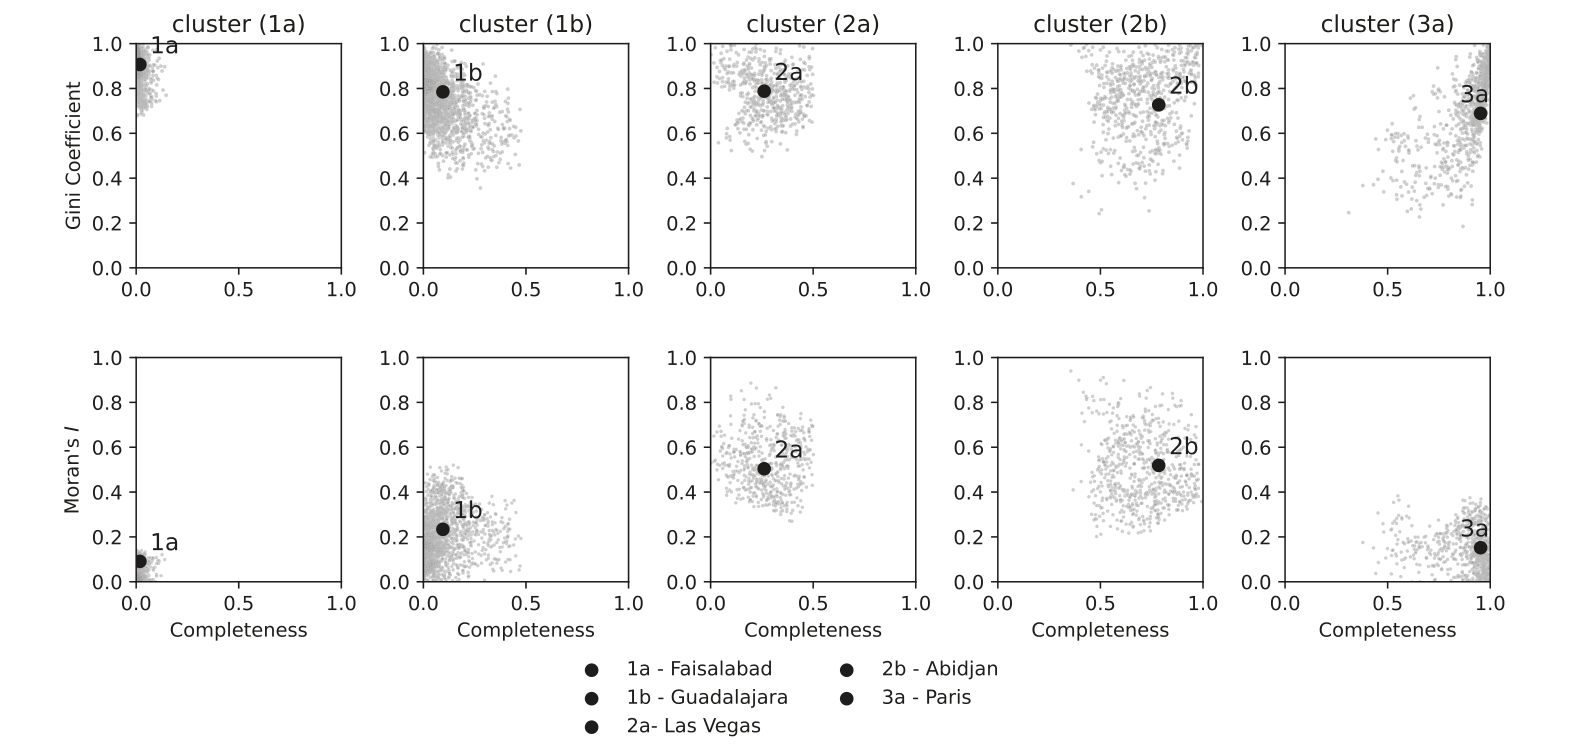
图 5|整体覆盖相似,街区之间的缺失也相似吗?
原图按 1a、1b、2a、2b、3a 五列展示,上排横轴为完整性、纵轴为基尼系数,下排横轴仍为完整性、纵轴为 Moran’s I。每个浅点是一座城市,深点为所选代表城市。由几乎空白、局部热点、成片分裂到接近完整,区别不仅在覆盖多少,也在覆盖怎样分布。来源:原论文 Fig. 5。
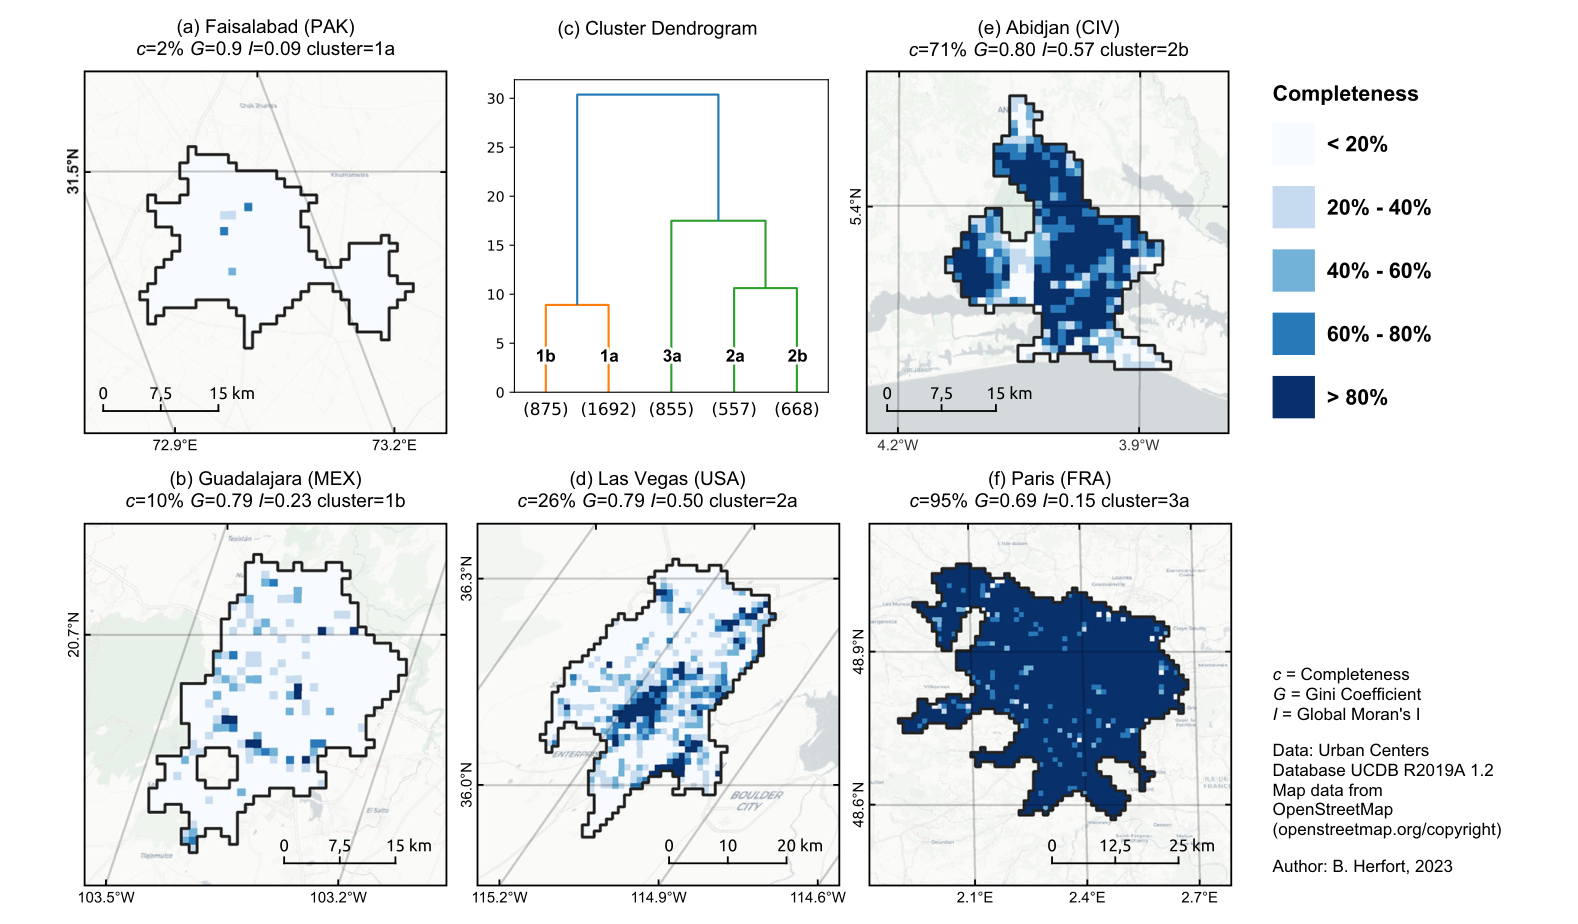
图 6|一个城市平均数,能藏住怎样的空白?
(a)费萨拉巴德:整体完整性约 2%,仅有少量分散记录。
(b)瓜达拉哈拉:约 10%,少数较完整网格聚成热点,周围仍缺失。
(c)聚类树:展示类型之间的合并层次及各组城市数量,不是时间演化树。
(d)拉斯维加斯:约 26%,局部已绘区域与大片缺失区域分裂共存。
(e)阿比让:约 71%,较大连续区域已经较完整,但仍有整片街区缺失。
(f)巴黎:约 95%,大部分地区接近完整,余下缺失更少。地图都采用一平方公里格、共用完整性色标,但城市空间范围不同。来源:原论文 Fig. 6。
阿比让的例子尤其关键:若用全市 71%给每个街区都打七折,仍可能误导,因为缺失不是随机撒开的。建筑数据支撑的暴露人口、服务覆盖和城市形态指标,都可能系统性忽略特定街区。
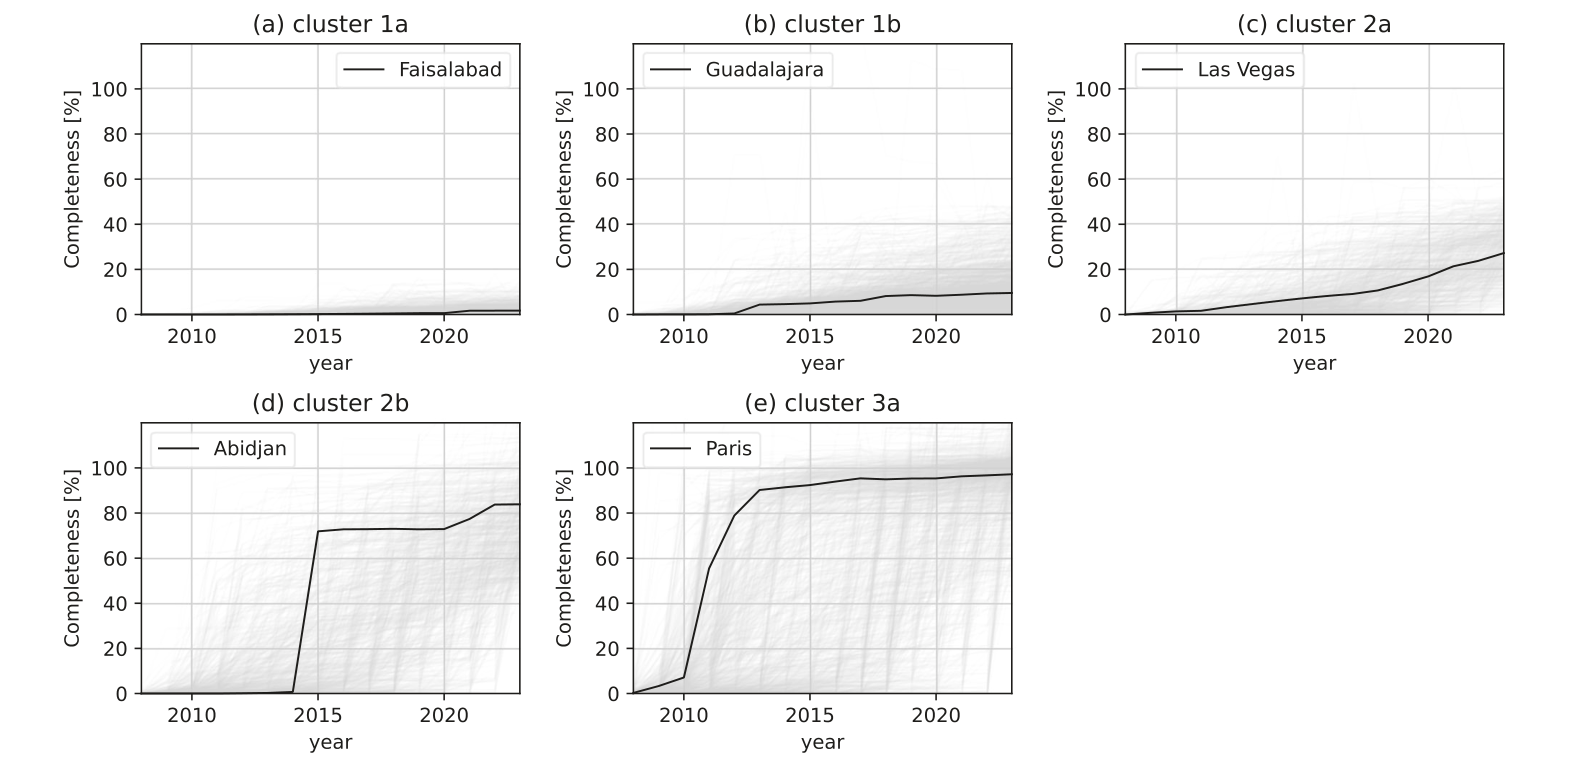
图 7|今天相似的完整性,是否由同样的过程形成?
(a)1a 组及费萨拉巴德;(b)1b 组及瓜达拉哈拉;(c)2a 组及拉斯维加斯;(d)2b 组及阿比让;(e)3a 组及巴黎。横轴均为年份,纵轴为完整性,浅线为同组城市,深线为代表城市。巴黎在 2010—2013 年快速补绘,阿比让则出现明显阶跃;不能据此认定所有城市都会复制这些轨迹。来源:原论文 Fig. 7。
是谁补上了空白,怎样理解他们的贡献?
研究将编辑者分为人道主义、企业与其他制图活动,依据 HOT Tasking Manager 记录及企业编辑者自报身份识别,再按新增建筑面积统计贡献。表 2 显示,全球约 10%的城市建筑制图贡献与有组织人道主义活动有关,在撒哈拉以南非洲这一比例为 51.1%;企业在城市建筑制图中的对应份额约为 0.1%。这些是可识别活动的贡献分解,不是所有商业建筑数据的市场份额,也不代表企业没有在 OSM 外制作建筑图。
人道主义组织把注意力带到原本被忽视的地区,是结果的一种合理解释。但行动可能本来就优先选择数据稀缺或灾害发生地,本文没有随机分派制图行动,无法从占比推出没有这类行动时会怎样。
表 1 罗列的公共卫生、灾害风险与可持续发展应用,说明缺失会进入哪些现实决策,并非逐项验证了这些应用已经从本文获得效果改善。
完整地图,还不等于准确地图
本文只评估建筑占地覆盖,不检验每栋房屋的用途、层数、几何边界和更新时效。大量轮廓被补齐,不保证可以直接识别学校、住宅或医院。
自动识别的微软建筑与人工维护的 OSM 也不能简单互认。补充图 3、表 2 直接比较两者面积,部分地区 OSM/微软之比甚至超过 1;这不是完整性超过 100%的证明,而是两套数据覆盖、来源与误差各异。论文建议探索融合,同时保留人工审核与本地参与。
城市中的训练参考本身有遗漏,模型也会继承其偏差;固定 2020 年基准使历史变化带有不确定性;未覆盖农村又限制了推广范围。这些边界不会抹去空间缺失的发现,却要求每个具体研究在使用前回答:我关心的城市、街区和指标,究竟会被哪些空白影响?
一句话总结
地图空白不是城市空白;比较城市之前,要同时检查建筑数据缺了多少、缺在哪里,以及这些缺失会把哪些人排除在分析之外。
核心来源
- Herfort, B. et al.(2023)原论文,Nature Communications 14, 3985。本文图 1—7 均源自原论文,补充图表在相关段落中讨论。
- 原论文补充材料。
- 研究数据 · 分析代码。
作者介绍
- Benjamin Herfort:署名海德堡地理信息技术研究所与海德堡大学地理研究所 GIScience 团队;参与设计、分析和图表制作,为通讯作者并承担论文主要写作。
- Sven Lautenbach:署名海德堡地理信息技术研究所,参与研究构思、分析及图表制作。
- João Porto de Albuquerque:署名格拉斯哥大学 Urban Big Data Centre,参与研究构思与论文写作。论文披露其与 Herfort 均为 HOT 无报酬投票成员。
- Jennings Anderson:署名 Meta Platforms,参与实验、分析及论文写作。
- Alexander Zipf:署名海德堡地理信息技术研究所与海德堡大学 GIScience 团队,参与论文写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果只选完整性高的城市做全球比较,确实能减少一部分数据误差,却可能把研究对象换成更容易被画出来的地方。若制图参与、数字基础设施和公共服务本身相关,那么完整城市样本里的关系,未必适用于被剔除的城市。
一个更可检验的办法,是先在少数完整城市中模拟不同缺失方式:随机删建筑、整片删街区、优先删小型住宅,再重算可达性或灾害暴露。若同样删掉 20%的建筑面积会造成截然不同的偏差,就能说明修正不能只依赖一个全市完整性比例。与此同时,模拟只能揭示敏感性,仍需要本地影像与社区知识确认真实缺失发生在哪里。