地图上有公交线路,为什么还不能直接分析一张公交网?
论文名片|Shiguang Wang、Jinyu He、Rui Ma、Zeyang Cheng、Heng Ding,A Comprehensive Vector Dataset of Bus Networks Across China for the Year 2024,Scientific Data 12, 524(2025)。原论文 · 数据描述论文。
想象你要比较两座城市:一座公交线路很多,另一座站点看起来更密,哪一座的公交网更容易在关键站点中断后维持连接?从地图截屏上数线条,很难得到可信答案。不同线路经过同一站却可能记录在略有偏移的位置,同一段道路也会叠着多条几乎重合的轨迹。图上看着相连,数据里却未必连得上。
这篇论文把商用地图中的公交线路与站点转为统一矢量数据,再构建站点与相邻连接组成的拓扑网络。成果面向 2024 年 4 月的网络结构研究;它提供空间骨架,不能直接替代带班次、方向和时刻表的运营网络。
先说结论
- 数据以 299 个城市为组织单元,包含 293 个地级市、4 个直辖市和2个特别行政区;三沙因数据不完整保留空文件,台湾不在数据范围内。
- 高德与百度数据经过坐标统一、线路交叉核对与站点合并,提供公交站点、线路及无向拓扑网络的 Shapefile 数据。
- 拓扑网络把站点作为节点、相邻站点间连接作为边,同一节点对上的多线路重合段只保留一条边,因此分析对象由线路服务变成了空间连接结构。
- 在 GDP 前十城市的比较中,这套数据的站点数均高于 OSM;这提示开放地图有遗漏,却不能据此计算新数据的独立准确率。
全国范围,具体覆盖哪些地方?
论文按城市行政单元组织数据,并不等同于只取中心建成区。线路包括市内和部分跨城市公交,因而可以研究更大行政区域的连接。与此同时,299 个城市不意味着中国所有地级行政区都被覆盖:地区、自治州与盟等其他行政类型不在这一城市清单中。
这是后续比较的第一个分母。第二个分母是统计分析样本:论文只选择至少有 20 条公交线路的城市,最终有 289 个。不能把 289 城市的平均指标称为每一座中国城市的公交特征,也不能把空文件当作三沙没有公交。
两家地图的信息,怎样合到一起?
高德部分利用城市代码与线路标识查询,取得线路名、线路几何、站点名与坐标;百度部分用已有线路名列表检索。与单纯凭记忆列举线路名相比,标识查询意在减少遗漏,但查询规则本身也可能变化。
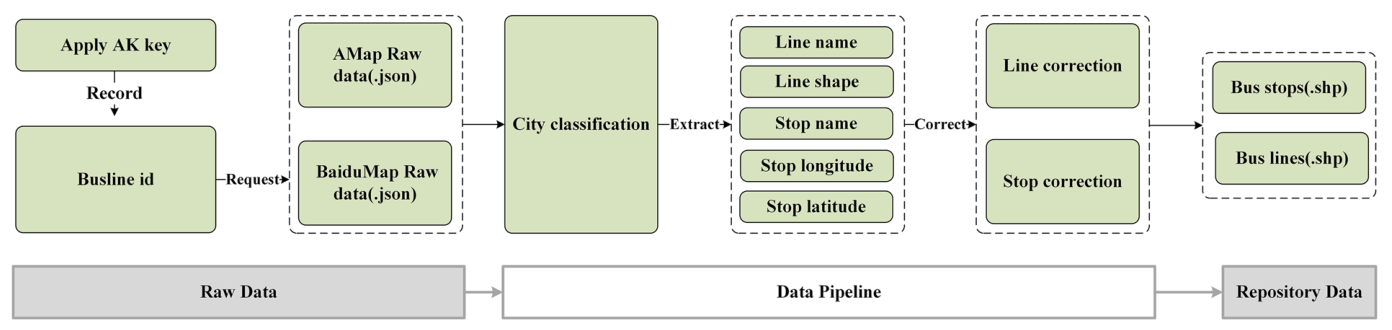
图 1|一座城市的线路、站点记录怎样成为可复用的数据?
本图没有字母子图。左侧为接口凭证与线路标识,中部为高德、百度原始 JSON 数据及城市匹配,之后提取线路名、线形、站名和坐标并做校正,右侧输出站点与线路矢量文件。箭头展示数据加工顺序,不是公交运行方向。来源:原论文 Fig. 1。
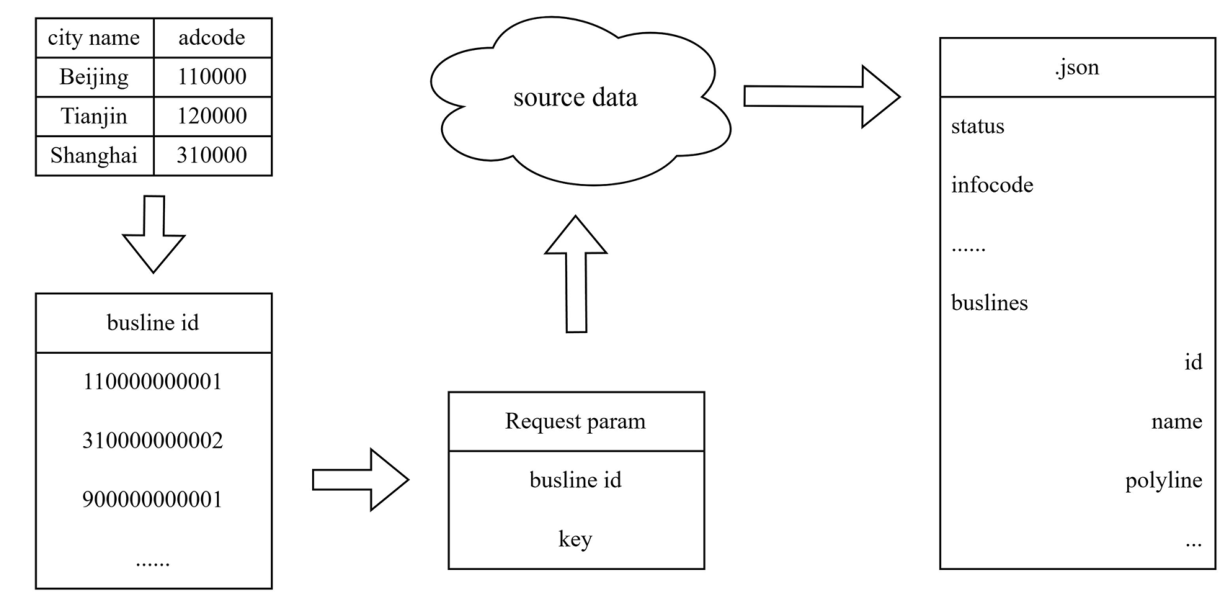
图 2|请求的是一条线路的什么信息?
本图没有字母子图。左上城市代码用于生成线路标识,中间请求参数连接数据源,右侧 JSON 返回线路标识、名称和折线等字段。城市代码与线路标识是获取记录的索引,不是站点间拓扑关系;原始返回仍要经过后续清洗。来源:原论文 Fig. 2。
两家的地理坐标不能直接叠加。高德使用 GCJ-02,百度使用 BD-09,研究先转成 WGS84,以便和其他地理数据连接。否则坐标系造成的偏移可能被误认为两个不同站点,或让站点偏离道路。
线路核对则比较两个来源,选择信息较完整者,并补充另一来源的缺项。这比完全依赖单一地图多一道检查,但两个平台也可能共享同一类遗漏;而百度检索使用高德获得的线路名,也意味着两次收集不是完全独立的地面调查。
同名站点靠得很近,为何需要合成一个节点?
多条线路经过同名站点时,各记录坐标往往略有差异。一部分来自位置记录误差,一部分来自实际相邻站位。若全部保留为互不相干的节点,网络会把本应能够换乘的位置拆开。
研究用同一站点多份记录的坐标质心,生成标准化位置。这个处理提高结构分析的一致性,同时也把一些实际距离压缩为零:道路两侧的站台、长距离步行换乘等,不会自动在合并后的节点中得到表达。
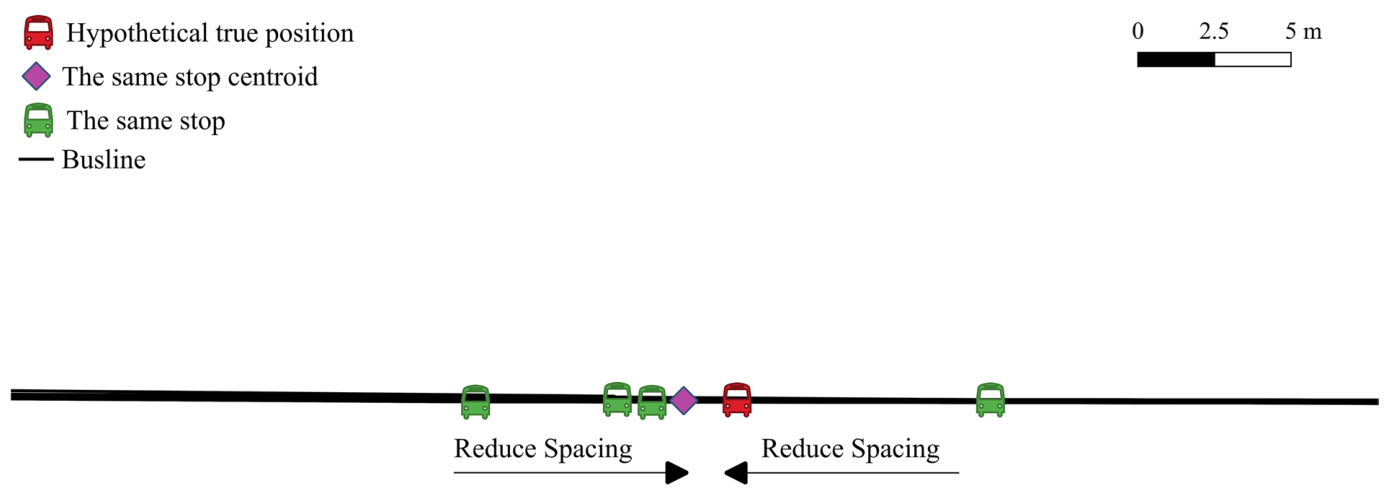
图 3|多个坐标怎样代表同一处站点?
本图没有字母子图。黑线表示公交线路,绿色为同站记录的位置,紫色菱形为质心,红色为示意中的假定真实位置;箭头表示合并缩小坐标分散。真实位置只出现在解释示意中,不能把质心与红点的差当成全国已测得的定位误差。来源:原论文 Fig. 3。
表 1 列出的线路表包含 lineName 与几何线形;站点表包含 stopName、所属线路和点几何。理解这些字段的对应关系,才能区分一条线路经过的站点记录与去重后的物理节点。文件以 Shapefile 交付,几何、属性、索引和字符编码分别由配套文件保存,使用时需要把同组文件一起保留。
一条公交线,怎样变成一条条网络边?
研究采用 L 空间模型(L-Space):站点是节点,同一线路上相邻站点之间的路段是边。它与把同一条线上任意两个站点都直接相连的网络表达不同,后者更接近免换乘关系。
构建时先把站点投影到线路几何上,再按站位切分线路;对多个路线共用的节点对只保留一条边,并处理略不重合的轨迹,使同一节点的边实际接到一起。
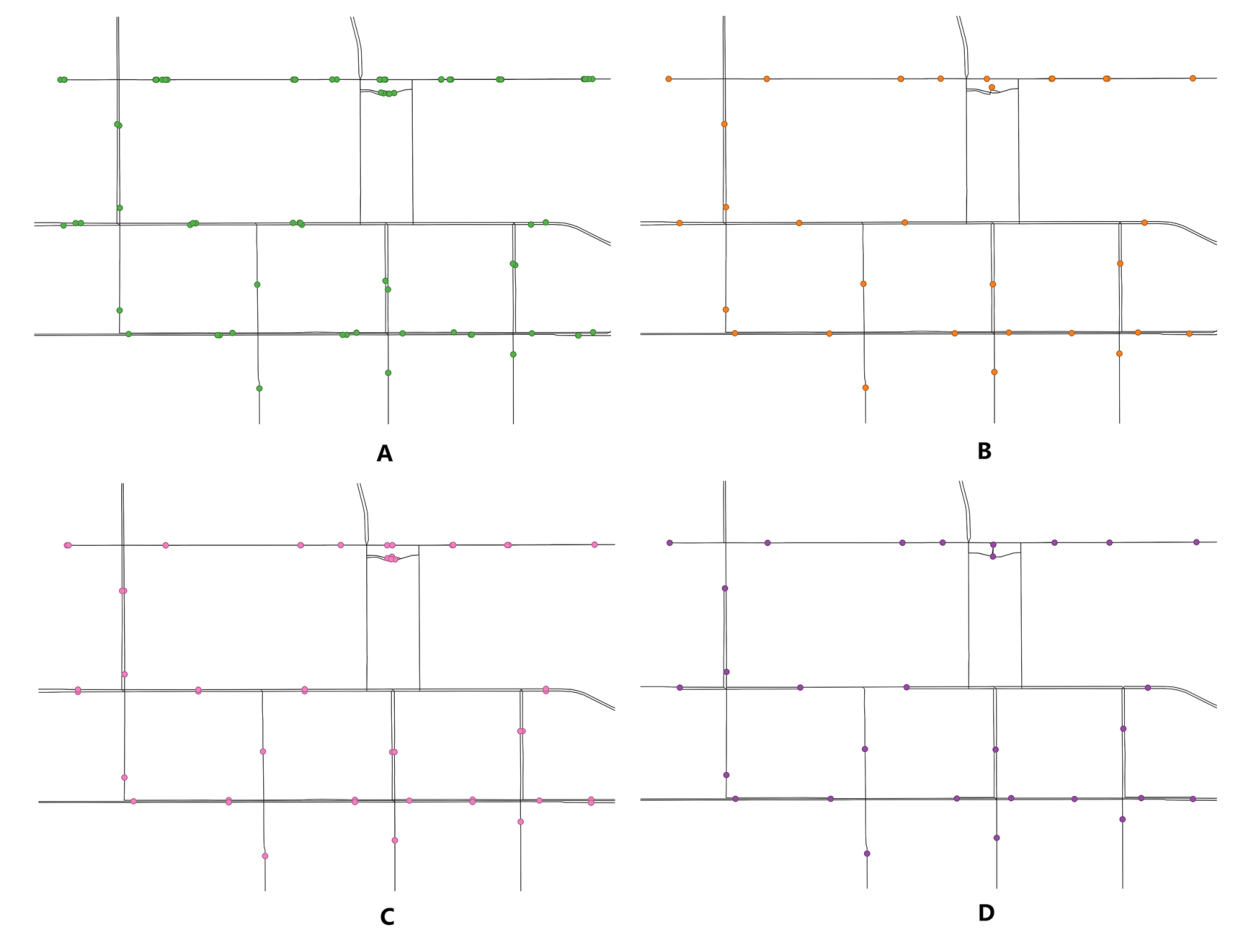
图 4|地图上的线条怎样获得可计算的连接关系?
(A)原始线路与站点,各线路的记录可能存在偏移或重复。
(B)简化网络,合并并统一同站记录,减少重复表达。
(C)站点投影,将站点匹配到线路并按站位建立分段。
(D)拓扑网络,得到节点和边的连接结构。颜色区分加工阶段,面板不是四座城市,也没有报告四种算法的性能差异。来源:原论文 Fig. 4。
最终拓扑边是无向的。它适合研究节点度、连接关系与结构中断,却不保证反方向真有公交运营。相邻站点间有 1 条还是 10 条服务线路,合并为一条边后也不会通过多重边保留。因此,网络连通不能直接等同于低等待时间、高运力或无需换乘的可达性。
比 OSM 站点多,就一定完整吗?
研究在 GDP 前十城市比较站点数量,两个来源都按站名去重。表 2 显示,例如成都 OSM 为 461 个站点,本数据为 14,072 个;上海分别为 10,312 和 16,313 个。这说明在所比版本与口径下,新数据包含更多记录,并揭示 OSM 在部分城市存在明显覆盖缺口。
但缺少独立完整的站点名录时,数量更多不能区分补足遗漏与残留重复,也不能检验每个坐标是否正确。站名去重还会受到同名异站、站点改名与上下行站位规则的影响。比较结果应理解为覆盖证据,而不是每个城市都有经实地验证的精确召回率。
线路数量也高于所列官方 2023 年末统计,如上海为 1808 对 1589 条、北京为 2352 对 2132 条。两个来源不仅年份相差数月,空间范围也不完全相同:官方统计可能主要覆盖建成区,而数据抓取覆盖更大行政范围。它不能被解释为短短几个月真实新增了所有这些线路。
289 座城市里,网络规模与线路形状怎样不同?
表 3 中,城市线路数的平均值为 274、中位数为 159、标准差为 361,说明少数大网络明显拉高均值。线路总长度平均为 6159.67 公里,中位数为 3623.18 公里,标准差为 7424.85 公里,同样表现出明显城市差异。
与此相比,平均线路长度的城市间平均为 23.22 公里,标准差为 7.71 公里;平均每线站数为 24.11,标准差为 4.66;平均站间距指标为 1026.02 米,标准差为 362.58 米。这里都是城市指标在样本中的汇总,不能当作对全国每条线路或每个站间段直接求得的加权平均。
表中还列出网络密度、冗余系数、非直线系数和 500 米覆盖指标。非直线系数均值为 1.74,但不能据此直接推出每位乘客都绕行 74%;人的起终点、换乘与路线选择不在这个指标里。密度和覆盖率则尤其依赖使用何种面积分母。原表 500 米覆盖字段的百分号与小数写法并列,实际复用前应回到数据和代码核定,不宜把一个数直接写成居民服务覆盖率。
它还缺少什么,才能用于出行决策?
这套数据记录的是地图可获得的网络,时间点为 2024 年 4 月。它不直接提供逐班时刻表、实时发车间隔、客流、拥挤程度或取消班次信息。分析公平性时,附近有站只是条件之一,还需要服务频率、运营时段和步行进入站点的成本。
合并站点和构建无向简单图是服务研究目标的建模选择,不是现实运营的全部细节。跨城线在按城市拆分的数据中如何处理、同名节点如何合并、行政边界与建成区如何对应,都可能影响跨城比较。
复现收集方法也不能假定接口永远可用。论文已经说明线路标识规则和商业服务会变化,并记录百度相关服务在 2025 年 3 月的可用性变化。因此,数据快照与采集代码都有价值,但代码能运行与复现当年地图状态是两回事。
一句话总结
这套数据把公交地图变成了可比较的空间网络,但要从站点连通走向真实出行体验,还必须补上方向、时间、频率与服务能力。
核心来源
- Wang, S., He, J., Ma, R., Cheng, Z. & Ding, H.(2025)原论文及完整图表,Scientific Data 12, 524。本文图 1—4 均源自该论文。
- 公交矢量数据与处理代码。
作者介绍
五位作者均署名合肥工业大学汽车与交通工程学院。分工依据论文作者贡献说明。
- Shiguang Wang:通讯作者,参与研究构思、调查、经费支持、可视化与稿件修改。
- Jinyu He:参与研究构思、正式分析、调查和可视化,撰写论文初稿。
- Rui Ma:参与分析、调查、可视化及稿件修改。
- Zeyang Cheng:参与分析、调查及稿件修改。
- Heng Ding:参与分析、调查及稿件修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设两座城市的公交拓扑图完全一样,一座每 5 分钟一班,另一座每小时一班。仅用连接数、最短路径或节点中心性,它们会得到相近评价,居民的实际机会却可能相差很大。空间结构相似,因此不是服务公平相似的充分条件。
一个可以检验的方向,是把这套骨架与少量可靠的时刻表样本结合,逐步加入方向和等待时间,观察城市排序会改变多少。若排序变化主要集中在郊区或晚间服务,就能更具体地定位纯结构分析忽略了什么,而不是笼统地给一座城市贴上公交发达或不足的标签。