手机定位很密的地方,就真的有更多人吗?
论文名片|Mingxing Chen、Yue Xian、Yaohuan Huang、Xiaoping Zhang、Maogui Hu、Shasha Guo、Liangkan Chen、Longwu Liang,Fine-scale population spatialization data of China in 2018 based on real location-based big data,Scientific Data 9, 624(2022)。原论文 · 数据描述论文。
想象要估计洪水会影响多少人。统计年鉴告诉你某个县有几十万人,却不能直接说明河边那几个街区住着多少人。把全县人口平均摊到每块土地上,会让山林和城区得到相同密度;只凭楼房和灯光分配,又可能漏掉建筑用途和白天活动的差异。
手机位置服务提供了另一种线索:人实际活动的地方会产生定位信号。但定位次数不等于人数。一个频繁使用地图的人可以留下很多次记录,不使用相关服务的人则可能几乎不出现。POP2018 的做法是用县级统计人口校准信号,再把县内人口分配到更细网格,而非把每次定位直接当成一个人。
先说结论
- 研究将 2018 年 2851 个县级单元的常住人口与腾讯位置服务数据结合,制作中国大陆 0.01°人口网格。
- 手机信号用于决定县内人口分布权重,县级统计人口用于约束总量。细网格是模型分配结果,不是逐人定位得到的人口普查。
- 在东莞 33 个镇的验证中,POP2018 的拟合 R² 为 0.91,图示均方误差为 22.48,优于该比较中的 WorldPop 和 LandScan;这一验证不能直接证明全国每个网格同样准确。
- 产品面向时间平均的活动人口分布,但输入和验证又使用常住人口。活动人口、常住人口和某一时刻在场人数,使用时必须区分。
地图的总量,来自统计;地图里的细节,来自信号
人口统计来自 2018 年全国人口抽样调查,样本约占全国人口的千分之一,研究获得 2851 个县级单元的人口数据。这里的常住人口是居住半年以上的人口,不是某一天的手机活跃用户。
腾讯位置服务数据覆盖经纬各 0.01°的网格,以 5 分钟为间隔记录用户定位信号次数。论文报告其数据涉及约 8 亿在线用户,但不能据此认为每个群体、每个地区都按人口比例出现。不同人群的设备使用、定位权限和服务频率都可能改变信号与人数的关系。
为了降低春运、寒暑假与节假日流动的影响,研究实际选取 2018 年 3—6 月和 9—12 月的非节假日,先汇总每日定位次数,再取日均。因此,这不是全年每一天、所有时刻都等权纳入的简单全年人口平均。
论文表 1 列明各项数据的不同任务:人口抽样调查提供总量,位置数据提供空间线索,行政区边界帮助匹配;WorldPop、LandScan 用作产品比较,东莞镇级统计则提供更细一级的验证。
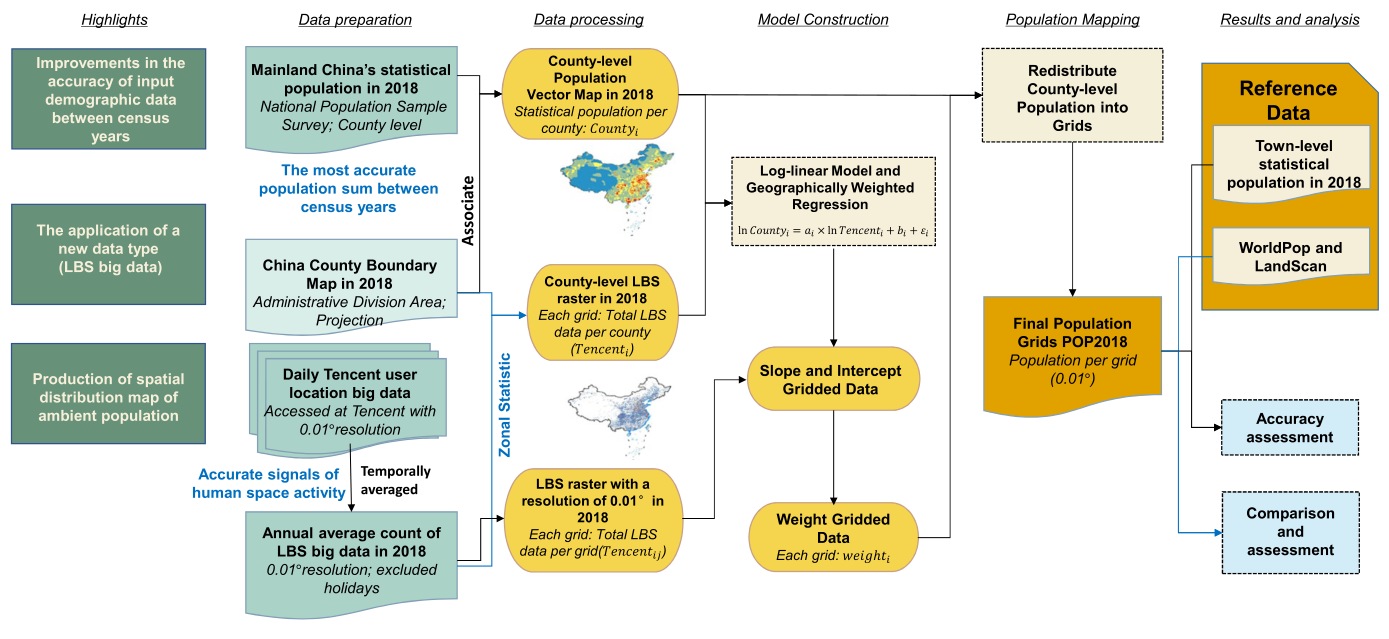
图 1|怎样从县级人口和定位信号,得到细网格人口?
本图没有字母子图。从左至右依次展示研究目标、数据准备、县级与网格数据构建、对数地理加权回归、网格权重及人口分配,右侧连接镇级验证和 WorldPop、LandScan 比较。箭头区分统计总量如何进入模型,以及定位信号如何生成细尺度权重。来源:原论文 Fig. 1。
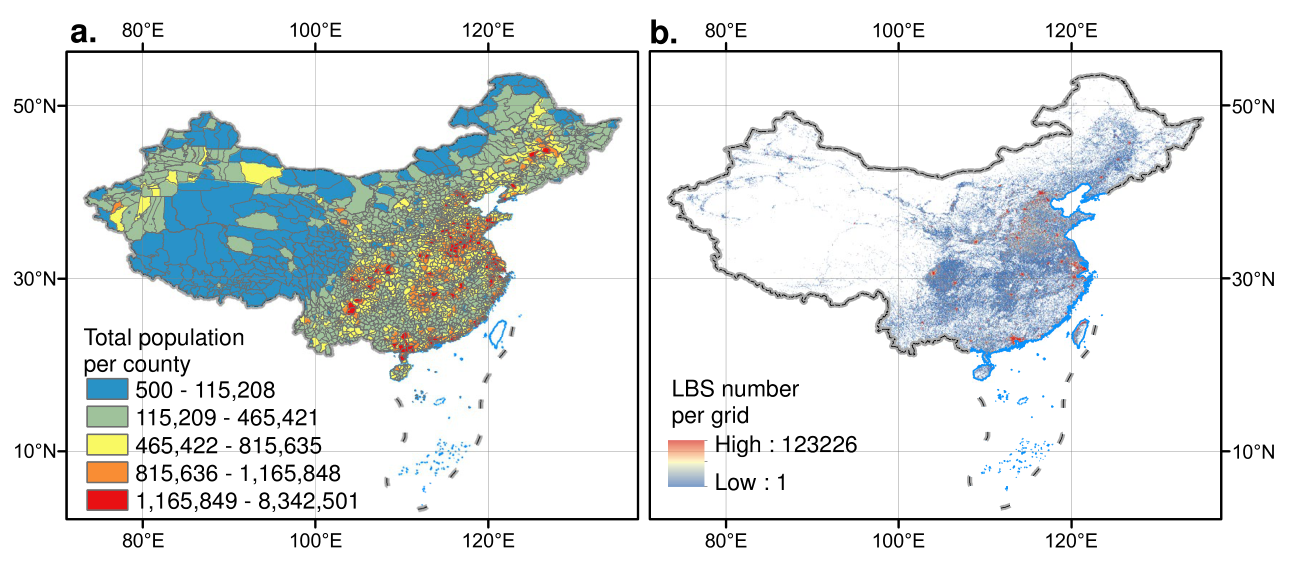
图 2|总人口分布与定位信号,大体指向同样的地方吗?
(a)县级常住人口总数,不是每平方公里人口密度;大县面积与总量都可能影响视觉判断。
(b)网格定位信号数量,深浅表示定位次数多少。两图的空间单元与数量口径不同,相似分布只是建立模型的起点,不能直接证明每次定位都对应一个独立居民。来源:原论文 Fig. 2。
同样数量的定位,在不同地方意味着同样多的人吗?
把各县的定位次数加总后,与县级常住人口比较,原始数值的 Pearson 相关系数为 0.82;两者取对数后,相关系数为 0.90。取对数让数量级悬殊的县可以在相对变化尺度上比较,减弱少数大值对图形的支配。
这里的 0.90 是相关系数 r,并不是解释了 90%的人口,也不是网格准确率。
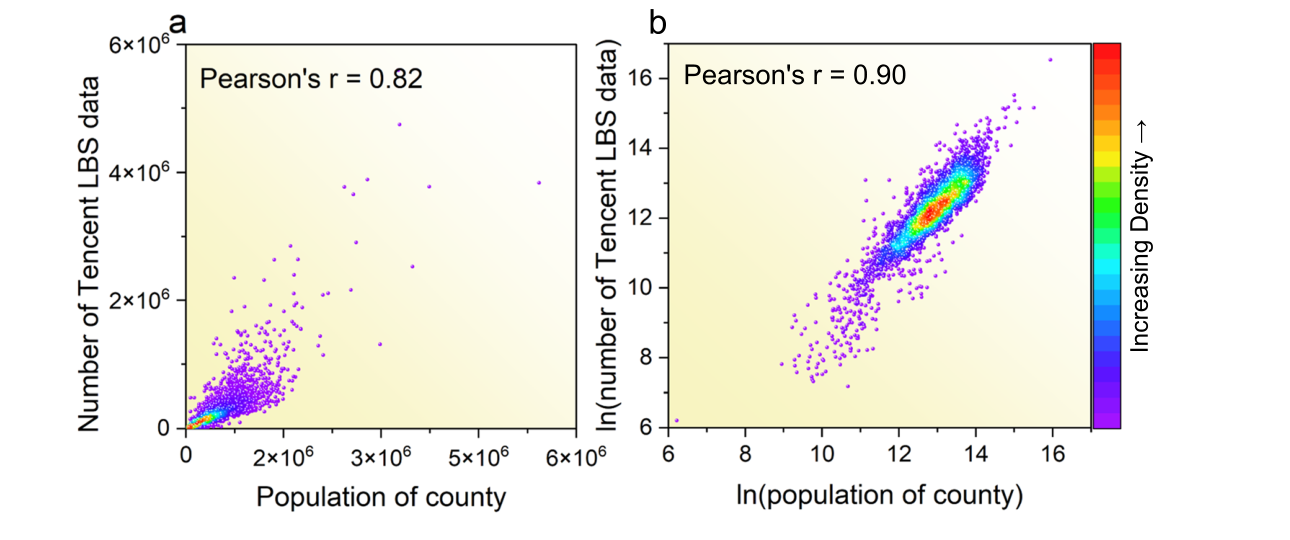
图 3|为什么需要改变比较尺度?
(a)横轴为县人口,纵轴为腾讯定位次数,原尺度下许多县挤在低值区,r = 0.82。
(b)横纵轴分别改为两者的自然对数;颜色表示点云的核密度,暖色处观测更集中,r = 0.90。颜色不是人口数量,也不是定位精度。来源:原论文 Fig. 3。
全国一个回归系数仍可能过于粗糙。位置服务的渗透率、使用强度及城乡差别,会让同样的定位次数在不同地方对应不同人口。研究采用对数地理加权回归(geographically weighted regression,GWR):每个地方的回归参数由附近县的信息估计,允许定位与人口关系随空间变化。
县级拟合的 R² 从普通最小二乘模型的 0.81 提高到 GWR 的 0.91,残差平方和从 426.28 降为 201.78。这个 0.91 评价的是模型对县级输入数据的拟合,与后文东莞镇级检验中的 0.91 是两次不同的比较,不能混为一项独立验证。
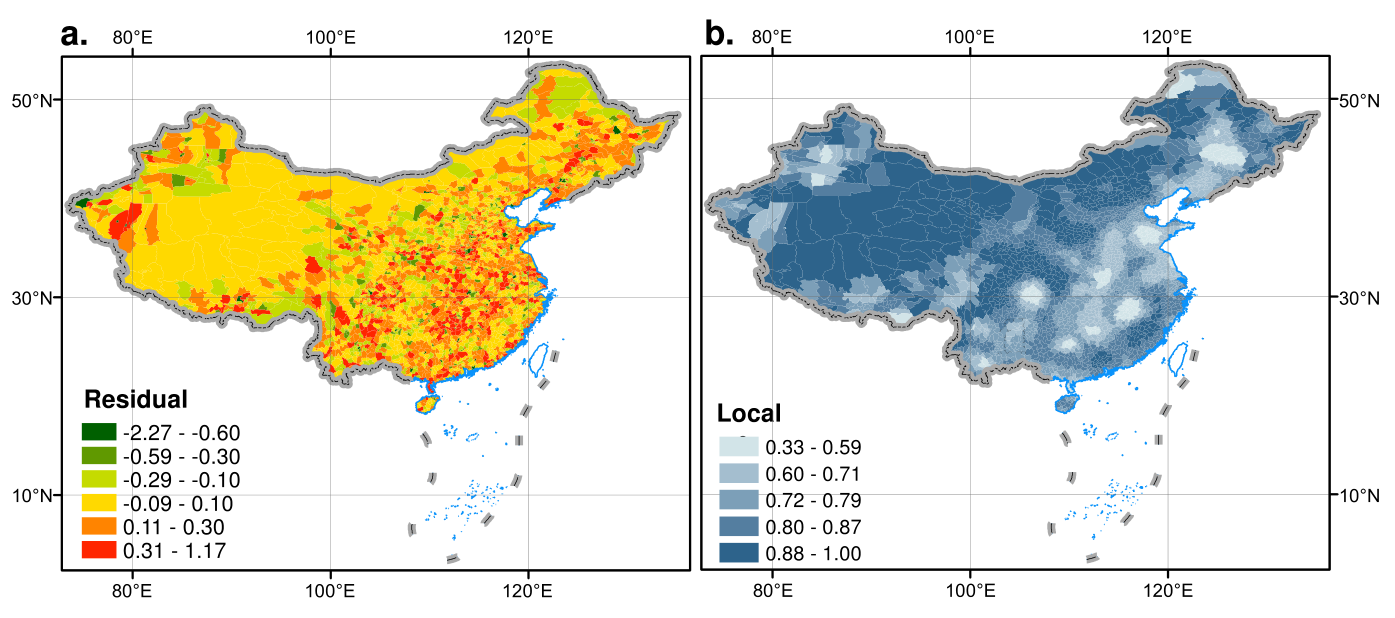
图 4|同一个空间化方法,在全国是否一样可靠?
(a)颜色表示各县回归残差的方向和大小,地图上仍有空间差异;它不是逐网格实测误差。
(b)颜色表示局部 R²,深色处拟合较高。2674 个县的局部 R² 超过 0.6,占全部县的 93.8%。高拟合说明县级关系较紧密,不能单独保证县内每个网格分配正确。来源:原论文 Fig. 4。
把县拆成网格,靠的是一条强假设
模型在县级数据上估计,却要用于县内细网格,关键假设是:同一个县里的网格共享该县的模型参数。将每个网格定位次数代入当地模型,得到一个人口分配权重;然后计算:
网格人口 = 县级统计人口 × 该网格权重 ÷ 县内全部网格权重之和。
这个归一化使县内网格人口之和回到县级统计总量。其好处是总量有统计依据;代价是县内分布仍取决于位置服务信号及跨尺度参数迁移。即使县总人口完全正确,商业中心与住宅区之间仍可能分错。
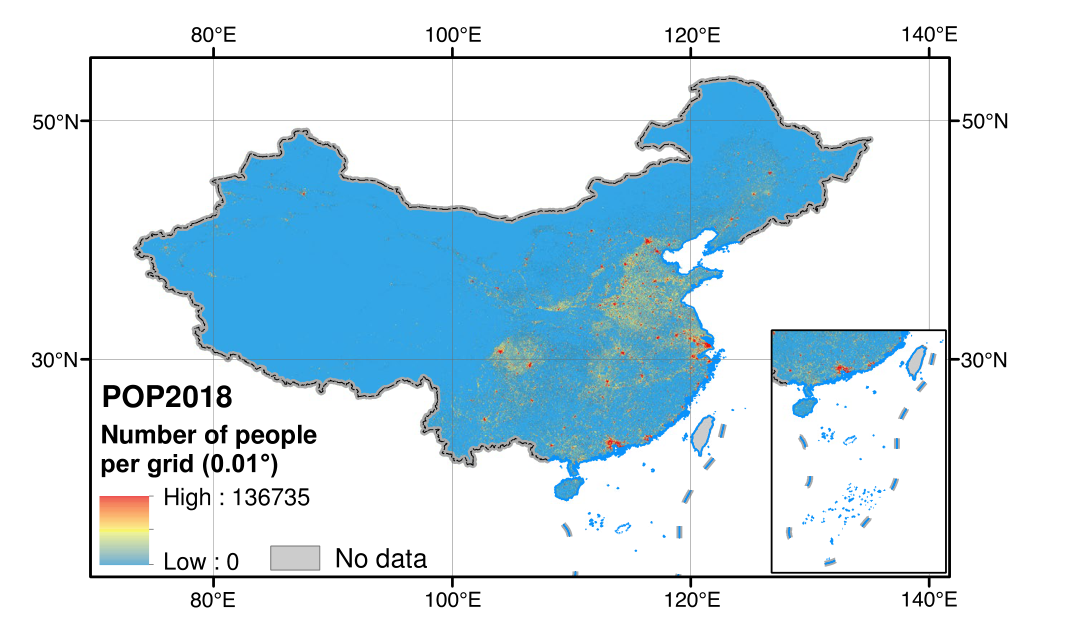
图 5|全国网格图显示了哪些人口集聚?
本图没有字母子图。颜色表示每个 0.01°网格的估计人数,暖色表示较多,灰色表示无数据。东部平原、主要城市群和西部部分河谷、绿洲形成人口集聚;这是一张模型估计的人数图,不能把无数据区当作零人口,也不能把经纬网格直接当成等面积密度格。来源:原论文 Fig. 5。
全国图展示集聚位置,城市放大则能看出核心与边缘的结构差异。论文选取人口超过 500 万的城市群体展示:有些中心与郊区反差更强,有些周边存在较多过渡区域。这样的形态比较是描述,不能只凭图形就推导某城必然拥堵或房价更高。
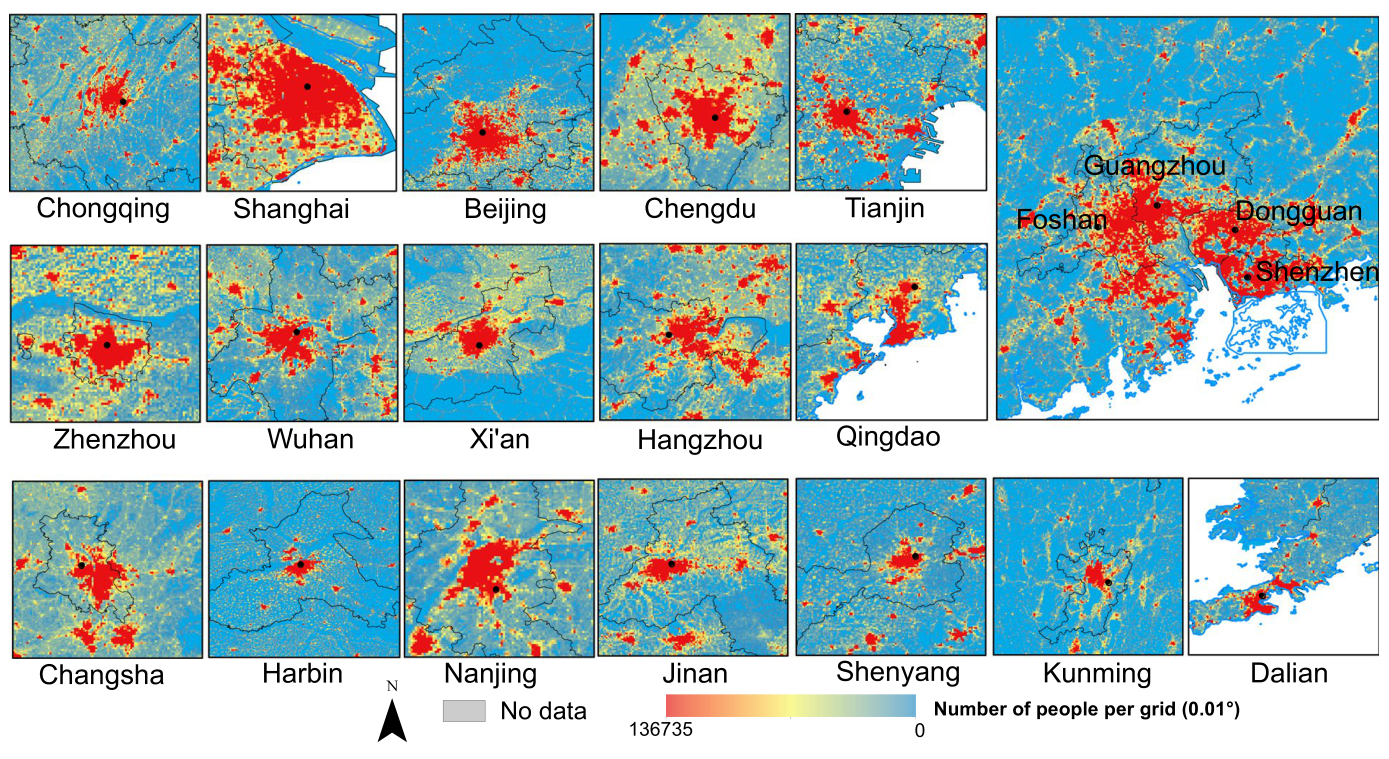
图 6|同样是大城市,人口是否按同一种形态展开?
原图没有字母标号,按标注城市阅读。上排为重庆、上海、北京、成都、天津,右侧较大面板覆盖广州、佛山、东莞与深圳;中排为郑州、武汉、西安、杭州、青岛;下排为长沙、哈尔滨、南京、济南、沈阳、昆明、大连。所有面板使用底部同一网格人数色标,以便比较中心集聚、边缘过渡和周边聚落,但各地地图窗口不等同于相同人口或相同行政面积。来源:原论文 Fig. 6。
哪份人口图更准,要拿更细的统计来比
如果用县总量检验一个本来就被县总量约束的产品,结论会过于乐观。研究因此取东莞 33 个镇的常住人口,把各产品网格汇总到镇域后比较。验证在县级输入以下一个尺度上进行,比再次检验县总数更有说服力。
图 7 横轴是产品估计人口,纵轴是镇级统计人口,均以万人表示。POP2018 回归斜率约为 0.97,接近一比一;LandScan 为 0.79,WorldPop 为 1.14。斜率描述总体关系,仍不能代替逐镇误差分析。
POP2018、LandScan、WorldPop 的 R² 分别为 0.91、0.61、0.89;图示万人尺度下的均方误差(MSE)分别为 22.48、100.91、37.24。MSE 是误差平方的平均,单位随人口单位平方变化,不能写成平均误差 22.48 人,也不是误差率 22.48%。
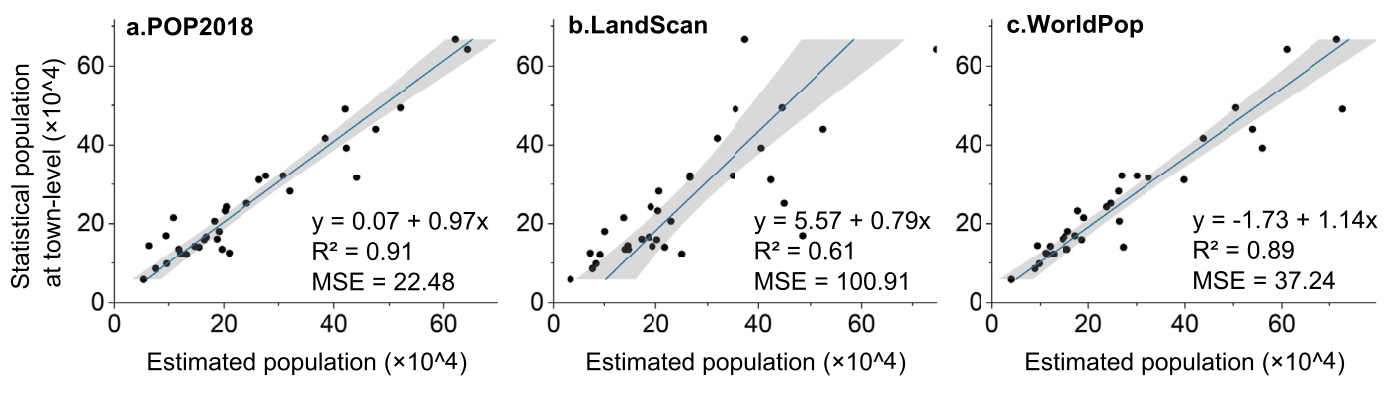
图 7|汇总到东莞 33 个镇,哪一份人口图更接近统计值?
(a)POP2018,R² = 0.91、MSE = 22.48,斜率 0.97。
(b)LandScan,R² = 0.61、MSE = 100.91,斜率 0.79。
(c)WorldPop,R² = 0.89、MSE = 37.24,斜率 1.14。三幅图横轴均为估计人口,纵轴为统计人口,单位均为万人;拟合线及其阴影展示模型关系,点偏离线的方向仍需结合横纵轴理解。来源:原论文 Fig. 7。
POP2018 在这组验证中表现较好,尤其是人口较多的镇;但验证地点集中于东莞。它没有检验全国所有农村、山区、老龄化地区和手机服务使用不足群体。镇级汇总还可能抵消镇内网格的高估和低估,不能直接当作每个像素的准确性证明。
地图看起来更细,并不自动意味着更接近真值
研究进一步选取黄石、西安、上海比较空间细节。三种产品的主要高密度中心大体相近,但高值格的范围与外围聚落分布不同。WorldPop 在西安和上海的高值中心更突出;LandScan 显示更多分散聚落,高值中心格较少;POP2018 呈现介于两者之间的某些特征。
这些差异也受产品目标和输入总量影响。论文采用的 WorldPop 是非约束版本,其人口总量基础与 POP2018 不同;LandScan 面向活动人口。不能把所有差异都归因于某一个算法更好。
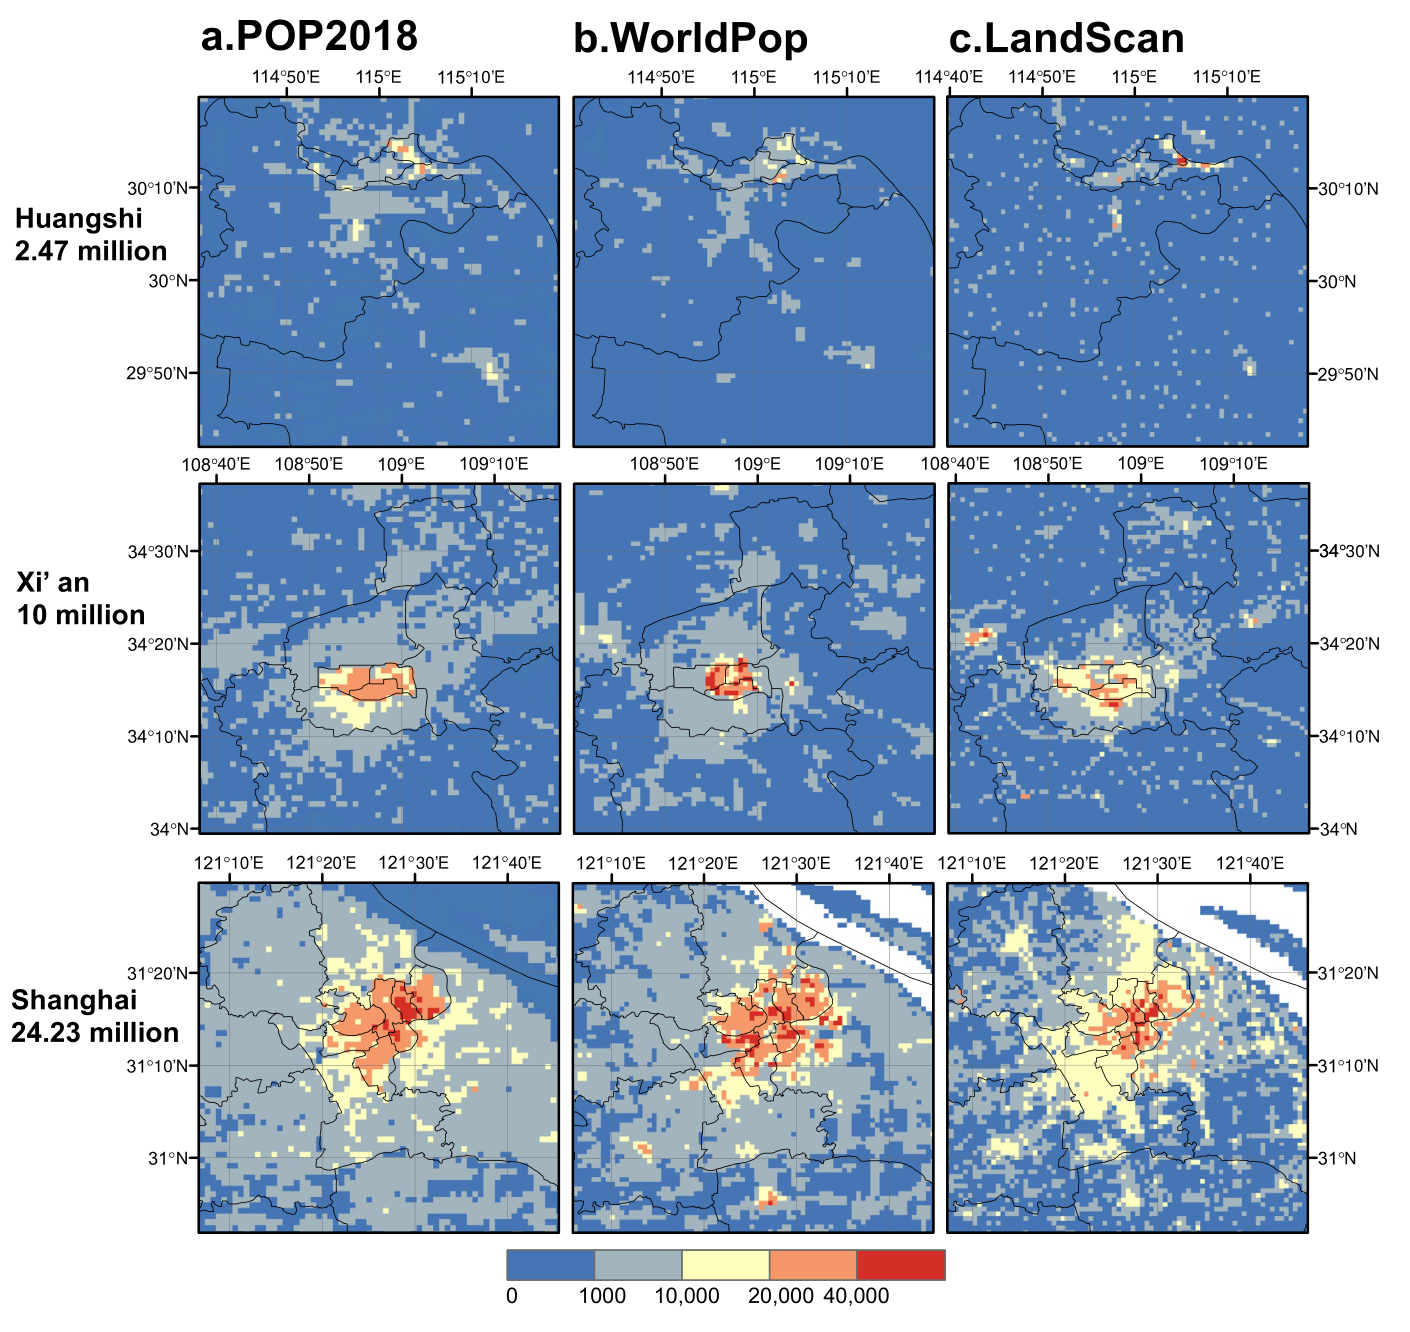
图 8|中心和乡村的不同人口分配,具体出现在哪里?
(a)左列为 POP2018;(b)中列为 WorldPop;(c)右列为 LandScan。上、中、下三行依次为黄石、西安、上海,底部共用色标为每格人数,暖色表示高值。按同一城市横向比较,能看出核心高值格、外围过渡带和分散聚落的不同表达;这张图本身没有提供这些网格的独立实测人数。来源:原论文 Fig. 8。
活动人口与常住人口,最终该怎样理解?
作者将 POP2018 定义为活动人口(ambient population)的时间平均表达,希望反映工作、购物和出行形成的空间分布。然而总量输入来自常住人口,验证也使用常住人口,而定位信号还剔除了部分高流动时段。因此,更稳妥的理解是:用日常活动信号作为空间权重、受县级常住人口总量约束的估计产品。
它既不是纯粹夜间居住人口图,也不是任意一个工作日白天的实时在场人数。论文数据记录部分将网格人口描述为停留半年以上的人口,不能据此认为模型实际跟踪并验证了每个人在该格停留半年;方法中并没有这样的个体居住识别步骤。
文件以 GeoTIFF 等格式发布,包含平均定位、人口网格与关联统计人口的县级边界。论文在投影描述中同时提及 Albers 等面积投影与 GCS WGS84,实际叠加分析前应以文件的坐标参考元数据为准,检查重投影和像元面积。原始 5 分钟定位记录因体量大未全部随归档提供,不能把已公布平均栅格当成可恢复逐日出行的轨迹数据。
一句话总结
手机定位可以帮助把县级人口分配得更细,但细节仍是经过校准和假设得到的空间估计,可靠程度要在目标地区、目标尺度与所需人口定义下重新检验。
核心来源
- Chen, M. et al.(2022)原论文及完整图表,Scientific Data 9, 624。本文图 1—8 均源自该论文。
- POP2018 论文所列数据归档。
- 论文所列处理代码。
作者介绍
以下身份与分工依据论文署名和作者贡献说明。
- Mingxing Chen:署名中国科学院地理科学与资源研究所及中国科学院大学,参与研究设计、组织、解释与写作。
- Yue Xian:署名上述两个单位,参与数据收集、模型构建、分析及论文写作。
- Yaohuan Huang:署名中国科学院地理科学与资源研究所,参与研究框架与稿件修改。
- Xiaoping Zhang:署名中国科学院大学资源与环境学院,参与稿件评论与修改。
- Maogui Hu:署名中国科学院地理科学与资源研究所,为通讯作者,参与设计、数据收集、建模与分析。
- Shasha Guo:署名中国科学院地理科学与资源研究所、中国科学院大学及中国建筑科学研究院城乡规划研究机构,参与数据收集、解释和写作。
- Liangkan Chen:署名中国科学院地理科学与资源研究所及中国科学院大学,参与数据收集、建模和分析。
- Longwu Liang:署名中国科学院地理科学与资源研究所及中国科学院大学,参与数据收集。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一张人口图用于不同决策,可能需要不同答案。配置社区养老服务时,常住居民的年龄与住所很重要;估计商业区白天的高温暴露时,工作和购物人口更重要。若把活动信号分配的产品无差别用于两者,即使全国总人口完全正确,也可能把服务资源配错地方。
一个可以检验的方法是,在少数有独立资料的城市,分别用夜间居住、工作日白天在场和全年平均三种目标人口做验证,再比较定位权重在哪些场景更有优势。研究问题也应从哪张图最准确,推进到哪张图对这个具体决策更准确。只有明确目标,地图中商业中心的一个高值,才知道是在修正传统人口图,还是引入了新的用途偏差。