猜中你还坐在原处,算不算已经看懂你的下一站?
论文名片|Edin Lind Ikanovic、Anders Mollgaard,An alternative approach to the limits of predictability in human mobility,EPJ Data Science,6,12,2017。DOI。
假设你在图书馆待了一下午。每隔 15 分钟问一次你在哪里,一个始终回答图书馆的程序就能连续猜中。但等到你真正离开,它能知道你去食堂、宿舍,还是朋友家吗?这两个问题,可能给出差距很大的预测成绩。
这篇研究用哥本哈根学生的长期定位数据,把停留造成的重复与地点间转换分开。它说明,所谓人类移动高度可预测,首先要问预测的是什么;去掉连续停留以后,下一地点的估计上限约为 71%,而非九成以上。
先说结论
- 预测下个时间格的位置,强烈依赖时间格和空间网格的大小。时间格越短,或者空间网格越大,猜仍在原处就越容易成功。
- 在 60 分钟、约 1.7 公里网格的一个对照设置中,原地不动预测器达到 88.3%,信息论估计上限为 95.5%;高分中很大部分来自区域没有改变。
- 把轨迹改为连续不同的停留地点序列后,下一站估计上限平均为 71.1%,一阶马尔可夫基线平均为 39.8%。前者不是已经训练出来的预测器成绩。
- 结果来自筛选后的 604 名学生,仍依赖定位、停留识别、地点聚类与缺失修正;71% 不能直接成为所有人、所有移动任务的固定常数。
多年的记录,也并不等于没有缺失
数据来自 Copenhagen Networks Study。该项目涉及约一千名学生,为参与者配发手机,记录多个渠道;本文主要分析由 GPS 与所连接网络共同确定的位置。2012 年 2 月至 2015 年 3 月期间,849 人拥有可用定位,合计约 2.4 亿个数据点,每个点含时间、经纬度和精度信息。
但原始点数很多,不能保证每个时间格都有位置。研究将未知时间格比例记为 qmin,仅保留缺失不超过 50% 的参与者,最终分析 604 人。这个门槛来自后面的缺失修正检验,也意味着结果描述的是记录相对充足的学生样本。
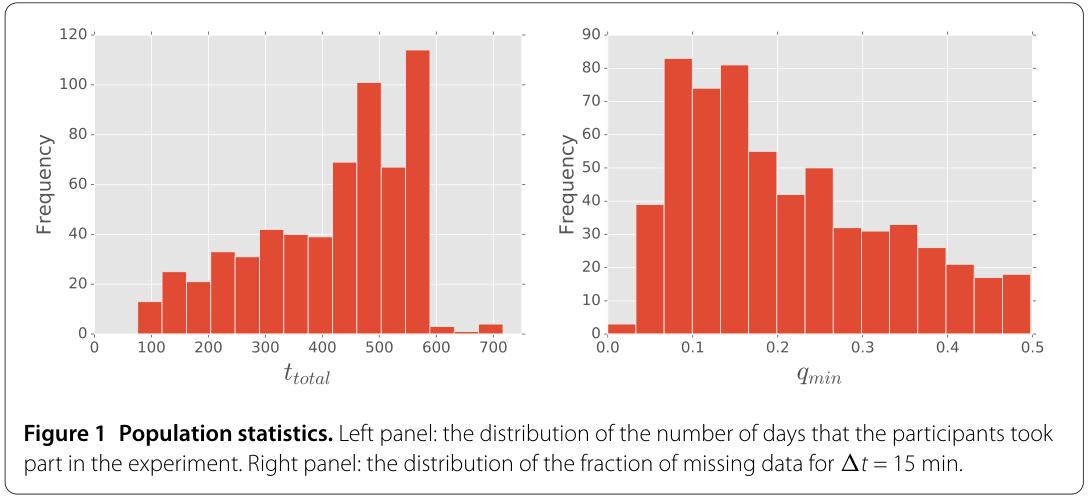
图 1|长期观测到底有多完整?左图横轴为参与观测的总天数、纵轴为人数频数,不少参与者超过一年;右图横轴为 15 分钟时间格中的缺失比例 qmin,纵轴也是频数。右图保留到 0.5,但每个人缺失程度不同,不能把全部轨迹当作完整记录。两面板原图整体保留。来源:原论文 Fig. 1。
同一条轨迹,为什么会得到不同的可预测性?
第一种编码沿用固定时间格:先把地理空间划成方格,以 A、B、C 表示区域,再把时间划成等长区间,每格记录出现次数最多的区域。若多个区域并列则随机选一个,没有观测则记为问号。
例如,A、B、B、A、A、A、C 表示人在 B 连续停了两格,在 A 又连续停了三格。这样的序列同时包含两件事:在一个地方待多久,以及离开后去哪里。
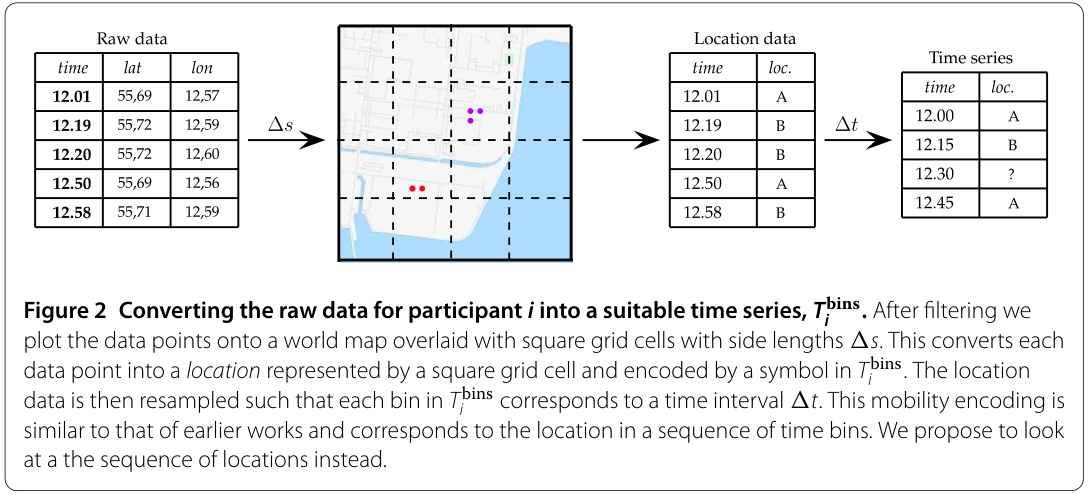
图 2|经纬度怎样成为可预测的符号序列?从左到右,原始时间—坐标表先映射到中间的空间网格,再转成地点符号,最后按固定时间间隔重采样。图中问号表示没有观测的位置,重复的 B 则保留停留信息。Δs 控制空间格边长,Δt 控制时间格长度。来源:原论文 Fig. 2。
研究测试 100、200、400、800、1,600 米的空间格,以及 15、30、60、120、240 分钟的时间格。网格以多数学生所在的丹麦技术大学附近为参考,并为每人添加随机平移,减少固定格边恰好切开某些地点的影响。
在时间很短的极限下,大多数人还没离开原区域;空间格很大时,即便走了一段,也可能仍在同一个格子。于是,预测下一格在哪的上下界都可能接近 1。高可预测性未必需要理解具体目的地。
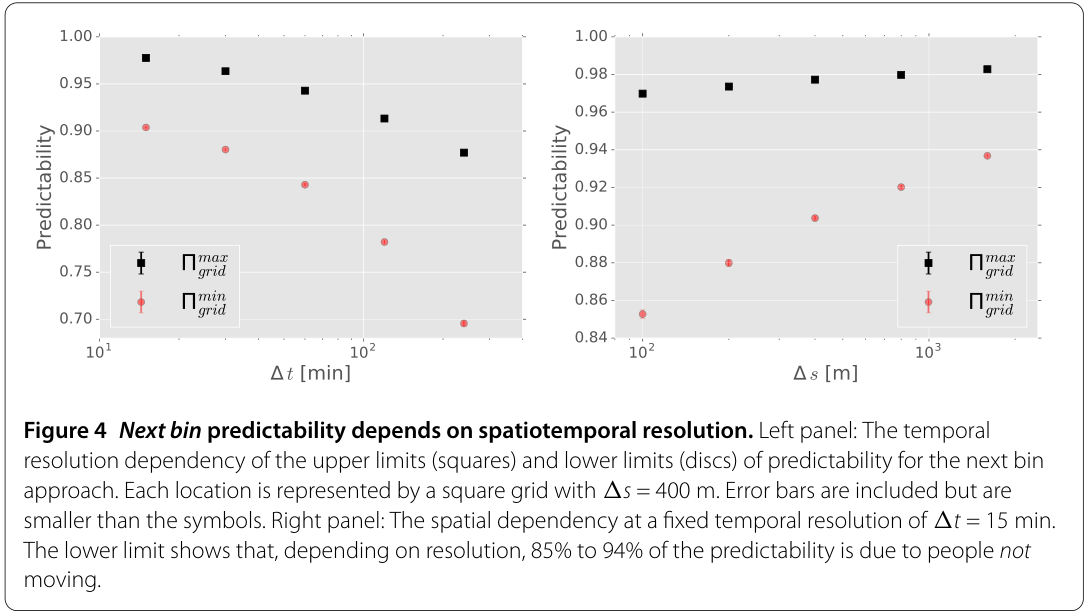
图 4|把时间格缩小、空间格放大,会发生什么?左图固定 400 米空间格,横轴为分钟数,黑方为估计上限,红点为始终预测原区域的基线,时间格越短两者越高;右图固定 15 分钟时间格,横轴为网格边长米数,空间格越大,两者越高。纵轴均为预测成功比例。两图未标面板字母,按原左右位置解释;误差线保留。来源:原论文 Fig. 4。
原地预测器在左图不同时间尺度约有 70%—91% 的成功率。在与既有研究近似的 60 分钟、约 1.7 公里设置中,本文报告原地基线 88.3±3.8%,上限 95.5±1.8%。二者相差约 7.2 个百分点。这里的 ± 沿用论文报告方式,不将它另解释为单次预测的误差或百分之九十五置信区间。
这没有否定预测停留时长的价值。它提醒我们:如果真正关心的是下一站,不能只用包含大量重复停留的总分来评价。
去掉停留重复以后,地点该怎样定义?
第二种编码先识别停留,再识别地点。研究采用 50 米定位精度门槛筛选记录;对相隔约 15 分钟、容许偏差 1.5 分钟且距离少于 100 米的两次观测,取平均位置作为一段停留的代表。这样会去掉大部分移动过程,但堵车和等公共交通仍可能被保留。
随后用密度聚类 DBSCAN 寻找经常停留的位置簇。邻域半径设为 5 米,最低点数设为 4。四个停留代表点在本文处理下对应累计约一小时;这个时间可以分散在整个观测期,并不要求一次连续待满一小时。
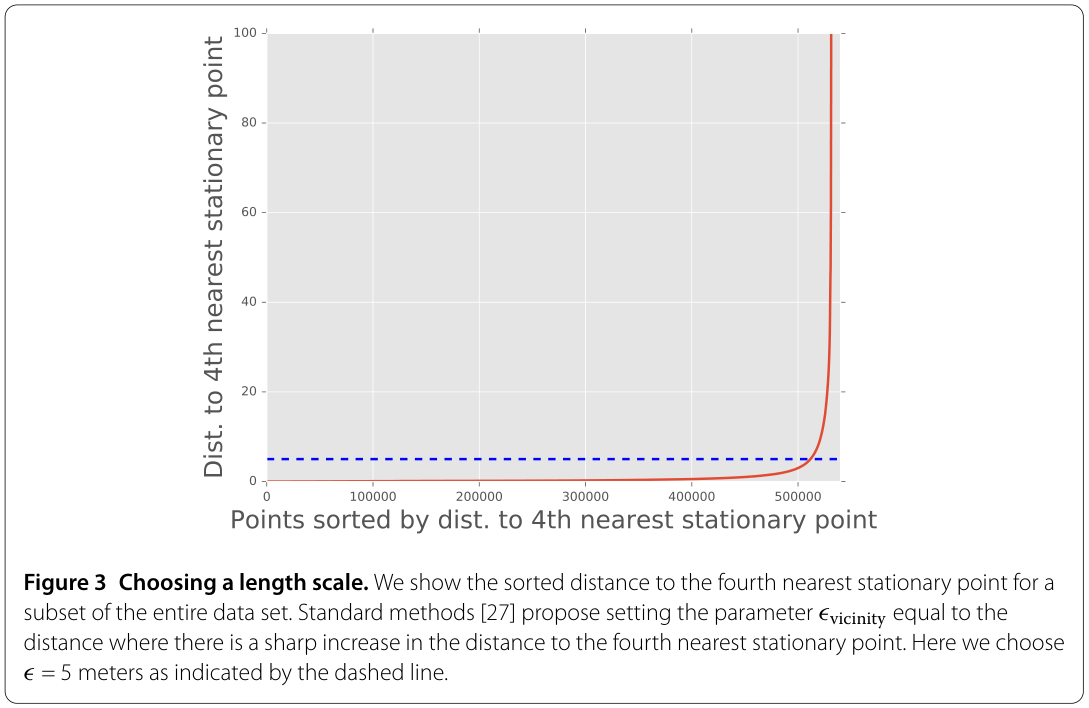
图 3|5 米邻域半径从哪里来?横轴是按到第四近停留点距离排序的点,纵轴是该距离;红线在末端快速升高,蓝色虚线标出选用的 5 米尺度。它为这一批数据的密度聚类提供依据,并不代表手机测量误差只有 5 米,也不要求一个地点簇的总直径必须小于 5 米。来源:原论文 Fig. 3。
地点聚类比固定大网格更贴近反复停留的位置,但依旧是算法定义。DBSCAN 还允许密度相连的点形成延展的簇,所以邻域半径与整个地点的尺度不能简单画等号。
最后把连续重复符号压成一次到访:A、问号、A、B、B、A、A、A、C 会变成 A、B、A、C。现在每个符号对应一次不同地点的访问,序列不再给长停留反复计分。
论文称这种表示不依赖时间尺度,条件是采样足够细。实际仍用 15 分钟识别停留,作者认为更细采样会受到定位精度限制。因此,时间无关应理解为不再以重复时间格计算下一站,而不是任意稀疏采样都能得到同一结果;短暂停留也可能漏掉。
71% 是怎样算出来的,又不是什么?
研究先估计符号序列的熵率(entropy rate),即知道既有历史后,下一个符号还剩多少不确定性。使用的是基于 Lempel–Ziv 压缩的估计器:序列中重复结构越多,可压缩程度通常越高,不确定性也越小。
再把熵率和地点数量代入 Fano 关系式,求出在该序列表示与估计前提下的最大可预测比例。它是一条估计上界:说明历史中理论上可能包含多少可利用信息,不等于已经有算法能达到这个数,也不能保证有限样本、非平稳行为下仍严格适用。
下方的可实现参照则来自一阶马尔可夫模型。它只问当前地点之后,历史上最常出现哪一站;遇到之前没见过的当前地点,则退回最常访问地点。这种参照的成绩可被更强算法超过,不能理解成所有算法必然达到的数学下界。
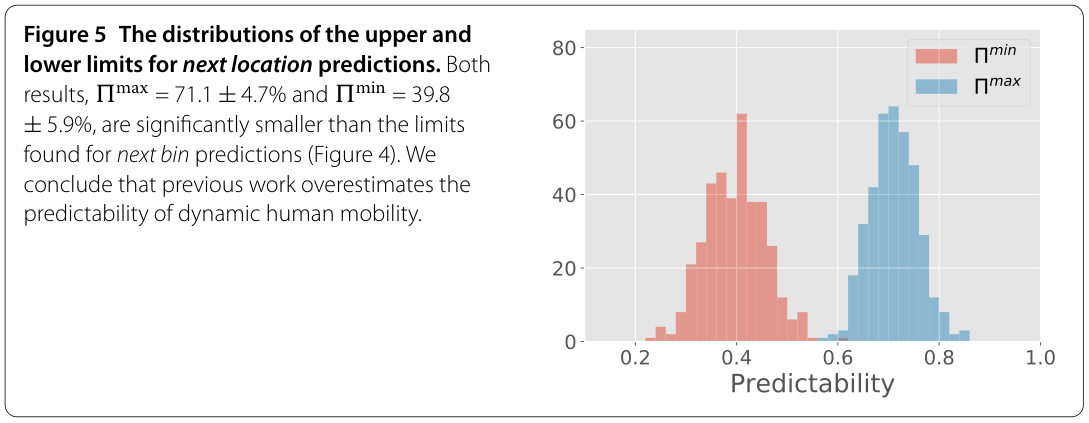
图 5|真正换了地点以后,下一站还能有多好猜?右侧直方图横轴为下一地点预测比例,纵轴为人数频数;蓝色分布是信息论估计上限,红色分布是一阶马尔可夫基线。前者平均约 71.1%,后者约 39.8%,两者明显分开。左侧原图文字给出论文报告的相应 ± 范围,完整图框整体保留。来源:原论文 Fig. 5。
71.1% 和 39.8% 相差约 31.3 个百分点,提示简单的一阶转移尚未用尽序列中的历史结构。但差距不等于某个未来模型必定能兑现的提升;熵率估计与上界计算本身也带有不确定性。
将聚类邻域半径从 5 米增至约 25 米,上限只改变几个百分点。论文还引用另一组用同一数据、不同聚类参数得到约 0.68 的结果,作为相近证据。那不是另一个独立人群的重复验证,不能据此认定各国居民都满足同一上限。
缺失、出行范围和性格,会怎样影响这个数字?
缺失数据会改变熵率估计。研究从 47 名拥有至少两周完整记录的参与者中取序列,人为移除记录,再检验外推。缺失比例不超过 50% 时,熵率估计可在完整序列值的约 ±10% 内。这个 ±10% 指熵率恢复误差,不是 71.1% 上限的直接置信区间;人为缺失实验也不保证能覆盖所有真实失联方式。
修正方法比较熵率与忽略先后顺序的普通熵之比,用带偏置的指数形式拟合其随缺失率的变化,再外推到没有缺失时。不同缺失模式可能影响外推,所以筛选门槛和检验范围都是结果的一部分。
Table 1 进一步比较个人差异:
| 指标 | 与下一地点估计上限的相关系数 | 可以支持的解释 |
|---|---|---|
| 回转半径 r_g | −0.05±0.05 | 这批样本中,活动距离范围与上限关联较弱 |
| 有效地点数 | −0.26±0.05 | 地点选择越分散,通常越难预测 |
| 一阶马尔可夫基线成绩 | 0.49±0.04 | 简单模型表现较好者,上限也倾向较高 |
| 外向性 | −0.13±0.05 | 存在较弱负相关,不能据此判断个人行为或因果 |
有效地点数是按访问比例的熵计算的 2 的幂,兼顾地点数量与访问是否均匀,并非原始不同地点数。表中的误差由自助抽样估计。宜人性、尽责性、神经质和开放性的相关分别约 −0.05、0.04、0.06、−0.004,论文没有把它们报告为显著关联。
这是一组关联分析,涉及多个心理指标,也未呈现因果设计。外向性可能伴随更分散的活动、社交机会或其他未测因素;不能把微弱相关写成性格决定一个人是否可预测。学生样本、记录完整性筛选和地点定义共同限制了推广范围。
一句话总结
高位置预测分数可能主要来自人还没离开;把任务限定为下一次不同地点访问后,估计上限显著降低,而这个上限仍必须连同数据、地点定义与缺失处理一起理解。
核心来源
Edin Lind Ikanovic, Anders Mollgaard. An alternative approach to the limits of predictability in human mobility. EPJ Data Science, 6, 12, 2017。论文与 DOI。本文依据全文及方法部分;Fig. 1—5 全部保留完整原图,Table 1 的相关分析在正文解释。
作者介绍
- Edin Lind Ikanovic:论文署名为丹麦哥本哈根大学尼尔斯·玻尔研究所,参与研究设计、数据分析和论文写作。
- Anders Mollgaard:论文署名为丹麦哥本哈根大学尼尔斯·玻尔研究所,列为通讯作者,参与研究设计与论文写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
评估一个位置预测系统,可以同时报告三个结果:全部时间格的命中率、发生地点变化时的命中率,以及停留时长的误差。这样既保留停留预测的实际价值,也能看见系统是否只靠重复当前区域获得高分。
如果服务需要发现短暂停留,例如取快递或换乘,这篇研究的停留筛选可能恰好移除了最相关的目标。可以先按业务定义最短停留时长,再对同一批轨迹重算地点、缺失与上限。值得追求的不是一个到处适用的可预测性常数,而是目标明确、可比较的任务定义。