一条规则,能同时解释你去哪里,以及城市之间流动多少人吗?
论文名片|Xiao-Yong Yan、Wen-Xu Wang、Zi-You Gao、Ying-Cheng Lai,Universal model of individual and population mobility on diverse spatial scales,Nature Communications 8,1639,2017 年 11 月 21 日发表。DOI。
假设两座城市人口相近,一座是你已经去过许多次的老地方,另一座从未去过。对你个人而言,熟悉程度会影响选择;把千百万人的移动加起来,人口分布、空间距离与机会竞争又会影响城市之间的流量。
只解释个人习惯,未必能生成合理的城市流量;只把城市人口和距离代入公式,也未必能生成一个人反复离开、返回、探索的轨迹。这篇论文尝试把两种作用写进同一条转移概率,以同一套机制同时生成个人序列和群体流动,并跨不同空间范围检验。
主要发现有四点:
- 目的地吸引力由个人访问记忆与人口竞争共同决定;每套数据分别校准一个记忆强度参数,未使用一套数值包办所有地区。
- 模型能同时重现四国数据中多种个人与群体统计,还能生成常见的闭合出行模体;补充材料将检验延伸到纽约市内。
- 去掉记忆后,个人探索增长偏快;去掉人口竞争后,城市间流量相似度明显下降。两部分分别承担不同任务。
- 所谓统一,是一套机制跨层级、跨尺度可用的证据,不是所有指标都最好,也不是仅凭人口就完成无需轨迹校准的未来预测。
为什么需要同时看个人与群体?
传统引力模型根据出发地人口、目的地人口和空间距离描述两地间流量,很适合刻画聚合网络。但一个人会不会回到原来的城市、过去去过哪里,通常不直接出现在这样的静态流量公式里。
个体移动模型则常把选择分为探索和返回:去过的地方越多,探索新地点的概率越低;返回时更偏向常去地点。这类机制能产生访问频率不均和缓慢扩张的个人活动范围,却未必自动得到正确的城市间流量。
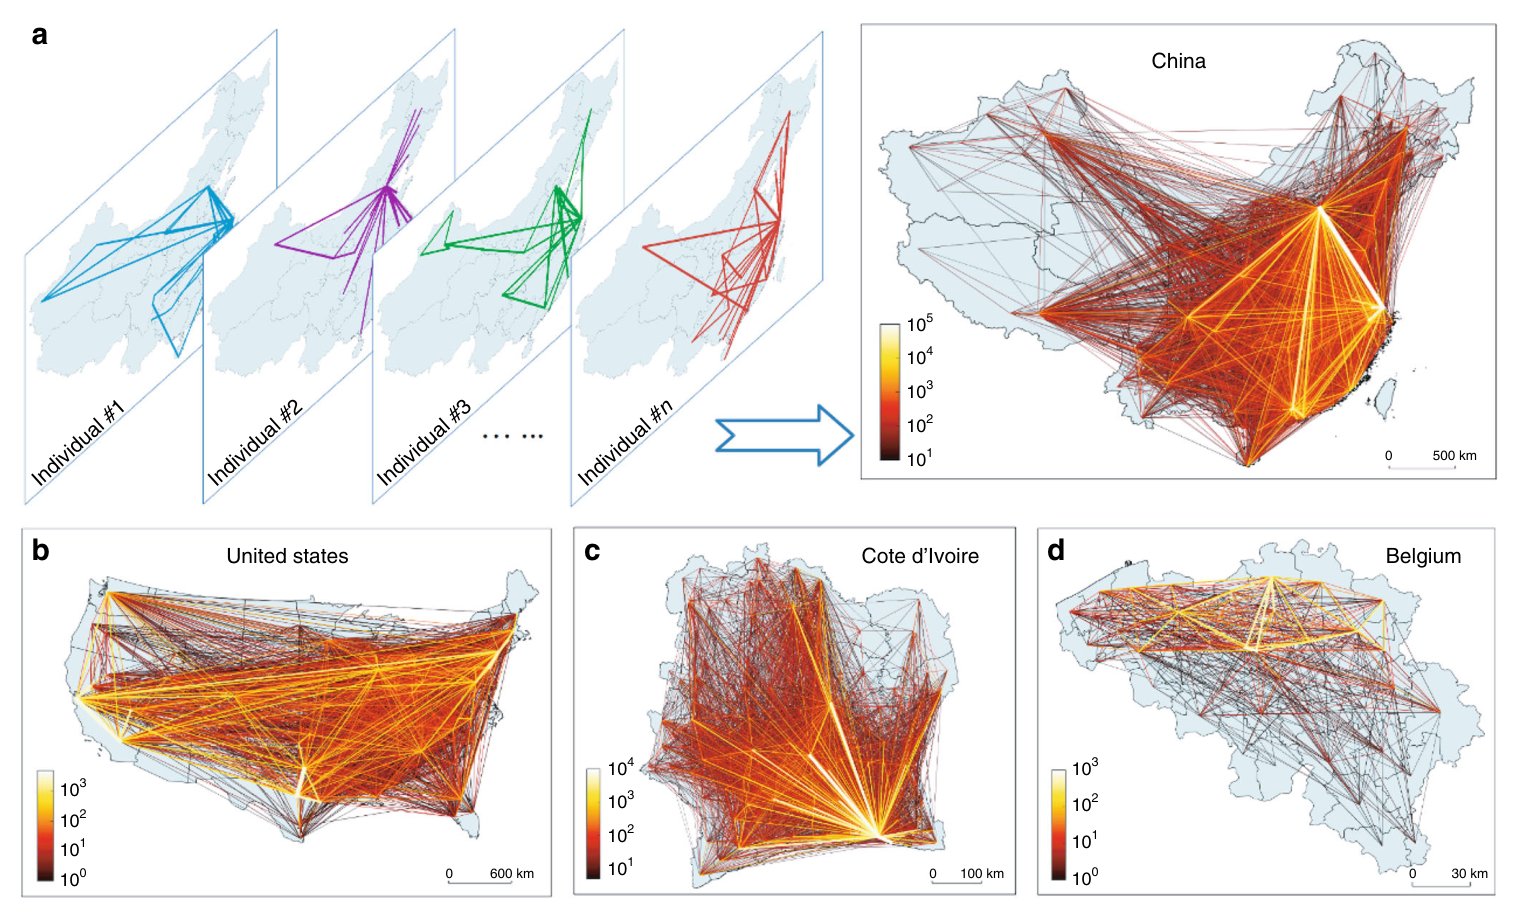
图 1|一批个人路径,如何成为不同空间范围的流量网络?(a)左侧展示中国大陆数据中的几条个人轨迹,右侧将个人移动聚合为城市间流动。(b)美国本土 48 州,(c)科特迪瓦,(d)比利时。连线颜色对应流量强弱,越亮越强;各面板有自己的色标和距离比例尺,不能用同一颜色直接比较各国绝对流量。这组图说明模型需要同时面对个人序列和聚合网络,以及不同空间跨度。
研究使用的四套数据如下。表中人数是数据里的用户规模,不是国家总人口;一次从一个城市移动到另一个城市算一个移动步。
| 地区与来源 | 地点数 | 用户数 | 移动步总数 | 拟合记忆参数 λ |
|---|---|---|---|---|
| 中国大陆,新浪微博签到 | 340 | 1,571,056 | 4,976,255 | 35 |
| 美国本土 48 州,Foursquare 签到 | 125 | 32,040 | 194,730 | 32 |
| 科特迪瓦,手机通话记录 | 237 | 229,335 | 8,747,801 | 50 |
| 比利时,Gowalla 签到 | 43 | 1,352 | 21,156 | 25 |
签到位置在城市内被归为同一地点;科特迪瓦数据覆盖五个月,按县定位,再以县的中心城市表示个人位置。记录反映被平台或通信事件观察到的移动,不是完整连续出行。不同平台的使用人群、主动签到倾向、观测频率与行政单元大小都可能影响比较。
地点的吸引力怎样同时包含记忆与竞争?
模型给每个目的地两部分权重。
第一部分是个人记忆。尚未访问的地点吸引力为 1;已经访问的地点 j,吸引力为 1+λ/rj。其中 rj 是这个人第一次发现该地点的次序:最早发现的地点 r=1,第二个 r=2,依此类推。λ 越大,旧地点相对新地点越有优势。
这个细节十分关键:r 不是实时访问次数排名,也不是最近访问排名。一个地点一旦被发现,它的发现次序就不会因之后多去几次而改变。作者用“越早发现的地点通常越常去”的老化效应近似联系两者,这是一项建模假设。
第二部分是人口竞争。目的地 j 的人口 mj 越多,吸引力越高;但目的地周围的竞争人口 Wji 越多,权重就越低。正文定义 Wji 为以目的地 j 为圆心、以 i 与 j 间距离为半径的圆内人口。
把两部分相乘,得到未归一化权重:
pij ∝ (mj/Wji) × (1+λ/rj)。
对所有可选目的地归一化,才得到从当前地点 i 出发的选择概率。它把人口竞争作为机会可得性的代理,没有直接模拟求职排队、住房争夺或人与人的谈判过程。
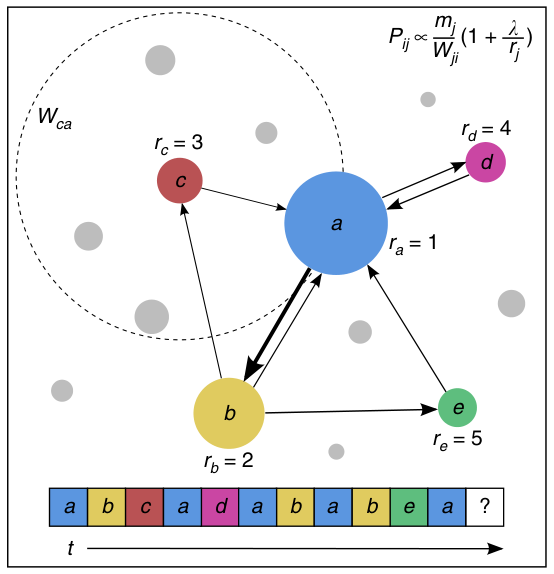
图 2|下一站由哪些信息决定?这张无子图字母的图用 a–e 表示五个地点,底部是访问序列;不同颜色用于区分地点,圆的大小表示吸引力,ra=1 至 re=5 表示发现次序。箭头展示移动,右上角给出记忆项与人口竞争项相乘的概率权重。复用公式时要注意:正文对 Wji 的定义以目的地为圆心,而原图及英文图注画出的 c→a 圆以 c 为中心,二者不一致;这里按正文公式定义解释,不能直接照示意圆实现。
一个参数,实际怎样确定?
模型每套数据只校准一个自由参数 λ,但并非完全不使用轨迹信息。
由于数据没有直接提供居住城市,研究把每个人签到最频繁的城市当作家,并用作模拟起点。每个人模拟多少步,则从经验轨迹长度分布 P(L) 抽取。λ 通过拟合经验数据中的 S(t) 确定,S(t) 表示移动 t 步后累计访问过的不同地点数。
拟合目标是各步模型与数据在 S(t) 上的相对绝对误差之和。四套数据分别得到 λ=35、32、50、25,随后固定该参数,再比较其他移动统计。方法部分还报告,用返回间隔或访问频率估计 λ 时,预测效果差别不大。
因此,S(t) 是参数校准目标,对它的贴合应按拟合理解;其他统计的吻合提供额外检验,但论文没有划分独立未来测试期,不能等同于在未见时间段预测每个人下一站。
作者讨论 λ 与人均 GDP 的关系,认为较高收入可能使旅行更容易、熟悉偏好更弱。但这里只有四套来源和尺度都不同的数据,美国与比利时的数值也不构成严格单调关系。这是解释性推测,不能当作收入决定记忆强度的因果结论。
生成的个人轨迹,是否只在一个指标上像真的?
个人层面要同时回答三件事:活动范围扩张得多快、多久回到一个旧地点、访问是否集中在少数地点。
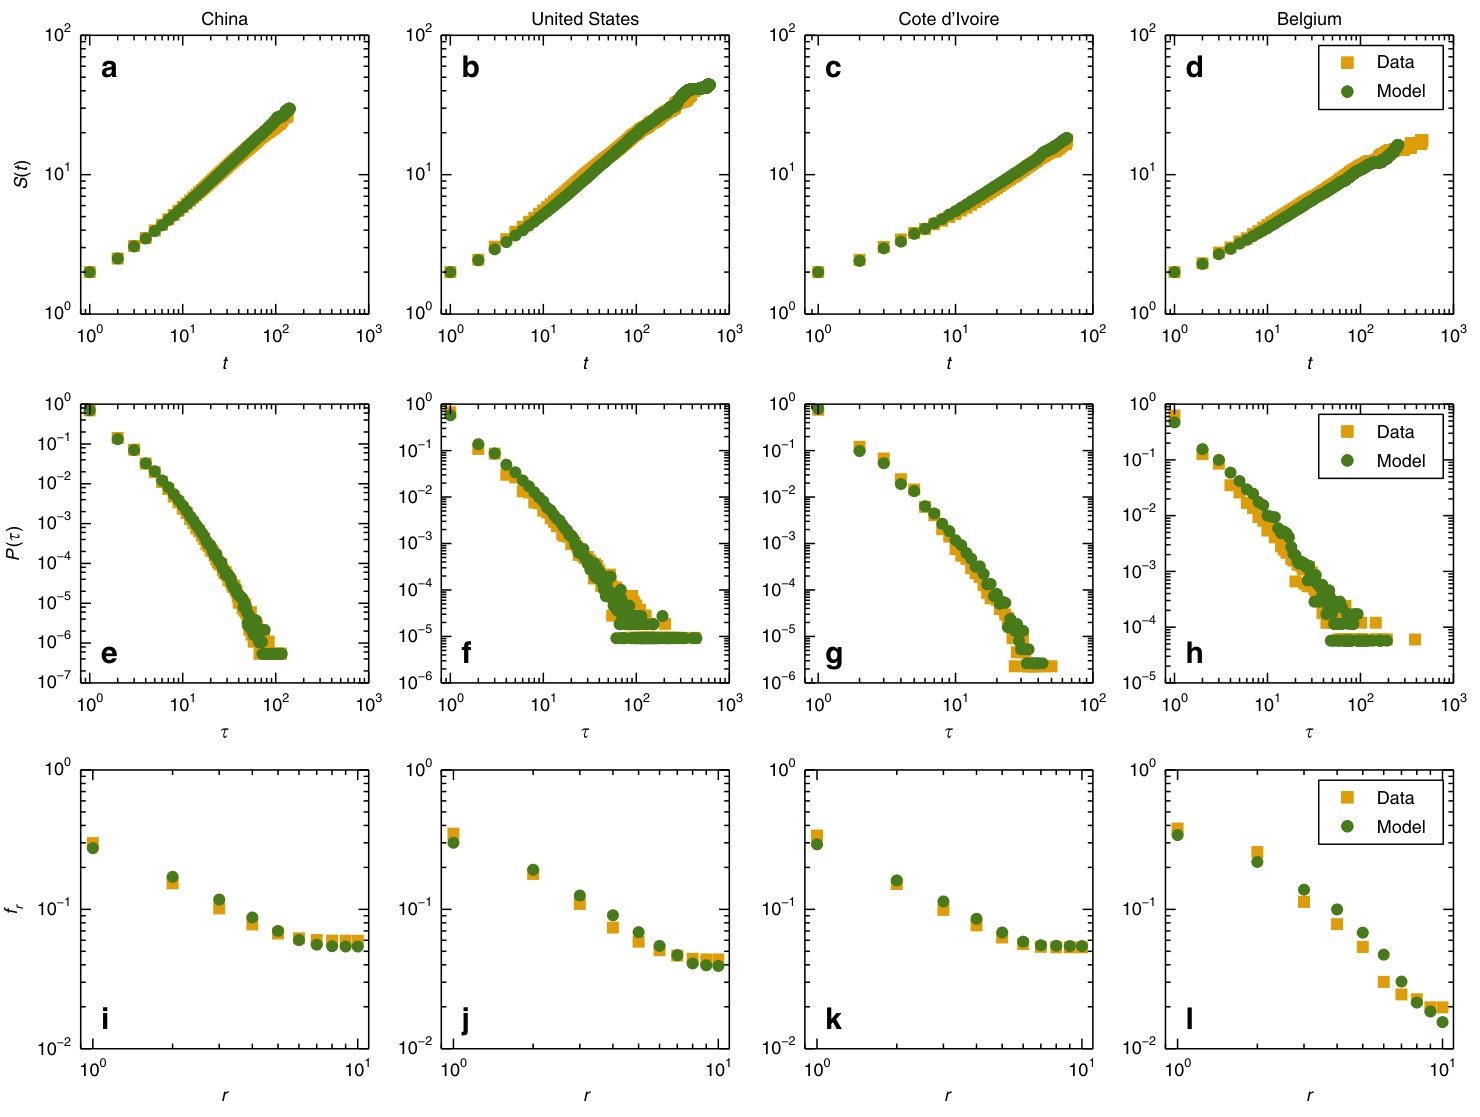
图 3|一个参数能否兼顾三种个人统计?四列依次为中国、美国、科特迪瓦、比利时,橙色为数据,绿色为模型。(a–d)横轴移动步数 t,纵轴不同地点数 S(t),是 λ 的主要拟合目标。(e–h)横轴为两次访问同一地点之间的步数 τ,纵轴为返回间隔概率 P(τ),不是小时或天。(i–l)横轴为频率排名 r,纵轴为该排名地点的访问频率 fr,检验少数常去地点是否占较大份额。整体相近、尾部仍有偏差,尤其稀少长间隔处不能理解为逐人精确预测。
这里还有两个不同的 r:生成规则中的 rj 是发现次序,图中 fr 是访问频率排名统计。模型希望发现次序产生的吸引力差异,最终能够形成接近经验的频率排序,而不是把经验频率排名原样塞给每一步模拟。
仅有三条分布还不够,真实路径有反复出现的结构。研究把从家出发、最终返回家的连续地点序列概括成出行模体(trajectory motif),也就是不看具体城市名称、只看访问连接模式的小图。
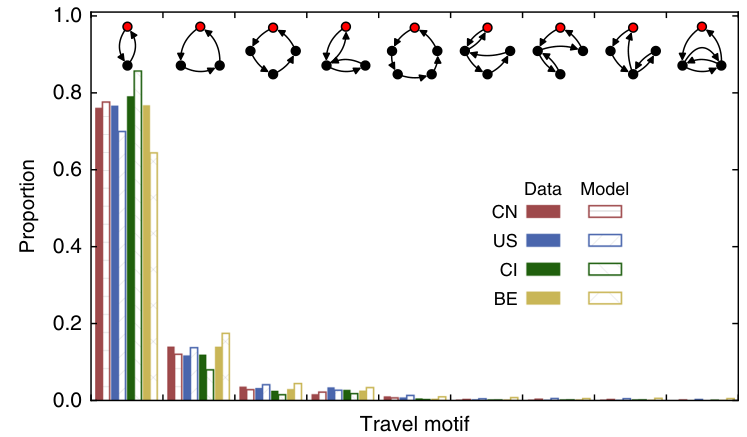
图 4|模型是否也能产生常见的出发—返回结构?这张无面板字母的图在上方列出九种模体,红点表示家,黑点为其他地点,箭头表示移动方向。下方横轴依次对应这些模体,纵轴为出现比例;CN、US、CI、BE 的实心柱为四国数据,空心柱为模型。两地点往返最常见,其余复杂结构比例依次降低,模型大体再现这种排序和份额。
九种并不是所有可能的模体。它们被选中是因为在数据中合计出现比例超过 97%;第十常见模体的比例已小于 0.001。因而证据支持模型能够覆盖常见闭合结构,不能写成真实轨迹只存在九种路径。
个人走得像,城市之间的流量也像吗?
将所有模拟移动聚合,可以比较每次移动的距离 d,以及城市对之间累计移动次数 Tij。T 是流量计数,不是一个人从 i 到 j 途中走了多少段,也不是旅行时长。
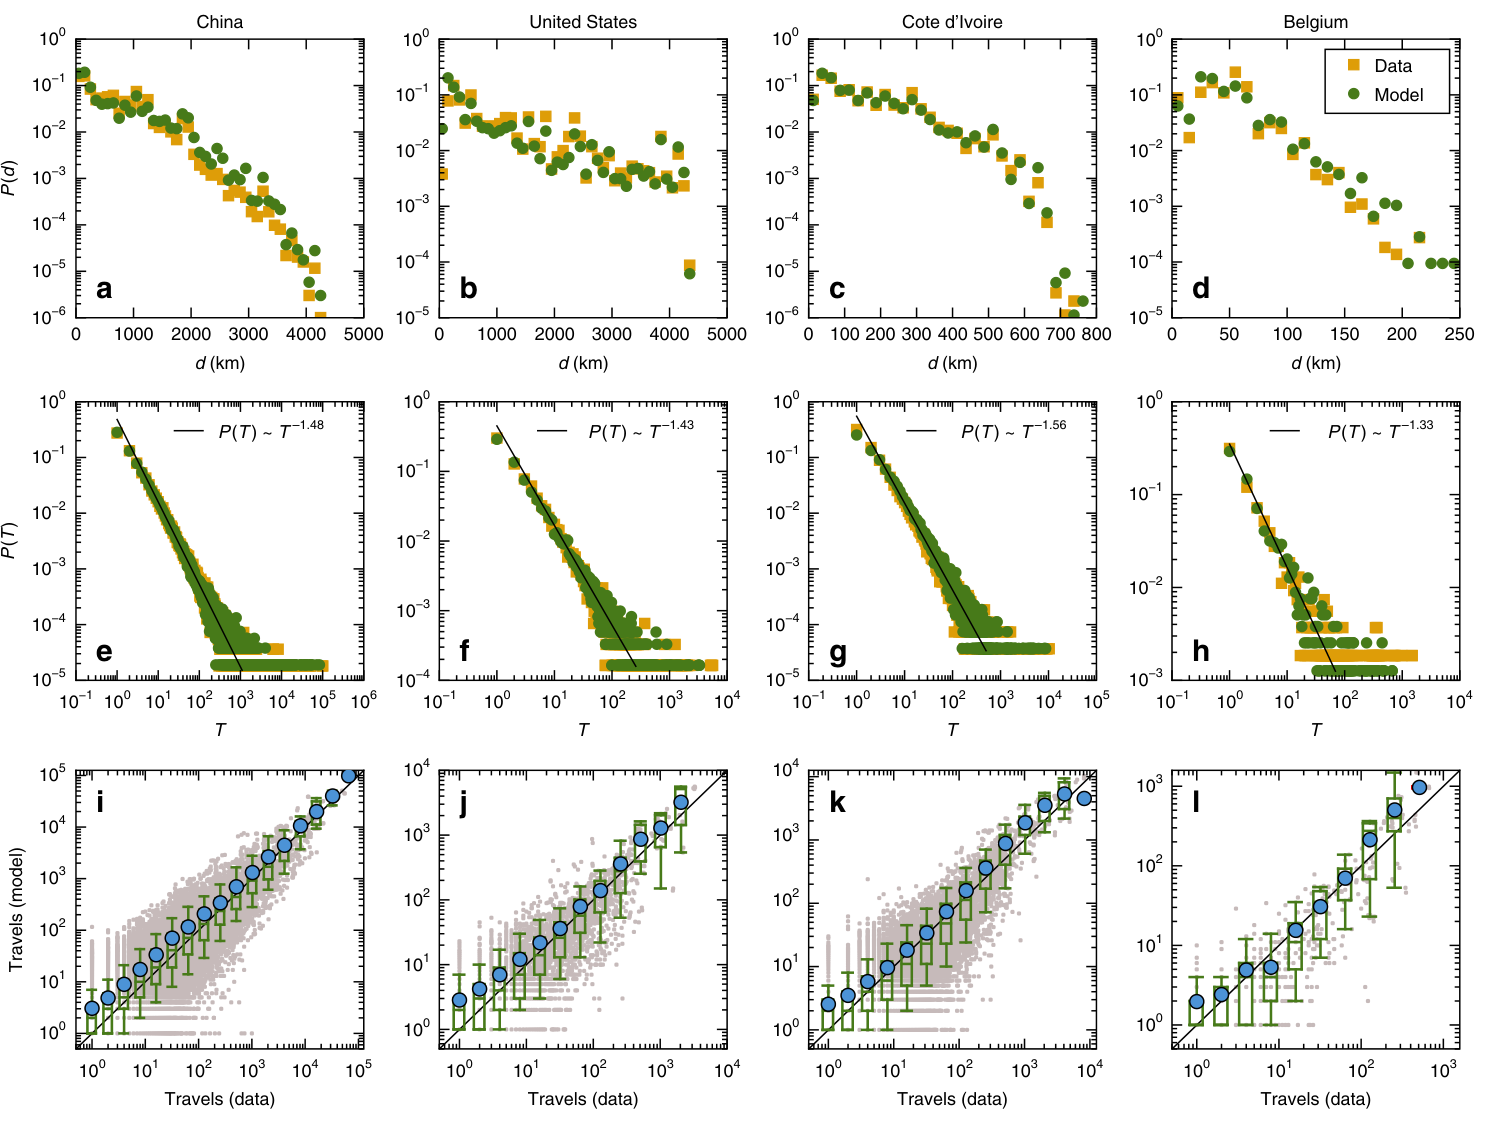
图 5|汇总后的流量是否仍与观测相符?四列地区顺序与图 3 相同,橙色为数据,绿色为模型。(a–d)横轴为距离 d,单位公里,纵轴为 P(d),采用半对数显示;各国跨度不同。(e–h)横轴城市对移动次数 T,纵轴 P(T),黑线分别为经验幂律拟合,指数依次约 −1.48、−1.43、−1.56、−1.33。(i–l)横轴实际城市对流量,纵轴模拟流量,灰点是单个城市对,蓝点是按观测流量分箱后的预测均值,箱线展示分布,黑线为 y=x。原图将 y=x 位于相应预测分布第 10% 至第 91% 范围内的箱标绿,否则标红;这不是 91% 预测准确率。
距离与流量分布的整体形状能对上,分箱均值也靠近等值线,但灰色散点仍有明显离散。能重现平均趋势与分布,不意味着每一个具体城市对都精确。若要用来规划班次或预测某个城市的输入风险,还需要针对目标流量做验证。
把记忆或竞争拿掉,会失去哪部分能力?
这一组消融比“曲线看着相似”更能说明两个机制各自做了什么。
无记忆模型把记忆项设为 1,只保留 mj/Wji。它仍能描述部分群体流量,却更容易不断探索新地点。
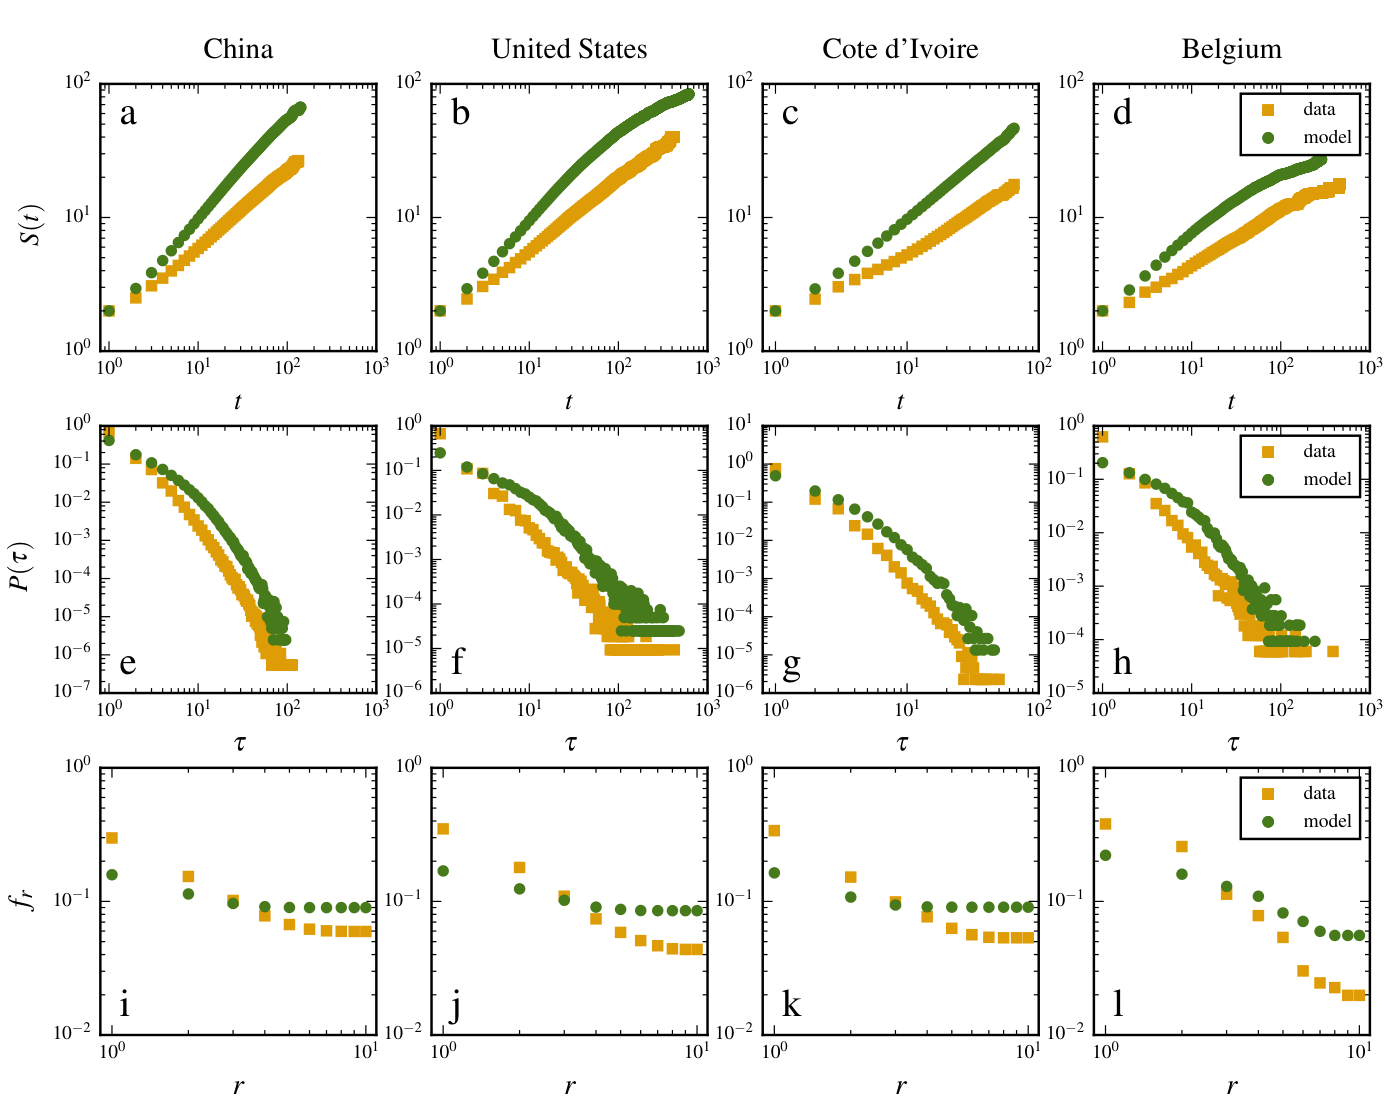
补充图 9|只有人口竞争,个人的回访规律还成立吗?四列仍按中国、美国、科特迪瓦、比利时排列,橙色数据、绿色模型。(a–d)S(t) 的模拟增长明显偏快;(e–h)返回间隔分布偏离;(i–l)访问频率排名也与数据不同。每一行的轴和单位分别对应图 3 的探索增长、返回步数、频率份额,显示去掉个人记忆会损害个人序列统计。
无竞争模型则保留人口 mj 与记忆项,却不再除以 Wji。它仍可产生一些合理的个人返回结构,但群体流量的对应较差。
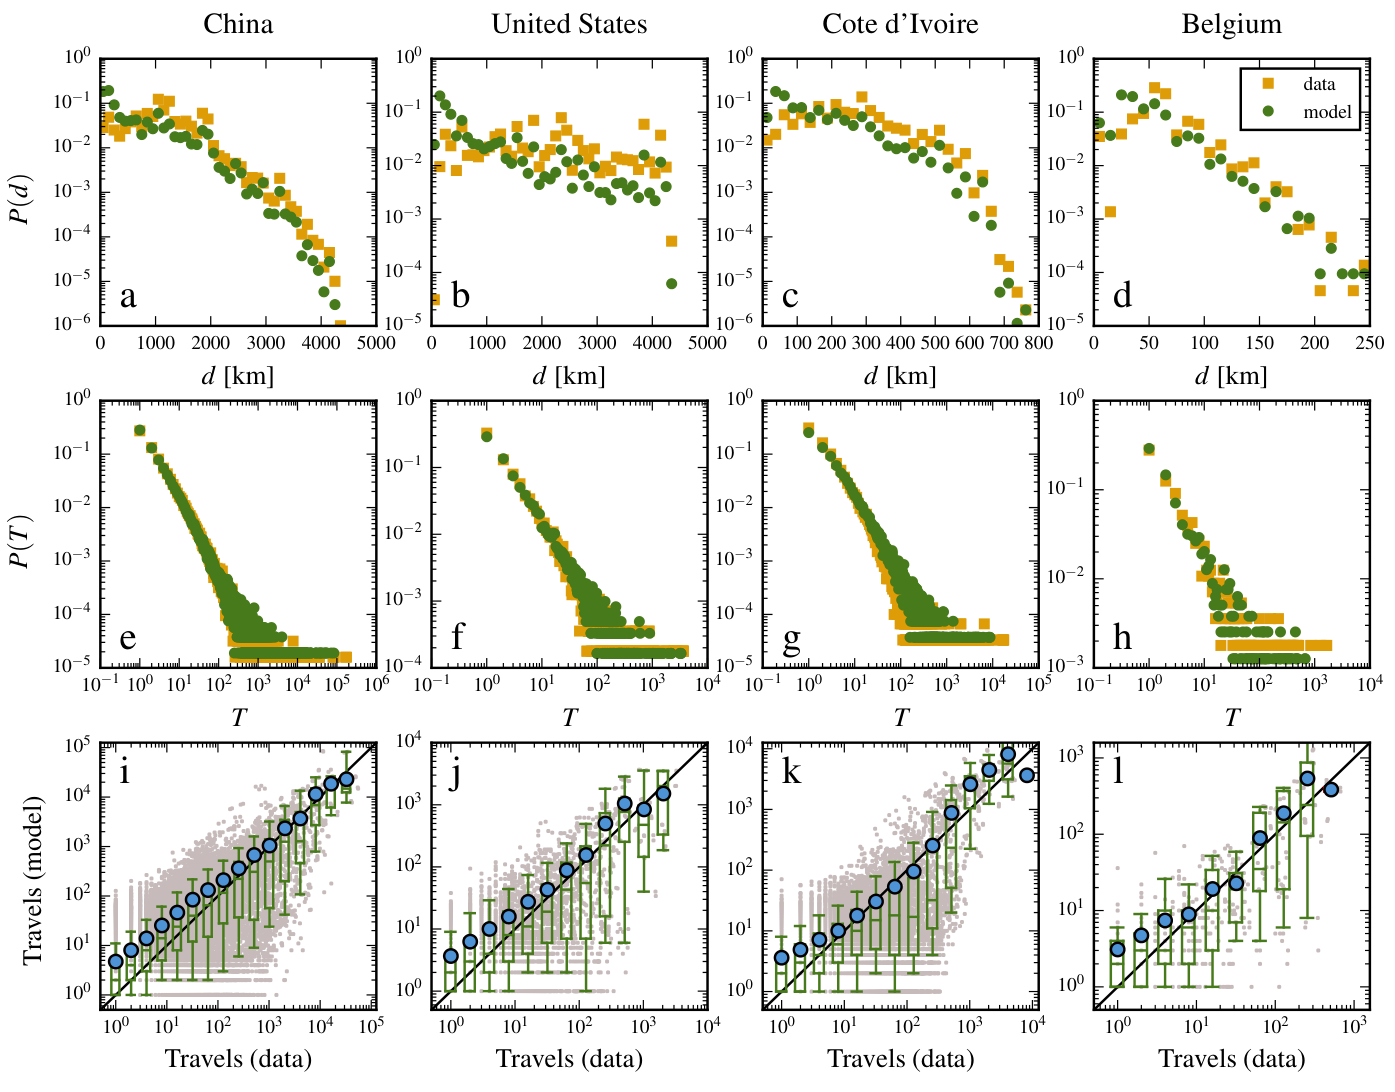
补充图 11|只有人口规模和记忆,群体流量还能对准吗?四列国家顺序不变。(a–d)距离分布,(e–h)城市对流量分布,仍是橙色数据、绿色模型;(i–l)单个城市对与分箱预测的比较,符号含义同图 5。即使上两行某些总体形状接近,下排仍出现更大的流量离散与偏差,提示不能只凭分布相似判断空间对应准确。
补充表 1 用两个指标量化差异。SSI(Sørensen similarity index)在这里对城市对流量的重合程度取平均,越接近 1 越好;RMSE 是 S(t) 的均方根误差,越小越好。它们分别衡量群体流量与个人探索,不能混成一个“准确率”。
| 地区 | 流量 SSI:完整 / 无记忆 / 无竞争 | S(t) RMSE:完整 / 无记忆 / 无竞争 |
|---|---|---|
| 中国 | 0.7126 / 0.6759 / 0.5394 | 1.3556 / 24.8674 / 1.6098 |
| 美国 | 0.7013 / 0.7225 / 0.5156 | 1.8376 / 29.3604 / 4.7381 |
| 科特迪瓦 | 0.7136 / 0.6914 / 0.5333 | 0.6738 / 16.7012 / 0.6926 |
| 比利时 | 0.6936 / 0.7739 / 0.5481 | 0.7141 / 9.2657 / 0.8308 |
最清楚的模式是:去掉记忆后,S(t) 误差大幅增加;去掉竞争后,四国 SSI 都下降。完整模型兼顾两类任务,但在美国和比利时,单看流量 SSI,无记忆模型反而更高。因此,证据支持两种机制联合解释多个层级,并不支持完整模型在每一项统计上都占优。
补充图 8、10 还展示无记忆模型的群体统计与模体,补充图 12、13 展示无竞争模型的个人统计与模体,共同补充这条分工证据。它们是模型内部移除组件的比较,仍不能直接证明现实中的人确实按公式计算竞争与记忆。
换成一座城市内部,还能用吗?
四国比较跨度很大,但其中的地点主要是城市或县中心。若要声称跨空间尺度,还需要更细的城市内部单元。
纽约检验使用 Foursquare 签到,以 2010 年人口普查街区作为地点单元。数据包含 42,035 名用户,其中 23,520 人有跨地点移动,共计 113,279 个移动步;同样估计参数后得到 λ≈8.0,明显不同于国家尺度数值。
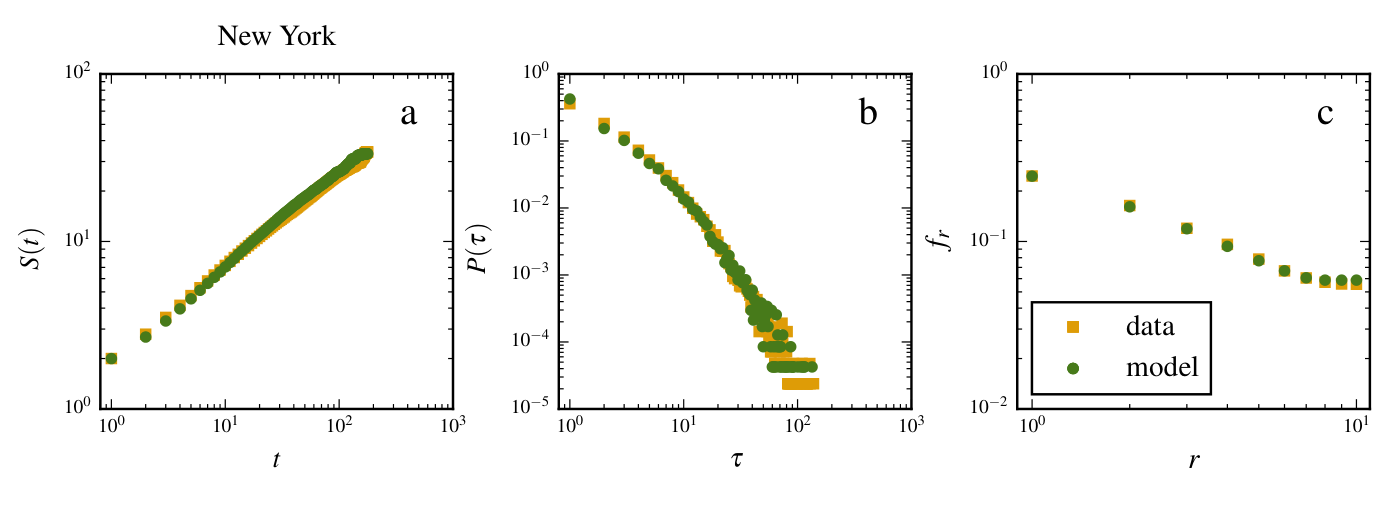
补充图 6|城市内部的个人统计是否也能生成?(a)不同地点数随移动步数增长,(b)返回间隔的步数分布,(c)频率排名与访问份额。绿色模型与橙色数据大体接近,提供了更细空间划分下的个体层面检验。
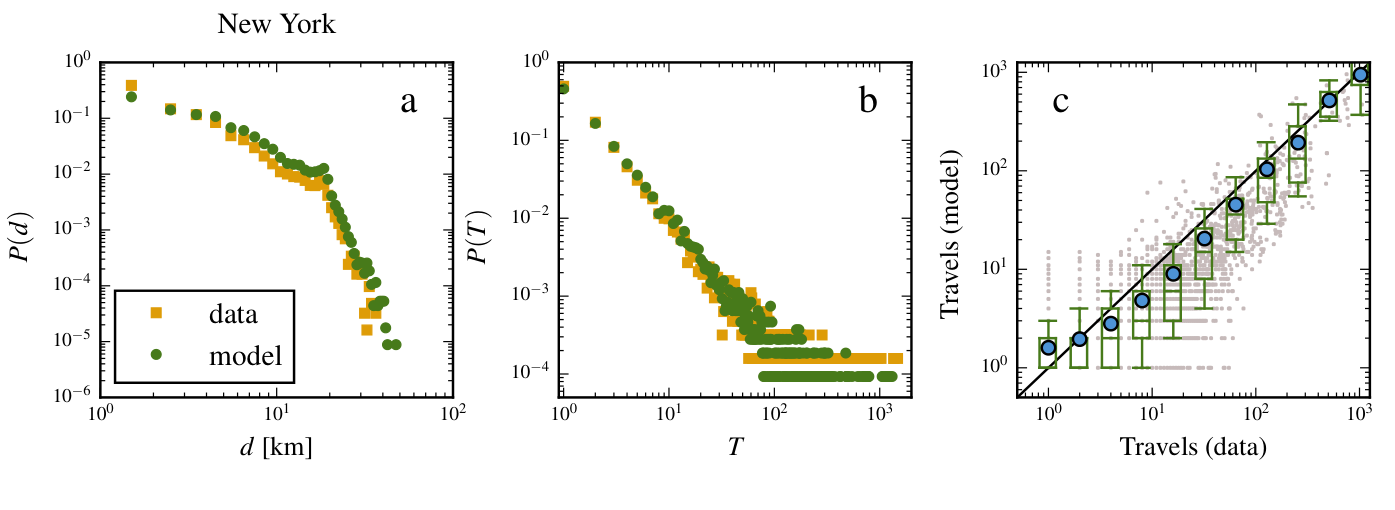
补充图 7|同一城市内部的流动汇总后怎样?(a)移动距离分布,横轴公里;(b)地点对移动次数分布;(c)模型与观测地点对流量的散点、分箱均值和箱线。颜色与图 5 对应,结果总体接近,尾部及具体地点对仍存在差异。
这增强了模型可跨尺度使用的证据,但仍只有一个市内案例,而且需要重新校准 λ。它不能保证任意城市、任意网格划分、任意观测频率下都有同样效果。
理论简化怎样解释记忆带来的增长规律?
现实人口分布很不均匀,完整模型难以精确求解。论文转向一个简化系统:地点人口均匀、忽略人口竞争,只保留发现次序记忆,进而分析探索、频率和返回间隔。
解析部分把访问后的吸引力写成 1+λN/r,N 为地点总数。这个 N 缩放与经验模型的 1+λ/r 不同,图 6 中的 λ 不能直接与四国拟合值作同尺度比较。
在已访问地点数 S 远小于总地点数 N 时,推导给出:
P新 ≈ 1/[1+λ(ln S+C)],其中 C≈0.577。
意思是:探索到的旧地点越来越多,记忆权重不断累积,新地点在总权重中所占比例下降,探索自然减慢。不过这一式是对数衰减,并不是预先指定的 S^−γ 幂律;它的适用条件与不同模型的增长规律应分开。
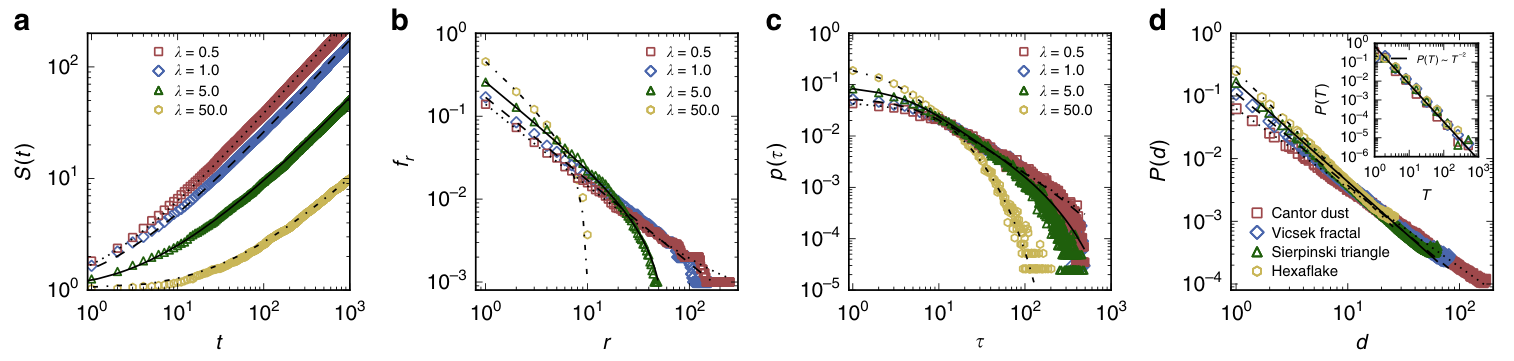
图 6|哪些规律能从简化假设推出?(a)探索增长 S(t),(b)访问频率分布 fr,(c)返回间隔分布 P(τ),曲线为解析结果、符号为模拟,N=1,000、轨迹长度 L=1,000,比较 λ=0.5、1、5、50。(d)在 Cantor dust、Vicsek、Sierpinski triangle、hexaflake 四种分形空间中检验距离统计,对应分形维数约 1.262、1.465、1.585、1.771;插图是地点对流量分布,参考线为 T^−2。这是理想空间中的机制示范,与四国真实人口数据的经验检验不同。
群体理论再做一步简化:每个人只移动一步,记忆不再发挥作用。在分形人口空间中,Wji 随距离约按 d^D 增长,城市对流量遂得到引力式 Tij∝mi·mj/dij^D。均匀人口条件下,作者推出 P(T)∝T^−2;真实数据的拟合指数却介于 −1.33 与 −1.56,不能把 −2 当作经验测量结果。
补充材料用一个中心城市向外移动、外围人口随距离下降的理想场景,说明人口异质性能够将流量分布指数移到 −1 与 −2 之间。这提供解释方向,但不是对每个国家所有空间过程的精确推导。距离统计也依赖理想空间构造与汇总方式,不能仅由城市对权重的距离指数直接断言任意地区的观测距离分布。
补充 Note 1 还考虑广义 Zipf 频率关系 f∝r^−ζ,在额外的优先返回、长时间近似下,得到 P新∝S^−(ζ−1),连接到既有探索—优先返回模型。这里展示的是假设之间的数学联系,不是通过观察数据证明“频率定律导致探索减少”或反过来的因果方向。
统一模型的价值,应该怎样理解?
它的贡献是把个人历史与空间机会放进同一个概率框架,既检验个人分布和路径模体,也检验群体流量,并用消融说明两部分在不同层级承担的任务。相较只拟合一条总体曲线,这是一条更完整的验证路径。
同时,模型仍需要地点及人口信息、经验起点、轨迹长度分布和参数校准。签到与通信轨迹的缺失不等同于人没有移动;把最常签到地点当家也可能误判。不同国家间的平台差异和样本量差异,使 λ 不能直接充当可比的心理记忆测量。
模型没有直接包含出行目的、交通方式、时间表或跨国移动,也没有开展独立疫情或拥堵干预实验。文中关于公共卫生与交通管理的应用,是需要后续针对具体任务检验的可能性。
一句话总结
把个人发现地点的历史与人口竞争结合起来,一套转移规则可以同时生成多种个人轨迹和群体流量统计;它的统一性来自机制跨任务的表现,而非免校准或逐人逐站的精确预测。
核心来源
- Yan XY, Wang WX, Gao ZY, Lai YC. Universal model of individual and population mobility on diverse spatial scales. Nature Communications 8, 1639 (2017).正式论文,DOI。
- 同文 官方 Supplementary Information:解析推导、纽约案例、消融图与数值表;官方页面另提供中国城市坐标、轨迹数据及审稿文件。
- Song C, Koren T, Wang P, Barabási AL. Modelling the scaling properties of human mobility. Nature Physics 6, 818–823 (2010).DOI。
全部配图来自原论文 Fig. 1–6 及 Supplementary Figs. 6、7、9、11,中文讲解按原面板解释。原文以 CC BY 4.0 许可发布。
作者介绍
以下采用论文发表时的机构与贡献说明。
- Xiao-Yong Yan:北京交通大学交通系统科学与工程研究所署名作者,参与研究设计、执行、分析工具与写作。
- Wen-Xu Wang:北京师范大学系统科学学院与复杂性研究中心署名作者、通讯作者之一,参与设计、执行、分析工具、数据分析与写作。
- Zi-You Gao:北京交通大学交通系统科学与工程研究所署名作者、通讯作者之一,参与设计、分析工具、数据分析与写作。
- Ying-Cheng Lai:美国 Arizona State University 电气、计算机与能源工程学院署名作者、通讯作者之一,参与设计、数据分析与写作。
延伸思考:一张正确的流量图,还不等于一群正确的人
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假设两个模型都预测每天有一万人从甲城到乙城。一个模型让同一万人反复往返,另一个每天换一批人;总流量完全相同,个人经历却不同。若关注传染接触、跨城服务使用或长期需求,两者可能产生不同后果。
这篇论文启发我们,评估合成移动数据时,最好同时问两个问题:汇总后的流量是否合理,拆开后每个人的返回与探索是否合理。消融结果还表明,一项群体指标变好,可能并不意味着个人统计也变好。
实际使用时可以按任务设立双层检验:交通运力看城市对流量及误差,个体暴露过程看返回结构、不同地点数与序列变化。通过这些检验仍不代表模拟轨迹对应某个真实人的未来;明确它是统计生成结果,有助于避免把模型输出误用为个人行为画像。