总爱回到熟悉的页面,为什么有时反而能更快发现新页面?
论文名片|Kanghun Kim、Jaegu Kyoung、D.-S. Lee,Self-attracting walk on heterogeneous networks,Physical Review E 93,052310,2016 年 5 月 25 日发表。DOI。
设想你浏览网站时,总喜欢回到已经打开过的页面。直觉上,这会让探索变慢。但如果反复返回的是一个链接很多的导航页,每次回来又能顺手打开一个新页面,它可能成为扩大探索范围的支点。等导航页周围都看得差不多了,同样的回访又可能让你在熟悉区域里反复打转。
这篇论文研究的正是“熟悉偏好”与网络连接结构的共同作用。它建立数学模型、生成合成网络并模拟游走,没有采集真实用户浏览数据。页面浏览是解释模型的场景,不是论文中的实地实验。
主要发现有四点:
- 在相同的强烈熟悉偏好下,连接度差异更大的网络,早期发现新节点的速度可以更快。
- 枢纽被优先访问后,剩余节点越来越难找,某些网络中的探索会从近似线性增长转向次线性增长。
- 这种转折可以用“通往未访问区域的边”与“已访问区域内部的边”的比例解释,而不是只凭网络节点数判断。
- 度相关、网络密度和偏好强度都会改变结果;部分极大网络结果来自间接数值计算,强弱偏好的准确分界仍未确定。
模型究竟记住了什么?
自吸引游走(self-attracting walk,SATW)让一个行走者沿网络连边移动。每次只走到当前节点的邻居,并把已经到过的邻居赋予更高的选择权重。
这里的记忆非常简单:只记“曾经去过没有”。去过一次与去过一千次,在返回权重上没有区别;昨天去过与很久以前去过,也没有区别。它与按累计次数优先返回、按近期排名返回的模型,是不同的记忆假设。
设当前节点共有 k 个邻居,其中 k̂ 个已经去过。每个旧邻居权重为 eᵘ,每个新邻居权重为 1,总权重为 k−k̂+eᵘk̂。于是选择某一个旧邻居的概率为 eᵘ 除以总权重,选择某一个新邻居的概率为 1 除以总权重。u 越大,熟悉偏好越强;u=0 时,每个邻居等概率,退化为普通随机游走(RW)。
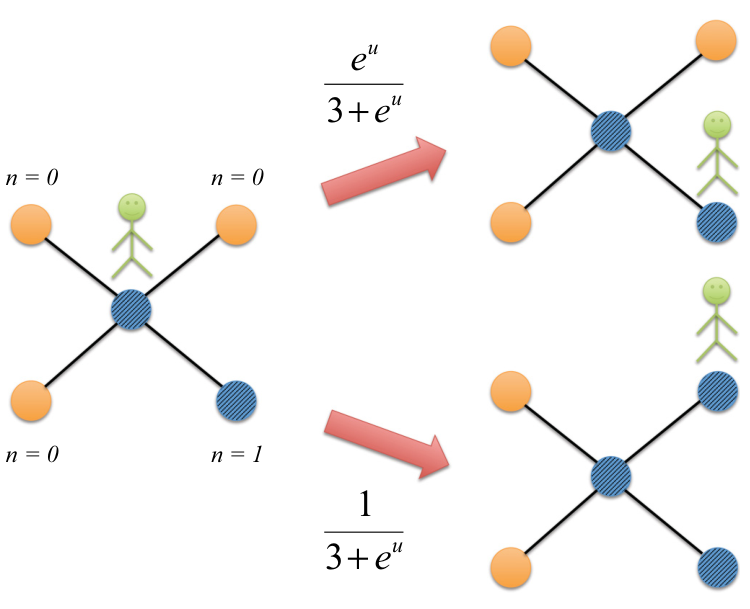
图 1|一份“去过没有”的记忆,怎样改变下一步?这张无字母的示意图中,橙色 n=0 表示未访问,蓝色 n=1 表示已访问。当前位置有四个邻居,其中一个已访问、三个未访问,因此回到那个旧邻居的概率为 eᵘ/(3+eᵘ),走向任意一个指定新邻居的概率为 1/(3+eᵘ)。走向全部新邻居的总概率则是 3/(3+eᵘ)。左右图共同解释一条移动规则,不是两组实验结果。
研究关注 S(t):走了 t 步以后,总共到过多少个不同节点。它衡量覆盖或探索的广度,不等于走出的物理距离,也不等于传播给多少个真实用户。t 是移动步数,本文没有把它换成秒、小时或天。
枢纽很多的网络,会怎样改变探索速度?
论文用配置模型生成无标度网络,度分布近似 P(k)∝k^−γ。度是一个节点的邻居数;在此类模型中,γ 越小,连接度越不均匀,大枢纽相对越突出。“异质性”在这里指连接度差异,不能直接理解成城市人口、用途或收入差异。
基础实验使用 100 万节点、平均度 4 的无相关网络,比较 γ=2.5、3.0、5.0,以及 u=0 和 u=9。无相关指边两端节点的度没有额外相关结构。图中每个数据点平均了 1,000 次模拟。
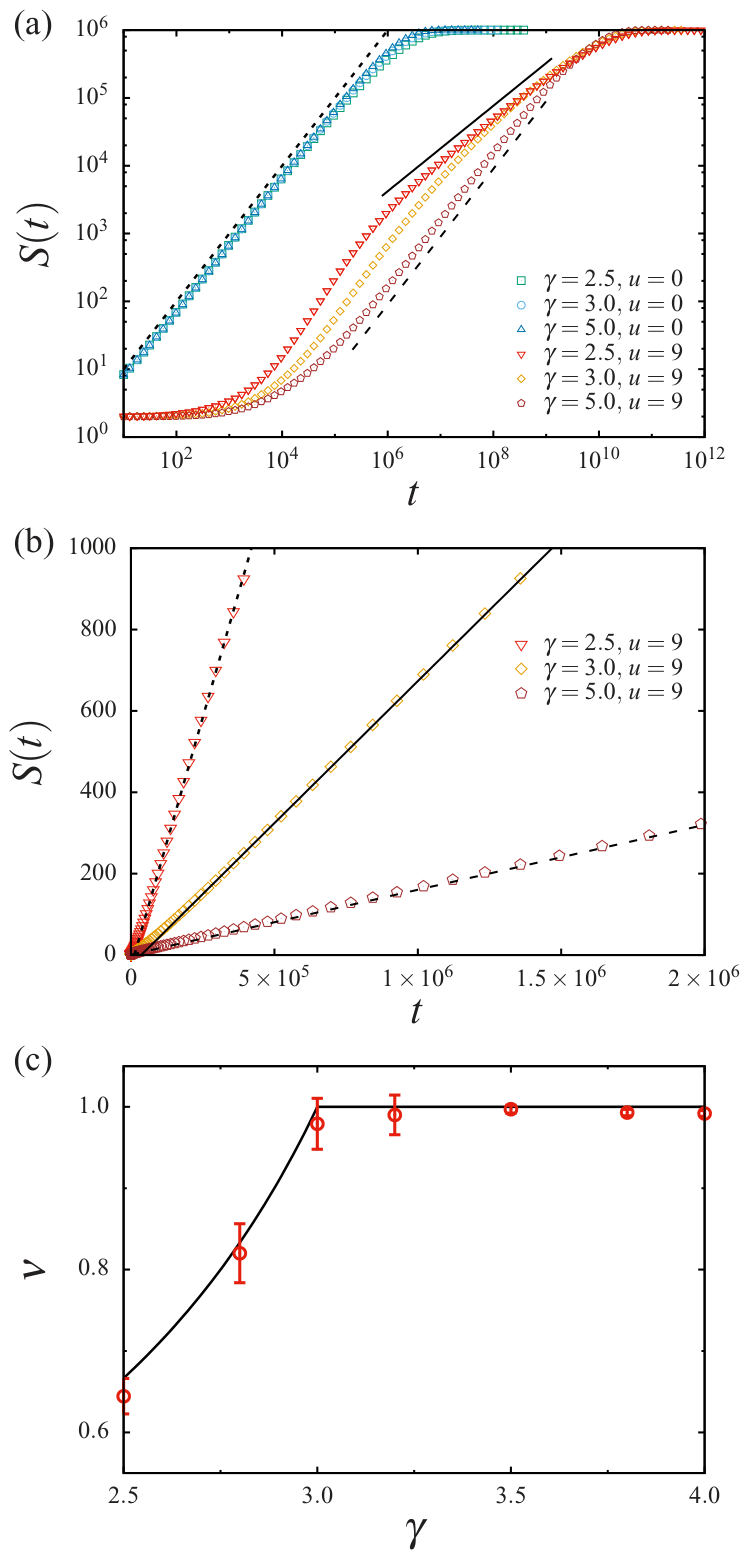
图 2|同样爱回头,哪种网络更容易探索?(a)横轴为移动步数 t,纵轴为不同访问节点数 S,双对数坐标。普通随机游走的曲线在较宽范围接近线性;强自吸引明显拖慢覆盖。(b)放大 u=9 的早期范围,坐标改为线性:γ=2.5 的增长斜率最大,γ=5.0 最小。(c)横轴 γ,纵轴是后期 S∝t^ν 的估计指数 ν,红点及误差条为数值估计,黑线为理论关系。γ 小于 3 时出现 ν<1,接近或超过 3 时趋近 1;误差条的具体置信定义未在图注中说明。
早期拟合斜率分别约为 24.5×10^−4、6.98×10^−4、1.6×10^−4 个新节点/步,对应 γ=2.5、3.0、5.0。这是同样 u=9 下不同网络之间的比较,不是说偏爱旧节点比普通随机游走更快。
还要区分两种减速。有限网络最终都会到达 S≈N 的饱和平台;本文关注的是尚未覆盖全网时,增长指数已经低于 1 的中间阶段,不能把最终平台本身当成“次线性机制”的证据。
为什么枢纽先帮忙,后来又不够用了?
要理解这个转折,可以把已经访问的节点及其相互连边看成一个“已访问子图”。进入一个新节点,意味着走出了这个子图的边界。
论文用两个量描述它:K 是所有已访问节点在原网络中的度之和;K̂ 是这些节点在已访问子图内部的度之和。K̂ 把每条内部边计两次,而 K−K̂ 恰好对应从已访问区域通向未访问区域的边数。
强自吸引下,行走者很久才走到一个新节点,在此之前有机会在已访问子图中充分游走。局部平稳近似给出:停在某个已访问节点的概率,与它在子图中的度 k̂ 成正比。将它代入移动规则,可以得到一个直观的近似式:
p新 ≈ (K−K̂)/(eᵘK̂)。
分子是外部机会,分母包含内部连接规模与返回偏好。外部边相对多,发现新节点的机会就大;内部连接累积得更快,探索就慢下来。这个公式依赖强吸引和局部平稳近似,不是任意偏好强度、任意网络上的精确恒等式。
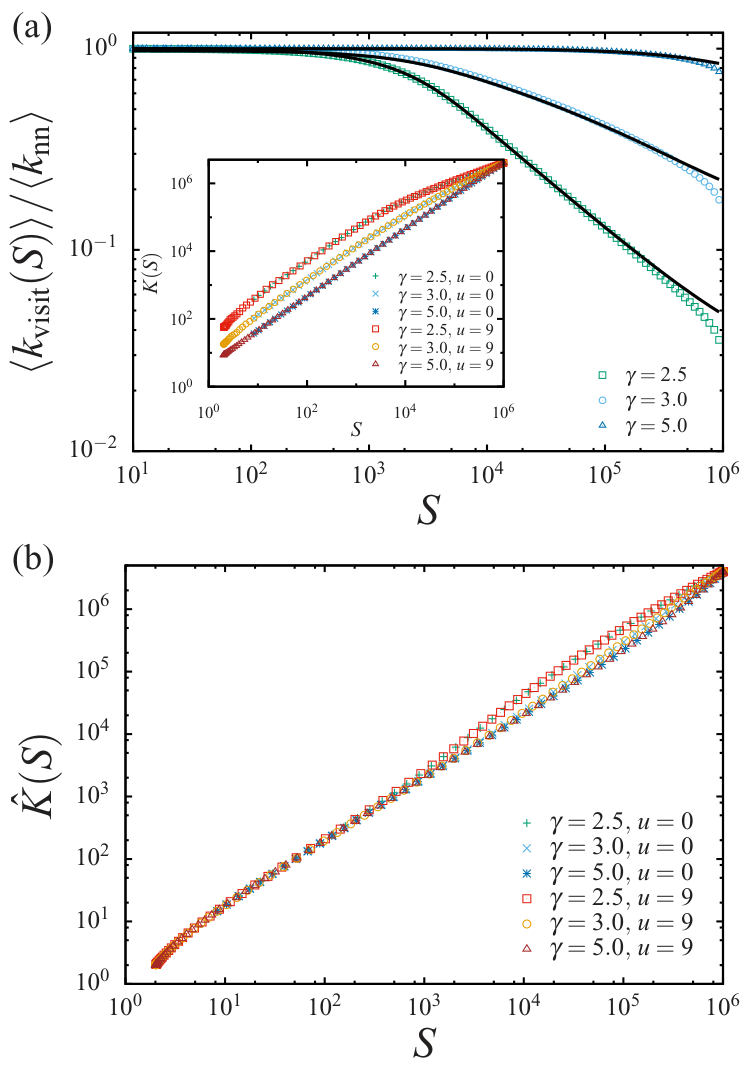
图 3|探索越深入,新发现节点还像早期那样连接丰富吗?(a)横轴为已访问节点数 S,纵轴为第 S 个新节点的平均度除以平均邻居度 ⟨k_nn⟩。γ=2.5 的曲线后期下降明显,γ=5.0 变化小,说明枢纽更容易较早被发现;插图为总度 K 随 S 的增长。(b)横轴仍为 S,纵轴为内部度之和 K̂。u=0 与 u=9 在相同 S 下的整体量接近,支持在无相关网络中把这些量主要视为探索规模的函数。所有网络仍是 100 万节点、平均度 4;黑线为解析近似。
为什么大度节点更早被找到?沿一条边到达节点,相比均匀抽节点,本来就更容易碰到边多的枢纽。随着探索推进,未访问节点中大度节点被消耗得更快。解析推导把未访问节点的度分布写成原幂律乘上近似指数截断 e^(−kS/2L),L 是全网边数。相应截断度大约为 2L/S,随 S 增大而下降。
由此出现一个特征规模 Sc=2L/k最大:探索规模超过这一量级后,最高度节点的稀缺开始改变后续增长。对于较稀疏、局部近似树状的网络,K̂ 约为 2S;而较强异质性下,额外内部边不能总被忽略。
这也解释一个容易误会的地方:图 3 中两个游走在相同 S 下有相近的 K 与 K̂,并不表示它们的访问形状、时间进程或每个节点的访问次数都相同。
能不能从网络结构算出增长指数?
在 2.5≤γ<3 的无相关稀疏网络中,推导给出早期近似线性增长,而在超过特征规模后,有 S∝t^[1/(4−γ)]。例如 γ=2.5 时,理论指数为 2/3。图 2 的数值拟合约 0.63,与理想渐近值不完全相等;有限规模、拟合区间和近似都会影响观测。
对于 γ>3,理论中主要保持线性增长;γ=3 是边界情形,表 III 还保留了对数修正。不能把分段幂律当成从第一步一直到全网覆盖的精确曲线。
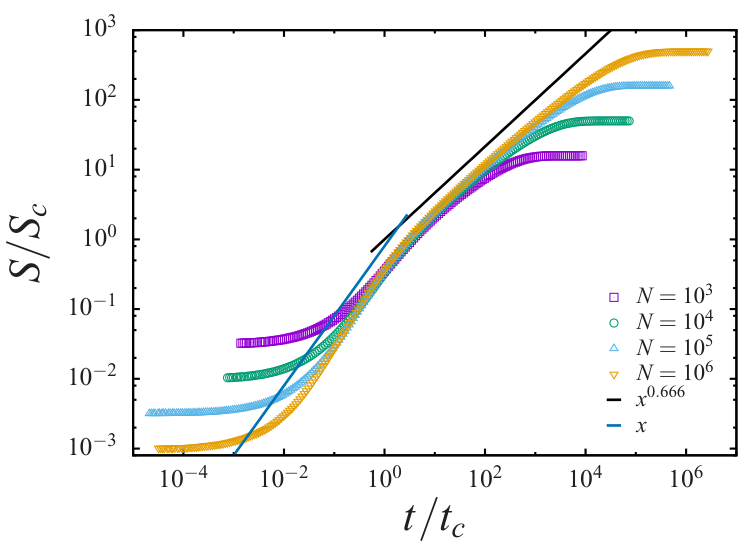
图 4|线性转为次线性,是否只出现在某一个网络规模?这张无子图字母的图把纵轴改为 S/Sc,横轴改为 t/tc。网络节点数从 10³ 到 10⁶,平均度均为 4、γ=2.5;较小两组使用 u=7,较大两组使用 u=9。按理论特征尺度重标度后,中间增长区接近共同轨迹,参考线分别为一次增长和约 0.666 次增长。末端平台仍因有限网络覆盖而分开。
特征时间 tc=Sc·eᵘ/⟨k_nn⟩。这个关系把两种作用拆开:强返回偏好通过 eᵘ 拉长探索所需步数,枢纽带来的较大平均邻居度则提高早期探索机会。
论文也明确指出,理论对非常早期的慢增长以及部分早期斜率仍有偏差,尚未解释所有细节。它提出的是能解释主要尺度关系的近似分析,而不是逐点完全吻合。
更强异质性下,为什么会出现两次转折?
当 2<γ<2.5 时,已访问子图内部的额外连边更重要。它们可能让 K̂ 在某个范围近似按 S² 增长,而不是保持树状的 2S。表 I、II 对 K 与 K̂ 分别归纳,表 III 合并后预测:S 随重标度时间 τ=t/eᵘ,可能先近似线性,再按平方根增长,最后转为 τ^[1/(γ−1)]。
这个结果尤其需要交代证据等级:作者在 100 万节点以内的强吸引直接模拟中,没有清楚观察到全部三个阶段,认为各阶段受到有限规模压缩,而更大规模直接模拟过于昂贵。
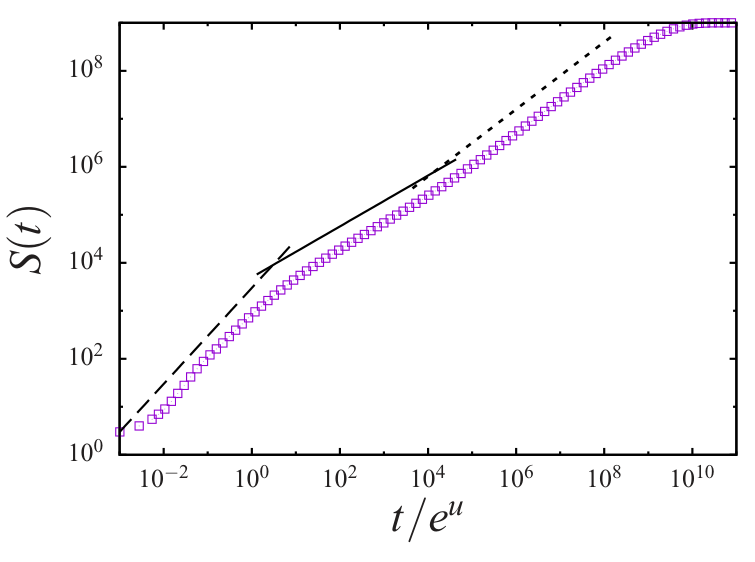
图 5|两次转折的证据从哪里来?这张无字母的图对应 N=10⁹、平均度 4、γ=2.2、u=12。紫色数据不是直接逐步跑完强自吸引轨迹:先做 u=0 的随机游走,测出 K(S) 与 K̂(S),再将它们代入强吸引近似式、数值积分得到 S(t)。横轴为 t/eᵘ,纵轴为 S,三条参考线斜率为 1、0.53、0.7,呈现相继变换的增长范围。
因此,图 5 是依赖近似公式与无相关网络体量关系的间接数值支持,不能写成十亿节点强自吸引的直接实验验证。理论最终指数在 γ=2.2 时约为 0.833,图中的 0.7 是所展示范围的参考斜率,二者不应混用。
同样访问五十个节点,留下的形状有什么不同?
强自吸引使行走者反复回到刚发现的枢纽,有机会逐个发现它的许多邻居。普通随机游走则更容易穿过枢纽后继续走,留下较长的链状探索痕迹。这种形状差异帮助我们理解,为什么同一个枢纽会既创造早期机会、又积累后期回转。
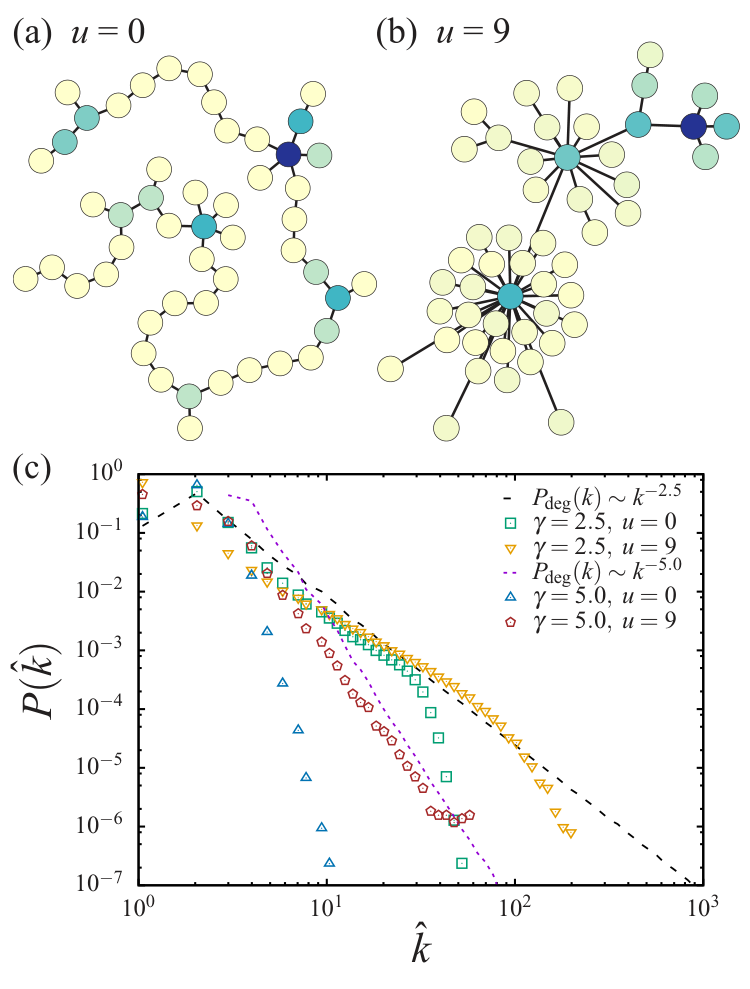
图 6|熟悉偏好怎样改变探索留下的网络?(a)普通随机游走 u=0,(b)强自吸引 u=9,均展示已访问 50 个节点时的子图;底层网络 N=10⁶、平均度 4、γ=2.5,颜色越深表示访问次数越多。(b)更像多个以枢纽为中心的星状片段相连。(c)在 S=1,280 时比较内部度 k̂ 的分布,横轴 k̂、纵轴概率,实测符号区分 γ 与 u,虚线为原网络度分布。自吸引下内部度分布更宽,显示部分枢纽已连接到更多被访问邻居。
早期反复回到枢纽,仍能沿未探索的边发现新节点;后期大枢纽及其周围逐渐被覆盖,剩余低度节点提供的外部边更少。于是边界增长跟不上内部体量,p新 随探索范围下降。这是“先促进、后拖慢”的结构解释,比较对象始终需要注明网络异质性与时间阶段。
网络不再无相关、也不再稀疏时,会怎样?
现实网络中的大节点未必随便连。度同配性(degree assortativity)表示相似度数的节点更倾向彼此连接;正同配网络中,枢纽更容易连枢纽。仅有同样的度分布,不能保证探索行为相同。
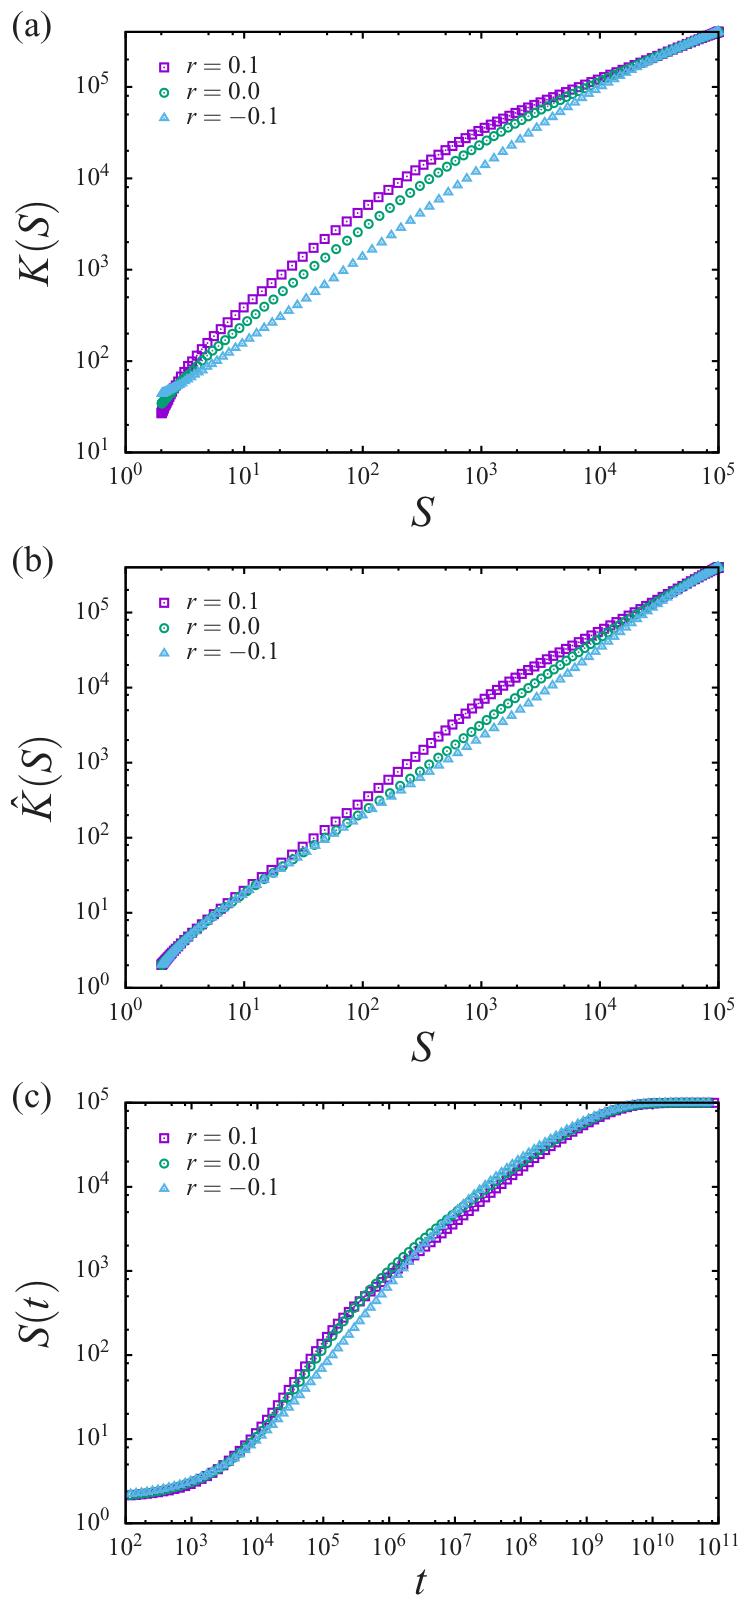
图 7|连接度不变,只改谁与谁连接,结果会变吗?三组网络具有相同度序列,N=10⁵、平均度 4、γ=2.5,均使用 u=9;紫色为同配系数 r=0.1,绿色 r=0,蓝色 r=−0.1。(a)比较 K(S),(b)比较 K̂(S),(c)比较 S(t)。正同配使早期访问更多互连枢纽,K 与 K̂ 更快增长;随后枢纽资源也更早消耗,探索呈现早期较快、后期较慢的变化。r 是网络连边结构指标,不是访问偏好的相关系数。
另一项改变是增加平均度。网络越密,已访问区域越不再像树,内部边可以增长得很快;完全图是每对节点都相连的极端情况,强自吸引下有平方根式增长。
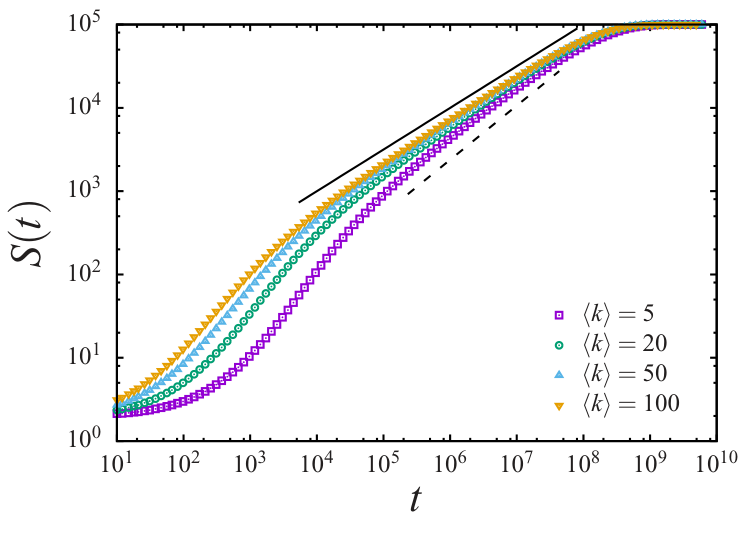
图 8|边更多,是否就始终探索得更快?这张无字母的图固定 N=10⁵、γ=2.5、u=7,比较平均度 5、20、50、100。横轴为步数,纵轴为不同节点数,双对数坐标。平均度增大时,曲线水平和转折同时改变,后期幂律参考斜率从约 0.66 向 0.5 接近。它展示增长形状随密度变化,不能据此简单断言高密度网络在每个时刻覆盖都更少。
这些比较限定了解析公式的使用范围:无相关、稀疏、局部近似树状,是推导简化的重要条件,而不是无关紧要的背景。
强偏好近似靠得住吗?
附录 A、B 直接检查了理论的关键假设。首先,如果强吸引主要带来 eᵘ 的时间放大,不同大 u 的曲线按 t/eᵘ 重标度后应当接近。
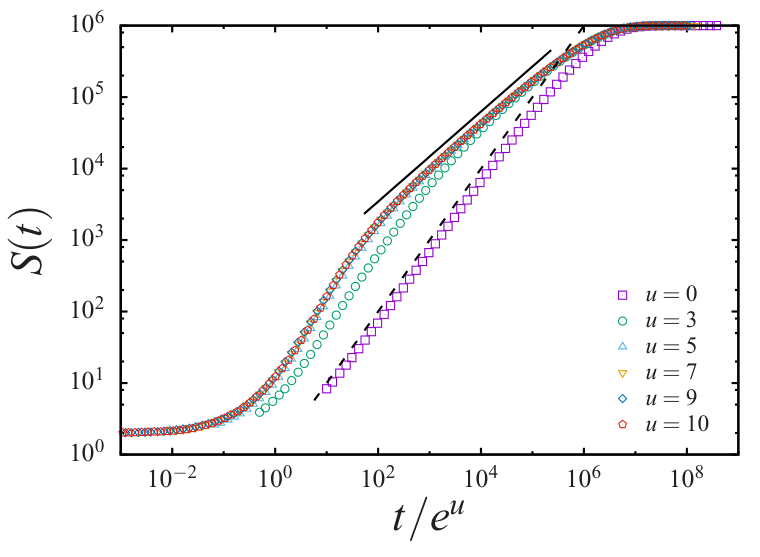
图 9|强吸引下能否用同一个时间尺度描述?无字母单图,固定 N=10⁶、平均度 4、γ=2.5,比较 u=0、3、5、7、9、10。横轴是 t/eᵘ,纵轴为 S;u=7、9、10 的曲线高度重合,而 u=0 等较弱情形不完全遵循相同形状,支持一个可用强吸引近似描述的范围。
解析近似的一个充分条件是 eᵘ 远大于网络最大度。但数值结果提示,出现相近次线性行为未必要求满足这么强的条件。论文没有确定临界 u,也未完整解决它如何随 γ、平均度或规模改变。
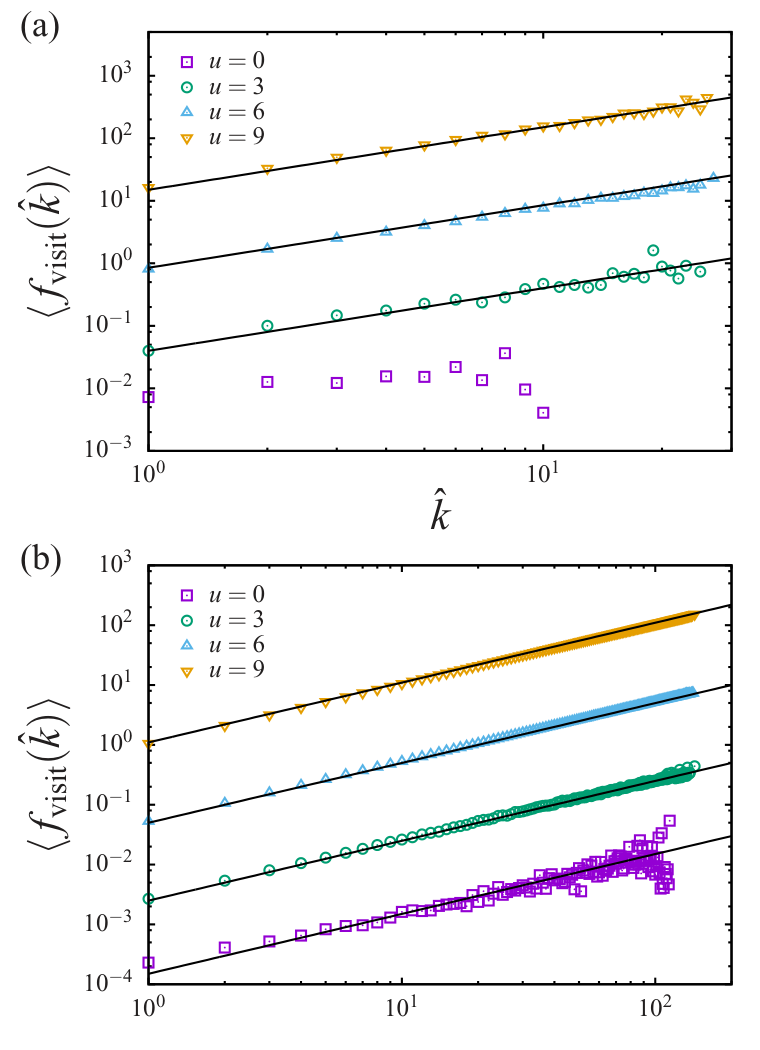
图 10|行走者是否有足够时间在已访问子图内达到局部平稳?(a)固定 S=40,(b)固定 S=2,560,均在 N=10⁴、平均度 4、γ=2.5 网络中,比较不同 u。横轴为内部度 k̂,纵轴为 S 暂时不变期间的平均访问次数;黑线斜率为 1。较强吸引时,访问次数近似正比于内部度,支持局部平稳近似;尤其早期、弱吸引的数据并不都符合。
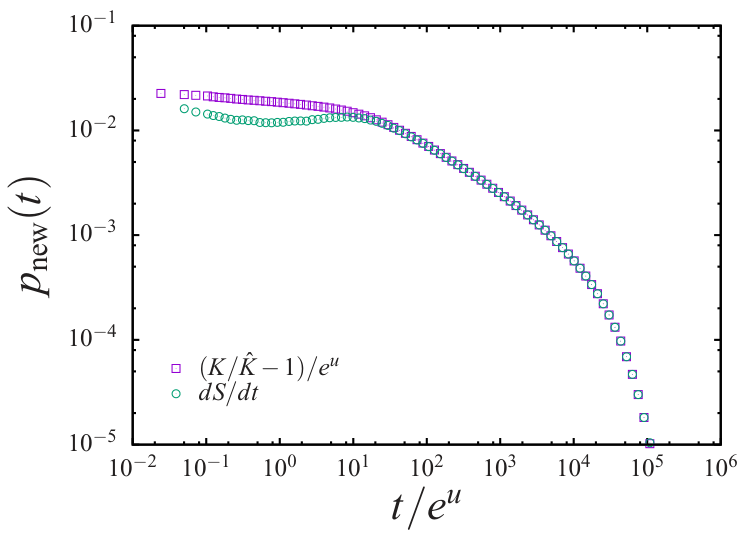
图 11|边界与内部体量的比例,能否估计真正探索速度?这张无字母单图使用 N=10⁴、平均度 4、γ=2.5、u=6。横轴为 t/eᵘ,纵轴为 p新;绿色圆圈来自直接对模拟 S(t) 数值求导,紫色方块来自 (K/K̂−1)/eᵘ。两者在大部分增长范围接近,最早期仍有可见差异。它支持近似式的主要适用区间,不表示公式在全过程无误差。
附录 C、D 进一步从未访问节点度分布的截断推导 K、K̂ 的分段增长,并说明额外内部边为何在 2<γ<2.5 时重要。它们完成了解释链:连接结构决定边界如何消耗,边界与内部体量的竞争再决定发现新节点的速度。
这能解释真实人的行为到哪一步?
论文展示了一种可能机制:即使记忆只保存“去过没有”,熟悉偏好与连接度异质性结合,也能产生复杂的探索减速。观察到新地点数增长越来越慢,不必立即推断人主动降低了探索意愿;底层可达结构也可能参与塑造这一规律。
不过,真实网页常有方向、权重、内容推荐和动态更新;现实出行还受地理距离、时间安排与交通成本影响。本文的静态随机网络、局部跳转、二元记忆,没有覆盖这些机制。文中关于网页浏览、信息扩散、疫情或运输的讨论属于潜在应用,尚未用相应真实数据验证。
此外,“次扩散”在本文主要通过不同访问节点数的次线性增长来表征;它不能直接换成欧氏空间里的均方位移指数。强吸引临界值、其他记忆形式、兼有有限分形维度与连接度异质性的网络,仍是开放问题。
一句话总结
爱回到熟悉节点的人,在枢纽丰富的网络中可能先借枢纽扩大探索,后因枢纽及其边界被消耗而减速;探索曲线取决于记忆规则与网络结构的共同作用。
核心来源
- Kim K, Kyoung J, Lee D-S. Self-attracting walk on heterogeneous networks. Physical Review E 93, 052310 (2016).期刊页面,DOI。正文图 1–8、附录图 9–11、表 I–III 及附录 A–D 均属于该论文。
- Song C, Koren T, Wang P, Barabási AL. Modelling the scaling properties of human mobility. Nature Physics 6, 818–823 (2010).DOI。本文讨论探索概率与既往移动模型关系的来源之一。
全部配图来自原论文对应 Fig. 1–11,中文说明按原图轴、面板与方法解释。
作者介绍
以下仅采用论文及期刊页面核实的发表时身份。
- Kanghun Kim:本文第一作者,署名机构为韩国 Inha University 物理系,参与这项异质网络自吸引游走研究。
- Jaegu Kyoung:本文共同作者,署名机构为 Inha University 物理系。
- D.-S. Lee:本文共同作者、通讯作者,署名机构为 Inha University 物理系。原文署名使用该缩写,本文保留这一形式。
延伸思考:导航枢纽的价值,可能随着探索阶段改变
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
设计知识网站时,常把一个大目录页视为普遍有用的入口。模型提示一个值得测试的可能性:初来者反复回到目录,能够接触许多新内容;熟悉者继续从同一个目录出发,却可能总在已经看过的区域打转。
若要据此做产品实验,可以按用户已经覆盖的内容范围调整导航,比较固定大目录、显示尚未访问的链接、跨主题入口三种方式。评估应同时记录新增内容覆盖、任务完成和满意度;单纯增加点击数可能只是增加回转,未必意味着获得更多新知识。
这仍不能从论文直接推出“少设枢纽”或“降低推荐集中度”必然更好。真实平台的内容质量、链接方向与个体目的会改变结果。更稳妥的问题是:一个在新手阶段帮助探索的结构,进入熟悉阶段后,是否还提供同样多的新机会?