电话与推文记录了不同的人,怎样一起帮助预测去向?
论文名片|Lucas M. Silveira、Jussara M. de Almeida、Humberto T. Marques-Neto、Carlos Sarraute、Artur Ziviani,MobHet: Predicting human mobility using heterogeneous data sources,Computer Communications,95,54—68,2016。DOI。
一个人在商业区打电话,另一个人在附近发带定位的推文。两条记录既不属于同一个账号,也不是连续轨迹。把它们放到一起,究竟能补充城市的移动规律,还是会把两种不一样的采样方式混在一起?
MobHet 用区域转移图统一这些记录,再比较不同信息对预测的贡献。它给出的答案相当具体:共享区域图能处理不同来源;联系人信息也有帮助,但这两种收益在论文中来自不同实验,不能合并成一个无条件成立的融合故事。
先说结论
- 模型预测人在离散时间窗内所在的区域,以区域完全命中的比例评分;研究使用 500 米边长网格,并不直接预测道路轨迹或精确坐标。
- 区域热度、区域间转移频率和联系人共处概率可以共同改善位置预测,但联系人定义过松或过严,表现都会下降。
- 巴西电话与推文中的身份无法对应,数据融合依靠共享空间图;由于巴西电话记录没有被叫标识,跨来源实验只使用热度和转移频率。
- 加入第二种来源没有自动超过表现最好的单来源结果。数据如何对齐、是否出现训练中没有见过的区域,都会改变成绩。
两类记录,真的在测同一件事吗?
电话记录把位置关联到通信基站;带定位的推文给出发帖坐标。前者随通话发生,后者随发帖发生,都不能直接代表每个人全天的连续移动。论文先删除只出现一次电话或推文的用户,再把空间统一成网格。
| 数据 | 时间和范围 | 过滤后规模 | 可提供的信息 |
|---|---|---|---|
| MobilePhone-BR | 巴西五座大城市,2011—2014 年间 27 份短时采集 | 874,147 次通话、表内合计 383,742 用户 | 通话时间与起讫基站,无法推断呼叫双方关系 |
| Twitter-BR | 与巴西通话采集对应的地点和时段 | 974,406 条推文、表内合计 392,848 用户 | 定位、关注关系和转推互动 |
| MobilePhone-MX | 墨西哥,2014 年 3 月 1—31 日 | 9,882,477 次通话、3,541,580 用户、22,304 基站 | 增加被叫匿名标识,可估计互动关系 |
巴西的用户数量是各采集批次的表内汇总,不能直接当作整个时期去重后的城市居民数。Table 2 给出各城市、日期、时段及样本量;Table 1 汇总符号。这些记录描述特定服务的活跃用户,不能自动推广到全部居民。
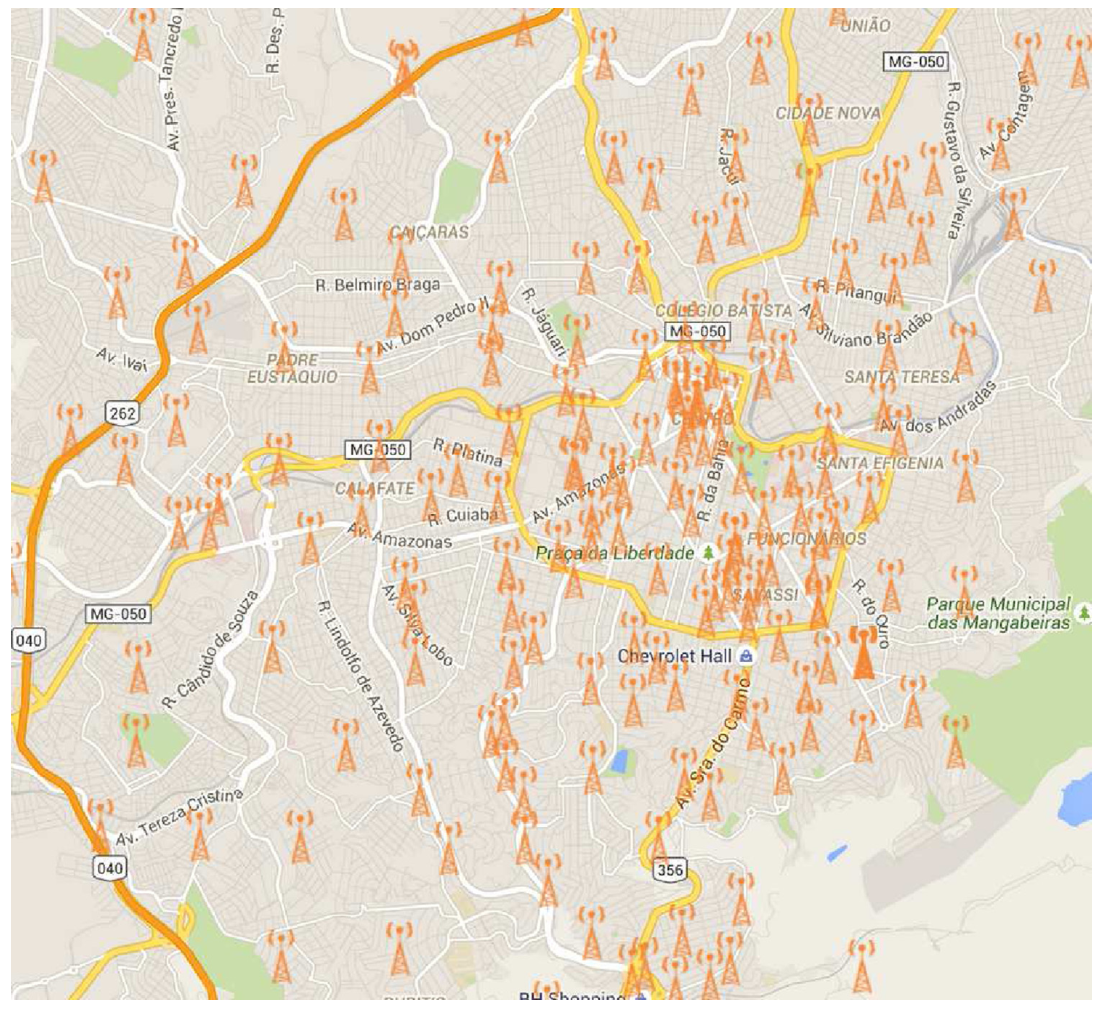
图 2|电话位置在城市里由哪些观测点产生?这张单面板地图展示贝洛奥里藏特的基站,橙色天线符号为位置点,底图提供城市道路背景。观测点分布并不均匀;图本身没有给出各点用户量,也不能把每个图标当作一个等面积服务区。来源:原论文 Fig. 2。
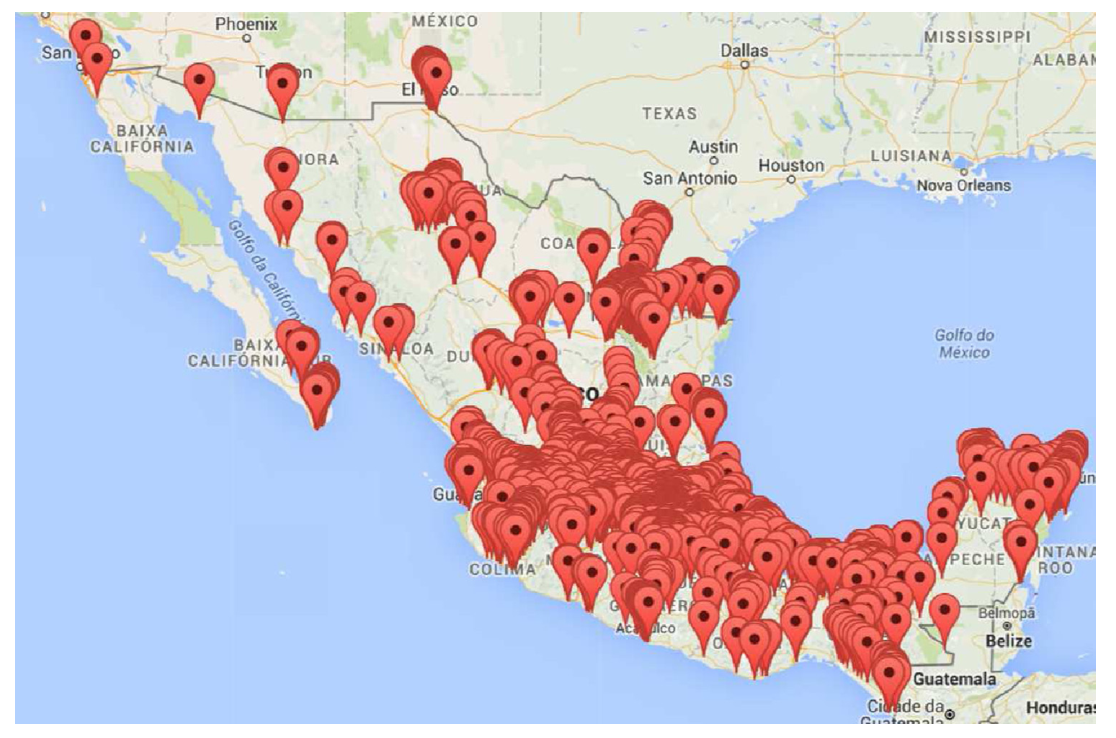
图 3|另一个国家的数据覆盖在哪里?单面板地图以红色标记展示墨西哥基站。南部和中部标记更密集,但地图密度不是人口密度估计,更不是对每个人的连续追踪。来源:原论文 Fig. 3。
巴西两类数据独立收集,论文不能识别电话用户与推文用户是否为同一个人,建模时将两组身份视为不相交。因此,所谓异构数据融合首先是把不同人的记录投到共同区域,而不是拼出某个个人的完整跨平台生活史。
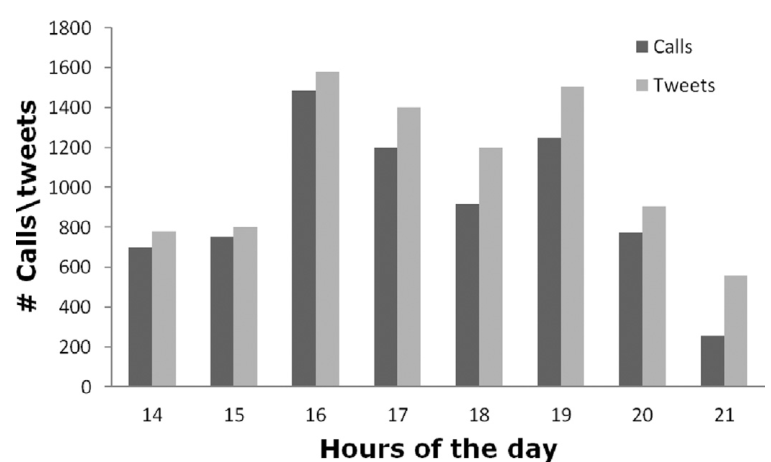
图 4|同一时段,两类数据的出现频率相同吗?横轴为 2014 年 6 月 29 日里约热内卢的一天内小时,纵轴为记录数;深灰为电话、浅灰为推文。两者均随时间波动,且数量不一致。按小时学习可以减少把不同活动时段混为同一分布的问题,但不能消除平台选择偏差。来源:原论文 Fig. 4。
一张区域图,怎样变成下一时刻的位置概率?
MobHet 将地区作为节点,把相邻时间窗中出现的区域转移作为边。留在同一区域也有自环。所有用户的记录共同形成一张群体图,再从待预测用户的起点在图上模拟,不是为每个人训练一套独立参数。
三个候选线索分别是:区域热度 P,即训练期到访该区域的不同用户数;转移频率 T,即相邻时间窗之间从一个区域去另一个区域的经验频率;联系人共处概率 C,即在一定数量联系人同处某区域时,用户也在该区域的条件概率。C 由训练数据估计后跨用户汇总,因此仍是一种群体统计。
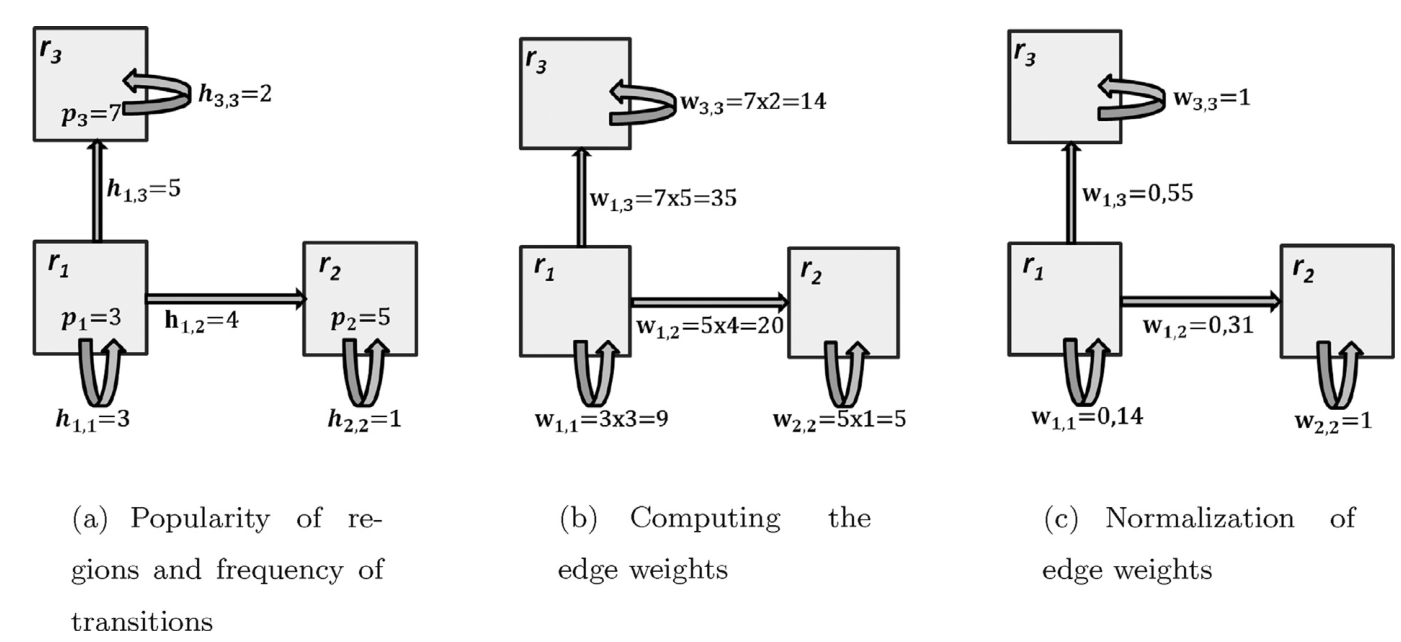
图 1|热度和转移频率怎样共同决定下一步?(a)三个区域的热度 p 与边上的转移频率 h,自环代表停留;(b)将目的地区域热度与对应转移频率相乘,得到边权;(c)对同一出发节点的所有出边归一化,得到概率。例如从 r₁ 到 r₃ 为约 0.55,到 r₂ 约 0.31,停留约 0.14。图中的 r₂、r₃ 只有自环可选,归一化后为 1。来源:原论文 Fig. 1。
只结合 T 和 P 的版本叫 MobHet-TP;再加 C,叫 MobHet-TPC。论文还比较只用 C、组合 TC、组合 PC 的变体,用来判断某条信息被移除后会发生什么。所选特征相乘后归一化,构成随机转移概率。
这里还有一个重要假设:电话和推文是稀疏事件。两个已知记录之间的空白,被处理为在两个端点区域各停留一半间隔,并在一个时间窗内完成转移。时间窗内发生又返回的旅行没有被单独恢复。因此,评价位置也依赖这套填补规则,不等同于独立 GPS 真值。
预测的时间边界,怎样避免与未来混淆?
研究使用两种训练测试划分。跨日方案用较早日期的同一小时训练,预测较晚日期相应小时;同日方案则把每小时的前 30 分钟用于训练,后 30 分钟用于测试。两者都遵守训练先于测试,但各自在短时段内假设移动规律大致稳定。
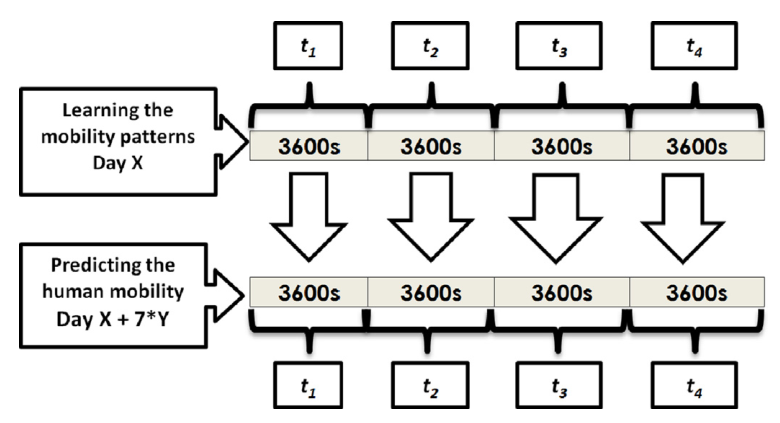
图 5|过去一天的规律怎样应用于后来一天?上方为训练日的连续一小时区段,下方为后续日期的对应区段,箭头表示用各训练时段学习的规律预测相应测试时段。图用相隔若干周作示意;具体日期配对由正文列出,不能据此假定所有样本都完整覆盖连续数周。来源:原论文 Fig. 5。
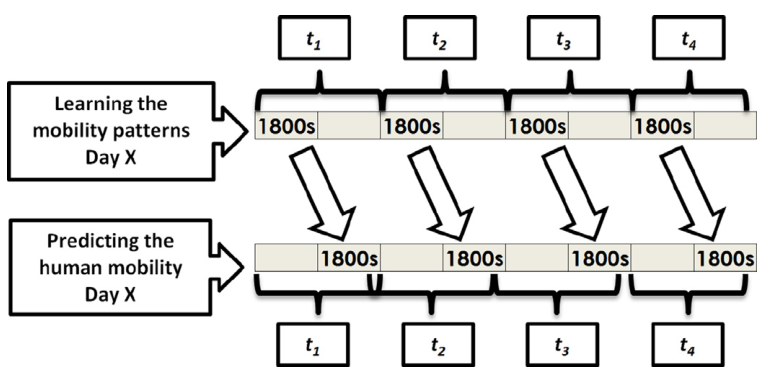
图 6|只有一天数据时,怎样前推?上方为各小时前半段的 1,800 秒训练片段,下方为后半段的 1,800 秒测试片段,箭头连接同一小时内的前后半段。这里的半小时是训练或测试周期,区别于内部的 5 或 10 分钟预测时间窗。来源:原论文 Fig. 6。
模拟以用户测试期第一条观测所在区域作为已知起点,再逐窗生成位置。评分分母是测试集中的用户—区域—时刻记录,分子是预测区域正确的记录。每个实验重复 50 次,表格报告平均准确率及 95% 置信区间;这不是说从一个未知位置开始,能连续无误地预测半小时。
对照方法 SMOOTH 和 Leap Graph 原本面向移动建模,本文把它们适配成相同网格和时间评价下的预测器;例如为 Leap Graph 增加自环和权重。因此,结果说明这套实现与设置中的表现,不能直接替代与后来所有预测算法的比较。
联系人有用,为什么不能越多越好?
Twitter 的第一种关系是双方互相关注,第二种关系 ContactStrength 用双方互动次数占某用户全部互动次数的比例来筛选联系人。墨西哥数据以通话互动建立后一种关系。比例的分母随用户而变,所以关系可以有方向性;25% 表示至少四分之一互动集中到该联系人,并不表示四分之一用户被保留。
Table 3 的里约同日、5 分钟窗口示例中,TP 平均准确率为 0.545;TPC 使用互相关注为 0.559,使用 25% 互动阈值为 0.678,50% 为 0.684,后两者统计上相近。墨西哥示例中,TP 为 0.619,TPC 在 25% 阈值时为 0.692。联系人提供了额外预测信息,但关注一个账号,不一定等于能反映移动联系。
门槛也有代价。Table 4 中,里约训练数据满足至少一个联系人的用户,在 25% 阈值下为 400 人,50% 为 392 人,75% 只剩 78 人。阈值太宽松可能引入较弱关系;太严格则削减可学习的样本。Table 5 把最低联系人数 m 从 1 增至 2、3,多数设置下降,但互相关注情形并非每次都单调下降,不能把 m=1 写成普遍规律。
如果测试用户不满足联系人数量条件,TPC 等组合版本会退回不用 C 的对应模型。因而整体准确率还受联系人可用性影响,未来部署时也需要交代联系人信息什么时候能够取得。这些结果说明预测关联,不能证明一个人因为朋友出现而决定移动。
Table 6、7 对时间设置作补充:里约 TPC、25% 阈值同日 5 分钟准确率为 0.678,10 分钟为 0.631;墨西哥对应示例为 0.690 与 0.665。Table 7 的原地停留模型在这些设置中约为 0.21—0.24。更细窗口在本文评分下较好,但这涉及离散化与移动填补,不能推广成所有数据里窗口越细越好。跨日与同日的有限比较没有显著差异,也不等于长期漂移已经解决。
把电话与推文合并,就一定更准确吗?
跨源实验比较两种对齐方式:将推文映射到最近基站;或者把基站位置当作一个点,与推文一起映射到网格。前一种会把推文的精细坐标压到基站位置,后一种保留两类点再统一网格。巴西电话数据缺少联系人,所以这些实验只比较 TP 与两个对照,不运行完整 TPC。
Table 8 的里约示例揭示了融合的代价。TP 只用电话时准确率为 0.799,只用推文为 0.545;把推文映射到电话位置后为 0.744,把电话作为点和推文合并后为 0.531。融合结果并没有超过最好的电话单源结果。前一种对齐下 Leap Graph 为 0.745,TP 为 0.744,数值几乎相同,也不能把所有场景写成 TP 都明显领先。
推文单源较难预测的一个原因,是测试出现更多训练未见区域;区域图没有这些节点,模型便无法预测到它们。这既是一个模型边界,也说明不同采样方式会改变任务难度。
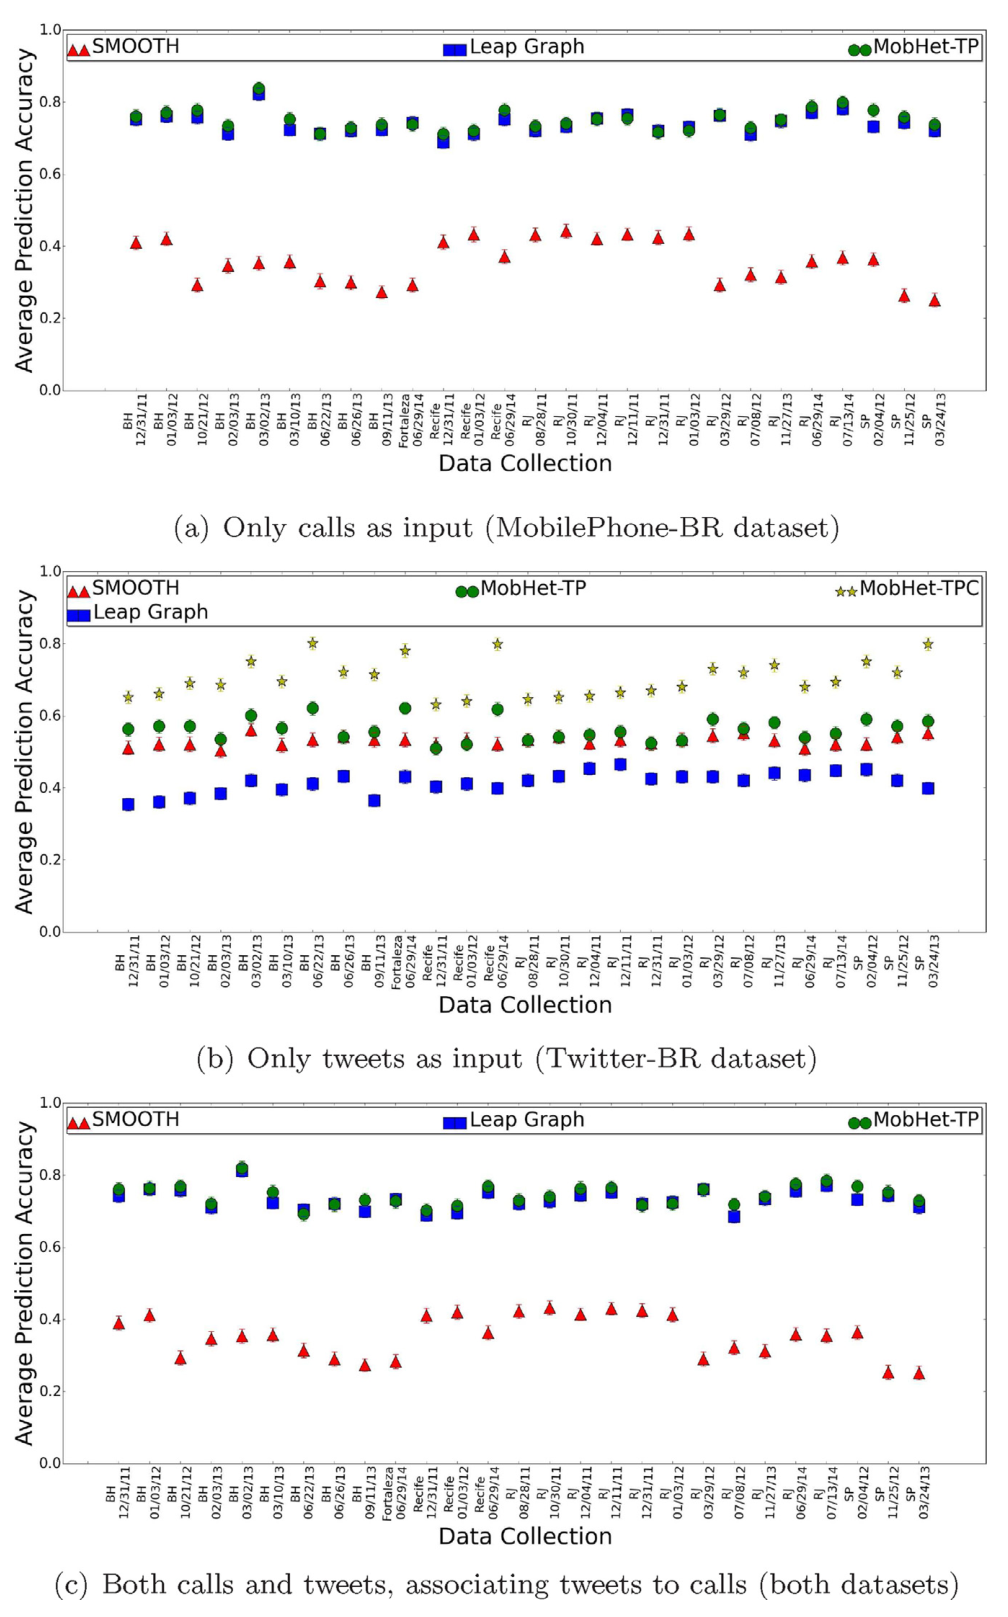
图 7|上述比较是否只出现在一个里约样本?(a)只用电话,TP 绿圆与 Leap Graph 蓝方通常接近,两者高于 SMOOTH 红三角;(b)只用推文,加入联系人信息的 TPC 星形整体更高,TP 绿圆与 SMOOTH 红三角较接近;(c)电话加推文,并将推文映射到基站,TP 与 Leap Graph 再度接近。三幅横轴均为城市—日期采集批次,纵轴为平均位置预测准确率,误差线表示不确定性;均为同日训练测试、5 分钟时间窗。完整组合图保留三种不同实验,不能将(b)的 TPC 成绩当成(c)的融合成绩。来源:原论文 Fig. 7。
论文汇总 27 个巴西采集批次:电话单源 TP 相对 Leap Graph 平均提高约 6%;推文单源最佳 TPC 相对 Leap Graph 约提高 71%;异构融合 TP 相对 Leap Graph 约提高 4%。这些是相对提升,比较对象和模型版本不同,不能相加,也不是分别增加 6、71、4 个百分点。
MobHet 的贡献因此更接近一套可组合的区域统计框架:它能容纳不同来源,检验热度、转移与联系人的作用。它没有消除平台偏差,没有恢复被事件采样遗漏的全部旅行,也没有证明更多来源永远带来更好的个人预测。
一句话总结
共享区域图可以把电话和推文放进同一套预测框架,联系人也能补充线索,但是否提高准确率,取决于数据对齐、关系门槛和可观测区域,而非数据源数量本身。
核心来源
Lucas M. Silveira, Jussara M. de Almeida, Humberto T. Marques-Neto, Carlos Sarraute, Artur Ziviani. MobHet: Predicting human mobility using heterogeneous data sources. Computer Communications, 95, 54–68, 2016。DOI,出版社书目信息。本文依据论文全文;Fig. 1—7 均为完整原图,Table 1—8 的定义、样本与比较在对应段落说明。
作者介绍
- Lucas M. Silveira:论文署名为巴西米纳斯吉拉斯联邦大学(UFMG),并列为通讯作者。
- Jussara M. de Almeida:论文署名为巴西米纳斯吉拉斯联邦大学(UFMG)。
- Humberto T. Marques-Neto:论文署名为巴西米纳斯吉拉斯天主教大学(PUC Minas)。
- Carlos Sarraute:论文署名为阿根廷 Grandata Labs。
- Artur Ziviani:论文署名为巴西国家科学计算实验室(LNCC)。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果融合后的平均准确率下降,可以先把测试记录分成训练中已见区域和新区域,再分别评估。若下降集中在新区域,问题主要是候选图覆盖;若已见区域也下降,就需要进一步检查平台间采样权重和空间对齐,而不是笼统归因于异构性。
联系人模型还可以同时报告两条曲线:可使用联系人信息的用户比例,以及这些用户相对不使用联系人的准确率收益。只有同时看到覆盖与收益,才能判断一个高分是否来自对大多数人的改善,还是仅来自一小群关系密集用户。