一份导航轨迹、一份零散签到,怎样看出是同一个人?
论文名片|Wei Cao、Zhengwei Wu、Dong Wang、Jian Li、Haishan Wu,Automatic User Identification Method across Heterogeneous Mobility Data Sources,ICDE 2016,978—989页。DOI:10.1109/ICDE.2016.7498306,作者公开全文。
同一个人开导航时留下密集位置点,查地图时只留下几次查询,社交签到又可能隔几天才有一条。把这些轨迹叠起来,点的数量和时间几乎对不上。如果另一位同学也常在同一栋宿舍楼和教学楼出现,只看空间相近,还可能把两个人弄混。
这篇论文研究的正是跨来源匹配:不靠统一用户编号,而从不同应用记录的空间活动中寻找同一位用户。它提出自动用户识别框架AUI(Automatic User Identification),利用活动地点、记录频次和地点之间的空间关系筛候选,并在不够确定时拒绝输出。最醒目的高准确率,必须和它选择回答多少记录一起看。
先说结论
- 全国范围随机用户较容易区分,同一公司或校园内的用户更难。采样密度不同、时间区间不重合,也会改变匹配难度。
- 全国稀疏对密集实验中,AUI输出记录的准确率为99.94%,对应覆盖率为59.72%;这不是对全部用户几乎百分之百识别。
- 更困难的校园跨时段实验中,覆盖率60.81%、输出准确率90.09%;相同覆盖率下,k-BCT为61.38%,提高28.71个百分点。
- 信号相似度SIG利用共处位置的频次,减少相邻地点的重复证据,再给相隔较远的独立共同地点更多权重。这里的共同地点不要求同时到场,也不等于真实面对面接触。
为什么同一人的轨迹未必很像,不同人的轨迹反而很像?
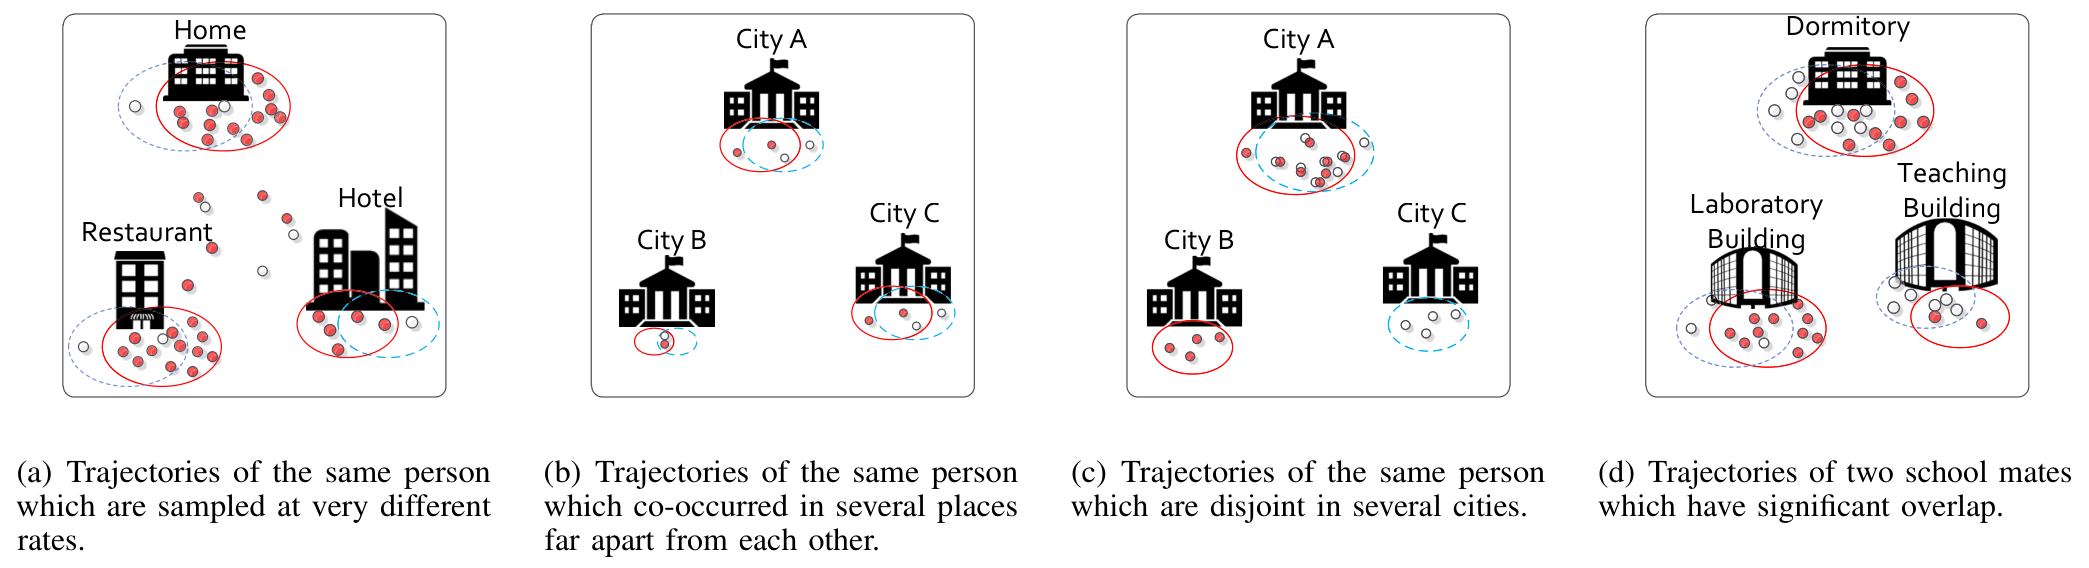
图 1|为什么单靠点数和距离容易认错人?
(a)同一人的两份记录密度相差很大,但共同涉及家、餐馆、酒店;(b)多个相隔较远的城市都有共同出现记录,提供更强的区分线索;(c)同一人的部分城市记录并不重合,仍可能在城市A有明显共同地点;(d)两名同学活动区域高度重叠,但在实验楼、教学楼的记录频次不同。红、白点及对应范围表示不同来源或用户的记录。来源:原论文 Fig. 1。
传统轨迹距离常依赖点与点接近,或需要速度、方向、时间顺序等信息。但稀疏来源连一天一个点都未必有,很难可靠重建移动过程。两份记录甚至采自不同月份,此时要求同一时刻同一地点,反而会排除真正匹配。
论文因而积累较长历史,比较空间活动中的重复模式。图2的例子覆盖2015年2月至5月、平均每天约五个位置点,家与工作场所逐渐显现,偶尔访问的王府井和植物园也留下线索。
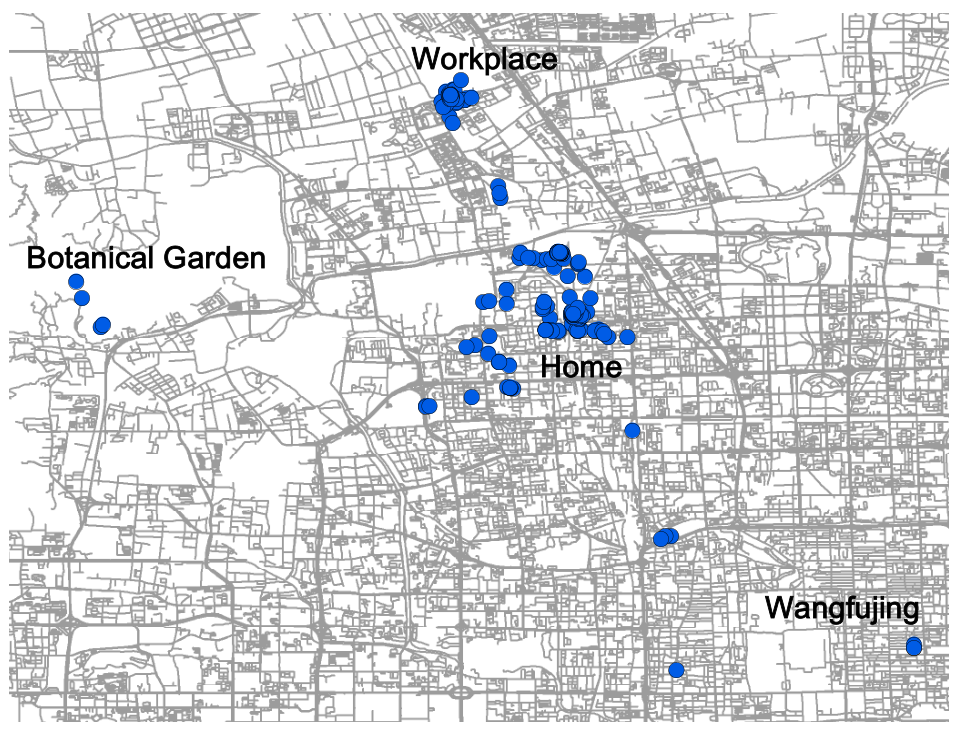
图 2|零散位置积累起来,还能留下什么信息?
蓝点是某个用户的记录,地图标注工作场所、家及两个访问地点,无子图字母。这是长期空间分布示例,蓝点并没有描绘完整连续路线,也不是每次出行都被观测。来源:原论文 Fig. 2。
本文所说共现(co-occurrence),在计算中是两份轨迹落入同一个空间网格的记录频次重合,取两者频次较小值。它不要求时间相近,因此不能把共现次数写成见面次数,也不能当作两人共享某个现实事件的证据。
任务本身还有一个条件:对来源A的一份轨迹,来源B中至多有一份属于同一用户,也可能没有。这与一个人拥有多个账户、多人共享设备等情况并不相同;输出匹配的仍是轨迹或匿名编号,而非直接恢复真实姓名。
先用什么办法,把庞大的候选范围缩小?
AUI分成预处理、多分辨率过滤、验证三部分,全部在MapReduce框架上实现。并行不是把每一对轨迹都算一遍,而是先用共同网格筛出少量值得细比的候选。
预处理把较密集的连续记录压成停留点。实验采用100米范围、半小时下限、12小时上限。上限是为了避免把稀疏记录中相隔几天的两个点误当作一直停在那里;对于极稀疏来源,一个原始位置点本身可能就成为代表点。压缩保留每段记录数量,因此后面的频次仍受应用采样方式影响,不是经过统一采样校正的真实访问次数。
默认过滤使用20米与200米两种网格。细网格中的重合区分力较强,较粗网格则缓和定位误差。出现用户过多的公共网格会被丢弃,减少地铁站等常见地点带来的无效比较;随后按照跨尺度的共现得分,保留每份查询轨迹得分最高的20个候选。
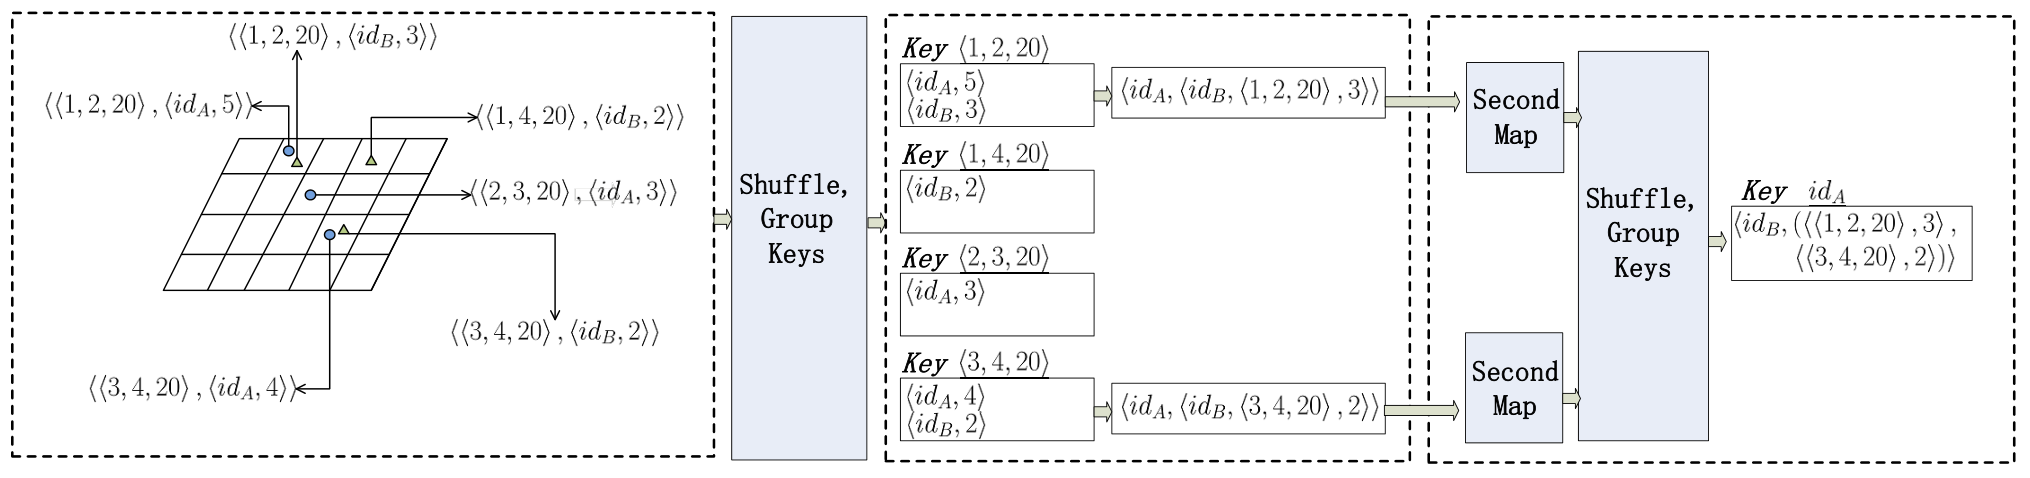
图 3|怎样让“共同出现过”变成小规模候选列表?
左侧圆和三角表示两个编号的停留点,网格携带不同记录数量;中间先按网格汇集相关编号,计算该网格中的频次重合;右侧再按查询编号汇集候选及其共同网格信息。图中为完整流程,没有子图字母。来源:原论文 Fig. 3。
表II列出的默认候选数为20、过密网格门槛为2000。表III中,保留20个候选时,六组实验的命中率约91.61%—99.66%。这里命中率按全部查询轨迹作分母,而某些跨时段查询在另一数据集里本来没有对应轨迹;它也不同于最终输出准确率。候选阶段漏掉真正匹配后,后面的精细评分不能凭空找回来。
网格尺度也不是越多越好。表IV中,全国稀疏对密集使用单一20米网格时,覆盖率28.92%、准确率100%;默认两种网格为59.72%、99.94%;四种网格则为92.01%、99.74%。更多尺度在这组数据中扩展了覆盖,但校园实验没有同样单调改善,不能当作所有来源通用的最优设置。
同一个公司和附近车站,算两条独立证据吗?
两份轨迹都频繁出现在公司,也可能频繁出现在附近公交站。若把公司、车站、周边每个网格都当独立证据,评分容易因为同一片活动区域被重复抬高。论文据此设计信号相似度(signal based similarity,SIG)。
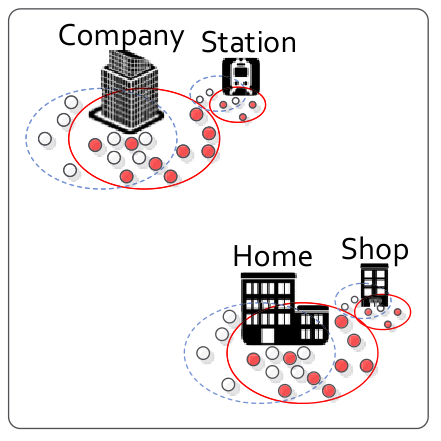
图 4|为什么共同地点不能简单按数量累加?
公司附近有车站,家附近有商店。红、白记录的空间重合可能来自两个主要活动区域,而非四个彼此独立的活动中心。原图无子图字母。来源:原论文 Fig. 4。
SIG首先把同一网格的共现频次转成饱和增长的分数:从没有共同记录变成有一些,增加的信息较大;本来已经有很多,再增加一条的贡献变小。这对应公式1的S形函数。
随后按照处理顺序,扣除之前已识别核心网格向附近衰减的贡献,只把剩余的正分数视为新的核心信号。公式2中的衰减系数控制“附近”能解释多少信息。最后,核心网格与此前核心地点相隔越远,所加权重可越大,但距离收益也会饱和,再汇总不同尺度的分数(公式3、4)。
这个设计保留了两种区别:在一个楼周围留下大量近邻点,与在几个相隔很远的活动地点都重合,信息不完全一样;只在某一城市记录不同,也不一定足以否定另一个城市中的强重合。
它是一套评分假设,不是同一人的后验概率。核心网格提取还依赖顺序,作者称实验中顺序对准确率影响很小,但这不能改写为数学上与顺序无关。
评分最高,就一定要输出这个匹配吗?
SIG适合寻找强共同地点,却仍可能把高度相似的同学弄混。AUI再加一个加权Jaccard相似度(weighted Jaccard similarity,WJS),比较两个网格频次集合重合了多大比例。
对每个网格,分子取两者记录频次的较小值,分母取较大值,分别求和后相除;各尺度再加权。与只奖励共同部分相比,这个比例同时会受各自独有记录影响。
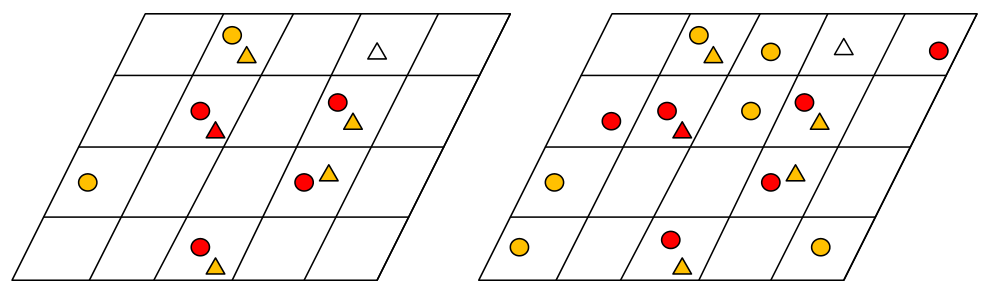
图 5|共同记录一样,为什么比例相似度仍会不同?
左右是两个无字母标记的示例,圆与三角表示不同编号,红、黄、白分别表示频次5、3、1。左图相似度为17/27≈0.63,右图为17/49≈0.35:共同频次相同,但右图独有部分更多。来源:原论文 Fig. 5。
单独使用WJS也有弱点:同一人的导航记录很多、签到很少,频次总量差异就可能压低相似度。AUI没有把两项分数简单相加,而是先设置较低门槛,再要求最终候选在两个分数上都不被另一个候选超越,并形成唯一最优者;若仍有互不占优的候选,就拒绝识别。
例如一人SIG较高、另一人WJS较高,算法不会仅凭某项领先就强行二选一。最终比较使用SIG门槛12、WJS门槛0.005。拒绝机制能降低输出错误,但也会使难题留在覆盖范围之外。
实验是在什么样的人群和记录上进行的?
数据来自百度不同移动应用中的导航、GPS位置、地图查询和带地理标记的记录。研究以一致的哈希用户编号作为匹配真值,进行算法计算时则依据轨迹寻找对应。哈希编号提供评估标签,不能据此认定位置序列本身不可关联。
| 人群 | 密集来源人数 | 稀疏来源人数 | 总体记录期 |
|---|---|---|---|
| 全国随机用户 | 31,511 | 6,396 | 2014年8月—2015年2月 |
| 同一公司员工 | 4,323 | 888 | 2015年3—5月 |
| 同一大学学生 | 14,115 | 1,992 | 2015年3—5月 |
每个人群有两种实验:稀疏来源对密集来源,以及将密集来源按时间拆成前后不重合的两段。全国拆成8—11月与12—2月,公司、校园拆成3月1日—4月15日与4月16日—5月31日。部分用户只在一个时段出现,因此前后人数不同。例如校园分别有9,695和12,497份轨迹,不能把14,115人当作每一组的查询分母。
表I也显示压缩幅度差别很大:全国密集来源每份轨迹平均由2303.12点变为196.65点,稀疏来源由81.31点变为20.47点。这是不同采样方式的证据,不代表稀疏用户实际出行更少。
比较“谁更准”,为什么必须把覆盖率对齐?
覆盖率=输出匹配的查询数÷全部查询数;准确率=输出正确数÷输出匹配的查询数。只回答最容易的少数查询,可以得到很高准确率,因而不同方法应在相同覆盖率下比较。
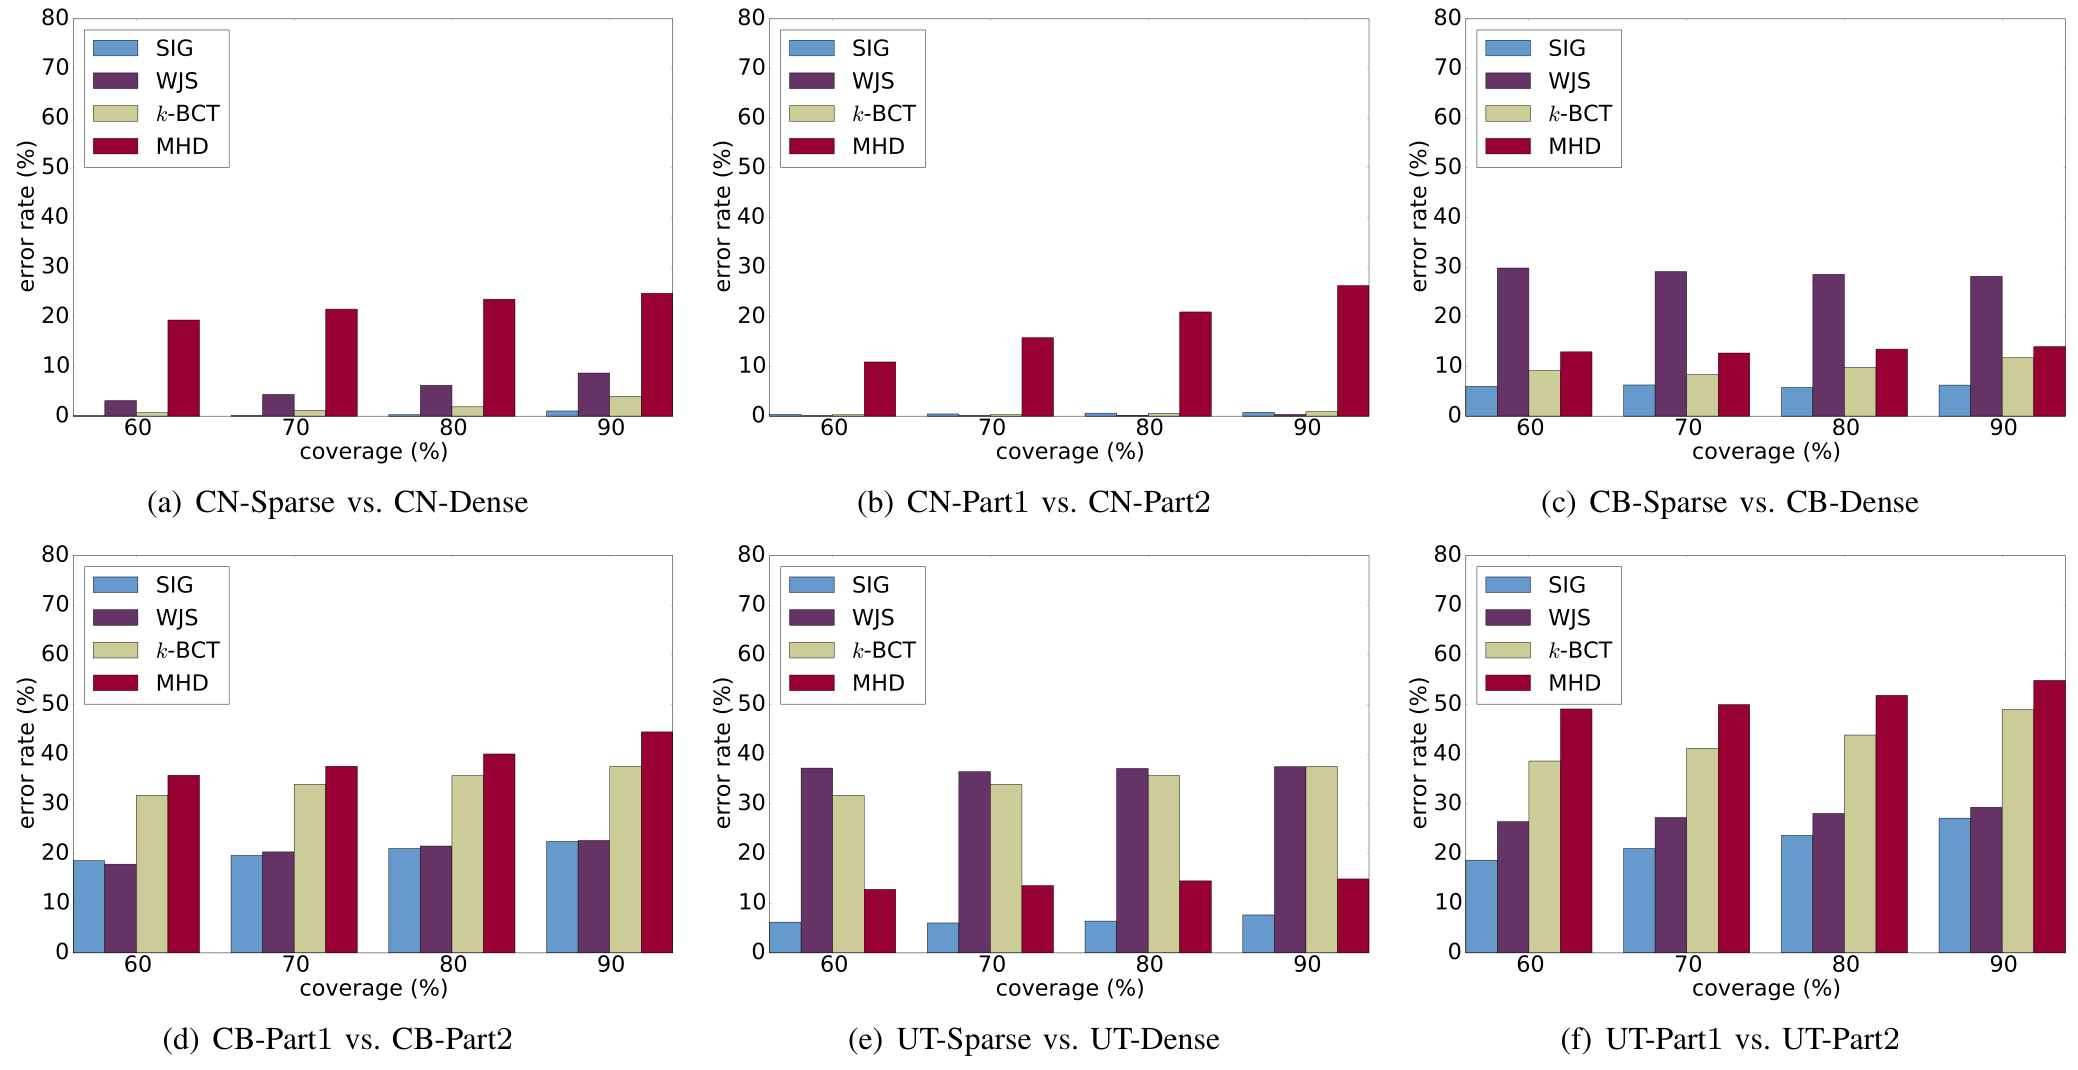
图 6|愿意回答更多查询,错误会怎样变化?
(a)全国稀疏对密集;(b)全国跨时段;(c)公司稀疏对密集;(d)公司跨时段;(e)校园稀疏对密集;(f)校园跨时段。各面板横轴为覆盖率60%—90%,纵轴为错误率,颜色对应SIG、WJS、k-BCT和MHD。这里比较的是四种单项相似度,不能把SIG柱子当成加入联合拒绝机制后的完整AUI。来源:原论文 Fig. 6。
SIG在多组困难对比中错误率较低。几何距离方法不一定能区分共用宿舍和教学楼的人;WJS则更容易受来源频次差异影响。但改进并非每行都优于每个单项方法:表VIII的公司稀疏对密集场景,AUI为97.39%,SIG为97.53%,两者不应被写成AUI全面占优。
| 实验(表VIII) | AUI覆盖率 | AUI准确率 | 相同覆盖率的k-BCT准确率 |
|---|---|---|---|
| 全国稀疏对密集 | 59.72% | 99.94% | 98.80% |
| 全国跨时段 | 88.35% | 99.80% | 98.20% |
| 公司稀疏对密集 | 73.31% | 97.39% | 91.59% |
| 公司跨时段 | 70.66% | 91.36% | 65.93% |
| 校园跨时段 | 60.81% | 90.09% | 61.38% |
校园跨时段结果最能说明联合拒绝策略的价值:在相同60.81%覆盖率下,SIG为80.96%、WJS为74.97%、MHD为50.89%,AUI达到90.09%。但这仍留下约39.19%的查询没有输出。把覆盖率与准确率相乘,正确输出约占全部查询的54.8%;这只是帮助理解分母,不等于在所有确有匹配用户中的召回率。
校园稀疏对密集在原文不同表中报告不一致:表IV默认设置列为覆盖71.18%、准确90.20%,表VIII为覆盖72.84%、准确95.63%。两者不宜拼成一个统一结果。论文的其他对比与困难跨时段结果仍可分别阅读,但不能用这组不一致值支撑精确的统一性能结论。
哪些设计真正起作用,哪些代价被留下?
参数实验进一步拆解方法。表VI在只用SIG、固定90%覆盖率时,校园稀疏对密集的准确率由不考虑邻近衰减时的87.06%,提高到默认衰减系数下的93.15%。表VII的同一设置中,不考虑核心地点距离时为76.00%,默认饱和距离加权为93.15%,线性距离加权为86.14%。这支持“邻近证据去重”和“远距离收益饱和”的设计,不能与表VIII不同覆盖率的完整AUI数字混比。
过滤公共网格也有代价。表V的校园跨时段实验中,过密门槛从50升至2000时,覆盖率由47.08%升至60.81%,准确率由88.45%到90.09%,运行时间由33秒升至521秒。更严格丢弃公共区域更快,却可能同时丢掉有用线索。
实验在10节点Hadoop集群上运行,每节点双核2.1GHz处理器和8GB内存,采用Python流式任务。它证明这批数据上的并行可行性,没有据此证明手机端实时运行,也没有独立给出在全国全量用户规模下的相同识别率。
从数据融合走向实际使用,还缺什么?
论文展示了跨应用、不同密度与不同时段记录之间的关联能力。它也提醒,去掉统一编号之后,位置历史仍可能被重新联系起来。但这些数据仍来自同一服务商及特定用户群,尚未验证任意供应商、任意城市或更长时间生活变化后的表现。
阈值和网格等参数经过这批实验选择,并不自动适合新来源。多人共用设备、一个人对应多个账户、错误真值或持续搬迁,也超出了“至多一个匹配”的简单条件。AUI能够拒绝部分查询,不意味着留下的匹配足以在每个高代价应用中直接作为身份事实;误匹配风险仍需按照实际用途独立评估。
一句话总结
跨来源识别依靠长期空间模式,也依靠承认不确定性;读高准确率时,必须同时问算法回答了多少人、哪些难题被拒绝。
核心来源
- Cao, W., Wu, Z., Wang, D., Li, J. & Wu, H.(2016). Automatic User Identification Method across Heterogeneous Mobility Data Sources. IEEE 32nd International Conference on Data Engineering,978—989。论文DOI,作者公开全文。本文方法、算法1—4、表I—VIII及全部图1—6据原论文,各图保留完整原组合。
作者介绍
按论文发表时署名介绍,不推断当前任职和职称。
- Wei Cao:清华大学交叉信息研究院与百度大数据实验室共同署名作者,本文第一作者。
- Zhengwei Wu:百度大数据实验室署名作者。
- Dong Wang:清华大学交叉信息研究院署名作者。
- Jian Li:清华大学交叉信息研究院署名作者。
- Haishan Wu:百度大数据实验室署名作者,本文通讯作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同样一个总体准确率,可能掩盖群体差异。校园里活动高度相似的人更难区分,实际评估应把居住条件、工作组织或采样稀疏程度相近的用户分别报告,检查错误是否集中在某些群体。否则,总体很准也可能伴随局部持续误配。
还有一个值得单独测量的问题:匹配用到的历史越长,性能增益是否会逐渐减小,而暴露的行为范围继续扩大?可以在不改变测试用户的前提下,比较不同历史长度下的覆盖率、误匹配率与新增敏感地点数量,为数据保留期限提供更具体的依据。