新站点之间大多没有人骑,模型看准的是零,还是那几条忙线?
论文名片|Yuebing Liang、Zhan Zhao、Chris Webster,Generating sparse origin–destination flows on shared mobility networks using probabilistic graph neural networks,Sustainable Cities and Society,2024,114:105777,2024年8月28日在线发表。DOI:10.1016/j.scs.2024.105777。2024年4月14日收稿,8月11日修回,8月26日接收。本文依据这一正式版解读;附录 A、B 附在同一篇正文末尾。
2017年9月,纽约 Citi Bike 又扩了一批站点。规划者如果要为新站点留车位、划自行车道,需要知道每一对站点之间平均每天有多少次骑行。重力模型会给出一个随距离下降的正数。可这张表里的大多数格子是 0:两个站都开着,整月也没有人从其中一个骑到另一个。
这项研究把任务定义成共享出行网络的起讫流量生成(origin–destination flow generation),用来支持扩站规划,并和“下一小时有多少单”的短期预测分开。零膨胀负二项图神经网络(zero-inflated negative binomial graph neural network,ZINB-GNN)为每一对站点输出一个分布,而不是一个点。在纽约 2013–2019 年的扩站测试里,它把大量接近零的新连接预测得更接近观测;日均至少 5 次的忙线仍然很难,80% 预测区间几乎罩不住这些观测。
先说结论
- 测试集共 17,023,154 个站点对—月份。日均至少 1 次的只有 322,877 条,占 1.9%;日均至少 5 次的只有 11,779 条,占 0.07%。分母都是这 17,023,154。
- 相对改造后的 Deep Gravity,一端是新站点的平均绝对误差从每天 0.050 次降到 0.028 次,降幅 (0.050−0.028)/0.050=44.0%;两端都是新站点时从 0.066 次降到 0.041 次,降幅 37.9%。
- 这两类新连接的流量重叠指标 CPC 从 0.393 升到 0.550、从 0.300 升到 0.525。正文写后一项提高 42.9%;按前一项的算法 (新−旧)/旧,应是 75.0%。42.9% 等于 (0.525−0.300)/0.525。
- 全体新连接的 80% 区间大约覆盖九成观测,平均宽度约 0.1 次/天。日均至少 5 次的子集上,覆盖率只有 0.038、0.003 和 0.008。高覆盖率主要来自零和低流量。
- 去掉零膨胀,误差上升比去掉起讫图更明显。SHAP 把长距离和介入站点排在前面,但这是对模型输出的归因,不是选址的因果效应。
站点一多,为什么表里的零会变多?
研究对象是站点到站点的日均行程,不是一个人的轨迹,也不是行政区之间的通勤人数。对月份 m 里同时运营的站点 i 和 j,日均行程等于该月从 i 到 j 的行程数,除以两个站点都在运营的天数。i 到 j 和 j 到 i 是两条记录。系统按月做成一张快照,因为站点会新增或撤除。
数据来自纽约 Citi Bike 的公开行程,时间从 2013 年 7 月到 2019 年 12 月,用来避开新冠疫情对骑行的影响。2013 年约有 330 个站点,2019 年 12 月超过 800 个。文中标出四次明显扩张:2015 年 8 月、2016 年 8 月、2017 年 9 月、2019 年 9 月。
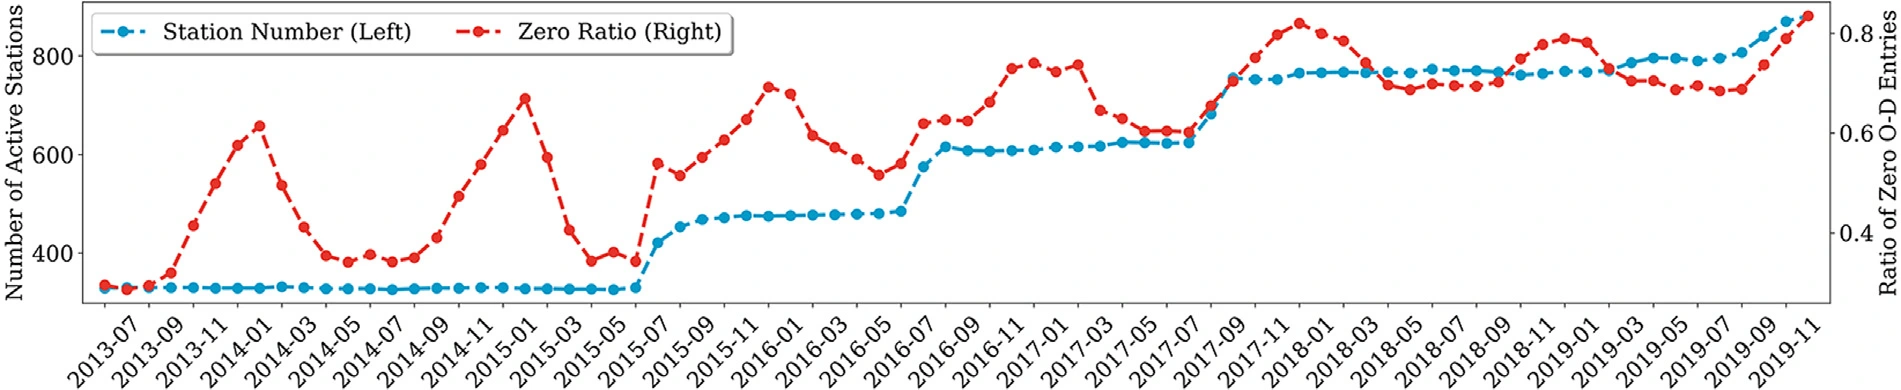
图 2|站点数增加时,整月没有任何行程的站点对占多大比例?
无字母子图。蓝线、左轴是当月活跃站点数,红线、右轴是起讫矩阵中的零值比例。蓝线在几次扩张处台阶式上升,红线则是冬季升高、夏季回落。正文把 2013 年 7 月的零值比例概括为约 25%,把 2019 年末概括为约 75%。图上的纵轴没有逐月读数表,不能把某一冬夏的峰值改写成精确百分比。来源:原论文 Fig. 2。
零变多有两层原因。网络变大以后,远距离站点对所占的比例上升,而这些对通常几乎没有骑行。与此同时,冬天的零值比例高于夏天,骑行受天气影响。所以后面的模型除了站点周围的环境,还放入月份和站点已经运营了几个月。
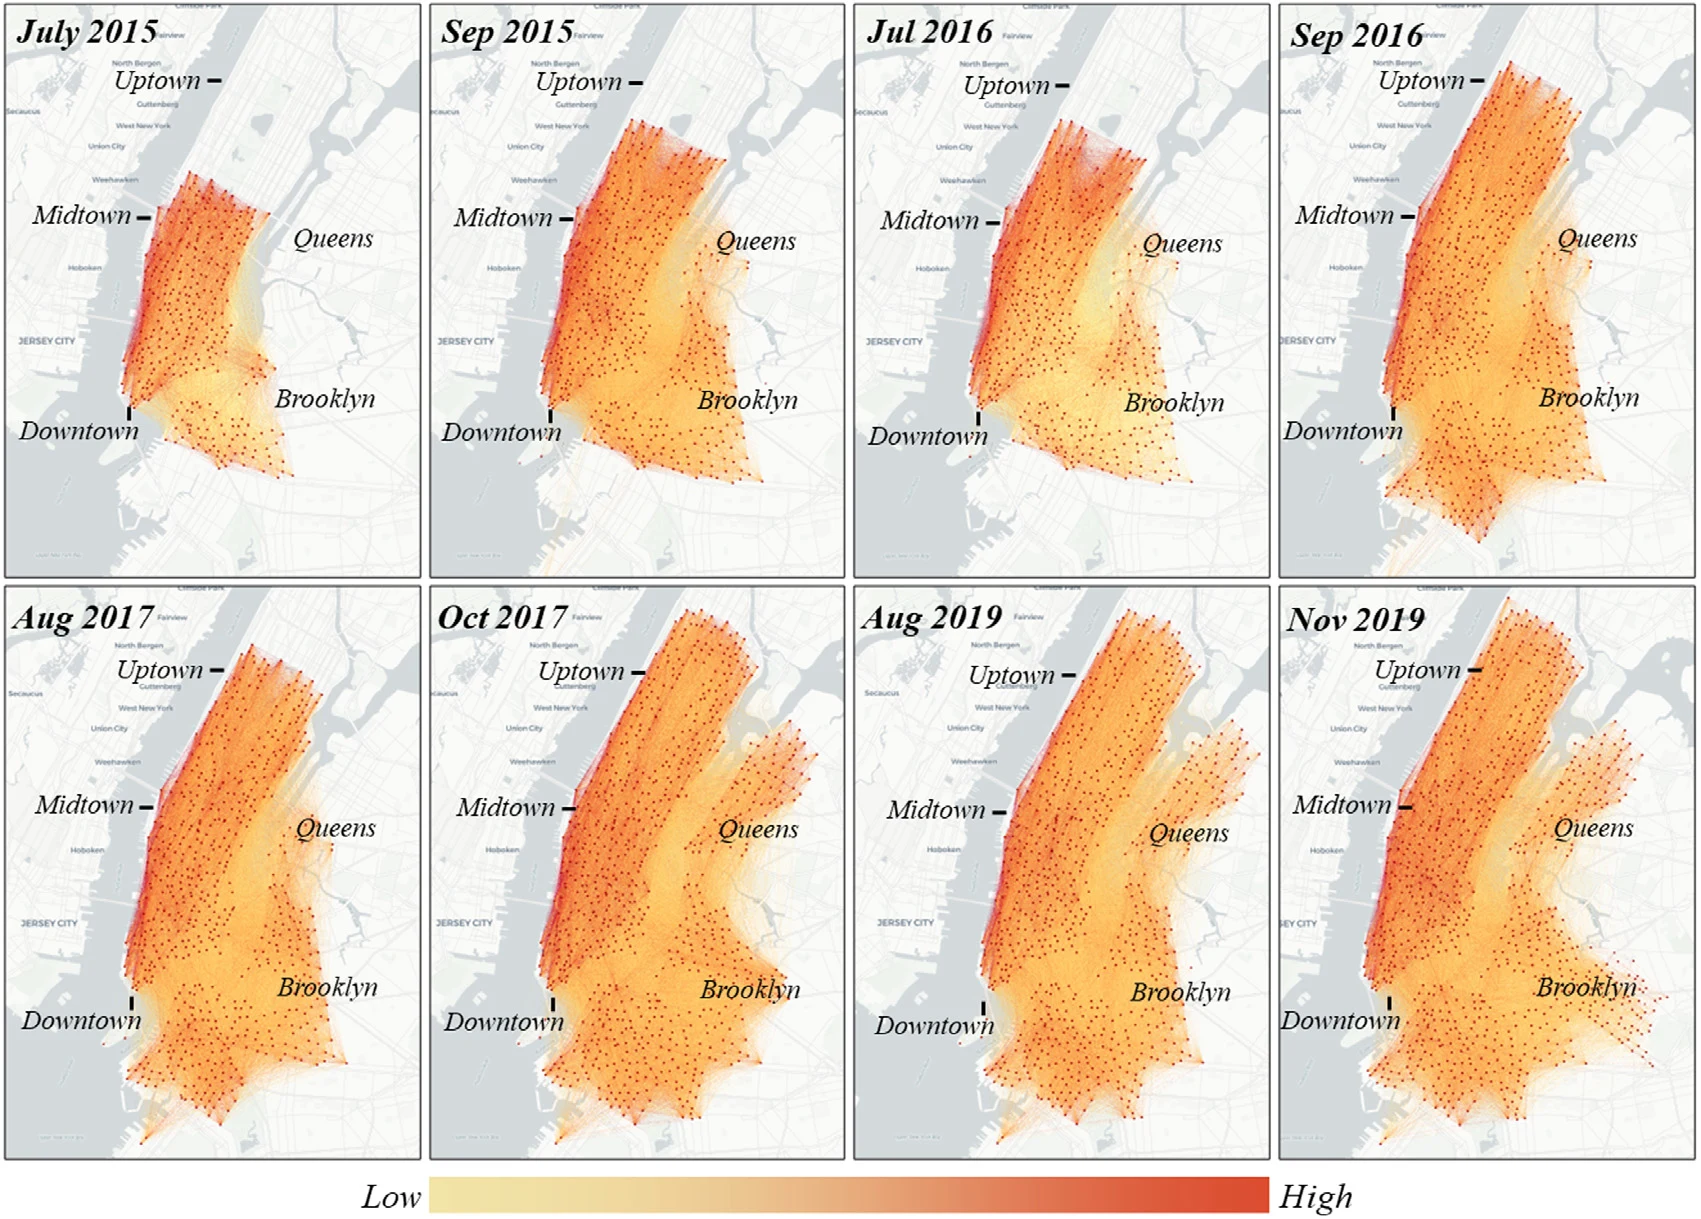
图 3|扩张前后,骑行联系集中在曼哈顿的哪些部分?
无字母子图,八张地图按时间排列:2015 年 7 月、2015 年 9 月、2016 年 7 月、2016 年 9 月、2017 年 8 月、2017 年 10 月、2019 年 8 月、2019 年 11 月。颜色从黄到红表示该月站点对流量由低到高,图例没有给出行程数刻度。曼哈顿中城和下城始终更红,布鲁克林、皇后区和上城更黄、更稀;服务范围随扩张向外铺开。2019 年 11 月比 2019 年 8 月更淡,对应冬季零值上升,但不能从颜色读出精确倍数。来源:原论文 Fig. 3。
距离本身也不能单独决定流量。表 1 统计的是站点对,不是行程。路网距离超过 5000 米的 0/1 变量,均值是 0.7424,也就是样本中 74.24% 的站点对;500–3000 米只有 0.1111,短于 500 米只有 0.0003。路网距离的均值是 9525.3 米,标准差高达 42387.1 米;直线距离均值 6067.2 米,标准差 3288.6 米。两种介入机会的均值和标准差都印成 337.92 与 215.47,论文没有解释为何两种距离定义得到同一组数字。
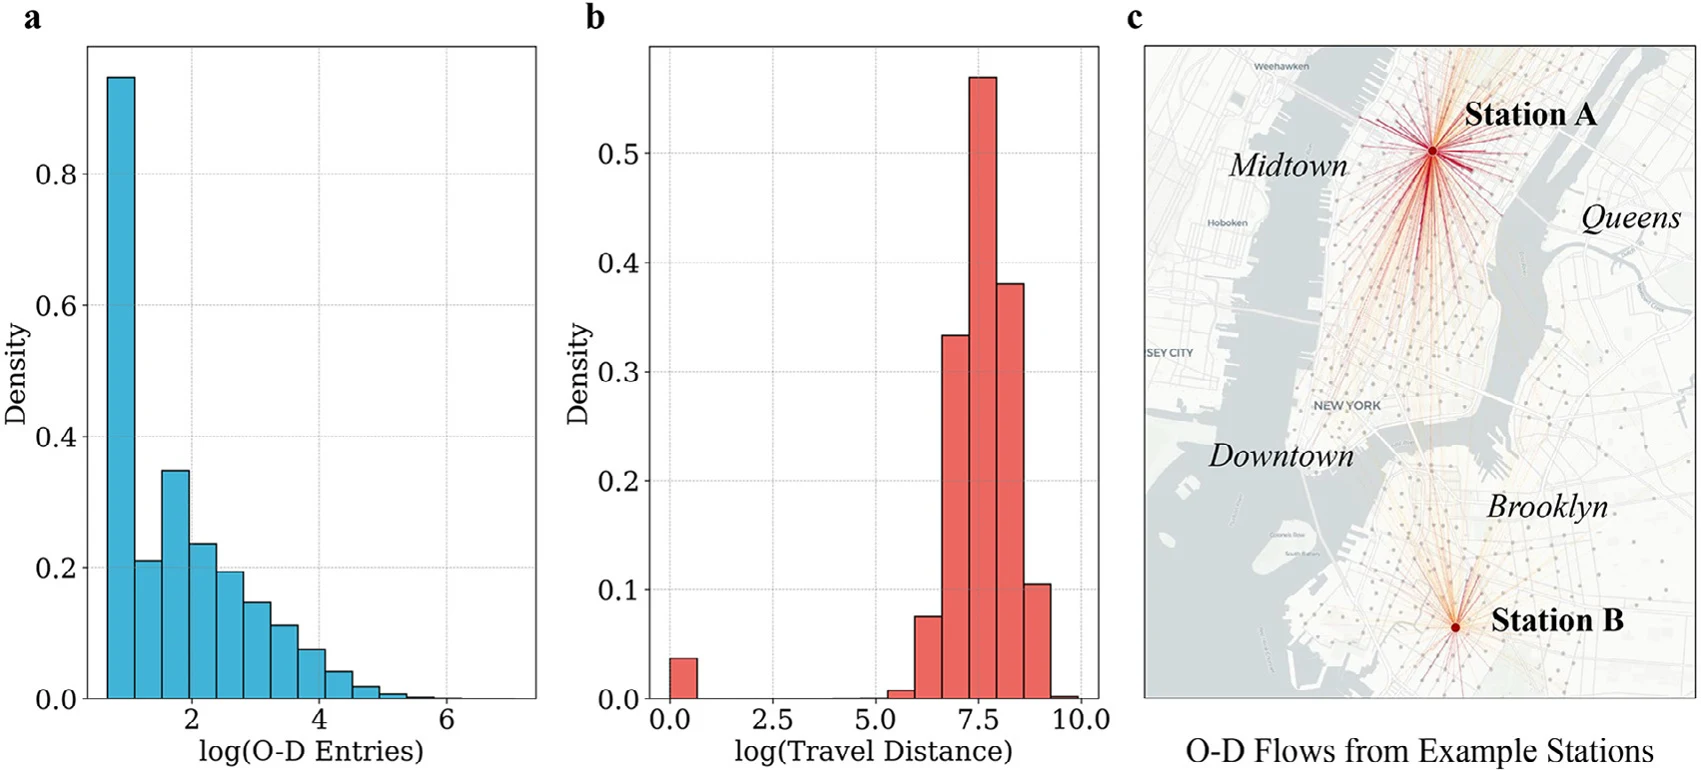
图 4|同样的距离,为什么有的站点拉出长线、有的只在附近打转?
(a)2019 年 8 月、至少有 1 次行程的站点对,横轴是流量的对数,纵轴是密度。最低一组最高,右尾很薄;零流量对没有画进这张图。(b)行程距离的对数分布。正文写大多数行程落在 500 米到 3 公里,这是行程的分布,不能和表 1 里 74.24% 的站点对超过 5 公里混成同一句话。(c)时代广场附近的站点 A 向多个区拉出较长连线,站点 B 主要是短线。颜色同样只区分相对高低。来源:原论文 Fig. 4。
要预测的是日均行程的分布,不是一条确定的人数
旧的重力模型和辐射模型用少量变量写出两地流量。后来的机器学习把每个站点对分开拟合,图神经网络则多半把站点或区域当成节点,用来填补大区之间较密的通勤或迁移。共享单车站点更细:零更多,未观测的天气和活动更难提前放进以月或年为跨度的规划模型,而且两条地理上接近的站点对会争夺同一批骑行者。
ZINB-GNN 把每一个站点对当成图上的一个节点。对目标对 (i, j),取 i 及其 k 个最近站点、j 及其 k 个最近站点,再让两组站点两两配对。节点数是 (k+1) 的平方。验证集上 k 从 5 试到 15、步长为 2,最终取 13,于是每张局部图有 196 个站点对。主模型不使用按距离写好的邻接权重;那个权重只用于后面的卷积变体。站点对之间的权重由两层前馈网络从特征里学习,再把邻居的特征向量加权求和。全系统若有 N 个站,潜在站点对是 N 的平方;局部图是为了避免把所有站点对放进一张大图。
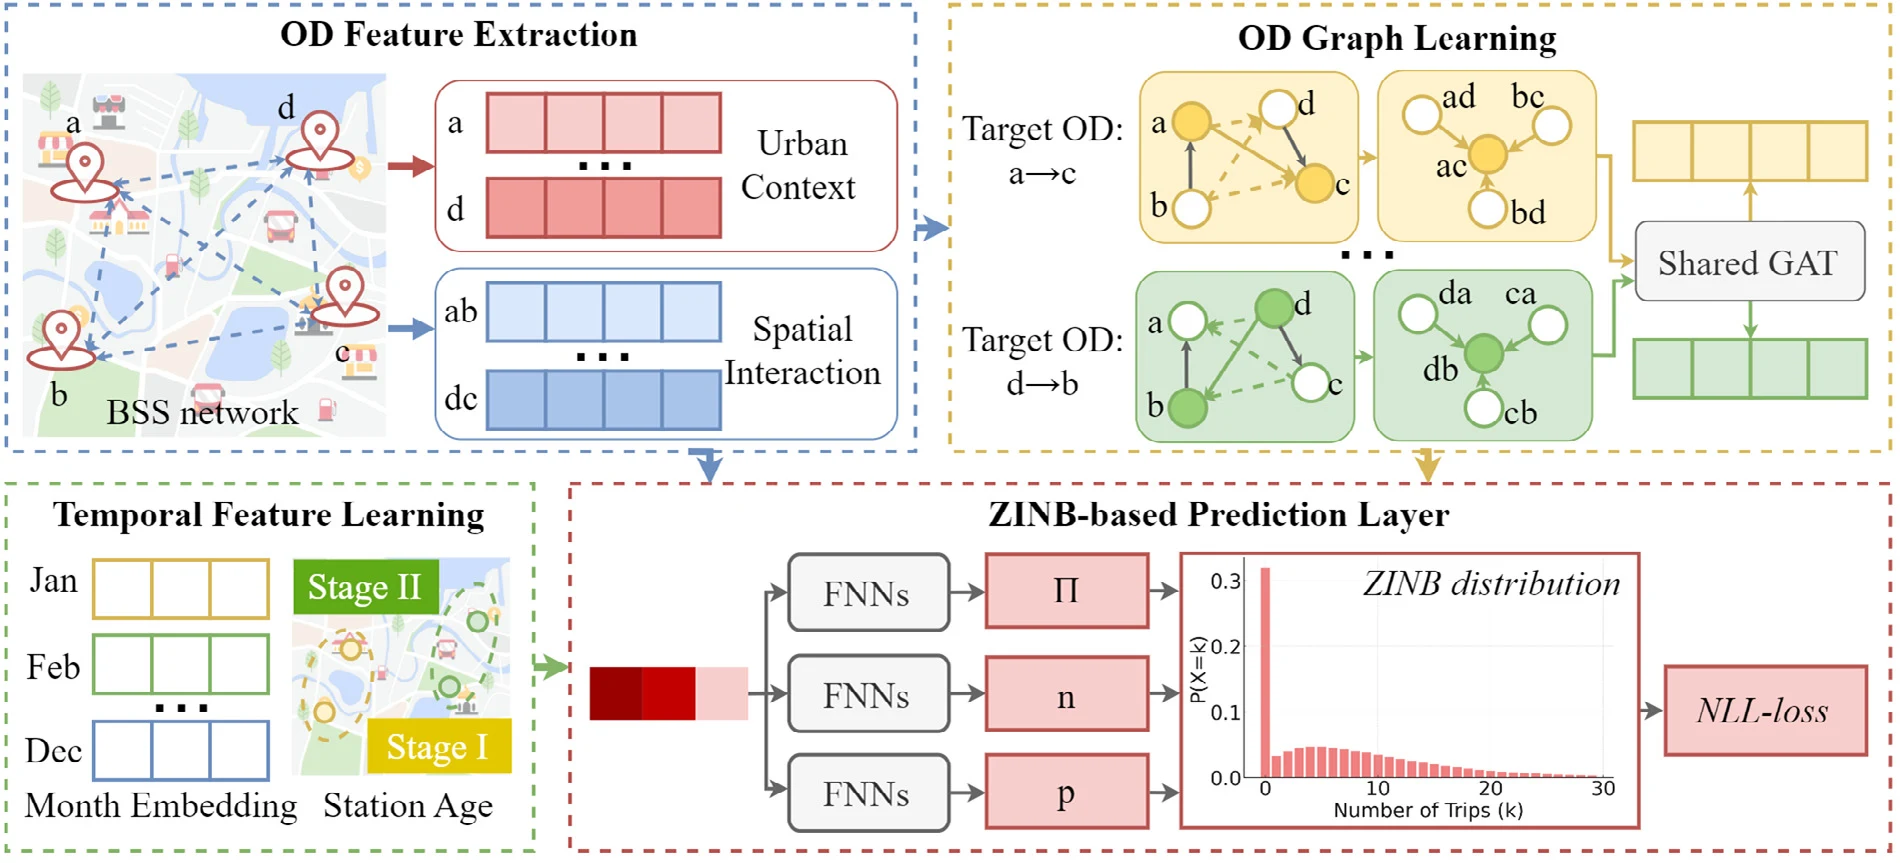
图 1|一个站点对的分布,由哪四类信息拼出来?
无字母子图,四个模块。左上从站点网络抽出起点、终点各自的城市环境,以及这一对的空间关系。右上为不同目标对建立局部图,经共享的图注意力压成向量;图中的 a、b、c、d 是示意站点,不是实验结果。左下用月份嵌入表示季节,用开通后的月数表示站点年龄,地图上的阶段只说明开通有先后。右下三组前馈网络分别输出零膨胀概率 π、负二项参数 n 和 p,再得到一条分布;训练目标是负对数似然。分布图的横轴是行程数,纵轴是概率,属于结构示意。来源:原论文 Fig. 1。
每个站点的环境特征包括 500 米范围内的兴趣点数量、道路数量和长度、2010 年人口普查的人口密度与族裔构成,以及到地铁和到其他共享单车站的距离。站点对特征包括路网距离、直线距离、方向、是否位于曼哈顿,以及比目的地更近或同样近的其他站点数量。人口统计停在 2010 年,行程一直到 2019 年,两者之间的人口变化没有逐年更新。
分布分成两段。π 是额外的零概率;没有被这一项解释掉的计数,再服从负二项分布。π 和 p 用 sigmoid 压到 0–1,n 用 softplus 保证非负。需要一个点预测时,取分布均值:(1−π) 乘以 n(1−p)/p。表中的误差比的是这个均值和观测日均行程。
这里有两处印刷和定义没有对齐。观测值是日均行程,可以是小数,而零膨胀负二项通常用于整数计数;似然式里使用了伽马函数,所以印刷公式在正实数上仍有定义,但论文仍称它面向计数数据。另外,概率公式把零处的概率写成 π 加上剩余部分在 0 处的负二项概率;对数似然式却把 log π、log(1−π) 和 n log p 直接相加,正流量项的最后一项印成 y log(1−π)。标准负二项对应的是 y log(1−p),零处的对数似然也应先把两项概率相加再取对数。正文没有给出推导来消除这个差别,本文不把印刷出来的对数似然当成可直接复现的损失。
点预测的均方根误差和平均绝对误差,分母都是测试期各月站点数的平方之和,也就是全部有序站点对。CPC 被正文定义为预测与观测流量的重叠,范围 0 到 1,越大越好。印刷公式却是对每一对的 2 min(y, ŷ)/(y+ŷ) 求和,没有再除以站点对数量,因此不可能落在 0 到 1;它也不同于先对流量求和、再计算共同部分的常用写法。区间宽度和覆盖率的印刷公式同样是连加,正文却把它们解释成平均宽度和落入区间的比例。下面读表时采用正文和表中 0–1 数值的口径。80% 区间取所学分布的 10% 与 90% 分位。区间越宽,越容易盖住观测,所以覆盖率高并不自动等于预测更有用。
和谁比,新站点对上的误差降了多少?
训练用 2013 年 7 月到 2017 年 8 月、第三次大扩张之前的 10,241,513 个站点对,其中 80% 训练、20% 验证。论文没有给出划分后的整数,也没有说明这 20% 是按月份、按站点还是按站点对抽取。测试是 2017 年 9 月到 2019 年 12 月的 17,023,154 个站点对,里面包含 2017 年 9 月和 2019 年 9 月的新站。
| 测试集中的站点对 | 数量 | 占 17,023,154 的比例 |
|---|---|---|
| 两端都在训练期出现过 | 9,665,072 | 56.8% |
| 只有一端是新站点 | 6,265,128 | 36.8% |
| 两端都是新站点 | 1,092,954 | 6.4% |
三类数量之和正好是 17,023,154。新站点指训练窗口里没有出现过的站,不是 2019 年才开的站。
基线都按这个扩站场景改过。重力模型加入了两端的城市环境,不只用人口。Deep Gravity 原本假定起点总流出已知、只预测目的地概率;本文改成直接预测流量,因为规划时往往还没有总流出。XGBoost 使用两端环境和站点对特征。SI-GCN 与 GMEL 改用每个站点一张局部图,并用双线性函数由两端的向量相乘得到流量,结构上放不进站点对的距离和介入机会。深度模型用 Adam,学习率 0.002,批大小 32。基线用均方误差、最多 100 个 epoch,10 个 epoch 无改进则早停;ZINB-GNN 用负对数似然,5 个 epoch,每个 epoch 100 次迭代。主结果是 5 次独立运行的平均,表中没有标准差。输入特征做最小—最大归一化。ZINB-GNN 不对日均行程归一化;基线的输出做了归一化,论文说这样能改善基线。误差表的量级仍是每天的行程数,但正文没有单独写出反归一化步骤。
| 站点对 | 指标 | 重力模型 | XGBoost | Deep Gravity | SI-GCN | GMEL | ZINB-GNN |
|---|---|---|---|---|---|---|---|
| 两端旧 | RMSE | 0.713 | 0.437 | 0.298 | 0.434 | 0.467 | 0.328 |
| 两端旧 | MAE | 0.514 | 0.204 | 0.104 | 0.192 | 0.219 | 0.090 |
| 两端旧 | CPC | 0.288 | 0.482 | 0.579 | 0.356 | 0.336 | 0.616 |
| 一端新 | RMSE | 0.502 | 0.244 | 0.164 | 0.237 | 0.269 | 0.150 |
| 一端新 | MAE | 0.313 | 0.110 | 0.050 | 0.120 | 0.123 | 0.028 |
| 一端新 | CPC | 0.156 | 0.227 | 0.393 | 0.209 | 0.183 | 0.550 |
| 两端新 | RMSE | 0.540 | 0.820 | 0.208 | 0.253 | 0.283 | 0.171 |
| 两端新 | MAE | 0.340 | 0.211 | 0.066 | 0.124 | 0.134 | 0.041 |
| 两端新 | CPC | 0.196 | 0.174 | 0.300 | 0.208 | 0.130 | 0.525 |
误差单位是每天的行程数。两端都是旧站时,ZINB-GNN 的 MAE 0.090 和 CPC 0.616 最好,RMSE 0.328 不如 Deep Gravity 的 0.298。一端新时,MAE 相对 Deep Gravity 下降 44.0%,CPC 从 0.393 到 0.550,相对增幅 (0.550−0.393)/0.393=39.9%。两端新时,MAE 从 0.066 到 0.041,下降 37.9%;CPC 从 0.300 到 0.525。正文把这两个 CPC 增幅写成 39.9% 和 42.9%。42.9% 对得上 (0.525−0.300)/0.525,对不上与前一项相同的 (新−旧)/旧。按后一种算法,增幅是 75.0%。比较时应以表中的 0.300 和 0.525 为准。
XGBoost 在两端都是新站时 RMSE 升到 0.820,比重力模型的 0.540 更差。SI-GCN 和 GMEL 没有超过 Deep Gravity。论文把 Deep Gravity 的 CPC 0.393 和 0.300 说成不到 40% 的流量被正确预测。CPC 衡量的是流量重叠,不是每一对都命中或都没命中的比例。
ZINB-GNN 还能给出区间。两端旧站点的平均区间宽度是 0.322 次/天,覆盖率 0.836。一端新是 0.081 与 0.897,两端新是 0.137 与 0.907。正文说涉及新站点的观测大约 90% 落在区间内、平均宽度大约 0.1,指的是后两类,不是旧站点对。基线没有分布,这两列为空。
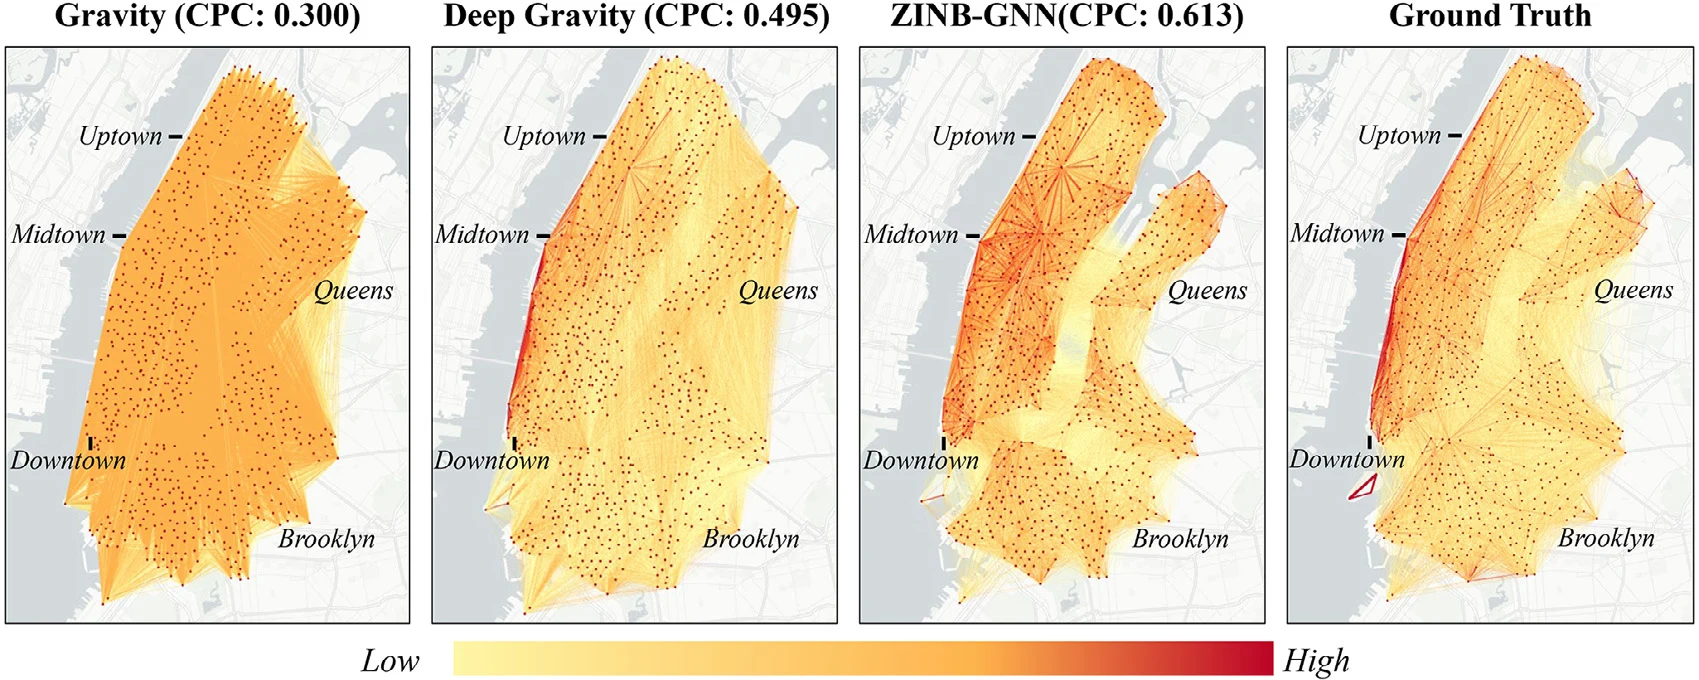
图 5|2019 年 8 月这一张图上,三种模型分别像真实流量的哪一部分?
无字母子图,从左到右是重力模型、Deep Gravity、ZINB-GNN 和真实流量。颜色由黄到红表示相对流量,没有行程数刻度。图内标出的 CPC 是这一月地图的重叠度:重力模型 0.300,Deep Gravity 0.495,ZINB-GNN 0.613。它们不是上一张表里整个测试期、分类别的 CPC。重力模型大片偏浅,强弱站点对拉不开。Deep Gravity 在中城和下城较深,上城、布鲁克林和皇后区偏弱,低流量连线偏多。ZINB-GNN 更接近外围的深浅变化,但论文指出它会高估中城的部分连线,对高需求对仍然弱。来源:原论文 Fig. 5。
变准的是零膨胀,还是站点之间的图?
作者拆开模型,看误差来自分布假设还是图。-ZINB 直接输出一个数;-ZI 保留负二项、去掉额外的零概率;-ODGraph 不用邻居;SiteGraph 把节点改回站点;OD-GCN 用预先写好的距离权重做卷积。数字仍是 5 次平均。
去掉整个概率层之后,一端新站点的 MAE 从 0.028 升到 0.050,升幅 (0.050−0.028)/0.028=78.6%;两端新从 0.041 升到 0.061,升幅 48.8%。CPC 从 0.550 降到 0.440、从 0.525 降到 0.446,相对完整模型下降 20.0% 和 15.0%。只去掉零膨胀时,一端新的 MAE 从 0.034 降到完整模型的 0.028,降幅 (0.034−0.028)/0.034=17.6%;两端新从 0.047 到 0.041,降幅 12.8%。CPC 的相对增幅是 3.8% 和 2.9%,也就是 0.530 到 0.550、0.510 到 0.525。负二项已经能压低误差,零膨胀再处理多出来的零。
图的作用更小。不用起讫图时,两端新的 MAE 仍是 0.041,RMSE 从 0.171 升到 0.173,CPC 从 0.525 降到 0.513。站点图和距离卷积在两端新的 MAE 上是 0.039,略好于完整模型的 0.041,但 CPC 只有 0.503 和 0.506。一端新的 MAE 上,站点图、距离卷积和完整模型都是 0.028。因此“完整模型在所有点预测指标上都更好”对两端新的 MAE 并不成立;更稳的差别是 CPC 和 RMSE。
区间指标不能同时又高又窄。去掉零膨胀后,一端新的覆盖率 0.910、宽度 0.104,完整模型是 0.897 和 0.081。覆盖率上升伴随着更宽的区间。
附录 B 用 3 次运行比较 k。两端新增站点的 CPC 从 k=5 的 0.522 到 k=13 和 15 的 0.528,变化很小。作者选择 k=13。附录把一端新、两端新写成 Exist-Add、Add-Add,k=13 时一端新的 CPC 是 0.555,与主表 5 次运行的 0.550 不完全相同。主结论不依赖某一个邻居数的细小差别。
一天不到一次,和一天五次,是同一道题吗?
全体 MAE 只有百分之几次/天,是因为绝大多数格子接近零。表 4 把测试对按观测流量切开。日均至少 1 次的三条样本量是 278,262、36,467 和 8,148,合计 322,877,除以 17,023,154 得 1.90%,正文写作 1.9%。日均至少 5 次的是 10,543、1,075 和 161,合计 11,779,占 0.069%,正文写作 0.07%。
流量等于 0 与大于 0 的样本量相加,分别比三类测试对少 2,114、4,708 和 966,合计少 7,788 条。论文没有解释这 7,788 条落在哪里。下面的百分比只用正文给出的分母。
在观测恰好为 0 的一端新、两端新连接上,Deep Gravity 的 MAE 是 0.031 和 0.041,ZINB-GNN 是 0.006 和 0.009,降幅 80.6% 和 78.0%。零流量的覆盖率印成 1.000,区间宽度只有 0.033、0.010 和 0.025 次/天。模型几乎总把零判在一条很窄的区间里。
日均至少 1 次、且涉及新站点时,ZINB-GNN 的 MAE 仍较低:一端新从 1.282 降到 1.104,降幅 13.9%;两端新从 1.579 降到 1.338,降幅 15.3%。CPC 从 0.490 到 0.588、从 0.214 到 0.409。绝对误差已经是每天 1 次上下,不再是全体平均里的 0.028。
日均至少 5 次时,排序反过来。两端旧的 MAE,Deep Gravity 是 5.176,ZINB-GNN 是 6.000;一端新是 6.001 对 6.357。只有两端都是新站时 ZINB-GNN 仍较低,5.905 对 6.235,但这类样本只有 161 条,CPC 也只有 0.185,Deep Gravity 是 0.097。三条忙线的 80% 覆盖率是 0.038、0.003 和 0.008,分母分别是 10,543、1,075 和 161。区间宽度约 1.8–3.3 次/天,小于这些格子上每天约 6 次的绝对误差。全体大约九成的覆盖率,不能搬到需要扩容的忙线。
流量大于 0 的覆盖率也只有 0.514、0.319 和 0.497。只要格子里真有行程,80% 区间经常盖不住。
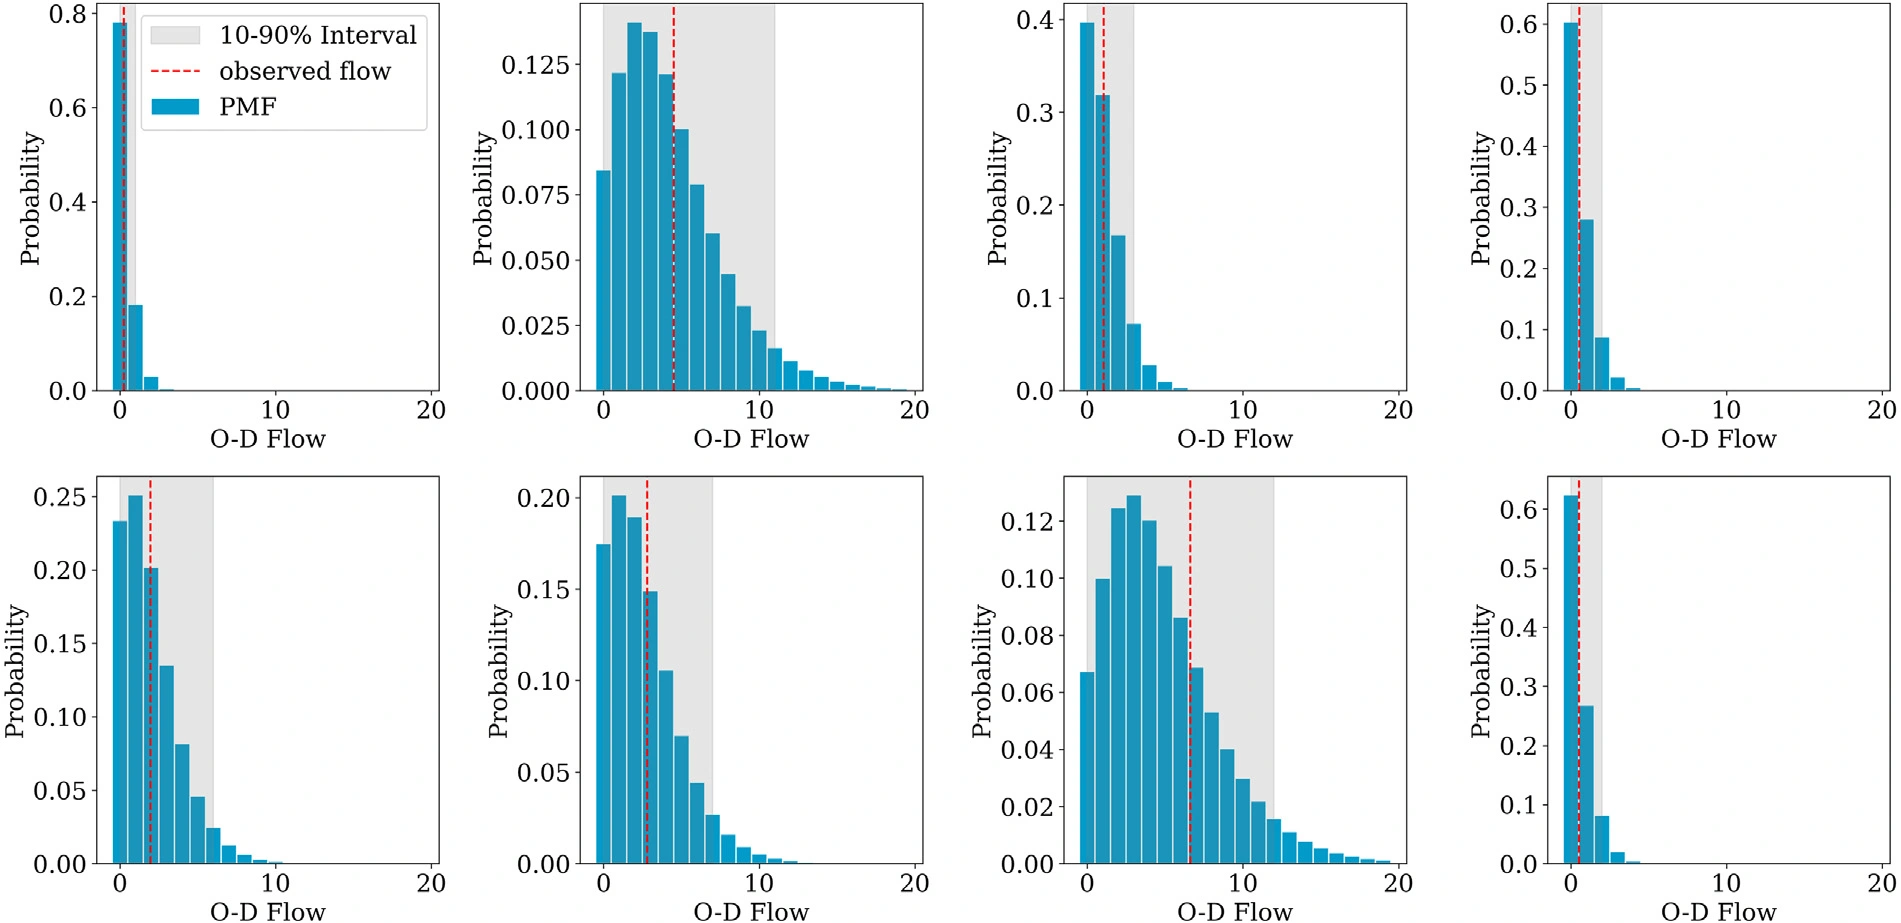
图 6|一条分布怎样同时表示“很可能是零”和“可能有几次”?
八个无字母例子,上、下各四个,论文没有给出站点名称或确切流量。蓝柱是概率质量,灰带是 10%–90% 区间,红虚线是观测日均行程,横轴统一画到 20 次/天。靠左堆积的例子概率集中在 0 附近,灰带很窄;拖长尾的例子灰带更宽。论文写每个例子的观测都落在灰带内。这是挑出的示意,不能代替表 4 里忙线接近 0 的覆盖率。来源:原论文 Fig. 6。
距离和介入机会排在前面,能当成原因吗?
SHAP 把每个特征对模型输出的平均边际贡献算出来。它解释的是这一个已训练模型的输出,不是纽约骑行为什么形成。图中红表示该特征取值高,蓝表示低;点在 0 右边表示把预测流量往上推。
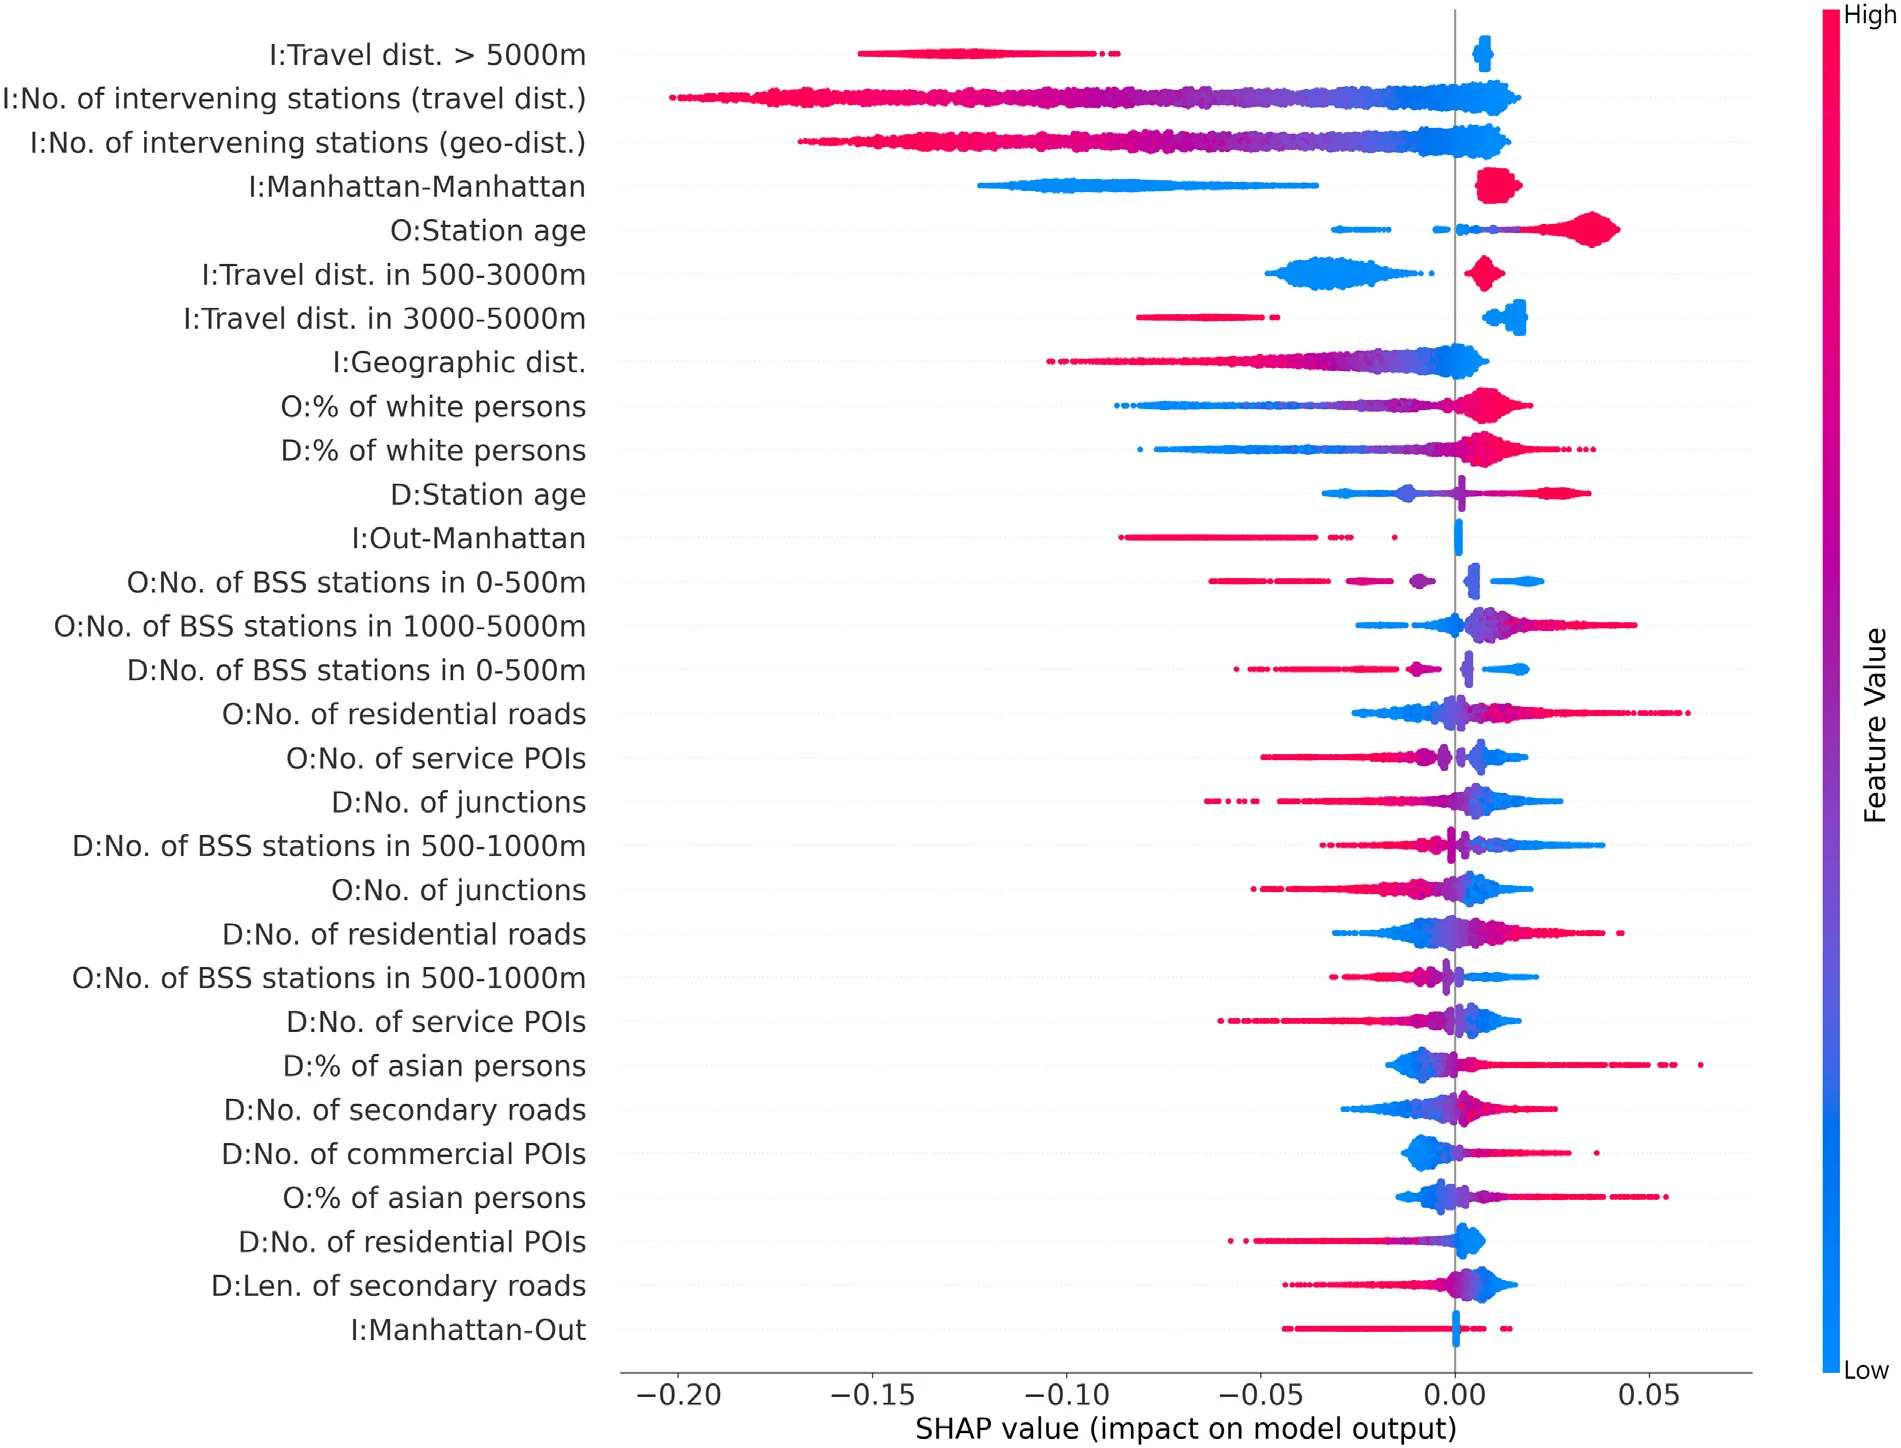
图 7|模型输出最敏感的是距离,还是站点周围的人口?
无字母子图,纵轴是按图中顺序排列的前 30 个特征,横轴是 SHAP 值。最上面依次是路网距离超过 5000 米、按路网和按直线距离计算的介入站点数、起终点都在曼哈顿,然后是起点站龄、路网距离 500–3000 米、3000–5000 米。论文写前七项都是起终点之间的空间关系;按这张图的顺序,第五位已经是起点站运营月数,并不属于站点对的空间关系。距离项的方向与正文一致:超过 5000 米、3000–5000 米的高取值偏左,500–3000 米的高取值偏右;介入站点越多越偏左。两端白人居民比例和站龄的高取值多在 0 的右侧。0–500 米内的其他车站在终点一端偏负,起点 1000–5000 米内的车站数量偏正。来源:原论文 Fig. 7。
正文的解释是:5 公里以上的骑行变少,500 米到 3 公里更容易产生行程;中间还有很多别的站时,从同一起点出发的行程被摊薄;曼哈顿内部的活动更集中。站龄被单独讨论:老站多在需求已经很高的市中心,运营越久也越被人知道,所以年龄和环境缠在一起。白人居民比例较高的地方预测流量较高,论文引用既有研究作为使用率差异的旁证,没有做新的个体调查。附近站点的正负方向也被解释成竞争或互补,但这是 SHAP 与先前站点级研究的对照,不是关闭一部分站点后的实验。
这些比较还不能推出什么
结果支持的是:在这一套纽约有桩共享单车、按月快照、以 2017 年 8 月为界的扩站划分里,用零膨胀负二项描述日均行程,能降低新站点对的整体绝对误差,并给出分布。它不支持四件容易顺口说出的话。
第一,全体 MAE 和大约 90% 的区间覆盖率,不是忙线的准确率。日均至少 5 次的连接只占测试对的 0.07%,绝对误差约每天 6 次,区间几乎不覆盖观测。
第二,模型均值不是观察到的骑行,SHAP 方向也不是选址原因。站龄、族裔比例和市中心位置相互重叠;2010 年普查对 2019 年的行程是过时的环境测量。
第三,基线经过了任务改造,又对输出做了归一化,主表没有标准差。0.171 和 0.173 这种差别不宜写成稳定优劣。CPC 的印刷公式、对数似然和表 4 少掉的 7,788 条,都使“按公式重算一遍”暂时做不到。
第四,自由浮动单车、电动滑板车和电动汽车只在讨论中被说成可以把服务区当成虚拟站点,本文没有这些数据。环境排放、拥堵和方式转移也没有被模拟。数据停在 2019 年 12 月,不包含疫情后的骑行。
一句话总结
对纽约共享单车的扩站规划,ZINB-GNN 主要把大量接近零的新站点连接估得更接近观测;决定车位和车道的少数忙线,仍然没有被这个分布可靠地罩住。
核心来源
- Sustainable Cities and Society 正式版,卷 114,文章编号 105777。正文图 1–7,表 1–4,附录表 A.5 与 B.6。
- 论文数据可用性声明中的仓库:https://github.com/liangchunyaobing/ZINB-GNN-for-sparse-OD-flow-generation。作者主页用户名下另有同名仓库 https://github.com/yuebingliang/ZINB-GNN-for-sparse-OD-flow-generation。本文没有用仓库重跑表格。
- Citi Bike 行程来自系统公开数据;兴趣点、道路、2010 年普查和地铁距离的链接写在论文第 5.2 节。
作者介绍
- Yuebing Liang:论文署名为新加坡-麻省理工科研中心和麻省理工学院 Senseable City Lab,负责初稿、方法、分析、数据与概念构思。个人主页写她在香港大学攻读博士、由赵展指导,研究共享单车需求与图神经网络,现任职清华大学城市规划系。
- Zhan Zhao(赵展):通讯作者,署名为香港大学城市规划与设计系、城市系统研究所和数据科学研究所,负责指导、方法与概念构思。学院页面写他的研究方向是人类移动、出行行为和共享出行。
- Chris Webster:署名为香港大学建筑学院,并列入上述两个研究所,负责审阅与方法。香港大学校历记 C. J. Webster 于 2013–2024 年担任建筑学院院长;学院页面写他的方向是城市规划与发展经济学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果规划指标是自行车道上的负荷,训练目标就不应让 1700 万条接近零的格子和 1 万条忙线分享同一种误差。表 4 已经显示,只看日均至少 5 次时,Deep Gravity 在含有旧站点的连接上绝对误差更小。把 CPC 改成按行程数加权,或者只在正流量上计算,模型排名可能和全体 MAE 的排名不同。作者提议的两步模型可以先用现在的分布识别零,再把忙线交给另一个模型;这一步还没有结果。
区间也不适合直接加成容量。新站点对的平均区间只有约 0.1 次/天,是因为零流量把宽度拉窄了。忙线上的 80% 区间既比误差窄,又几乎不包含真实值。若把每条连接的 90% 分位加起来决定桩位,备余会堆在本来就没有骑行的格子上,真正可能排队的连接仍然缺少缓冲。要让区间服务于扩容,至少得在日均不少于 1 次的子集上同时报告覆盖率和宽度,而不是只报告全体 PICP。
站龄和白人居民比例排在前面,还提醒一件选址时容易发生的事。老站本来就更多位于已经很忙的市中心,模型会把这种历史一起写进新站点的预测。若用它比较两个社区该不该建站,预测流量更高可能只是在重复既有网络和 2010 年的人口结构。把站龄、开通时的建成环境和后来的需求分开,需要站点开通前后的对照,而不是再做一次 SHAP。