城市货运为什么收成枢纽放射,而不是地点之间均匀互连?
论文名片|Yitao Yang、Bin Jia、Xiao-Yong Yan、Yan Chen、Lóránt Tavasszy、Michiel de Bok、Zhuotong Bai、Erjian Liu、Ziyou Gao,Structure and dynamics of urban freight truck movements: A complex network theory perspective,Transportation Research Part C: Emerging Technologies,2024,158:104442。2023年12月2日在线发表,期刊卷期为2024年第158卷。DOI:10.1016/j.trc.2023.104442。本文依据该正式版本解读。
一辆载重超过12吨的货车离开物流园。下一站可以是附近任意一座仓库,也可以是已经和很多客户保持来往的地点。前一种走法会把连边铺开;后一种会让少数地点既挂着许多小节点,又彼此对接。路网密不密,是另一条可能的线索:货流大的地方,也许只是因为旁边高等级道路更密。
这项研究用2018年5月18日至31日的重型货车轨迹,在北京、上海、重庆、天津把货运兴趣点连成加权网络。四座城市的连边都偏向短距离和高度数地点,高度数地点之间又越来越密。一个在真实地点上逐步加边的模型,把直线距离、节点强度和“复制已有伙伴”放在一起,能在图上跟上这些形态。北京的道路密度与货流量相关没有给出低于0.05的p值;吸引参数、距离尺度和间接作用强度的估计值,正文也没有列出。
先说结论
- 四市网络的节点与边来自表1:北京15,983个节点、207,264条边,上海16,094个节点、436,172条边,重庆10,629个节点、203,203条边,天津10,697个节点、216,724条边。按无向网络计算的平均度数2E/N分别约为25.9、54.2、38.2和40.5,分母是各市节点数。
- 度数服从截断幂律。图6给出的幂指数γ为北京1.85、上海1.62、重庆1.54、天津1.56;连边直线距离的指数特征尺度为7.8、8.8、17.1和10.2千米。特征尺度是拟合曲线的尺度参数,平均运距正文没有报告。
- 富人俱乐部系数随度数升高并在高度数处接近1。节点对里较大的那个度数偏向高值,较长距离的连边仍然经过高度数节点。这是枢纽放射的截面形态。
- 边权并不均匀。高度数地点的加权邻居度和加权聚类系数,相对各自的无权版本更高;低度数地点的加权聚类系数低于无权版本。图8标出的Jaccard均值,四市真实网络为0.550、0.510、0.508、0.501。
- 生长模型的点与上述分布叠在一起。正文称吻合良好,同时没有给出α、典型尺度r_c、间接强度σ,也没有给出相似度或误差。模型校准的是这两周的截面,地点坐标来自已经存在的兴趣点。
这两周的轨迹,汇总成什么样的网络?
数据来自全国道路货运车辆公共监管与服务平台,对象是载重超过12吨的货车。2018年5月18日至31日共有260万辆货车的410亿条轨迹记录,字段包括车辆编号、时间、经纬度、速度和方向角。这是全国平台上的两周,四市网络是其中能匹配到本市货运兴趣点的部分。各市留下多少辆车、多少次行程,正文没有单列。
地点来自高德地图的货运相关兴趣点,包括货运公司、市场、物流设施和交通枢纽,使用名称和坐标。行程端点用作者此前的识别算法从连续轨迹中切出,再按地理邻近连到兴趣点。这篇论文没有重述停留时间阈值和匹配半径。
每个节点是一处货运兴趣点,每条边是地点之间的货车移动,边权是货车行程次数。后文的度数、聚类和Jaccard都按有无连接计算,去程和回程没有分开报告。节点强度是连在该点上的边权之和,图1用它给地点着色;色标范围是10⁰到10⁵,表示图例的刻度,正文没有逐城报告最大强度。
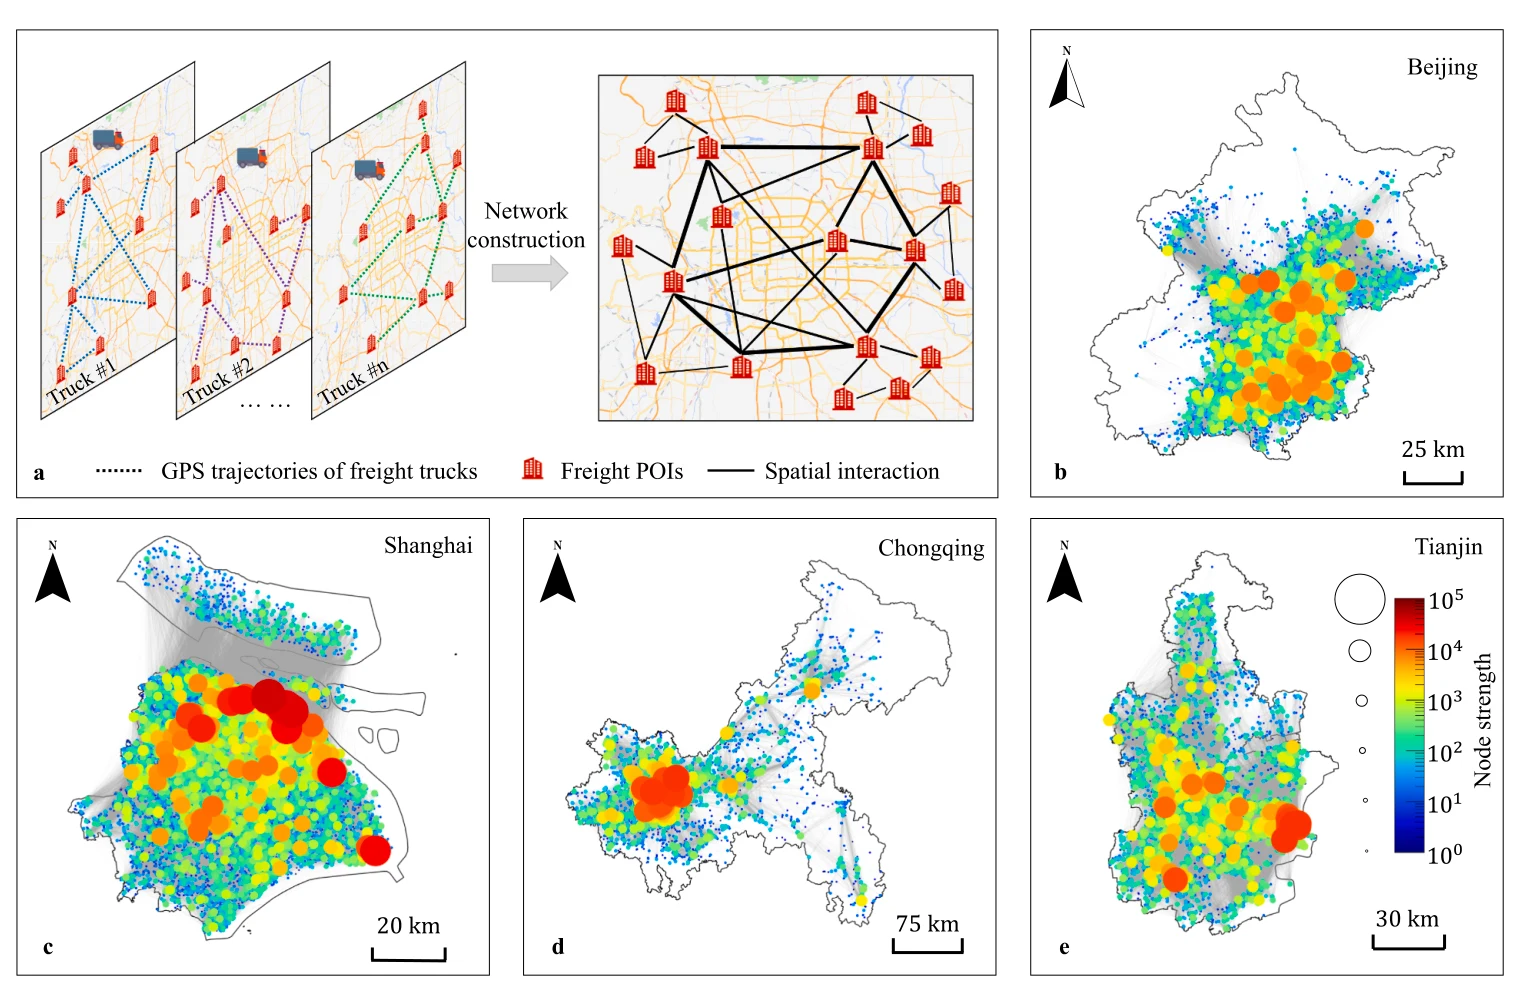
图 1|单车轨迹怎样变成四座城市的货运网络?
(a)左侧按车辆把GPS轨迹连到货运兴趣点,右侧把全部车辆汇总成地点之间的空间交互;虚线、仓库图标和实线分别表示轨迹、兴趣点和汇总后的连边。(b)北京,比例尺25千米。(c)上海,比例尺20千米。(d)重庆,比例尺75千米。(e)天津,比例尺30千米。b–e中点的大小和颜色表示节点强度,色标由10⁰到10⁵,画在天津一幅上。来源:原论文 Fig. 1。
四座城市被选来代表不同的面积、人口、经济和路网。表1的面积一列与正文使用同一组数字,重庆一格就是正文写出的82,403 km²,因此这一列按平方千米读。人口、地区生产总值和道路长度在表中没有单位,下面只转述原数:上海的GDP数字32,680最高,天津的人口1,560、GDP 18,810和道路长度16,257在四市中较低,重庆面积最大。这些背景数字描述城市差异,网络结论的直接分母仍是节点和边。
| 城市 | 面积 GA(km²) | 人口 POP | GDP | 道路长度 RL | 节点 N | 边 E | Moran’s I | Geary’s C |
|---|---|---|---|---|---|---|---|---|
| 北京 | 16,410 | 2,154 | 30,320 | 22,256 | 15,983 | 207,264 | 0.43 | 0.39 |
| 上海 | 6,341 | 2,424 | 32,680 | 13,106 | 16,094 | 436,172 | 0.52 | 0.23 |
| 重庆 | 82,403 | 3,102 | 20,363 | 157,483 | 10,629 | 203,203 | 0.71 | 0.15 |
| 天津 | 11,920 | 1,560 | 18,810 | 16,257 | 10,697 | 216,724 | 0.65 | 0.18 |
人口、GDP和道路长度保持表中原数。Moran’s I和Geary’s C度量的是各地点进出货车流量的空间自相关,解释见下一节。
货流量大的地点,周围的高等级道路也更密吗?
路网关系只以北京为例。道路来自OpenStreetMap,保留高速公路、主干路、次干路和支路四类。每个货运地点生成一个泰森多边形:多边形内部任意一点到该地点的距离,短于到其他货运地点的距离。道路密度等于多边形内该类道路的总长度除以多边形面积,单位是km/km²。然后计算地点货流量与这四类密度的皮尔逊相关系数。
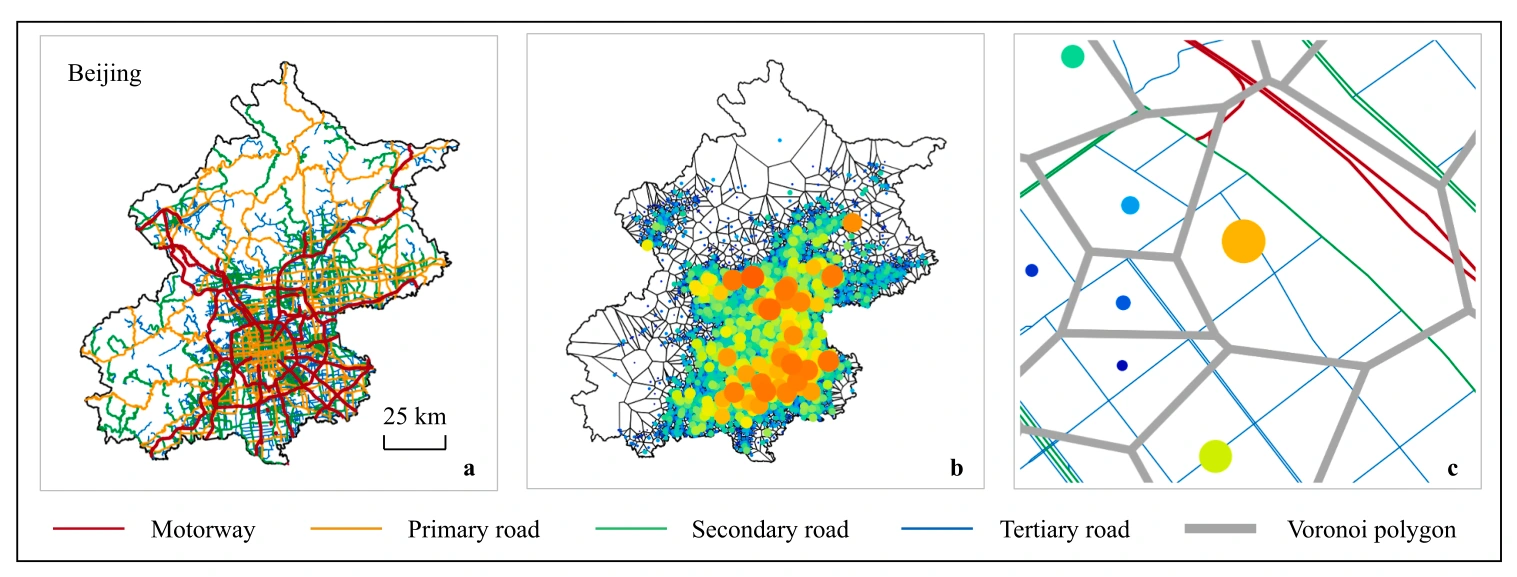
图 2|货运地点和四类道路怎样放进同一个空间单元?
(a)北京的高速公路、主干路、次干路和支路,比例尺25千米。(b)全部节点的泰森多边形,点的大小和颜色仍表示节点强度。(c)多边形内部的放大,灰线是多边形边界。这一张说明密度算在哪个面积上,相关数字在图4。来源:原论文 Fig. 2。
图4把四类道路分开。高速公路与货流量的相关系数r=0.1521,p=0.1669;主干路r=0.2038,p=0.0627;次干路r=−0.0292,p=0.1384;支路r=−0.1273,p=0.0801。四个p值都高于0.05。分箱均值的方向与文字描述一致:货流量较低的箱子里,高速公路和主干路密度的均值较低,次干路和支路密度的均值较高;货流量较高的箱子方向相反。正文没有说明p值按全部15,983个地点计算,还是按分箱后的点数计算。在这组已印刷的检验里,四类道路密度都没有跨过0.05的门槛。
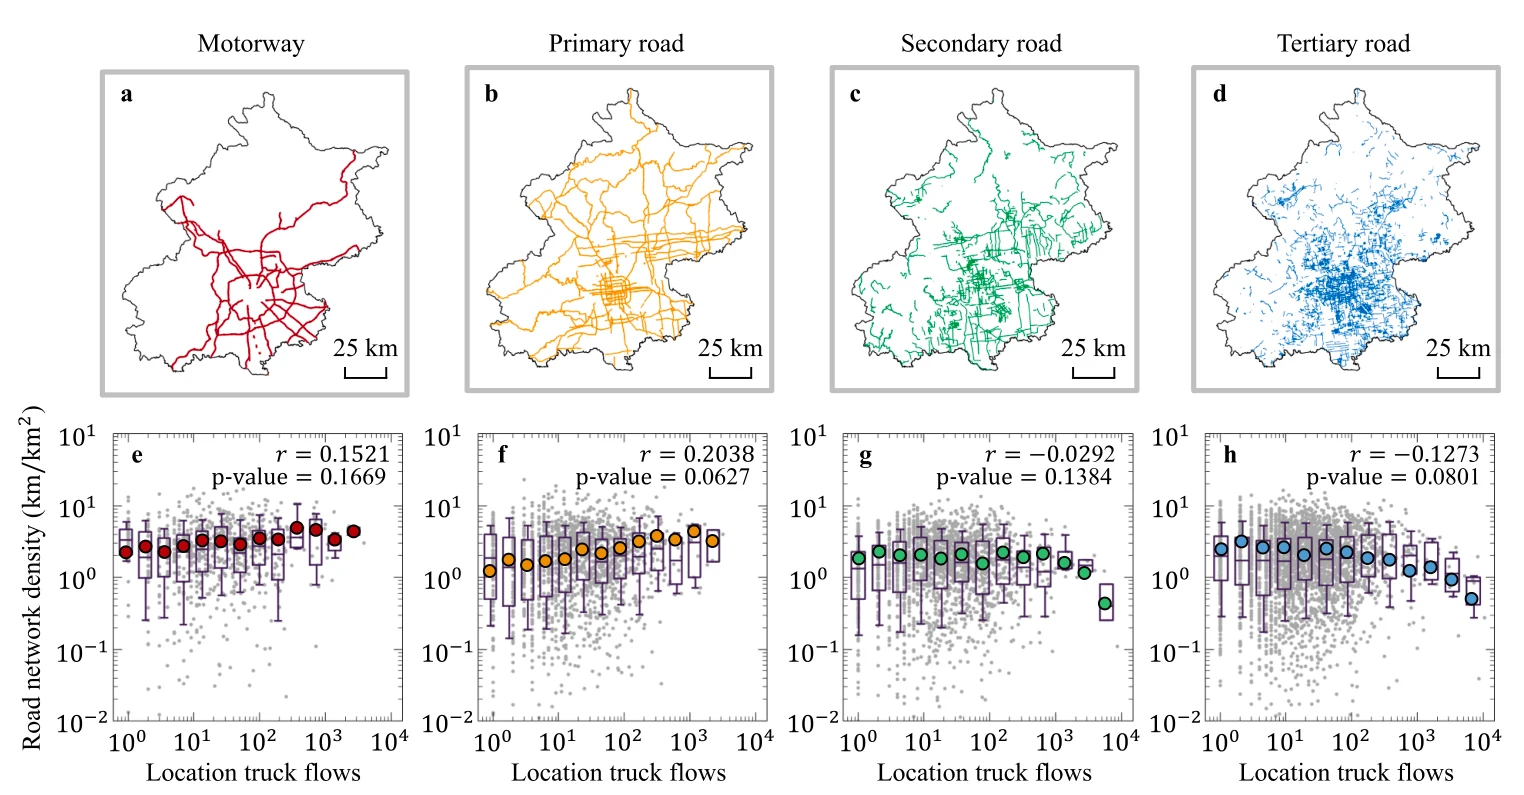
图 4|北京的货流量和周围道路密度有多强的线性关系?
(a)高速公路。(b)主干路。(c)次干路。(d)支路。四幅地图的比例尺都是25千米。(e–h)对应四类道路的密度箱线图,横轴是地点货流量,纵轴是道路密度(km/km²),灰点是地点,箱内圆点是分箱均值。图中印刷的r和p值分别为0.1521与0.1669、0.2038与0.0627、−0.0292与0.1384、−0.1273与0.0801。来源:原论文 Fig. 4。
货流相近的地点靠在一起,和地点本身挤在一起,是同一件事吗?
Moran’s I和Geary’s C用的是地点进出货车流量。I为正表示流量相近的地点在空间上靠近;C小于1表示邻近地点的流量差小于随机排布时期望的差,C大于1则表示邻近地点更不相似。四市的I都为正,C都小于1。重庆的I为0.71、C为0.15,在四市中聚集信号最强;北京的I为0.43、C为0.39,聚集信号最弱。这里的聚集是流量取值的空间自相关。它回答“大货流地点是否彼此靠近”,还没有回答兴趣点坐标本身是否比随机点更挤。
坐标的聚集用论文定义的Ripley’s F函数F(r)。对每个地点,数出直线距离小于r的其他地点,再按地点数和平均密度换算;作者给出,点若近似均匀,F(r)接近πr²。平均密度按N/A估计,A是包含全部点的区域面积。图中的随机基线就是这条πr²,它把城市区域看成均匀的泊松点过程,没有先扣除山地、水面或建成区形状。
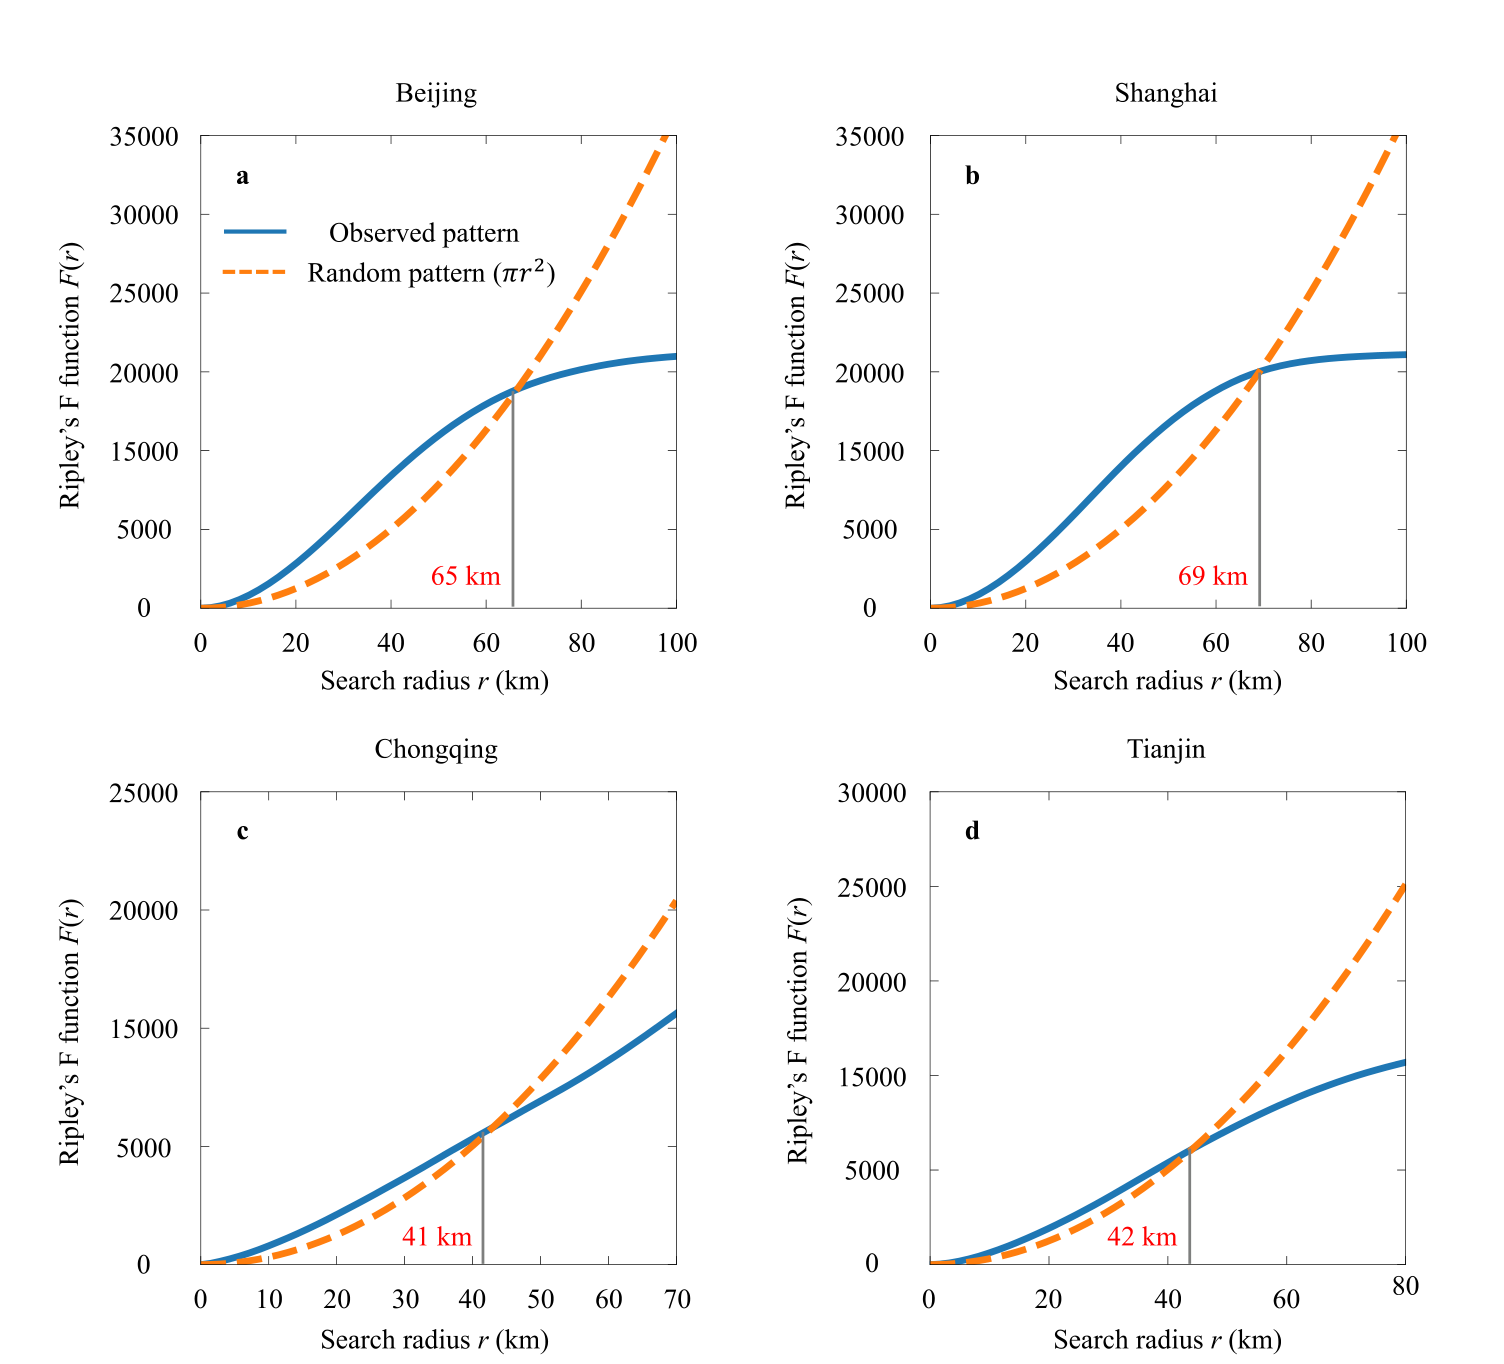
图 5|货运地点在多远的半径内比均匀随机更聚集?
(a)北京,观察曲线与πr²交于65千米,横轴至100千米。(b)上海,交于69千米,横轴至100千米。(c)重庆,交于41千米,横轴至70千米。(d)天津,交于42千米,横轴至80千米。实线是观察模式,虚线是πr²。短半径上实线高于虚线,超过交点后实线低于虚线。来源:原论文 Fig. 5。
交点之前,地点对比均匀随机更集中;交点之后,曲线落到πr²下面。重庆和天津的交点在41千米和42千米,北京和上海在65千米和69千米。作者据此认为,前两市的地点聚集压在更短的距离内,后两市的聚集铺得更开。这个比较的基线是全市均匀随机,建成区本身集中在市域一侧时,短距离上也会高出πr²。
少数地点如何把网络收成枢纽放射?
度数kᵢ是地点i的邻居数。四市的度数分布被拟合为截断幂律p(k)~(k+Δk)^(−γ)e^(−k/kₓ)。图6的拟合式为:北京(k+13)^(−1.85)e^(−k/134),上海(k+18)^(−1.62)e^(−k/167),重庆(k+12)^(−1.54)e^(−k/176),天津(k+14)^(−1.56)e^(−k/181)。多数地点度数低,少数地点度数高;指数截断使分布在大度数处下降更快,纯幂律并没有延伸到任意大的度数。正文把北京较高的γ读成更集中的枢纽结构,把上海、重庆、天津较低的γ读成连接更分散。γ描述的是度数分布的陡峭程度,枢纽的具体业态没有按兴趣点类别拆开。
连边距离d是两端兴趣点的直线距离,单位千米。距离分布拟合为P(d)~e^(−d/r_d),r_d为北京7.8、上海8.8、重庆17.1、天津10.2。重庆的尺度最长,上海最短。图的近距离段比这条指数线更平,指数线主要跟上衰减的那一段,所以r_d是这条拟合的特征尺度。
富人俱乐部系数RC(k)=E₍>k₎/[N₍>k₎(N₍>k₎−1)/2]。分子是度数大于k的节点之间实际有多少边,分母是这些节点两两之间全部可能的边数。RC(k)随k上升,在足够大的k处接近1。高度数地点之间几乎彼此相连;低度数处的系数远低于1。接近1的那个俱乐部有多少个地点,正文没有按k报告N₍>k₎。
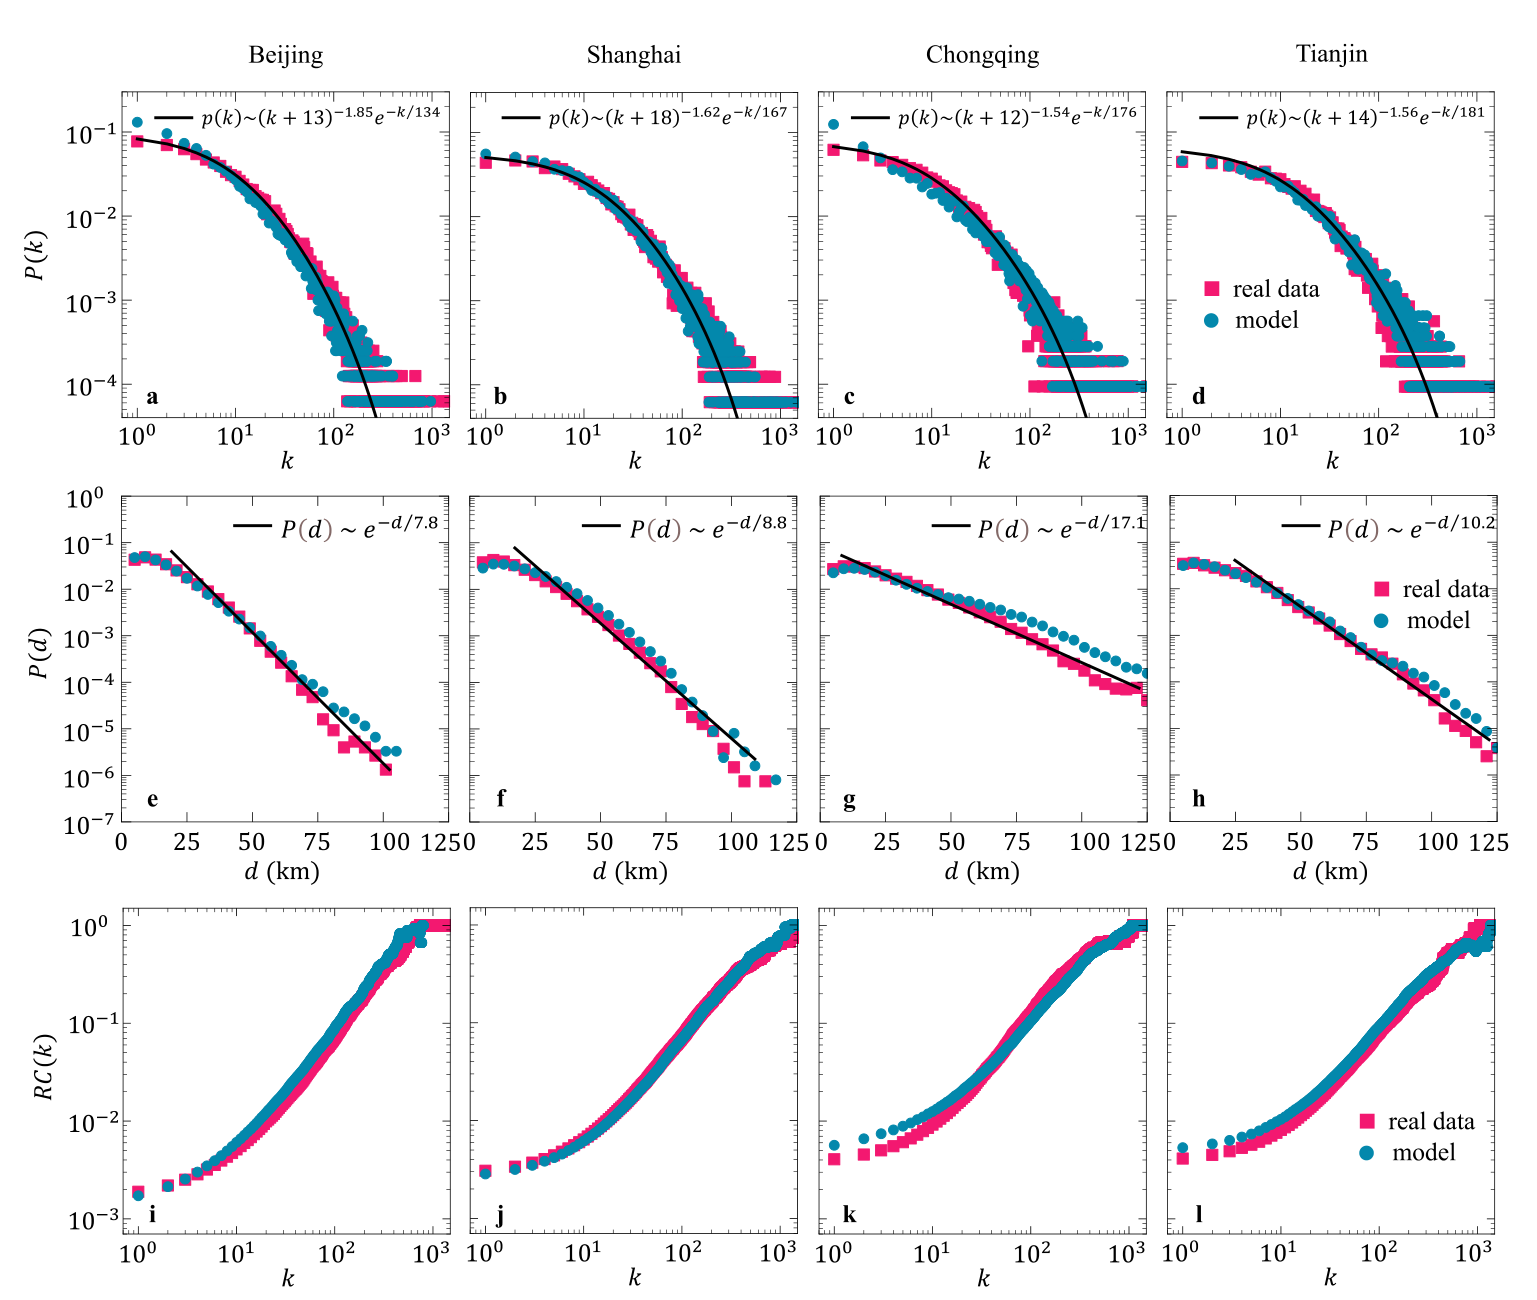
图 6|度数、距离和富人俱乐部,真实网络和模型各是什么形状?
(a–d)北京、上海、重庆、天津的度数分布。品红为真实数据,青色为模型,黑线为截断幂律;拟合式依次为(k+13)^(−1.85)e^(−k/134)、(k+18)^(−1.62)e^(−k/167)、(k+12)^(−1.54)e^(−k/176)、(k+14)^(−1.56)e^(−k/181)。(e–h)连边直线距离分布,黑线为e^(−d/7.8)、e^(−d/8.8)、e^(−d/17.1)、e^(−d/10.2),d以千米计。(i–l)富人俱乐部系数RC(k),四市都随k上升并在高度数端接近1。来源:原论文 Fig. 6。
只看度数分布,还会漏掉“低度数地点连向谁”。作者对每条连边取两端度数的较大值,再和直线距离一起作二维概率。较大度数集中在高值一侧,和“大多数地点度数很低”的边际分布放在一起,表示低连接地点倾向于连上高连接地点。距离拉长时,概率质量仍留在较大度数较高的区域。作者把这张图读成枢纽放射:枢纽是城市内部跨区域转运的主要接点,边远地点相对孤立。图7a是结构示意,b–e才是四市连边的概率。
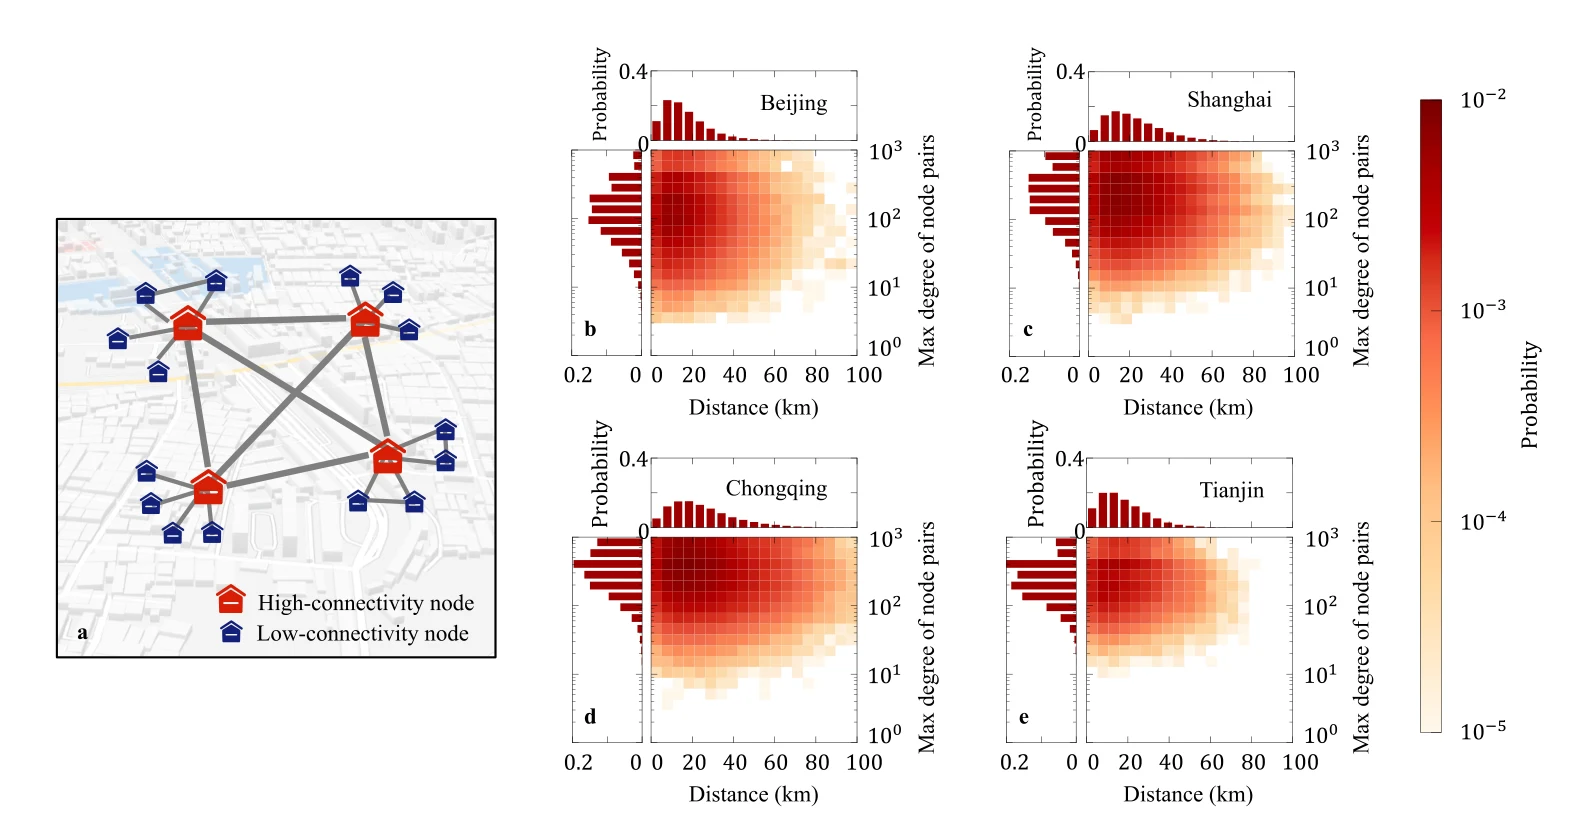
图 7|长距离连边是否仍然经过高度数地点?
(a)枢纽放射示意:红点为高连接节点,蓝点为低连接节点,底图不作为实测货流。(b)北京。(c)上海。(d)重庆。(e)天津。热力是连边落入“较大度数×直线距离”格子的概率,色标约从10⁻⁵到10⁻²;上方直方图是较大度数的边际,左侧直方图是距离的边际。重庆的距离质量更靠外,天津更靠短距离。来源:原论文 Fig. 7。
四市差异也写在这组图里。重庆的r_d为17.1千米,节点对距离相对更长,作者将其与82,403 km²的市域面积放在一起理解。上海的r_d为8.8千米,连边更局部。天津的节点对距离更集中于短距离。北京和上海的较大度数分布比重庆更铺开。这些是连边统计的城市差异,还没有换成运输成本或排放差。
连边的重量和伙伴重叠,分别堆在哪一类地点上?
邻居的平均度数有两个版本。无权版本把每个邻居同等看待;加权版本按连边重量加权。若较重的边更常连向高度数邻居,加权值就大于无权值。按度数分组后,四市的比值〈kₙₙ〉ʷ(k)/〈kₙₙ〉(k)都随k上升,并位于等于1的虚线之上。边权因此是不均匀的,高度数地点上的不均匀更明显。正文指出北京这条比值上升更慢、最大值更低;图上北京的右端也低于其余三市。
聚类系数看一个地点的邻居之间有没有互相连接。加权版本若大于无权版本,说明构成三角形的那些边更重。比值Cʷ(k)/C(k)随k上升:低度数一端低于1,高度数一端达到或超过1。高度数地点组成的局部集团连着较重的边;低度数地点组成的局部集团,内部边权通常更低。作者用末端配送点举例说明后一种情况,节点数据本身没有标注是否为末端点。
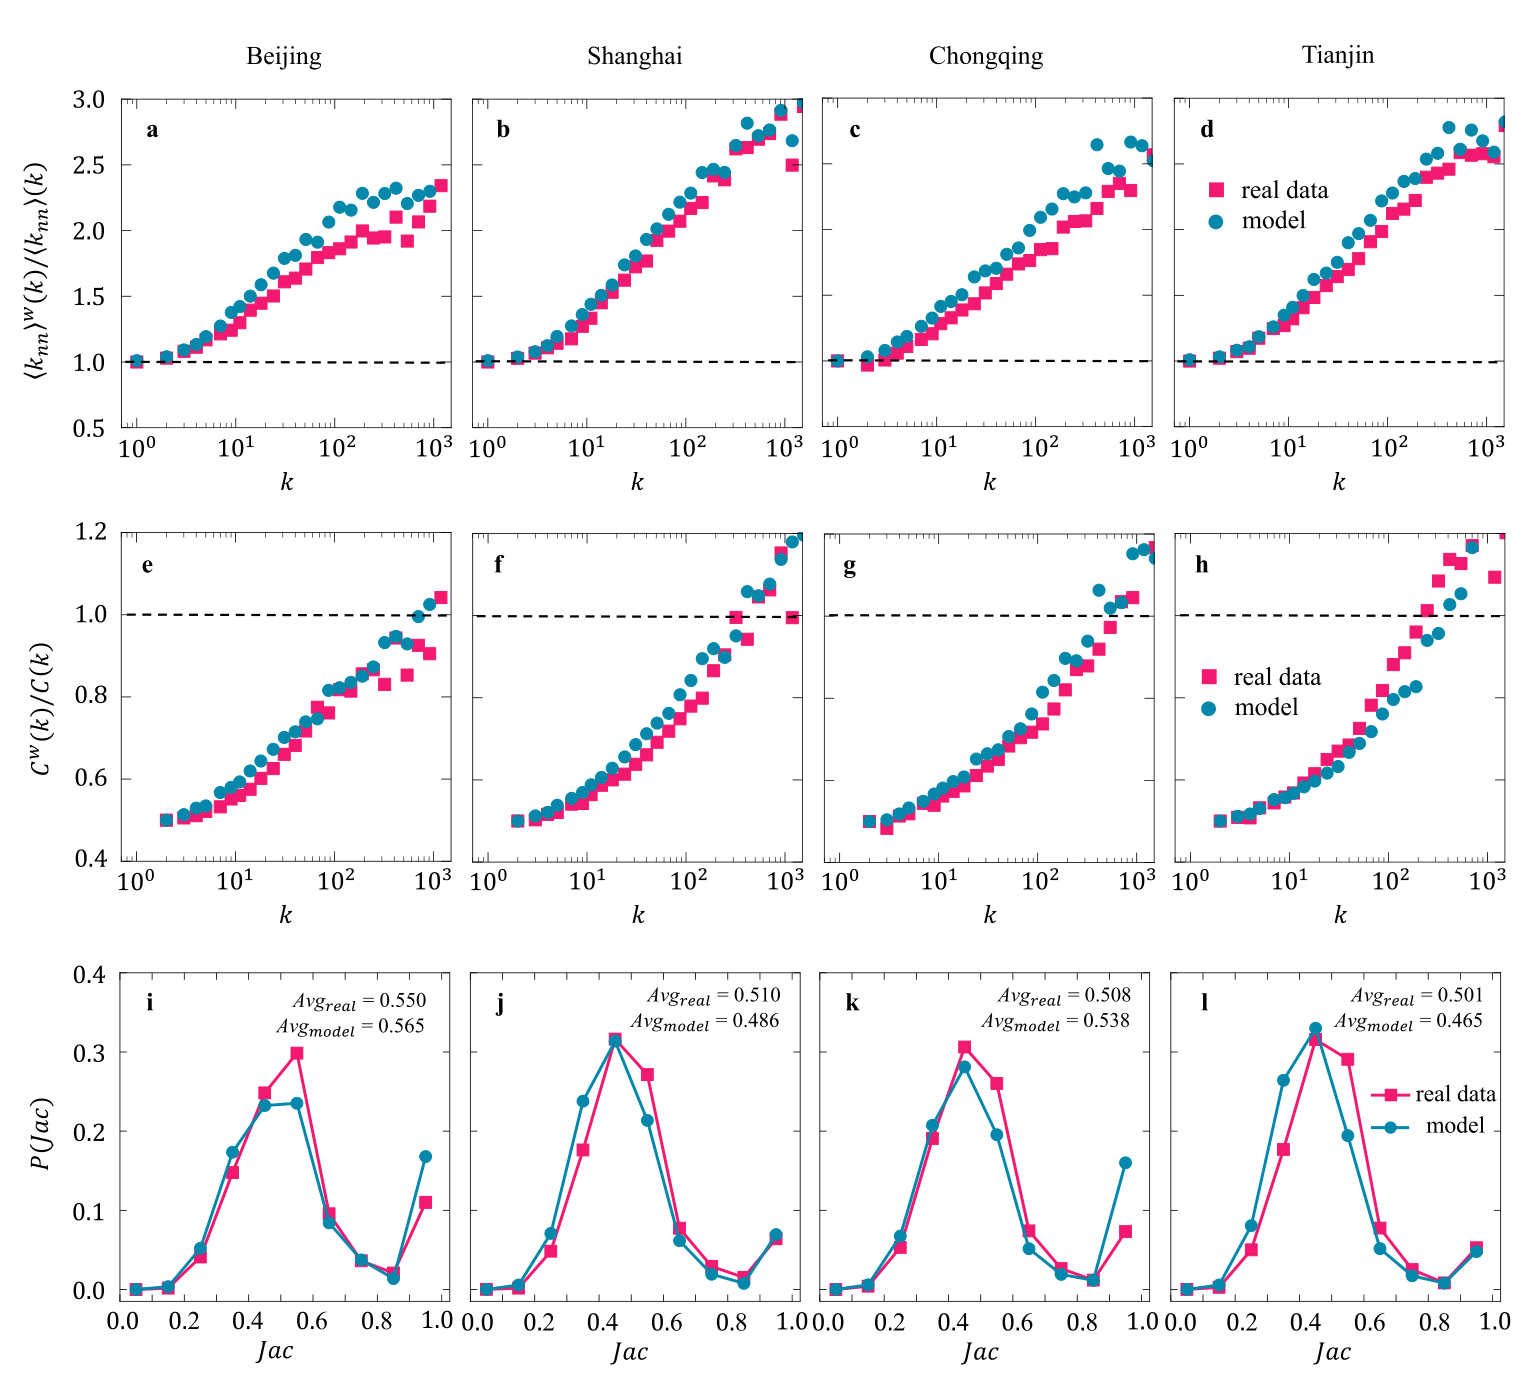
图 8|边权偏向谁,地点之间又共享多少伙伴?
(a–d)加权与无权的邻居平均度数之比,虚线为1;四市比值随度数上升,北京右端低于上海、重庆和天津。(e–h)加权与无权聚类系数之比,虚线为1;低度数低于1,高度数升到1附近或以上。(i–l)Jaccard系数分布。图中印刷的真实均值与模型均值为:北京0.550与0.565,上海0.510与0.486,重庆0.508与0.538,天津0.501与0.465。分布在0.4到0.5附近达到高峰。来源:原论文 Fig. 8。
Jaccard系数Jacᵢⱼ=|Γ(i)∩Γ(j)|/|Γ(i)∪Γ(j)|。分子是两个地点的共同邻居数,分母是两边邻居并集的大小。图注写明均值针对全部节点对。四市真实均值都在0.50上下,峰在0.5附近,0附近的概率质量很低。按表1的无向简单图计算,边占全部可能节点对的比例约为北京0.162%、上海0.337%、重庆0.360%、天津0.379%,分母是N(N−1)/2。在这样的密度下,若每一个节点对都进入Jaccard分布,大量没有共同邻居的对会把均值拉向0。图上的分布几乎没有这堆0。因此0.50到0.55是图中那组节点对的平均值;正文没有说明是否先去掉了邻居集为空或不相交的对。它可以支持“被纳入这张分布的地点对有不低的伙伴重叠”,还不能直接换成“任意两个货运地点都有一半伙伴相同”。
图9把上述比较画成示意。高连接子图里,加权邻居度高于无权邻居度,加权聚类系数不低于无权聚类系数。低连接子图里,加权聚类系数低于无权聚类系数。最后一幅用3/5演示Jaccard的算法,这个分数是示意图上的五个邻居里有三个相同,不是四市的实证均值。
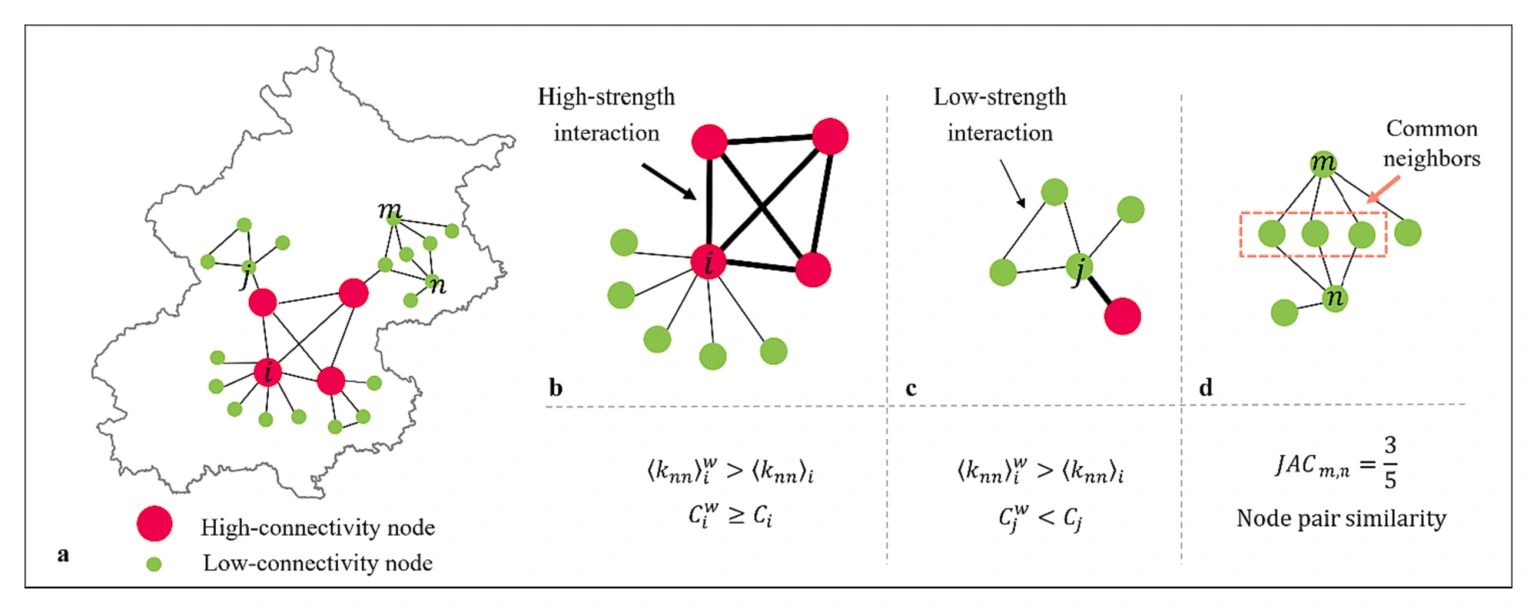
图 9|高连接、低连接和伙伴重叠在示意里如何区分?
(a)城市轮廓上的高连接节点与低连接节点,属于结构示意。(b)高连接节点i及其邻居,连边粗细表示作用强弱;加权邻居平均度大于无权版本,加权聚类系数不低于无权版本。(c)低连接节点j及其邻居,加权聚类系数低于无权版本。(d)节点m与n的共同邻居示意,图中的Jaccard写为3/5。来源:原论文 Fig. 9。
在已经存在的地点上加边,模型复现了哪些形态?
模型要解释的是:截断幂律、短距离连边、富人俱乐部、边权随度数加重,以及伙伴重叠,能否由同一套加边规则长出来。地点坐标不是模型生成的。每一步从该市尚未入网的货运兴趣点中随机抽一个新节点,长到设定的网络规模为止。正文没有另给一个不同于真实节点数的目标规模。
初始网络是5个随机地点的全连接图,每条边权重w₀=1。这两个数被固定,不参与估计。新节点n以概率Pᵢ∝sᵢ^α·e^(−dₙᵢ/r_c)挑选一个已有地点i作为复制对象。sᵢ是i当前的节点强度,α调节强度的吸引力,dₙᵢ是n与i的直线距离,r_c是距离尺度。被复制地点的全部邻居成为候选伙伴。n只连接其中一半,每个候选j再按P₍n,j₎∝sⱼ^α·e^(−dₙⱼ/r_c)抽取。一半是简化规则,奇数个邻居如何取整,正文没有说明。
新边的直接重量设为1。作者同时设一条间接作用σ:n连上j之后,还通过j接触j的邻居。j的强度加上1+σ;σ再按j的各邻居强度占邻居强度总和的比例,分到j与这些邻居的既有边上。于是一条新的枢纽连接会抬高枢纽周围已有边的重量。作者把〈kₙₙ〉和聚类比值随k上升,归到这种外溢。
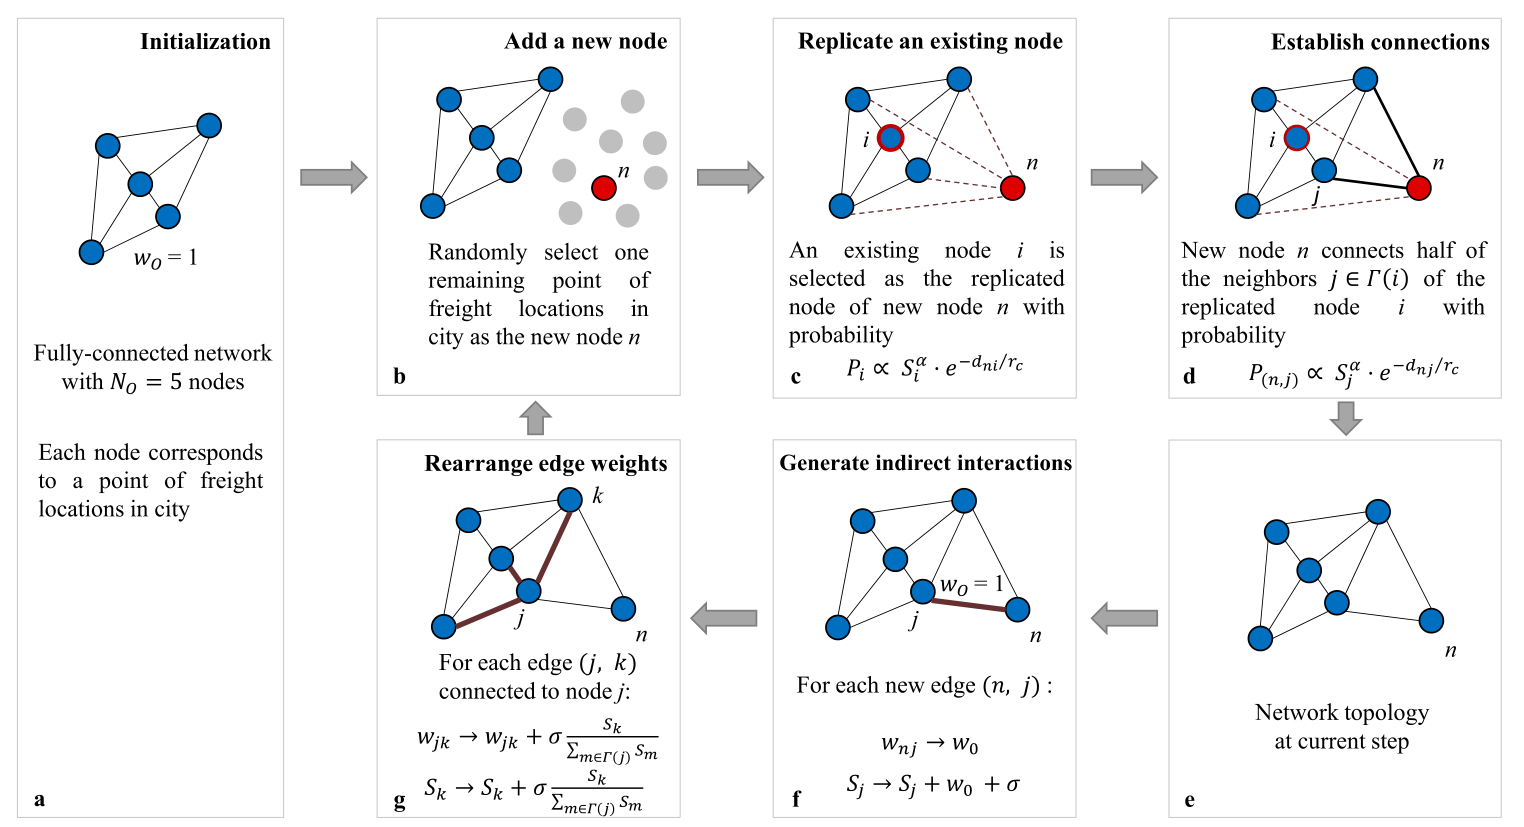
图 3|新地点加入时,拓扑和边权分别按什么规则更新?
(a)初始为5个节点的全连接网络,边权为1,每个节点对应城市中的一处货运地点。(b)从剩余地点中随机加入节点n。(c)按强度与距离挑选被复制节点i,i的邻居是候选连接。(d)n按同样的强度和距离规则,连接i的一半邻居。(e)这一步结束后的拓扑。(f)每条新边的直接重量为1,并使被连接节点的强度增加w₀+σ。(g)σ按邻居强度的比例改写已有边的重量,邻居强度同步增加。来源:原论文 Fig. 3。
α、r_c和σ用基于图相似度的方法估计,目标是尽量复现真实网络的结构。估计值和相似度都没有印刷出来。图6里,模型的度数、距离和富人俱乐部与真实点叠在同一套坐标上;重庆的距离分布在中长距离处,模型点略高于真实点。图8里,两类比值的上升和Jaccard的单峰也被模型跟上。Jaccard均值的差距为百分之一个位数:北京模型0.565、真实0.550;上海模型0.486、真实0.510;重庆模型0.538、真实0.508;天津模型0.465、真实0.501。上海和天津的模型均值低于真实均值。每个城市图上是一套模型点,不同随机种子的波动没有画出。
作者对各项拟合的机制解释是:强度偏好使新地点更常连向已经很大的地点,从而拉出截断幂律;距离项使新连接更常落在近处;复制规则使成功地点的伙伴关系被反复沿用,高度数地点在扩张中彼此相连;间接作用σ使枢纽周围的边越来越重。这些句子解释的是模型规则与图6、图8的对应。规则是事先写入的,参数又按同一批结构指标校准,因此图上的贴近表示这套规则足以产生类似形态。它还没有把距离、强度和复制拆开,也没有用下一段时间的新地点做核对。
这些证据停在哪一层?
网络描述的是2018年5月18日至31日、载重超过12吨的货车,以及能匹配到高德货运兴趣点的行程。面包车、小货车和末端配送车辆不在这张网里。一个在重型货车网中度数很低的地点,仍可能是小车辆的集散点。直线距离代替了沿路里程和行程时间,作者把这一点列为后续工作。兴趣点没有按产业、就业或服务范围分开,货流方向也没有识别。
北京道路分析给出的是四个皮尔逊系数和箱线图。最高的主干路相关是r=0.2038、p=0.0627。这组结果描述道路等级与货流量的弱线性关系,还不能作为“高等级道路导致货流”的证据。Moran’s I描述流量取值的空间聚集,F(r)描述坐标相对均匀泊松过程的聚集,两者的基线不同。
生长模型使用真实兴趣点的位置,加边顺序是随机的。它拟合一个两周截面,并不是观测到新公司逐年开设后记录下来的生长过程。政策讨论中,作者由距离项延伸到集聚、税收或地价激励和分区,由复制规则延伸到可持续做法的知识共享,由σ延伸到多式联运设施。模型没有计算车公里、费用或排放,因此这些是规则启发的政策设想。正文同时建议,在缺少货车轨迹的城市,可参照用地、规模和经济发展相近的城市近似参数;由于四市的参数值没有列出,这一步还无法从论文中的数字直接操作。
一句话总结
四座城市的重型货车把少数高强度地点连成枢纽,连边偏向短距离,复制伙伴、距离和强度写在一起的加边模型能重现这些统计形态;道路密度并没有给出显著的线性相关,模型也还没有单独证明复制就是枢纽形成的原因。
核心来源
- 正式版本为Transportation Research Part C: Emerging Technologies,2024,158:104442,在线发表于2023年12月2日。收稿日期2023年5月17日,修回9月22日,接受11月27日。DOI:10.1016/j.trc.2023.104442。
- 正文图1至图9和表1均来自该版本。17页PDF包含参考文献,没有附录。数据声明写明可向作者申请。
- 行程端点算法引自作者此前的Yang et al., 2022a,Identifying intracity freight trip ends from heavy truck GPS trajectories,Transportation Research Part C,136。匹配半径和停留阈值以那篇论文为准,本文没有复述。
作者介绍
机构与分工以论文首页署名前缀和文末CRediT为准。
- Yitao Yang:署名北京交通大学系统科学学院与代尔夫特理工大学交通与规划系,负责概念、形式分析、调查、方法、可视化和初稿。
- Bin Jia:署名北京交通大学系统科学学院与西安工业大学经济与管理学院,通讯作者之一,负责概念、指导、资助和项目管理。
- Xiao-Yong Yan:署名北京交通大学系统科学学院,通讯作者之一,负责概念、指导、资助、方法和修改。
- Yan Chen:署名北京交通大学交通运输学院,参与方法和修改。
- Lóránt Tavasszy:署名代尔夫特理工大学土木与地球科学学院交通与规划系,参与修改和指导。本文参考文献中的Combes and Tavasszy(2016)讨论库存、方式选择与货运网络结构。
- Michiel de Bok:同一代尔夫特单位,参与修改和指导。
- Zhuotong Bai:署名清华大学Institute of Civil Engineering,参与修改。
- Erjian Liu:署名北京交通大学系统科学学院,参与修改。
- Ziyou Gao:署名北京交通大学系统科学学院,在CRediT中负责资助。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
参数没有公布,城市之间就还不能比较“谁更受距离约束”。可以把同一批地点做三次残缺实验:只保留距离项、只保留强度项、只保留复制一半邻居,看哪一次仍能同时追上截断幂律、r_d和富人俱乐部。三项绑在一起的拟合,留下的是一套够用的规则;拆开之后,规划上该优先缩短枢纽之间的距离,还是该改变新地点可复制的伙伴名单,才会变成两个不同的问题。
另一项可核对的预测来自Jaccard。若新地点确实在复制一个已有地点,它的邻居集合应更接近那个被复制地点的邻居,而不是接近距离最近地点的邻居。这需要地点进入网络的先后。2018年5月这14天的截面没有这个时间戳。把平台上另一个月份的兴趣点新增情况接上这张网,才能把“伙伴重叠很高”从截面现象推进到复制规则。
重型货车图也不宜直接拿来合并低度数地点。低度数在12吨以上的网络里成立,小货车和面包车的停留仍可能集中在这些点。同一批兴趣点若叠加载重12吨以下车辆,高度数集合一旦换人,按本文枢纽制定的货运分区就会漏掉末端集散。这个对照使用的是论文已经划出的车辆门槛,换的是被排除的那一部分车。