路上的车速,能不能帮我们补出一天里每小时的人流?
论文名片|Can Rong、Zhicheng Liu、Jingtao Ding、Yong Li,Learning to Generate Temporal Origin-destination Flow Based on Urban Regional Features and Traffic Information,ACM Transactions on Knowledge Discovery from Data,2024,18(6):Article 150,2024年4月发表,共17页。DOI:10.1145/3649141。收稿日期2023年3月9日,修回2023年11月6日,接收2024年1月16日。
早高峰里,人从住宅区去办公区,经过的路会变慢。城市研究里长期用区域特征解释这件事:人口、兴趣点不同,两地之间的人流就不同。引力模型把这种联系写成规模相乘、再随距离衰减。可是同一对区域在早晨和傍晚的人数并不一样,而路上的车速又是人流经过之后留下的痕迹。
这篇论文要生成的,是一座城市里普通日逐小时的起讫流量(origin–destination flow,OD流量):从区域 i 到区域 j、在第 t 个小时有多少人移动。方向性结论是:在北京五环内、按区域对随机留出的测试上,让生成的人流同时去解释路网速度,均方根误差低于只用区域特征的引力模型、随机森林、DeepGravity 和图神经网络。车速在这里是训练时的辅助监督,模型输出也不是对车速因果作用的直接观测。
先说结论
- 对象是2021年7月北京五环内的小时平均起讫流,不是逐日预测,也不是个人轨迹。表1写342个区域,正文一处写343个。起讫点对按8:1:1随机划分成训练、验证和测试。
- 使用交通数据A的完整模型 ours-A,RMSE为36.571,NRMSE为0.615,CPC为0.634。表中RMSE最低的外部基线是 multi-GNN 的47.411;以该基线的 NRMSE 0.797 为分母,ours-A 低22.84%。随机森林的 CPC 已有0.624,ours-A 只高到0.634,相对提高1.60%。
- 交通数据B得到的 ours-B,RMSE为38.615,CPC为0.617。以 ours-B 的 NRMSE 0.649 为分母,ours-A 低5.23%;CPC相对提高2.75%。作者把差距归因于B与人流的年份相距更远。
- 消融文字写:时空嵌入大约降低8%误差,距离投影最多约降低10%,交通分支再使 RMSE 下降约7%。柱状图没有印出每个柱的精确高度。五次随机初始化的方差分析 p 值小于0.05,表2本身没有给出标准差。
要生成的是哪一天、哪一块地方的人流?
空间范围是北京五环以内,按次级公路划分区域。表1列出三份数据:起讫流为2021年7月1日至31日、1小时、342个区域;交通A为2022年7月1日至31日、5分钟、29,418个路段;交通B为2017年4月1日至5月31日、15分钟、15,073个路段。B是公开的 Q-Traffic。A来自论文所称最大的数字地图服务商,起讫流和区域属性来自一家大型互联网服务商,两家都没有写出名称。
区域属性采集于2021年,包括分年龄、分性别的人数,以及分类兴趣点(point of interest,POI)的数量。起讫流是2021年7月每天同一小时的平均人数,再排成普通日的24个小时。论文把这种剖面叫做 daily temporal OD flow:一年中普通日在不同时刻的常规移动。因此模型学习的是这一个月叠出来的小时节律,不能直接说成7月15日或任何一个未来工作日的流量。
这里有一处记录不一致。5.1.3节写交通A与起讫流同一时期、每5分钟一条速度;表1把交通A标在2022年7月。后文又说交通B因与起讫流年份差距大,带来的改进有限。若以表1为准,A与人流也相差一年,只是比2017年的B近。后文在比较 ours-A 与 ours-B 时保留这一矛盾,不把“同期”当成已经核实的事实。
分析单位是区域对乘以小时,不是受访者,也不是单次出行。论文没有给出用户数、采样率、兴趣点类别数或特征维度,也没有说明是否去掉区域内流动。损失按全部区域对的平方 |R|² 平均,而起讫点对的定义又写的是两个不同区域。表中的误差因此不能换算成“每个被调查者偏差多少人”。
三条联系上的人流和车速,先说明什么?
在建模之前,论文抽了三对区域,看小时人流和速度是否一起变化。这是案例,不是相关系数,也不是模型预测。
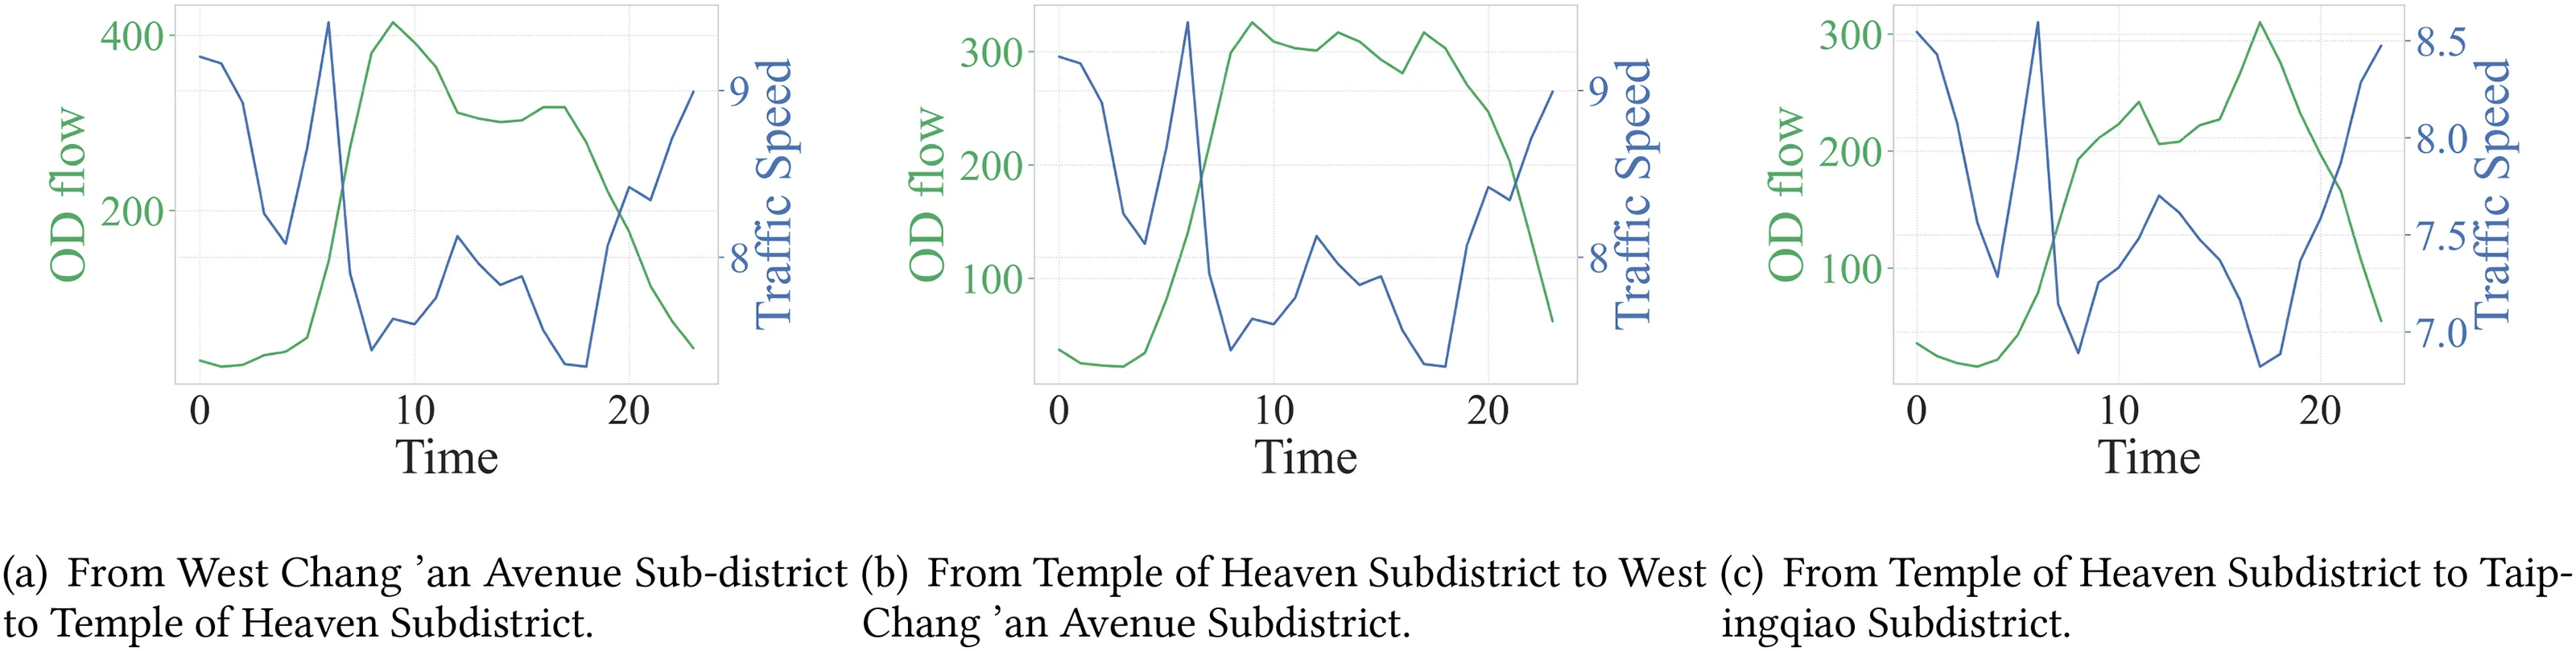
图 5|人流升高时,这几条联系上的车速怎样走?
(a)西长安街街道到天坛街道。蓝线是起讫流量,左轴刻度见到400;绿线是交通速度,右轴刻度在8到9附近。早晨人流冲高时速度处于低位,午后速度较高。(b)天坛街道回到西长安街街道,左轴刻度见到300。人流的高峰比(a)更靠后,速度在白天维持高位、夜间下降。(c)天坛街道到太平桥街道,左轴刻度见到300,右轴大约7.0到8.5。早晨同样有人流尖峰,速度却从早晨的低位升到傍晚。横轴是时刻,刻度越过20,与小时粒度相符,图上没有标到24。来源:原论文 Fig. 5。
作者的读法是:人流增加会加重拥堵、从而降低速度。三张图里,(a)的早晨最接近这个方向;(c)在人流尖峰之后速度继续上升,并不能当成同一条反向曲线。右轴没有印出速度单位,不能把7到9读成公里每小时。三对区域是挑选出来的街道组合,也不能代表342个区域的全部联系。
车速怎样进入模型,而不靠不可导的仿真器?
旧办法可以用 MATSim 或 SUMO 把人流仿真成路况,但仿真过程不能对参数求梯度。生成模型这边又要用梯度训练。GODUT 把两件事接成可导的多任务网络:Urban2OD 由区域特征生成人流,OD2Traffic 再由这条生成的人流预测速度,两边的误差一起反向传播。
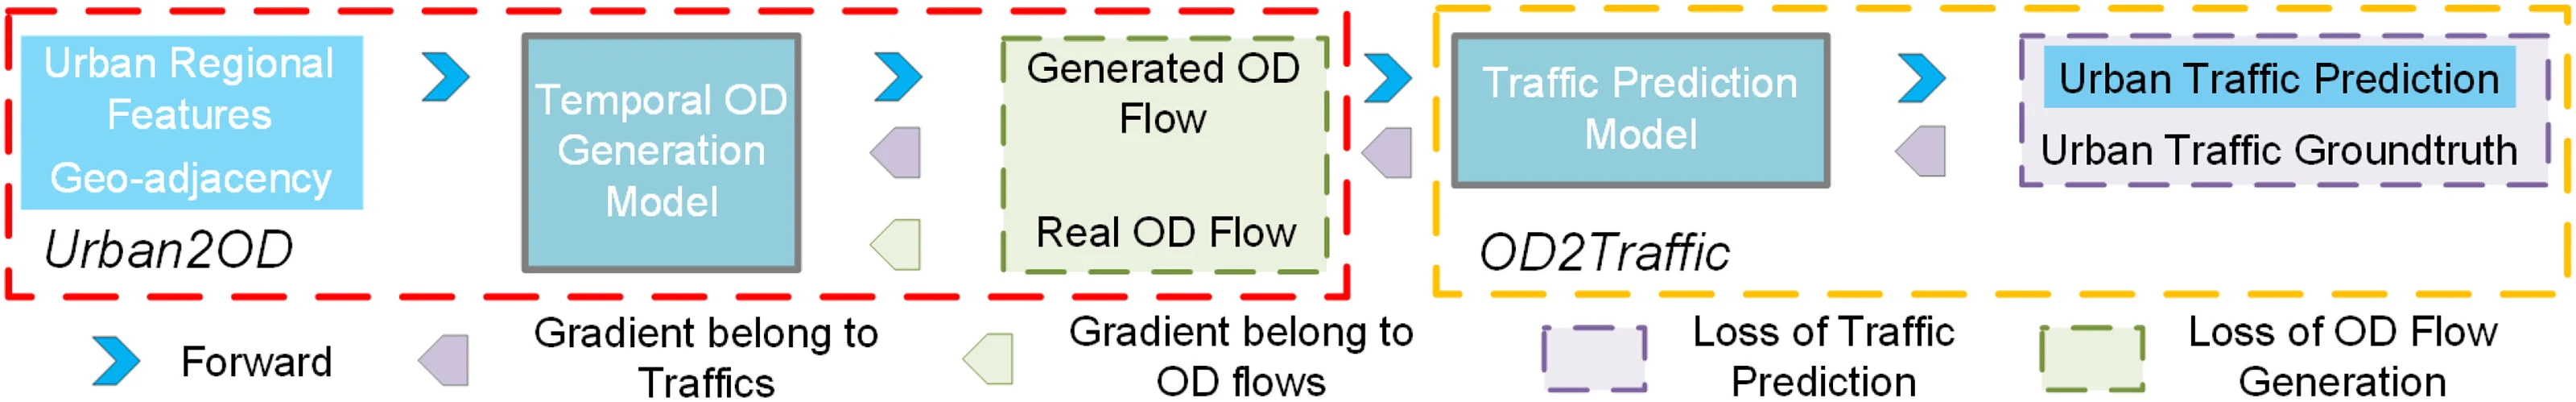
图 1|人流生成和速度预测怎样互相传梯度?
无字母子图。左侧虚线框是 Urban2OD:区域特征与地理邻接进入逐小时人流生成,输出与真实人流比较。右侧是 OD2Traffic:交通预测与真实路况比较。实心箭头是前向计算,浅色箭头把交通损失和人流损失传回生成模块。来源:原论文 Fig. 1。
形式化问题把区域特征 {X_r} 和路网速度 {S_k^t} 都写成输入,输出是 {F_ij^t}。实现上,生成人流的前向路径使用区域特征、邻接、时刻嵌入和距离;速度不直接拼进人流预测器,而是作为 OD2Traffic 的预测目标。训练因此需要两套标签:留出之外的真实人流,以及路段速度。它适合“一部分区域对缺少人流、速度和其余人流可见”的补全,不能按这个实验直接说成一座完全没有人流标签的新城市。
两项损失都是均方误差,再直接相加,论文没有报告权重。人流项对时间片数 |T| 和 |R|² 取平均;速度项对 |T| 和路段数 |l| 取平均,比较的是速度 Vel。人流量和速度的数值尺度不同,相加后谁主导梯度,正文没有单独检验。优化器用随机梯度下降。
区域特征怎样变成逐小时的起讫流?
城市功能既来自区域内部,也来自相邻区域。图按地理相邻连接区域,节点特征是区域属性加上时刻嵌入。每个小时走一步图增强门控循环单元:重置门和更新门都经过图卷积。图中这两个门的激活标成 ReLU,不是教科书门控循环单元常用的 sigmoid。候选状态用 tanh。这样得到每个区域在该小时的时空嵌入。
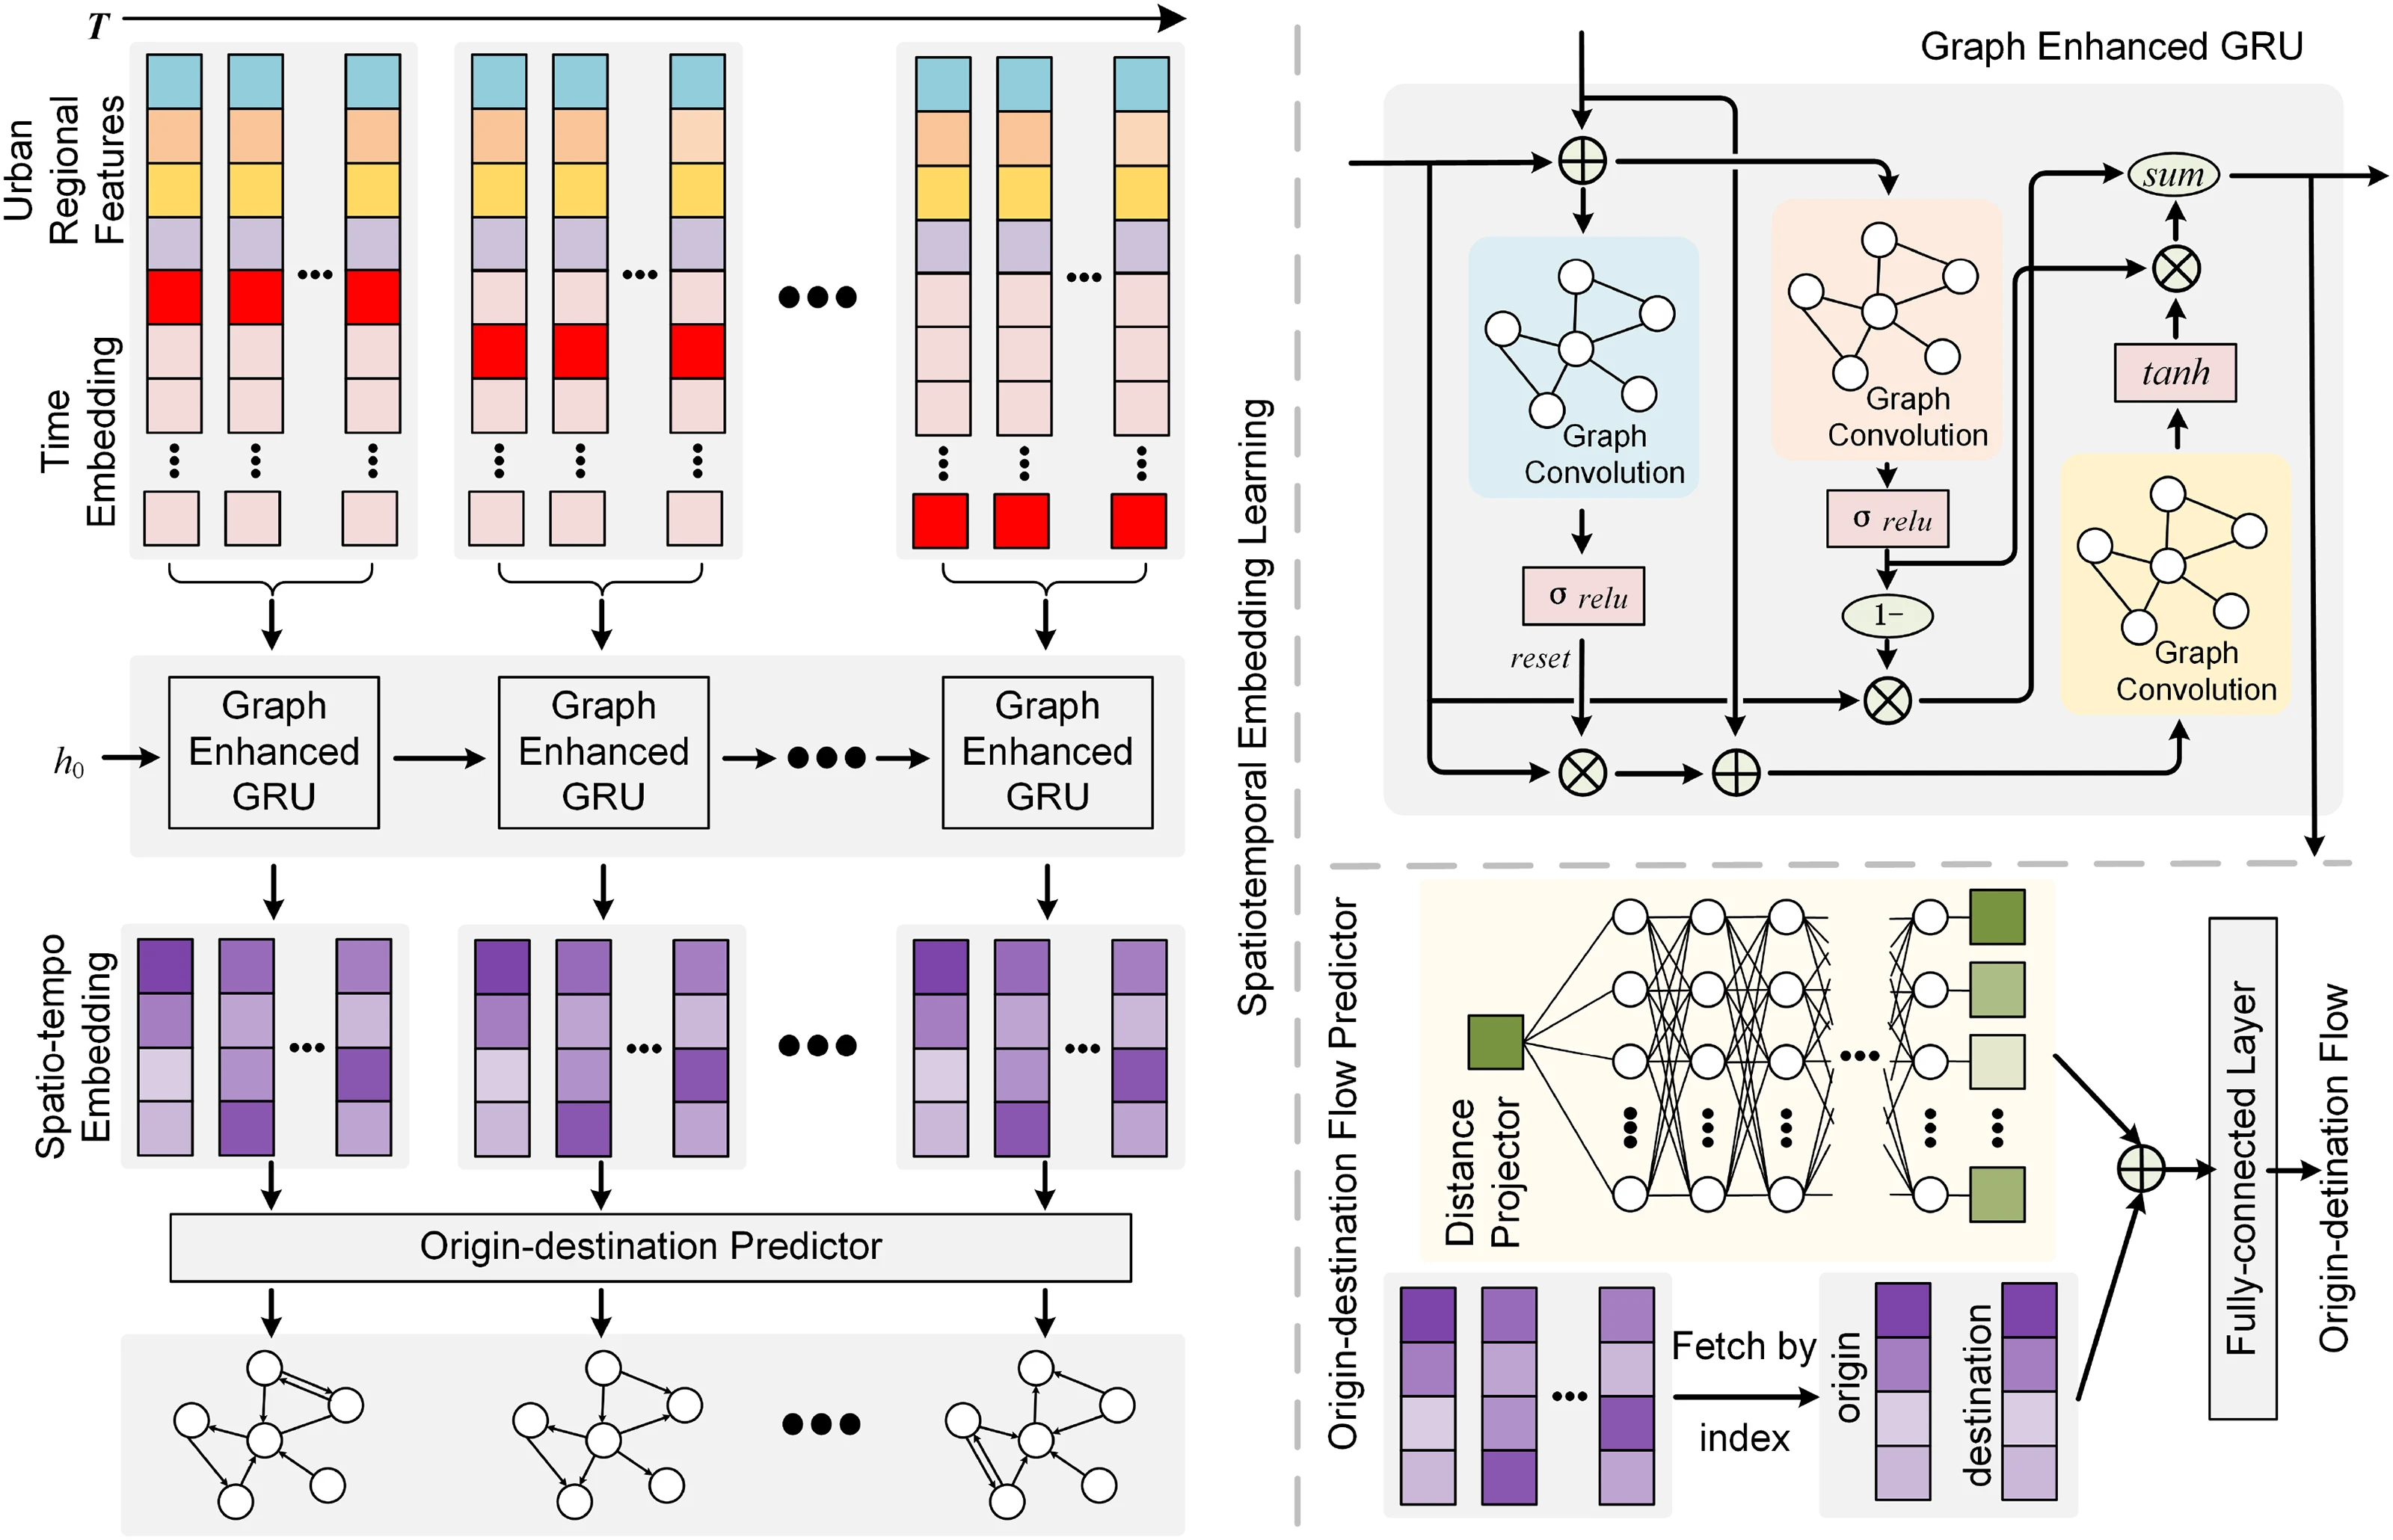
图 2|从区域特征到一对起讫点的流量,中间经过哪些计算?
无字母子图。左列沿时刻 T 重复图增强 GRU,输入是区域特征与时刻嵌入,输出时空嵌入,再交给起讫点预测器。右上是 GRU 内部:三处图卷积分别服务重置门、更新门和候选状态,门上标着 σ relu。右下是距离投影:一维距离先进入多层感知机,再与起点、终点嵌入拼接,经全连接层得到流量。来源:原论文 Fig. 2。
距离衰减很陡,幂函数或指数函数都只是已有写法。作者不用手写一种衰减,而用5层、每层64个神经元的多层感知机把一维距离投到高维,再与两端嵌入拼接。主实验里图卷积为3层、64个通道,时空嵌入维度也是64。所有对比模型共用同类超参数:引力模型只用居住人口和就业人口、4个可学习参数;随机森林30棵树;各图网络3层、64通道。
基线分两组。单模型组把一天中的小时做成 one-hot,包括引力模型 GM、随机森林 RF、DeepGravity(DG)和 GMEL 式的图网络 GNN。多模型组为24个小时各训一个模型,没有共享跨小时的隐状态,即 multi-GM、multi-RF、multi-DG、multi-GNN。多模型用来回答:把时间拆开单独拟合,是否已经够用。
一条路该和哪些起讫点对有关?
一个人从起点到终点,很少只走唯一最短路。论文也不使用观测轨迹,而是画一个几何代理:起点和终点构成的矩形里的路段,都算与这对起讫点有关。一对起讫点连多条路,一条路也连许多起讫点,于是得到二分图。
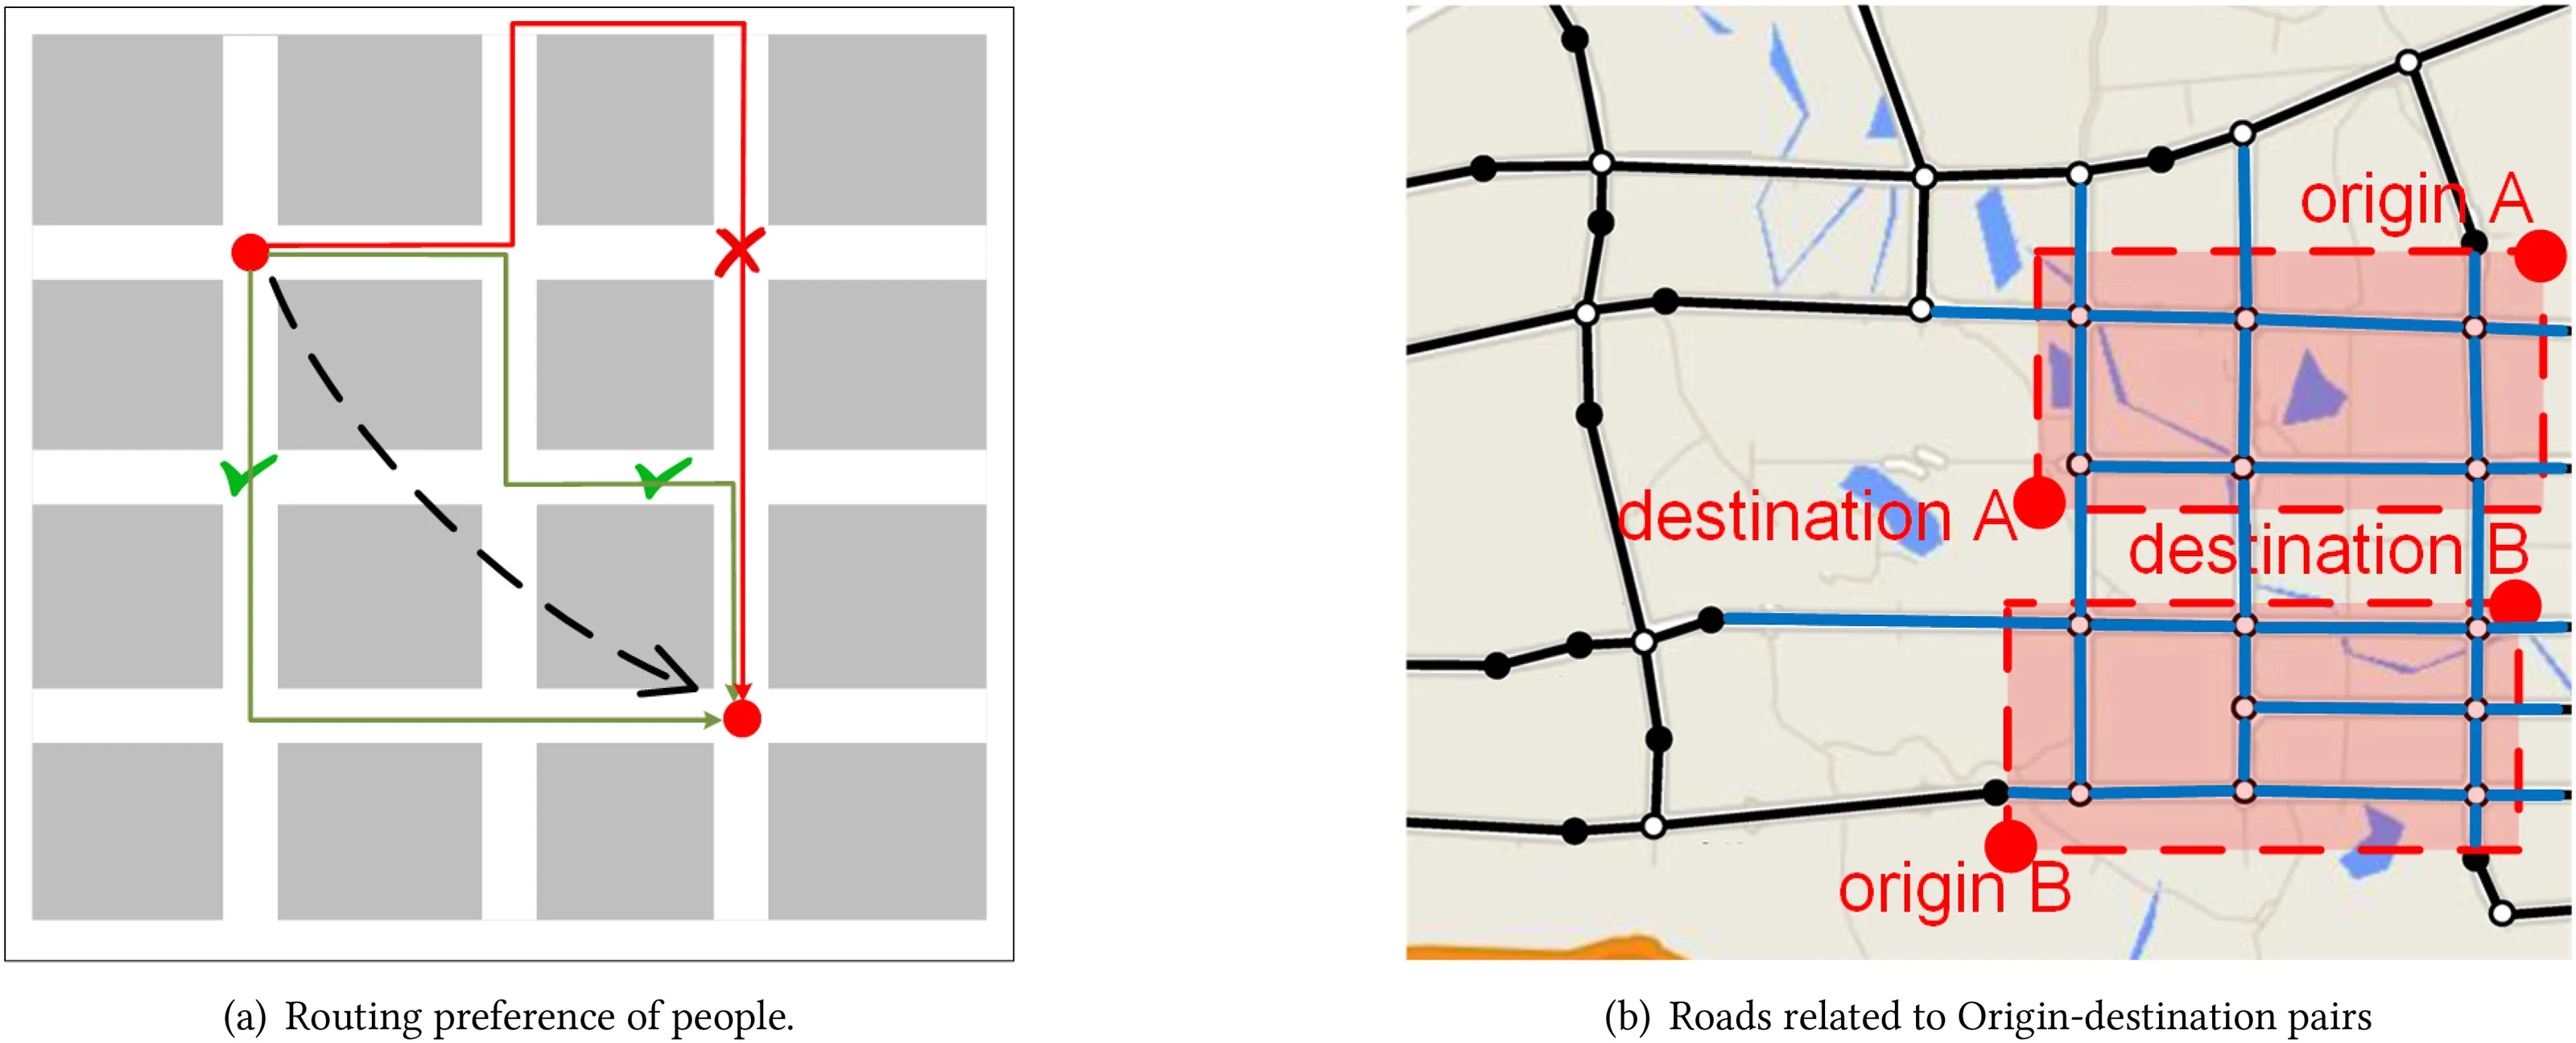
图 3|没有真实路径时,模型靠什么把路和起讫点连上?
(a)示意同一起终点之间的多条偏好路径:实线、折线和虚线都能到达,矩形网格只说明选择不唯一。(b)在真实路网上,起点 A 到终点 A、起点 B 到终点 B 的矩形覆盖范围内,蓝色路段被标成与对应起讫点对有关。矩形是空间代理,不是导航记录。来源:原论文 Fig. 3。
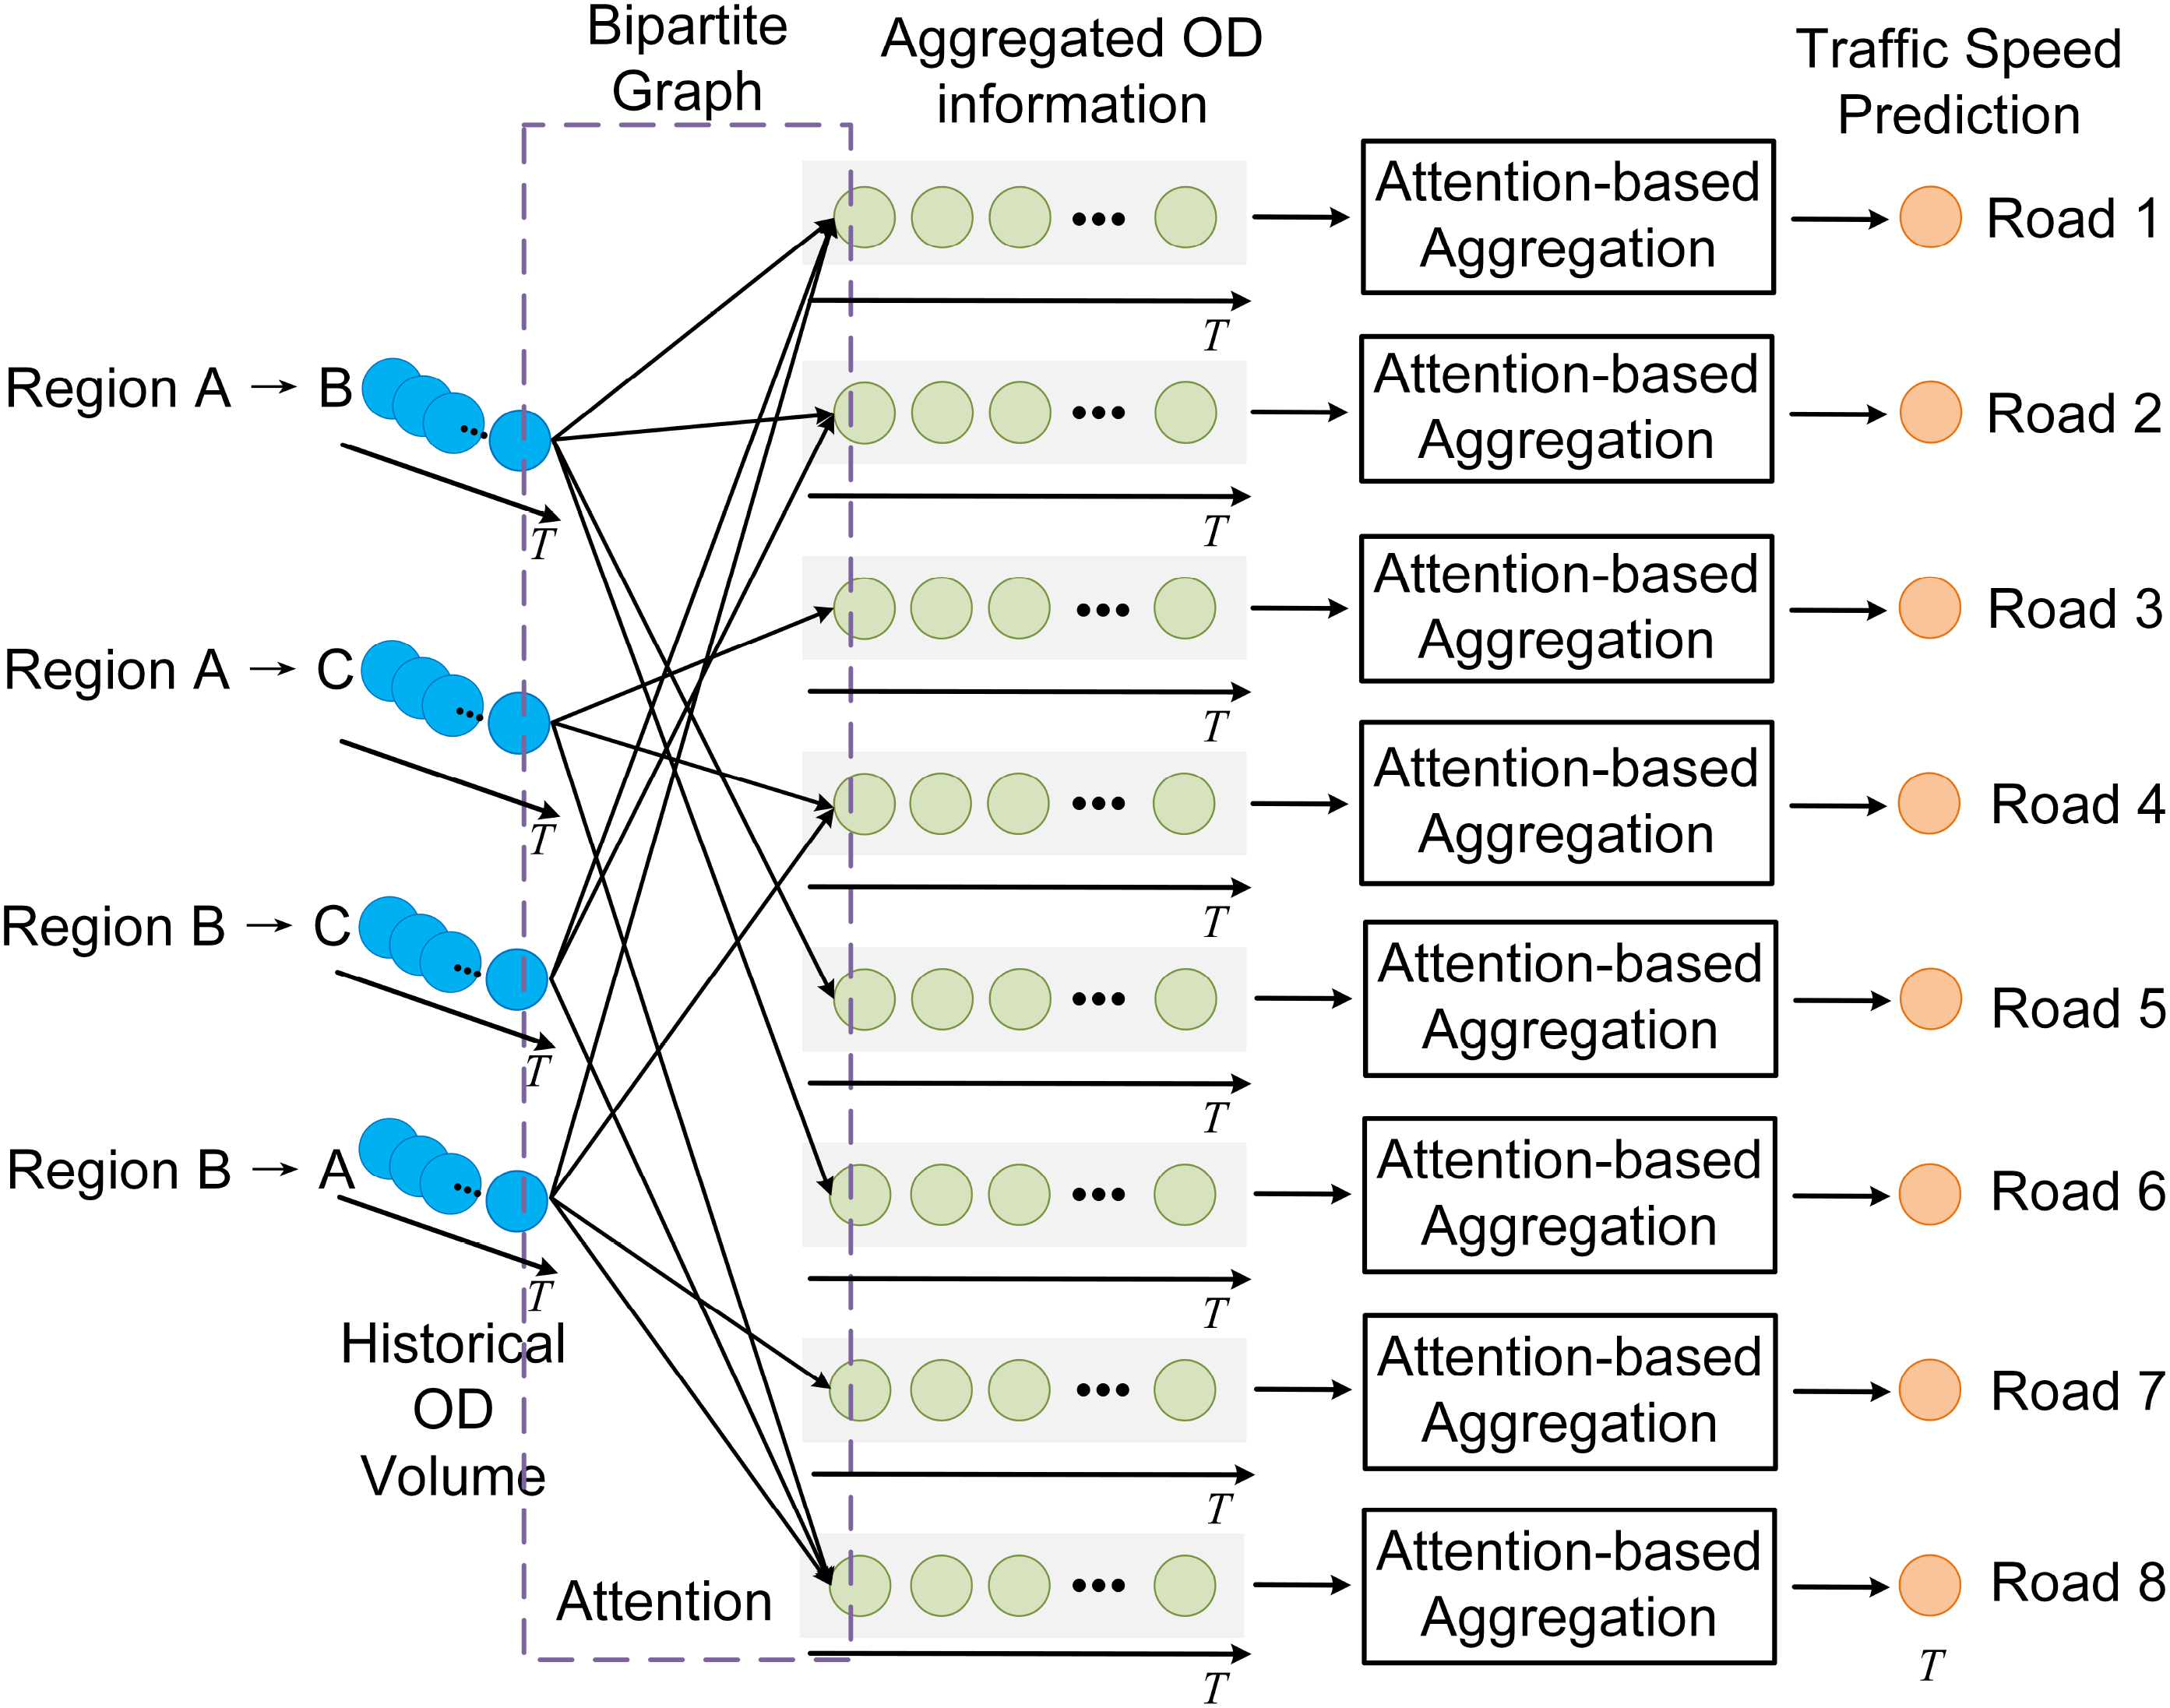
图 4|一条路的速度,由哪些历史人流加权得到?
无字母子图。左侧蓝点是区域对在各小时的历史人流量,经注意力连到中间的绿色路段表示;右侧第二层注意力再沿时间聚合,输出路段1到路段8的速度预测。主实验使用的历史长度为2个小时。来源:原论文 Fig. 4。
第一层注意力决定某一时刻哪些起讫流量进入这条路,权重里还拼了路段的 one-hot。第二层注意力决定该用更近还是更早的小时。论文的直观说法是:近的起点更依赖最近的人流,远的起点可能更依赖更早的人流。注意力可以学出这种差别,但实验没有报告学到的权重是否真按距离这样排列。速度分支的输入是 Urban2OD 生成的流量,不是真实流量,这样速度误差才能改到生成器。
留出的区域对上,误差比谁低?
指标有三个,都在同一批流量上计算。RMSE 是预测与真实流量之差的均方根,公式对 |T| 和 |R|² 平均,单位与小时平均出行人数相同。NRMSE 等于这个 RMSE 除以观测流量相对均值的均方根偏差,分母是数据自己的离散程度;0.615 表示模型误差相当于该离散程度的61.5%,1将接近“所有格子都猜同一个均值”的误差量级。CPC 是两倍的逐格较小值之和,再除以真实总量加预测总量,落在0到1。名字来自通勤重叠,这里的求和覆盖各小时和各区域对,不单指上下班。
每个模型用5个随机种子各跑一次,方差分析的 p 值小于0.05。表2给出的是点估计,没有附标准差。Imp. 列以 ours-A 为参照:NRMSE 的 Imp. 是 (ours-A − 该模型) / 该模型,负值表示 ours-A 更低;CPC 的 Imp. 是同一形式的相对差,正值表示 ours-A 更高。
| 模型 | RMSE | NRMSE | 相对 ours-A 的 NRMSE | CPC | 相对 ours-A 的 CPC |
|---|---|---|---|---|---|
| GM | 54.275 | 0.912 | −32.57% | 0.349 | +81.66% |
| DG | 53.532 | 0.900 | −31.67% | 0.402 | +57.71% |
| GNN | 47.795 | 0.797 | −22.84% | 0.560 | +13.21% |
| RF | 48.499 | 0.815 | −24.54% | 0.624 | +1.60% |
| multi-GM | 52.142 | 0.876 | −29.79% | 0.387 | +63.82% |
| multi-DG | 52.197 | 0.877 | −29.87% | 0.432 | +46.76% |
| multi-GNN | 47.411 | 0.797 | −22.84% | 0.556 | +14.03% |
| multi-RF | 49.502 | 0.830 | −25.90% | 0.537 | +18.06% |
| ours-B | 38.615 | 0.649 | −5.23% | 0.617 | +2.75% |
| ours-A | 36.571 | 0.615 | — | 0.634 | — |
外部基线里 RMSE 最低的是 multi-GNN,47.411。ours-A 的36.571比它少10.840;因为 NRMSE 只保留三位小数,GNN 的47.795和 multi-GNN 的47.411都对应0.797,所以两行的相对降幅都印成22.84%。正文说依靠交通A、按 RMSE 超过20%,与这一档相符。引力模型的 NRMSE 0.912 最高,CPC 0.349 最低;DeepGravity 只比它略好,仍明显高于随机森林和图网络。随机森林的 RMSE 不是最好,CPC 却有0.624,与 ours-A 的0.634只差0.010。平方误差改善大,不自动等于流量重叠也大幅提高。
24个独立模型并没有稳定优于对应的单模型。multi-RF 的 CPC 降到0.537,低于单棵随机森林的0.624。只把24小时拆开、不共享时间结构,不足以解释 ours-A 的差距。
ours-B 用交通B,RMSE 38.615,仍低于全部外部基线,但高于 ours-A。以0.649为分母,0.615低5.23%。作者认为B与2021年7月人流的时间间隔更大,人流本身会慢慢变化,所以旧速度的约束更弱;同时写模型对交通数据的时间错位具有稳健性。若表1中交通A其实是2022年7月,则A也不是零错位,5.23%只比较了两份错位程度不同的速度,不能单独证明“必须同一小时的速度”。
推理时间在约15万条时间化起讫记录上小于1秒,论文把复杂度写成随区域对数量线性增长,并说明 CPU 与 GPU 并行。15万这个数没有再拆成测试对数量乘以24小时。参数量约100万,训练约20分钟。作为对照,multi-GNN 约70万参数、训练约20小时,DeepGravity 约4.1万参数、训练约5小时。参数更多而训练更短,只说明这次硬件和实现下的耗时,不是精度来源。
少掉的误差来自哪一块设计?
消融从 multi-GNN 出发,依次加入时空嵌入、距离投影和交通分支。图6的柱没有标数字,误差棒来自重复运行。下面的百分数是正文对这张图的概括。
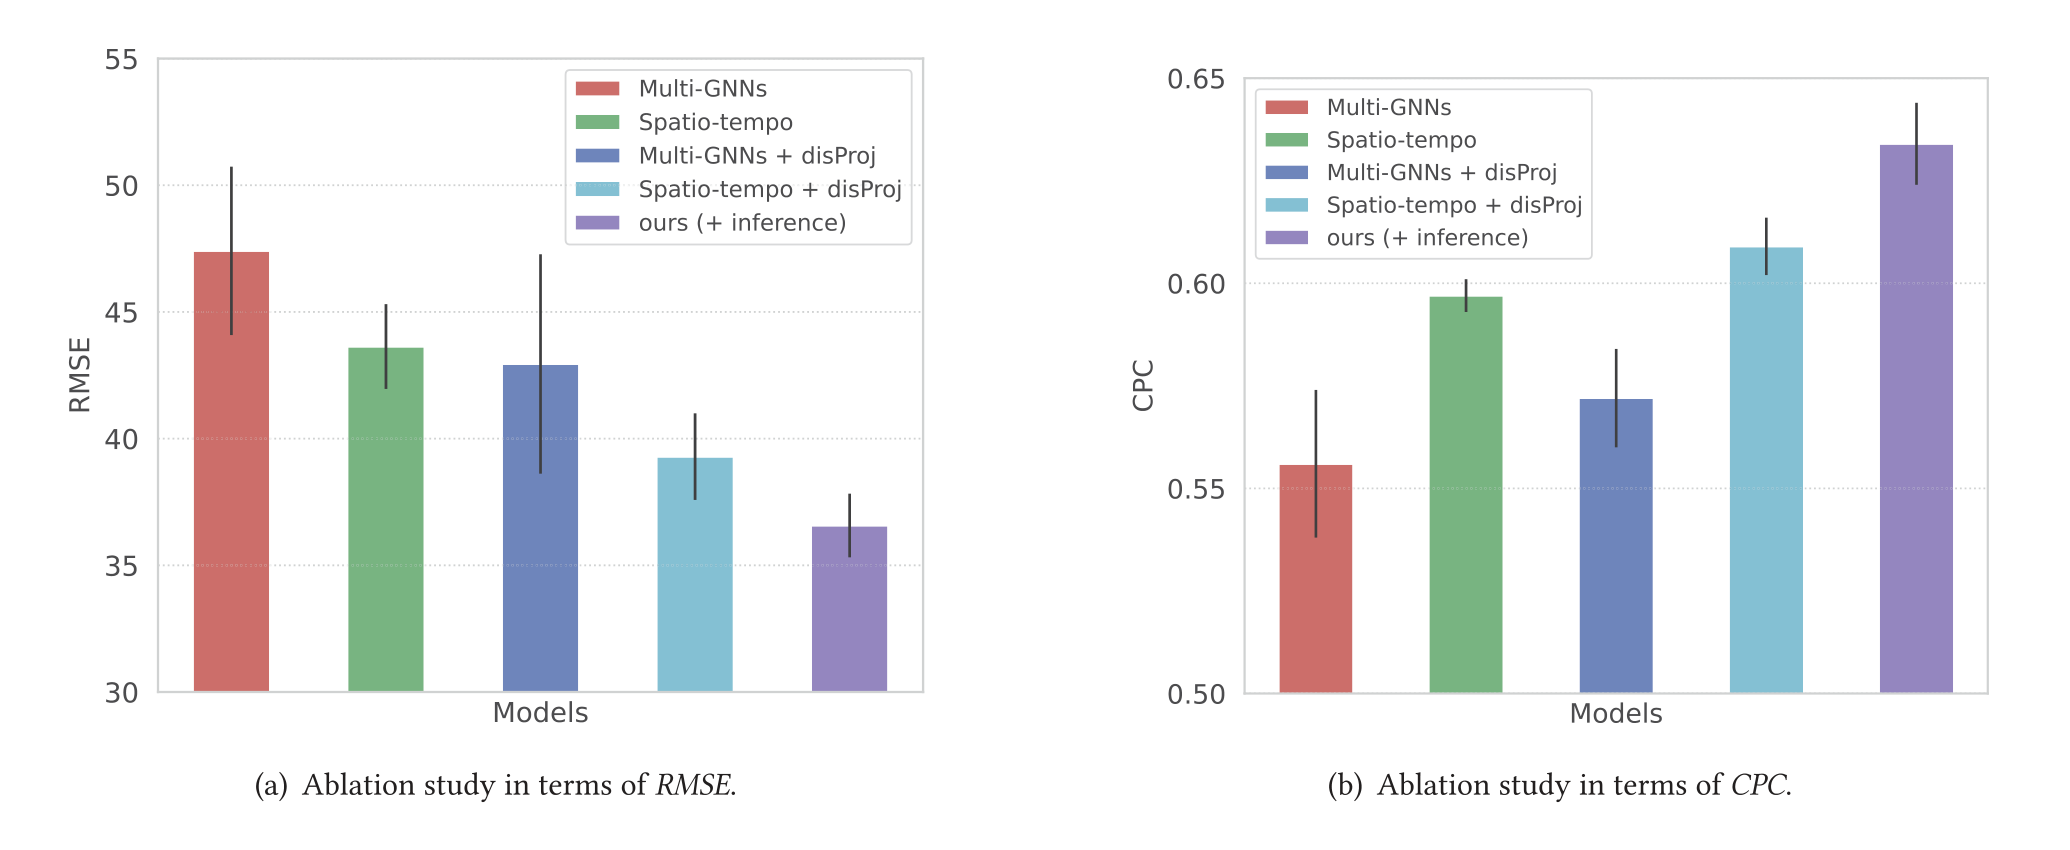
图 6|拿掉时空嵌入、距离投影或交通分支,误差怎样变?
(a)纵轴 RMSE,越低越好。从左到右为 multi-GNN、只加时空嵌入、只加距离投影、时空嵌入加距离投影、再加上交通分支的完整模型。正文写时空嵌入相对 multi-GNN 大约改进8%,距离投影最多降低约10%的生成误差,最右侧交通分支再使 RMSE 下降约7%。(b)纵轴 CPC,越高越好,顺序与(a)相同。图例里的 inference 指速度预测分支,也就是损失里的 L_inference,不是因果推断。误差棒有重叠,精确柱高不能从坐标上读出。来源:原论文 Fig. 6。
完整模型的最右侧柱与表2的 ours-A 属于同一设计,但图上没有印出36.571或0.634。因此8%、10%、7%应理解为作者对柱高的概括,分母是相应的前一个设置,而不是表2里某个外部基线。三块都使误差朝同一方向变化,不能据此把其中一块说成已经解释了人为什么出发。
通道数、嵌入长度和历史小时停在哪里?
主实验把图卷积通道、时空嵌入和距离投影的宽度都设为64,交通分支的历史长度设为2。图7检查这些选择附近的 RMSE,纵轴仍是生成误差,点上没有印出精确读数,竖线是波动范围。
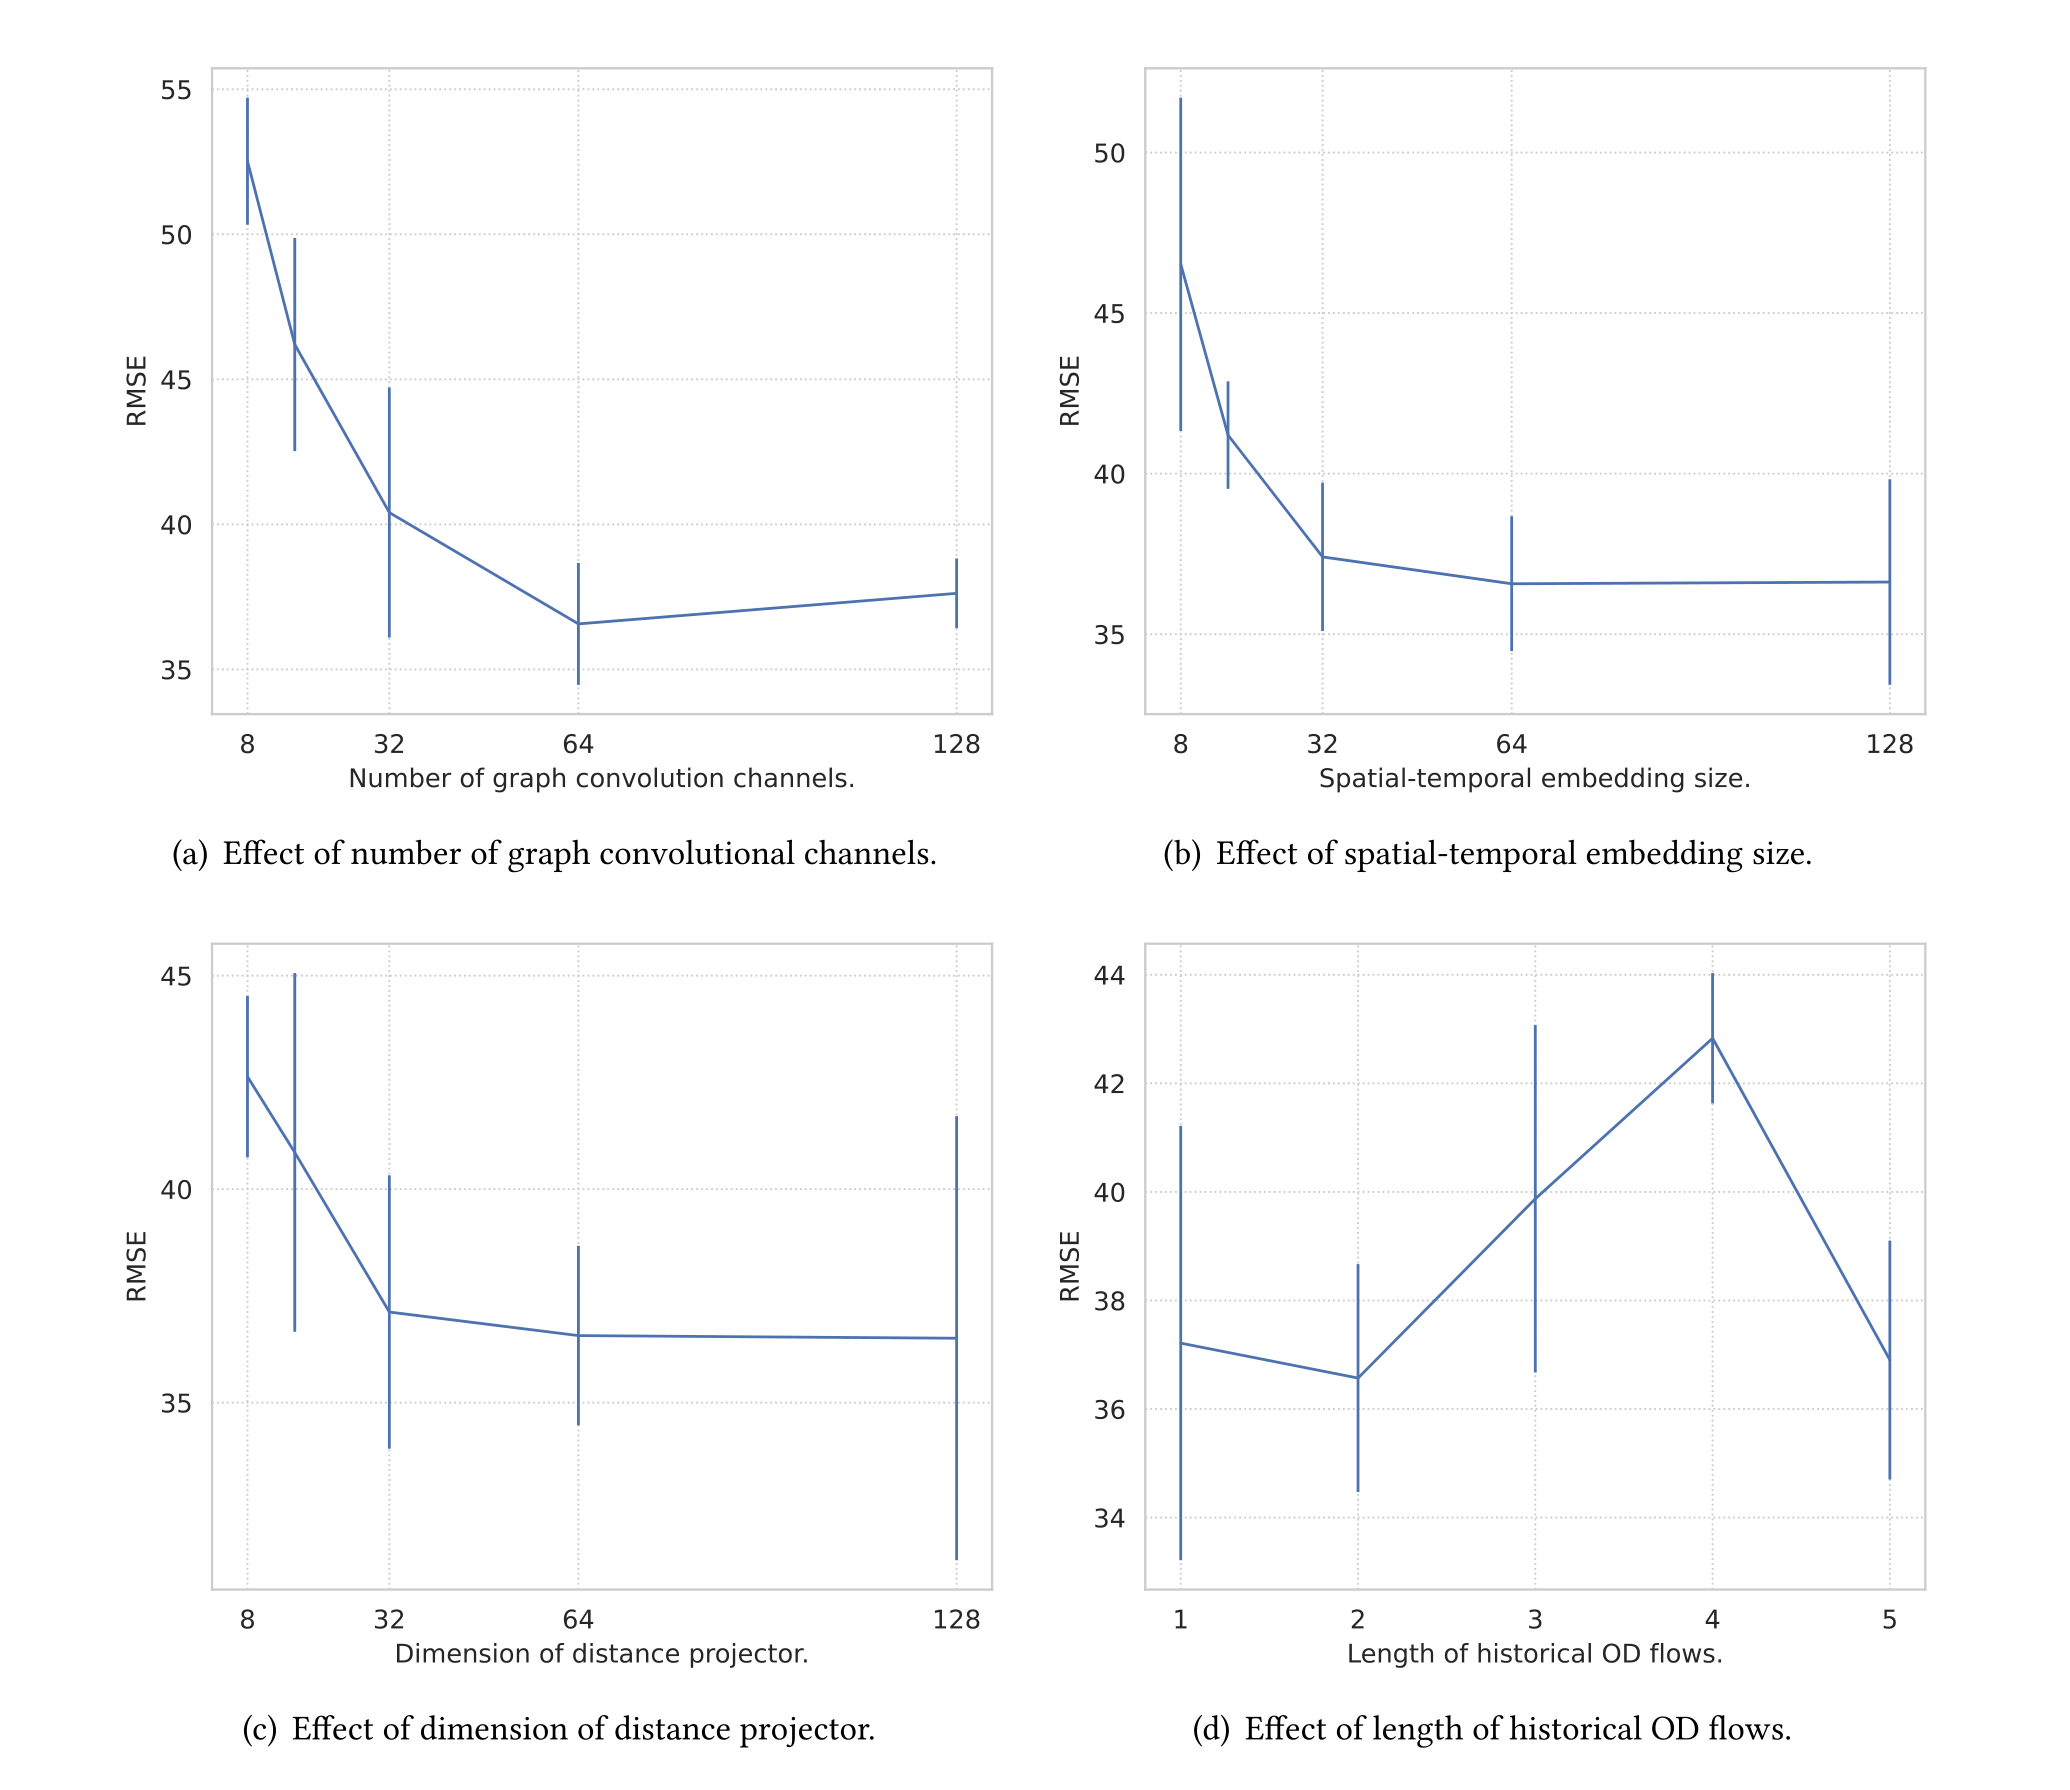
图 7|四个超参数离开默认值之后,生成误差怎么变?
(a)图卷积通道取8、32、64、128。误差随通道增加而下降,64处最低,128略回升。正文说通道太少会拟合不足,到64后不再继续变好。(b)时空嵌入维度同样取这四档,从8降到32以后趋于平缓,64与128几乎持平。(c)距离投影维度在32之后也变平,128的波动范围很大,说明加宽并不稳定地更好。(d)历史人流长度从1到5小时。均值在2最低,3和4上升,5又下降,竖线互相重叠。正文认为2小时最合适,更长的历史会带进噪声;图本身对长度为5的回落没有另作解释。来源:原论文 Fig. 7。
这四张图是灵敏度曲线,不是每档之间的显著性检验。默认值64和2落在曲线变平或均值较低的位置,与“再加大就不再稳定变好”一致,也说明论文报告的表2使用了这组已经扫过的设置。
这些比较停在什么边界上?
随机划分的是区域对,不是日期,也不是另一座城市。图卷积又能看到全部区域的特征和邻接,所以测试对的起点、终点属性并没有被藏起来。结果说明模型能补同一张五环地图上缺了标签的联系,不能说明换一座城市、或换到2021年7月以外的某一天,RMSE 仍会少22.84%。
速度损失约束的是“生成的人流能否再预测速度”,不是从速度反推每个出行者的路径。矩形把包围盒里的路段都连上起讫点,环路或平行道路可能被许多其实不经过它的区域对共享。图5只展示三对挑选的街道,而且(c)并不表现为简单的人流升、速度降。
CPC 与 RMSE 对随机森林的结论不一样:重叠只多0.010,NRMSE 则低24.54%,分母是随机森林自己的0.815。若应用关心的是大流量格子不要错得太狠,RMSE 的下降更相关;若关心有多少流量质量被双方同时覆盖,0.634对0.624的差别很小。两项损失直接相加,也没有报告速度预测本身的准确率,所以交通分支的7%是人流误差的变化,不是速度预报的成绩。
区域数343与342并存,交通A的年份在正文和表1之间不一致,速度图没有单位,兴趣点类别数、用户规模和测试对的确切个数都没有给出。这些缺口不推翻表2里 ours-A 低于所列基线,但限制了把36.571理解成某种普适的人数误差。
一句话总结
在北京五环内的普通日小时剖面上,用区域特征生成留出区域对的人流、并要求这批人流能解释路网速度,可以把 RMSE 降到表中的36.571;这是同一城市、同一套平均日上的补全成绩,不是车速造成了人流,也不是换一天或换一座城市仍能照这个幅度补齐。
核心来源
- ACM Transactions on Knowledge Discovery from Data 论文页,核对题目、作者、卷期与2024年4月发表信息。本文依据该文17页正式版,图1至图7均来自这一版。
- 论文末尾给出的代码入口:tsinghua-fib-lab/Traffic_Enhance_OD。代码公开不等于运营商的原始人流和路况公开。
作者介绍
四位作者在论文中的署名单位都是清华大学电子工程系与北京信息科学与技术国家研究中心(BNRist)。
- Can Rong:第一作者,论文邮箱 rc20@mails.tsinghua.edu.cn。所在实验室后来的论文目录中,他继续做通勤起讫流生成和移动轨迹建模。
- Zhicheng Liu:论文邮箱 zhichengliu@tsinghua.edu.cn。本文未写职称;同一实验室的公开目录里还有他参与的路网与城市数据工作。
- Jingtao Ding:论文邮箱 dingjt15@tsinghua.org.cn,其清华大学个人页面提供了本文 PDF。与李勇合作的工作覆盖城市时空学习、复杂网络和生成模型。
- Yong Li(李勇):通讯作者,邮箱 liyong07@tsinghua.edu.cn。清华大学电子工程系主页列其为教授、博士生导师,研究方向写的是数据科学、城市科学与计算。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市只剩旧年份的路况,交通分支未必还能贡献消融文字里那约7%的 RMSE。ours-A 相对 ours-B 的 NRMSE 只低5.23%,而作者已经把这份差距和年份错位联系在一起。使用前应先核对照表:速度的月份与人流的月份相距多远。表1与正文对交通A是否同年的矛盾也说明,这一步核对不能只看方法名称。
另一个可以直接检验的改动,是把矩形包围盒换成真实轨迹或最短路,再看交通分支的误差下降还在不在。包围盒会让平行道路共享许多起讫点;若换了连边之后7%消失,现在的增益里就有一部分来自过宽的路网代理,而不是来自速度真的知道人走了哪条路。
评价也要先选定分母。相对随机森林,NRMSE 低24.54%,CPC 只高1.60%,绝对差是0.010。规划若要压低最大的人数偏差,平方误差更有信息;若要问预测和真实有多少流量被双方同时覆盖,这0.010几乎不能单独支持更换模型。把两个指标绑在一起报告,比只说全面超过更能决定这个生成结果该不该进入后续仿真。