货车在路边停了半小时,这一停算不算一趟货的终点?
论文名片|Yitao Yang、Bin Jia、Xiao-Yong Yan、Jiangtao Li、Zhenzhen Yang、Ziyou Gao,Identifying intercity freight trip ends of heavy trucks from GPS data,Transportation Research Part E: Logistics and Transportation Review,2022,157:102590。2021年12月29日在线发表,正式卷期为2022年第157卷。DOI:10.1016/j.tre.2021.102590。本文依据这一正式发表版解读。
一辆重型货车在绕城高速上停了四十分钟。若按以前常用的15分钟规则,这一停会被记成一次装货或卸货。它也可能只是堵车。GPS只给出时间和坐标,不会写明这一停是装卸、加油、服务区休息,还是堵在路上。
这篇论文要分开两件事:轨迹上的停车,以及真正用来切开一趟货运的行程端点。端点包括装货、卸货,以及作者所理解的行程结束后的长时间停车。短于26分钟的停留被当作途中临时停车;长于13小时的停留被当作端点;介于二者之间的停留,还要落在货运相关地点、并且不在按道路宽度扩出的拥堵范围内,才保留。在随机抽出的1000辆车、用卫星影像和兴趣点做的目视核对里,准确识别的端点占被核对端点的94.24%。这是端点计数上的一致程度,不是司机日志逐条确认后的活动分类。
先说结论
- 速度刚好为零,盖不住静止时的GPS漂移。一个点要同时落在方向变化和速度两条序列的异常段里,才被当成静止漂移点,再与零速点合成一次停车。
- 全部停车的停留时间呈三段断裂幂律,拐点在26分钟和13小时,指数依次为1.37、0.45和1.64;图例给出的整段拟合R²为0.8837。短停留不当成端点,超过13小时的停留当成端点。
- 1000辆车的目视核对中,本文方法对应6850个判对、249个误判、170个漏判,准确率为6850/7269=94.24%。三组对照的准确率更低,但每种方法的分母不同。
- 约260万辆重型货车在这一周被识别出约2500万个端点,并从全部货车行程中保留约1800万次城际行程。多数城际行程的距离大约100公里、时长大约3小时;这是分布的主体位置,不是每辆车的日程。
经验上的分钟数,为什么分不开卸货和堵车?
行程端点(freight trip ends)在这里指一趟货运的起点或终点。GPS轨迹要先被切成一段段行程,第一步就是找出这些端点。以往做法常分两步:先用相邻定位点的平均速度判断车是否停下,再用停留时间判断这次停车算不算端点。
速度阈值在不同研究里被取成14、8、5或1公里/小时,多半来自经验。货车明明停着时,定位点仍会在真实位置附近乱跳,算出的漂移速度可以接近甚至超过慢速行驶。一条固定速度线很难把漂移点和真实行驶点分开。
时间阈值同样不统一。有的研究用3分钟或5分钟,对照信号灯周期和加油;也有研究用10、15或20分钟,因为重型货车装卸往往要几十分钟到数小时。拥堵造成的停留可以落到同一时段。只看停了多久,会把堵在路上记成到达,也会把一次较短的装卸漏掉。
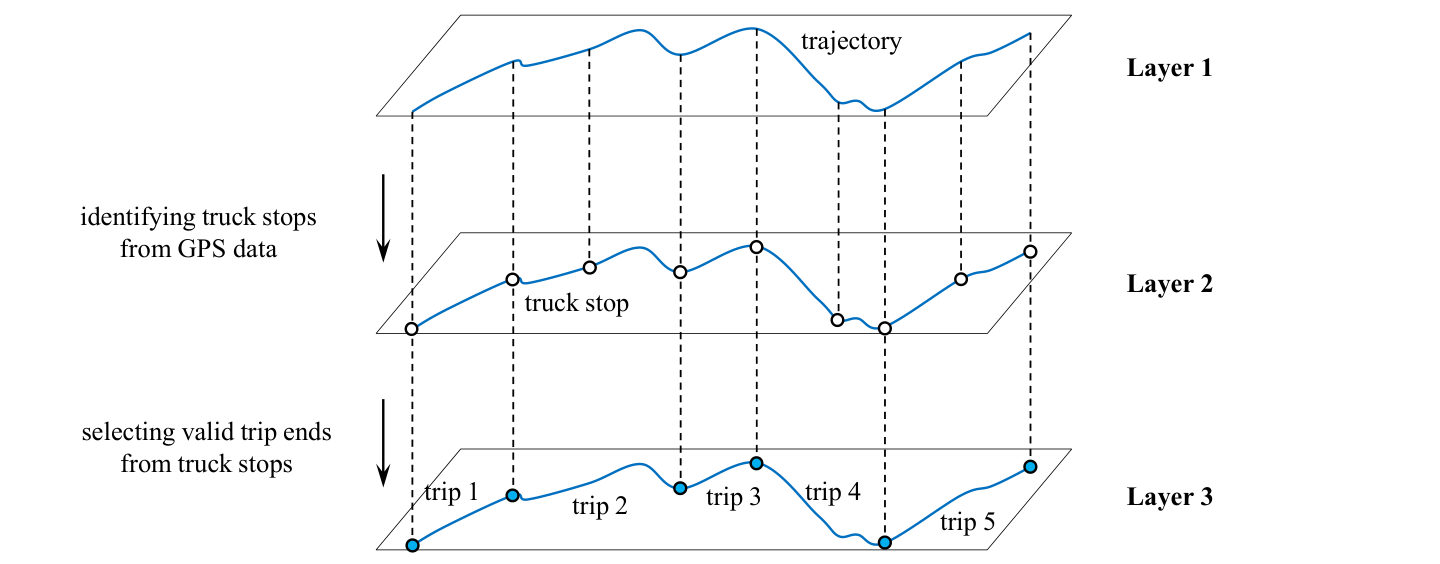
图 1|连续轨迹要经过哪两步,才变成多段行程?
无字母子图。Layer 1是预处理后的轨迹。Layer 2用空心点标出识别到的停车。Layer 3只保留被选中的端点,并用这些端点把轨迹切成trip 1至trip 5。虚线只表示三层之间的位置对应。来源:原论文 Fig. 1。
所以参数不能只报一个看起来合理的分钟数。本文先从方向和速度的异常波动里找出停车,再从停留时间分布的拐点出发,用货运兴趣点和道路数据筛选端点。
这一周的点,记的是车,不是货单
数据来自全国道路货运车辆公共监管与服务平台(National Road Freight Supervision and Service Platform,https://www.gghypt.net/)。按交通运输部规定,核定载质量超过12吨的重型货车自2014年7月起须安装定位设备。数据集大约260万辆,约占全国重型货车的41%;记录数多于200亿条。时间是2018年5月18日至24日这一周,采样间隔30秒。表1只给出一条轨迹的五行样例,不能当成样本量。
原始点先做三类清理。重复或缺失记录删去;国境以外的点删去;相邻点平均速度超过120公里/小时,或加速度超过5米/秒²,视为跳点并删除。清理和信号丢失还会留下很长的时间空洞。若从轨迹中抽出的一趟货运里,相邻两条记录相隔超过1小时,这一整趟被丢弃。后面的城际行程因此不是这一周全部重型货车活动,而是空洞没有超过1小时、并且端点被识别出来的那些行程。
分析单位逐层变化。最底层是30秒左右的定位点;停车是一段连续的非行驶点;端点是从停车中留下的起点或终点;城际行程是同一辆车前后两个端点落在不同地级行政区时的那一段。同一城市内的行程被丢掉。
速度为零,为什么仍会漏掉一次停车?
相邻点的速度写成 vᵢ₊₁ = dᵢ,ᵢ₊₁ / (tᵢ₊₁ − tᵢ)。d是两点地面距离,t是时间戳。速度恰好为零时,这两点称为停止点。速度大于零的点里,既有真的在开,也有车已经停下、定位却在跳的静止漂移点。
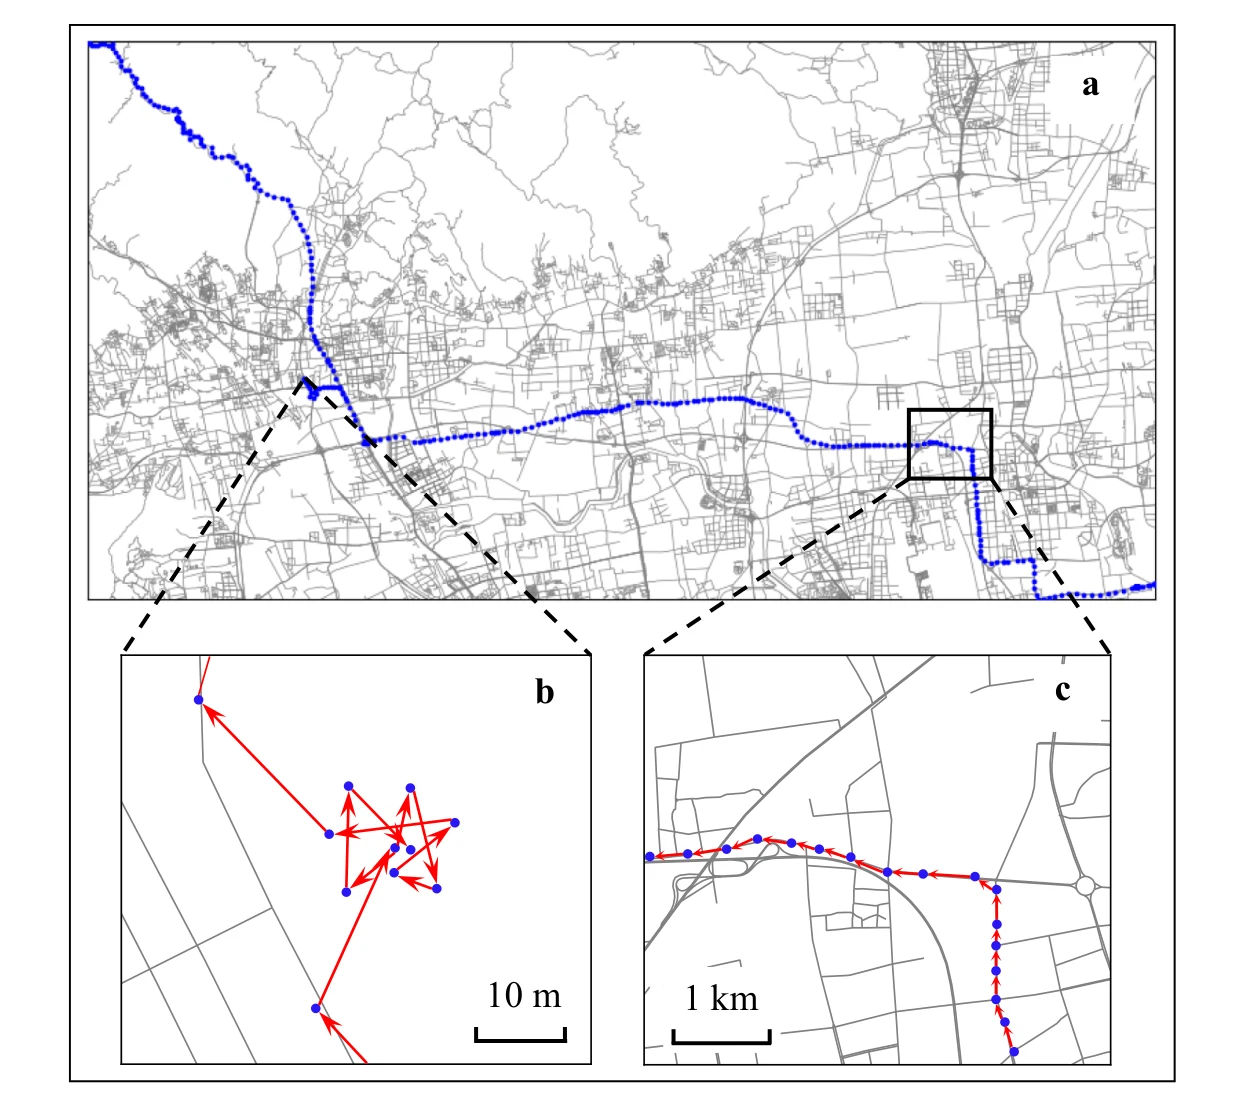
图 2|停下和行驶,在轨迹形状上差在哪里?
(a)一辆重型货车的一段轨迹,两个方框分别放大为下面两幅。(b)静止时定位点在约10米的尺度上折返、方向乱跳。(c)行驶时点沿道路前进,比例尺为1公里,方向变化平滑。这是一段例子,不是漂移距离的全国分布。来源:原论文 Fig. 2。
每辆车先被看成一条时空序列。方向变化 Δθᵢ 是从点 i−1 到 i、再从 i 到 i+1 的方向角之差。速度仍用上面的相邻点公式。零速点先从序列里拿掉,剩下的点组成一个轨迹单元。然后对方向变化序列和速度序列做增广迪基-富勒检验(Augmented Dickey–Fuller test,ADF)。两条序列的p值都大于0.05时,这个单元被判为非平稳,里面可能有静止漂移。
对这样的单元,再用三倍标准差规则找异常点:区间是均值加减3倍标准差,落在区间外的是异常点。若某点自己还在区间内,但它左右相邻点都是异常点,这一点也算进异常段。一个定位点只有同时处在方向变化和速度两条异常段里,才是静止漂移点。
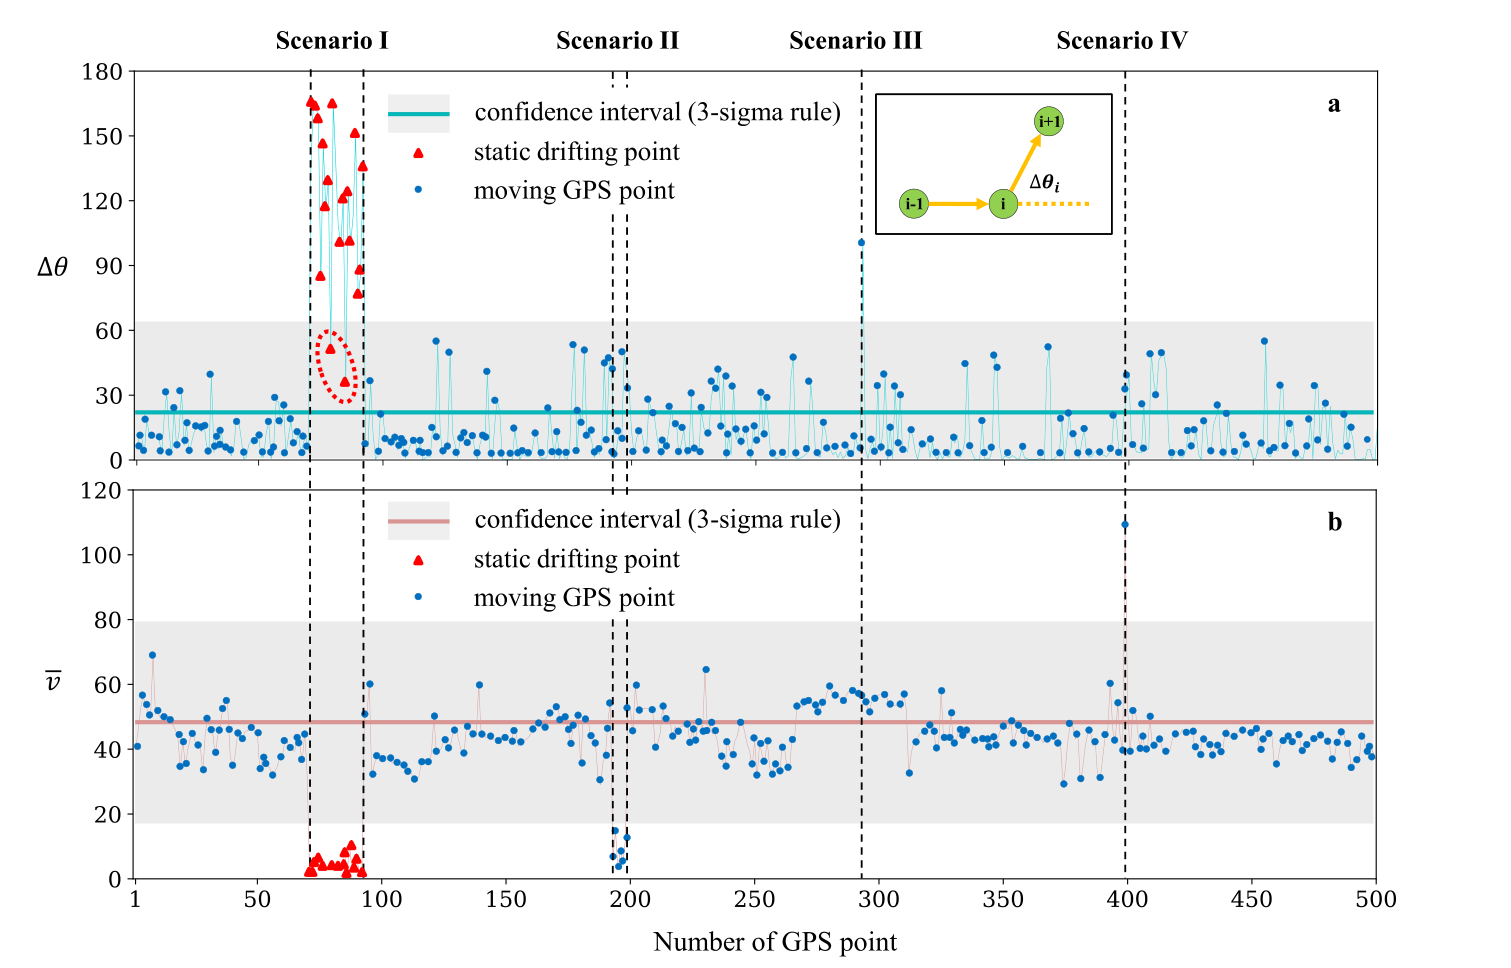
图 3|怎样避免把慢行、转弯和漂移当成同一种停车?
(a)纵轴是方向变化,灰带和实线是三倍标准差区间及其均值;右上角小图说明 Δθᵢ 怎么量。横轴是这一轨迹单元里的定位点序号,大约500个点,不是全国样本。(b)纵轴是相邻点平均速度,单位与图中刻度一致,灰带同样是三倍标准差区间。情景I在两条序列里都进入异常段,这些点标成静止漂移。情景II主要是速度异常而方向变化不构成异常段,论文解释为拥堵等造成的慢行。情景III只有方向突变,解释为匝道或环路。情景IV方向平滑、速度却异常偏大,仍视为行驶。四幅情景来自同一条示意轨迹,不能单独当成四种活动的出现频率。来源:原论文 Fig. 3。
停车区间由这段非行驶点的第一个和最后一个点定出。区间里若全是漂移点,停车位置取这些点经纬度的平均;只要其中有一个速度为零的停止点,位置就取这个停止点的坐标。
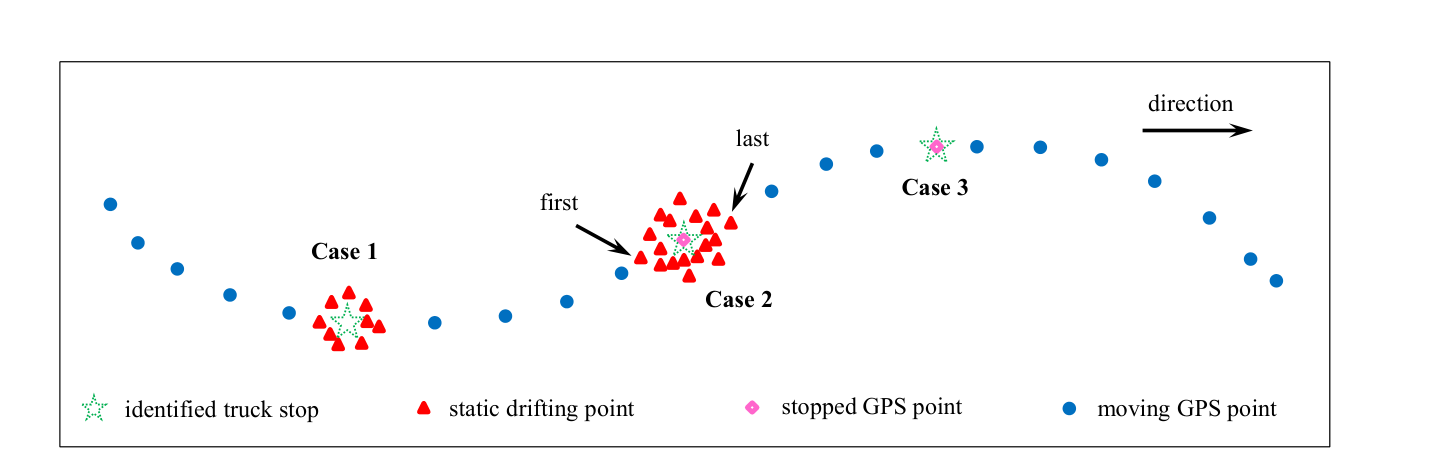
图 4|停车位置落在漂移点的平均坐标上,还是落在零速点上?
无字母子图,三个案例沿行驶方向排列。Case 1只有红色漂移点,绿色星标用它们的平均经纬度。Case 2和Case 3的区间里出现粉色零速点,星标放在零速点上。蓝色点是行驶点,不参与这次停车的位置。来源:原论文 Fig. 4。
26分钟和13小时,是分布弯折的位置
把识别出的停车都算一遍停留时间,分布呈断裂幂律:三段幂律在26分钟和13小时处断开。图例中的拟合优度是整段曲线的R²=0.8837,不是每一段各自的R²。
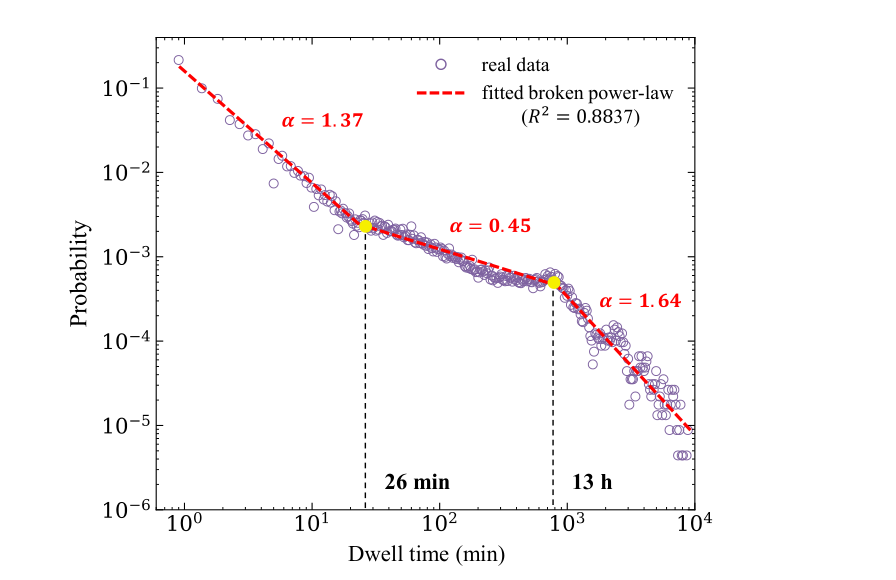
图 5|停留时间分布在哪里弯折?
无字母子图。横轴是停留分钟数,纵轴是概率,都用对数刻度。空心点是实际分布,红色虚线是三段拟合,指数 α 依次为1.37、0.45和1.64。两个黄点标在26分钟和13小时。图例写明整段R²=0.8837。拐点是分布形状,不是司机填写的活动标签。来源:原论文 Fig. 5。
作者把三段对应到三类活动:途中运输时的短暂停、端点上的装卸,以及行程结束后的长时间停车。据此规定:短于26分钟的是短时停车,不当成端点;长于26分钟且短于13小时的是中时停车,可能是装卸,也可能是较长的拥堵;长于13小时的是长时停车,直接当成端点。论文的说法是,临时停留几乎不可能超过13小时,司机更可能是收工后把车停在这里。
这个对应是解释。分布本身没有记录装卸、加油或收工。26分钟和13小时刚好落在断点上的停留,正文没有单独归类。
半小时到十三小时之间,还要看停在货场还是停在路上
中时停车继续用两类外部数据筛选。货运相关兴趣点来自高德地图 Amap(https://lbs.amap.com/api/),类别包括建筑公司、机械电子、化工冶金、商贸、物流仓储、矿业、工厂、农业基地、工业园区、居住区和建材市场。兴趣点只有坐标和语义,没有现成的货车作业范围。货车常常停在建筑物轮廓外面,所以作者没有直接用建筑外轮廓。
他们先对全国这些兴趣点做泰森多边形(Voronoi diagram)。每个格子里的停车,离本格兴趣点比离其他兴趣点更近。再在格子里用均值漂移找停车聚集区:以兴趣点为圆心,半径从零增大,取停车空间密度增量 ΔN/ΔS 最大的半径作为检测圆半径。圆内停车的经纬度平均成为新的圆心,圆跟着移动,直到圈进的停车不再增加。这些停车的最大凸包,就是检测到的兴趣点边界。
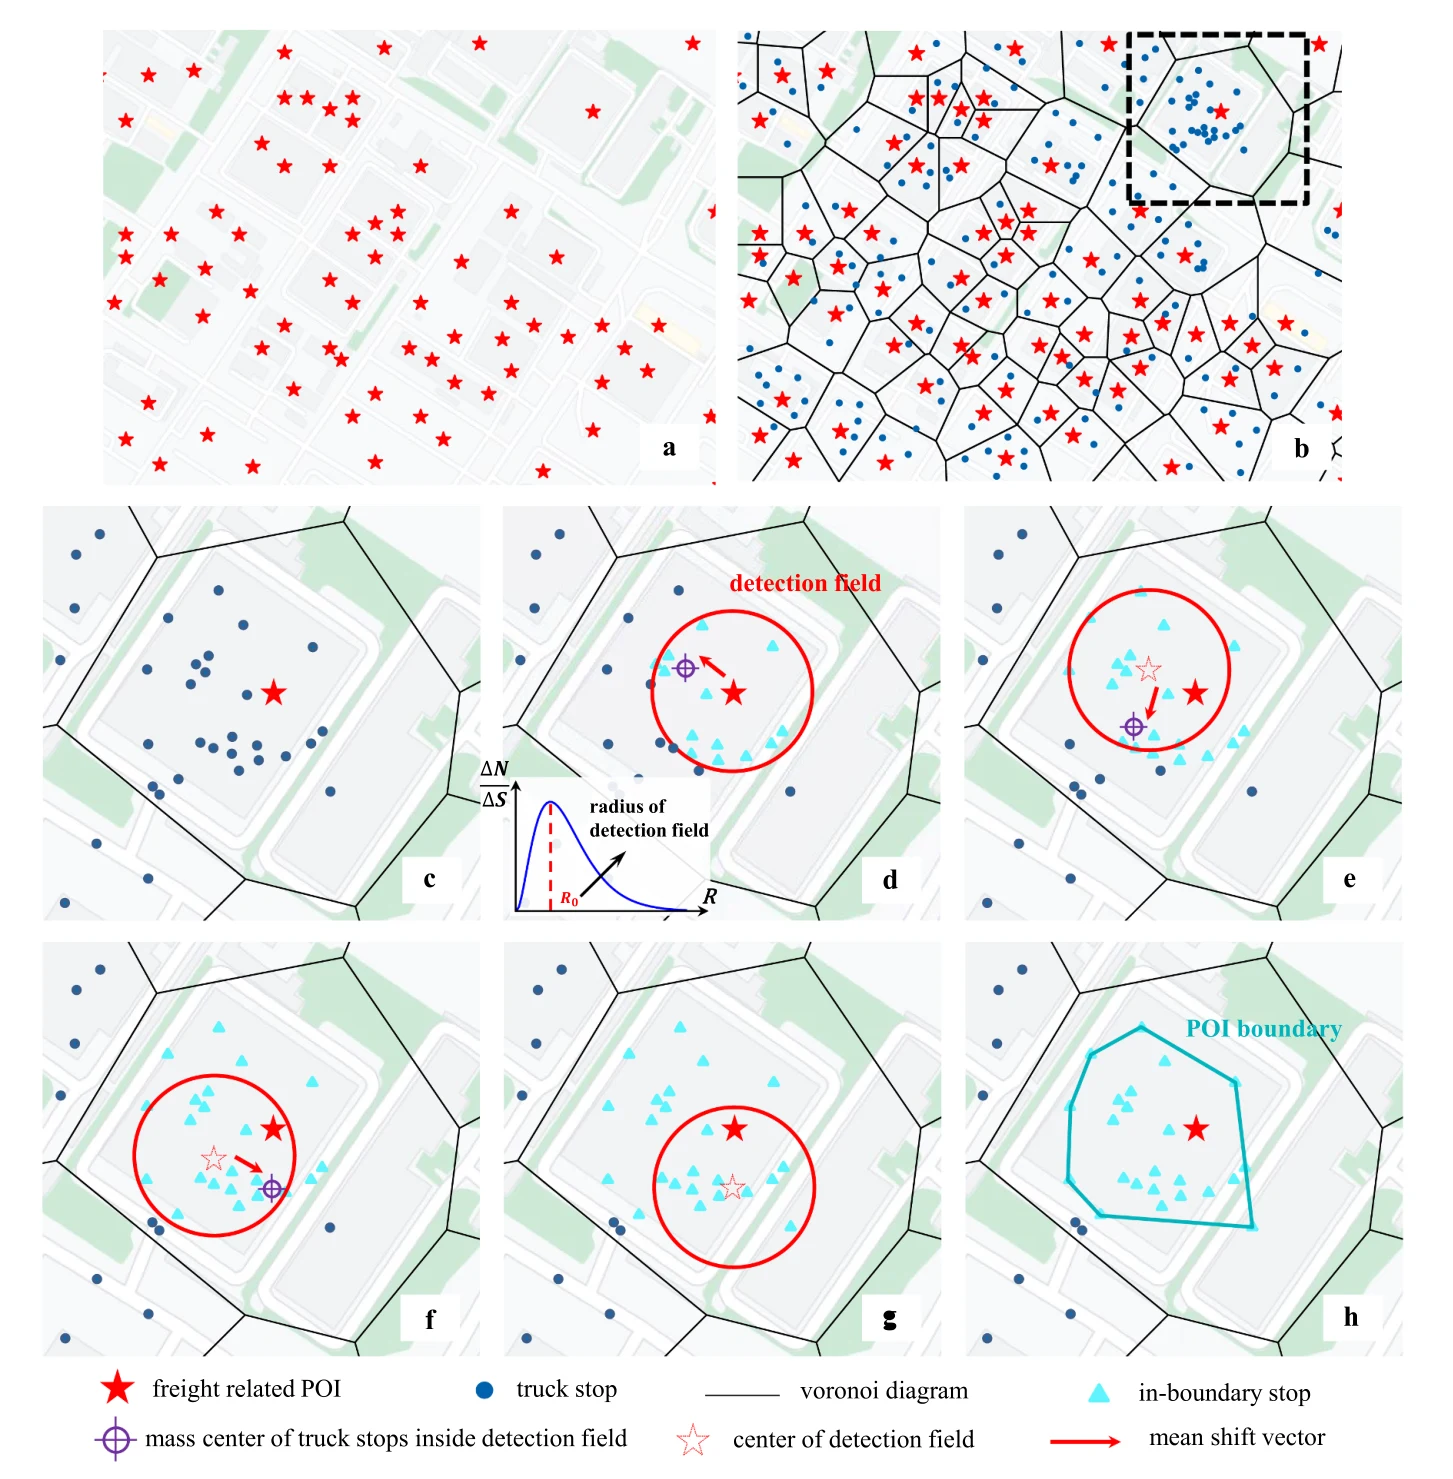
图 6|货运兴趣点的作业范围是怎样圈出来的?
(a)若干位置上的货运兴趣点。(b)泰森多边形;虚线框是后面各幅所用的那一格。(c)这一格里的兴趣点与停车。(d)检测圆半径取停车密度最高的位置,左下小图的横轴是半径,纵轴是密度,R₀ 是密度峰值。(e、f、g)圆心按均值漂移移向圆内停车的质心。(h)界内停车的最大凸包被当作兴趣点边界。这是算法示意图,凸包不是地块产权边界。来源:原论文 Fig. 6。
检测半径大多很短。全部货运相关兴趣点里,98.5%的检测半径小于200米;图7a的累积曲线在200米处标到0.985。全部识别出的停车里,只有26.8%落在这些边界内,73.2%在边界外。分母是停车,不是后面的城际行程。边界外的停车大多位于面积较大的泰森多边形。图7b横轴是按多边形面积从小到大排列的兴趣点序号,右端刻度约为1.4×10⁷;正文没有另给兴趣点总数。
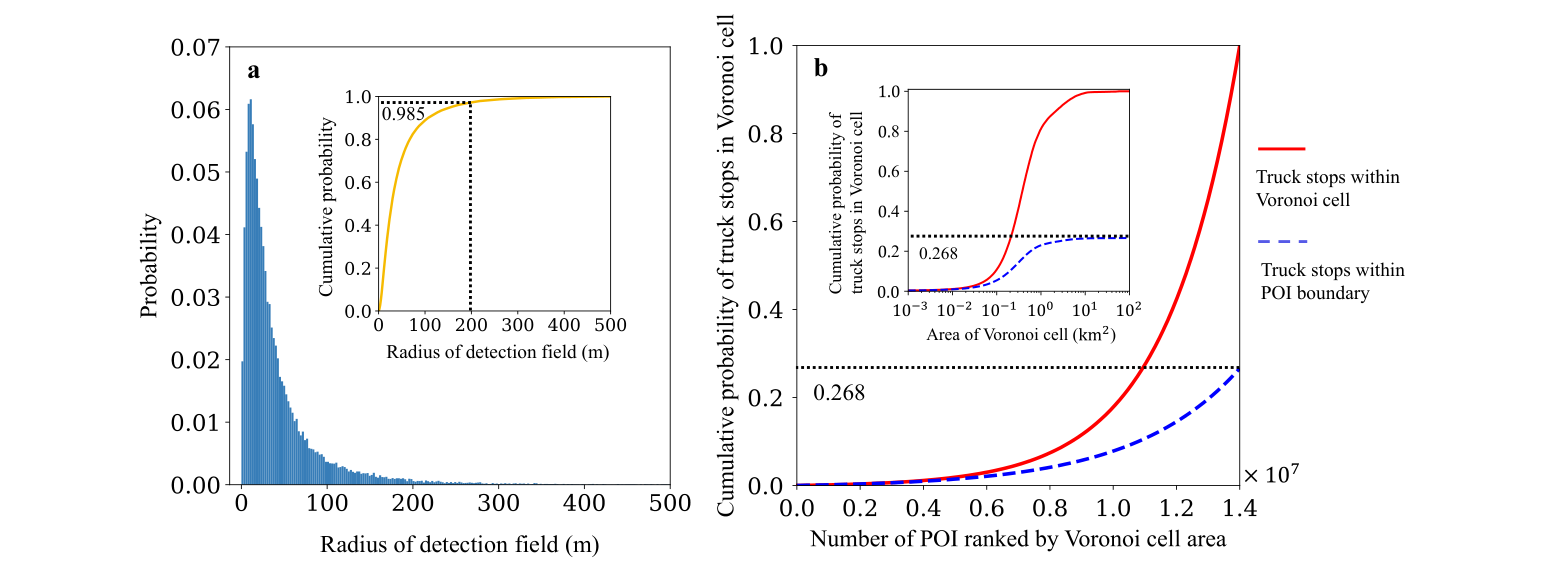
图 7|兴趣点边界盖住了多少停车?
(a)检测半径的分布,横轴到500米;插图是累积概率,200米处为0.985。(b)按泰森多边形面积升序排列后,停车数量的累积概率。红色实线是格内全部停车,蓝色虚线是边界内停车;水平虚线标在0.268。插图把横轴换成多边形面积,单位是平方公里。0.268的分母是被统计的停车,不是兴趣点个数。来源:原论文 Fig. 7。
落在边界内的中时停车,仍可能是城市道路上的拥堵。道路数据取自OpenStreetMap,保留高速公路、主干路、次干路和支路四类。正文依据城市道路工程设计规范写道:主干路和次干路单向至少四条车道,高速公路和支路至少两条,每条车道至少3.5米。实际计算时,主干路和次干路的平均宽度取五条车道共17.5米,高速公路和支路取三条车道共10.5米。这是统一采用的平均宽度,不是逐条道路实测。
作者再考虑10至20米量级的定位偏差,把两侧各20米、共40米加到平均宽度上。主干路和次干路的计算宽度成为57.5米,高速公路和支路成为50.5米。停车到道路中心线的距离小于该计算宽度的一半,就视为堵在路上,从中时端点里剔除。边界内、又不落在这条道路缓冲里的中时停车,才和超过13小时的长时停车一起,构成该方法的行程端点。
1000辆车的卫星核对,分母是端点不是车
最理想的核对材料是行车日志,论文写明多数情况下拿不到。这里随机抽取1000辆重型货车,用卫星影像和货运兴趣点目视判断:端点是否判对、是否把中途停车误判成端点、以及有效端点是否漏掉。准确率定义为
Macc = NA / (NA + NM + NU)。
NA是判对的端点数,NM是误判数,NU是漏判数。表2把漏判列名为NE,与公式里的NU是同一类计数。
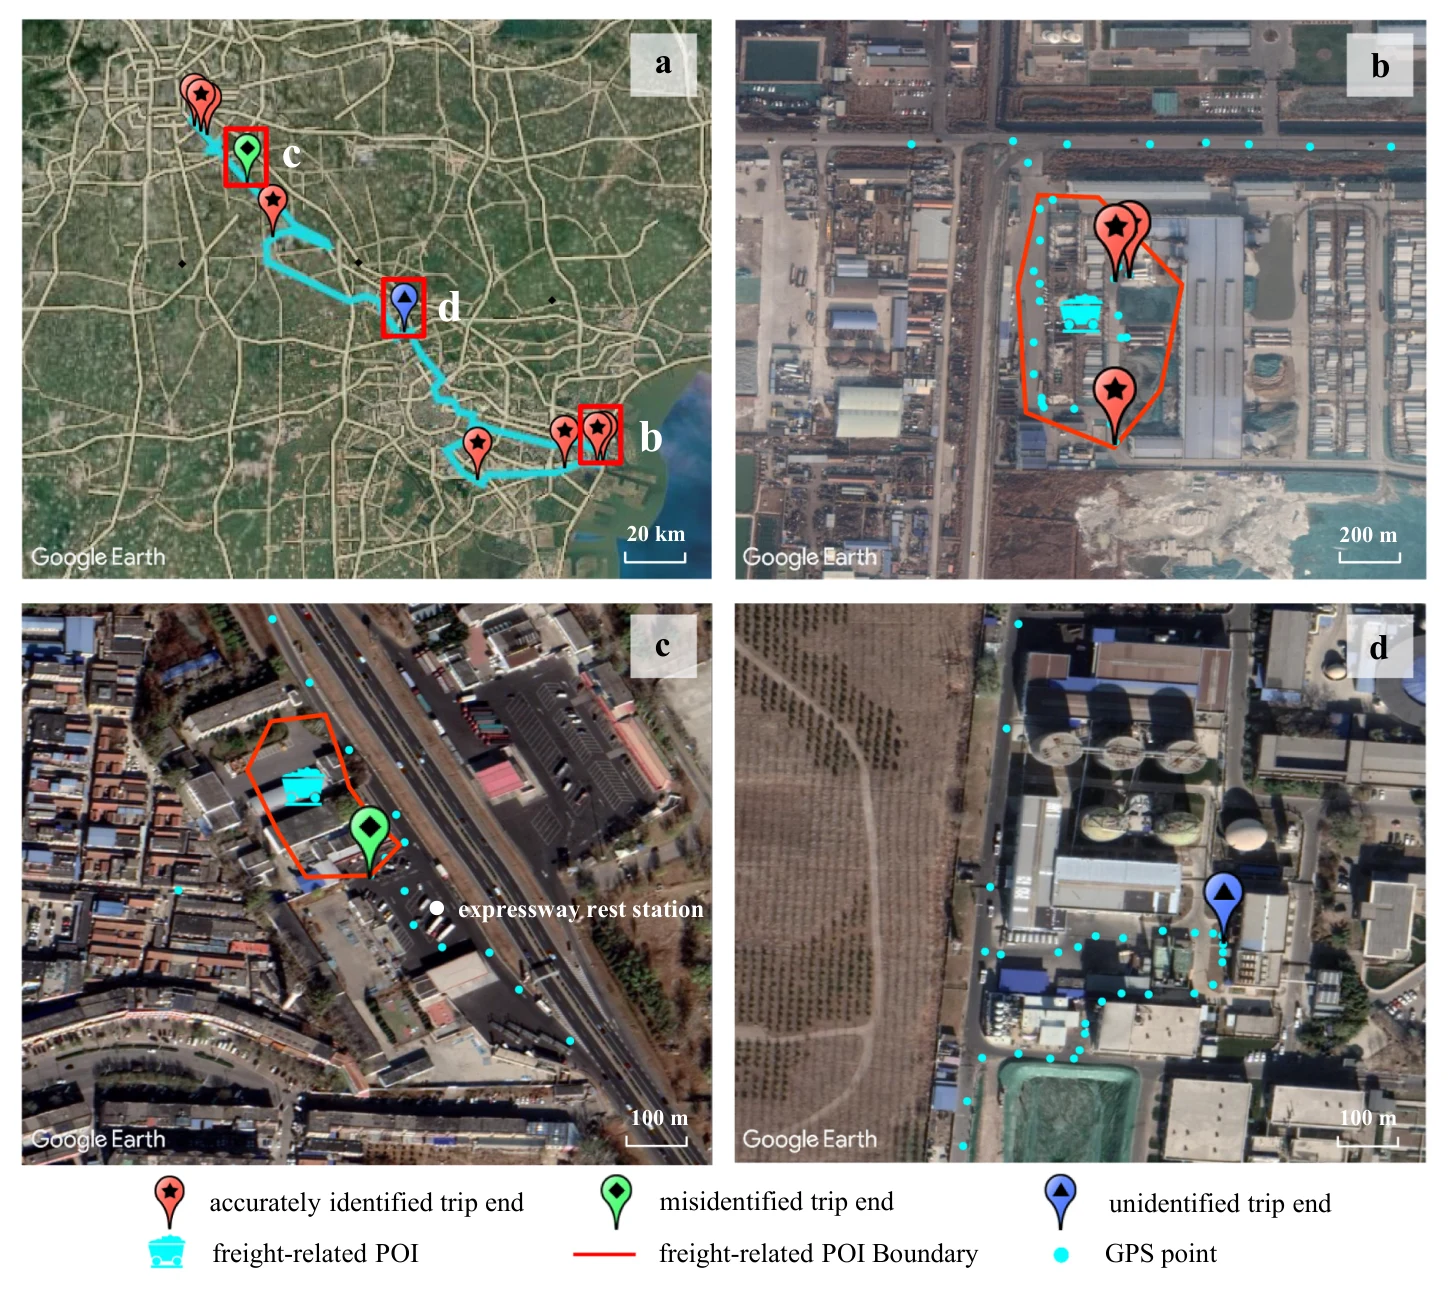
图 8|同一辆车的一周轨迹里,对、错、漏各长什么样?
(a)一辆车一周的轨迹,青色点为定位点,比例尺20公里;三个方框对应后面三幅,不是1000辆车的汇总。(b)端点落在建筑特征明显的货运场所,比例尺200米,判为正确。(c)兴趣点边界内的高速公路服务区被当成端点,比例尺100米,这是误判。(d)企业所在位置没有货运兴趣点,有效端点没有被识别,比例尺100米,这是漏判。这一辆车的例子不能代替表2的准确率。来源:原论文 Fig. 8。
本文方法在这1000辆车上得到NA=6850、NM=249、NE=170。分母是6850+249+170=7269个被核对的端点,不是1000辆车。6850/7269=94.24%;误判占249/7269=3.43%,漏判占170/7269=2.33%。平均每辆车进入这次核对的端点是7269/1000=7.269个。
对照有三类,而且各自的端点集合不同,所以分母不能共用。地理信息法把本文检测出的兴趣点边界当作区域:停车只要落在边界内就算端点,不用停留时间和道路缓冲。它的结果是6902/(6902+1304+118)=6902/8324=82.92%,误判更多。空间聚类使用DBSCAN-TE和支持向量机,准确识别5928个,误判973个,漏判1092个,5928/7993=74.16%。论文在核对中看到,它容易把拥堵停车聚成端点,也容易漏掉分布稀疏的单个端点。
旧的时间阈值法只保留停留超过预设分钟数的停车。5、15、20、45分钟四档的判对、误判、漏判和表中准确率如下。合计一列是前三个计数之和,用来看清分母。
| 方法 | 判对 NA | 误判 NM | 漏判 NE | 合计 | 表中准确率 |
|---|---|---|---|---|---|
| 地理信息法 | 6902 | 1304 | 118 | 8324 | 82.92% |
| 空间聚类 | 5928 | 973 | 1092 | 7993 | 74.16% |
| 时间阈值5分钟 | 6975 | 2820 | 45 | 9840 | 70.88% |
| 时间阈值15分钟 | 6891 | 1622 | 129 | 8642 | 79.74% |
| 时间阈值20分钟 | 6657 | 1129 | 363 | 8149 | 81.78% |
| 时间阈值45分钟 | 5708 | 457 | 1312 | 7477 | 76.34% |
| 本文时间阈值法 | 6850 | 249 | 170 | 7269 | 94.24% |
5分钟一档几乎很少漏判,45/9840=0.46%,但误判有2820/9840=28.66%。45分钟一档把误判降到457/7477=6.11%,漏判却升到1312/7477=17.55%。短阈值和长阈值是在两种错误之间换位置。20分钟这一行,表中准确率印为81.78%;按三个计数计算,6657/8149约为81.69%。其余各行的百分比与NA/(NA+NM+NE)四舍五入到两位小数后一致。论文没有给出这些准确率差异的置信区间或配对检验。
这套核对还有一个结构限制。兴趣点边界既用来决定中时停车算不算端点,又用来帮助目视判断对错。图8c和图8d说明卫星影像还能抓住服务区误判和缺失兴趣点造成的漏判,但判断者仍是作者,论文也在结尾写明这一过程耗时且必然带有主观性。它不是一份事先独立标注的行车日志。
端点连起来之后,城际货运呈现怎样的分布?
约260万辆车被识别出约2500万个端点。同一辆车一周内按时间排列的端点构成行程链。相邻端点若在同一城市行政区,记为市内行程;若在两个城市,记为城际行程。论文只保留约1800万次城际行程。1800万的分母是全部货车行程,正文没有给出全部行程的总数,因此不能把1800万除以2500万当成城际比例。端点个数和行程次数本来也不是同一个单位。
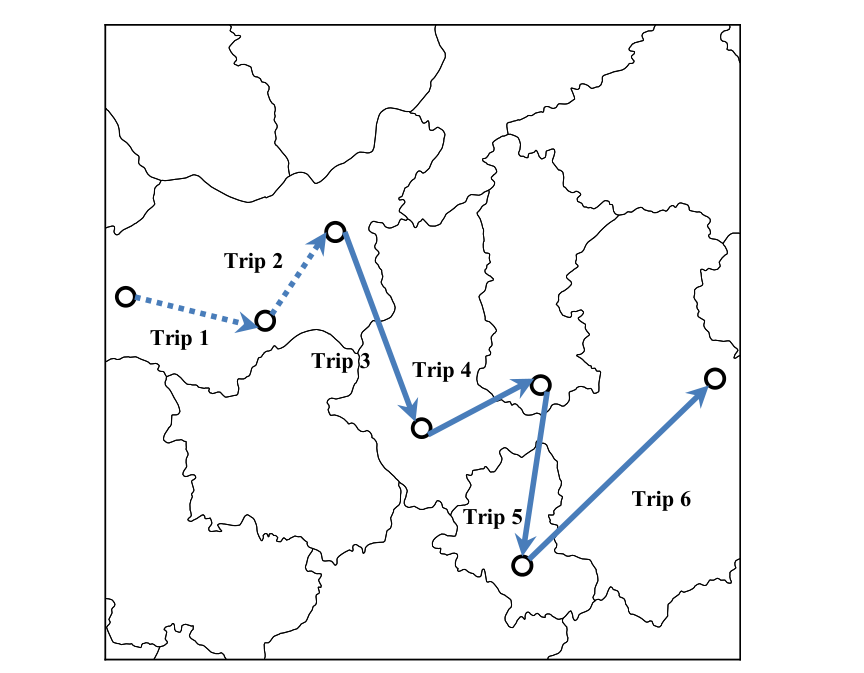
图 9|相邻端点怎样被分成市内和城际?
无字母子图,是行政区示意,不是实测流量。实线是城市边界。Trip 1和Trip 2两端都在同一城市内,用虚线箭头表示市内行程。Trip 3至Trip 6两端落在不同城市,用实线箭头表示城际行程。来源:原论文 Fig. 9。
能匹配到上述11类兴趣点的城际行程端点,类别比例如下。各类加总为100%,分母是已归入这些类别的端点。论文没有给出这个分母的绝对数量,也不能把百分比直接乘到2500万个端点上。
| 兴趣点类别 | 占已归类城际端点的比例 |
|---|---|
| 工厂 | 23.6% |
| 工业园区 | 19.22% |
| 建筑公司 | 13.98% |
| 机械电子 | 12.66% |
| 物流仓储 | 10.12% |
| 农业基地 | 7.12% |
| 矿业 | 5.25% |
| 商贸 | 3.15% |
| 化工冶金 | 2.31% |
| 居住区 | 1.48% |
| 建材市场 | 1.11% |
论文点名的四类较大需求是建筑公司、机械电子、工厂和工业园区。四类合计13.98+12.66+23.6+19.22=69.46个百分点,分母仍是上表的100%。这表示重型货车的城际端点在已归类记录里更多落在工业场所,不能直接读成这四类企业的产值或运量吨位。
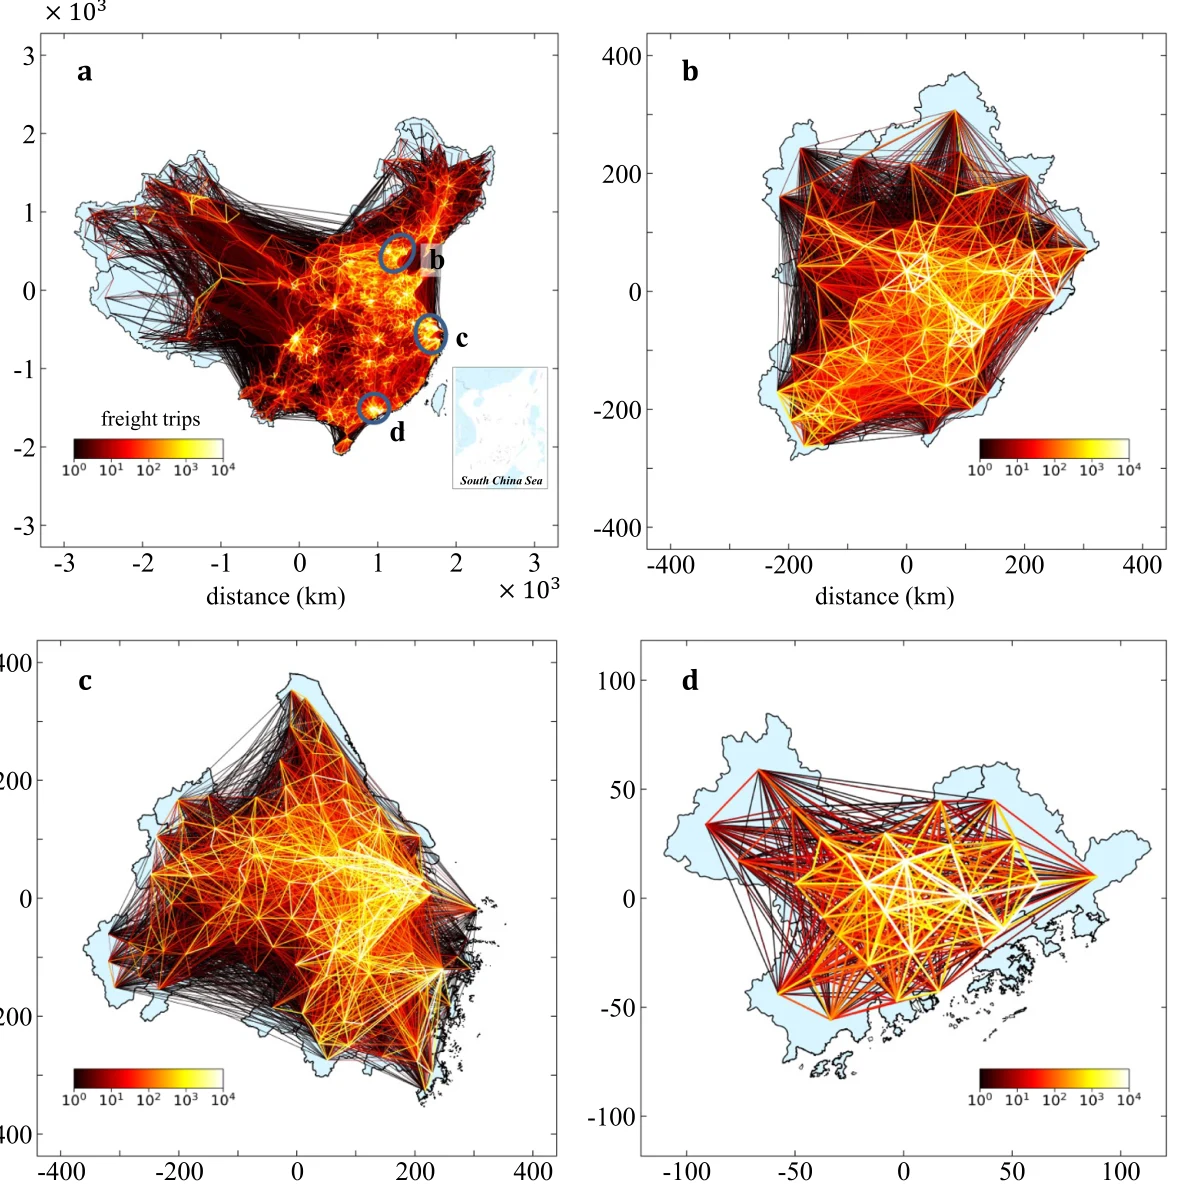
图 10|城际货运在全国和三个城市群里挤在哪里?
(a)中国大陆。每条线是一对城市之间的货运交互,颜色表示行程次数,色标从10⁰到10⁴;坐标是以公里计的平面距离,不是经纬度。三个蓝圈对应后面三个城市群,右下有南海诸岛附图。(b)京津冀。(c)长江三角洲。(d)珠江三角洲。三幅区域图的色标同样从10⁰到10⁴,坐标范围分别大约为正负400、400和100公里。中东部亮于西部,城市群里核心城市之间更亮。线的数量不是经济联系的因果度量,也没有在图中给出具体城市对的行程数。来源:原论文 Fig. 10。
距离和时长都呈对数正态。图注写出的密度是 1/(x σ √(2π)) 乘以 exp(−(ln x − μ)² / (2σ²))。图例把距离拟合标成 μ=97、σ=1.29,时长标成 μ=174、σ=1.34。97和公里、174和分钟处于同一量级。若把 μ 当成 ln x 的均值,距离中位数会是 e 的97次方,不可能对应大约100公里。图例里的 μ 因此不能按对数均值使用。论文没有报告按标准对数正态换算后的均值、中位数,也没有给出图11的拟合优度。
正文的读图结论是:多数重型货车的城际行程距离大约100公里,时长大约3小时。174分钟约合2.9小时,与大约3小时一致。出发时间呈双峰,论文写峰值大约在8时和14时;到达时间单峰,大约在12时。货运活动主要发生在白天,图中虚线标在6时和18时。
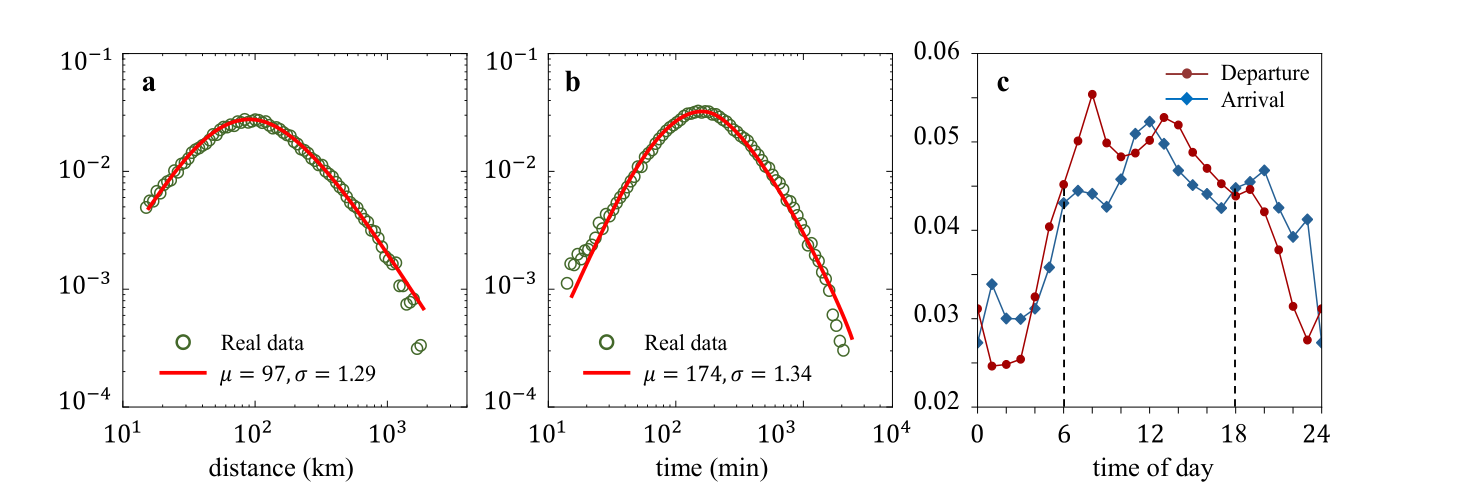
图 11|城际行程的距离、时长和出发到达时刻各是什么形状?
(a)行程距离,绿色空心点为实际值,红线标 μ=97、σ=1.29;横轴为公里,纵轴为概率,峰值大约落在100公里附近。(b)行程时长,红线标 μ=174、σ=1.34;横轴为分钟,主体大约在数小时。(c)出发为褐色圆点,到达为蓝色菱形;两条虚线在6时和18时。纵轴是概率,刻度从0.02到0.06。图中没有逐小时读数表,8时、14时和12时是正文对峰位的近似描述。来源:原论文 Fig. 11。
准确率高,还不等于已经看见装卸本身
94.24%比较的是目视判断下的端点位置,不是装卸、休息和送货标签。兴趣点参与了规则,也参与了核对。没有货运兴趣点的企业会系统性漏掉;兴趣点边界里的服务区会系统性混进来。道路缓冲用的是全国统一的57.5米和50.5米,宽收费站和窄山区公路不会得到同样合适的一半宽度。
260万辆约占全国重型货车的41%,时间只有2018年5月18日至24日。超过1小时的数据空洞会使整趟行程被丢弃。市内行程被主动删去。作者认为数据驱动的拐点比经验阈值更容易迁移到其他国家和轻型货车,但正文的准确率只来自这一平台、这一周、这1000辆重型货车。市内端点被明确留给后续研究。图10里的亮线是行程次数,不是运量、产值或政策效果。
一句话总结
重型货车GPS上的一次停车,要先躲过定位漂移,再通过26分钟和13小时两道时间弯折,并在中间档接受兴趣点与道路位置的筛选,才成为可以切开城际货运的端点;94.24%是1000辆车、7269个目视端点上的一致率,不是货单已经被逐票证实。
核心来源
- Transportation Research Part E正式论文,卷期为157(2022)102590。收稿日期2020年10月31日,修回2021年8月27日,接受2021年12月19日,2021年12月29日在线发表。
- 正文数据平台为 https://www.gghypt.net/ ,兴趣点来自高德,道路来自OpenStreetMap。16页正式刊没有补充附录,也没有数据与代码可用性说明。
- 同题预印本 arXiv:2106.11793 的摘要仍写由速度分布确定速度阈值。正式刊识别漂移点时使用的是方向变化、速度序列、ADF检验和三倍标准差规则。两套写法不能混成同一步。
作者介绍
- Yitao Yang:论文第一作者,署名北京交通大学综合交通大数据应用技术交通运输行业重点实验室与交通系统科学与工程研究院,邮箱 yitao-yang@bjtu.edu.cn。没有查到可核对的独立职称页。
- Bin Jia(贾斌):论文通讯作者,北京交通大学教授。学校教师页列出的研究方向包括复杂交通系统建模与调控,邮箱 bjia@bjtu.edu.cn 与论文一致。
- Xiao-Yong Yan(闫小勇):论文通讯作者,北京交通大学系统科学学院教授。教师页列出其主持的项目包括人类移动行为的统计特征、出行行为复杂性,邮箱 yanxy@bjtu.edu.cn,并收录本文。
- Jiangtao Li:署名北京交通大学交通系统科学与工程研究院,邮箱 17125670@bjtu.edu.cn。没有查到可核对的独立职务说明。
- Zhenzhen Yang:署名同一研究院,邮箱 zzyang@bjtu.edu.cn。没有查到可核对的独立职务说明。
- Ziyou Gao(高自友):北京交通大学教授,邮箱 zygao@bjtu.edu.cn。教师页列出的研究方向包括系统科学与交通运输规划管理;交通系统科学与工程研究院现任领导页列其为院长。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
26分钟和13小时来自2018年5月这一周的全国停留分布。若把这两个数直接写进另一年、另一座港口城市或一套新的驾驶时间规定,弯折位置可能移动。更稳妥的用法是保留“从停留分布找断点”这一步,让断点随当地、当季的数据重估,而不是把26和13当成货车装卸的物理常数。
另一处会改变排序的缺口是兴趣点覆盖。表3里工厂占23.6%、工业园区占19.22%,分母只包括已经归进11类兴趣点的城际端点。图8d那种没有货运兴趣点的企业,根本不会进入这张百分比。若用城际行程给工业货运需求排位,地图上缺失的厂区会被低估,排在前面的类别也可能只是兴趣点更完整的类别。
道路规则同样不该全国共用一个米数。主干路按57.5米、高速公路按50.5米判断“是否堵在路上”,来自车道数假设再加40米缓冲。大型收费广场可能比这个缓冲更宽,山区双车道可能更窄。1000辆车的总准确率没有按道路等级拆开,因此看不出误判主要发生在哪一类路上。把表2再分成高速公路、城市主干路和无兴趣点区域三行,比再把总准确率提高一个百分点更能说明方法用在哪里会失效。