新路把客流送进地铁之后,地面的延误涨速会被按住吗?
论文名片|Zhihan Fang、Guang Wang、Yu Yang、Fan Zhang、Yang Wang、Desheng Zhang,A long-term travel delay measurement study based on multi-modal human mobility data,Scientific Reports,2022,12:15988。2022年4月29日收稿,8月29日接收,9月26日在线发表。DOI:10.1038/s41598-022-19394-z。本文依据这一正式版解读。研究类型是一座城市、五种年份的多方式出行延误测量,名字叫 mRhythm。
2013年底,广深沿江高速把深圳机场、居住区和市中心商务区连在一起。开通前后各一个月,接上这条路的地面试验区,延误比从22%降到18%;同一窗口里的地铁试验区,延误比从18%升到24%。对照区的地铁只从20%升到21%,地面却从23%升到36%。一条新路没有让两套系统一起变快。
这项测量看的是2013年到2017年深圳的地铁、公交、出租车和约1万辆自愿接入的私家车。方向性的结果是:连续年份的起讫点平均延误在统计上逐年变高,但地面和地铁对人口、高峰和新设施的反应方向相反。新路相连的区域里,地面延误下降、地铁延误上升;新地铁沿线则是地铁延误下降,地面延误仍在涨,只是涨得比对照区慢。这些是按升级前特征配过对照区的观察比较。施工地点本身就不是随机选的,所以还不能把某一次开通说成唯一原因。
先说结论
- 把每一年所有起讫点的平均延误配成前后两年,Mann–Whitney U 检验在 p < 0.01 下都显著。效应量 A 是后一年更高的起讫点所占比例,相等记 0.5。地铁的 A 从 2013–2014 年的 0.71 升到 2016–2017 年的 0.79;地面前三段从 0.72 升到 0.78,最后一段降到 0.71。论文没有给出起讫点的个数,A 的分母因此只知道是这些配对,不知道是几百对还是几万对。
- 2011年到2016年的普查里,常住人口从1047万增到1191万,相对2011年增加13.8%;私家车从198万辆增到323万辆,相对2011年增加63.3%;地铁年客运量的端点写成4亿到12亿人次,论文另给的相对增幅是177.1%。用四舍五入后的端点相除会得到200%,和177.1%对不上,各年原始客运量没有列出。地铁运营里程从178.341公里增到285.528公里,人均供给曲线仍然向下。2014年到2016年,注册汽车相对2014年只再增加2.2%。
- 地面新路的全市比较用的是 A,不是延误比本身。地面试验区的 A 从升级前的 0.71 降到升级后的 0.33,对照区从 0.69 升到 0.78;地铁试验区从 0.61 升到 0.79,对照区从 0.65 升到 0.68。沿江高速那一个月的前后对照,用的才是延误比百分数,见开头的 22%→18% 和 18%→24%。
- 2016年开通的地铁7号线长30.1公里、27座车站,并与既有6条线换乘。开通前后各一个月,地铁试验区延误比从36%降到18%,对照区从19%升到20.6%。地面延误比的增加量,试验区是0.9%,对照区是3.2%。全市地铁升级的 A:地铁试验区从0.61降到0.28,地面试验区从0.68降到0.53,两侧对照区仍升到0.63和0.71。
- 人口和高峰上,两个系统方向相反。地铁延误比在1万–2万人口的车站服务区是15.5%,在5万–6万人口的服务区是10.4%;地面在同样两档人口上从8%升到28%。这两档的分母分别是车站步行区和1.37平方公里网格,不能看成同一批地块。高峰(7–9时和16–20时)地铁延误比约13%,非高峰是18%;地面高峰约50%,非高峰是35%。
四套记录覆盖的不是同一群人
深圳在方法部分被写成792平方英里、约1200万人口的东南沿海城市。792平方英里约合2050平方公里。普查序列里的2016年常住人口是1191万,和方法部分的约1200万是两个口径。出行数据是2013年到2017年,作者概括为800万居民、四种机动方式。800万怎样去重,正文没有拆开。
地铁刷卡覆盖使用交通卡的公交和地铁乘客,出租车覆盖乘出租车的乘客,私家车是约1万名驾驶员自愿用车载诊断和手机上报,用来换保险优惠。自愿样本不是全市300多万辆注册汽车的随机抽样本。地面延误若主要由私家车贡献,这个1万辆的选择性就会进到结论里。
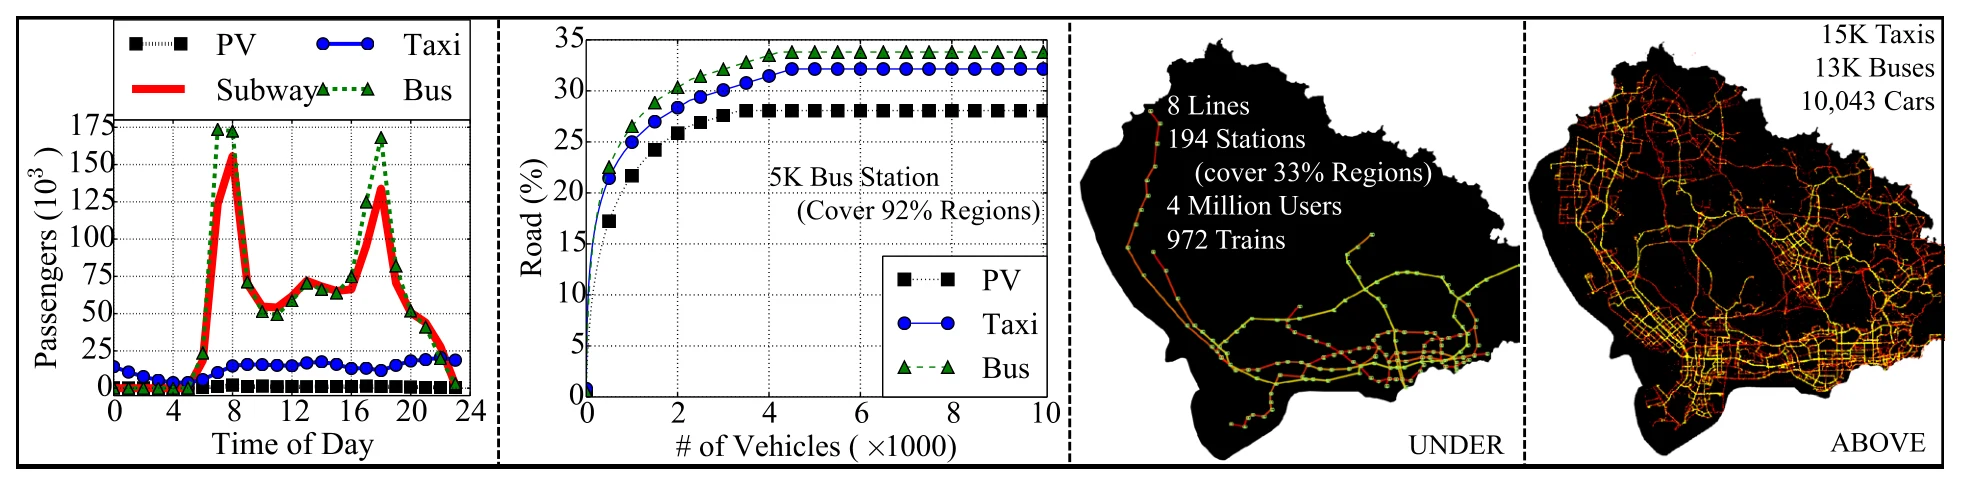
图 12|这四套数据在一天之内、在路网上和在地图上各覆盖到哪里?
图中四块没有子图字母,从左到右看。左一是一天中的乘客数,纵轴单位是10的4次方;私家车按每车1名乘客计入。地铁和公交有早晚尖峰,出租车全天较平,私家车曲线贴在底部。左二是车辆数增加时覆盖的道路比例,横轴单位是千辆;公交曲线在5千辆附近标注覆盖92%的区域。右一是地下系统,标注为8条线、194座车站并覆盖33%的区域、400万用户、972列车,亮色表示需求更高,覆盖偏中心。右二是地面系统,标注1.5万辆出租车、1.3万辆公交、10043辆私家车,路网铺得更满。来源:原论文 Fig. 12。
地图上的400万用户,和正文里的日均300万地铁乘客、图13里的每日400万条刷卡记录,是三个不同的数。日客运量、刷卡条数和用户数不能互相代替。
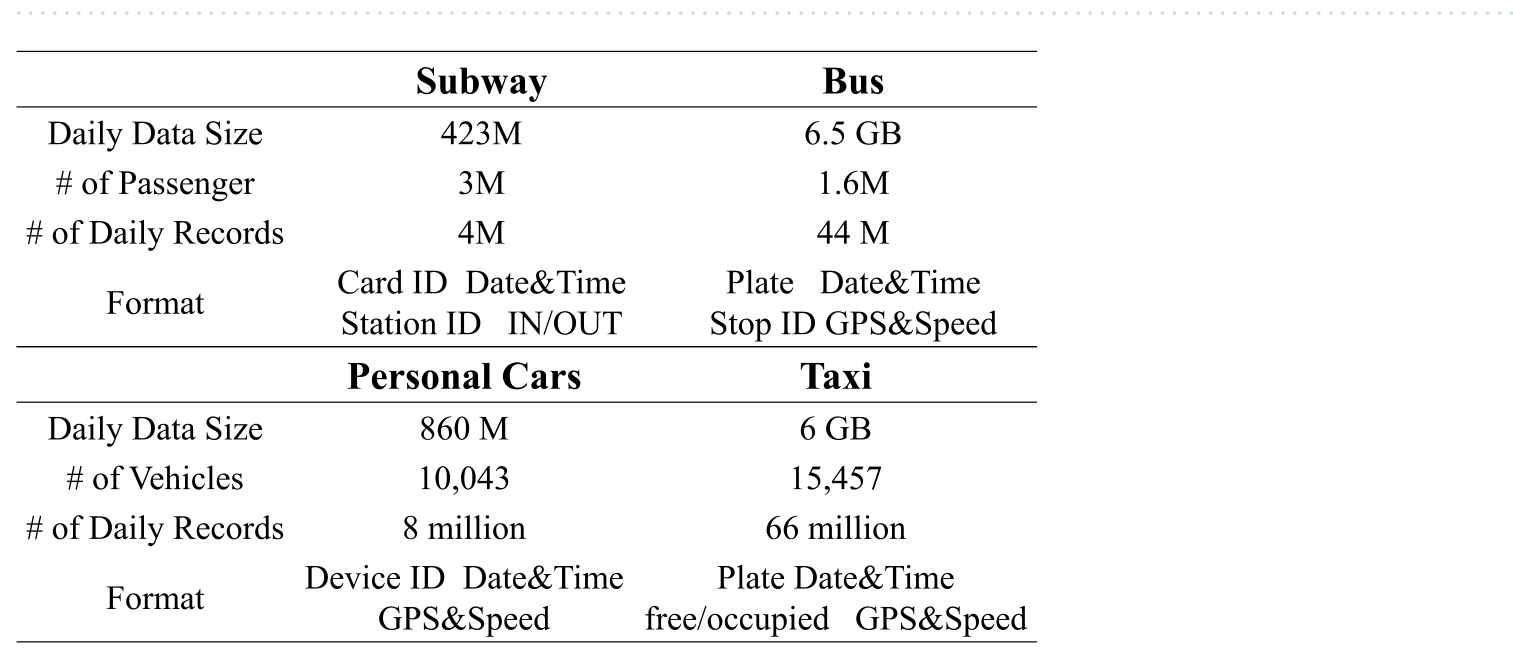
图 13|每一天实际进来多少记录,字段是什么?
这张图是一张表,没有子图字母。地铁每日数据量423 MB,乘客300万,记录400万条,字段是卡号、日期时间、车站和进出站。公交每日6.5 GB,乘客160万,记录4400万条,字段是车牌、日期时间、站点、GPS和速度。私家车每日860 MB,车辆10043辆,记录800万条,字段是设备号、日期时间、GPS和速度。出租车每日6 GB,车辆15457辆,记录6600万条,并多一个空驶或载客标志。公交和出租车约每30秒一条,私家车约每10秒一条。来源:原论文 Fig. 13。
正文还给出系统规模:地铁8条线、194站、972列车;公交1115条线、10106个站点、约1.3万辆车;出租车约1.5万辆。图13把车辆数写到了10043和15457。站点总数10106,和图12里“5千辆公交覆盖92%区域”不是同一个数,后者是覆盖曲线上的一个点。
延误比的分母,是去掉过短行程之后的最短时间
地铁行程的起终点是车站,延误多来自站内等待。地面行程的起终点是 GPS 停留点,延误多来自道路拥堵。所以两套空间单元从一开始就不同。跨方式比较时,作者再把两边都叠到政府部门发布的497个行政区上,按重叠面积对齐。
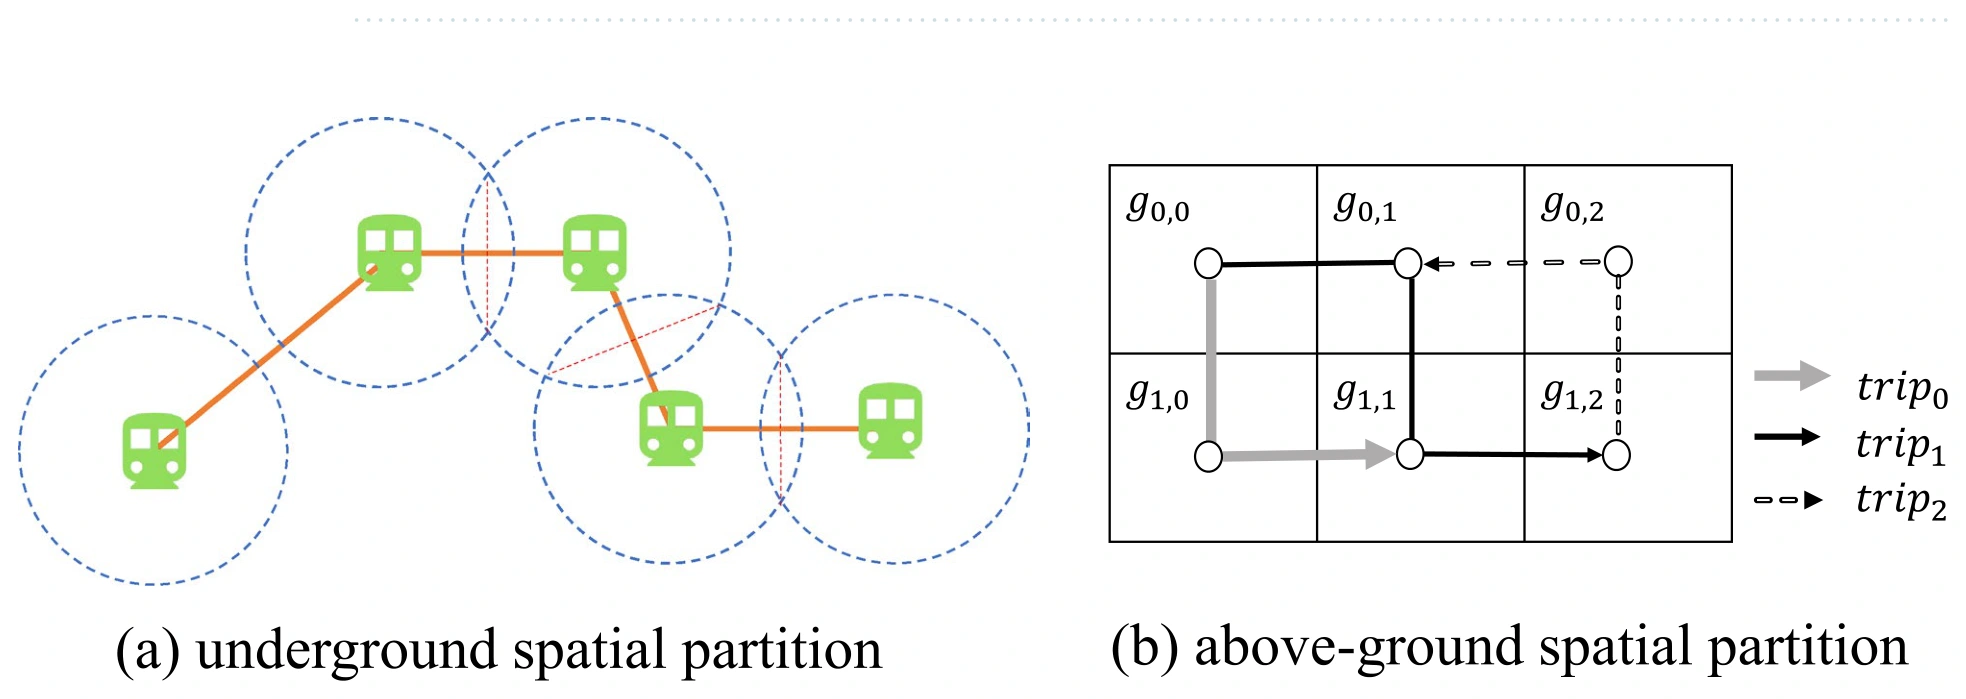
图 14|同一次比较里,人和行程被放进哪种空间单元?
(a)地铁用互不重叠的步行圈和中垂线,把人分到步行距离内最近的车站。相邻车站平均相距1.16公里,步行半径取一半,即0.58公里;作者据此写出1.05平方公里的步行面积,这是半径对应的圆面积。(b)地面示例是100米乘100米的网格,三条行程穿过不同格子。人口与地面延误的相关分析后来又改用1.37平方公里的网格,和这里的100米网格不是同一层。来源:原论文 Fig. 14。
一次地面行程先靠停留点切开,记成起点、终点、出发时刻、到达时刻和乘客或车辆编号。行程时间就是到达减去出发。地铁行程直接来自进出站记录,用同一套公式。
顺畅行程时间是同一起讫点上、当作没有拥堵时的参照。直接取最小值会被定位错误或异常快的行程拉低,所以先做清洗,再用 z 分数过滤。z 等于这条行程时间与该起讫点平均时间之差的绝对值,除以标准差。阈值 θ 取 1.96,作者把它对应到大约95%的区间,再在留下的行程里取最短时间作为顺畅时间。排版后的概率式不完整,操作口径以这段文字为准。
延误比等于(这条行程的时间 − 顺畅时间)÷ 顺畅时间,再乘 100%。分母是该起讫点过滤后的最短时间。一条延误比 24% 的地铁行程,就是比这条起讫点上那些够快的行程多花了24%的时间。它不是时刻表晚点,也不是按限速算出来的自由流时间。
两年之间谁更高,用 Mann–Whitney U 检验,显著性阈值是 p < 0.01。差多少用 Vargha–Delaney 的 A。把同一批起讫点前后两期的平均延误配对:后一期更高记 1,相等记 0.5,更低记 0,再求平均。按公式,A 大于 0.5 表示后一期在更多起讫点上更高;A 小于 0.5 表示后一期更低。方法段有一句把“第一组更高”说反了,下文以公式和逐年结果的用法为准。
逐年变慢能从 A 值里看见,图1却没有把两个系统分开
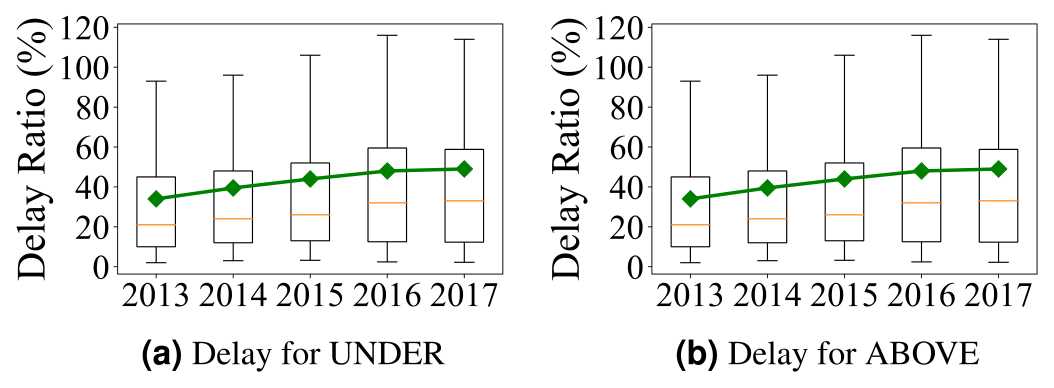
图 1|五年里,全部行程的延误比分布有没有整体上移?
(a)地下系统,也就是地铁。(b)地面系统,出租车、公交和私家车合在一起。纵轴都是延误比百分数。箱体是第25到第75百分位,橙色短线是中位数,须线是最大和最小。绿色菱形折线在正文里没有定义,这里不把它读成均值。两块面板的箱体高度和中位线位置逐年相同,只是左右平移。因此图1本身看不出地面分布高于地铁,也看不出谁的增幅更大。能确定的是:这一组被画了两次的箱线,中位数和箱体逐年上移,箱体变高,上须线在后几年接近120%。来源:原论文 Fig. 1。
作者仍根据这张图写出三条观察:两个系统的延误和离散程度都逐年增加;地面延误的增速慢于地铁;地铁的总体增幅小于地面。后两条无法由这两块重合的箱线互相核对。能把两个系统分开的定量结果在表1。
| 比较的年份 | 2013–2014 | 2014–2015 | 2015–2016 | 2016–2017 |
|---|---|---|---|---|
| 地铁 A | 0.71 | 0.74 | 0.76 | 0.79 |
| 地面 A | 0.72 | 0.75 | 0.78 | 0.71 |
四个年份台阶上,两个系统的差异都通过了 U 检验,A 都大于 0.5,所以后一年更高。地面在2016–2017年的 A 降到0.71,低于地铁的0.79。作者给出的原因包括地铁需求继续上升、小汽车指标政策、2016年地面延误的基数已经较高,以及地面路网有升级。这里的 A 仍是起讫点配对后的比例,不是延误比百分数。
人、车和地铁客运都在涨,人均的路和轨在降
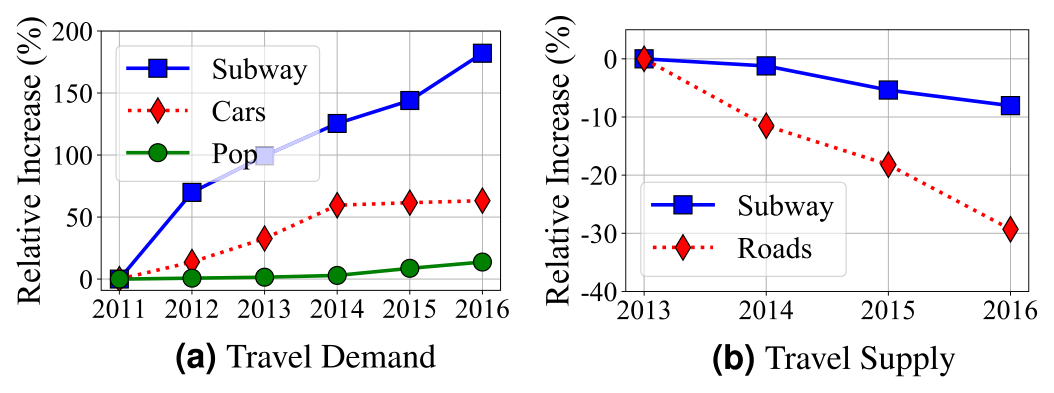
图 2|延误逐年变高时,需求和人均供给各自由哪一年开始转慢?
(a)相对2011年的需求增幅。地铁客运升得最陡,私家车在2015年后趋平,常住人口缓升。正文给出的端点是人口1047万到1191万(+13.8%)、私家车198万到323万辆(+63.3%)、地铁年客运4亿到12亿人次,并另写177.1%的相对增幅。(b)人均供给的相对变化,地铁里程和道路长度都向下,道路降得更陡。绝对里程仍在增加,人均下降是因为人和出行增加得更快。地铁绝对长度从178.341公里增到285.528公里。来源:原论文 Fig. 2。
2015年起深圳对私家车实行牌照摇号,依据是作者引用的既有政策研究,不是这篇论文自己做的问卷。作者把地面延误增速放缓,归到私家车增量变慢,并认为私家车是地面延误的主要部分。2014年到2016年注册汽车只再增加2.2%,分母是2014年的注册量。这个时间和图2里私家车曲线在2015年后走平是对得上的。它仍是时间上的同期解释:摇号、汽车增量和延误增速放在同一段年份里,没有单独的对照城市。
作者由此写下一句判断:增加供给可能好过控制需求。支撑这句话的对比是,地铁需求增幅很大、人均供给降得较慢,总体延误增幅仍小于地面;地面在摇号之后需求几乎停增,总体延误增幅却更高。图1又无法单独展示这个总体增幅差,所以这句话的力度取决于表1和后文案例,而不是取决于两块重合的箱线。
新路的全市曲线和一个月案例,答案并不一样
2013年初道路总长6015公里,2017年末6668公里,其间投入使用653公里。6015加653等于6668。开通时间来自 OpenStreetMap 和社会媒体,这条路网长度和普查里的人均道路不是同一套统计。作者写道,新路多在郊区,因为中心区已经没有空间。对照区按升级前的人口分布、延误比和延误比增速挑选,不是随机划出的地块。
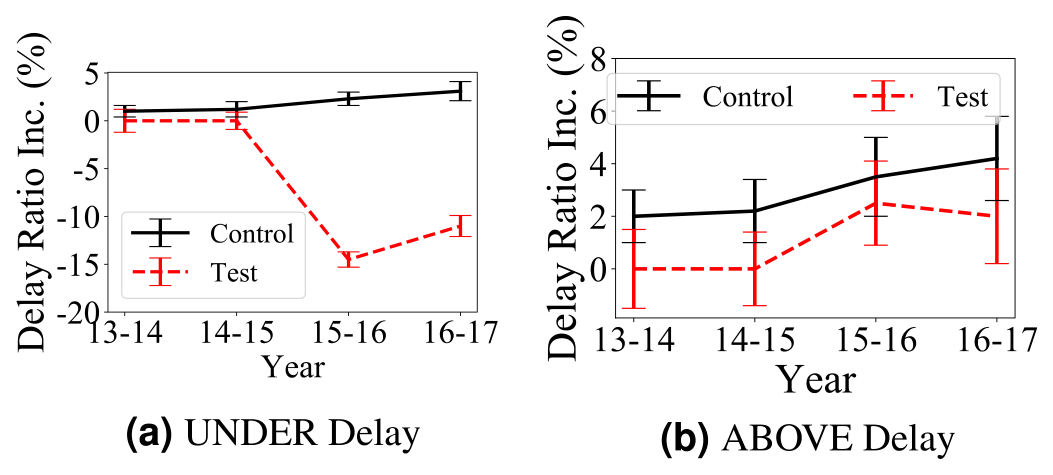
图 3|新路覆盖的区域,延误比的年度变化比相似区域更高还是更低?
纵轴是延误比的绝对变化,单位是百分点,误差线是标准差。黑线是对照区,红线是试验区。(a)地铁。试验区在13–14和14–15年接近0,15–16年落到−15刻度附近,16–17年仍在−10以下;对照区从0附近缓升到大约3。(b)地面。试验区前两年接近0,后两年大约在2上下;对照区从大约2升到大约4,试验区的增幅低于对照区。来源:原论文 Fig. 3。
结果部分有一句把图3a说成地面延误上升。面板标题写的是地下系统,后文又说新路让郊区居民接驳地铁、从而推高试验区的地铁延误,并说图3b显示地面延误下降。图上的地铁试验区曲线是大幅落到零以下,也就是年度延误比在下降,并不是上升。
表2把同一问题换成升级前与升级后的 A:
| 系统 | 试验区升级前 | 试验区升级后 | 对照区升级前 | 对照区升级后 |
|---|---|---|---|---|
| 地铁 | 0.61 | 0.79 | 0.65 | 0.68 |
| 地面 | 0.71 | 0.33 | 0.69 | 0.78 |
A 从0.71降到0.33,表示地面试验区里后一期更高的起讫点变少,作者称为地面延误下降。地铁试验区从0.61升到0.79,作者称为地铁延误上升。这和开头摘要一致,也和沿江高速的一个月案例一致,但和图3a里试验区落到零以下的年度变化方向相反。论文没有解释年度平均变化为负时,为什么升级前后的 A 会上升。图3因此不能和图上的文字互相核对成同一个数。
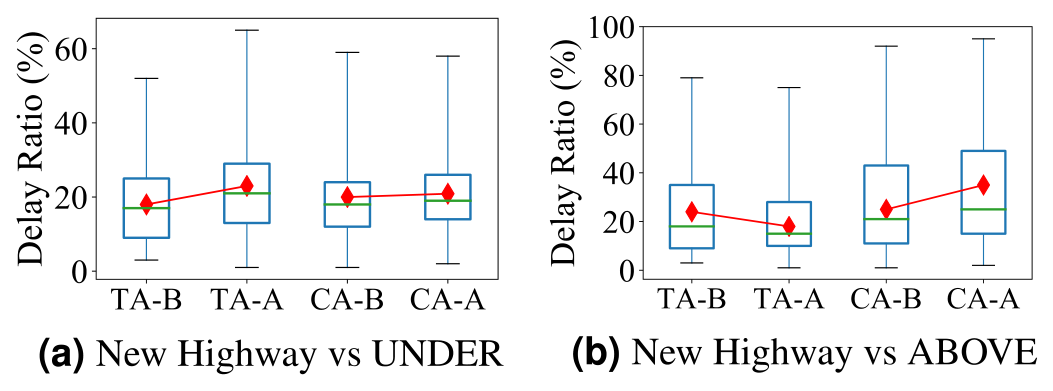
图 4|一条通向机场和市中心的新高速,开通前后一个月各自改变了谁?
横轴 TA 是受这条路影响的试验区,CA 是对照区,B 是开通前,A 是开通后。红点是作者用来概括前后变化的位置,绿线在箱内。(a)地铁试验区从18%到24%,对照区从20%到21%。(b)地面试验区从22%到18%,对照区从23%到36%。来源:原论文 Fig. 4。
作者的解释是:这条路伸到更远的地区,把客流送到一端的两座主要地铁站,站内延误上升;对地面,它缩短相连区域的行程并改善路况。对照区地面从23%跳到36%,一个月窗口里还有季节和其他工程。这个案例支持的是“试验区相对对照区”的差别,不是全市每一条新路都会造成同样的6个百分点和4个百分点。讨论里另写新高速使相连区域地面延误降低12.2%、相连地铁站延误升高16.7%,没有给出由18、24、22、18算出这两个百分数的步骤。相对开通前,24相对18是增加三分之一,18相对22是下降约18%。讨论中的12.2%和16.7%与这四个数对不上,下文以图4正文里的前后值为准。
新地铁的全市图,和前一张新路图是同一组折线
2016年和2017年,深圳增加3条地铁线和68座车站。7号线是其中一条。作者写大多数地铁升级发生在需求高的中心区,从而减少既有地面系统上的需求增长。对照区仍然是人口、地理和升级前延误特征相似、但不受这些新站影响的区域。由于升级集中在2016和2017年,试验区在2014和2015年的延误增量被写成0。原文这一句误写成地面升级只发生在这两年,按本节标题,指的是地铁升级。
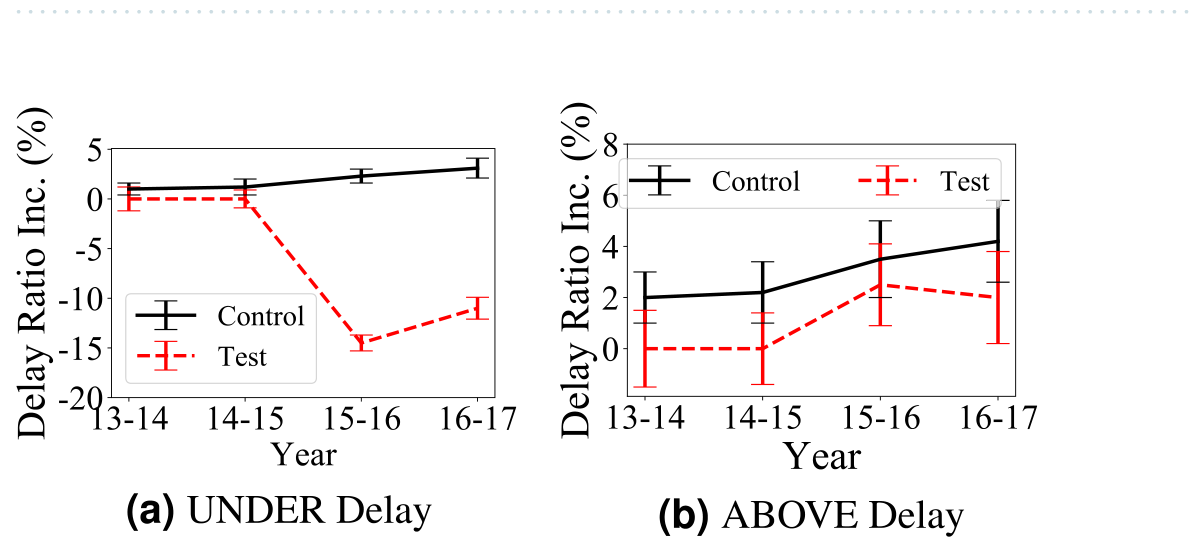
图 5|新车站覆盖的区域,延误比的年度变化是否低于相似区域?
(a)地铁,黑线对照、红线试验。(b)地面,图例相同。曲线、误差线和刻度与图3一致,只是标题从地面设施升级换成了地下设施升级。图注还有一处把对照区写成没有地面升级,正文则定义为不受地下升级影响。来源:原论文 Fig. 5。
在这组与图3相同的曲线上,作者另给了两个读数:地下升级使地铁延误绝对下降14个百分点;地面延误比的增加从3.5%降到2%,试验区的延误本身仍在增加。14个百分点接近图上15–16年落到−15刻度附近的那一步。3.5没有标在图上。因为图5没有提供第二套独立曲线,这两个数不能当成另一次全市测量的交叉验证。
表3是升级前后的 A,和表2的口径相同:
| 系统 | 试验区升级前 | 试验区升级后 | 对照区升级前 | 对照区升级后 |
|---|---|---|---|---|
| 地铁 | 0.61 | 0.28 | 0.61 | 0.63 |
| 地面 | 0.68 | 0.53 | 0.66 | 0.71 |
地铁试验区 A 降到0.28,表示升级后更高的起讫点成为少数,作者称为地铁延误下降。地面试验区从0.68降到0.53,仍略高于0.5,作者称为涨速放缓而不是转为下降。对照区两边都在上升。U 检验的显著格子用底色标出;作者讨论了全部四组变化。
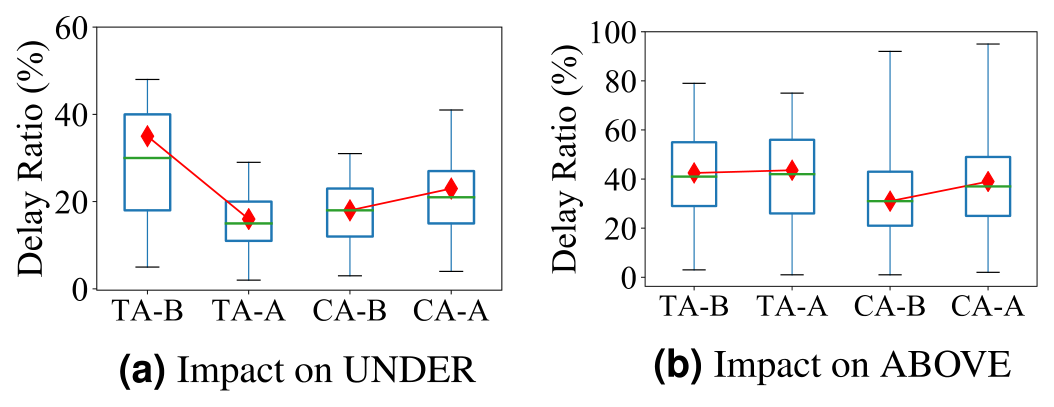
图 6|7号线开通前后一个月,已有车站和地面的延误怎么变?
符号与图4相同,TA 为受新线影响的区域,CA 为对照,B、A 为开通前、后。(a)地铁试验区从36%降到18%,对照区从19%升到20.6%。相对开通前的36%,试验区降了一半;绝对差是18个百分点。(b)地面箱线的水平变化不大。正文另给延误比增加量:试验区0.9%,对照区3.2%。按前文对增加量的定义,这是延误比的绝对差,不是图上箱线的高度。来源:原论文 Fig. 6。
7号线穿过商务区并连接6条既有线,作者认为它减少了既有车站的客流、行程距离和换乘时间,也让一部分本会走地面的乘客改乘地铁。讨论里写,新线和新站使超负荷换乘站的延误下降44.1%,并把地面延误的增加从43.8%减到13%。这四个数没有计算过程,也不能由36%到18%、以及0.9%对3.2%直接得到。同一段后文又说7号线使地下延误降低18%。18可以理解成36到18的绝对差,也可以理解成降到18%,两种读法不是同一个比例。
人多和高峰,地铁可以加车,地面加不出新路
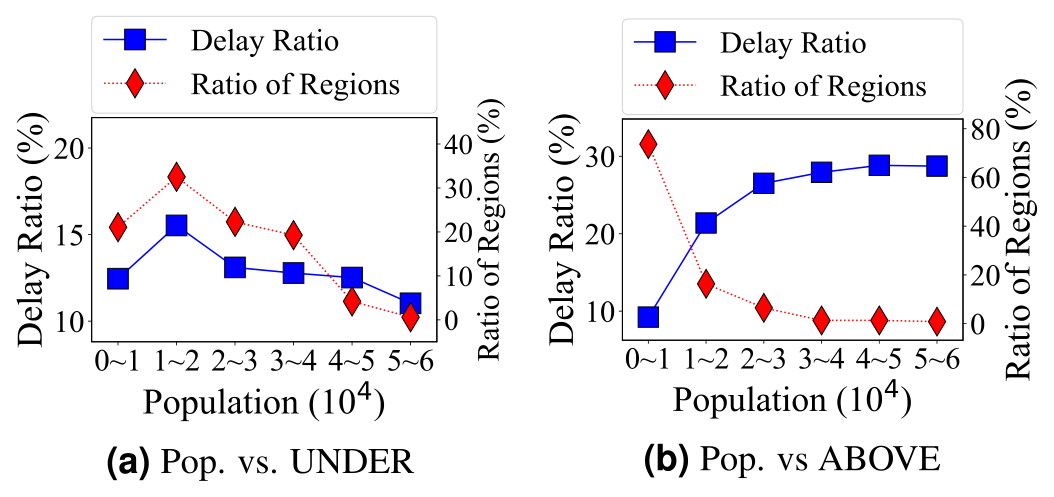
图 7|人口更高的地方,延误比是更高还是更低?
横轴人口以万人为单位,从0–1万到5–6万。蓝线是平均延误比,左轴;红线是该类区域占全部区域的比例,右轴。(a)地铁服务区。1–2万人口一档延误比最高,之后下降;正文给出1–2万为15.5%、5–6万为10.4%。地铁覆盖范围内78.4%的区域人口超过1万,因为地铁主要覆盖中心。(b)地面网格,边长对应1.37平方公里。延误比随人口上升,1–2万为8%,5–6万为28%,高人口网格的占比很低。77.1%的网格人口少于1万。超过2万以后,地面延误的升幅变小,作者推测中心区路网结构更好,没有另给路网指标。来源:原论文 Fig. 7。
作者把相反的斜率归于供给弹性。人多的地铁服务区可以加开车次、把线网修得更密,所以人均地下供给更高。人多的地面区域缺少新路的空间,供给加不上去。这是对横截面相关的机制解释。它没有测量每个区域的实际发车间隔或道路面积,也没有把就业、商业和收入从人口里分开。
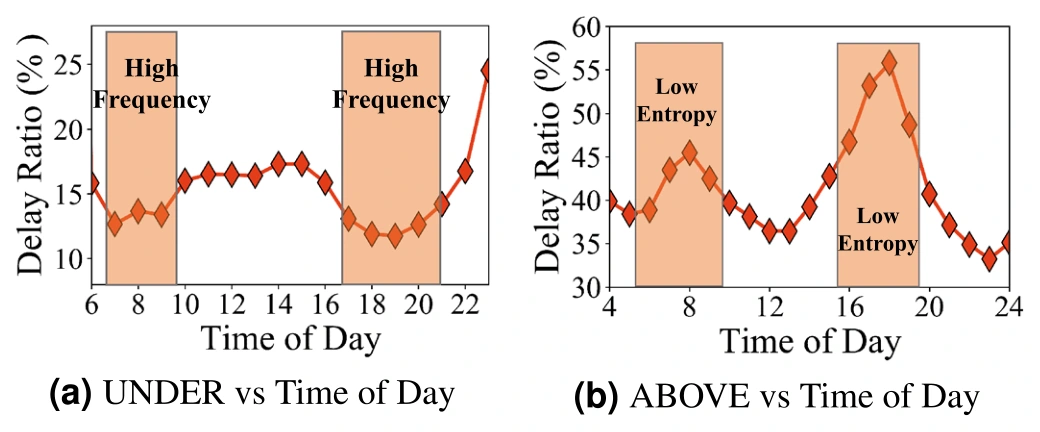
图 8|高峰时段,两条曲线为什么一个下降、一个上升?
(a)地铁。阴影标为高发车频率,对应7–9时和16–20时。阴影内曲线降到大约13%,与正文的高峰约13%、非高峰18%一致。午间回到大约17%,21时以后继续上升。18%到13%是非高峰对高峰的概括,不是22时以后那个尖点。(b)地面。阴影标为低空间熵,早晚延误升到大约45%和55%附近,午间和深夜接近35%。正文概括为非高峰35%、高峰约50%。来源:原论文 Fig. 8。
地铁高峰每5分钟一班,非高峰每8.5分钟一班,这个间隔来自深圳地铁的公开信息,不是这套 GPS 里数出来的车次。作者用一条单程1小时的线路做例子:非高峰至少7列车(60除以8.5),高峰12列车(60除以5),列车数增加71%。这是示例里的运力,不是深圳地铁的会计成本。
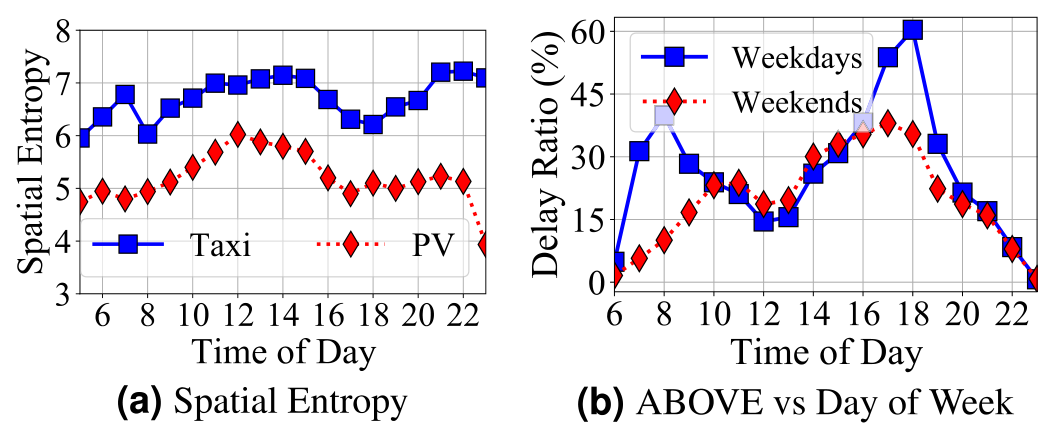
图 9|地面高峰更堵,是不是因为车辆都挤向同一批地区?
(a)空间熵。蓝线出租车,红线私家车。熵越低,作者定义为空间去向越不随机。两条曲线都在早晚通勤时段下降,出租车全天高于私家车。正文没有给出熵的计算公式。(b)只画了地面。工作日晚高峰明显高于周末,白天其余时段两条线接近。正文写工作日高峰的地面延误比周末高峰高25%,分母是周末高峰的延误比;地铁的工作日与周末差别可以忽略,但这张面板没有画出地铁。来源:原论文 Fig. 9。
空间上,正文说两个系统的市中心延误逐年上升,郊区总体逐年下降,因为郊区在城市化中修了新路和新站,而一条新地铁还能兼作既有车站之间的换乘、覆盖面大于一段新路。Top k 的 k 没有定义,市中心和郊区的延误比也没有数字,并且没有对应的地图。
大风有图,雨、气温、节日和油价能说的程度不同
五年里的日子按风(清风、和风、劲风、大风)、雨(无雨、小雨、大雨)和气温分组。只有大风对正常日进入了图10。
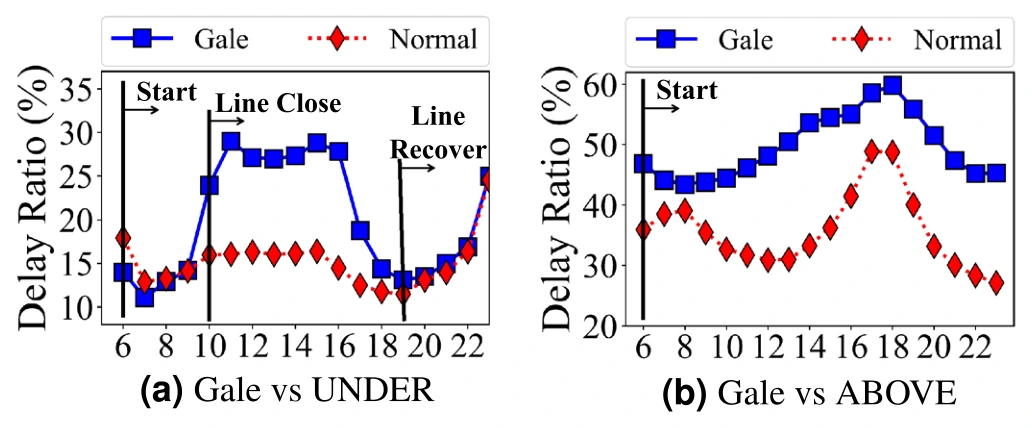
图 10|大风当天,地铁延误的台阶和地面延误的抬升各出现在什么时候?
(a)地铁。蓝线大风,红线平常日。图上标了开始、线路关闭和线路恢复。关闭之后大风曲线跳上一个高平台,恢复标记之后掉回来,末尾又上升;平常日大部分时间停在大约15%附近。(b)地面。大风曲线全天高于平常日,两者都在傍晚达到高点,大风的高点更接近60%的刻度。作者的解释是:极端风让部分地铁线路和车站临时关闭,乘客绕行,所以地下延误升高;关闭可以较快恢复。地面则是车速下降。来源:原论文 Fig. 10。
小雨和大雨都会推高地面延误,高峰更明显。小雨推高地铁延误;大雨略微降低地铁延误,作者说这是因为看过客运量之后,需求下降了。气温没有明显影响。这三句都没有延误比的数字,也没有单独的图。
节日同样只有方向。春节多数居民离城,延误下降很多;国庆人们购物和去本地景点,延误高。没有百分数。
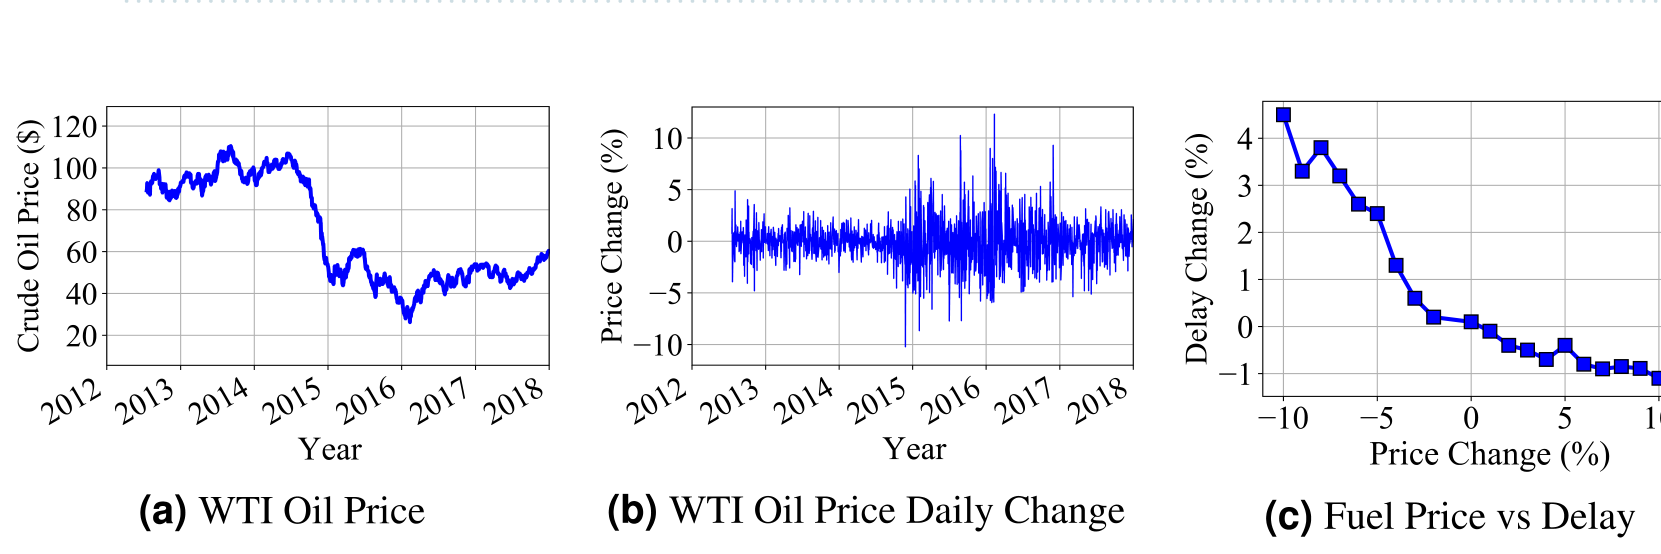
图 11|油价的短期涨跌,和地面延误比的涨跌是不是反向?
(a)WTI 原油价格,大约从2012年的100美元附近降到2016年以后的50美元附近,正文的范围写到2018年。(b)后一日相对前一日的价格变化百分数,多数日子在零附近,少数日子波动很大。(c)横轴是价格变化百分数,纵轴是延误比变化百分数。价格下跌的一侧,延误比变化为正;价格上涨的一侧,延误比变化接近零或略负。来源:原论文 Fig. 11。
长期延误受城市扩张支配,所以油价只做短期比较。正文的结论是负相关,跌价对延误比的推动大于涨价,因为更便宜的油会增加地面出行,已经开车通勤的人并不因涨价而改方式。相关系数没有给出。地下系统几乎不受短期油价影响,因为发车间隔不跟着油价改。
配过对照区,仍然不是施工实验
试验区和对照区在升级前按人口、延误比和增速对齐。新路多选在郊区,新地铁多选在中心区。郊区本身正在城市化,中心区本身需求更旺。开通前后的差别里,同时有新设施、地点选择和那几个月里的其他变化。沿江高速对照区的地面延误在同一个月从23%升到36%,说明窗口本身不稳定。
A 和延误比也不是同一个问题。A 回答后一期有多大比例的起讫点更高;图3的纵轴回答这一年的平均延误比比上一年高了几个百分点。两套数在新路对地铁的方向上没有对齐。图1的两个面板、图3与图5的折线又是重复绘制。能够分开两个系统、并且前后值写明了的,是表1到表3,加上沿江高速和7号线的一个月箱线。
测量停在2017年。作者说明此后数据访问更严,五年前的记录仍能看到设施、人口和天气一起变化时的延误。它不能直接回答2017年以后新线的效果。分区是事先定好的,作者也承认怎样分区仍然是开放问题。步行和骑行没有进入地面系统。私家车只有自愿上报的10043辆。疫情期间的方式转移来自其他城市的文献,这套数据结束于2019年之前,不能当作深圳在疫情中的测量。
作者写道,指标和部分观察有可能用到规模与政策相近的城市,又在局限里写结果可能只适用于深圳或特征相近的城市。后一句是更紧的边界。他们还写,这项工作和深圳市交通运输委员会一起,服务于新站选址和公交、地铁的班次安排。论文没有给出由此选定的车站名单或排班改变后的延误。
一句话总结
在2013年到2017年的深圳,地铁和地面的起讫点延误整体变高;人多和高峰会拉低地铁延误、拉高地面延误,新路案例把延误转给相连的地铁站,新地铁案例则压低地铁延误、并让地面延误涨得比对照区慢。
核心来源
Fang, Z., Wang, G., Yang, Y., Zhang, F., Wang, Y., & Zhang, D. (2022). A long-term travel delay measurement study based on multi-modal human mobility data. Scientific Reports, 12, 15988. https://doi.org/10.1038/s41598-022-19394-z
测量用的是深圳市交通运输委员会提供的2013–2017年四种方式数据,以及作者引用的2011–2016年普查、OpenStreetMap 道路开通、深圳地铁公开间隔和 WTI 原油价格。论文给出的代码页是 https://github.com/GrandDuelist/mRythm。正文说将发布一个月的聚合数据,正式版里没有这批数据本身。
Zhihan Fang 与 Guang Wang 为并列第一作者。Fang 的论文署名为罗格斯大学计算机科学系;罗格斯大学学位论文库收录其博士论文 Human mobility modeling based on heterogeneous urban sensing systems,导师为 Desheng Zhang。作者贡献写明他参与构思实验、做数据分析并分析结果。
Guang Wang 的论文署名为佛罗里达州立大学计算机科学系。该系教师页写明他是助理教授,研究方向包括从大规模数据里识别人类移动、智慧城市和共享经济中的模式,并设计相应的决策算法。作者贡献与 Fang 相同,并共同构思实验。
Yu Yang 的论文署名为理海大学计算机科学与工程系。其个人站点写明他是该系助理教授,发表工作包括人类移动模型在不同使用场景下的可推广性。作者贡献为分析结果。
Fan Zhang 的论文署名为中国科学院深圳先进技术研究院。作者贡献写明他与 Fang、Wang 一起完成数据分析与实验。
Yang Wang 是通讯作者,署名为中国科学技术大学,邮箱 angyan@ustc.edu.cn。论文写明实验方案经该校软件学院机构审查委员会批准,个人敏感信息在分析前去除,使用的是聚合后的行程。作者贡献为分析结果。
Desheng Zhang 是另一位通讯作者,署名为罗格斯大学计算机科学系。其教师页写明他是该系副教授,计算机科学博士毕业于明尼苏达大学,此前获得麻省理工学院 Senseable City Consortium 的博士后奖学金。作者贡献为构思实验并分析结果。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一条新路的考核只看地面速度,沿江高速的试验区就是成功:地面延误比在一个月里从22%降到18%。同一窗口里地铁试验区从18%升到24%,多出来的6个百分点落在两座接驳站上。规划台账若把道路行程时间和地铁站内等待分成两张表,这种转移会被记成一路改善、另一路另有原因。把497个行政区上的两种延误比放进同一张前后对比,才能看见转移。这个做法仍然依赖对照区在那一个月里不要自己大起大落;沿江高速的对照区地面延误从23%升到36%,说明一个月尺度上,对照区并不安静。
地铁能在高峰把间隔从8.5分钟收到5分钟,示例线路的在线列车从7列增到12列。地面在已经拥挤的网格上加不出对应的车道。所以高峰地铁延误降到约13%、地面升到约50%,更像两种供给能不能在当天调配,而不是人在高峰突然更愿意等地铁。若把这个方向差写成居民偏好,就越过了数据:数据里没有人在两种方式之间的选择记录,只有各自系统内部的行程时间。
私家车曲线被作者当作地面延误增速放缓的主要原因,而 GPS 只有10043辆自愿车,注册量在2016年是323万辆。摇号可以解释注册量从2015年起走平,不能自动解释这1万辆车的延误代表其余未接入的车辆。公交和出租车是系统内的全量记录,私家车不是。把三者合成一条地面曲线之后,再归因到小汽车政策,中间缺一层:10043辆车的延误比,和全市注册车辆的延误比,是否同向变化。论文没有这层对比。
7号线的36%降到18%,发生在穿过商务区、连接6条既有线的走廊上。一条修在低需求郊区、不与既有线换乘的新线,没有理由复制这个绝对差。图7已经暗示供给位置会改变斜率:人多的地铁服务区延误更低,人多的地面网格延误更高。把2016–2017年中心区新线的结果,写成任何新增车站都会同时压低两个系统的延误,和论文自己的人口梯度是冲突的。