同样从家里出发,早上和晚上为什么不该共用一个预测上限?
论文名片|Chao Zhang、Kai Zhao、Meng Chen,Beyond the Limits of Predictability in Human Mobility Prediction: Context-Transition Predictability,IEEE Transactions on Knowledge and Data Engineering,2023,35(5):4514–4526。2022年2月4日在线发表,当前版本日期2023年4月3日。DOI:10.1109/TKDE.2022.3148300。这是一篇给下一地点预测建立信息论上限、再用签到数据比较预测器的论文。Chao Zhang与Kai Zhao为并列第一作者,Meng Chen为通讯作者。
可以这样想象:同一个人早上从家去办公室,晚上从家去商店。如果只记录地点的先后,两次出发都是“家的下一站不唯一”,不确定性看起来很大。把钟点放进去,早上的下一站和晚上的下一站就不再是同一个问题。
Song等人在2010年用熵给出人类移动的可预测性上限,并指出若能用尽时空规律,预测准确率最高大约可以到93%。那是他们那项研究的结果,不是本文测到的准确率。本文认为,只按地点序列计算的上限漏掉了时间、地点类别这类情境,所以上限偏低;一些用到情境的预测器看起来会“超过理论上限”。作者因此定义情境—转移可预测性(Context-Transition Predictability):在相邻地点转移之外,再计入随地点变化的情境,重新计算下一地点还能被猜中的上界。
这个上界高于旧上界,仍然是由熵反推的上限,不是某个模型已经达到的命中率。
先说结论
- 在纽约和东京的Foursquare签到里,情境—转移可预测性高于只看地点频率的香农上限,也高于只看地点顺序的真实熵上限。表4的用户平均值为纽约82.78%、东京77.58%。
- 把转移从前一个地点加长到前五个地点,平均值略降:纽约从82.78%到80.45%,东京从77.58%到75.51%。短转移比长前缀更有规律。
- 每位用户按时间顺序取前80%签到训练、后20%测试。前5、10、20、30、50名的平均准确率里,Embedding 24h最高,纽约32.09%、东京28.60%;分母是同口径随机猜测的0.40%和0.25%。东京的前5名和前10名则是Bayes 24h更高。
- 用户层面上,Embedding 24h的预测准确率与情境—转移可预测性的相关系数为纽约0.539、东京0.541,均有p<0.01。相关系数不是准确率,也没有写成解释率。
- 只保留访问最多的地点时,情境—转移上限随地点变多而下降。纽约从前200个地点的92.70%降到前3200个的83.73%;东京从85.95%降到79.36%。换成地点类别后,这条上限的分布仍在另外两种的右侧。
签到里的“下一步”,旧上限漏掉了什么?
数据是Foursquare上公开的纽约和东京签到,时间从2012年4月到2013年9月。每条记录有用户、地点、地点类别和签到时间。作者去掉签到次数少于20的地点和用户,再按时间把每位用户排成一条轨迹。分析单位是用户轨迹上的下一次签到地点,不是连续GPS,也不是这个人当天的全部出行。没被签到的路段不会进入熵。
| 数据 | 用户数 | 唯一地点数 | 平均每位用户签到次数 |
|---|---|---|---|
| 纽约 | 951 | 4,292 | 111 |
| 东京 | 1,948 | 6,994 | 163 |
表3的列名是平均签到次数。正文又把111和163说成用户平均访问的地点数。后文说明随机猜测困难时,用的是全体唯一地点数4292和6994,不是111。地点可以重复签到,所以这两个数字不是同一口径。
旧上限有两档。香农熵只看每个地点出现的频率,不管顺序。真实熵用Lempel–Ziv估计地点序列里新出现的最短子串,从而计入顺序。熵越小,Fano不等式给出的猜中上限越高。本文的意见是:家后面既可能是办公室也可能是商店,单看地点顺序会把这两种情境混成一份不确定性。
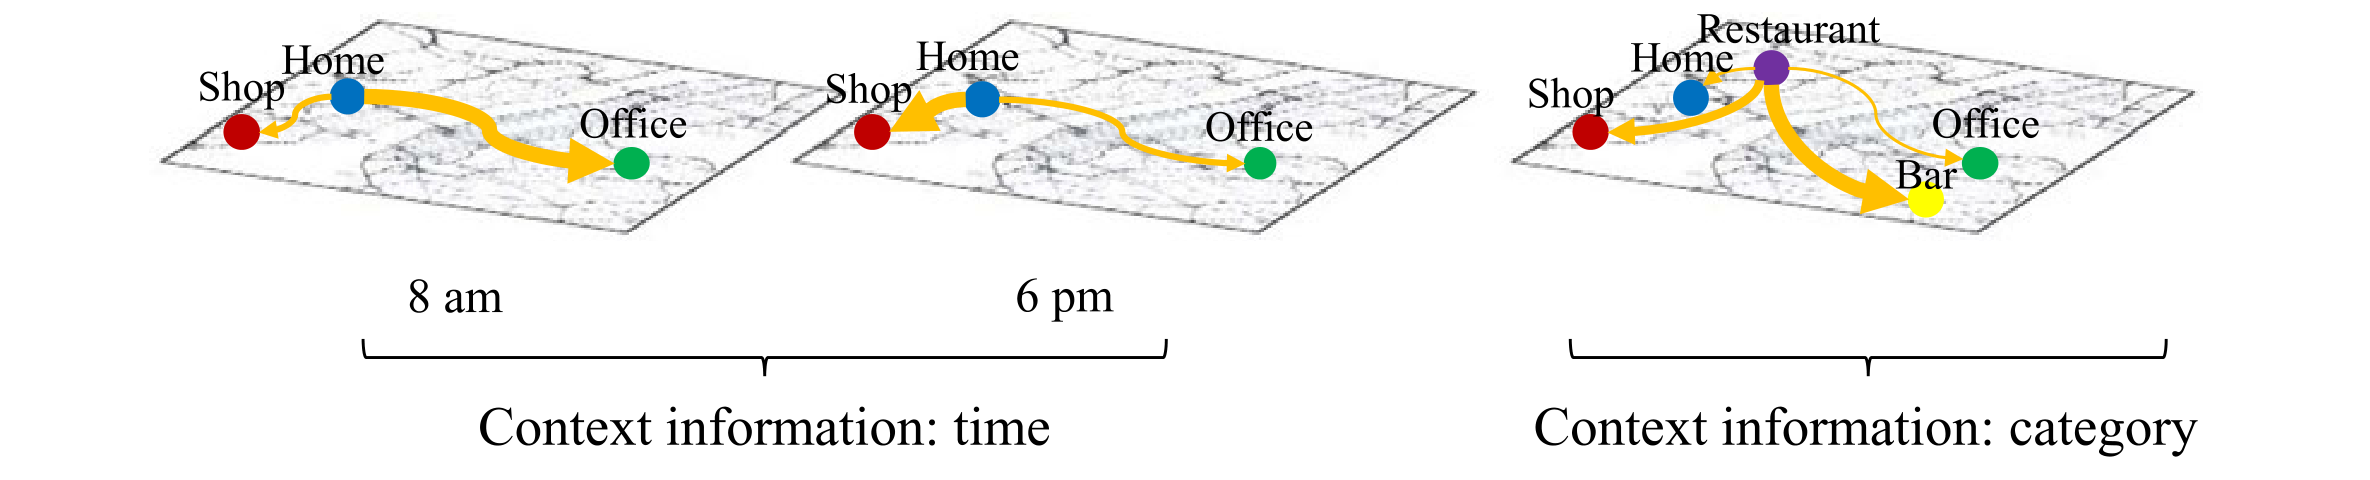
图 1|同一组地点,换了时间或类别之后,下一站为什么不该看成同一个问题?
图中没有子图字母。左侧标为时间情境,两张地图分别对应早8点和晚6点,地点都是商店、家和办公室。早8点有一条从家指向办公室的长箭头;晚6点仍能看到家与办公室之间的箭头,家与商店之间还有一段较短的箭头。右侧标为类别情境,地点包括餐馆、家、商店、办公室和酒吧,箭头从餐馆指向商店和酒吧。这是示意图,没有样本量和准确率。正文用它说明:从家出发时,早上更可能去办公室、晚上更可能去商店;人在餐馆时,下一站更可能是酒吧,而不是任意其他地点。来源:原论文 Fig. 1。
情境怎样进入熵,上限又怎样读?
作者没有把真实熵直接改成条件熵。Lempel–Ziv切出的子串长短不一,很难和每个地点上的钟点对齐。他们改用相邻转移:从当前地点直接到下一地点,中间不再插入其他签到。转移熵是这些转移频率的香农熵,以2为底。再减去转移与情境之间的互信息。互信息越大,说明知道情境之后,转移还剩下的不确定性越少。至少要有一种随地点变化的情境,时间或类别都可以;实验主体用的是访问时刻。
这样得到的情境—转移熵,再放进Fano关系里解出上限。设某用户去过的不同地点数是N,上限Pmax满足:
熵 = −Pmax log2(Pmax) − (1−Pmax) log2(1−Pmax) + (1−Pmax) log2(N−1)。
他们用Householder方法解这个式子。Pmax是一次猜中下一地点的成功率上界:再好的算法,也不能超过它。论文举例说,若某用户的上限是0.8,则大约两成时刻像完全随机,准确率不能高于80%。这是上限的读法,不是这两座城市的实测准确率。
论文据此排列三种熵:香农熵不小于真实熵,真实熵不小于情境—转移熵,所以上限从小到大是香农、真实熵、情境—转移。图2的分布确实按这个方向分开。需要同时记住,真实熵是变长子串的估计,情境—转移熵是转移频率减去互信息,二者不是在同一条子串上做的减法。分布的左右顺序支持“情境把不确定性算低了”,并不单独证明两种熵在数学上逐用户嵌套。
两座城市里,上限真的被抬高了吗?
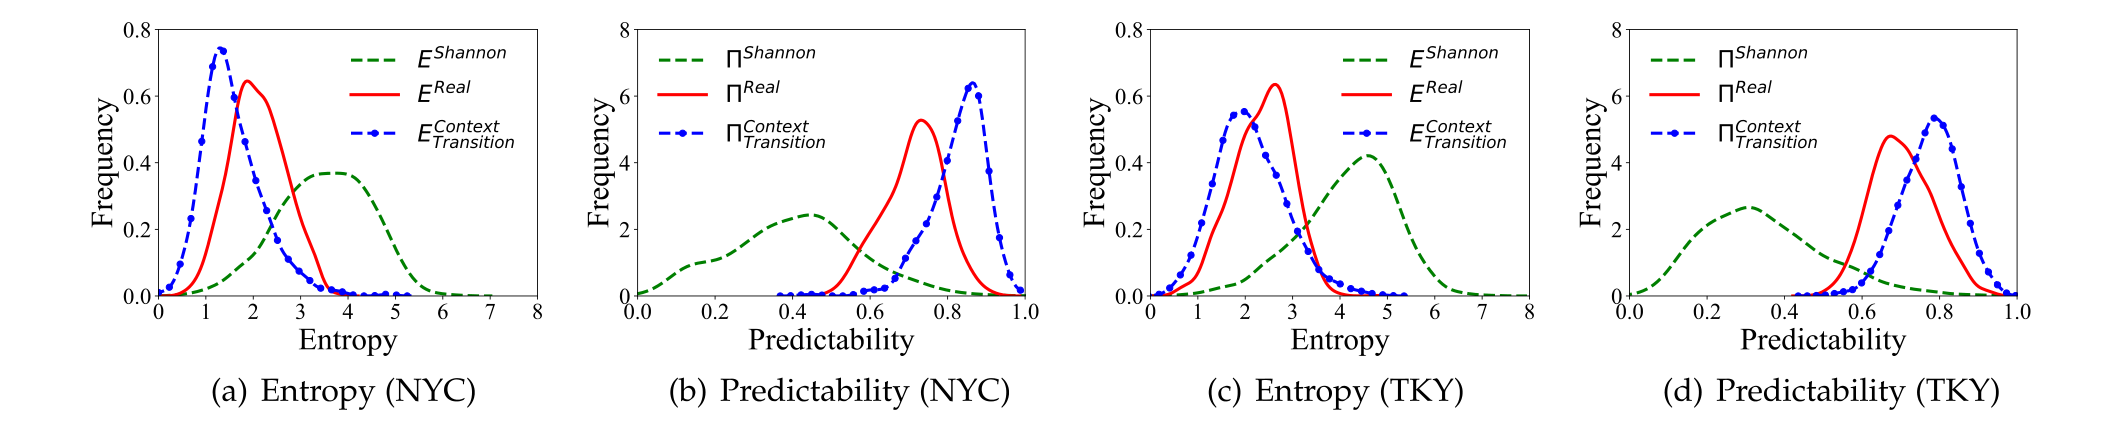
图 2|加入情境之后,熵和可预测性上限各向哪个方向移动?
(a)纽约用户的熵分布,(c)东京用户的熵分布。横轴是熵,纵轴图上标为Frequency,图注称为概率密度。绿虚线是香农熵,红实线是真实熵,蓝虚线是情境—转移熵。(b)纽约、(d)东京的可预测性上限,颜色对应同名的三种上限,横轴从0到1。正文写明真实熵的峰在1.87,香农熵的峰在3.74,没有分城市给出峰坐标;情境—转移熵只说峰在更小的位置。图上两座城市都是蓝线最靠左、红线居中、绿线最靠右。可预测性图上则是蓝线最靠右、红线次之、绿线更扁也更靠左。曲线的峰不是表4的用户平均值。来源:原论文 Fig. 2。
表4把这个上限对用户取平均,单位是百分比。只看相邻转移时,纽约82.78%,东京77.58%。前缀加长到2、3、4、5个地点后,纽约依次为81.13%、80.61%、80.47%、80.45%,东京依次为76.24%、75.71%、75.55%、75.51%。从一阶到五阶,纽约下降2.33个百分点,东京下降2.07个百分点。下降幅度小,方向稳定:这些签到里,短转移比长前缀更整齐。它不能推出“人没有长期习惯”,只说明在这条转移熵的定义下,把更早的地点放进条件,规律性略减。
哪种预测器靠近这条新上限?
上限抬高之后,还要看哪种算法的命中率跟着升高。作者比较了七类方法。随机猜测从训练集里抽一个地点。最热门地点按全体访问频率排序。UCF借用去过相似地点的其他用户。加权矩阵分解把去过记为1、没去过记为0,并用访问次数加权,权重在去过的地点上是1加一个正常数乘以次数,常数的具体取值正文没有给出。LSTM只吃地点序列。贝叶斯同时用上一个地点、当前小时和用户;它假设这三项在给定下一地点时条件独立,这是模型假设,不是检验过的事实。嵌入模型把前M个地点、上一时段和用户向量合成情境,M和向量维数正文没有给出。24小时版不区分工作日和周末,48小时版把两者拆开,一共48个一小时时段。
准确率是Acc@K:测试签到中,真实下一地点落在前K名里的比例。K取5、10、20、30、50。表中的Average是这五个比例的简单平均,不是按K加权,也不是只猜中第一名的比例。相对提升的分母是随机猜测的这个五档平均值。
| 方法 | 纽约平均准确率 | 纽约相对提升 | 东京平均准确率 | 东京相对提升 |
|---|---|---|---|---|
| Random | 0.40 | — | 0.25 | — |
| MostPopular | 6.86 | 1615.00 | 12.66 | 4964.00 |
| UCF | 12.88 | 3120.00 | 18.21 | 7184.00 |
| WMF | 27.49 | 6772.50 | 24.28 | 9612.00 |
| LSTM | 20.89 | 5122.50 | 23.52 | 9308.00 |
| Bayes 24h | 19.40 | 4750.00 | 26.26 | 10404.00 |
| Bayes 48h | 19.27 | 4717.50 | 25.97 | 10288.00 |
| Embedding 24h | 32.09 | 7922.50 | 28.60 | 11340.00 |
| Embedding 48h | 31.71 | 7827.50 | 28.55 | 11320.00 |
单位都是百分比。纽约嵌入24小时版的32.09,除以随机猜测的0.40,大约是80倍;表里的7922.50%等于(32.09−0.40)/0.40,不是提高了7922个百分点。随机猜测很低,是因为候选地点有4292个和6994个。最热门地点能抬起准确率,是因为访问很集中:纽约访问量最高的50个地点占全部4292个地点中的50个,却占全部签到次数的10%。最热门方法在纽约的Acc@50是10.25%。10%是这些地点占全部签到的份额,10.25%是测试下一步落进前50个最热门地点的比例,两者接近,但不是同一个分数。
嵌入24小时版在两个平均准确率上都最高。它的纽约五档分别是16.38%、25.90%、36.00%、40.05%、42.12%;东京是12.85%、20.57%、30.63%、36.61%、42.32%。把工作日和周末拆开,平均准确率略低一点。东京还有一个不能被“平均最高”盖住的结果:前5名是Bayes 24h的17.23%,高于嵌入的12.85%;前10名是22.95%对20.57%。短名单上,按小时统计的条件频率可以胜过嵌入。LSTM在纽约的平均准确率20.89%,低于加权矩阵分解的27.49%。只建模地点顺序,并不会自动靠近这条把时间也算进去的上限。
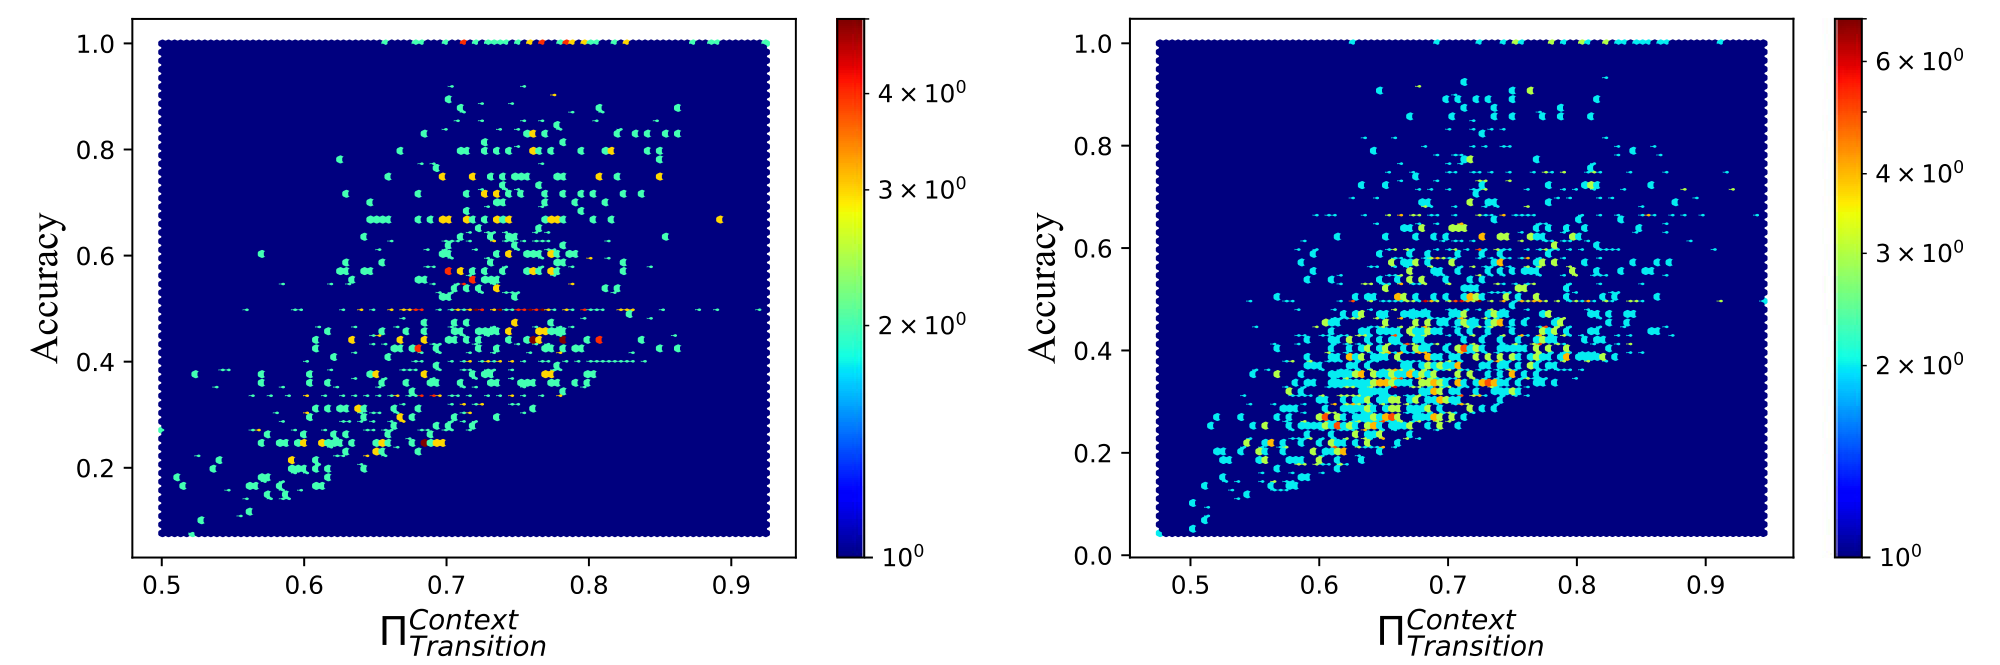
图 3|用户的情境—转移上限更高时,嵌入模型的准确率是否也更高?
无字母子图。左为纽约,右为东京。横轴是该用户的情境—转移可预测性,纵轴是Embedding 24h的预测准确率;论文没有写明纵轴对应哪一个K。颜色表示落在该格子里的用户数,色标从10的0次方起到纽约约4×10的0次方、东京约6×10的0次方。纽约的点更散,东京更明显地从左下走向右上。不少点的准确率低于横轴上的可预测性。正文给出的相关系数是纽约0.539、东京0.541,p均小于0.01;图上没有印出这两个数,也没有说明相关系数的类型。来源:原论文 Fig. 3。
这里有两道不能混用的口径。Fano上限约束的是下一次地点被一次猜中的成功率。表5和表6没有报告Acc@1,报告的是前5名到前50名是否包含真实地点。纽约Acc@50的42.12%不能拿去和82.78%的平均上限比谁大谁小。另外,第6节的上限按每位用户的签到轨迹计算,第7节的准确率只用时间顺序上最后20%。论文没有写明计算熵时是否排除了这20%。相关图说明两者一起变化,还不能单独证明上限完全来自训练段。
地点变多,或者改用类别,上限还稳吗?
作者按访问次数保留前200、400、800、1600、3200个地点,再重算三种上限的用户平均值,单位仍是百分比。
| 保留地点数 | 纽约香农 | 纽约真实熵 | 纽约情境—转移 | 东京香农 | 东京真实熵 | 东京情境—转移 |
|---|---|---|---|---|---|---|
| 200 | 55.62 | 68.73 | 92.70 | 43.00 | 71.57 | 85.95 |
| 400 | 53.96 | 71.15 | 91.71 | 40.82 | 71.47 | 84.39 |
| 800 | 52.63 | 73.43 | 89.71 | 38.92 | 71.13 | 82.81 |
| 1600 | 48.88 | 73.47 | 86.95 | 38.59 | 71.42 | 81.18 |
| 3200 | 42.90 | 72.10 | 83.73 | 37.37 | 71.20 | 79.36 |
地点从200增到3200,纽约的情境—转移上限下降8.97个百分点,东京下降6.59个百分点。真实熵上限没有跟着下降,纽约在68.73%到73.47%之间,东京一直在71%附近。候选地点变多,主要伤害的是“知道时间和上一站之后还有多确定”,而不是那条只看最长重复子串的上限。前3200个地点的83.73%和79.36%,也不等于全体地点上表4的82.78%和77.58%,因为全体地点更多,两次计算的地点集合不同。
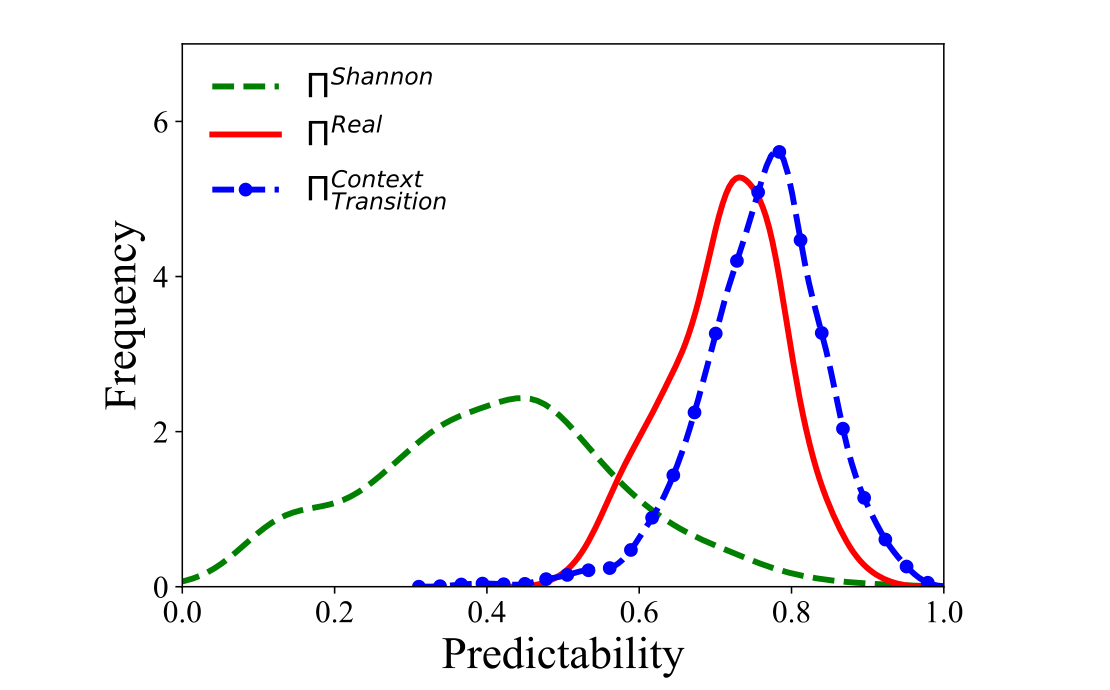
图 4|把时间换成地点类别,情境—转移上限是否仍高于另外两种?
无字母子图,只有纽约。横轴是可预测性,纵轴是Frequency。绿虚线为香农上限,红实线为真实熵上限,蓝虚线为情境—转移上限。绿线的主体在大约0.2到0.6,峰远低于另外两条;红线和蓝线集中在0.7以上,蓝线的峰略靠右。论文没有给出这张图的峰坐标或用户平均值。它支持“类别也能把上限右移”,不能支持类别比时间抬得更高,因为图上没有时间版曲线。来源:原论文 Fig. 4。
类别必须跟着地点变化。作者明确写了边界:天气、钟点、地点类别可以进入这个定义;社交关系这类对同一用户固定不变的信息不能进入,因为它不随地点改变,无法写成地点上的情境序列。
正文还用两份更大的Foursquare签到做了同样方向的检查。纽约大样本有876,101条签到、11,098名用户、17,494个地点;东京大样本有1,331,329条签到、9,552名用户、13,928个地点。分布和各预测器的准确率表放在补充材料里。正文只概括说排序相同:情境—转移熵的峰最小,对应上限最接近最大可预测性,嵌入预测器仍被用来逼近这条上限。
这条上限不能直接当成已经达到的准确率
上限来自熵和地点个数,不是把预测器的输出再平均一次。嵌入模型在五档平均准确率上领先,只说明在这套签到、这个训练切分和这些候选模型里它更接近作者想指导的方向。东京前5名、前10名由贝叶斯领先,说明“模型用了情境”不等于“任何名单长度上都最好”。
签到不是一个人的全部移动。没签到的通勤、停留和绕路都不会降低或提高这里的熵。2012到2013年的纽约和东京用户,也不能代表其他城市、其他年份或连续轨迹。相关图是用户之间的伴随变化,不是“提高某个人的上限就会提高他的准确率”这种干预结论。
一句话总结
早上和晚上不该共用一个只看地点顺序的预测上限;把随地点变化的时间或类别放进转移熵之后,下一地点的理论上限会提高,但提高的是上界,不是模型已经猜中的比例。
核心来源
Chao Zhang、Kai Zhao、Meng Chen,Beyond the Limits of Predictability in Human Mobility Prediction: Context-Transition Predictability,IEEE Transactions on Knowledge and Data Engineering,2023,35(5):4514–4526。DOI:10.1109/TKDE.2022.3148300。论文给出的代码位于 https://github.com/zcfinal/ContextTransitionPredictability。文中作为对照的旧上限来自 Song、Qu、Blumm、Barabási,Limits of predictability in human mobility,Science,2010,327(5968):1018–1021。
Chao Zhang与Kai Zhao是论文标明的并列第一作者。刊出时的作者简介写明,Zhang就读于山东大学软件学院,在Meng Chen课题组做研究助理两年以上,研究兴趣是数据挖掘;论文署名单位是山东大学软件学院。
Kai Zhao于2015年在赫尔辛基大学获得计算机科学博士学位。作者简介写明他是佐治亚州立大学罗宾逊商学院助理教授,2016至2017年在纽约大学做博士后,研究数据挖掘、移动计算和商业人工智能。论文署名单位是该商学院。
Meng Chen是通讯作者,IEEE会员。他于2016年在山东大学获得计算机科学与技术博士学位,2016至2018年在加拿大约克大学信息技术学院做博士后。作者简介写明他是山东大学软件学院副教授,研究轨迹数据挖掘和交通管理。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一个出行应用先用旧的地点序列上限筛选模型,时间感知模型就可能因为“超过理论上限”被丢掉。该先问上限里有没有模型真正使用的钟点,再比较准确率。本文的东京结果还说明,名单只展示前五个地点时,按小时统计的条件频率可以高于嵌入模型;前50个地点时排序又会反过来。选模型之前,要先定产品到底展示多少个候选。
82.78%也不能拿来安排隔离或估计某人全天的位置。它是签到转移在已知情境后的猜中上界,分母是下一次签到地点,不是两签到之间的路线,也不是没有打开应用的那些行程。一个人晚饭后固定签到酒吧,签到类别可以很有规律,中间怎么走仍然可以很散。
表7还暗示一个反例。若数据里大量地点只出现少数几次,情境—转移上限会从纽约前200个地点的92.70%降到前3200个的83.73%。一座游客多、重复到访少的城市,即使用了时间,这条上限也不会维持在只看常去地点时的高度。社交关系若对同一个人始终不变,按论文自己的定义也不能用来抬高它。