连了四条线的枢纽,为什么不一定排在客流中心前面?
论文名片|Feng Xia、Jinzhong Wang、Xiangjie Kong、Da Zhang、Zhibo Wang,Ranking Station Importance With Human Mobility Patterns Using Subway Network Datasets,IEEE Transactions on Intelligent Transportation Systems,2020,21(7):2840–2852。DOI:10.1109/TITS.2019.2920962。2019年6月14日在线发表,当前版本日期为2020年6月29日,刊于2020年7月第21卷第7期。本文依据这一期刊版本。这是一项用刷卡记录做车站排名的方法研究,对照的是两种已有排名。
世纪大道接上四条线,论文给出的晚高峰接近中心性达到 1,是这一指标的最高值。用度和介数做成的加权混合指标排名(WMIRank)把它放在 288 座车站的第 1 名。同一套上海地铁数据改用双向客流来分配分数后,第 1 名换成人民广场,世纪大道不进入前 10 名。
轨道在站台上交会,和人实际从哪一站到哪一站,回答的是两件不同的事。这项研究把客流份额写进一个改进的 PageRank,再拿 2020 年前规划中的新线换乘站来计算重合。名单最前面的重合高于只按度数排,也高于度与介数的混合指标。重合的分母是被考察的前 n 个站,它记录的是排名与规划名单有多接近。
先说结论
- 2015年4月的上海地铁有 14 条线、288 座车站,刷卡记录超过 4.51 亿条,约 0.95% 的错误记录被剔除。静态轨道网上,平均度数为 2.3125,全部车站中 77% 的度数为 2。客流网上,平均入度为 203、平均出度为 197;这里的“度”是有客流相连的车站数,分母是 288 座车站,不是人次。
- 工作日早高峰的热门方向包括通河新村到上海火车站、莘庄到人民广场、九亭到漕河泾开发区,晚高峰在同一批走廊上反向。周末的热门方向包括莘庄到人民广场,以及徐泾东到中山公园。2 号线与 10 号线之间的方向,工作日和周末相反。
- 车站重要性排名(SIRank)在摘要中的前五名命中率为 60%。表 II 前五名有 3 个下划线站,3/5 等于 60%。前 100 名的命中率,SIRank 为 23%,WMIRank 为 6%,NDRank 为 19%,分母都是这 100 个站。前 10 名在正文里写成约 60%、10% 和 30%,表 II 的下划线是 6、1 和 3 座;同一段又写 n=10 时命中 5、1 和 3 座。
- 报告的权重是客流项 α=0.6、网络项 β=0.4;网络项内部,度中心性 γ=0.5、聚类系数 φ=0.2、接近中心性 λ=0.3。β 不超过 0.3 时,居住区车站的名次上升。
- 命中率假设运营效率是挑选换乘站的首要因素。刷卡记录给出起讫站,论文假设乘客走最短路径,路径本身没有被观测。
刷卡表里的一行,对应哪一次出行?
数据是 2015 年 4 月上海地铁公交卡交易。当时网络有 14 条线、288 座车站;论文写到,线路总长 567 公里,并称截至 2014 年这一长度居世界第一,第一条线路建于 1993 年。每条记录有七个字段:卡号、日期、时间、线路、车站、经度、纬度。表 I 的例子是卡号 2602022534、2015-04-01、07:20:49、9 号线、杨高中路(Middle Yanggao Road)、经度 121.555042、纬度 31.233833。
这一行是某张卡在某一时刻出现在某一座站,还不是一张写好起点和终点的出行表。论文说,他们按人、按日抽出起讫站,再统计站对之间的客流。进站与出站如何配对、换乘是否被拆成多段,正文没有给出规则。因此后面的客流网络是配对流,分析单位是站与站之间的连接,不能把 4.51 亿理解成 4.51 亿次独立出行。
他们同时建了两张网。上海地铁静态网络(Shanghai Subway Static Network,SSSN)按 L-space 来连:车站是点,同一条线上前后相邻的两站有一条无向边。上海地铁客流网络(Shanghai Subway Passenger Network,SSPN)是有向加权图:只要有人从甲站到乙站,就有一条从甲指向乙的边,权重是这条方向上的客流量。地理上不相邻的两站,也可以因为一次出行而相连。
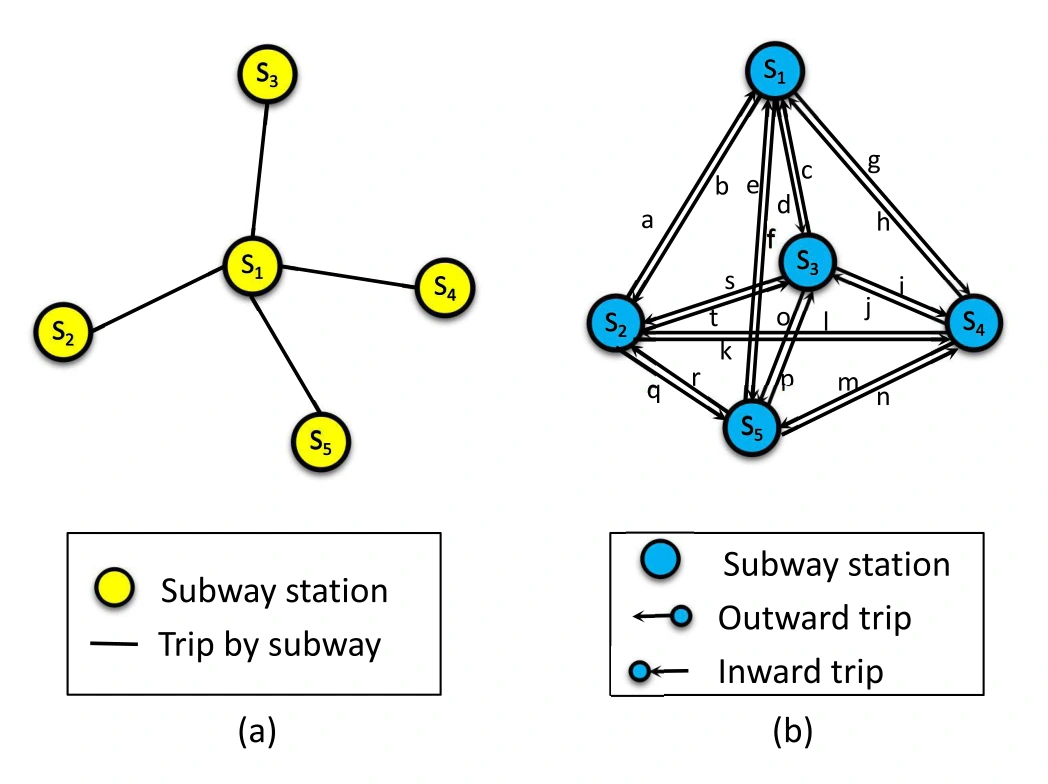
图 1|只连相邻站,和按出行方向连站,网络会差在哪里?
(a)五座站的静态示意。黄点是车站,黑线是相邻站之间的地铁行程;S1 连着其余四站,S2 到 S5 彼此不相连。(b)同一组站的客流示意。蓝点仍是车站,边带字母和箭头:向外的箭头表示发出的行程,指向本站的箭头表示到达的行程。五座站之间几乎两两都有方向相反的连线。来源:原论文 Fig. 1。
图 1 是定义用的小图,S1 到 S5 不是上海的真实站名。真实线网画在图 3:空心圆是换乘站,绿色实心点是非换乘站,颜色区分线路。图上能看到 1 至 13 号线和 16 号线。论文特别说明,莘庄把 1 号线和 5 号线接在一起,这种连通也算换乘站。
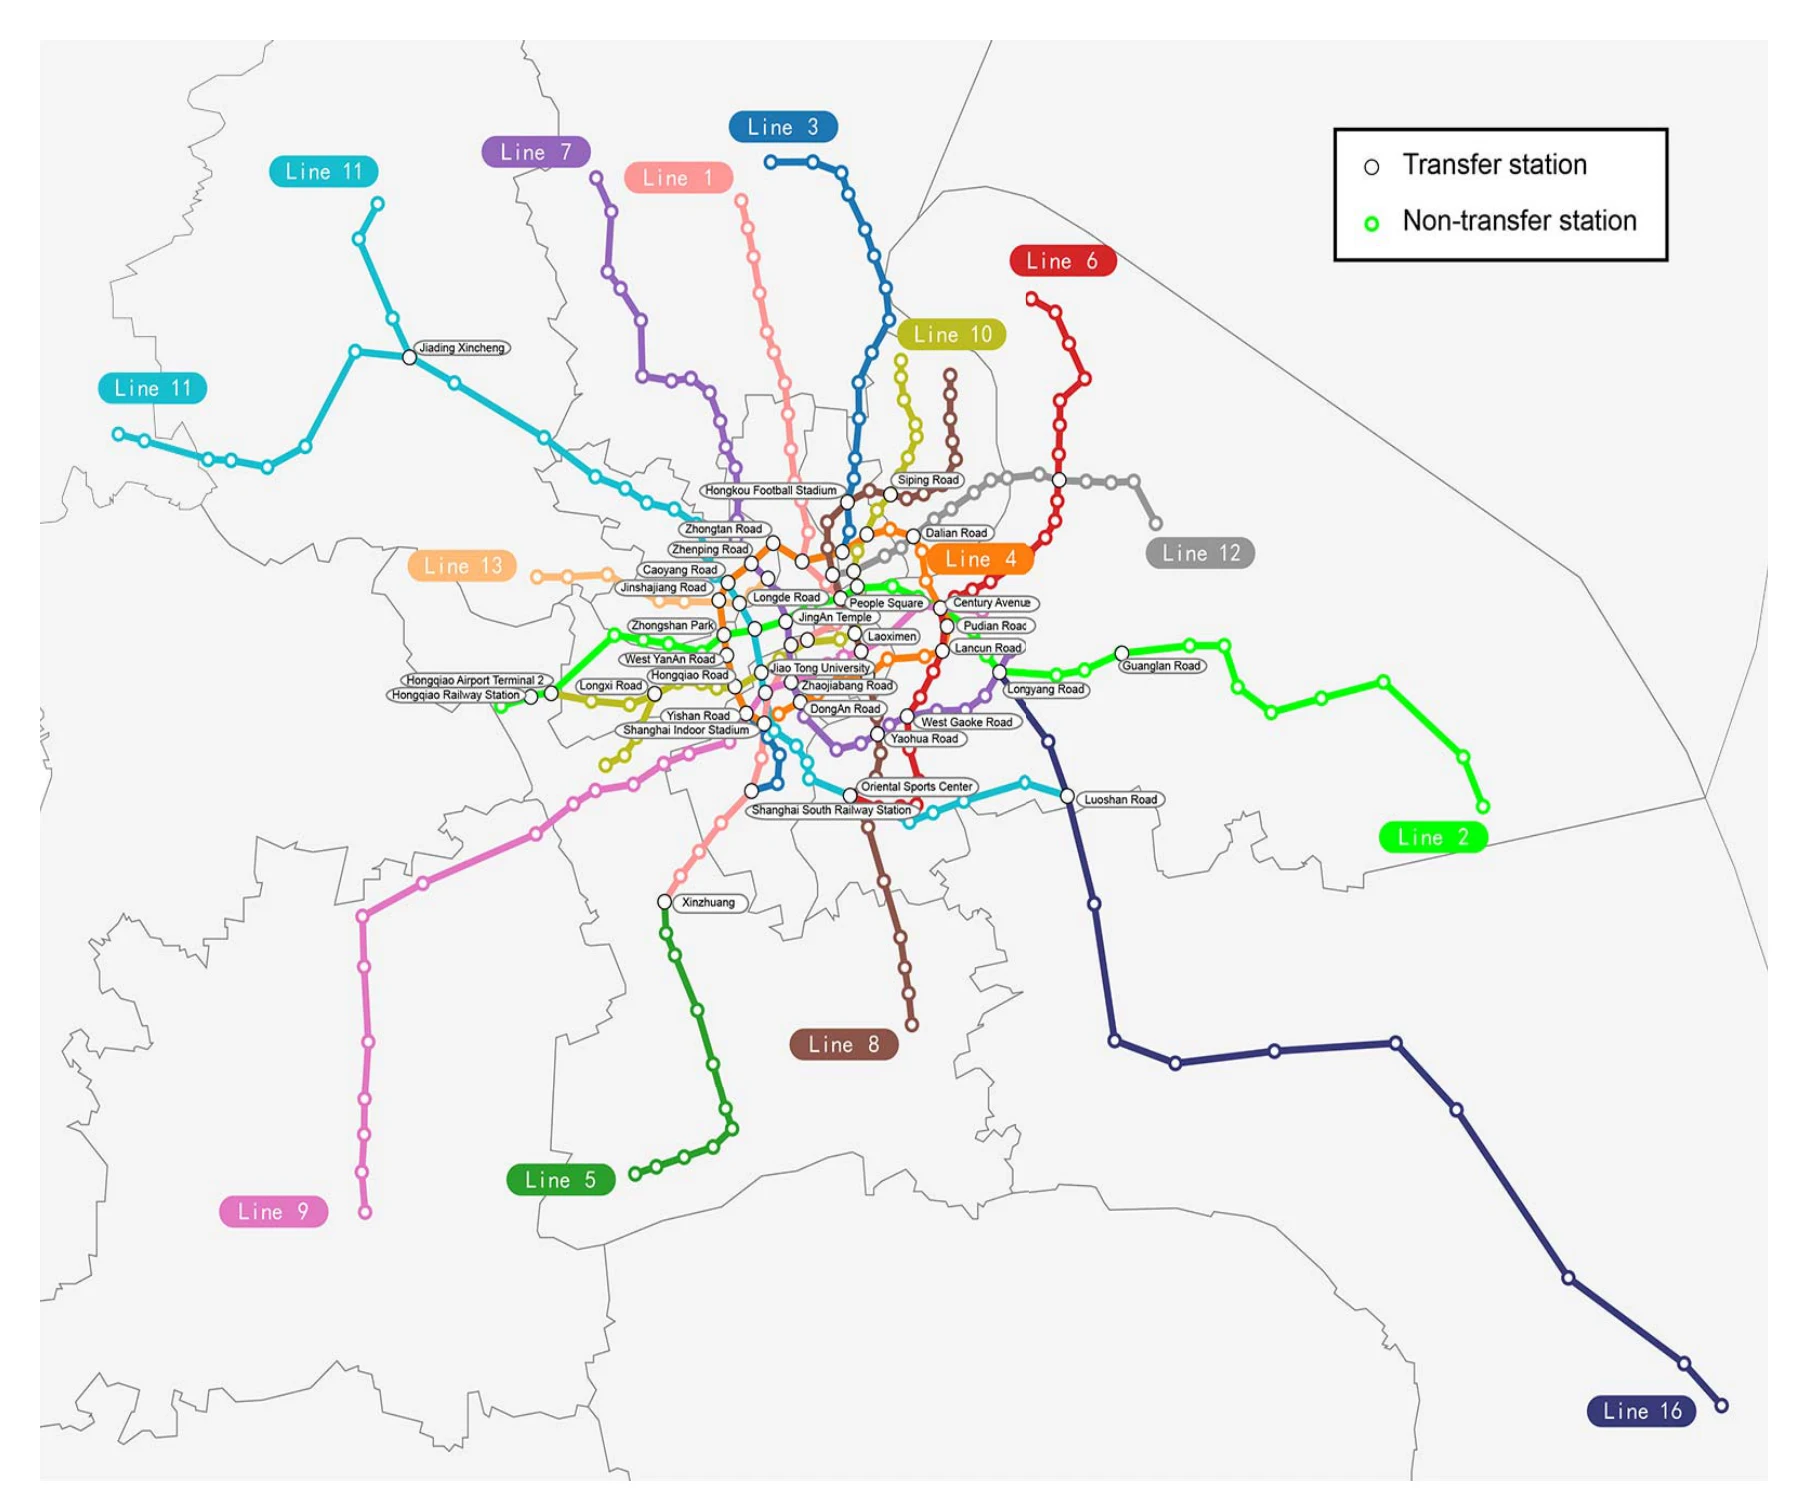
图 3|2015 年这 14 条线在地图上怎样交会?
空心圆为换乘站,绿色点为非换乘站。1 号线、2 号线穿过中心区,9 号线、11 号线向西和西北延伸,16 号线向东南拉出一条长支线。这张图表示轨道相邻关系,线上没有客流人数。来源:原论文 Fig. 3。
出行距离用地球半径 6370 公里的大圆距离计算,输入是起终点的经纬度。静态网上,一次出行的距离写成最短站序上各段大圆距离之和;客流网上,则直接计算起点和终点之间的大圆距离。论文依据乘客通常知道并选择最短路径这一假设,把轨迹看成最短路径。刷卡字段里没有经过站序列,所以最短路径是假设,不是读出来的路线。大圆距离也不是车厢里的行驶时间或票价。
同一条走廊,晚高峰为什么会掉头?
时间、地点和客流量被当作出行的三个宏观指标。全天按 1 小时切段,排名里使用 4:00 到 23:00 的 20 个时段。图案比较则集中在工作日和周末的早高峰、午间和晚高峰。图 7 至图 9 把这三段标成 7:00–9:00、11:30–13:30 和 17:00–19:00。图 4 和图 5 的图注只写早、午、晚,没有重写这三组钟点。
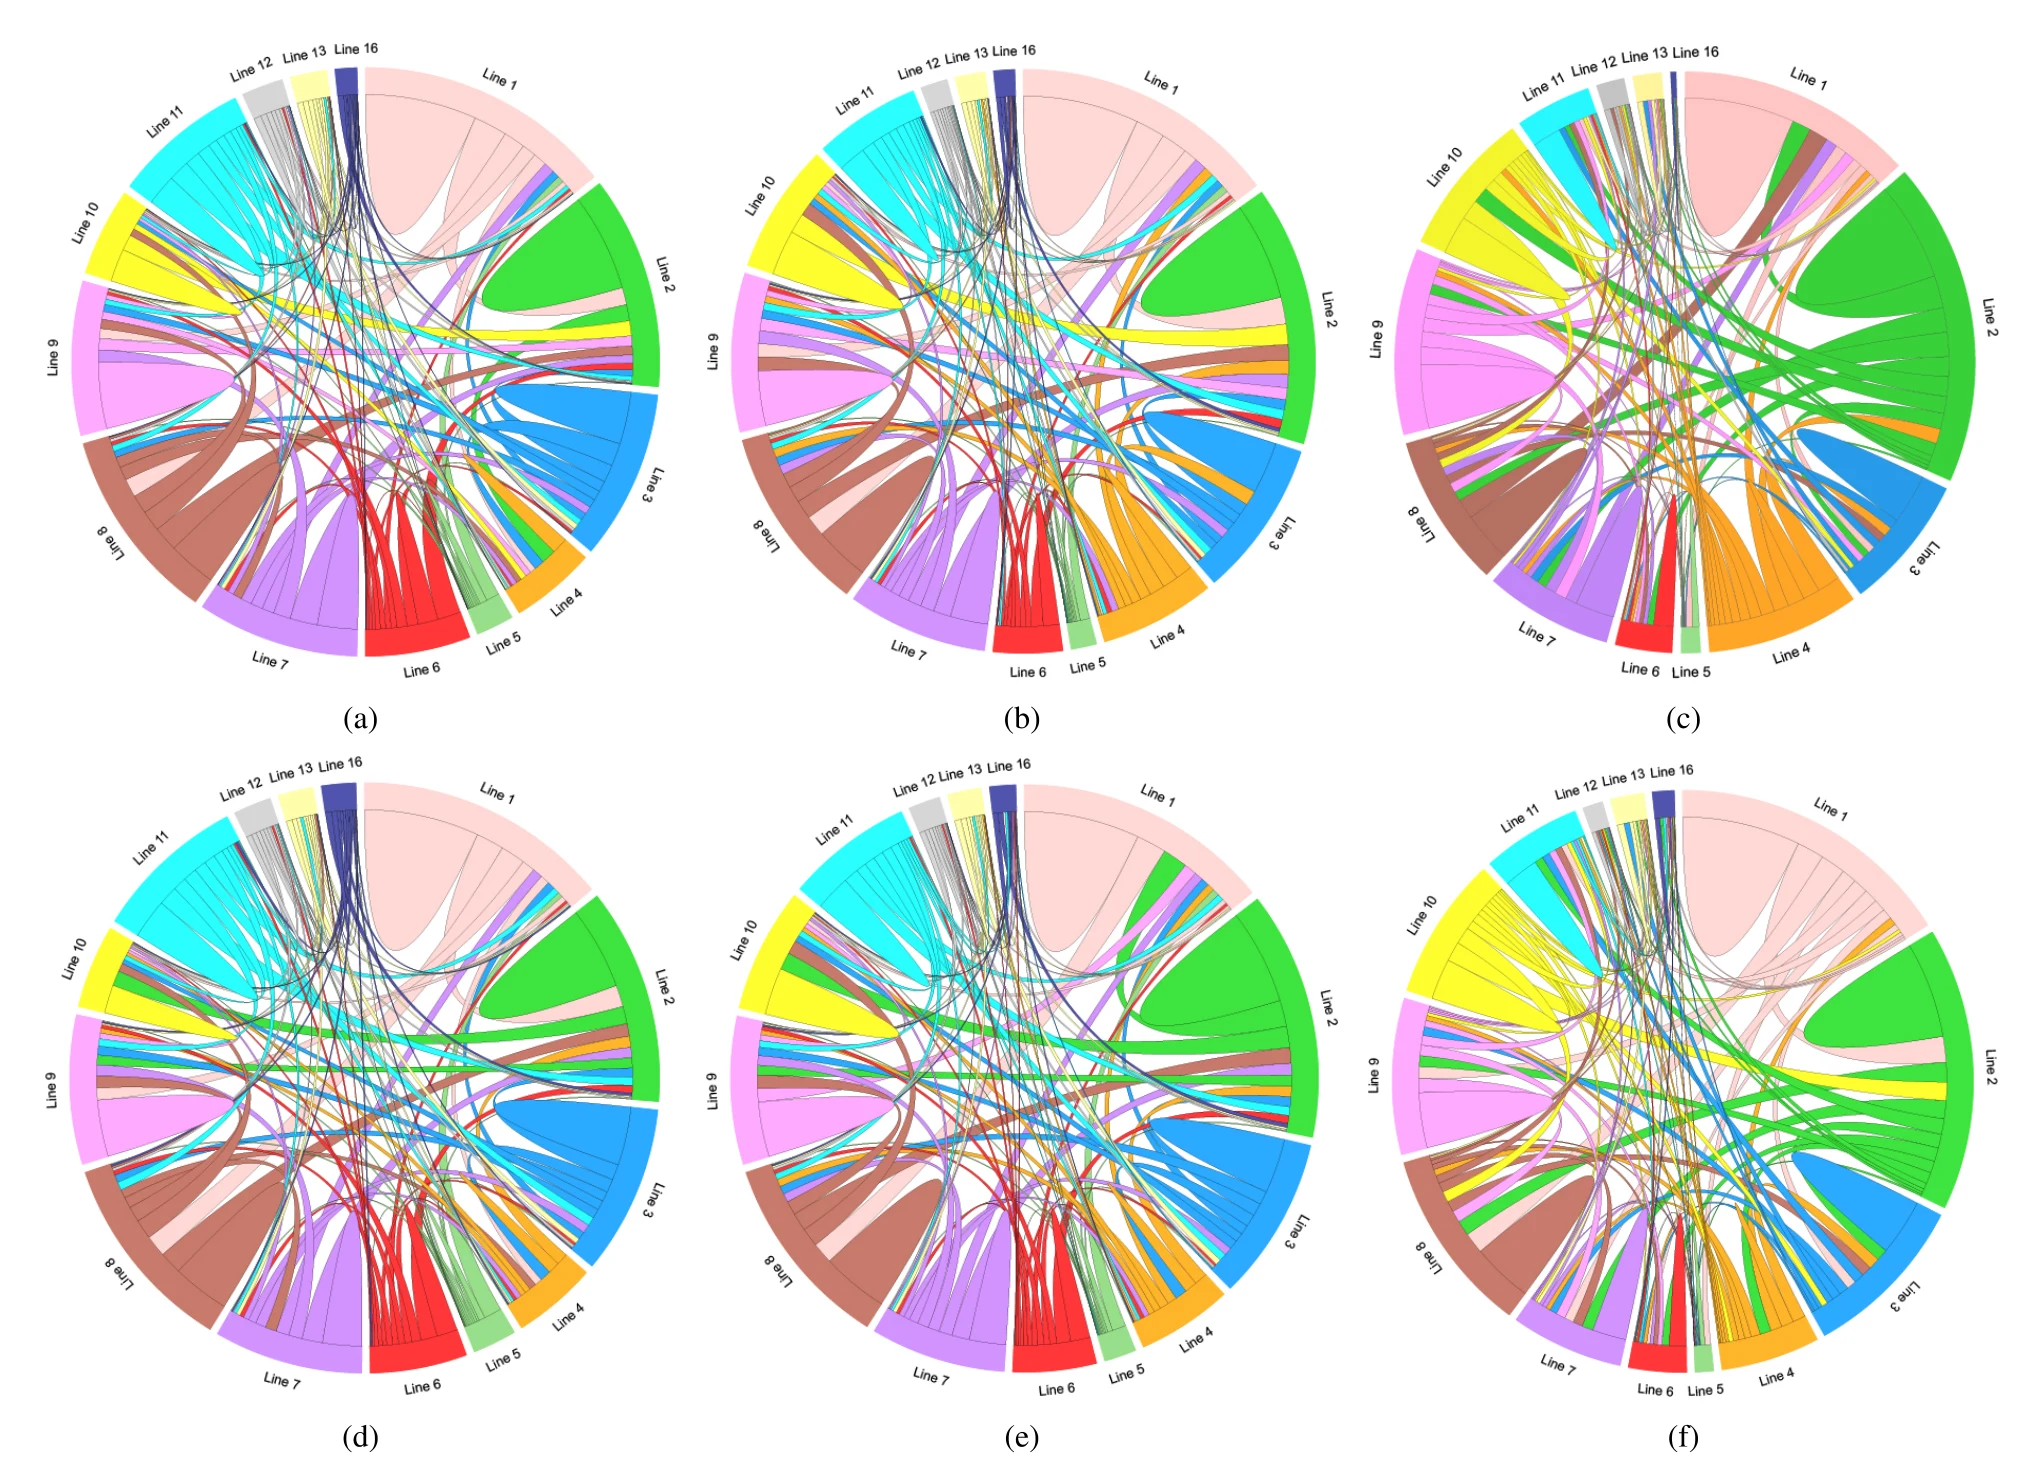
图 4|线路和线路之间的客流,一天之内怎样改变方向?
六个弦图的圆弧是地铁线路,弦的粗细是线路之间的客流量,弦的颜色表示方向:与某一侧圆弧同色的弦,表示从该线路发出的客流。(a)工作日早高峰。(b)工作日午间。(c)工作日晚高峰。(d)周末早高峰。(e)周末午间。(f)周末晚高峰。论文读到的结果是:1 号线和 2 号线的客流多于 16 号线;工作日里 2 号线与 12 号线的联系相对紧密;2 号线与 10 号线之间的方向,在工作日和周末相反。来源:原论文 Fig. 4。
弦图把全网收成 14 条线,看不出是哪两座站在贡献这股客流。站一级的方向画在图 5。线的颜色和疏密表示客流强弱,图例分成冷暖两套色阶;正文没有逐段抄出色阶边界。公式里,单个时段、单个方向的客流权重范围是 1 到 27,530,单位是这一对站在该时段的客流量。图 5 的色阶是否使用同一口径,正文没有写明。
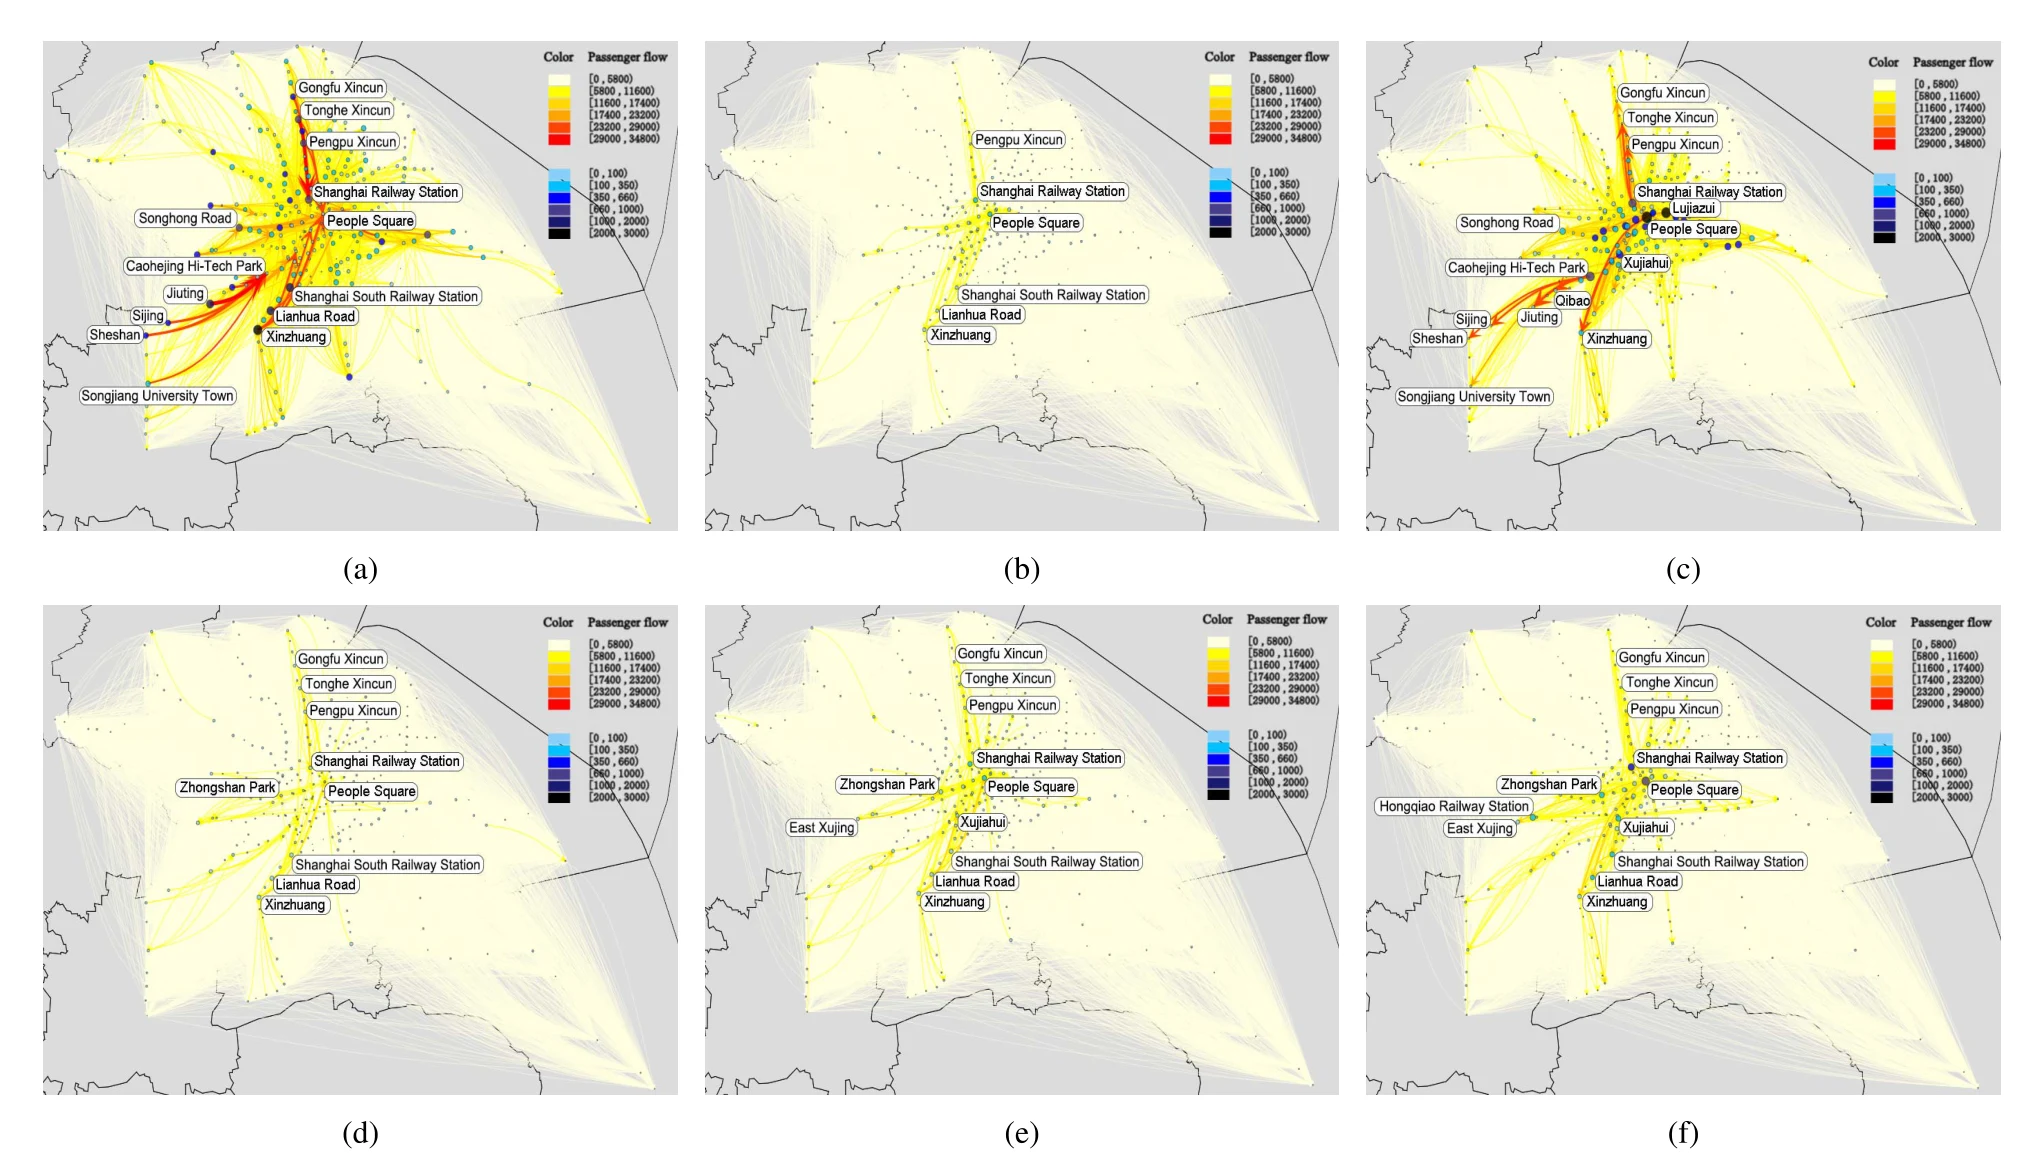
图 5|哪些站到哪些站,在高峰里形成了来回走廊?
底图是上海,线连接有客流的车站,颜色对应客流量图例。(a)工作日早高峰,暖色粗线集中在中心城和若干外围站之间。(b)工作日午间,线明显变疏。(c)工作日晚高峰,早高峰的若干走廊重新变密。(d)周末早高峰。(e)周末午间。(f)周末晚高峰。周末三张图整体疏于工作日早晚高峰。来源:原论文 Fig. 5。
论文点名的工作日早高峰方向是:通河新村到上海火车站,莘庄到人民广场,九亭到漕河泾开发区。晚高峰在这些走廊上反向。论文由此推断,这三个早高峰起点位于居住区,人们早晨进城。这个推断来自方向对调,论文没有附土地利用数据。周末被点名的两条是莘庄到人民广场,以及徐泾东到中山公园;正文写作 East Xujin。人民广场被放在中心商业区,周末仍有人前往。图上还标着共富新村、彭浦新村、徐家汇、陆家嘴等站,论文没有把它们逐一写成热门起讫。
轨道网上多数站只连着两邻居,客流网为什么几乎人人相连?
静态网的度数是相邻车站的个数。288 个站的平均度数为 2.3125。全部车站中,度数为 2 的占 77%。77% 乘以 288 不是整数,所以这是论文给出的比例,不是精确到个位的车站数。平均度可以复核:288 × 2.3125 = 666,无向边若每条计两次,对应 333 条边。这个边数是由平均度推出来的,论文正文写的是 2.3125。
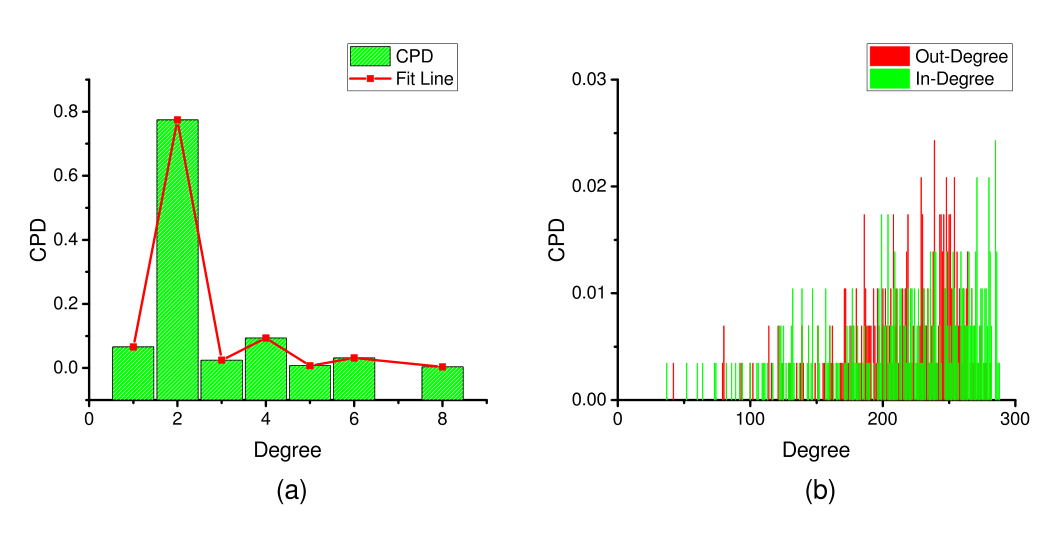
图 6|度数是集中在 2,还是分散到几百个邻居?
纵轴被标成累积概率分布 CPD,绿柱是这一度数上的份额,红线是拟合线。(a)静态网。度数为 2 的绿柱是全图最高的一根,高度与 77% 相符,其余度数只有矮柱。论文认为它既不服从幂律,也不服从泊松分布,并称累积分布有重尾。(b)客流网。横轴延伸到 300 附近,红柱为出度、绿柱为入度,纵轴刻度到 0.03,单根柱都远低于(a)的主柱。来源:原论文 Fig. 6。
客流网的平均入度是 203,平均出度是 197,都远高于静态网的 2.3125。一座站最多与另外 287 座站相连,203 的意思是:平均而言,大约 203 座其他站有客流到达该站。这是连接有无,不是 203 人次。入度与出度的差说明有些方向只有单行客流。论文说,度数高的站主要靠近人民广场、上海火车站和陆家嘴。
度中心性写成 DCᵢ = Dᵢ / (N − 1),也就是邻居数除以其他车站的总数,最大为 1。图 7 的纵轴却标到 3,客流网的线多次高于 1。因此图 7 不能直接代回这个公式核对。论文用文字给出的方向是:不考虑客流时,静态网的度中心性保持很低;客流网里,晚高峰明显高于其他时段;周末的起伏大于工作日。
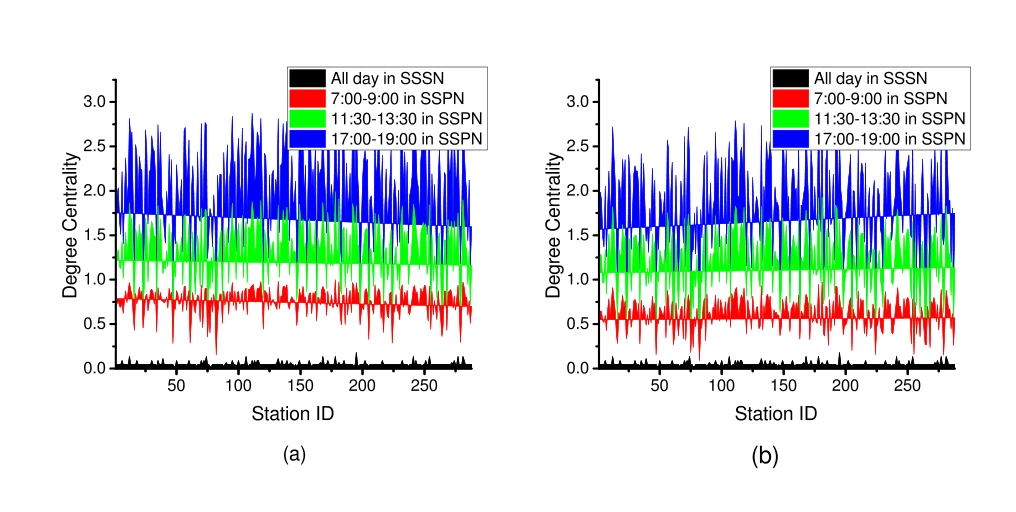
图 7|把度数归一化之后,晚高峰是否仍然更高?
横轴是车站编号,纵轴标为 Degree Centrality,刻度到 3.0。黑色是静态网全天,红色是客流网 7:00–9:00,绿色是 11:30–13:30,蓝色是 17:00–19:00。(a)工作日。黑色贴近 0,蓝色整体高于绿色,绿色高于红色,蓝色多次越过 1。(b)周末。蓝色仍然最高,红色的起伏更大。来源:原论文 Fig. 7。
聚类系数被用来看一座站的邻居是否也彼此相连。印刷的公式是 Cᵢ = 2Dᵢ / (N(N − 1))。按这个式子,N=288、度数为 2 时,Cᵢ = 4 / (288 × 287) ≈ 0.000048,而且只要度数大于 0,数值就大于 0。后文却说静态网只有六个站非零,平均聚类系数只有 0.003125,客流网的平均值则是工作日 0.828249、周末 0.804645。图 8 里客流网的点大多落在 0.7 到 0.9,静态网只有贴着 0 的少数尖峰。这些结果对得上“邻居是否成团”的文字解释,对不上印刷公式。读数值时以正文平均值和图 8 为准。
六个非零站被说成两个三角形。论文点名上海体育馆、宜山路和徐家汇,没有把六座站全部列出。0.003125 的分母是网络中的车站数:它是全网平均,六个非零站的贡献被其余接近 0 的站拉低。客流网的高平均值表示,一旦两座站都和第三座站有客流,这两座站之间也常常有客流。这是连接密集之后的几何结果,还没有单独证明乘客在选择目的地。
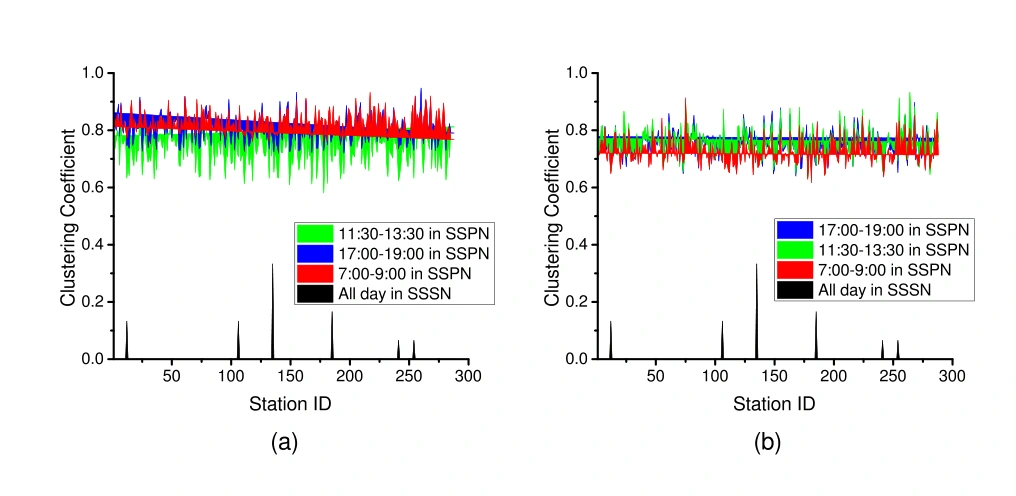
图 8|客流网的车站,是不是更容易形成彼此连通的小团?
横轴为车站编号,纵轴为聚类系数,范围 0 到 1。黑色是静态网全天,其余颜色是客流网的三个时段。(a)工作日。图例中红色为 7:00–9:00,绿色为 11:30–13:30,蓝色为 17:00–19:00。客流网成团挤在高位,早高峰的红线比午间绿线更齐,与正文“工作日早晨高于午间”一致。静态网只在 0 附近留出少数尖峰。(b)周末。图例颜色仍是红早、绿午、蓝晚,客流网整条带子略低于工作日,与周末平均值 0.804645、工作日平均值 0.828249 的方向一致。来源:原论文 Fig. 8。
论文还写到,工作日早晨的聚类系数高于午间,周末则是午间更高。他们把早晨的相似理解成通勤例行,把周末午间的升高联系到出行偏好和社交活动。图 8 能支持时段之间高低不同;它不能把聚类系数换成活动类型。
接近中心性看一座站到其他站的距离有多短。正文解释为:到其他各站的最短路径长度之和的倒数,越大表示离全网越近。印刷的求和把车站编号 i 同时又用作求和指标,式子本身不能逐站区分。报告的数值是:客流网落在 0.6 到 1.0,静态网落在 0.0 到 0.5。上海火车站在周一 7:00–9:00 为 0.9829,是该时段最高;世纪大道在晚高峰达到 1,论文把它联系到四条线的交会。
若严格按“最短路径长度之和的倒数”,数值为 1 就要求这个和等于 1。面对另外 287 座站,跳数或公里数的和都不会是 1。0.6 到 1.0 更像常见的归一化接近中心性,也就是其他车站数除以最短路径长度之和,1 表示到其余每座站都只有一步。论文没有写明路径长度用的是站数还是公里。图 9 与文字中的两个区间一致,静态网贴在 0 附近,客流网整群抬到 0.6 以上。
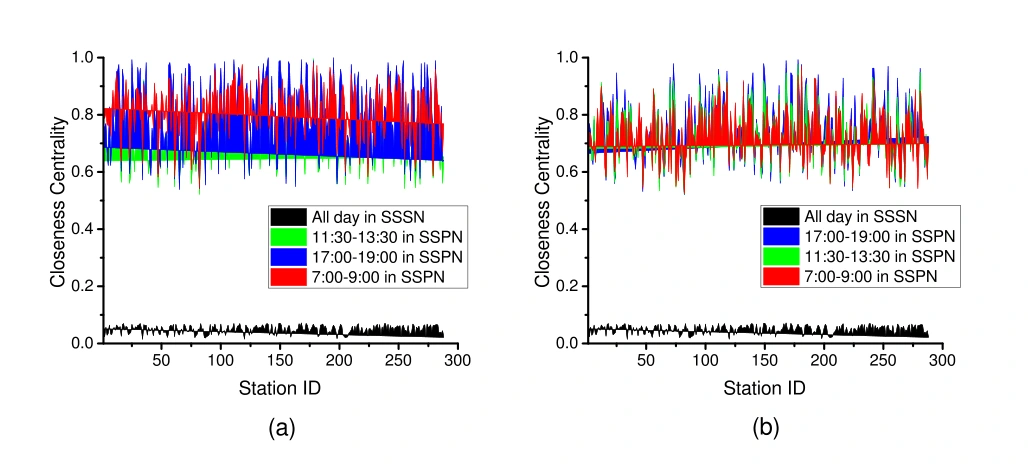
图 9|客流一密,车站到全网的距离是否集体变短?
横轴为车站编号,纵轴为接近中心性。(a)工作日。黑色静态网全天贴在底部;客流网的红(7:00–9:00)、绿(11:30–13:30)、蓝(17:00–19:00)抬到论文所写的 0.6 到 1.0 这一段,早晨红线更常顶到上沿。(b)周末。黑色仍然贴底,三条客流线仍在 0.6 以上。来源:原论文 Fig. 9。
相关工作里有一句话,把幂律度数安在小世界网络上,把短路径和高聚类安在无标度网络上。这与 Watts–Strogatz 小世界、Barabási–Albert 无标度的通常区分相反。本文能够单独成立的观察是上面这些度数、聚类和接近中心性的数值,而不是那一句网络类型的命名。
客流份额和线网指标,怎样合成一个分数?
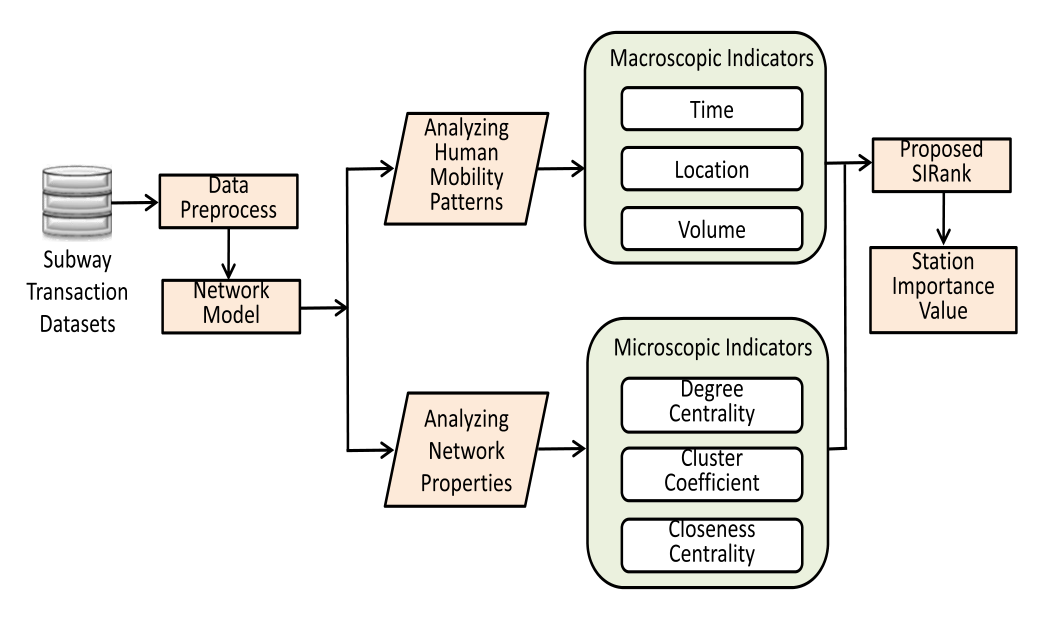
图 2|从刷卡表到一个重要性分数,中间经过哪两类指标?
左侧是地铁交易数据,先做数据预处理,再建成网络。一条分支分析出行模式,取出时间、地点和客流量;另一条分支分析网络性质,取度中心性、聚类系数和接近中心性。两类指标进入 SIRank,输出车站重要性。图中没有画出具体权重。来源:原论文 Fig. 2。
PageRank 的想法是:一个点的分数由连向它的点传过来,邻居越重要、分给它的份额越大,它的分数越高。网页版本常按出链条数平均分配。地铁里的人有相对固定的起终点,所以 SIRank 用客流替换这个份额。
车站 i 的重要性是两项加权:
SI(i) = α × SI_H(i) + β × SI_N(i)
客流项 SI_H(i) 把邻居 j 的当前分数,按“j 流向 i 的客流,除以 j 流向各邻居的客流之和”传给 i,再对 20 个时段平均,乘以阻尼 d,然后加上 (1 − d) / N。网络项是
SI_N(i) = γ × 度中心性 + φ × 聚类系数 + λ × 接近中心性
α 与 β 相加为 1,γ、φ 与 λ 相加为 1,五个数都在 0 到 1。N 是车站数。d 取 0.85,算法里每个站从 1/N 开始,变化不超过 0.00001 时停止。正文另写随机跳转概率为 0.1。0.85 对应的跳转权重是 0.15,与 0.1 不是同一个数;论文没有说明最终实验用的是哪一个。
伪代码里,网络项一度写成 SI_M,公式里则是 SI_N;停止条件的绝对值前后都写了 SI(i)。实验后文给出的是公式和权重,不是这条伪代码的逐行证明。他们用多元线性回归估计参数,但没有给出回归系数表、标准误或样本量。报告的比较结果是:α 相对高、β 相对低;β 达到 0.5 及以上时,度数高的站名次更高;β 为 0.9 时,SIRank 几乎等于按节点度的排名;β 不超过 0.3 时,排名偏向居住区车站。三个网络指标里,度中心性对命中率的影响大于另外两个,聚类系数的影响又小于接近中心性。
最终采用的一组是 α=0.6、β=0.4、γ=0.5、φ=0.2、λ=0.3。客流项的权重大于网络项。这组“最好”是相对后面的命中率而言。
他们还用人民广场和上海火车站做稳定性检查,记为 S1 和 S2。换用不同数据后,S1 始终排在 S2 前面。这只说明这一对的先后没有颠倒,没有给出全部 288 个名次的相关系数。
前几名对上规划换乘站,这个重合有多强?
论文认为当时没有统一的车站重要性标准,于是用规划中的换乘站当作参照。脚注给出的上海市轨道规划写明,到 2020 年将建成 12 条线和 26 座换乘站,并已公布位置。命中率等于 Ntr / Nse:分子是被考察的车站里,有多少座被这条规划选为新线换乘站;分母是被考察的车站数,也就是前 n 名的 n。分母不是 26,也不是 288。
这里有一个明确假设:提高运营效率是选择换乘站的首要因素,所以被选中的站应当获得更高的重要性名次。地理结构、造价和其他规划理由都被放在这个假设之外。命中率高,表示排名与这份名单重合得多。
对照方法有两个。WMIRank 用节点度和介数的加权组合,出自对北京地铁鲁棒性的研究。NDRank 按节点度排名。两者都在本文的上海网络上重新计算,不是把其他城市的旧名次直接拿来比较。
288 座站按名次排列后,SIRank 的分数从 0.02903 到 0.00061,NDRank 从 0.02715 到 0.00059,WMIRank 从 0.00713 到 0.00112。前两者头尾拉开得更开。拉开的幅度表示分数更能区分第一名和最后一名,本身还不等于命中更多换乘站。
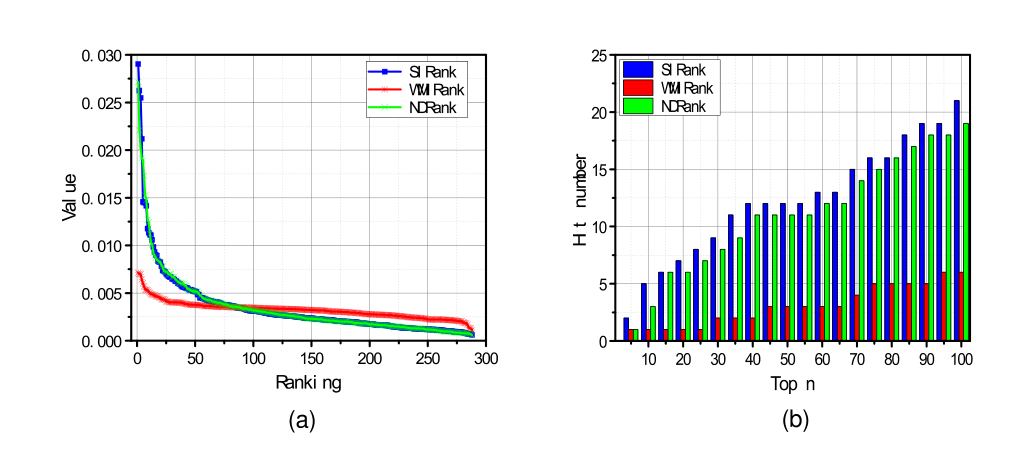
图 10|三种排名的分数差,和命中的换乘站数量,是否同一回事?
(a)横轴是 288 座站的名次,纵轴是排名分数。蓝色 SIRank 和绿色 NDRank 从正文给出的 0.02903 与 0.02715 一带快速下降,红色 WMIRank 从 0.00713 一带开始,头尾更接近。(b)横轴是前 n 名,纵轴是命中的换乘站数量。蓝色高于绿色,绿色高于红色;到 n=100 时,三根柱的高低与正文的 23%、19% 和 6% 同向。来源:原论文 Fig. 10。
正文写,n=10 时三种方法命中的换乘站数是 5、1 和 3。表 II 用下划线标出命中站,前 10 名分别能数到 6、1 和 3 个下划线。6/10 等于 60%,1/10 等于 10%,3/10 等于 30%,与后文“前 10 名命中率约 60%、10% 和 30%”一致;5/10 则是 50%,与“约 60%”不一致。摘要写的前五名 60%,对应表 II 前五名里的 3 个下划线,3/5 等于 60%。前 100 名没有逐站名单,只有命中率 23%、6% 和 19%。
表 II 的前 10 名如下。下划线在表中表示命中规划换乘站,这里用“命中”标出。正文的 People’s Square 与表中的 People Square 都指人民广场;Lujiazui 与表中的 Lujia Zui 都指陆家嘴。
| 名次 | SIRank | WMIRank | NDRank |
|---|---|---|---|
| 1 | 人民广场 | 世纪大道 | 人民广场 |
| 2 | 上海火车站 | 龙阳路,命中 | 上海火车站 |
| 3 | 虹桥火车站,命中 | 东方体育中心 | 徐家汇 |
| 4 | 龙阳路,命中 | 人民广场 | 虹桥火车站,命中 |
| 5 | 陕西南路,命中 | 巨峰路 | 南京东路 |
| 6 | 徐家汇 | 徐家汇 | 静安寺,命中 |
| 7 | 静安寺,命中 | 四平路 | 陕西南路,命中 |
| 8 | 中山公园 | 高科西路 | 中山公园 |
| 9 | 陆家嘴,命中 | 耀华路 | 宜山路 |
| 10 | 上海南站,命中 | 大连路 | 上海体育馆 |
SIRank 的前两名,人民广场和上海火车站,没有下划线。它在第 3 到第 5 名命中虹桥火车站、龙阳路和陕西南路,其后还有静安寺、陆家嘴和上海南站。WMIRank 的前 10 名只命中龙阳路,世纪大道占第 1。NDRank 与 SIRank 共享人民广场、上海火车站和中山公园,并命中虹桥火车站、静安寺和陕西南路。三种名单的前两名很不同,命中率的差别也主要来自第 3 名往后哪些站被算进规划换乘站。
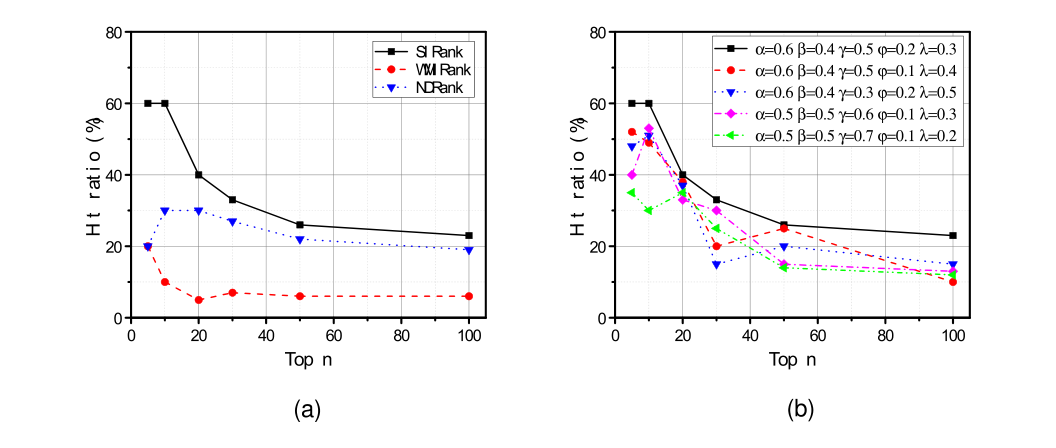
图 11|把名单放长,或者改五个权重,命中率还留在 60% 吗?
纵轴都是命中率,分母是横轴上的前 n 个站。(a)黑色 SIRank 在名单较短时位于 60% 附近,随 n 增大下降,到 100 时落到正文所写的 23% 一带;蓝色 NDRank 位于黑线之下,右端接近 19%;红色 WMIRank 降到 10% 以下后保持平直,右端接近 6%。(b)黑色是 α=0.6、β=0.4、γ=0.5、φ=0.2、λ=0.3,形状与(a)的黑线相同。其余四组为:红线把 φ、λ 改成 0.1 和 0.4;蓝线把 γ、λ 改成 0.3 和 0.5;品红线为 α=β=0.5、γ=0.6、φ=0.1、λ=0.3;绿线为 α=β=0.5、γ=0.7、φ=0.1、λ=0.2。正文写这些组合使命中率在 10% 到 60% 之间起伏。来源:原论文 Fig. 11。
论文把黑线这组权重称为效果最好,并写明客流模式的贡献大于其他指标。图 11 同时表明,n 从名单最前面放到 100 时,60% 的优势会降到 20% 出头。前 100 名上,SIRank 的 23% 与 NDRank 的 19% 只差 4 个百分点,分母同为 100 个站。
重合更高,能说明到哪一步?
命中率是排名名单和一份规划换乘站名单的重合比例。它支持的结论是:在这套权重和这个参照下,SIRank 的前部名单比 WMIRank、NDRank 覆盖更多被规划点名的站。它没有记录规划部门是否看过客流、造价或行政边界。26 座换乘站是否全都已经存在于 2015 年的 288 座车站之中,正文也没有逐座说明。尚未建成的站不可能出现在当时的排名里。
最短路径是假设。若有人多换乘一次以避开拥挤,客流仍记在起讫站上,中间站的重要性不会按真实经过次数增加。大圆距离等于 6370 公里半径下的直线距离,不包含轨道绕行。
三个网络公式与后文数值不能互相回代。度中心性公式的上限是 1,图 7 的纵轴到 3。聚类系数的印刷公式会给出远小于 0.001 的数,图 8 和平均值却在 0.003125 与 0.8 这一量级。接近中心性达到 1,与“路径长度之和的倒数”不能同时描述 287 座其他车站。排名使用了这些指标,读者无法只用印刷公式把分数重算一遍。
稳定性只检查了人民广场始终排在上海火车站之前。前 10 名的命中座数在正文里写成 5,在表 II 的下划线里是 6。使用前 10 名的命中率时,需要同时看见这两个数。
数据是 2015 年 4 月一座城市的地铁刷卡。结论不能直接换成公交、出租或后来开通的新线,尽管论文认为那些网络也可以试用同一方法。地铁受路口信号和路面拥堵的约束较少,这是论文给出的适用范围,不是其他方式已经得到相同命中率的证据。
一句话总结
在 2015 年 4 月的上海地铁里,用双向客流份额分配分数后,排名前部与规划换乘站的重合高于只数连线、也高于度加介数;这份重合的分母是前 n 个站,它还留着公式、路径假设和前 10 名两种计数之间的缝。
核心来源
- IEEE Xplore 论文页面,题目、作者、卷期页码与 DOI 以期刊首页为准。本文图 1 至图 11 和全部数值都来自这一版本的正文、表 I 与表 II。
- 规划参照在论文脚注中写为 12 条线、26 座换乘站,网址为
http://www.envir.gov.cn/docs/2016/20160418709.htm。正文没有附上这 26 座站的完整名单,前 10 名的命中只能从表 II 的下划线读出。
期刊 PDF 没有补充材料和附录数据表,也没有公开代码或回归系数表。
作者介绍
以下只采用论文署名和文末作者简介里的身份,不把 2020 年的职务写成现在的职务。
- Feng Xia:浙江大学学士、博士,曾任昆士兰科技大学研究员。论文署名为大连理工大学软件学院、辽宁省泛在网络与服务软件重点实验室。作者简介中的研究方向包括数据科学、大数据、知识管理、网络科学和系统工程。IEEE 与 ACM 高级会员。
- Jinzhong Wang:2002 年获鞍山师范学院计算机教育学士,2005 年获辽宁大学计算机应用技术硕士。论文发表时在大连理工大学软件学院攻读博士,并任沈阳体育学院副教授;署名同时包括沈阳体育学院管理与新闻传播学院。研究方向是交通数据分析与移动社交网络。
- Xiangjie Kong:通讯作者,2009 年获浙江大学博士。署名为大连理工大学软件学院副教授,联系邮箱为 xjkong@ieee.org。研究方向是交通大数据、社会计算和信息物理系统。IEEE 高级会员。
- Da Zhang:2010 年获大连理工大学软件工程学士,2012 年获俄亥俄州立大学计算机科学与工程硕士。论文发表时在迈阿密大学电子与计算机工程专业攻读博士,并担任助教。署名单位是迈阿密大学。研究方向包括知识图谱、大数据、网页语义和深度学习。
- Zhibo Wang:2007 年获浙江大学自动化学士,2014 年获田纳西大学诺克斯维尔分校电子工程与计算机科学博士。署名为武汉大学网络空间安全学院副教授。研究方向包括移动群智感知、物联网、网络安全与隐私保护。IEEE 高级会员。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
前 100 名上,SIRank 与 NDRank 的命中率是 23% 和 19%,同样以 100 个站为分母,只差 4 个百分点。前 10 名的文字结果则是大约 60% 对 30%,或者另一句里的 5 座对 3 座。若一份名单只采纳最前面几座站,客流项改变的是少数关键座位;若要筛出上百座备选站,按度数排序已经离 SIRank 很近。同一个算法会因为名单长度不同而值回不同的价钱。
β 不超过 0.3 时,居住区车站上升,而论文为命中率选出的是 β=0.4。早高峰运力、接驳公交和车站商业要服务的车站并不相同。若目标是早晨从通河新村、九亭、莘庄发出的那一端,为“对上新线换乘站”调出的权重,可能系统地压低这些起点。权重最优只在命中率这一种比较里成立。
世纪大道的晚高峰接近中心性为 1,WMIRank 把它放在第 1,SIRank 的前 10 名没有它。若要问摘掉一座站以后,其余站之间的最短路径会延长多少,四线交会的枢纽和客流分配分数会排出两张表。论文把维护投资、新线规划和应急都写成用途,检验的参照却只有换乘站重合。换一个损失,名次可以整表重排,而且这种重排要用路径或客流的另一种汇总才能看见。