知道地铁站旁边是什么地方,就能判断乘客为什么出门吗?
论文名片|Xia Zhao、Yong Zhang、Ying Li、Baocai Yin、Hao Liu,Inferring Heterogeneous Mobility Patterns Based on Station Functionality and Spatiotemporal Travel Regularities in Urban Subway,会议论文,2017年1月。稿面标注投稿日期为2016年8月1日,字数为5,598词,另按每张图250词计入7张图,合计7,348词。PDF未印DOI,也未印会议名称。ResearchGate:332142156。署名页列出上述五人;封面写7 authors, including,没有印出另外的姓名。
工作日早上,回龙观、西二旗一站接一站地吐出下车的人,国贸也在进人。中午过后,西单和南锣鼓巷仍有人刷卡。这些记录在卡里都只是进站时间和出站时间。若只按一个月坐了多少次把人分成常客和偶尔坐地铁的人,会漏掉一件事:常客不一定都在上下班,一个月只坐一两次的人也不一定是来旅游。
这篇论文用2013年6月的北京地铁刷卡,加上车站周边1公里内的兴趣点,先给车站标上功能,再按次数、时长和功能把乘客分成五类,并给每类补一个出行目的。人数最多的两类,在比例上接近《2013年北京交通发展年报》里的固定出行和生活出行。年报的分母是全部出行次数,论文的分母是乘客人数。后三类的名称,包括把高频短时出行说成偷窃、乞讨或快递,是看到规律之后的推测。卡上没有目的字段。
先说结论
- 线网有17条线、270个站、近400条相邻站连线。站点功能用站区半径1公里内的236,040个兴趣点来推,潜在狄利克雷分配选出8个功能。
- 2013年6月1日至30日的刷卡超过1亿条,乘客11,450,928人,全部进入K均值聚类。五类占这些乘客的35.75%、48.17%、2.40%、4.18%和9.50%,加总为100%。
- 按上述百分比回乘总人数,五类大约是409.4万、551.6万、27.5万、47.9万和108.8万人。论文没有单列人数;百分比只印到小数点后两位,每一类因此还有大约几百人的舍入余地。
- 摘要把客流最高的三类功能写成商业、教育或医疗、居住,正文对应s5、s6、s2。正文没有给出这三类各自的客流份额。
- 刚性类48.17%的乘客、弹性类35.75%的乘客,被拿去对照年报里占全部出行44.25%的固定出行和37.12%的生活类出行。后三类合计16.08%的乘客,对照年报中近18.63%的“其他”出行。两组百分比的分母不同。
刷卡记下的是进出站,不是出门的原因
研究对象是持卡人,不是单次刷卡,也不是全市人口。地铁卡数据给出卡号、进出站时间、线路号和车站号。论文要解释的是:只靠这些记录,再加上车站周边是什么场所,能否把人分成几种出行模式(mobility patterns),也就是一组人在次数、时间和地点上反复出现的方式。
兴趣点(points of interest,POI)是带坐标和类别的地点,例如居住、商场、学校、医院。作者把每个站周围半径1公里的圆叫做站点影响区,理由是这个距离适合步行。236,040是落在这些圆里的兴趣点数,不是北京全市兴趣点总数。相邻站的圆会重叠,论文没有说明同一个兴趣点是否被重复计入多个站,因此不能把236,040除以270当成每个站独占的点数。
一个月的数据经过预先清洗,并重构成用于聚类的行程。清洗规则引自另一篇智能卡论文,本文没有写出删掉多少条脏记录,也没有写出清洗后还剩多少条交易。“超过1亿条”因此不能再算出精确的人均刷卡次数。
作者还引用年报说,地铁占全部公共交通客流的40%以上。这是年报里的流量份额,分母是公共交通客流,不是这11,450,928人,也不是本文自己算出来的数。
车站功能是怎样从周边地点里推出来的?
一个站周围往往同时有商店、餐馆和住宅。作者没有让人先规定“这个站是居住站”,而是把站区当成一篇文档,把兴趣点类别当成词语,用潜在狄利克雷分配(latent Dirichlet allocation,LDA)去找隐藏的主题。这里的主题被解释成站点功能。
模型在主题数2到10上各训练,最多300次迭代,每50次迭代调整一次参数。先验沿用所引LDA文献的常用设置:α=50/K,β=0.01。K取8时,α就是6.25。这两个数不是用一份“真实出行目的”标签调出来的。
选8的依据是困惑度。困惑度越低,模型对已经看到的兴趣点类别越不意外。它衡量的是兴趣点分布好不好被主题解释,并不直接等于功能标签和城市规划一致。论文写150次迭代时困惑度最小,再在这一次迭代上比较主题数,最小出现在8个主题。
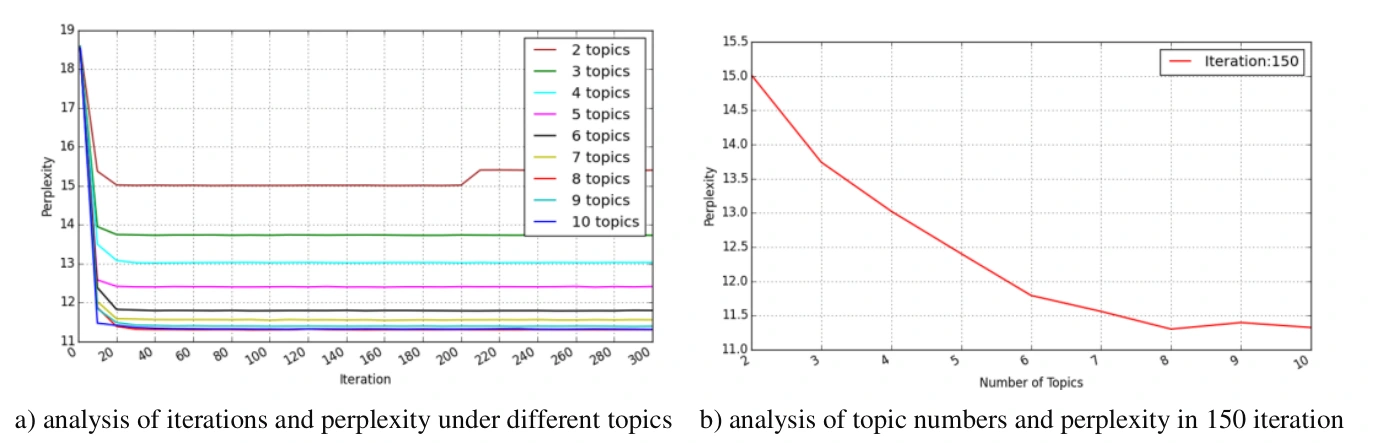
图 2|功能要分成几类,模型自己的惊讶程度怎样变化?
(a)横轴是迭代次数,纵轴是困惑度,9条线分别是2到10个主题。多数曲线在大约40次迭代后走平;2个主题的曲线在200次迭代之后还有一次抬升。正文把150次迭代定为后续比较的位置。(b)固定在150次迭代,横轴是主题数。从图上读,2个主题时困惑度接近15,随后下降,8个主题落到略高于11的位置,9和10与8非常接近。正文没有列出困惑度的具体数字,也没有做统计检验来证明8显著优于7或9。来源:原论文 Fig. 2。
每个站因此得到一个8维的功能比例。作者再对这个比例做K均值聚类,距离用欧氏距离,聚类前先做归一化。类数也取8,标记为s0到s7。困惑度本来是在选LDA的主题数,这里同时被当成站点聚类的类数。两类“8”被绑在一起,论文没有单独展示“主题取8、站点却聚成别的类数”会怎样。
聚类之后,还要用频率密度给每一类起名字。某一类兴趣点的频率密度等于它在站区内的个数除以站区面积。密度最高的类别被当作这个站区的代表功能,表里同时给出内部排序。颜色越深,密度和排序越高。
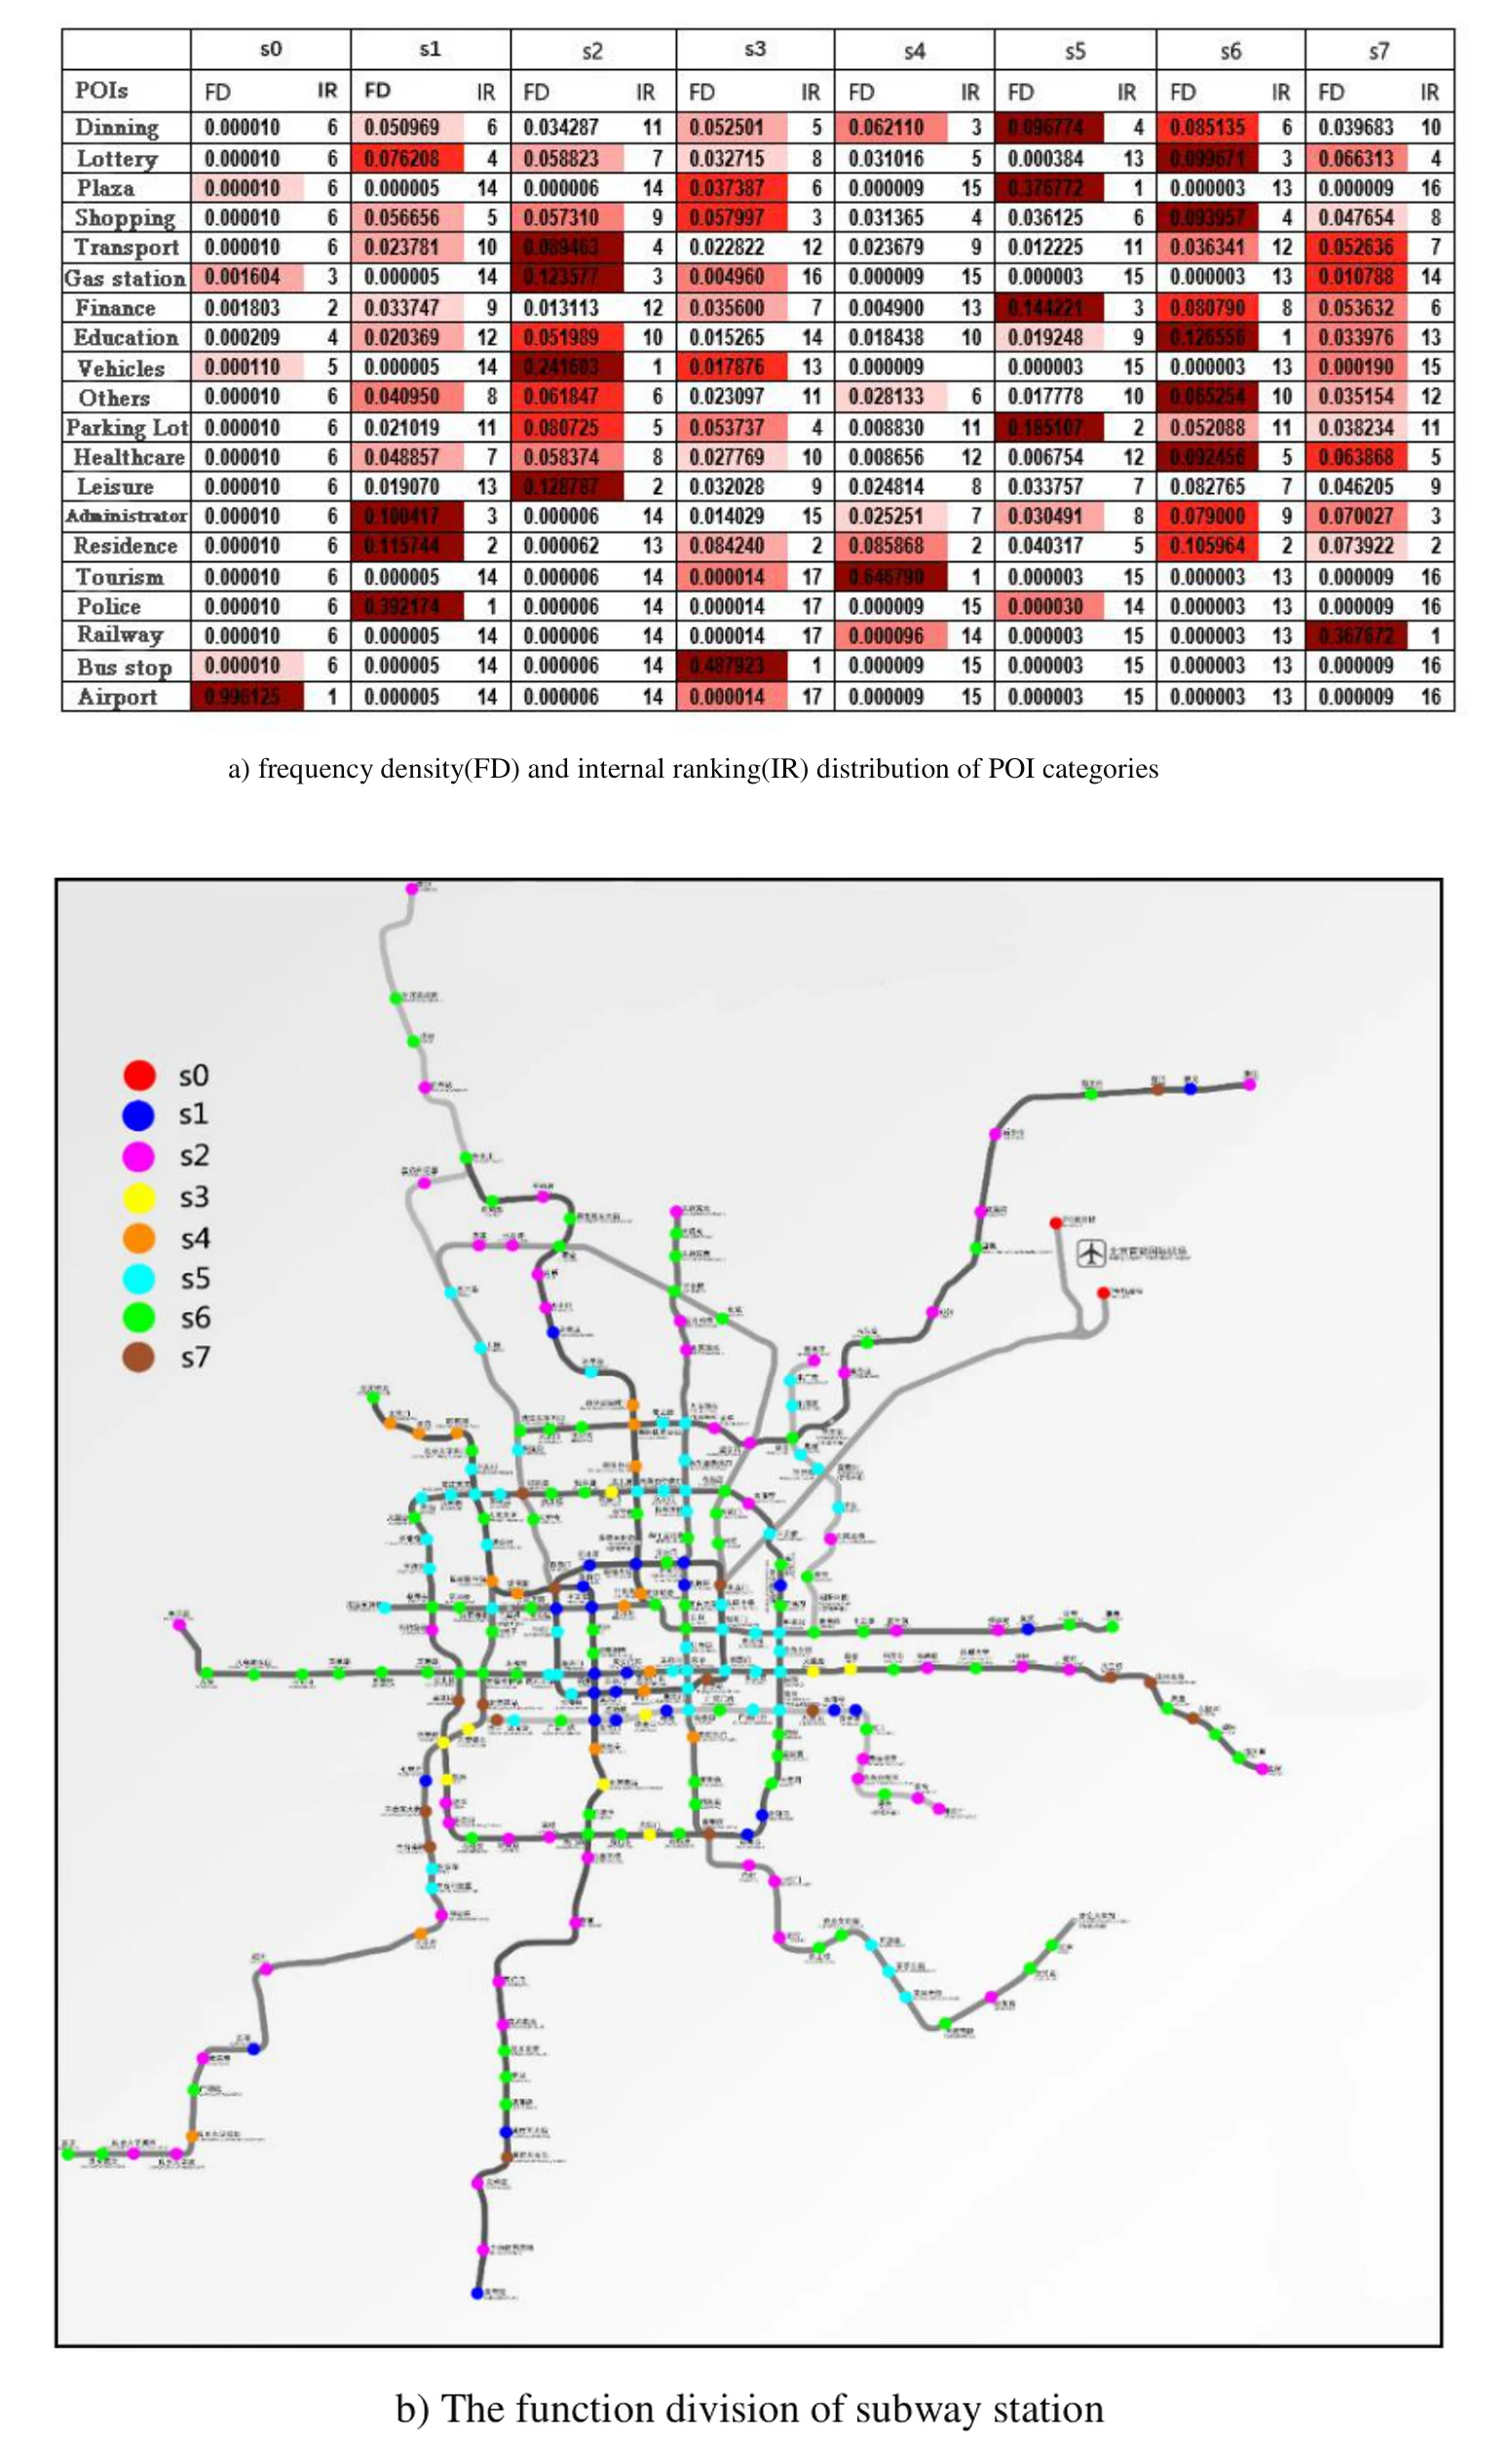
图 4|八类车站各自被什么兴趣点撑起来,又落在线网的哪里?
(a)行是兴趣点类别,列是s0到s7。每一列有频率密度FD和内部排序IR,红色越深越高。正文没有逐格抄这些小数,代表功能由作者结合最深的格子和站区位置写成下面八类。(b)北京地铁图上的功能分区,图例为s0红、s1蓝、s2品红、s3黄、s4橙、s5青、s6绿、s7棕。机场线东北端为红色,中心区能看到成片蓝色,外围放射线上品红色较多,绿色分布很广。来源:原论文 Fig. 4。
八类在正文中的说法是:
- s0机场:T2、T3两个站,连接机场线,另有少量加油站、银行和餐馆。
- s1政务:二环内的26个站,政府机构和公共组织密度高。
- s2居住:四环外的55个站,餐馆、银行和体育场所用来支撑日常生活。
- s3长途汽车:9个地铁站,周围有31个不同规模的长途汽车站。31个数的是汽车站,9个数的是地铁站。
- s4风景:文中写有16处代表性历史地点,举例故宫,附近有餐馆和酒店。这里的16处是历史地点,正文没有给出这一类的车站数。
- s5商业:24个站,举例CBD和文中所称的中国硅谷,并有餐馆、银行、商场和停车场。
- s6教育或医疗:二环到四环之间的86个站,教育和医疗兴趣点密度高但不均匀,商场和便利店也很常见。
- s7铁路:16个站,举例北京西站,交通枢纽密度高。
除s4外,正文写出的车站数是2+26+55+9+24+86+16=218。线网一共270个站。s4又没有给出车站数,所以这些句子不能加总成一套完整分区。地图看起来给站着了色,论文没有附上每个站的归属表。
作者用北京城市总体规划(2004–2020)作对照,并举了一个能核对的例子:政府和市政机构大多在二环内,与s1的位置一致。其余类别被说成同样吻合。PDF里没有规划图,也没有逐站正确率。
还有一处地点归属需要并读。站点功能一节把故宫当作s4的例子;后文写c3时,又把故宫当作带有游览功能的s1的例子。论文没有解释同一个地点为什么出现在两类里。
五类乘客是怎么定下来的?
功能只说明车站周边是什么。一个人是不是每天同一时间、往返同一类站,还要看他自己的刷卡。作者为每名乘客做了一个9维向量,再做第二次K均值。聚类前同样归一化。
九个特征分成三组。频率:6月的出行次数;该月每天次数的最大、最小和平均;有规律出行的天数。规律行程指首次上车时间相近、车站编号序列相近、路径序列相近,阈值写在被引用的智能卡论文里,本文没有重写。时间:单次行程时长的平均、最大和最小。空间:行程所属的站点功能类别。一名乘客有多次行程,第九个特征如何从多次行程收成一个类别,正文没有写明。
类数看误差平方和(sum of squared error,SSE):每个乘客到自己类中心的距离平方,再对所有类相加。因为向量已经归一化,图上的0.10不是“10%的乘客”,也不是原始次数的平方和。
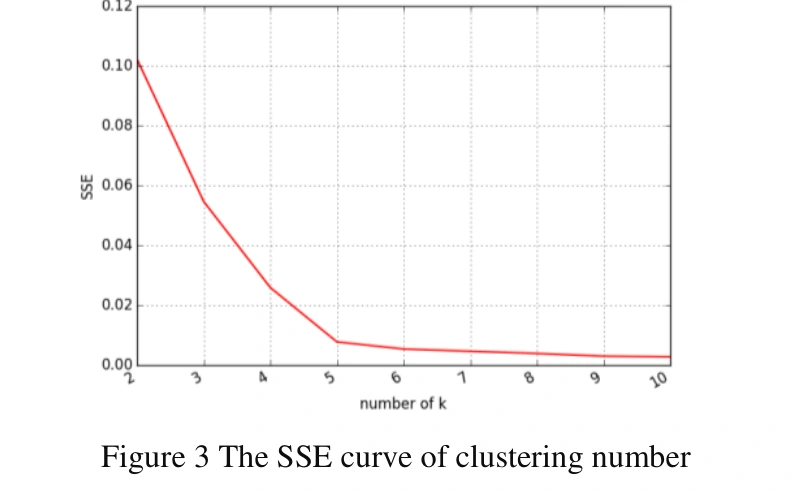
图 3|乘客应该分成几类,类内离散程度在哪里变缓?
无字母子图。横轴是类数k,纵轴是SSE。k=2时曲线约在0.10;到k=5已降到0.02刻度以下,之后继续缓降,右端比k=5更低。下降在5之前快、在5之后慢。正文写SSE在k趋于5时达到最小,并补充说实际出行目的不少于5类,例子包括上班、上学、购物、出差、游览和快递。这张清单已经举出6类,而且是选择类数时的经验名单,不是聚类算法输出的标签。来源:原论文 Fig. 3。
五类记为c0到c4,11,450,928人全部分进去。平行坐标把这九个特征并排画出来:一条折线是一种乘客向量的走向,颜色是聚类结果。
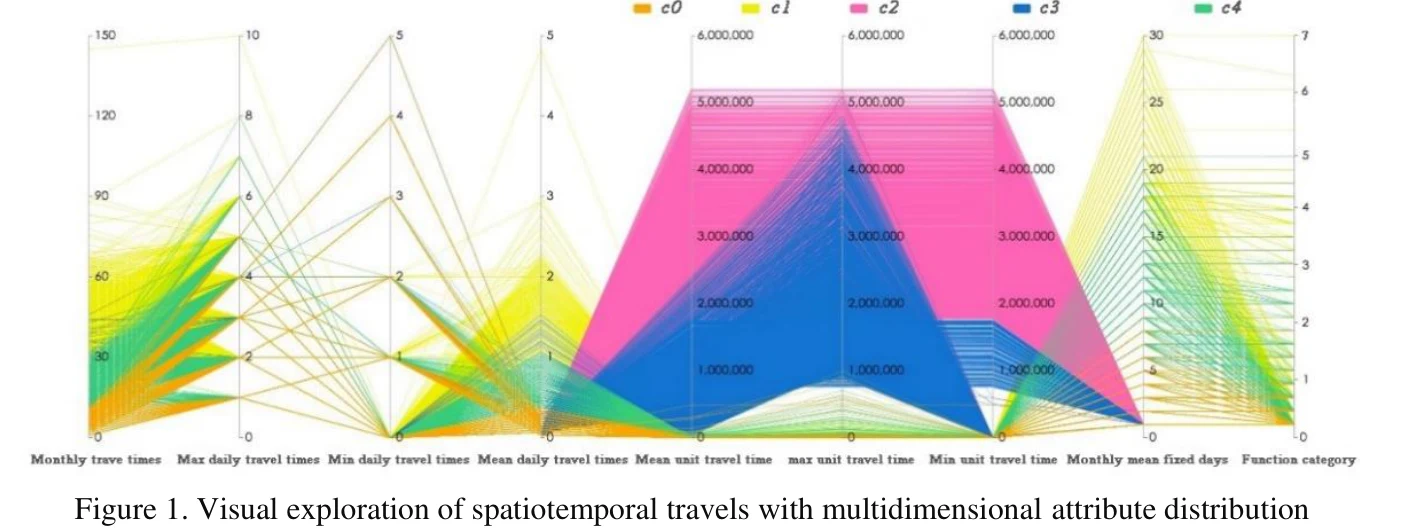
图 1|五类乘客在次数、时长和功能上拉开了吗?
无字母子图。从左到右九根轴依次是月出行次数、每日次数的最大、最小和平均、单次时长的平均、最大和最小、每月规律天数、功能类别。颜色为c0橙、c1黄、c2粉、c3蓝、c4绿。月次数轴标到150,每日次数轴分别标到10、5和5,规律天数标到30,功能类别标到7。三根时长轴的刻度印到6,000,000,论文没有说明这个数的单位。后文用分钟描述各类时长,并没有把分钟换算到这三根轴上。因此分钟范围以正文叙述为准,图上能看清的是相对位置:黄色在月次数和规律天数上整体更高,粉色在时长轴上抬得最高,蓝色在时长上拉得很开,橙色贴在月次数的底部,五种颜色都横跨功能类别轴。来源:原论文 Fig. 1。
每一类占多少人,他们出站的地方像不像?
人数占比回答“这类人多不多”。出站流量占比回答“这类人的到达记录落在哪些功能的站”。两件事的分母不同。
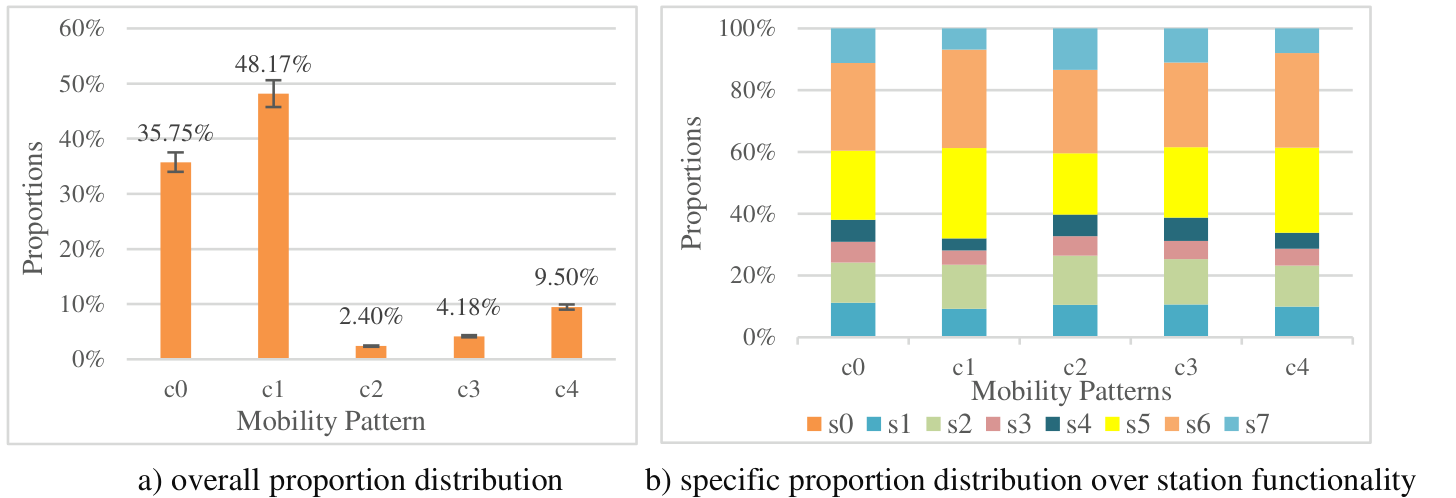
图 5|五类人各占多少,出站流量是否都挤在同一类车站?
(a)横轴c0到c4,纵轴是占比。柱顶数字为35.75%、48.17%、2.40%、4.18%、9.50%,分母是全部11,450,928名乘客,五数之和为100%。每根柱都有误差线,正文没有说明它是标准差、标准误还是重复实验的波动。(b)每根柱都画到100%,图例s0橙、s1蓝、s2浅绿、s3粉、s4深青、s5黄、s6浅橙、s7青。黄色的商业和浅橙色的教育或医疗在每根柱里都比较厚,浅绿的居住也清楚,五根柱的厚薄结构相近。正文没有印出各色块的百分比。来源:原论文 Fig. 5。
公式(13)写的是:某一类在某一种功能上的出站流量,除以全部类别、全部功能的出站流量。若严格按这个分母,每根柱的高度应等于该类占全部出站流量的比例,五根柱加起来才是100%。图5b却把每一根都画成100%。按图的画法,它表示的是每一类自己的出站流量内部,八种功能怎样分配。图和公式用了两种归一化。下面只采用图上看得清、正文又写明的结论:人数最多的乘客经常到达s6、s5或s2,而且五类的功能构成没有明显差别。
作者把这种相似归因于总体规划强调区域之间均衡、集约、多中心。若预定目的地太费时间,人可以改去另一个能完成同样活动的地区。这是对规划文本的解释。图5b本身只说明功能构成相似,不能单独证明人们确实因为多中心而更换了目的地。
地图上的大圆和一天的颜色,能把目的钉死吗?
人数和功能构成仍然没有回答“这群人几点到、进站多还是出站多”。作者又画了两类图。空间图只保留每个模式到达量最高的15个站,到达量是该站进站与出站之和。圆的大小表示流量;粉色是进站,黄色是出站,绿色是二者之差。不同面板是分开的地图截图,论文没有给统一比例尺,所以不能拿两张图里圆的直径直接比绝对人数。
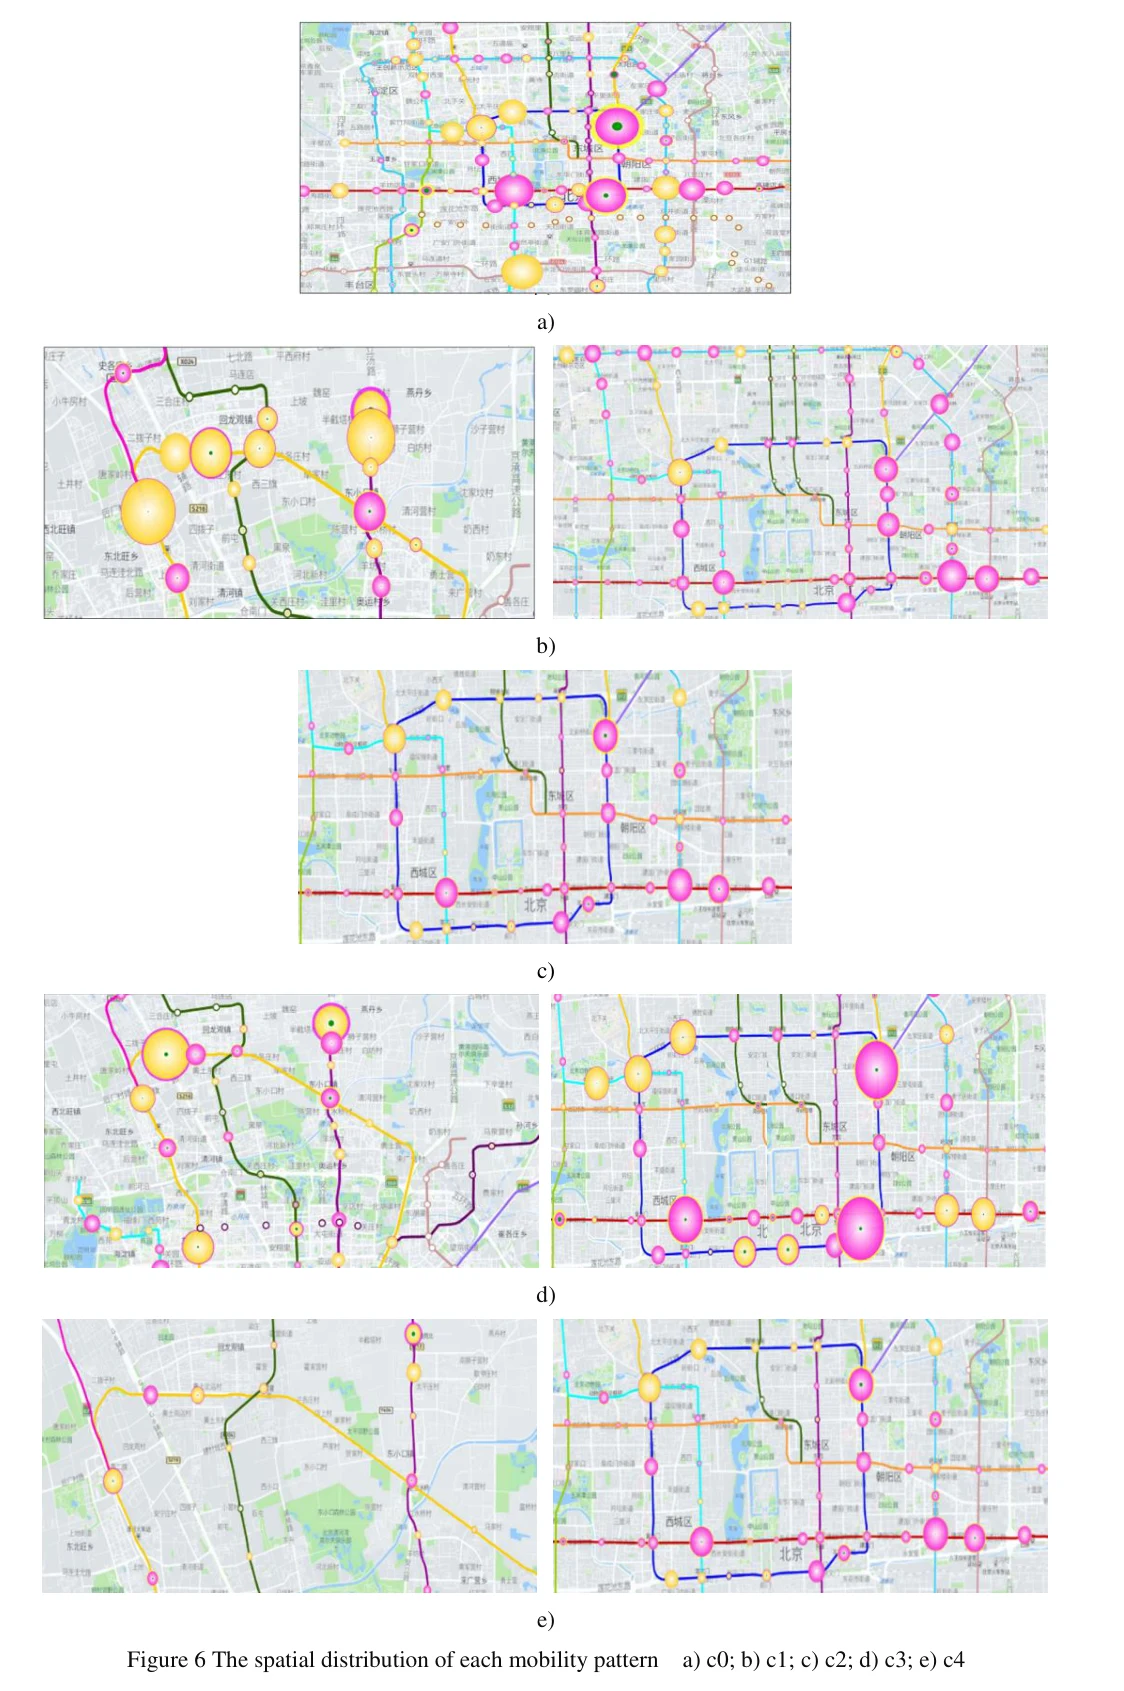
图 6|每一类乘客的前15个站,落在城中心还是外围?
(a)c0,一张中心城区图,大圆集中在中心。(b)c1,左右两张图,一张偏北、黄圆更大,一张仍在中心城区。(c)c2,一张中心城区图。(d)c3,同样是北侧一张、中心一张。(e)c4,也是北侧与中心各一张。粉色、黄色、绿色按正文分别表示进站、出站和两者之差;粉圆常带着黄边,是两种圆叠在一起。每张图都只含到达量前15个站。来源:原论文 Fig. 6。
时间图只取2013年6月4日,星期二。横轴从凌晨4点到晚上11点,每小时一格;纵轴是s0到s7。论文因为出行有周期性,只用了这一个工作日。周末是否一样,图里没有。图上也没有色标数值,深色只表示在该面板内部相对更高。
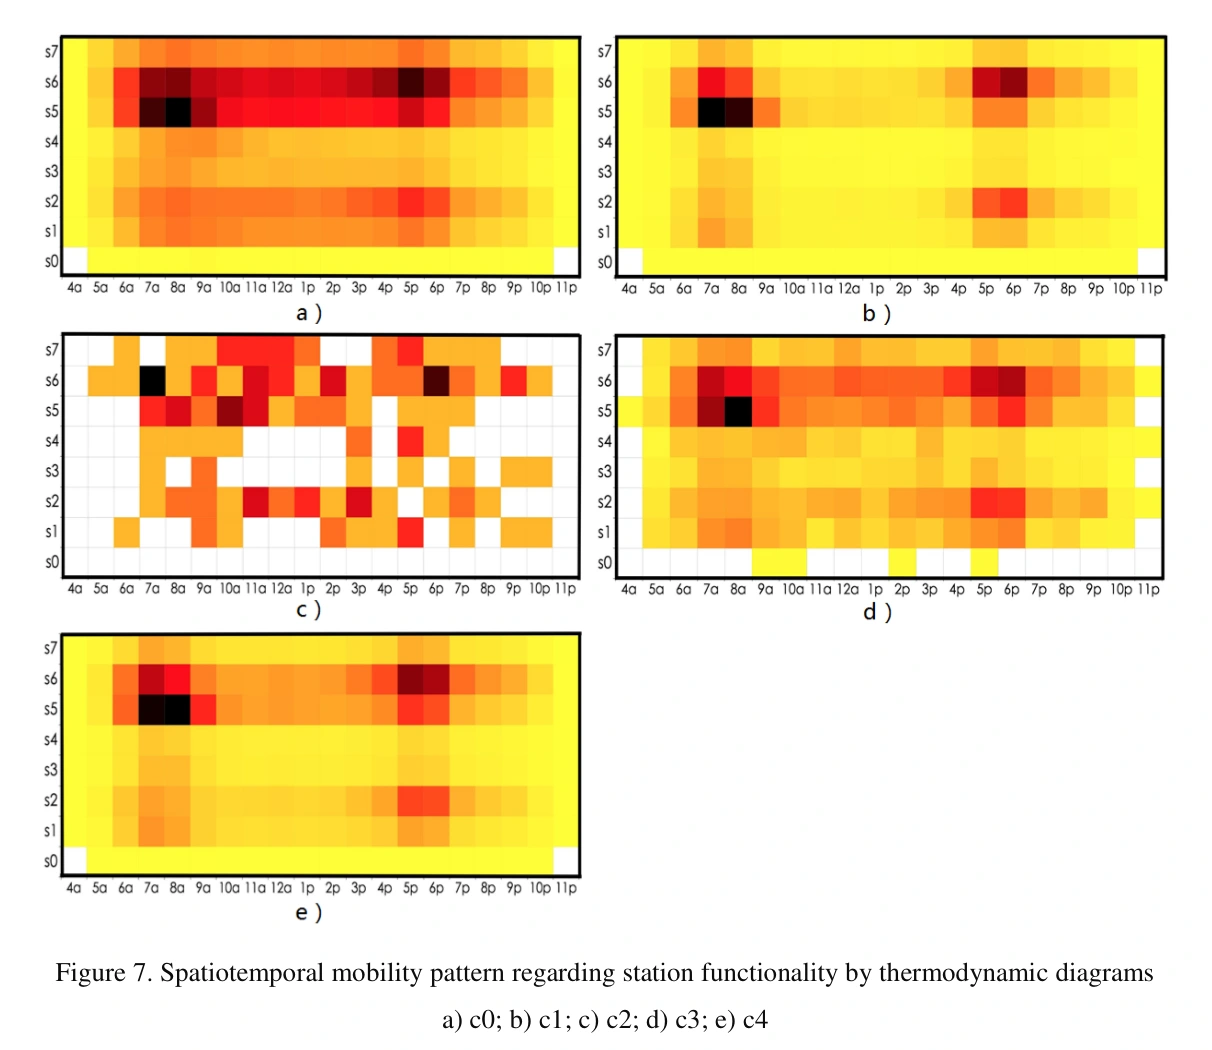
图 7|同一个周二,五类乘客的到达集中在高峰还是散在全天?
(a)c0整天都有颜色,s5、s6两条横带更深,早晚尤其深。(b)c1最集中:早晨s5、s6有深格,傍晚s6和s2再深一次,其余时间淡。(c)c2最碎,有发白的格子,也有散布的深格。(d)c3又变得连续,早晨s6深,傍晚s2深。(e)c4早晨s5、s6深,傍晚s6深,s2在午后到傍晚也变深。五个面板的s0一行都保持很浅。正文据此写s1到s7能看到早高峰6点至9点和晚高峰17点至19点,机场类s0没有这种高峰。来源:原论文 Fig. 7。
把占比、前15站和这一天的热力合在一起,作者给五类起了名字。名称是解释,下面按正文的范围转述,并标出解释停在哪里。
c0被叫做随机出行或弹性出行,占乘客35.75%。正文写他们每月至多出行1到5次,平均单次时长30到90分钟,可以在一天里的各个时段出现,不只是高峰。代表站区在三环内的大型换乘枢纽和铁路车站,例子有s1西单、s7北京西站、s5国贸、s6南锣鼓巷。南锣鼓巷被放在教育或医疗类的例子里,这只说明作者如此归类,不表示该站周边只有学校和医院。作者推测目的包括购物、访友、吃饭、休闲和私事。依据是时间和起终点都比较灵活。
c1被叫做刚性出行,占48.17%。正文写他们每月出行23次或65次,规律天数20到30天,平均时长同样是30到90分钟。图1的月次数轴一直标到150,黄色线是一条宽带,不是23和65两个孤立的点,所以“23次或65次”应理解为作者对这一类的概括,而不是只观察到这两个整数。活动范围写到六环内。早晨集中到达s5或s6,例子有国贸、西二旗和清华大学;傍晚集中到达s2或s6,例子有回龙观和天通苑。作者据此把他们解释成工作日固定时段、往返住家和固定工作地或学校的通勤者。热力图(b)的早晚深格和这个叙述最相配。它仍是聚类之后的命名:数据里没有职业,也没有“家”和“单位”的问卷。
c2占2.40%,正文有一处写成2.4%,图5a的标签是2.40%。他们每月1或2次,平均单次时长超过90分钟,长于其他类。主要出现在四环内,例子有s7北京站、s6东直门和积水潭、s5国贸、s2劲松。正文写这些站的进站流量明显高于出站流量,但没有给出差值或比值;图6又只画了前15个站。作者推测他们办理离京或抵京,目的可能是短期公务或休闲。进站多于出站,和“从这些站离开”更直接;“抵达北京”同时被写进同一段,图上没有第二套数字把两件事分开。
c3占4.18%。每月1到12次,平均时长30到50分钟,最长可以达到或超过90分钟。例子有s4颐和园、被写成兼有游览功能的s1故宫,以及s6的北京大学和北医三院,位置在北京北部或四环内。作者推测这是来京观光或就医,并写他们可能从外省坐火车来。刷卡记录没有籍贯。外省来京是由铁路站、景区和医院这些地点推出来的。
c4占9.50%,约108.8万人。相对前两类少,但不是可以略去的零头。每月12到34次,平均单次时长短于30分钟,经常出现在四环内或北部的s5、s6,而且不限于高峰。作者认为这和上班、上学、就医的时间与频率都不一样,于是推测目的可能是偷窃、乞讨、快递或其他异常活动,并写明还需要警方证据。所附参考文献是加州短途出行需求模型,不是犯罪或快递运单。热力图(e)仍有早晨和傍晚更深的格子,所以“任何时间都能到”和“高峰格仍然更深”在图上同时存在。
摘要和结论用三句话概括后三类:低频进入北京,例如观光潮、就医潮;频率不定的离京,例如公务和返乡;市内高频异常,例如乞讨、偷窃、快递。各节的叙述对不齐这三句。观光和就医写在c3,离京公务写在c2,而c2的标题又是低频、长时。结论没有逐一声明c2、c3、c4分别等于哪一句。
和年报对上的,是乘客还是出行次数?
验证用的是两份官方材料,不是给乘客重填的出行目的问卷。车站功能对照总体规划,上节已经说过,那是位置上的定性吻合。出行模式对照《2013年北京交通发展年报》。
年报把出行目的分成三类,分母都是全部出行:固定出行占44.25%,包括通勤、通学和接送,次数、时长和常去地点比较固定;生活类出行占37.12%,包括购物、吃饭、访友、娱乐和私事,次数、时长和地点比较随机;其他约占18.63%,年报没有再拆开。44.25%+37.12%+18.63%=100%。
作者认为固定出行对应c1,生活类对应c0,其他对应c2到c4。c1是48.17%的乘客,c0是35.75%的乘客,c2到c4合计2.40%+4.18%+9.50%=16.08%的乘客。数字彼此接近。比较的两边一个数的是出行次数,一个数的是人数。一个人一个月可以有许多次出行,通勤者贡献的出行次数会高于他在人数里的份额。论文没有把五类再换成出行次数后重新计算,因此“比例吻合”是这两种分母之间的接近,不是同一张表上的复现。
年报里的“其他”没有目的细类。本文用c2、c3、c4把这18.63%的出行缺口说成离京、来京和市内高频短时。这个推进依赖前面的推测。它填上了名称,没有填上一份被目的标签核对过的准确率。
一句话总结
车站周边的兴趣点和一个月的刷卡规律,可以把2013年6月北京地铁的11,450,928名乘客分成五类,并让人数最多的两类在比例上接近年报里的固定出行和生活出行;卡上仍然没有目的,后三类叫什么,还是解释。
核心来源
- 本文PDF:Xia Zhao、Yong Zhang、Ying Li、Baocai Yin、Hao Liu的会议论文稿,ResearchGate标注2017年1月,稿内投稿日期为2016年8月1日。稿内为20页正文,另有封面,图1至图7。PDF未印DOI。ResearchGate页面。
- 文内用于对照的《北京市城市总体规划(2004–2020)》和《2013年北京交通发展年报》。规划图和年报原表不在这份PDF里,44.25%、37.12%、18.63%以及“地铁占公共交通客流40%以上”都是论文对年报的引用。
- 数据致谢写明来自北京信息中心和北京TOCC。论文没有展开TOCC的全称,也没有描述抽样流程。
作者介绍
五人的身份以论文署名页为准。
- Xia Zhao:投稿时为北京工业大学城市交通学院、多媒体与智能软件技术实验室博士生。ResearchGate封面把他的单位写成北京建筑大学,与稿面不同,属于封面页上的后来信息。
- Yong Zhang:同上实验室,助理教授,通讯作者。
- Ying Li:同上实验室。署名页没有写学位或职称。
- Baocai Yin:同上实验室,教授。
- Hao Liu:北京市交通信息中心研究员。论文致谢中的数据提供方写的是北京信息中心和北京TOCC,与这个署名单位并列表述。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一个人完全可能在工作日像c1、在周末像c0。论文把6月压成一个9维向量,热力图又只给了6月4日这一个周二。若把工作日和周末分开各聚一次,就能看到c1里有多少人一到周末就掉进弹性类。留在原类的人,更接近“这个人有稳定行程”;掉出去的人,更接近“工作日时刻表制造出来的稳定”。两种结果会把“刚性”从人的属性改写成日历的属性,而本文的一次聚类还分不开它们。
c4的短时、高频、又出现在商业和教育医疗站,也会是快递、巡站人员,或住在站边、一天里多次短乘的人留下的轨迹。论文把偷窃、乞讨和快递写在同一个推测里,并声明需要警方证据。若要把9.50%的乘客,大约108.8万人,拿去做异常监管,先要有一批已知职业的卡:在同样的次数和时长里,快递和工作人员占多少。没有这个分母,高频短时只说明使用方式极端,说明不了行为是否违规。