一条街上的餐厅,能估出这里白天有多少人、开了多少公司吗?
论文名片|Lei Dong、Carlo Ratti、Siqi Zheng,Predicting neighborhoods’ socioeconomic attributes using restaurant data,Proceedings of the National Academy of Sciences,2019,116(31):15447–15452。2019年7月15日在线发表,2019年7月30日见刊。DOI:10.1073/pnas.1903064116。本文依据这一正式发表版。研究类型是网格尺度上的预测:餐厅特征去拟合已经整理好的人口、企业和消费,不是随机实验。
假如要回答“这几公里白天有多少人上班、夜里有多少人住、注册了多少企业、刷了多少卡”,普查通常十年一次。论文写到,北京、上海这类大城市里,多数社会经济数据库公开时只到区县,空间上往往不到 20 个点。大众点评上则已经有餐厅的位置、菜系、人均价格和评论。这项研究要检验的是:把这些餐厅属性收成网格特征之后,能在多大程度上预测日间人口、夜间人口、企业数量和消费额。
方向先说清楚。在九座中国城市、大约街道尺度的测试网格上,餐厅特征能解释这四项大约九成到九成五的差异。被预测的日间人口是手机数据里识别出的工作地,夜间人口是识别出的居住地,都不是某个钟点的街头人数。网格上的决定系数高,说明餐厅的空间分布和这些统计量一起变化,不能单独推出“开餐厅会带来人口”。
先说结论
- 网格边长取 4.5 公里时,论文报告测试集上的解释比例为:日间人口 95%(九座城市最低 86%、最高 98%),夜间人口 95%(91%、98%),企业数 93%(87%、97%),消费额 90%(82%、94%)。这里的百分比是决定系数 R²,分母是测试网格之间的变异,不是居民人数,也不是分类答对的比例。
- 网格越大,R² 越高。北京、3 公里网格上,只用训练集的 10%(大约 100 个样本)时,日间人口的 R² 为 0.86(标准差 2.3 个百分点),夜间人口 0.87(2.0),企业数 0.74(3.3),消费额 0.82(2.6)。样本再增加,上升变慢。
- 正文比较夜间灯光后写道,餐厅模型的均方误差只有夜间灯光模型的四分之一。人口结果也被作者拿去和另外两篇遥感人口论文报告的 R² 86%、85% 对照;那两篇不是这九座城市上的配对实验。
- 北京街道尺度上,15–64 岁人口的 R² 为 0.73,房价中位数 0.70,0–14 岁只有 0.56。街道普查是 2010 年,餐厅数据是 2017–2018 年。农业和制造业比多数服务业更难从餐厅预测。
- 把 3 公里模型从一座城市直接用到另一座城市,日间人口、夜间人口和企业的外城 R² 在大多数情况下仍超过 0.7,本市模型通常更高。也能读到很差的城市对:用沈阳的模型预测衡阳夜间人口,R² 为 0.26;用岳阳的模型预测昆明日间人口,R² 为 0.33。
普查很稀,餐厅名单为什么被拿来用?
作者面对的缺口是:中国城市变化快,又缺少又细又常更新的街区社会经济数据。餐厅被选中,是因为它分散、受本地需求拉动,又和人口、财富、消费放在一起变化。大众点评、美国的 Yelp 都能在全国范围拿到价格和评论,这些变量本身有经济含义,模型挑中某一项时还可以回头看。
这和“用 Yelp 估计美国县域经济、街区变化或卫生状况”的已有工作不同。本文把餐厅和三套微观数据接在一起:手机推算的人口、企业登记、银行卡消费,并同时看空间分辨率、不同人群和行业,以及跨城市直接套用。
餐厅名单仍然是消费场所的名录。它不记录一个人白天的行程,也不记录一家公司有多少雇员。后面的高 R²,都要放在这个测量对象里理解。
九座城市里,四套数据各按什么口径计数?
餐厅来自 2017–2018 年的 dianping.com。到 2017 年底,点评列出约 800 万家餐厅,覆盖 2,298 个县级单位,论文写这占县级单位的 80%。分析用了九座城市:北京、深圳、成都、沈阳、郑州、昆明、保定、岳阳、衡阳。作者按地域和人口规模挑选,用来看方法是否稳,不是从全国城市里随机抽样。
| 城市 | 点评餐厅数 |
|---|---|
| 北京 | 139,131 |
| 深圳 | 98,531 |
| 成都 | 134,497 |
| 沈阳 | 57,915 |
| 郑州 | 66,458 |
| 昆明 | 56,140 |
| 保定 | 46,219 |
| 岳阳 | 15,864 |
| 衡阳 | 18,209 |
| 合计 | 632,964 |
北京还有一个覆盖率对照。北京市餐饮协会的报告写,2016 年底在营餐厅 147,575 家;点评数据里北京有 139,131 家,论文计算为 94%。分子和分母不是同一年。其他八座城市没有给出同样的协会分母。点评覆盖面大,渗透率也没有到 100%。
每家餐厅使用的字段是:名称、经纬度、菜系、价格、口味、环境、服务、综合评分和评论数。城市一级的描述统计放在补充表 S1,正文没有逐城列出人口和面积。
日间人口和夜间人口来自 2015 年的手机定位。原始记录是匿名用户使用定位服务时的时间与坐标。处理分三步,细节在补充说明 Note 1。第一步,10 分钟内位移小于 200 米,记为一个停留点。第二步,用 DBSCAN 按密度把停留点分成簇。第三步,用 XGBoost 分别训练“家”和“工作地”两个分类器。家的分布当作夜间人口,工作地的分布当作日间人口。论文把前者视为居民的代理,把后者视为就业的代理。预处理之后,九座城市合计有 5,630 万这样推算出来的人口,并汇总到 100 米网格。区县尺度上,北京的夜间人口和人口小普查的 R² 为 0.97,比较的是区县之间的空间分布,不是 1 公里网格,散点在补充图 S11。
企业是 2000–2017 年的工商登记,九座城市共 872 万条,地址用百度地图接口转成坐标,再汇总进网格。登记地址可以不同于经营地址,原始数据也没有企业规模。消费是 2016 年 7–9 月银行卡在销售点的金额,原始记录匿名,只保留每个地点的消费额,没有餐饮、酒店或交通这样的类别。单笔超过 10,000 元的消费被改记为 10,000 元,所以网格总数是截断之后的合计。各城市银行卡和销售点的普及率不同,这会影响到后面的跨城市比较。
人口结构另用 2010 年普查,最高只到街道(Jiedao,论文比作美国的邻里)。北京有 309 个街道。街道表里没有教育、宗教和收入。房价中位数来自链家,当作家庭财富的代理;采集年份正文没有写。
这几套数据的年份并不对齐:手机是 2015 年,刷卡是 2016 年夏秋,企业登记横跨 2000–2017 年,餐厅是 2017–2018 年,年龄和外来人口是 2010 年。模型学到的是这些年份叠在一起的空间格局。
半个网格的平移,测到的是新街区还是邻近副本?
每个网格、每种菜系计算 7 项指标,图 1 写出其中三项:评论数之和加 1 再取对数,价格均值加 1 再取对数,口味均分。其余指标在补充说明 Note 2。不同菜系、不同指标叠在一起,是数百个特征。网格边长从 1 公里取到 5 公里,每座城市、每种边长单独训练。
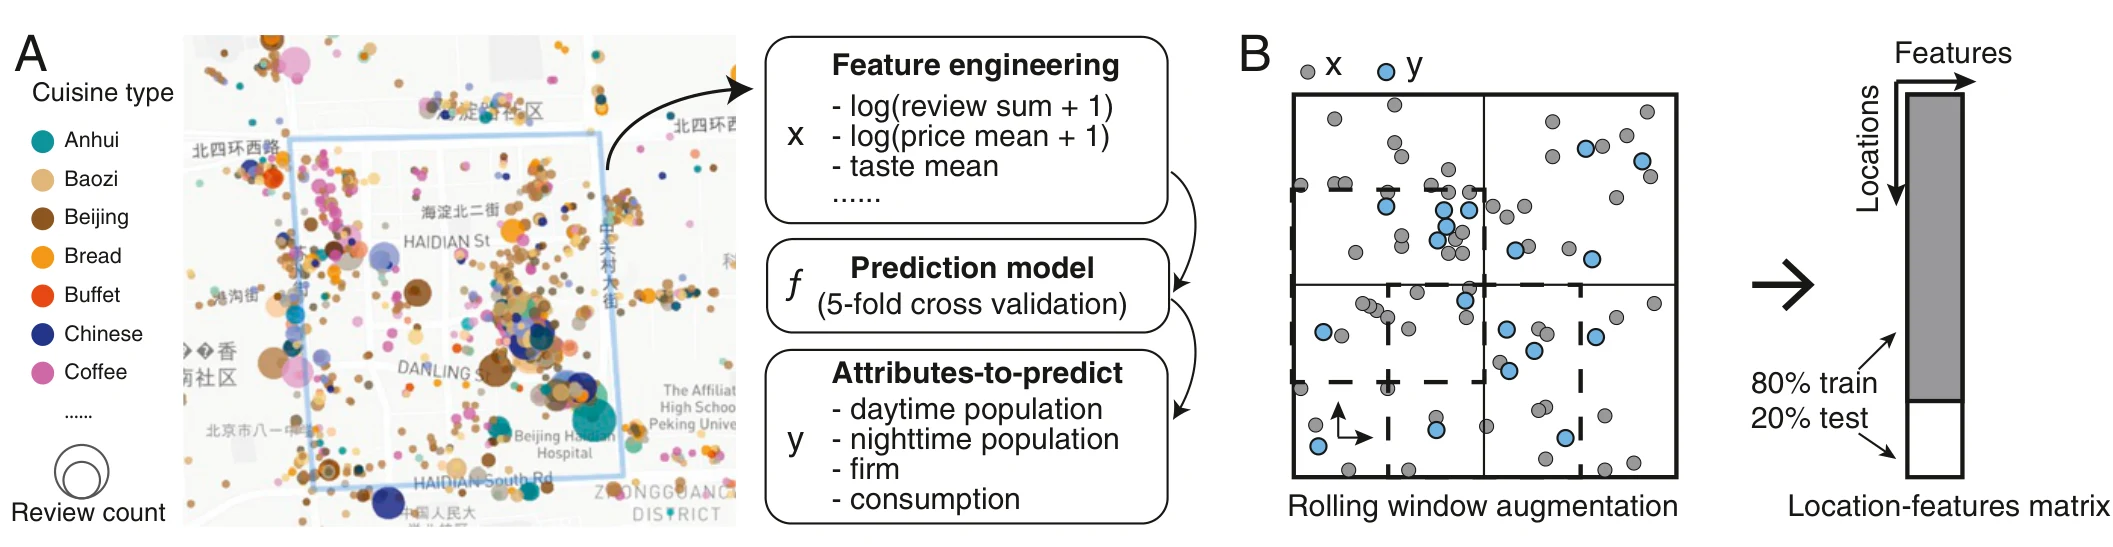
图 1|餐厅的哪些字段进入模型,训练和测试怎样切开?
(A)方法示意。左图用颜色区分菜系,点的大小表示评论数,展示的是特征从哪里来,不是预测成绩。中间的例子包括 log(评论数之和 + 1)、log(价格均值 + 1) 和口味均分;图注写明每种菜系共 7 项指标。预测目标是日间人口、夜间人口、企业数和消费额。模型为五折交叉验证的套索回归。(B)采样窗沿 x、沿 y,以及同时沿两个方向,各平移半个网格边长,样本量变为原来的 3 倍;合并后再分成 80% 训练集和 20% 测试集。右侧是地点对特征的矩阵。来源:原论文 Fig. 1。
模型是套索回归(least absolute shrinkage and selection operator,LASSO)。它要解决的比较是:在几百个餐厅特征里,怎样拟合网格上的目标,又不让系数随意变大。最小化的量是残差平方和的一半,加上 λ 乘以全部系数的绝对值之和。λ 不小于 0,用交叉验证来选。一部分系数会被压成 0,等于这个模型不用那些特征。
具体做法是:先把样本随机分成 80% 和 20%。在训练集内部做五折交叉验证,再拿到留下的 20% 上计算成绩。整套划分重复 50 次,报告测试集上的平均表现。变量重不重要,不靠某一次系数的大小。作者认为重要变量应在不同划分里更常出现,于是比较 50 次试验中被选中的次数。同一次预测里,一个变量在这批样本中被用到,换一批就可能被丢掉,而准确率仍可以接近。
图 1B 先做平移、再随机划分,会带来一个直接的读数限制。半个网格的错位和原来的格子大量重叠。随机抽出的测试样本,地理上往往贴着训练样本。因此这里的 R² 表示这些样本点没有被用来拟合系数,不表示一整片没见过的城区也被测到了。论文没有报告按区县整体留出的对照。补充图 S7 讨论增广对准确率和稳定性的作用,正文只说增广可以明显改善,没有给出抬升了多少个百分点。
网格放大到大约一条街道,测试集里还剩多少没解释?
4.5 公里被作者当作街道的分辨率:中国街道办事处这一级,并比作美国的邻里。这是正方形网格的边长,不是把真实街道多边形拿来做前面那组主结果。真实街道多边形用在后面的人口结构和行业分析里。
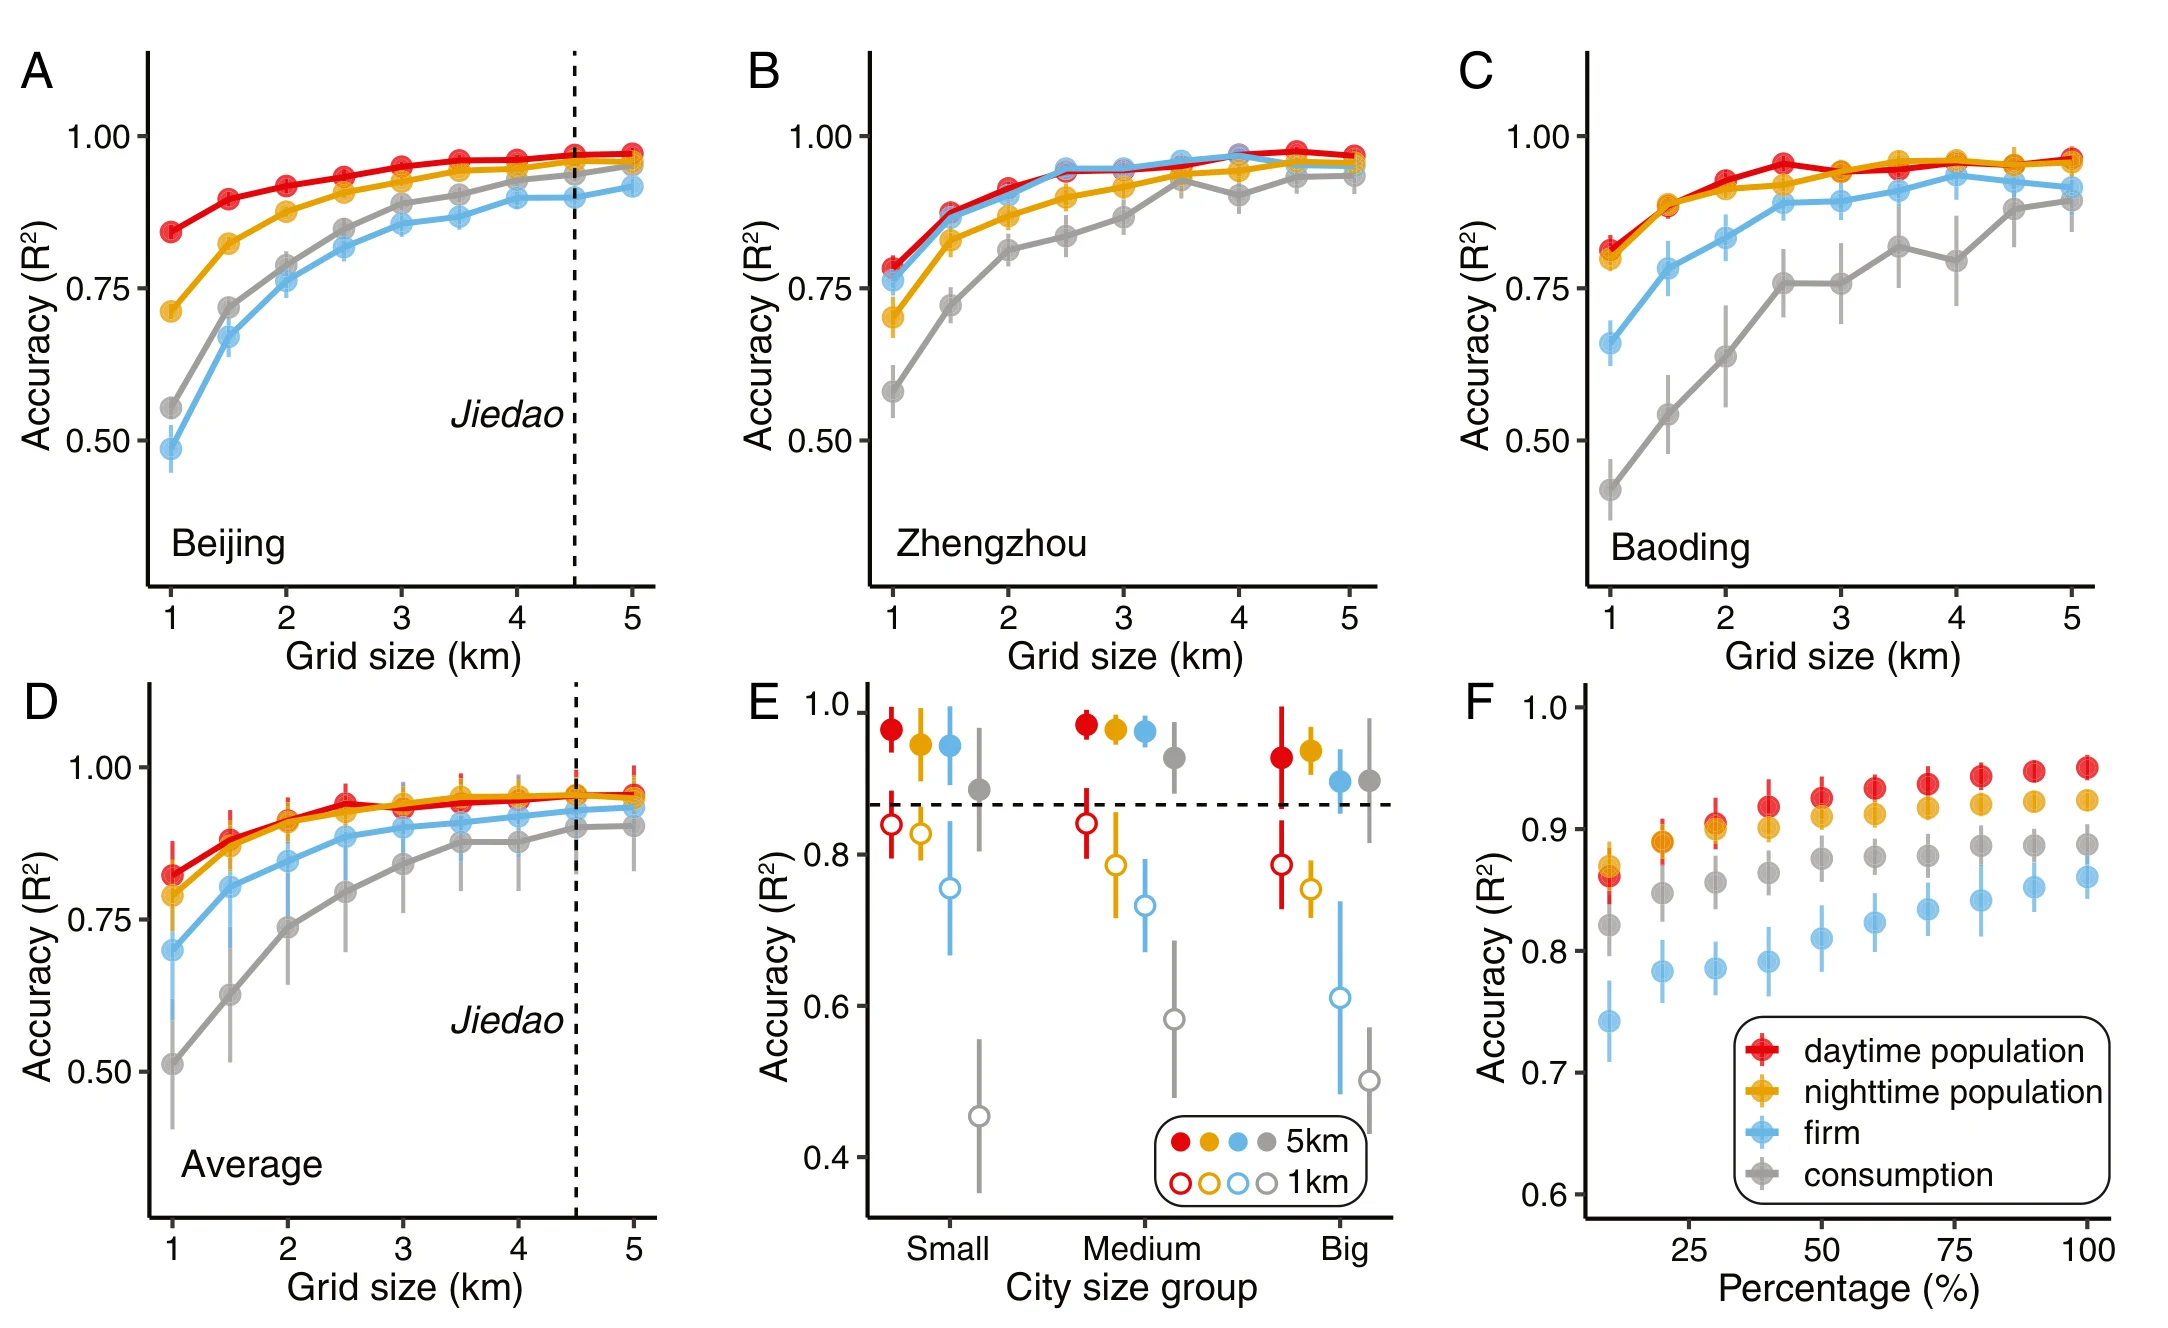
图 2|网格变大、城市变小、训练样本变少时,测试集 R² 怎样变?
(A)北京。(B)郑州。(C)保定。横轴是网格边长,从 1 公里到 5 公里;纵轴是测试集 R²。红线为日间人口,黄线为夜间人口,灰线为企业数,蓝线为消费额。四个面板里的曲线都随网格变大而上升。(A)和(D)在约 4.5 公里处有一条标为 Jiedao 的竖线。(D)九座城市的平均。论文在 4.5 公里给出的测试集数字是:日间人口 95%(城市间最低 86%、最高 98%),夜间人口 95%(91%、98%),企业数 93%(87%、97%),消费额 90%(82%、94%)。(E)按城市规模分组。人口超过 1,000 万的是北京、深圳、成都;300 万至 1,000 万的是沈阳、郑州、昆明;少于 300 万的是保定、岳阳、衡阳。空心圆是 1 公里模型,实心圆是 5 公里模型。除消费额外,高分辨率下中小城市比大城市更高;5 公里上各组都挤在高处。(F)北京、3 公里。横轴是所用训练样本占训练集的百分比。10% 约对应 100 个样本。来源:原论文 Fig. 2。
四项里,日间和夜间人口最高。作者的解释是,餐厅跟着本地人口走,而这两项分别代理就业和居民。企业略低。作者认为原因包括只有注册地址、没有规模;这是对数据集的判断,论文没有用经营地址再估一遍。消费侧,餐厅本应更贴近餐饮支出,但这套刷卡数据分不出类别,所以这个猜测无法在本文里检验。
网格变大之后 R² 上升,作者的解释是格子内部更匀,极端值更不容易拉动模型。更大的格子更好拟合,不等于街道内部的差异也被解释了。
城市规模的分组用的是论文给出的人口门槛。除消费额外,1 公里这种高分辨率上,中小城市比大城市更可预测。作者把它归到中小城市内部的空间差异更小。5 公里上,各组的点都很高,规模之间的差距被格子放大盖住了。
样本量的权衡只用北京、3 公里来展示。训练集的 10%,大约 100 个样本,日间人口 R² 为 0.86(SD = 2.3%),夜间人口 0.87(SD = 2.0%),企业数 0.74(SD = 3.3%),消费额 0.82(SD = 2.6%)。这 100 个样本来自增广之后的训练集,不是 100 个互不重叠的街道。论文没有在这一段写明标准差来自多少次重抽;方法部分写的 50 次,是主流程的重复次数。样本从很少加到全部,准确率上升,边际增益变小。
夜间灯光被当作城市活动的常用基线,结果在补充表 S2。正文说灯光对日间和夜间人口已经不错,但离餐厅模型仍远,企业和消费差得更明显;按均方误差,餐厅模型的预测误差只有灯光模型的四分之一。正文没有按四个变量分别写出这个倍数。
人口上的 95%,作者还和文献里相近粒度的遥感人口估计比较:一篇报告的人口密度 R² 为 86%,另一篇为 85%。比较的是各篇自己报告的 R²,不是把遥感模型和餐厅模型放到这九座城市的同一批网格上再跑一次。
市中心更准的时候,餐厅在混合就业和居住
主模型在市中心更稳,到了郊区变差。这和一些遥感人口估计相反:夜间灯光有饱和,密的地方反而容易被低估。餐厅模型的薄弱处在另一头。
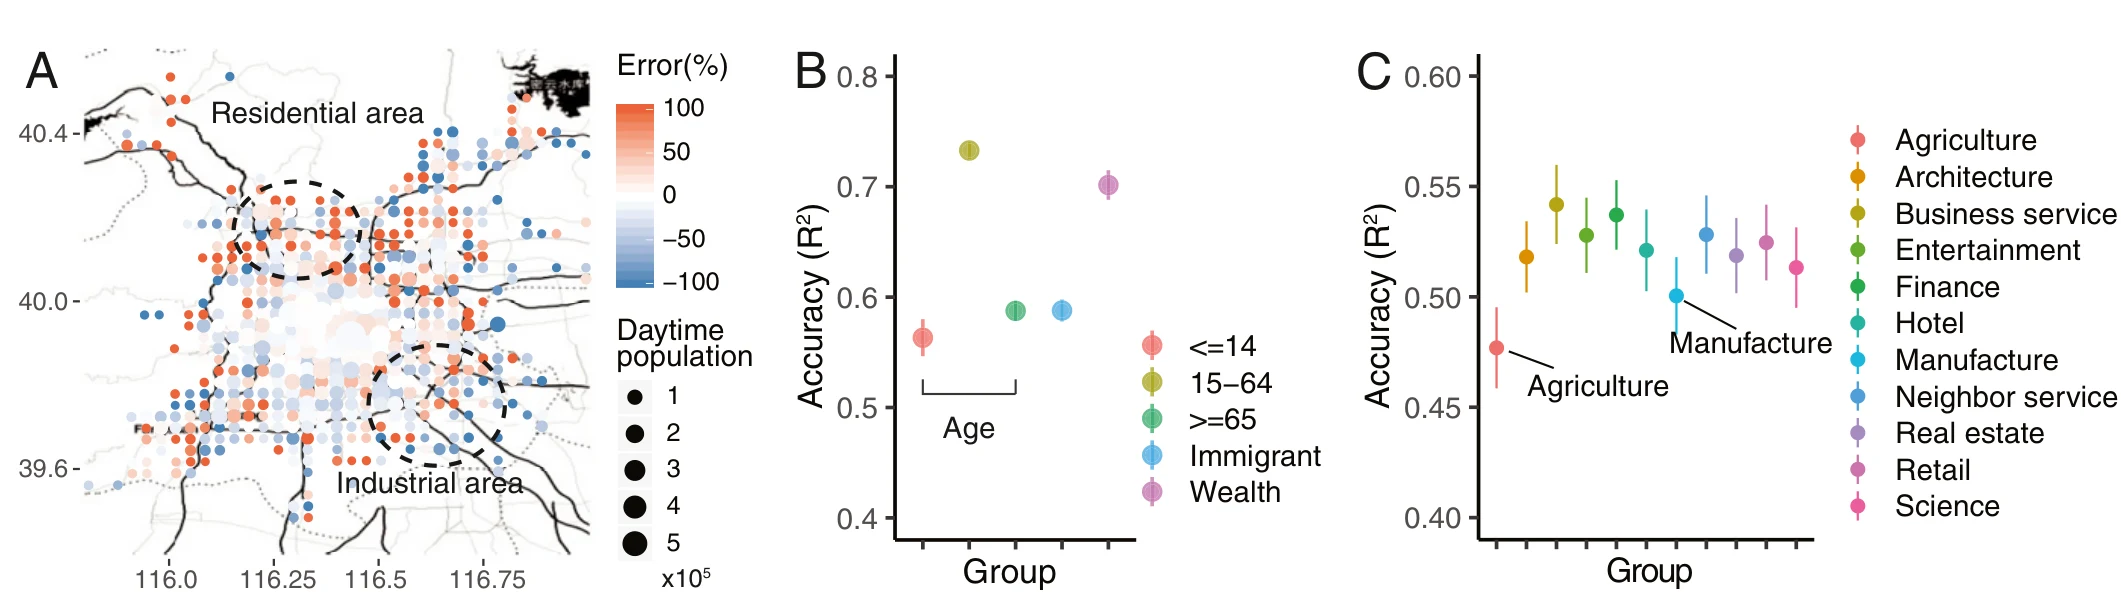
图 3|同样用餐厅去预测,误差集中在哪类地方、哪类人和哪类企业?
(A)北京、3 公里,日间人口预测误差的地图。点的大小是日间人口,图例为 1×10⁵ 到 5×10⁵。颜色是误差百分比,色标从 −100% 到 100%。图上标出居住区和工业区。正文写市中心更准、郊区较差,部分居住区的日间人口被高估,部分工业区被低估。图注没有给出误差的计算公式。夜间模型的偏差方向相反,地图在补充图 S10。(B)北京街道尺度的人群。纵轴为 R²。图例分组是 ≤14 岁、15–64 岁、≥65 岁、外来人口比例和房价(财富)。(C)街道尺度、分行业的企业数。纵轴刻度约从 0.40 到 0.60,农业和制造业被标在较低处,多种服务业靠在一起。来源:原论文 Fig. 3。
作者的机制解释是:餐厅同时对着就业和居住,混合用地的市中心两边都靠得上,纯居住区或纯工业区就会偏。日间模型把一些居住区估高、把一些工业区估低;夜间模型反过来。被低估的地区,作者还写成餐饮业的潜在机会。这是从误差方向推过去的商业解读,不是一篇选址实验。
没有手机数据里的人口属性时,作者改用 2010 年街道普查。北京 309 个街道。15–64 岁的 R² 为 0.73,房价中位数 0.70,外来人口比例 0.59,65 岁及以上 0.59,14 岁及以下 0.56。15–64 岁最高,作者的解释是这一档既是城市活动的主体,也是餐厅的主要顾客。中间隔着大约七年,作者也写明年份错开可能压低预测力。
企业按行业代码分开训练,仍在街道尺度。农业和制造业最低;商务服务、娱乐、金融和许多其他服务业彼此接近。作者把这联系到企业的空间偏好:高技能企业更靠集聚、靠近中心,低技能企业对地价更敏感、分布更散,雇员的收入和技能因而不同,餐厅也跟着不同。图 3C 的纵轴刻到 0.60,点都落在这个区间里。这里预测的是街道上分行业的企业数。4.5 公里网格上的人口来自另一次回归。正文没有列出每个行业的精确 R²。
常被选中的特征也写在正文里,完整排序在补充表 S3,重要性是 50 次里出现的次数。外来人口的例子包括北京菜、烘焙(Bakery)、Cooked 和新疆菜。房价的例子包括湖北菜、咖啡和北京菜。15–64 岁的例子包括烘焙、火锅和海鲜。咖啡和房价之间还能讲一个消费故事;烘焙和外来人口之间,作者明确说看不出显然联系。Cooked 在正文里没有再定义成哪一种中餐。
在一座城市训好,换到另一座城市还剩多少?
跨城市实验把网格固定在 3 公里,九座城市两两配对。对于城市对 A–B,只用 A 和 B 都有的特征训练,再去预测 B。菜系若只在一座城市出现,就不会进入这一对。每个格子是 50 次试验的平均 R²。横轴是训练城市,纵轴是被预测城市。黑框里是该被预测城市的最高值。
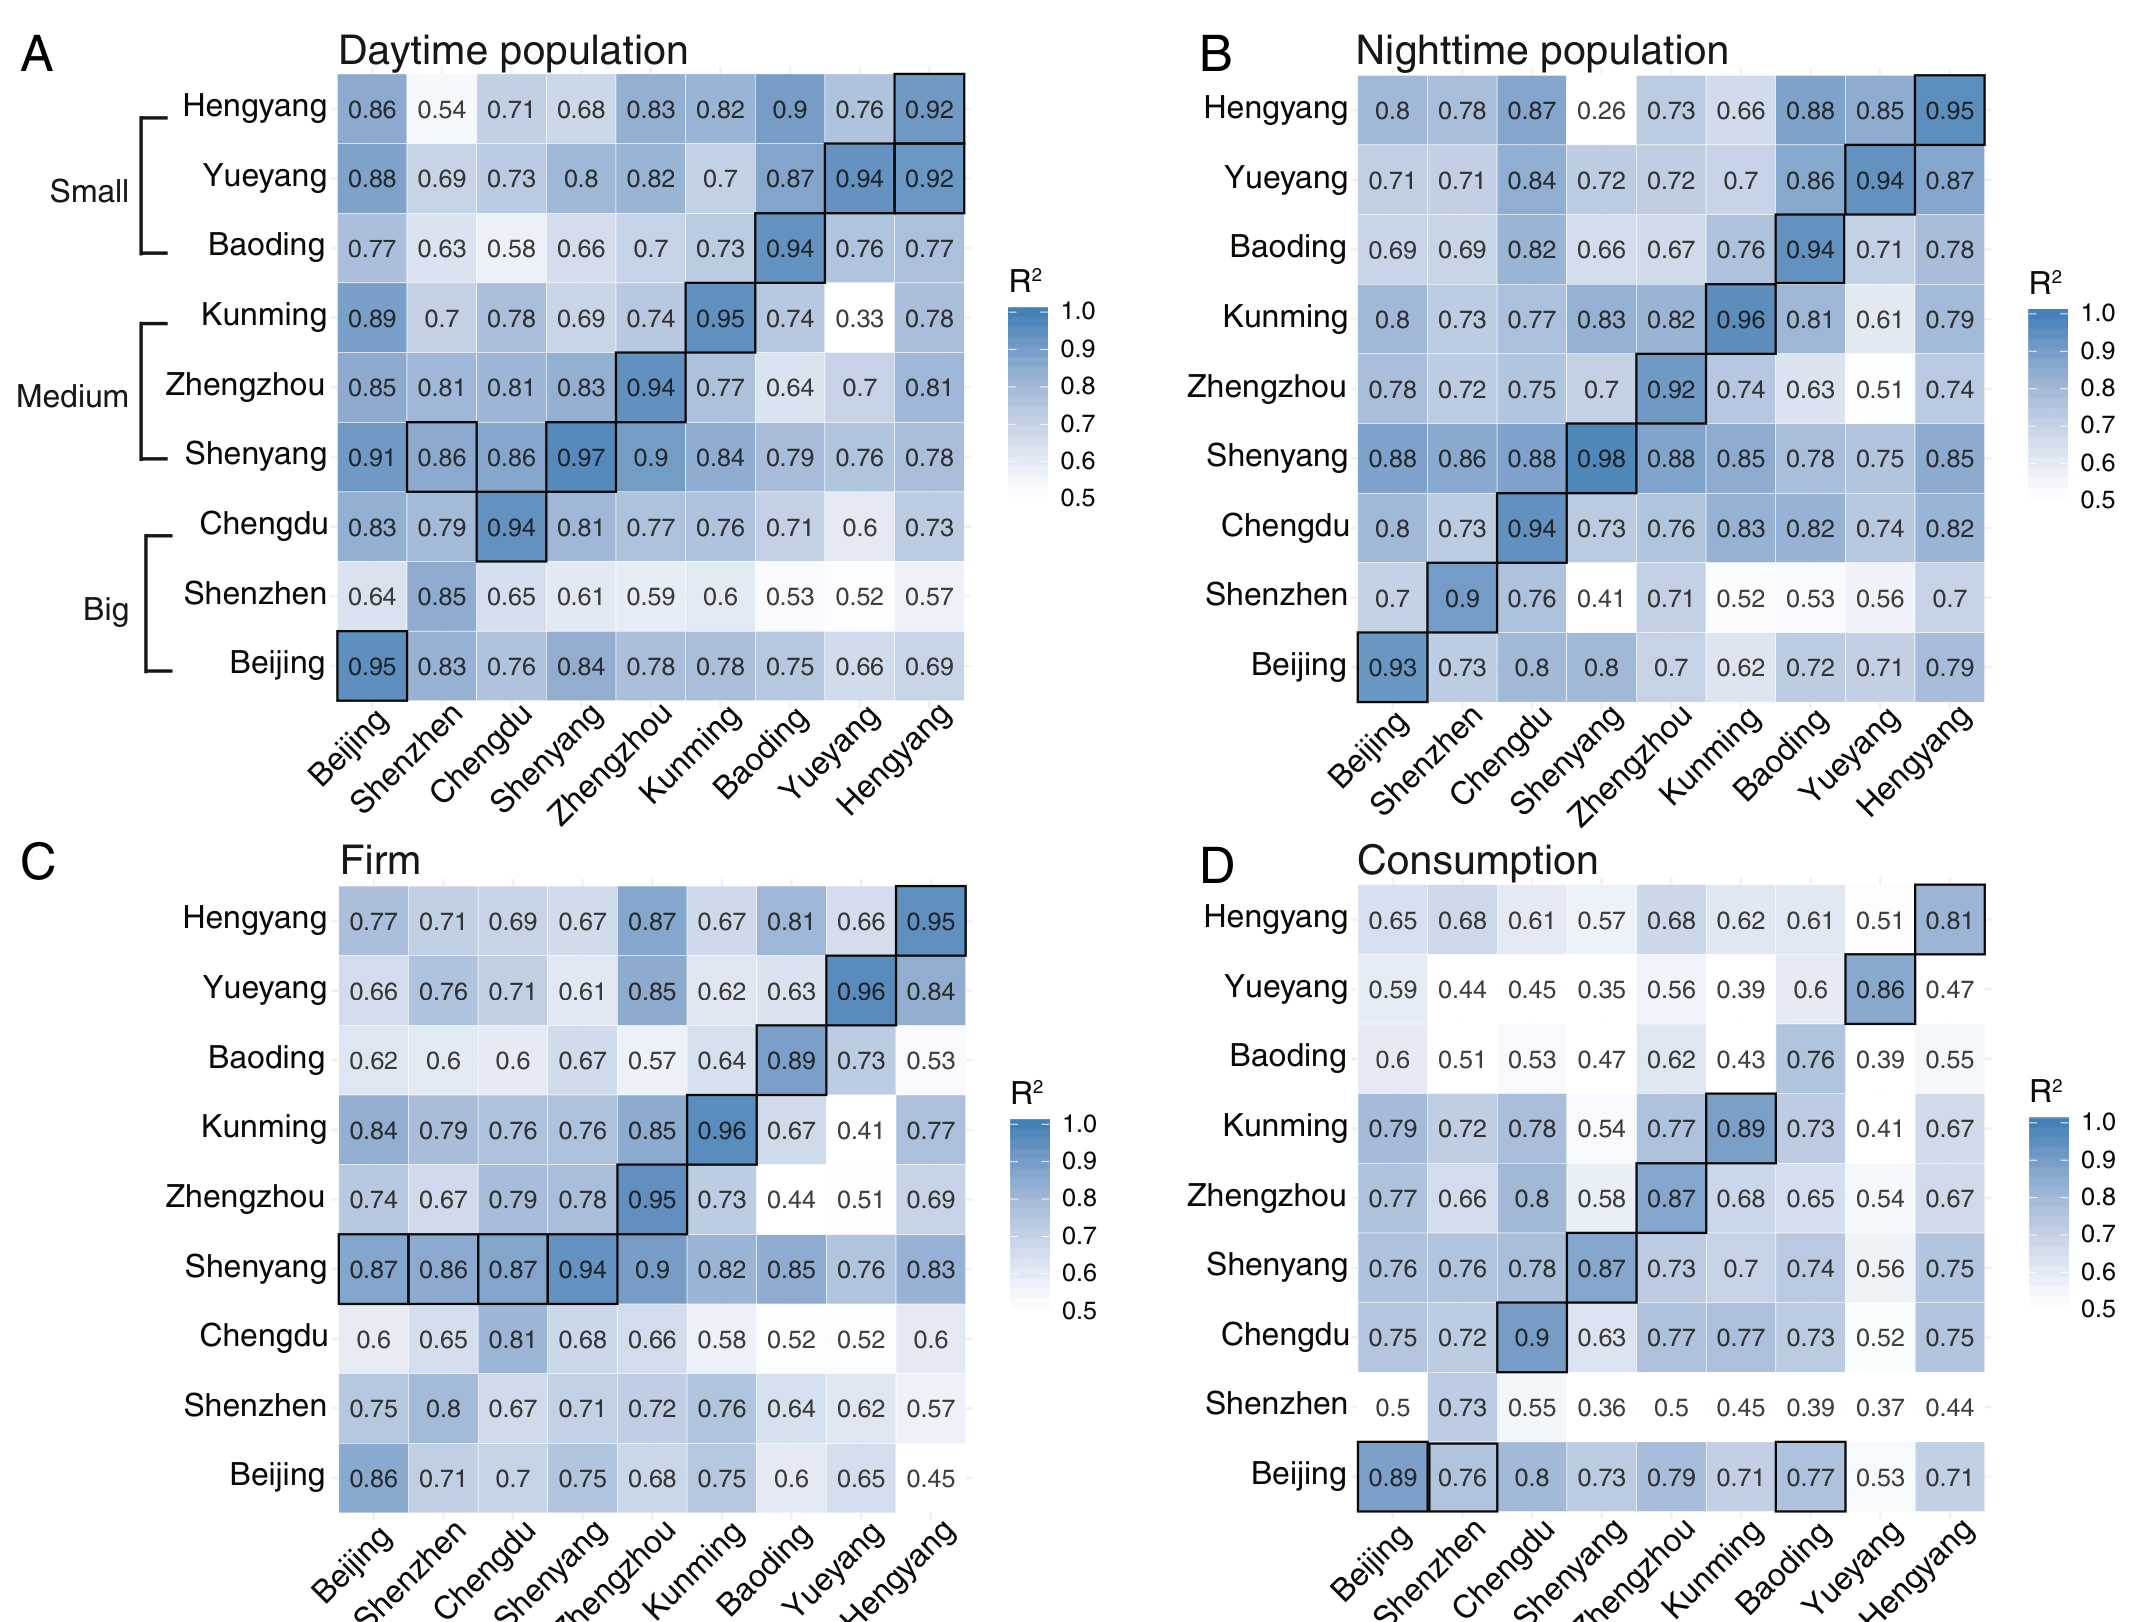
图 4|用一座城市的餐厅模型,直接预测另一座城市,R² 掉到哪里?
(A)日间人口。(B)夜间人口。(C)企业数。(D)消费额。颜色是 R²,色标约从 0.5 到 1.0。左侧括号把城市分成小、中、大,和正文的人口分组一致。50 次平均之后,北京预测北京的日间人口为 0.95,衡阳预测衡阳为 0.92;北京训练的模型预测衡阳为 0.86,衡阳训练的模型预测北京为 0.69。昆明日间人口的本市结果为 0.95,岳阳训练的模型为 0.33。衡阳夜间人口的本市结果为 0.95,沈阳训练的模型为 0.26。企业数里,北京本市为 0.86,成都本市为 0.81,沈阳本市为 0.94;同一行用北京、深圳、成都训练的结果为 0.87、0.86 和 0.87。昆明企业的本市结果为 0.96,岳阳训练的模型为 0.41。消费额里,北京本市为 0.89,深圳本市为 0.73,沈阳训练、深圳被预测时为 0.36。来源:原论文 Fig. 4。
多数本市模型高于外城模型。日间人口、夜间人口和企业上,大多数外城模型的 R² 仍超过 0.7。上面的 0.33、0.26 和 0.41 说明“大多数”里留着很差的城市对,不能把 0.7 理解成每一对都过线。
沈阳的企业数是正文点名的例外:外城模型可以超过本市模型。图 4C 这一行印出的 50 次平均里,最高仍是本市的 0.94;北京、深圳、成都三个外城结果是 0.87、0.86、0.87,接近,但没有更高。
用大城市训练、再预测其他城市,在大多数情况下好于反过来用。明细在补充表 S4。日间人口里,北京预测衡阳的 0.86 高于衡阳预测北京的 0.69,方向和这句总结一致;它只是一对城市,不是表 S4 的全部计数。
迁移模型里,四项结果共同靠前的特征包括江浙菜、广东菜和小龙虾。咖啡只进入日间人口的靠前特征。作者把这些菜系的跨城市出现写成它们比较常见,并写明这些预测因子还需要继续查。完整名单在补充表 S5。
预测得准,也不等于可以按这个数分配设施
相关和预测停在网格统计量上。餐厅特征、推算人口、登记企业和截断后的刷卡额一起变化,得不出开一家餐厅改变了人口或就业。日间人口是工作地分类的汇总,夜间人口是居住地分类的汇总。停留点只覆盖使用了定位服务、且在 10 分钟内移动不足 200 米的记录。
测量本身有缺口。点评没有覆盖全部餐厅,北京的 94% 还跨了协会统计的 2016 年底和点评采集的 2017–2018 年。企业没有规模,注册地可以不是经营地。消费分不出类别,单笔万元以上被压到 10,000 元,城市之间的刷卡普及率也不同。街道上的年龄和外来人口比餐厅早大约七年,房价的采集年份没有写出。
模型也没有回答变化。作者写明,手头没有足够细、又按时间重复的人口和就业序列,所以还不能检验同一地点的社会经济属性怎样随时间改变。跨城市只做到中国境内。国家之间能否迁移,正文列为后续问题。增广样本的空间重叠,使测试集 R² 不能直接当成“留出一整片新区”的成绩。
讨论里,作者认为少量训练样本就能以较低成本推断没调查到的网格,并提到可用日间和夜间人口帮助安排公共设施。同一节也引用了一句判断:做出预测和做出决策之间还有一段距离。城市的基础设施和用地是长期决定,这些模型用的是短时段数据。怎样把预测放进决策,论文没有做完。
一句话总结
在这九座城市里,餐厅的价格、菜系和评论能在大约街道尺度的测试网格上解释人口、企业数和消费额的大部分差异;这个结果依赖重叠样本和已有调查来训练,替换不了普查,也说明不了开餐厅就会带来居民或岗位。
核心来源
- PNAS 正式发表版,卷 116,第 31 期,15447–15452。正文四张图都来自这一版。
- 聚合数据和复现代码存于 GitHub:leiii/restaurant,论文写明存放日期为 2019 年 5 月 3 日。公开的是聚合数据,不是匿名之前的个人定位记录。
- 实验室项目页 Tasty Data 列出了这项研究的分工称呼。董磊后来的单位与研究方向见北京大学地球与空间科学学院页面。
作者介绍
- 董磊(Lei Dong):论文署名为麻省理工学院城市研究与规划系可感知城市实验室,以及中国未来城市实验室与房地产中心。他执行研究并分析数据,也参与设计和写作。北京大学地球与空间科学学院页面介绍他为助理教授,研究方向是城市科学与时空大数据。
- Carlo Ratti:论文署名为麻省理工学院可感知城市实验室。该研究的实验室项目页写明他是可感知城市实验室主任,并参与研究设计与写作。
- Siqi Zheng:通讯作者,邮箱 sqzheng@mit.edu。论文署名为中国未来城市实验室与房地产中心。项目页写明她是中国未来城市实验室主任,并参与研究设计与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
北京 3 公里上,随机使用约一成训练样本就得到日间人口 R² 0.86。若一个城市省钱时只调查市中心,这一数字不能直接搬过去。图 3A 已经把较大误差放在郊区,以及日间人口被高估的居住区和被低估的工业区。随机网格和“只测中心”不是同一种十分之一。
菜系被反复选中,也不适合直接做成街区标签。咖啡和房价还能讲消费故事,烘焙和外来人口之间作者已经说不出显然联系,而且同一种特征换一次数据划分就可能退出模型。若用菜系结构去指导信贷、学区或执法,等于把一次相关选成了人群分类。
平台覆盖率一变,预测可以在居民不变时改口。北京的 94% 还是两个年份对在一起的结果。衡阳的夜间人口用沈阳的模型去预测,R² 只有 0.26,说明“大城市模型拿到小城市,多数情况下仍超过 0.7”挡不住个别城市对失败。使用之前至少要留下一对没参与训练的城市,看消费和企业是否也像人口那样过线。