家离强关系更近,去过的地方却更靠近弱关系?
论文名片|Santi Phithakkitnukoon、Zbigniew Smoreda、Patrick Olivier,Socio-Geography of Human Mobility: A Study Using Longitudinal Mobile Phone Data,PLoS ONE,2012,7(6):e39253,2012年6月28日发表。DOI:10.1371/journal.pone.0039253。观察研究,依据这份 PLoS ONE 正式版。
下班后绕去一个不常通话的地方,晚上回到通话最多的那一片。前一处离偶尔联系的人更近,后一处离经常联系的人更近。这不是论文里的某位用户,只是把两种距离放在同一天:人住在哪里,和这一年实际连上过哪些基站。
葡萄牙 2006–2007 年的语音通话记录里,住所平均更靠近通话更久的强关系;到过的不同地点却有更高比例落在弱关系的一定距离之内。最近社会联系的住所向外 20 公里,平均覆盖八成到访地点。居住地越密,覆盖同样比例所需的距离越短。
先说结论
- 每月至少有 5 次位置记录的 110,213 人,占全部 1,318,905 名用户的 8.36%。他们到过的不同地点中,平均 80% 落在最近社会联系住所的 20 公里内,90% 落在 45 公里内。
- 强关系的家比弱关系的家平均近约 11 公里:联系层面的平均距离是 41.50 公里对 52.75 公里。活动范围落在给定距离内的比例则是弱关系更高,正文把差距概括为大约 15%(标准差 10.7%,p = 0.09)。
- 市镇人口密度越高,活动范围落在短半径内的比例升得越快。10 公里那条拟合的幂律指数是 0.10913,40 公里只有 0.021092。里斯本和波尔图要覆盖 80% 的活动范围,地理社会半径大约 7 公里。
- 论文按人口密度把这条葡萄牙关系套到其他城市,给出巴黎、孟买各 1.99 公里,悉尼 5.79 公里等估计。这些是外推,正文没有当地通话样本。把人的位置随机对调后,平均覆盖更低、波动更大。
一年通话里,谁被留下来比较?
数据来自一家欧洲电信运营商的计费记录,覆盖葡萄牙全部 308 个市镇,时间是 2006 年到 2007 年之间的一年。原始用户 1,318,905 人,论文写约占人口的 13%;正文没有印出计算这 13% 时使用的人口总数。记录只有语音通话,没有短信,也没有上网流量。号码在离开运营商机房前已被换成匿名标识,位置是通话时连接的基站。
全国有 6,509 座基站。平均每座覆盖 14 平方公里,里斯本和波尔图降到 0.13 平方公里。所以后面说的“地点”,是基站覆盖范围的质心,粒度随城乡改变。
分析没有使用全部用户。论文只保留每个月至少有 5 次位置记录的客户,得到 110,213 人。这个筛选让轨迹更密,也把很少打电话的人留在样本外。在这 110,213 人里,一年平均大约 49 条有来有往的联系;每人每月通话 467 分钟、173 次,并连接 98 座不同基站。
467 分钟若按 30 天均摊,大约是每天 15.6 分钟;173 次大约是每天 5.8 次。正文括号里写的“大约每天 6 分钟、8 次”与按 30 天均摊不一致。后面使用每月 467 分钟和 173 次。98 座基站和每月通话写在同一句里,正文没有单独标明 98 是每月还是全年的去重数。
社会联系只保留互有来往的通话,做法跟随 Onnela 等人 2007 年的研究,用来降低商业号码和单向呼叫的噪声。从不互打电话的同事、邻居不会进入这张网。因此这里的社会联系是语音通话网,不是一个人全部的面对面关系。
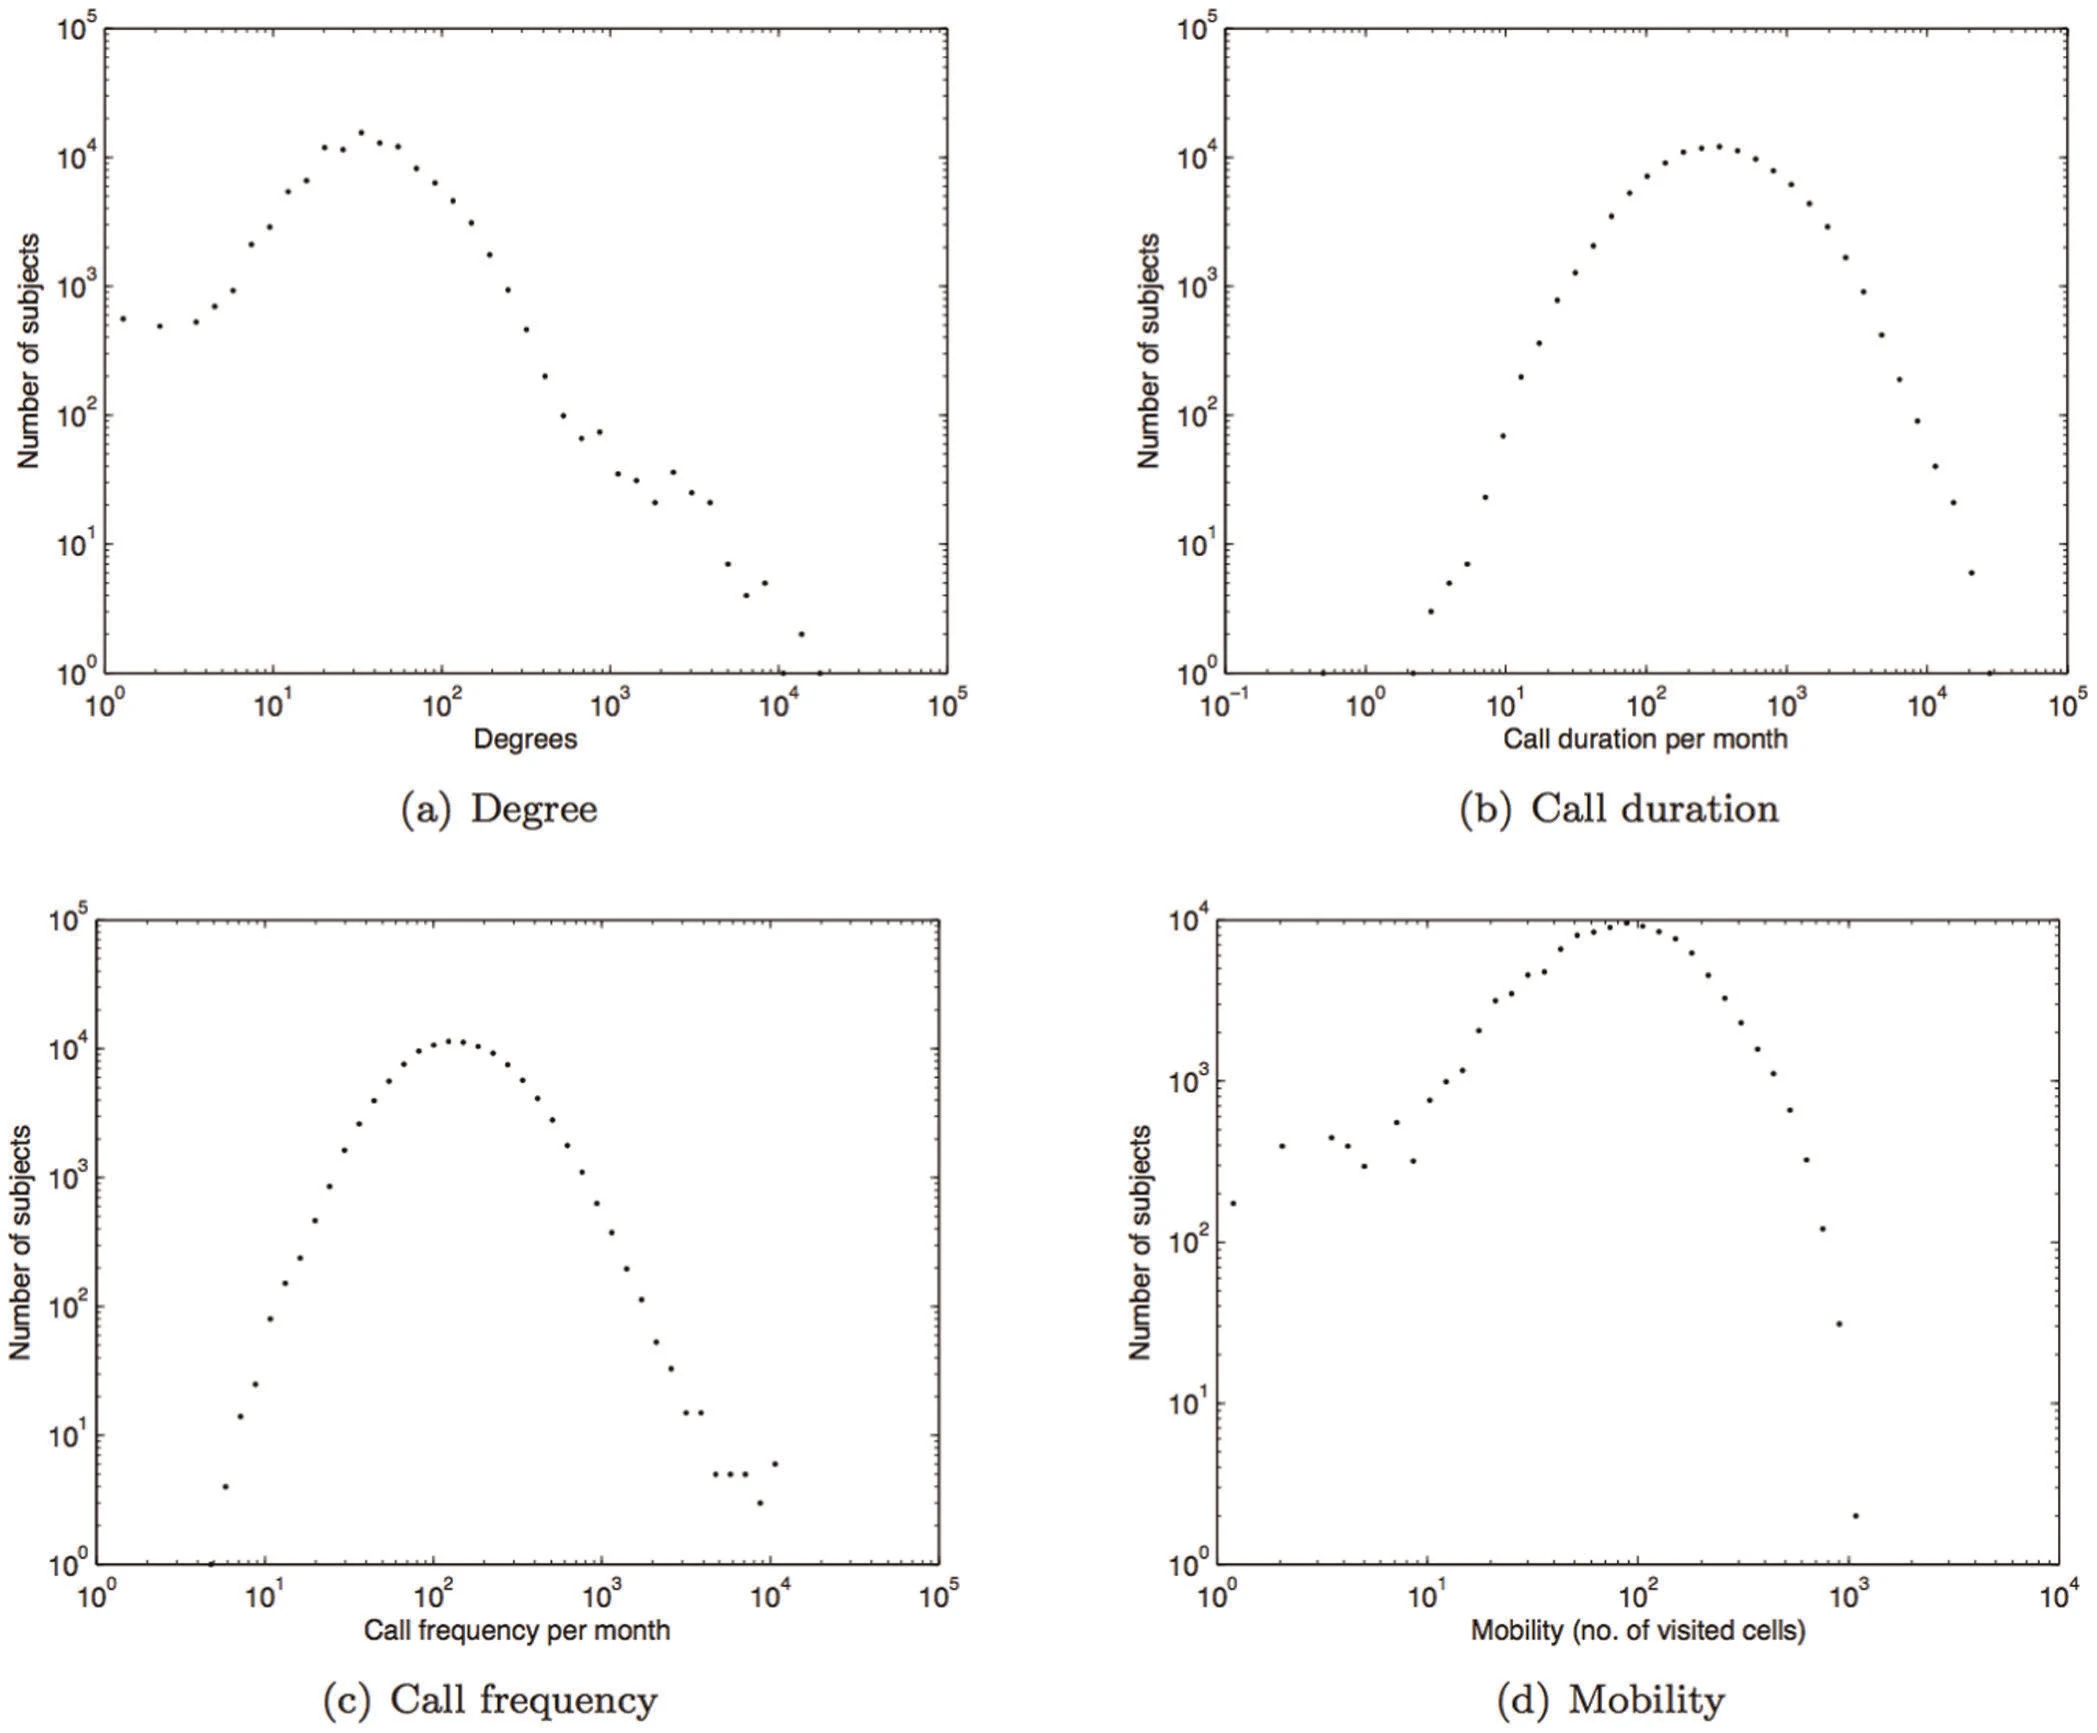
图 1|留下来的 110,213 人,通话和移动各有多宽?
(a)联系数:纵轴是人数,横轴是互惠联系数,双对数坐标。人数在数十个联系附近达到高峰,长尾超过 1,000。(b)每月通话时长,单位是分钟,高峰落在数百分钟,与月均 467 分钟同量级。(c)每月通话次数,高峰在大约 100 次附近,月均是 173 次。(d)到过的不同基站数,高峰在大约 100 座附近,与正文的 98 座同量级,长尾伸向大约 1,000 座。四张图的纵轴都是受试者人数,不是通话条数。来源:原论文 Fig. 1。
家和工作地落在哪座基站上?
家被定为夜间 22 时至次日 7 时通话最多的基站,工作地定为白天 9 时至 17 时通话最多的基站。坐标取覆盖范围的质心。运营商市场份额、套餐在一天中的分布、以及一人多号,都会改变这个估计。论文把这些列为家位置的固有限制。
核对办法是:按估计的家,把受试者分进居住市镇,再和葡萄牙国家统计局 2001 年人口普查的市镇人口比较。通话发生在 2006–2007 年,普查早大约五年。正文说二者大体呈线性,对不上的市镇大约不到 10%。图上打印的是双对数坐标里的幂律,指数不是 1。
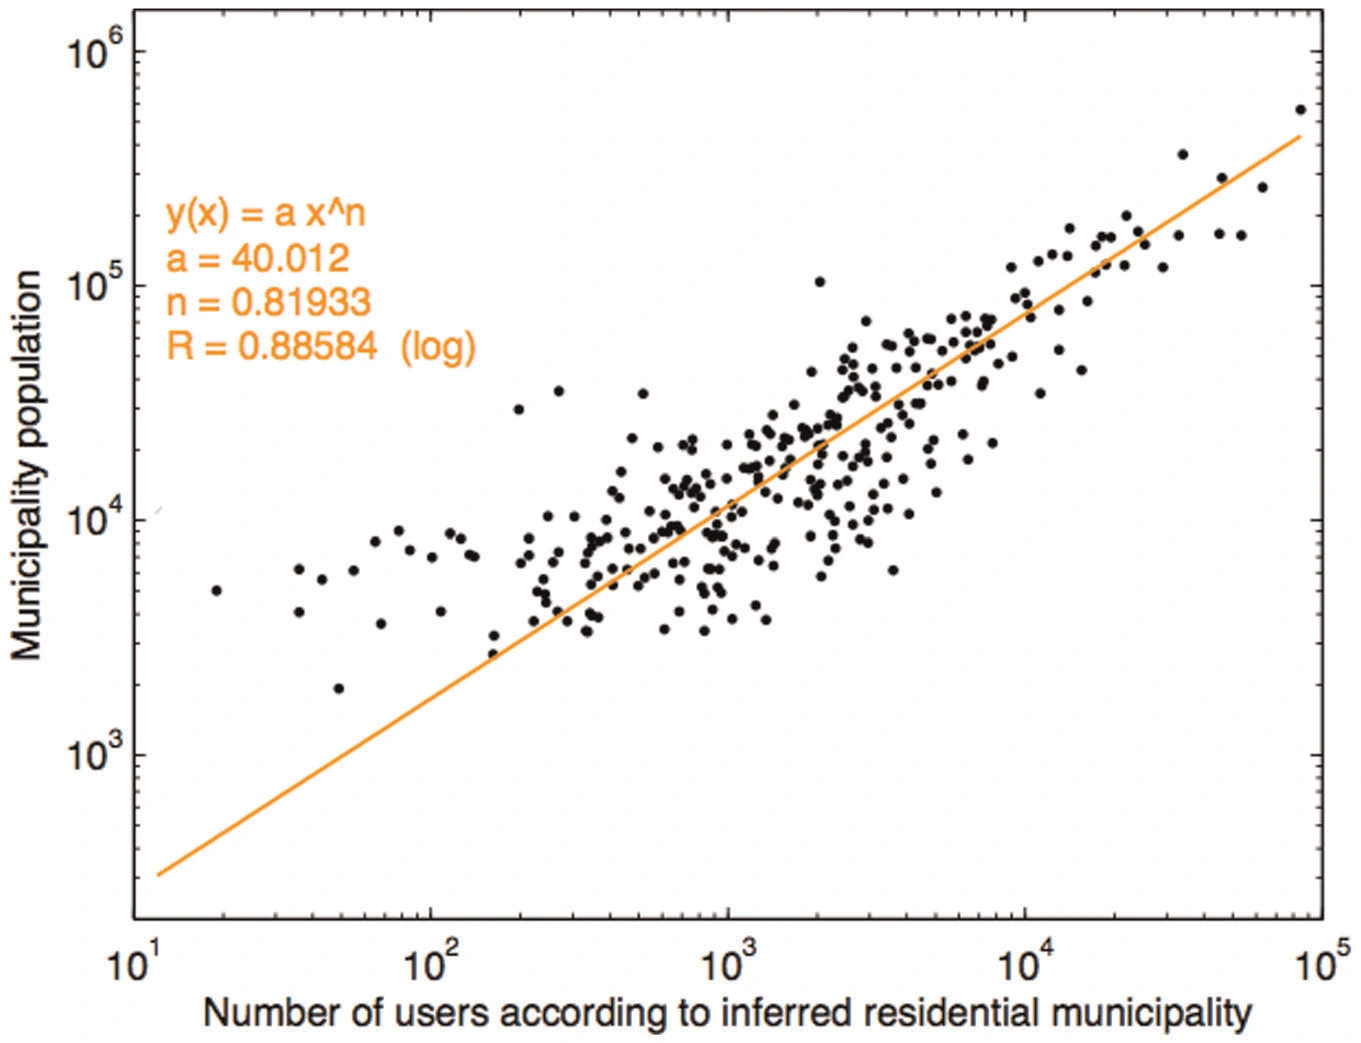
图 2|估计的居住市镇,和普查人口还对得上吗?
无字母子图。横轴是按估计住所归入该市镇的用户数,纵轴是 2001 年普查的市镇人口,两边都是对数刻度。拟合为 y = 40.012 × x 的 0.81933 次方,对数相关系数 R = 0.88584。指数低于 1,用户数增加时,拟合人口不是按同样倍数增加。每个点是一个市镇;“不到 10% 对不上”是正文的概括,图上没有逐点标出哪些市镇被算作偏离。来源:原论文 Fig. 2。
工作地用通勤距离做侧面核对。通勤距离是估计的家与工作地基站之间的距离。平均 7.59 公里,68% 的受试者短于 10 公里。Eurofound 2000 年的葡萄牙工作条件资料写,人口中 67.4% 的通勤短于 10 公里。两个 10 公里门槛接近,但一个是 2006–2007 年这家运营商的受试者,一个是 2000 年对人口的调查,不是同一批人。
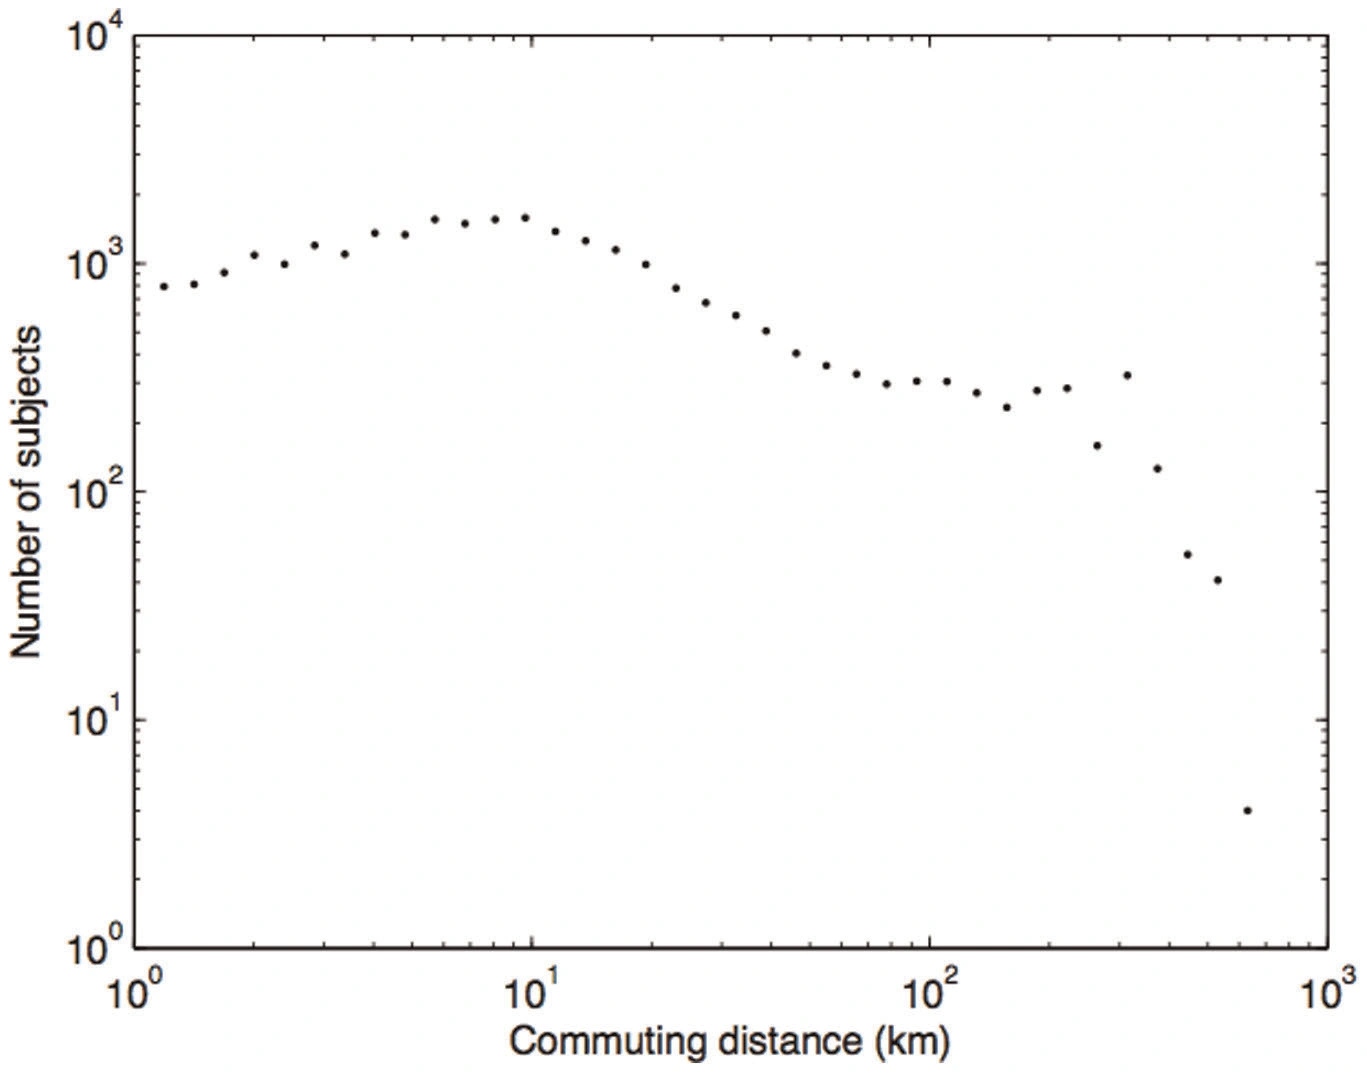
图 3|估计的家和工作地之间,大多数人有多远?
无字母子图。横轴是通勤距离(公里),纵轴是受试者人数,双对数坐标。短距离的人数最高,平均 7.59 公里;68% 的受试者短于 10 公里,分母是纳入分析、并能估计家和工作地的受试者。100 公里以外仍有长尾。来源:原论文 Fig. 3。
地理距离用半正矢公式,把两点的经纬度差换算成球面大圆距离,地球平均半径取 6,371 公里。这是地图上的大圆距离,不是沿路里程,也不是通勤时间。
强关系只是比本人平均通得更久
强弱关系沿用 Granovetter 1973 年的区分,但操作指标窄得多。某条联系的强度,等于和这个人的总通话时长,除以该受试者全部联系的平均通话时长。商大于或等于 1 算强关系,小于 1 算弱关系。分母是这个人自己的平均时长,不是全样本的统一分钟线,也没有直接测量亲密程度或互惠服务。互惠已经用在“算不算联系”上,强度本身只看时长。
按这个定义,平均每人 7 条强关系、42 条弱关系。7 加 42 等于正文所说的大约 49 条互惠联系。通话时长通常右偏,超过本人平均值的联系本来就会少一些,所以 7 对 42 符合这个相对门槛,并不表示弱关系在社会上更重要。
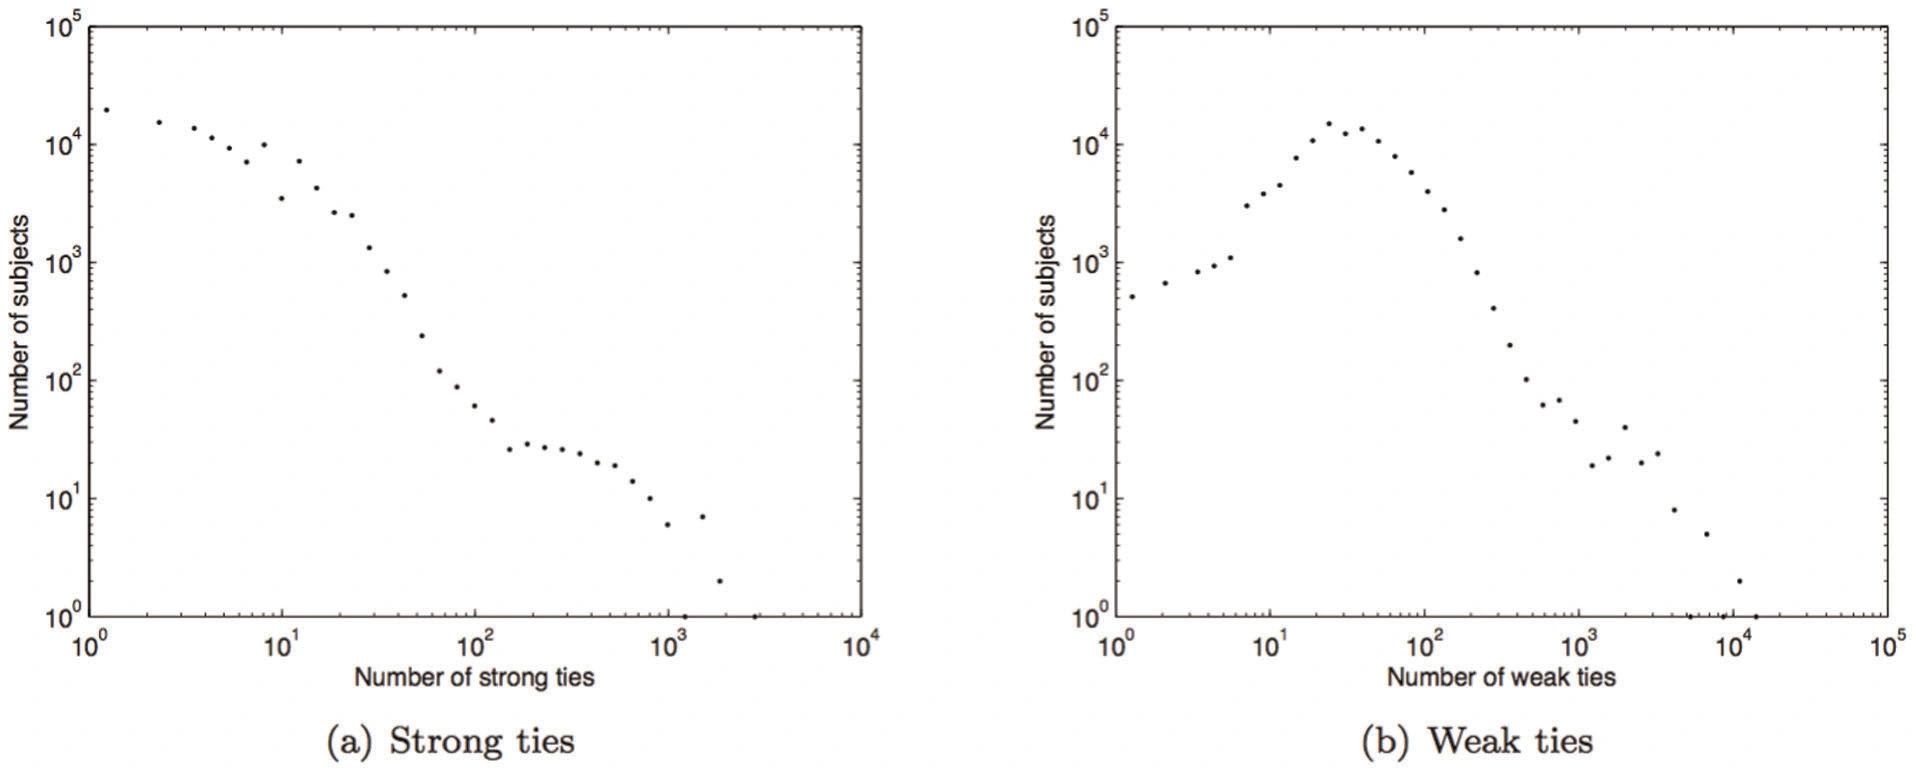
图 4|强关系和弱关系各有多少条?
(a)强关系条数:很多人只有很少几条,人数随条数下降,平均是 7 条。(b)弱关系条数:人数在大约十几到几十条达到高峰,平均是 42 条,长尾可以到数千条。纵轴都是受试者人数。平均值不是图上的峰值。来源:原论文 Fig. 4。
住所离强关系更近,平均近多少?
先看全部联系,不区分强弱。受试者的家到联系人的家,平均 19.66 公里;家到联系人的工作地,平均 13.30 公里。这里的统计单位是联系,图的纵轴是联系条数。
再只看家到家,并按强弱分开:强关系平均 41.50 公里,标准差 91.52 公里;弱关系平均 52.75 公里,标准差 81.98 公里。52.75 减 41.50 等于 11.25 公里,正文概括为大约近 11 公里。标准差大于平均值,少数很远的联系会把平均拉开。图上条数的高峰大约在 10 公里附近,40 多公里是被长尾拉高后的平均。
用平均 7 条强关系和 42 条弱关系做权,(7 × 41.50 + 42 × 52.75)÷ 49 ≈ 51.1 公里,与全体联系的 19.66 公里对不上。正文没有说明这三组平均是先对每个人平均、再对人群平均,还是把所有联系合在一起平均。11 公里只对应强弱两组家—家距离的差。
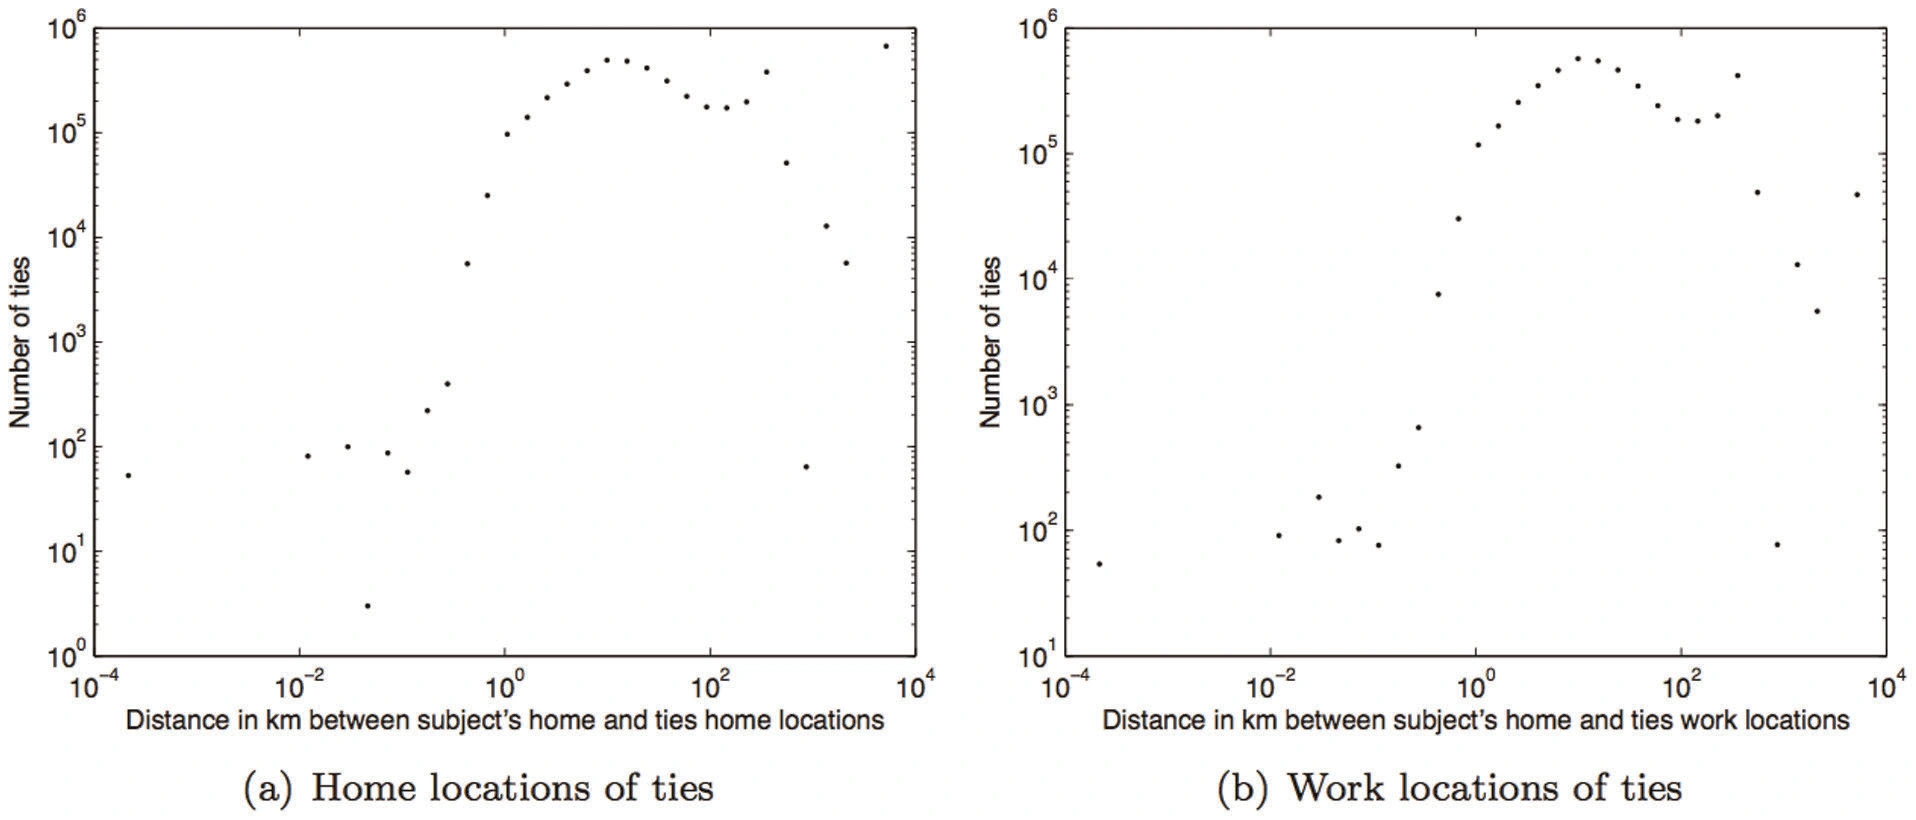
图 5|家离联系人的家和工作地各有多远?
(a)家到联系人的家,平均 19.66 公里。(b)家到联系人的工作地,平均 13.30 公里。纵轴是联系条数,横轴是公里,双对数坐标。两条分布都在数公里到数十公里达到高峰,并在数百公里处还有一截抬升。来源:原论文 Fig. 5。
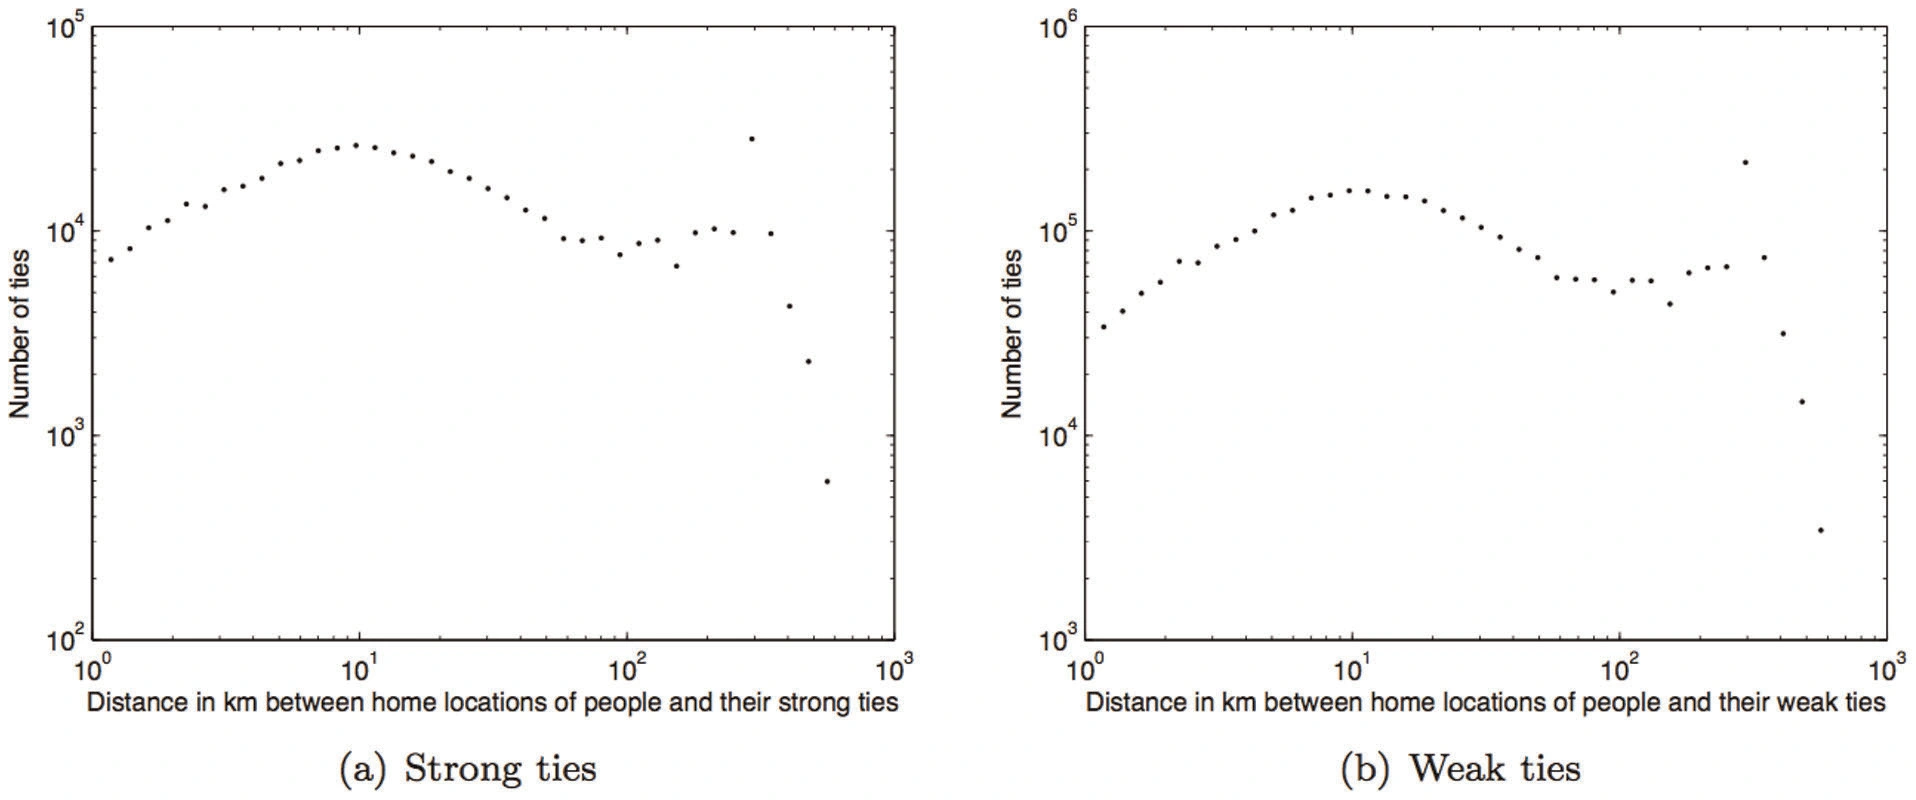
图 6|强关系的家是否更近?
(a)家到强关系的家,平均 41.50 公里,标准差 91.52 公里。(b)家到弱关系的家,平均 52.75 公里,标准差 81.98 公里。纵轴仍是联系条数。强关系的平均更短,两组都有远长于平均值的尾巴。来源:原论文 Fig. 6。
到过的地点,离联系人的位置有多近?
活动范围(travel scope)是一个人到过的不同地点的集合,地点仍是基站。位置只在通话接通时记下,活动范围就是这些接通过的基站。论文引用既有研究,把这类轨迹当作个人移动的可用代理,同时在文末把断续采样列为首要限制。
地理社会半径(geo-social radius)回答的是:从社会联系的位置向外扩多少公里,能罩住一定比例的到访地点。某个地点只要落在任一联系人的这个距离内,就算被罩住,因此等价于它到最近联系人的距离。论文写,r_y = x 公里表示 y% 的到访地点位于社会联系的 x 公里内。
对家的位置,到访地点平均有 80% 落在最近联系人住所的 20 公里内,90% 落在 45 公里内。距离从 0 算到 200 公里。工作地的曲线形状相近,正文没有另给一组工作地的 80% 和 90% 公里数。图上的竖线,结果正文称为标准差;标准误放在补充图里,正文没有列出标准误数值。20 公里处的竖线仍然很长,80% 是受试者之间的平均,人与人之间仍很分散。
作为对照,论文把受试者的位置随机对调。对调后的平均覆盖更低,波动更宽。正文只报告这个方向,没有给出 z 值。
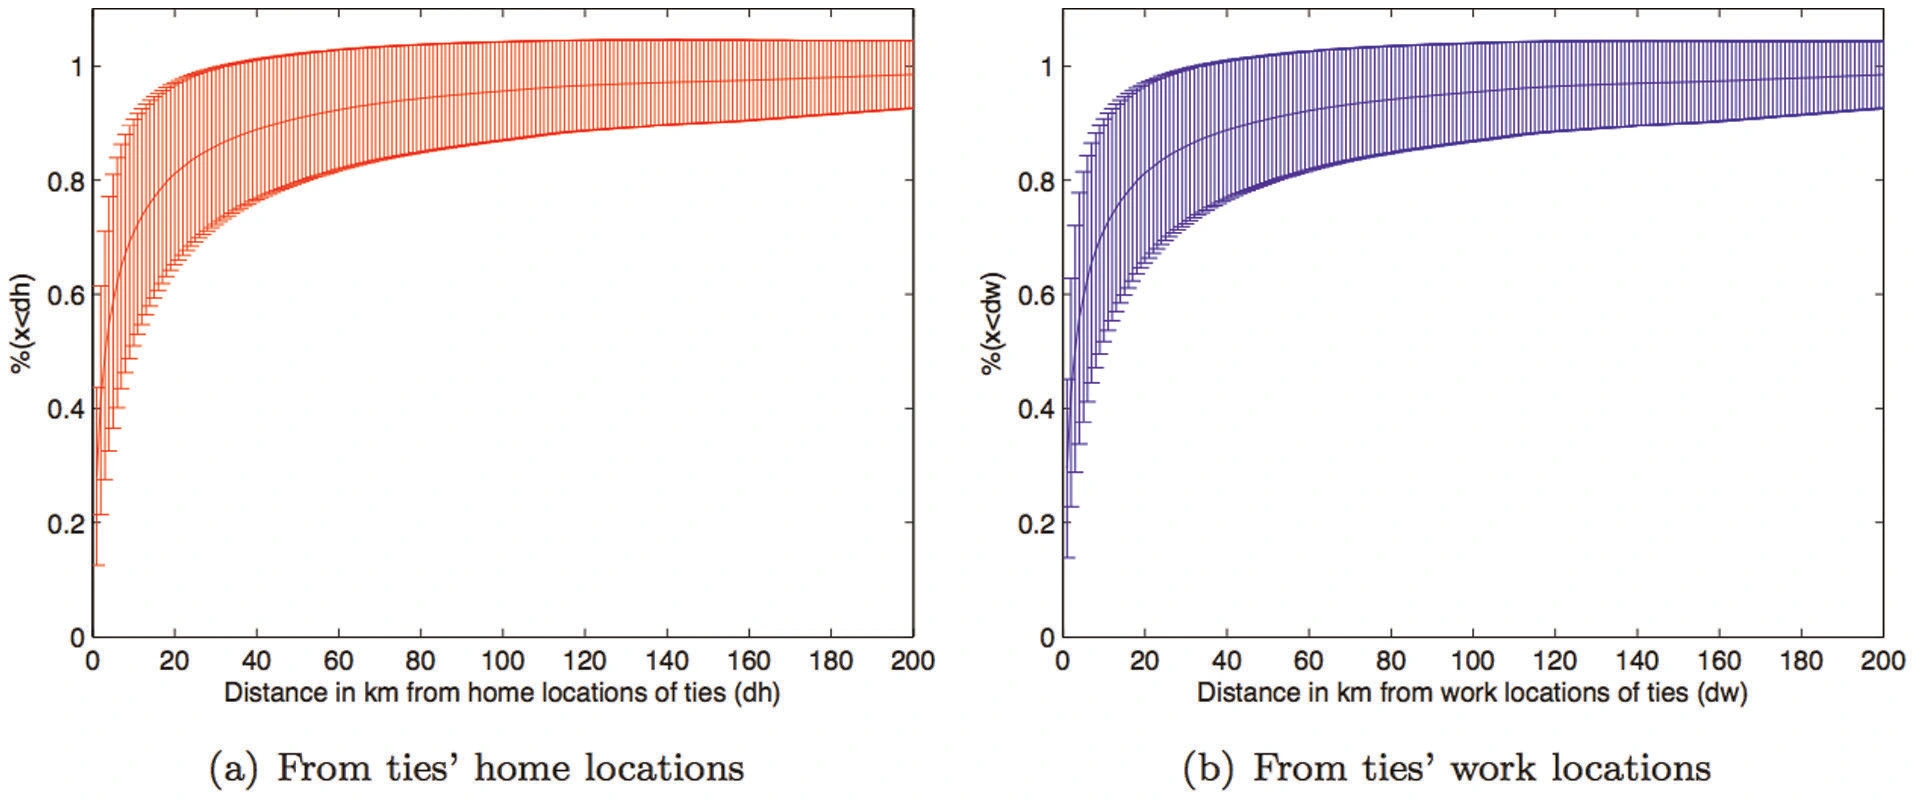
图 7|扩到多少公里,能罩住大部分到访地点?
(a)以联系人的家为圆心,横轴 0 到 200 公里,纵轴是活动范围中距离小于该值的比例。(b)以联系人的工作地为圆心,坐标相同。家的曲线在约 20 公里到达约 0.8,约 45 公里到达约 0.9,之后上升变慢。竖线是结果正文所称的标准差。来源:原论文 Fig. 7。
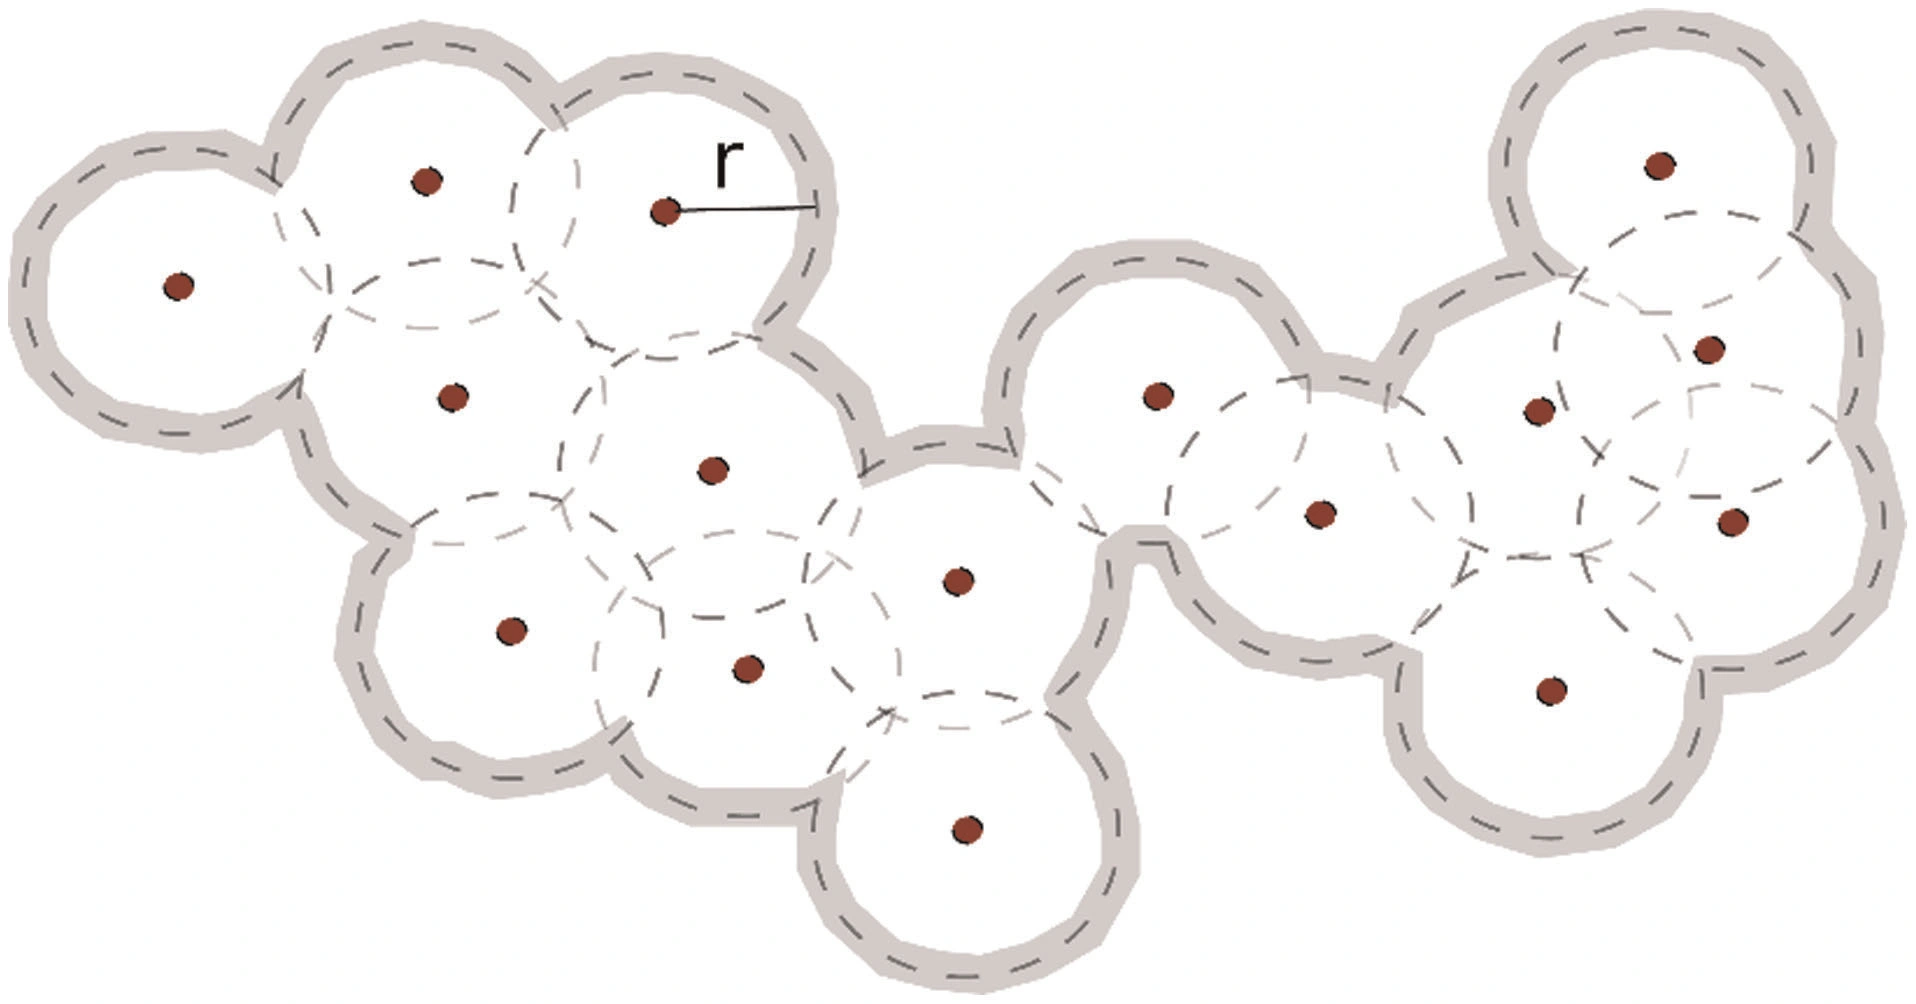
图 10|地理社会半径在图上是什么?
无字母子图,是示意图,不是某位用户的真实轨迹。圆点是社会联系的地理位置,r 是地理社会半径,灰色虚线轮廓是这些圆覆盖到的范围,用来表示由联系人位置推断的活动范围。一个到访地点只要进入任一圆内,就落在半径 r 内。来源:原论文 Fig. 10。
活动范围更靠近弱关系,这个 15% 是什么?
居住距离和活动范围的方向相反。人住得离强关系更近,但到过的地点有更高比例落在弱关系附近。图 8 的纵轴仍是“落在该距离以内的比例”。弱关系曲线在强关系曲线上方:同样的公里数,弱关系罩住的活动范围比例更高。结果段的英文写成更可能处于离弱关系一段距离之外,讨论段写成在物理上更靠近弱关系。纵轴是落在该距离以内的比例,弱关系更高,所以 15% 说的是到访地点的覆盖比例。住所仍然是强关系更近。
正文把这一差距概括为大约 15%,标准差 10.7%,p = 0.09。它没有印出每个距离上的差值。p = 0.09 高于常用的 0.05 界线,方向在图上,汇总差异还不稳定。10.7% 的汇总口径,正文也没有说明是跨距离、跨人,还是别的算法。
弱关系平均 42 条,强关系平均 7 条。地点更容易碰到某一条弱关系,可能只是因为弱关系更多。论文报告,每人只保留最强和最弱各一条联系时,方向仍然相近。正文没有给出这组对照的新百分比。
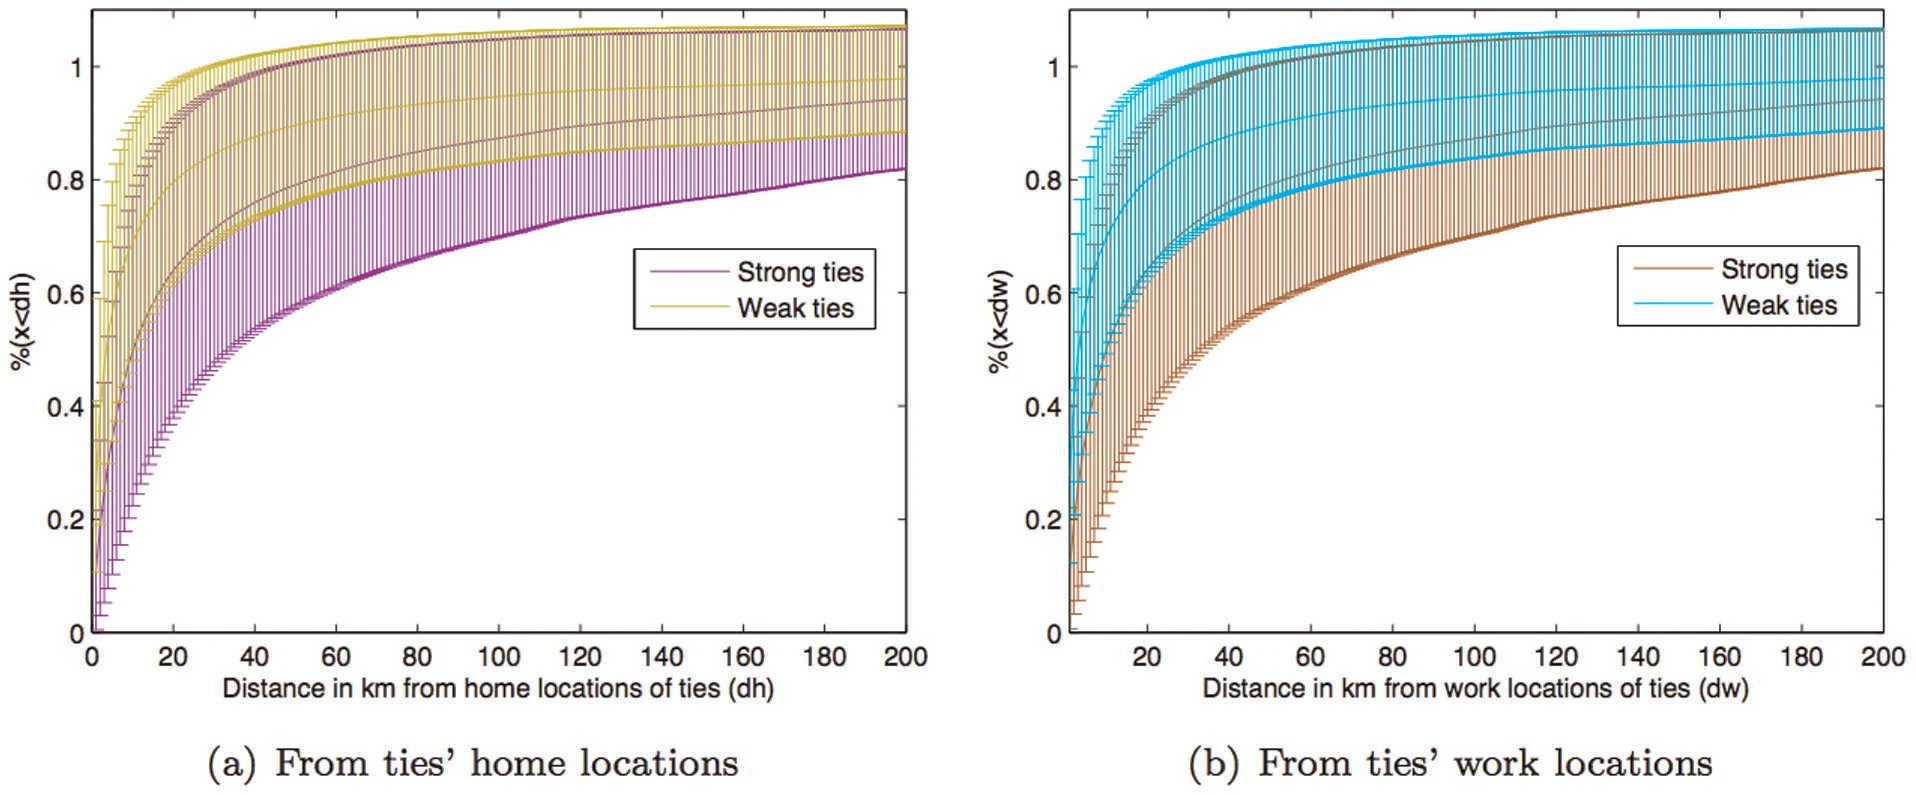
图 8|同样的距离,弱关系罩住的比例是否更高?
(a)以家为圆心:紫色是强关系,黄色是弱关系。(b)以工作地为圆心:棕色是强关系,青色是弱关系。横轴都是 0 到 200 公里,纵轴是活动范围落在该距离内的比例。两条弱关系曲线都在对应的强关系曲线之上,距离较近时分开更明显,接近 200 公里时都靠近 1。来源:原论文 Fig. 8。
人口密度怎样改写这个半径?
密度用的仍是 2001 年普查,分析单位是 308 个市镇。论文计算活动范围落在 r = 10、20、30、40 公里内的比例,看它如何随人口密度变化。比例随密度上升,可以用幂律拟合。短半径在低密度市镇的比例更低,但随密度上升得更快。高密度市区里,80% 的活动范围落在 10 公里的地理社会半径内。这是高密度一端的读数;前面全体受试者平均要 20 公里才到 80%,因为样本混有低密度地区。
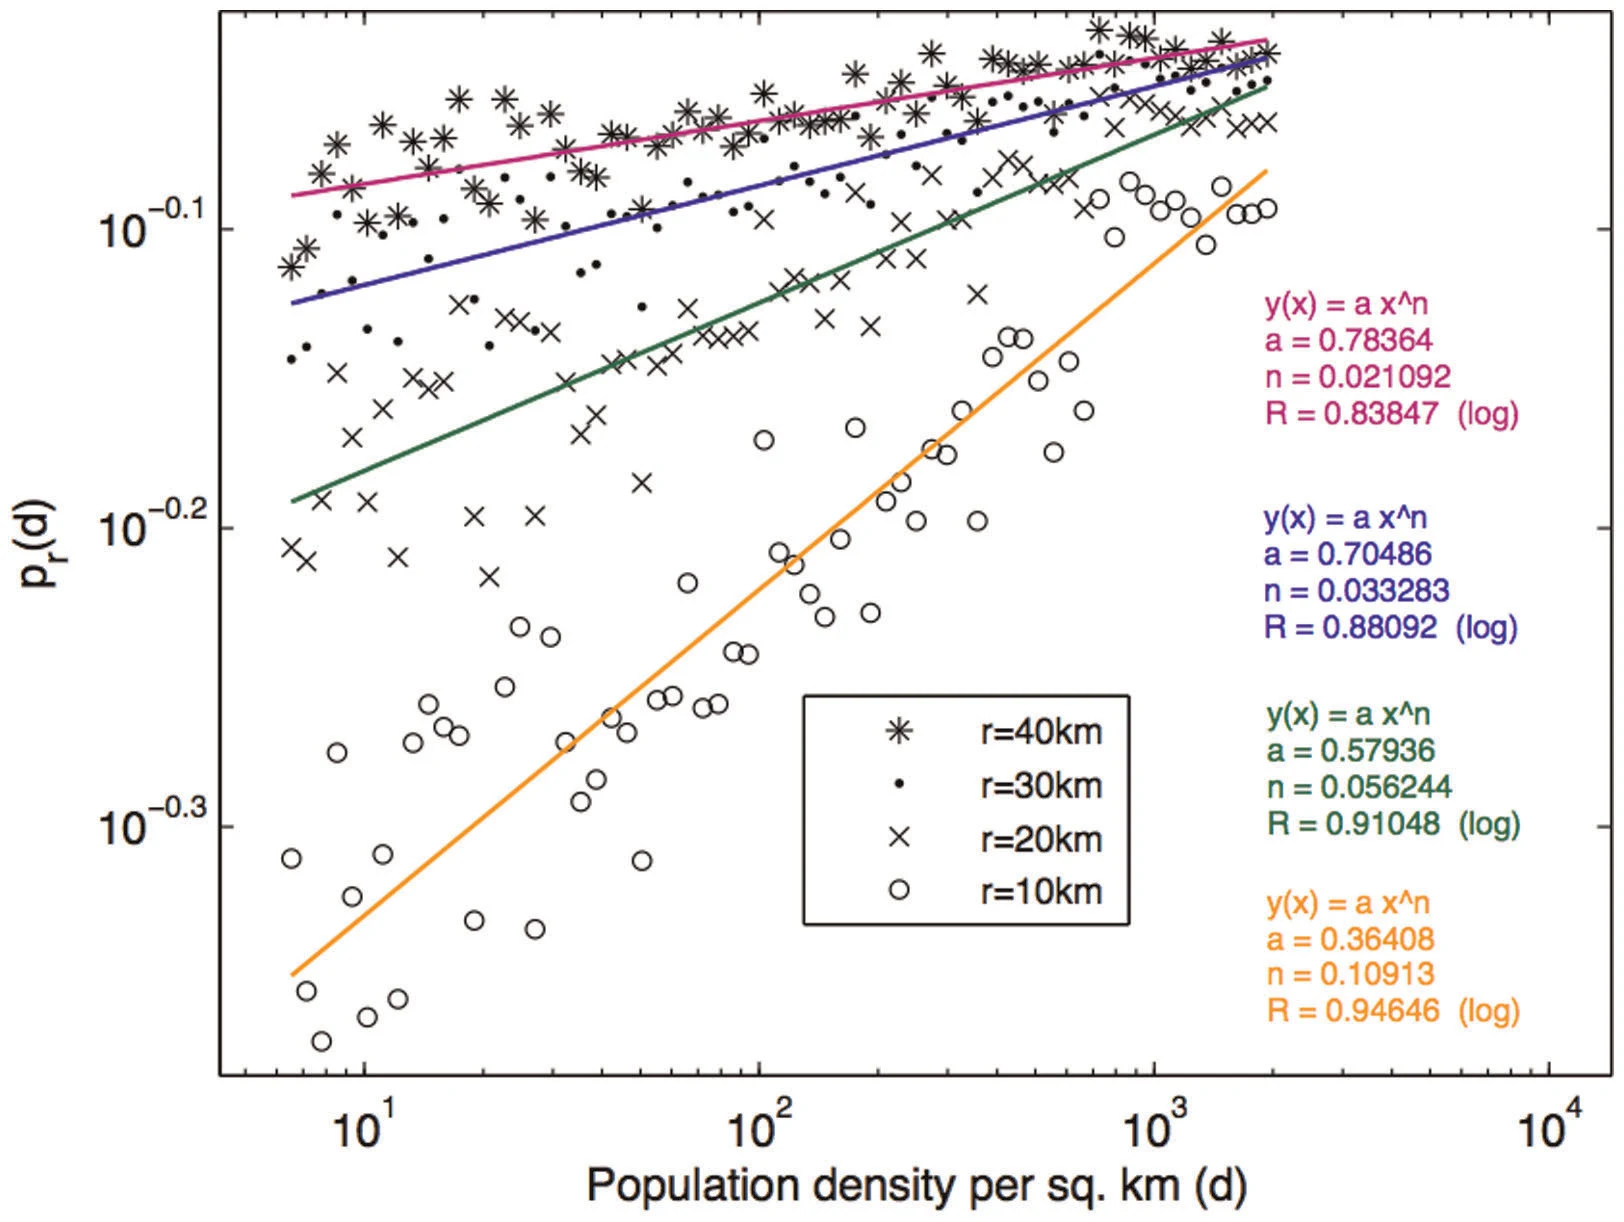
图 9|短半径的覆盖比例,是否随密度升得更快?
无字母子图。横轴是每平方公里人口,纵轴 p_r(d) 是活动范围落在半径 r 内的比例,两边取对数。刻度写成 10 的 −0.1、−0.2、−0.3 次方,换算约等于 0.794、0.631 和 0.501;接近 0.8 的位置对应正文所说的大约 80%。星号、圆点、叉号、空心圆分别是 40、30、20、10 公里。四条幂律 y = a × x 的 n 次方为:40 公里 a = 0.78364,n = 0.021092,R = 0.83847;30 公里 a = 0.70486,n = 0.033283,R = 0.88092;20 公里 a = 0.57936,n = 0.056244,R = 0.91048;10 公里 a = 0.36408,n = 0.10913,R = 0.94646。R 都是对数坐标下的相关系数。半径越短,指数越大,拟合的 R 也越高。来源:原论文 Fig. 9。
论文接着对每个人计算覆盖 80% 和 90% 活动范围所需的半径 r80、r90,再按居住地人口密度分组取平均。半径随密度下降。正文用幂律概括,图上的两条拟合形式并不相同:80% 更紧,90% 下降更慢,对数相关也更低。
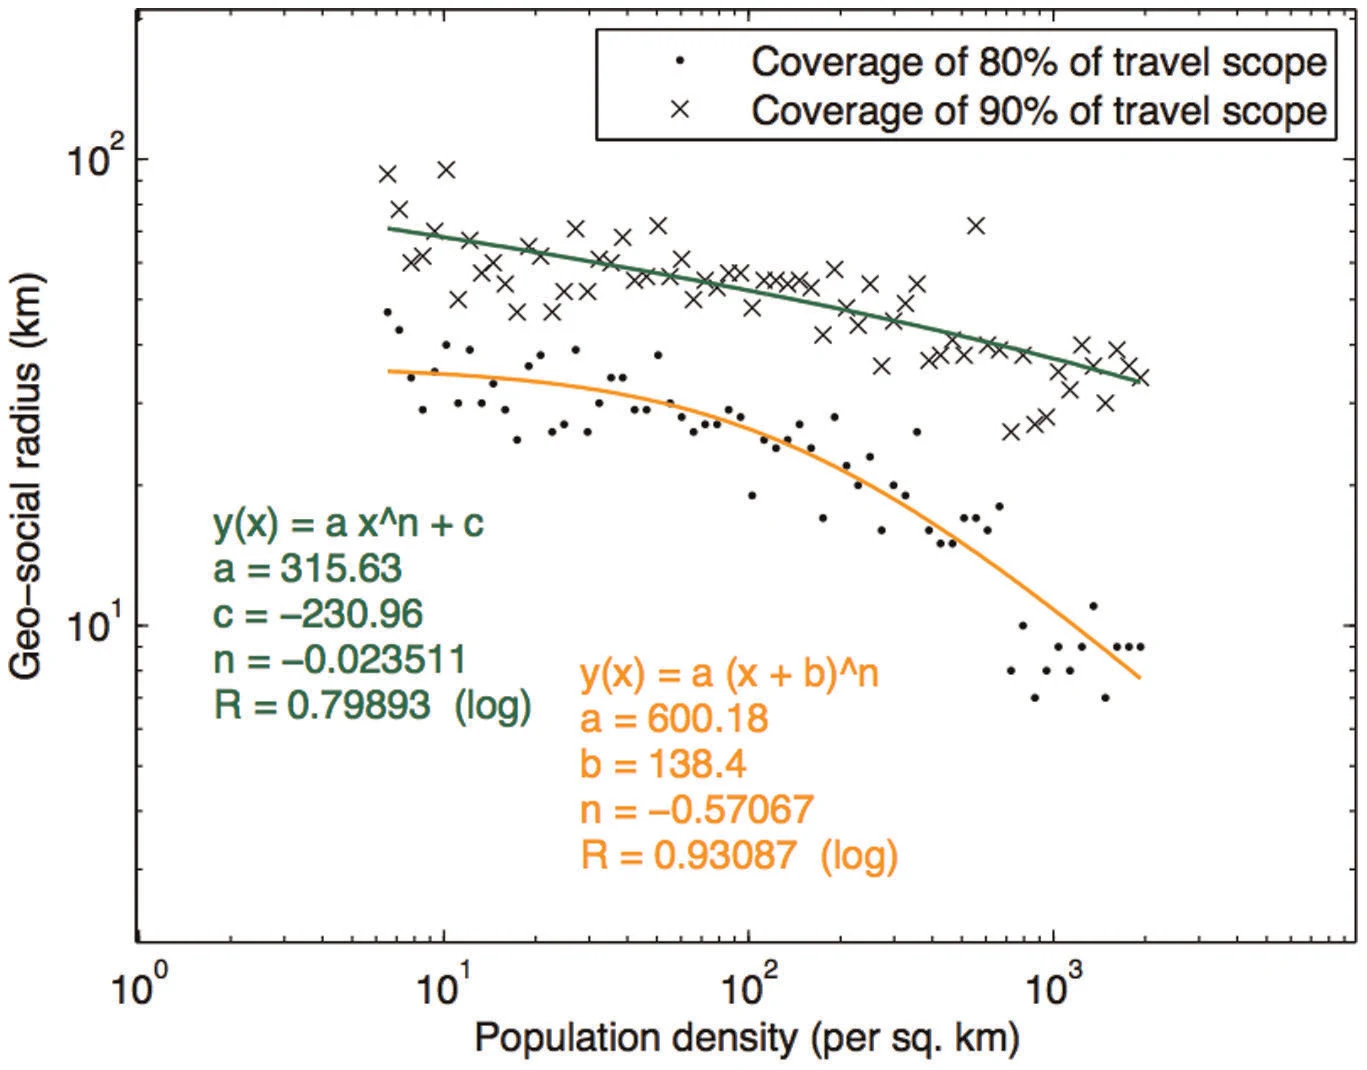
图 11|要罩住八成或九成地点,半径如何随密度缩短?
无字母子图。横轴是居住地每平方公里人口,纵轴是地理社会半径(公里),双对数坐标。圆点是 80% 覆盖,拟合 y = 600.18 × (x + 138.4) 的 −0.57067 次方,R = 0.93087。叉号是 90% 覆盖,拟合 y = 315.63 × x 的 −0.023511 次方 − 230.96,R = 0.79893。R 均为对数坐标下的相关系数。点是密度分组后的受试者平均,正文没有给出组距和每组人数。来源:原论文 Fig. 11。
在这条关系下,里斯本和波尔图的 r80 大约 7 公里。正文点名的密度较低市镇里,Parades、Santa Maria da Feira 和 Vila Nova de Famalicão 需要 15–20 公里;Albufeira、Barcelo 和 Oliveira do Bairro 需要 20–25 公里。摘要把 Parades 和 Santa Maria da Feira 写作大约 15 公里,落在正文 15–20 公里区间的下端。这些是 r80,分母是当地受试者到过的不同地点里被覆盖的 80%。
这些公里数能搬到葡萄牙以外吗?
论文把 r80 与密度的关系套到其他城市的人口密度上,得到一组估计。正文没有印出当时采用的密度,也没有用这些城市的通话记录复核。
| 城市 | 论文给出的 r80(公里) |
|---|---|
| New York City | 2.86 |
| Los Angeles | 5.08 |
| London | 4.11 |
| Paris | 1.99 |
| Mumbai | 1.99 |
| Bangkok | 4.25 |
| Tokyo | 2.41 |
| Shanghai | 3.51 |
| Seoul | 2.18 |
| Sydney | 5.79 |
| Johannesburg | 5.51 |
因此,巴黎的 1.99 公里是葡萄牙拟合的外推值。换运营商、换基站间距或换强弱关系的定义,同样的人口密度不必得到同样的半径。
还有几项边界直接限制这些公里数。位置只在建立蜂窝连接时出现,一天中的其他地点看不到;长期汇总只能补上反复出现的基站,补不上从未触发通话的地点。空间分辨率由基站覆盖决定,14 平方公里和 0.13 平方公里不是同一把尺子。2007 年葡萄牙人口统计的净迁移率是 0.18%;作者此前对这份数据的研究给出 0.03% 的迁移率。两个数字的分母不同,一个是人口统计口径,一个是该数据集。亚速尔和马德拉距本土大约 600–1000 公里,论文没有剔除在那里打过电话的人,认为假期只占常规生活的一小部分,影响有限。葡萄牙作为申根区的发达经济体,作者认为结果更可能适用于社会、文化和经济状况相近的国家;这是适用范围上的判断,不是在其他国家重复了同一测量。
论文留下的问题包括:地理社会半径如何随关系强度和联系数量变化,最常去的地点在社会联系地理中起什么作用,以及移动与社会网络之间更定量的关系。引言里列举的内容分发、推荐系统、城市规划和流行病学,是这类测量可能用到的场景,不是这篇观察研究已经检验过的效果。
一句话总结
住所平均离强关系更近大约 11 公里,到过的地点却有更高比例落在弱关系附近;就全体分析样本而言,最近联系人住所向外 20 公里平均罩住 80% 的不同到访地点,而这个半径会随居住地人口密度缩短。
核心来源
- PLoS ONE 正式版,Phithakkitnukoon S, Smoreda Z, Olivier P (2012) Socio-Geography of Human Mobility: A Study Using Longitudinal Mobile Phone Data. PLoS ONE 7(6): e39253。2011年11月10日收稿,2012年5月22日接受,2012年6月28日发表。资助来自纽卡斯尔大学计算学院,资助方未参与设计、分析和发表决定。
- 正文图 1–11 均出自该正式版。支持信息列出补充图 S1–S10,正文用它们放置零模型、标准误和逐距离 p 值;这些图的具体数值未写入正文。
作者介绍
三位作者的单位和分工,以论文署名页及文末贡献说明为准。
- Santi Phithakkitnukoon:通讯作者,署名英国纽卡斯尔大学计算科学学院 Culture Lab。负责构思与设计、完成实验、分析数据、撰写论文并主持研究。页上邮箱为 santi@newcastle.ac.uk。
- Zbigniew Smoreda:署名法国伊西莱穆利诺 Orange Labs 的网络与服务社会学及经济学部门。提供数据集,并参与构思、分析、工具、写作与讨论。论文声明他受雇于 Orange Labs。
- Patrick Olivier:同样署名纽卡斯尔大学 Culture Lab。参与构思、分析、提供计算工具、写作与讨论。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若弱关系只是因为条数更多才罩住更多地点,把两边抽成同样条数再比,差距可能缩小。论文已经报告最强与最弱各留一条时方向仍在,那是两个极端,还不是从强、弱关系里随机抽出同样多的联系。后一种比较才能分开“关系弱”和“联系多”。
城市服务若全国共用一个公里门槛,在里斯本大约 7 公里已对应八成地理社会覆盖,在论文点名的较低密度市镇却要 15–25 公里才到同一覆盖。同一个 7 公里,在两地对应的覆盖比例不同。把巴黎写成 1.99 公里,用的是葡萄牙曲线和外部密度;两座人口密度相同、基站间距或互惠通话比例不同的城市,仍可能测出不同的 r80。值得先在同一运营商、同一国内重拟合密度与半径,再决定这条曲线能不能带走。