另一个人的移动,什么时候才真能帮你预测下一段路?
论文名片|Manlio De Domenico、Antonio Lima、Mirco Musolesi,Interdependence and predictability of human mobility and social interactions,Pervasive and Mobile Computing,2013,9:798–807,2013年7月19日在线发表。DOI:10.1016/j.pmcj.2013.07.008。本文依据这一期刊版;作者写明,它扩展了提交给2012年诺基亚移动数据挑战研讨会的同题报告。这是轨迹上的预报比较,不是检验社交是否导致出行的实验。
两个人若常在相近的时间出现在相近的地方,下一段位置可以有两种报法。一种只重放其中一个人自己的定位历史。另一种再加入一条与他相关的轨迹。误差会不会因此收紧,取决于那条轨迹是否真的携带关于他的信息,而不是取决于通讯录里有没有这个名字。
这项研究的方向性结果是:移动之间的互信息可以改进位置预报。在很小的手机样本里,通讯录关系伴随着更小的配对预报误差;作者同时写明,即便没有社会联系,只要两条轨迹的动态高度相关,预报仍会改进。旧金山出租车没有友谊记录,却提供了后一种证据。相关可以提示身体靠近或远程联系可能存在,不能据此说社交导致了移动。
先说结论
- 用户179最后1000个GPS点上,24阶多元自回归的位置误差为大约3°这一量级,高度误差一般大于600米;同一批点上,近邻数固定为10的多元非线性预报把位置误差降到0.19°,高度误差降到219.43米。这是一个人的对照。
- 在出租车轨迹上,保留原始分布和线性自相关、打乱非线性结构之后,95%置信水平下多数轨迹拒绝“线性随机过程就够了”。多数轨迹的合适嵌入维数接近30;伪近邻比例下降本身不能把确定性与随机性绝对分开。
- 诺基亚数据的表1只有三对用户。无通讯录关系的026与127,位置误差0.167°、高度误差66.33米;有通讯录关系的063与123为0.011°和20.95米,094与009为0.003°和5.57米。相对这一对无关系参照,位置误差大约降到1/15和1/56。作者写明用户很少,不能当成普遍规律。
- 出租车比较使用137条单独轨迹,配对情形对应9316条轨迹;高互信息指这些配对里最高的5%。正文称该方法能在80%的情形中,把未来30分钟的位置误差控制在轨迹自身位置统计不确定性以内,高互信息的优势大约维持到90分钟。到3小时,三种预报仍有超过50%的轨迹达到这一标准。
手机用户和出租车,记录的是两种移动
人类移动性(human mobility)在这里指人在地理空间中的位置如何随时间变化,不是搬家或户籍迁移。论文用了两套已经采集好的定位序列。
第一套来自诺基亚移动数据挑战。作者收到的数据含39名用户的GPS、电话号码、通话与短信记录、蓝牙和无线局域网记录。其中14人没有电话号码,无法判断他们之间是否以及何时通话,因此后续使用其余25人。短信和无线局域网出现在数据说明里,正文报告的结果没有使用它们。
第二套是Cabspotting:约500辆出租车在旧金山行驶30天的定位。分析限定为轨迹长于25000个GPS读数的178辆。这是职业驾驶,受班次和叫车需求约束,不是居民全天活动的样本。作者没有出租车司机之间的友谊或同事关系。
两套序列的采样间隔都不固定。一个点是一次GPS记录,只覆盖被写下的位置。
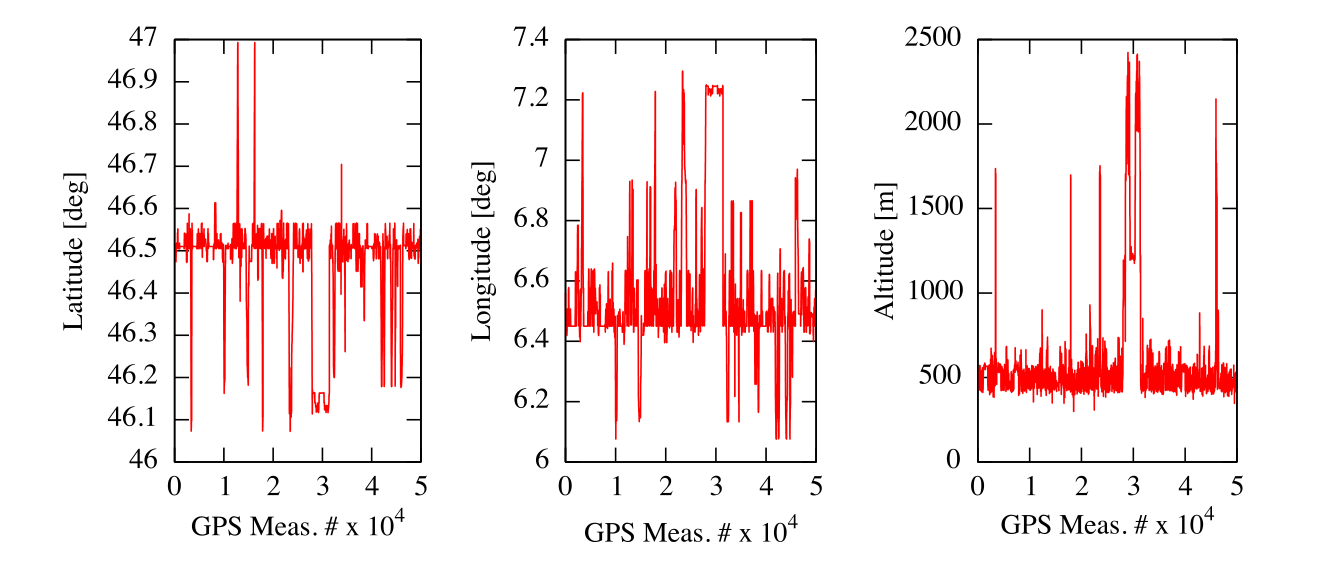
图 1|单看一条手机轨迹,能看见稳定的周期吗?
无字母子图,从左到右是用户179的纬度、经度和高度。横轴是按记录顺序排列的GPS测次,单位为万次,画到约5万次。纬度大约落在46°到47°,经度大约落在6°到7.4°,高度多数时候为数百米,偶发超过2000米。曲线有长时间的平台和突然的尖峰。正文指出,从这条序列看不出明显周期。它是一个人的原始记录,不是25人的平均轨迹。来源:原论文 Fig. 1。
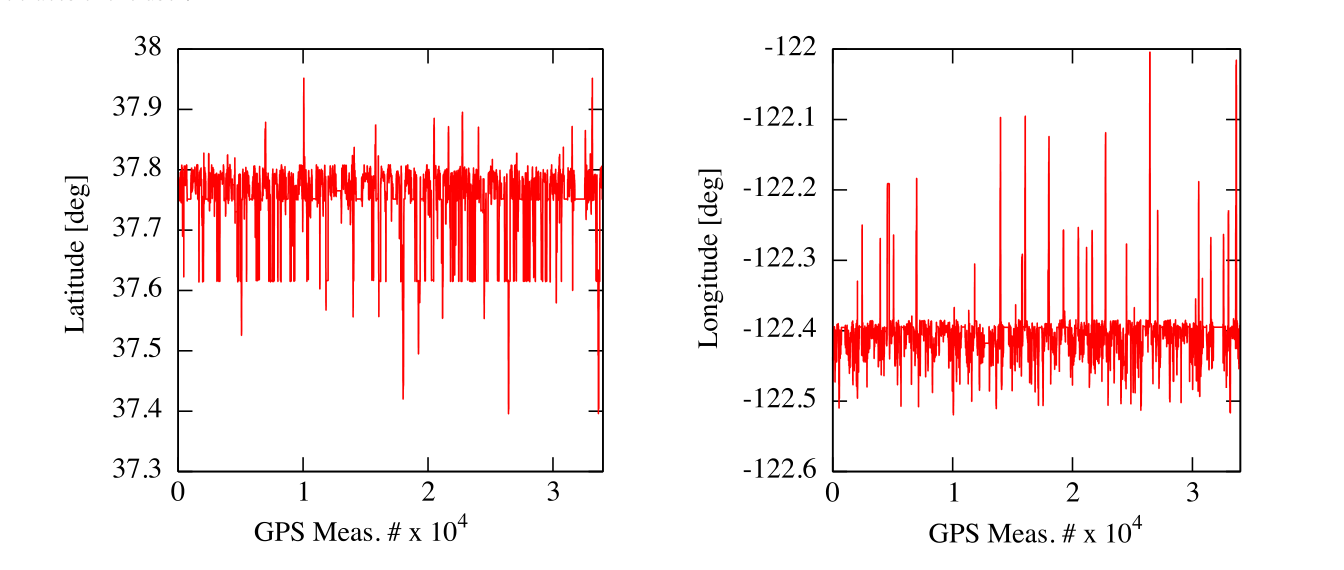
图 2|出租车的原始轨迹同样没有简单周期吗?
无字母子图,左为纬度,右为经度,没有高度。示例车是abgibo:纬度大多在37.6°到37.8°,经度大多在−122.5°到−122.4°,横轴测次略多于3万,因而满足“长于25000个读数”的筛选。活动集中在一小片区域,同时有频繁的短促偏离。这只说明这一辆车的记录看起来不规则,不能把图中的经纬度范围当成178辆车的共同活动范围。来源:原论文 Fig. 2。
诺基亚数据里,每个时刻的状态包含一天中的小时、纬度、经度和高度。出租车没有高度,状态少一维。预报因此不只看见地图坐标,也看见记录落在哪个小时。日常作息或班次本身就可能贡献可预测性。论文没有去掉小时后再预报一次,无法把钟点的作用和另一个人的移动拆开。
同一个人的最后1000个点,线性预报偏到哪里?
图1和图2看起来嘈杂。接下来要问的是:用过去若干步的线性组合,能不能接上下一步。拟合的是多元自回归加噪声,阶数按赤池和施瓦茨信息准则定为24。检验用的是用户179最新的1000个GPS点,这1000个点没有参与阶数选择。本节的度和米,都是这1000个点上的误差。
对用户179,线性预报的位置误差约为3°,高度误差一般大于600米。位置误差按预测点与真实点的测地距离计算,正文以度报告,没有换算成公里。大约3°是量级,不是印刷成3.00的精确值。
同一批1000个点改用多元非线性预报。做法是延迟嵌入:把当前值和若干延迟值放在一起,构成状态;再在历史上寻找与最近状态相近的片段,用这些片段各自往后若干步的位置的平均作为预报。用户179的近邻个数固定为10,正文没有展示换成其他近邻数的结果。这样得到的位置误差为0.19°,高度误差为219.43米。位置上的改善远大于高度:高度从“一般大于600米”降到219.43米,缩小的倍数明显小于纬度经度。0.19°仍然是这一人和这10个近邻下的检验误差,不是25人的均值,也不说明未来行程已经被机制解释。
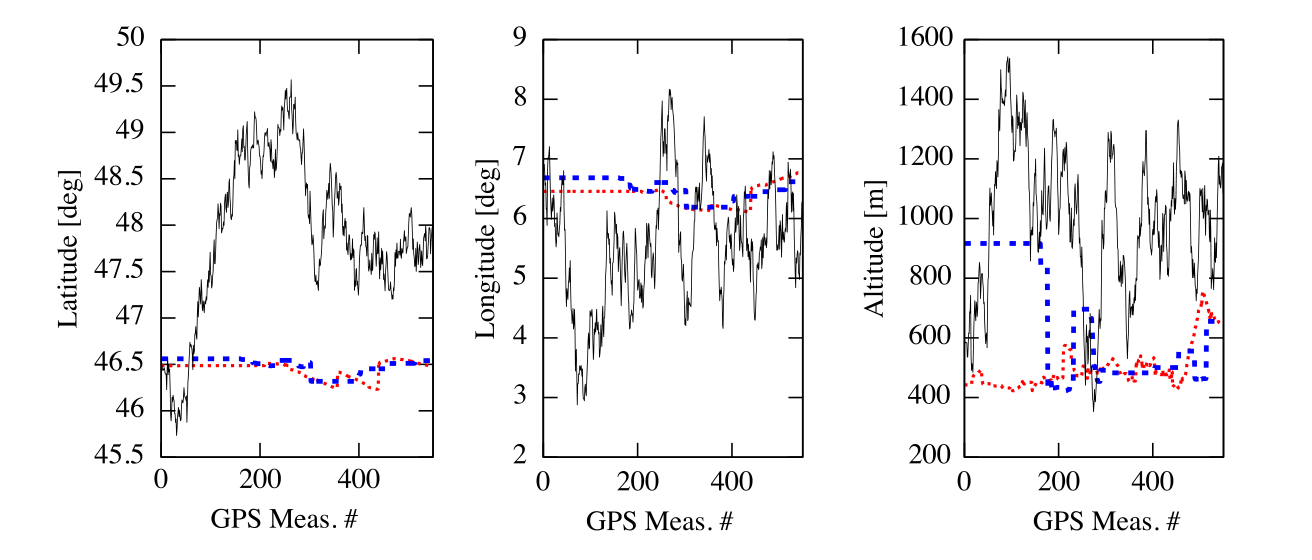
图 3|同样一段行程里,线性预报和非线性预报各落在哪里?
无字母子图,左起纬度、经度、高度。横轴是预报序号,图中只画前600次;正文说这大约对应60小时。点线是真实移动,实线是图注所称的ARMA线性预报,虚线是多元非线性预报。图中点线为红色,实线为黑色,虚线为蓝色。纬度和经度上,虚线贴近点线,实线大幅偏离;高度上虚线比实线更靠近点线,仍能看到偏差。0.19°和219.43米是全部1000个检验点的总体误差,不能从图上某一个尖峰直接读出。来源:原论文 Fig. 3。
正文在不同段落把真实轨迹说成点、三角形或点线。读图时以图3图注为准:点线为真实值,实线为线性预报,虚线为非线性预报。
延迟该取几小时,嵌入要有多深?
非线性预报依赖两个选择:往回看多远,以及状态要堆多长。作者对各个分量使用同一个时间延迟。延迟取平均互信息的第一个局部极小,记为τ_min。对同一用户,各分量的这个延迟处于同一量级,所以可以用一个数。
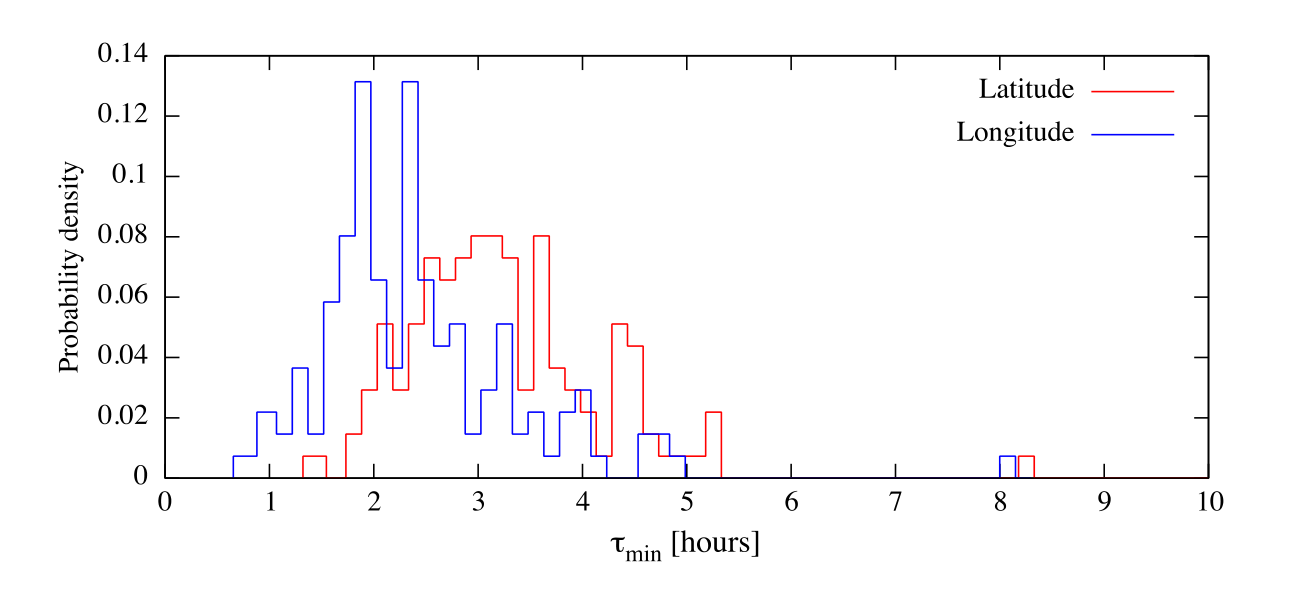
图 4|构造状态时,该回看大约几个小时?
无字母子图。横轴是出租车纬度、经度序列的τ_min,单位为小时;纵轴是概率密度。红线为纬度,蓝线为经度。两条分布都铺在数小时里,约8小时处还有很小的一截。正文给出的平均值大约是3小时。这是嵌入用的回看间隔,不是后文5分钟、30分钟或90分钟的预报时效。来源:原论文 Fig. 4。
嵌入维数用伪最近邻来选:在m维里靠得很近、到了m+1维却分开的点,算作伪近邻。伪近邻比例足够小,才把m当作合适的嵌入维数。作者用TISEAN软件计数,并把“例如低于5%”作为足够小的例子。
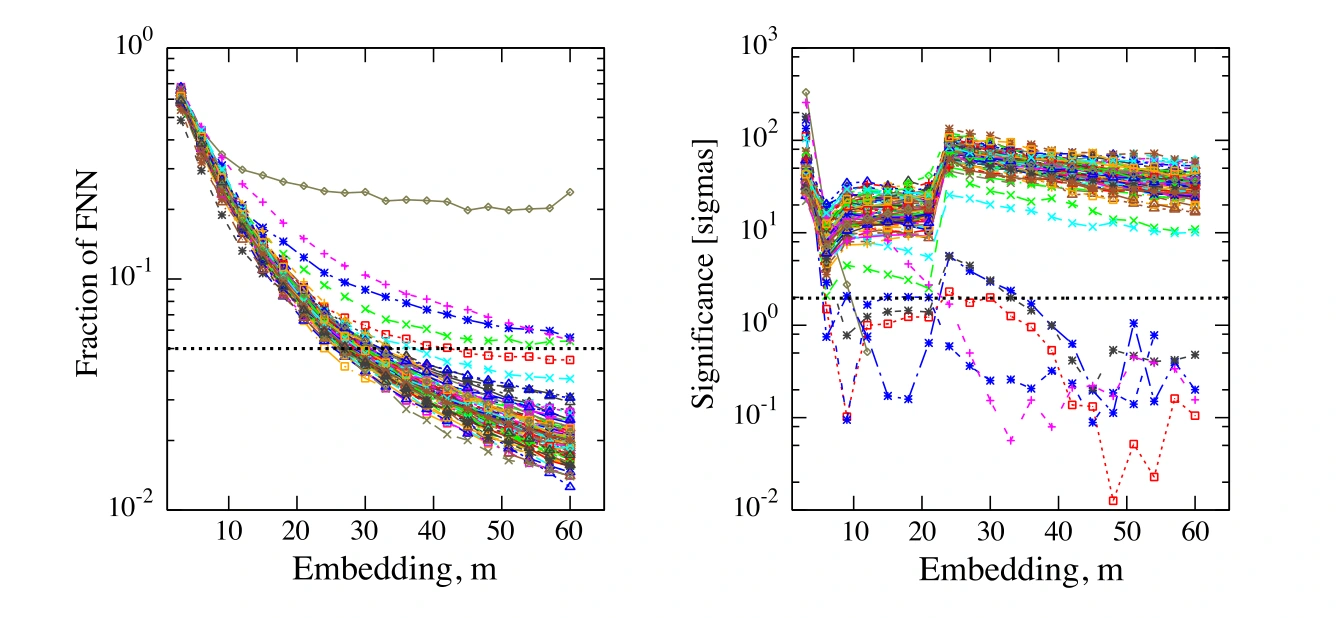
图 5|这些轨迹能否被线性随机过程解释?
无字母子图,每条曲线是一条出租车轨迹。左图纵轴是伪最近邻比例,横轴是嵌入维数m;横虚线是作者选定的阈值,正文举例为低于5%。多数曲线在m接近30时降到这条线附近或以下,少数曲线维持在高处。脚注写明,嵌入维数明显不同的例外少于全部轨迹的5%。右图纵轴是显著性,横虚线对应正文的1.96,也就是事先规定的5%检验水平、95%置信。多数曲线远高于1.96,也有落在线附近或以下的例外。来源:原论文 Fig. 5。
右图的对照是替代序列。替代序列用迭代幅度调整傅里叶变换生成,保留原始轨迹的概率分布和自相关,去掉非线性与非平稳。判别量仍是伪最近邻比例。若真实轨迹与这些替代序列的差距超过1.96,就在95%置信水平上拒绝“线性随机模型足以描述移动”。多数出租车轨迹被拒绝,而且这一结论不太随所选的m改变。
由此能说的是:短程相关之外,还有线性自相关解释不了的结构,其中可能混有确定性成分和噪声。伪最近邻比例随维数下降,并不能单独证明运动是确定性的。它也没有指出这份结构来自社交、班次还是路网。
通讯录关系对应的误差,到底小在哪一对上?
社会联系在诺基亚数据里的操作定义很窄:若一个人出现在另一个人的通讯录中,就把两人视为朋友或熟人。这不是双方确认的好友,也没有关系强度。作者后来写明,数据里没有另行提供真实或虚拟的社交关系,通讯录是当时能用的最强定义。
预报时,把两个人的状态接在一起输入同一个非线性预报器。诺基亚数据中每个人有小时、纬度、经度、高度四项,两人合起来是8维。出租车没有高度,配对状态更短。比较的是加上另一条轨迹之后,位置和高度误差如何变化。
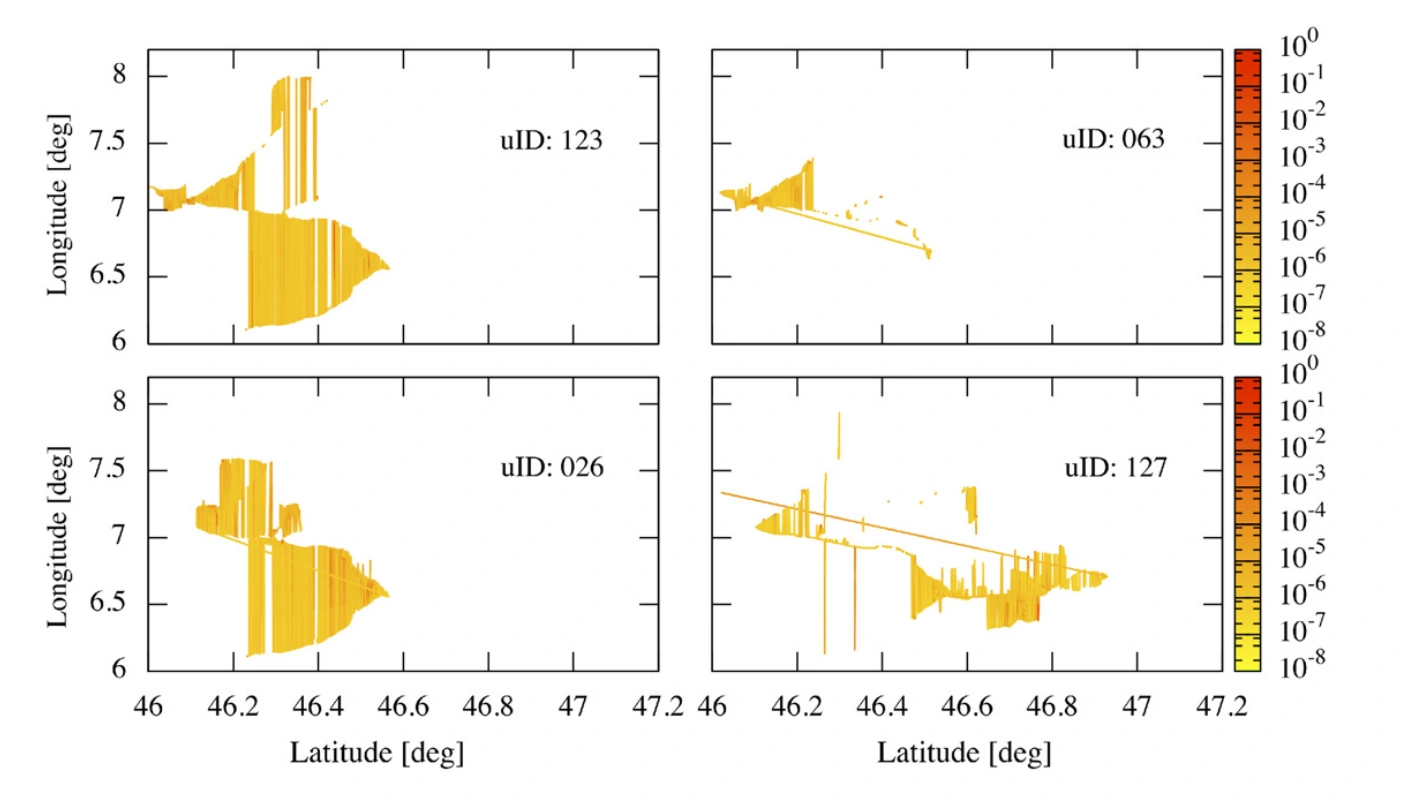
图 6|通讯录关系是否等于活动范围长得一样?
无字母子图。上排uID 123与063被正文标为有通讯录关系,下排026与127没有。横轴纬度,纵轴经度,颜色表示地点占用频率,色标从10^0到10^−8。123与026都占据较宽的区域,063更集中,127呈另一种条带。这张图给出四个人的地点分布和关系标签,不能单独证明通讯录关系会使活动范围更相似。来源:原论文 Fig. 6。
误差仍用各分量的均方根:N个检验点上,预测值与真实值之差的平方求平均,再开方。单人例子里N=1000。表1使用同一误差定义,但没有逐对重印N。位置误差是测地距离,高度误差单独以米计。
| 用户对 | 通讯录关系 | 位置误差(°) | 高度误差(米) |
|---|---|---|---|
| 026与127 | 无 | 0.167 | 66.33 |
| 063与123 | 有 | 0.011 | 20.95 |
| 094与009 | 有 | 0.003 | 5.57 |
表里无关系的参照只有一对。0.167°对0.011°约为15倍,0.167°对0.003°约为56倍,所以位置误差相对这一对参照下降超过一个数量级,还没有到两个数量级(100倍)。高度从66.33米到20.95米约为3倍,到5.57米约为12倍。063与123的高度改善并没有达到一个数量级。正文另称,相对只使用单人轨迹,诺基亚数据上的改进至少有一个数量级,常常有两个数量级。逐人的单人基线只完整印刷了用户179的0.19°和219.43米,不能把表1的三行直接除以0.19°。
作者自己强调,25名用户太少,很难声称这些发现普遍成立。
通话、近距离接触和互信息,是同一件事吗?
互信息(mutual information)衡量一条轨迹能减少另一条轨迹的多少不确定性。两条移动若相互独立,互信息为0。地点分布在这里表示用户停留在各个位置上的时间占比。本文使用自然对数,单位是奈特(nat)。互信息没有固定上限,所以后文的高、低是在一批配对内部比较,不是超过某个通用阈值。
对25人里的每一对,作者统计蓝牙接触和通话的总次数,再对至少有一次接触的配对,把联系占比画到互信息上。联系占比的分母正文没有写明,因此只能看相对高低,不能把纵轴换算成通话次数。
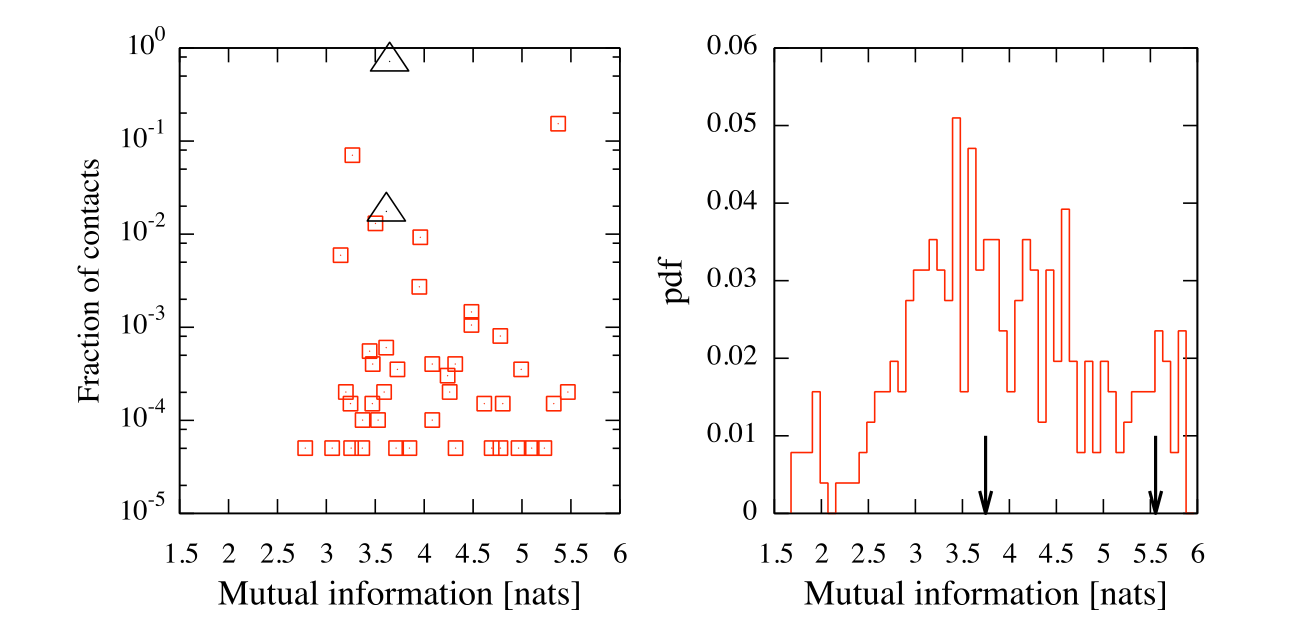
图 7|联系占比高的配对,互信息也更高吗?
无字母子图。左图只含至少有一次蓝牙或通话联系的用户对:横轴互信息,单位奈特;纵轴联系占比,为对数刻度。方点很分散。三角是其中有通讯录关系的两对,联系占比高于大多数方点,但两枚三角彼此相差很大,而且没有落在横轴最右端。右图是完全没有联系记录的用户对的互信息分布;箭头标出仅有的两对“有通讯录关系、却没有联系记录”的人。正文没有印出箭头的精确坐标。来源:原论文 Fig. 7。
左图没有呈现一条清晰的上升关系。右图说明,通讯录关系可以和零次蓝牙或通话记录同时出现,其互信息也落在“没有联系的人”的分布里。作者写明,这些图案只属于这个小数据集,统计不足,不能外推。因此,通讯录、身体接近、远程通话和移动互信息是四件相关但并不重合的事。
没有社交标签时,高互信息还能维持多久?
出租车样本更大,也没有社交标签。作者仍把另一辆车的历史接进预报,用互信息挑选配对。高互信息定义为互信息处于最高5%的配对,低互信息是其余配对。
这里的误差随预报时间累积。每个坐标先计算从预报起点到时刻t的均方根,位置误差再由纬度和经度两项合成。较早的偏差会留在这个平均里。论文把累积误差e(t)与该轨迹位置的统计不确定性σ_data相比。e(t)不大于σ_data时,认为预报落在轨迹自身的起伏以内。正文没有给出σ_data的计算公式。
单独预报的统计使用137条轨迹。配对情形正文写的是9316条。137×136/2正好等于9316,与137条轨迹的全部无序两两配对数相同。引言里轨迹长于25000个读数的出租车是178辆;正文没有说明178为何在这项比较中变成137。高互信息若按9316对中的最高5%理解,是配对中的一档,不是5%的司机,也不是137辆车各有一条独立的高相关轨迹。正文没有把高、低两档的样本量分开印刷。
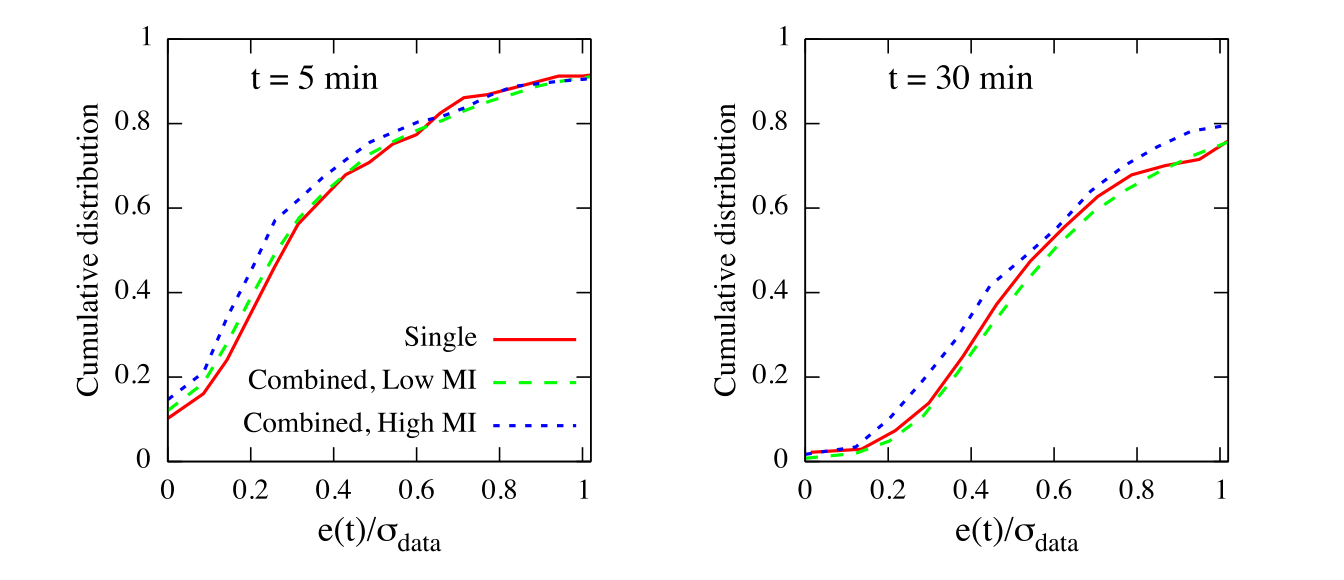
图 8|未来5分钟和30分钟,有多少预报落在不确定度以内?
无字母子图。左图为5分钟,右图为30分钟。横轴是累积位置误差除以σ_data,纵轴是累积分布。红色实线只使用本车历史,绿色虚线是低互信息配对,蓝色点线是高互信息配对。蓝色曲线更靠左上,表示有更大比例的轨迹具有更小的误差比。正文的概括是:该方法在80%的情形中,未来30分钟的误差不大于统计不确定性。图上没有另印三条曲线在横轴等于1处的精确百分比。来源:原论文 Fig. 8。
80%是30分钟这一档里、误差不大于σ_data的情形占比。它不表示每辆车的误差缩小到原来的80%,也不等于5分钟面板上的读数。低互信息曲线与单独预报很接近。随便配上一辆车,带来的是绿色曲线,而不是图中更靠左上的蓝色曲线。
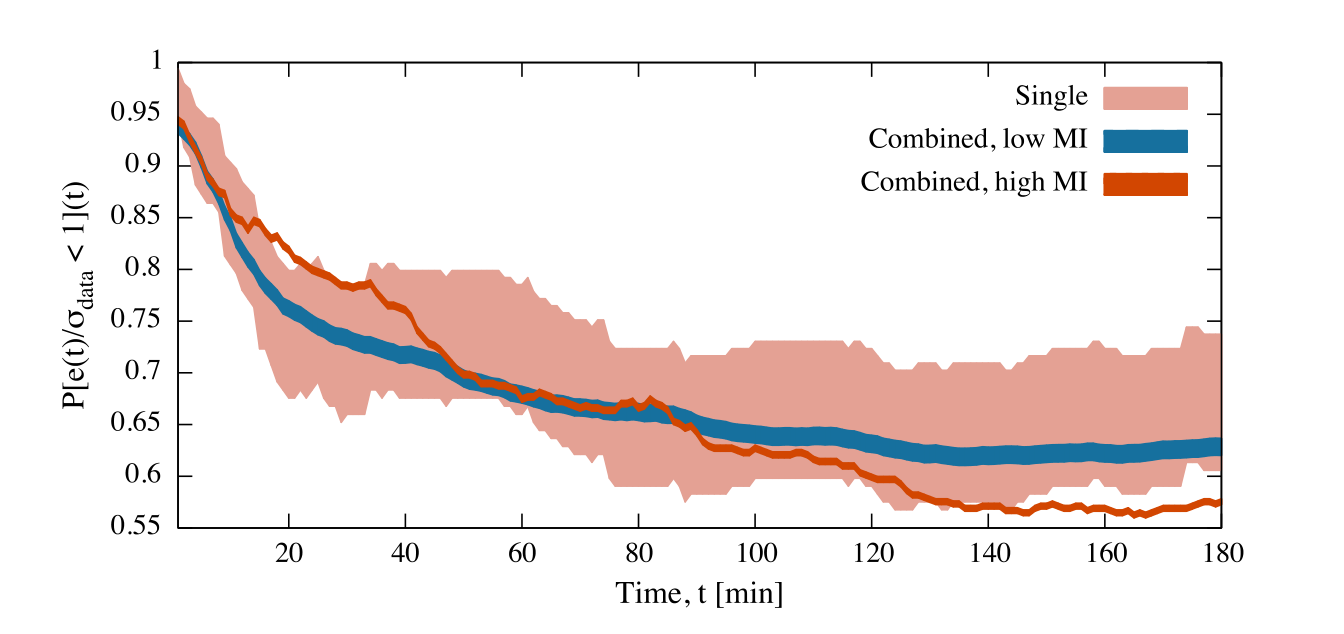
图 9|高互信息的优势能维持到第几个小时?
无字母子图。横轴是预报时间,画到180分钟;纵轴是满足e(t)/σ_data < 1的轨迹比例。浅红色带是只使用本车历史的90%置信带,蓝色是低互信息,红色是高互信息。三条曲线都随时间下降。正文称高互信息在大约90分钟以内不差于另外两种;图的后半段红色曲线落到蓝色之下,所以这一优势没有覆盖整个3小时。单独预报只有137条轨迹,色带比配对情形宽,并与另外两条重叠。因此曲线的高低不能读成每一辆车都稳定地差出一个固定比例。正文写明,直到3小时,每种预报仍有超过50%的轨迹落在统计不确定性以内。来源:原论文 Fig. 9。
图9的纵轴使用严格小于1。正文在定义“可接受”时,也把等于σ_data算进去。两条表述差在等号,不改变“超过50%”和“大约90分钟”这两个印刷结论。
预报变准之后,还剩哪些边界?
相关存在于这些轨迹之间,因果并没有被识别。通讯录可以用来挑选输入,但作者写明:判定社会联系的标准既可能提高、也可能降低预报质量;两条轨迹高度相关时,即使不存在社会联系,预报仍会改进。出租车结果把后半句单独托住了,因为那里根本没有社交标签。
手机样本只有25人,表1只有三对,图7被作者明确拒绝外推。引言中的178辆长轨迹出租车,和后来单独预报使用的137条轨迹,正文没有解释差额从何而来。σ_data没有公式。0.19°只属于用户179、最后1000个点和10个近邻。状态里包含小时,钟点的贡献没有被拆出。序列采样不均匀,图3里“600次预报大约60小时”只描述这一段,不能换成整套数据都是每6分钟一个点。
计算上也有作者给出的限度。两人以上一起算互信息,代价随组合规模迅速增加;他们实际做的是成对计算。嵌入空间大于约40维就不可行,而单条轨迹的嵌入维数已经常常接近30,所以同时使用的轨迹不宜超过三条。作者举例说,问题规模常常不超过大约100条最相关轨迹,例如一个人联系较密的圈子;这是对规模的说明,不是从这两个数据集数出来的朋友人数。
作者还提到,以后可以采用不同分量使用不同延迟,以及用局部多项式代替局部常数。这两项没有在本文里做成结果。正文讨论的用途,是用预报支持与用户所处地点相关的信息服务,并同时受上面的误差和计算限度约束。
一句话总结
另一条轨迹能收紧位置预报,是因为它与目标轨迹共享了移动信息;通讯录只是寻找这种共享的一条线索,而且在这个很小的手机样本里,不能单独证明社会联系导致了出行。
核心来源
- Pervasive and Mobile Computing期刊论文,DOI:10.1016/j.pmcj.2013.07.008。正式题名、作者、卷页、2013年7月19日在线日期,以及正文的样本、误差和图,均以这一版本为准。
- 文内数据出处:诺基亚移动数据挑战见Laurila等对研讨会的介绍;出租车轨迹为作者所引CRAWDAD的epfl/mobility/cab,版本2009-02-24。
- Manlio De Domenico个人主页中的经历说明,核对伯明翰大学计算机学院期间的身份。
- 伯明翰大学2012年7月16日新闻,核对Lima当时的博士生身份,以及Musolesi带领这项研究的说法。
- 剑桥大学2014年1月研讨会简介,核对Musolesi当时在伯明翰大学计算机学院的教职与研究方向。
作者介绍
三位作者在论文上的署名单位都是伯明翰大学计算机学院。
- Manlio De Domenico:通讯作者。个人主页记载,2012年3月至2013年1月他在伯明翰大学计算机学院做博士后,工作包括用相空间重构和多元非线性方法,预报具有社会联系者的移动轨迹。
- Antonio Lima:论文只列出伯明翰大学计算机学院。伯明翰大学2012年7月16日新闻称,他是该学院参与这项研究的博士生。
- Mirco Musolesi:论文只列出同一学院。2014年1月剑桥大学研讨会简介称他当时是该学院高级讲师,研究兴趣包括普适计算、大规模数据挖掘和网络科学。伯明翰大学2012年新闻称他带领了这项研究。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果服务只能读取通讯录,而预报真正使用的是互信息,两类人会被选错。图7里有通讯录关系的配对并没有站在互信息的最高端;出租车又说明,没有社交标签的高互信息配对仍能在大约90分钟内不差于单独预报。一个与论文结果相称的后续检验,是在同一批、足够大的轨迹上,比较“按通讯录挑选”和“按互信息最高5%挑选”的累积误差。诺基亚的25人和没有社交标签的出租车,各自缺一半,回答不了这个对照。
另一个会改变读数的设计,是把累积误差改成某一个提前期上的误差。图9的e(t)从预报起点一直平均到t,早先报准会垫高后来的比例。若应用要求的是第90分钟当时的位置,而不是从出发到90分钟的平均,高互信息曲线可能更早落到低互信息之下。再加上状态里本来就有“小时”,还应各做一版去掉钟点的预报。否则,班次和作息带来的可预测性,会继续算在另一个人的轨迹账上。