走得越像的两个人,后来打电话的机会有多大?
论文名片|Dashun Wang、Dino Pedreschi、Chaoming Song、Fosca Giannotti、Albert-László Barabási,Human Mobility, Social Ties, and Link Prediction,Proceedings of the 17th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining(KDD’11),2011年8月21–24日,圣迭戈,第1100–1108页。会议论文。PDF 首页与文末均未印刷 DOI。
可以先把问题想成一对还没打过电话的人。一种线索是他们常在同一小时出现在同一个基站;另一种线索是通话网络里他们隔得很近,比如有共同联系人。接下来五周,哪一种线索更能把“会打通一次电话”的人对排到前面?
这项研究用同一个匿名国家的手机通话详单(call detail record,CDR)同时看移动和通话。方向是:轨迹越像,已有联系在网络上越近,通话也越多;只靠移动指标,就能把新通话排到接近传统网络指标的位置。两者合用会再提高。73.5% 的精确率出现在事先筛过的一小批候选的测试集上;分母换成约 5100 万条未形成联系之后,合用模型的精确率是 0.3076。
先说结论
- 前 9 周最大连通分量有 34,034 人、51,951 条已有通话边。此前没打过电话的用户对有 579,087,610 对,后 5 周新出现通话的只有 12,484 对,约每 10 万对 2.16 对。
- 新通话大多出现在最短路径 2 步之内。任意两人最可能的网络距离大约是 12 步。
- 在已有的 51,951 条边上,同一小时共现、空间余弦与共同邻居、Adamic-Adar、Jaccard、Katz 同向变化。移动指标和这些网络指标的皮尔逊系数大约在 0.19 到 0.31;通话次数与移动指标大约是 0.14,高于它和网络接近度的相关。
- 在约 5100 万条未形成联系的样本上,无监督排序里 Katz 的精确率是 0.1762,同一小时共现和余弦共现大约是 0.09,随机基线是 0.0002。网络与移动合用的监督模型达到 0.3076,约为该随机基线的 1500 倍。
- 在共同邻居且进一步设阈值的子集上,决策树测试集的精确率是 73.5%(228/310),召回率是 66.1%(228/345)。同一做法只用网络指标时,精确率 36.2%,召回率 6.1%。
比较的是谁,一条联系指什么
运营商数据覆盖大约 600 万用户。进入分析的是其中 5 万名最活跃用户。作者写明,这与文中所引 Song 等人 2010 年的移动可预测性研究是同一批人,观察窗口是 2007 年连续 14 周的通话。由此得到大约 9000 万条通信记录、1 万多个不同地点,地点分布的半径超过 1000 公里。作者注明数据受保密协议约束,未予公开。
一条记录是主叫、被叫、时间和接通这次电话的基站。引言写明,空间位置记的是发起通话的一方。一个人没打电话的时段不会出现在轨迹里。时间粒度是小时。两人之间只要在窗口内至少有一次通话,就连一条无向边。预测实验把前 9 周当作过去,第 10 到 14 周当作未来。
过去这张网络取最大连通分量:34,034 个用户,51,951 条边。后面的相关、距离分布和新联系预测都在这个分量上展开。5 万名高活跃用户已经是从约 600 万里选出的活跃者,最大连通分量又只保留其中互相连得上的 34,034 人。
新电话出现之前,两人在网络上通常隔多远
预测新边时,网络方法通常假设:图上离得近、却还没有边的人,以后更可能连上。这里的距离是最短路径步数,论文称为化学距离(chemical distance)。步数为 1 表示过去已经有通话。
他们把每一周新出现的边拿出来,看这些边的两端在前一周相距几步。这个概率在第 1 周到第 14 周都很稳定,并随步数变长迅速下降。多数新边出现在两步之内,也就是两端有共同邻居。任意挑一对用户,最短路径最可能大约是 12 步;真正形成新边的那些对,最可能是 2 步。
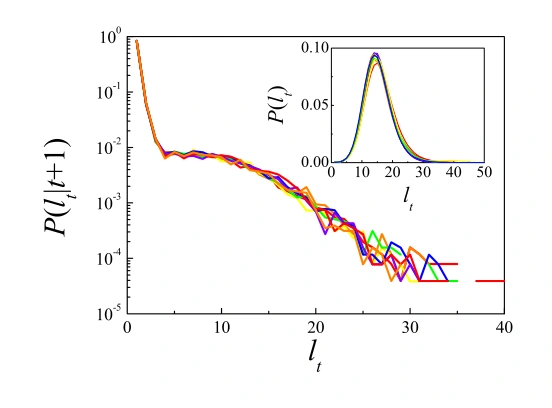
图 1|新通话出现之前,两人在通话网络上隔着几步?
无字母子图。主图纵轴是新边在前一周最短路径长度为 lt 的概率,对数刻度;横轴是这个步数。不同颜色是不同周,曲线叠在一起,短路径处更高,随后下降。插图是任意用户对的最短路径分布,峰值在大约 12 步附近,横轴向更大步数延伸。主图显示新边偏向近邻,插图显示任意两人的典型距离远得多。两张分布描述的是位置,因果还留在图外。来源:原论文 Fig. 1。
网络一侧因此选用四个已有指标,都在前 9 周的边上计算。共同邻居是两边邻居集合的交集有多大。Adamic-Adar 仍用共同邻居,但按对方度数的对数倒数加权,度数很高的枢纽贡献变小。Jaccard 系数是交集除以并集。Katz 把两端之间所有路径按长度做指数衰减后相加,短路径权重大,衰减系数通常取 0.05。
已经打过电话的人,距离和轨迹重叠是什么形状
移动一侧要回答另一件事:两个人的日常轨迹有多像。论文把这组相似度称为移动同质性(mobile homophily)。
最常去地点之间的距离,是两人各自出现次数最多的基站相隔多远。空间共现 SCoL 把两人在每个地点出现的概率相乘,再对所有地点求和,不要求同一小时,并假设两人的访问相互独立。空间余弦 SCos 比较的是两人访问频率向量的夹角。同一小时共现 CoL 只数同一小时、同一地点的重叠,再除以两人都在同一小时被观测到的次数,时间窗是 1 小时。加权版本按地点人多而降低权重,让冷清地点的相遇更突出。非工作时间共现只保留夜间或周末。
同一小时共现更接近“当时可能碰面”,但只要有一个人那一小时没打电话,碰面就不会被记下。空间共现不要求同时出现,能保留“都去过这些地方”这一更弱的条件。哪个更接近面对面接触,论文认为并不能事先确定。
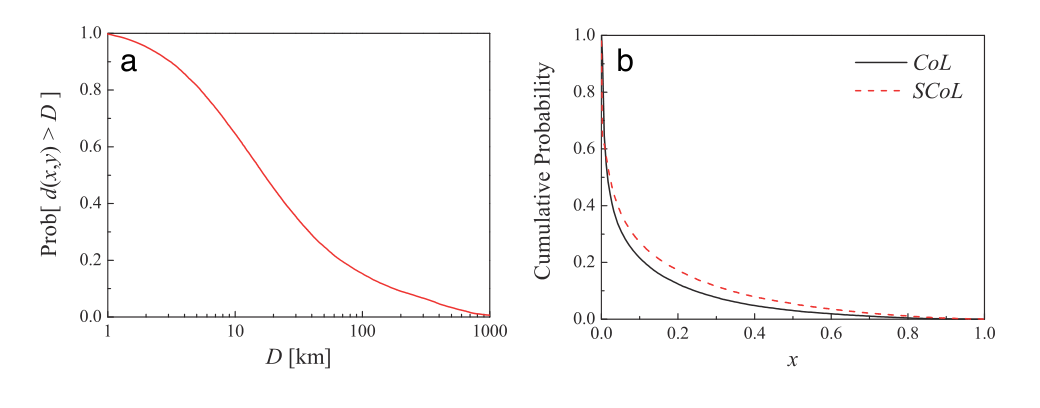
图 2|已经打过电话的人,住得有多近、轨迹重叠有多少?
对象是前 9 周最大连通分量里的已有边。(a)纵轴是两人最常去地点相距超过 D 的比例,横轴 D 以公里计、取对数,从 1 公里到 1000 公里。曲线从左侧接近 1 降到右侧接近 0,远距离一端仍有尾巴。(b)纵轴是指标大于横轴 x 的比例;黑实线是同一小时共现 CoL,红虚线是空间共现 SCoL。两条都从左侧高处快速下降,红虚线位于黑实线上方。多数已有联系存在地点或同时空重叠,重叠比例下降很快;厚尾只说明有些联系相距很远,不给出中位距离。来源:原论文 Fig. 2。
轨迹相似度升高时,网络指标和通话次数怎样变
相关的计算单位是这 51,951 条已有边。通话次数是前 9 周两人之间的呼叫数,用来表示联系强度。横轴把同一小时共现和空间余弦按对数分箱。
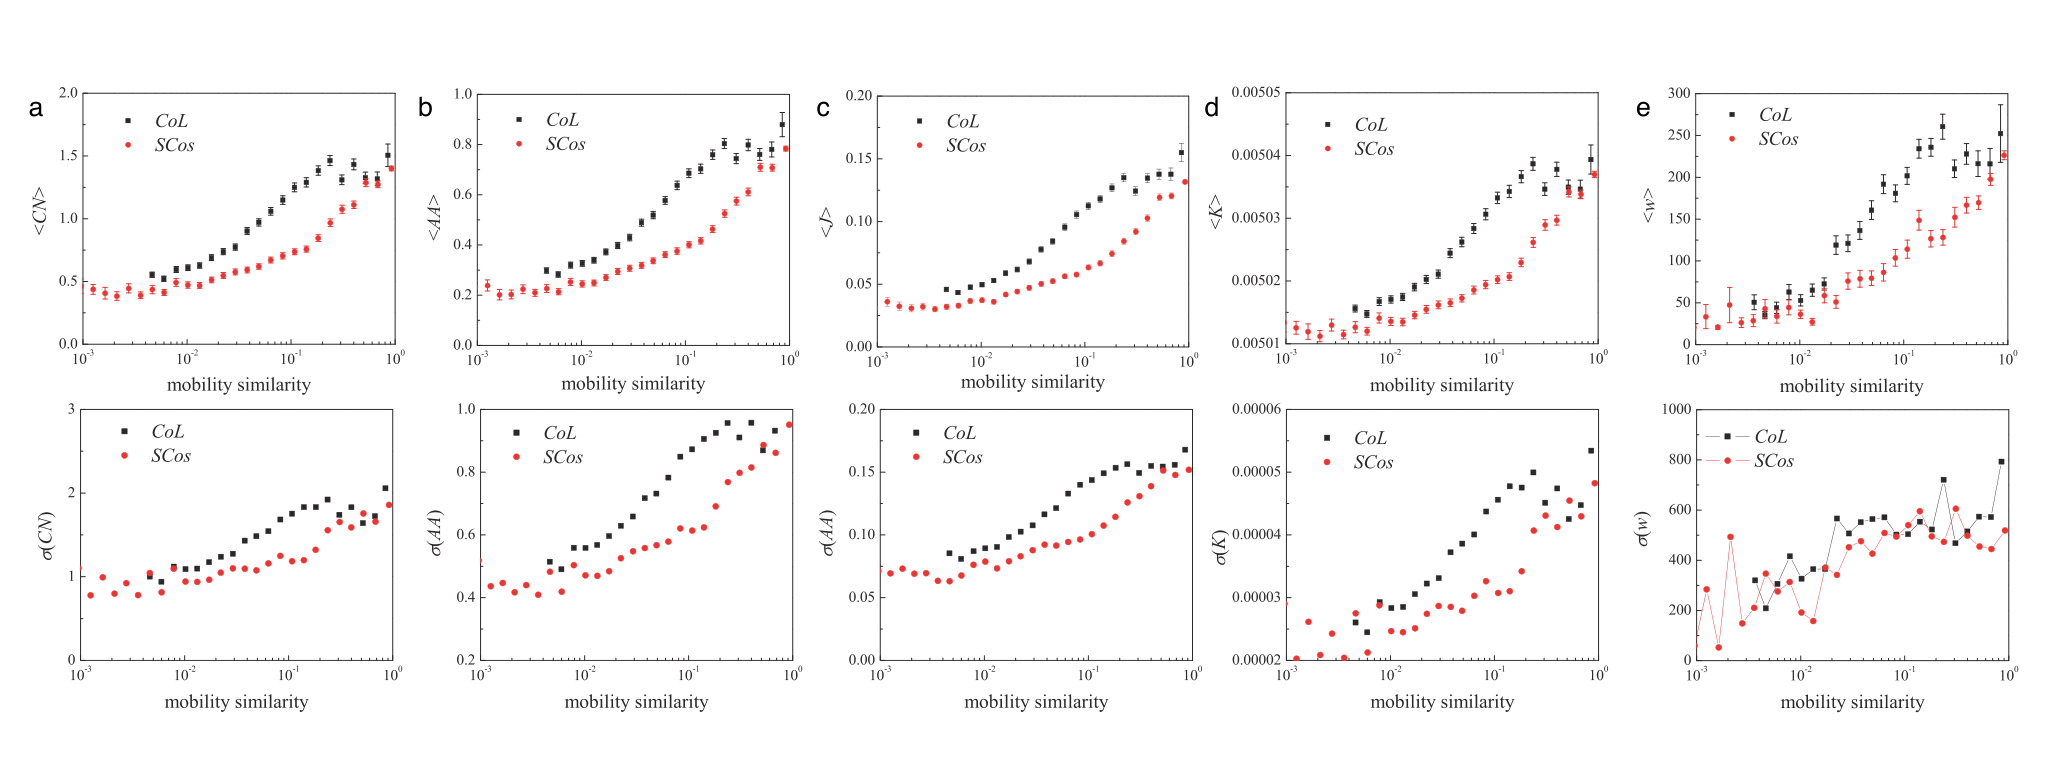
图 3|轨迹越像,网络指标和通话次数的平均水平是否更高?
每一列上图是均值、下图是标准差。黑方块是同一小时共现,红圆点是空间余弦,横轴都是移动相似度的对数刻度。点上有误差线。(a)共同邻居,(b)Adamic-Adar,(c)Jaccard 系数,(d)Katz,(e)通话次数。五列均值大体随相似度上升;标准差在(a)到(d)也多半上升,(e)的标准差起伏很大。各列纵轴刻度不同,升降只在每一列内部比较。方向一致。误差线和标准差同时说明,相似度高时网络数值仍会分散。来源:原论文 Fig. 3。
地理距离随着这两种移动相似度下降。论文把下降描述为对数形式。
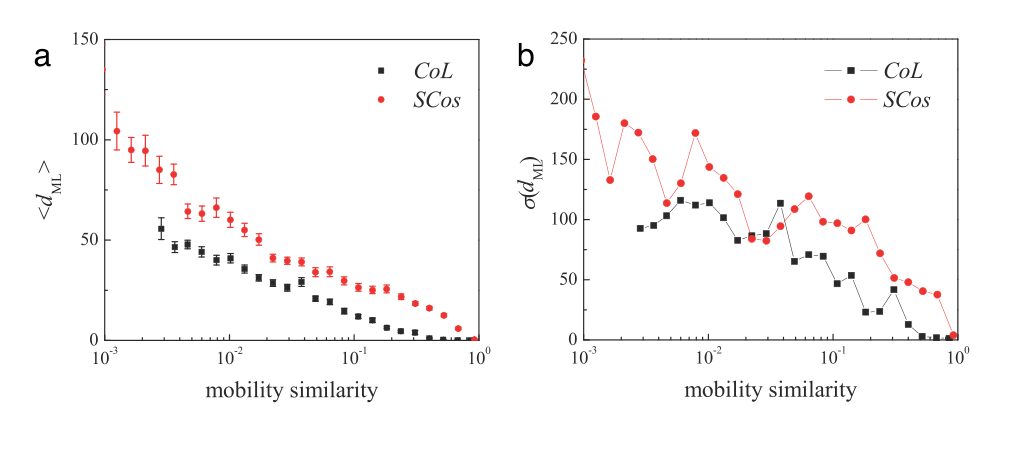
图 4|轨迹更像的人,最常去的地点是否更近?
横轴仍是移动相似度的对数刻度。黑方块是同一小时共现,红圆点是空间余弦。(a)纵轴是最常去地点距离的均值,点上有误差线,两条都随相似度下降。(b)纵轴是该距离的标准差,整体也下降,中间有起伏,相似度接近 1 时才收得很小。两条线共用横轴,CoL 和 SCos 的数值含义不同,同一横坐标对应的是各自指标取到该数值的用户对。来源:原论文 Fig. 4。
表 1 给出这些量两两之间的皮尔逊系数。和后面的判断直接相关的几列是:
| CoL | SCos | Jaccard | 共同邻居 | Adamic-Adar | Katz | 通话次数 | 最常去地点距离 | |
|---|---|---|---|---|---|---|---|---|
| CoL | 1 | 0.76286 | 0.25359 | 0.19618 | 0.2251 | 0.18952 | 0.14521 | -0.17894 |
| SCos | 0.76286 | 1 | 0.30789 | 0.25657 | 0.28679 | 0.24933 | 0.14402 | -0.24938 |
| 通话次数 | 0.14521 | 0.14402 | 0.11348 | 0.05989 | 0.086881 | 0.053842 | 1 | -0.029339 |
同一小时共现和空间余弦彼此相关 0.76286。它们和网络接近度的相关大约 0.19 到 0.31,低于网络指标彼此之间的相关:共同邻居和 Katz 是 0.99939,共同邻居和 Adamic-Adar 是 0.94437。通话次数和两种移动相似度是 0.14521 和 0.14402,高于它和 Jaccard 的 0.11348、和 Adamic-Adar 的 0.086881、和共同邻居的 0.05989、和 Katz 的 0.053842。论文据此说,联系强度与移动同质性的相关高于它与网络接近度的相关。0.14 仍是弱到中等的线性相关。
距离与两种移动相似度负相关,分别是 -0.17894 和 -0.24938,方向是相似度越高、最常去地点越近。图 3 的标准差不小,平均趋势之外仍有不少个别用户对的起伏。
在全部没打过电话的人里,新联系稀到什么程度
潜在联系是前 9 周没有通话的用户对。新联系是这些对里,第 10 到 14 周至少打过一次电话的。一直没打过的称为缺失联系。
34,034 人、51,951 条已有边,潜在联系是 579,087,610 对。其中新联系 12,484 对,12,484 / 579,087,610,大约每 10 万对 2.16 对。把所有潜在联系都判成“不会打”的分类器,准确率是 99.998%。所以总准确率会把题目做成看起来几乎全对,真正要看的是新联系这一侧的精确率和召回率。
精确率是预测为新联系的对里,后来确实打过电话的比例,即 TP / (TP + FP)。召回率是后来确实出现的新联系里被找回来的比例,即 TP / (TP + FN)。论文更重视精确率:宁可漏掉一些新边,也希望被判成新边的那些对更可靠。
全部 5.79 亿对算不过来,正负类又极不平衡。他们用两条路缩小范围。一条是逐步加入缺失联系,最多约 5100 万条,论文写这大约是全部缺失联系的 10%。另一条是只保留有共同邻居的用户对,这时负样本可以全部纳入。
无监督做法是按某一个指标从高到低排序,把排在最前、数量等于新联系总数的那些对判成新联系。监督做法是用决策树、随机森林、支持向量机或逻辑回归学习一个分类器,并用交叉验证挑选较稳、较不像过拟合的结果。特征可以只用网络、只用移动,或两类一起用。
负样本从很少加到约 5100 万,精确率掉到哪里
第一组实验保留全部 12,484 条新联系,再分别混入这 5100 万条缺失联系的 1%、25%、50%、75% 和 100%。无监督时,每个指标都把排名最前的 12,484 对判成新联系。图中小数点印成逗号,下文改写成小数点。
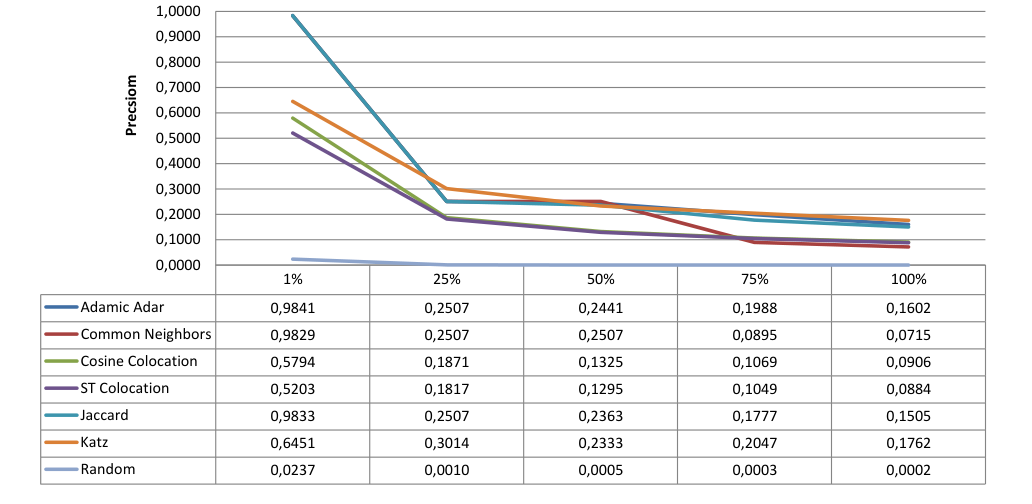
图 5|负样本变多以后,单指标排序的精确率还剩多少?
无字母子图。纵轴是精确率,横轴是缺失联系占约 5100 万条抽样的比例。精确率的分母是排名最前的 12,484 对。图例中 Cosine Colocation 对应访问频率的余弦,ST Colocation 对应同一小时共现。100% 一列:Katz 0.1762,Adamic Adar 0.1602,Jaccard 0.1505,Cosine Colocation 0.0906,ST Colocation 0.0884,Common Neighbors 0.0715,Random 0.0002。1% 一列里,Adamic Adar、共同邻居和 Jaccard 都在 0.98 附近,Katz 是 0.6451,两条共现指标是 0.5794 和 0.5203,随机是 0.0237。来源:原论文 Fig. 5。
在负样本很少时,若干网络指标几乎把前 12,484 对都排对了。负样本加到全部约 5100 万条以后,Katz 仍是这张图里最高的无监督指标,精确率 0.1762;两条共现指标大约 0.09,高于共同邻居的 0.0715,低于 Katz 和 Adamic-Adar。从 25% 到 100%,共同邻居由 0.2507 降到 0.0715,余弦共现由 0.1871 降到 0.0906,同一小时共现由 0.1817 降到 0.0884。论文说移动指标略低于最好的网络指标、高于共同邻居,并且随负样本增加下降得更慢。这张图同时说明:到了这个规模,所有单指标的精确率都已经不高。论文也写明,这 5100 万条仍只是全部缺失联系的大约一成,因此这里的预测力仍然有限。
监督模型画在下一张图里。正文写明它们在独立测试集上评估,并与无监督 Katz、随机分类器对照。
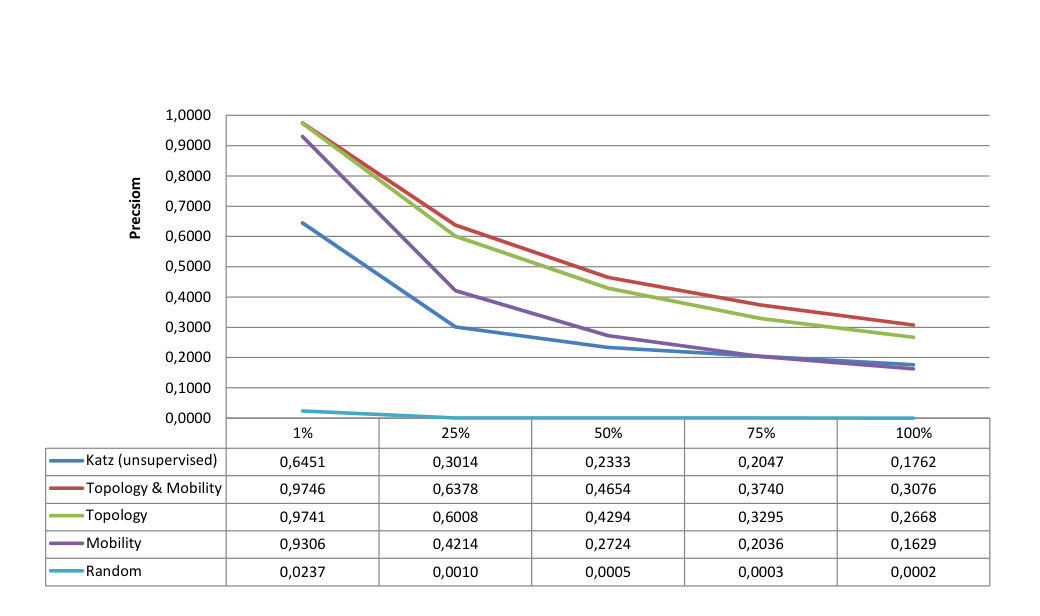
图 6|把网络和移动合在一起,广样本上的精确率提高到多少?
无字母子图。纵轴、横轴与图 5 相同,小数点在图中印成逗号。100% 一列:网络与移动合用 0.3076,只用网络 0.2668,无监督 Katz 0.1762,只用移动 0.1629,随机 0.0002。1% 一列合用为 0.9746,只用网络 0.9741,只用移动 0.9306。来源:原论文 Fig. 6。
合用模型在 100% 样本上是 0.3076,正文写作大约 30%。0.3076 除以同一格的随机基线 0.0002,约为 1500 倍,对应正文所说的 1500 倍以上。这个倍数的分母是图上印出的随机精确率。
只用移动的监督精确率 0.1629,接近无监督 Katz 的 0.1762,低于只用网络的 0.2668。合用相对只用网络,是从 0.2668 到 0.3076。论文说监督模型大约是对应无监督模型的两倍;图上合用 0.3076 相对 Katz 0.1762 大约是 1.7 倍。移动指标在这个广样本上接近传统网络排序,合用把精确率再提高到 0.3076。
只看有共同邻居的人,移动指标排第几
图 1 已经表明,多数新边发生在两步之内。于是第二组实验只保留前 9 周至少有一个共同邻居的用户对。这样的潜在联系有 266,750 对,其中 3,130 对后来真的打通,3,130 / 266,750 = 1.17%。负样本在这个子集里是全的。无监督精确率仍是排名前 3,130 对里的新联系比例,分母是 3,130。
| 排序指标 | 精确率 |
|---|---|
| Katz | 9.1% |
| Adamic-Adar | 7.8% |
| 空间余弦 | 5.6% |
| 加权空间余弦 | 5.6% |
| 非工作时间共现 | 5.1% |
| 加权同一小时共现 | 5.1% |
| 共同邻居 | 5.1% |
| 同一小时共现 | 5.0% |
| Jaccard | 3.0% |
随机抽 3,130 对,期望精确率就是子集里的 1.17%。Katz 的 9.1% 大约是这个基线的 7.8 倍,空间余弦的 5.6% 大约是 4.8 倍。几种移动指标都在 5.0% 到 5.6%,加权版本与未加权版本处在同一区间。结论还报告,把共现放进 Adamic-Adar 之后,无监督精确率可以到 9.6%,并超过正文列出的传统指标。9.6% 未再写样本口径;同一段传统指标的最高值是这张表里的 Katz 9.1%。
73.5% 和 66.1% 是在筛选后的测试集上
更高的数字来自一次再筛选。作者在共同邻居用户对上,用网络和移动指标一起训练 Quinlan 的 C4.5 决策树,并用交叉验证控制过拟合。筛选条件在实验段落写作:Adamic-Adar 大于 0.5,并且 SCoL 大于 0.7。后文总结时写成高 Adamic-Adar 和高 SCos。SCoL 表示不要求同一时刻的地点共现,SCos 表示访问频率的余弦。73.5% 属于这个筛过的小群体;第二个阈值的符号,实验段落和后文总结写得不一致。
独立测试集的混淆矩阵是:
| 预测为非新联系 | 预测为新联系 | |
|---|---|---|
| 实际非新联系 | 6,627 | 82 |
| 实际新联系 | 117 | 228 |
精确率 228 / (228 + 82) = 228 / 310 = 73.5%。召回率 228 / (228 + 117) = 228 / 345 = 66.1%。预测为新联系的 310 对里,82 对是假阳性,占 26.5%,接近正文说的大约四分之一。测试集里 345 条实际新联系中,117 条被漏掉,占 33.9%,接近大约三分之一。四格相加是 7,054 对,其中实际新联系 345 条,非新联系 6,709 对。这 7,054 对是独立测试集。筛选前的共同邻居候选是 266,750 对。论文未给出 AA > 0.5 且 SCoL > 0.7 的全部候选有多少。
同一套做法如果只用网络指标,精确率 36.2%,召回率 6.1%。合用之后,精确率从 36.2% 到 73.5%,召回率从 6.1% 到 66.1%。提升对应的是已经同时具备较高网络接近度和较高移动相似度的那一批人。
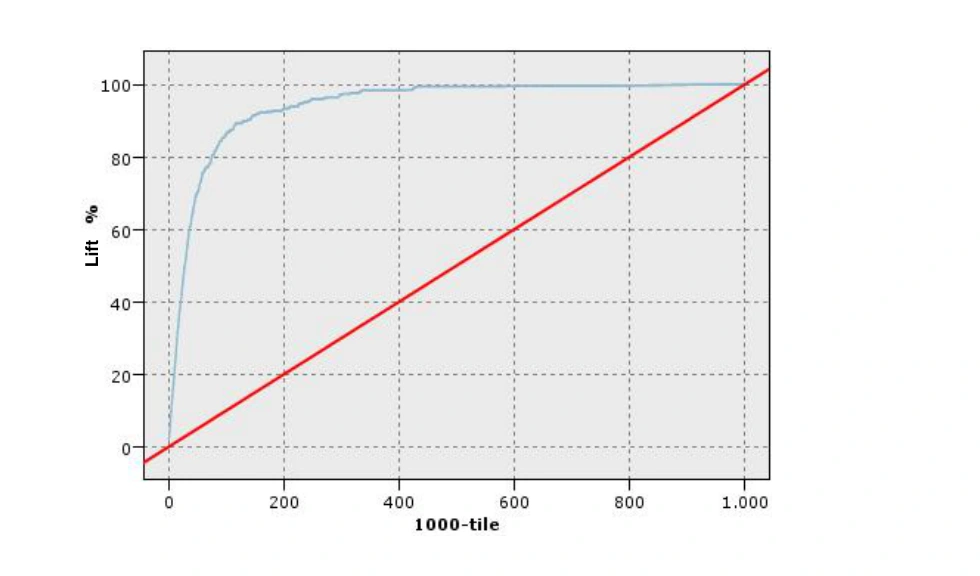
图 7|把测试集按预测概率排序后,前百分之多少能覆盖多少新联系?
无字母子图。横轴是 1000 等分,100 对应前 10%,1000 对应全部。纵轴是这些排名靠前的候选所覆盖的实际新联系百分比。蓝线上升很快,随后接近 100%;红线是随机分类器的对角线。正文给出的读数是前 10% 覆盖 86.4% 的新联系,图注写作超过 85%。图上没有把 86.4 标成单独的点。来源:原论文 Fig. 7。
这些数字各自管住哪一个范围
三组量同向变化,发生在已经打过电话的 51,951 条边上。平均而言,轨迹更像的人网络上也更近、通话也更多。因果方向,以及工作地、学校或家庭安排是否同时推高两边,这张相关表没有分开。
新联系的定义是后 5 周至少一次通话。一条边表示窗口内至少有过一次呼叫。友谊、见面,以及没打电话时的相处,都需要别的记录。位置只在主叫发起呼叫时落到基站,小时以外的停留和没打电话的碰面都不在这份详单里。
73.5% 的分母是筛选后测试集里被判为新联系的 310 对。0.3076 的比较对象是混有约 5100 万条缺失联系的样本,而且这仍只是全部缺失联系的大约一成。1.17% 是 266,750 对共同邻居里的新联系比例。三个精确率回答的是三个不同的候选池。
样本是一个国家、2007 年 14 周、5 万名最活跃用户中的最大连通分量。作者在结论里写明,这种抽样会带来尚未充分理解的偏差,并希望用更多用户和多个国家的数据再做。报告的是多种算法和参数里较稳的结果。共同邻居和 Katz 的相关达到 0.99939,多放几个网络指标,重复的仍是“两人在图上靠近”这一条线索。
论文把移动对通话关系的预告力写成一种隐私含义:轨迹可能泄漏谁和谁有联系。任务本身是,运营商数据里已经存在的用户编号之间,未来会不会出现通话。论文把反向问题留到以后:知道社会联系之后,能否更多了解人在哪里。那个问题留在未来工作里。
一句话总结
轨迹相似、网络接近和通话次数会一起升高,移动线索单独就能把新通话排到远高于随机的位置;精确率能到七成,还是掉到三成、甚至接近一成,取决于候选池是筛过的小群体,还是几十万、几千万对没打过电话的人。
核心来源
- Dashun Wang、Dino Pedreschi、Chaoming Song、Fosca Giannotti、Albert-László Barabási,Human Mobility, Social Ties, and Link Prediction,KDD’11,2011年8月21–24日,圣迭戈,第1100–1108页。正文图 1–7、表 1–2 及上述数值均出自这一会议版本。首页版权行印有 ACM 978-1-4503-0813-7/11/08。该 PDF 未印刷 DOI。
- 文内脚注说明,所用通话详单受保密协议约束,未予公开。AA > 0.5 且 SCoL > 0.7 的候选总数,以及只用网络指标时那棵树的混淆矩阵,正文都未列出。
作者介绍
以下只采用论文署名机构和本文引用关系。
- Dashun Wang:署名东北大学物理与计算机科学系复杂网络研究中心(CCNR),以及哈佛大学丹娜-法伯癌症研究所系统生物学中心(CCSB)。
- Dino Pedreschi:署名东北大学 CCNR,以及比萨大学信息系 KDD 实验室。
- Chaoming Song:署名东北大学 CCNR 与丹娜-法伯 CCSB。本文使用的 5 万名高活跃用户,与论文所引 Song、Qu、Blumm、Barabási 2010 年的移动可预测性研究是同一批人。
- Fosca Giannotti:署名东北大学 CCNR,以及意大利国家研究委员会信息科学与技术研究所(ISTI-CNR)的 KDD 实验室。论文相关工作引用了她参与的轨迹模式挖掘研究。
- Albert-László Barabási:署名东北大学 CCNR、丹娜-法伯 CCSB,以及哈佛医学院布莱根妇女医院医学系。论文所引的个体移动模式和移动可预测性工作,作者中都有他。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个服务只有轨迹、手边还没有通话网络,图 6 在 100% 列给出的只用移动的监督精确率是 0.1629,接近无监督 Katz 的 0.1762。筛选后的 73.5% 还要求候选对的 Adamic-Adar 大于 0.5,通话网络已经先被用过一遍。移动在那个小群体里,是给已经很近的人再做一次确认。两个数字对应两个候选池。
另一个可检验的缺口是:位置只在打电话时被写下来。两个每天在同一教室见面、却很少打电话的人,会比两个常从同一办公楼打电话的人更不像。表 1 里 0.14 到 0.31 的相关,可能混有“常打电话的人更容易被记到共同地点”。若用进站闸机或连续定位,让在场不必依赖一次呼叫,移动指标和通话网络的相关还会不会停在这个区间,本文没有数据。
共同邻居和 Katz 的皮尔逊系数是 0.99939。继续堆叠同类网络分数,会把“你们隔着两步”重复计分。图 6 里,合用相对只用网络从 0.2668 提到 0.3076,相差 0.0408。这是移动在该样本上多出来的精确率,幅度有限。以后若要说明社会线索之外又多了一层信息,对照里至少放一个已经很强的单指标。彼此相关 0.9 以上的网络分数,会计入同一步事实。