选一家店,和先选一片区,是两种偏好吗?
论文名片|Yingrong Qin、Chen Gao、Zhen Tu、Hongsheng Wu、Shuangqing Wei、Yue Wang、Lin Zhang、Yong Li,Modeling Multi-Grained User Preference in Location Visitation,第 31 届 ACM SIGSPATIAL(2023 年 11 月 13–16 日,德国汉堡),10 页。Chen Gao 为通讯作者。DOI:10.1145/3589132.3625628。本文依据该会议正式版本解读。
工作日中午只想吃饭时,人常常直奔一家熟悉的店;周末说想出去走走,又常常先在一片商圈里晃,再决定进哪一家。这是帮助理解论文动机的设想。实验里没有“午饭”或“出游”这样的需求标签,训练只用去过或没去过。
论文提出 MMGUP(Modeling Multi-Grained User Preferences),用图神经网络同时学习地点尺度和区域尺度的表示,再把两个尺度的匹配分数加总,预测用户以后会不会到访某个地点。在腾讯地图的北京、上海数据上,它对全部地点排序,多数召回率和命中率高于所列基线;上海的排序质量指标 NDCG 上,KGAT 更高。指标变化说明两套表示对离线排序有用,并没有测出人先选区、再选店。
先说结论
- 过滤后,北京保留 40,000 名用户、27,685 个地点、961,232 次交互;上海保留 43,272 名用户、40,529 个地点、518,140 次交互。按用户数平均,分别约 24.03 次和 11.97 次交互。
- 对全部地点排序、只看前 3 名时,MMGUP 的北京 Recall@3 为 0.02334,相对 KGIN 的 0.02210 高 5.61%;上海 Recall@3 为 0.01286,相对 KGIN 的 0.01191 高约 7.98%(论文写作 7.97%)。分母都是各用户测试地点数,再对用户平均。
- 论文把上海 8.95% 写在 NDCG@3 上。表 3 里与 8.95% 相符的是上海 HR@3:从 KGIN 的 0.03116 到 MMGUP 的 0.03395。上海 NDCG@3 的最高值在 KGAT,为 0.01751,MMGUP 为 0.01207。
- 去掉地点尺度的用户偏好后,北京 Recall@3 从 0.02334 降到 0.01110,上海降到表中印出的 0.0009。去掉区域尺度后,北京降到 0.02167,上海降到 0.01191。
- 两座城市的最好区域分数系数都是 γ=0.2,也就是加总时区域分数乘 0.2、地点分数乘 0.8。0.2 是公式系数,不是区域解释了两成到访。
这两座城市的到访有多稀?
数据来自腾讯地图,论文写明经过用户授权。兴趣点(point of interest,POI)若被少于 10 名不同用户到访,就删去;用户若到访过的不同 POI 少于 10 个,也删去。过滤之后的规模见表 2。论文没有给出过滤前的人数,也没有给出采集起止日期,也没有定义一次到访是停留、点击还是导航。
| 北京 | 上海 | |
|---|---|---|
| 用户数 | 40,000 | 43,272 |
| 地点数 | 27,685 | 40,529 |
| 交互次数 | 961,232 | 518,140 |
| 知识图谱实体数 | 31,900 | 44,910 |
| 关系类型数 | 16 | 16 |
| 三元组数 | 366,730 | 538,356 |
用交互次数除以用户数,北京约 24.03 次/人,上海约 11.97 次/人。再用交互次数除以“用户数 × 地点数”,北京约 0.000868,上海约 0.000295:每一万个可能的用户—地点组合里,大约分别有 8.68 次和 2.95 次记录。上海用户更多、地点更多、交互更少,所以更稀。这些比值由上表算出,论文没有单独列出稀疏度。
交互按时间顺序分成训练、验证、测试,比例 7:1:2。模型在训练集上学习,验证集连续 5 个 epoch 没有更好成绩就停止,然后报告测试集。每个方法跑 3 次,表中是平均值。论文没有给出三次的离散程度。表里的星号表示该格最好,论文说明这是加粗加星,不是显著性检验。
推荐时对全部地点打分并排序,不先抽一个小候选集。前 k 名只评估 k=3 和 k=5。召回率 Recall@k 的算法是:每个用户被前 k 名命中的测试地点数,除以该用户自己的测试地点数,再对用户平均。命中率 HR@k 是前 k 名里至少命中一个测试地点的用户比例,分母是公式里的用户集合规模;论文没有另报有多少用户因为测试集为空而被排除。NDCG 用来看命中是否排在更前面。公式 (22) 印成理想折损增益除以实际折损增益,与常用的 NDCG(实际除以理想)分子分母相反。下面的表内数字都按原文抄录,不按常用定义重算。
因为北京要在 27,685 个地点里只推荐 3 个,Recall@3 只有百分之二点几,表示前 3 名平均只盖住各用户测试地点的一小部分,不是分类任务里那种“百分之二的准确率”。
坐标一旦写成“属于某区”,邻近性还在吗?
既有地理推荐很多只在地点尺度上处理距离。这篇论文认为,区域功能会改变人去哪里:同一区域内的店既可能互补,也可能竞争。区域按路网划分,论文认为这比聚类或方格更接近城市功能区。区域有多少个、路网来自哪里、每个区域至少包含几个地点,正文都没有写。
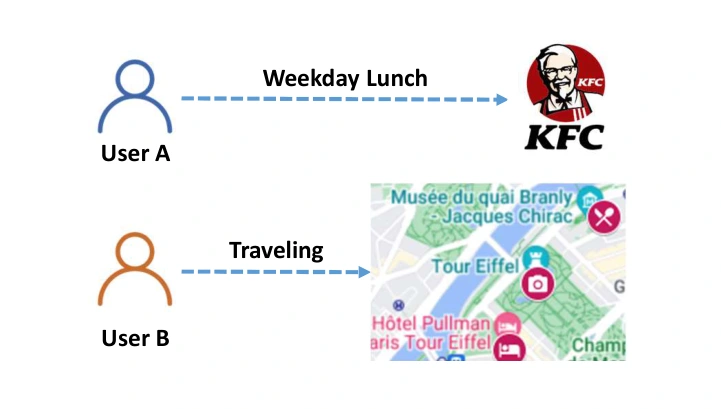
图 1|明确需求和复合需求,在示意图里被画成了哪两种去处?
图中没有子图字母。上排用户 A 沿 Weekday Lunch 指向一家 KFC,表示需求明确时直达具体地点。下排用户 B 沿 Traveling 指向一张标有埃菲尔铁塔和布朗利码头博物馆的地图,表示复合需求先落在一片区域。品牌和巴黎地图是示意,不是北京或上海数据里的真实用户。来源:原论文 Fig. 1。
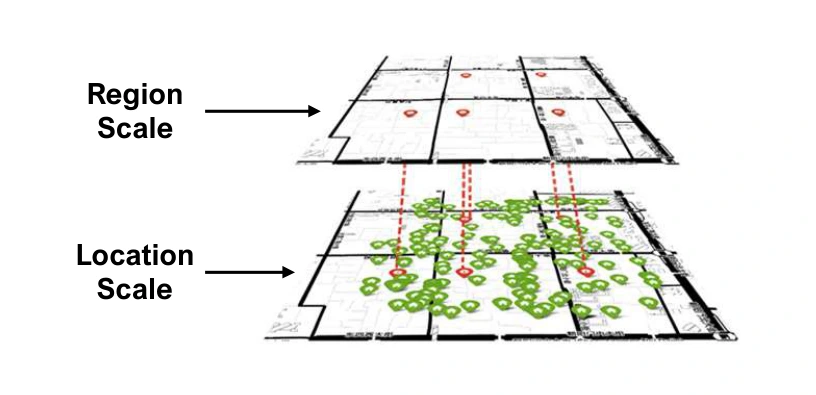
图 2|区域和地点在空间上怎样叠在一起?
图中没有子图字母。上层 Region Scale 是路网划分出的街区,红点表示区域。下层 Location Scale 在同一路网中铺开绿色地点,红色虚线把区域和它所属的地点连起来。这张图说明模型采用的两层结构,不报告地点或区域的实际个数。来源:原论文 Fig. 2。
辅助信息分成两类。地理先验包括经纬度、地点属于哪个区域、区域之间的距离。功能先验包括品牌和三级类别。它们被写成(头实体,关系,尾实体)。例如“地点 i 的品牌是 KFC”,存成(i,IsBrandOf,KFC)。经纬度不能原样放进这种三元组,论文把地点坐标收成(i,BelongTo,某区域),并明确说这一步有不可逆的信息损失:绝对位置精度丢掉了。
用户—地点交互图则只连接用户和他历史上到访过的地点。到过相同地点的用户,会在后面的消息传递里变得更近。这是协同信号,仍然是在“去过哪里”上相似,不是需求类型相似。
最终分数怎样把两个尺度加在一起?
图神经网络(graph neural network,GNN)在这里做的事,是让直接相连、以及隔若干跳相连的节点,在向量空间里互相带动。知识图谱上,地点的邻居消息先按关系向量做逐元素相乘,再对邻居取平均,加回地点自己的向量。交互图上,用户向量加上他到访地点向量的平均。第 0 层随机初始化。实验设置写明所有方法的向量维度都是 64,优化器用 Adam,初始化论文印为 Xiaver(通常即 Xavier),批大小 1024。学习率在 0.1、0.01、0.001、0.0001 里搜索。正文没有写明报告结果时用了几层。
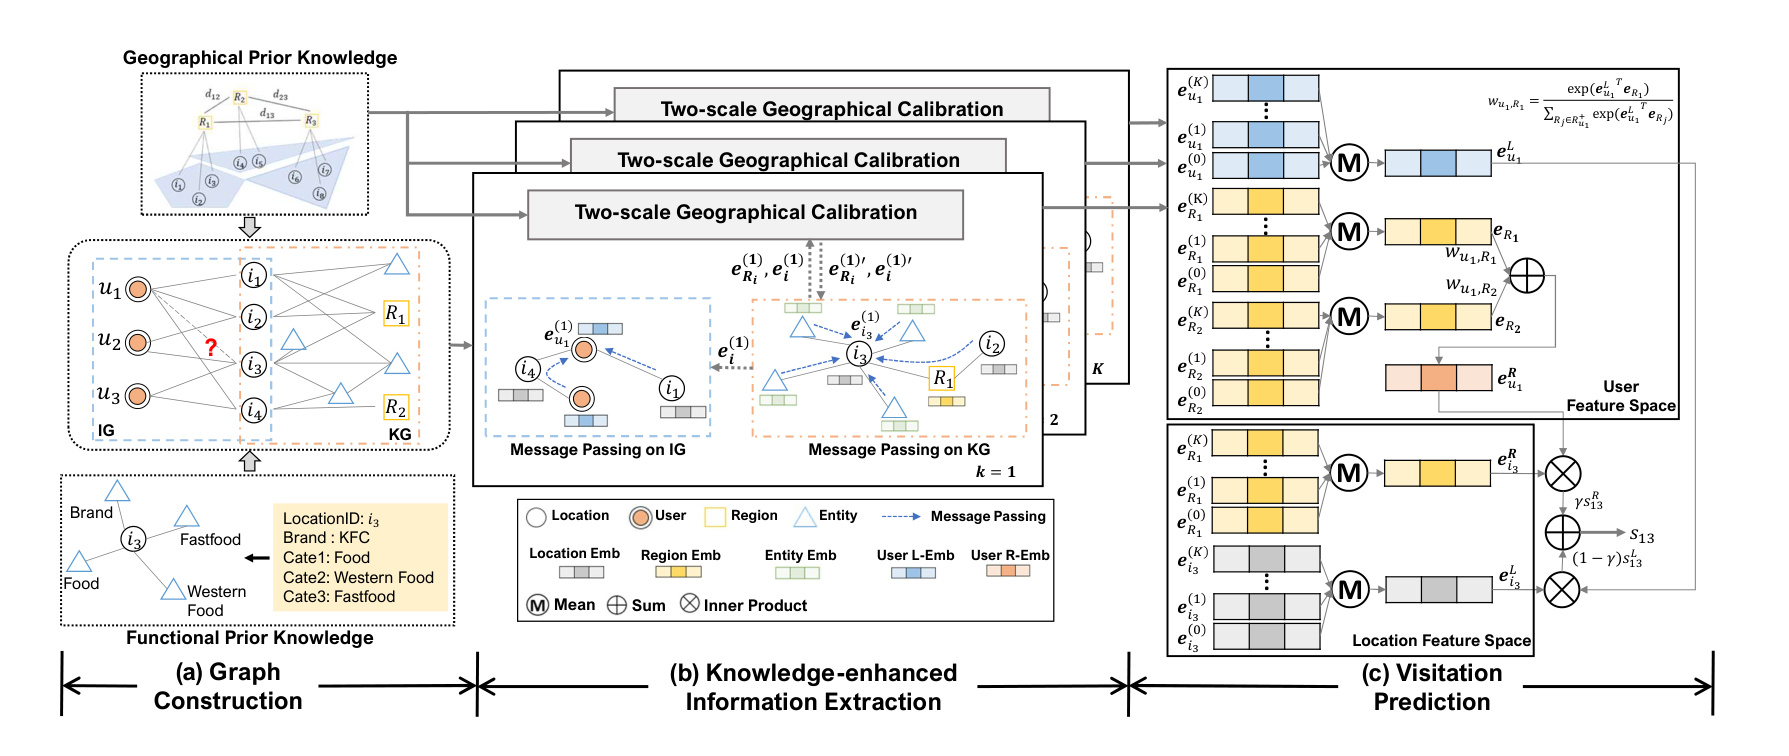
图 3|从辅助信息到到访分数,中间经过哪三步?
(a)左侧用历史到访建立用户—地点交互图,用品牌、三级类别和所属区域建立知识图谱;地理坐标在这一步收成所属区域。(b)中间在两类图上逐层传递消息,并做两尺度地理校准。图中的 k=1 是层的示意,不是实验报告的层数。(c)右侧把各层向量平均,得到地点尺度和区域尺度的表示;用户对到过的区域做加权,最后把两个尺度的分数按 γ 相加。图中的 KFC 与 Food 是结构示例。来源:原论文 Fig. 3。
地理校准用来补回建图时丢掉的距离。区域中心是区内地点经纬度的平均。每个区域连接它的 N 个最近区域,边权是中心距离的倒数,训练中边权固定。N 等于多少,正文没有给出。区域向量更新为:自己的向量乘(1−α),加上邻居向量的加权平均乘 α。α 在 0.1 到 0.4 之间调节。
地点若也两两连边,城市里的地点数量会让计算过重。所以地点不再互相拉近,而是被拉向所属区域。正则项是地点向量与所属区域向量之差的平方和。区域在特征空间里充当锚点。
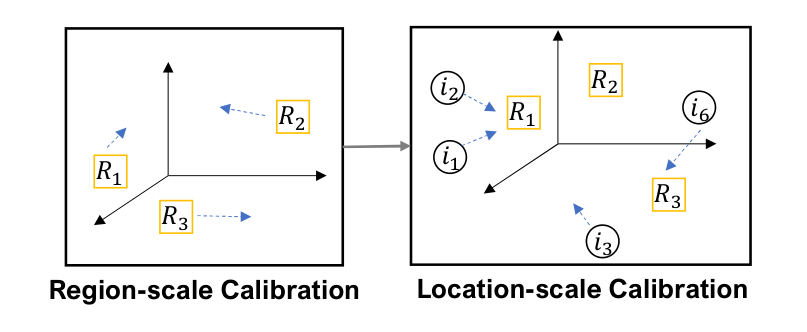
图 4|地理校准分别拉动区域和地点的哪些表示?
图中没有子图字母。左图是区域尺度:邻近区域的表示互相靠近,正文里的边权是区域中心距离的倒数。右图是地点尺度:地点被拉向所属区域,区域是锚点。坐标轴没有标出真实距离或 64 维向量的某一维,这是机制示意。来源:原论文 Fig. 4。
各层向量取平均后,地点有一套地点尺度向量;同一区域里的地点,共用该区域的向量作为自己的区域尺度特征。用户的地点尺度向量同样由各层平均得到。用户的区域尺度向量,只在他到访过的区域上做加权平均:权重是地点尺度用户向量与区域向量的内积经过指数归一化。没去过的区域不进入这个平均。
预测时两个尺度都用内积。公式 (13)(14)的打分函数是地点尺度 fᴸ 和区域尺度 fᴿ;正文有一处把地点尺度印成 fᴾ。最终分数是:
s = γ × 区域尺度内积 +(1−γ)× 地点尺度内积。
γ 从 0 到 1 调节,实验实际搜索了 0.1、0.2、0.3、0.4。
优化用贝叶斯个性化排序(Bayesian Personalized Ranking,BPR):抽(用户,去过的地点,没去过的地点),让去过的得分高于没去过的。区域尺度的这项损失还有一个开关:负样本地点所在的区域若也被用户去过,这项就不计入。总损失是地点尺度 BPR、乘以 β 的区域尺度 BPR、地理正则和参数正则之和。公式 (16) 把地点尺度损失写作 Lᴸ,总损失里又写作 Lᴾ,指的是同一项主任务。
全量排序时,提升出现在哪些格子里?
对比方法分成只用交互图的,和共用同一知识图谱的。NGCF 在交互图上传递一阶和高阶协同信号。LightGCN 在表中写作 LGN,去掉非线性激活和权重矩阵,对邻居取平均。KGAT 在交互图和知识图谱上都用注意力区分邻居。HAKG 在双曲空间里建模层级,并用两套地点向量分别承载协同信号和侧信息。KGIN 用关系感知的消息传递区分不同边,并把用户意图设为 4,这是原论文报告的最好设置。五个基线与 MMGUP 使用相同的维度、优化器、早停和搜索范围。
下表是三次运行的平均。Recall、NDCG、HR 的分母见上一节。星号沿用原表:该列最高。
| 方法 | 北京 Recall@3 | 北京 NDCG@3 | 北京 HR@3 | 上海 Recall@3 | 上海 NDCG@3 | 上海 HR@3 |
|---|---|---|---|---|---|---|
| NGCF | 0.00939 | 0.00866 | 0.01982 | 0.00736 | 0.00711 | 0.01949 |
| LightGCN | 0.01328 | 0.02334 | 0.08975 | 0.00846 | 0.00602 | 0.02279 |
| KGAT | 0.00394 | 0.01069 | 0.02230 | 0.01142 | 0.01751* | 0.03014 |
| HAKG | 0.00973 | 0.01277 | 0.03613 | 0.01150 | 0.01108 | 0.02968 |
| KGIN | 0.02210 | 0.03269 | 0.08995 | 0.01191 | 0.01064 | 0.03116 |
| MMGUP | 0.02334* | 0.03553* | 0.09746* | 0.01286* | 0.01207 | 0.03395* |
北京六个指标都是 MMGUP 最高。相对该格最强基线 KGIN:Recall@3 为(0.02334−0.02210)/0.02210=5.61%;NDCG@3 为(0.03553−0.03269)/0.03269=8.69%;HR@3 为(0.09746−0.08995)/0.08995=8.35%。前 5 名也是 MMGUP 最高:Recall@5 从 0.03295 到 0.03423,相对高 3.88%;NDCG@5 从 0.03504 到 0.03721,相对高 6.19%;HR@5 从 0.13277 到 0.14030,相对高 5.67%。HR@5=0.14030 的意思是,约 14.03% 的用户在前 5 个地点里至少有一个测试地点。
上海 Recall@3 相对 KGIN 为(0.01286−0.01191)/0.01191=7.98%,论文写作 7.97%,差在表内五位小数的舍入。HR@3 相对 KGIN 为(0.03395−0.03116)/0.03116=8.95%。前 5 名的 Recall@5 从 KGIN 的 0.01960 到 0.02052,相对高 4.69%;HR@5 从 0.05080 到 0.05366,相对高 5.63%。
上海 NDCG@3 和 NDCG@5 的最高值在 KGAT:0.01751 和 0.02304。MMGUP 为 0.01207 和 0.01634。以 KGAT 为分母,NDCG@3 低 0.00544,相当于 KGAT 的 31.1%;NDCG@5 低 0.00670,相当于 KGAT 的 29.1%。论文第 4.2 节把 5.61%、7.97% 和 8.69%、8.95% 都写成相对最强基线、并写成两项 NDCG@3。前三个百分比与表 3 的 Recall@3、北京 NDCG@3 一致;8.95% 与上海 HR@3 一致,与上海 NDCG@3 不一致。同一节后文写明,KGAT 在 NDCG@3 和 NDCG@5 上高于 MMGUP,并把原因归到上海更稀,以及 k=3、5 很小时 Recall 和 HR 比 NDCG 更重要。这是作者对指标轻重的判断,表本身同时保留了 KGAT 更高的两格。
另一点也要看全表:带知识图谱并不自动更好。北京 Recall@3 上,KGAT 只有 0.00394,低于只用交互图的 NGCF(0.00939)和 LightGCN(0.01328)。上海 NDCG 上,KGAT 又是最高。所以 MMGUP 的差距不能概括成“加上知识图谱就会赢”。
拿掉一个尺度,指标掉多少?
地理校准的对照是整段去掉,包括区域邻域平滑和地点被拉向区域的正则。北京 Recall@3 从 0.02334 降到 0.02238,差值 0.00096,相当于去掉校准后的 4.29%;HR@3 从 0.09746 降到 0.09143,差值 0.00603,相当于 6.60%。上海 Recall@3 从 0.01286 降到 0.01248,相对 3.04%;HR@3 从 0.03395 降到 0.03302,相对 2.82%。论文称去掉后性能明显变差。就 @3 这几格而言,相对变化是几个百分点,方向与“校准有帮助”一致,幅度远小于下面拿掉地点尺度的变化。
多粒度对照分两种删法。去掉区域尺度用户偏好后,北京 Recall@3、NDCG@3、HR@3 为 0.02167、0.03200、0.08790;上海为 0.01191、0.01100、0.03120。相对完整模型的北京 Recall@3,降了(0.02334−0.02167)/0.02334=7.16%;上海降了(0.01286−0.01191)/0.01286=7.39%。
去掉地点尺度用户偏好后,北京三项为 0.01110、0.01738、0.04933,Recall@3 只剩完整模型的 47.6%。上海三项在表中印为 0.0009、0.0006、0.0025,小数位比其他格子少一位。按印出的 0.0009 除以完整模型的 0.01286,约为 7.0%。地点尺度承担了大部分离线排序,区域尺度是在此之上的一小段增量。
三个系数的最好取值,以及表里不连贯的一格
α 控制区域向量朝邻居靠拢的强度。北京在 α=0.3 时三项最高,就是上面的 0.02334、0.03553、0.09746;上海在 α=0.2 时最高,为 0.01286、0.01207、0.03395。两边都是先升后降的 Recall 和 NDCG,论文把差异归于两套数据不同。
北京 α=0.2 的 HR@3 印为 0.03153。同一列相邻行是 α=0.1 的 0.08773、α=0.3 的 0.09746、α=0.4 的 0.09665。同一行的 Recall@3=0.02228、NDCG@3=0.03293,仍落在相邻 α 之间。论文总结说调这三个系数时没有观察到性能振荡。0.03153 与这条总结、也与同列其他 HR 不连贯。这里照表抄录,不把它改成看起来更顺的数字。
β 是区域尺度 BPR 在总损失里的系数,搜索了 0.01、0.001、0.0001。北京最好的是 0.0001。上海在 β=0.01 时 Recall@3=0.01296、HR@3=0.03425,略高于 β=0.0001 的 0.01286 和 0.03395,NDCG@3 几乎相同(0.01208 与 0.01207)。论文仍在上海使用 0.0001,并写更大的 β=0.1 会略微提高成绩,同时让 Recall@5、NDCG@5、HR@5 明显变差。表 7 没有 β=0.1,也没有这些 @5 的数字。β=0 时,正文只说成绩剧烈振荡,没有列出指标。
γ=0.2 在两座城市的 @3 三项上都最高。γ=0.4 时,北京 Recall@3 降到 0.02132,上海降到 0.01106。搜索网格没有包括纯地点分数(γ=0)和纯区域分数(γ=1);把某一尺度整个拿掉的结果在上面的消融里。最好设置下,地点分数的系数是 0.8。两个内积没有先归一化到同一尺度,所以 0.2 不能读成“区域贡献了 20% 的到访”。
这些数字能支持到哪一步?
支持的结论限于:在这两套过滤后的腾讯地图交互上,用同一套训练、早停和全量排序协议,MMGUP 的平均 Recall 与 HR 在 k=3 和 k=5 上高于表中基线;地点尺度表示对这个排序必不可少,区域尺度表示和地理校准带来较小的额外变化;上海 NDCG 上 KGAT 更高。
训练标签是去过或没去过。图 1 的午饭和出游没有对应的标注,模型也没有输出需求类型。区域向量来自路网分区和历史到访的加权,它是表示学习的结果,不是观察到的“人先选了这片区”。离线分数更高,也不等于上线后用户会更多采纳。论文把真实场景部署和在线 A/B 测试放在未来工作里,本文没有这项结果。
绝对命中仍然有限。北京 HR@3=0.09746,即约 9.75% 的用户能在前 3 个地点里碰到至少一个测试地点;上海 HR@3=0.03395,即约 3.40% 的用户。分母是用户。把前 3 名从数万个地点里挑出来,这个覆盖比例和“模型已经理解出行”是两件事。
三次平均没有配离散程度,星号也不是统计检验。北京 α=0.2 的 HR@3 与相邻行不连贯。路网邻居数 N、网络层数、区域个数、采集时段和到访定义都没有给出。换一套区域边界或换一种到访定义后,γ=0.2 是否仍最好,表内没有答案。
一句话总结
把区域尺度加进地点到访排序,能在北京和上海的召回、命中上多出一小段,地点尺度仍决定大部分成绩;这是离线排序的结果,不是对人先选店还是先选区的直接测量。
核心来源
- ACM 正式版本,DOI:10.1145/3589132.3625628。题目、作者、会议信息与正文图表均按该 10 页版本核对。
- 论文给出的代码入口:tsinghua-fib-lab/SIGSPATIAL-MMGUP。代码公开不等于腾讯地图原始到访记录公开。
作者介绍
以下只写论文署名和可核对的公开身份,不补充论文未列出、主页也未写明的职务。
- Yingrong Qin:论文署名为清华大学。本文参考文献中的图神经网络推荐综述,作者名单包含 Yingrong Qin、Chen Gao 与 Yong Li。
- Chen Gao:论文署名为清华大学,并标为通讯作者。其公开个人主页写明,他在清华大学电子工程系 FIB 实验室从事数据挖掘与信息检索,博士阶段由 Yong Li 与 Depeng Jin 指导。主页另有 incoming research assistant professor 的表述,页面未标注更新日期,这里不把它写成已经到任。
- Zhen Tu:论文署名为腾讯,北京。
- Hongsheng Wu:论文署名为腾讯,北京。
- Shuangqing Wei:论文署名为路易斯安那州立大学。学校教师主页列其为电气与计算机工程教授,研究方向包括通信理论、信息论及其在网络中的应用。
- Yue Wang:论文署名为清华大学。本文没有更细的职务说明。
- Lin Zhang:论文署名为清华大学深圳国际研究生院。
- Yong Li:论文署名为清华大学。其个人主页写明他是清华大学电子工程系教授,工作包括人类移动与推荐。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
γ=0.2 是在全部保留到访上估出来的平均系数。若把工作日中午和周末晚间拆开分别学习,地点分数和区域分数的系数可能会换位置:午饭行程的 γ 可能更低,闲逛行程的 γ 可能更高。当前实验把这些行程混在同一个 BPR 里,所以最好系数描述的是混合后的排序,不是两种需求各自的权重。要检验这一点,需要时间或行程目的标签,而原文的损失里没有这类标签。
另一个可计算、原文未报告的量,是“地点没碰对,区域是否碰对”。北京 HR@3 只有 0.09746,分母是用户;前 3 名没碰到测试地点时,它们是否仍落在该用户测试地点所属的区域内,会改变产品该先展示一家店还是先展示一片区。若区域命中很高而地点命中仍低,界面可以先给区域;若两者一起低,区域系数再调也主要是在重排一个很难命中的长名单。这需要沿用原文的路网分区重新统计,不能从现有 HR 直接换算。