日常位移看起来没有典型距离,是因为不同活动范围被加在了一起?
论文名片|Laura Alessandretti、Ulf Aslak、Sune Lehmann,The scales of human mobility,Nature,2020,587:402–407,2020年11月18日在线发表(期刊日期为2020年11月19日)。DOI:10.1038/s41586-020-2909-1。Alessandretti 与 Aslak 同等贡献。本文依据 Nature 正式版,含方法、扩展数据图和扩展数据表。研究类型是对个人 GPS 轨迹的观测建模:先从轨迹里估计嵌套的空间容器,再用留出的位移和分组比较做检验。
早上出门买面包,接着去附近办事,偶尔跨到城市另一头,很少才去另一个区域。如果把这些步子的长度放进同一张直方图,尾部往往拖得很长,看起来像没有一个典型距离。大量轨迹研究因此把人类移动性(human mobility,人在空间中的移动)说成无标度:位移长度的分布近似幂律,而幂律是没有特征尺度的分布。地理学却一直用邻里、城市、区域、国家这些有大小的层次来描述同一件事。
这篇论文的方向性结论是:日常移动里存在有典型大小的空间容器(container)。容器是从一个人的停留点轨迹里切出来的嵌套活动范围,不完全等于地图上的行政区。把容器内部的短移动和容器之间的长移动混在一起,混合分布才会看起来像幂律。在全球 GPS 数据集 D1 上,第 2 到第 5 层容器直径的中位数分别是 3.089 千米、27.064 千米、88.442 千米和 161.634 千米。分布是对数正态,有中心,但人与人之间仍然很散。
先说结论
- D1 的个人轨迹平均大约有四个层级。容器直径用对数正态描述优于截断幂律;第 2–5 层中位数为 3.089±0.006 千米、27.064±0.006 千米、88.442±0.022 千米、161.634±0.049 千米。变异系数在 2.721 到 3.042 之间,典型尺度不是人人相同的半径。
- 离开一个容器、进入另一个同层容器之前的停留时间也接近对数正态。图 1 虚线标出的中位数约为 0.4 天、1.0 天、2.2 天和 2.7 天。
- 用一年轨迹拟合后,在随后不重叠的 50 次位移上,容器模型比探索与偏好返回模型(exploration and preferential return,EPR)更好地描述全体位移分布、地点访问频率,以及时间熵与无关联熵之差;似然比检验的 P 远小于 0.01。回转半径随位移次数对数增长。
- 在 53 个国家中,21 个国家的女性层数显著多于男性(P≤0.05),没有任何国家相反。层数分布的性别差异与 2017 年性别不平等指数的 Spearman 相关为 ρ=0.69(P<10⁻⁶)。另有 48 个国家里,女性的容器更小(P≤0.05)。
- 乡村居民的容器大于城镇居民(P≤0.05),低层更明显。在新西兰、澳大利亚、加拿大和美国共 11,511 人中,家附近步行指数与第 2 层容器大小的 Spearman 相关为 ρ=−0.96(P<10⁻⁹)。这些是分组相关,不是干预效果。
无标度的是混合后的步长,还是移动本身?
既有研究把一个人连续位移的长度 Δr 写成尾部近似幂律,P(Δr) ≈ Δr⁻ᵝ,指数 β 通常落在 1 到 2。幂律没有特征尺度,所以那些工作把人类移动说成无标度。这篇论文不重新估计一个全球 β。它提出另一条账:每个尺度对应一种容器,容器有自己的典型大小;只在把各层容器内的移动和层与层之间的移动加总之后,才出现那条长尾。
图 1d 是示意图,不是这批 GPS 的拟合。左边是若干方差不同的对数正态(图中写成 log–log Gaussians),右边是它们的混合。虚线只是一条 β=1 的参照,用来让眼睛看出混合之后可以很像一条直线。它不证明真实位移的指数等于 1,也不证明对数正态混合是唯一能造出长尾的办法。
容器大小在文中的定义是直径:该层容器里,任意两个停留点之间的最大距离。它不是半径,也不是一天的总路程。第 1 层是单个停留点,不参与这四档直径。图 1 里标出的 3.1 千米、27.1 千米、88.4 千米、161.6 千米,是中位数四舍五入后的读数,精确值见下文的表。
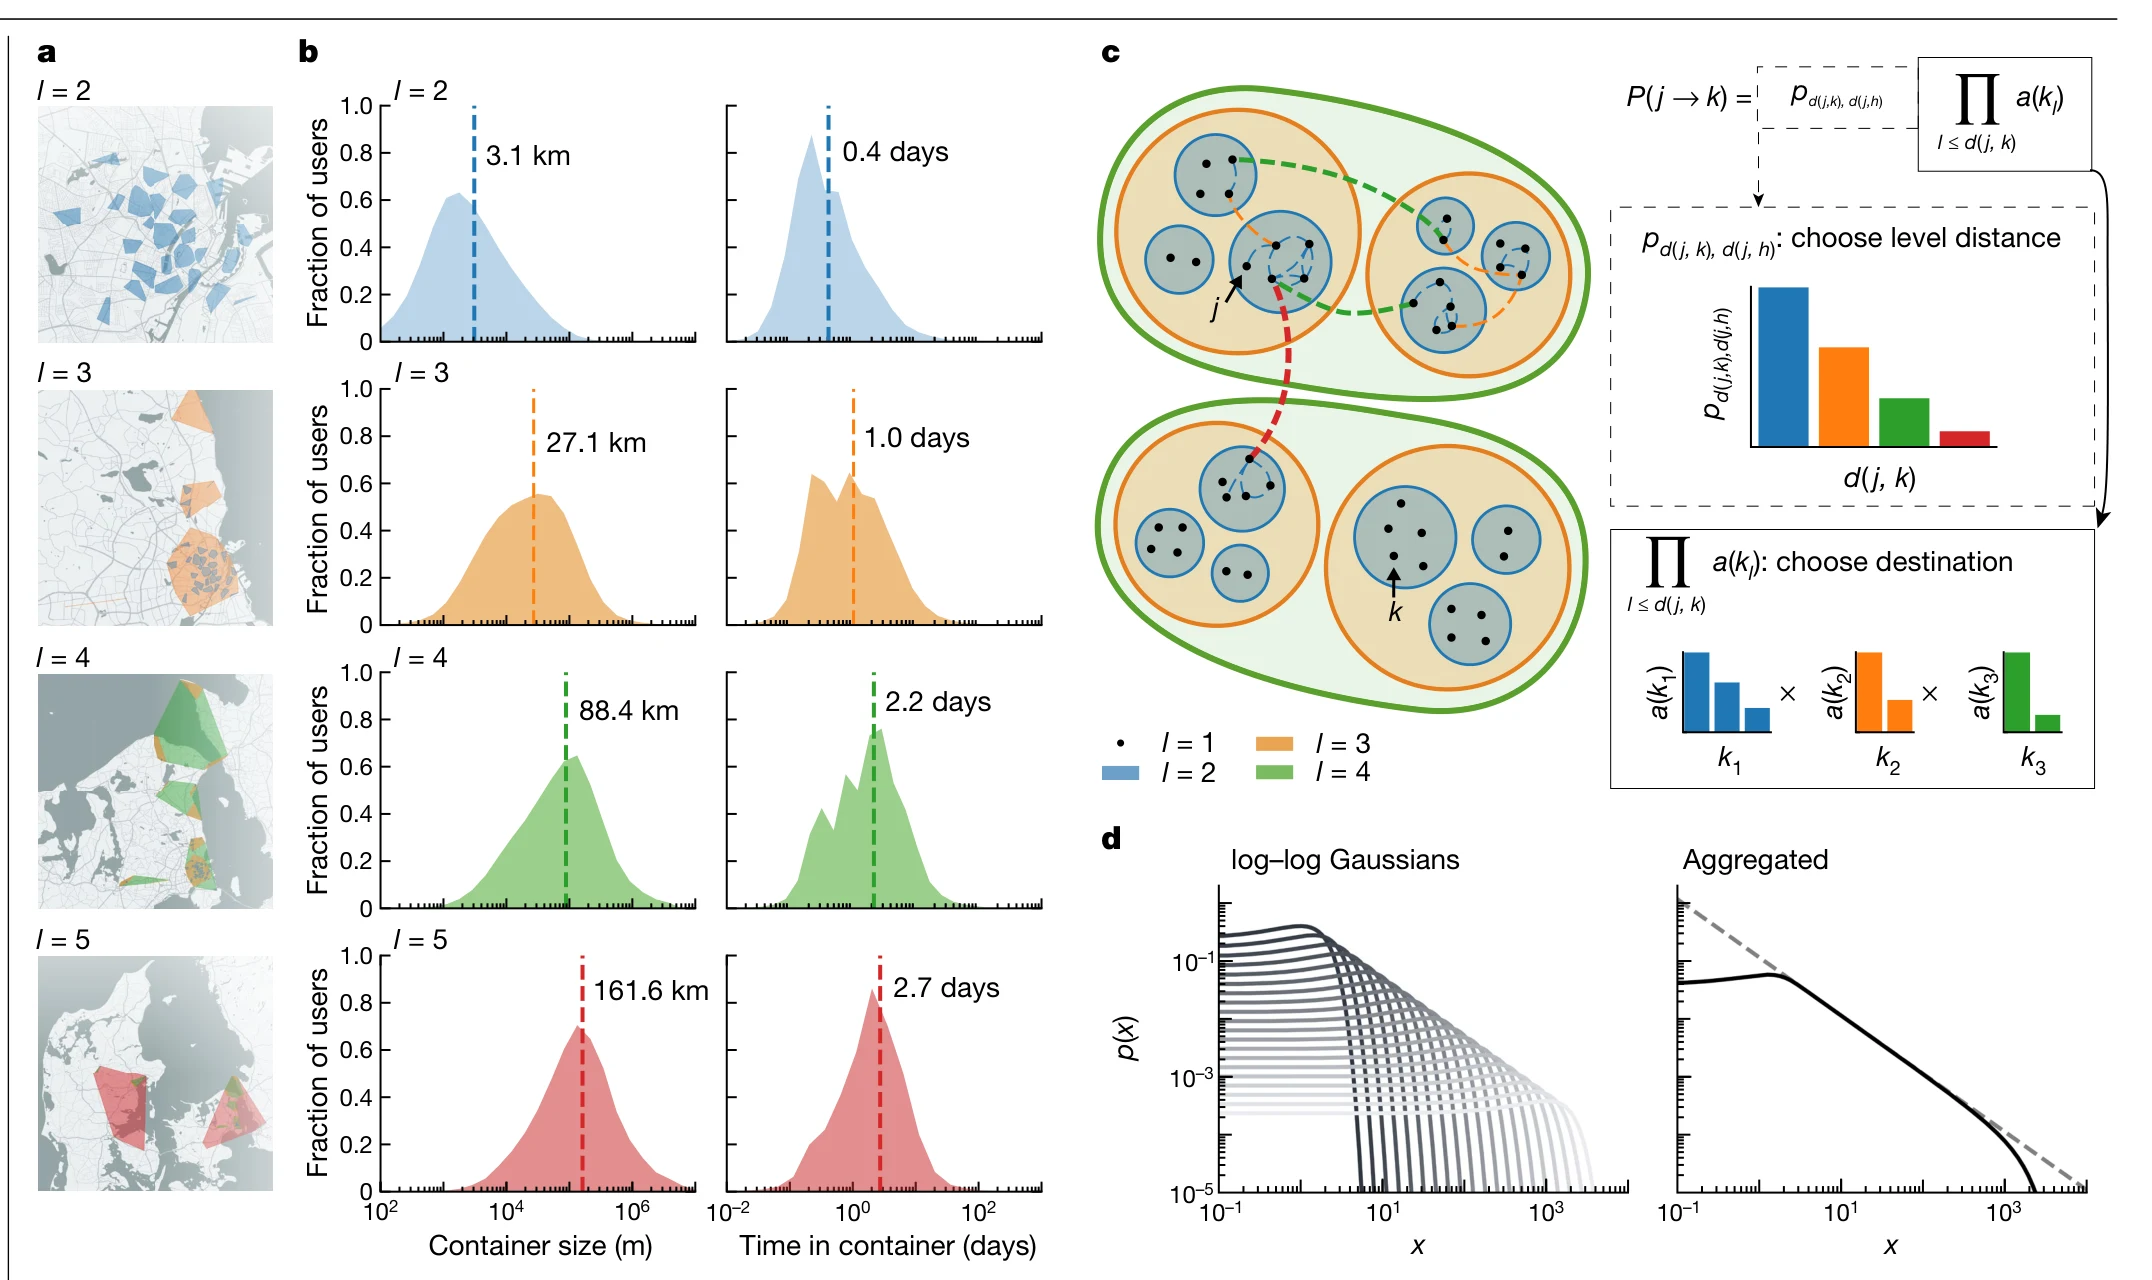
图 1|日常移动的典型尺度,是嵌套容器的直径,还是一条没有中心的幂律?
(a)一位作者在哥本哈根的轨迹示例,不是 D1 或 D2 里的随机被试。蓝、橙、绿、红分别示意邻里、城市、城市群和区域四层容器;地图来自 OpenStreetMap。(b)D1 上各层容器直径(左)和在同一容器中的停留时间(右)。纵轴是用户比例,虚线是中位数:第 2–5 层约为 3.1 千米与 0.4 天、27.1 千米与 1.0 天、88.4 千米与 2.2 天、161.6 千米与 2.7 天。分布有峰,不是一条一直平下去的幂律。(c)模型示意。黑点是地点,嵌套椭圆是容器。从 j 到 k 先按层级距离选要跨多远,再按各层吸引度选具体目的地。(d)方差不同的对数正态在对数坐标上混合后,可以接近一条幂律。虚线的指数取 1,只为对照。来源:原论文 Fig. 1。
这两套轨迹,分别是谁、精确到什么程度?
D1 来自一家全球智能手机与电子产品公司的应用,2017–2019 年,原始采集约 5,000,000 人。位置不是固定频率采样,而是加速度计发现运动状态变化时才更新。93% 的点定位误差低于 100 米。年龄、性别等由用户注册时自报。方法里的纳入标准是:至少有一年数据,并且每天至少 50% 的时间位置已知,这样选出约 700,000 人,年龄 18–80 岁,平均 36 岁,大约三分之一为女性。摘要写的是超过 700,000 人。
扩展数据图 1 的图注给出另一个印出来的分母:至少一年数据、且任意一天的时间覆盖率高于 50%,共 600,817 人;每人取时间覆盖率中位数最高的那一年。约 70 万、超过 70 万和 600,817 是正文不同位置的三种写法,不能当成同一个精确计数。下面的性别柱状图属于这 600,817 人。
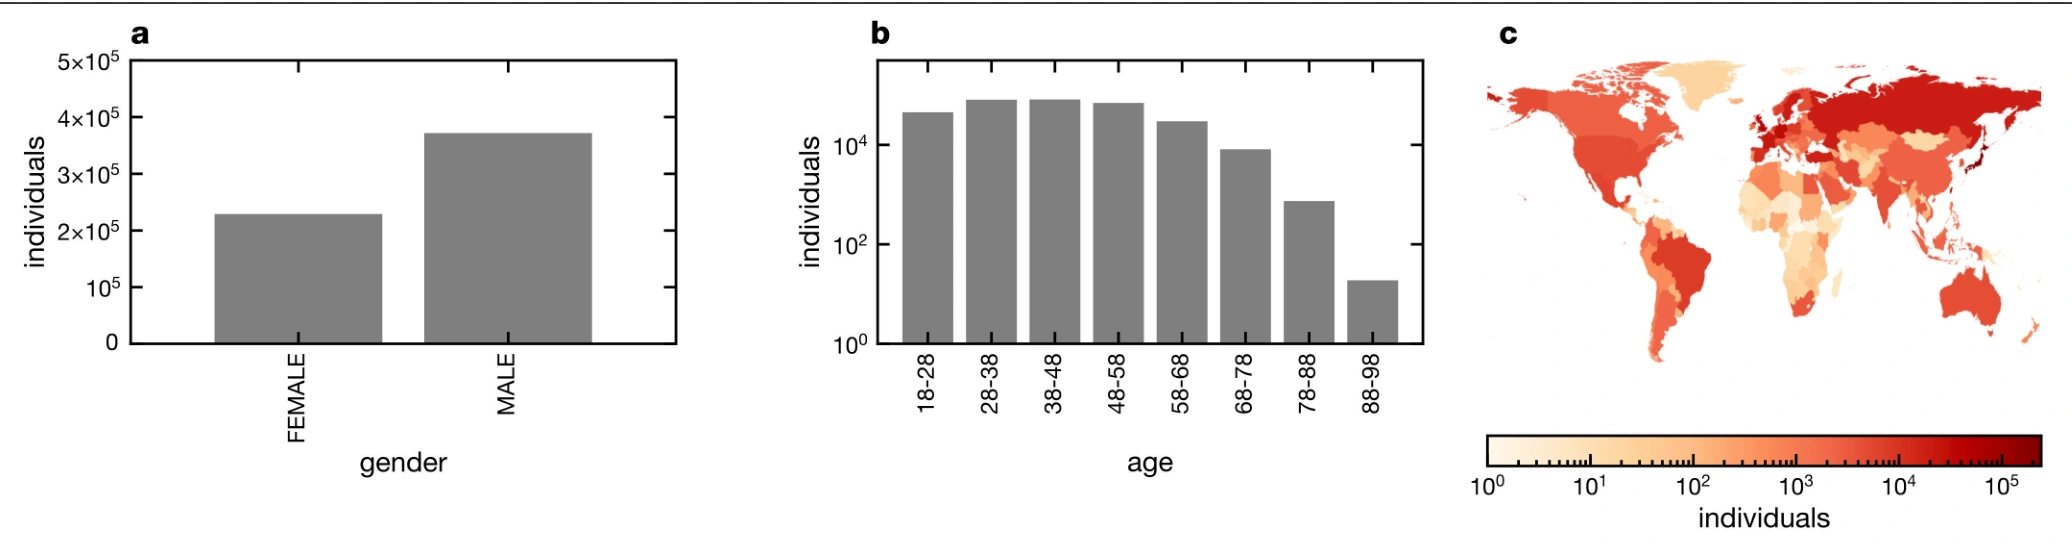
图 4|全球这批轨迹的人,在性别、年龄和国家上怎么分布?
(a)600,817 人中,女性柱略高于 2×10⁵,男性柱略低于 4×10⁵。这与方法里“大约三分之一为女性”同向,图上没有印出精确人数。(b)年龄分组后,中年几组最高,最高龄组降到 10¹ 和 10² 之间。方法正文写的年龄范围是 18–80 岁、平均 36 岁;图中分组边界此处不逐格转写。(c)各国人数,颜色是人数而不是人均出行,色标从 10⁰ 到 10⁵。深色集中在美国和欧洲一部分国家,不能把结果读成世界人口的等比例样本。来源:原论文 Extended Data Fig. 1。
D2 是另一套对照,用来看尺度是否只属于这一家公司的用户。方法写的是 2013 年 9 月到 2015 年 9 月的 851 名丹麦技术大学学生,约 22% 为女性、约 78% 为男性,年龄多在 19–21 岁。正文开头写的是大约 1,000 名学生。位置由 GPS 和 WiFi 合并,大约每 1–2 分钟一个点,95% 的点误差低于 50 米。D2 的年龄和职业极窄,不能代表一般成年人。
所有轨迹先用 Infostop 收成停留点:空间参数 r₁=r₂=30 米,最短停留 10 分钟,两段记录相隔不超过 24 小时仍可算同一次停留。正文称这些参数变动后结果仍然稳健。第 2 层直径的众数约 301 米,D1 里 93% 的点定位误差低于 100 米,停留点又按 30 米合并。众数只比这档定位误差大几倍,分布左尾还可以更接近测量误差。
模型到底在选什么?
对每个人单独建一棵容器层次,不假设全世界共用同一套边界。地点 k 写成一串从细到粗的容器 (k₁, …, k_L)。层级距离 d(j, k) 是两串编号从哪一层开始不同:还在同一个邻里里,层级距离就低;要换城市或换国家,层级距离就高。家被定义成各层吸引度都最大的那个地点,不一定是夜间停留最久的住宅,文中没有用夜间规则去核对这个定义。
一次移动拆成两步。人在 j,先决定这次跨多大的层级距离;这个概率要看 j 离自己的家有多远,因为人不在本国时,更可能发生国家级的转移。然后在该层级距离上,按吸引度挑选具体容器。吸引度 a(k_l) 是在同一个上级容器里选中 k_l 的概率,同一上级之下加总为 1。正文把转移概率写成层级距离概率与沿途各层吸引度的乘积。方法里多了一项归一化:当前所在的那个容器不能被再次选中。正文为了可读省掉了这一项。
这是描述轨迹的概率模型,不是在还原当事人脑子里的选择。它也不包含出发时刻、探索新地点,或道路和航班是否真的连得上。作者在讨论里把这三件事列为模型没有处理的部分。
层次不是随便画的圈。候选分割来自完全连接层次聚类:每次合并后,新簇的直径(簇内最远两点的距离)要最小。然后沿树状图一次加一刀,用似然挑选切在哪里;若自助法表明似然没有显著变好(P≤0.01),就停止。轨迹足够长时,吸引度和层级距离概率可以由转移频数直接估计,搜索主要花在层次本身。
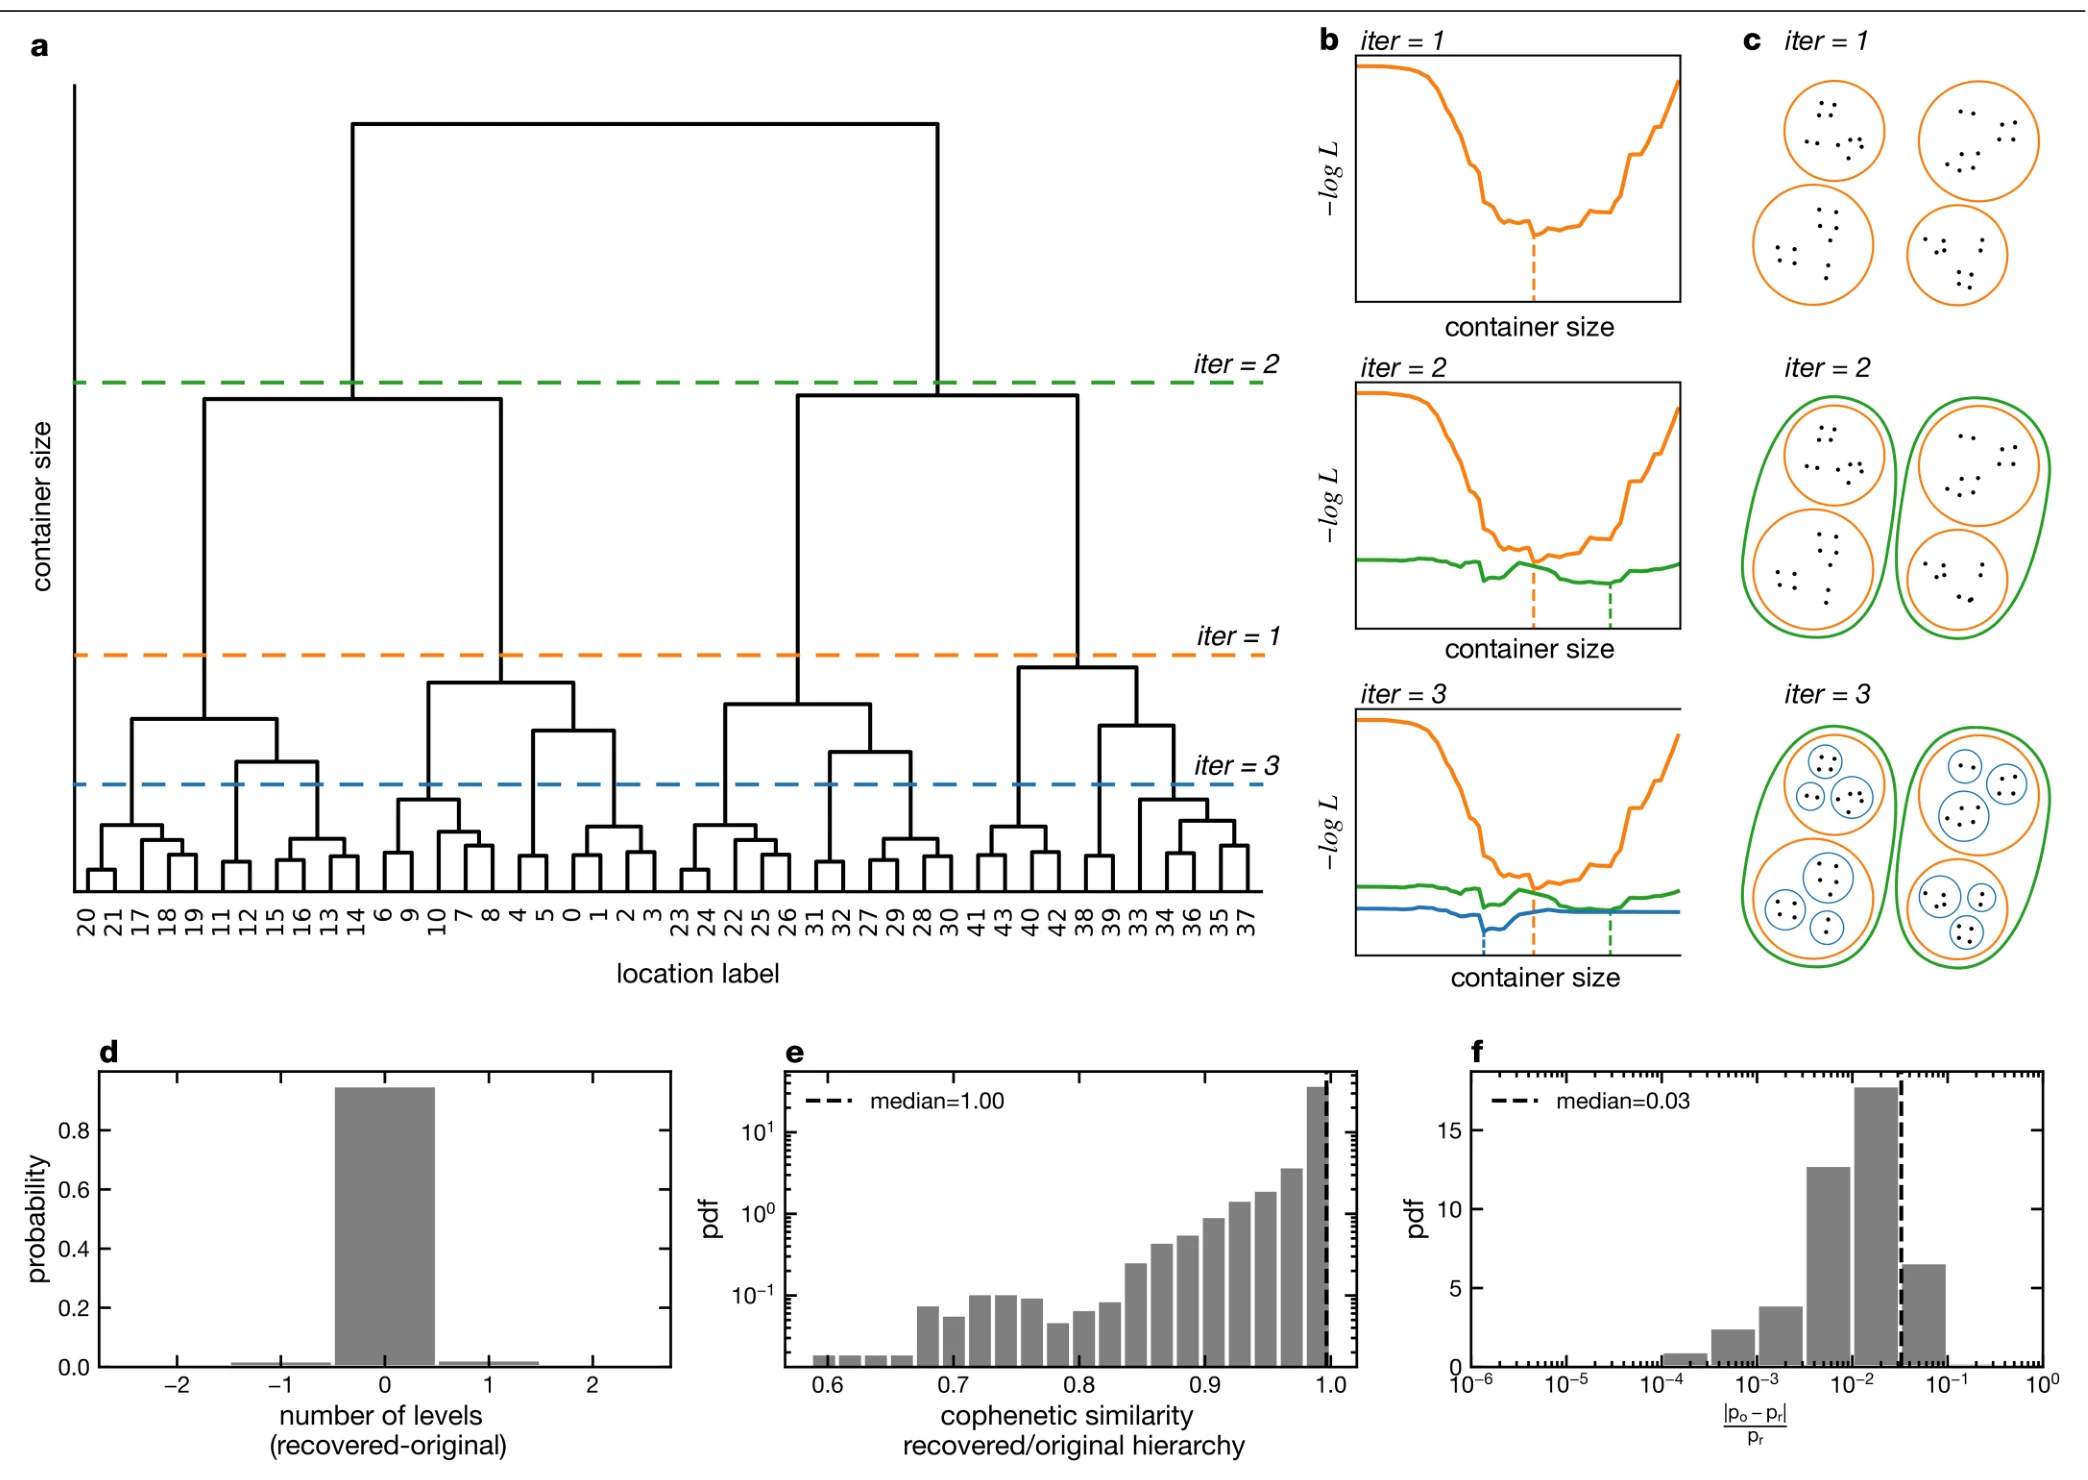
图 6|从停留点到容器层次,这一刀切在哪里,合成数据上能恢复多少?
(a)完全连接聚类的树状图。横轴是地点,纵轴是容器大小;虚线是不同迭代加上的切分。(b)每一轮在容器大小上寻找负对数似然的低点,从而决定要不要再加一层。(c)这些切分对应的嵌套分区:点、小圈、再套进大圈。(d)5,000 条、每条 3,000 个地点的合成轨迹上,恢复层数减去原始层数。零差的柱明显高于 0.9。图注写这个差为 0 的情况占 70%,方法正文写大约 95% 能找回正确层数。三处数字对不齐,不能合成一个恢复率。(e)恢复层次与原始层次的同位相关系数,中位数为 1。(f)转移概率矩阵逐项相对差 |p₀−pᵣ|/pᵣ,中位数为 0.03。来源:原论文 Extended Data Fig. 3。
同位相关的中位数为 1,只说明在这批合成轨迹上,地点两两之间的层级距离大多被恢复成原样。它不说明真实城市的行政边界被找到了。层数恢复率在图、图注和方法正文里不一致,使用这个算法时要把这处不确定留下来。
四公里和一百六十公里都叫典型尺度,人与人差多大?
把 D1 上每个人的容器直径放在一起,每一层都呈单峰,并且更像对数正态,而不是一条无标度的幂律。对数正态的中位数是 e 的 μ 次方。正文给出:
e^μ₂ = 3.089±0.006 千米,e^μ₃ = 27.064±0.006 千米,e^μ₄ = 88.442±0.022 千米,e^μ₅ = 161.634±0.049 千米。
扩展数据表 3 把同一批中心值写成米,并给出对数均值、对数标准差、众数和变异系数。第 2 层的不确定度与正文一致,是 ±6 米。第 3–5 层表中的不确定度大于正文的千米不确定度。中心值换算后一致,不确定度的两种印法不能互相覆盖。
| 层级 | 中位数 | 众数 | μ | σ | 变异系数 |
|---|---|---|---|---|---|
| 2 | 3.089±0.006 千米(表:3,089±6 米) | 301±1 米 | 8.036±0.002 | 1.526±0.001 | 3.042±0.007 |
| 3 | 27.064±0.006 千米(表:27,064±58 米) | 2,653±14 米 | 10.206±0.002 | 1.524±0.002 | 3.033±0.008 |
| 4 | 88.442±0.022 千米(表:88,442±217 米) | 8,791±51 米 | 11.390±0.002 | 1.519±0.002 | 3.010±0.009 |
| 5 | 161.634±0.049 千米(表:161,634±498 米) | 19,233±136 米 | 11.993±0.003 | 1.459±0.002 | 2.721±0.010 |
变异系数是标准差除以均值,对数正态下等于 √(e^(σ²)−1)。正文说第 2–5 层落在 2.721 到 3.042,与表的两端一致。变异系数大约是 3,意味着离散程度大约是平均直径的三倍。第 2 层最常出现的直径约 301 米,但有一半人超过 3.1 千米。有典型尺度,指的是分布有中位数和众数;它不表示人群挤在同一个 3 千米圈子里。
停留时间同样用对数正态,而不是截断幂律来描述。图 1 的 0.4 天、1.0 天、2.2 天、2.7 天是各层中位数的图上标注。扩展数据表 2 的定义更明确:在转移到另一个容器之前,待在当前容器里的时间。它不是一辈子累计待在家乡的总天数。表 2 只比较对数正态和截断幂律。D1、地点尺度 30 米、第 2–5 层的对数似然比 R 为 176821、104424、50225、22965,全部为正并标到 P≤0.001。R 为正表示对数正态的似然更高。D2 在地点尺度 20 米、30 米、50 米下,这一行同样全部为正并标到 P≤0.001。
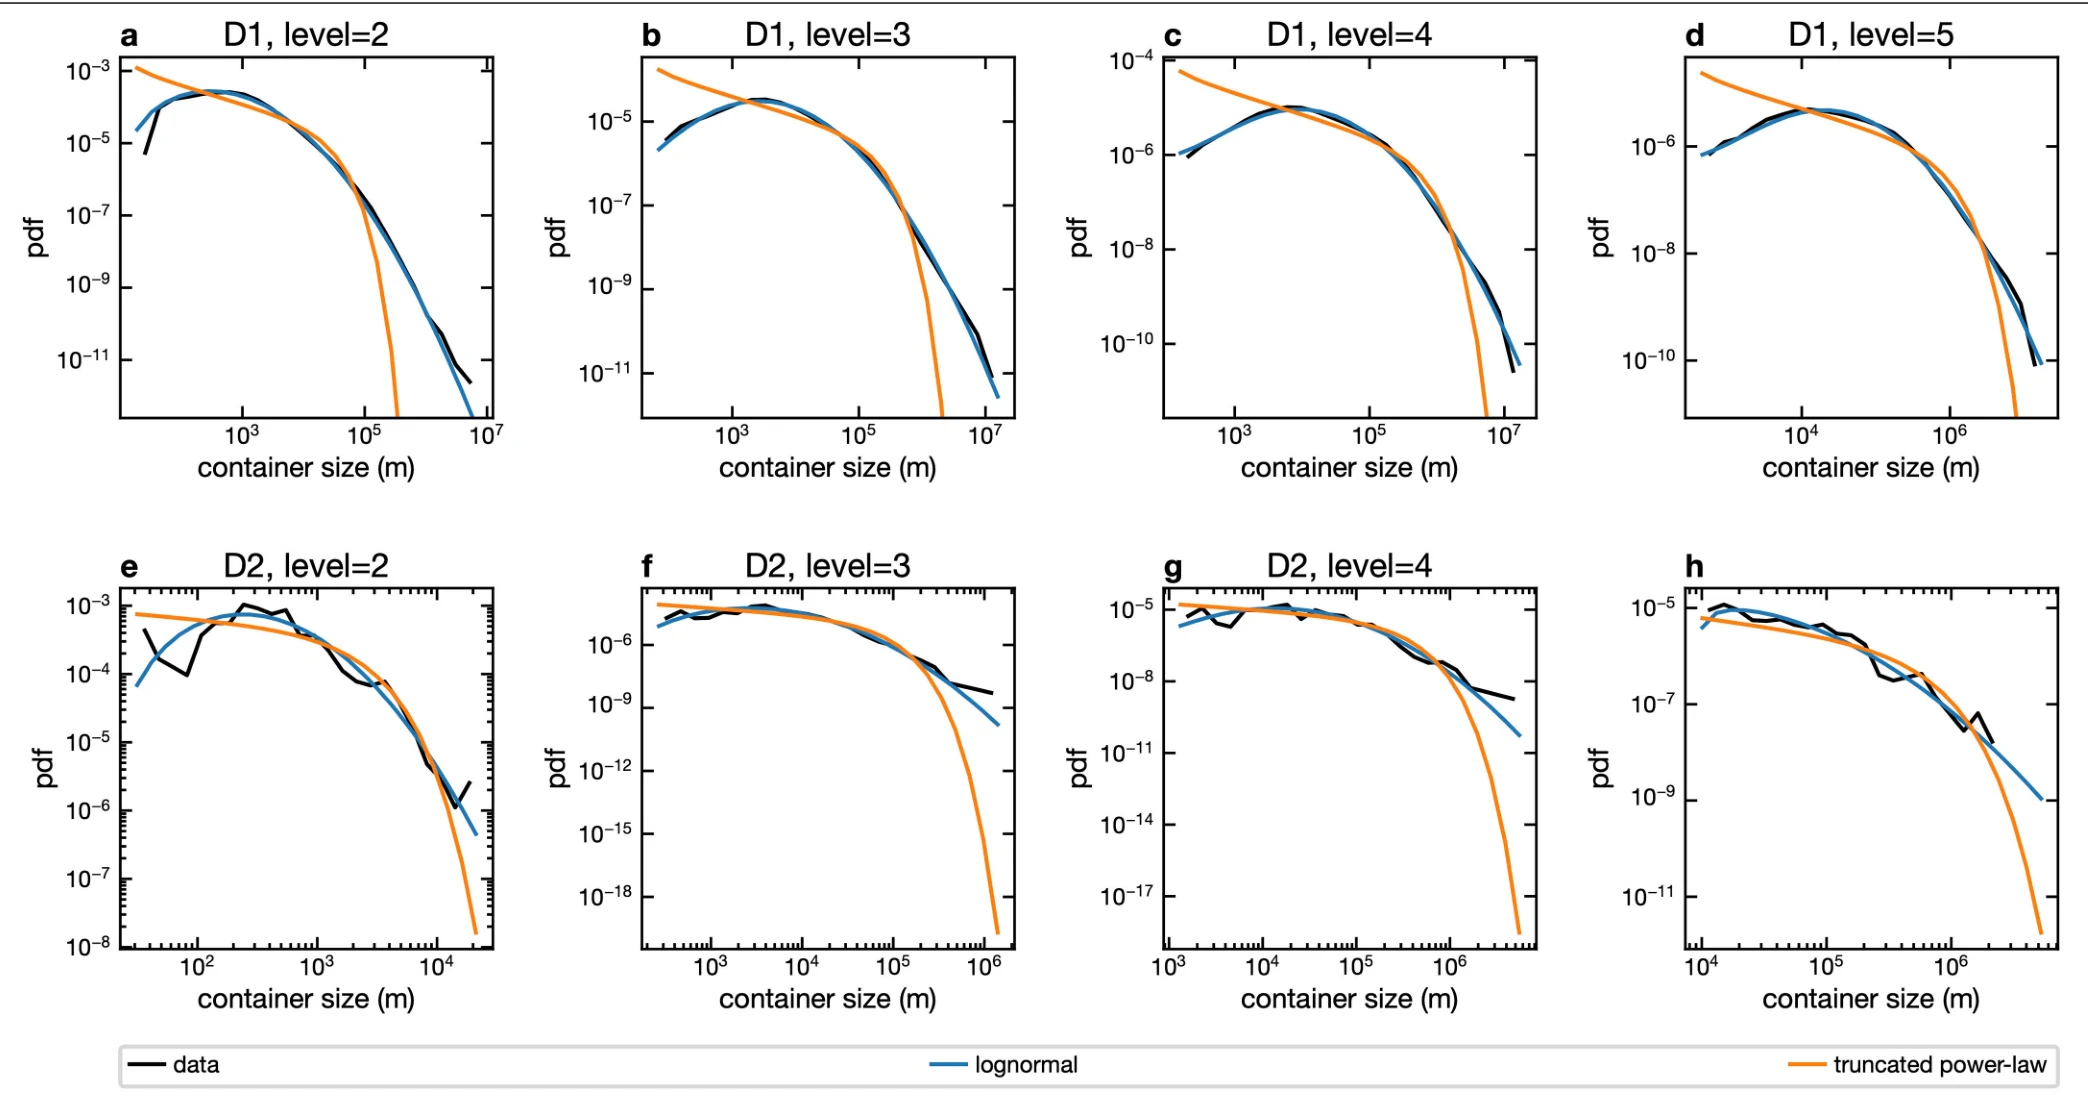
图 5|容器直径的长尾,是对数正态还是被截断的幂律?
(a、e)第 2 层,(b、f)第 3 层,(c、g)第 4 层,(d、h)第 5 层。上排(a–d)是 D1,下排(e–h)是 D2。黑线是数据,蓝线是对数正态,橙线是截断幂律。横轴是容器直径(米),纵轴是概率密度。橙线在大尺度一端掉得更快,蓝线跟黑线的尾部更久。D2 的曲线更抖,学生样本更小。来源:原论文 Extended Data Fig. 2。
扩展数据表 1 把对数正态再拿去和截断幂律、幂律、对数逻辑、对数伽马、对数拉普拉斯、对数韦伯比较。表中 D1 显示的地点尺度是 30 米,D2 是 20 米、30 米和 50 米。截断幂律那一行在这些格子里都为正,D1 第 2–5 层的 R 为 114347、66452、47085、28175,均标到 P≤0.001。对数逻辑一行不是一边倒:D2 里出现 0 以及 −1、−2 这样很小的 R。对数正态赢过截断幂律,并不等于它赢过每一种替代分布。似然更高也还不是机制证明,只是在这些候选分布里更合适。
层级数目本身也有集中趋势。正文说经验轨迹平均大约四个层级。EPR 及其变体生成的轨迹,最好只用一个把停留点归并起来的层级来描述。读扩展数据图 5 时要先对齐计数:层数等于 1 表示只有停留点、没有容器;层数等于 2 表示在停留点之上再加一层容器。正文说的单一层级,对应图上峰值在 2,而不是峰值在 4。
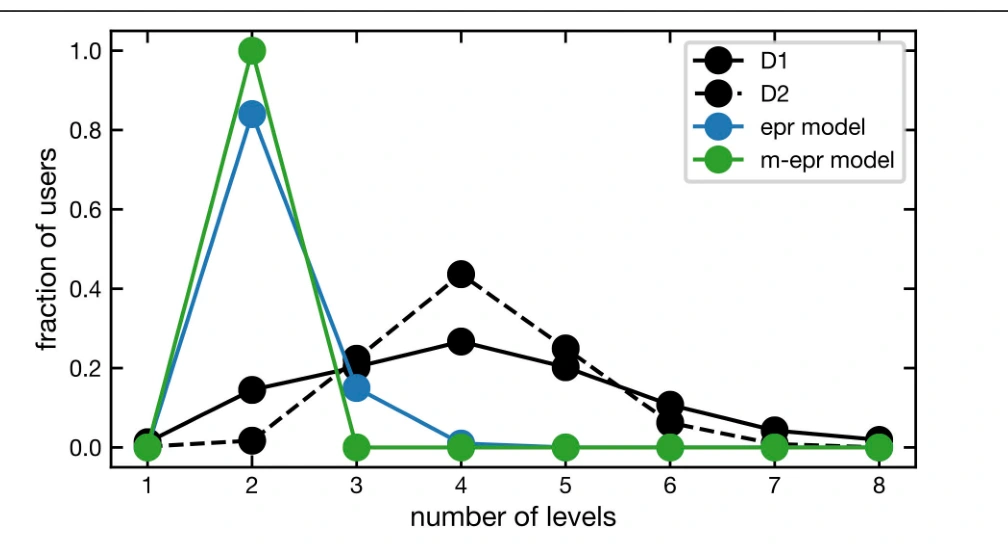
图 8|真实轨迹的层数集中在四层附近,EPR 生成的轨迹集中在两层,这张图没有分子图字母。
横轴是层数,纵轴是用户比例。D1 实线和 D2 虚线都在 4 层最高,两侧递减。1,000 条 EPR 合成轨迹的峰值在 2 层,m-EPR 在 2 层达到图的顶端。图上没有印出 4 层的精确比例,不能把柱高读成精确百分数。来源:原论文 Extended Data Fig. 5。
D1 和 D2 的峰值都在 4 层,所以“大约四个层级”不只是全球手机用户的结果。D2 只有数百名大学生,峰值位置能对齐,各层直径的千米中位数仍然来自 D1 的图 1 和表 3,不能抄到丹麦学生身上。
没见过的下一段路,模型跟得上吗?
拟合只用每个人一年的轨迹。随后生成 1,000 条、每条 50 次位移的合成序列,拿去和训练窗之后那 50 次真实位移比较。两段数据不重叠。图 2 用的是随机抽出的 9,000 人,不是全部 60 万或 70 万人。位移分布、地点频率和熵差的色带,是每人 1,000 次模拟的均值加减两个标准差。回转半径的色带是四分位距。
比较对象首先是 EPR。在那个模型里,人会以随已访问地点数变化的概率探索新地点,新地点的距离从幂律里抽;否则按过去的访问次数回到旧地点。它本来就是为了解释无标度位移和返回行为。容器模型若只是多加了参数,应该在留出的 50 步上失去优势。似然比检验的结果是,位移长度分布、地点访问频率,以及无关联熵与时间熵之差,都更支持容器模型,P 远小于 0.01。
回转半径衡量足迹铺得多开:各次位置到当时质心的均方根距离,这里的位移次数 N=50。真实数据、EPR 和容器模型的回转半径都大致按 a + b log(t) 增长。正文说,只有容器模型的 a 和 b 在误差范围内与真实数据一致。正文没有印出 a 和 b。
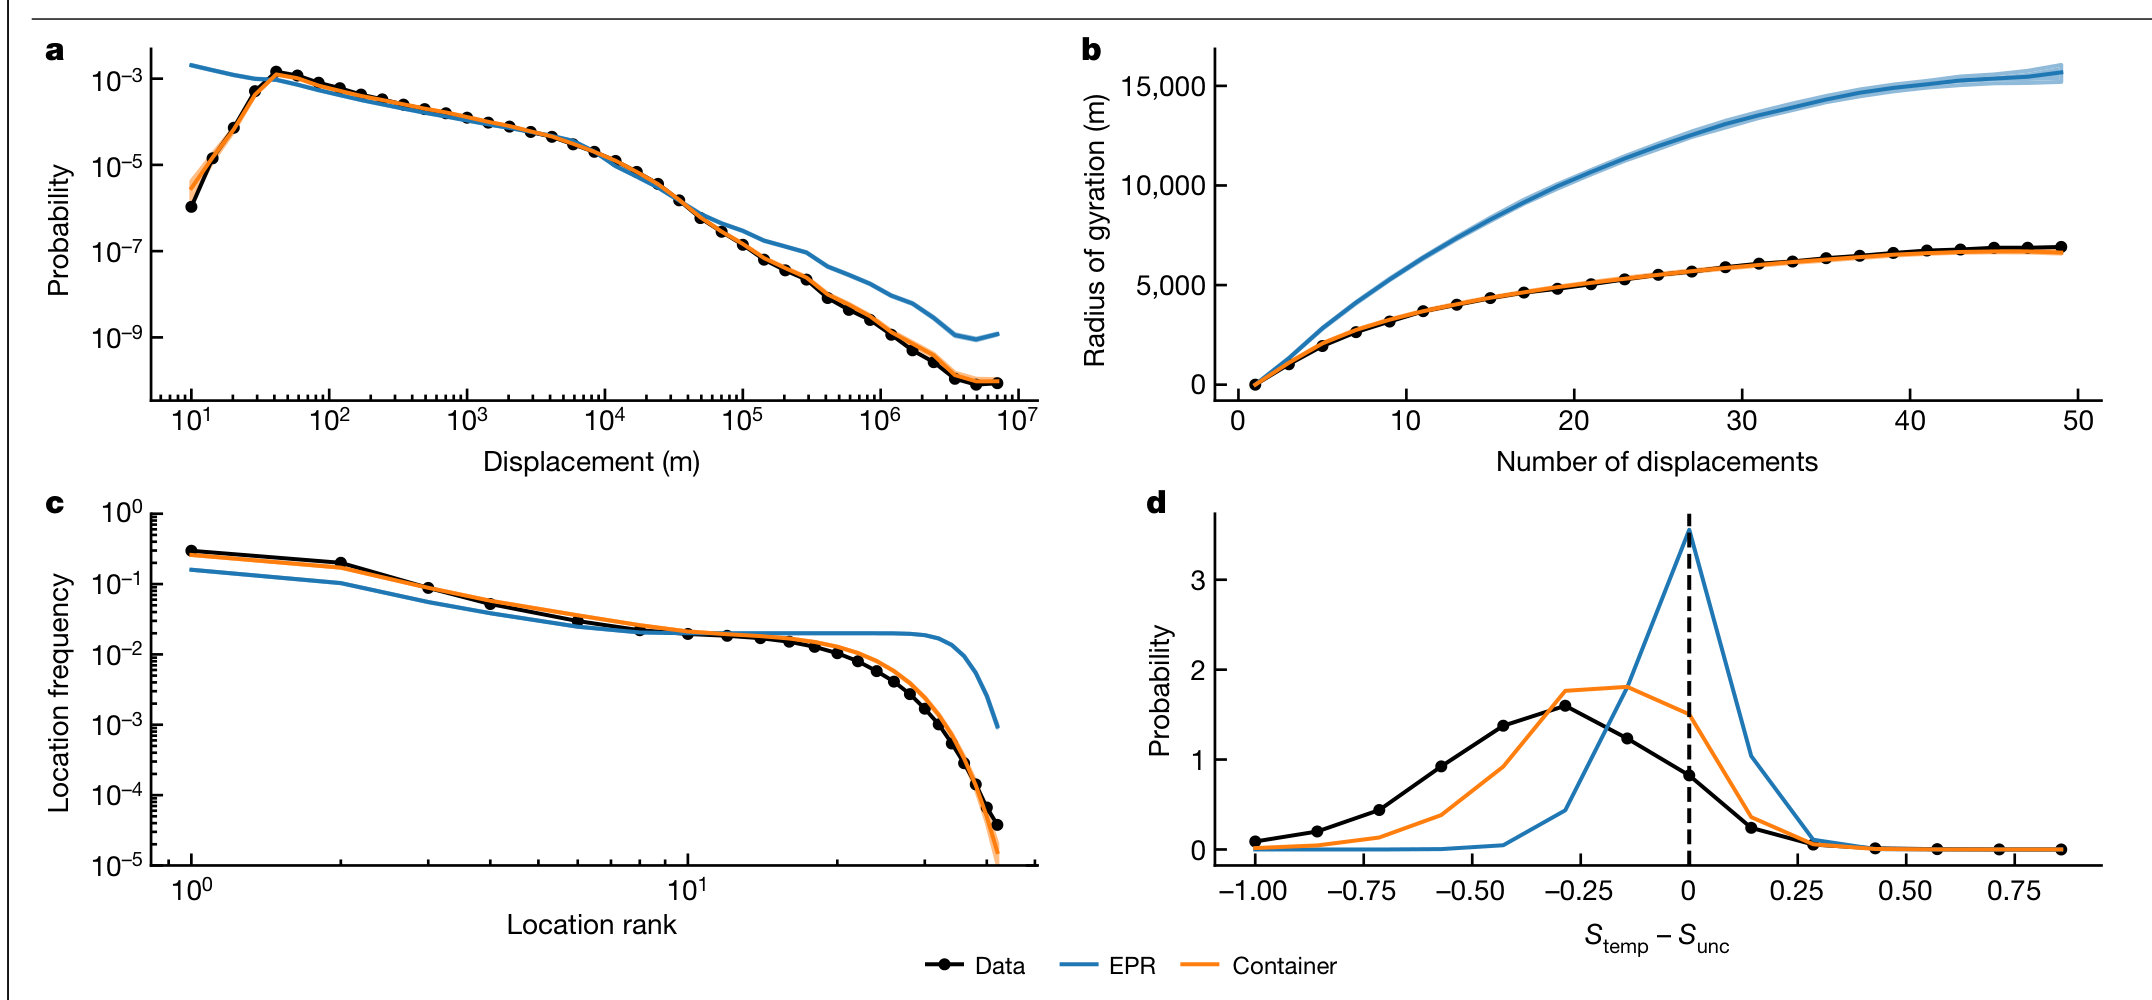
图 2|用下一年的 50 步检验,容器模型比 EPR 多解释了哪几项?
(a)全体位移长度分布。黑点是 9,000 人的真实轨迹,橙线是容器模型,蓝线是 EPR。短距离处 EPR 抬得过高,10⁵ 米以后又比数据下降得慢;橙线贴着黑点。(b)个人回转半径的中位数对位移次数。50 次时 EPR 接近坐标上沿 15,000 米,数据和容器模型落在 5,000 米与 10,000 米两格之间。(c)地点访问频率对地点排名。容器模型跟上真实曲线的下降,EPR 在高排名处偏平。(d)时间熵减去无关联熵。数据的峰在 0 的左侧,EPR 在 0 处又高又窄,容器模型夹在两者之间。似然比支持容器模型,并不表示熵差的形状已经重合。来源:原论文 Fig. 2。
扩展数据图 4 把对照扩到 m-EPR、recency-EPR、d-EPR 和 DITRAS。扩展数据表 4 的对数似然比在所有印出的格子里都为正,表示容器模型的似然更高,多数标到 P≤0.001。需要单独看的格子是:D2 上 d-EPR 的位移分布 R=557,只标了一颗星,对应 P≤0.05,不是 P≤0.001。d-EPR 和 DITRAS 在 D1 的三列是空的,表下没有说明缺项原因。正文还说,这一优势在补充说明 4 的六种个体模型上仍然成立。
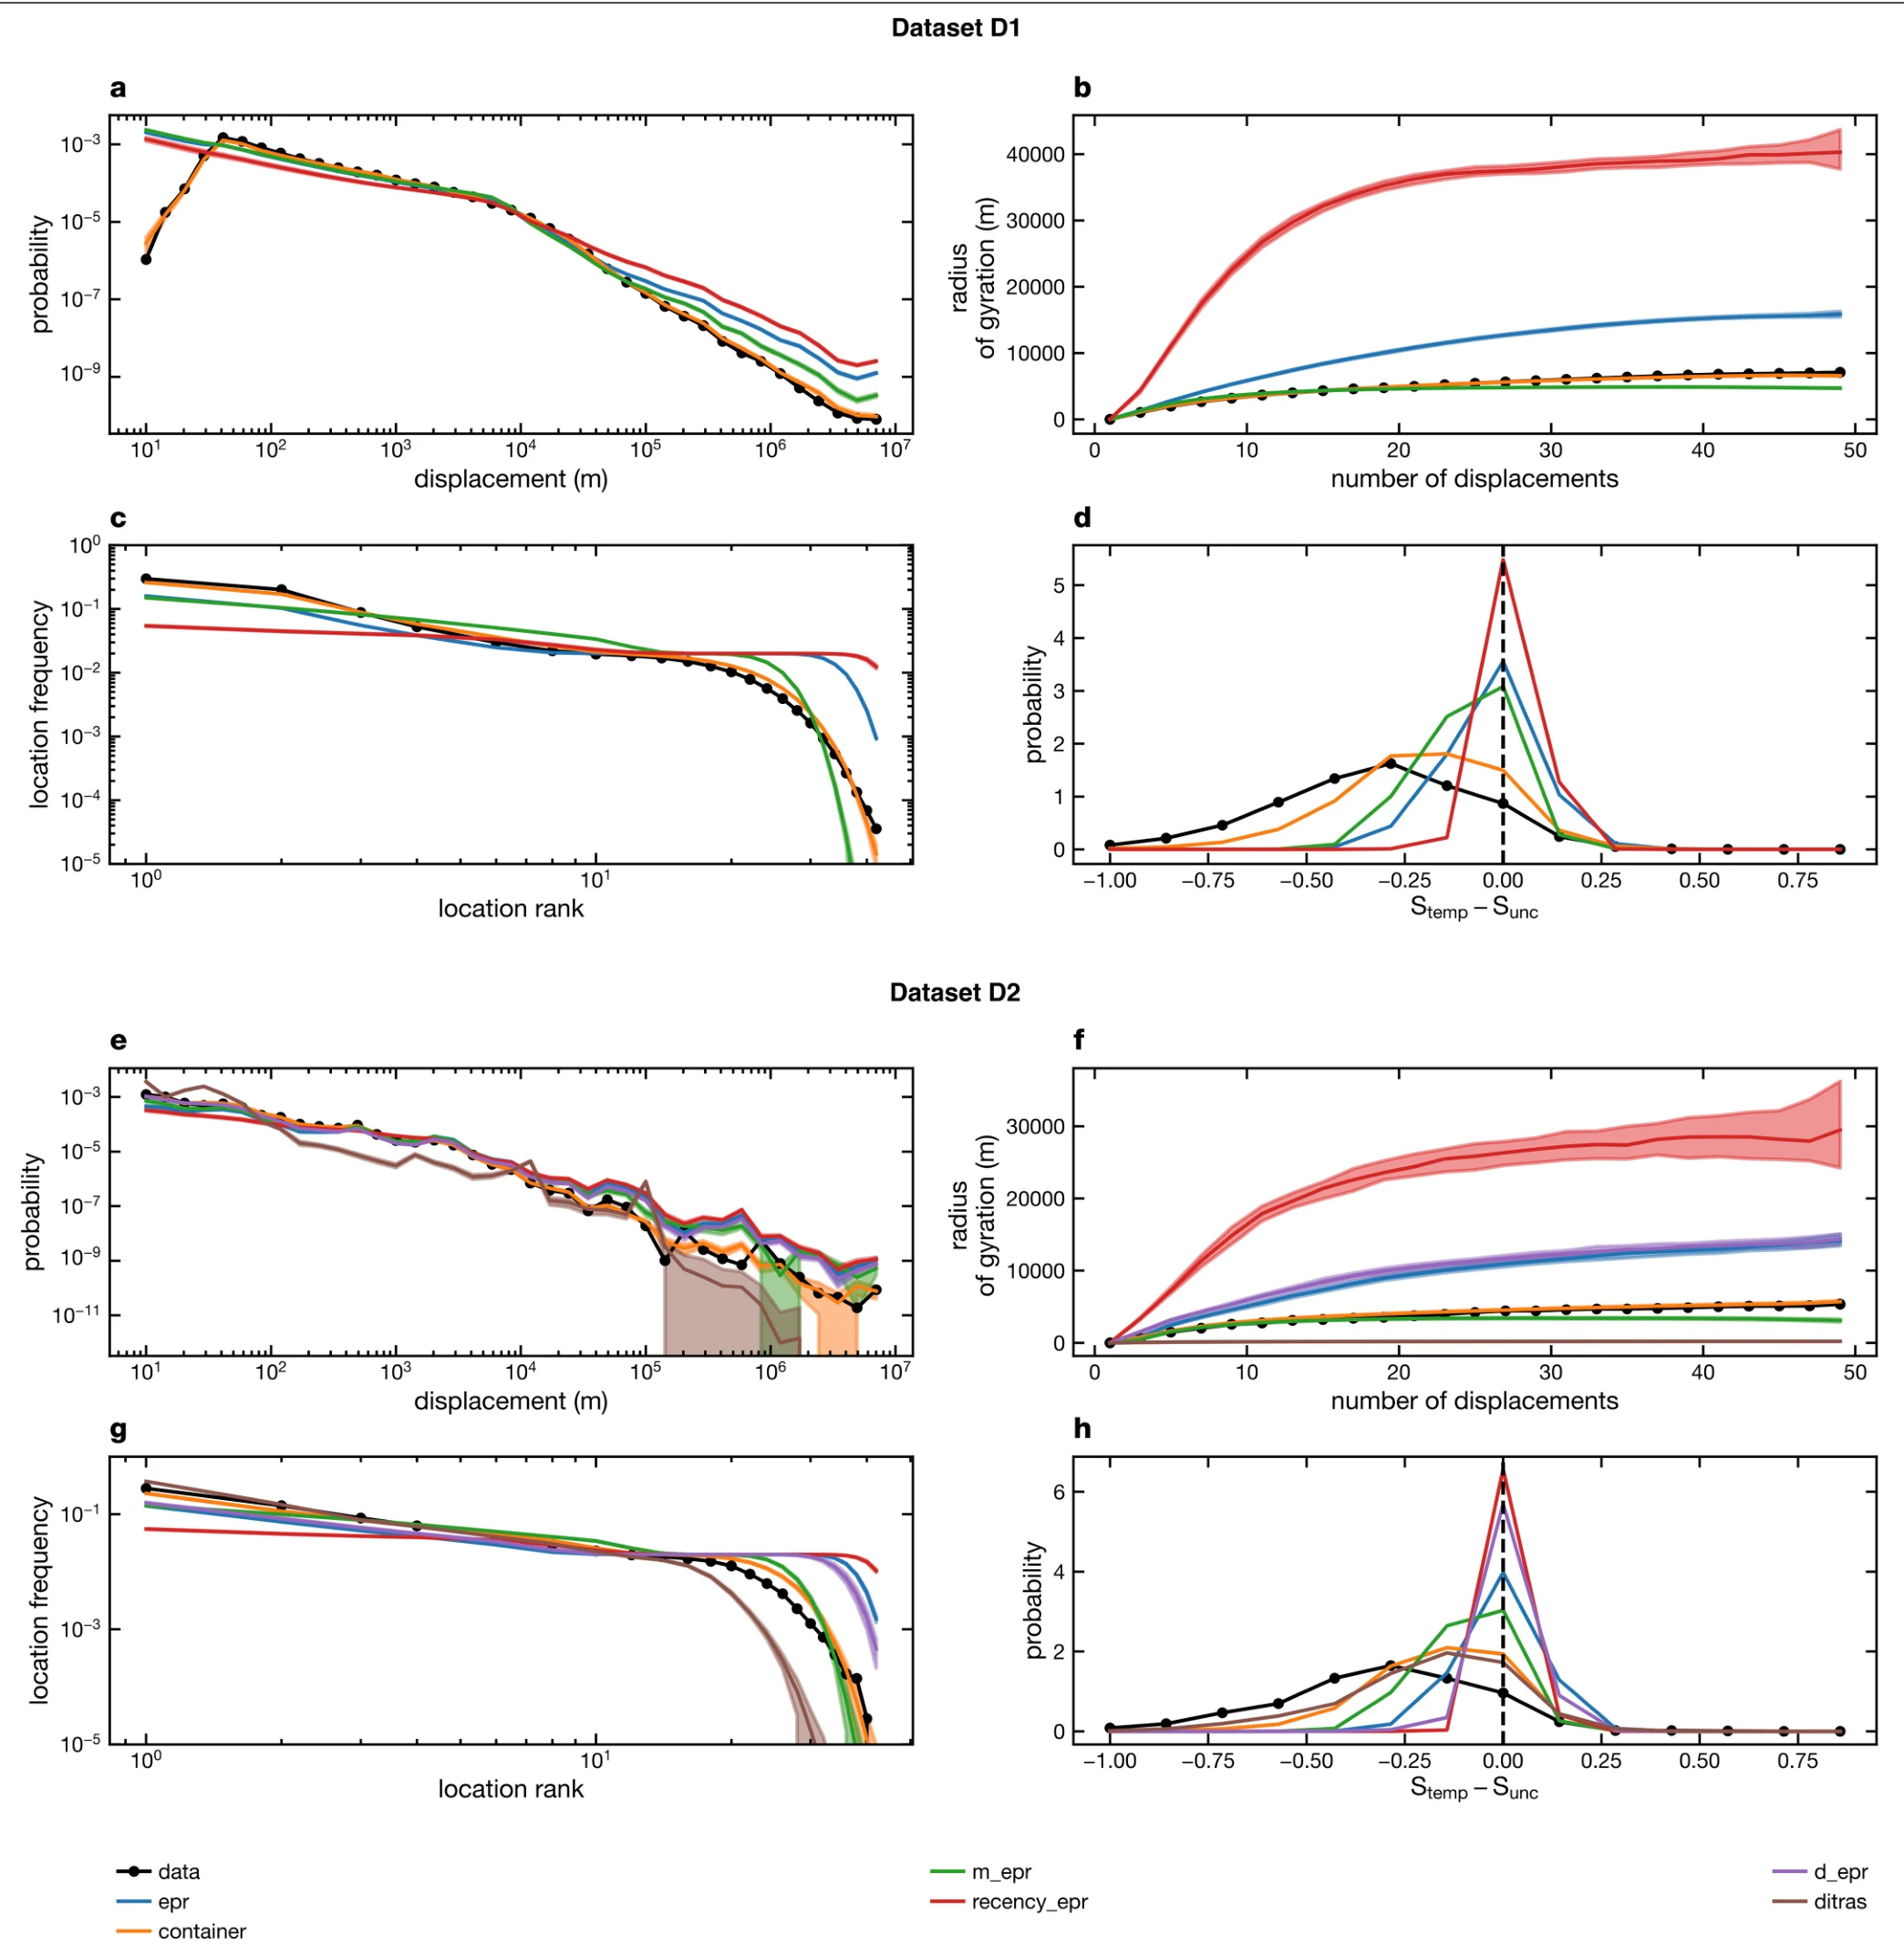
图 7|换一批个体模型之后,优势还在同一类统计上吗?
(a、e)全体位移分布,(b、f)回转半径中位数对位移次数,(c、g)地点访问频率对排名,(d、h)时间熵减无关联熵。上排(a–d)是 D1,下排(e–h)是 D2。黑色带点是数据,橙色是容器模型,其余为 EPR、m-EPR、recency-EPR、d-EPR 和 DITRAS。(b)里容器模型和 m-EPR 都贴近 D1 的回转半径,recency-EPR 升到约 4×10⁴ 米,EPR 升到约 1.5×10⁴ 米。曲线靠近不等于似然最高;表 4 里容器模型相对 m-EPR 的 R 仍为正。(d、h)里多个模型在 0 处形成尖峰,数据更扁,并且峰在 0 的左边。(e)的长距离端抖动大,D2 的人数只有数百人。来源:原论文 Extended Data Fig. 4。
50 次位移是很短的检验窗。模型可以在这 50 步上赢过 EPR,同时仍然缺少星期和昼夜节律。生成轨迹时,层次、吸引度和转移概率都来自这个人自己的过去,不是一个对所有城市通用、事先不知家在哪里的预测器。
国家、性别、城乡和步行环境,差在层数还是差在直径?
分组比较用的是容器模型已经估计好的层数和直径,再对照已有文献里的性别差异、城乡可达性和步行指数。对照成立,说明这种描述和已有现象对得上;它不能把相关变成性别、居住地或街道设计的因果效应。
性别先看层数。53 个国家里,21 个国家的女性层数显著多于男性(P≤0.05),没有一个国家相反。图 3a 挑出 KL 散度最大的沙特阿拉伯和印度,以及最小的德国和南非。KL 散度衡量的是男女层数分布差多远,不是平均层数本身。沙特阿拉伯和印度的累积分布差在层数较低的一段为正:男性的累积分布升得更快,也就是男性更集中在较少的层数上;插图里女性曲线在男性右侧。德国和南非的差接近 0。逐国检验见补充表 1 和补充表 2。
层数上的性别差再对上 2017 年性别不平等指数(Gender Inequality Index,GII)。GII 衡量的是性别不平等造成的潜在人类发展损失所占的百分比。每个点是一个国家。Spearman ρ=0.69,P<10⁻⁶。图上的虚线是 β=0.55 的幂律参照,点在线的两侧散得开。这是国家层面的相关:GII 高的国家,男女层数分布往往差得更大。它不表示某一个人的层数由这个指数决定,也不能从四个橙色国家推广成所有高 GII 国家的形状都一样。
容器直径是另一项。正文说 53 个国家中有 48 个,女性的容器更小(P≤0.05),与已有的城市移动性别差异研究同向。其余 5 个国家没有被写成男性容器更小。逐国直径见补充说明 2。
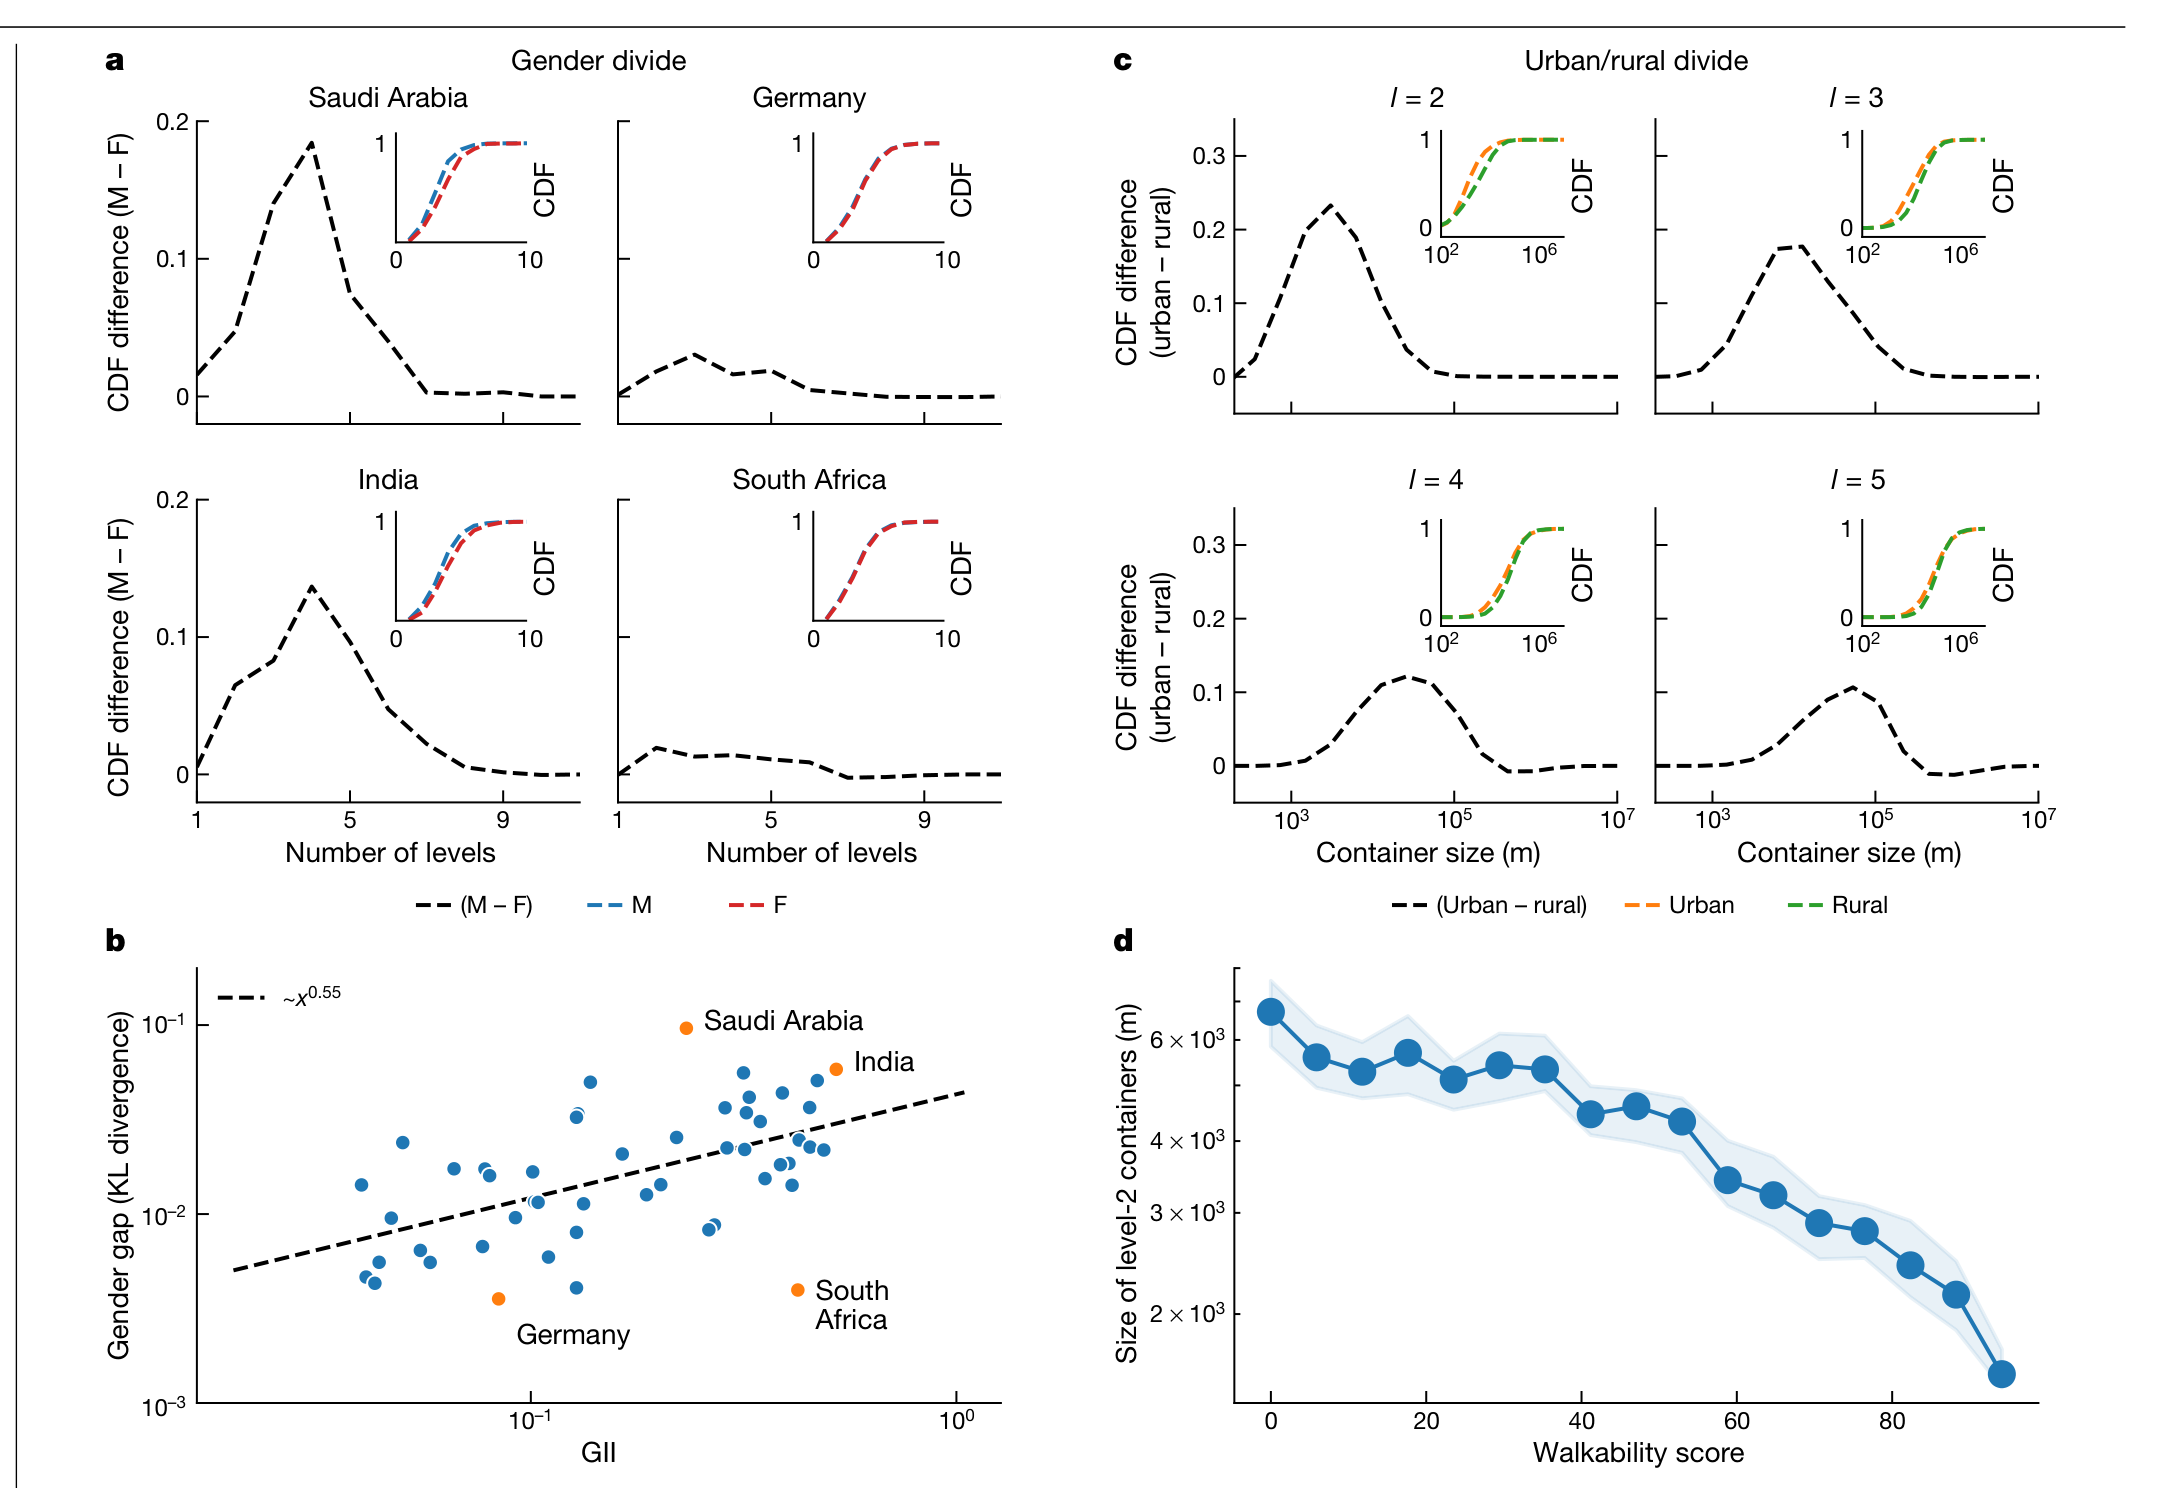
图 3|尺度的差别,怎样随着性别、城乡和步行环境变化?
(a)层数的累积分布差,男性减女性。左列沙特阿拉伯和印度差得大,右列德国和南非接近 0。插图蓝线为男性,红线为女性。横轴层数大约从 1 到 9。(b)纵轴是男女层数分布的 KL 散度,横轴是 GII,一点一国。橙色四点对应(a)。虚线为 x^0.55。相关为正,但同样的 GII 上各国散度可以差一个数量级。(c)容器直径的累积分布,城镇减乡村。第 2–5 层都画出。插图橙色为城镇,绿色为乡村;绿线在橙线右侧,表示乡村直径更大。黑线的正差在第 2 层最高,到第 5 层变小。(d)第 2 层容器直径对家附近的步行指数。点总体下降,阴影是每个步行指数上抽取 500 个样本得到的 50% 四分位区间。纵轴刻度包括 2×10³、3×10³、4×10³ 和 6×10³ 米。来源:原论文 Fig. 3。
城乡使用全球人类住区网格。原始分类有城市、城镇和乡村;分析时把城镇和城市并成一类,再和乡村比。因此图 3c 的城镇一侧包含城镇和城市,不是只含大城市建成区。乡村容器显著更大(P≤0.05),差异在最低的层级更明显,与图 3c 里第 2 层差幅最大的读法一致。更细的检验见补充表 3。乡村更大,和第 2 层中位数 3.1 千米可以同时成立:那是全体 D1 的中位数,乡村是其中一组,而且变异系数大约为 3。
步行指数只覆盖能取到 Walk Score 的 11,511 人,国家是新西兰、澳大利亚、加拿大和美国,不是 D1 的全体。家附近步行指数与第 2 层直径的 Spearman ρ=−0.96,P<10⁻⁹。正文说这种负相关一直到第 3 层仍然显著(P 远小于 0.01),分层系数见补充说明 2。图 3d 的阴影是抽样波动,不是每个人的直径。ρ=−0.96 描述的是图上这些步行指数位置的总体关系,不是“步行指数每高 1 分,直径减少多少米”。
这些尺度能说到哪一步?
容器是轨迹的统计分区。一个人住在两个行政区交界处,模型仍可以绕着停留点切出一个容器,这个容器不必和第几街区的官方边界重合。图 1a 把四层叫成邻里、城市、城市群和区域,是哥本哈根这一个例子的叫法,不能把第 2 层一律叫成邻里、把第 5 层一律叫成省份。
对数正态优于截断幂律,说明“完全没有特征尺度”不如“有一个很宽的中心”。变异系数约 3,所以特征尺度不能写成通勤半径的上限。模型生成的轨迹在 9,000 人、每人 50 步的留出比较里优于 EPR,这项优势是预测分布的似然,不是证明人先选择层级、再选择目的地。熵差的图尤其说明:赢过 EPR,仍然可以和数据的峰位置不一样。
性别、GII、城乡和步行指数都是观察到的伴随差异。用户来自一家公司的应用,性别和年龄自报,国家人数极不均匀,D2 又是一所大学的学生。运动状态触发的定位会漏掉静止时段里的细小移动。家用吸引度最大来定义,没有和夜间居住地核对。交通网络、探索新地点和时间节律都还在模型外面。
一句话总结
日常移动不是没有尺度,而是嵌在直径有中心、但人与人差得很开的几层容器里;把容器内的短位移和容器之间的长位移加在一起,才会看起来像一条没有典型距离的幂律。
核心来源
Alessandretti L.、Aslak U.、Lehmann S.,The scales of human mobility,Nature,587:402–407,2020。https://doi.org/10.1038/s41586-020-2909-1。派生数据:https://doi.org/10.11583/DTU.12941993.v1。代码:https://github.com/lalessan/scales_human_mobility/。D1 原始轨迹因隐私不公开;D2 原始轨迹只在哥本哈根、签署保密协议并接受监督的条件下申请。
无标度位移的代表工作是 González、Hidalgo 与 Barabási,Understanding individual human mobility patterns,Nature,2008。EPR 模型来自 Song、Koren、Wang 与 Barabási,Modelling the scaling properties of human mobility,Nature Physics,2010。文中 β 通常介于 1 和 2 的说法,引用 Alessandretti、Sapiezynski、Lehmann 与 Baronchelli 在 PLOS ONE 2017 年的多尺度分析。
Laura Alessandretti 的论文署名为丹麦技术大学计算系,以及哥本哈根大学哥本哈根社会数据科学中心。她与 Ulf Aslak 同等贡献。三人一起设计研究和模型;分析和程序实现由她与 Aslak 完成。哥本哈根大学社会学院 2020 年的报道称她当时为助理教授,工作是用移动轨迹估计与邻里、城市、国家相对应的地理尺度。
Ulf Aslak 的署名机构与 Alessandretti 相同,同等贡献,并与她一起完成分析和实现。丹麦技术大学与哥本哈根大学 2020 年的报道称他当时为博士后。本文停留点使用他与 Alessandretti 提出的 Infostop 算法。
Sune Lehmann 是通讯作者(sljo@dtu.dk),署名机构相同。他参与设计、结果分析和写作;贡献说明没有把程序实现记在他名下。丹麦技术大学与哥本哈根大学 2020 年的报道称他为两校教授。他在报道中把这项工作说成:用轨迹把自然科学里的移动模型,和地理学里的尺度概念接起来。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果疫情或客流模拟把所有位移抽成一条幂律,3 千米量级的容器内往返和 160 千米量级的跨层移动会被当成同一种步长,只是一个长、一个短。容器模型把“这次跨哪一层”和“在这一层选哪个目的地”分开,短距离可以反复出现在低层,长距离只在高层转移发生时出现。这篇论文没有把容器接到传播模型上,所以这只是对生成过程的推论。真要用于城市封控,还得补上模型故意没写的交通网络:层级距离在概率上说得通,不表示两点之间有车或有航班。
步行指数和第 2 层直径的 ρ=−0.96 很容易被读成“把街道改得更好走,邻里就会缩到 2 千米”。样本只是四个国家的 11,511 名能查到 Walk Score 的用户,图上的阴影来自 500 次抽样,而且第 2 层变异系数约 3。同一步行指数下,人与人的直径仍然可以差很多。论文没有街道改造前后的对比。乡村容器更大,也同向于“可达的目的地更稀,活动范围更大”,但网格上的乡村定义并没有测量公交和商店,这个机制同样还没被这篇数据分开。
女性一侧更值得分开看的是两句并不自动相容的话:21 个国家里层数更多,48 个国家里容器更小。层数更多不一定是走得更远,也可能是在若干更小的容器之间切换。论文没有报告各层的转移次数,因此这条读法还不能从 21/53 和 48/53 里直接推出来。国家层面的 GII 相关是 ρ=0.69,点很散。自报性别、谁更常带着这部手机,都会进到同一批轨迹里。要把容器直径写成性别不平等的后果,需要个人层面的纵向比较,而不是再把这张散点拟合一次。