记录最多的基站,就是家吗?
论文名片|Luca Pappalardo、Leo Ferres、Manuel Sacasa、Ciro Cattuto、Loreto Bravo,Evaluation of home detection algorithms on mobile phone data using individual-level ground truth,EPJ Data Science,2021,10:29。2020年11月5日收稿,2021年5月12日接收,2021年6月2日在线发表。DOI:10.1140/epjds/s13688-021-00284-9。这是一篇有个体住址真值的方法评估。
下班以后,手机可能整晚不再拨出电话,却仍会自动收取邮件;周末它又可能在另一个地方响个不停。只数通话,活动最多的基站会偏向周末那一头;改数夜里的自动联网,基站又会换一个。这段对照用来看清记录类型为什么会把“家”指到不同地方,不是论文里某位参与者的真实行程。
在 65 名写明住址、并同意调取历史记录的智利 Telefónica 员工身上,扩展详单配合工作日夜间的记录,比常见的通话规则更常落到住址附近。表中最高的一档是 0.69,分母是这 65 人;这里的“对”指检测基站属于住址的三个最近基站之一。通话记录更稀,也更不稳定。事件最多的控制面记录,并没有超过扩展详单。
先说结论
- 主文比较的 13 种规则,两两选出同一基站的平均比例是:扩展详单 44.37%,控制面 38.88%,通话详单 35.25%。分母是 65 人,再对规则配对取平均。即便最一致的扩展详单,平均也有超过一半的人无法对齐。
- 以三个最近基站之一为判对,13 种规则的平均准确率是扩展详单 0.50、控制面 0.47、通话详单 0.33。图上前五名的平均是 0.65、0.61、0.43。最高组合是扩展详单上的工作日 19:00–7:00,准确率 0.69。只认离住址最近的那一个基站时,同一组合降到 0.45。
- 通话详单的最高值出现在周末全天,0.51;它的工作日夜间是 0.37。工作日白天被作者当作对照,扩展详单上的 7:00–19:00 只有 0.15,正文另给出 9:00–19:00 的 0.11。
- 把判错的人也算进距离后,三组数据里各自距离最短的五个规则,平均距离标为 4.7 公里、3.0 公里和 2.5 公里。工作日夜间有 1 人被指到约 100 公里外,所以它的平均距离长于“不同日期数最多”。只平均判对的人时,前五名的平均距离约为 0.5 公里和 0.4 公里。
- 每人随机抽走一部分记录、重复 5 次:通话详单上的周末全天规则,至少保留 50% 的记录,准确率才接近用完全部记录时的 0.51。扩展详单和控制面在更少记录、更少天数时仍更高、也更稳。正文没有列出每个抽样比例的准确率。
没有个人住址时,家是怎样被指定的?
人口、通勤、迁居和疫情模型都要把一部手机安到一个住处,才能和普查或行政单元对上。文献里的家位置识别算法(home detection algorithm)大多是经验规则:哪里通话最多,哪里就是家;或者只数夜里的通话。这些规则被用进很多城市研究,却很少能对照到“这个人实际住在哪”。运营商出于隐私,通常不会交出个人住址。Vanhoof 等人曾把每个基站上被判为家的人数和普查人口比较,能发现某个基站的人数是否离谱,不能判断同一个人有没有指对。他们因此呼吁用已知住址做个体评估。
另一层缺口来自记录本身。通话详单(Call Detail Records,CDR)只在拨出或接听电话时留下位置。两次电话之间可以隔很久,夜里不打电话的人,家就从这种记录里消失。扩展详单(eXtended Detail Records,XDR)混合了人的主动上网和手机的自动下载,例如自动收取邮件。控制面记录(Control Plane Records,CPR)由网络触发,例如把手机切到新基站,或手机重新激活。三种记录看到的是同一批基站位置,时间密度差很多。这篇论文问的是:在住址已知时,哪种记录配哪种规则,更能把家放到住址附近的基站。
65 个已知住址,三种记录各有多密?
参与者是智利 Telefónica 的员工,从数千名员工中同意参加的 65 人。他们提供圣地亚哥的住址,并同意调取 2019 年 9 月 24 日至 10 月 6 日这 14 天已经产生的历史记录。论文用 Google Maps 把住址换成经纬度。作者没有发放手机或 SIM 卡,也没有收集性别、年龄或其他人口属性。因为同意发生在记录产生之后,这 14 天的人并不知道自己随后会被纳入研究。样本仍是一家公司的在职员工,作息集中在白天上班。
数据集有 1,663 个天线位置。一个位置可以是多天线的塔,也可以是室内的单根天线;后文按论文的简化,统称基站。两周合计 19,234 条通话详单、43,607 条扩展详单、772,871 条控制面记录。把这三笔总数除以 65,大约是每人 296 条、671 条和 11,890 条。这只是算术平均。控制面缺了 10 月 5 日,实际只有 13 天;通话在很多小时里接近于没有人出现。
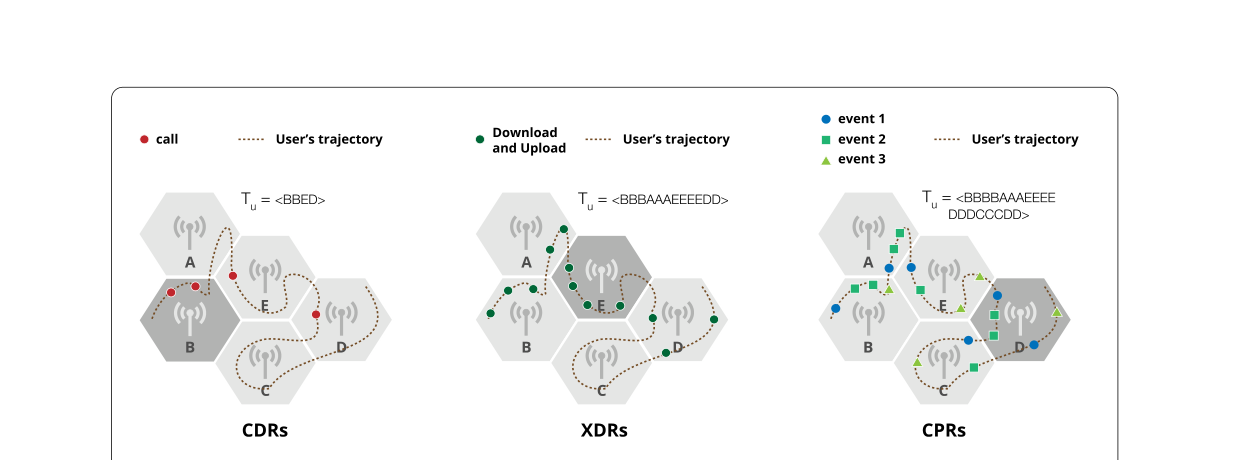
图 1|同一次移动,三种记录会把活动最多的基站标在不同格子上吗?
这是示意图,三个面板没有子图字母,分别标为 CDRs、XDRs、CPRs。虚线是事先画好的行程,从左向右经过同一组六边形基站。红点是通话,绿点是上传或下载,蓝点、绿方块和绿三角是三类网络事件。深色格子是该面板里记录最多的基站。通话的点最少,扩展详单增多,控制面几乎点亮沿途基站,三个面板的深色格子不在同一处。图上的字母串只属于这张示意图。来源:原论文 Fig. 1。
住址附近的基站也不等于手机在家时实际连上的基站。市中心基站密,运营商会在一天中的不同时刻关闭部分天线,或在拥塞时把用户改接到别处。天线朝向也可能背对住处,更远的一座塔反而对着家。因此论文对每个住址用 k 近邻取出三个最近基站,k 等于 3。检测结果落在这三个基站中的任何一个,这一人就算判对。准确率是判对人数除以 65。另一个也叫 k 的量出现在后面:它是算法按活动排出的前 k 名基站,和这里的三个最近基站不是同一个 k。
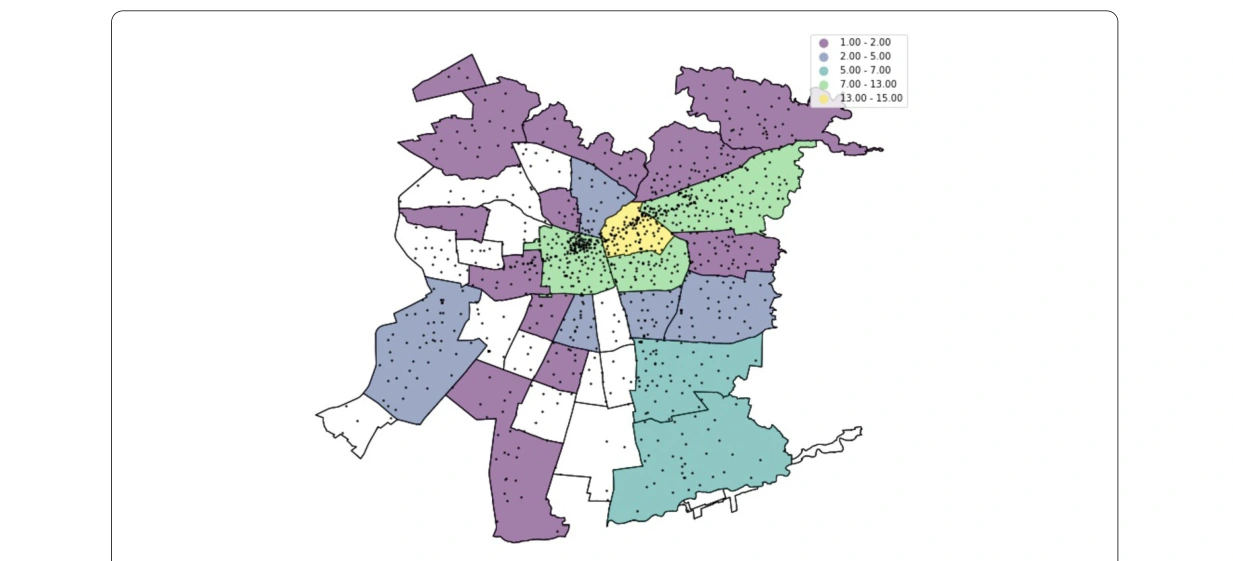
图 2|这 65 个住址和 1,663 个基站,落在圣地亚哥的什么格局里?
黑点是基站,黑线是市辖区(comuna)边界。图注写明,基站在需求高的地方更密,地图中部一条基站带落在较富裕的金融类市辖区。色块图例分五档:1.00–2.00、2.00–5.00、5.00–7.00、7.00–13.00、13.00–15.00。图例没有写出单位,图注也没有说明留白市辖区代表什么,所以这里不把颜色读成收入或天线数量。图题说的是基站位置,以及 65 名用户出现在圣地亚哥最大的建成区里。来源:原论文 Fig. 2。
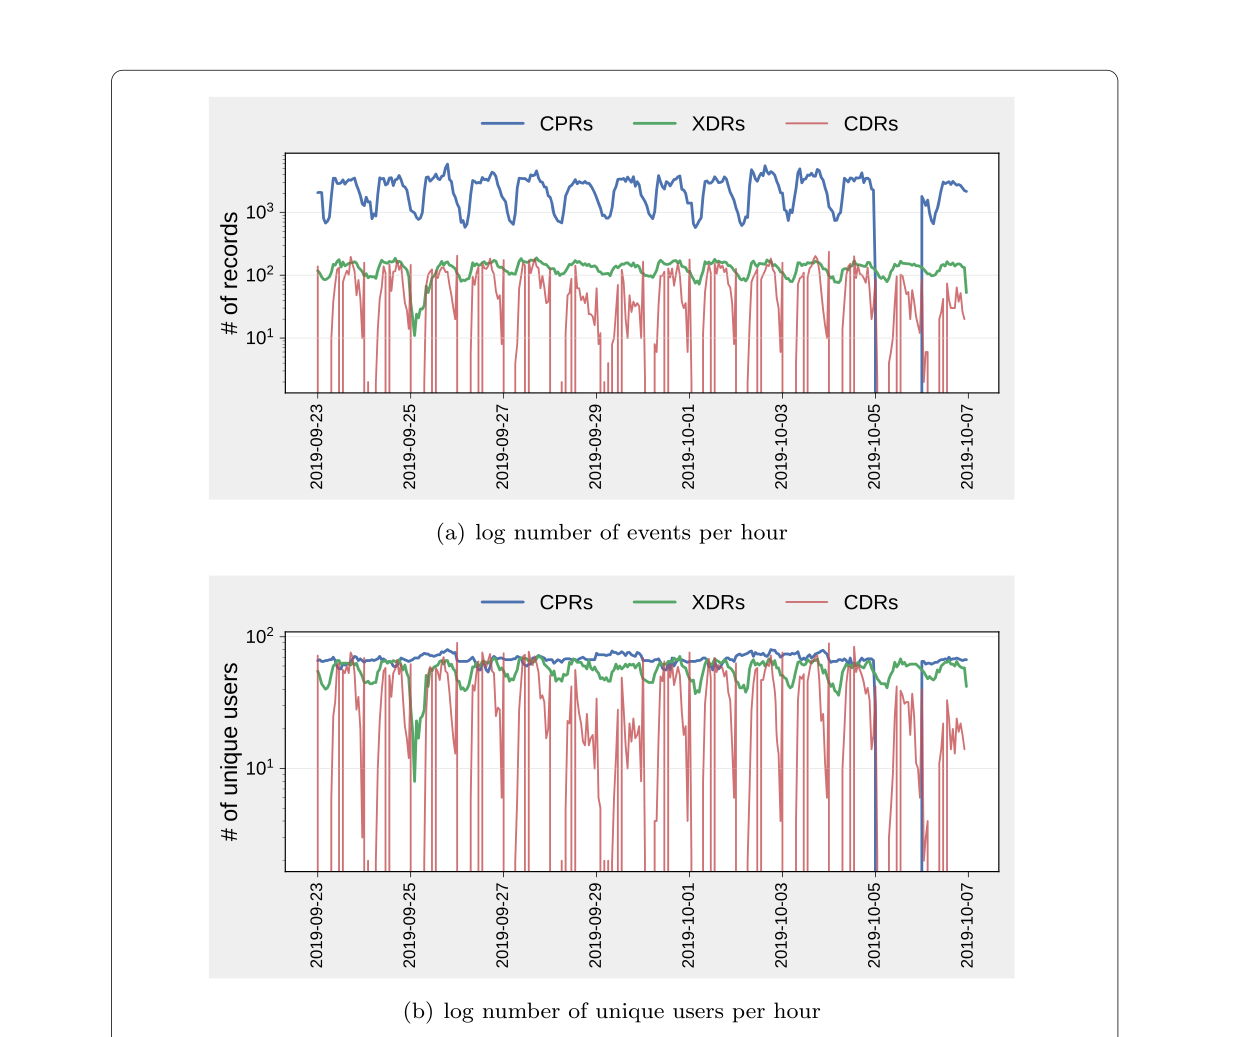
图 3|两周里,三种记录每小时差多少?
(a)纵轴是每小时记录数的对数,刻度从 10¹ 到 10³。蓝线控制面大多贴着 10³ 上下,绿线扩展详单大多在 10² 附近,红线通话在接近底部和 10² 之间大幅摆动。10 月 5 日控制面掉到图的底部,对应这一天没有入库。扩展详单在 9 月 25 日前后也有一次落到 10¹ 附近的低谷,图上没有标出精确条数。(b)纵轴是每小时至少有一条记录的人数,对数刻度标出 10¹ 和 10²。控制面和扩展详单多数时间停在靠近样本上限的位置,通话则反复掉向底部。来源:原论文 Fig. 3。
论文写明,活动表按 37 种规则汇总,共 555,771 行。主文的定义表和准确率表呈现其中 13 种。时间窗考察了四段夜间和四段白天:19–7、19–9、21–7、21–9,以及 9–21、9–19、7–19、7–21。主图只展开 19:00–7:00 和 7:00–19:00。作者说具体起止对结果影响不大,检验放在补充材料,主文没有给出统计量。
13 种规则都是在给每个基站算一个活动量,再取活动最高的基站。比较的口径是:全部记录数(MA),只保留工作日(MA-WK)或周末(MA-WE),把 1 公里内各基站的活动加到中心基站(MA-R),有记录的不同日期数(DD),夜间或白天的记录数(TC-19-7、TC-7-19),以及这些时间窗再限制到工作日、周末或 1 公里范围。工作日是周一到周五,周末是周六和周日。并列时,论文改选全体用户活动总和更低的基站;仍并列则随机。1 公里规则产生的并列最多,通话详单比另两种记录更常并列;并列次数在补充材料里,主文没有写出次数。
两种规则会把家指到同一个基站吗?
准确率之前,先看两条规则会不会选出同一个基站。简单匹配系数(Simple Matching Coefficient,SMC)是两种规则对同一人选出同一基站的人数,除以 65,再写成百分比。它只描述规则之间的一致程度。
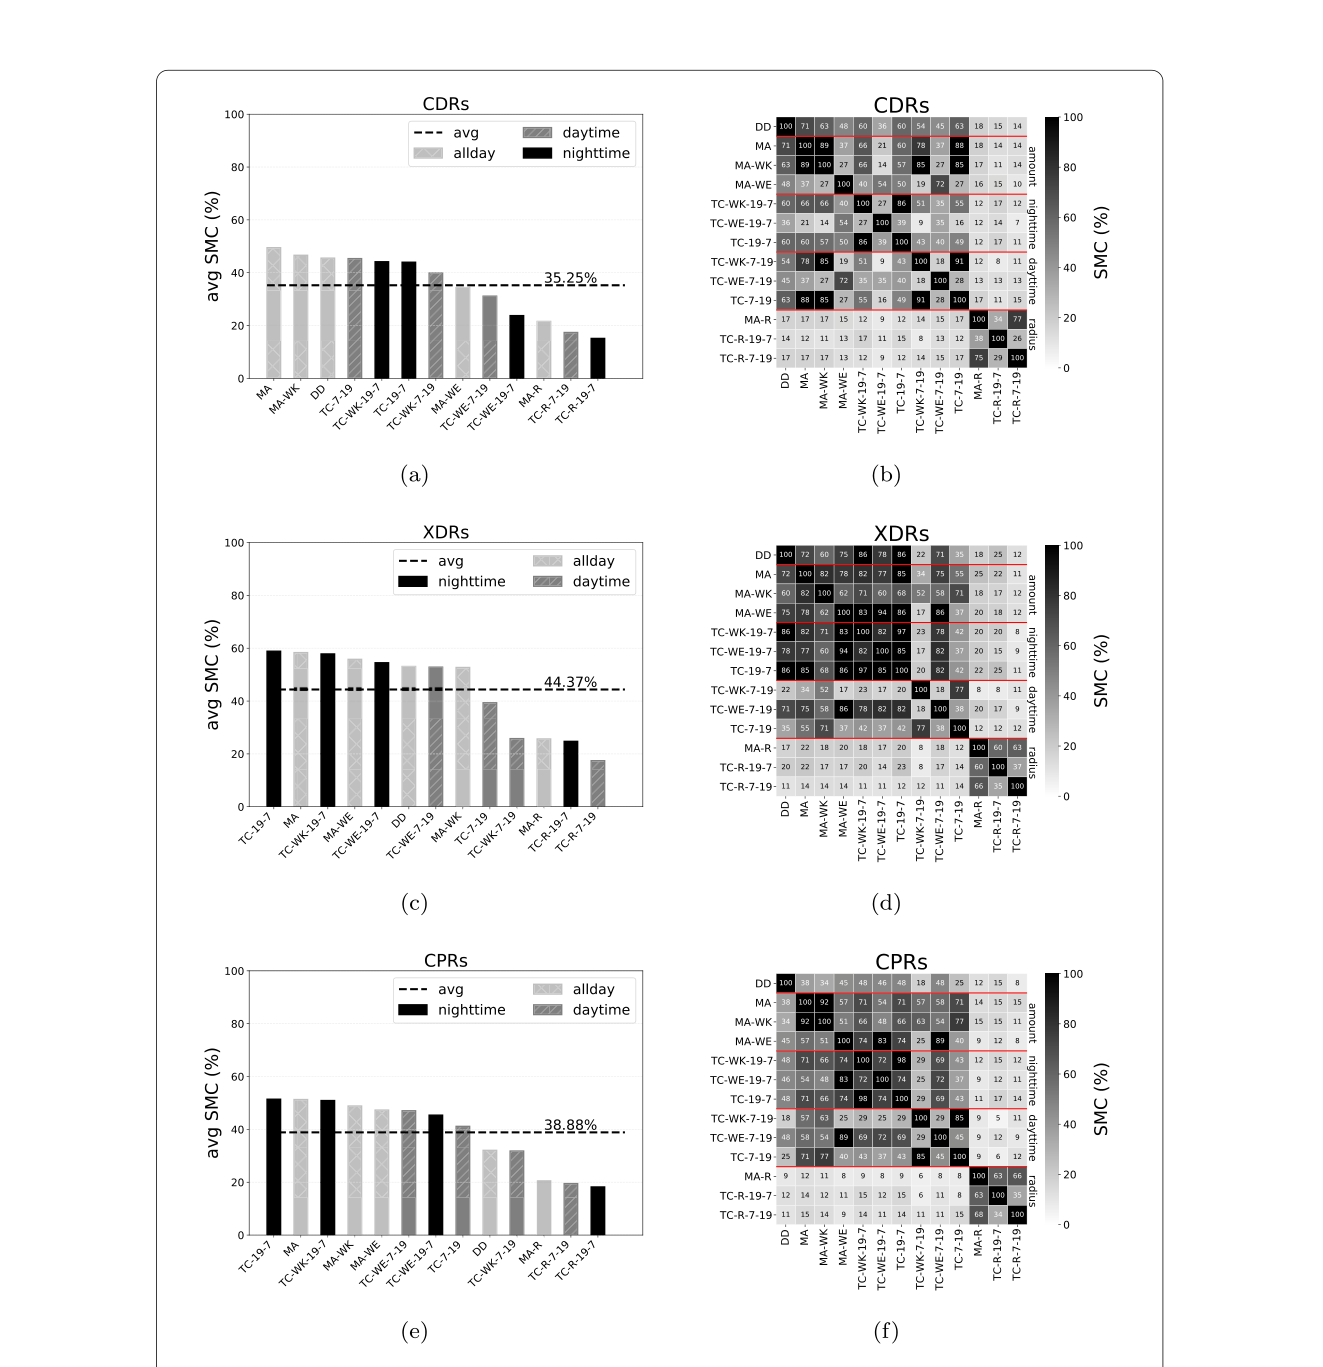
图 4|换一条规则,家会改到另一个基站吗?
(a、c、e)分别是通话、扩展详单和控制面。纵轴是每条规则与其他规则的平均 SMC,虚线是该数据内全部配对的平均:35.25%、44.37%、38.88%。浅灰是全天,黑色是夜间,斜线是白天。通话里平均一致率最高的是全部记录数 MA;扩展详单和控制面里最高的是夜间 TC-19-7。1 公里规则排在每组的右侧,平均一致率最低。(b、d、f)是两两 SMC 的矩阵,颜色越深越高,对角为 100%。1 公里规则彼此较深,和夜间、全天规则分成一块。来源:原论文 Fig. 4。
扩展详单的平均一致率最高,所以换一条常见规则,结果相对不那么容易翻脸。44.37% 仍表示平均下来,65 人里有超过一半对不上。文献若继续用通话详单,又各用各的规则,家的位置很难横向比较。
判对,指的是三个最近基站之一
下表来自论文表 4。每一格都是判对人数除以 65,保留两位小数。左三列里,检测基站属于三个最近基站之一即判对。右三列把标准收紧为必须就是最近的那一个基站。
| 规则 | 通话,三个最近 | 扩展详单,三个最近 | 控制面,三个最近 | 通话,仅最近一个 | 扩展详单,仅最近一个 | 控制面,仅最近一个 |
|---|---|---|---|---|---|---|
| 不同日期数 DD | 0.40 | 0.66 | 0.63 | 0.22 | 0.40 | 0.35 |
| 全部记录 MA | 0.26 | 0.57 | 0.49 | 0.15 | 0.34 | 0.25 |
| 1 公里加总 MA-R | 0.31 | 0.38 | 0.35 | 0.15 | 0.20 | 0.09 |
| 周末全天 MA-WE | 0.51 | 0.62 | 0.54 | 0.25 | 0.35 | 0.28 |
| 工作日全天 MA-WK | 0.22 | 0.52 | 0.48 | 0.12 | 0.31 | 0.25 |
| 夜间 TC-19-7 | 0.42 | 0.68 | 0.65 | 0.25 | 0.43 | 0.40 |
| 白天 TC-7-19 | 0.22 | 0.31 | 0.34 | 0.12 | 0.18 | 0.17 |
| 夜间加 1 公里 TC-R-19-7 | 0.31 | 0.43 | 0.38 | 0.11 | 0.22 | 0.11 |
| 白天加 1 公里 TC-R-7-19 | 0.29 | 0.32 | 0.28 | 0.14 | 0.15 | 0.12 |
| 周末夜间 TC-WE-19-7 | 0.42 | 0.60 | 0.54 | 0.20 | 0.34 | 0.32 |
| 周末白天 TC-WE-7-19 | 0.40 | 0.58 | 0.58 | 0.25 | 0.34 | 0.31 |
| 工作日夜间 TC-WK-19-7 | 0.37 | 0.69 | 0.66 | 0.23 | 0.45 | 0.42 |
| 工作日白天 TC-WK-7-19 | 0.17 | 0.15 | 0.23 | 0.09 | 0.09 | 0.11 |
| 13 种平均 | 0.33 | 0.50 | 0.47 | 0.18 | 0.29 | 0.24 |
扩展详单在 13 种平均和最高值上都领先。控制面有 772,871 条,扩展详单有 43,607 条,前者约为后者的 17.7 倍。三个最近基站口径的平均准确率是控制面 0.47、扩展详单 0.50,最高值是 0.66 与 0.69。更密的网络事件包含路过和切换,住址信号会被路上的基站稀释。扩展详单介于主动使用和自动联网之间,在这组员工里更贴近住处。
通话详单的最高值是周末全天 MA-WE 的 0.51,同一数据上的工作日夜间是 0.37。通话要有人拨打或接听。这组白天上班的人,周末留下的电话更多。把通话上的最优规则 MA-WE 用到扩展详单,表中是 0.62,低于扩展详单自己的最高值 0.69。把扩展详单上的最优规则 TC-WK-19-7 用到通话,表中是 0.37,低于通话自己的最高值 0.51。
1 公里加总没有带来更高的准确率。MA-R 在扩展详单上是 0.38,低于不加半径的 MA 的 0.57。把邻塔的活动算进来,会把家从住所基站挪到一片更大的热点上。工作日白天是作者设置的对照:按时上班的人,这段时间应在工作地。TC-WK-7-19 在扩展详单上是 0.15,在三列里都靠近表的底部。正文还给出主表之外的 TC-WK-9-19,也就是工作日 9:00–19:00,扩展详单准确率 0.11,并称为全部比较里最低的一档。0.11 和 0.15 说明,在这组白天上班的人里,工作日白天的规则很少命中住址附近的基站。样本没有夜班工人。
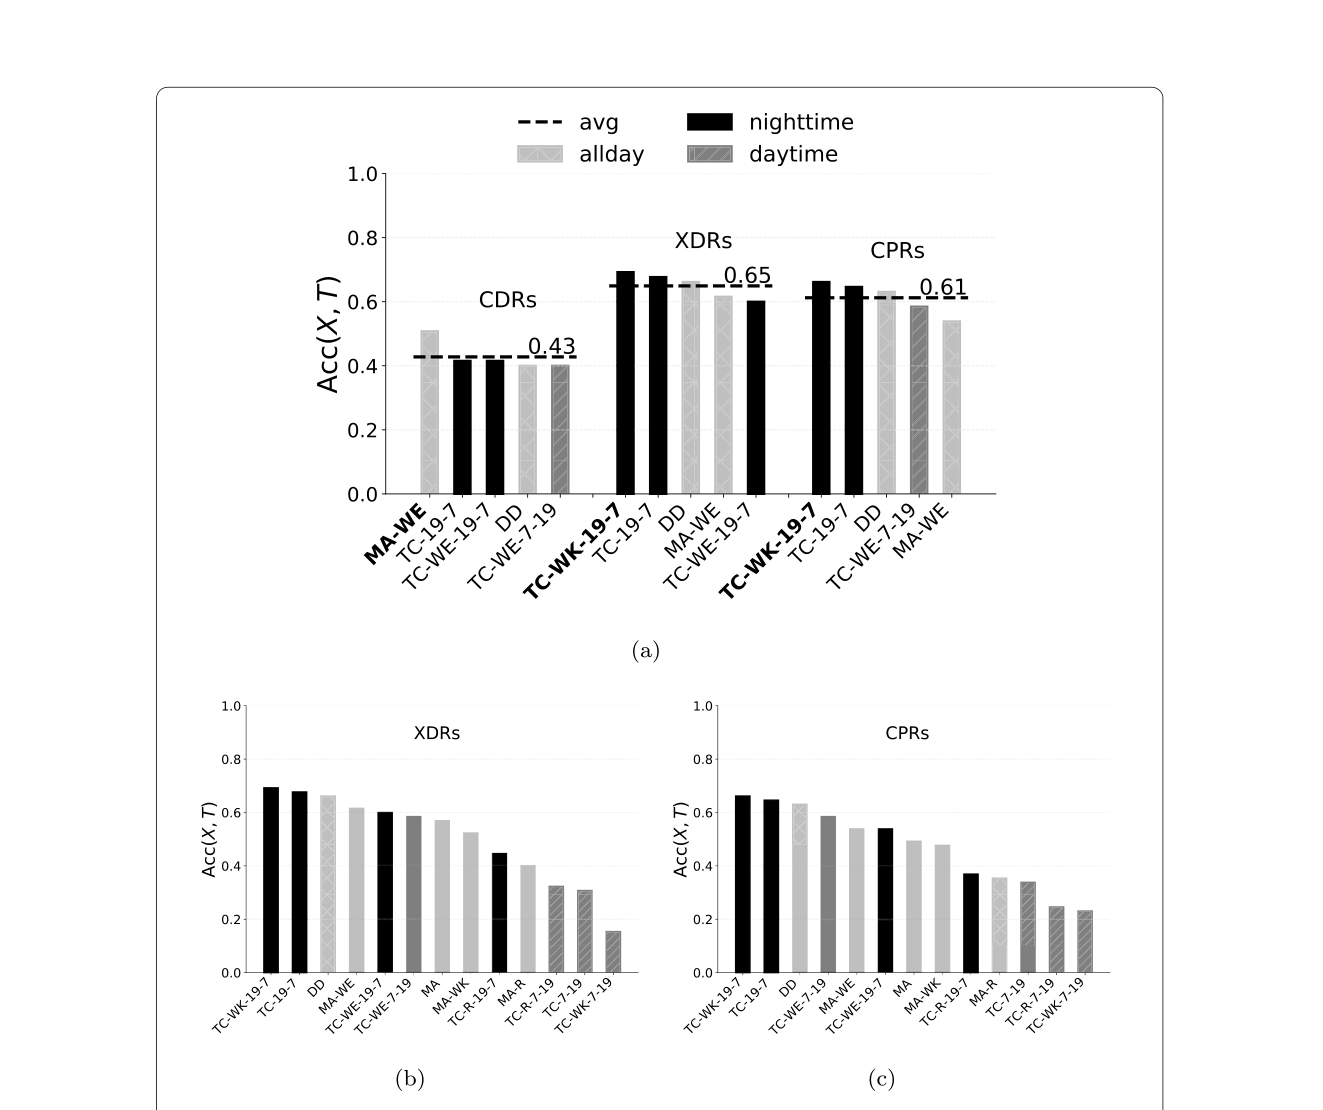
图 5|前五名和 13 种规则的准确率差多少?
(a)每种数据只画准确率最高的五条,纵轴是三个最近基站口径的准确率。黑色为夜间,浅灰为全天,斜线为白天。虚线是这五条的平均:通话 0.43、扩展详单 0.65、控制面 0.61。加粗的最高条分别是通话的周末全天 MA-WE、扩展详单和控制面的工作日夜间 TC-WK-19-7。这三条虚线高于表 4 的 13 种平均 0.33、0.50、0.47,因为图上先挑出了最好的五条。(b、c)扩展详单和控制面各 13 条,从高到低排列。左侧高条以夜间和不同日期数为主,右侧低条是白天和 1 公里规则。柱上没有逐条印出数字,读数以表 4 为准。来源:原论文 Fig. 5。
只认最近一个基站时,扩展详单上的 TC-WK-19-7 仍是表中最高,由 0.69 降到 0.45。13 种平均降到通话 0.18、扩展详单 0.29、控制面 0.24。排名的头名没有换,前五名的成员有少量进出。
还可以放宽检测端:活动最高的前 k 个基站里,只要有一个属于三个最近基站,这个人就算判对。k 等于 1 时,就是表 4 的左三列。
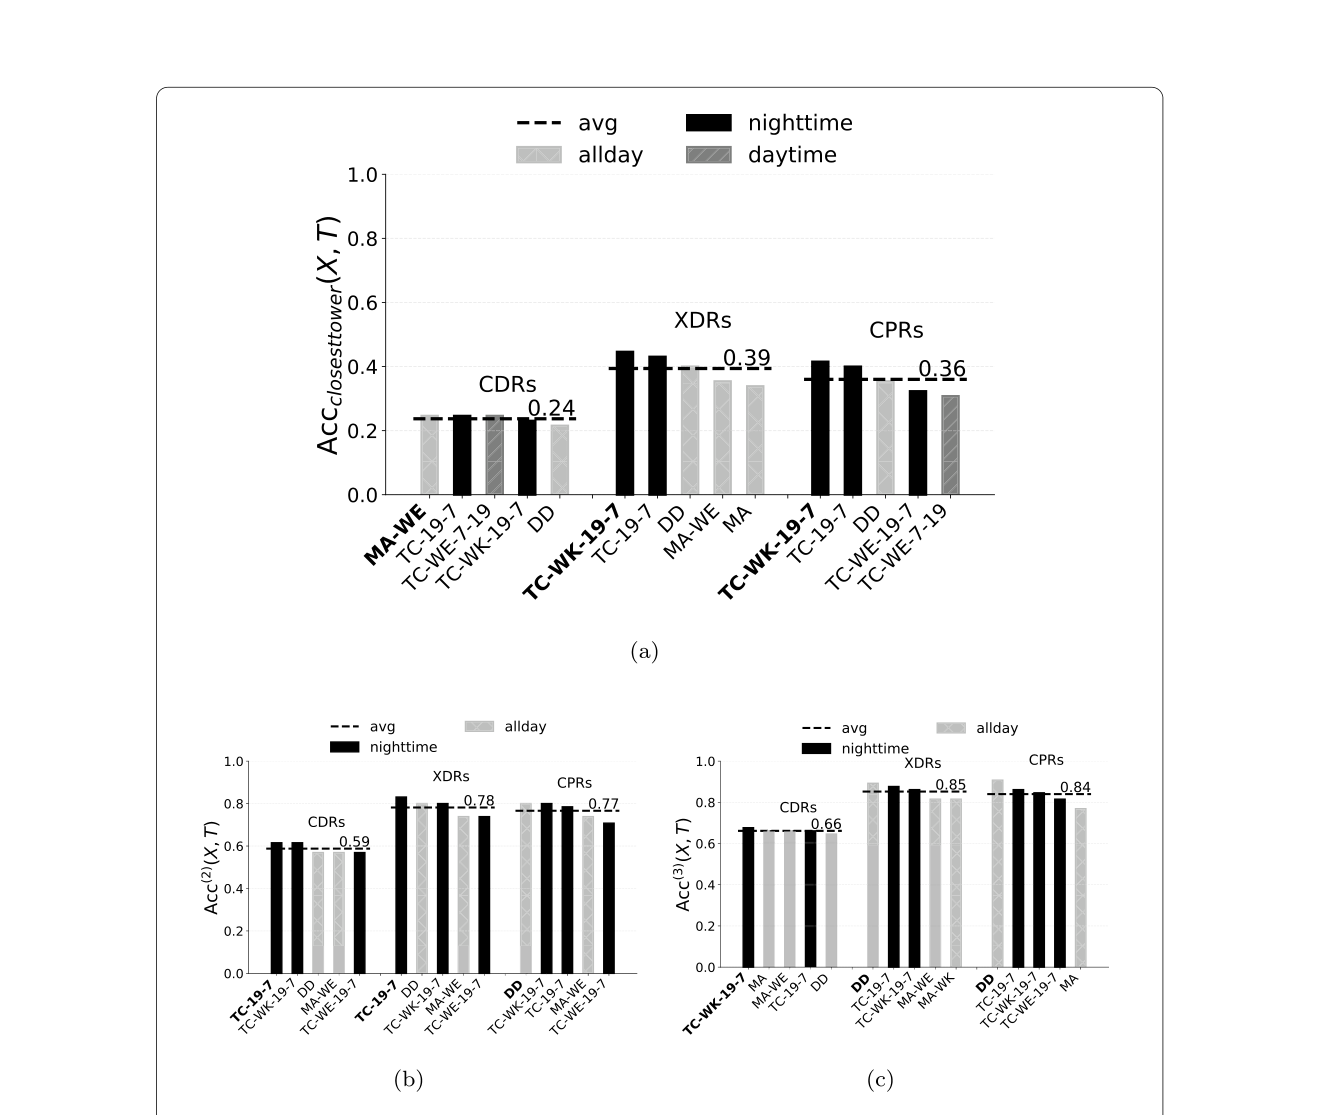
图 6|收紧到最近一个基站,或放宽到前两名、前三名,排序还在吗?
(a)判对改为必须命中最近的那一个基站,仍是每种数据的前五名。虚线平均为通话 0.24、扩展详单 0.39、控制面 0.36。头名仍是加粗的 MA-WE 与两个 TC-WK-19-7。(b)活动前两名里有一个落入三个最近基站即可。虚线平均为 0.59、0.78、0.77。扩展详单上加粗的最高条换成夜间 TC-19-7,控制面换成 DD。(c)活动前三名,虚线平均为 0.66、0.85、0.84。扩展详单和控制面的最高条都变成 DD,通话仍是 TC-WK-19-7。0.85 是扩展详单前五名在“前三个候选基站”上的平均,分母仍是 65 人;它高于“只输出一个基站就必须命中最近塔”的 0.45。来源:原论文 Fig. 6。
候选从 1 个增到 3 个,DD 在扩展详单和控制面上升到图中第一。不同日期数在只输出一个基站时让位给工作日夜间;允许三个候选之后,它更常把住址附近的基站留在名单里。虚线 0.85 是扩展详单前五名的平均,补数 0.15 是这五条平均下来仍未命中的比例,分母仍是 65。
检测基站离住址坐标有多远?
判对只问基站是否进入三个最近者。一个人可以被判对,家仍在数百米外的邻塔上;也可以被判错,而且错到城市另一头。论文对每个人计算检测基站到住址坐标的距离。
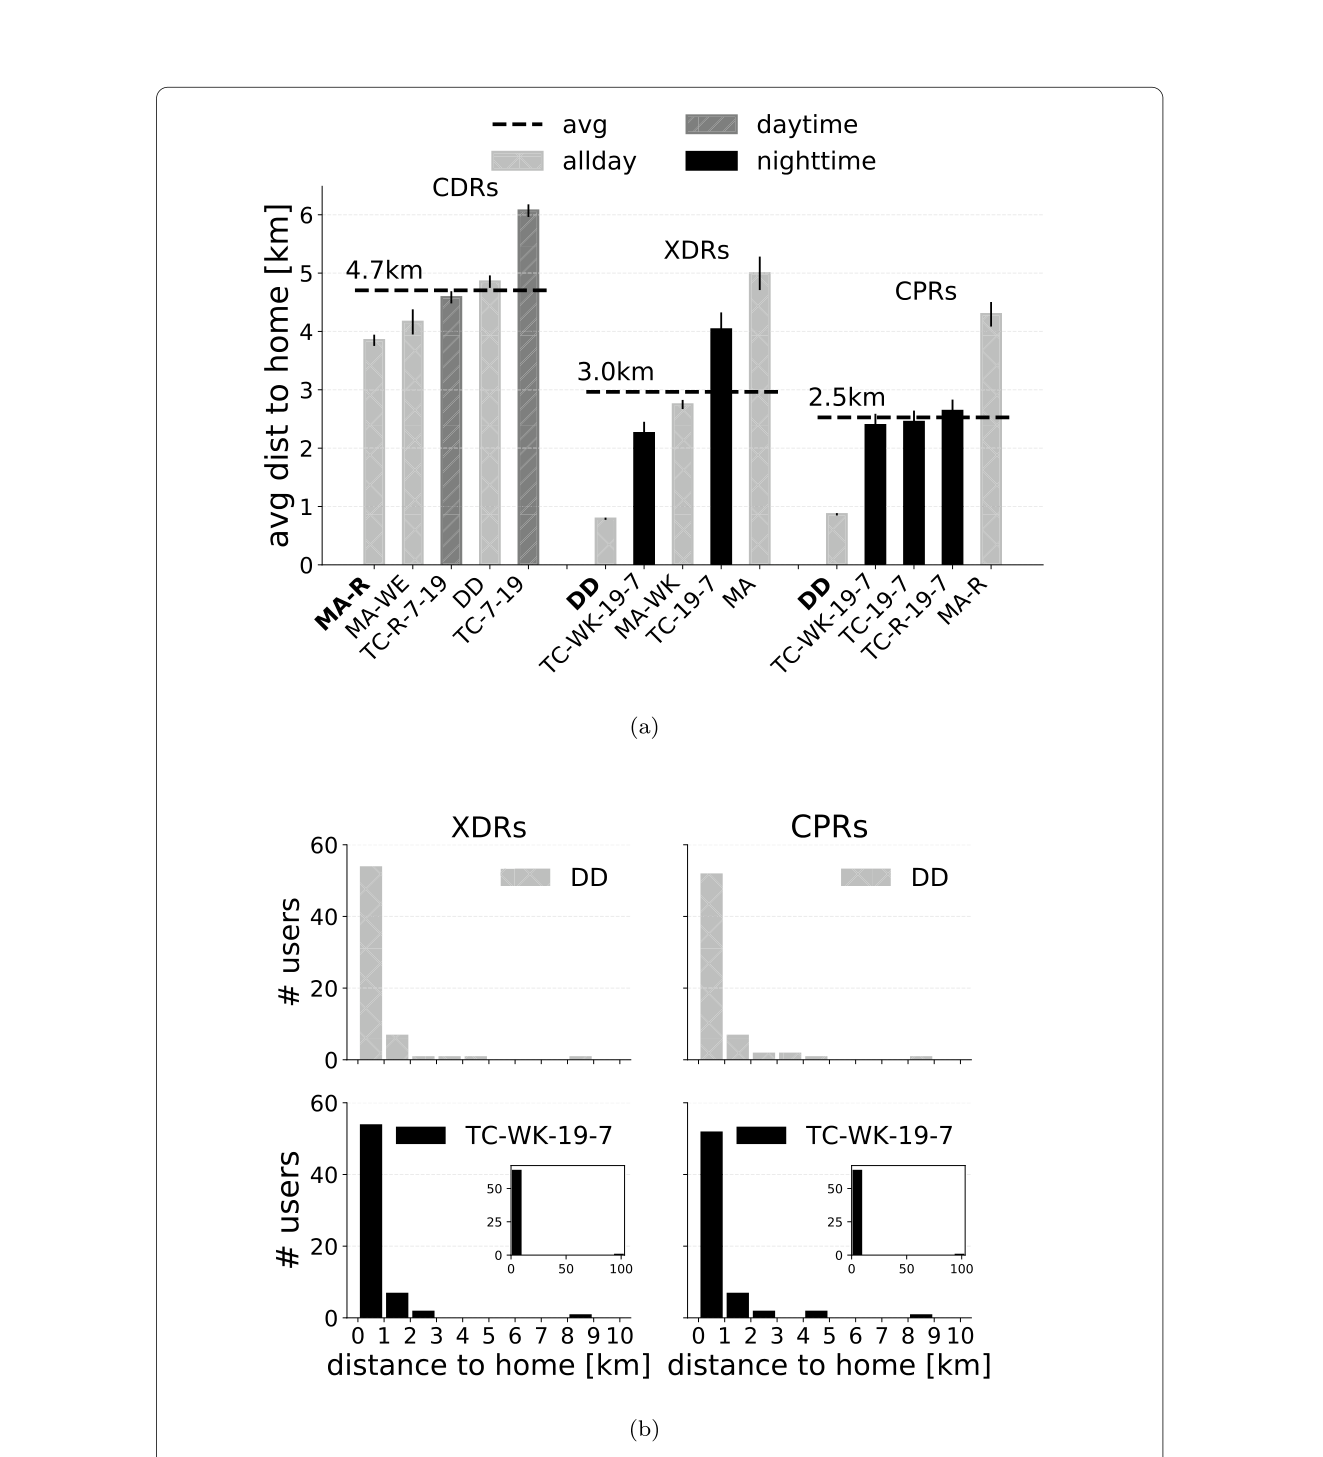
图 7|把判错的人留下,家平均离住址多远?
(a)每种数据画出平均距离最短的五个规则。纵轴单位是公里。虚线标出这五条的平均:通话 4.7 公里,扩展详单 3.0 公里,控制面 2.5 公里。浅灰为全天,黑色为夜间,斜线为白天。通话上加粗的最短条是 1 公里规则 MA-R;扩展详单和控制面上,加粗的最短条是 DD,短于同组的 TC-WK-19-7。柱顶有误差线,图注没有定义它是标准差、标准误还是区间,所以这里只用印出的三个平均数。(b)上排是 DD,下排是 TC-WK-19-7;左为扩展详单,右为控制面。横轴是到住址的距离,主图刻到 10 公里,纵轴是人数、刻到 60。大多数人堆在 0–1 公里这一档。下排插图把横轴拉到 100 公里,对应正文所说的那 1 名被 TC-WK-19-7 指到约 100 公里外的用户。这一人把 TC-WK-19-7 的平均距离拉到 DD 之上。来源:原论文 Fig. 7。
控制面的五规则平均距离最短,和它的准确率略低于扩展详单可以同时成立:控制面的错误可能更近,扩展详单则有更多人进入三个最近基站。结论段写“工作日夜间配合扩展详单同时带来最高准确率和总体最短距离”。图 7 支持最高准确率;平均距离这一项,DD 更短,原因正是那 1 个约 100 公里的点。
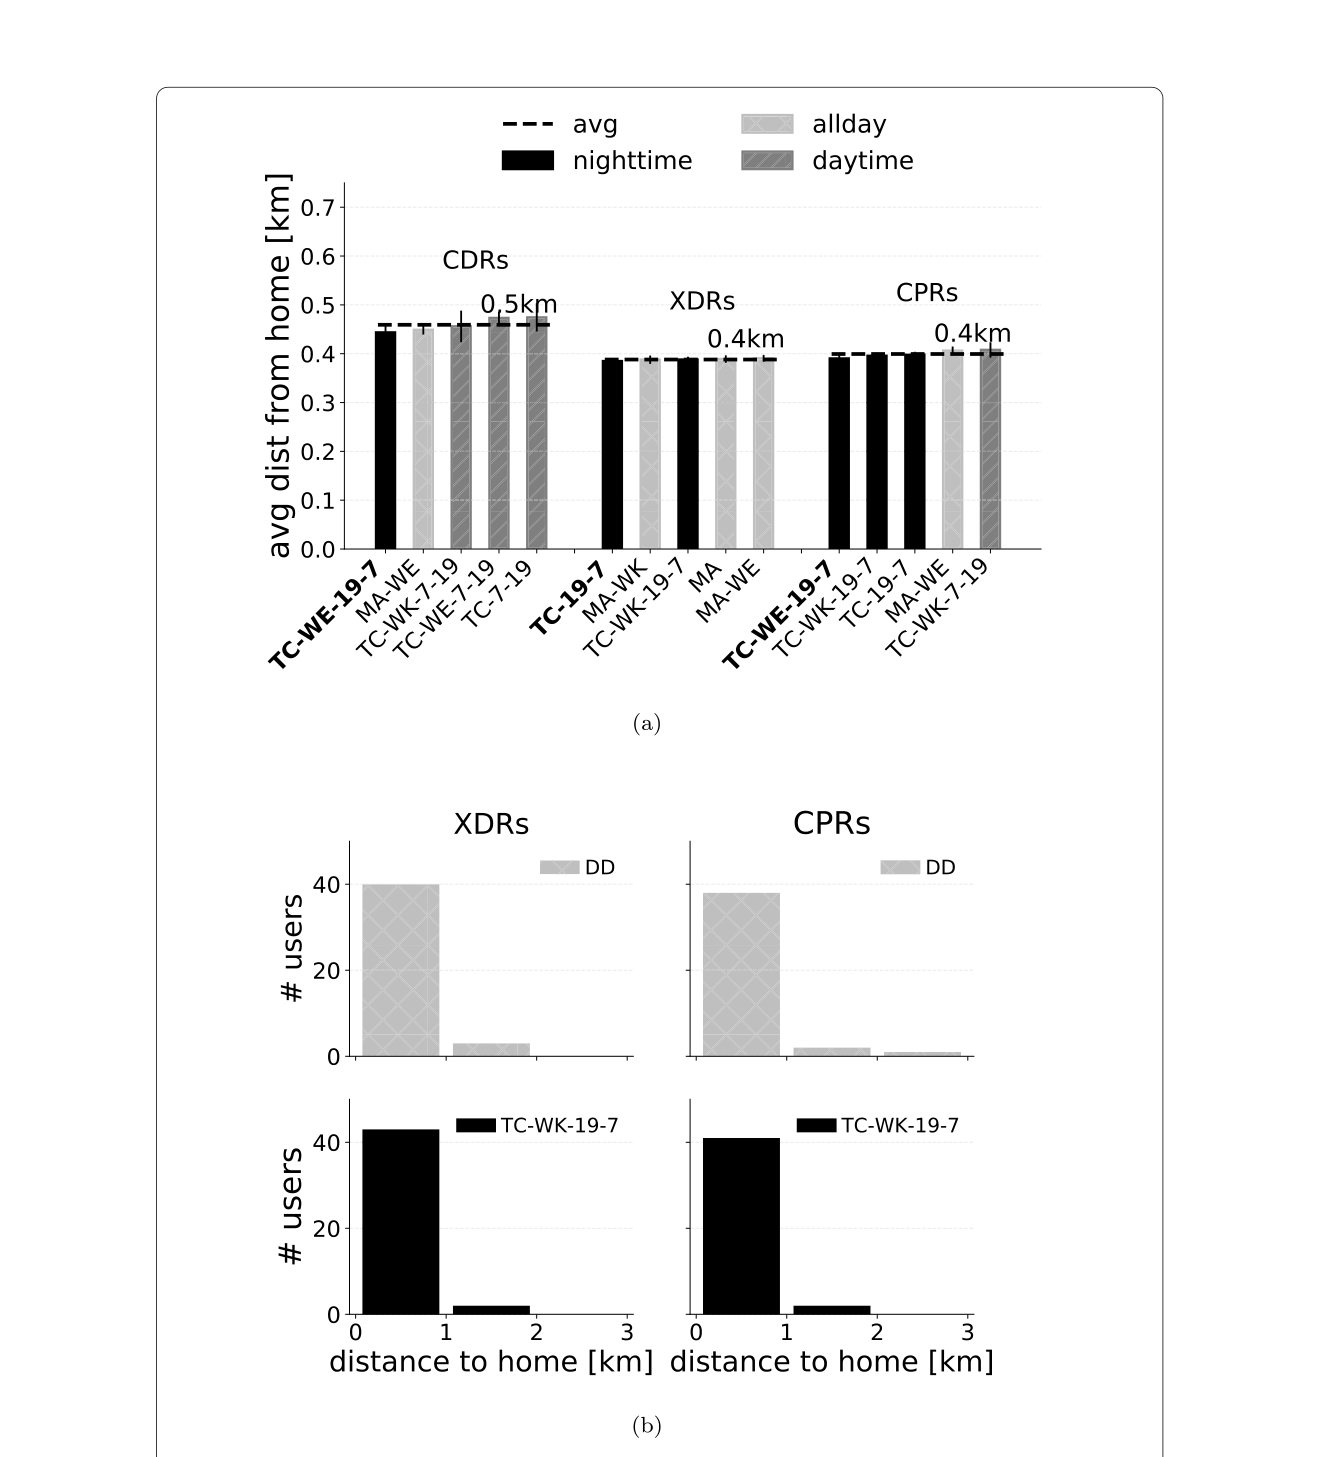
图 8|只看判对的人,剩余误差还有多大?
(a)距离只对判对的人平均,判对仍是三个最近基站之一。每种数据仍是平均距离最短的五条。虚线约为通话 0.5 公里,扩展详单 0.4 公里,控制面 0.4 公里。加粗的最短条是通话与控制面的周末夜间 TC-WE-19-7,以及扩展详单的全周夜间 TC-19-7。正文说,在这组人里 TC-WK-19-7 的平均距离低于 DD。各柱的分母是该规则自己判对的人数,论文没有逐条列出这个人数。(b)四块直方图的分法和图 7 相同,横轴改为 0–3 公里,纵轴刻到 40 人。判对之后,人主要落在 0–1 公里。来源:原论文 Fig. 8。
作者还用三个最近基站之间的平均距离去除实测距离,当作当地基站密度的代理。正文说归一化之后没有显著差别,检验在补充材料,主文没有给出统计量。因此“规则之间的距离差只是市中心基站更密造成的”这一替代解释,在主文里被作者否定,但读者无法从主文复核检验本身。
记录少一些,准确率先从哪里掉下去?
向运营商要两周全部控制面,意味着这 65 人已经产生 772,871 条记录。论文接着问:每种数据要留下多少,准确率才接近用完全部。第一个实验按人随机抽取 10%、20% 直到 100% 的记录。第二个实验随机抽取整天,从 2 天到 12 天,只用这些天里的记录。每个设置重复 5 次。图中的色带是这 5 次的标准差。比较集中在两种已经领先的规则:扩展详单和控制面用 TC-WK-19-7,通话详单用 MA-WE。
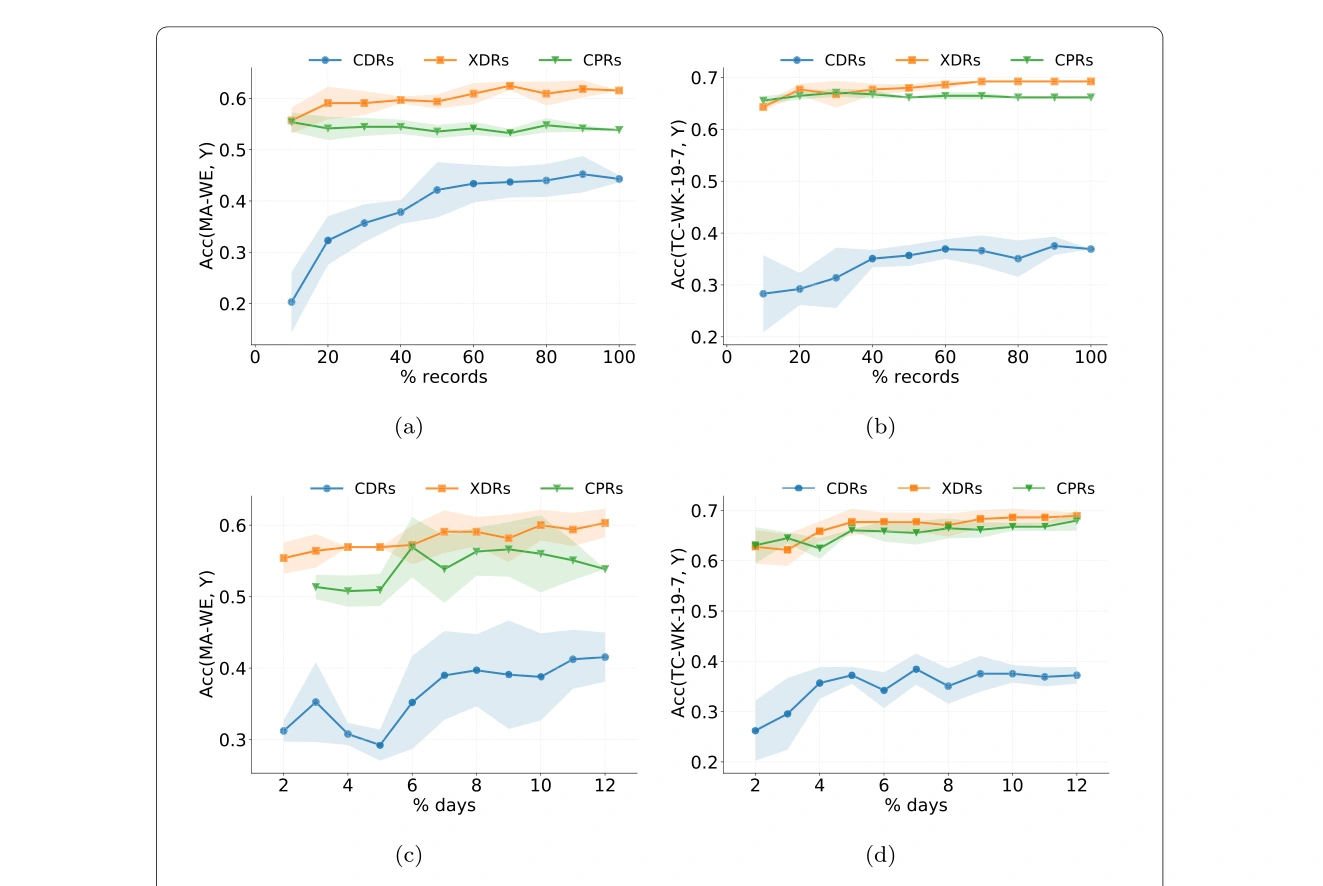
图 9|抽走记录或抽走整天之后,准确率怎样变化?
(a)纵轴是周末全天 MA-WE 的准确率,横轴是每人保留的记录比例。(b)纵轴换成工作日夜间 TC-WK-19-7,横轴仍是记录比例。(c、d)规则与(a、b)相同,横轴刻度是 2、4、6、8、10、12,轴标题印成 % days。正文写的是随机抽取 2 天、3 天直到 12 天的全部记录,刻度与这段文字一致,不宜把 12 读成 12% 的天数。图注把(a、c)都写成记录比例、把(b、d)都写成天数;坐标轴的分法是(a、b)为记录比例,(c、d)为天数。蓝线通话的波动和色带都更大。正文给出的定量锚点是:MA-WE 在通话上至少需要 50% 的记录,才接近使用全部记录的准确率;表 4 里这个全部记录的准确率是 0.51。橙线和绿线在较低比例、较少天数时仍高于蓝线。逐点数值正文没有列表。来源:原论文 Fig. 9。
天数实验停在 12 天。通话和扩展详单的观测窗口是 14 天,控制面是 13 天。其余规则的抽样曲线在补充材料,主文只概括了三点:通话的准确率更随抽到哪一批记录而变;扩展详单和控制面用较少天数就能接近用全部天数;无论抽到哪些天,扩展详单都更高。
这组结果能用到谁身上
65 人、两周、一家运营商、一座城市,而且都是白天上班的企业员工。没有年龄、性别和收入,规则会不会在不同收入的市辖区里高低不同,这篇数据看不出来。夜班、居家办公比例很高的人群、几乎不产生数据业务的老人,都不在这个分母里。工作日夜间之所以领先,和“夜里人在家、白天人在班上”这套作息绑在一起。
0.69 的意思是,65 人里比例为 0.69 的人,检测结果落进三个最近基站。基站坐标停在塔的位置。只要求最近一个基站时,最好的一档是 0.45。图 8 里,判对之后的平均距离仍约 0.4–0.5 公里,这个距离可以跨过一条市辖区边界。小区域人口若直接把基站当成住处,头名规则留下的误差仍然会进入统计。
控制面的记录更多,三个最近基站口径的准确率仍低于扩展详单。数据最小化说明的是,在这 65 人的五次随机里,扩展详单和控制面在删记录之后保持得更稳。实验给出的是这个样本上的曲线,另一座城市的最低天数还要重新测量。
一句话总结
在这 65 个已知住址上,扩展详单配合工作日 19:00–7:00 的记录,比通话详单和“哪里记录最多”更常落到住址附近的基站;最好的一档是 65 人中的 0.69,而且对的是三个最近基站之一。
核心来源
Pappalardo L.、Ferres L.、Sacasa M.、Cattuto C.、Bravo L.,Evaluation of home detection algorithms on mobile phone data using individual-level ground truth,EPJ Data Science,2021,10:29。DOI:10.1140/epjds/s13688-021-00284-9。同一 DOI 下附有补充材料。论文写明规则代码放在 github.com/leoferres/home_loc。
Luca Pappalardo 是通讯作者之一,任职于意大利国家研究委员会信息科学与技术研究所(ISTI-CNR)。研究所人员页列出他为高级研究员,工作集中在人类移动性。本文中他分析数据、实现并运行家位置规则、作图。致谢写明欧盟 H2020 SoBigData++(871042)的支持。
Leo Ferres 是另一位通讯作者。论文署名为智利发展大学工程学院、圣地亚哥 Telefónica R&D 和都灵 ISI 基金会。发展大学工程学院页面介绍他从事数据科学与社交网络分析;研究人员名录写作 Leonardo Adrián Ferres。本文中的分工与 Pappalardo 相同。致谢写明 Telefónica R&D Chile 与 CISCO Chile 的资助。
Manuel Sacasa 的论文署名为圣地亚哥 Telefónica R&D。作者贡献写明他提取并提供匿名化的手机数据。智利 ANID 的 Dataciencia 也把他标在 Telefónica R&D,并收录本文。
Ciro Cattuto 的论文署名为都灵大学与 ISI 基金会。他的个人页面写明,研究人类行为与数字平台交织的现象,并担任 ISI 基金会科学主任。本文中他参与分析并设置实验。致谢包括 CRT 基金会的 Lagrange 项目,以及欧盟 H2020 项目 EpiPose(101003688)和 PERISCOPE(101016233)的部分支持。
Loreto Bravo 的论文署名为发展大学工程学院与 Telefónica R&D。发展大学写明她领导工程学院与 Telefónica I+D 共建的数据科学研究所。本文中她提取并提供匿名化数据。致谢为 FONDECYT 1130902。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一套官方通勤统计仍用通话详单,并在“全部通话最多”和“周末通话最多”之间选择,表 4 里后者是 0.51、前者是 0.26,工作日夜间只有 0.37。家被放到周末常打电话的基站之后,家到白班工作地的距离会被拉长或拉偏。这是从 65 名白天上班员工推出来的风险。一座夜班占比很高的城市,同一套夜间规则会把班次地点当成家,论文没有这组人,也就没有测量这种反向误差有多大。
采购数据时也容易把“事件更多”当成“家更准”。控制面有 772,871 条,扩展详单有 43,607 条,前者约为后者的 17.7 倍。三个最近基站口径下,13 种平均是控制面 0.47、扩展详单 0.50,头名是 0.66 与 0.69。控制面在图 7 里换来更短的五规则平均距离,2.5 公里对扩展详单的 3.0 公里。要让更多人进入住址附近的三个塔,这个样本里扩展详单的比例更高;要让判错的人平均离住址更近,控制面的这五条更短。两个目标对应的数据选择不同。
图 9 还提示,两周全部控制面不一定是最小够用的请求。在这五次随机里,扩展详单用较低的记录比例就维持在高位,通话的周末规则却要到 50% 才接近自己的 0.51。把这个 50% 写成任何城市的最低采购量,已经超出实验。班次混杂的城市要先分开日班和夜班,再决定时间窗。全城共用一个 19:00–7:00,会把这篇白天班次里的优势带到夜班样本上。论文没有做这个分组。