预测下一个人去哪、一个格子进出多少人、再造一份轨迹,为什么还不能用同一个分数比较?
论文名片|Massimiliano Luca、Gianni Barlacchi、Bruno Lepri、Luca Pappalardo,Deep Learning for Human Mobility: a Survey on Data and Models,arXiv:2012.02825v1 [cs.LG],2020年12月4日。预印本标识 arXiv:2012.02825。PDF 首页的 ACM 参考文献行写为 2020 年 12 月,卷期为 Vol. 1, No. 1,文章号留空;DOI 印作 10.1145/nnnnnnn.nnnnnnn,是未分配模板,此处不作为正式 DOI。本文是综述,讨论下一位置预测、人群流量预测和轨迹生成。
设想市政部门同时收到三份技术需求。一份要判断某人下一站落在哪里,用来做出行提示。一份要估计每个街区下一小时有多少人进来、多少人离开,用来看哪里会挤。第三份不要真实个人轨迹,只要一批统计上像真的合成轨迹,以便在不交出个人记录时做规划推演。三份需求都指向人类移动性(human mobility,人在空间中的移动;下文称人类移动)。日常出行、格子上的人流和合成轨迹都算在内,并不等于人口迁移。
这份综述给出的方向是:到 2020 年 12 月这版预印本,深度学习并没有交出一个通吃三件事的网络。文献已经按三件任务分开生长。新模型常常换一套数据、一套地理网格和一套评分,因此“更深”还不能直接读成“在同一道题上更准”。
先说结论
- 综述把深度学习在人类移动中的用法收成三件事:下一位置预测、人群流量预测、轨迹生成。表 2 收录 11 篇、13 篇和 6 篇,共 30 行;正文还讨论了未列入该表的 Song 等人的轨迹生成工作。
- 公开数据的计数单位并不相同。GeoLife 是 182 名用户、4.5 年的轨迹;Gowalla 正文写超过 600 万次签到,表 1 的 196k 对应另一口径;通话详单只在通话或短信发生时把人记到基站。
- 人群流量论文反复使用北京出租车和纽约单车,但网格从 32×32、16×8 改到 10×20、21×12,或改成 100 个、120 个不规则瓦片。RMSE 的分母是该网格上的流入、流出预测,网格一变,误差就不能跨论文排名。
- 轨迹生成看的是合成分布是否贴近真实移动规律。综述转述 SVAE 在真实轨迹与合成轨迹逐步配对上的重建误差小于 800 米;MoveSim 用 JS 散度比较距离、回转半径、每日访问地点数、集体访问秩和个体访问秩。这些都不是“下一站猜对了多少次”。
- 综述自己没有做统一实验。它把未完成的问题写成地理可迁移、可解释、隐私、可调节,以及人与人的移动并不互相独立。
三件事各自在预测什么?
下一位置预测(next-location prediction)根据一个人已经去过的地点,估计他接下来去哪。地理空间若先切成瓦片,任务就是多分类:输出下一个瓦片的编号,或对所有可能地点排一个名次。若直接预测经纬度,任务就是回归。还有一种变体预测下一个兴趣点,也就是带名称和类别的场所。模型通常给出一串由高到低的候选,而不是只吐出一个点。
人群流量预测(crowd flow prediction)先把区域切成格子,再数每个格子的流入和流出。流入是这一时段在格子里、上一时段不在的人数;流出是这一时段在格子里、下一时段去了别处的人数。一个时段的流量可以写成一个张量,两层分别是流入和流出。这和起讫矩阵(origin–destination matrix,OD 矩阵)是两种输出:OD 矩阵记录从哪里到哪里,流入和流出分别记录这个格子有多少人进来、多少人离开。后文的 MVGCN 预测的就是区域之间的 OD,综述把它放在流量任务的变体里。
轨迹生成(trajectory generation)要造出 n 条合成轨迹,每条是按时间排列的时空点,对应 n 个互相独立的代理个体。真实程度靠一组空间规律和时间规律来检验:单人的量,例如回转半径和移动熵;集体的量,例如地点有多热门。训练用一部分真实轨迹,检验用留出的真实轨迹。对每一条规律,用 KL 散度或 JS 散度比较合成分布和真实分布。散度越低,模型在这一条规律上越像真实数据。
三件事因此对应三种分母。下一位置的准确率,分母是一次次预测里真实地点是否进入前 k 名。流量误差的分母是格子上的流入、流出数值。生成模型的分母是一组分布之间的差异。把三者写成一个“移动预测准确率”,会把三种计数混成一种。
格子一切,地点的含义就变了
轨迹在综述里是按时间排列的点。每个点有时间和位置,位置是某个坐标系里的坐标;带语义的点再加一个含义,例如家、工作地或其他类别。做流量或分类时,这些坐标要先落到空间剖分(spatial tessellation)上:有限块瓦片互不重叠,合起来盖住整个研究区。一个点只属于一块瓦片。规则瓦片可以是正方形、六边形;不规则瓦片可以是建筑物、普查区或行政区。
图 1 用纽约市展示四种切法。它是剖分示例,上面没有预测误差,也不能用来宣布哪一种格子更适合深度学习。
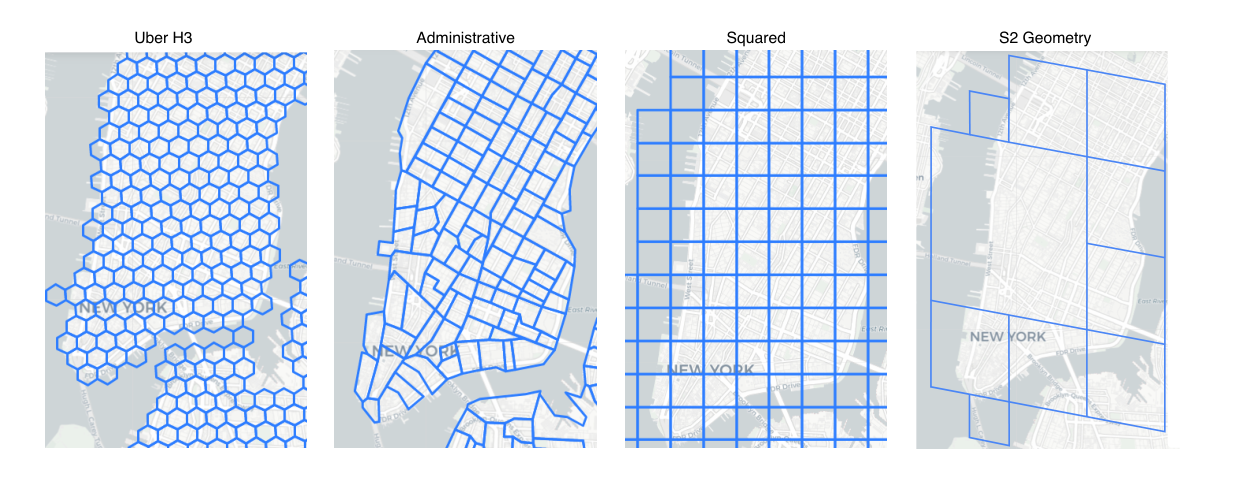
图 1|同是纽约市,四种剖分把一个地点切成什么?
原图没有子图字母,从左到右按图上标题阅读。(Uber H3)六边形网格,正文说明这里用的是 H3 分辨率 6。(Administrative)按纽约市开放数据门户的 GeoJSON 行政区边界切开;综述没有给出多边形个数。(Squared)用 scikit-mobility 切出 1 公里×1 公里方格。(S2 Geometry)球面上的四边形层级;图上没有标注具体层级。来源:原论文 Fig. 1。
H3 的第 0 级有 122 个基格,之后每一级把一格分成 7 格,另外还有 15 级更细的网格;最细的第 15 级,格子面积小于 1 平方米。S2 从立方体的 6 个面投到球面,层级从 0 到 30;第 30 级叶子格共有 6×4³⁰ 个,地表上大约 1 厘米见方。图 1 的六边形是分辨率 6,方格是 1 公里边长。同一条 GPS 轨迹在这四种图上会变成不同的地点序列,后面的分类标签和流量张量也会跟着变。
综述接着复述人类移动里已经反复出现的统计规律,供后文的生成模型当检查清单,而不是在本文重新拟合指数。连续两个停留点之间的距离叫跳跃长度,经验分布常用截断幂律近似,指数会随数据类型和空间尺度略有变化;文中没有给出具体指数。回转半径把一个人在观测期内走过的范围收成一个距离:各点到轨迹质心的距离先平方、再按点数平均、再开方,分母是这条轨迹的点数。群体平均回转半径随时间大约按对数增长。只在最常去的 k 个地点上计算的 k 回转半径,曾被用来区分回返者和探索者。
真实熵把访问顺序和停留时间都算进去。综述转述其分布在 S≈0.8 附近达到峰值,并写成 2 的 0.8 次方等于 1.74,也就是典型用户的时空不确定性少于两个地点。1.74 是由这个熵值换算出来的地点数,来自综述所引的规律文献,不是本综述任何一个深度学习模型的准确率。个体访问秩近似齐普夫定律,排名第 L 的地点被找到的概率大约随 1/L 下降;集体访问秩则描述一个地点在所有人访问中有多热门。等待时间的分布同样被写成截断幂律,人的移动还带有昼夜节律。生成模型后面要逐项面对的,就是这些分布。
公开数据很多,计数单位却不是同一种移动
手机、GPS 和社交媒体都能留下位置,但记录触发的条件不同。手机覆盖在综述所引的既有研究里已接近多数国家的全部人口;这不是本综述自己的抽样比例。运营商在用户通话、收发短信或使用移动数据时分配基站。通话详单(Call Detail Record,CDR)在通话或短信时生成,位置是处理这次通信的基站,不是基站覆盖范围内的精确坐标。两次记录之间人去了哪里,详单里没有。扩展详单(eXtended Detail Record,XDR)在上网连接时生成,通常比通话更密,空间上仍然落在基站。基站分布随人口密度变化,城乡的位置近似因此不同。详单还可以带通话对象和社会人口属性,但多数原始详单不公开。
GPS 可以到厘米至米级,具体取决于设备和系统误差;室内和隧道里收不到。点列本身没有“家”或“店”这种语义,语义地点要另外推断。社交媒体只在发帖或签到时才有位置,稀疏是常态;好处是场所往往自带类别,例如餐馆的层级分类。
表 1 按数据源列出可研究使用的数据集,并标明公开、注册后获取或申请后获取。项数一栏的单位是用户或点数;“-”表示数据已汇总,或数量未提供。下表只抽出后文模型真正用到、且综述给了明确口径的几行,避免把用户数、签到次数和轨迹点数读成同一个分母。
| 数据 | 综述给出的口径 | 后文任务里的用途 |
|---|---|---|
| GeoLife | 182 名用户,4.5 年;点间隔约 1–5 秒或 5–10 米 | MoveSim 的公开 GPS 实验 |
| MDC | 185 名参与者,2 年,洛桑 | Ouyang 等人与 Kulkarni 等人的生成实验 |
| Gowalla | 2009 年 2 月至 2010 年 10 月超过 600 万次签到;表 1 另记 196k、20 个月。196k 与正文约 20 万个好友节点同一量级,签到次数则是超过 600 万 | 下一位置与下一兴趣点 |
| Foursquare(Yang 等) | 约 10 个月:纽约约 23 万次签到,东京约 57.5 万次;表 1 的 800k 与这两组签到之和同量级 | Flashback、VANext、DeepJMT 等 |
| DeepMove 数据 | 纽约 16,000 名用户,1 年 | DeepMove 的公开签到数据 |
| 波尔图出租车 | 表 1 为 441 辆、9 个月;点间隔约 15 秒 | 下车点坐标预测 |
| 旧金山出租车 | 表 1 为 500 辆、30 天;2008 年 5 月,平均约 10 秒一点 | 坐标预测,以及 Yin 等人的密度生成 |
| 北京 T-Drive | 约 10,000 辆出租车,1 周,约 177 秒一点 | 表 1 所列 GPS 轨迹 |
| ST-ResNet 出租车 / 单车 | 北京出租车流入流出,表 1 写 4、6 个月;纽约单车 6 个月 | 人群流量的常用公开输入 |
| 纽约、华盛顿单车 | 站点之间的行程;纽约表 1 记自 2013 年,华盛顿自 2010 年 | 流量模型的另一种网格实验 |
还有几组数据决定了“大规模”到底大在哪里。OpenStreetMap 在 2013 年发布的 GPS 集覆盖约 7 年、近 30 亿个点,论文写明 2013 年 4 月的版本是当时的最近更新;这些点在世界上的分布很不均匀,20% 的世界范围集中了 75% 的测点,分母是这批 GPS 测点。长春数据是一周内约 200 万用户:每小时每人最后位置、基站对之间的流动人数,以及位置之间的距离矩阵,没有精确坐标。松辽数据在正文中写作 Sangliao、表 1 写作 Songliao,是一周内近 300 万用户在 167 个行政区之间的小时汇总;正文括号里把范围写成约 20 平方公里。WorldPop 把手机数据与普查等合在一起,估计 100 米×100 米格网上的人口密度,表 1 的时间跨度写 20 年;它是密度估计,不是个人轨迹。
Telecom Italia 大数据挑战在米兰和特伦蒂诺省发布两个月的多源数据,包含格子上的通话、短信和上网活动,格子与意大利其他省份的联系,以及米兰、特伦蒂诺内部格子之间的有向联系强度。表 1 没有给出用户人数。普查数据通常每 5 年或 10 年采集一次,提供居住地、工作地和先前居所,时间粒度与每隔几秒的 GPS 不是同一件事。欧盟 Urban Atlas 把土地利用分成 20 类,覆盖 10 万人口及以上的城市。天气和道路传感器则被流量模型当作外部条件:天气数据集可含气温、湿度、风速和降水,道路传感器给出两次测量之间经过的车辆、自行车或行人数。
循环网络、卷积和对抗生成,分别在比较什么?
下一位置是一条有顺序的地点序列。全连接层理论上能逼近很多函数,但本身不处理顺序。循环神经网络(Recurrent Neural Network,RNN)让每一站的隐藏状态同时看当前输入和上一站留下的状态,这样“刚才在哪”能影响“下一站猜什么”。普通 RNN 用双曲正切把这两部分合在一起,长序列上早期信息容易传不到末尾。LSTM 用细胞状态和遗忘门、输入门、输出门决定忘掉什么、写入什么、输出什么。GRU 只用隐藏状态,靠重置门和更新门做类似的取舍,结构更短。双向 LSTM 再把序列倒过来走一遍,综述指出这种双向上下文在语音里有用,移动预测里是否同样必要,要看具体论文,而不是结构图本身能证明的。
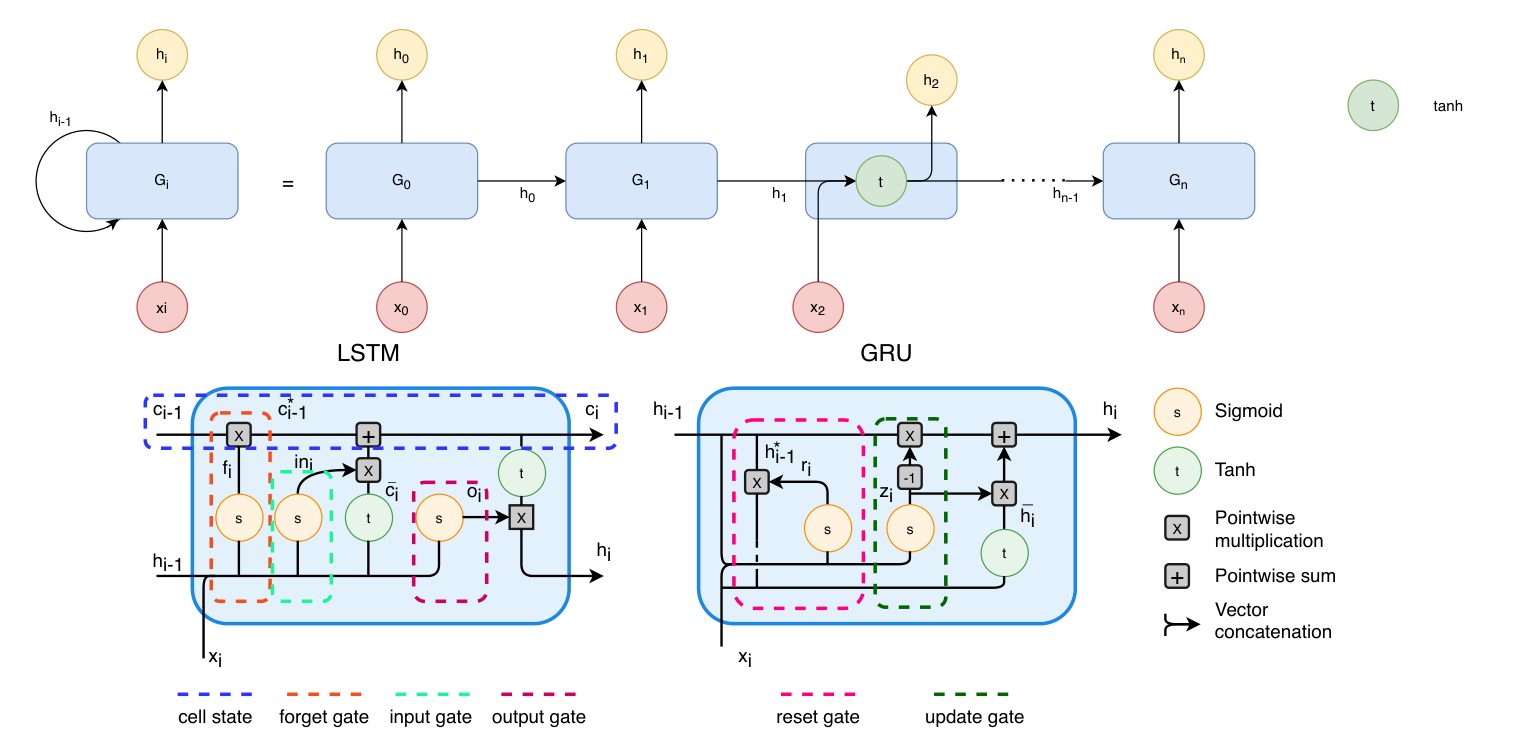
图 2|处理一条地点序列时,早期位置怎样被留下来?
原图没有 a、b、c 字母,按上下两块阅读。(上)左边是折叠起来的循环单元,右边是按时间展开的样子。输入是序列 x₀ 到 xₙ,第 i 步的输出由当前输入和上一隐藏状态共同决定;绿色圆表示普通 RNN 里的 tanh。(下左,LSTM)虚线框出细胞状态、遗忘门、输入门和输出门。细胞状态横贯单元,三个门用 sigmoid 决定信息保留多少。(下右,GRU)红色虚线是重置门,绿色虚线是更新门,过去的信息只通过隐藏状态传递。右侧图例中,s 为 sigmoid,t 为 tanh,× 为逐点相乘,+ 为逐点相加,箭头合并表示向量拼接。这是结构示意图,没有移动数据上的误差。来源:原论文 Fig. 2。
人群流量把一座城市写成一叠矩阵:每一张是一个时段的流入或流出。卷积网络(Convolutional Neural Network,CNN)用小滤波器在矩阵上滑动,把一片邻域收成一个数,池化再把一片区域收成最大值或平均值。残差连接把前面某一层的输出加到后面,用来减轻很深的网络里损失传不回去的问题;综述写跳跃间隔 j 通常小于 4。卷积看的是空间上的近处和远处能否互相影响。一个人乘车从城市南边到北边,会同时改两个相距很远的格子的流入流出,所以只看相邻格子并不够。时间顺序则常交给 LSTM,或交给把卷积放进循环单元的 ConvLSTM。
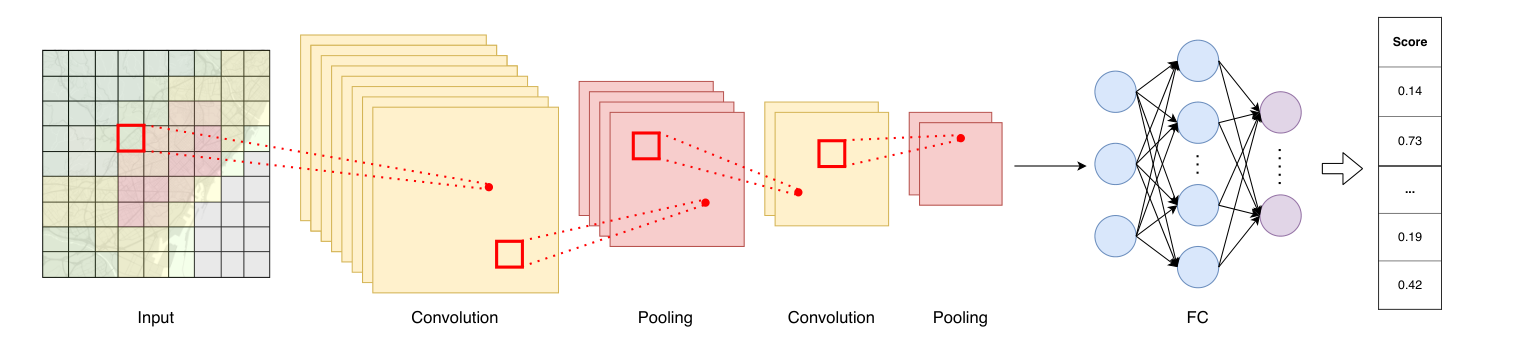
图 3|把城市流量当成一张张图时,网络怎样把邻域收成一个预测?
原图是一条从左到右的示意管道,没有子图字母。(Input)输入是画在地图上的网格,红框表示滤波器正在看的一小块。(Convolution、Pooling)卷积与池化各出现两次,红点表示一块区域被收成更少的数值;图中的堆叠方块表示多个通道,不是多座城市。(FC)全连接层把这些特征合成输出。(Score)右侧 0.14、0.73、0.19、0.42 是分类示例里的分数,图注说明它们可以是样本属于各类的概率。这些数字不是某座城市的流量,也不是模型误差。来源:原论文 Fig. 3。
轨迹生成需要从随机噪声里造出新的轨迹,同时让判别器分不出真假。生成对抗网络(Generative Adversarial Network,GAN)把这件事写成一场双方只能控制自己参数的博弈:生成器希望自己的分布接近训练数据,判别器希望把真实样本和生成样本分开。训练时两边同时做随机梯度下降。综述把常用代价写成交叉熵。图 4 是这个博弈的示意图;它还没有绑定任何一座城市的数据。
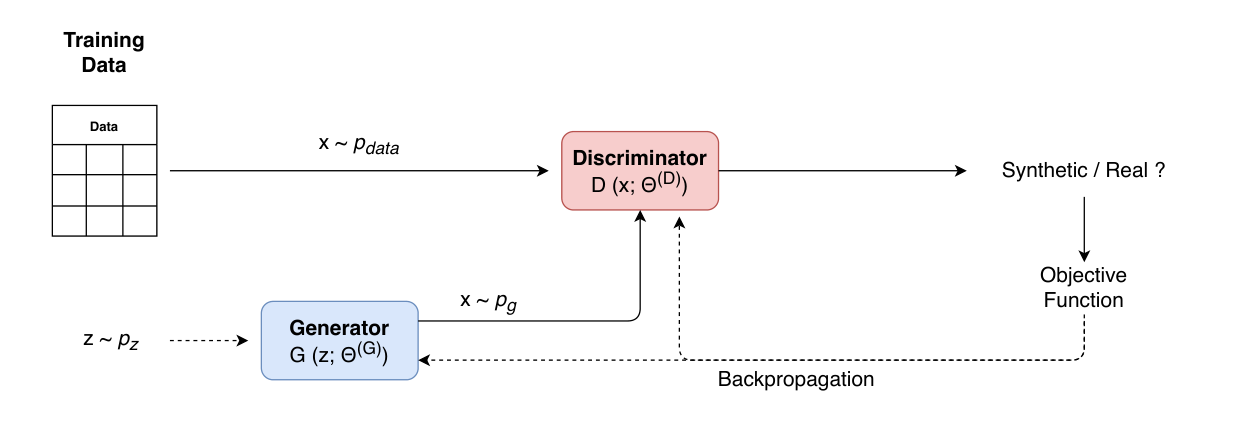
图 4|生成轨迹时,谁在造样本,谁在判断真假?
原图没有子图字母,按图上的模块阅读。(Training Data)真实轨迹分布 p_data 中的样本 x 进入判别器。(Generator)噪声 z 来自 p_z,生成器 G 用参数 Θ(G) 产出分布 p_g 上的样本,再送入判别器。(Discriminator)判别器 D 用参数 Θ(D) 判断输入来自真实数据还是生成数据。(Synthetic / Real)输出是真假判断。(Objective Function、Backpropagation)目标函数的结果沿虚线返回,更新生成器。图中没有报告某一数据集上的散度或误差。来源:原论文 Fig. 4。
注意力机制给输入的每一部分打分,再把分数和输入乘在一起,得到当前更该看的上下文。下一位置模型用它从很长、很稀的历史轨迹里挑出和当前行程相近的片段;流量模型用它在多个时段之间分配权重。分数来自模型,不等于研究者直接观察到的“这个人当时在注意哪”。
评分本身也分成三套。MAE、MSE、RMSE、MAPE 都是误差大小,范围从 0 到无穷,越低越好,分母都是预测次数 n。MAE 对每个误差取绝对值。MSE 把误差平方,大误差更重。RMSE 是 MSE 的平方根,单位和预测值相同。MAPE 把绝对误差除以真实值的绝对值再乘 100,表示相对于真实流量的百分比。坐标误差另有哈弗辛距离和等矩形距离,二者都用地球半径把经纬度差换成距离,越低越好;综述没有给出所用的地球半径数值。k 准确率 ACC@k 是真实地点出现在模型认为最可能的 k 个地点之中的次数比例,ACC 等于 ACC@1,分母是预测次数。AUC 在 0 到 1 之间,0.50 对应随机猜测。KL 散度不对称,为 0 表示两个离散分布相同;JS 散度对称,范围在 0 到 1。生成模型用它们比较某一条移动规律的分布,不用它们表示猜对了百分之多少的人。
下一位置:猜中格子和猜中坐标,记的是两种账
传统做法里,马尔可夫链用当前地点预测下一个地点,n 阶链再把前 n 个地点纳进来;频繁序列方法则寻找“带着典型行程时间的区域串”。它们在小数据上可用,也较容易解释。综述指出它们的记忆有限,长程顺序要靠大量人工特征去补。深度学习模型声称能把地点顺序、周期、文本和天气放进同一个网络。这份综述没有在同一测试集上给出这些家族相对马尔可夫链的统一百分比,下面的数字都是各篇自己的数据和指标。
出租车下车点是坐标回归。De Brébisson 等人用全连接网络,输入是变长 GPS 点,外加出发时间、司机身份和乘客信息,在波尔图出租车上用等矩形距离评估。综述明确说这个模型没有处理时间维。T-Conv 把轨迹当成图像,用卷积看不同空间尺度,再把出发时间和用户信息送进全连接层,同样用波尔图数据,距离改成哈弗辛距离。Rossi 等人的 LSTM 加自注意力,并给地点配上周围地理信息,在波尔图、纽约和旧金山的出租车上报告哈弗辛距离。Ebel 等人先用 k-d 树把 GPS 分到瓦片,一路循环网络读轨迹,一路全连接网络读星期、时刻和天气,合并后同时给出落在某瓦片的概率和目的地坐标;评估是平均哈弗辛距离以及到真实到达点的距离,数据仍是波尔图和旧金山。
同一座城市的下车点,至少已经出现等矩形距离、哈弗辛距离、瓦片概率三种记分。米和“是否落在前 k 个瓦片里”回答的是两道题。
兴趣点和签到走的是分类。ST-RNN 为时间和空间各学一套转移矩阵,在 Gowalla 和 Global Terrorism Dataset 上报告 F1、Rec@k、MAPE 和 AUC。DeepMove 用多模态嵌入加上注意力和 GRU,应对又长又稀的轨迹,在其 16,000 名纽约用户的 Foursquare 数据、手机数据,以及一个中国社交平台数据上用 ACC 评估。HST-LSTM 用编码器记住一段时间和一块区域内去过的地点,解码器预测接下来可能的兴趣区域,ACC 来自私有的百度数据,表 2 的公开数据集栏为空。SERM 把时间、地点和社交媒体关键词嵌进 LSTM,在纽约 Foursquare 帖子和洛杉矶推文上用 ACC@k。VANext 用两条编码器分别处理历史轨迹和当前轨迹,再用注意力找最相似的历史,数据包括 Gowalla 以及新加坡、纽约的 Foursquare。Flashback 在稀疏语义轨迹里按时间相似性回看旧轨迹,同样在 Gowalla 和 Foursquare 上用 ACC@k。DeepJMT 同时预测下一个兴趣点和到访时间,四条支路分别处理轨迹顺序、空间邻居、周期和社会时间上下文,ACC@k 的城市是纽约、东京和伊斯坦布尔的 Foursquare。
这些 ACC@k 的分母都是各自测试里的预测次数。综述没有打印任何一篇的 ACC 数值,因此这里不能排列谁的前 k 名更高。能确定的是:波尔图坐标论文和签到分类论文即使都叫下一位置预测,一个在量米,一个在量名次是否盖住真值。
人群流量:网格一换,RMSE 的分母就换了
自回归、ARIMA 及其季节、向量、时空变体,是流量预测里常见的基线。综述认为它们难处理空间依赖:一个格子的流出可以改变远处格子的流入,而经典时间序列主要沿着时间往下推。季节项很长时,季节 ARIMA 的表现还会下降。深度学习模型用卷积看空间、用循环网络看时间,并把天气、假日、兴趣点分布接进额外的全连接层。时间上,综述区分紧邻时段、重复出现的趋势,以及早高峰这类周期。
多数论文用 RMSE,并使用 Zhang 等人 2017 年 ST-ResNet 的公开数据。那套数据里,北京出租车是 32×32 的方格,纽约单车是 16×8 的方格。ST-ResNet 自己用三条卷积残差支路分别抓趋势、周期和近期,再与处理天气等外部因素的全连接输出合并。后面的模型常在这个起点上改零件:STRCN 用三套卷积加 LSTM 区分近期、日影响和工作日与周末的差别;STDN 在两条卷积支路之外用 LSTM 和注意力看当天的时间动态;DST-ICRL、ST-DCCNAL、MV-RANet、LDRSN、DeepSTN+ 分别加入不规则卷积、稠密连接、图上的转移概率,或用全连接去看相距很远的格子。PCRN 预测的是城市里人出现的分布,Ai 等人预测无桩单车在成都的短期分布特征,MVGCN 预测的是区域之间的 OD 图。任务语句已经不完全是“每个格子的流入流出”。
关键的数值差异在网格,不在一个共享的 RMSE 表。综述没有给出各模型的 RMSE 数字,下面是各篇实验所用的剖分,分母都是该剖分上的流量预测,不能跨行相减。
- ST-ResNet 及多数跟随者:北京出租车 32×32,纽约单车 16×8。
- STDN:纽约单车和纽约出租车,10×20,除 RMSE 外还报告 MAPE。表 2 的数据集栏只列了单车数据。
- DST-ICRL:表 2 的公开数据栏写 ST-ResNet 数据;正文实验还包括北京公交和地铁电子卡的私有数据,方格为 128×128,指标是 RMSE 和 MAE。
- MV-RANet:北京出租车 32×32;三亚的私有手机详单为 85×110。指标写有 RMSE、MAPE 和 MAE。
- LDRSN:综述写纽约单车使用 16×8,纽约出租车使用 10×20,指标为 MAPE、RMSE 和 MAE。
- DeepSTN+:纽约单车为 21×12;一家中国社交平台的私有数据为 19×21。它还把兴趣点分布当作先验。
- MVGCN:纽约单车、纽约出租车和华盛顿单车用 120 个不规则瓦片;北京出租车用 100 个不规则瓦片。指标是 RMSE 和 MAE。
- Ai 等人:成都两家无桩单车公司的私有数据,指标是 RMSE 和 MAE;表 2 没有填写公开数据集。
表 2 里还有两行正文没有展开结构:HIDLST 组合 LSTM 与 ST-ResNet,ATFM 使用 ConvLSTM,二者都用 RMSE,公开数据栏都是 ST-ResNet 那套数据。只凭表 2 不能重建它们的层数和输入窗口。
因此,纽约单车至少已经以 16×8、10×20 和 21×12 三种方格出现。16×8 共 128 个格子,10×20 共 200 个,21×12 共 252 个。格子数不同,流入流出的空间单位就不同。一篇论文的 RMSE 更低,只说明它在自己的网格、自己的时段和自己的指标上误差更小。它不提供跨论文的名次,也不说明模型抓住了天气或土地利用的因果作用。外部变量进入网络,只说明作者把它们当作输入。
合成轨迹要同时像好几条规律
机制模型先规定人怎么选下一个地点。探索与优先返回模型(Exploration and Preferential Return,EPR)让代理人在两件事之间选择:按幂律步长随机走到没去过的地方,或按到访频率回到旧地点。TimeGeo 和 DITRAS 再补上昼夜出行倾向和脱离日常的行程,用马尔可夫链描述时间。综述认为这类模型的好处是机制可以阅读,限度是机制本身较简单,所以文献转向由数据学习的生成网络。这个判断是综述的归纳。文中没有用同一批轨迹、同一组散度,把 EPR 和后面每一个 GAN 排成一张表。
深度学习这边,trajGANs 是一篇展望:生成器把随机向量变成轨迹的稠密表示,判别器判断真假,并建议用循环网络做表示。表 2 的评估栏为空。Ouyang 等人把轨迹写成停留张量,空间是 n₁×n₂ 的方格,每个地点最多重复 k 次停留;实验取 k = 4,在洛桑用 MDC 数据做成 64×64 的方格。生成器和判别器都是卷积网络,训练用 Wasserstein GAN。相似性用 JS 散度,比较地点热度、随时间的热度、停留时长、语义重要性和集体访问秩。综述没有打印这些 JS 的数值。
Song 等人用四层卷积的 GAN,把轨迹画成 512×512 的矩阵,先缩到 32×32,生成后再用最近邻放回 512×512。实验包含私有手机数据和把真实轨迹随机打乱后的合成数据。综述写明没有给出真实程度的定量评估。
SVAE 把变分自编码器和 LSTM 接在一起,并迫使输入轨迹具有固定的时间戳。真实程度用逐步配对的平均距离误差(Mean Distance Error,MDE)衡量:两组等长轨迹逐对算距离,再对轨迹条数平均。综述转述其重建误差小于 800 米。这是距离的上界陈述,不是一个精确的平均米数;表 2 没有填写数据集,因此不能把 800 米写成某一座城市、某一批用户上的误差。MDE 低,说明逐步位置靠近,并不自动说明跳跃长度、回转半径和访问秩的分布都已对齐。
Kulkarni 等人在 MDC 上比较循环网络、SeqGAN、RGAN 和非参数 copula,标准包括地理与语义相似性、统计相似性、长程依赖,以及隐私检验。综述的结论是 copula 在模型表现和计算时间上都占优。文中没有给出时间的倍数或相似性的数值。
MoveSim 把人类移动的空间连续和时间周期写进 GAN 的预训练和判别损失。空间单元在私有手机数据上是基站,在 GeoLife 上是经纬度小数点后最多 3 位的网格;时间槽是一天中的半小时。评估用 JS 散度比较距离分布、回转半径、每日访问地点数、集体访问秩和个体访问秩。同样没有打印 JS 数值。小数点后 3 位是综述的网格说法,文中没有把它换算成米。
Yin 等人生成的是每个地点、每个时间槽里的人数密度,不是一个人的路径。生成器和判别器都是全连接层。实验数据一是 MoMo,空间分辨率 2 公里、时间槽 30 分钟;二是旧金山出租车,50 公里×50 公里的方格、时间槽 2 分钟。综述说该模型在重建误差和效用损失上优于一种差分隐私做法,文中也列出攻击误差这项比较,但没有给出具体数值。密度对应每个地点、每个时间槽的人数;个体轨迹的访问顺序是另一项检验。
把这些实验放在一起,生成模型的“成功”至少有四种含义:逐步距离小于某个米数、若干分布的 JS 散度更低、定性地说某种方法又快又好、以及根本没有定量评估。它们都不能换成下一位置的 ACC@k,也不能换成某个 32×32 网格上的 RMSE。
综述停在五个还没做完的问题上
地理可迁移:在一个区域训练的模型,换到不相重叠的另一个区域去预测地点、流量或生成轨迹,效果会怎样,目前没有普遍答案。数据稀缺的城市恰恰最需要这种能力。综述把 RegionTrans 当作流量预测上的一次初步尝试,没有在本文报告迁移前后的误差差。
可解释:网络是黑箱。天气、兴趣点和时空特征各自把预测推了多少,综述认为尚不清楚。解释需要正例和反例,才能让规划者知道一条轨迹或一片流量为什么被生成。本文没有提供这样的特征贡献分解。
隐私:训练和使用两端都有风险。合成轨迹可能和某条真实轨迹过于相似;训练数据被扰动到什么程度,仍能保住生成模型的真实感和预测模型的准确度,综述认为文献几乎还没测量。
可调节:实用模型需要能按空间范围、时间粒度、限行或大型活动来拨动。综述指出,现有深度学习模型的可调程度有限,而且真实程度或准确度在多大程度上取决于剖分的大小和形状,并不清楚。它举了一个决策例子:想找一天之中最活跃的地区,行政区可能更好读;想看路网如何受大型活动影响,更细的格网可能更有用。这是用途说明,不是一次改变剖分后的误差实验。图 1 的四种纽约市切法,正好显示“地点”可以这样变,但没有给出四种切法下的预测差。
互动:下一位置模型和轨迹生成模型通常把人当作互相独立。堵车、事故和大规模通勤说明人的移动会缠在一起。综述认为,要把这些互动写进模型,还需要新的设计。独立个体上的 ACC 或散度,不能直接解释成群体拥堵的机制。
作者还留了一个合作清单,短链写作 bit.ly/DL4HM,用来继续登记数据集和论文。
一句话总结
深度学习已经分别用来预测下一地点、格子上的进出人数和统计上像真的轨迹,但这三套结果站在不同的数据单位、空间网格和评分分母上,更深的网络还没有自动变成可以横向比较的人类移动知识。
核心来源
- arXiv:2012.02825v1,2020 年 12 月 4 日预印本。首页题目为 Deep Learning for Human Mobility: a Survey on Data and Models。ACM 参考文献行的 DOI 为未分配模板 10.1145/nnnnnnn.nnnnnnn。
- 预印本正文中的图 1 至图 4、表 1 与表 2,以及第 5 节列出的五个开放问题。
- 文中给出的清单维护入口 bit.ly/DL4HM。
作者介绍
四位作者的身份以 PDF 首页署名和本预印本的参考文献为准。
- Massimiliano Luca:第一作者。署名 Fondazione Bruno Kessler(FBK,Via Sommarive 19,Povo-Trento)和博尔扎诺自由大学(Piazza Domenicani 3,Bolzano),邮箱 mluca@fbk.eu。参考文献中与 Simini、Barlacchi、Pappalardo 合著 Deep Gravity,讨论用深度网络和地理信息生成移动流量。
- Gianni Barlacchi:署名 Amazon Alexa(柏林)。首页脚注写明这项工作完成于加入 Amazon 之前。参考文献中他参与 2015 年米兰与特伦蒂诺省多源城市数据集,也出现在 scikit-mobility 和 Deep Gravity 的作者列表里。
- Bruno Lepri:署名 FBK(Via Sommarive 19,Povo-Trento)。同一篇 2015 年米兰与特伦蒂诺数据论文列出他为作者。
- Luca Pappalardo:署名意大利国家研究委员会信息科学与技术研究所 ISTI-CNR(Via G. Moruzzi 1,56124 Pisa),邮箱 luca.pappalardo@isti.cnr.it。致谢写明他部分受 EU H2020 SoBigData++(协议号 871042)资助。参考文献中的回返者与探索者研究、DITRAS 和 scikit-mobility 均列出他为作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要让三件事能够并列,最低限度的成绩单需要把分母写在指标旁边,并强制报告第二种指标。下一位置至少同时给出 ACC@k 和一种写明公式的坐标距离,因为波尔图出租车已经分别使用等矩形距离和哈弗辛距离。人群流量至少在同一座城市的两种剖分上各报一次 RMSE。纽约单车已经出现 16×8、10×20 和 21×12,格子数分别是 128、200 和 252。若模型名次在这三种网格上对调,改进就更可能来自格子,而不是来自一条可迁移的流量机制。
轨迹生成也不适合收成一个总分。SVAE 的逐步距离可以小于 800 米,同时仍然错过跳跃长度的长尾,或错过回返者与探索者的分化。更有信息量的检验是逐条规律报告 JS 或 KL,并允许模型在一条规律上通过、在另一条上失败。地理迁移同样应报告相对同一城市基线的误差增幅,同时说明剖分、兴趣点和时间窗是否按新城重做。RegionTrans 在综述里只是流量任务上的一次被点名的尝试,这个增幅本身仍待测量。