线网差很多的四座城市,地铁乘客的出行骨架为什么这么像?
论文名片|Shixin Chang、Liang Gao、Chaoyang Zhang、Ting Yu、Xiao Han、Bingfeng Si、Jose F.F. Mendes,Unraveling metro mobility patterns in China: A multi-city comparative study using travel motifs and entropy analysis,Chaos, Solitons and Fractals,2025,191:115916。2024年11月18日收稿,12月10日接收,12月27日在线发表。DOI:10.1016/j.chaos.2024.115916。本文依据这一正式版本解读。
周一早高峰,北京的地铁图铺成一张密网,苏州只有几条线。若只看线网,很难相信两地乘客的刷卡方式会接近。刷卡记录里反复出现的,常常是很少几个车站之间的来回。
这项研究比较北京、重庆、南京、苏州四座城市各约一个月的地铁自动售检票记录。线网规模差很多,但在每月乘车 15 到 300 次的活跃用户里,十二种出行模体的占比排得很近,几种熵的分布也挤在一起。偏好返回模型在用上这些经验分布之后,能再模拟出熵分布上的几个峰。相似指的是这批地铁活跃用户的统计分布。线网形状怎样改变一个人的选择,要另做开通前后的对照。
先说结论
- 分析单位是活跃用户。四城为 510 万、84 万、82 万和 17 万,分别占各城票卡用户的 15.5%、15.0%、12.2% 和 6.8%。刷卡条数和全体居民是另外两套口径。
- 随机熵主要落在 1.5 到 5.5,对应大约 3 到 46 个不同车站。分布均值约在 2 附近;北京、重庆、苏州的峰约在 2.5。按 2 的熵次方换算,南京更集中于大约 4 个车站,另外三城大约 6 个车站。把到站频率算进去之后,时间无关熵的峰在 1.58 附近,有效车站数大约是 3。
- 十二种出行模体里,两站来回的 M1 占活跃用户 28.4% 到 30.8%。模体在提取前去掉只出现一次的车站,计的是反复出现的两站骨架。随机熵等于 1 则表示全部不同车站正好为 2,论文写这个比例不高。
- 同一模体组内,熵的峰出现在 0、1、log₂3 和 2 附近。正文用这些峰表示一种很死板的循环,或两三种出现频率接近的主模式。M3、M6、M11 的组内比例是作者给出的概括。
- 访问占比随车站秩下降,幂指数 ζ 的四城平均从访问 3 个车站时的 1.76 降到 6 个车站时的 1.29。100 万名模拟用户的熵在 0、1 和 log₂3 处再出现峰;初始子序列已经按观察到的模体占比分配。
比的是哪一批地铁刷卡?
四座城市都位于论文所说的中国 GDP 前十,人口、辖区和地铁规模各不相同。表 1 的人口(单位百万人)依次是北京 21.707、重庆 31.018、南京 10.722、苏州 8.436;GDP(单位十亿元人民币)是 2801.5、2036.3、1282.0、1859.7。表 1 把面积印成北京 16 410、重庆 6 587.0、南京 8 657.3、苏州 82 402 平方公里。苏州与重庆这两格的数量级和常见市域面积对不上,论文在该表旁没有给出年鉴出处。后面的比较用的是线网和刷卡,不把这一行面积当成城市尺度的测量结果。
表 2 给出论文采用的线网底数。北京 22 条线、293 站、608 公里,日客运量 10.35 百万人次;重庆 8 条线、141 站、313 公里、2.35 百万人次;南京 10 条线、150 站、378 公里、3.065 百万人次;苏州 4 条线、93 站、121 公里、0.89 百万人次。日客运量的分母是系统客运量。后面的模体占比另以活跃用户为分母。
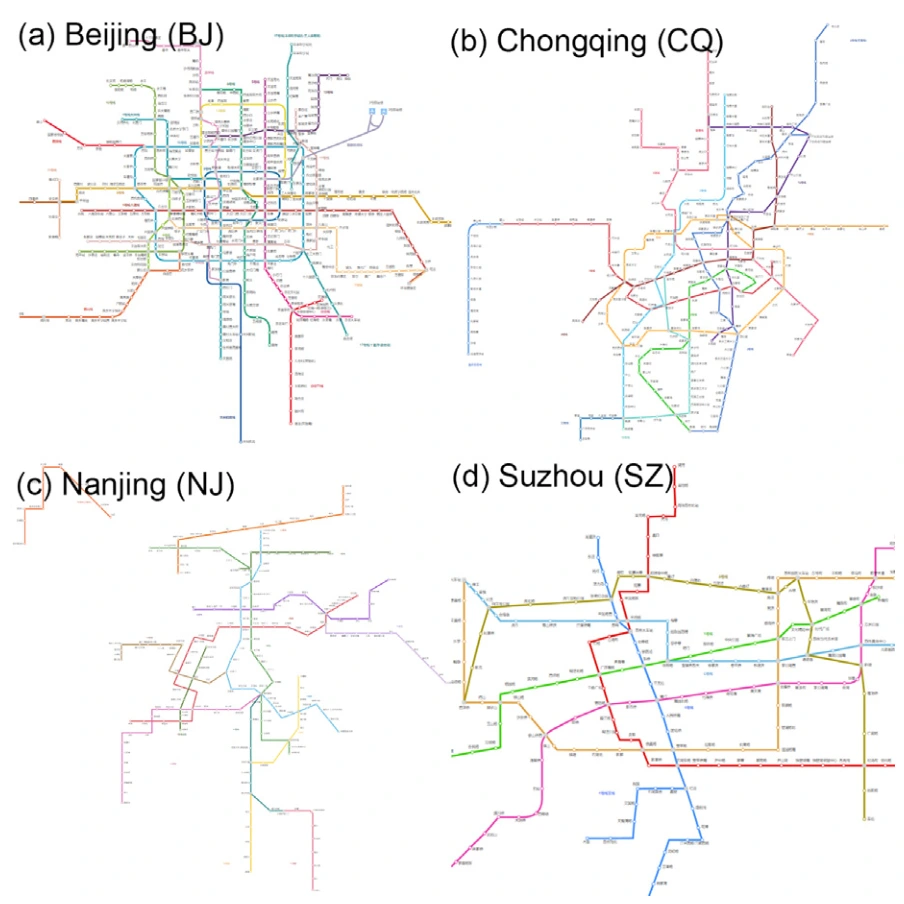
图 1|四座城市的地铁网,形状差在哪里?
(a)北京线路多、网格密。(b)重庆线路沿组团伸展。(c)南京线路更疏,覆盖被拉出中心。(d)苏州只有少数几条走廊。颜色区分线路,站名小到需要放大才能读。这张图说明比较发生在形态不同的网上;它本身不包含客流。来源:原论文 Fig. 1。
刷卡来自各城自动售检票系统,字段包括用户编号、日期、进出站和进出站时间。四个观察窗并不重叠:北京 2017 年 10 月,31 天里 17 个工作日;重庆 2018 年 4 月,30 天里 20 个工作日;南京标为 2018 年 3 月,数据覆盖 28 天、19 个工作日;苏州 2018 年 5 月,30 天里 19 个工作日。南京这 28 天短于 2018 年 3 月的日历长度,苏州的 30 天也短于 5 月的 31 天。
论文只保留活跃用户:一个月超过 300 次的记录被当作可能的地铁工作人员而剔除,少于 15 次的被当作低频用户剔除。阈值是作者给出的筛选,职业并没有另作核对。
| 城市 | 刷卡记录 | 票卡用户 | 活跃用户 | 活跃用户 / 票卡用户 |
|---|---|---|---|---|
| 北京 | 1.7×10⁸ | 3.3×10⁷ | 5.1×10⁶ | 15.5% |
| 重庆 | 5.0×10⁷ | 5.6×10⁶ | 8.4×10⁵ | 15.0% |
| 南京 | 5.2×10⁷ | 6.7×10⁶ | 8.2×10⁵ | 12.2% |
| 苏州 | 1.5×10⁷ | 2.5×10⁶ | 1.7×10⁵ | 6.8% |
右列分母是表 3 的票卡用户。四城活跃用户合计 6.93×10⁶,这个合计是四格相加,论文没有单独报告合并样本。苏州留下的比例最低。此后的熵和模体,分母都是这批活跃用户。一次刷卡是一条起讫记录;一个人一个月可以有很多条。
两名乘客的图,怎样帮人看见“选择并不均匀”?
把一名用户去过的车站当成点,把自动售检票记下的车次当成有向连线,就得到一张个人出行网。图 2 用两名用户说明这种网可以差很远。正文写,第一人在 20 天里往返 3 个车站,三角形路线跨度约 21 公里、覆盖约 18 平方公里。第二人在 27 天里去过 6 个车站,路线跨度约 70 公里、覆盖约 80 平方公里,而实际选用的连接只有 13 条。连线粗细对应选择次数,两人都有一对车站之间的来回特别多。作者推断其中一个点很可能是居住站,数据里没有单独的居住地字段。
这两名用户是例子。21 公里、13 条连接都不能外推成某城的平均出行。
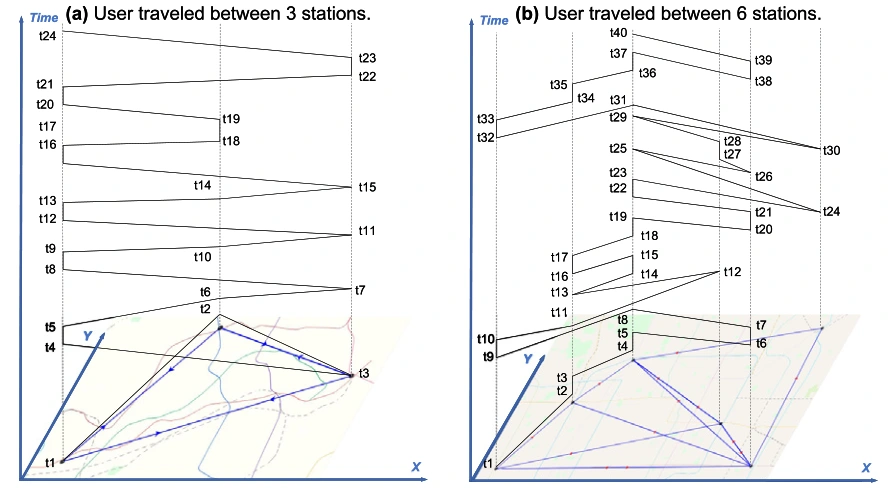
图 2|同是地铁用户,个人出行网可以差到什么程度?
(a)3 个车站。纵轴是时间,底面是这几站的空间位置和来回;t1 到 t24 标出依次经过的站。(b)6 个车站,时间层上的折线更散,底面的连线也更多,仍有少数边明显更粗。来源:原论文 Fig. 2。
去过的车站多,就算出行更难猜吗?
熵在这里用来比较一张出行序列有多“散”。论文为每个用户准备了四种算法,每一种改一个信息。
随机熵假定人在自己去过的车站里完全均匀地挑下一站,写成 S^randᵢ = log₂Nᵢ。Nᵢ 是不同车站个数。它是车站集合大小的上限式度量:站越多,这个熵越高。它不看来过几次,也不看先后。
时间无关熵把均匀假设拿掉,只保留历史到站频率:S^uncᵢ = −Σ pᵢ(j) log₂pᵢ(j)。常去的站会把熵压低。顺序仍然不进入计算。
出行选择熵把基本单位从车站换成起讫车次:S^tripᵢ = −Σ pᵢ(od) log₂pᵢ(od)。同是三个站,只走家和公司,与三站之间每种搭配都走,这一项可以差很多。
真实熵还要看子序列的顺序。子序列长度为 1 时,它退回时间无关熵;长度等于整条轨迹时,熵为 0,因为整段行程已经被看完。直接对所有长度计算很重,所以后面用模体对应的那个长度来近似。
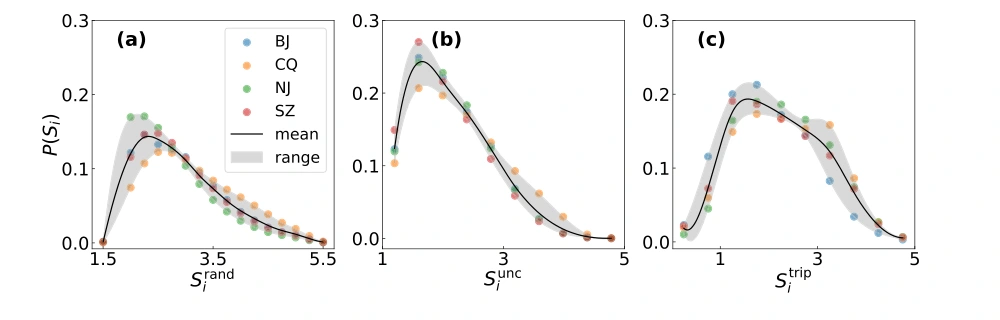
图 3|三种熵在四座城市里有多接近?
蓝、橙、绿、红依次是北京、重庆、南京、苏州;灰带是同一熵值上四城的最大到最小,黑线是灰带的平滑均值。(a)随机熵从 1.5 铺到 5.5,峰在 2 到 2.5 附近,南京的峰更靠左、更高。(b)时间无关熵在 1.58 附近最高,再往右迅速下降。(c)出行选择熵的峰靠近 2。来源:原论文 Fig. 3。
随机熵 1.5 和 5.5 换算成车站数,是 2^1.5 ≈ 2.8 和 2^5.5 ≈ 45.3。论文据此说,用户大约访问 3 到 46 个不同车站。四城这条分布的均值约在 2,2² = 4。北京、重庆、苏州的峰约在 2.5,2^2.5 ≈ 5.7,论文说大约 6 个车站;南京则以较高概率落在大约 4 个车站。论文又写,空间上的不可预测性集中在 8 个车站附近,那对应随机熵 3。
时间无关熵的峰在 1.58,2^1.58 ≈ 3.0。论文的读法是:人更可能有效地使用 3 个车站,继续增加车站的人变少。随机熵的峰落在大约 4 到 6 个车站,频率加权之后的有效车站数更靠近 3。多去过的站里,有些几乎不再被使用。
出行选择熵的峰约在 2。均匀选择下,熵为 2 对应大约 4 种起讫。论文原句把这个数量写成约 2 的随机熵次方、大约 4 次出行。无论沿用哪一个上标,被解释的都是大约 4 种车次。分母是这名用户自己的起讫选择。
图 3 支持四城分布同形、南京的随机熵略偏少站。行程顺序留在后面的模体熵里。
把一个月收成一张小图,小图为什么只有十二种?
出行模体(travel motif)在本文里是个人时空图里反复出现的有向小结构,自环保留。自环的来源很具体:上一趟的到达站可以是下一趟的出发站,时间不同,两点仍要分开。只出现一次的车站在提取模体前被去掉。方法节还写,权重小于 1 的边被排除,因为只发生一次的出行可能是偶然出行。若权重就是次数,出现一次的边权重为 1,并不小于 1。正文同时留下这两句,没有再给一个可复核的删除公式。
模体的用途,是替每名用户选一个子序列长度,用来计算模体熵,并把它当作真实熵的近似。表 4 最后一列就是这个长度,M1 为 4,M3 为 16,M12 为 28。正文没有列出从图形数到这些长度的逐步规则。每个用户只归入一种模体,多种模体的组合不单独分类。
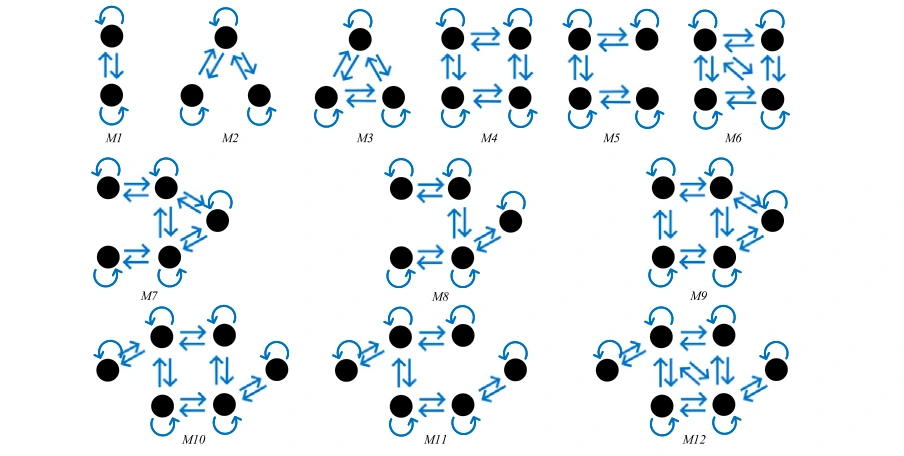
图 4|十二种典型模体各自由哪些站和箭头组成?
图中没有 a、b 子图字母。黑点是车站,蓝箭头是有向联系,多数点上有自环。M1 是上下两个车站对开。M2 和 M3 各有三个车站,M3 的箭头更满。M4 到 M12 的点和箭头继续变密。正文点名的结构是:M6 为四站环,M11 为 6 个节点、5 条连接。其余模体的箭头以图为准。来源:原论文 Fig. 4。
这十二种模体在每座城市都出现,正文说它们覆盖至多 95% 的用户。表 4 的单位是占该城活跃用户的百分比。
| 模体 | 北京 | 重庆 | 南京 | 苏州 | 子序列长度 |
|---|---|---|---|---|---|
| M1 | 29.2 | 30.7 | 28.4 | 30.8 | 4 |
| M2 | 18.6 | 15.1 | 17.0 | 18.2 | 8 |
| M3 | 16.7 | 14.7 | 14.7 | 15.2 | 16 |
| M4 | 9.25 | 8.51 | 9.44 | 8.51 | 12 |
| M5 | 7.91 | 7.45 | 8.45 | 8.56 | 12 |
| M6 | 4.07 | 4.30 | 4.48 | 3.88 | 20 |
| M7 | 3.74 | 3.90 | 4.34 | 3.82 | 20 |
| M8 | 3.59 | 3.50 | 3.85 | 3.61 | 16 |
| M9 | 2.40 | 2.87 | 3.07 | 2.43 | 24 |
| M10 | 1.73 | 1.79 | 1.92 | 1.54 | 24 |
| M11 | 1.56 | 1.71 | 1.62 | 1.27 | 20 |
| M12 | 1.20 | 1.52 | 1.55 | 1.21 | 28 |
十二行相加,北京 99.95%、重庆 96.05%、南京 98.82%、苏州 99.03%。相加时每一项的分母都是 100 个百分点。概括句里的“至多 95%”低于这四个加总,阅读占比时以表中的分项为准。四城的名次几乎相同,只有苏州 M5 的 8.56% 略高于 M4 的 8.51%。
正文概括,大约 30% 的用户在两个固定车站之间活动,大约 17% 在三个固定车站组成的环上活动。和 30% 对齐的是 M1 的 28.4%–30.8%。17% 更接近 M2 的 15.1%–18.6%;M3 是 14.7%–16.7%,后文又把 M3 称作三站环。正文没有把“大约 17%”再指定到 M2 或 M3 的编号上。
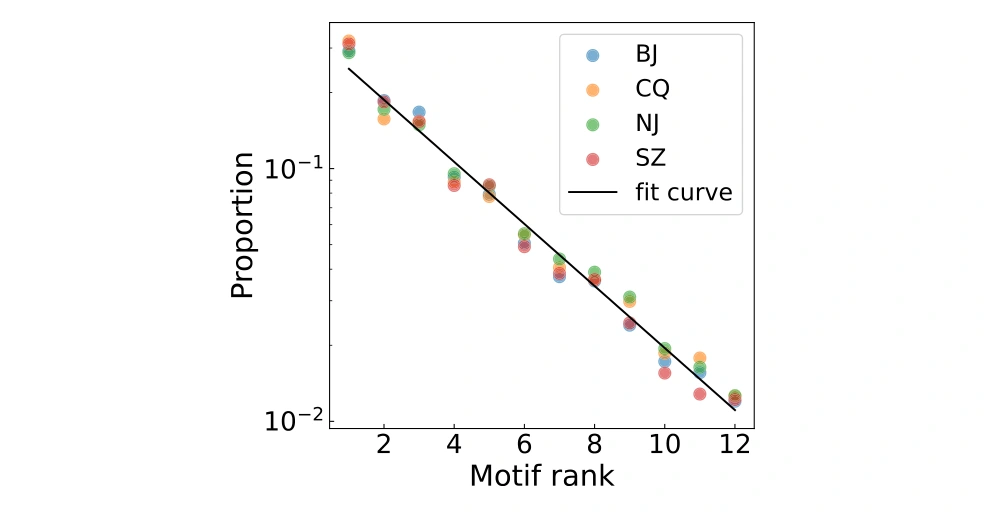
图 5|模体占比怎样随名次下降?
无子图字母。横轴是模体名次 1 到 12,纵轴是占比、对数刻度。四城的点几乎叠在同一条下降线上,第 1 名约在 0.3,第 12 名略高于 0.01,与表 4 的 28.4%–30.8% 和 1.20%–1.55% 相符。图注给出 y = −0.28x + 1.15,R² = 0.9824,并把对数坐标上的直线读成占比随名次指数下降。后文使用的占比以表 4 为准。来源:原论文 Fig. 5。
M1 约占三成,而随机熵等于 1 的用户比例被论文描述为不高。随机熵等于 1 意味着不同车站数正好是 2。模体在提取前去掉只出现一次的车站,随机熵则把这名用户去过的车站都算进 Nᵢ。两套数字的分母都是活跃用户,计入的车站集合不同:M1 量的是反复出现的两站骨架,随机熵把偶尔去过的站也算进去。论文自己的解释是,通勤者还会访问两个通勤站以外的车站。
同一种骨架里,还有多少人完全按一种循环走?
模体熵看的是:按该模体的子序列长度切出行链之后,各种长度为这个值的片段有多集中。熵为 0,表示切出来的片段非常单一。熵为 1,等于 log₂2,论文把它读成两种主模式的频率接近。log₂3 ≈ 1.58 对应三种,2 对应四种。这个 m 是作者用来解释峰位的主模式个数。它和随机熵里 2 的幂次所对应的车站个数,回答的是两件不同的事。
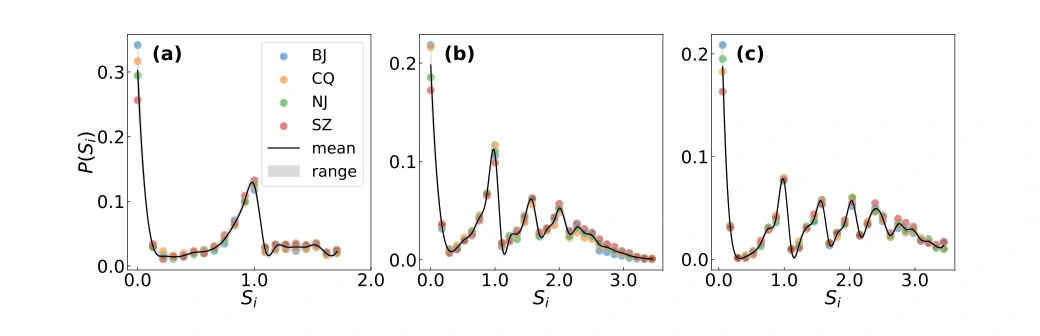
图 6|同一种模体内部,熵是单峰还是多峰?
颜色和图 3 相同,灰带仍是四城在该熵值上的最大到最小。(a)M3,横轴到 2;0 处的峰顶在 0.3 一线,1 附近的峰高于 0.1。(b)M6,0 处顶到 0.2,1 附近略高于 0.1,更高熵处还有更小的峰。(c)M11,0 处接近 0.2,1 之后继续有若干小峰。四城曲线的起伏位置一致。来源:原论文 Fig. 6。
正文的概括以组内用户为分母。M3 里大约 30% 严格走三站环,大约 15% 再带一个附加模体,与图 6a 在 0 和 1 附近的峰同量级。M6 里大约 20% 严格走四站环,大约 6% 多一个模体,大约 5% 多两个模体。0 处大约 20% 与图 6b 的轴顶一致;1 附近的峰按纵轴看略高于 0.1,高于正文写的大约 6%。M11 里大约 18% 在 6 个节点、5 条连接上活动,多一个、两个、三个模体的大约是 6%、5% 和 5%。这些百分比是正文概括,图上没有逐点标出。
30% 的分母是 M3 这一组。北京 M3 占活跃用户 16.7%,组内大约 30% 乘回去,大约相当于全体活跃用户的 5%。30% 本身是大约,这个 5% 只表示量级。
其余九种模体的熵分布写在补充材料中。正文的概括是:结构越复杂,熵越分散,四城波动几乎相同。下文的峰高只来自正文已经画出的 M3、M6、M11 和全体分布。
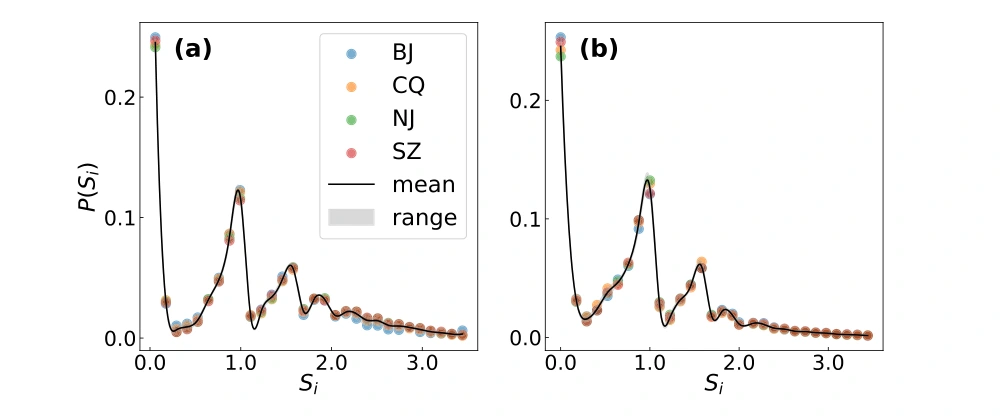
图 7|全体用户的模体熵,和“各长度里最规则的那个熵”像不像?
(a)按每人所属模体算出的熵。0 处最高,图上超过 0.25;1 附近是第二个主峰,再往后峰谷差变小。(b)对每名用户在不同子序列长度上计算熵,取最小值。0 和 1 两处的峰还在,高熵一侧更平。来源:原论文 Fig. 7。
图 7b 被用来支持模体长度是一个可用的近似:它和按模体计算的分布像。论文没有给出两条分布的距离或相关系数。“像”是图上的判断。熵越高,峰和谷越接近,人越难被收成一种稳定循环。高熵用户在四城都存在,只是占比低。
偏好返回模型,复现的是哪一层规律?
个人模型要接上两件事:人会回到自己常去的站,又不会让最早去过的站永远累积优势。论文把下一站选在第 r 个地点的概率写成到访次数除以这名用户全部到访次数,fᵣ = mᵣ / Σ mᵣ。到访很不均匀时,这个频率随秩近似成齐夫关系 fᵣ ∼ r^(−ζ)。同一组“不同车站数 Nᵢ 相同”的用户共用一个 ζ。
| 不同车站数 | 北京 | 重庆 | 南京 | 苏州 | 平均 |
|---|---|---|---|---|---|
| 2 | 1.63 | 1.52 | 1.71 | 1.77 | 1.66 |
| 3 | 1.71 | 1.73 | 1.83 | 1.83 | 1.76 |
| 4 | 1.44 | 1.49 | 1.6 | 1.59 | 1.53 |
| 5 | 1.35 | 1.34 | 1.43 | 1.40 | 1.38 |
| 6 | 1.28 | 1.24 | 1.32 | 1.33 | 1.29 |
平均列是四城并列之后的平均值,论文没有按活跃用户数加权。ζ 在 3 个车站时最高,平均 1.76;到 6 个车站降到 1.29。2 个车站的平均 1.66,低于 3 个车站。论文的总判断是:模体更简单的用户更依赖历史到访,模体更复杂的用户依赖更弱。表只报到 6 个车站。图 8a 的横轴延伸到 20 以上,更多车站的用户没有对应的 ζ。
偏好在每次移动后更新,用来抵消旧地点的累积优势。正文用文字说明了这一步,没有再给一个独立公式。
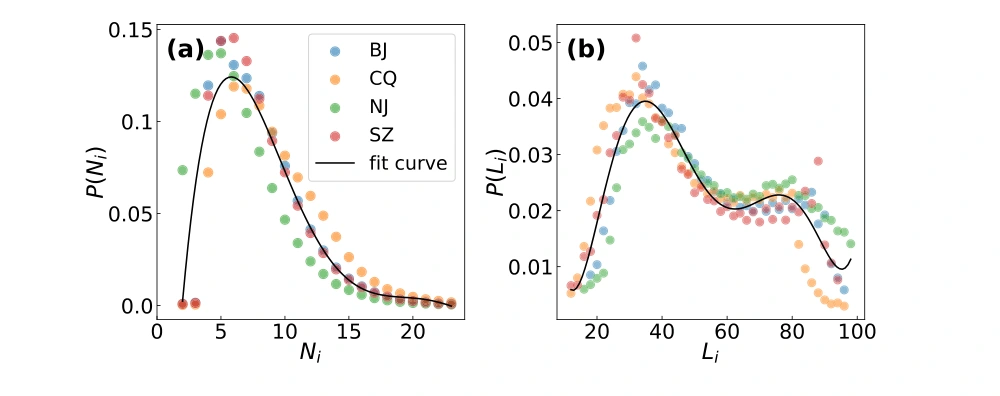
图 8|模拟之前,车站数和出行链长度本身如何分布?
(a)不同车站个数 Nᵢ。四城都在大约 5 到 8 个车站处最高,纵轴大约 0.12 到 0.15;重庆的点往更大的车站数延伸更远,南京下降更快。黑线是五次多项式,R² = 0.9684。(b)出行链长度 Lᵢ。主峰大约在 30 到 40,概率约 0.04;70 到 90 附近还有一个较低的平台。六次多项式的 R² = 0.9042,曲线在接近 100 时再次抬头,这段抬头更像多项式的形状。来源:原论文 Fig. 8。
论文写图 8a 与图 3a 相似。一条横轴是车站个数,另一条是车站个数的以 2 为底对数。图 8a 的高点在大约 5 到 8 个车站,图 3a 的高点在熵大约 2 到 2.5,换算成大约 4 到 6 个车站。两者都是“少数人只去两站、多数人集中在数个车站”。
模拟把三样东西直接取自经验分布:按图 8a 分配不同车站数,按图 5 的指数占比分配初始模体链,按图 8b 抽取链长。车站的地理坐标不进入模型,模型记录的是去过几种站、每种去了多少次。
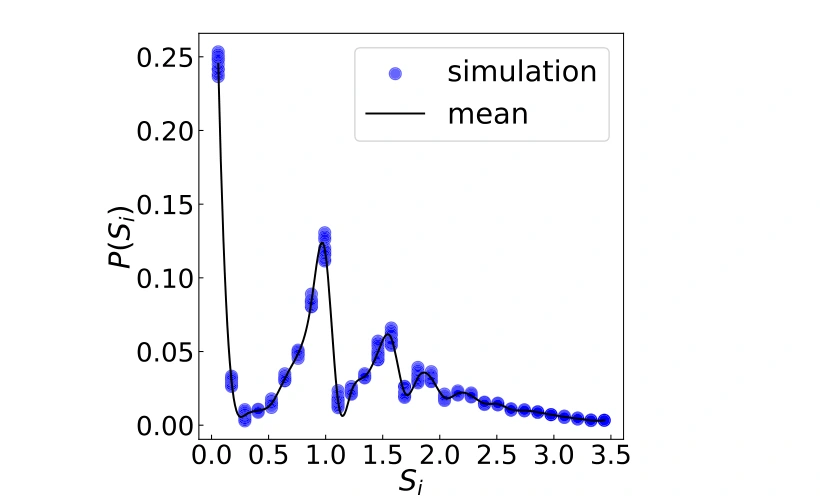
图 9|100 万名模拟用户的熵,峰落在哪里?
无子图字母。蓝点是模拟,黑线是均值。图上 0 处约 0.25,1 附近约 0.13,1.5 到 1.6 之间约 0.06,之后下降。来源:原论文 Fig. 9。
这三个位置对应 0、1 和 log₂3,与图 7 的前几个峰同址。论文写特征熵值的比例与观察数据接近,没有报告分布距离、相关系数或分城误差。初始链已经按观察到的模体占比放进模型。图 9 说明的是:在车站数、模体占比和链长都照经验分布给定之后,偏好返回还能把熵的峰留在这些位置。M1 为何约占三成,在这套模拟里是初始条件。
相似可以说到哪一步?
四城曲线接近,比较的是各自活跃用户内部的分布形状。观察窗相差半年,工作日数量从 17 天到 20 天,线网从 93 站到 293 站。分布相似发生在这些差异已经存在的时候。论文没有做同一批人在新线开通前后的对照。四城模体占比接近时,线网规模的差异已经同时存在。
样本停在地铁闸机里。步行、公交、驾车和小汽车接驳都不在序列中。一名用户的两站模体,可能只是他地铁部分的骨架。
活跃用户排除了少于 15 次和多于 300 次的人。低频乘客和被怀疑为工作人员的极端高频乘客,都不参与熵的峰。引言里北京地铁占偏好通勤方式 52%、公共交通出行 71% 的句子,没有给出由这批刷卡计算的过程。表 3 报告的是记录数、票卡用户和活跃用户。
每人只保留一种模体。熵分布上的第二、第三个峰,是作者对“还有别的主模式”的读法。
数据可用性声明写的是 “No data was used for the research described in the article.” 正文明确使用了四城自动售检票数据。声明和正文对不上,PDF 里也没有附上可复算的记录。
讨论列出的后续方向包括:四座城市对稳健性不够,时间序列可以改成动态监测,指标还可以纳入更多社会和拓扑统计,空间距离尚未进入模型。这些是作者标明的未做事项。
一句话总结
在每月 15 到 300 次的地铁活跃用户里,四座线网很不相同的城市仍然共享接近的模体占比和熵分布;偏好返回模型在吃进这些分布之后,把熵峰留在 0、1 和 log₂3。线网规模与模体占比的关系,停留在四城横截面的同时出现。
核心来源
- Chaos, Solitons and Fractals 正式页面,卷期为 191 (2025) 115916。正文图 1–9 与表 1–5 均来自这一版本。
- 论文写明补充材料可在同一 DOI 获取。除 M3、M6、M11 和全体用户外的分模体熵分布,只在正文中被概括,不在这 9 页 PDF 内。
作者介绍
以下只写论文署名、贡献说明和论文里能够核对的机构信息。
- Shixin Chang:北京交通大学系统科学学院,以及综合交通运输大数据应用技术交通运输行业重点实验室。贡献为调查和撰写初稿。
- Liang Gao:同一学院和重点实验室,通讯作者。贡献为概念、调查、指导和撰写初稿。论文所留邮箱为 lianggao@bjtu.edu.cn。
- Chaoyang Zhang:同时署北京交通大学上述单位,以及葡萄牙阿威罗大学物理系与 I3N。贡献为调查和审阅修改。致谢写明中国留学基金委项目 202207090075 的支持。
- Ting Yu:北京交通大学系统科学学院和上述重点实验室。贡献为调查和审阅修改。
- Xiao Han:署名单位只标到北京交通大学系统科学学院。贡献为验证和审阅修改。
- Bingfeng Si:北京交通大学系统科学学院和上述重点实验室,通讯作者。贡献为调查和撰写初稿。论文所留邮箱为 bfsi@bjtu.edu.cn。
- Jose F.F. Mendes:阿威罗大学物理系与 I3N,通讯作者。贡献为概念和审阅修改。参考文献中与 S. N. Dorogovtsev 合著的 The Nature of Complex Networks(牛津大学出版社,2022)也使用这一姓名。论文所留邮箱为 jfmendes@ua.pt。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要检验“线网变了,出行骨架变不变”,同一城市、同一批卡在新线开通前后的模体占比,比四座城市的横截面更直接。比较时可以继续用本文的活跃用户门槛作基线:开通后仍然每月 15 到 300 次的人,M1 是否还在 30% 附近;同时单列开通后才进入这个门槛的人。横截面里的相似,给这个前后比较提供了一个待检验的数字。
另一组值得单列的人,是每月少于 15 次、因而没有进入熵分布的乘客。运营上更难安排的往往是这批人,而本文的峰主要由反复出行的人贡献。把同一月份、同一城市里 2 到 14 次的用户,按他们实际出现过的车站数和起讫种类,与活跃用户的图 3 并排,就能看出“好猜”在多大程度上来自样本门槛。这个对照不需要先假定他们也会落入 M1。