没有这座城市的历史人流,只靠地理信息,能生成早高峰的格子流量吗?
论文名片|Jifu Guo、Shengguang Bai、Xun Li、Kai Xian、Erjian Liu、Wenting Ding、Xizhi Ma,A universal geography neural network for mobility flow prediction in planning scenarios,Computer-Aided Civil and Infrastructure Engineering,2025,40(29):5769–5789。DOI:10.1111/mice.13398。正文依据这一正式版本;收稿日期 2024 年 6 月 8 日,接收日期 2024 年 12 月 5 日。
规划一张新区时,手里往往先有人口和用地草图,没有去年的起讫流量。多数流量模型要先看见历史人流,再外推下一天;就算改成引力模型,也常常要先拿到每个地方的总流出,再把这些人分到各个目的地。新区恰恰两样都缺。
这项研究训练一个通用地理神经网络(universal geography neural network,UGNN):用其他城市的地理信息和已经发生的人流,学习任意两个 1 公里格子之间、某个小时有多少出行。在 10 座没有参加训练的城市里,它在 7–8 时的格子流量上好于四个对照。这些对照城市是 2019 年已经存在的中国城市,地理、人口和兴趣点都来自真实建成环境。模型复现的是扩样之后的电信出行,还不是一张没有兴趣点的新城蓝图会如何改变人流。
先说结论
- 训练用 26 座城市、测试用 10 座城市,比较的都是 2019 年工作日 7:00–8:00 的跨格子流量。UGNN 在 10 座城市的平均绝对误差都低于该城市其余四个模型中的最低值。相对这个最低基线,降幅从无锡的 (1.17−0.95)/1.17 ≈ 18.8% 到天津的 (0.92−0.60)/0.92 ≈ 34.8%。分母是该城市最好对照的平均绝对误差,不是全天总出行。
- 同样这 10 座城市,UGNN 的流量重叠比例 CPC 为 0.53–0.67。上海是 0.55,Deep Gravity 是 0.31,引力模型是 0.09。引力模型在表 5 的皮尔逊相关系数一列记为 0.00,精度写到 0.01。
- 7 时的出行距离分布上,UGNN 更贴近真实曲线的近距离高峰和随后的下降。引力模型与 Deep Gravity 的地图更暗,作者认为它们把大流量起讫对生成少了。
- 上海全天 24 小时里,生成流量和真实流量都在早、晚高峰抬高小时份额。500 米、1 公里、2 公里三档格子上,沪、深、杭的 CPC 仍在同一量级,但并不是格子越大每一项指标都更好。
- 对上海中心一处居住区的 1000 条起讫对做特征解释,路径距离、地表距离和目的地工作人口的影响最大。把重要特征挪动其取值全距的万分之一后,预测的平均变化与上海测试误差处于同一量级,路径距离对应的变化为 1.50,上海相对真实流量的平均绝对误差为 0.99。
规划要的是生成,历史数据外推够不到
已有研究大多做流量预测:用过去的序列估计未来。雄安、巴西利亚、昌迪加尔这类新建或在建地区,作者用来说明另一种任务:真实流量还拿不到,能用的是估计人口和规划用地。这时要直接生成起讫矩阵(origin–destination matrix),也就是任意两个地点之间的出行次数。
传统做法常分成两步。先估计每个地区的流入和流出,再把这些总量拆成两两之间的流量。引力模型把流量写成起点产生量、终点吸引量和距离的幂:
fᵢⱼ = α₀ × Pᵢ 的 α₁ 次方 × Aⱼ 的 α₂ 次方 ÷ dᵢⱼ 的 α₃ 次方。
它需要数据来定这四个参数,也很难从兴趣点、建筑和道路里再挖出非线性关系。Deep Gravity 用全连接网络估计每个起点前往各目的地的概率,仍是在分配流量,而不是为每一对地点单独给出次数。图神经网络则要为整座城市建图。规划人员有时只想看一块新区改了用地之后的变化,现有模型却往往得把全市重新算一遍。
UGNN 把任务收成一次回归:给定一座城市在某个小时的格子特征、格子对特征和城市特征,直接输出这一对格子的出行次数。格子是不重叠的 1000 米 × 1000 米,时间按出发小时分成 24 段。全市格子对不一次放进内存,而是逐对生成。
36 座城市里,被预测的流量是什么口径?
流量来自中国电信 2019 年全年、36 座城市的手机数据。电信公司先从处理后的信令得到出行,再按小时统计格子之间的次数。只保留城内出行,城际出行被去掉,因为城内和跨城的方式不同。起点格子与终点格子相同的出行也去掉,这些行程短,而且难测。因此后文所有误差都只针对跨格子流量,不能还原一个人的全部活动,也不能推出跨城联系。
这 36 座城市的电信市场份额在 15% 到 25% 之间。作者按各城市场份额把流量放大,希望接近全体居民。各城的具体份额没有列出,所以平均绝对误差处在放大后的人次上。若某城份额是 20%,原始计数大约被乘以 5;文中没有给出可以逐城复核的乘数。
周末、周一和周五受周末影响,公休日也被去掉。最后只留周二、周三、周四,共 133 个典型工作日,再对工作日同一小时、同一对格子求平均。模型学的是这一年平均小时流量,不是某一天的突发拥堵,也不含作者假定影响较小的恶劣天气和节庆。
人口分居住人口和工作人口,同样来自中国电信,格子尺度与流量一致。兴趣点与兴趣面来自百度地图,按规划用地手工分成 23 类和 19 类:兴趣点计个数,兴趣面计面积。建筑轮廓用底面积乘高度后对格子求和,用来补兴趣面只有占地、没有高度的缺口。夜间灯光来自 Earth Observation Group,按光斑面积加权平均到 1 公里格子。道路长度、最近地铁站和公交站的直线距离来自 OpenStreetMap。
格子对还有三项成本:两格中心的地表距离、沿路网的最短距离,以及按限速估算的最短时间。路网节点是交叉口,格子中心先连到最近交叉口,这段连接的限速被定为 10 公里/小时。作者没有加入拥堵,也没有把格子之间的行驶时间单独再算一遍,理由是新城往往没有这些观测。建成区外把 5×5 个格子并成一个大格子来算距离,因为远离中心的路网精度没那么关键。
建成区用 DBSCAN 从建筑轮廓里划出。搜索距离 1500 米,建筑占地超过 30,000 平方米的格子作为起始点,聚类结果再向外扩 1000 米。图 1 用北京说明这件事,北京在后文属于训练城市。
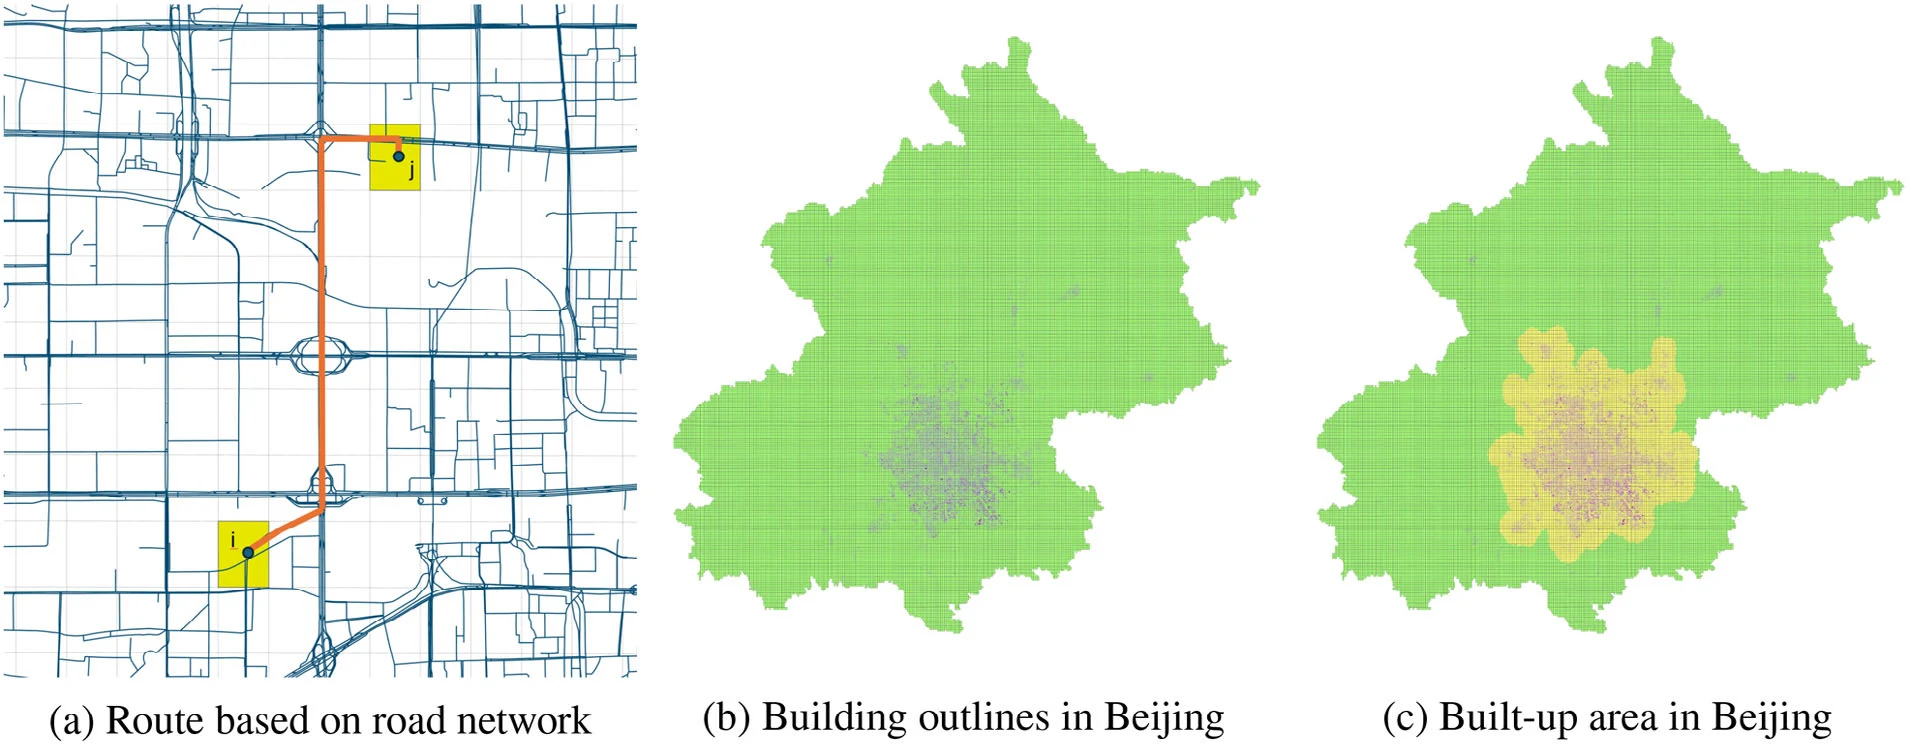
图 1|距离和建成区在送进模型之前怎样被定义?
(a)蓝色为路网,黄色格子中心 i、j 连到最近交叉口,橙色为两点间的最短路。地表距离是另一项特征,不在这条橙线上。(b)北京建筑轮廓落在 500 米格子上,深浅表示建筑聚集。(c)同一范围经 DBSCAN 标出的建成区为黄色,并包含建成区外 1000 米内的格子。来源:原论文 Fig. 1。
城市级特征使用 2019 年的统计:GDP、总人口、总面积、行政区域几何中心的经纬度,以及建成区面积,来自政府网站。再加上出发时段。表 3 写外部特征共 8 项,正文点名的城市统计和时段并没有把 8 项逐一命名。
表 4 的表题写着还包括网格数量,印出的列只有人口、建成区面积和日总出行量。正文把人口称为建成区内人口。日总出行量是放大后的工作日总量,单位是百万次每天。训练城从徐州 638 万次到北京 5272 万次;测试城从呼和浩特 654 万次到上海 6153 万次。苏州建成区 2447 平方公里、人口 399 万、日流量 1236 万次,面积大于不少人口更多的城市。这里按表 4 原文转述。各城格子数没有出现在印出的表里。
26 座训练城市是北京、广州、成都、南京、郑州、宁波、佛山、东莞、合肥、长沙、青岛、苏州、厦门、济南、沈阳、大连、昆明、长春、温州、石家庄、贵阳、南昌、常州、哈尔滨、乌鲁木齐、徐州。10 座测试城市是上海、深圳、杭州、武汉、天津、无锡、福州、南宁、兰州、呼和浩特。划分按政府报告中的城市等级,并要求每个等级至少有一座测试城。论文没有逐城写出等级,也没有把雄安放进测试集。测试城被当作规划阶段的替身,是因为模型没有用它们的流量做训练,它们的用地和人口仍然是 2019 年已经存在的。
一个格子对怎样变成一个出行次数?
格子特征分成两路,因为兴趣点和兴趣面更稀疏。除去这两类,每个格子还有 7 项地理信息。模型取目标格子周围 3×3 的格子,拼成 7×3×3 的小块;兴趣点与兴趣面则拼成 42×3×3。起点和终点各走一套结构相同、参数分开的网络:两层卷积,核大小为 2、步长为 1,维度 256 和 128,后面再接两层 128 维的全连接。每层后有批归一化和 Leaky ReLU。
三项格子对特征进入 64 维全连接,八项外部特征进入另一路 64 维全连接。起点的地理向量和用地向量先拼在一起,经两层 128 维网络压缩;终点同样处理。然后把起点、终点、格子对和城市四段接起来,送入六层全连接,维度依次为 512、512、256、256、128、128,最后一层输出这一对格子的出行次数。
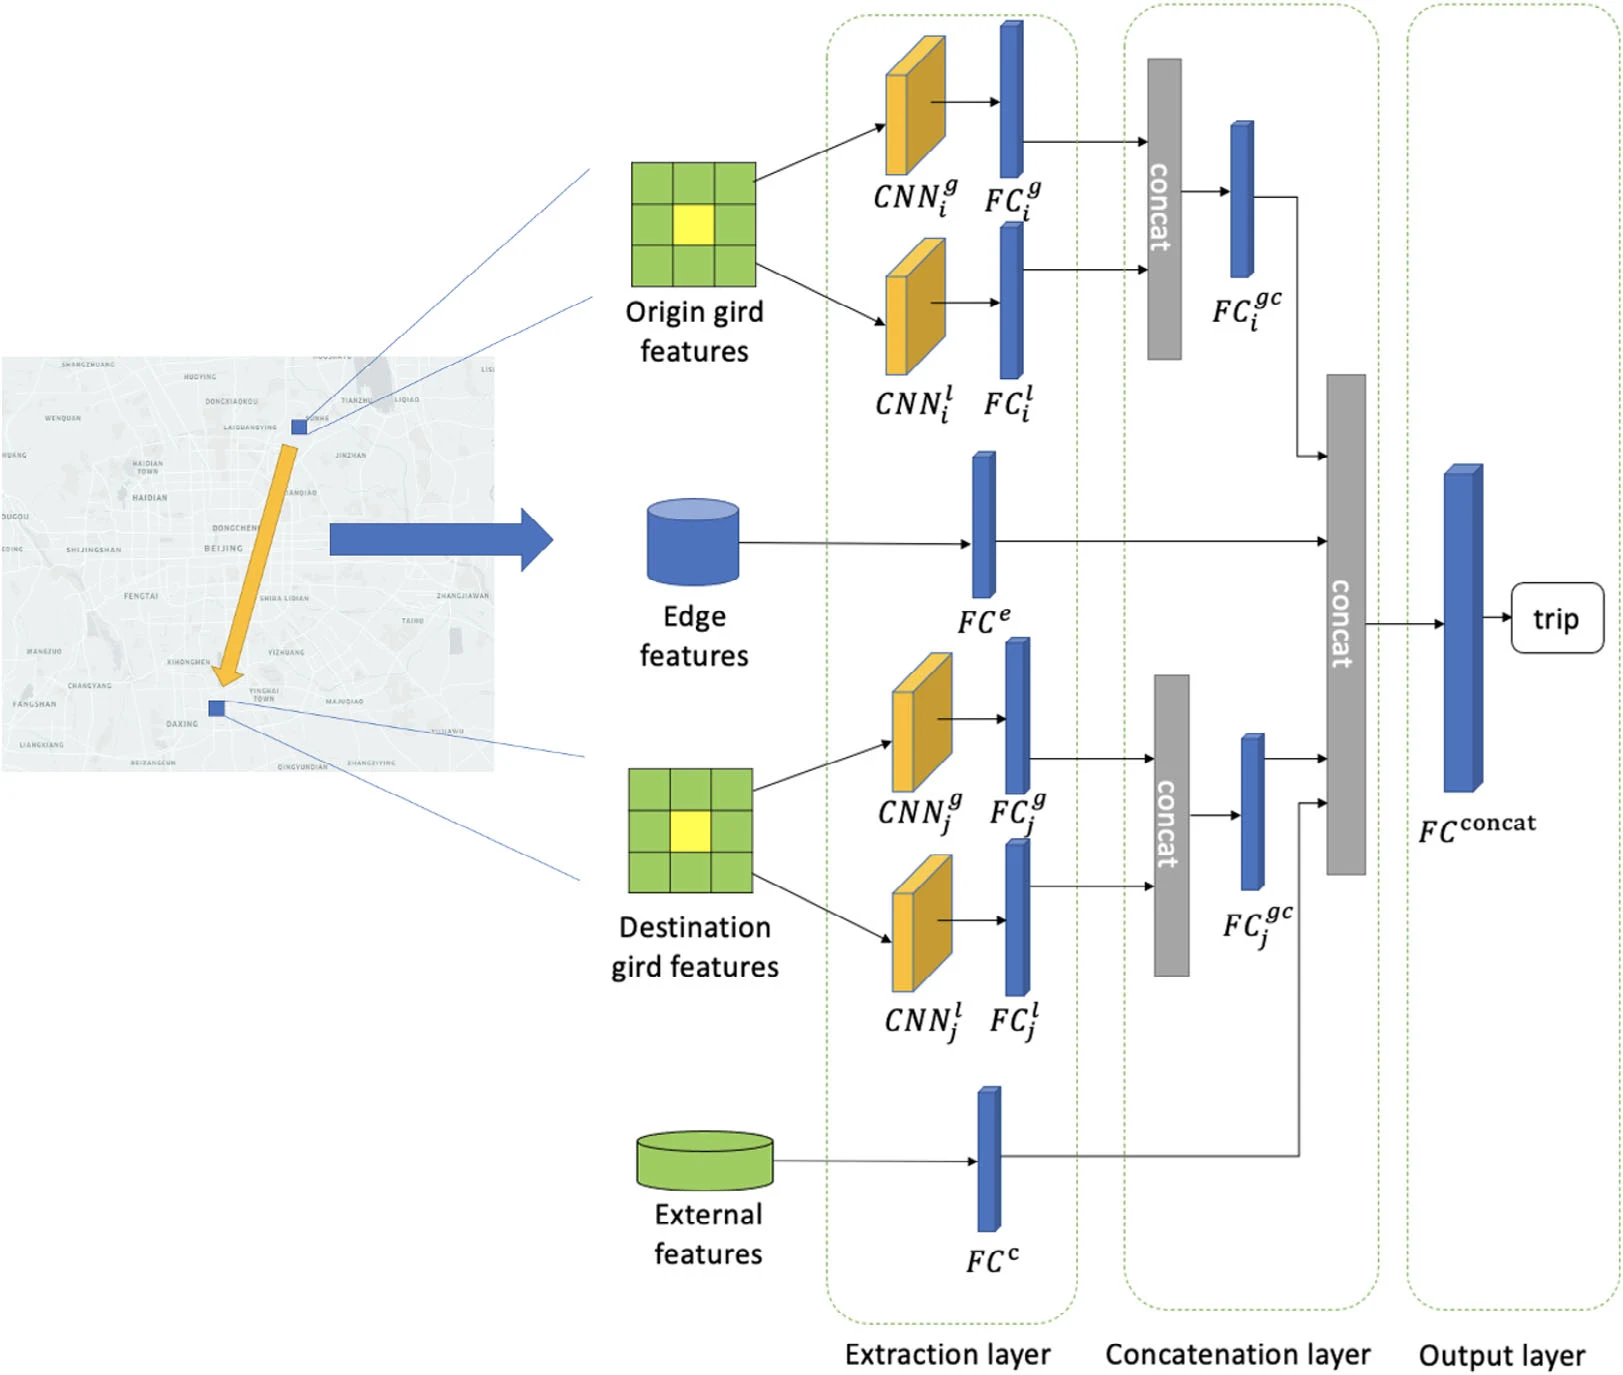
图 2|一次预测用到哪些输入,又在哪一层汇合?
无字母子图。左侧示意一条格子对及其周围格子,图中把 grid 印成了 gird。中间提取层把起点、终点的地理与用地小块、格子对特征和外部特征分别编码;拼接层再把四路合在一起;输出层给出这一对格子在该小时的出行次数,而不是一组加总为 1 的概率。来源:原论文 Fig. 2。
这个设计和 Deep Gravity 的差别在于,各起讫对互不归一。作者的理由是 1 公里格子上的位置和流量都有偏差,若强制同一个起点的流量加总等于某个总量,一对格子的误差会改写所有共享该起点的预测。代价是:改一块用地之后,模型不会自动把全市其他流量重新分配;各对预测加总,也不保证等于该格子的规划岗位或居住人口。3×3 邻域能看见紧邻格子的用地,看不见更远目的地之间的竞争。
训练在 26 座城市内部再切分。格子按 90% 和 10% 分成训练与验证,起讫对跟着起点格子走。0 到 1 次的起讫对占多数,每 3 个训练轮次只重新抽取其中 20%,超过 1 次的全部保留。外部特征每次加上均值 0、标准差 0.01 的噪声,避免记住某座城市的精确 GDP。权重初始为均值 0、标准差 0.01 的正态,偏置为 0。UGNN 训练 50 轮,Adam 的两个 beta 为 0.9 和 0.999,批大小 2048,学习率 5×10⁻⁵,损失是平均绝对误差。机器是一张 RTX 3090。最终采用验证误差最低的那一轮。
平均绝对误差的分母是 n(n−1),n 为该城格子数,只加总 i 与 j 不同的格子对:
MAE = 1/(n(n−1)) × Σᵢ Σⱼ≠ᵢ |fᵢⱼ − f′ᵢⱼ|。
大量接近 0 的格子对会把这个平均值压低。均方根误差使用同一个分母,再对平方误差开方,因此大流量上的偏差更显眼。后文上海的 MAE 可以是 0.99,RMSE 仍有 11.20,两件事同时成立。
四个对照使用同一训练切分、同一抽样和同一个随机种子。引力模型只用起点产生量、终点吸引量和地表距离,四个参数用深度学习拟合 5 轮,学习率 10⁻³,初值来自均值 0.5、标准差 0.1 的正态。测试时假定每个格子的产生量和吸引量已经 100% 正确,并让生成的总流出等于真实总流出。学到的参数是 α₀ = 71.3847,α₁ = 0.4561,α₂ = 0.4222,α₃ = 1.4396,距离的幂大约是 1.44。
XGBoost 把全部特征拉成一条向量,用平均绝对误差和 0.1 的学习率训练。Deep Gravity 换成本文的格子与格子对特征,结构仍是 15 层全连接:前 6 层 256 维,后 9 层 128 维,dropout 为 0.35。它训练 30 轮,损失是交叉熵,优化器为 RMSProp,动量 0.9,学习率 10⁻⁵。每个起点最多抽 512 个终点。输出是概率,再乘以真实人口得到次数。论文写明,这等于假定上一阶段的人口完全正确,只考察当前这一步的分配。
GraphSAGE 把每座城市建成一张大图,格子是节点,相邻格子连边,三层维度为 1024、1024、512,格子对和城市特征的全连接与 UGNN 相同。它不是 UGNN 的逐对卷积。
主比较有一个不对称:对照模型不分小时,只学习和生成 7:00–8:00。UGNN 在全部小时上训练,测试时只输出这一个小时。因此 UGNN 多看见了其他小时的流量。后文的优势不能单独记成网络层数。
10 座没训练过的城市,7 时到 8 时差多少?
测试指标有五个。MAE 和 RMSE 越接近 0 越好。结构相似性指数(structural similarity index,SSIM)把流量矩阵当成图像,用 10×10 的窗口逐格滑动,窗口内比较均值、方差和协方差,再对所有窗口取平均;论文把式中的 α、β、γ 都设为 1。通勤者共同部分(common part of commuters,CPC)沿用 Deep Gravity 的名字,这里算的是该小时全部跨格子出行的重叠,并不只含通勤。皮尔逊相关系数(Pearson correlation coefficient,PCC)衡量两套流量的线性相关。SSIM、CPC、PCC 越接近 1 越好。
式(16)在 1/(N(N−1)) 之后,又写下两倍的逐对较小值之和,除以真实流量与生成流量之和。若再除以全部格子对的个数,CPC 会变成接近 0 的数。表 5 的 CPC 却落在 0.53 到 0.67。读表时按重叠比例理解:分子是两倍的重叠流量,分母是真实与生成流量之和。式子前面的 1/(N(N−1)) 与表中量级对不上。
| 测试城市 | UGNN 的 MAE | 其余模型的最低 MAE | 最低 MAE 来自 | UGNN 的 RMSE | SSIM | CPC | PCC |
|---|---|---|---|---|---|---|---|
| 上海 | 0.99 | 1.36 | XGBoost | 11.20 | 0.65 | 0.55 | 0.62 |
| 深圳 | 2.52 | 3.40 | XGBoost | 14.76 | 0.90 | 0.63 | 0.74 |
| 杭州 | 1.01 | 1.32 | XGBoost | 6.71 | 0.99 | 0.62 | 0.72 |
| 武汉 | 1.17 | 1.72 | XGBoost | 18.23 | 0.75 | 0.60 | 0.66 |
| 天津 | 0.60 | 0.92 | XGBoost | 4.08 | 0.98 | 0.64 | 0.72 |
| 无锡 | 0.95 | 1.17 | XGBoost | 4.81 | 0.93 | 0.53 | 0.64 |
| 福州 | 1.14 | 1.59 | XGBoost | 9.26 | 0.93 | 0.60 | 0.67 |
| 南宁 | 1.09 | 1.53 | XGBoost | 9.43 | 0.95 | 0.60 | 0.70 |
| 兰州 | 0.70 | 0.97 | GraphSAGE | 6.41 | 0.88 | 0.63 | 0.76 |
| 呼和浩特 | 1.46 | 2.22 | XGBoost | 7.72 | 0.98 | 0.67 | 0.76 |
表中 MAE、RMSE 的分母都是该城全部跨格子起讫对,数值是放大后的人次。UGNN 的五项都好于同城的四个对照,包括那些已经拿到真实总流出或真实人口的模型。深圳的 MAE 最高,为 2.52,对应的最好对照是 3.40。武汉的 RMSE 仍有 18.23,说明大流量格子对的偏差没有消失。上海的 SSIM 只有 0.65,在 10 城中最低;杭州达到 0.99。CPC 最低是无锡 0.53,最高是呼和浩特 0.67。重叠大约一半到三分之二,剩下的流量仍对不上。
引力模型的 PCC 在 10 座城市都记为 0.00。论文没有解释这一列为何恰好为零。它的 CPC 也很低,上海只有 0.09。在已经对齐总流出的前提下,线性相关仍接近 0,说明次数的排序或空间分配没有跟着真实流量走。
GraphSAGE 在部分城市的 SSIM、CPC、PCC 高于引力模型和 Deep Gravity,但 MAE 常常更大。上海它的 MAE 是 5.03,高于 XGBoost 的 1.36;作者检查预测后认为它能大致摆出流量分布,却把出行次数高估了。原因被归到图太大:在 26 座城的图上训练之后,提取层处理不了测试城的新图。兰州是例外,GraphSAGE 的 MAE 为 0.97,是该城对照里最低的,但 SSIM 只有 0.03。更高的结构分数和更低的绝对误差并不是同一句话。
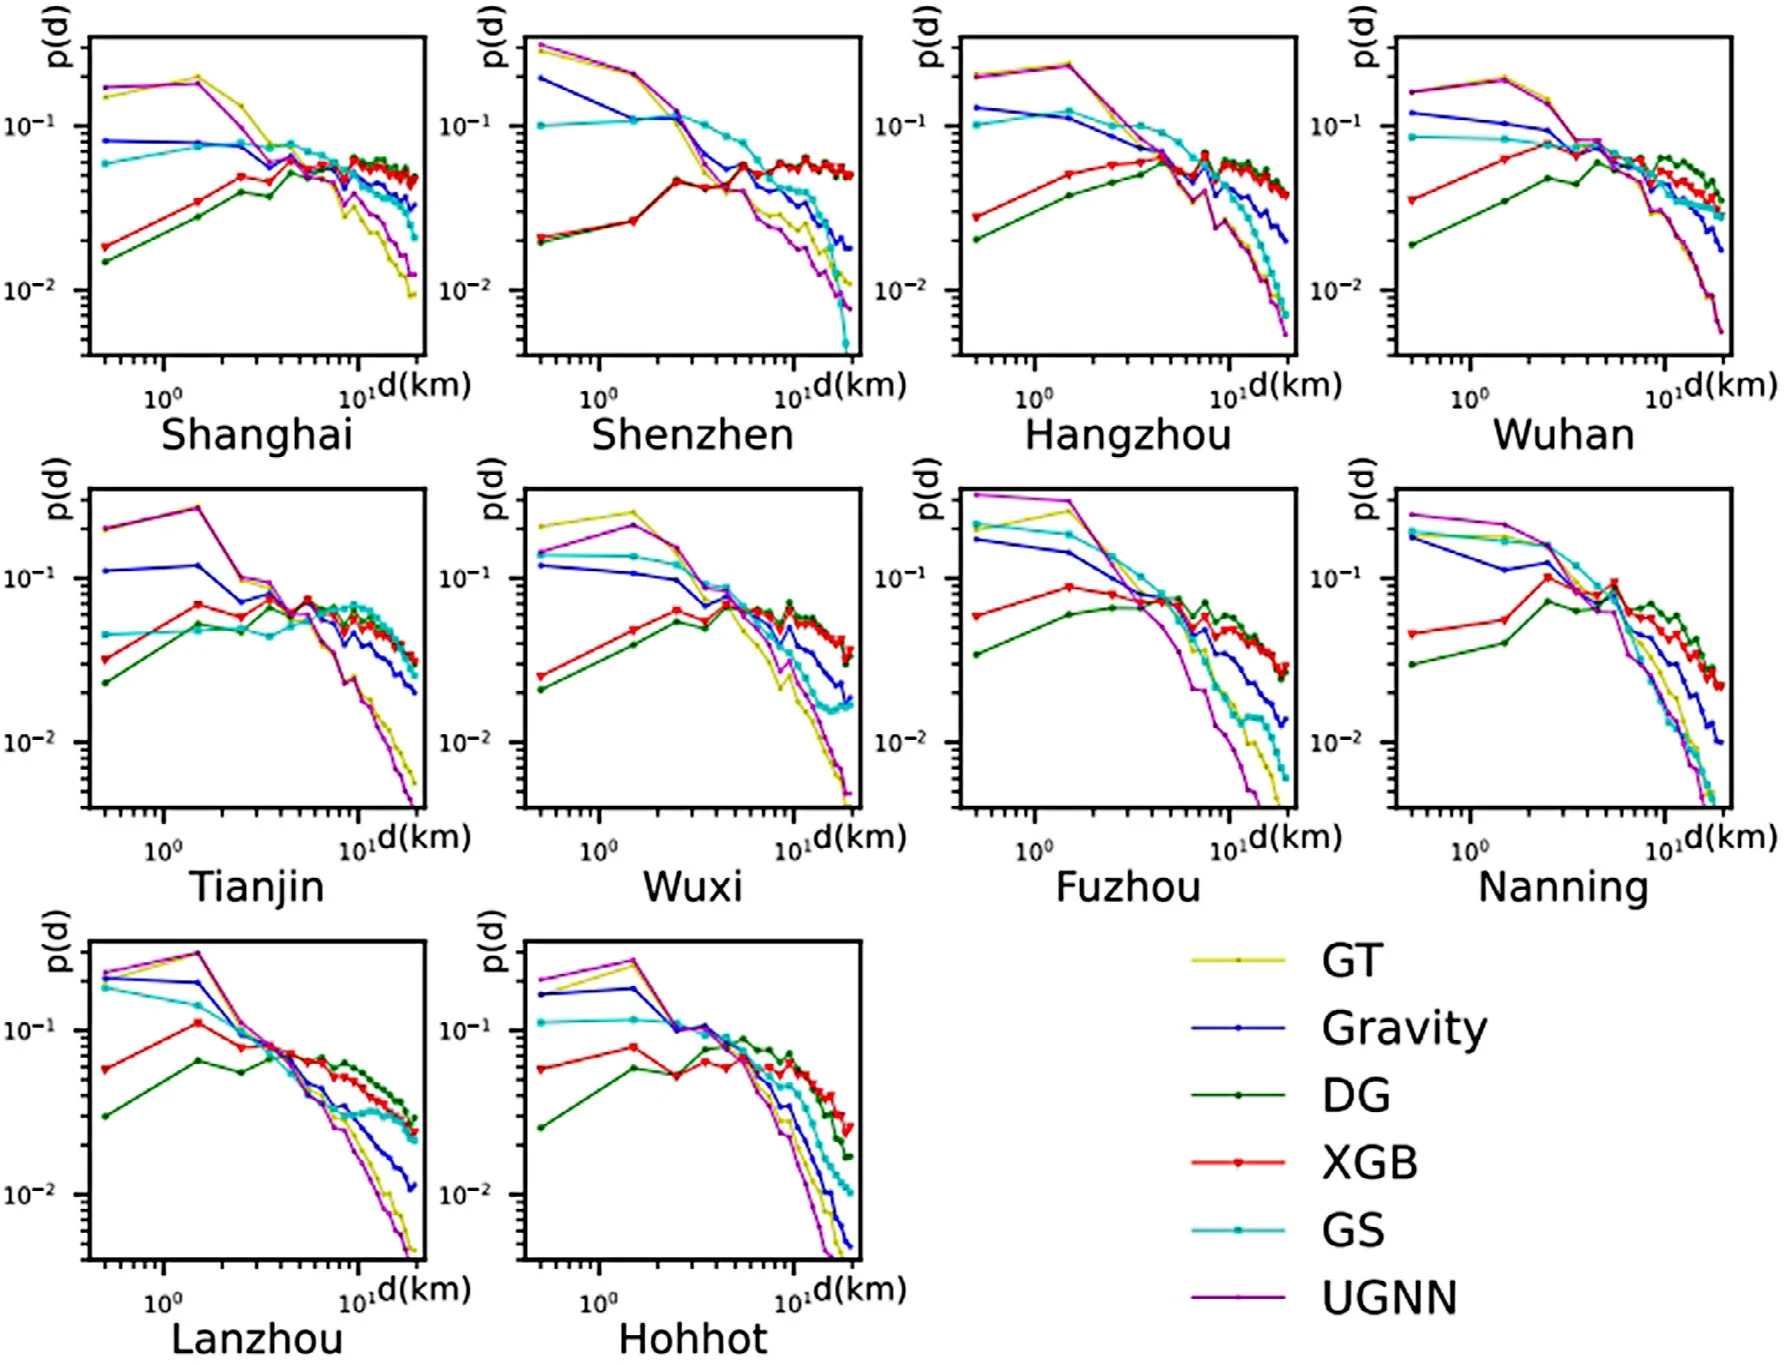
图 3|7 时的出行更集中在近距离,还是被模型摊平了?
无字母子图,十个面板依次为上海、深圳、杭州、武汉、天津、无锡、福州、南宁、兰州、呼和浩特。横轴是地表距离 d,单位公里,刻度在 1 公里和 10 公里;纵轴是该距离段的流量比例 P(d),纵轴为对数。黄线为真实值,蓝线引力模型,绿线 Deep Gravity,红线 XGBoost,青线 GraphSAGE,紫线 UGNN。正文把行程按 1 公里一段分成 20 组,每组比例等于该组流量除以全部组的流量之和。真实曲线和紫线在短距离更高,并随距离下降;红线和绿线往往把短距离压低、把中距离抬高。来源:原论文 Fig. 3。
图 4 只画建成区内、流量处在前 3% 的起讫对,时间仍是 7 时。4.2.1 节点名上海、武汉、兰州和呼和浩特,图中四行却是上海、杭州、无锡和呼和浩特。结论里又写成四座测试城市。表 5 的定量比较覆盖全部 10 座。读地图时以图中的四座为准,读误差时以表 5 为准。
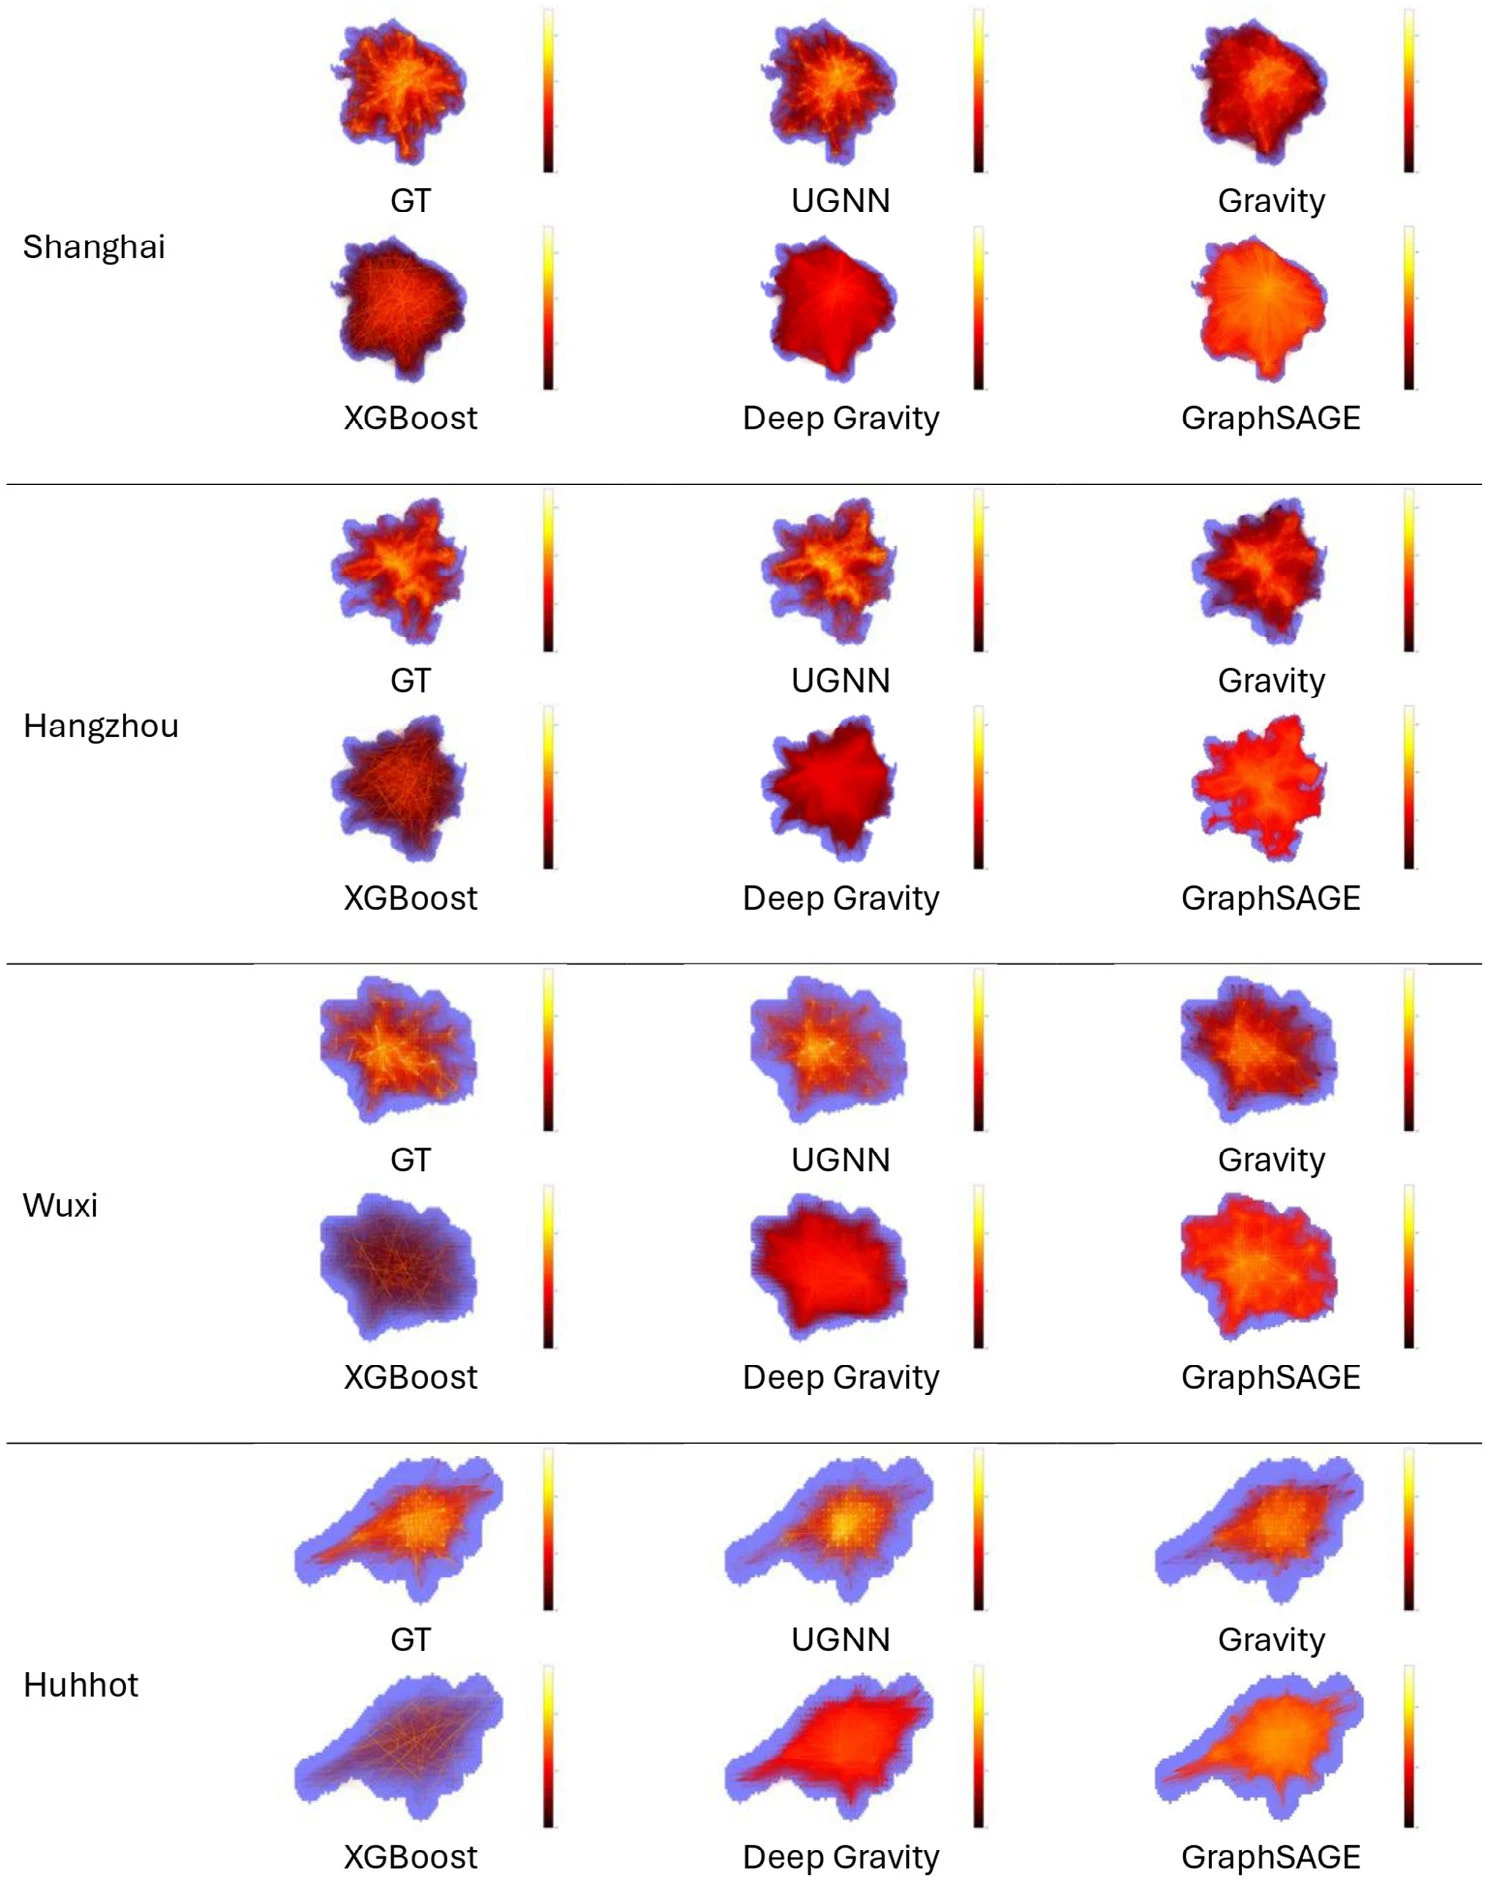
图 4|主要出行走廊能不能在地图上对上?
无字母子图。四行分别为上海、杭州、无锡、呼和浩特;每行六个小图为真实值、UGNN、引力模型、XGBoost、Deep Gravity 和 GraphSAGE。色标上端浅、下端深,图注写浅色流量更大、深色更少,只保留建成区内流量前 3% 的起讫对。UGNN 更接近真实图里亮的走廊;引力模型和 Deep Gravity 整体更暗。这是前 3% 的可视化,不能代替表 5 里全部格子对的误差。来源:原论文 Fig. 4。
换一个小时,或者换一档格子,还保持同样的重叠吗?
小时实验只在上海做,而且不再和四个对照比。UGNN 对每个小时生成流量,再和真实流量算 SSIM、CPC、PCC。图 5 没有逐小时数值表,下面的读数是对照坐标刻度看曲线。
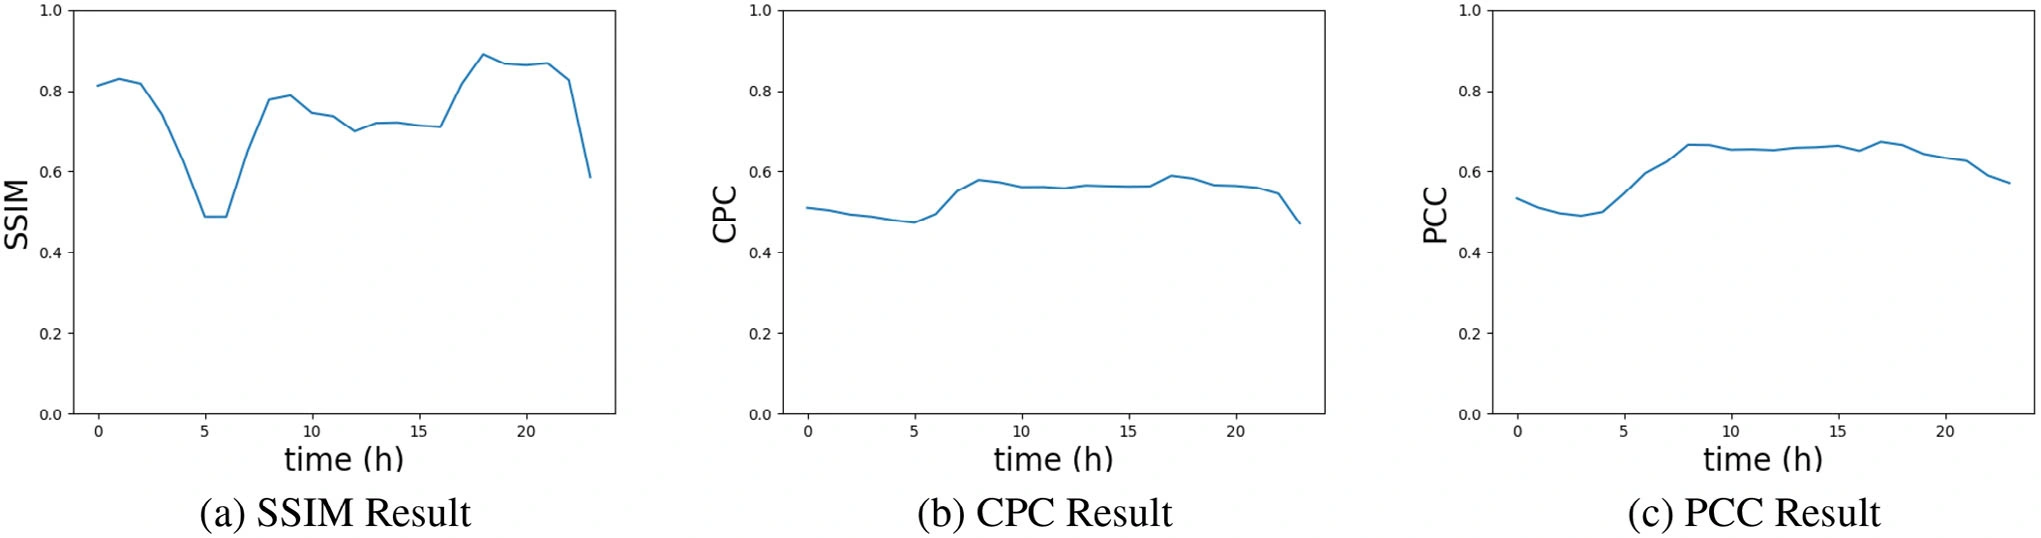
图 5|上海不同小时的生成结果是否一样像?
(a)SSIM,清晨大约 5 时降到 0.5 刻度下方,17 时前后回到 0.8 以上,临近 23 时再下降。(b)CPC 大部分时间位于 0.5 与 0.6 之间,曲线末端略降。(c)PCC 清晨约在 0.5,白天升到 0.6 以上,入夜略回落。三张图的横轴都是出发小时,纵轴都是 0 到 1。来源:原论文 Fig. 5。
重叠比例全天大体停在同一段里,结构相似性却在清晨明显变差。作者写的是各小时相似度保持一致。图 5 支持 CPC 和 PCC 没有大起大落,不支持 SSIM 每个小时都一样。
图 6 把每个小时的出行加总,再除以全天出行,得到小时份额。若 24 小时均匀分配,每小时约为 1/24 ≈ 0.042。
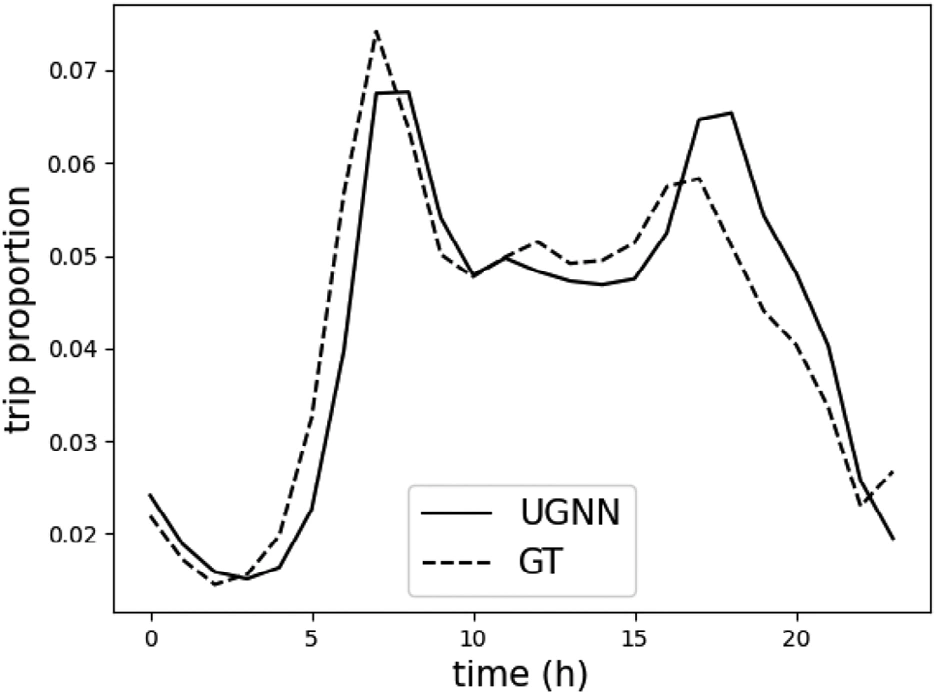
图 6|早高峰和晚高峰的小时份额有没有被生成出来?
无字母子图。横轴为小时,纵轴为该小时出行占全天的比例,刻度从 0.02 到 0.07。实线为 UGNN,虚线为真实值。两者都在大约 7–8 时形成早高峰,真实曲线略高于 0.07 刻度,UGNN 的平台紧贴该刻度下方;午间回到 0.05 上下。晚高峰 UGNN 高于真实虚线。深夜降到 0.02 附近,最右端真实曲线略有上翘,生成曲线继续向下。来源:原论文 Fig. 6。
份额接近,只说明这一小时的总出行量占全天的比例相近。它可以和某一条具体走廊完全走反,只要别的走廊把总量补上。走廊是否同向,要回到图 7。
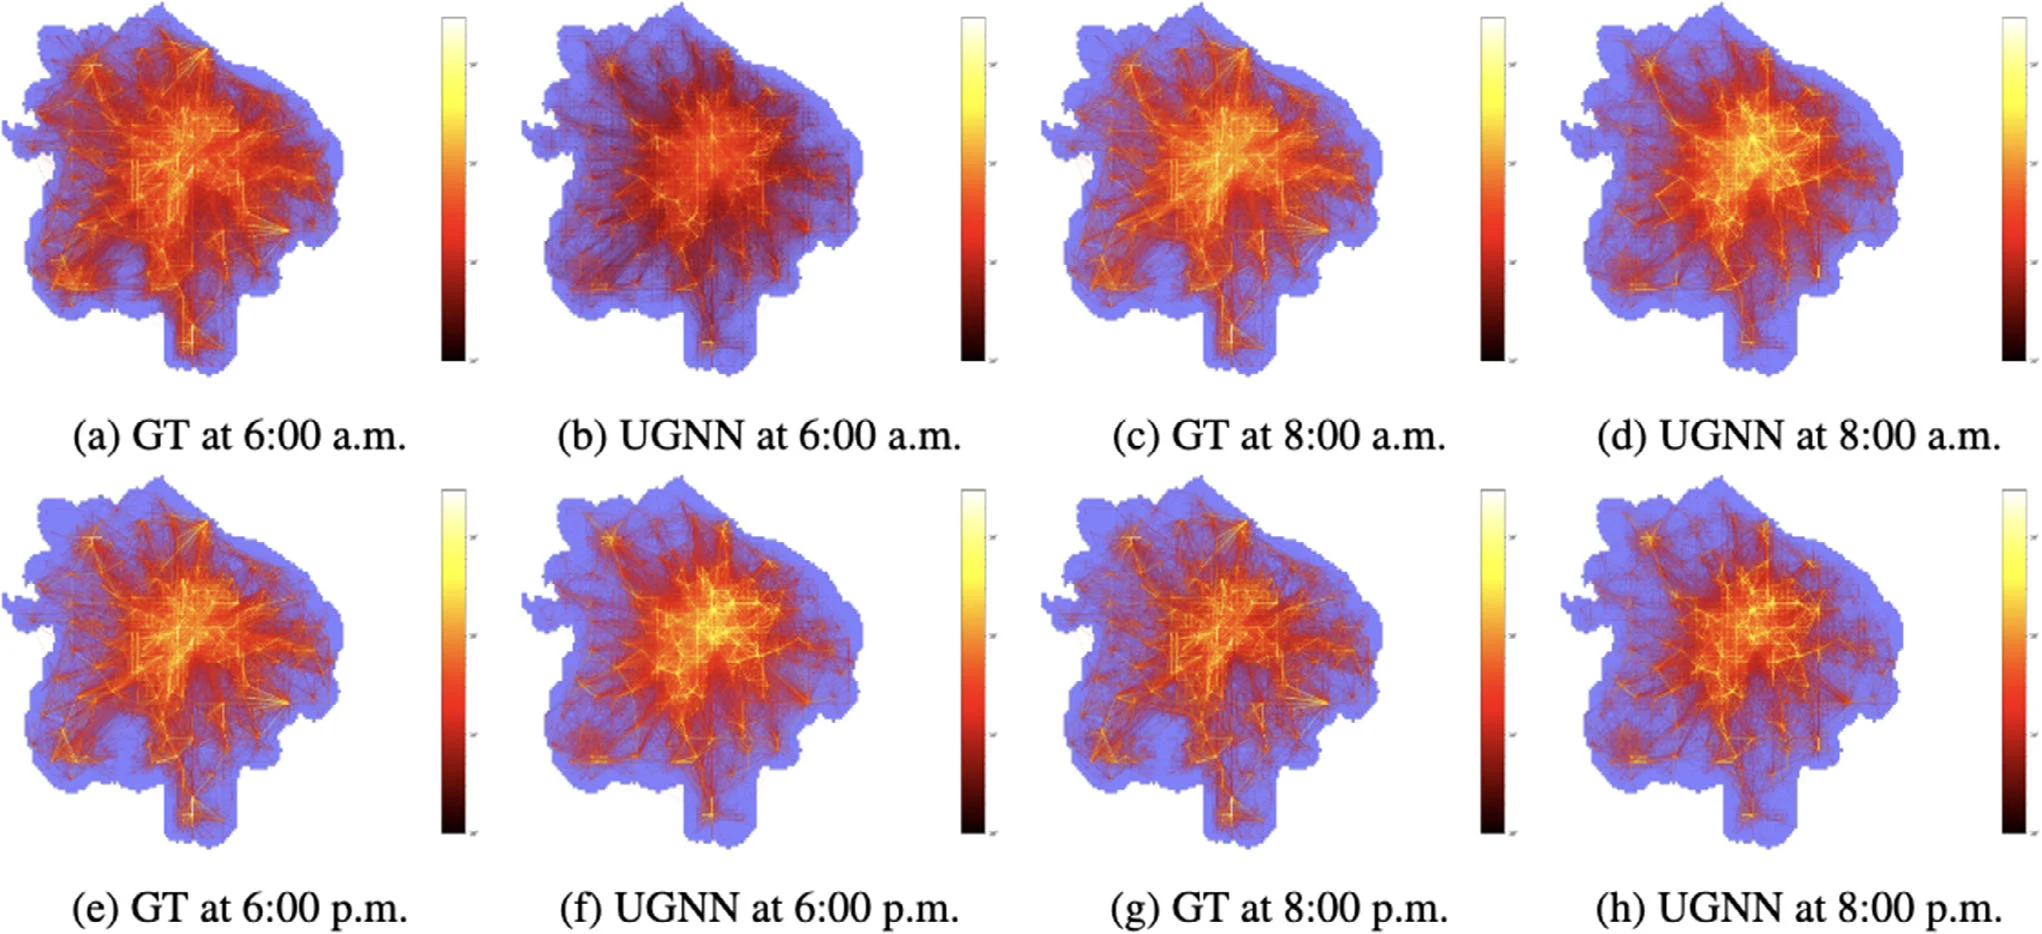
图 7|上海四个时刻的主要流向是否跟着钟点改变?
(a)6:00 真实值,(b)6:00 的 UGNN,(c)8:00 真实值,(d)8:00 的 UGNN,(e)18:00 真实值,(f)18:00 的 UGNN,(g)20:00 真实值,(h)20:00 的 UGNN。色标同样是浅色流量更大。6 时已经有连接外围和中心的亮线,8 时更密。18 时与 20 时的形态彼此接近,也和对应的真实图接近。正文另写到 22–23 时只剩少量返家出行,这四个时刻的图里没有 22 时。正文里的 16:00–7:00 p.m. 与图中的 18:00 对不上,这里按子图标注的钟点阅读。来源:原论文 Fig. 7。
格子尺度实验使用原始的 500 米格子,并汇总到 1000 米和 2000 米,只报告上海、深圳、杭州的 SSIM、CPC、PCC,没有再报 MAE。
| 城市 | 500 米 SSIM / CPC / PCC | 1000 米 SSIM / CPC / PCC | 2000 米 SSIM / CPC / PCC |
|---|---|---|---|
| 上海 | 0.62 / 0.55 / 0.61 | 0.65 / 0.55 / 0.62 | 0.66 / 0.58 / 0.66 |
| 深圳 | 0.91 / 0.58 / 0.70 | 0.90 / 0.63 / 0.74 | 0.98 / 0.67 / 0.76 |
| 杭州 | 0.91 / 0.60 / 0.66 | 0.99 / 0.62 / 0.72 | 0.98 / 0.63 / 0.72 |
1000 米一列与表 5 的 SSIM、CPC、PCC 一致。作者认为格子越大,缺少明确目的的短出行被包进同一格,指标越好。表 6 里 CPC 和 PCC 随格子变大不降,SSIM 却有两处回头:深圳 500 米的 0.91 高于 1000 米的 0.90,杭州 1000 米的 0.99 高于 2000 米的 0.98。变粗之后更好,只在多数格子、多数指标上成立。
哪些信息在推动预测,轻轻改一下会怎样?
特征解释用 SHAP,只取上海中心一处典型居住区发出的 1000 条起讫对。居住、工作等特征先把周围九个格子平均,再计算贡献。因此图 8 是这一片居住区出发流量的解释,不是 36 座城市的平均重要性,也不能直接挪到工业区或新城。
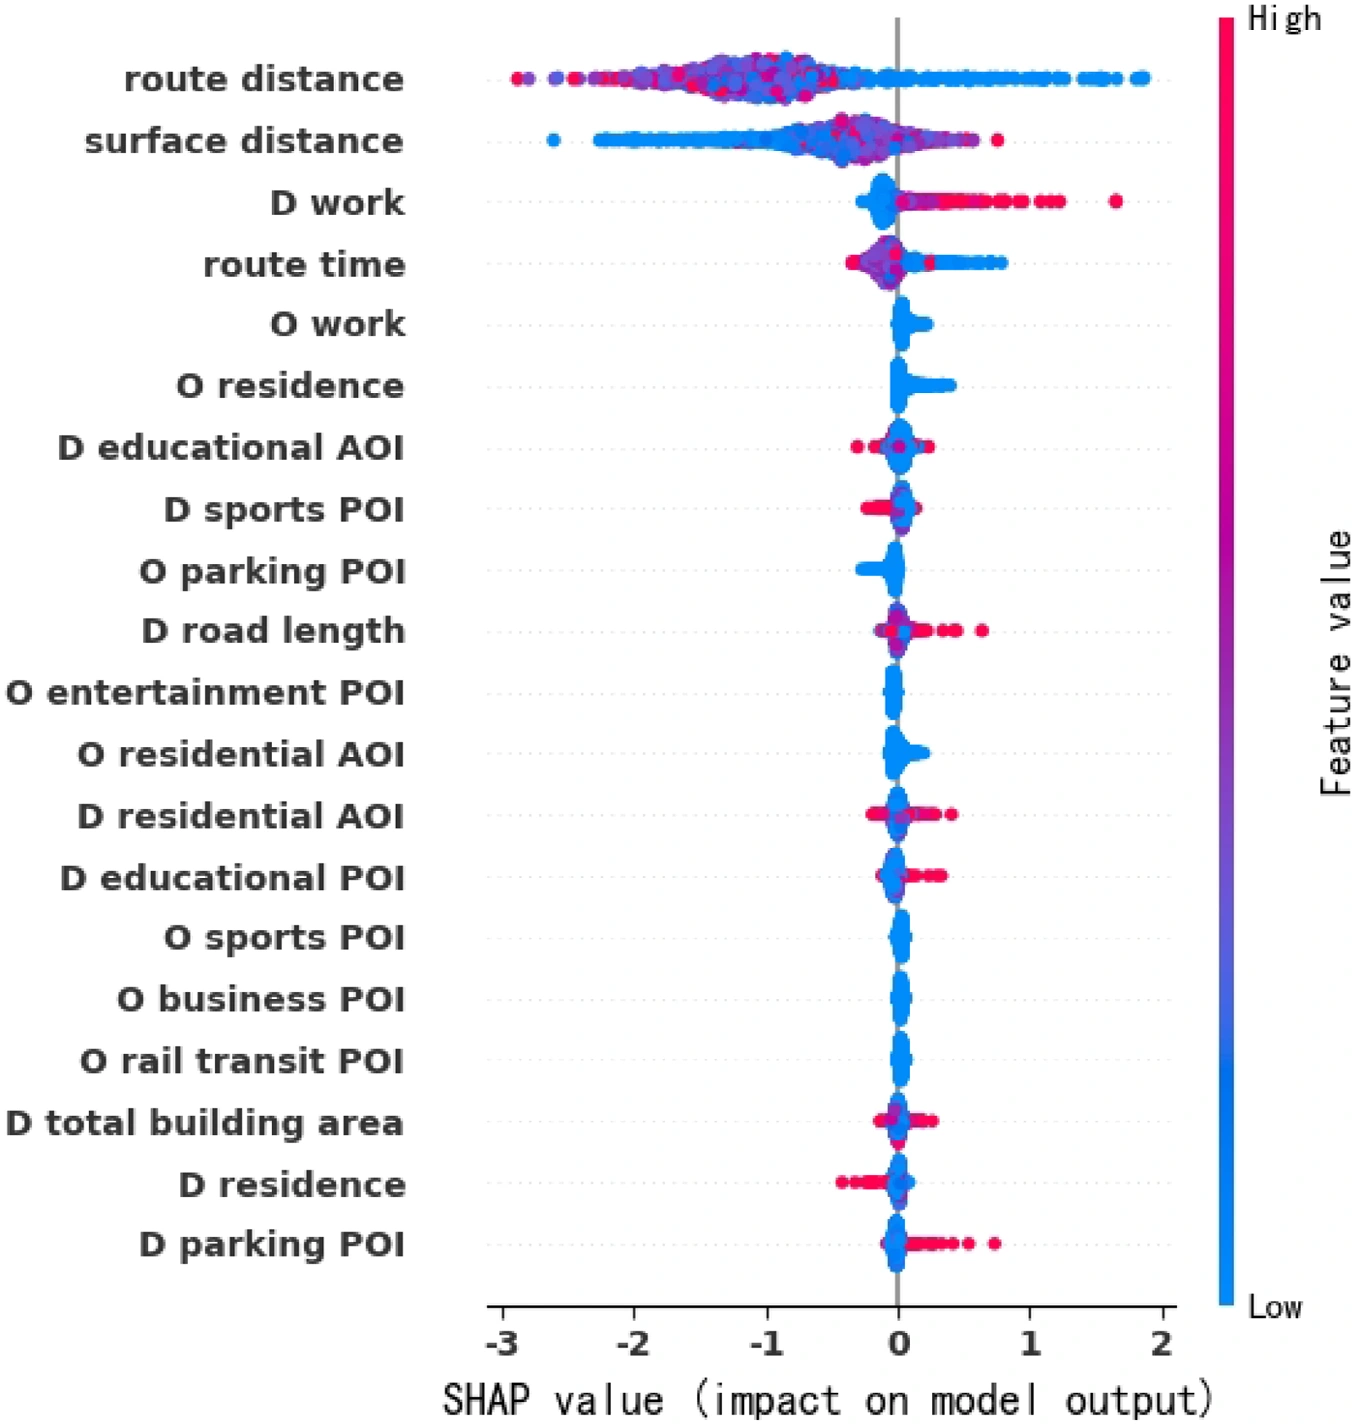
图 8|这一千条居住区出发的起讫对里,哪些特征把预测推高或压低?
无字母子图。每一行是一个特征,点的横向位置是 SHAP 值,纵轴特征按影响排序。颜色从蓝到红表示该特征取值从低到高。路径距离和地表距离的点云横向跨度最大,目的地工作人口次之;起点工作人口、起点居住人口以及教育、体育、娱乐类用地也离开了零线。时间与城市级特征没有出现在这张最相关特征图的前列。正文的概括是边特征影响大,多数特征与流量负相关,也有低取值处呈正相关的情形,并由此推测有人必须到较远的地方工作。颜色相关是模型解释,不是用地改变后的观测实验。来源:原论文 Fig. 8。
敏感性分析仍在上海,每次只改一个重要特征。扰动量 ε 等于该特征最大值减去最小值,再除以 10000。论文没有标注 ε 的单位。改完之后重新预测全部起讫对,用 MAE 比较新旧预测。这里的 MAE 是预测相对预测的平均变化,分母仍是全部跨格子对,对照的是未扰动的 UGNN,不是真实流量。
| 特征 | ε | 相对原预测的 MAE |
|---|---|---|
| 路径距离 | 28.57 | 1.50 |
| 地表距离 | 19.62 | 0.95 |
| 目的地工作人口(表中写 Work) | 2.80 | 1.23 |
| 路径时间 | 0.02 | 0.77 |
| 起点工作人口 | 2.80 | 1.12 |
| 起点居住人口 | 3.31 | 0.98 |
作者据此认为模型经得起微小改动。路径距离引起的 1.50 已经大于上海相对真实流量的 MAE 0.99。平均变化不大,主要因为绝大多数格子对的次数本来就接近 0;这个表没有给出大流量起讫对单独的变化。
数据太大时,作者试过把出行次数直接改成整数。0 到 1 次的起讫对因此变成 0,总出行被压低,平均距离被拉高。后来改为先四舍五入到 0.01,再乘以 100 存储,计算损失时除回 100。这是存储处理,不是一条新的出行规律。
它还不能直接当成规划方案的因果实验
UGNN 在 10 座真实城市上更接近 7–8 时的放大流量,也能跟着小时改变上海的总量份额和主要走廊。证据停在这里。
测试城的兴趣点、建筑和人口都是 2019 年已经存在的。作者在展望里写明,全新地区往往给不出这么细的兴趣点和兴趣面,规划图常常只有一小块用地类型。模型没有做过去掉兴趣点之后的对照实验。
各对预测相互独立,所以一块用地的改变不会在同一次计算里改写所有相关起讫对。图神经网络原则上能连接这些格子,但作者认为上万个格子连成图的内存和时间仍然太大。
流量来自一家运营商的城内、工作日、跨格子平均。市场份额放大假设未观测到的用户与电信用户出行结构相同,这个假设没有另作检验。周一、周五、周末和城际出行都不在目标里。SHAP 只解释了上海一处居住区的 1000 条出发流量。
一句话总结
用其他城市的工作日人流学会地理与流量的对应之后,这套网络能在 10 座没参与训练的城市里,比拿到真实流出量的对照更接近 7–8 时的格子流量;它复现的是已有城市的电信出行结构,还不能代替一张缺少兴趣点的新城方案。
核心来源
- Computer-Aided Civil and Infrastructure Engineering 正式页面,核对题目、作者、卷期、页码与 DOI。正式版本为 2025 年,40(29),5769–5789。
- 本文图 1–8 与表 4–7 的数值均来自这一正式 PDF。文中没有补充材料、数据仓库或代码链接;表题提到的各城网格数也没有印在表 4 的数值列里。
- 对照模型 Deep Gravity 的原始定义见 Simini、Barlacchi、Luca 与 Pappalardo,2021,Nature Communications。本文的 CPC 名称来自那里,实验特征、损失和是否强制分配总流出已经改成作者自己的设置。
作者介绍
七位作者在本论文中的署名机构都是 Beijing Transport Institute,即北京交通发展研究院。论文没有单独的贡献说明。
- Jifu Guo(郭继孚):通讯作者,邮箱 guojf@bjtrc.org.cn。北京市人民政府网站 2024 年称其为北京交通发展研究院院长。2024 年与缐凯、李寻等合作的仿真论文作者简介中,他为博士、教授级高级工程师,研究方向包括交通规划、交通战略、交通管理和智能交通。
- Shengguang Bai(白盛光):署名为北京交通发展研究院。2023 年与郭继孚、李寻发表《基于深度学习的城市交通需求场景库》,讨论城市交通需求场景,与本文的生成任务相连。
- Xun Li(李寻):署名为北京交通发展研究院,并出现在上述 2023 年场景库论文和 2024 年北京交通仿真论文的作者中。
- Kai Xian(缐凯):2024 年《北京交通仿真建模的新技术探索与实践》的作者简介写明,他为北京交通发展研究院正高级工程师、研发中心主任,研究方向为交通需求预测、交通仿真和智能交通。该文已把通用地理神经网络用于出行分布预测。
- Erjian Liu、Wenting Ding、Xizhi Ma:本论文只列出北京交通发展研究院署名,没有另附个人履历。介绍停在论文给出的身份。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若规划图上只有用地类型,没有 23 类兴趣点和 19 类兴趣面,可以直接在这 10 座测试城里做一次掩码:保留距离、人口和道路,去掉兴趣点与兴趣面,看 CPC 从现在的 0.53–0.67 掉到哪里。掉得少,才比较有理由把模型用于资料不全的新区;掉得多,则图 8 里那些靠后的用地特征虽然 SHAP 跨度小,仍可能是城市之间能迁移的关键。这个实验论文没有做。
另一项可以先在测试城里算清的账,是生成流量的加总。把每个起点预测出的全部出行加起来,再除以该格子的工作人口或居住人口,10 座城市会得到 10 组比例。比例若稳定,规划人员至少知道模型隐含的人均出行次数;比例若随城市差出一倍,独立预测在方案比较里就会把就业中心的规模读偏。表 5 的平均绝对误差不会自动暴露这件事,因为接近 0 的格子对主导了平均。