待在同一个地方,就算彼此见过面吗?
论文名片|Ismaïl Saadi、Etienne Côme、Liem Binh Luong Nguyen、Mahdi Zargayouna,An agent-based model for estimating daily face-to-face contact networks in large urban systems,Computers, Environment and Urban Systems,2025,121:102321,2025年7月17日在线发表。收稿日期2024年1月28日,修回2025年5月30日,接受2025年6月10日。DOI:10.1016/j.compenvurbsys.2025.102321。本文依据这一正式发表版;附录 A–E 在同一篇正文内。
工作日早晨,一个人把孩子送到学校,自己再去另一处上班。孩子和同学、老师待在同一所学校;这个人和同事待在同一处工作地点。地图上两个人都“在巴黎”,并不等于他们彼此说过话。地点越大,这种差别越大:一间教室里的人,和一栋有上千人进出的办公楼里的人,不能用同一种办法连成边。
这项研究用法兰西岛一个典型工作日的合成活动日记,先找出谁和谁在同一地点、时间有重叠,再决定哪些重叠留下,成为面对面接触网络。家庭成员按同住关系彼此相连;家庭以外,大部分共现不会变成边。留下的网络能重现接触调查里按年龄、按场景分开的主要结构,但它是模型在外部接触次数约束下的估计,不是当天被观察到的谈话清单。
先说结论
- 合成人口约 1200 万人、520 万户,分布在 1,714,920 个地点上。这些地点来自活动模型,不是调查人员逐一清点的见面场所。
- 家庭以外的候选边要求同一地点且时间重叠;记录的时长是重叠长度,论文称为时长上界。家庭内部则做成完全图,不靠当天的时间重叠来决定。
- 若所有场景用同一个保留比例,工作和教育会被高估,购物、休闲和其他会被低估。因此保留比例按双方活动目的分开,并随地点人数增加而下降。
- 家庭层人均接触为 2.11 次。工作、教育的目标分别设为每人 6.68 次和 3.26 次,等于 2.11 乘以法国接触调查给出的倍数 3.17 和 1.55。全网络人均每天 10 次是外部设定,不是从这批日记里数出来的。
- 把 25%、50%、75% 的人改为在家工作后,每天接触很多的人变少。沿接触边向外走 7 步时,基线已覆盖 77% 的地理单元;从 25% 再提高到 75%,这一覆盖只从 0.56 降到 0.50。
先有活动,才有可比较的共现
研究对象是法国法兰西岛一个典型工作日。区域面积 12,011 平方公里,含 8 个省、1,296 个市镇。人口超过 1 万的市镇再划成 IRIS 统计小区。2015 年 1 月普查时,人口约 12,082,144,密度约每平方公里 1,005 人,分母是上述面积。
作者没有重新做一次出行调查,而是调用 Hörl 与 Balac 的开放活动模型 EQASIM。活动模型(activity-based model)先安排一个人当天要完成的活动,再从相邻活动推出出行。它和标题里的个体模型不是同一个词:个体模型把每个人当作一个节点;EQASIM 负责给这些节点一张活动–出行日记。
合成人口约 1200 万人,编入约 520 万户。用这两个约数相除,户均略高于 2 人;2.11 的家庭接触稍后会回到这个量级,但 2.11 不是户均人数。输入分成四类。普查提供年龄、性别、职业、就业、居住地、收入、户规模和汽车保有,正文写样本大约覆盖全部家庭的 30%,附录写人口子集为三分之一。工作和教育的起讫矩阵给到市镇尺度。行为来自家庭出行调查:正文称为 2010 年法国全国家庭出行调查,约 18,000 户,只记录 5 岁及以上者前一天的出行,区域最多分成约 100 个地带,起终点落到 100 米网格。讨论部分又把日记来源写成可公开的 ENTD 2008,或需申请的 EGT 2010。图 1 的输入框同时写着 RP 2015、EGT 2010/ENTD 和 BPE。因此,人口是 2015 年的,行为是 2008 或 2010 年前后的,论文没有把这两套年份合成同一天的观测。
地点由地址库 BD-TOPO、企业库 SIRENE 和设施库 BPE 拼到坐标。工作地点靠企业地址,教育和其他活动靠设施。地点有多细,直接决定后面会不会把整座楼里的人误当成彼此见过面。
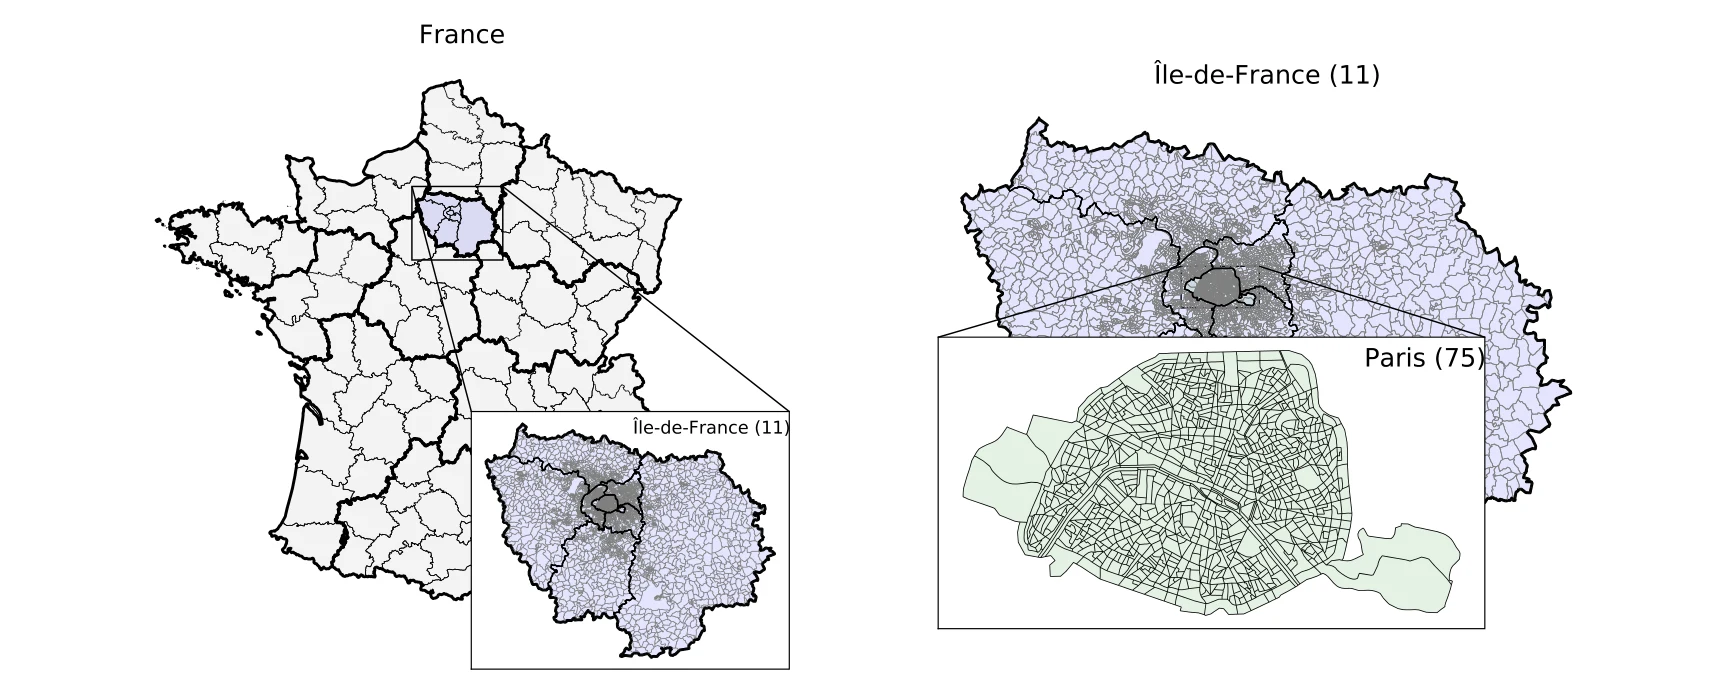
图 4|接触网络准备在哪一块地方上生成?
无字母子图。左图是法国,浅色标出区域代码 11 的法兰西岛,下方放大显示省和市镇。右图是法兰西岛,深色是巴黎及紧邻建成区,下方放大到省代码 75 的巴黎,细线密到统计小区。这张图只说明空间单元,没有出行量或接触次数。来源:原论文 Fig. 4。
表 C.2 给出活动地点数量。合计 3,109 + 1,368,177 + 47,584 + 182,780 + 38,317 + 74,953 = 1,714,920,与摘要中的地点总数一致。
| 地点类型 | 数量 | 占 1,714,920 的比例 |
|---|---|---|
| 住宅 | 1,368,177 | 79.8% |
| 其他 | 182,780 | 10.7% |
| 工作 | 74,953 | 4.4% |
| 休闲 | 47,584 | 2.8% |
| 购物 | 38,317 | 2.2% |
| 教育 | 3,109 | 0.18% |
住宅占将近八成。教育地点只有 3,109 个,不到地点总数的 0.2%,但后面教育层的年龄结构仍然很清楚,因为边是按人的活动目的计,不是按地点个数计。
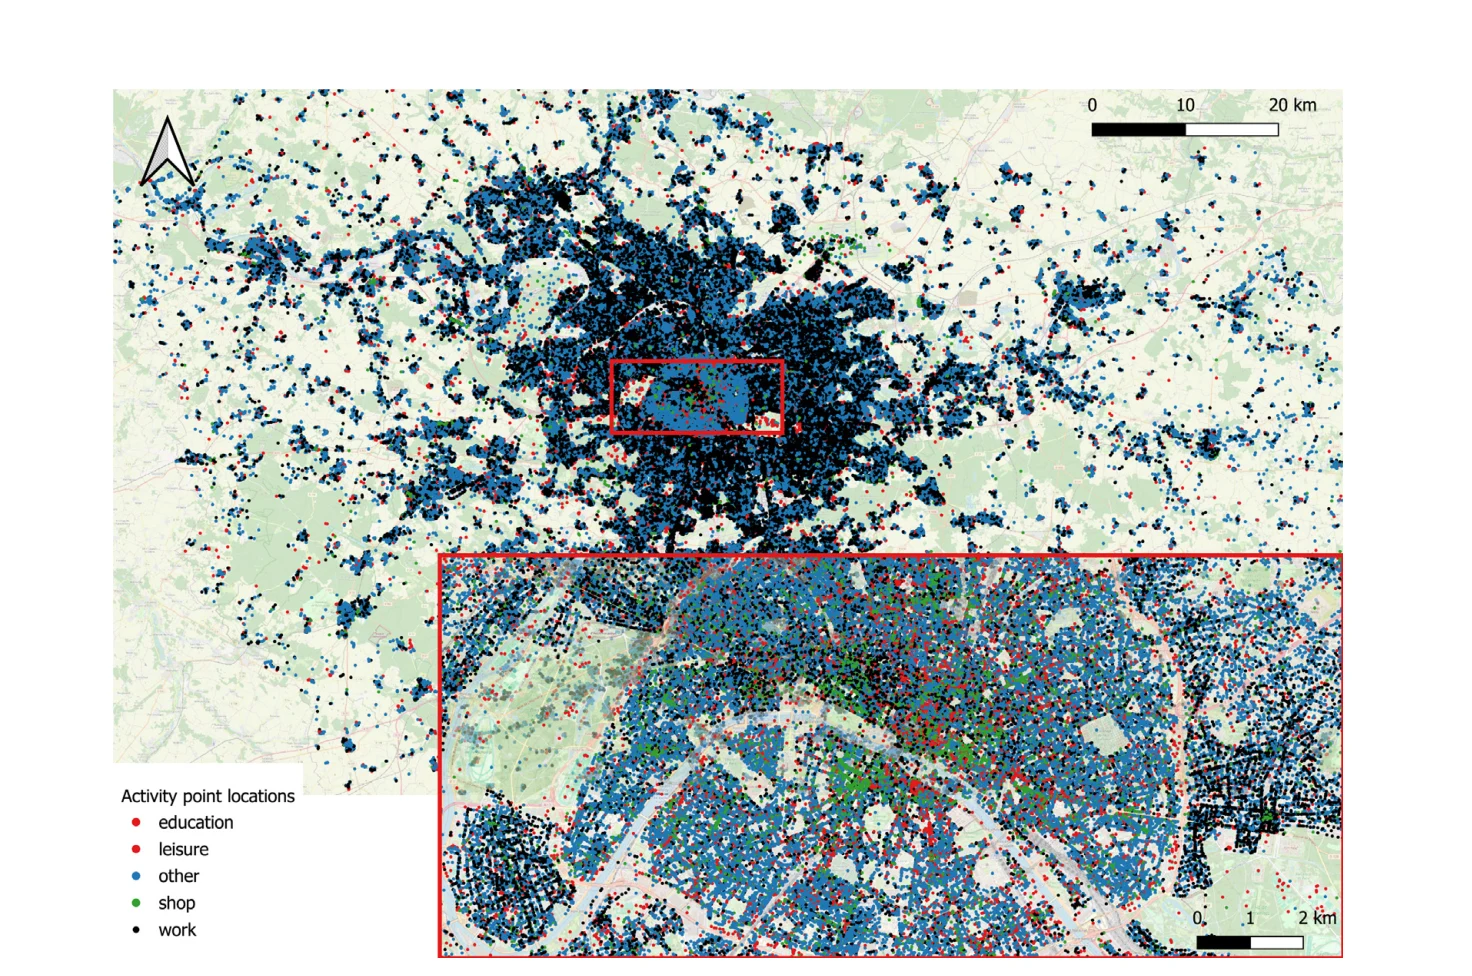
图 10|这些地点在地图上挤在哪里?
无字母子图。点表示活动地点:教育为红,休闲为绿,其他为蓝,购物为青绿,工作为黑。主图标尺 0–20 公里,红框放大后的标尺为 0–2 公里。点在巴黎及近郊最密。图例没有住宅。住宅虽占地点清单的 79.8%,这张散点不能用来数家里有多少人。来源:原论文 Fig. C.10。
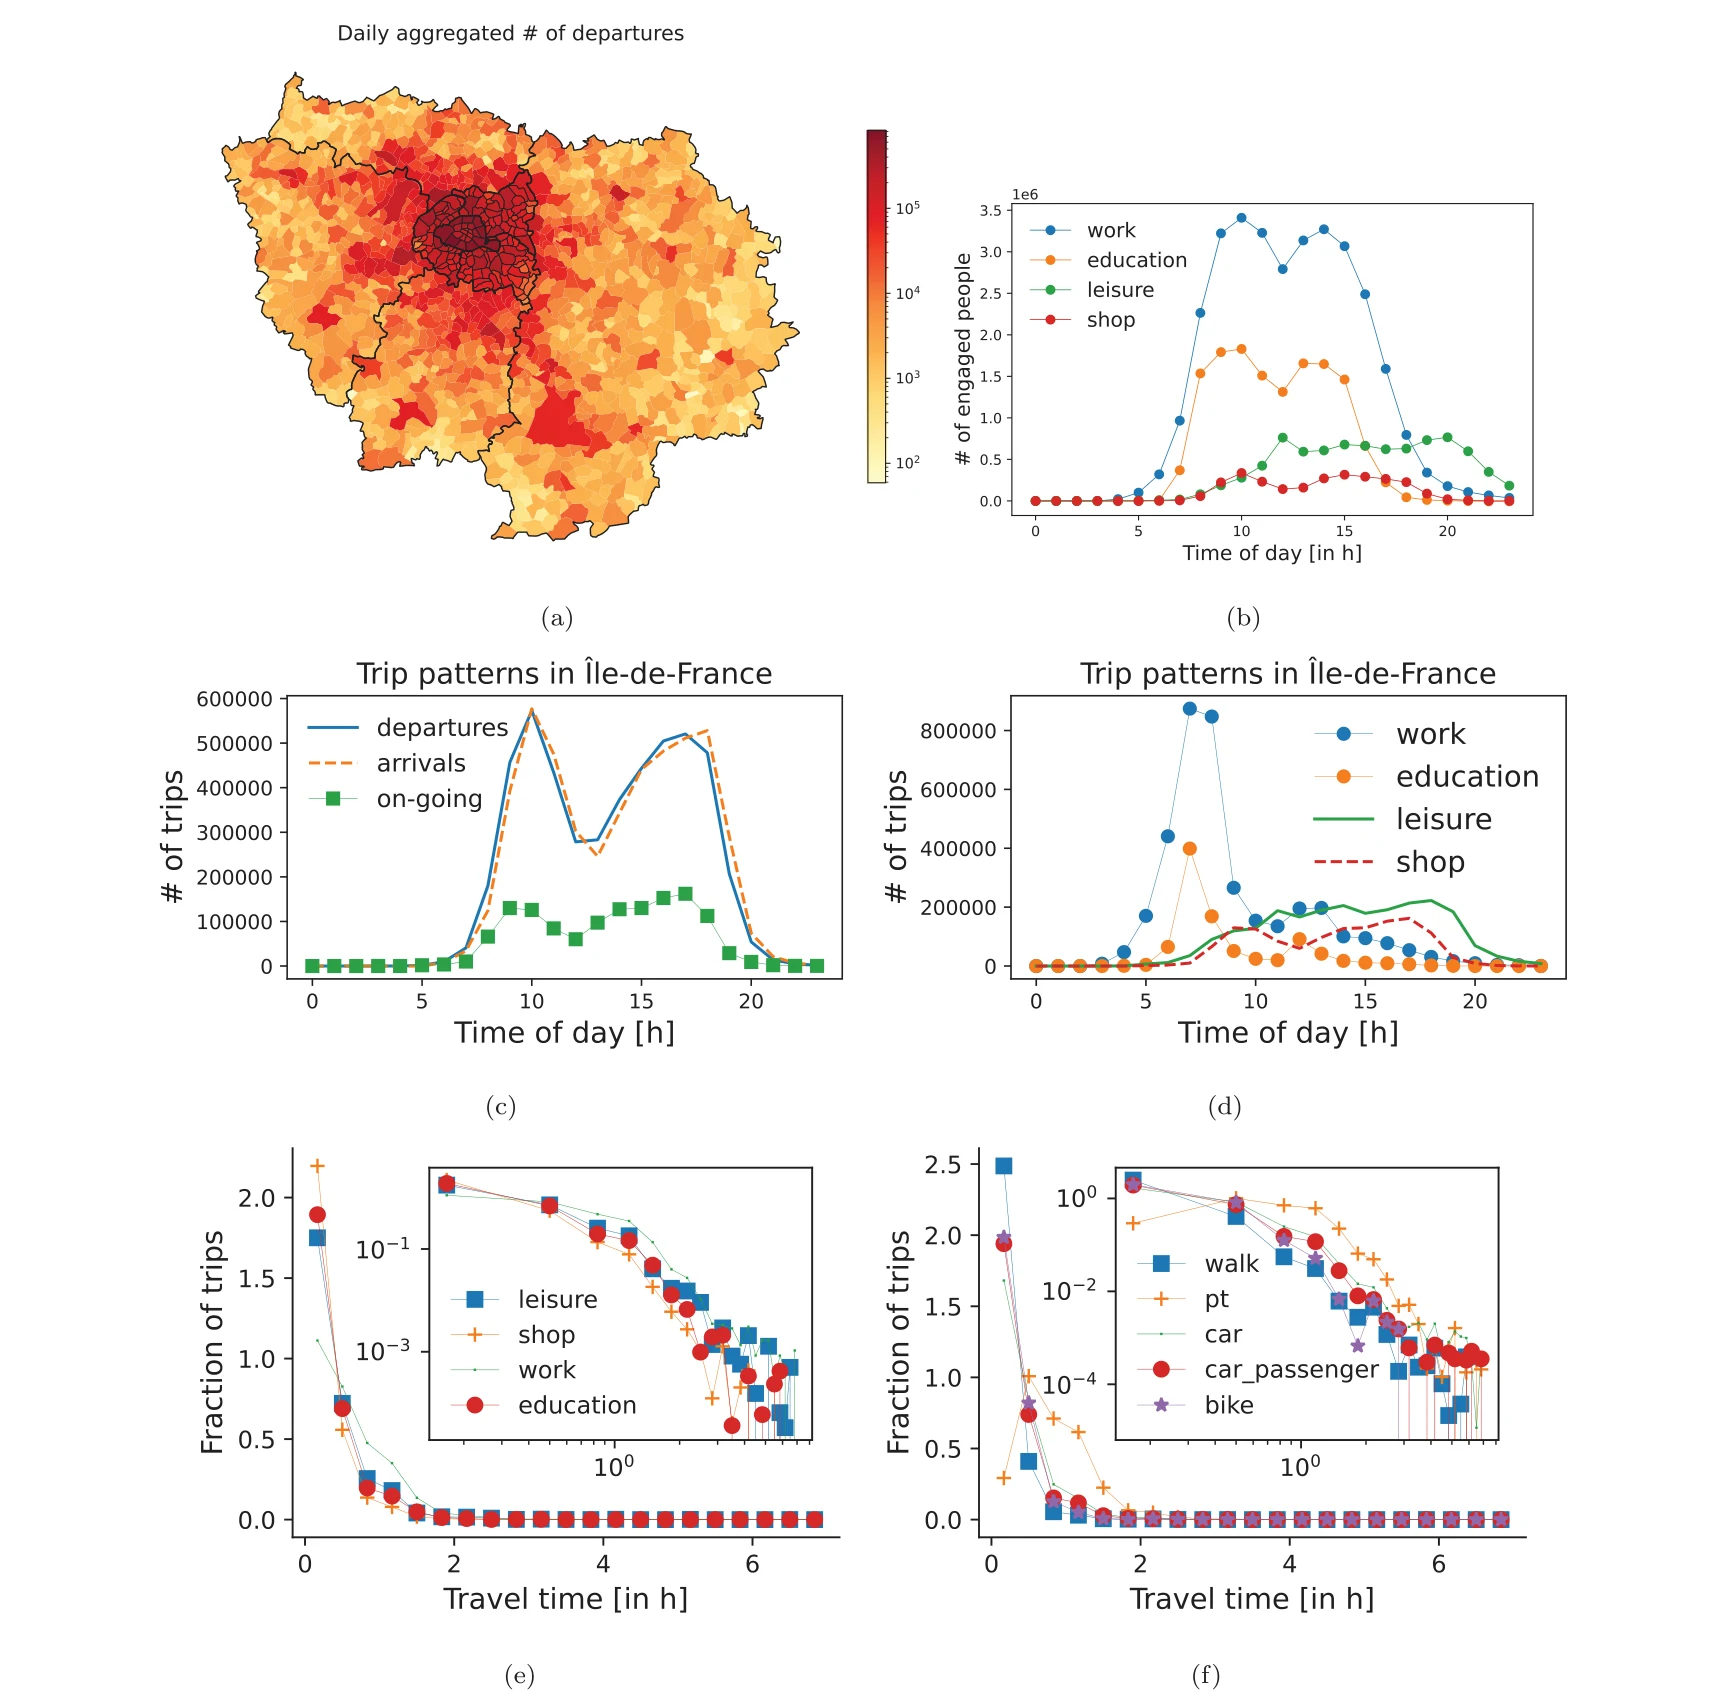
图 11|这一天的人,在何时、以何种目的离开住所?
图中字母与图下英文说明不完全一致。英文说明把出发、到达和在途写成 (b)、把分活动人数写成 (f);图面上 (b) 是分活动的在场人数,(c) 才是出发、到达和在途,(f) 是分方式的出行时间。下面按图面字母读。正文对 (b) 的文字与图面一致。
(a)市镇尺度的日出发次数,颜色由浅到深,色标从 10² 到 10⁵。巴黎核心最深,外围更浅。这是出发量,不是接触次数。(b)纵轴为正在从事该活动的人数,刻度到 3.5×10⁶。工作最高,白天中段有一次回落;教育次之,高点低于 2×10⁶;休闲在午后抬升,购物更低。(c)出发与到达在上午和傍晚各有一峰,上午高峰接近纵轴 600,000 次;正在途中的出行明显更低,并在中午回落。(d)按目的统计的出行次数。工作的早高峰达到或超过 800,000 次,教育的早高峰更低,休闲和购物的高峰更晚。(e、f)横轴为出行时间,最长约 7 小时。绝大多数出行挤在最短的几档;内嵌图用对数坐标展开长尾。(e)分目的,(f)分方式,包括步行、公共交通、驾车、驾车乘客和自行车。两张主图的纵轴都标着比例,但最左一档大于 1,不能把这些点读成已经加总为 1 的概率。来源:原论文 Fig. C.11。
这组图说明的是合成日记里的移动,还不是谁和谁见了面。公共交通上的接触没有单独建层,论文把它们并进“其他”。作者给出的理由包括估计车内共现的计算量;因此后面其他层里既有购物、休闲以外的活动,也混有未被单独抽出的乘车共现。
重叠的时间,才是一条候选边
接触网络记为图:点是人,边是两个人之间的一次候选或保留接触。论文把候选接触和保留接触分开。候选接触来自时空共现:同一地点、时间区间有重叠,就认为他们有机会见面。这是严格重叠,不是“同在一个片区就按概率连上”。
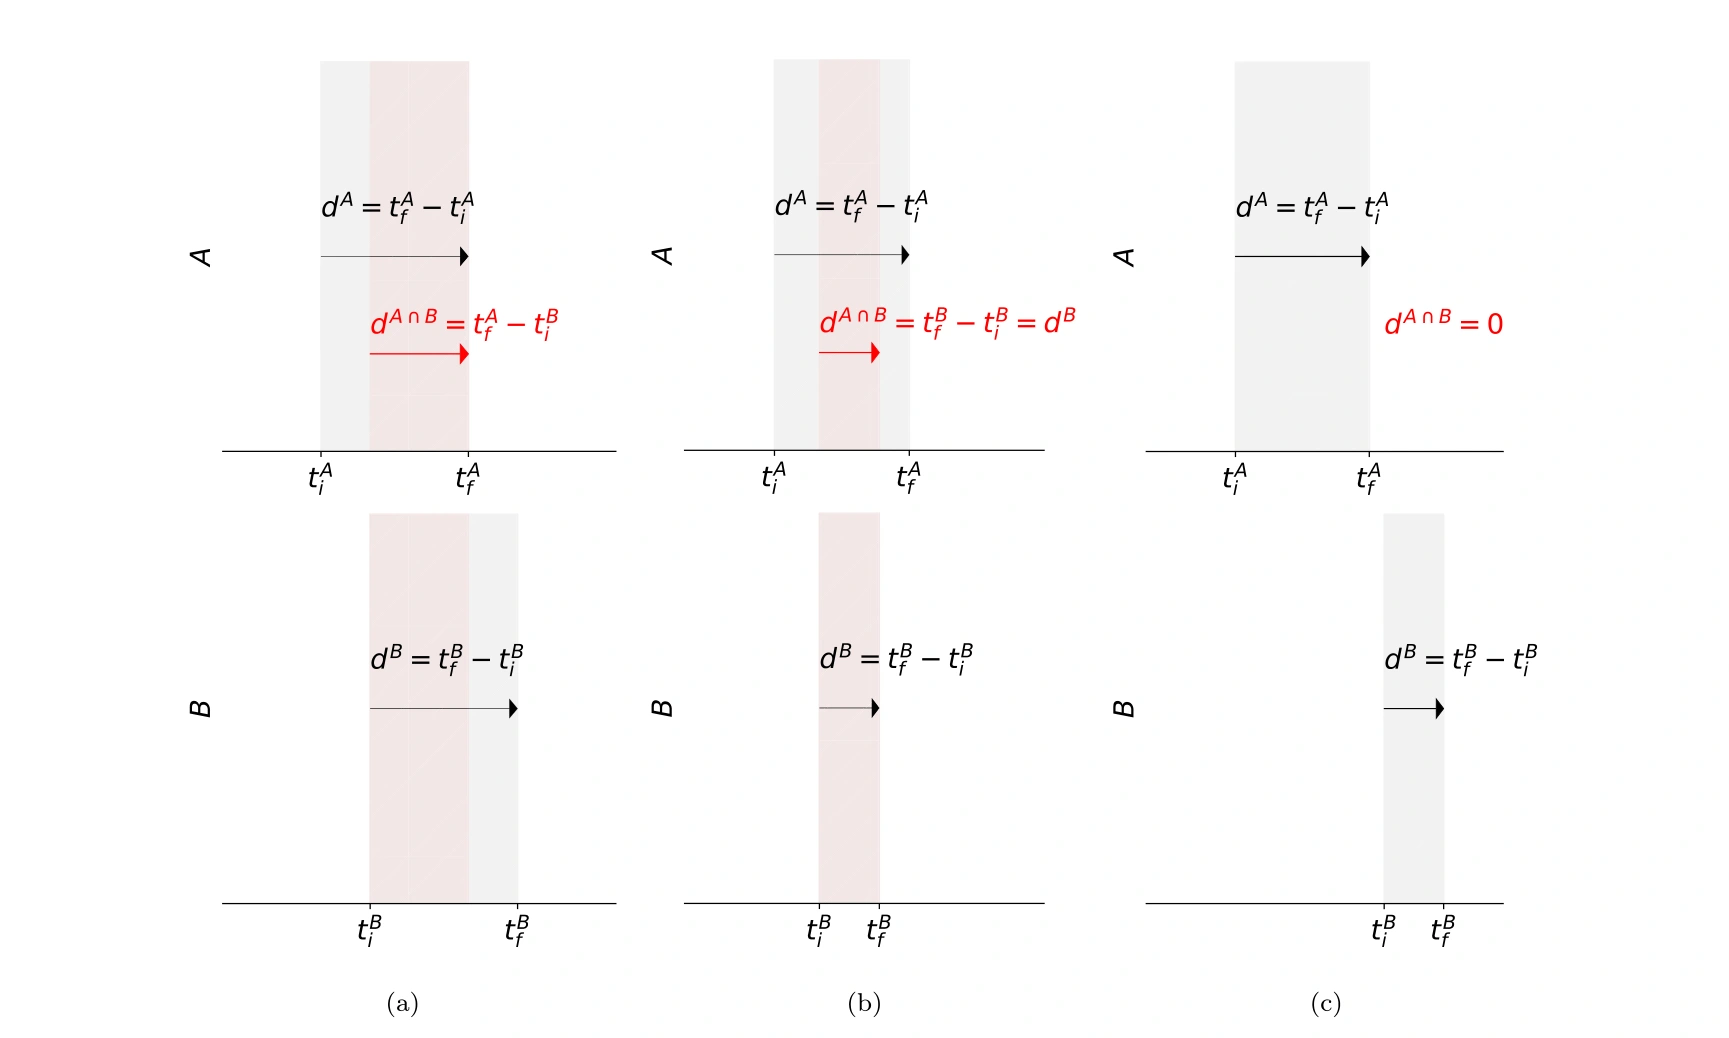
图 2|两个人的活动时段,怎样算出共现时长?
每一列上排是 A、下排是 B,横轴为开始与结束时刻,阴影是相对位置。(a)两段部分重叠,重叠长度标为 A 的结束减去 B 的开始。(b)B 的整段落在 A 之内,重叠等于 B 自己的时长。(c)两段不相交,重叠为 0。这里的时长是时间窗的重叠,后面称为时长上界:它是两个人最多能面对面相处的窗口,不是测到的谈话长度。来源:原论文 Fig. 2。
实现时先按地点分开,再按活动开始时间排序,只检查仍可能重叠的后续活动。排过序以后,一旦后面的活动已经不可能与当前活动相交,就可以停。摘要说,约 1200 万人、1,714,920 个地点的多层网络可以在数分钟内生成。这是作者对这套流程的耗时陈述,不是独立复测。
家庭另算。同住的人共享住所,论文直接做成完全图:一户有 n 个人,就有 n(n−1)/2 条边,相当于户内见面概率取 1。因此家庭边不由当天日记的时间重叠决定。成员白天其实都在外面时,这条规则仍会把他们彼此连上。作者的理由是同住者共享生活空间,并在家中度过大量时间。
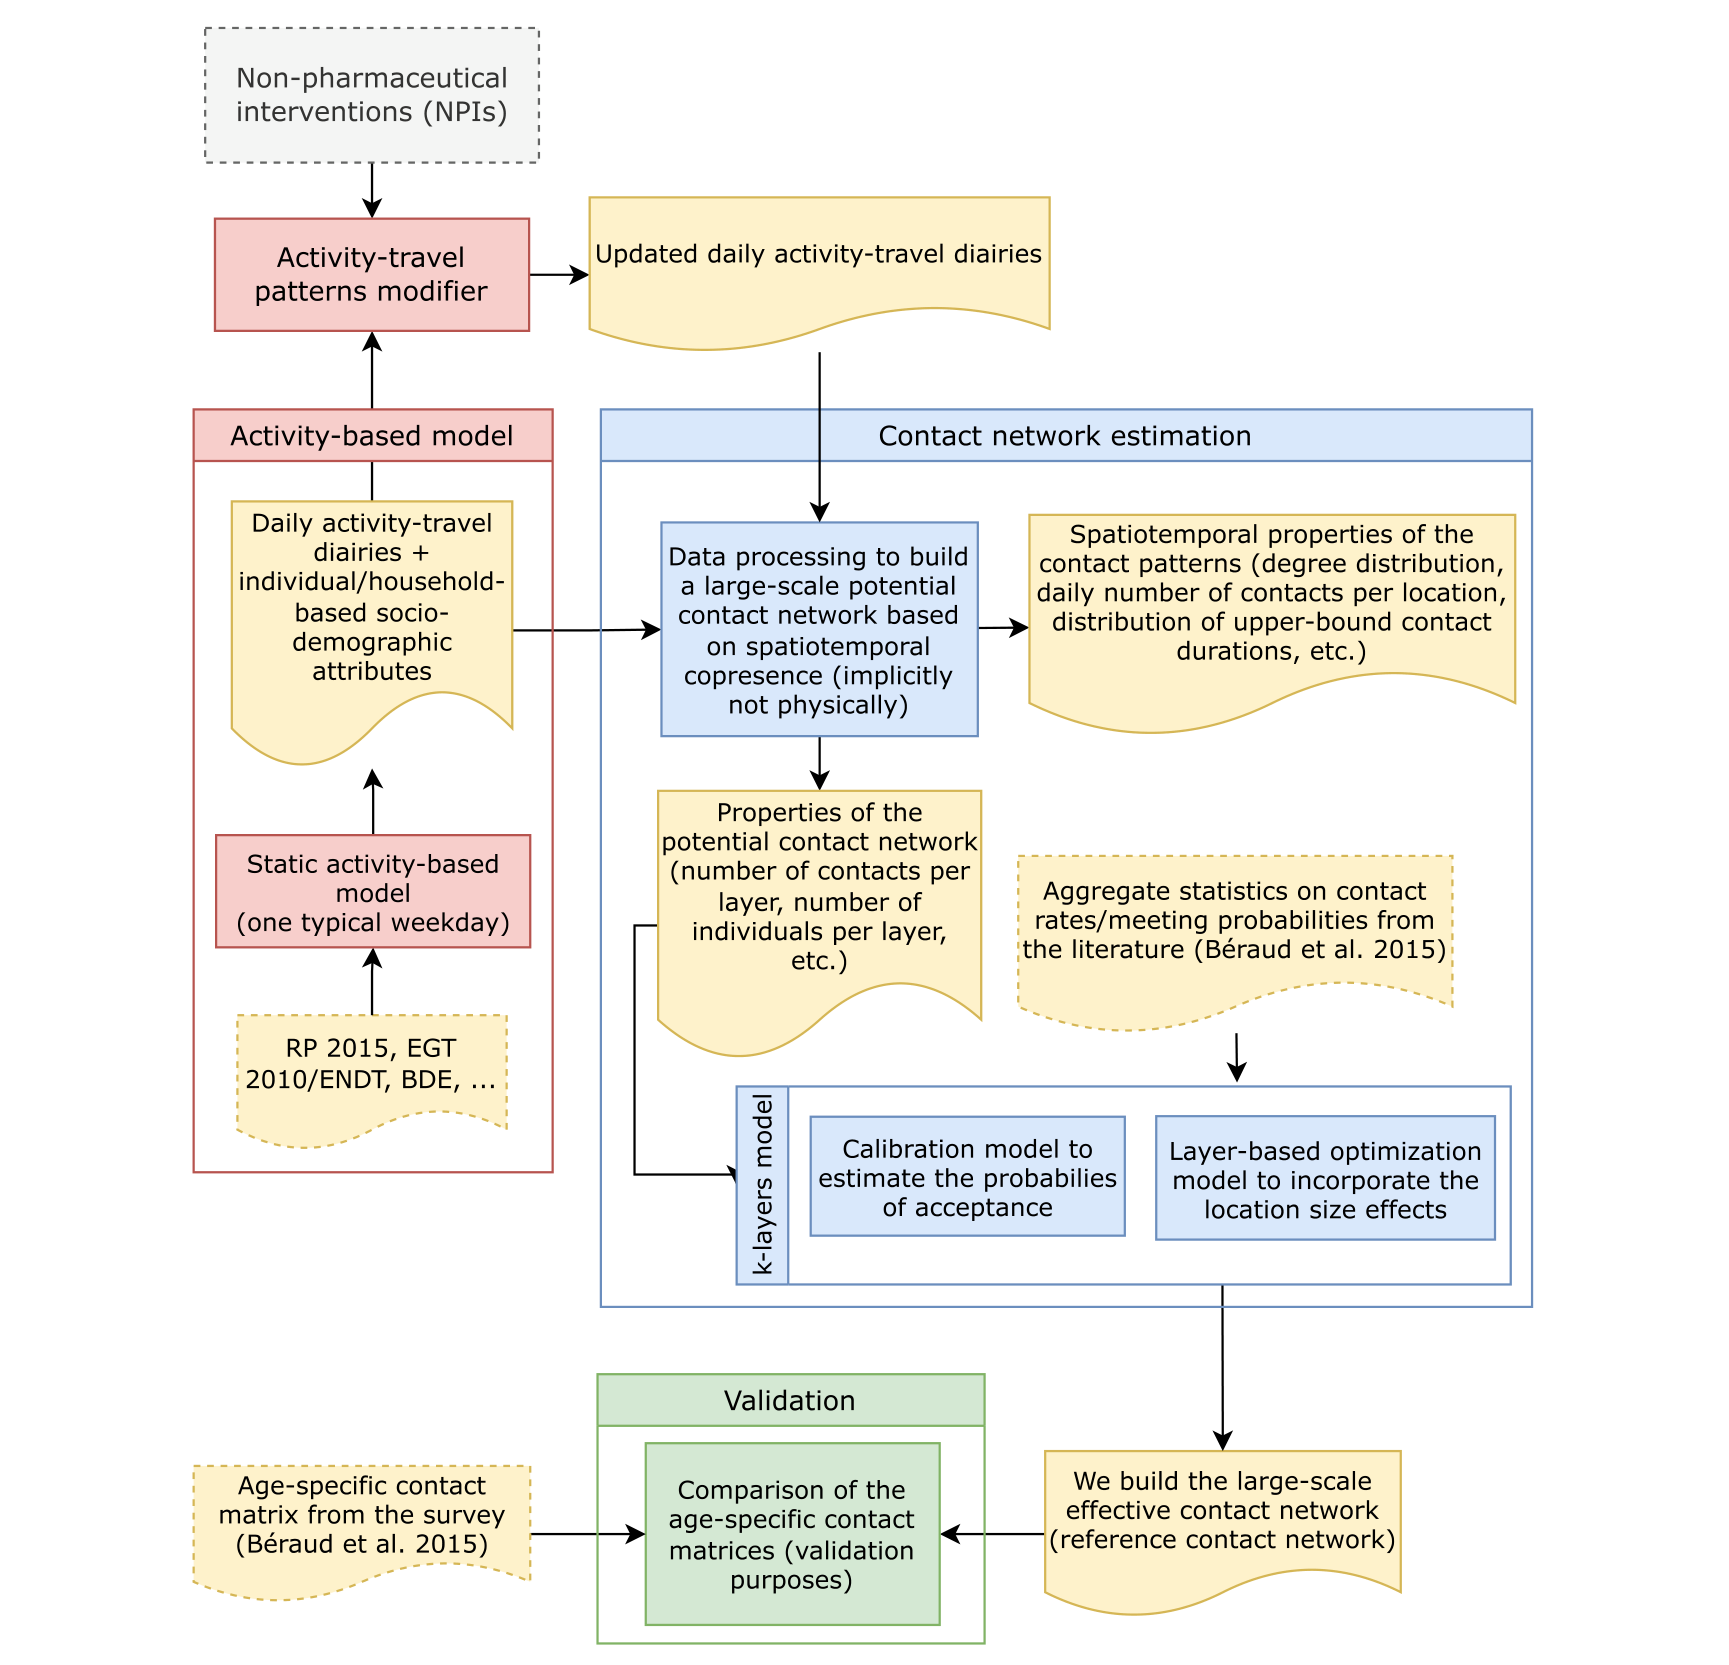
图 1|日记、共现和外部接触次数,在流程里各占哪一步?
无字母子图。左侧由 2015 年人口和出行调查生成一个典型工作日的活动模型,输出带个人和家庭属性的日记。中部用时空共现建立大规模候选网络,共现本身还不是当场测量到的见面;再读出各层边数和人数。右侧用文献中的接触次数做校准,并按地点规模调整保留比例,得到保留下来的接触网络。底部把模型的分年龄接触矩阵与 Béraud 等人 2015 年的调查矩阵对照。最上方的方框改写活动日记,后文的在家工作情景走的是这条路,而不是在已经建好的网络上直接删边。来源:原论文 Fig. 1。
留下谁,取决于双方在做什么
如果只设一个全网保留比例,使每人每天的平均接触等于某个总数,年龄别的接触率对不齐。原因是地点人数和接触量不是线性关系:统一抽边时,工作、教育偏多,购物、休闲和其他偏少。论文把这一试验写为未在正文报告,只保留了方向。
于是保留比例按接触层分开。场景是活动上下文,例如工作或教育;层是两个人活动目的的组合。两位教师之间是工作–工作,教师和学生是工作–教育。层可以出现在不同场景里:教师与学生的边可以发生在学校,也可以发生在工作地点。两位教师即使人在学校,也计入工作–工作,不计入教育–教育。边看的是目的,不是门牌上写的设施类型。
本文把场景收成三个:工作 W、教育 E、社区 X。X 把休闲、购物和其他并在一起。三个场景形成六种层:三种同目的,三种交叉。作者认为再拆细会缺少可引用的接触统计,六层是折中。
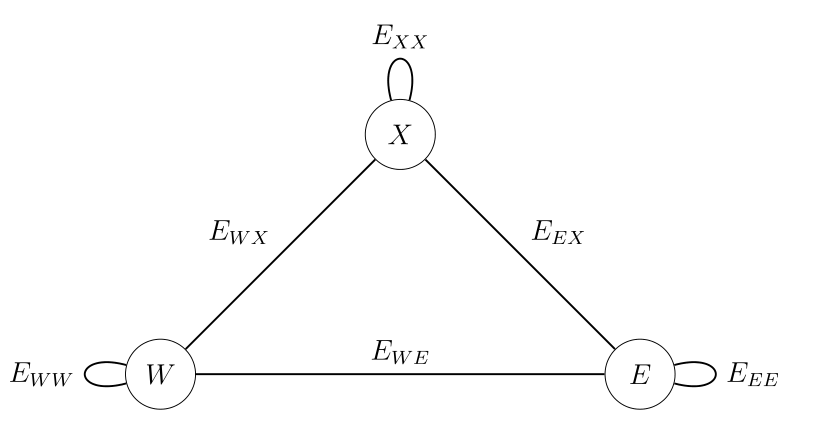
图 3|六种层分别连接谁和谁?
无字母子图。圆点 W、E、X 表示工作、教育和社区。环是同目的接触,边是交叉接触:工作–工作、教育–教育、社区–社区,以及工作–教育、工作–社区、教育–社区。这是层的示意图,没有人数。来源:原论文 Fig. 3。
某一目的的人均接触,等于留在该目的上的边,除以当天至少从事过该目的的人数。同目的的一条边在分子里算两次,因为两端都算这个人的一次接触。家庭层全部保留,模型给出的人均接触 μ_H 为 2.11 次,分母是人,不是户数。
工作和教育的目标不来自这批日记。Béraud 等人 2015 年法国接触调查里,工作接触与家庭接触之比为 3.17,教育与家庭之比为 1.55。于是工作目标为 2.11×3.17 = 6.68 次/人,教育目标论文写作 3.26 次/人,即 2.11×1.55 的四舍五入。全人口的人均每天接触被设为 10 次,引用的是 López 等人 2021 年,分母是网络中的全部人。10 不是法兰西岛日记的实测均值。它用来决定家庭以外要留下多少候选边;家庭边已经全部留下。
交叉层还要一组份额。教育侧,学生与教师的接触占该侧接触的 0.03,因而学生与学生占 0.97。这个 0.03 来自一所法国小学的接触记录,不是法兰西岛全区的普查。工作侧,教师与教师的份额取 0.09。学生与“既不是学生也不是教师的人”的份额被假定为 0。表 1 的六个输入里,只有工作倍数和教育倍数来自后面用来对照的那份法国调查;其余来自上述外部来源或这一假定。作者据此说明,对照并不是把同一份调查既当目标又当答案。
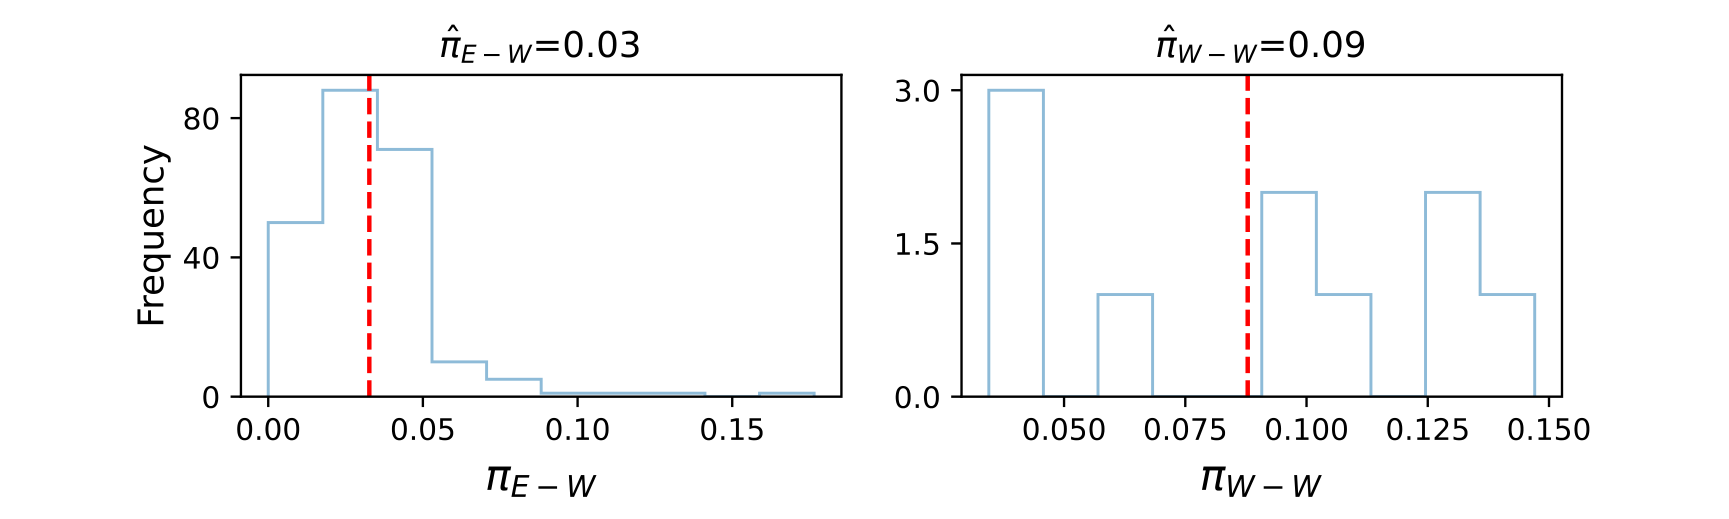
图 5|0.03 和 0.09 在原始分布上站得稳吗?
无字母子图。左图横轴是教育–工作份额,红色虚线标在 0.03。纵轴为频数,最高一档超过 80,分布集中在 0.05 以下。论文没有说明每一格是一天、一个班级还是一个人。右图横轴是工作–工作份额,虚线标在 0.09。纵轴最高只到 3,各档只有个位数。0.03 有一大团观测撑着;0.09 是在很稀的直方图上取的代表值。来源:原论文 Fig. 5。
地点规模再改一次保留机会。人少的地点更可能真的见面:地点里只有 2 人时,这一调整给出的比例为 1;人数趋于很多时,比例趋于 0,并且随人数下降。每个层单独配一个规模参数,使各地点留下的边加总后,仍等于该层已经确定的目标边数。作者试过另一种指数形式,说结果没有实质差别,但没有给出差别的数值。
见面在所对照的法国调查里,指肌肤接触,或 2 米以内的交谈。模型用这一定义对齐“什么算一条边”。共现重叠只提供候选窗口,不是这 2 米已经在地图上被测到。
保留之后,谁和谁连在一起?
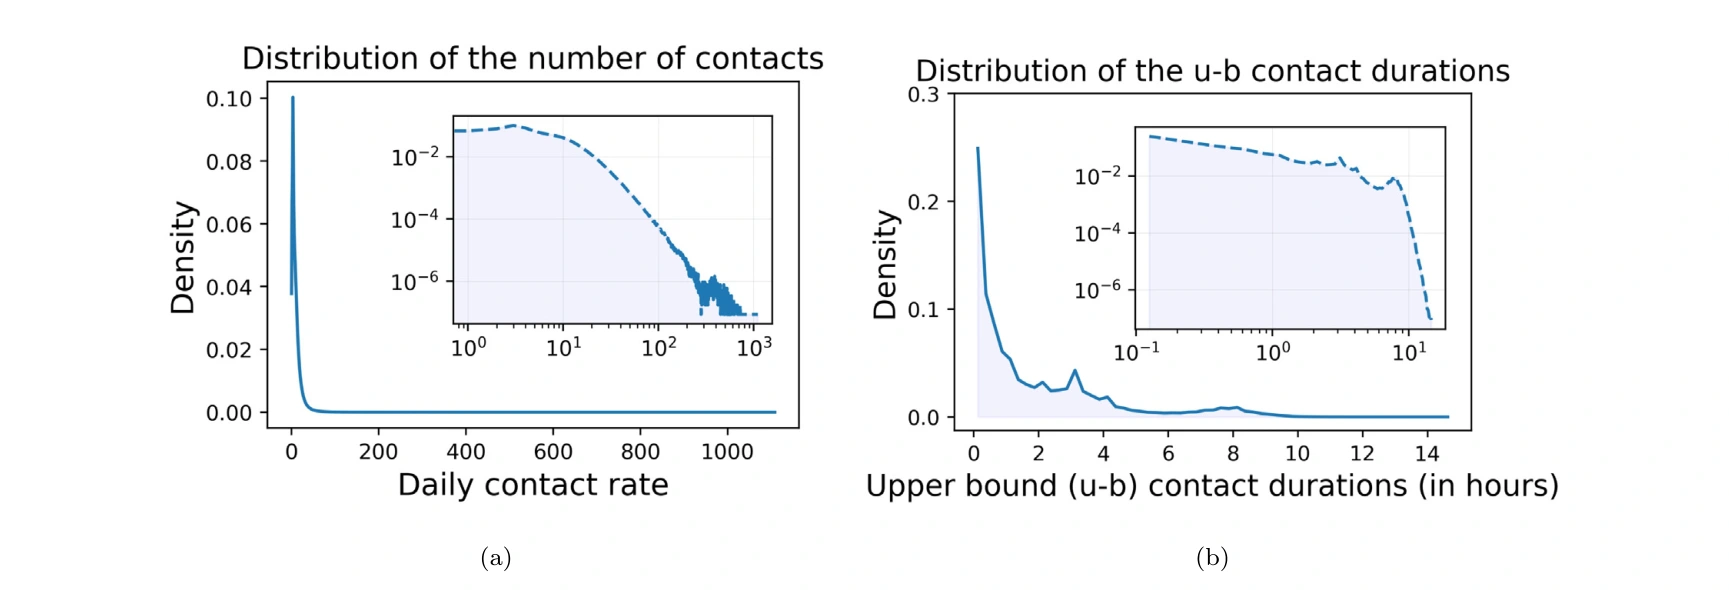
图 6|一个人一天连到多少人,重叠窗口有多长?
(a)横轴是每人每天的接触次数,线性坐标画到 1,000 以上;纵轴是密度。密度几乎全部挤在接近 0 的位置。内嵌对数坐标从约 1 次画到约 10³ 次,大约 10 次以后下降,尾部仍延伸到千次量级。正文把形状说成带截断的幂律,截断大约在每人每天 10 次。10 次是这句描述里的尺度,不是图上的最大值,也不是前面那个外部设定的人均 10 次本身。(b)横轴是时长上界,单位小时,画到 14。短窗口占大多数,曲线右偏;内嵌对数坐标显示长窗口的尾部。它仍是共现重叠的上界,不是谈话计时。来源:原论文 Fig. 6。
分年龄的矩阵按双方活动目的拆开,并且做成对称。工作–工作主要落在约 25 岁到 65 岁之间,两侧有一些散布。教育–教育集中在学生年龄。其他–其他没有清晰的年龄块,因为同一地点可以混入各种年龄。工作–教育抓住教师与学生。工作–其他可以包括从事工作的人与从事休闲或购物的人。家庭矩阵的主对角对应伴侣或同龄同住者,次对角对应亲子。
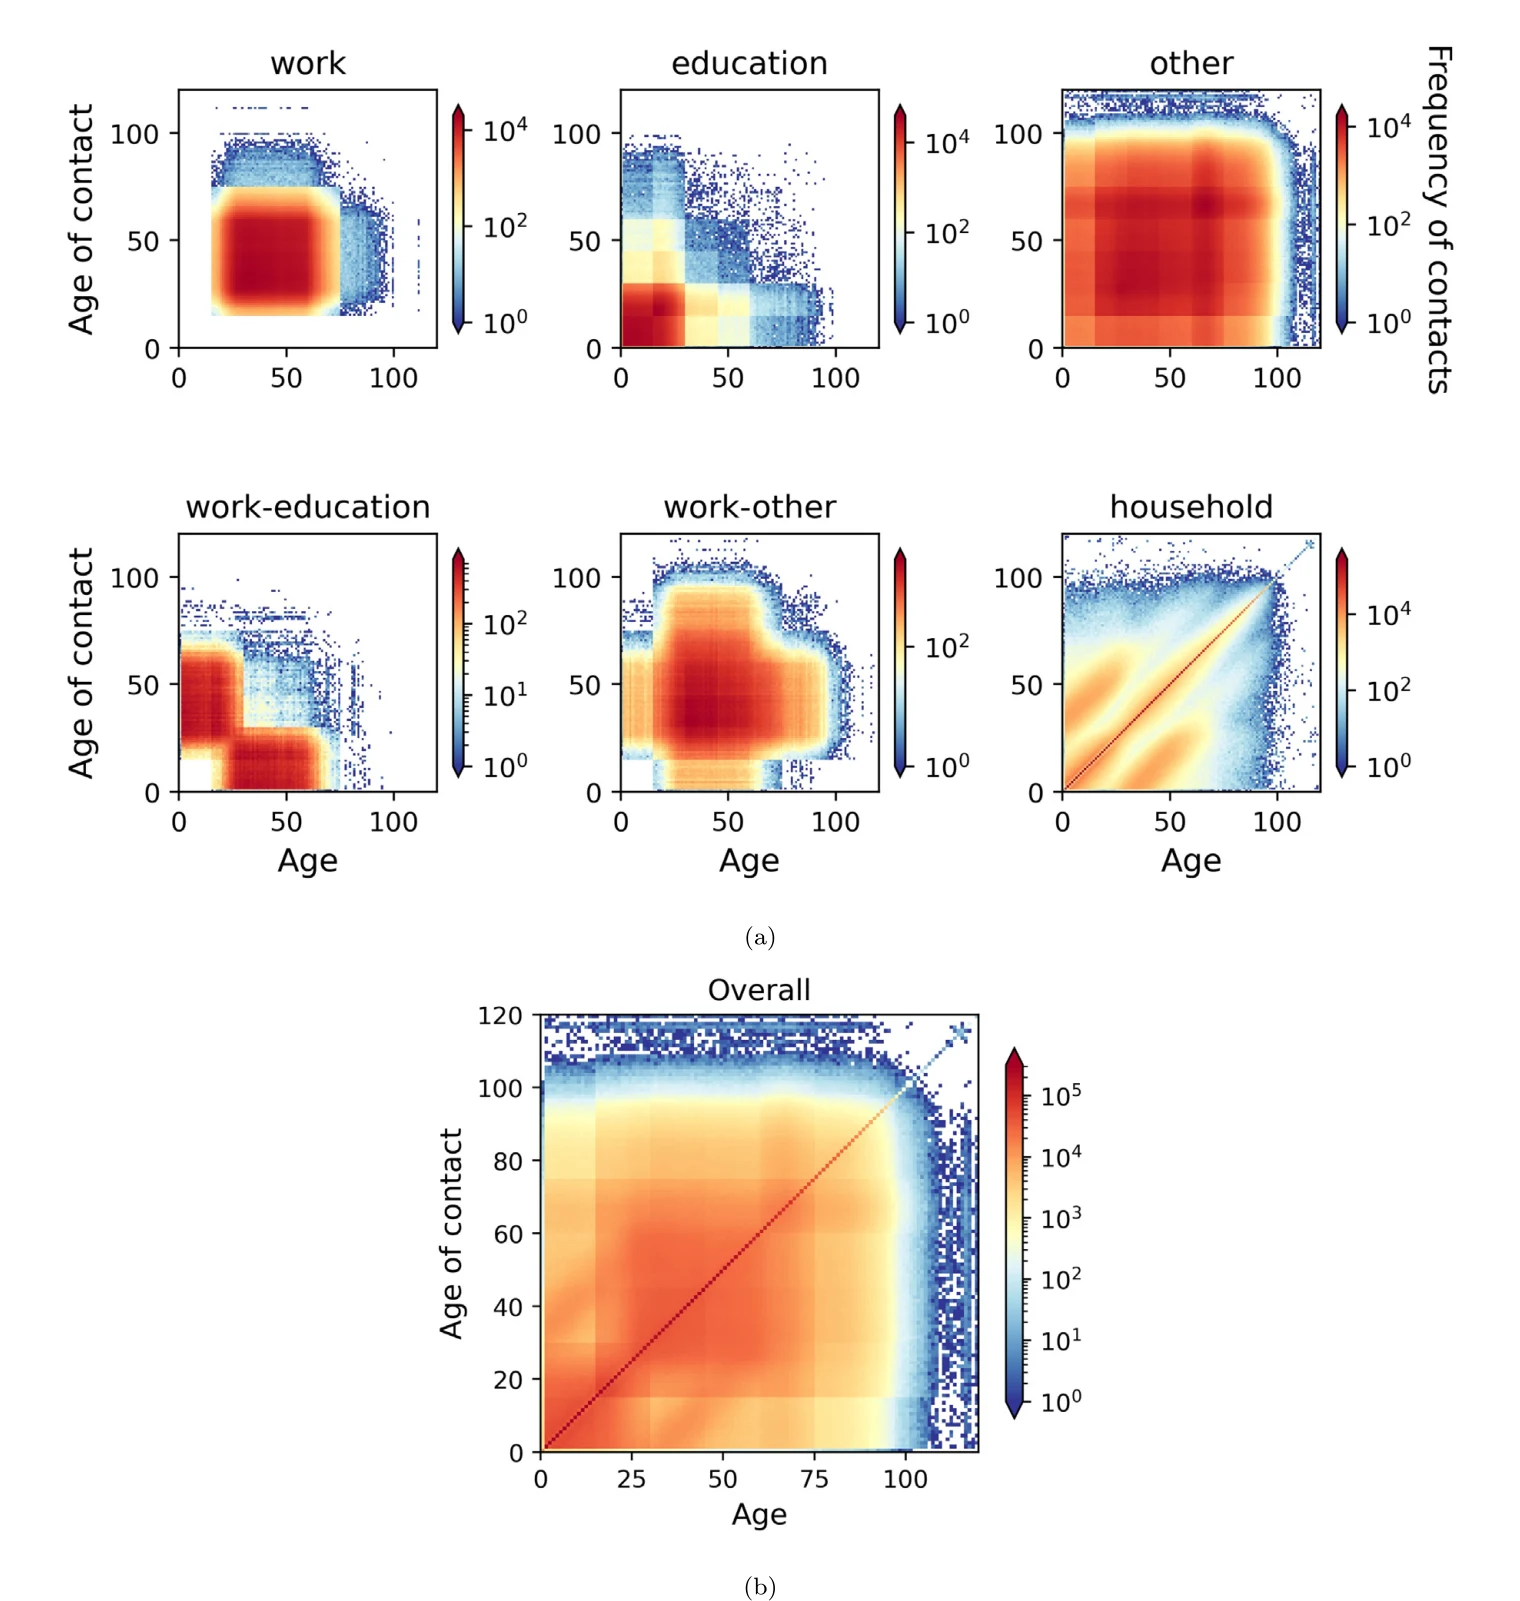
图 7|不同活动目的,把接触集中在哪些年龄?
横轴是一方年龄,纵轴是对方年龄,颜色是接触次数,对数刻度。各小图色标上限不同,工作–教育只到约 10²,其余多到约 10⁴,总矩阵到约 10⁵,不能用颜色深浅跨图比较绝对次数。
(a)上排从左到右是工作、教育、其他;下排是工作–教育、工作–其他、家庭。工作块集中在劳动年龄,教育块集中在低龄及一条年轻人对年轻的结构,其他层铺得很开。工作–教育呈成年与低龄交叉的块。家庭矩阵有一条亮的主对角和两侧的次对角。(b)总矩阵同时保留对角和一大片成年接触,右上、左下的高龄与低龄交叉较稀。来源:原论文 Fig. 7。
按居住市镇再排一张地理矩阵。省的位置按空间邻近安排,省内市镇按边际接触数从小到大排。巴黎是接触数的中心。作者用住房成本解释在巴黎工作、住在外围的通勤;模型本身没有放入房价,这是对已有出行格局的解读。
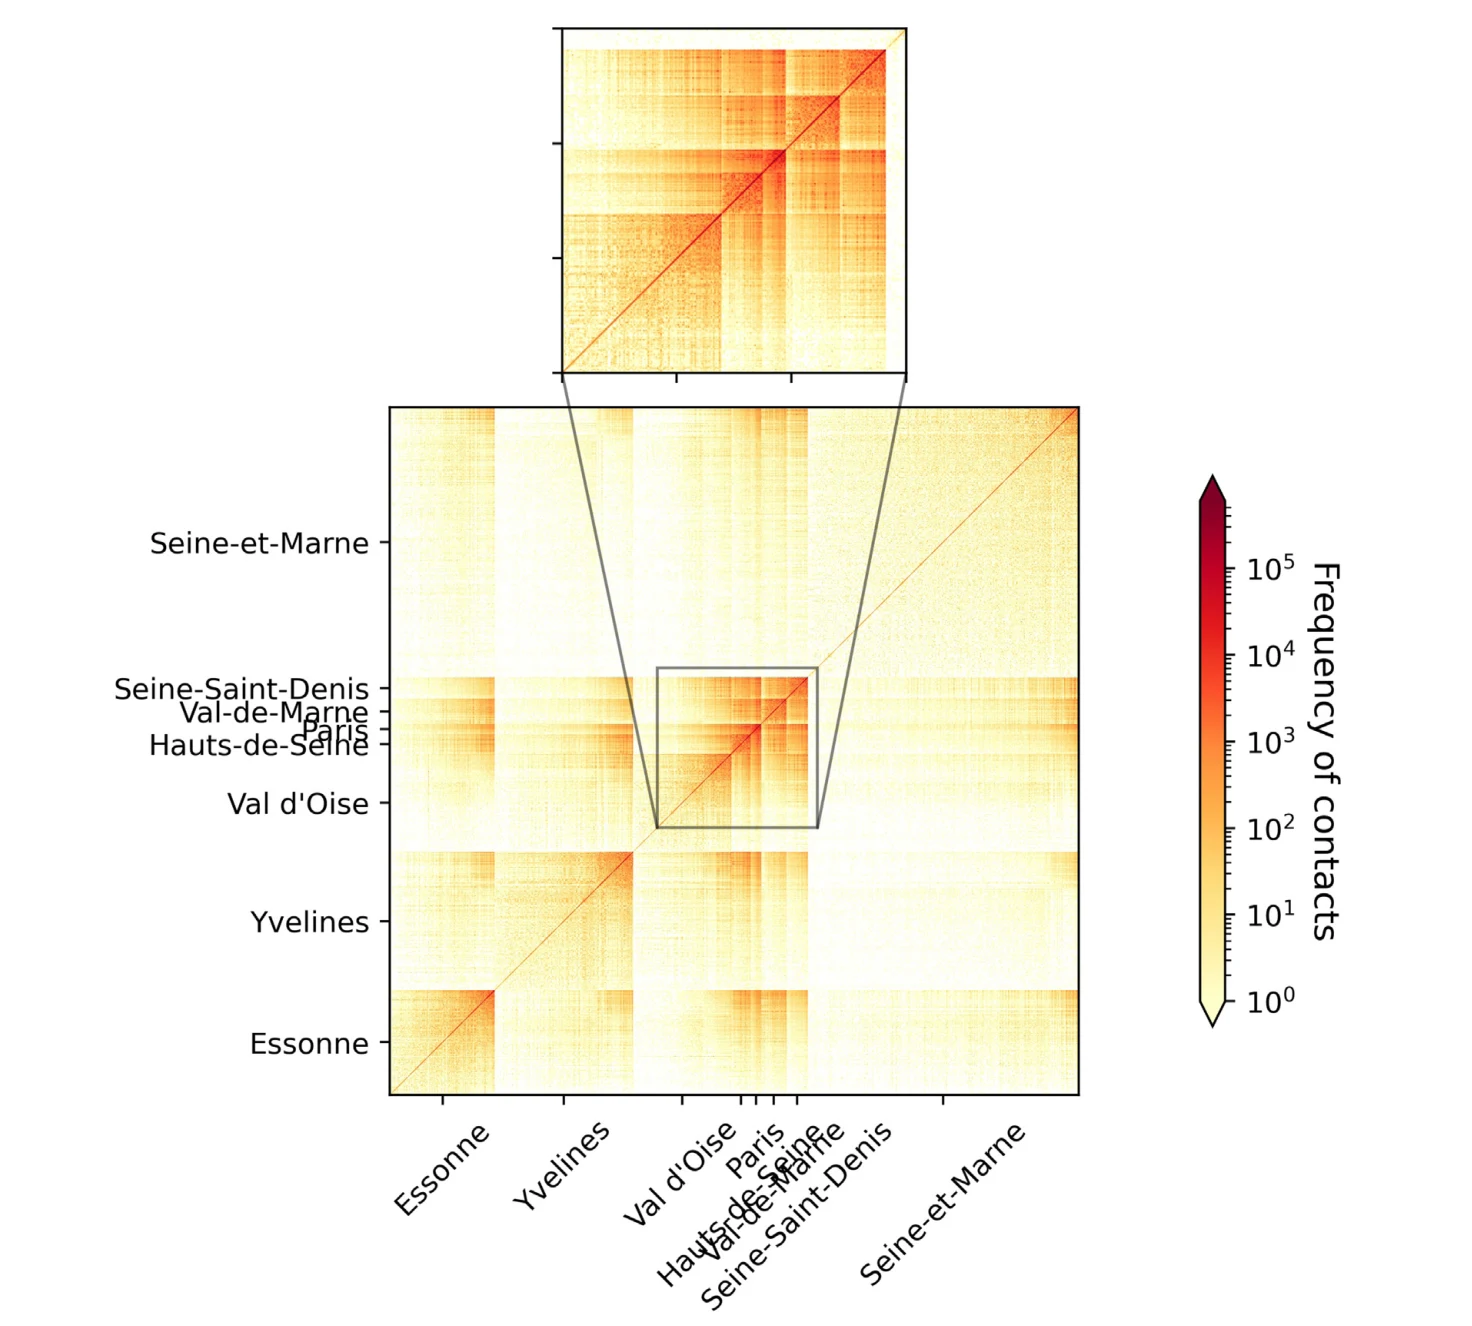
图 12|接触更常落在哪些市镇之间?
无字母子图。行和列是市镇,按省分组:埃松、伊夫林、瓦勒德瓦兹、巴黎、上塞纳、马恩河谷、塞纳–圣但尼、塞纳–马恩。颜色是接触次数,从 10⁰ 到 10⁵。对角色块是省内接触。上方放大的是巴黎及紧邻省,中心最亮。读的是居住市镇之间的接触计数,不是通勤距离,也不是每个市镇的人口。来源:原论文 Fig. D.12。
和接触调查比,对上的是结构,不是原始答卷
对照使用 Béraud 等人 2015 年的分年龄接触率,比较单位主要是 5 岁年龄组。那份矩阵不是调查表的直接计数。直接计数会很稀,所以原作者用负二项分布的广义可加模型,并放入参与者年龄与对方年龄的交互,先平滑再成矩阵。它不能当作地面真值。本文只从那份研究借用了工作、教育相对家庭的两个倍数;家庭基准 2.11 来自合成人口。
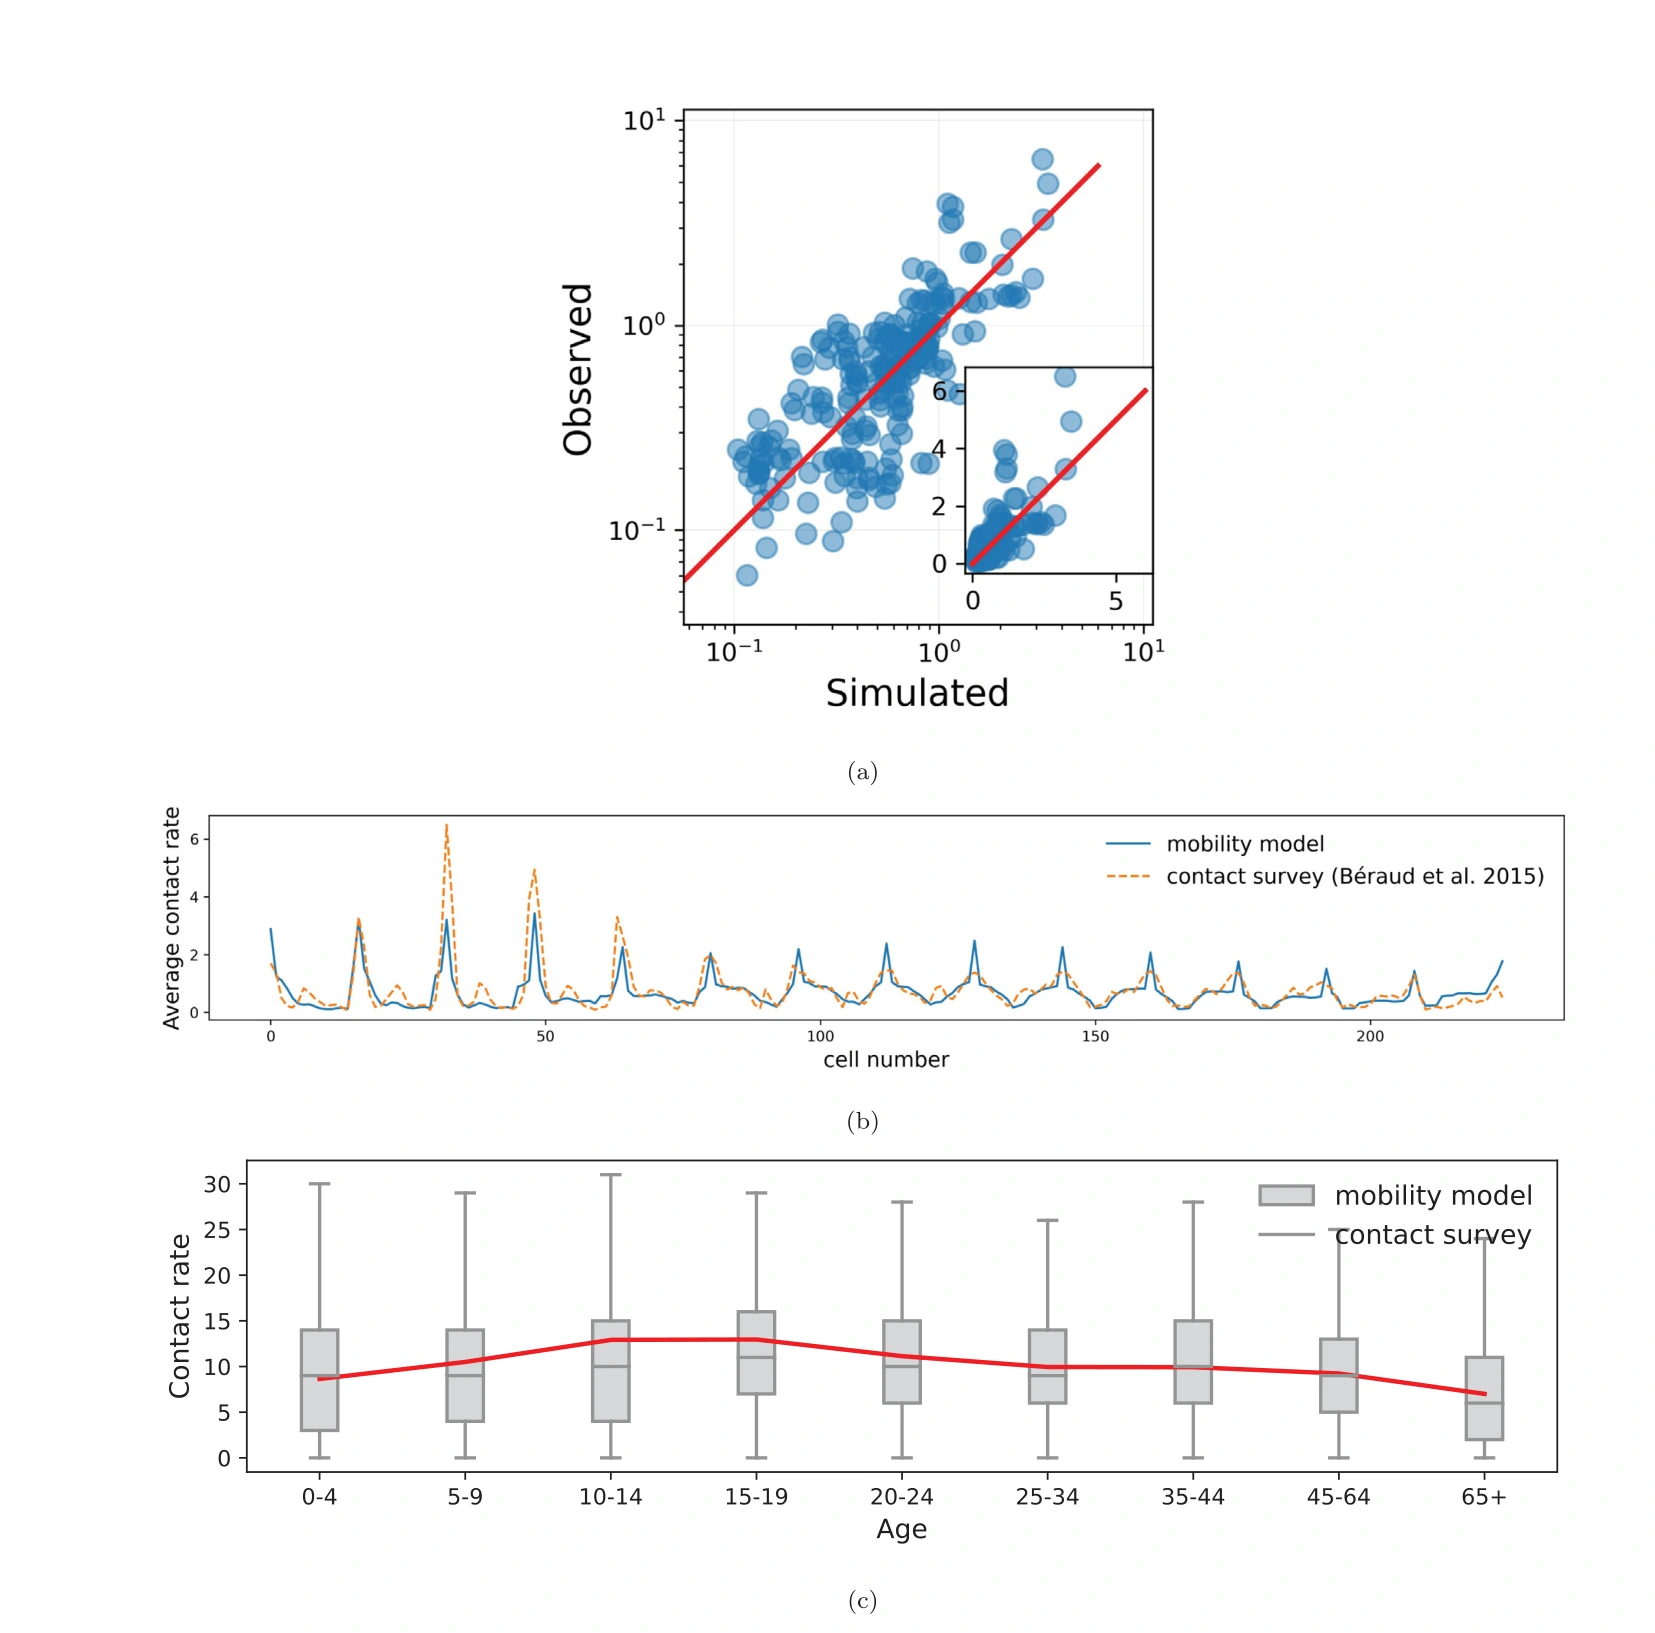
图 8|按年龄拆开以后,模型还跟着调查走吗?
(a)每个点是一对年龄组合。横轴为模型接触率,纵轴为调查接触率,都是对数坐标;内嵌图是线性坐标,大约落到 0–5 与 0–6。点沿一条上升的参考线分布,论文据此说存在正向对应。图中没有相关系数。(b)把总的分年龄矩阵拉成格子序列。蓝线是出行模型,橙虚线是接触调查。调查在若干格子上明显更高,有的峰超过纵轴 6。这与正文所说的模型略低估一部分最高接触率相符。横轴是格子序号,不是年龄本身。(c)箱线是出行模型,红线是接触调查。年龄组为 0–4、5–9、10–14、15–19、20–24、25–34、35–44、45–64 和 65 岁及以上。正文写按 5 岁一组比较,成年段在这张图里已经合并。纵轴标到 30。红线在学龄和青少年段较高,到 65 岁及以上回落;箱线的跨度远大于红线在年龄之间的起伏。论文没有写明每个箱子里的样本是矩阵格子还是个人。来源:原论文 Fig. 8。
因此,“对得上”指的是:在借用两个倍数、其余目标来自别处或假定的条件下,分年龄的接触率大体同向,年龄曲线的起伏也大致跟着调查。它不表示每一对年龄的次数都准确,更不表示合成日记记录了真实谈话。
改的是日记,不是事后删边
在家工作的做法,是改当天的活动计划,再重算接触网络。作者用公开的规则工具 PAM,把 25%、50% 和 75% 三档人口的工作活动改回住所。后文比较边际变化时,又把对象说成在业人口。正文没有给出在业人口的人数,所以这三档的分母是“被要求在家工作的那一部分人”,不能改写成全体 1200 万人里已经核实的就业人数。
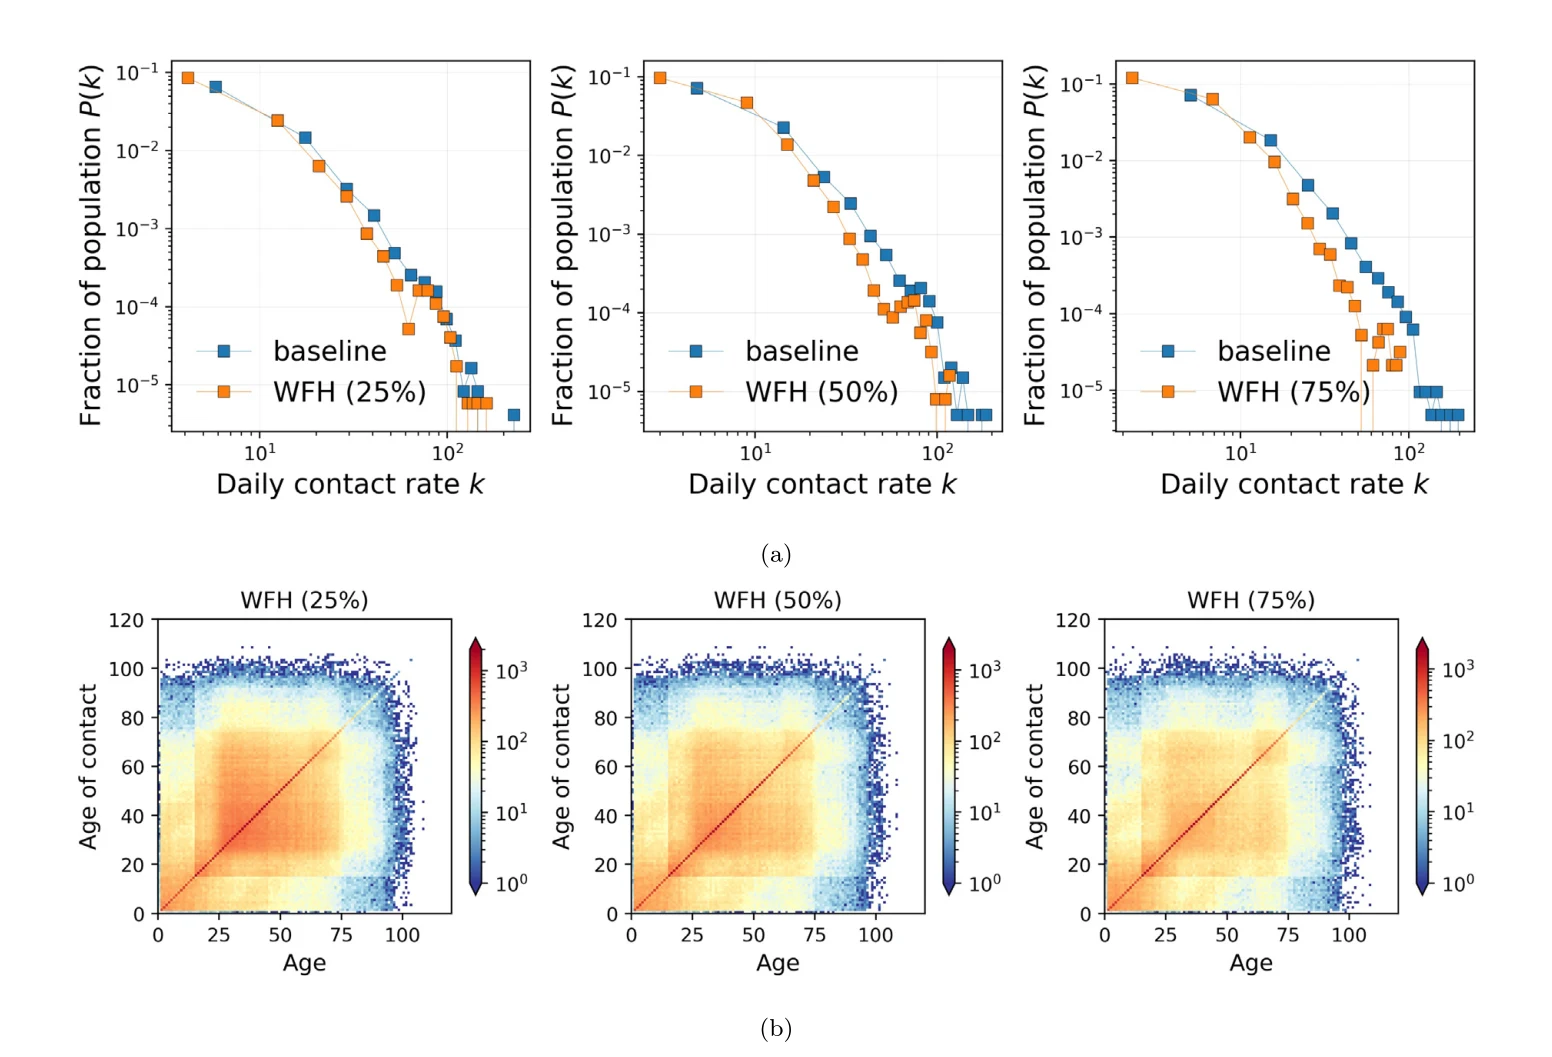
图 9|在家工作以后,高接触的人少了多少?
(a)三张图从左到右是 25%、50%、75%。横轴是每天接触次数 k,纵轴是人口比例,都取对数。蓝方块是基线,橙方块是在家工作。低次数一端两条线接近;高次数一端橙线落到蓝线之下,75% 那一档分得更开。读的是比例,不是人数。(b)三张总的分年龄矩阵,色标到约 10³。对角结构还在。正文认为工作场所接触的减少会反映在这些总矩阵上,但图上没有单独拆出工作层,不能从颜色读出工作接触少了多少次。来源:原论文 Fig. 9。
空间覆盖比例 sc 等于:从随机选出的一个人出发,沿接触边向外走到第 t 步以内,至少出现过一名接触者的地理单元数,除以地理单元总数。论文的例子是 5 个分区里触及 3 个,sc 为 3/5。分母是地理单元,不是人,也不是 12,011 平方公里。若接触者都住在同一个单元,这个比例不增加。作者强调绝对值本身不好解释,要看情景之间的差别。t 是接触网络上的步数,不是钟点,也不是出行耗时。
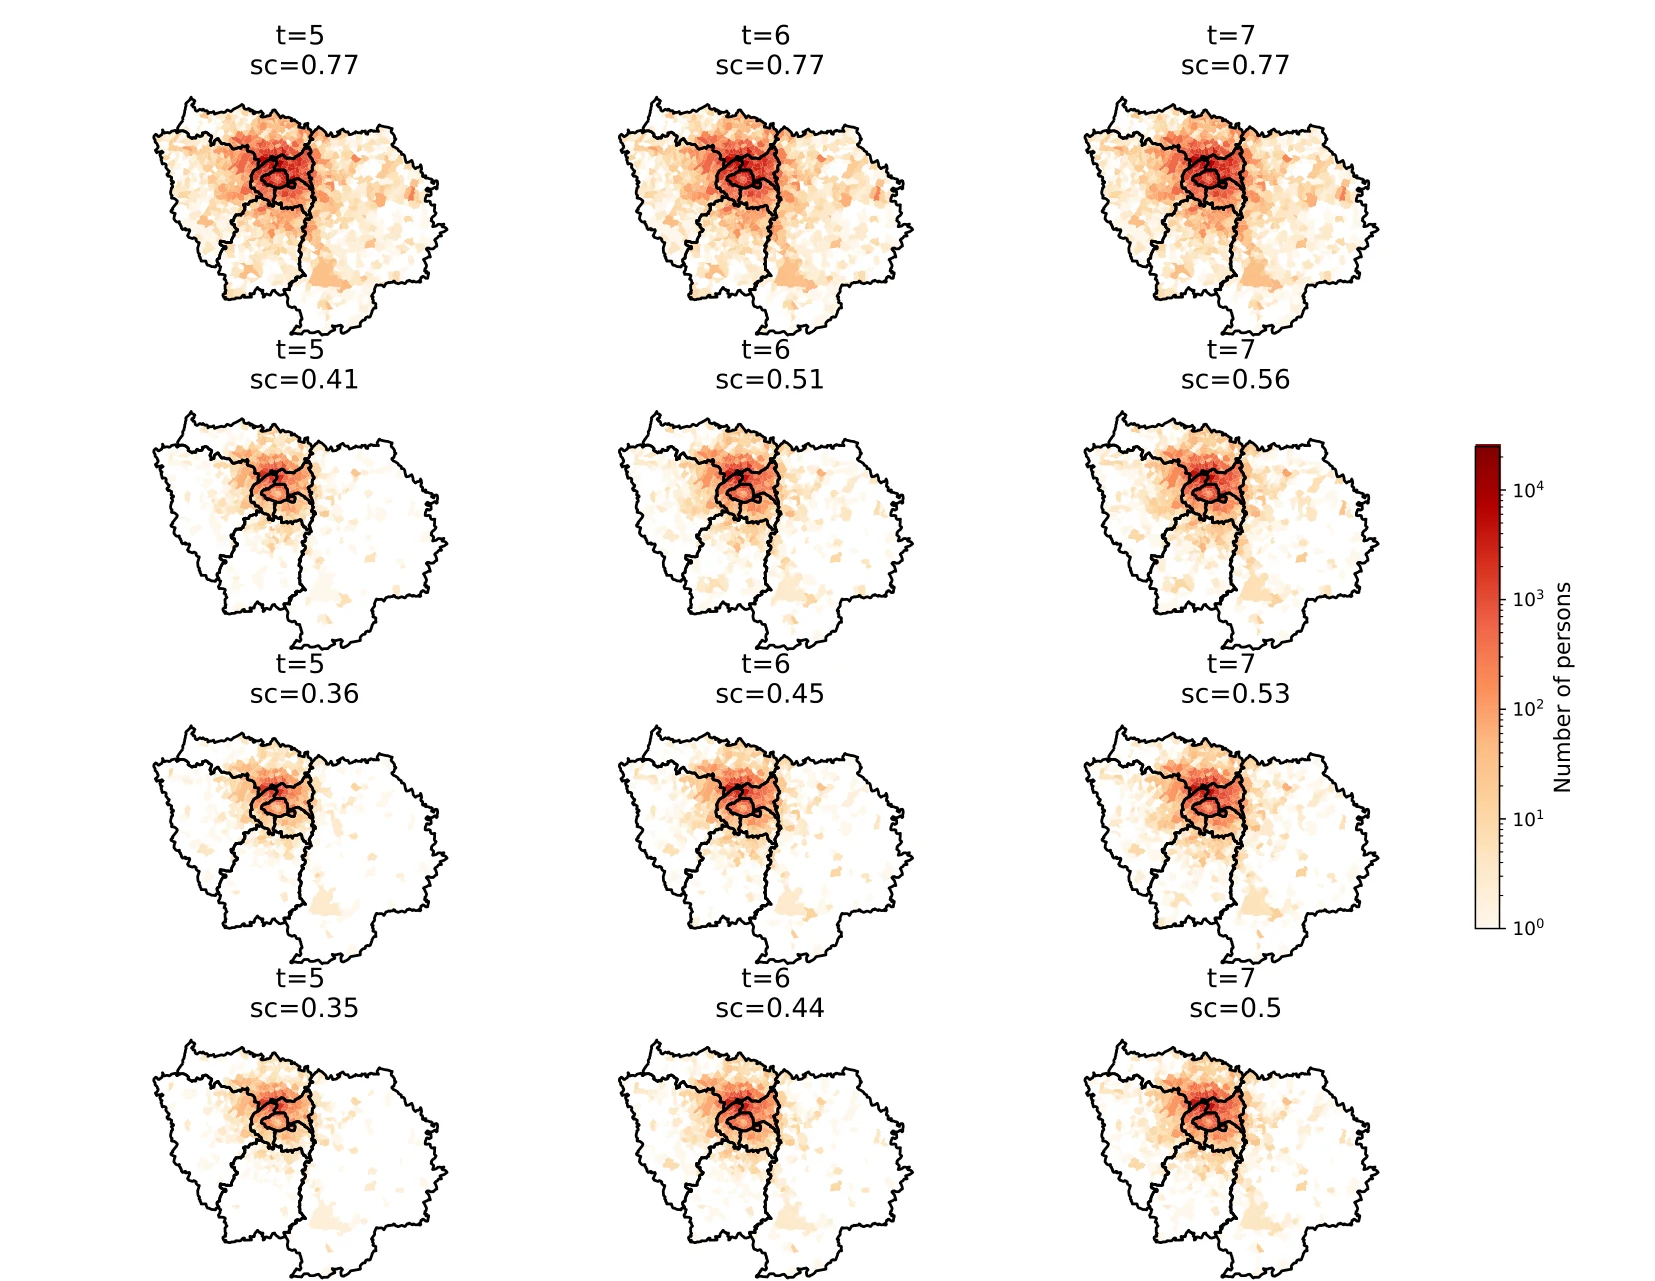
图 13|接触边向外延伸时,覆盖的地理单元如何变化?
无字母子图。列是 t = 5、6、7,行从上到下是基线、25%、50%、75%。颜色是人数,从 10⁰ 到 10⁴,深色集中在区域中部。图上印出的覆盖比例为:基线三列都是 0.77;25% 为 0.41、0.51、0.56;50% 为 0.36、0.45、0.53;75% 为 0.35、0.44、0.50。基线在第 5 步已经是 0.77,并没有在这三列里继续升高。在家工作各行仍随步数上升。到第 7 步,从基线到 25% 下降 0.21;从 25% 到 75% 只再降 0.06。这与正文的判断一致:在这一指标上,第一档在家工作带来的变化大于后面再提高比例。来源:原论文 Fig. E.13。
0.77 是地理单元的 77%,不是 77% 的人口被某个人接触到。图上的颜色才是人数,而且各情景共用一个色标时,外围在在家工作情景下明显更淡。作者也写明,这一空间指标要和其他指标一起看;单看 sc 的绝对水平没有独立含义。在家工作能否外推,还取决于城市密度、劳动力构成和行业是否允许离开工作地点。本文没有按职业重做这三档。
这些结果能说到哪一步
网络的边取决于“见面”怎么定义。作者选用接触调查的口径,而不是蓝牙、Wi-Fi 或射频装置的口径,因为他们引用的比较认为纸笔调查偏低、装置记录偏高。跨层的份额换数据源时相对稳定,文中说网络密度影响不大,同样没有给出数值。
活动模型本为出行需求而建。它在这里能分出工作、教育、家庭和其他的年龄结构,是因为日记里有地点、时间和活动目的。合成人口仍是多源数据配出来的近似。2015 年的人和 2008/2010 年的日记不是同一年。出行调查不含 5 岁以下的行程。结果是一个典型工作日的横截面,没有日与日之间的变化。公共交通没有单独的接触层。
家庭完全图、学生不接触学生和教师以外的人、以及人均 10 次这些外部约束,都会推进最终的边。换一组约束,年龄矩阵的高低会变。与调查的同向关系,是在这些约束之下的结构对照,不是对每一条边的核实。地点规模函数的另一种写法没有实质差别,这句话也缺少可核对的差值。
一句话总结
同一地点只有在时间重叠时才构成家庭以外的候选见面,而真正留下的接触网络,是按活动目的和地点规模从这些候选里抽出的一张图;它能跟着分年龄的接触结构走,但不能当成当天被观察到的谈话。
核心来源
- Computers, Environment and Urban Systems 正式发表页面,核对题目、作者、卷期、在线日期与开放获取说明。正文 17 页,图 1–9 及附录图 C.10、C.11、D.12、E.13,表 1 与表 C.2 都在这一版内。
- 生成接触网络的代码入口为论文给出的 smartlab-lability。合成人口、活动日记和多层接触网络的数据包写为 Saadi(2025),Mendeley Data,V1,10.17632/577b3kfrsh.1;论文注明数据尚待通过。
- 活动日记来自 EQASIM(Hörl & Balac, 2021)。在家工作情景调用 PAM。分年龄对照为 Béraud 等人 2015 年法国接触调查;小学里的层份额来自 Génois 与 Barrat 2018 年。
作者介绍
以下只写论文署名机构和贡献说明。
- Ismaïl Saadi:通讯作者,署名剑桥大学临床医学院 MRC 流行病学单位。负责初稿、方法、形式分析、数据整理和构想。论文写明,工作主要在居斯塔夫·埃菲尔大学 Smart Lab LABILITY 完成,修订时作者已在剑桥。
- Etienne Côme:署名居斯塔夫·埃菲尔大学 COSYS-GRETTIA。负责审阅、指导、方法和构想。
- Liem Binh Luong Nguyen:署名巴黎公立医院集团 Cochin 医院 CIC Cochin Pasteur。负责审阅、指导、方法和构想。
- Mahdi Zargayouna:署名居斯塔夫·埃菲尔大学 COSYS-GRETTIA。负责审阅、指导、方法、经费和构想。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
地点细到地址,还是粗到市镇,可能比多模拟一天更影响接触网络。本文的教育地点只有 3,109 个,工作地点 74,953 个,住宅却有 1,368,177 个。若把同一批人先归进 IRIS 或市镇再连边,大地点里的候选对会暴增,而地点规模调整会把其中大部分丢掉。一个直接的检查是:只用论文已经生成的日记,把坐标逐级合并,看工作层的人均接触和教育–工作那一块年龄结构从哪一级开始明显变样。变样的那一级,就是这套估计还能相信的最粗空间单元。
在家工作的三档也还没碰到“谁可以回家”。25% 到 75% 之间,第 7 步的地理覆盖只从 0.56 降到 0.50,但这是按比例改写工作活动,不是按职业改写。合成人口里已经有社会职业分类。若改为只有部分职业离开工作地点,高接触尾部和市镇矩阵的外围色块不一定还呈现这种边际递减。在没有按职业重算之前,不宜把“第一档就够了”理解成对所有岗位都成立。