只保留较强的见面关系,圈子内部是不是就人人一样熟?
论文名片|Theus Hossmann、Thrasyvoulos Spyropoulos、Franck Legendre,A Complex Network Analysis of Human Mobility,2011 IEEE Conference on Computer Communications Workshops(INFOCOM WKSHPS),Network Science for Communication Networks(NetSciCom),2011,第 876–881 页。这是一项观察性的接触网络测量,不是转发实验。
两个人反复碰面,可能是同一间实验室的同事,也可能只是每天都经过同一个食堂。若把谁和谁见过收成一张网,常见直觉是:关系强的人抱成内部差不多一样熟的团,团和团之间才靠弱关系串起来。这个场景只帮助想象边权的差别,不是论文记下的某两个人。
Hossmann、Spyropoulos 和 Legendre 检查的是这个直觉的后半句。他们把四组移动记录收成一张加权接触图(weighted contact graph):节点是携带设备的人,边权同时计入见面次数和总时长。只保留较强的边时,网络仍然又密又短;加权图上也分得出社区。社区内部却仍然又疏又重尾,分布形态接近整张网,并不是一块人人一样熟的团。
先说结论
- 只保留全部可能节点对中最强的 4% 时,达特茅斯、ETH、Gowalla、MIT 的聚类系数是 0.54、0.53、0.26 和 0.57。同密度随机图的期望聚类系数是 0.04。此时平均最短路径是 2.6、4.0、2.8 和 3.8 跳,分母是这个二值图里能够连通的节点对,不是地理距离。
- 加权图上 Louvain 划分的模块度 Q,同一顺序为 0.84、0.81、0.7 和 0.52。随机划分的期望是 0。聚类高不等于模块度高:MIT 聚类高而 Q 最低,Gowalla 聚类最低而 Q 仍有 0.7。
- 社区不是完全图。社区内部边权为正的比例,同一顺序是 0.65、0.47、0.13 和 0.92,分母是同一社区内的节点对。Gowalla 有 87% 的社区内节点对没有正边权。
- 边权变异系数按同一顺序,全局为 3.4、2.7、7.2、2.5,社区内为 1.8、2.2、5.9、1.4,都高于指数分布的 1。社区内分布与全局形态相近。中位数通常社区更高,Gowalla 两边都是 0.24。
- 边权按节点加总再除以节点数之后,分布更接近指数,而不是无标度网络的幂律度分布。论文据此质疑按度中心性选中继的常见理由,但没有测量送达时间。
四组见面记录,为什么不能当成同一种边?
这里的分析单位是接触图里的节点和节点对,不是一个人一天的坐标序列。论文把一次接触定义为两台设备处于彼此无线传输范围内、可以交换数据的一段时间。四组数据把这句话落实成不同的事件,后面的边不能当成同一种物理碰面。
| 数据 | 节点与场景 | 时段 | 记录方式 | 接触总次数 | 每设备接触次数 |
|---|---|---|---|---|---|
| 达特茅斯 DART | 1,044,校园 | 17 周,2003-11-02 至 2004-02-28 | 接入点关联 | 4,200,000 | 4,000 |
| 苏黎世联邦理工 ETH | 285,校园 | 近 15 周;正文印为 2006-10-25 至 2006-02-03 | 接入点关联 | 99,000 | 350 |
| Gowalla | 473,得克萨斯州 | 6 个月,2010 年 4 月至 9 月 | 自行签到 | 19,000 | 40 |
| MIT | 92,校园学生和职员 | 轨迹中的 3 个月,未给起止日 | 蓝牙扫描 | 81,961 | 890 |
每设备接触次数是总次数除以人数后的取整,分母是上表节点数。MIT 最清楚:81,961÷92≈890.9,表中记为 890。达特茅斯 4,200,000÷1,044≈4,023,表中记为 4,000。这四组数字来自表 I,不是受访者问卷人数。
人选也有门槛。达特茅斯保留平均每周至少 5 天有关联的设备,即 17 周里至少 5×17=85 天。ETH 用同一规则,论文写成至少 75 天。Gowalla 保留 6 个月内每周至少 5 天在得克萨斯州有签到的重度用户。MIT 没有写同样的活跃天数门槛,只说取了 92 名校园学生和职员的 3 个月。筛选前的校园总人数或 Gowalla 全部用户数,论文没有给出。
ETH 的日历本身对不齐:开始日印成 2006 年 10 月 25 日,结束日印成 2006 年 2 月 3 日,结束早于开始。近 15 周和 75 天是论文给出的筛选口径,不能靠这两个日期再核对一遍跨度。
场景也不一样。达特茅斯同时有学校和住所;ETH 的接入点不在住宅楼里,主要记下工作时段。Gowalla 由签到应用的性质,更多是外出和社交。MIT 最小,但论文认为工作、住所和休闲都有。作者判断,来源多样使结果更一般;这是判断,不是对某座城市人口的抽样检验。结果描述的是这些高频设备,不是每周只出现一两天的人。
边的含义差在定义上。达特茅斯和 ETH 把同一时间连到同一个接入点视为接触,并事先去掉短于 60 秒的断连,以及设备在相邻接入点之间来回跳。这是共址推断,不是直接测到的无线电链路。Gowalla 没有签退,同一地点相隔不到 1 小时的签到记为一次接触,时长一律假定为 1 小时。论文脚注说明,若每次接触时长都相同,这个小时数不改变后文的边权图,因此这组数据分不开见面次数和见面时长。MIT 是四组里唯一直接扫描接触的数据,蓝牙间隔 5 分钟,较短的碰面可能没有被记上。后文的强,是在这些定义下相对本数据集更频繁或更久,不是四组共用的分钟数。
一个边权,怎样同时记住次数和时长?
机会网络把每次见面当成传数据的机会。见面勤,转发机会多;见面久,一次能传的数据多。这两件事不是同一个数,而大多数网络指标只接受每对节点一个权重。
论文先给节点对 {i, j} 一个二维特征。见面次数 fᵢⱼ 和总时长 tᵢⱼ 各自减去本数据集的均值,再除以标准差:
zᵢⱼ = ((fᵢⱼ − f̄) / σ_f, (tᵢⱼ − t̄) / σ_t)
然后投影到次数和时长变异最大的方向,也就是二者 2×2 协方差矩阵里最大特征值对应的特征向量 v₁:
wᵢⱼ = v₁ᵀ zᵢⱼ + w₀
w₀ 取没有接触的那一对在同一方向上的投影,用来把边权平移成正数。wᵢⱼ 越大,表示这对人相对本数据集的其他人见面更频繁或更久。它是标准化之后的分数,不是分钟,也不是次数。各数据集分开标准化,达特茅斯的 0.74 和 Gowalla 的 0.24 不能当成同样的见面强度。同一数据集内部,全局和社区可以比。
整段记录被收成一张静态图,等于假定这段时间里的见面规律大致稳定。论文写明,有些轨迹并不平稳;实际做协议可以用滑动窗口,但本文的表和图都没有报告窗口结果。
取阈值之前,四张图都是连通的:任意两个节点之间都存在一条路径。边权为正的节点对占全部节点对的比例,正文写为达特茅斯 0.12、ETH 0.09、Gowalla 0.04、MIT 0.68。表 IV 的全局密度一栏里,ETH 是 0.10,其余三组与正文相同。两处都指 wᵢⱼ > 0 的比例。0.09 和 0.10 是印刷差异,下面不把其中一个改写成另一个。
只留最强的一小部分边,路为什么还短?
图 1 是达特茅斯接触图的一种布局。同色节点聚成大小不等的团,团与团之间有灰色连线。图注没有定义颜色,不能把颜色当成后文社区划分的图例,也不能从图上数出社区个数。它只说明这张图肉眼就不像均匀撒开的随机点。
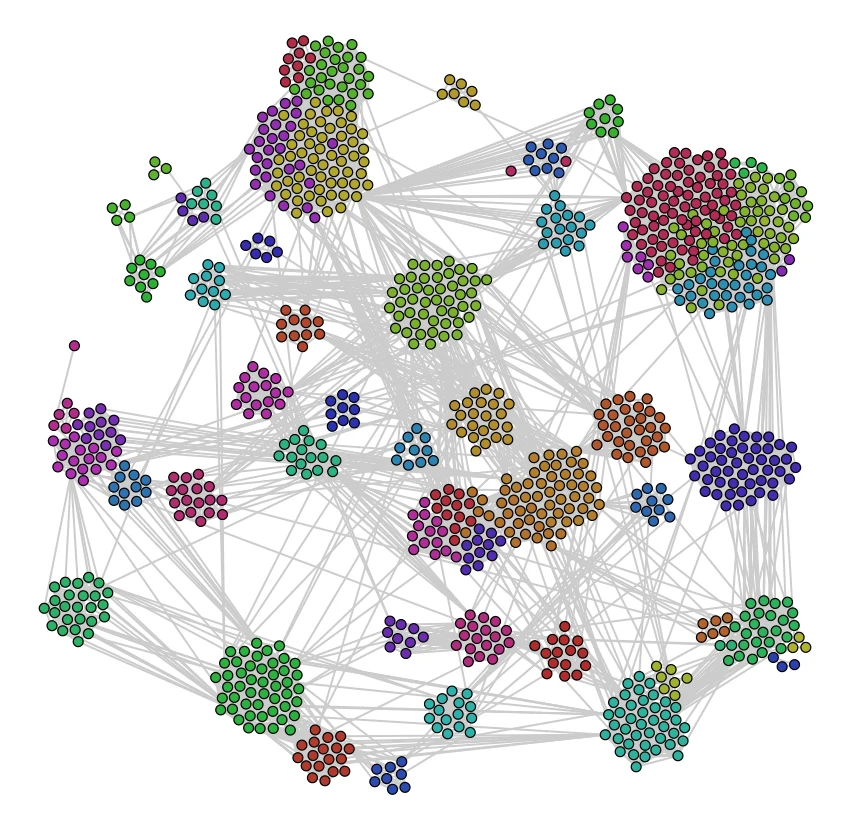
图 1|达特茅斯的接触图,肉眼是否已经不像随机连边?
无字母子图。节点是设备,灰色线是接触关系,颜色没有图例。能看到成团,不能读出聚类系数、路径长度或模块度。来源:原论文 Fig. 1。
要比较四组数据,需要两个有明确分母的指标。节点 i 的聚类系数,是连着 i 的三角形个数除以连着 i 的三元组个数,范围从 0 到 1,表示邻居之间也相连的比例。全图聚类系数是各节点这个比例的平均。平均路径长度是最短路径的跳数,对所有能够连通的节点对取平均。
加权图上这两个指标的推广不容易解释。论文改为按边权从高到低保留,使二值图的密度固定在 1%、2%、3% 和 4%。这里的密度是保留下来的边占全部可能节点对的比例。这样做是为了在四组之间对齐保留比例,不是因为存在一个跨数据集通用的分钟阈值。论文把留下来的部分称为可预测骨架,把去掉的部分称为更随机、更难预测的接触;这一步依据他们此前的工作,本文没有另报预测准确率。能直接从本文读出的是:最强的那些边本身长什么样。
对照是边以固定概率独立出现的随机图,常称 Erdős–Rényi 图。这种图的聚类系数期望等于密度。论文举例,10% 的节点对相连时期望聚类系数是 0.1;按同一关系,4% 时期望是 0.04,1% 时期望是 0.01。10% 只是解释这个线性关系,不是他们使用的阈值。
| 数据 | 聚类 1% | 聚类 2% | 聚类 3% | 聚类 4% | 路径 1% | 路径 2% | 路径 3% | 路径 4% |
|---|---|---|---|---|---|---|---|---|
| 达特茅斯 | 0.71 | 0.63 | 0.57 | 0.54 | 7.4 | 3.7 | 2.9 | 2.6 |
| ETH | — | 0.66 | 0.57 | 0.53 | — | 6.1 | 5.6 | 4.0 |
| Gowalla | 0.28 | 0.27 | 0.27 | 0.26 | 4.5 | 3.4 | 3.0 | 2.8 |
| MIT | — | — | 0.56 | 0.57 | — | — | 4.6 | 3.8 |
空格表示该密度下没有巨大连通分量,论文不报告一个小数。先看 4% 这一列,因为四组在这里都有巨大连通分量。聚类系数 0.54、0.53、0.26、0.57,基线都是 0.04。达特茅斯的 0.54 是这个基线的 13.5 倍,Gowalla 的 0.26 是 6.5 倍。平均路径是 2.6、4.0、2.8、3.8 跳。论文没有给出同规模随机图的路径长度,所以短是相对数跳而言,不是相对一条随机图基线算出的倍数。
1% 时只有达特茅斯和 Gowalla 仍有巨大连通分量。达特茅斯聚类 0.71,基线 0.01,路径 7.4 跳;Gowalla 聚类 0.28,路径 4.5 跳。ETH 在 1%、MIT 在 1% 和 2% 都没有巨大连通分量。阈值从紧放到松,聚类略降、路径变短,但高于同密度随机图、路径只有数跳这个方向保持不变。强到什么程度才连得起来,四组并不一样。
Gowalla 的聚类明显更低,四个阈值都在 0.26 到 0.28。论文把它归到签到更多记录外出和社交,而工作场所和住所里的关系更容易传递。这是按数据场景作的解释,不是用社会关系标签做过的检验。
小世界在这里采用 Newman 的用法:路径短,这一点随机图也有;聚类高,表示关系倾向于传递。两个条件一起出现,才叫小世界。Chaintreau 等人此前用传染式转发数过中继跳数,强边和只偶然见面的弱边都算进去,说明短路径可以存在,但没有说明只靠反复出现的强边也能短,也没有报聚类。他们的网络大约小一个数量级,MIT 已是其中最大的一组。本文把比较推进到约 1,000 个节点的达特茅斯,以及地理范围更宽的得克萨斯州签到。它支持的是强边骨架上的小世界,不是消息已经测出能够很快送达。
社区分得很开,是否就是内部人人相连?
社区在这里指一组节点,组内连接强于组向外面的连接。高聚类不一定产生这种分组。论文脚注举了环形格子:每个节点连接左右各 K 个邻居,K 是不小于 2 的常数,不做随机重连时,聚类系数可以到 3/4,但没有社区。所以表 II 的高聚类还要另做一次划分。
论文在加权接触图上使用 Louvain 算法,再用 Newman 的模块度 Q 衡量划分质量:
Q = 1/(2m) Σᵢⱼ (wᵢⱼ − dᵢ dⱼ / (2m)) δ(cᵢ, cⱼ)
dᵢ 是节点 i 连出的边权之和,m 是全网边权总和的一半,δ 在两人属于同一社区时为 1,否则为 0。随机划分的期望 Q 是 0。Newman 在若干社交和生物网络里报告过高于 0.3 的模块度,论文拿它作参照,不是显著性阈值。
| 数据 | 社区数 | Q |
|---|---|---|
| 达特茅斯 | 23 | 0.84 |
| ETH | 21 | 0.81 |
| Gowalla | 29 | 0.7 |
| MIT | 6 | 0.52 |
四组都高于 0,也高于 0.3 这一参照,范围是 0.52 到 0.84。论文用谱聚类做了第二次划分,写明结果很接近,但没有给出另一套社区数或 Q。
聚类和模块度在这四组里并不同步。达特茅斯和 ETH 两边都高。MIT 在 3% 和 4% 密度下聚类系数为 0.56 和 0.57,Q 却最低,只有 0.52。Gowalla 聚类最低,Q 仍有 0.7,并分出 29 个社区。论文的解释是:外出签到不太构成三角形,人仍会落入较大的群。这个解释和两个指标的定义相容,论文没有地点类型或社会关系标签来核对这些群是同学、同事还是别的群体。
社区规模也不整齐。图 2 只画了 ETH 和 Gowalla。达特茅斯的直方图因篇幅没有画出,论文说形态相同:多数社区不超过 10 个节点,同时有少数很大的社区。MIT 只有 6 个社区,论文认为不够用来谈规模分布。有的社区达到 100 个节点以上,这句话覆盖论文所讨论的这几组;图 2 里能直接看到的是 Gowalla 横轴 100 以上有柱,ETH 最大的柱落在 100 左侧。
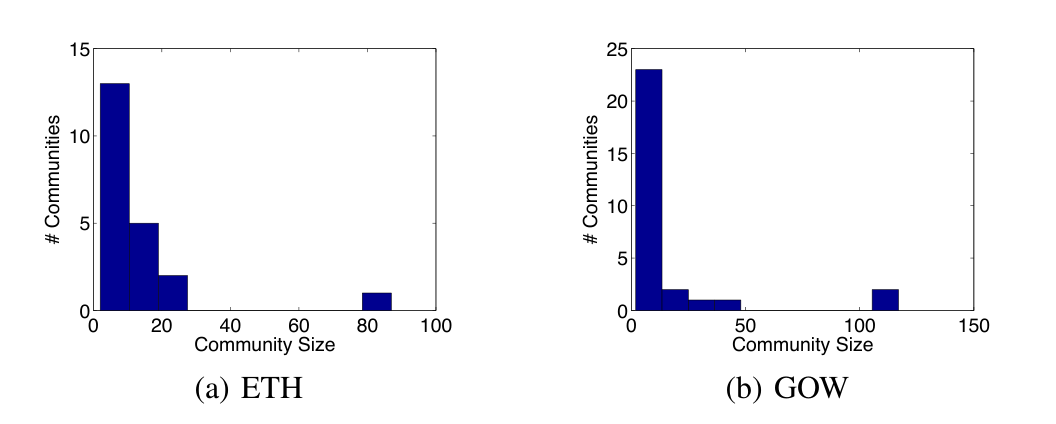
图 2|分出来的社区是差不多大,还是少数很大?
(a)ETH,横轴为社区人数,纵轴为社区个数,横轴画到 100,纵轴到 15。高柱靠在左端,80 到 100 之间还有一柱。(b)Gowalla,横轴画到 150,纵轴到 25。左端的柱最高,100 以上还有一柱。柱高没有逐柱标数,精确到个位的人数以论文文字为准:多数不超过 10 个节点。来源:原论文 Fig. 2。
大社区马上带出下一个问题。一百来个节点若真是人人一样熟,内部应接近一张权重均匀的完全图。下面的密度和分布拒绝这个图景。
圈子里面的强弱,为什么仍像整张网?
社区按定义内部更强,所以社区内边权的中位数应高于全部边权的中位数。分布重尾时,平均数容易被极强的几对拉开,论文因此使用中位数。边权仍是前面的标准化分数。
表 IV 有两套密度,分母不同。全局密度的分母是全部节点对:达特茅斯 0.12、ETH 0.10、Gowalla 0.04、MIT 0.68。社区密度的分母是同一社区内的节点对:0.65、0.47、0.13、0.92。MIT 最接近全连通,仍有 8% 的社区内节点对边权为 0。Gowalla 社区内部只有 13% 的节点对有正边权。被划进同一社区,不等于这两个人被记录为见过面。
| 统计量 | 范围 | 达特茅斯 | ETH | Gowalla | MIT |
|---|---|---|---|---|---|
| 密度 | 全局 | 0.12 | 0.10 | 0.04 | 0.68 |
| 密度 | 社区内 | 0.65 | 0.47 | 0.13 | 0.92 |
| 中位数 | 全局 | 0.02 | 0.16 | 0.24 | 0.1 |
| 中位数 | 社区内 | 0.74 | 0.34 | 0.24 | 0.94 |
| 变异系数 | 全局 | 3.4 | 2.7 | 7.2 | 2.5 |
| 变异系数 | 社区内 | 1.8 | 2.2 | 5.9 | 1.4 |
| 偏度 | 全局 | 8.7 | 5.8 | 33 | 7.3 |
| 偏度 | 社区内 | 5.1 | 4.5 | 21 | 4.5 |
| 峰度 | 全局 | 188 | 54 | 1431 | 105 |
| 峰度 | 社区内 | 72 | 34 | 607 | 44 |
中位数:达特茅斯社区内 0.74、全局 0.02;ETH 是 0.34 对 0.16;MIT 是 0.94 对 0.1。Gowalla 两边都是 0.24。论文概括说社区内中位数强得多。前三组符合,Gowalla 这一格不符合,不能把这句话套到每一格上。
变异系数大于 1,表示比指数分布更散;指数分布的变异系数是 1,偏度是 2,峰度是 9。四组边权的变异系数、偏度和峰度都高于这些参照,社区内也是如此,只是通常低于各自的全局值。Gowalla 的峰度尤其高,全局 1431、社区内 607。论文把更高的峰度读成分布更平、尾巴更厚。这些都是同一套标准化分数内部的形状比较,不是跨数据集的分钟差。
社区内边权是全部边权条目的子集,占条目数的 29%(达特茅斯)、59%(ETH)、42%(Gowalla)和 26%(MIT)。分母是边权条目个数,不是边权之和。它们也不是随机抽出的子集,而是必须落在同一社区内的那些对。因此,社区内分布和全局长得像,并不是抽样本身保证的。
图 3 把这个比较画成互补累积分布:纵轴是边权大于横轴数值的比例,坐标是双对数。黑色实线是全部节点对,红色虚线是社区内部。
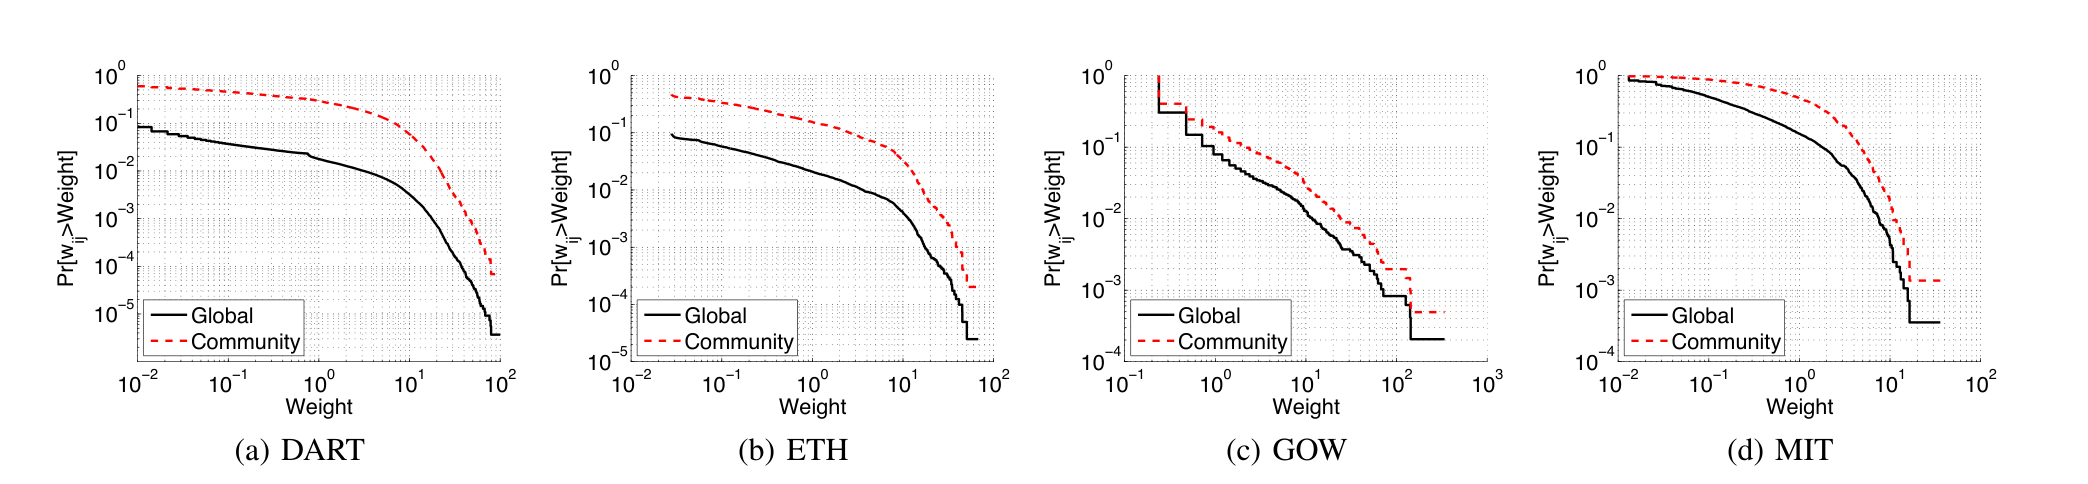
图 3|社区内部的边权分布,只是整体分布的加强版吗?
(a)达特茅斯,横轴边权从 10⁻² 到 10²,纵轴从 10⁻⁵ 到 10⁰。(b)ETH,坐标范围与(a)相近。(c)Gowalla,横轴从 10⁻¹ 到 10³,纵轴从 10⁻⁴ 到 10⁰,曲线呈阶梯。(d)MIT,横轴从 10⁻² 到 10²,纵轴从 10⁻⁴ 到 10⁰。四组都是黑实线为全局、红虚线为社区内部。红线整体位于黑线右上方,社区内较强的边权更常见。Gowalla 更接近一条斜直线,论文认为像幂律;另外三组在大权重端下降更快,论文认为尾巴更薄,可能分两段或接近对数正态。图上没有拟合指数。来源:原论文 Fig. 3。
形态相似、位置不同:社区内通常更强,但强弱不均的方式仍像整张网。对转发的含义停留在讨论。找到目的地所在的社区还不够,社区里面仍要再找路。Gowalla 0.13 的社区密度把这件事说得很具体:同一标签下,大多数节点对甚至没有正边权。本文没有做社区内转发实验,没有送达率。
节点强度为什么更接近指数,而不是无标度?
一个人可以不和社区里的每个人都见面,但仍被分进这个社区。论文预期,他对社区同伴的平均边权会更高。
归一化全局强度等于该节点全部边权之和,除以全网节点数。归一化社区强度等于他连向本社区其他节点的边权之和,除以该社区的节点数。分母是节点个数,所以这是平均边权,不是朋友人数,也不是二值图里的度数。论文脚注说,边权之和有时称节点强度(node strength),用来和二值图的度数区分。后文说的度分布,指的是这个归一化强度。
| 统计量 | 范围 | 达特茅斯 | ETH | Gowalla | MIT |
|---|---|---|---|---|---|
| 中位数 | 全局 | 0.10 | 0.09 | 0.02 | 0.41 |
| 中位数 | 社区内 | 1.7 | 0.7 | 0.08 | 1.8 |
| 变异系数 | 全局 | 0.9 | 1.2 | 1.9 | 0.7 |
| 变异系数 | 社区内 | 0.9 | 1.5 | 3.5 | 0.7 |
| 偏度 | 全局 | 2.2 | 2.1 | 5.0 | 1.0 |
| 偏度 | 社区内 | 2.6 | 2.3 | 6.3 | 1.4 |
| 峰度 | 全局 | 11.5 | 9.0 | 37 | 4.2 |
| 峰度 | 社区内 | 15.1 | 9.1 | 52 | 6.4 |
四组的社区内中位数都高于全局,包括边权中位数没有升高的 Gowalla:0.08 对 0.02。一个人可以在最典型的单条边上并不更强,同时对社区同伴的平均边权仍然更高。群体成员身份和某一对关系的强度,是两个尺度。
变异系数全局为 0.9、1.2、1.9、0.7,社区内为 0.9、1.5、3.5、0.7。除 Gowalla 外,它们靠近指数分布的 1,也明显小于表 IV 边权的 2.5 到 7.2。偏度的指数参照是 2,峰度的参照是 9。ETH 最接近这组参照,全局峰度就是 9.0。Gowalla 的偏度 5.0 和 6.3、峰度 37 和 52,偏离很大。MIT 的峰度 4.2 和 6.4 低于 9。论文把除 Gowalla 以外的三组概括为接近指数分布;这个概括对达特茅斯和 ETH 更稳,对 MIT 主要来自变异系数和后面的图形,而不是峰度已经等于 9。
图 4 用纵轴取对数、横轴不取对数的坐标画互补累积分布。指数分布在这种坐标上接近直线,幂律则不会。插图使用同一批数值,只是把横轴收到更短的范围,避免主图里靠近零的那一段被压成一条竖线。
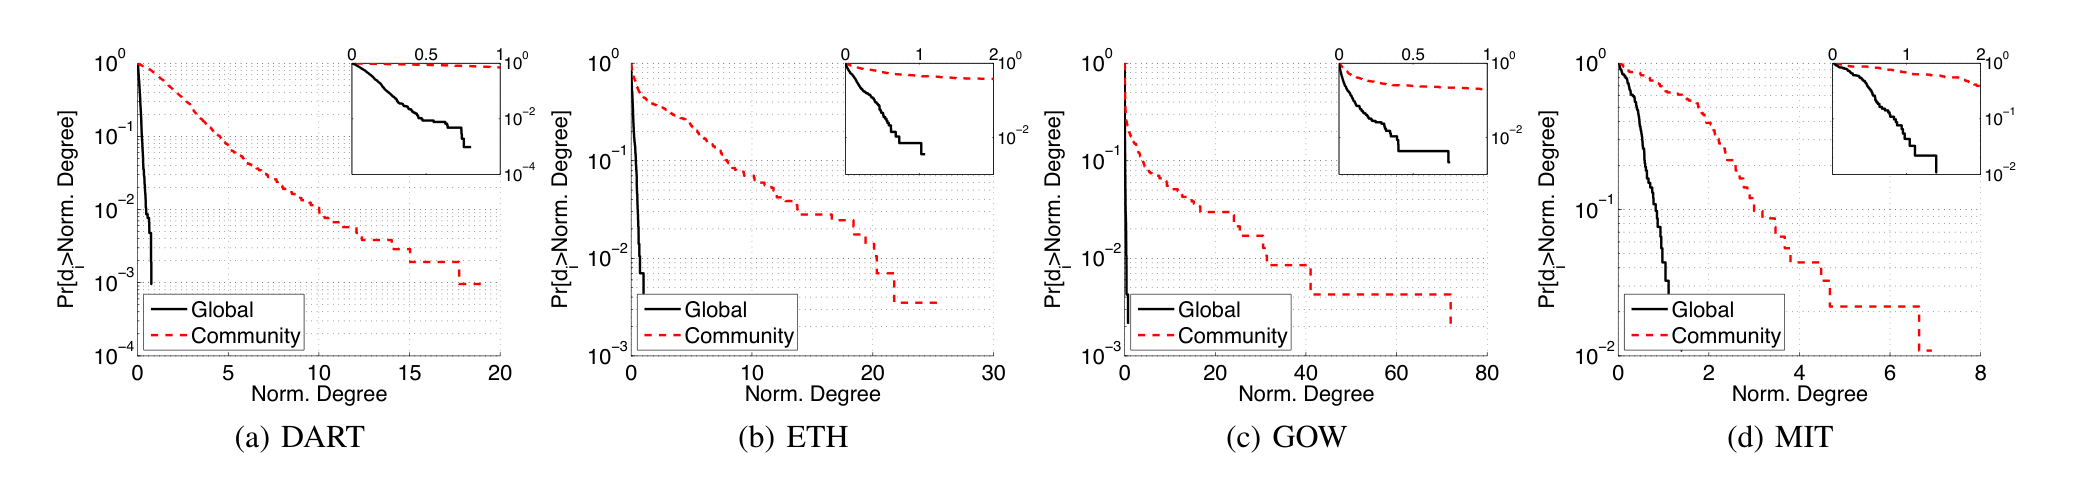
图 4|归一化强度是接近指数分布,还是接近无标度的幂律?
(a)达特茅斯,主图横轴到 20,纵轴从 10⁻⁴ 到 10⁰,插图横轴大约 0 到 1。(b)ETH,主图横轴到 30,纵轴从 10⁻³ 到 10⁰,插图大约 0 到 2。(c)Gowalla,主图横轴到 80,纵轴从 10⁻³ 到 10⁰,插图大约 0 到 1,尾巴最长。(d)MIT,主图横轴到 8,纵轴从 10⁻² 到 10⁰,插图大约 0 到 2。黑实线为全局,红虚线为社区内。达特茅斯和 ETH 的主图最接近直线,Gowalla 下降更慢。直线是视觉判断,加上表 V 的矩,不是正式的拟合检验。来源:原论文 Fig. 4。
度的异质性小于边权,而且不像无标度网络那种幂律度分布。许多按度中心性逐跳挑选中继的办法,理由来自无标度网络里的搜索。论文指出这个理由在这里不成立,并把它留作以后的定量问题。理由不足还不是实验结论:本文没有送达率,不能写成这种方法行不通。
全局和社区内的边权、强度在分布类型上相近。论文认为,两个尺度上也许可以用相近的路由策略,并暗示接触图可能像一些复杂网络那样跨尺度自相似。同一节写明,这种相似性还要再检验,也计划拿这些统计去对比合成移动模型。自相似和模型对比都不是本篇已经做出的结果。
这些比较能说到哪里?
可以比较有把握地说的是:在这四组记录、这套接触定义和整段时间汇总之下,最强的一小部分边同时具有高聚类和数跳的短路径;加权图的模块度高于随机划分,也高于论文引用的 0.3 参照;社区内部通常更强,但密度远不到处处相连,边权分布的重尾形态接近全局;归一化强度的异质性小于边权,形状更接近指数而不是幂律。
不能从这些图表推出的是:社区因为同学或同事关系才形成;高边权已经被证明可以事先预报,低边权一定是偶遇;某条路径上的消息要等多久;社区标签可以代替社区内部的寻路;四组边权的绝对值可以换算成同一套分钟。每周活跃不到筛选门槛的人、住宅里没有接入点的校园以外的生活,以及这四种记录方式以外的接触,都不在测量范围里。
已经做的稳健性,是 1% 到 4% 四个密度上的方向稳定,以及谱聚类与 Louvain 很接近这一句定性说明。没有数字的部分包括谱聚类的社区数、达特茅斯的社区规模直方图、滑动窗口,以及导航性和合成模型对比。ETH 正文密度 0.09 与表 IV 的 0.10 也不应被看成同一格印刷完全一致。
一句话总结
人与人的见面网在较强的边上已经是小世界,也分得出社区;社区却不是内部人人一样熟的团,它自己的边权和节点强度仍带着整张网那种不均匀。
核心来源
Theus Hossmann、Thrasyvoulos Spyropoulos、Franck Legendre,A Complex Network Analysis of Human Mobility,2011 IEEE Conference on Computer Communications Workshops(INFOCOM WKSHPS),Network Science for Communication Networks(NetSciCom),2011,第 876–881 页。图 1 至图 4、表 I 至表 V 均来自这一版正文。
作者介绍
- Theus Hossmann:论文署名为苏黎世联邦理工学院通信系统组。他与另外两位作者一起,把无线接触收成加权图,并讨论这种结构对移动模型和机会网络的含义。同一组作者在参考文献中的 2010 年 Infocom 论文,讨论如何把接触映射成转发可用的社会图。
- Thrasyvoulos Spyropoulos:论文署名为法国 EURECOM 的移动通信方向。论文没有另列职务。他参与的是同一项接触网络结构分析。
- Franck Legendre:论文署名为苏黎世联邦理工学院通信系统组,与 Hossmann 同一署名单位。论文没有另列职务。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个移动模型先划社区,再把社区内部画成权重差不多的团,它会直接错过表 IV。社区密度只有 0.13 到 0.92,社区内边权的变异系数仍是 1.4 到 5.9,高于指数分布的 1。只把模块度调到 0.5 以上也过不了这关:MIT 聚类高而 Q 只有 0.52,Gowalla 聚类低而 Q 有 0.7。一个和本文相称的检验,是用模型生成接触后再画社区内与全局的互补累积分布,看红线是否仍在黑线右上方,同时尾巴还在。
另一个容易混的尺度是 Gowalla 的两个中位数。单条边权的中位数,全局和社区内都是 0.24;归一化社区强度的中位数却是 0.08,全局是 0.02,分母分别是社区人数和全网 473 人。同社区可以提高一个人对同伴的平均边权,却不一定提高最典型的那一条边。把同一社区当成这两个人见面很强,就把这两个尺度叠在了一起。再加上 ETH 和 MIT 在只保留最强 1% 节点对时没有巨大连通分量,强到哪一档才既可重复又仍连得通,也不能由小世界这个名称单独决定。