用北京的出租车行程做训练,能填出成都和西安的格子流量吗?
论文名片|Chenyang Yu、Xinpeng Xie、Yan Huang、Chenxi Qiu,Harnessing LLMs for Cross-City OD Flow Prediction,The 32nd International Conference on Advances in Geographic Information Systems(SIGSPATIAL ’24),2024年10月29日至11月1日,美国亚特兰大。DOI:10.1145/3557915.3560938。同一份文本首页还印有 arXiv:2409.03937v1,2024年9月5日。
2009年3月2日至25日,北京有 3,100,845 条出租车行程。2016年10月1日至31日,成都有 3,887,769 条、西安有 2,419,072 条网约车行程。年份、城市和服务都不相同。论文把城市切成方格,用北京的行程微调一个大语言模型,再根据成都或西安每个起点格子的兴趣点构成和出发时间,预测目的地格子,最后数成一张起讫流量表。
在 1 公里格子上,这张表的均方根误差比深度迁移模型 GODDAG 大约低 46%。测试时模型已经拿到目标城市的起点和出发时间。格子放大到 2 公里后,优势缩到大约一成或 1%,而且同一份 PDF 把同一对误差数字标到了不同的城市。对称百分比误差印成 0.00 时,流量重叠指标仍是 0.57。前一个数汇总相对误差,后一个数汇总两边流量的重叠。
先说结论
- 训练只使用北京。测试城市是成都和西安,方向只有北京出发。1 公里上,成都的 RMSE 从 GODDAG 的 4.29 降到 2.29,西安从 3.94 降到 2.12。分母都是 GODDAG 的 RMSE,降幅分别约为 46.6% 和 46.2%。论文概括为 46%。
- RMSE 本身还要再除一次:它对目标城市全部格子对取平均,分母是格子数的平方。成都 1 公里有 30,028 个格子,分母是 901,680,784 个格子对;西安 1 公里有 14,001 个格子,分母是 196,028,001 个格子对。
- 四种基线在表 5 的每一列都是 SMAPE 2.00、CPC 0.00。LLM-COD 的 SMAPE 印成 0.00,CPC 在 1 公里两座城市都是 0.57。0.00 保留两位小数,CPC 又不到 1,不能读成每个格子对都完全重合。
- 2 公里上,和 GODDAG 同图例的两组差是 24.25 对 26.97(低 10.1%)以及 28.49 对 28.87(低 1.3%)。表 5、图 6 和表 6 没有把这两组稳定地标成同一座城市。
三座城市的行程,先被收成格子之间的计数
研究对象是格子之间的起讫流量(origin–destination flow,OD 流量):从格子 i 到格子 j 有多少次行程。计数单位是格子之间的行程条数。北京来自出租车轨迹,西安和成都来自滴滴网约车。表 3 没有写出行程筛选规则。
| 数据 | 行程数 | 时间 | 1 公里格子数 | 2 公里格子数 |
|---|---|---|---|---|
| 北京出租车 | 3,100,845 | 2009/3/2–2009/3/25 | 250,120 | 140,160 |
| 西安网约车 | 2,419,072 | 2016/10/1–2016/10/31 | 14,001 | 8,103 |
| 成都网约车 | 3,887,769 | 2016/10/1–2016/10/31 | 30,028 | 17,745 |
行程数的分母是行程条数。格子数是表 3 的空间单元数。若 1 公里格子互不重叠,北京 250,120 个格子对应约 25.0 万平方公里的范围。2 公里格子的面积是 1 公里格子的 4 倍,同一外接范围下格子数应约为 1/4。表中的实际比例是:北京 250,120/140,160 ≈ 1.78,成都 30,028/17,745 ≈ 1.69,西安 14,001/8,103 ≈ 1.73。PDF 没有给出外接矩形的坐标,也没有解释这组比例。
每个格子用兴趣点(point of interest,POI)的类型计数来描述。兴趣点归入中心离它最近的格子,实验通过地图服务查询格子中心附近的兴趣点。附录写共有 24 类,表 7 印出 23 行。印出的最高一行是居住区 105,183。23 行频率相加是 518,653。表没有写明城市、采集日期和是否去重,这个和只说明印刷行的合计。
方法举例里出现过 500 米格子。结果表和图只报告 1 公里与 2 公里。
已知起点和时间之后,模型在猜哪一个格子?
框架叫 LLM-COD。源城市有行程表,目标城市在问题定义里提供起点集合:每个起点格子和出发时间。模型输出目的地的兴趣点构成,以及一个可接受的出行代价。再在代价范围内,找兴趣点分布最接近的格子。把匹配到的格子对计数,就得到目标城市的流量矩阵。
图里的书店、学校、2.0 公里和上午 10 点是示意图上的例子。表 2 的示例回答是 1.3 公里、预测格子序号 23,只说明输入输出的格式。表 5 的误差是另一组测量。
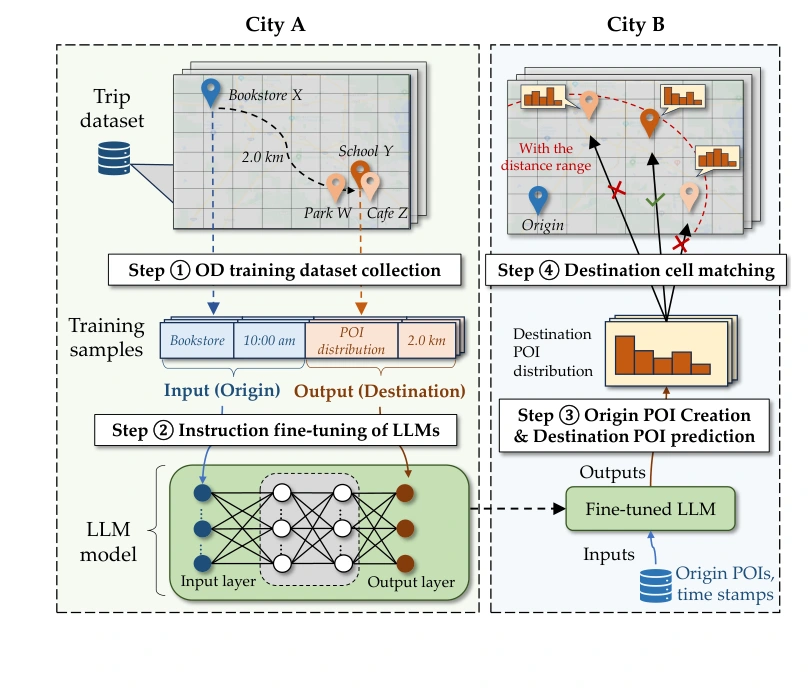
图 1|从源城市的行程到目标城市的格子流量,中间交出去了什么?
无子图字母。左侧城市 A 从行程得到训练样本:输入是起点兴趣点和出发时间,输出是目的地兴趣点分布和距离。右侧城市 B 把起点兴趣点和时间送入微调后的模型,得到目的地兴趣点分布,再在预测的距离范围内匹配格子。来源:原论文 Fig. 1。
因此,测试阶段使用的是目标城市的起点信息。贡献陈述里有一句“目标城市训练数据较少也能适应”,实验部分没有给出目标城市标注量从少到多的曲线。报告的设置是:成都和西安的行程不参与训练,预测时使用它们的起点。
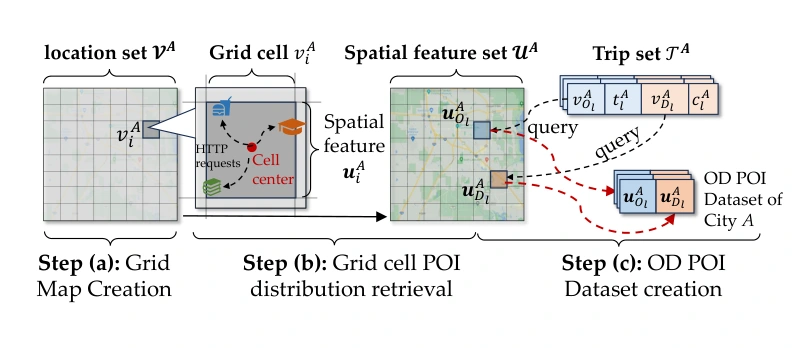
图 2|一条行程怎样变成模型能读的兴趣点样本?
(a)按城市范围切出等边长方格,记录格子中心。(b)向格子中心附近查询兴趣点,得到该格子各类兴趣点的数量。(c)每条行程保留起点格子、出发时间、终点格子和出行代价,并查回两端的兴趣点计数,组成城市 A 的训练样本。来源:原论文 Fig. 2。
微调使用 LLaMA2 7B,低秩适配(Low-Rank Adaptation,LoRA):原权重冻结,只训练低秩增量。PDF 没有给出秩、训练轮数和随机种子。优化器是 Adam,学习率 0.001,批大小 100,机器为 4 块 40GB 的 A100。随机森林、引力模型和 GBRT 也被写成使用 Adam,学习率 0.0002,权重衰减 0.001。
损失把两类东西放进同一次比较:目的地各类兴趣点的数量,以及出行代价。二者先一起做 softmax,再算加权交叉熵。代价的权重是 α。各类兴趣点的权重没有列表。
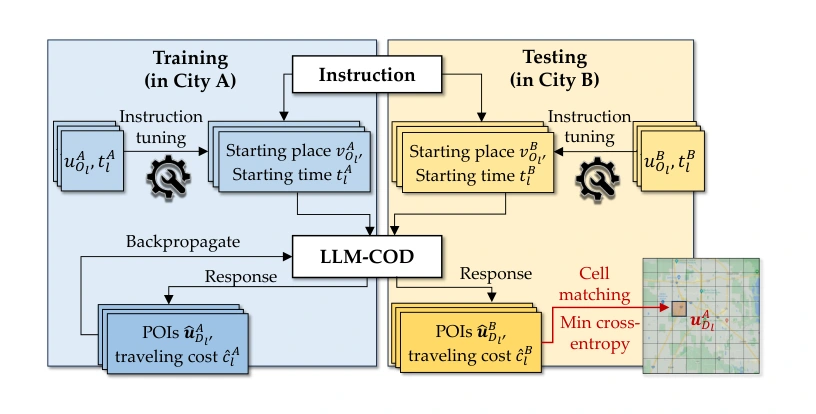
图 3|训练时回传什么,测试时拿什么去对格子?
无子图字母。左半是城市 A:起点和时间经过指令微调,模型给出目的地兴趣点和出行代价,再把损失传回参数。右半是城市 B:同样的指令格式产生兴趣点和代价,在候选格子里取交叉熵最小的一个。来源:原论文 Fig. 3。
方法部分还写,实验用 2024 年 3 月 1 日至 28 日的腾讯位置请求定义起点格子,并引用参考文献 [22] 中位置请求与居住人口的相关系数 0.9。该条文献的作者是 Qian、Liu 等,正文写成 Liu et al.。0.9 来自被引文献,本文没有对这三座城市重算该相关。第 4 节用来打分的真实流量,是 2009 年北京出租车和 2016 年成都、西安网约车。PDF 没有给出位置请求的条数,也没有说明 2024 年的起点层如何与这些行程对齐。
1 公里上,相对谁低了多少?
比较对象有四个。随机森林和 GBRT 是树模型。引力模型(gravity model)把区域特征当作质量,并假设流量随距离按幂律衰减;本文没有印出这次拟合的幂指数。GODDAG 是基于图网络和领域对抗训练的跨城市流量生成模型,相关工作把它写成目标城市可以没有流量标签。LLM-COD 的测试输入里则有目标城市的起点格子和出发时间。作者认为其他模型的结构用不上这组起点。表 5 因此比较的是各自结构下的结果,四类基线是否收到了同一份起点清单,PDF 没有单独列表。
误差有三个。RMSE 是格子对流量差的均方根,除以的是全部格子对的个数,也就是格子数乘格子数。CPC(Common Part of Commuters)把每个格子对上真实流量和预测流量的较小值加总,乘 2,再除以两边流量总和;范围是 0 到 1。名字用了 commuters,本文数据是出租车和网约车行程。SMAPE 是对称的百分比误差,论文写的范围是 0 到 2,越低越好。两边都是 0 的格子对会使单项分母变成 0,PDF 没有写明这些格子对怎么处理。基线全部顶在 2.00、CPC 又是 0.00,符合“只在至少一边有流量的格子对上计算,而且两边的正流量没有落在同一格子对”这种读法。
1 公里、北京出发的结果如下。SMAPE 与 CPC 在四种基线上都相同,表中仍按印刷值列出。
| 方法 | 成都 RMSE | 成都 SMAPE | 成都 CPC | 西安 RMSE | 西安 SMAPE | 西安 CPC |
|---|---|---|---|---|---|---|
| 随机森林 | 25.32 | 2.00 | 0.00 | 8.72 | 2.00 | 0.00 |
| 引力模型 | 13.08 | 2.00 | 0.00 | 10.56 | 2.00 | 0.00 |
| GBRT | 29.12 | 2.00 | 0.00 | 9.07 | 2.00 | 0.00 |
| GODDAG | 4.29 | 2.00 | 0.00 | 3.94 | 2.00 | 0.00 |
| LLM-COD | 2.29 | 0.00 | 0.57 | 2.12 | 0.00 | 0.57 |
成都相对 GODDAG 的降幅是 (4.29 − 2.29) / 4.29 ≈ 46.6%,西安是 (3.94 − 2.12) / 3.94 ≈ 46.2%。作者写成都略好于西安,并把原因归于路网和人口密度更接近北京;PDF 没有给出相似度的数值。1 公里上两座城市的 CPC 都是 0.57,西安的 RMSE 2.12 低于成都的 2.29。
CPC 0.57 的含义要连着公式读:较小值之和的两倍,占真实总流量与预测总流量之和的 57%。PDF 没有单列两个总量是否相等,所以 0.57 还不能改写成“57% 的行程被逐条找对”。SMAPE 印成 0.00,而完全相同的矩阵在 CPC 公式下会得到 1。两个印刷结果放在一起,说明 0.00 是保留两位小数后的汇总,不能单独当作逐格恢复。
格子放大到 2 公里后,城市标签对不上
2 公里的格子更少,单格流量可以更大,RMSE 的数量级也从个位数升到二十多。成都 17,745 个格子,RMSE 的分母是 314,885,025 个格子对;西安 8,103 个格子,分母是 65,658,609 个格子对。绝对 RMSE 不能跨分辨率直接比大小。
表 5 把 2 公里印刷为:
| 方法 | 表 5 成都 RMSE | CPC | 表 5 西安 RMSE | CPC |
|---|---|---|---|---|
| 随机森林 | 304.85 | 0.00 | 444.25 | 0.00 |
| 引力模型 | 50.51 | 0.00 | 67.8 | 0.00 |
| GBRT | 268.09 | 0.00 | 446.26 | 0.00 |
| GODDAG | 26.97 | 0.00 | 28.87 | 0.00 |
| LLM-COD | 24.25 | 0.63 | 28.49 | 0.42 |
SMAPE 在这四列里仍是基线 2.00、LLM-COD 0.00。按表 5 自己的城市标签,成都相对 GODDAG 低 (26.97 − 24.25) / 26.97 ≈ 10.1%,西安低 (28.87 − 28.49) / 28.87 ≈ 1.3%。
表 6 和表 8 的完整模型一行是:北京到成都 RMSE 28.49、CPC 0.63,北京到西安 RMSE 24.25、CPC 0.42。CPC 与城市的对应和表 5 一致,RMSE 与城市的对应对调了。正文 4.3 节写北京到西安的完整模型 RMSE 为 24.25、CPC 为 0.42,跟随的是表 6。图 6 的小图标题与图例也不一致:标题写西安的两张图,图例总误差是 24.25、随机森林 304.85、GODDAG 26.97,这组在表 5 里属于成都;标题写成都的两张图,图例是 28.49、随机森林 444.25、GODDAG 28.87,这组在表 5 里属于西安。
因此 2 公里上能够核对的是两组相对差距。城市名称仍随表格而变。24.25 相对同组 GODDAG 26.97 低约 10.1%,28.49 相对同组 28.87 低约 1.3%。CPC 0.63 在表 5 和表 6 都印在成都,0.42 都印在西安。
城市名、兴趣点种类和距离权重,各自动了哪一个数?
设计比较使用表 6 的城市标签,PDF 没有在这张表上写出格子边长。完整模型的 RMSE 是 28.49 和 24.25,数量级与 2 公里结果相同,与 1 公里的 2.29、2.12 不同。
去掉指令里的城市名后,成都 RMSE 从 28.49 升到 32.96,增加 4.47,相当于 4.47/28.49 ≈ 15.7%,CPC 从 0.63 降到 0.57。西安 RMSE 从 24.25 升到 27.96,增加 3.71,相当于 3.71/24.25 ≈ 15.3%,CPC 从 0.42 降到 0.40。正文只叙述了西安这一侧。
每个格子只保留一种兴趣点时,成都 RMSE 为 32.95、CPC 为 0.57,西安 RMSE 为 31.28、CPC 为 0.40。西安相对完整模型增加 7.03,相当于 7.03/24.25 ≈ 29.0%。多种兴趣点同时保留,对应的是这一列更低的 RMSE。选择单一类型时所依据的签到热度,PDF 没有给出次数表。
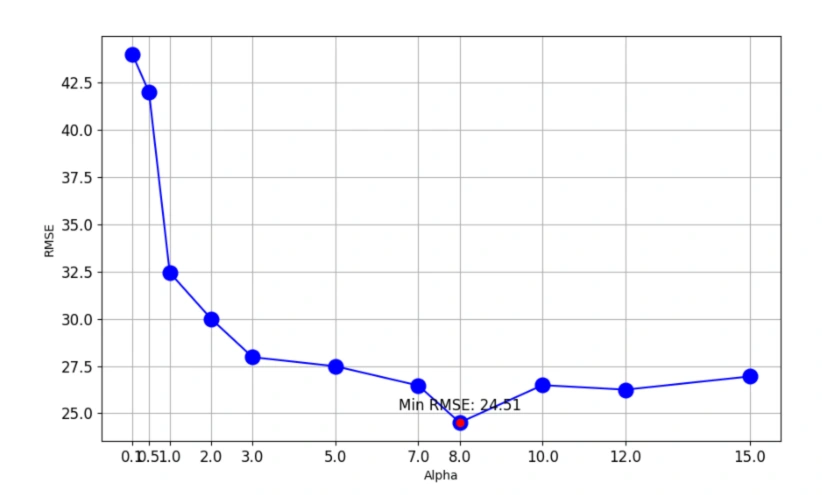
图 4|把距离项的权重 α 从轻调到重,平均 RMSE 会怎样走?
无子图字母。横轴 Alpha 的刻度包括 0、0.5、1、2、3、5、7、8、10、12 和 15,左端三个刻度挤在一起。纵轴是 RMSE。曲线从 42.5 的网格线以上下降,红点标在 8.0,注释为 Min RMSE: 24.51,之后略回升,右端仍低于 30。图内没有城市名和格子边长。24.51 与表中的 24.25 是两个印刷数字。来源:原论文 Fig. 4。
4.3 节开头写这组设计比较使用北京到西安。图 4 的最低点不能直接改写成表 6 的 24.25。作者对曲线的解释是:权重大低时距离约束不够,权重大高时模型会偏向更近的目的地,从而错过稍远但更常被选中的地点。这是对曲线形状的解释,图上没有按餐馆、酒店分类型给出误差。
附录把底模从 LLaMA2 换成 Gemma-7B。表 8 同样没有格子边长,LLaMA2 一行与表 6 完全相同。Gemma 在成都是 RMSE 21.07、CPC 0.66,相对 28.49 低 7.42,即 7.42/28.49 ≈ 26.0%。在西安是 RMSE 19.18、CPC 0.48,相对 24.25 低 5.07,即 5.07/24.25 ≈ 20.9%。SMAPE 仍是 0.00。这张表说明换一个更后面的底模,在同一套损失下误差还会下降。下降同时允许跨城市语义和模型容量两种解释,表 8 没有把二者拆开。
误差是出在大流量上,还是出在近距离上?
表 5 的 RMSE 把空格子对和繁忙格子对平均在一起。图 5 和图 6 改成分档曲线:上半部分是该档的 RMSE,下半部分是该档的样本数。图例里的 RMSE 是整张表的总误差,曲线上的点是某一档的误差。两张图都没有子图字母。
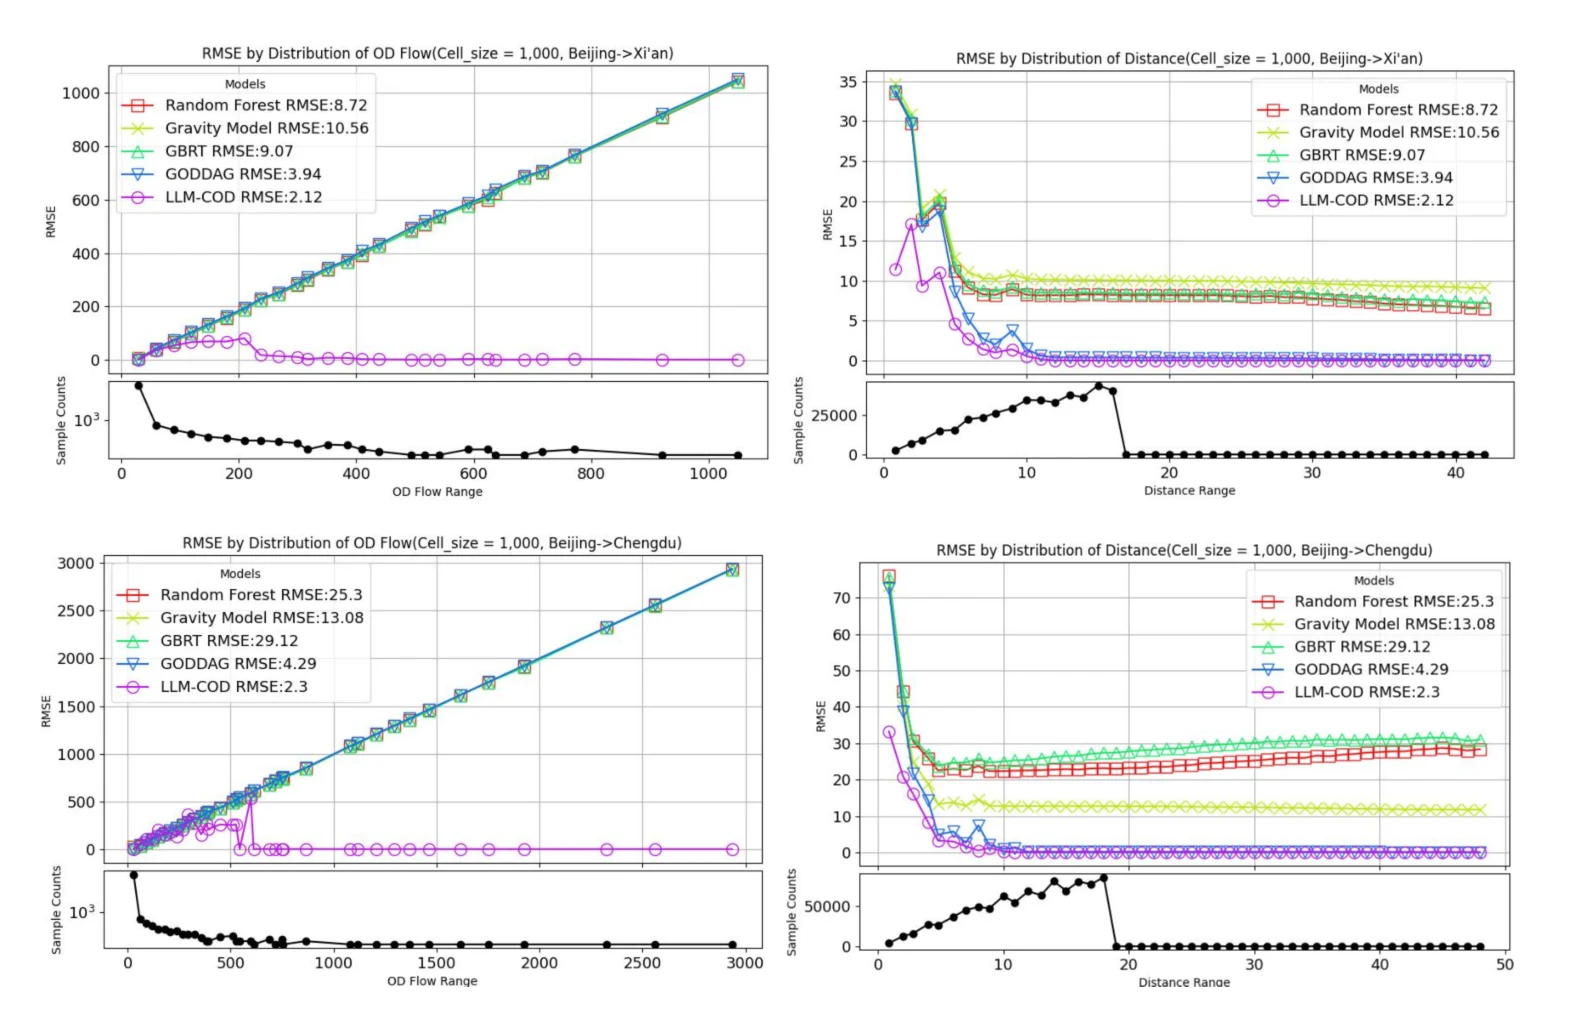
图 5|1 公里上,误差跟着流量档升高,还是跟着距离档升高?
左上:北京到西安,横轴流量档到 1000 以上,纵轴 RMSE 到 1000。随机森林、引力模型、GBRT 和 GODDAG 贴着对角线,分档误差和该档流量差不多大;LLM-COD 在低流量一侧抬起后回到横轴附近。图例总 RMSE 为 8.72、10.56、9.07、3.94、2.12,与表 5 的西安 1 公里一致。下方样本数是对数刻度,低流量档最高。
右上:同一城市对的距离档,纵轴 RMSE 到 35,横轴画到 40 以上,没有单位。短距离档全体最高,之后 LLM-COD 与 GODDAG 落到横轴附近,随机森林、GBRT 和引力模型停在更高的平台。样本数高点靠近 25,000 刻度,大约 17 之后落到横轴。
左下:北京到成都,流量档纵轴到 3000。基线同样沿对角线上升。LLM-COD 在中段有一次离开横轴的尖峰,尖峰没有标出坐标,随后回到横轴。图例把随机森林印成 25.3、LLM-COD 印成 2.3,表 5 对应 25.32 和 2.29。
右下:成都的距离档,纵轴到 70,横轴到 50,没有单位。短距离后 LLM-COD 与 GODDAG 接近横轴,树模型维持在更高处。样本数高点靠近 50,000 刻度,大约 18 之后落到横轴。来源:原论文 Fig. 5。
正文写 LLM-COD 在流量或距离变大时 RMSE 达到 0,并写八组设置都如此。曲线显示的是:大流量档和大距离档上它靠近横轴,低流量和短距离上仍有离开横轴的点。距离图后半段的 0 与样本曲线的 0 出现在同一段,长距离误差变小发生在图上几乎没有样本的档位。基线在流量图上贴着对角线,说明那些档的误差规模接近流量本身;这也解释了为什么整表 RMSE 可以只有 2 左右,繁忙格子对上的分档误差仍然可以很大。整表 RMSE 的分母里有数以亿计的格子对。
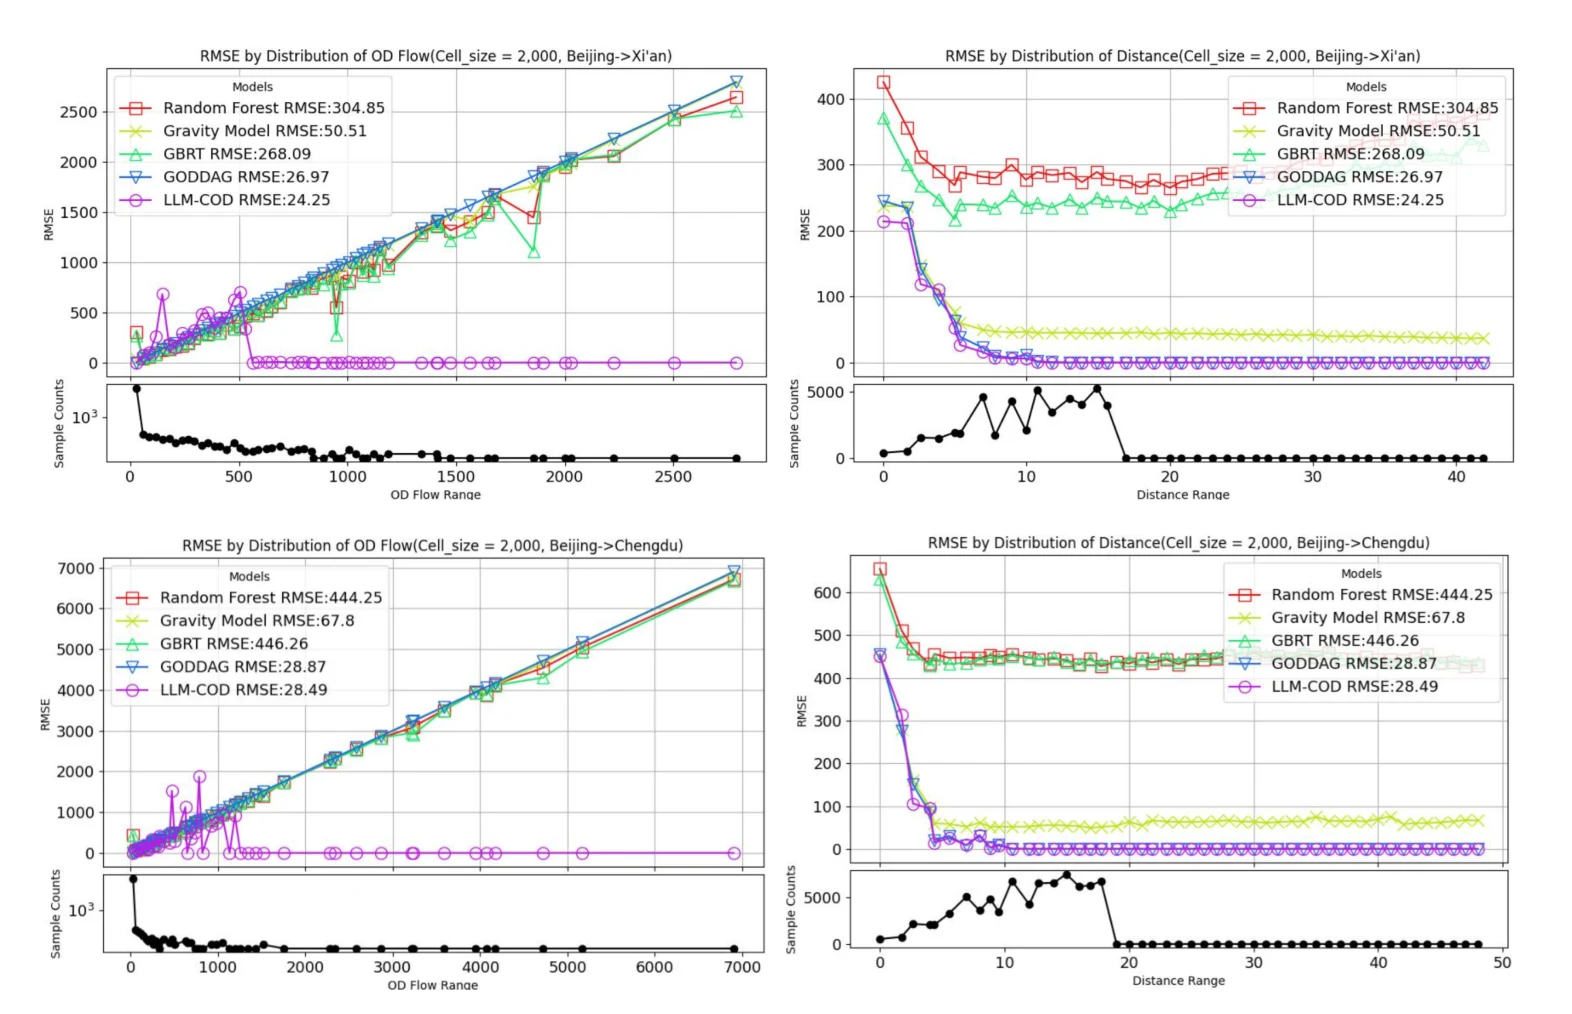
图 6|2 公里上,分档曲线还保持同样的形状吗?
左上标题是北京到西安、2 公里、流量档,纵轴到 2500 以上。图例却是随机森林 304.85、引力模型 50.51、GBRT 268.09、GODDAG 26.97、LLM-COD 24.25,与表 5 的成都列一致。树模型和 GODDAG 大体沿对角线上升,LLM-COD 在左侧有尖峰,之后靠近横轴。样本数向高流量档下降。
右上标题同为西安、距离档,纵轴到 400,横轴到 40 以上。图例数字与左上相同。随机森林和 GBRT 在数百的高度起伏,引力模型降到较低平台,LLM-COD 与 GODDAG 降向横轴。样本数高点靠近 5,000 刻度,大约 18 之后落到横轴。
左下标题是北京到成都、流量档,纵轴到 7000。图例是随机森林 444.25、引力模型 67.8、GBRT 446.26、GODDAG 28.87、LLM-COD 28.49,与表 5 的西安列一致。形状仍是基线沿对角线、LLM-COD 在前半段尖峰后回到横轴。
右下标题为成都、距离档,纵轴到 600,横轴到 50。图例数字与左下相同。短距离最高,LLM-COD 与 GODDAG 随后接近横轴,树模型维持高位。样本数同样在大约 18 之后落到横轴。来源:原论文 Fig. 6。
读这四张小图时,标题里的城市名和图例里的总 RMSE 不能同时当真。曲线形状本身仍然清楚:2 公里上,树模型的分档误差继续随着流量档升高;LLM-COD 的低误差主要出现在样本已经变少的高流量档,以及样本落到横轴之后的长距离档。
西安的弧线,有没有从外围指向市中心?
最后一张图把北京到西安、2 公里的流量画成弧线。色标标题是 OD Flow,刻度到 945。正文指定绿色为起点、白色为终点,并写真实行程大多从周边进入市中心,LLM-COD 复现了这个格局。面板上的点并没有再印一套颜色图例。
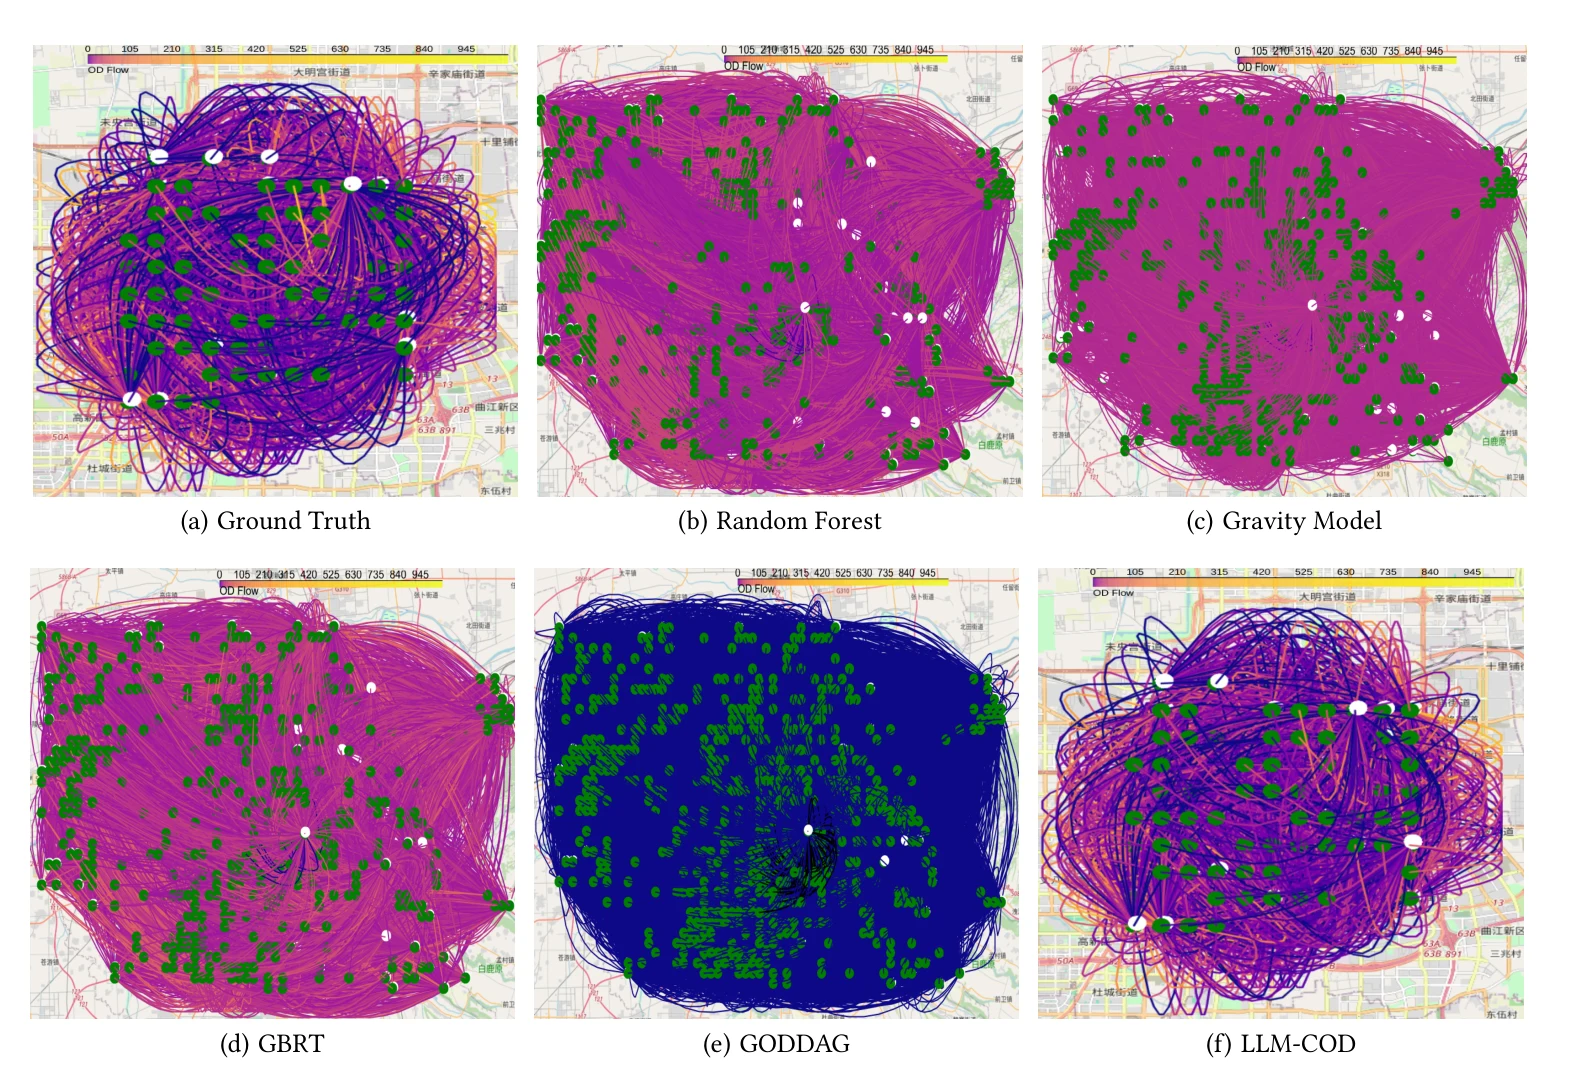
图 7|2 公里的西安流量,空间形态更接近哪一张对照?
(a)真实流量是一团紫红色弧线,绿色圆点和白色点都集中在城区中部。(b)随机森林、(c)引力模型、(d)GBRT 都是铺满城区的洋红色弧线,绿色点散在其中。(e)GODDAG 是深蓝色椭圆带,绿色点分布更开,白色点很少。(f)LLM-COD 回到紫红色弧线和较集中的绿点、白点,视觉上更接近(a)。(e)则是深蓝色椭圆。来源:原论文 Fig. 7。
正文把 GODDAG 写成 Figure 7c,并描述蓝色弧线和西北—东南方向的椭圆。图上的字母是(c)引力模型、(e)GODDAG,蓝色椭圆在(e)。后文又把引力模型写成 7c、随机森林写成 7b、GBRT 写成 7d,与图下字母一致。椭圆这一观察可以对上(e),字母需要按图下的标注读。
(f)与(a)的相似是弧线颜色和点的聚集方式。它不提供逐个格子对的误差,也不能代替表 5 的 RMSE 或 CPC。基线看起来“更满”,可能来自弧线更多,也可能来自颜色尺度被高流量占满。各面板都标到 945,PDF 没有说明每张小图是否各自拉伸颜色。
这些比较停在哪一层
1 公里上,LLM-COD 相对 GODDAG 的 RMSE 降幅可以按表 5 复核,大约 46%。这项比较发生在三个条件同时成立的时候:测试使用目标城市的起点格子和出发时间;RMSE 对全部格子对平均;训练是 2009 年北京出租车,测试是 2016 年成都和西安网约车。换服务、换年份和换城市叠在同一次转移里。
CPC 0.57 和 SMAPE 0.00 给出的完成度不同。基线 CPC 为 0、SMAPE 为 2,表示正流量没有落在相同格子对上。流量分档图则显示,繁忙档的基线误差可以跟流量一样大。长距离档的误差靠近 0 时,样本曲线也靠近 0。
2 公里的城市标签在表 5、图 6 和表 6 之间不一致。在这个分辨率上,本文只把相对 GODDAG 的差距写成“大约 10.1% 或 1.3% 的两组”,不把 24.25 固定成某一座城市的已核实成绩。表 6、表 8 和图 4 都没有印刷格子边长。图 4 的最低 RMSE 24.51 也没有和 24.25 印成同一个数。
PDF 没有重复实验、置信区间、LoRA 的秩、训练轮数、兴趣点权重、500 米结果、反方向城市对,也没有目标城市标注量曲线。格子数与 4 倍面积缩放不合,外接范围没有坐标。位置请求和行程表的对齐没有样本量表。更低的 RMSE 说明在上述定义下更接近表 5 的矩阵,还留着指标、分辨率和城市标签三处需要分开看的读数。
一句话总结
在测试时已经知道起点格子和出发时间的条件下,用北京出租车行程微调的语言模型,使成都和西安 1 公里流量表的 RMSE 比 GODDAG 低大约 46%;这个平均误差摊在全部格子对上,2 公里时优势变小,同一份 PDF 也没有把较大的那组误差稳定地标到同一座城市。
核心来源
- 论文首页的会议引用:SIGSPATIAL ’24,2024年10月29日至11月1日,亚特兰大;首页印刷的 DOI 为 10.1145/3557915.3560938。首页同时印有 arXiv:2409.03937v1,2024年9月5日。正文图 1–7、表 1–8 和附录 A、B 都在这份文本内。
- 北京出租车行程引自 Shang、Li、Bao,2018,DITA,SIGMOD。西安与成都行程在脚注中指向滴滴盖亚数据。兴趣点在脚注中指向腾讯地图服务。起点格子的例子指向腾讯位置请求,相关系数 0.9 引自文中参考文献 [22]。
作者介绍
四位作者都署名北得克萨斯大学计算机科学与工程系。
- Chenyang Yu:论文列出的邮箱为 my.unt.edu。文本没有另写个人研究方向。
- Xinpeng Xie:论文列出的邮箱同为 my.unt.edu。文本没有另写个人研究方向。
- Yan Huang:学校教师页写明为该系 Regents Professor,研究时空数据库与空间数据挖掘、智能交通和基于位置的社交网络。页上邮箱与论文中的 yan.huang@unt.edu 一致。
- Chenxi Qiu:学校页面写明为该系助理教授,研究包括空间计算、统计隐私和移动计算。页上邮箱与论文中的 chenxi.qiu@unt.edu 一致。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市已经有打车请求的起点和出发时间,只缺目的地调查,LLM-COD 使用的正是这种输入。若手里只有人口和距离、没有起点清单,实验里的引力模型更接近当时能做的事。46% 的 RMSE 差距同时混有模型差异和输入差异。下一步可以把同一份起点清单交给四种基线,再看还剩多少差距。
交通部门若只看整表 RMSE,1 公里上 2.29 会显得很小,因为分母是 9.02 亿个格子对。图 5 已经表明,繁忙档的基线误差可以和流量一样大,而 LLM-COD 的 SMAPE 印成 0.00 时 CPC 仍是 0.57。汇报时至少同时给出整表 RMSE、按流量加权的误差,以及 CPC。只留一个数,完成度会跟着指标的分母改变。
长距离档的误差落到横轴时,样本数也落到横轴。用这个结果规划跨区长途运力之前,需要一批真正有行程的长距离档,并且最好只改变城市、保持年份和服务不变。本文一次跨过了 2009 年出租车和 2016 年网约车。2 公里结果还要先把表 5、图 6 和表 6 的城市标签对齐,否则 10% 和 1% 的改进不知道该记在成都还是西安。