回到去过的地方之后,下一步为什么仍不好预测?
论文名片|Douglas do Couto Teixeira、Jussara M. Almeida、Aline Carneiro Viana,On estimating the predictability of human mobility: the role of routine,EPJ Data Science,2021,10:49。2020年11月11日收稿,2021年9月13日接收。DOI:10.1140/epjds/s13688-021-00304-8。
工作日早晨,一个人从家里出来,到已经去过的早餐店,再到单位。五分钟后他还在不在这一格,常常就是还在;下一次换到哪一格,早餐和单位的先后一对调就会猜错。地点都出现过,两问的难度却不一样。
这篇论文把一条地点序列拆成两部分。地点第一次出现,记为新奇(novelty);此后每一次再出现,记为例行(routine)。例行在这里包括只出现第二次的地点。日常口语里的例行,通常指一遍遍前往的地方。两套口径同时记住,后面的数字才不会读错。
拆开之后,论文做两件测量。第一,造一条同样长、第一次到访次数也相同的参照序列,把再访全部换成同一个地点的重复,看真实序列的熵高出多少。第二,用停留、地点是否集中、到访顺序这三件事,去拟合每个用户例行部分的熵。拟合解释的是用户之间熵的高低,尚未证明人按这三条规则决定下一步。
先说结论
- 在本文的定义里,再访占序列的大部分。通话详单的下一地点分析中,个别用户的新奇访问最多占该用户全部访问的 22%。
- 相对“再访永远是同一个地点”的参照,论文报告的用户平均缺口为:下一格,GPS 2.6%、通话详单 13%;下一地点,GPS 13.5%、通话详单 22.2%。
- 用规律性、驻留和轨迹多样性拟合例行熵,下一格任务的调整后 R² 在通话详单上达到 0.960;GPS 在规律性与驻留之外再放入序列长度和基线熵后达到 0.849。
- 去掉连续停留、改问下一次不同的格子之后,同样的拟合下降。GPS 最高 0.750,通话详单最高 0.855。五分钟一次的 GPS 里,驻留已经覆盖了顺序指标的大部分信息。
猜下一格,和猜下一次换到哪里,差在停不停
可预测性(predictability)沿用 Song 等人 2010 年的做法。给定一个人按时间排列的地点序列,它估计一条通用预测器猜对下一个符号的比例上限,取值在 0 到 1 之间。这个上限建立在两条前提上:序列来自统计性质不随时间改变、而且足够长的一段样本能够代表这个人的平稳遍历过程;预测器是不依赖特定训练集的通用预测器,马尔可夫模型属于这一类。针对一份数据单独训练的神经网络,不在这个保证里。人搬到另一座城市,也不符合“规律长期不变”。
同一条序列可以问两个问题。下一格预测(next-cell)保留连续重复:人在下一格时间仍停在当前格子,也算一个待预测的符号。下一地点预测(next-place)删掉连续重复,只问下一次出现的不同格子。论文用的例子是,序列 A, B, A, A, A, D, B, B, B, C, F 在下一地点任务里变成 A, B, A, D, B, C, F。停得越久,下一格越好猜;把停留拿掉,序列更短,也更难。
熵(entropy)在这里度量下一个符号有多不确定,单位是每个符号的比特。论文采用基于压缩的估计:重复片段越长、越多,熵越低。可预测性上限再由熵和不同地点数换算。后文的回归直接拟合例行部分的熵,不把熵的差值当成某个导航软件已经达到的准确率。
第二次到访为什么也算例行?
给定序列 X,每个地点的第一次出现归入新奇,其余出现归入例行。这样分,是因为多数预测方法靠已经见过的地点来猜下一次;第一次出现的地点没有这段历史。再访虽然有历史,顺序仍可以变:天气、临时起意、事件,都会打乱常去地点的先后。本文把新奇次数留在原样,专门看再访偏离一条完全重复的参照有多远。

图 1|一条地点序列里,哪些格子是第一次出现?
无字母子图。每个字母是一个地点。灰色是新奇,白色是例行。它只说明分类规则,不是某个人的真实行程,也不能从灰白格读出这个人去过多少个不同地方。来源:原论文 Fig. 1。
参照序列把再访收成同一个地点,比的是什么?
真实序列的熵同时受三件事影响:序列有多长、第一次到访有多少、再访的顺序有多乱。前两件不隔开,就无法把熵的高低归因到例行。论文的参照序列因此满足三条:长度与原序列相同,新奇符号的个数相同,再访部分改成同一个地点的重复。附录论证,第一次到访落在序列的哪个位置,不改变它们在熵估计分母里的合计贡献,所以可以用相同的新奇次数对齐两条序列。
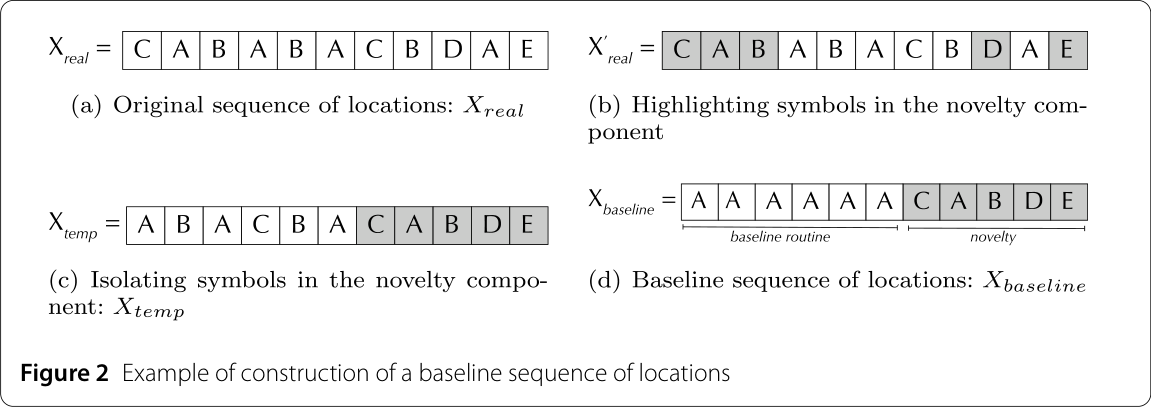
图 2|参照序列改了例行的哪一部分?
(a)原始地点序列。(b)灰色标出新奇符号。(c)把新奇符号移到序列后部,前部留下再访;论文据此隔离两类符号。(d)前部的再访换成同一个地点的重复,后部仍是原来那些新奇符号。两条序列的差别落在再访是否还有顺序变化。来源:原论文 Fig. 2。
记真实序列的熵为 S_real,参照序列的熵为 S_baseline。缺口写成 ΔS_routine = S_real − S_baseline。参照的再访没有顺序变化,真实熵高出的部分,被论文当作例行里难预测的行为,并在后文称为可预测性缺口。式中两项都是熵。结果图的横轴和正文平均值则用百分比。论文没有给出从比特换算成百分比的公式,下面的百分数按论文报告的用户平均值理解。
谁被记录下来,一格是多大?
研究用两套粒度不同的观测,分析单位都是用户的地点序列。
GPS 来自志愿者安装的 Android 应用 MACACOApp,每 5 分钟记录一次位置,同时还有流量和网络连接。全体志愿者 132 人,分布在两大洲的六个国家;其中 67 人来自同一个国家,身份是举办过讲座的两所大学里的学生、研究人员和行政人员。为避免跨国差异,后文分析只用这 67 人。论文没有写出这 67 人所在的国家,也没有给出精确的起止日期,只在后文说这套轨迹跨越数月。
通话详单(call detail records,CDR)来自中国一家大型运营商,时间是 2015 年的两周。用户拨出或接听语音通话时产生记录;论文使用的位置是该小时的质心,半径 200 米,不是传统基站的覆盖范围。原始用户 642,000 人,均已匿名。筛选规则与 Song 等人相同:平均每 2 小时至少有一个位置。筛完保留 3,349 人,也就是 3349/642000。留下来的是记录较完整的用户,不能把后面的缺口直接读成全部用户的情况。
两套数据都把区域画成边长 200 米的方格,时间放进固定间隔,坐标换成格子编号。GPS 在未另作说明时是每 5 分钟一个观测;通话详单保证平均每 2 小时至少一个观测。这里的“到访”是序列里出现的格子,包括路过的格子,不是只保留停留点。因此下一地点序列会比“只预测停留点”的定义更长。熵估计在更长的序列上更稳,也意味着这里的下一地点是下一次不同的格子。
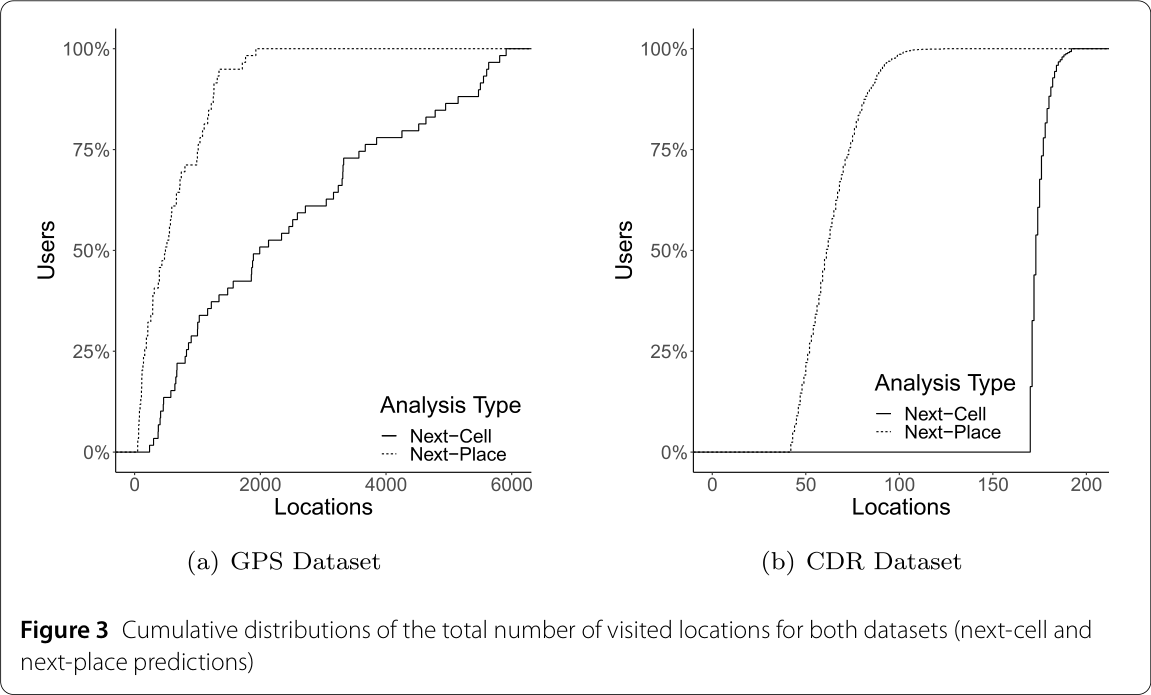
图 3|每个人的序列有多长?
横轴是地点观测次数,纵轴是用户的累积比例。实线是下一格,虚线是删掉连续停留后的下一地点。(a)GPS,横轴直到约 6000 次;下一地点的曲线更早升到 100%,因为去掉停留后序列变短。(b)通话详单,横轴只到约 200 次,两周、更稀的采样下序列短得多。正文给出的平均长度是 GPS 2388.8 次、通话详单 174.7 次,分母是各数据集的用户,计的是观测次数,不是不同地点个数。下一地点更短,论文没有再给那一组的平均数。来源:原论文 Fig. 3。
再访占多数之后,新奇还剩多少?
对每个用户,新奇次数和再访次数除以该用户的序列长度 n,两个比例相加为 1。
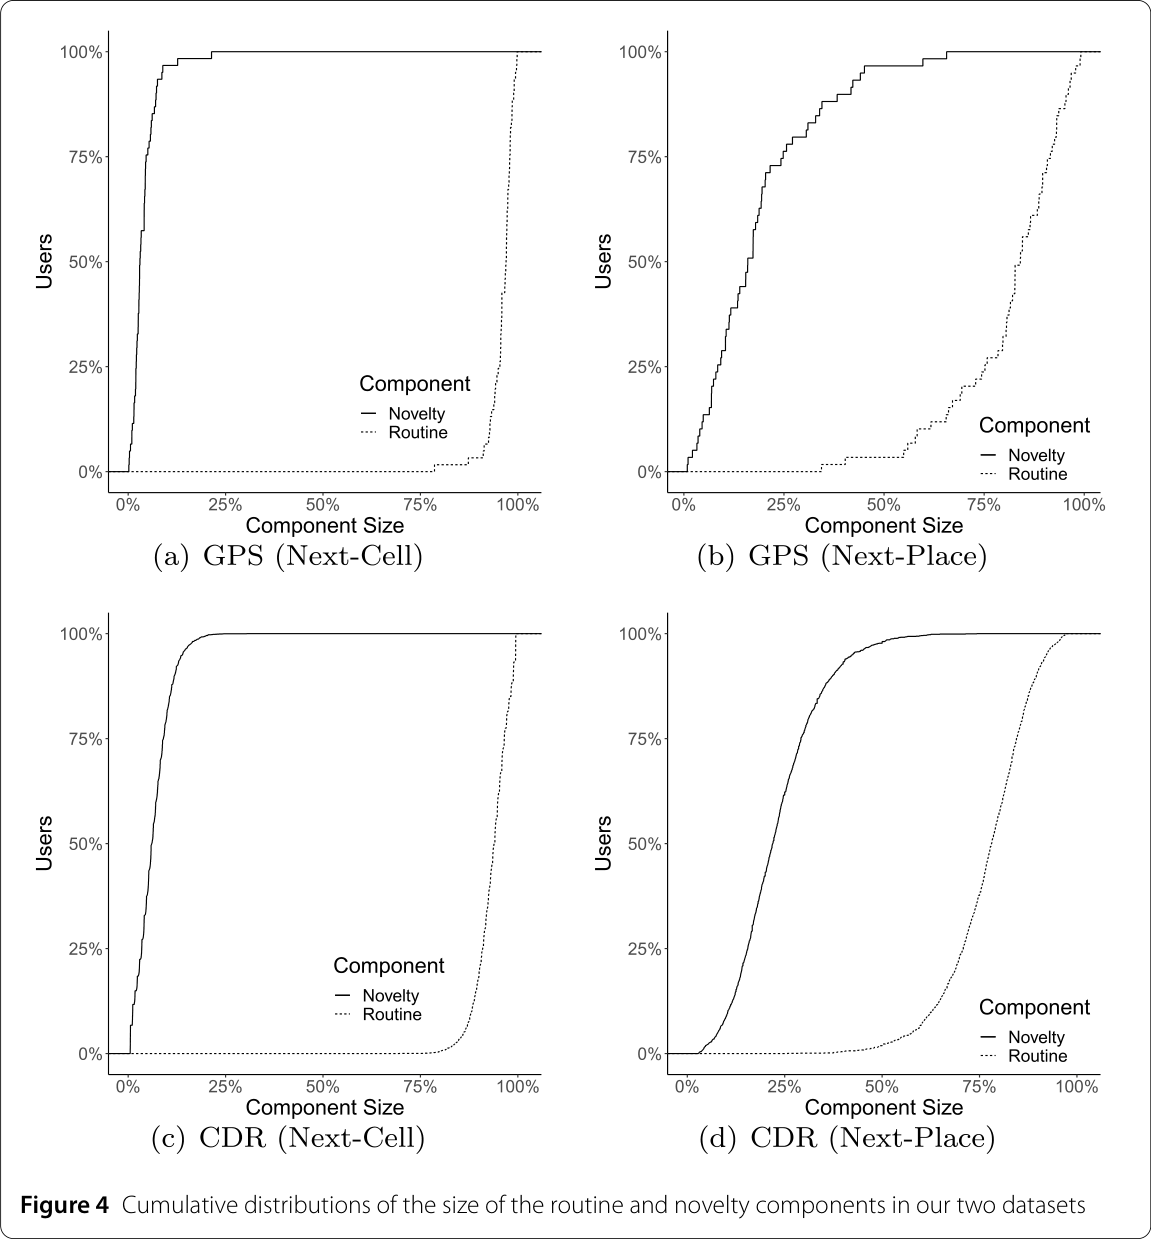
图 4|新奇和例行各占这条序列的多少?
横轴是该部分占 n 的比例,纵轴是用户累积比例。实线为新奇,虚线为例行。(a)GPS 下一格,(c)通话详单下一格:新奇曲线很快升到 100%,多数用户的新奇比例很低,例行接近整条序列。(b)GPS 下一地点:去掉停留后,新奇比例整体右移。(d)通话详单下一地点:新奇比例最大。正文写明,尤其在这组里,有的用户新奇访问最多占该用户全部访问的 22%。比例高,只说明第一次出现的格子更多,不能推出这个人更爱探索。来源:原论文 Fig. 4。
GPS 的记录更长,例行份额也更大,与既往研究里“新地点会随时间变少”的方向一致。下一地点同时丢掉停留、又留下更大的新奇份额,所以比下一格更难。这是序列构成上的预期,还不是缺口本身。
和永远回到同一个地点相比,平均高出多少?
把每个用户的 ΔS_routine 画出来,看再访离那条完全重复的参照有多远。
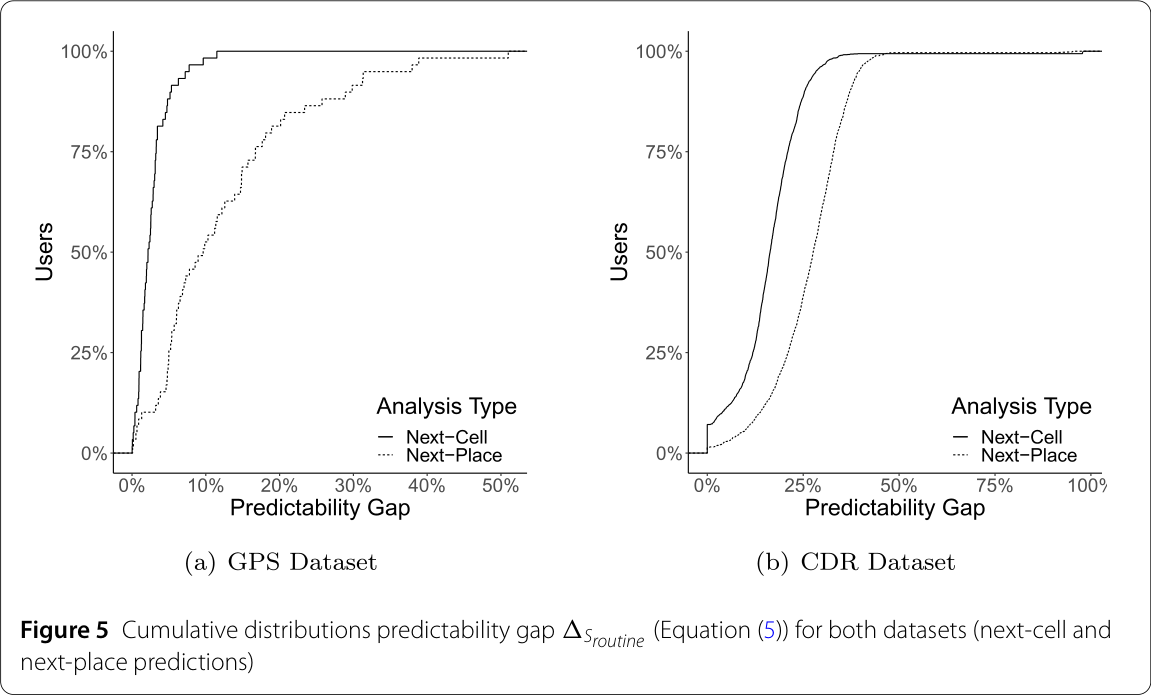
图 5|例行带来的缺口在用户之间有多散?
横轴是可预测性缺口,纵轴是用户累积比例。实线为下一格,虚线为下一地点。(a)GPS 的下一格曲线在大约 10% 处已经接近 100%,下一地点上升更慢,横轴大约画到 50%。(b)通话详单的两条曲线都更靠右,横轴画到 100%。来源:原论文 Fig. 5。
论文报告的用户平均缺口:下一格,GPS 2.6%、通话详单 13%;下一地点,GPS 13.5%、通话详单 22.2%。分母是对应数据集、对应任务里的用户。停留把下一格的平均缺口压低;去掉停留后,例行内部的顺序变化露出来。通话详单的缺口在两个任务里都更大。作者推测,原因是它更短、时间更稀,记下的停留更少。这是猜想。两套数据的人群、时长和采样并没有被配成同一批人的两种记录。
缺口也因人差别很大。平均值不能当成每个人的下一步都只剩这几个百分点的不确定性。
停留、地点集中和顺序,各与例行熵有多齐?
缺口说明再访里仍有难预测的部分。论文接着只用每个用户的例行子序列,看三种可直接数出来的量能不能解释这段子序列的熵。
规律性(regularity)是 reg = 1 − n_unique / n。n 是这段例行的长度,n_unique 是其中不同地点的个数。不同地点越少,规律性越接近 1。
驻留(stationarity)是 st = 停留转移数 / (n − 1)。相邻两个观测落在同一格,计一次停留转移。下一地点任务已经删掉这种相邻重复,驻留在该任务里没有定义。
轨迹多样性(diversity of trajectories)是不同子串的个数,除以长度为 n 的序列里全部子串的个数 n(n+1)/2。子串越丰富,顺序越不固定。
两条构造出来的长度 10 的例行可以看见第三项的作用。H、W、S 只是三个地点符号。序列 H, W, S 反复出现,和把这三段的内部顺序打乱,都有 3 个不同地点,规律性都是 1 − 3/10 = 0.7;相邻位置都没有重复,驻留都是 0/9 = 0。论文算出前一条的熵为 1.50 比特,后一条为 2.18 比特;多样性分别为 0.49 和 0.76。地点集合相同,顺序不同,熵可以差一截。
连续六个相同符号 A, A, A, A, A, A 的多样性是 6/21 = 0.28。长度为 6 的全部子串有 21 个,不同子串只有 A 到 AAAAAA 这 6 个,而且每一个都是停留。五分钟一次的 GPS 里这种长停留很多,多样性会和驻留缠在一起。
下表是这三个量与例行熵的斯皮尔曼相关系数。每一格的样本是该数据集、该任务中的用户,不是每一次出行。
| 任务与数据 | 规律性与熵 | 驻留与熵 | 多样性与熵 |
|---|---|---|---|
| 下一格,GPS | −0.46 | −0.78 | 0.54 |
| 下一格,通话详单 | −0.70 | −0.94 | 0.98 |
| 下一地点,GPS | −0.41 | 无定义 | 0.15 |
| 下一地点,通话详单 | −0.53 | 无定义 | 0.84 |
规律性和驻留越高,熵越低;多样性越高,熵越高。下一格里,驻留与多样性的相关为 GPS −0.74、通话详单 −0.95,两者共享了大量“停着不动”的信息。多样性与熵的相关,在四组里有三组强于规律性;GPS 的下一地点是例外,多样性只有 0.15,规律性为 −0.41。正文里“多样性在所有情形都比规律性更强”这一句,覆盖不了这组例外。
这些指标能记下多少用户之间的熵?
回归的因变量是用户例行部分的熵。调整后 R² 表示,在这一批用户的例行熵方差里,模型记下了多少。它是同批数据上的拟合,论文没有报告独立留出的测试。
下一格先用规律性和驻留,记为 RS;再加上多样性,记为 RSD。高度相关的变量之间还有一个交互项。
| 下一格模型 | GPS 调整后 R² | 通话详单调整后 R² |
|---|---|---|
| RS,规律性 + 驻留 | 0.786 | 0.939 |
| RSD,再加多样性 | 0.783 | 0.960 |
GPS 上,多样性的 p 值为 0.34,RSD 的 0.783 并不高于 RS 的 0.786。只含规律性和驻留的模型里,两项系数的 p 值都小于 10⁻⁵,方向是越高则熵越低。五分钟采样里的长停留,已经由驻留记下;多样性再数一遍那些重复子串,几乎不增加解释。
通话详单上,RSD 的全部系数 p 值都小于 10⁻²⁶,调整后 R² 从 0.939 升到 0.960。记录更短、时间更稀,单靠停留盖不住顺序。正文另有一句说两个模型在两套数据上的 R² 相同;表 4 里,GPS 几乎相同且略降,通话详单升高 0.021。以表为准。
摘要里的“最高 84.9% 和 96.0%”不是表 4 的同一行。0.960 就是通话详单的 RSD。GPS 这边,作者把序列长度 n 加进 RS,调整后 R² 为 0.839;再加入参照序列的基线熵,升到 0.849。通话详单加入 n 后调整后 R² 没有升高,n 的 p 值为 0.04。
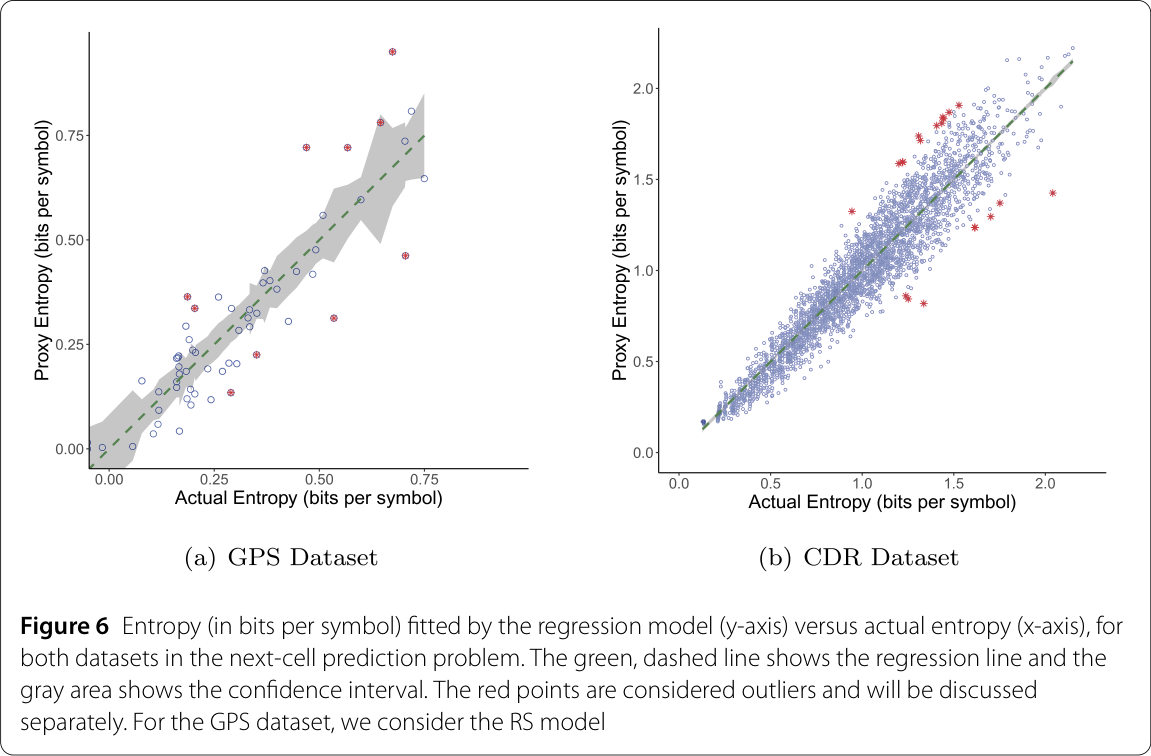
图 6|下一格的例行熵,拟合值和实际值差多远?
横轴是例行部分的实际熵,纵轴是模型给出的代理熵,单位都是每个符号的比特。绿虚线是回归线,灰带是置信区间,红点是离群用户。点靠近对角线,表示该用户的熵被对应模型对上了。(a)GPS 纵轴刻度到 0.75 比特;图内说明写明这一面板用的是 RS,不含多样性。(b)通话详单的点更密,纵轴刻度到 2 比特,红点偏离对角线。正文又说这些图按完整 RSD 绘制。GPS 面板以图内文字为准。来源:原论文 Fig. 6。
作者抽看了 GPS 的 10 个离群用户和通话详单的 20 个。熵估计会随序列变长而下降。GPS 里例行超过 1000 个地点的长序列,以及通话详单里过滤后不足 40 次观测的用户,都出现在拟合偏离的情形里。论文对长序列究竟是把熵估高还是估低,前后有两句相反的话;图 6 只把红点标成离群,没有逐点标出方向。可以确认的是:序列长度会牵动熵的估计,代理指标没有把长度完全吸收。
不问还在不在原地,顺序指标才更有用
下一地点模型拿掉驻留,并放入序列长度 n。表中四行的调整后 R² 逐行升高。表注把后续模型写成先加多样性、再加 n、再加基线熵,行名却印成 RN、RND、RNDB。下面按行名列出印出的数值,不把行名改成表注的缩写。
| 下一地点模型 | GPS 调整后 R² | 通话详单调整后 R² |
|---|---|---|
| R | 0.672 | 0.735 |
| RN | 0.723 | 0.801 |
| RND | 0.739 | 0.852 |
| RNDB | 0.750 | 0.855 |
从 R 到 RNDB,GPS 的调整后 R² 上升 0.078,通话详单上升 0.120。若按行名把 RN 到 RND 看成加入多样性,增量是 0.016 和 0.051;RND 到 RNDB 的增量是 0.011 和 0.003。正文写基线熵带来 1.1% 和 0.3%,与 0.011、0.003 的百分数写法一致。同一段写多样性使调整后 R² 提高 7.2%(GPS)和 9.9%(通话详单)。这两个百分数不等于 0.016 和 0.051,也不是 0.016/0.723 与 0.051/0.801。结论里又把 7.2% 和 9.9% 说成相对既有指标的提升。阅读拟合水平时用表 5 的调整后 R²。论文还写明,下一地点各系数的 p 值都小于 0.05。
和下一格的 0.786、0.960 相比,下一地点的 0.750 和 0.855 更低。停留一旦不在序列里,规律性和多样性记下的方差就少一截。通话详单上多样性与熵的相关达 0.84,加入之后 R² 的升幅也大于 GPS。指标的轻重随数据的时间粒度改变;这仍是样本内拟合的差别,不能直接换成“换一种采样就必须换一种预测器”的操作建议。
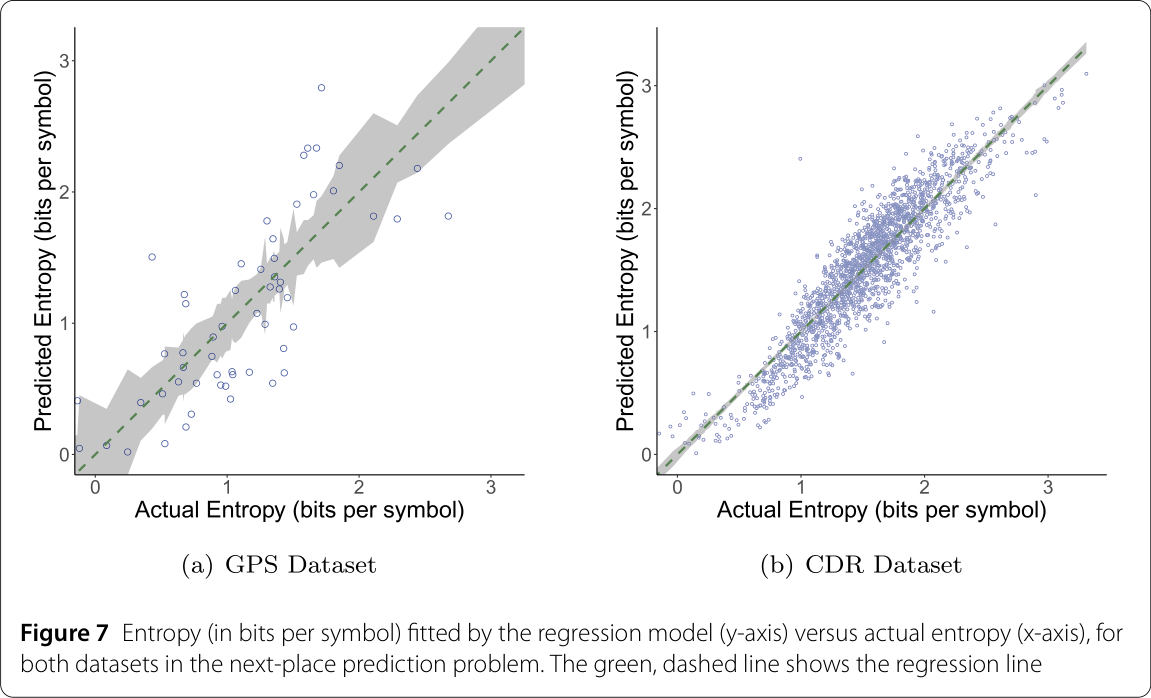
图 7|下一地点的例行熵,拟合还贴着对角线吗?
横轴为实际熵,纵轴为模型预测的熵,单位是每个符号的比特,刻度大约都到 3。绿虚线是回归线。正文说图 7 用的是 RND 模型;图注只标明这条绿虚线。(a)GPS 的点更散,线周的灰带更宽。(b)通话详单的点更贴着对角线,与表中 RND 一行 0.852 的调整后 R² 相符。来源:原论文 Fig. 7。
图 7 的熵整体高于图 6。下一格里大量“仍在原地”把熵压到 1 比特以下;下一地点必须在不同格子之间选择,不确定性更大。贴合对角线说明三组计数能重建熵的高低,不说明已经找到人改变顺序的原因。
这些比较停在哪一层?
相关和回归都在用户之间比较,不能推出“让一个人多停一会儿,他的下一步就会更好预测”。驻留高和熵低会同时出现在五分钟一次的记录里,因为人本来就会在家或单位停留许多个 5 分钟。
两套数据不能互相代表。GPS 是 132 名志愿者中同一国家的 67 人,来自两所大学;通话详单是 642,000 人里记录较密的 3,349 人,只有 2015 年的两周。国家名、运营商名和 GPS 的具体月份,论文都没有给出。200 米格子和固定时间间隔会把格子内部的移动抹平,也会把一次停留切成许多个重复符号。
可预测性上限不是已部署模型的准确率。神经网络可以落在通用预测器的保证之外,既往工作里也出现过超过该上限的情形。本文没有报告一个实际的下一地点预测器在这些用户上猜对了多少次。
例行的操作定义把第二次到访也算进去。一个只去过两次的格子,和每个工作日都去的单位,在这个分类里同属例行。规律性会惩罚不同地点的个数,仍然不区分“去过两次”和“去过两百次”。
调整后 R² 高,表示这三组计数与熵一起变化。GPS 下一格里多样性不显著,不能写成多样性在任何采样下都没有作用;通话详单下一地点里它与熵相关 0.84,也不能写成顺序就是熵的唯一来源。
一句话总结
再访占了记录的大部分之后,人是否还停在原地,仍比他下一次换到哪个旧格子更容易从序列里看出来;旧地点之间的顺序变化,本身就留在例行的熵里。
核心来源
- EPJ Data Science 论文页面,DOI:10.1140/epjds/s13688-021-00304-8。正式题为 On estimating the predictability of human mobility: the role of routine,2021 年,10:49。正文图 1–7、表 1–5 与附录都在这篇 30 页的文章里。
- 可预测性上限来自 Song、Qu、Blumm 与 Barabási,Limits of Predictability in Human Mobility,Science,2010,327(5968):1018–1021。本文沿用其熵与上限,并把序列拆成新奇和例行。
- 论文给出的代码入口为 https://github.com/dougct/predictability。GPS 与通话详单因隐私和保密协议不能公开。
作者介绍
以下只写论文署明的机构、分工,以及参考文献里能对上的研究方向。论文没有给出职务头衔。
- Douglas do Couto Teixeira:通讯作者,同时署米纳斯吉拉斯联邦大学、École Polytechnique/IPP 与 Inria。与另两位共同设计研究,并负责数据预处理和分析。参考文献中的前作讨论过情境、驻留和规律性如何影响移动可预测性。
- Jussara M. Almeida:署米纳斯吉拉斯联邦大学。共同设计研究,并参与写作与定稿。
- Aline Carneiro Viana:署 Inria(帕莱索)。共同设计研究,并参与写作与定稿。数据不能公开时,论文把访问问询指向她。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果同一批人先按 5 分钟记录,再把记录抽成平均每 2 小时一个点,本文的对比提示:后一种序列会少掉许多停留,例行熵和那个“永远同一地点”的缺口都可能变大。现在的两套数据来自不同的人、不同的周数和不同的设备,还不能把 13% 与 2.6% 的平均缺口差算成采样间隔本身的效果。要检验这一点,需要同一用户的两种时间粒度,并保持 200 米格子不变。
第二个可以单独测量的量,是再访次数的分布。本文把第二次出现和第二百次出现都放进例行。一个为办事去过两次的格子,会和一个每个工作日都出现的单位分享这个标签。若把例行再按到访次数切开,规律性与熵的相关还能否保持 −0.46 或 −0.70,是这篇文章没有回答的问题。
第三条与那两个长度为 10 的构造序列有关。三个地点、没有连续停留的两段行程,熵可以是 1.50 比特,也可以是 2.18 比特。一个只保存“常去地点名单”的服务,面对的是规律性已经固定、多样性仍可能从 0.49 变到 0.76 的情形。它若要降低的是下一地点的熵,就还需要顺序,而不是更长的地点名单。这组数字来自构造序列,不是 67 名或 3,349 名用户的实测熵。