同样的等待,夜里和白天为什么不能共用一个回复概率?
论文名片|Linyun Yu、Peng Cui、Chaoming Song、Tianyang Zhang、Shiqiang Yang,A Temporally Heterogeneous Survival Framework with Application to Social Behavior Dynamics,Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining(KDD ’17),2017年8月13–17日,加拿大哈利法克斯,页1295–1304。DOI:10.1145/3097983.3098189。PDF首页印出的地址是 http://dx.doi.org/10.1145/3097983.3098189 。本文依据这篇会议论文解读;PDF共10页,内无补充材料。
晚上11点发出的一条微博,和中午12点发出的另一条,如果都过了8小时才出现回复,前一段等待里往往夹着睡眠,后一段更接近对方醒来之后仍把这件事往后放。只统计回复间隔有多长,会把这两种等待合成同一条长尾;只统计一天里几点人多,又会把已经等了10秒和已经等了10小时看成同一种强度。这篇论文要放进同一个模型的,就是钟表上的时刻,以及从被回复的那条消息到回复发出去过了多久。
方向很明确:把此刻有多活跃、以及已经等待之后回复强度怎么变,写进同一个危险率,模型可以同时重现昼夜起伏和间隔分布的形状。优势出现在两项检验一起通过的时候。单看间隔分布,它不是每一格都最好。拟合描述的是已经配成对的通信等了多久,数据里没有对方看见消息的时刻。
先说结论
- 腾讯微博扩散数据的回复密度同时随自然时间和回复时长变化。间隔跨大约五个数量级;图4在中尺度标了斜率0.63的幂律参照,长时间一端快速下跌,同质泊松过程对不上这条曲线。
- 危险率写成 λₜ(τ) = ω(t) · G(ω(t) · τ)。活跃函数 ω 处处等于1时,模型退回只依赖等待的生存模型;响应函数 G 不随等待变化时,退回只依赖钟点的异质泊松过程。
- 信息扩散数据上,回复时长和日活动两项 Kolmogorov–Smirnov 检验都通过的测试用例占77.06%,异质泊松为56.40%。正文把前者约成77.1%,并把相对56.4%的提高写成约36.6%。单看回复时长,自然时间上的威布尔 ksstat 为0.1555,本文为0.1597。
- 邮件数据上,两项都通过的比例是79.07%,帕累托模型为73.64%。单看回复时长通过率,自然时间上的帕累托为96.90%,本文为79.07%。
- 信息扩散数据里,10.8%的测试用例满足 |α| ≤ 0.01,36.4%满足 α > 0.01,52.8%满足 α < −0.01。邮件数据91.4%的测试用例 α 为正。日活跃曲线分成7类后归成4组,论文给出的用户占比是39.49%、25.55%、21.44%和13.52%。
回复间隔和钟点,为什么会缠在同一张图上?
论文用了两套已经发生的通信,分析单位都是一对用户之间的一条记录 (s, e):通信从 s 开始,在 e 得到回复,回复时长 τ = e − s。
第一套是腾讯微博上的信息扩散数据,来自2011年11月15日至25日之间的10天。保留的是至少有5条微博的级联,共计46万条。每条微博记为发送者、发送时间和它所回复的用户;回复时长是被回复那条微博的发送时刻,到这条回复的发送时刻。脚注写该数据当时可在 http://www.thumedia.org 获取。引言说所考察的大规模社交通信数据包含500万用户,并据此讨论图1;数据集一节没有说明这500万与46万条级联如何对应,也没有给出用户数或用户对数量。
第二套是一所大学邮件服务器上83天的通信,引用 Eckmann、Moses 与 Sergi 在2004年报告的记录。对每一封在时刻 t、由 r 发给 s 的邮件,论文向前寻找最近一封由 s 发给 r 的邮件,把两封之间的间隔当作一次回复。短于或等于10秒的记录被去掉,用来避开邮件系统的自动回复。论文没有写出学校名称、用户数或邮件条数。
似然函数只把这些已经配成对的记录乘在一起。没有回复的消息没有作为右删失项进入公式。因此模型回答的是:在这些已经发生的回复里,等待时长如何分布。它不直接回答一条新消息最终会不会得到回复,也没有观察到收件人是在哪一秒看见消息。夜里发出的微博,即使对方天亮才打开,整段睡眠都会算进 τ。
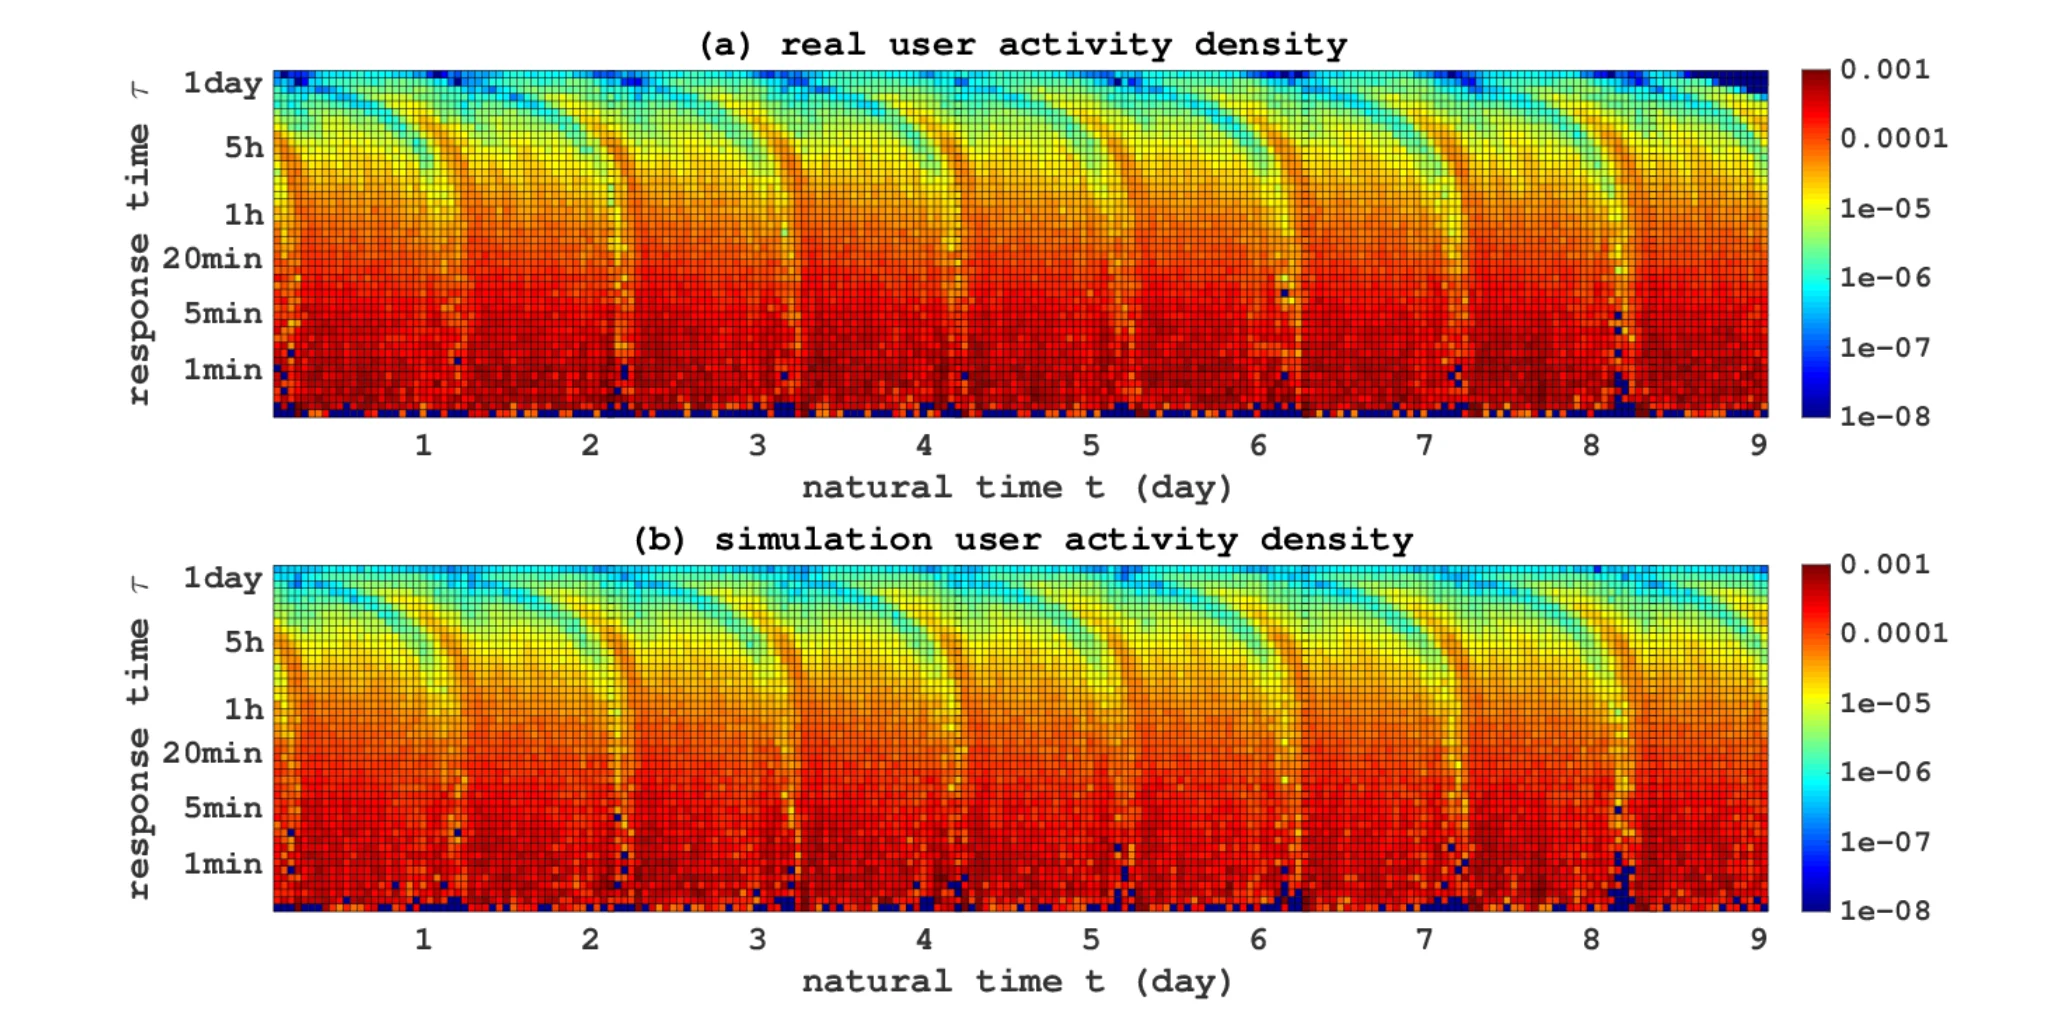
图 1|回复密度是否同时跟着钟点和等待时长变化?
(a)信息扩散数据的真实回复密度。横轴是自然时间,标到第9天;纵轴是回复时长,从约1分钟到1天;颜色是密度 Pₜ(τ),色标由蓝端的1e-8到红端的0.001。短等待在白天更密,夜间出现低密度竖带,并连成大约一天一轮的弧。(b)用本文模型再生的密度,昼夜弧形和短等待处的高密度还在。这是同一批通信模式的再生比较。数据说明写的是10天,图1的时间轴标到第9天,论文没有解释这个差别。来源:原论文 Fig. 1。
忙闲是所有人共用的一条曲线吗?
总体计数已经能看见昼夜起伏。论文按小时统计信息扩散数据里的消息数:白天高,夜间低。
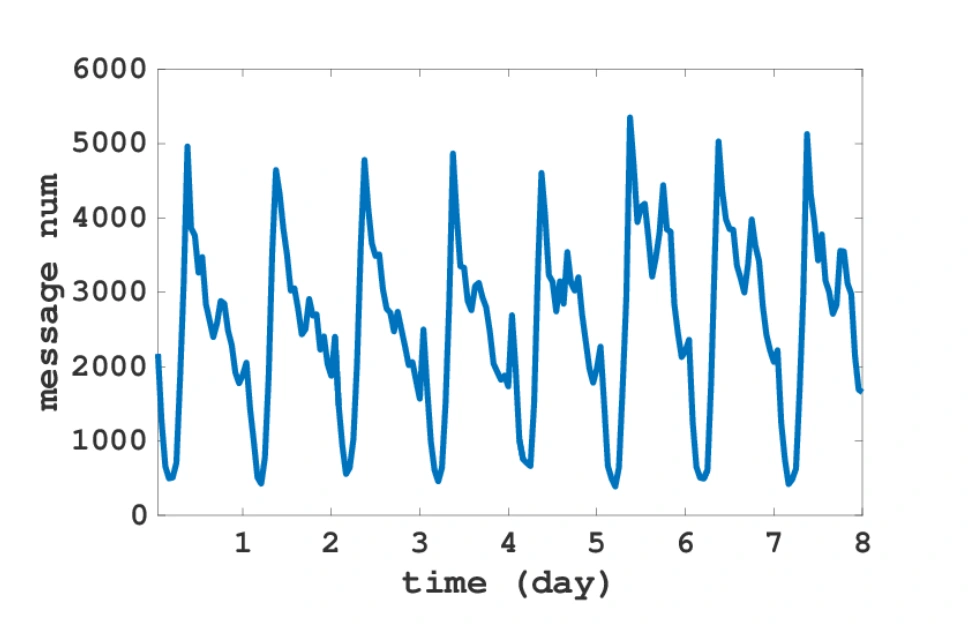
图 2|总体消息量有没有重复的昼夜起伏?
无字母子图。横轴为天,标到第8天;纵轴为每小时消息数,刻度到6000。每个白天冲高,夜间落到低处。它说明总体忙闲存在,还看不出每个人是否共用同一条曲线。来源:原论文 Fig. 2。
已有做法用事件时间消掉这种起伏:时钟不再按秒走,而按系统里已经出现的消息条数走。论文认为这有两个缺口。它不再告诉读者人在钟表时间上如何行动;而且不同人的一天并不相似。图3画了六个用户。一天被分成六个时段:黎明2:00–6:00,早晨6:00–10:00,中午10:00–14:00,下午14:00–18:00,傍晚18:00–22:00,午夜22:00至次日2:00。
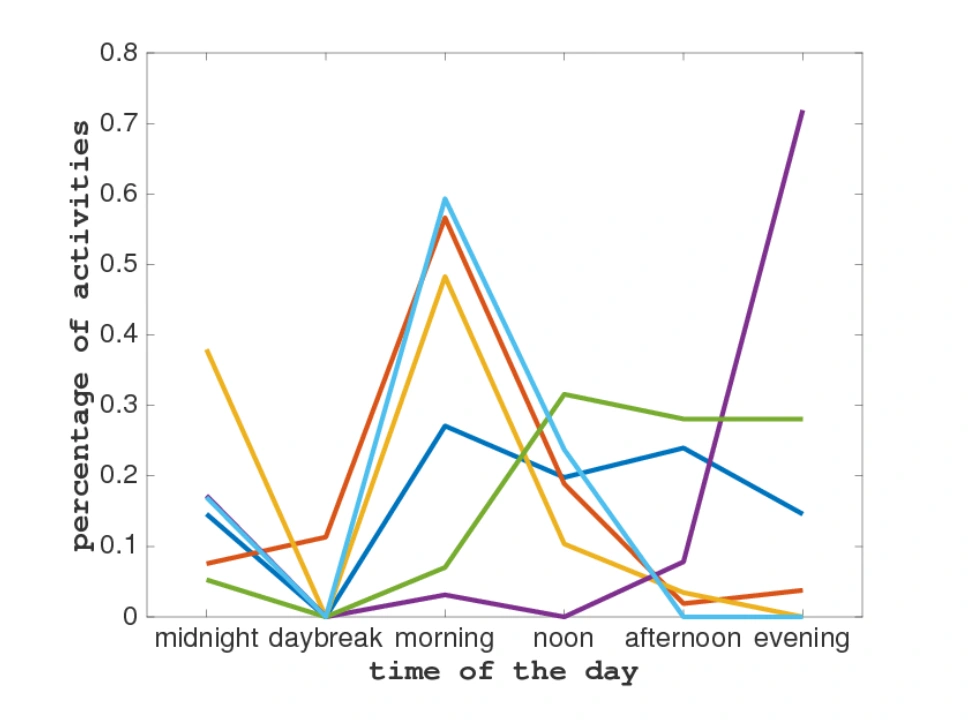
图 3|六个人的一天,能不能合成一条公共作息?
无字母子图。横轴是午夜、黎明、早晨、中午、下午、傍晚;纵轴标注为活动所占比例,刻度到0.8。六条线的高点分别落在午夜、早晨或傍晚,黎明附近多条线接近0。一条公共的事件时间对不上这种差别。来源:原论文 Fig. 3。
间隔分布本身长什么样?
把信息扩散数据里的回复间隔放在一起,时长大约跨五个数量级。论文把曲线分成三段:中尺度可以用幂律近似,短尺度和长尺度不行;长尺度有尖锐截断,呈指数尾。整条曲线不同于同质泊松过程给出的形状。
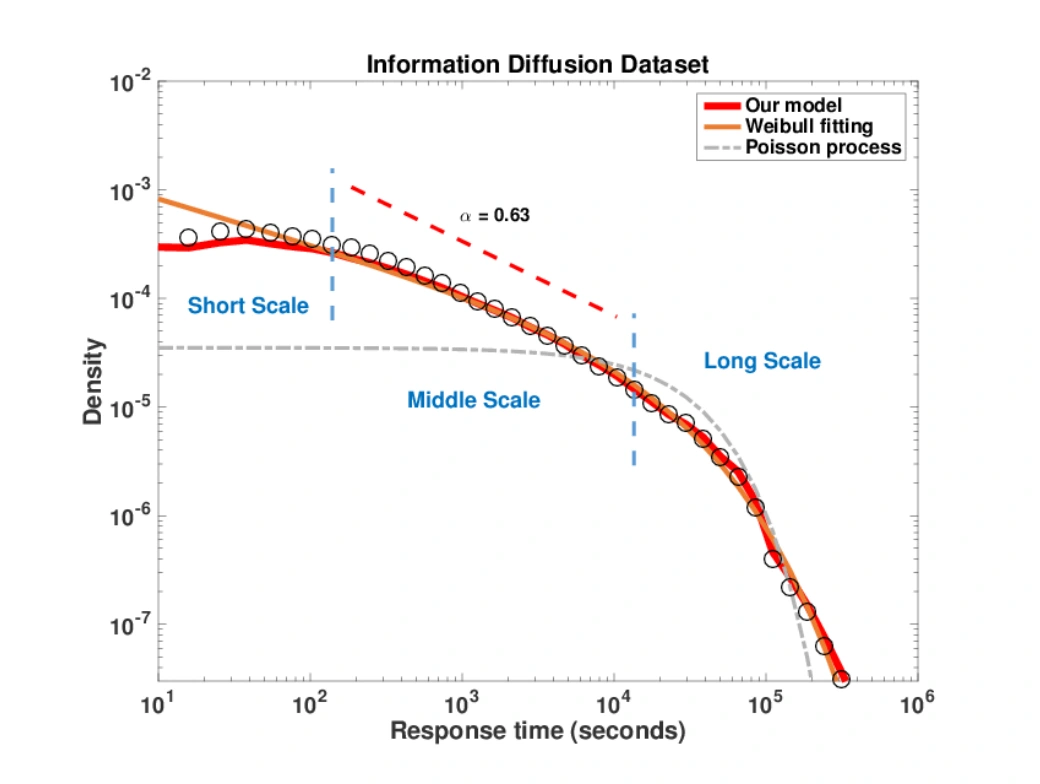
图 4|中间段的幂律,能不能代表全部间隔?
无字母子图。空心圆是信息扩散数据的间隔密度。横轴为秒、对数刻度,大约从10¹到10⁶;纵轴为密度、对数刻度。图例中红线是本文模型,橙线是威布尔拟合,灰虚线是泊松过程。另一条红色虚线标着 α = 0.63,画在标为中尺度的一段上,用作幂律参照。短尺度和长尺度离开这条直线,长尺度一端密度快速下跌;灰虚线在中段过平。图上的0.63是密度曲线的参考斜率。后文每个测试用例拟合出的形状参数 α,在这套数据上的均值是0.008。两个数是不同的量。来源:原论文 Fig. 4。
一个危险率怎样同时装下两件事?
生存分析在这里要回答两个相连的问题:通信从时刻 t 开始,再过 τ 仍未回复的概率是多少;若已经等到 t+τ 还没回复,接下来一小段时间里回复的速率是多少。
三个量可以互相推出。密度 fₜ(τ) 是回复时长恰好为 τ 的概率密度。生存函数 Sₜ(τ) 是等到 τ 仍未回复的概率。危险率 λₜ(τ) 是在已经等过 τ 的条件下,接下来回复的瞬时强度,等于 fₜ(τ) / Sₜ(τ)。论文选择直接写危险率,因为两维密度很难一次设计清楚。
拆法是:先用拉伸函数 ω(t) 表示这个人在钟点 t 有多活跃,并让它的平均值是1;再用响应函数 G 表示强度如何随等待变化。组合是
λₜ(τ) = ω(t) · G(ω(t) · τ)。
活跃时,回复所用的时钟走得更快:同样的自然时间等待,会对应更多活动时间。两个特例说明它覆盖了旧模型。若 ω(t) 处处为1,危险率只剩 G(τ),回到同质生存模型。若 G 不随等待变化,危险率变成常数乘以 ω(t),回到异质泊松过程。
针对社交回复,论文把 G 取成带位置平移的幂形式:
G(τ) = λ₀ · τ^(−α) · H(τ − β)。
H 是阶跃函数,等待未超过 β 时这项为0,超过后为1。三个参数的含义如下。
λ₀ 是尺度,论文说它主要控制平均回复时长,尺度越小分布越分散。α 是形状,且建模时要求 α < 1。α > 0 时,等得越久,随后的回复强度越低,回复更集中在早段。α = 0 时,强度不随等待变化,只随当天活跃程度变化。α < 0 时,等得越久强度越高,回复更倾向出现在等待的后段。β 是位置,论文把它解释为回复前的考虑时长。
为了能对参数求导,阶跃函数被换成平滑尺度固定为 φ = 0.001 的逻辑函数。φ 是计算用的常数,不是从行为里估计出来的偏好。ω(t) 用周期高斯混合表示,周期取一天,T = 86400秒。论文提到周期也可以取一周,本文实际用的是日周期。混合成分的个数没有写出。
参数按用户对的通信记录,用最大似然估计。优化使用 L-BFGS,并分成三组轮流更新:先动 λ₀ 和 α,再动 β,再动 ω(t),直到收敛。初值是:λ₀ 取平均回复时长的倒数,α 取0.9,β 取该用户对最短回复时长的一半,ω(t) 由回复时刻的 k-means 给出。0.9是起点。后面看到的 α 分布集中在0附近,不能把0.9读成拟合结果。
像不像,要两项一起过关
比较对象有两类。一类是同质生存模型:威布尔、对数正态和帕累托,它们的强度随时间呈固定的函数形式,不单独写每个人的昼夜曲线。另一类是异质泊松点过程,强度可以随时间变化,但不随已经等待的时长变化。
同质生存模型各做两种拟合。一种直接在自然时间上学习。另一种先把自然时间换成事件时间,在事件时间里学习并再生,再换回钟表时间。
接近程度用 Kolmogorov–Smirnov 检验。ksstat 是两条经验累积分布函数的最大垂直距离,越小越接近。ksrate 是在默认5%显著性水平下,检验没有拒绝“两组样本来自同一分布”的测试用例所占比例,越大越好。论文再定义一行准确率:同一个测试用例同时通过回复时长检验和日活动检验的比例。通过检验表示分布整体相容,不是把某条消息的回复时刻预测对了。分母是测试用例。论文没有写出测试用例的个数,也没有写明留出了未来的哪一天。
信息扩散数据的结果在表1。本文的回复时长 ksstat 是0.1597,自然时间上的威布尔是0.1555,后者更小。回复时长通过率也是威布尔的自然时间版本最高,88.56%,本文和威布尔的事件时间版本都是87.23%。日活动上本文明显更近:ksstat 0.1440,通过率84.49%;异质泊松是0.1907和73.52%,其余同质模型的日活动通过率在28.91%到33.99%之间。两项都通过时,本文77.06%,异质泊松56.40%,其余同质模型在26.74%到32.00%之间。
(77.06 − 56.40) / 56.40 = 36.6%。正文说的提高约36.6%,是相对异质泊松这项通过率的增幅。两项通过率相差20.66个百分点。77.06%低于87.23%和84.49%中的任何一个,说明有的用例只通过了其中一项。
| 信息扩散数据 | 本文 | 威布尔·自然时间 | 威布尔·事件时间 | 对数正态·自然时间 | 对数正态·事件时间 | 帕累托·自然时间 | 帕累托·事件时间 | 异质泊松 |
|---|---|---|---|---|---|---|---|---|
| 回复时长 ksstat | 0.1597 | 0.1555 | 0.1612 | 0.1741 | 0.1731 | 0.1581 | 0.1673 | 0.2021 |
| 回复时长通过率 | 87.23% | 88.56% | 87.23% | 80.88% | 81.64% | 87.56% | 84.11% | 71.43% |
| 日活动 ksstat | 0.1440 | 0.3532 | 0.3190 | 0.3520 | 0.3249 | 0.3526 | 0.3189 | 0.1907 |
| 日活动通过率 | 84.49% | 28.91% | 33.03% | 30.11% | 32.61% | 30.38% | 33.99% | 73.52% |
| 两项都通过 | 77.06% | 26.74% | 30.72% | 27.91% | 30.30% | 28.79% | 32.00% | 56.40% |
表1的分母是信息扩散数据中的测试用例,个数未在论文中给出。ksstat 越小越接近;两个通过率越大越好。
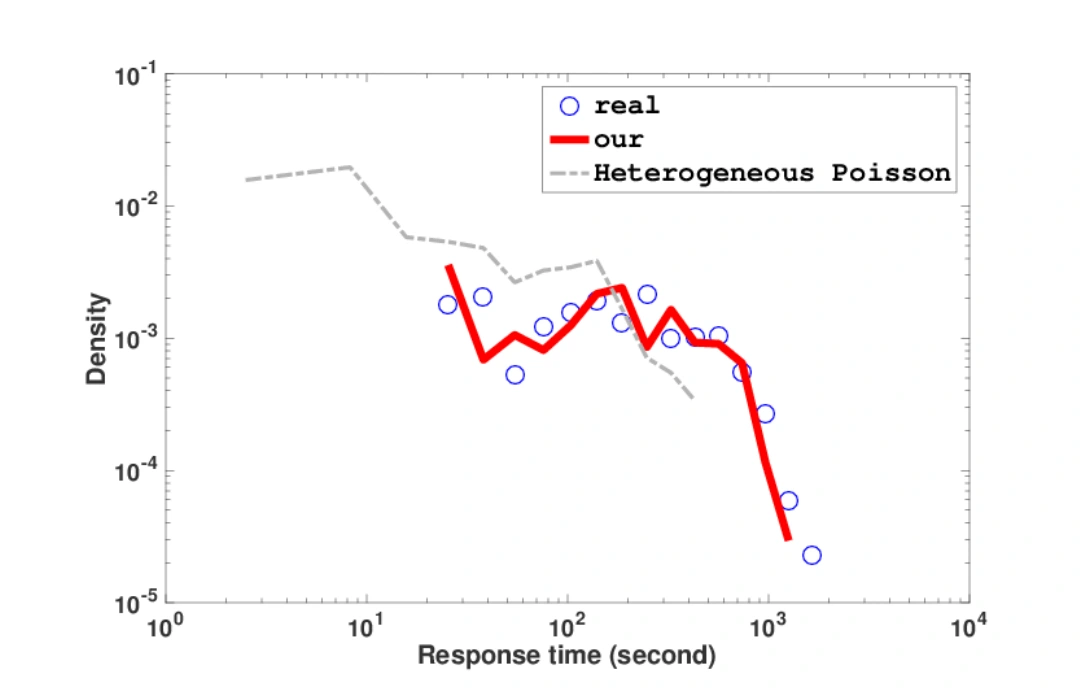
图 5|只让强度随钟点变化,间隔分布还跟得上吗?
无字母子图,只展示一个测试用例。空心圆是真实回复时长密度,红线是本文模型,灰虚线是异质泊松。横轴为秒、对数刻度。灰线在短间隔处偏高,之后下降,没有跟上圆点的起伏;红线在圆点出现的区间里更贴近观察。这一例不能代替表1的全体通过率。来源:原论文 Fig. 5。
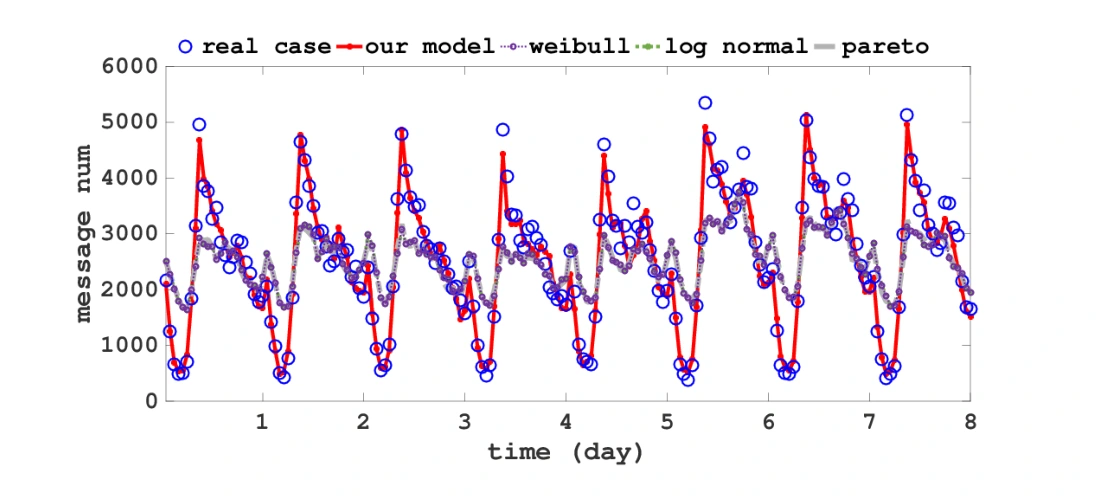
图 6|只拟合间隔分布,回复还会落在正确的钟点吗?
无字母子图。横轴标到第8天,纵轴为每小时回复消息数,刻度到6000。蓝色圆点是真实数量,红色是本文模型,二者一起出现白天尖峰和夜间低谷。威布尔、对数正态和帕累托挤在中间一带,夜间偏高、白天尖峰偏矮。图例没有放入异质泊松,也没有分开事件时间版本。来源:原论文 Fig. 6。
论文还按通信开始的时段把数据切开,再对每一段做回复时长的 KS 检验。六个时段与图3相同。正文写本文模型在所有时段都优于基线。
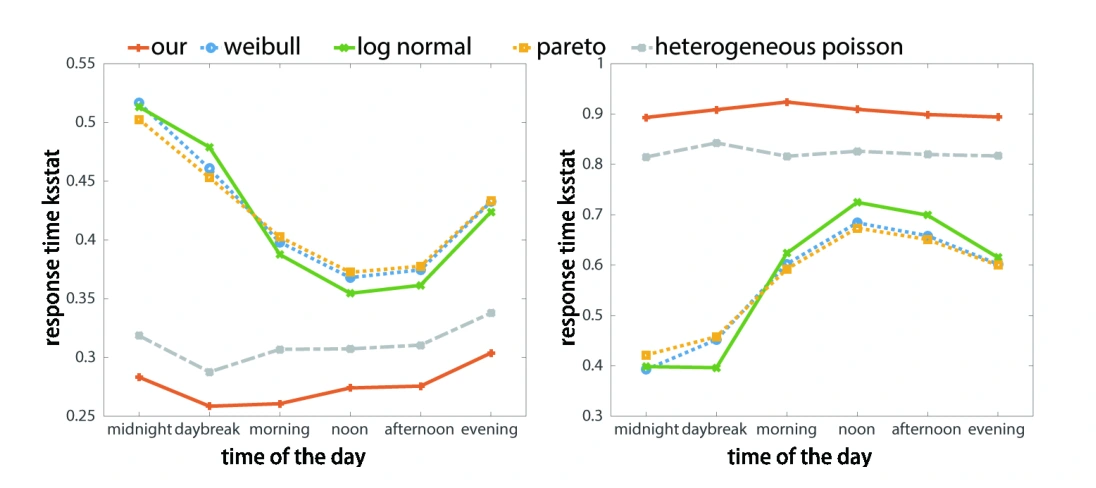
图 7|按开始时段切开后,回复时长的检验还保持优势吗?
无字母的左右两图,横轴都是午夜、黎明、早晨、中午、下午、傍晚。图注写的是 ksrate 与 ksstat,两幅纵轴文字却都印成 response time ksstat。左图刻度标到0.55,本文曲线在六个时段都最低;右图刻度标到1,本文曲线最高。按 ksstat 越小越近、通过率越高越好的定义,左图符合距离更小,右图的高低方向符合通过率更高。右图没有另印出 ksrate,曲线上的点也不在正文中逐一给出,这里不把它们写成表1之外的精确通过率。来源:原论文 Fig. 7。
邮件数据用同一套指标,见表2。本文的回复时长 ksstat 是0.2150,大于自然时间上的帕累托0.1685,也大于其余同质生存模型。距离更大,表示这一项更不接近。只有异质泊松的距离更大,为0.2797。回复时长通过率以自然时间上的帕累托最高,96.90%,本文是79.07%。日活动上本文和异质泊松的通过率都是100%,本文的 ksstat 为0.1440,异质泊松为0.1570。两项都通过时本文79.07%,两个帕累托版本都是73.64%,相差5.43个百分点。因为日活动通过率已经是100%,79.07%就等于本文的回复时长通过率,邮件数据上的短板在间隔分布。
| 邮件数据 | 本文 | 威布尔·自然时间 | 威布尔·事件时间 | 对数正态·自然时间 | 对数正态·事件时间 | 帕累托·自然时间 | 帕累托·事件时间 | 异质泊松 |
|---|---|---|---|---|---|---|---|---|
| 回复时长 ksstat | 0.2150 | 0.1813 | 0.2022 | 0.1748 | 0.1945 | 0.1685 | 0.1897 | 0.2797 |
| 回复时长通过率 | 79.07% | 94.57% | 88.37% | 96.12% | 86.82% | 96.90% | 93.80% | 40.31% |
| 日活动 ksstat | 0.1440 | 0.2527 | 0.2230 | 0.2420 | 0.2188 | 0.2385 | 0.2189 | 0.1570 |
| 日活动通过率 | 100% | 65.89% | 76.74% | 68.99% | 83.72% | 73.64% | 78.29% | 100% |
| 两项都通过 | 79.07% | 63.57% | 67.44% | 68.22% | 72.09% | 73.64% | 73.64% | 40.31% |
表2的分母同样是测试用例,论文未写个数。邮件数据上其余生存模型的日活动通过率高于它们在信息扩散数据上的表现。论文给出的一种可能是:邮件更常集中在一天里的若干时刻,社交网络上的使用时间更分散,因此同时拟合两轴的模型更适合社交网络里的重度用户。这是对两套数据差异的解释,不是对使用动机的测量。
学到的钟点和等待参数,能区分两套系统吗?
日活跃参数 ω(t) 在信息扩散数据上用 k-means 分成7类,论文再合成4组,并按曲线的钟点命名。占比相加为100%,分母是论文所称的用户,个数没有给出。参数优化的输入写的是一对用户的通信记录;聚类对象写的是用户。正文没有说明一对记录是否对应一个用户。
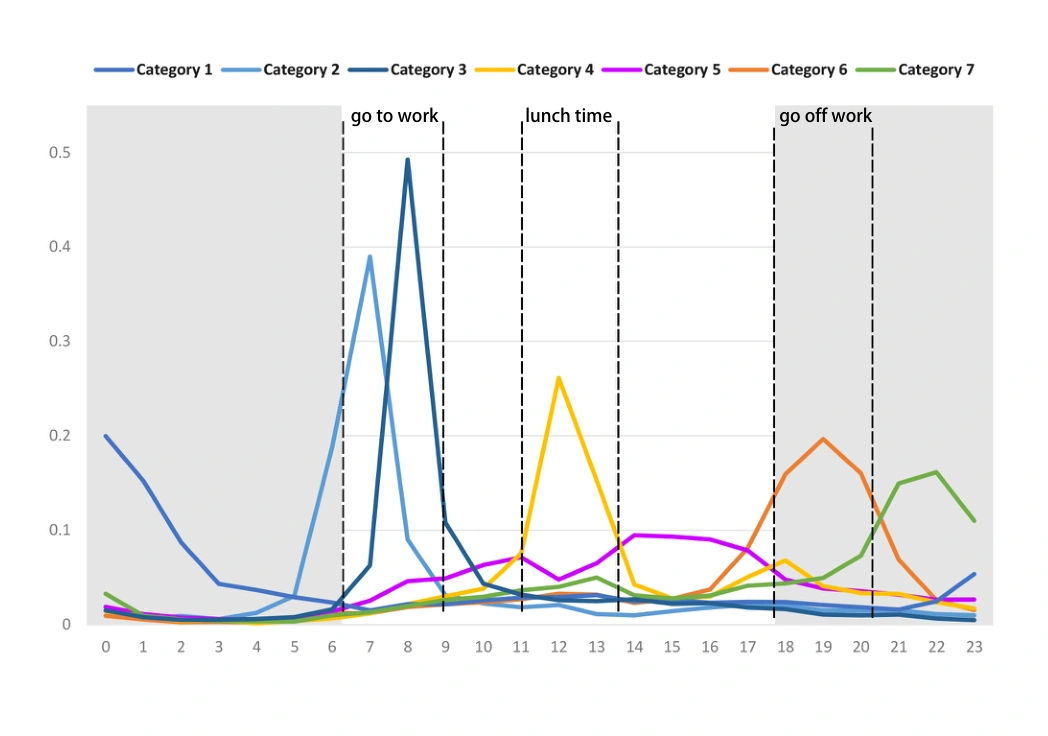
图 8|日活跃曲线能分成哪几种钟点形状?
无字母子图。七条线是聚类类别,横轴为0至23时,纵轴为活跃程度。白色约为白天,灰色约为夜间到清晨。虚线标了上班、午饭和下班。类别2和3在早晨出现尖峰,类别4在中午,类别6在18点以后升高,类别7在21点以后升高,类别1在0点较高,类别5相对平坦。来源:原论文 Fig. 8。
四组占比和论文给出的命名是:
- 类别5全天相对平坦,称为全天活跃的重度用户,占39.49%。
- 类别2、3的峰在7:00–9:00,类别6的峰在18:00–20:00,三组合计25.55%,论文称为在通勤途中使用。
- 类别4的峰被写在中午12点,类别1的峰在凌晨0点,两组合计21.44%,论文称为睡前把服务当作休闲工具。中午的峰与睡前这个名字对应得并不紧,占比仍按论文的合并口径。
- 类别7在晚饭到睡觉之间升高,占13.52%,论文称为以娱乐为目的。
这些名字是对钟点尖峰的解读。数据里没有通勤、娱乐或睡前的问卷。邮件数据的聚类结果论文说与此相似,但限于篇幅没有展示。
回复函数的三个参数在两套数据上分别计数,见图9和图10。纵轴是落入区间的个数。信息扩散数据的刻度到数百至一千多,邮件数据只到10、12和25,柱高不能跨图比较。
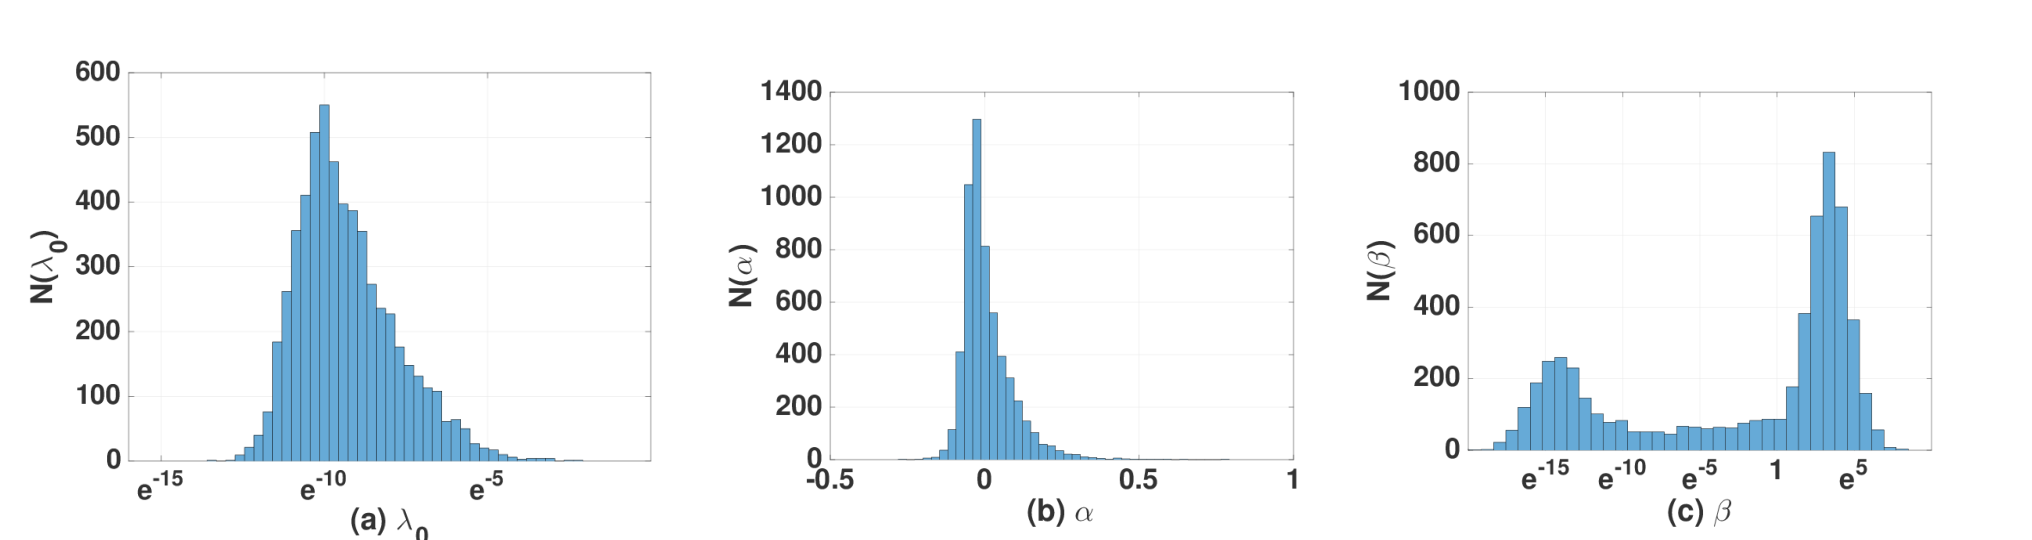
图 9|信息扩散数据里,三个参数集中在哪里?
(a)λ₀ 的横轴取对数,峰在 e⁻¹⁰ 附近,纵轴刻度到600。论文写它在这套数据上近似服从对数正态,均值约在 e⁻¹⁰。(b)α 集中在0附近,横轴从 −0.5 到1;论文给出的均值是0.008。(c)β 的横轴取对数,左峰靠近0,右峰位于1与 e⁵ 之间。论文把这两个峰写成接近0和接近1分钟。来源:原论文 Fig. 9。
在信息扩散数据的测试用例中,|α| ≤ 0.01 的占10.8%。论文认为这时过程接近只随日活动变化的异质泊松。α > 0.01 的占36.4%,α < −0.01 的占52.8%。三项相加为100%。超过一半的用例是强度随等待上升,不能用均值0.008代表每一个用户对。
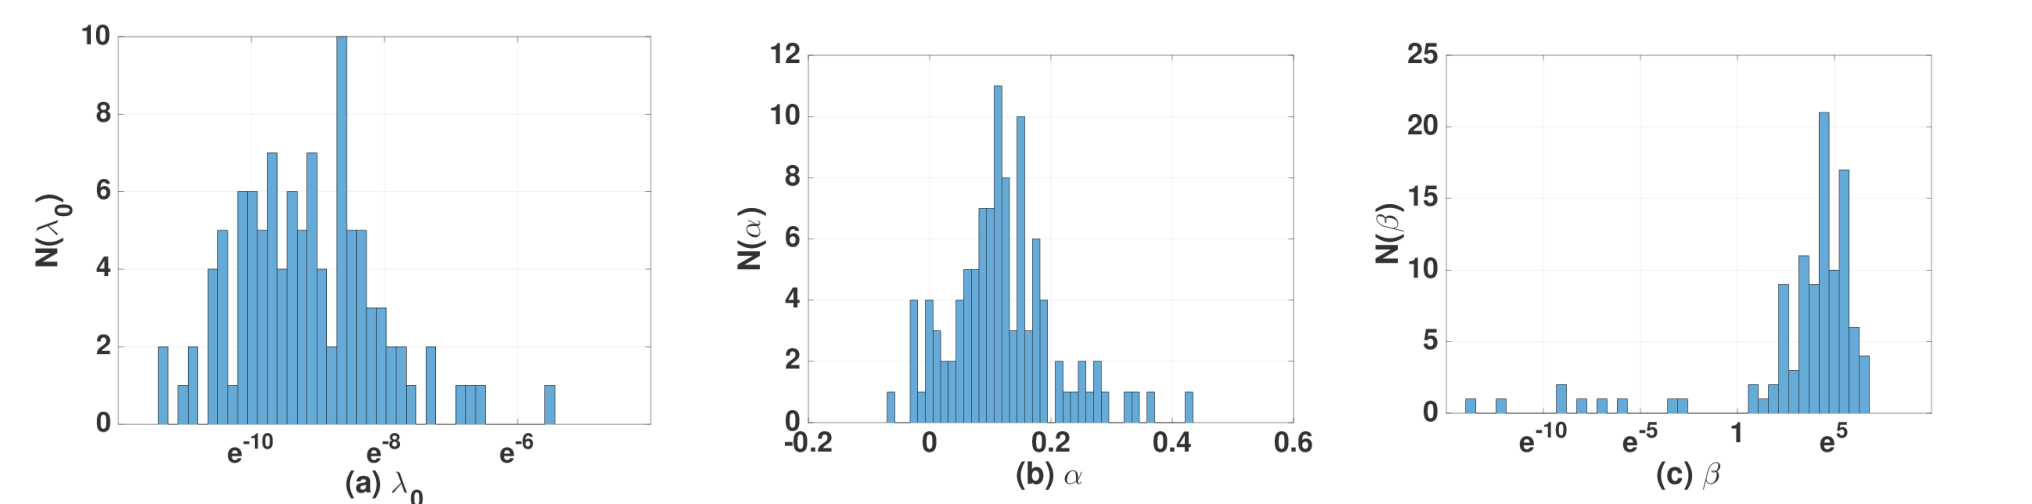
图 10|邮件数据的参数分布和微博扩散相同吗?
(a)λ₀ 仍大致单峰,论文写大多数落在 e⁻⁹ 附近,纵轴刻度到10。(b)α 的质量主要在正值一侧,横轴大约从 −0.2 到0.6;均值是0.1206。(c)β 基本单峰,峰值靠近 e⁵。e⁵ 秒约148秒,论文把它记成约2分钟。来源:原论文 Fig. 10。
邮件数据91.4%的测试用例 α 为正,用的是正负号,不是信息扩散数据里0.01那个阈值。正的 α 表示已经等得越久,随后回复强度越低。论文因此建议,若希望这些 α > 0 的人回复,就要认真选择发起通信的时刻。对 β,论文建议对较小 β 的人使用更醒目的措辞,对较大 β 的人把内容写得更实。这两句是根据参数方向提出的应用设想,论文没有做改写文案或改变发送时刻的对照实验。
这些比较还停在哪一层?
模型重现的是已观察到的回复等待和它们在一天中的数量。KS 通过率高,表示模拟样本和观察样本在分布上更常相容;它不证明危险率的拆法是唯一机制,也不证明某一个人会在下一小时回复。
两套数据的时间、平台和记录定义都不同。微博的 τ 从被回复微博的发送时刻算起,邮件的 τ 从反方向最近一封邮件算起。邮件去掉了不超过10秒的记录,微博一节没有写同样的过滤。图1、图2和图6的时间轴分别标到第9天或第8天,数据说明写的是10天,论文没有对齐这个差别。
4组钟点名称是聚类之后的解释。类别4的中午尖峰被放进名为睡前的那一组。全天活跃指的是类别5缺少单独尖峰,不是测到这39.49%的人每个小时都同样频繁地看手机。
图7的图注和纵轴用词没有对齐,右图不能脱离这个歧义读成另一张精确表格。邮件聚类图没有给出。高斯混合的成分个数、测试用例个数、500万用户与46万条级联的对应关系,正文都没有写清。
一句话总结
回复等了多久和消息是在几点发出的,会一起改变下一次回复的强度;把两者写进同一个危险率后,模型更能同时重现间隔形状和昼夜起伏,但单看间隔、以及换一套通信系统时,它都不是处处最好的那个分布。
核心来源
- ACM KDD 2017论文页,核对题目、作者、会议时间和 DOI。正文图1–10、表1–2都在这10页里,PDF没有补充材料。
- 信息扩散数据的论文脚注:当时公开于 http://www.thumedia.org ,平台为腾讯微博 http://t.qq.com 。
- 邮件数据的引文:Jean-Pierre Eckmann、Elisha Moses、Danilo Sergi,Entropy of dialogues creates coherent structures in e-mail traffic,Proceedings of the National Academy of Sciences,2004,101(40):14333–14337。本文只使用 KDD 论文里写出的83天和10秒过滤,没有另引该文的样本量表。
- 致谢写明工作受到国家自然科学基金与清华—腾讯互联网创新技术联合实验室支持。
作者介绍
论文署名页没有分列个人贡献。下面只写该页能够核对的单位;Song 的资助来自论文致谢。
- Linyun Yu:清华大学计算机科学与技术系。
- Peng Cui:清华大学计算机科学与技术系。
- Chaoming Song:迈阿密大学物理系。致谢写明,其部分工作受美国国家科学基金会项目 IBSS-L-1620294,以及迈阿密大学文理学院 Convergence Grant 支持。
- Tianyang Zhang:清华大学计算机科学与技术系。
- Shiqiang Yang:清华大学计算机科学与技术系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果真要按钟点安排一条消息,四个组不该共用一个发送时刻。类别5的曲线平坦,换小时能改变的活跃程度有限;类别2、3和6的尖峰挤在早晨或傍晚的两三小时里,发送时刻差两小时,落进的就是另一段 ω(t)。类别4的峰在中午,却被论文和凌晨那一组放在同一个名字下面。按名字理解成睡前再发,会错过图上那个中午尖峰。要检验这一点,需要固定同一对用户,只改变发起时刻,再看回复时长分布是否按 ω(t) 移动。本文的结果是拟合已经发生的记录,没有做这个干预。
另一件容易混用的事是评价指标。KS 通过率问的是模拟出来的等待分布像不像全体观察。产品里更常问的是下一条消息会不会在一小时内得到回复。分布形状接近时,单条概率仍可能偏。两套系统的形状方向也不一样:邮件数据91.4%的测试用例 α 为正,强度随等待下降;信息扩散数据52.8%的测试用例 α < −0.01,强度随等待上升。同一条早点催促的规则,在前一种形状上是赶在强度跌下去之前,在后一种形状上可能正对着相反的方向。这需要新的、按用户对随机改变提醒时刻的比较,不能从现在的直方图直接推出该不该催。