一座城市的手机流量,有多少跟着作息走?
论文名片|Fengli Xu、Yuyun Lin、Jiaxin Huang、Di Wu、Hongzhi Shi、Jeungeun Song、Yong Li,Big Data Driven Mobile Traffic Understanding and Forecasting: A Time Series Approach,IEEE Transactions on Services Computing,2016,9(5):796–805。2015年12月31日收稿,2016年3月30日修回,2016年7月13日接收,2016年8月12日出版,当前版本日期2016年10月12日。DOI:10.1109/TSC.2016.2599878。
2014年8月的上海,同一座城市在凌晨4点和晚上10点,蜂窝数据流量的地图完全换了亮法。这里的流量是设备经过基站传出的字节,汇总到基站和城区之后,才能看见作息怎样写进全网。九千多座基站如果共用一套扩容和调度,白天会重复出现的起伏,就会和某一座塔突然涌来的字节混在一起。
这项研究把每座基站的流量时间序列拆成规律分量和随机分量。规律分量跟得上日和周的作息,可以用季节性时间序列往前推一周的形状;随机分量缺少稳定的自身线性记忆,也不会可靠地从邻近基站提前传过来。规律分量占多大份额,又和基站周围是娱乐、办公、居住还是乡村有关。
先说结论
- 数据来自2014年8月上海一家大型运营商的匿名蜂窝流量:约19.6亿条记录、超过9000座基站、15万用户,总量超过2.8 PB,全网平均每天92 TB。比较单位是基站、相邻基站对和全市汇总。
- 全市合计在午夜最低、白天较高,周末低于工作日。拆开以后,全网平均的规律分量约为 10^7 字节/10分钟,平均随机分量约为 10^6 字节/10分钟;单座基站的随机尖峰仍可以画在 10^8 字节/10分钟的纵轴上。
- 预测只展示了两座基站。正文写,用前三周预测第四周后,两座基站都有80%的绝对相对误差小于0.3。图7上,基站b在约0.23处达到累积比例0.8,基站a要到约0.38。相对误差的分母没有写出。
- 德劳内三角剖分得到23964对相邻基站。某一天里,随机分量的平均绝对互相关在零延迟为0.14。两天之间,相关曾高于0.5的基站对里,只有5%在另一天仍然高于0.5。
- 功率比的众数约0.45,全部基站的平均值是2.4392,一半基站落在0.67到3.27。极高组41座中,娱乐类占26/41,即63.41%;极低组43座中,办公占18/43,即41.86%,乡村占6/43,即13.95%。
记录先被切成基站上的10分钟
流量来自上海一家大型运营商2014年8月整月的蜂窝网络,运营商名称没有写出。每条记录对应一次连续数据通信,字段包括设备标识、起止时间、基站编号、基站位置和流量体积。全文约19.6亿条,覆盖超过9000座基站和15万用户。
总量超过2.8 PB,同时写着每座基站超过7 GB、全网平均每天92 TB。92 TB乘31天约等于2.85 PB,与“超过2.8 PB”同一量级。按超过9000座分摊,每天92 TB大约是每座基站每天10 GB,和“超过7 GB”同属一天的量级。论文没有把7 GB定义成整月累计。
一次通信可以持续几分钟到几小时。论文假设这段时间里流量均匀,再切进若干个10分钟;短于10分钟的记录近似成一个10分钟段。时段起点取整点之后的10、20、30、40或50分钟。因此后面的10分钟序列,是把一次通信的字节摊进时间格,整点本身如何归入并没有另作说明。基站地址经百度地图接口转成经纬度,同一单位面积上的基站再加总,得到空间分布。这个单位面积的边长没有给出。
结论里把对象称为3G/LTE流量。正文没有按制式分开报告,也没有把设备标识连成个人行程。后文的分解、预测和地图,用的都是基站或城区合计。
市中心最亮的时刻,是不是全市都更忙?
四个时刻被拿来并排:凌晨4点、上午10点、下午4点、晚上10点。因为市中心峰值太高,线性色标会把其他地方压暗,所以图中强度用流量密度的平方根表示。色标从0到0.5,没有单位,不能和图2横轴上的原始密度直接换成同一个数。
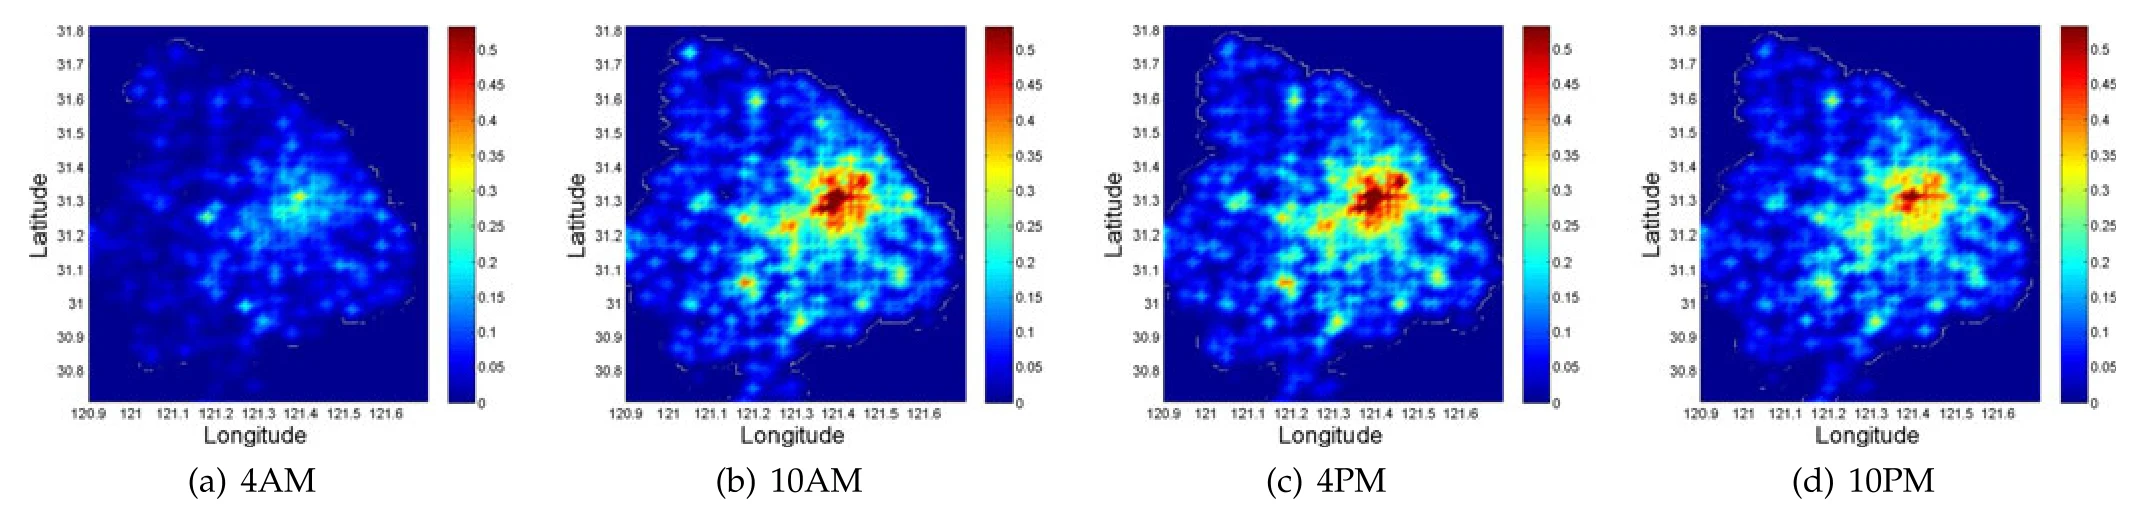
图 1|四个时刻里,亮的是市中心峰值,还是全市范围?
(a)凌晨4点整体最暗,只有零星亮点。(b)上午10点市中心出现明显高值,外围仍以冷色为主。(c)下午4点市中心峰值仍然突出。(d)晚上10点市中心不如午后那么红,城区里中等亮度的范围更广。经纬度覆盖上海城区,颜色是流量密度的平方根。来源:原论文 Fig. 1。
正文写,凌晨4点多数地区偏暗,因为多数人在睡眠、设备不活跃;晚上10点多数地区偏亮,因为人和设备更活跃;下午4点到晚上10点,颜色有变暗的趋势。前两句和地图的明暗相符。变暗的趋势更像在说市中心峰值,全市分布要看下一张累积曲线。
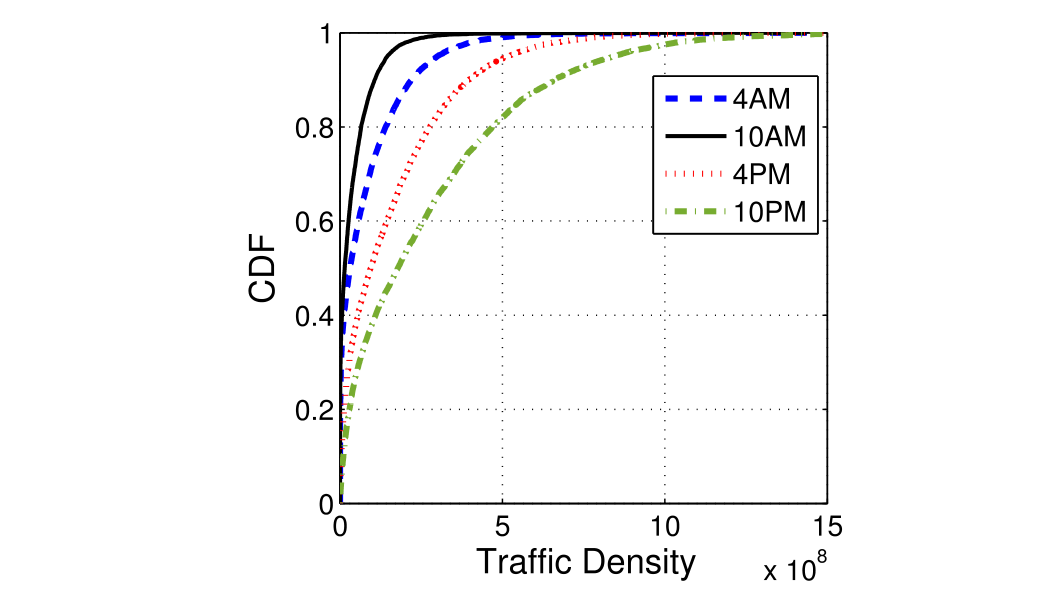
图 2|全市各处的流量密度,在哪个时刻整体更高?
无字母子图。纵轴是累积分布,横轴是流量密度,标到 15×10^8。四条曲线从左到右是上午10点、凌晨4点、下午4点、晚上10点。曲线越靠左,同样累积比例下的密度越低。因此这四个时刻里,晚上10点的密度分布整体最高,上午10点最低。上午10点地图上的红心,只说明市中心峰值高,全市大多数地方在这个时刻仍然偏低。来源:原论文 Fig. 2。
把全网加总,为什么会看见作息?
单座基站的曲线很碎。把整个网络加在一起,日周期就稳下来。图3用三层时间窗看同一条全市总量:约四周、其中一周、其中一天。三张小图的纵轴都是 ×10^11,黑框和箭头表示逐级放大,不是三套互不相关的指标。
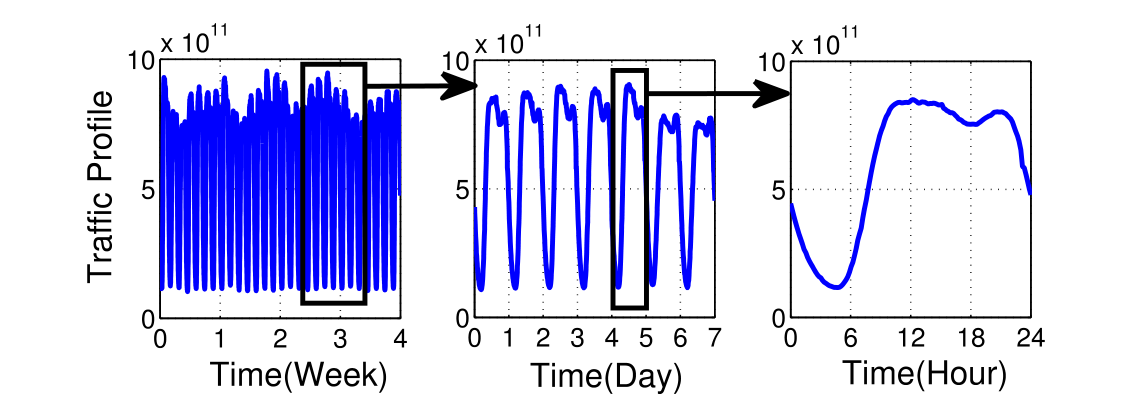
图 3|全市总量在周、日、小时上重复的是什么?
无字母子图,从左到右是四周、七天和24小时,纵轴均为流量曲线 ×10^11。左图每天一条起伏,峰高并不完全一样。中图把黑框里的一周拉开,可见七个昼夜循环。右图清晨降到低谷,上午爬升,中午前后维持高位,入夜后下降。图上没有标出哪一天是周末。来源:原论文 Fig. 3。
正文根据这条全市曲线写:白天较高,午夜最低;周末明显低于工作日,并把原因归于人们的工作日程。低多少没有给出百分比。小时图的低谷和高位,和“午夜低、白天高”一致;周末那一句留在文字里,不能从图3的日期轴上直接读出星期六、星期日。
这组昼夜重复,是后面做分解的理由。另一组差异也已经出现:工作日和周末不一样,而且有的基站用户数量天天变。若只拿一条平均日曲线去套全部基站,这两类差别都会被抹平。
拆掉重复的部分以后,剩下的还像随机数吗?
一座基站在第 t 个时间格的流量写成 x_t。论文把它看成规律分量 u_t 加随机分量 y_t。经典分解里还有趋势 m_t、周期项 s_t 和残差 r_t,这里规定 u_t = m_t + s_t,y_t = r_t。规律分量因此同时含有缓慢趋势和按周期重复的形状,随机分量是去掉这两者之后的残差,可以低于零。低于零表示比规律分量低,不是基站产生了负的字节。
做法是:先用长度为 d 的移动平均粗估趋势,d 的一半记为 q;再按周期中的相位,把偏离趋势的部分平均起来,得到周期项;去掉周期项之后再做一次平滑,作为更好的趋势。d 被写成作者设定的时间窗,数值没有给出。图4展示的是7天,数据本身有31天。
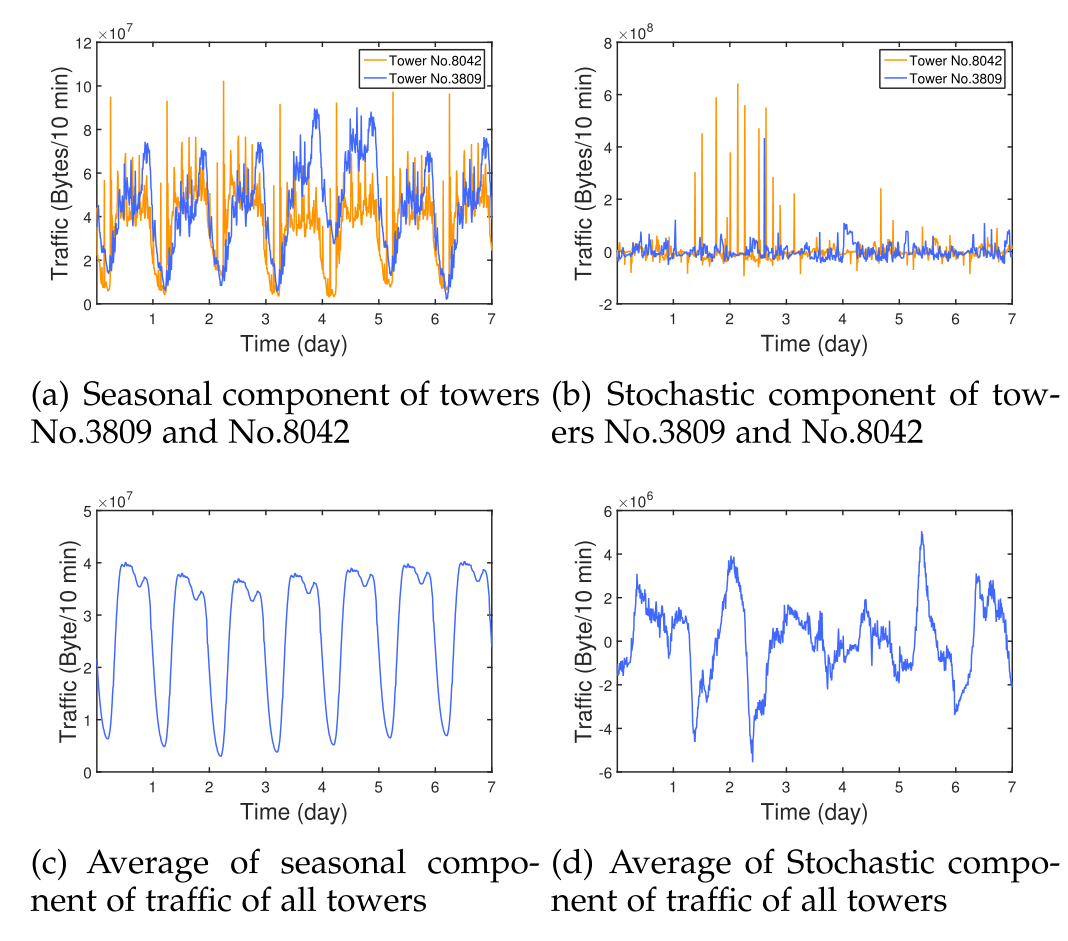
图 4|规律分量和随机分量,在单座基站和全网平均上各有多大?
(a)基站3809和8042的规律分量,纵轴 ×10^7 字节/10分钟,7天里都有昼夜起伏。(b)这两座基站的随机分量,纵轴是 ×10^8 字节/10分钟;8042在第2天前后有多根尖峰,3809贴近零。残差可以略低于零。(c)全部基站规律分量的平均,纵轴 ×10^7 字节/10分钟,夜间降到1以下,白天升到大约4。(d)全部基站随机分量的平均,纵轴 ×10^6 字节/10分钟,围绕零不规则波动。来源:原论文 Fig. 4。
四张小图的纵轴不能连着看。(c)是 10^7 字节/10分钟,(d)是 10^6 字节/10分钟,全市平均之后随机残差比规律分量小大约一个数量级。平均会把各座基站各自的尖峰抵消掉。(b)的纵轴却是 10^8,比(a)的 10^7 还大一档。8042那种单塔尖峰,在全市平均里看不见,在这座塔自己的10分钟里仍然很大。
要判断残差是不是还藏着周期,论文用自相关。若序列接近随机,大约95%的自相关应落在 ±1.96/√n 以内,n 是序列长度。论文给出这个界限,没有写出代入后的具体高度。红线是各基站自相关的平均,绿色区域是相应的标准差。
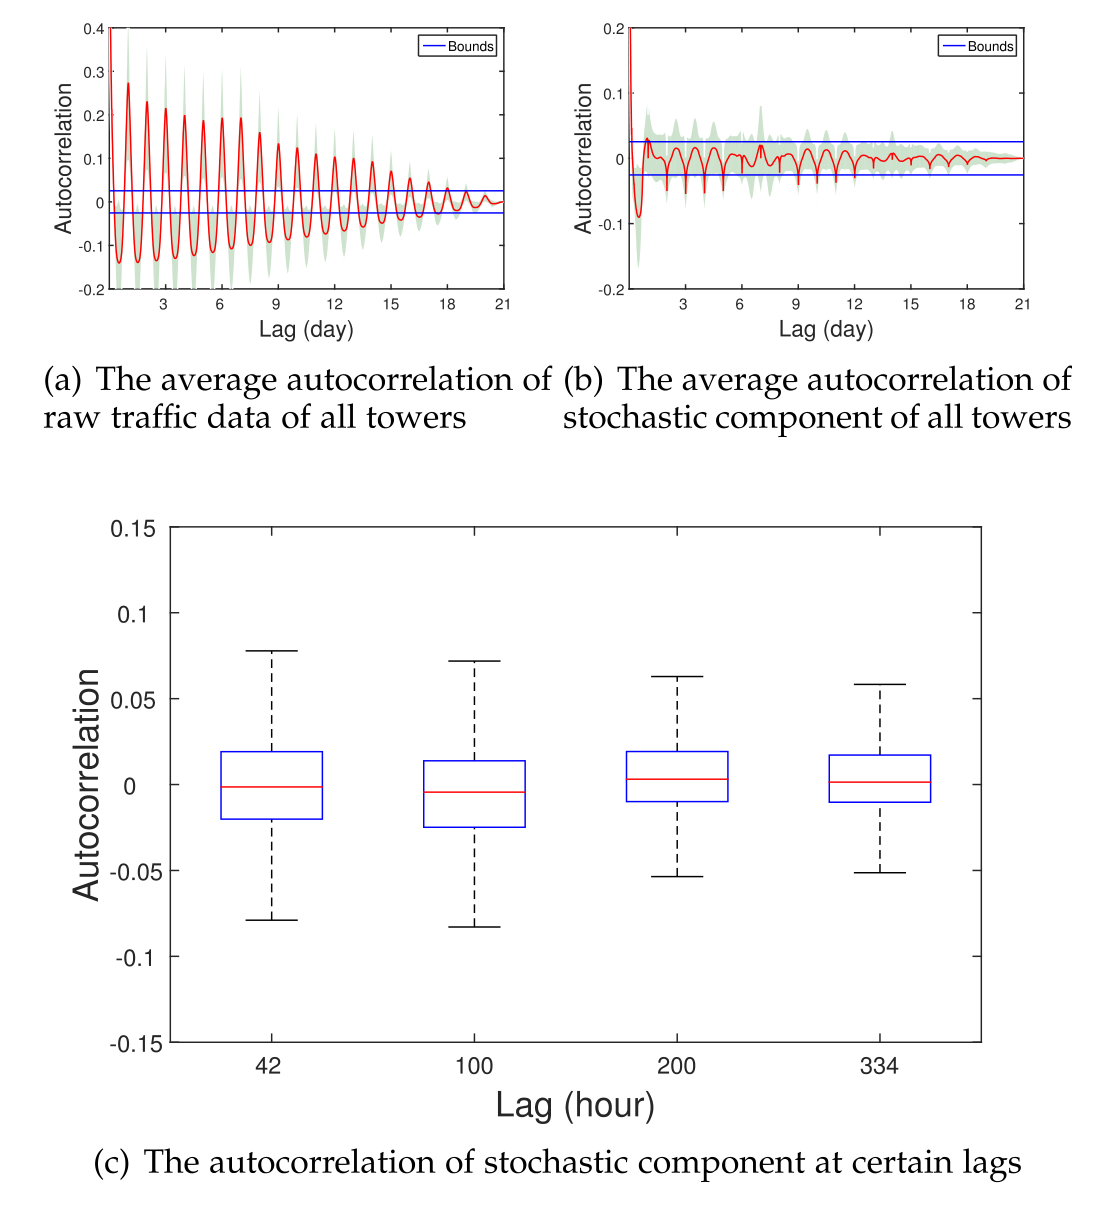
图 5|随机分量还保留日周期吗?
(a)原始流量自相关的基站平均,横轴滞后0到21天。红线按大约一天的间隔起伏,峰值随滞后变矮;绿色标准差带很宽,蓝线是随机序列界限。(b)随机分量的平均自相关。滞后0处的峰被纵轴0.2截断,其后红线大多贴着蓝线界限,绿色标准差仍会越出界限。(c)随机分量在滞后42、100、200、334小时的自相关箱线,中位数都靠近0,箱体窄。来源:原论文 Fig. 5。
正文写,图5b里超过95%的平均自相关落在界限内,因此同一流量模式的随机分量内部依赖弱,可以把它看成随机序列。(c)说明换成长达数百小时的滞后,各基站的自相关中位数仍然靠近0。绿色标准差提醒另一件事:平均曲线贴着界限,并不等于每一座基站的自相关都同样低。
规律分量预测的是日夜形状
规律分量含有一天的周期,严格说也含有一周的周期,因为工作日和周末不同。预测使用季节性自回归积分滑动平均模型,一般写成 ARIMA(p, d, q)×(P, D, Q)_m。印刷的公式(9)左侧是一阶自回归、滞后为 24×7 的季节自回归、同样滞后的季节差分,作用在 y_t 上;右侧是三阶滑动平均和滞后 24×7 的季节滑动平均,作用在 x_t 上。表1实际列出的系数是 AR1、SAR1、MA3 和 SMA1,常数固定为0。
24×7 等于按小时计算的一周。原始序列的最小格子是10分钟,一周应有1008个点。论文没有写明送进模型之前是否先按小时相加。正文说用前三周预测第四周,也没有说明8月29日到31日是否进入测试。图6的横轴只有14天。
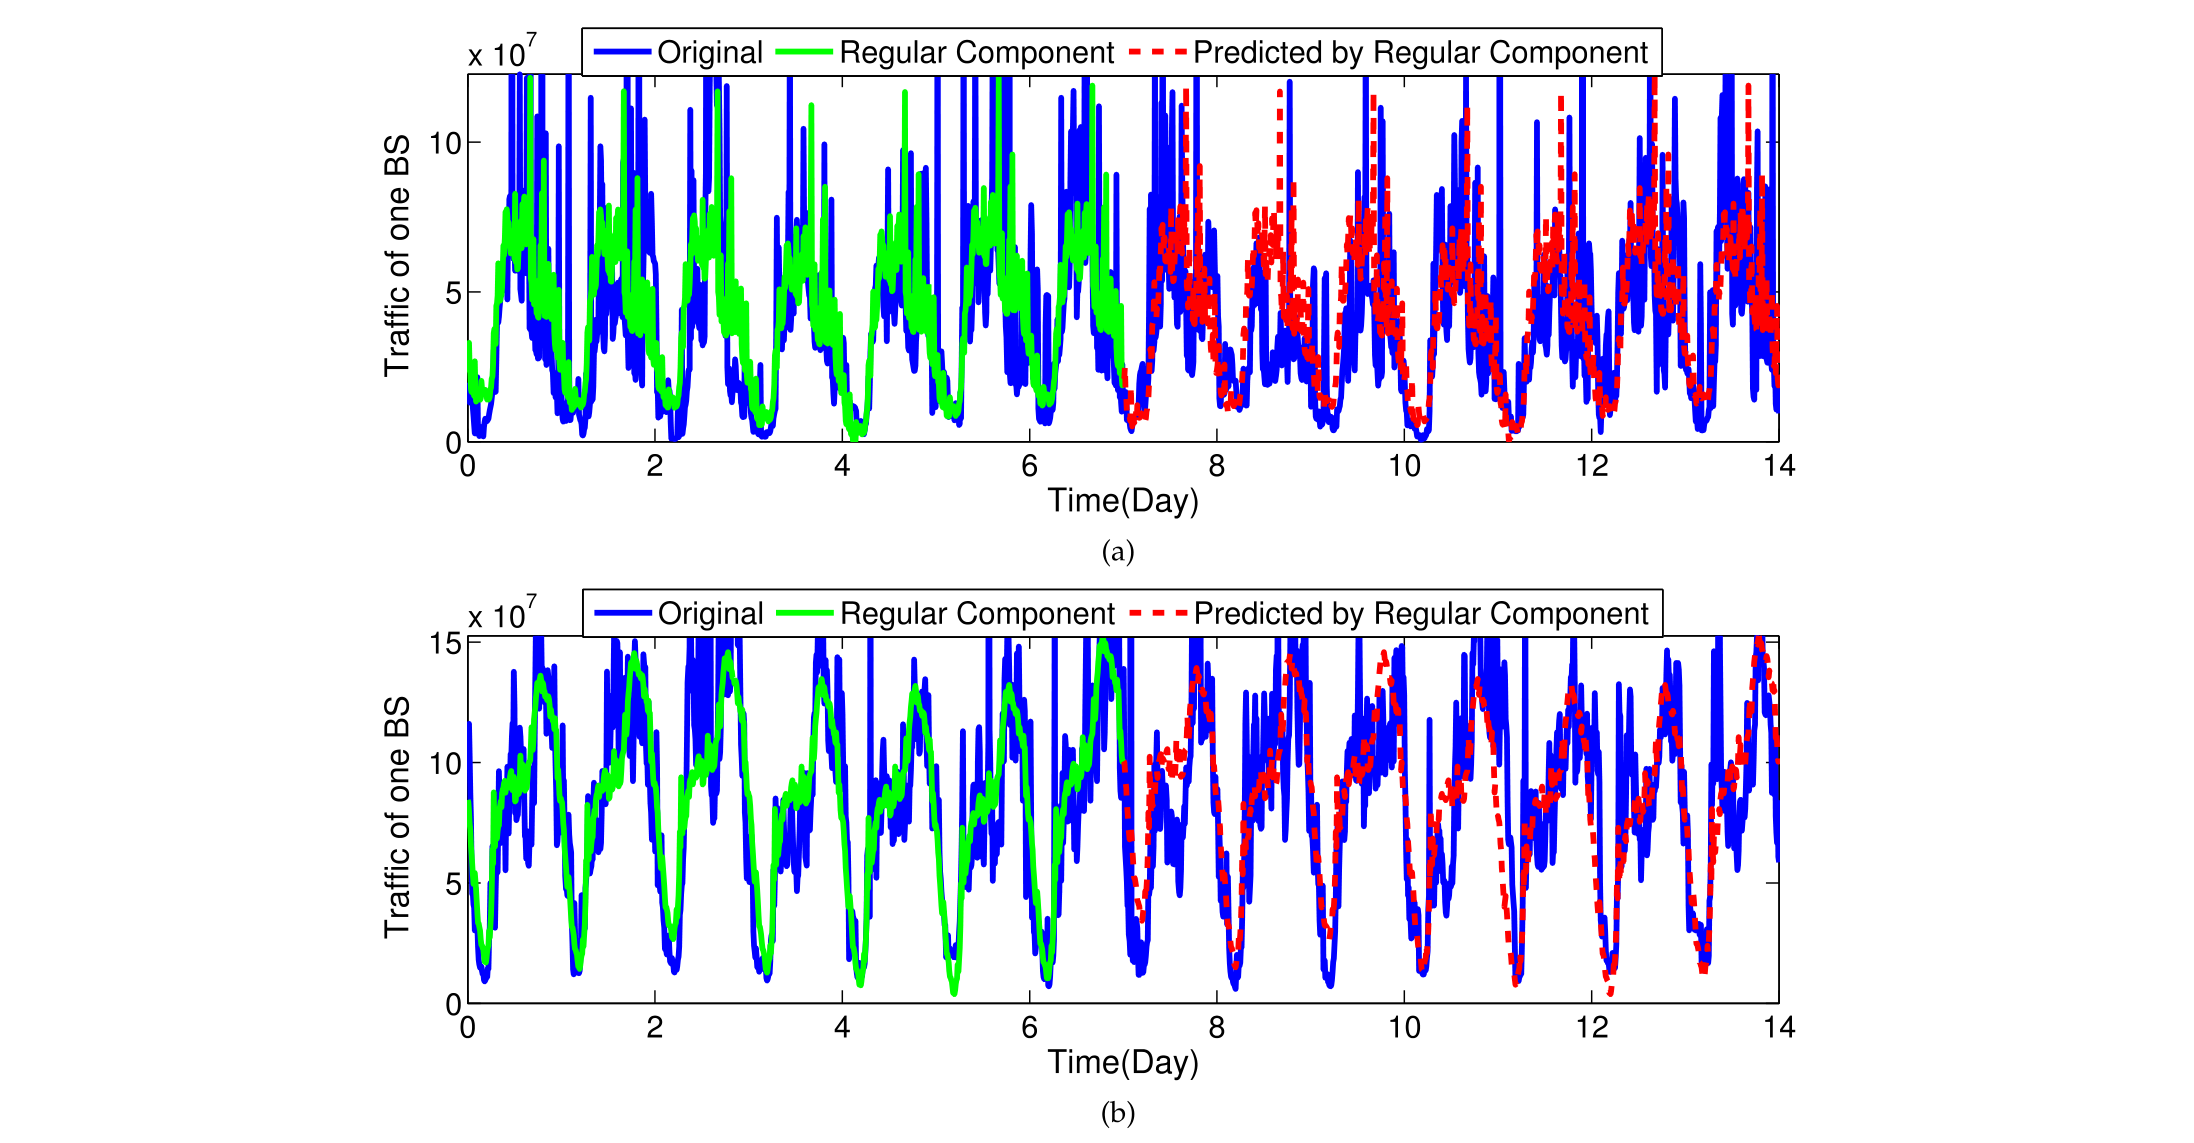
图 6|预测曲线跟上的是原始流量的哪一部分?
(a、b)两座未编号基站,纵轴均为单座基站流量 ×10^7,横轴0到14天。蓝线是原始流量,绿线是规律分量,红虚线是由规律分量作出的预测。绿线主要出现在前大约7天,红虚线主要出现在后大约7天,蓝线贯穿全程。红线跟得上昼夜起伏,蓝线仍有许多尖峰高出红线。(a)纵轴到大约12,(b)到大约15。来源:原论文 Fig. 6。
表1把两座基站的系数、标准误和统计量印在一起。统计量与“系数除以标准误”一致。两座基站的 AR1 和 SAR1 被印成完全相同的数值、标准误和统计量。
| 基站 | 系数 | 估计值 | 标准误 | 统计量 |
|---|---|---|---|---|
| (a) | AR1 与 SAR1 | 0.972823 | 0.720408 | 1.35038 |
| (a) | MA3 | −0.017419 | 4.59487 | −0.00379096 |
| (a) | SMA1 | −0.872813 | 3.11263 | −0.28041 |
| (b) | AR1 与 SAR1 | 0.96773 | 5.74149 | 0.16855 |
| (b) | MA3 | −0.0590281 | 39.4714 | −0.00149547 |
| (b) | SMA1 | −0.435804 | 16.7299 | −0.0260494 |
(a)的方差估计是 2.22149×10^13,标准误 3.49061×10^−13,统计量 6.36418×10^25。(b)的方差估计是 5.07796×10^13,标准误 2.19945×10^−12,统计量 2.30875×10^25。作者写参数的训练误差很小。滑动平均项的标准误远大于系数,自回归项的统计量也只有1.35和0.17。这张表支持的是方差项的标准误极小,不能支持 AR、MA 系数被精确估计。
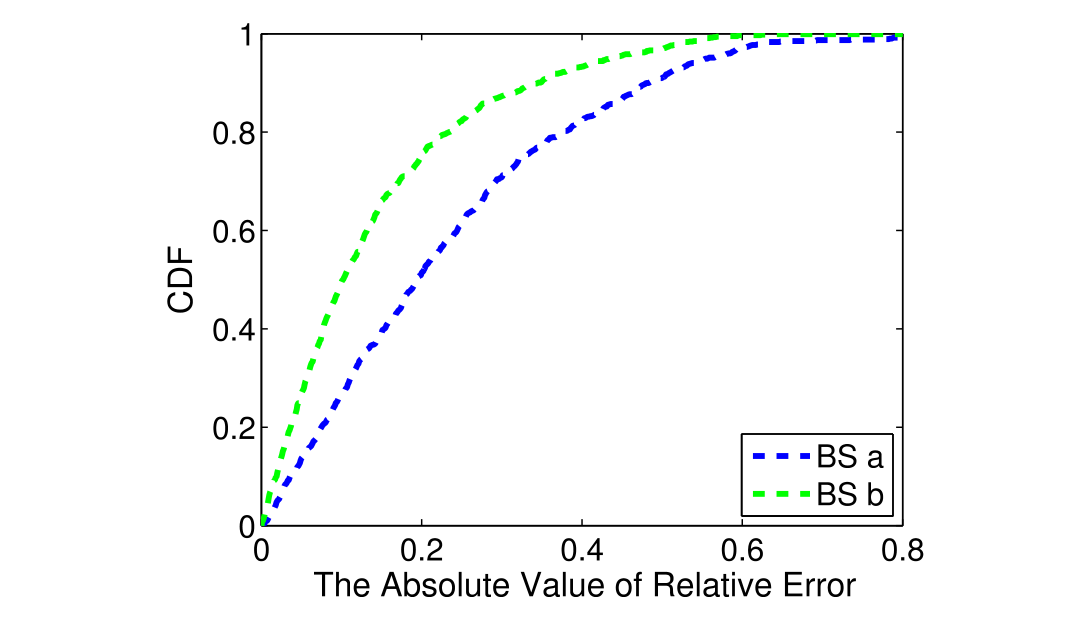
图 7|两座基站的绝对相对误差有多大?
无字母子图。横轴是相对误差的绝对值,从0到0.8;纵轴是累积比例。蓝虚线为基站a,绿虚线为基站b。在横轴0.3处,b的累积比例约0.87,a约0.71。累积比例0.8对应的绝对相对误差,b约0.23,a约0.38。两条曲线都要到接近0.8才贴近累积比例1。来源:原论文 Fig. 7。
正文把这个结果概括成:两座基站都有80%的绝对相对误差小于30%。按图7的坐标,这句话贴近基站b;基站a的80%分位大约在0.38。相对误差的分母没有定义,0.3也不能换算成少了多少字节。无论按正文还是按图,误差都只来自两座随机选出的基站,分母不是9000座。
邻塔的随机起伏,会不会提前漏过来?
随机分量如果能由旁边的基站提前几分钟预告,运营上就可以看着邻塔扩容。论文用德劳内三角剖分连接基站位置,得到23964对相邻基站。样本互相关 c(k) 比较两条随机分量错开 k 格之后的共同起伏,每一格是10分钟。印刷公式是离均差乘积的平均,没有除以两条序列的标准差。图上的数值处在大约 −1 到 1 的范围,0.14这样的数字应按图和正文报告的相关强度理解。
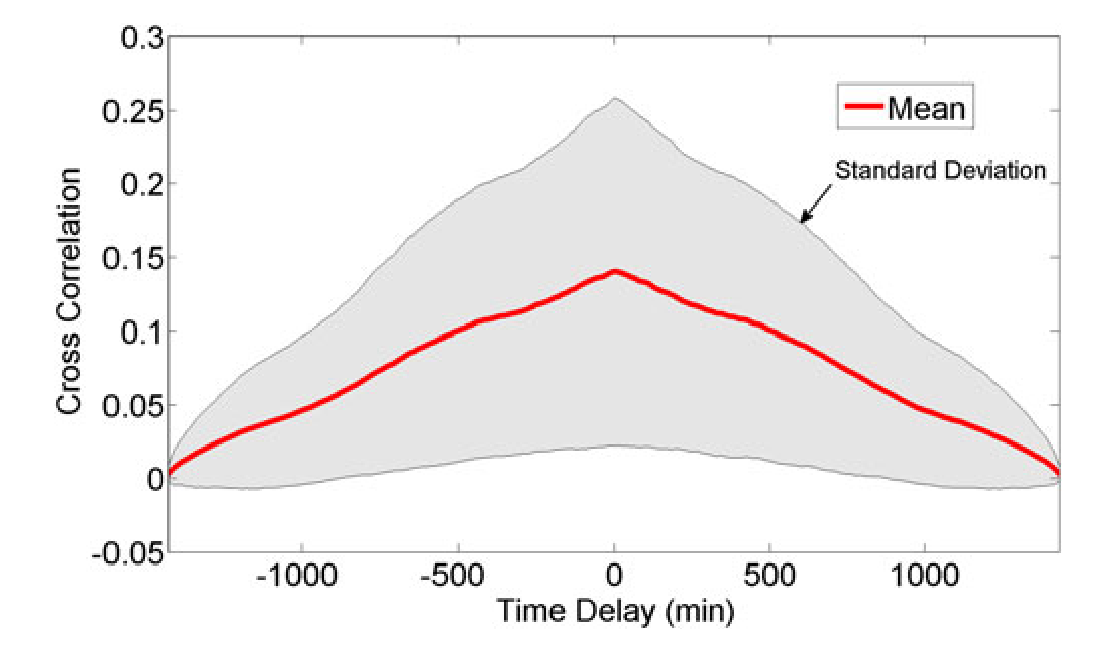
图 8|相邻基站的随机分量,平均一起动多少?
无字母子图。横轴是时间延迟,单位分钟,大约从 −1400 到 1400;纵轴是互相关。红线是23964对在单独一天里的平均绝对互相关,零延迟处被正文记为0.14,图上峰值位于0.15刻度下方。灰色带是基站对之间的标准差,零延迟附近上沿接近0.25、下沿接近0。曲线左右大致对称,峰值在延迟0,而不是在提前或滞后几十分钟的位置。来源:原论文 Fig. 8。
0.14的分母是这一天的23964对相邻基站,不是全月,也不是流量字节的百分比。标准差和均值同量级,说明有的基站对更高、有的几乎为零。峰值停在延迟0,表示这些残差更像同时发生,而不是稳定地从一座塔传到下一座。作者讨论过一种可能:一群人边走边上网,会把相邻基站连起来。平均互相关低,说明这种跨塔使用要么很少,要么不是随机分量的主要来源。这是对合计流量的解释,论文没有据此追踪个人。
距离再拉远,相关也不一定下降。n 步邻居指沿相邻关系至少经过 n 座塔。图9只画到5步。
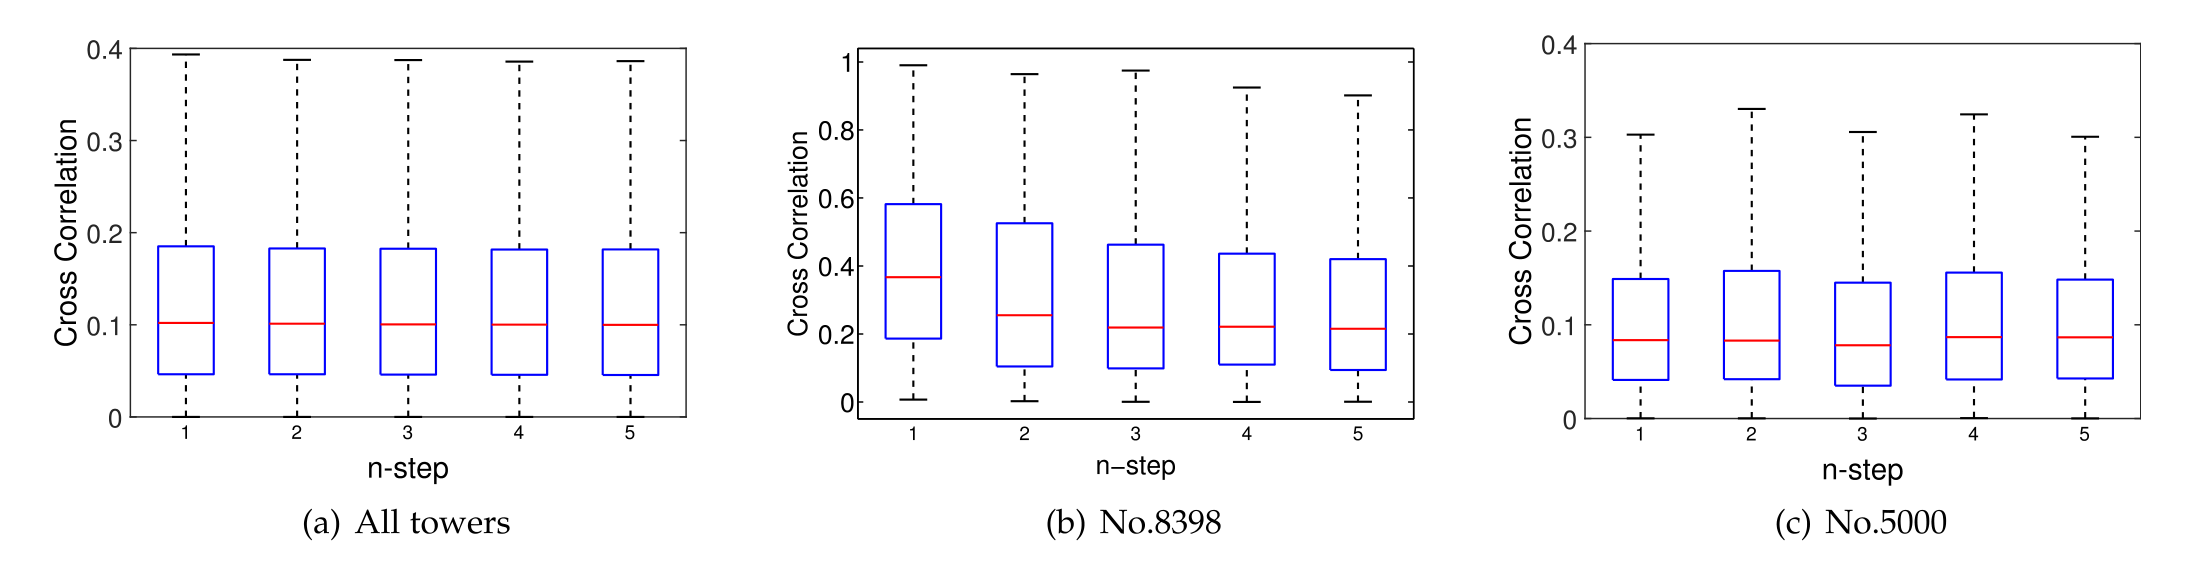
图 9|随机分量的相关会随距离下降吗?
(a)全部基站,纵轴0到0.4,1到5步的中位数都靠近0.1,箱体大约在0.05到0.2。(b)市中心基站8398,纵轴0到1;第1步中位数约0.35,后面降到0.2附近,最大和最小仍然差得很大。(c)居住区基站5000,纵轴0到0.4,各步中位数都低于0.1,形状几乎不变。来源:原论文 Fig. 9。
全市合计没有出现“步数增加、相关下降”。8398的中位数有所下降,但每一步内部的高低差距盖过了这个下降。5000则连中位数的下降也没有。所以邻近基站对随机分量没有一个稳定的距离衰减。
同一对基站换一天,相关也会变。图10a是相邻的5000和5029号基站,三天分别是第1周第2天、第1周第3天和第3周第3天。
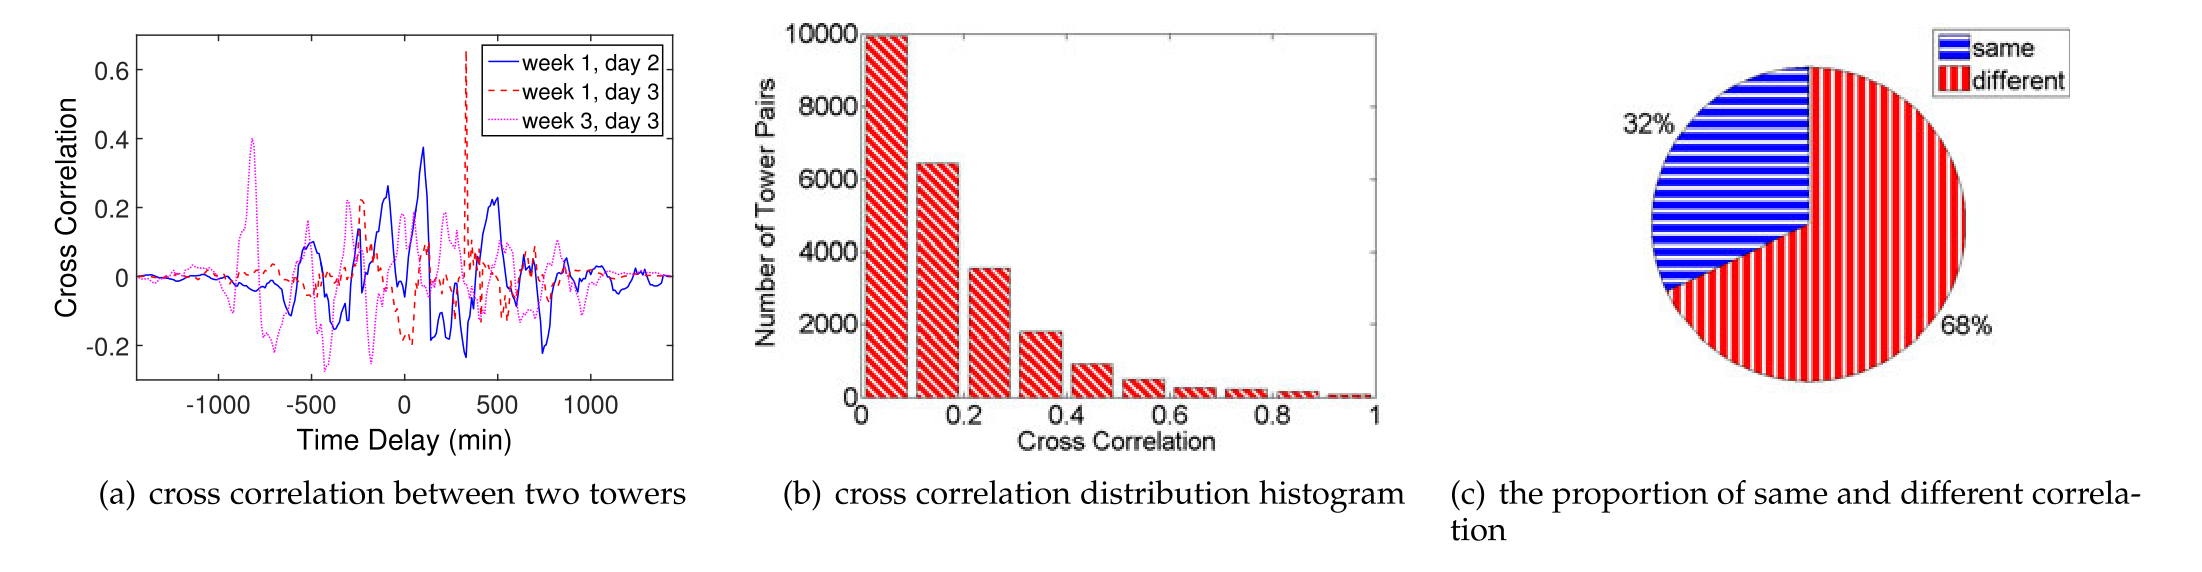
图 10|相邻基站的相关能不能维持到另一天?
(a)5000与5029的随机分量互相关,横轴延迟约 ±1000 分钟,纵轴可正可负。三天的曲线彼此错开,各有各自的尖峰。(b)23964对在10分钟滞后上的相关直方图,横轴0到1。0到0.1这一档接近1万对,随后迅速减少,超过0.5的对很少。正文写大多数对小于0.3。(c)另选一天做对照:32%的基站对落在相同相关区间,68%落在不同区间。来源:原论文 Fig. 10。
(a)可以出现负相关,(b)的横轴从0起算,所以直方图统计的是0到1上的相关强度。68%的分母是23964对相邻基站,比较的是两天是否落入同一区间,区间宽度没有逐档列出。正文另外写:两天里至少有一天相关高于0.5的基站对中,只有5%在另一天仍然高于0.5,95%回到0.5以下。5%的分母是“至少一天高于0.5的那些对”,不是全部23964对。
由此,论文认为随机分量不可预测。证据范围是:自身滞后的线性相关接近随机序列界限,邻近基站的线性互相关又低、又随地点和时间改变。天气、活动或基站自己的其他外部信息,不在这组检验里。
功率比高的塔,聚集在什么样的地方?
随机分量难预测之后,规律分量占的能量越多,原序列里能够跟着作息走的部分就越大。功率比把这件事写成一个数:
R =(规律分量各时刻的平方和)÷(随机分量各时刻的平方和)。
R 越大,规律分量相对随机分量的能量越大。它还不是预测误差。论文没有报告 R 更高的基站,ARIMA 的绝对相对误差是否更低。
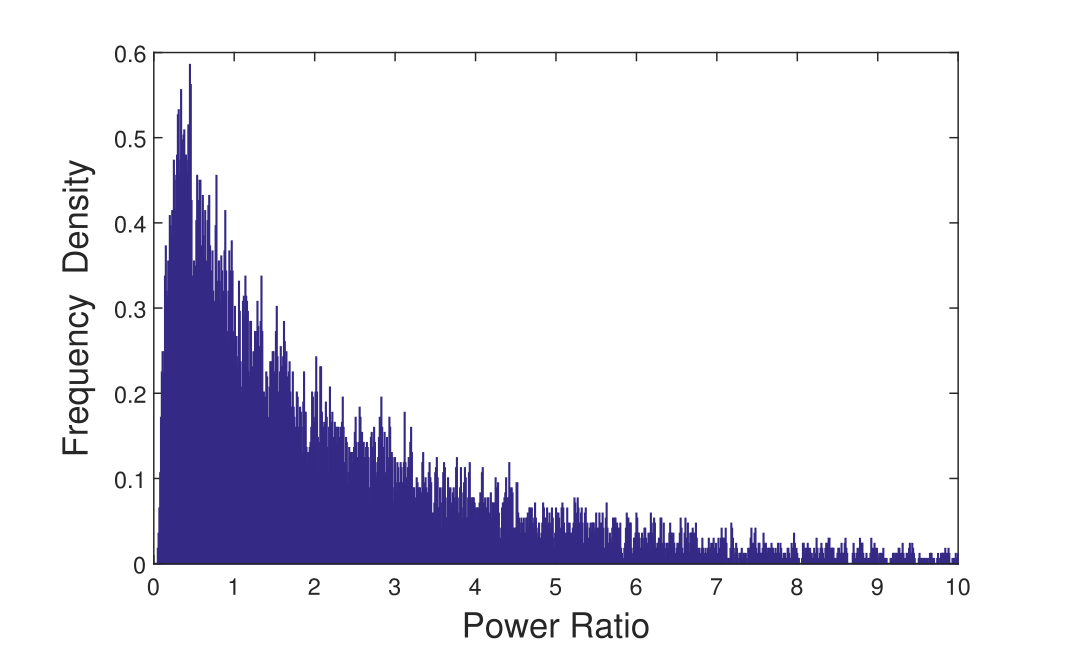
图 11|大多数基站的功率比集中在哪里?
无字母子图。横轴功率比画到10,纵轴频率密度。最高的一簇靠近0.45,密度接近0.6,然后向右拉出长尾。正文说平均值是2.4392,一半基站落在0.67到3.27,另有少量基站稀疏分布在10到45。10到45这一段没有画进横轴。来源:原论文 Fig. 11。
众数约0.45,表示最常见的基站里,规律分量的平方和只有随机分量的0.45倍,随机分量的能量更大。平均值2.4392被右侧长尾抬高,所以“平均一座基站”比“最常见的一座基站”更偏规律。一半基站所在的0.67到3.27,横跨了 R 小于1和大于1的两侧。作者据此说,多数基站的可预测性并没有压过随机性。这句话适合众数附近;它不适合那一小撮 R 达到10以上的塔。
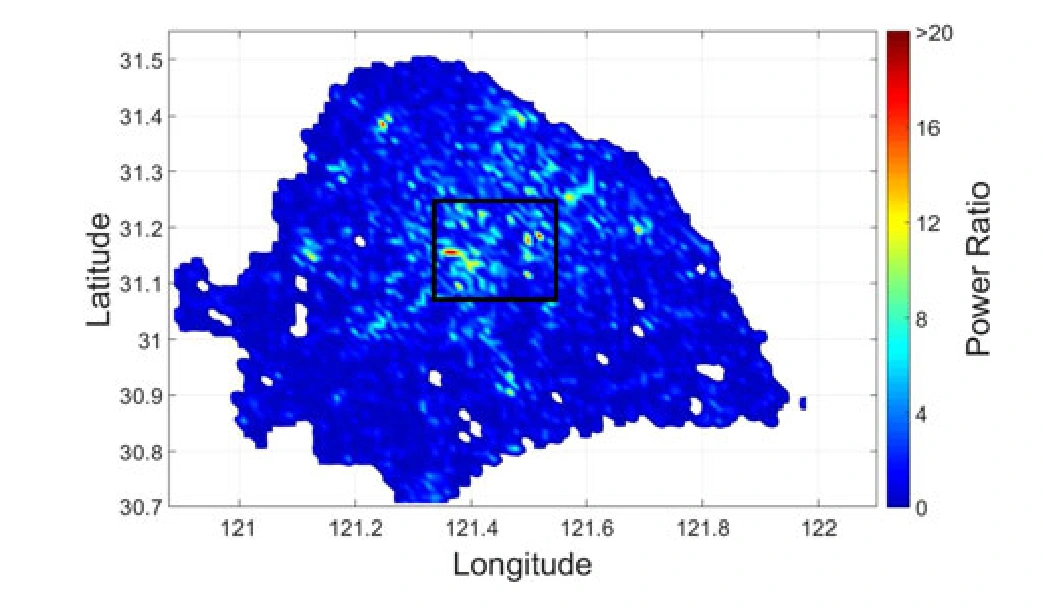
图 12|高功率比在上海的哪里出现?
无字母子图。横轴经度大约121到122,纵轴纬度大约30.7到31.5,色标从0到大于20。全市绝大多数格点是深蓝色低值,黄、红点很稀。黑框标出后文要放大的中心范围,框内能看见少量更亮的点。在0到20以上的色标下,中等功率比看起来仍然偏蓝。来源:原论文 Fig. 12。
正文认为市中心的基站更常拥有相对较高的功率比,大部分城区处于中间水平。地图上的主色是低值蓝,和“极端高值很少”一致;“市中心相对更高”主要靠框内那些稀疏亮点,不是一片红色城区。
为了看两端,论文取出功率比高于99.5%基站的一组,以及图例中写成低于99.5%基站的一组。表2分别有41座和43座。超过9000座的0.5%大约是45座,两组数量与两端各约0.5%接近。若按“低于99.5%”的字面理解,紫点应几乎包括全部基站,和图上的稀疏紫点不符。紫点应看成作者挑出的低功率比对照。
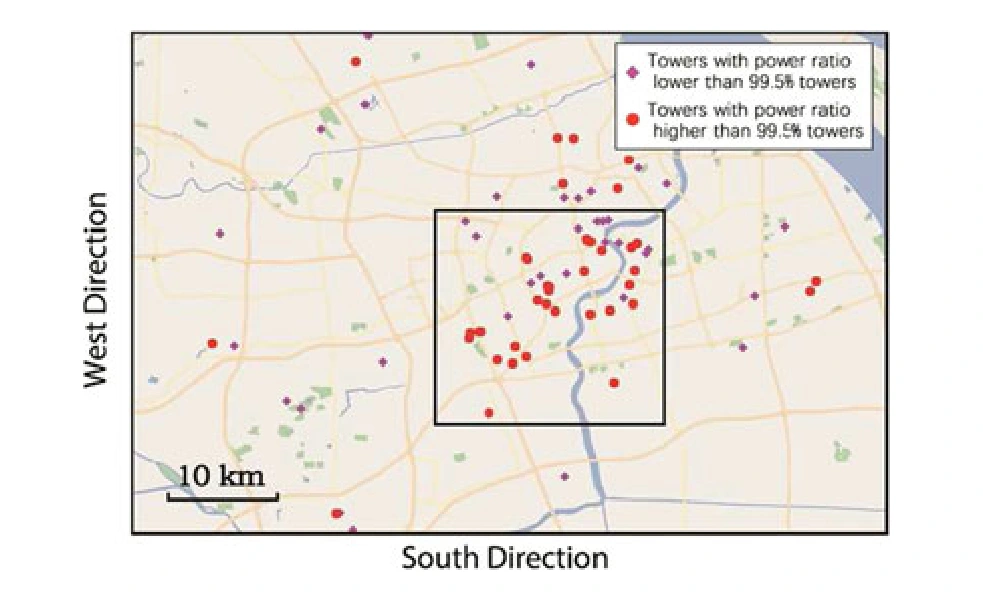
图 13|极高和极低功率比的基站分别坐落在哪里?
无字母子图。红点是功率比高于99.5%基站的塔,紫点是图例所写的低功率比塔。黑框与图12的黑框同一范围,比例尺为10公里,左为西、下为南。红点环绕市中心和河湾,紫点更分散,其中一部分离开中心。来源:原论文 Fig. 13。
作者看图后写,红点大多位于商场和大型公园。这个判断随后用兴趣点来数。兴趣点来自百度地图,分成娱乐、办公、居住、乡村四类。以基站为圆心、半径200米的圆代表该塔所在位置的功能。圆内同时有多类兴趣点时如何只留一个标签,正文没有逐步说明。表2的座数已经互斥,每座入选基站只进了一类。
| 位置类型 | 高功率比座数 | 占41座的比例 | 低功率比座数 | 占43座的比例 |
|---|---|---|---|---|
| 娱乐 | 26 | 63.41% | 13 | 30.23% |
| 办公 | 11 | 26.83% | 18 | 41.86% |
| 居住 | 4 | 9.76% | 6 | 13.95% |
| 乡村 | 0 | 0% | 6 | 13.95% |
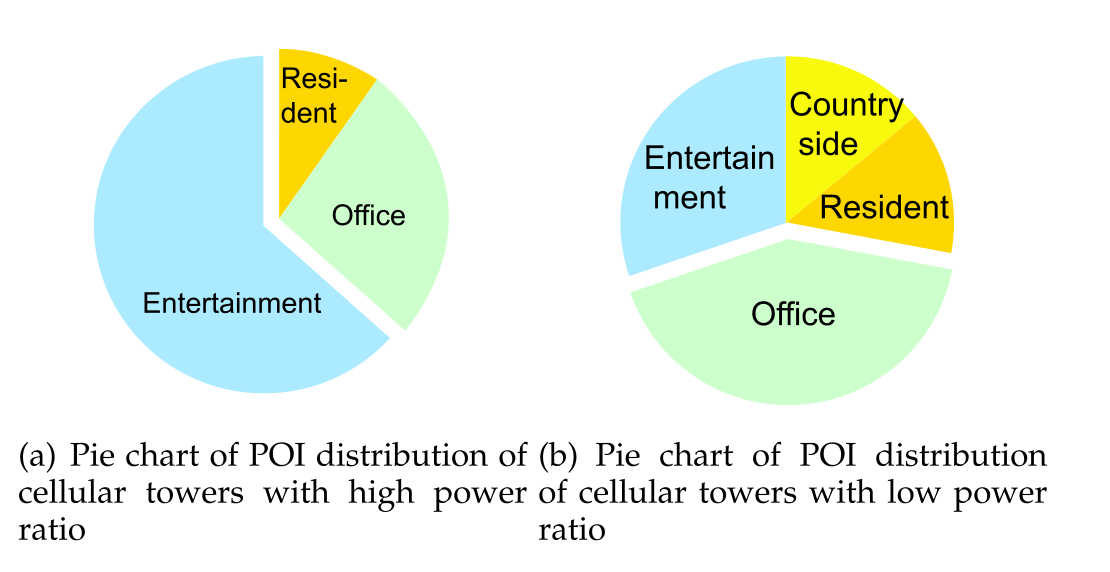
图 14|两类极端基站周围的兴趣点构成有何不同?
(a)高功率比41座:娱乐约占六成,办公次之,居住很少,没有乡村。(b)低功率比43座:办公成为最大一块,娱乐大约降到三成,居住与乡村各接近14%。饼图没有标出百分比,数值以表2为准。来源:原论文 Fig. 14。
娱乐类从高组的63.41%降到低组的30.23%,大约一半,和正文的“大约减半”一致。低组里乡村出现,并占到13.95%,高组为0。作者据此认为,市中心娱乐区的基站更可预测,乡村基站更不可预测。
他们给出的可能原因有两层。一层是市中心人口和密度为全市平均的1.40到2.48倍,人来人往对单座基站总流量的影响更小;另一层是商店有固定营业时间,会把流量的周期托住。乡村则人口更稀、功能更散,少数人的行为就能让流量晃动。1.40到2.48倍没有在本文给出测量或出处,不能当成这批八月流量自己算出的结果。营业时间也没有和流量序列对齐检验。兴趣点与功率比的对应,是这41座加43座上的分布差异,还不是“把基站建在商场就会提高预测精度”的因果。
这些比较停在哪里
分解用的时间窗长度没有给出,所以同样的日周期可以被不同的平滑强度切出来。10分钟序列来自均匀分摊,一次长时间通信会被抹进多个格子,突发因此看起来更平。论文没有比较按开始时刻计入、或按实测速率计入的另一种切法。
预测公式按 24×7 的小时周周期书写,数据格子却是10分钟。图6只覆盖14天和两座基站,表1里的系数标准误很大。80%和0.3这个概括,还与图7里基站a的位置有大约0.08的差距。把“规律分量高度可预测”推广到全部9000座,缺少全市误差分布。
功率比只比较两类分量的能量。它解释不了高 R 的塔是否真的有更小的预测误差,也解释不了低 R 来自用户少、测量噪声还是功能混合。200米兴趣点分类的并列规则没有写清。人口倍数没有来源。
随机分量“不可能预测”,指的是自身线性滞后和邻塔残差都提供不了稳定的提前信号。一个月、一座城市、一家运营商,也还没有第二个月来检查8月的日周期是否原样重复。更细的流量刻画指向作者2015年的会议论文,那篇的图表没有附在本文后面。本文PDF共10页,没有随文补充材料。
一句话总结
上海这一个月的蜂窝流量里,跟得上昼夜作息的部分可以在示例基站上被季节性时间序列跟上形状,剩下的随机起伏既缺少自身线性记忆,也不稳定地跟着邻塔走;一座塔有多守时,要看它周围的城市功能,全市平均值盖不住众数附近那些随机能量更大的基站。
核心来源
- IEEE Xplore 论文页,核对题目、作者、卷期和 DOI:10.1109/TSC.2016.2599878。正文图1–14、表1–2均出自这一正式版本,页码796–805。
- 作者在文中指向的更早流量刻画:H. Wang、F. Xu、Yong Li、P. Zhang、D. Jin,Understanding mobile traffic patterns of large scale cellular towers in urban environment,ACM Internet Measurement Conference,2015,第225–238页。本文没有重印那篇的图表。
作者介绍
以下身份和方向取自论文脚注与文末简介,对应发表当时的介绍。Jeungeun Song 在文末没有单独简介。
- Fengli Xu:署名清华大学电子工程系。2015年于华中科技大学获电子与信息工程学士,论文发表时在清华大学电子工程系攻读博士。简介列出的方向包括人类移动性、移动大数据挖掘和用户行为建模。
- Yuyun Lin:署名清华大学电子工程系,发表时为该系本科生。简介列出的方向是移动大数据挖掘和用户行为建模。
- Jiaxin Huang:署名清华大学电子工程系,发表时为该系本科生。简介列出的方向是移动大数据挖掘和用户行为建模。
- Di Wu:脚注署名为湖南大学。简介写明他当时是湖南大学计算机工程系副教授,并有帝国理工学院等研究关联;2012年、2013年于加州大学欧文分校获计算机科学硕士和博士。方向包括无线网络、移动计算、物联网和智慧城市。
- Hongzhi Shi:署名清华大学电子工程系,发表时为该系本科生。简介列出的方向是移动大数据挖掘和用户行为建模。
- Jeungeun Song:脚注署名为韩国首尔淑明女子大学。论文没有提供学位、职务或研究方向简介。
- Yong Li:通讯作者,署名清华大学电子工程系,IEEE会员。2007年于华中科技大学获电子与信息工程学士,2012年于清华大学获电子工程博士。简介写明其方向是网络与通信。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若按全市平均功率比2.44去准备容量,会把最常见的那类基站想象得过于守时。众数约0.45意味着,在最常出现的塔上,随机分量的平方和已经超过规律分量。商场那一小撮高功率比基站可以按营业时间做强周期调度;对靠近众数的大量基站,日程只解释较少的能量,容量里仍要留给本塔自己的突发。这个差别来自分布的偏斜,本文没有把它写成运营商策略。
另一个可以单独检验的机制是“人多则单个人的会话被平均掉”。作者用市中心人口倍数和商店营业时间来解释高功率比,但没有在同一类兴趣点内部,再按基站服务的用户规模分组。若机制真是人数把尖峰摊薄,那么同为娱乐或同为办公时,用户更多的基站应有更高的功率比。若分组之后功率比不再上升,营业时间表本身就比人数更关键。这需要的是基站层面的用户规模,比较仍然停在基站合计。