出租车抄了近路,公交要不要改道把人接回来?
论文名片|Yanchi Liu、Chuanren Liu、Nicholas Jing Yuan、Lian Duan、Yanjie Fu、Hui Xiong、Songhua Xu、Junjie Wu,Exploiting Heterogeneous Human Mobility Patterns for Intelligent Bus Routing,2014 IEEE International Conference on Data Mining,2014:360–369。DOI:10.1109/ICDM.2014.138。版本为这次会议论文,含图1–14与表I–V。
一个人站在家门口,去同一栋楼可以坐绕路、多站的公交,也可以坐少停几站的公交,还可以花更多钱坐出租车直达。图1把这三句话画在同一张示意图上:1美元符号、1.5小时、5站;1美元符号、1小时、3站,并打了勾;20美元符号、30分钟、中途不停。这是帮助理解的图画,上面的价钱和分钟数不是北京某条线路的账单。
真正要分清的是另一件事。2012年北京已经有公交刷卡和出租车载客轨迹。有些区域之间,出租车走得比较顺,公交却绕路、多停,甚至没有直达。论文把出租车走过的路当作公交线路的参照上限,估计如果公交更接近这条路,群体里选择公交的比例会升多少,再在预算里挑选要改的起讫点对(origin–destination pair,OD pair,从一个站点区域到另一个站点区域)。下面的乘客增量是方式选择模型算出来的期望,总行程保持为观察到的公交加出租,不是改线落地后重新清点的人数。
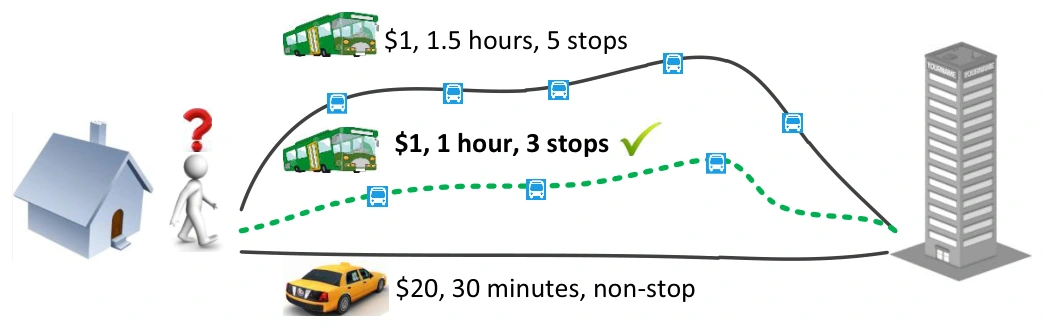
图 1|同样的起终点,绕路公交、少停公交和直达出租车怎么被画成一个选择?
无字母子图。左侧是住宅和正在犹豫的人,右侧是楼。上方黑线绕得更远,标注为1美元符号、1.5小时、5站;中间绿色虚线标注为1美元符号、1小时、3站,并有勾;下方直线标注为20美元符号、30分钟、中途不停。美元符号和分钟数属于这张示意图。来源:原论文 Fig. 1。
先说结论
- 表3的原始规模是29,964辆出租车、1,900万次载客行程,以及1,000万次公交行程、701,250个持卡人。进入模型前,论文把公交与出租的行程比抽样调到约3.5:1。按这个比换算,抽样行程里公交约占77.8%,即3.5除以4.5。图5至图8的纵轴是各起讫点对内部的公交占比,分母是该对的公交加出租,不能读成全北京出行的八成坐公交。
- 全部起讫点对上,分时段做10折交叉验证再对7个时段取平均,时空功能加权逻辑回归的AUC是0.82,不加时段的逻辑回归是0.67。七个时段单独的AUC为0.81、0.84、0.81、0.82、0.80、0.83、0.81,算术平均0.817,与0.82在两位小数上一致。正类是一次出行还是一个起讫点对,正文没有写明,所以AUC没有可报告的样本分母。
- 用出租车路线替换现有公交后,论文写全体起讫点对的公交概率平均提高5%。图12的概率差曲线在大部分位置靠近0.05,纵轴刻度到0.10。图中没有同时画出提高前的概率,因此这5%对应的是概率差,不能再换成相对历史概率的增幅。客流增量集中在横轴右端的少数点对。
- 前100个缺陷起讫点对上,最大乘客的逻辑回归给出平均预测增量731.2,最短距离法是445.6,最短时间法是467.2。表中各列是每个起讫点对的平均值,731.2相对445.6高出285.6,约是445.6的1.64倍。历史公交乘客数本身没有单列,总行程量也保持不变。
- 小红门到前门、沙子口到前门被合成一条线。论文写这条线与北京公交集团2013年3月新开的93路有相同子路径,没有给出93路的客流。
两套记录,先落到同一批站点区域
这里的人类移动性(human mobility)是人在城市里的日常移动,具体只包括公交刷卡和出租车载客,不包括搬家,也不包括地铁和私家车。公交记录来自北京市政交通一卡通,字段有卡号、线路号、上车站、下车站、时间和票价。出租车只用载客轨迹,从上车点到下车点;空驶没有进入行程。
表3给出的口径是2012年8月至11月。出租车有29,964辆、有效114天,其中工作日77天、周末37天,载客GPS点3.33亿个,载客行程1,900万次,总里程1.56亿公里。公交刷卡有7,810个站点、701,250个持卡人、1,000万次行程。引言里的评估句另写了2012年8月至10月,并把车辆数写成约3万辆。114天更接近8月至11月这四个自然月,两处月份在论文内部并不相同。摘要和结论中的1,900万次出租、1,000万次公交,与表3一致。
站点还有三套数,不能混用。刷卡数据里出现7,810个站。城区公交线路数据是2,427个站、1,058条线。同名站,或像明光桥北、明光桥南这种实际共用一处的站,被合并后剩下1,250个站。城市按这些站做维诺划分,每个站对应一块区域,出租车上下车点归到最近的站。路网有196,307个路段,1,250个区域节点之间连出3,855条不含中间站的直接边。
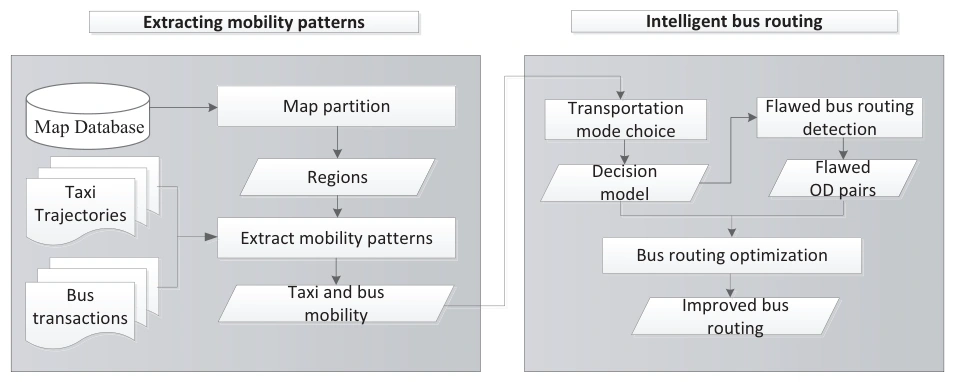
图 2|公交、出租车和路网怎样接到同一套改线流程?
无字母子图。左侧从地图、出租车轨迹和公交交易得到区域,再抽出两类移动;右侧用方式选择模型找出有缺陷的起讫点对,并在优化后给出改进线路。这是流程示意,不是客流大小。来源:原论文 Fig. 2。
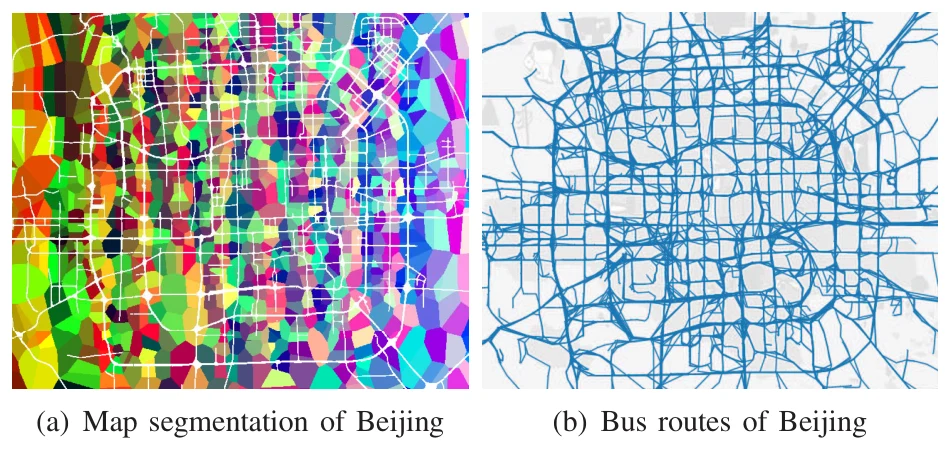
图 3|1,250个站点区域和既有公交线在北京城区长什么样?
(a)颜色区分合并站点后的区域,白线是道路,没有人数图例。(b)蓝线是城区既有公交线路。两张图都没有把7,810个刷卡站点再画一遍。来源:原论文 Fig. 3。
分析前还有一次抽样。论文写用随机抽样恢复公交行程,使公交与出租的行程比约为3.5:1,脚注指向北京市交通委员会网站,正文没有给出抽样前后的行程对照表。原始的1,000万对1,900万约是0.53:1,和3.5:1不是同一个比例。后文的公交占比都建立在抽样后的分析集上。
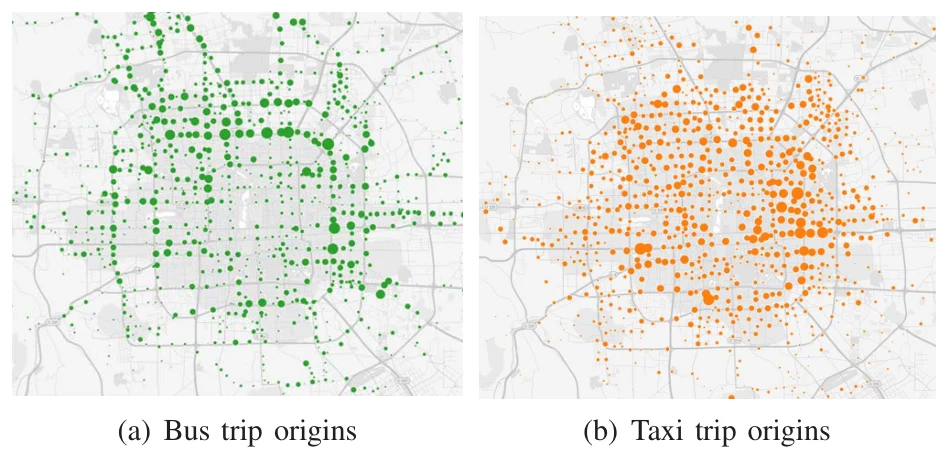
图 4|公交起点和出租车起点是否铺在同一片城区?
(a)绿点是公交行程起点,点越大行程越多,沿路网铺得比较开。(b)橙点是出租车载客起点,较大的点更集中在中心城区,南侧也能看到大点。图注写点的大小与行程数成正比,没有印出每个点的次数。来源:原论文 Fig. 4。
行程再按出发时间切成7段,因为论文认为工作日通勤和周末、白天办事的方式偏好不一样。公交分析只保留5:00至23:00,理由是23:00至次日5:00很少有人规律地坐公交。
| 时段 | 星期 | 钟点 |
|---|---|---|
| 1 | 工作日 | 5:00–10:30 |
| 2 | 工作日 | 10:30–16:00 |
| 3 | 工作日 | 16:00–19:30 |
| 4 | 工作日 | 19:30–23:00 |
| 5 | 周末 | 5:00–12:30 |
| 6 | 周末 | 12:30–19:30 |
| 7 | 周末 | 19:30–23:00 |
时段1被写成每周5天、每天5.5小时。后面计算线路供给时会用到这个时间跨度。每个时段、每个起讫点对分别统计公交与出租的行程量、平均时间、里程、速度、票价和站数。出租车站数记为0。出租车里程按连续GPS点的道路距离相加,公交里程按连续站点的道路距离相加,两条里程的测量方式并不相同。
里程、时间、票价和站距,各自把公交占比拉向哪边?
方式选择在这里是群体比例:某时段、某起讫点对上,公交行程除以公交加出租的行程。论文明确写的是起讫点对的群体行为,不是一个人的选择记录。他们还假定可达性和可靠性不变,只看与线路有关的因素。
七个特征是:出租车里程,公交里程除以出租车里程,出租车时间,公交时间除以出租车时间,出租车票价,公交票价除以出租车票价,以及公交站数除以出租车里程。出租车里程被用来代表有经验司机走出的较短道路距离。比值大于1,表示公交比出租车更远或更慢。
图5至图8都是箱线图。每一档汇总该档起讫点对的公交占比,红线是中位数,红色加号是离群点。中位数没有印成数字,只能读升降方向。纵轴分母是该起讫点对在分析集中的公交加出租。
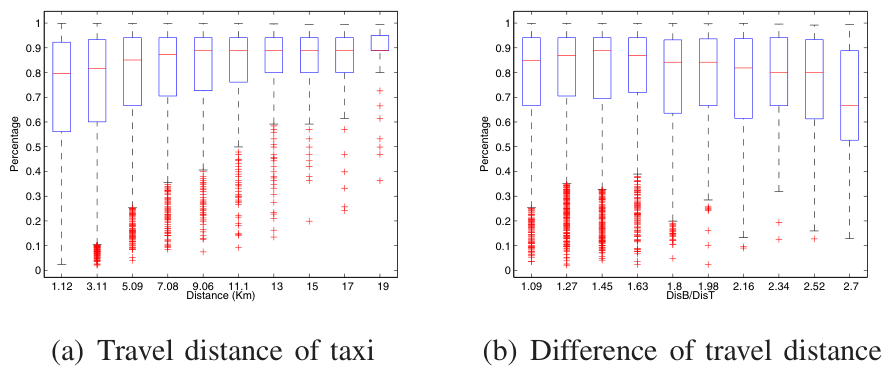
图 5|公交占比怎样随距离和绕路程度变化?
(a)横轴是出租车里程,单位公里,刻度从1.12到19,相邻刻度大约间隔2公里。中位数随里程升高。(b)横轴是公交里程除以出租车里程,刻度从1.09到2.7,各档都大于1,中位数随这个比值下降。来源:原论文 Fig. 5。
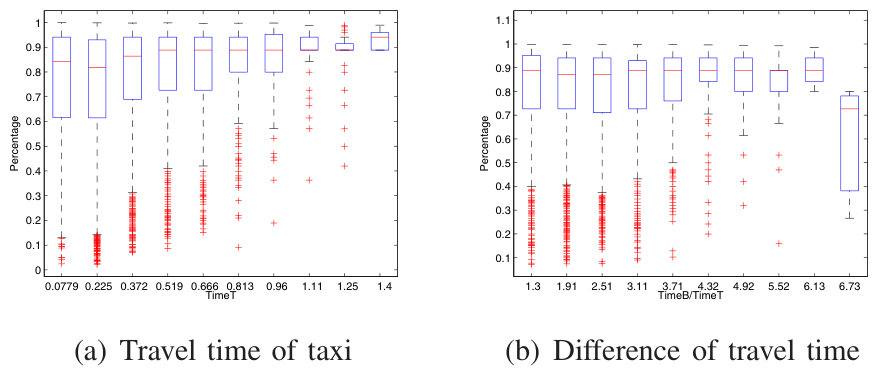
图 6|时间变长以后,公交占比还升吗?
(a)横轴标为TimeT,刻度从0.0779到1.4,图上没有写单位;后文线路时间表用的是小时。中位数随出租车时间升高。(b)横轴是公交时间除以出租车时间,刻度从1.3到6.73,都大于1;右侧最末一档的箱体明显下移。纵轴(b)从0.1起画。来源:原论文 Fig. 6。
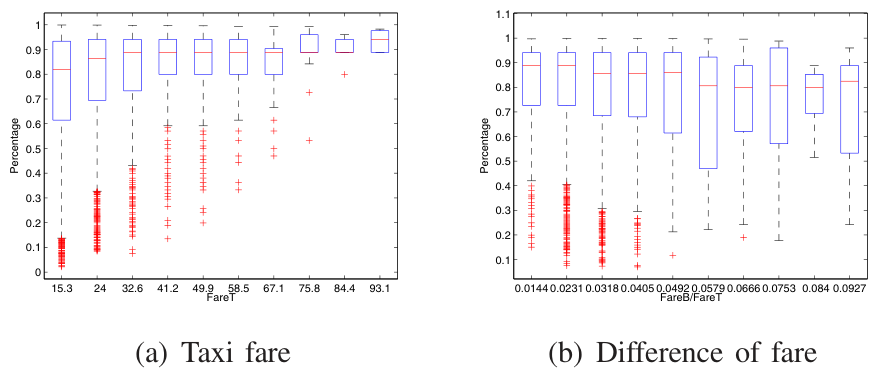
图 7|票价升高时,上车的人是更多还是更少?
(a)横轴标为FareT,刻度从15.3到93.1,图上没有货币单位;线路结果表里的票价单位是元。中位数随出租车票价升高,论文解释为长距离时出租比公交贵得多。(b)横轴是公交票价除以出租车票价,刻度从0.0144到0.0927,都低于0.1;中位数整体偏高,并随比值有所下降。纵轴(b)从0.1起画。来源:原论文 Fig. 7。
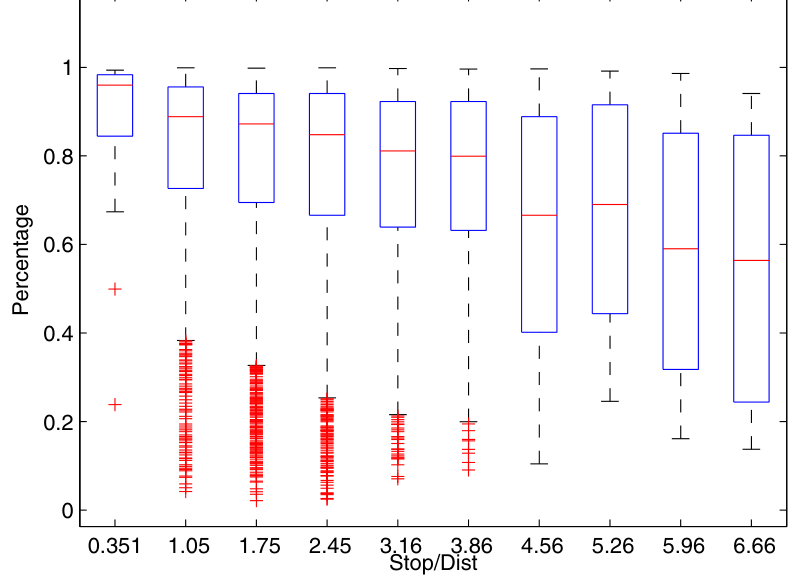
图 8|每公里停靠越密,公交占比掉得有多快?
无字母子图。横轴是公交站数除以出租车里程,刻度从0.351到6.66。中位数从左侧接近1降到最右一档的箱体中部,论文称之为下降很快。各档中位数没有印出。来源:原论文 Fig. 8。
这四张图描述的是同时观察到的线路条件和选择比例。距离长的地方公交占比高,也可能因为长距离本身更少有人叫车,而不只是因为线路设计。它们还不能单独证明把站距拉开就一定会增加乘客。
邻近、功能相近的点对,能否互相借用选择?
若每个起讫点对完全单独拟合,邻居的信息就用不上。论文的理由是:功能相近、位置相近的区域对,出行目的和偏好更可能接近;居住区到商业区,也可能不同于商业区返回居住区。因此每个目标点对在估计系数时,给其他点对一个权重:
权重 = exp(−空间距离 / (2hα) − 功能距离 / (2hβ))。
空间距离是起点之间、终点之间欧氏距离的平均,欧氏距离这里是站点的直线距离,不是沿路里程。功能距离是两个区域兴趣点数量向量的余弦距离的平均。2012年北京兴趣点分成10类,向量只数每类有多少个点。hα和hβ控制尺度,正文没有给出它们的数值。
| 类别 | 内容 | 个数 |
|---|---|---|
| 居住 | 公寓楼 | 29,246 |
| 工作 | 政府与办公楼 | 71,915 |
| 教育 | 学校、培训机构 | 15,489 |
| 餐饮 | 餐馆 | 36,723 |
| 购物 | 商店、商场、奥特莱斯 | 56,520 |
| 娱乐 | 博物馆、剧院、俱乐部 | 7,897 |
| 户外 | 公园、运动场 | 2,211 |
| 交通 | 机场、铁路与公交站 | 15,287 |
| 医疗 | 医院、医疗中心、药店 | 9,768 |
| 汽车服务 | 销售、维修、加油站 | 10,781 |
预测函数有两种。逻辑回归把内积z变成概率1 / (1 + e^(−z)),保证结果落在0到1之间。线性版本直接把内积当作预测,计算更快,但不再自动限制在0到1。模型按7个时段分别建立。对照方法是:全天不按时段的逻辑回归LoR,分时段逻辑回归TLoR,以及分时段线性支持向量机TLiSVM。
评价用ROC曲线下面积AUC。阈值从0到1,每0.01取一次。灵敏度是真正例除以正类总数,特异度是真负例除以负类总数。10折在每个时段内分开做,再把各时段结果平均,作为图10(a)的总体分数。
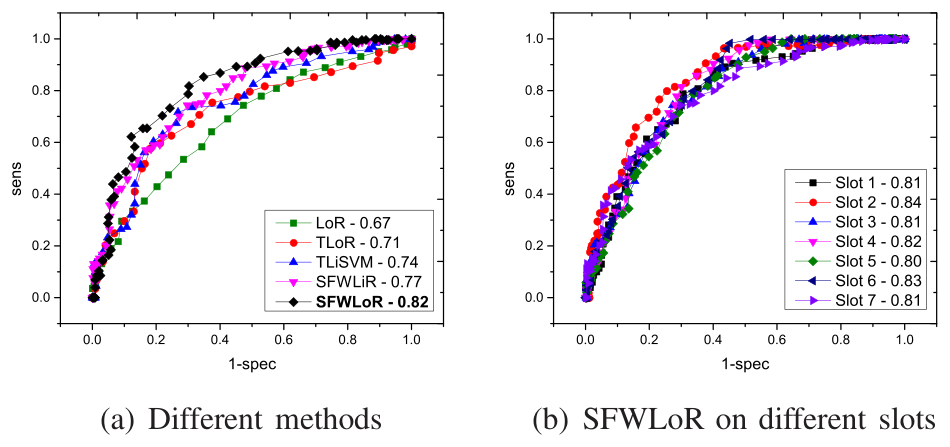
图 10|加上位置和功能的权重以后,方式选择预测提高了多少?
(a)横轴是1减特异度,纵轴是灵敏度。图例AUC为:LoR 0.67,TLoR 0.71,TLiSVM 0.74,线性加权SFWLiR 0.77,逻辑加权SFWLoR 0.82。这是7个时段平均后的结果。(b)只看SFWLoR:时段1至7的AUC为0.81、0.84、0.81、0.82、0.80、0.83、0.81。来源:原论文 Fig. 10。
论文写工作日时段1至4好于周末时段5至7,原因是周末行程变化更大。把图例直接平均,工作日四段是0.820,周末三段是0.813,差距只有0.007。周末时段6是0.83,高于时段1、3、4。所以“工作日更好”作为四段对三段的平均可以成立,不能理解成每一个周末时段都更难预测。
另有一次时间上分开的检验。2012年9月21日起,北京城区8条公交线发生调整,这个日期落在8月至11月的数据中间。9月21日之前用来训练,之后用来测试,并选出受线路变化影响的86个起讫点对。
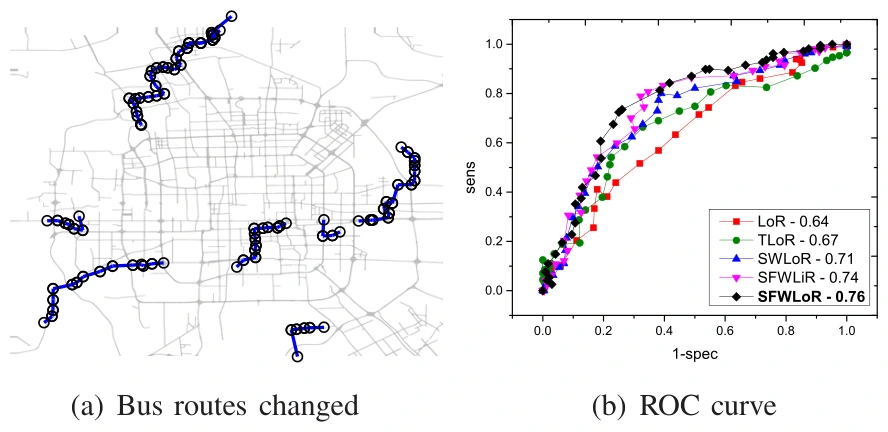
图 11|线路真的改过以后,模型还能分出公交和出租车吗?
(a)蓝圈标出调整过的公交线路,正文写明是8条,图上没有逐条写线路号。(b)86个起讫点对上的ROC。图例AUC为:LoR 0.64,TLoR 0.67,TLiSVM 0.71,SFWLiR 0.74,SFWLoR 0.76。来源:原论文 Fig. 11。
0.82和0.76来自两套检验。前者是全部点对、分时段十折后再平均;后者是86个受影响点对、按9月21日前后分段。两者相差0.06,样本和划分方式都不相同。这张ROC评价的是方式选择还能不能被分对;优化器是否复现公交公司当天采用的新线,不在这86个点对的结果里。
概率只抬高约0.05,新增乘客却堆在少数点对
要改现有线,先得指出哪些起讫点对的公交相对不便。论文把每个点对的出租车路线当作公交能达到的上限,因为出租路线被看成实际驾驶中较好的走法。再算:
潜在新增公交乘客 = 各时段的(公交加出租行程量)×(出租车路线下的预测公交概率 − 历史公交概率)。
总行程量不变,增加的公交乘客来自原来记在出租一边的那些行程。私家车不在数据里。论文写,若再考虑私家车,公交的实际影响还可以更大;这是作者对未观测方式的预期,数据里没有私家车行程可以核对。
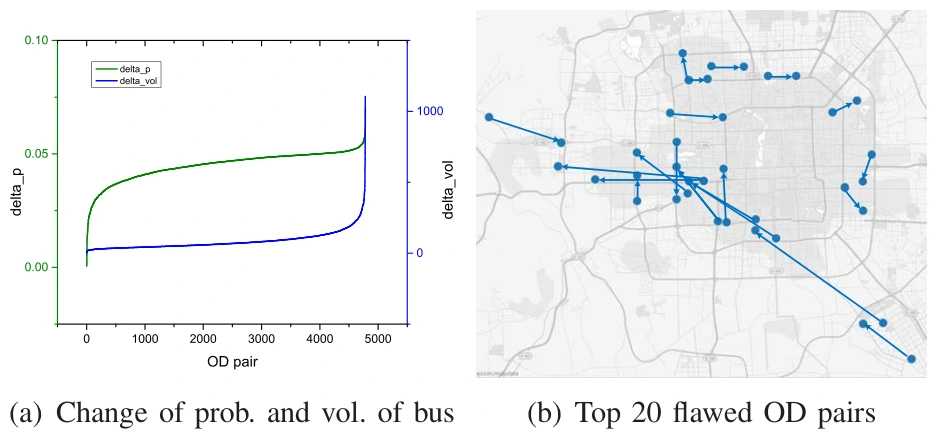
图 12|把公交改到出租路线的上限后,概率和客流分别动多少?
(a)横轴是起讫点对,刻度到5000。绿线delta_p是公交概率的变化,左轴到0.10,曲线在大部分位置靠近0.05,右端略抬。蓝线delta_vol是客流增量,右轴到1000,前段很低,接近5000时陡升。正文没有写出这张图的起讫点对总数,也没有给出齐夫定律的拟合指数。(b)前20个缺陷起讫点对画在北京地图上,连线覆盖西南并有伸向东南的长线,图上没有站名。来源:原论文 Fig. 12。
论文据此写:线路改进后,全体起讫点对的公交概率平均提高5%;客流增量符合齐夫定律,大部分增量发生在少数点对上。图中绿线靠近0.05,和“5%”处于同一概率刻度。由于提高前的平均概率没有画出,不能把5%再解释成“在原概率上再增加5%”。前20对被用来对照图4:西南部公交需求存在,出租车行程多、公交行程少,因而有从出租接过乘客的可能。这是空间上的并存,还不是改线造成了出租减少。
预算没有写明时,模型仍给出每对多少新增乘客
多个缺陷点对一起改时,目标是各时段、各点对的行程量乘以新线路下的公交概率,再全部相加。成本不超过预算向量C,成本按线路长度和行驶时间计算,并用时段长度除以发车间隔,把“开出多少班”放进供给。发车间隔对所有线路都取15分钟,论文写自己不研究时刻表。时段1的时间跨度写成5×5.5小时;小时和15分钟如何换算后进入同一条成本,正文没有再演示。C的具体数字也没有给出。
边上的公交时间另有两个设定:公交速度取出租车速度的0.7倍,每停一站再加1.5分钟。0.7和1.5分钟是为北京取的常数,不是这篇论文里带误差的估计结果。逻辑回归的目标非线性、非凸,分支定界得到局部意义下的整数解。线性版本把预测函数改成内积本身,变成带约束的线性规划。实验里线性结果被用来逼近逻辑回归。特征分解也说明,改线时出租车里程、时间、票价以及票价比放在不随新线变化的常数项里,随线路变的是公交里程、公交时间和站数。
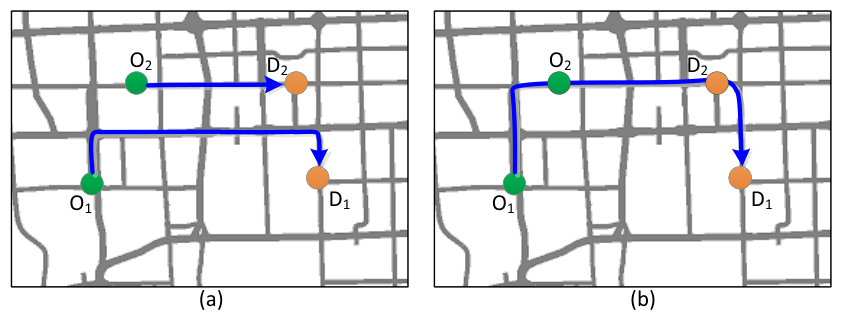
图 9|两条需求各自修一条线,和合成一条线,差在哪里?
(a)O1到D1、O2到D2各走一条蓝线。(b)两条需求合成一条蓝线,先过O1一侧再折向两个终点。这是预算示意:论文写(a)会超出预算,(b)能留在预算内。图上没有预算数字,也不是北京实测线路。来源:原论文 Fig. 9。
对照线路不是随机线路,而是实践中常见的最短距离SD和最短时间ST。最大乘客目标记为MR,线性版是MR-LiR,逻辑回归版是MR-LoR。表5的每一列都是K个起讫点对的平均值。概率是新线路上的预测公交概率。ΔBVol是预测公交乘客相对历史公交乘客的变化。K从100增到500时,MR-LoR的平均增量从731.2降到342.3,符合按潜力排序后,后面的点对潜力更小,因此更能说明这一列是每对的平均,而不是K对的合计。
| K | 方法 | 公交里程(公里) | 公交时间(小时) | 站数 | 票价(元) | 预测概率 | 平均ΔBVol |
|---|---|---|---|---|---|---|---|
| 100 | 最短距离 | 3.63 | 0.28 | 3.71 | 0.44 | 0.83 | 445.6 |
| 100 | 最短时间 | 3.84 | 0.27 | 4.02 | 0.44 | 0.83 | 467.2 |
| 100 | 线性最大乘客 | 3.65 | 0.29 | 3.83 | 0.44 | 0.85 | 669.3 |
| 100 | 逻辑最大乘客 | 3.45 | 0.28 | 3.67 | 0.44 | 0.86 | 731.2 |
| 200 | 最短距离 | 4.23 | 0.33 | 4.56 | 0.48 | 0.81 | 247.8 |
| 200 | 最短时间 | 4.30 | 0.30 | 4.52 | 0.49 | 0.82 | 301.1 |
| 200 | 线性最大乘客 | 4.41 | 0.34 | 4.33 | 0.49 | 0.84 | 427.3 |
| 200 | 逻辑最大乘客 | 4.52 | 0.35 | 4.40 | 0.49 | 0.85 | 481.2 |
| 500 | 最短距离 | 4.31 | 0.34 | 4.77 | 0.48 | 0.79 | 184.4 |
| 500 | 最短时间 | 4.51 | 0.32 | 4.78 | 0.49 | 0.81 | 225.8 |
| 500 | 线性最大乘客 | 4.54 | 0.33 | 4.64 | 0.49 | 0.83 | 316.4 |
| 500 | 逻辑最大乘客 | 4.58 | 0.34 | 4.71 | 0.49 | 0.84 | 342.3 |
前100对里,逻辑最大乘客的预测概率0.86,比最短距离和最短时间的0.83高0.03;平均增量731.2比445.6高285.6。线性版本是669.3,为731.2的91.5%。这100对上,逻辑回归的平均里程3.45公里,短于最短距离的3.63公里和最短时间的3.84公里,时间都在0.27至0.29小时,票价都是0.44元。0.28小时合16.8分钟,这是单位换算。
前200对和前500对的格局变了。逻辑回归的平均里程变成4.52公里和4.58公里,都长于同组最短距离的4.23公里和4.31公里,预测概率和平均增量仍然更高。最短时间的增量高于最短距离,论文据此认为时间比里程更受重视。票价在同一K内几乎不变,增益主要不来自把票价改低。历史乘客数没有列进表,所以不能从731.2反推出原来有多少人坐公交。
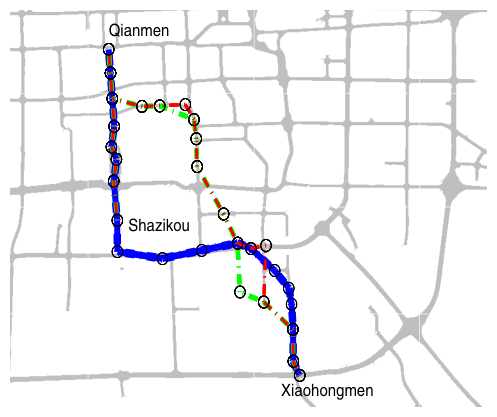
图 13|小红门、沙子口到前门,三种走法是两条线还是一条线?
无字母子图。前门在北,沙子口在中部,小红门在东南。绿线是最短距离,红线是最短时间,蓝线是最大乘客。绿线和红线各自更像短的局部走法,蓝线把两个起点连进同一条通往前门的线。来源:原论文 Fig. 13。
论文写,这条最大乘客线路与93路有相同子路径,93路由北京公交集团于2013年3月新开。数据停在2012年11月,93路出现在数据之后。相同子路径说明后来的实际线路与模型线路有重叠,没有报告重叠了多少站,也没有报告93路开通后的客流变化。
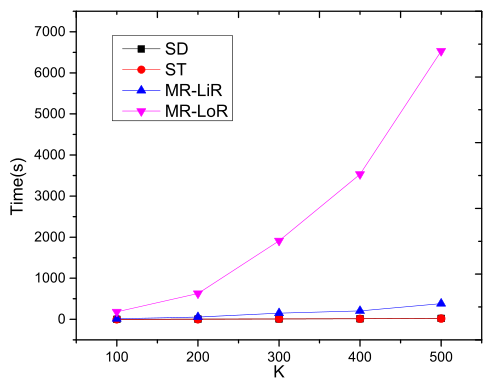
图 14|点对从100增到500,四种走法要算多久?
无字母子图。横轴K为100、200、300、400、500,纵轴是秒,刻度到7000。最短距离和最短时间贴在底部。线性最大乘客在K=500时仍低于1000秒。逻辑回归上升最快,K=500时落在6000秒与7000秒之间。各点没有标出精确秒数。表5没有给出K=300和400的乘客结果。来源:原论文 Fig. 14。
论文因此建议大规模时用线性版本,离线规划再用逻辑回归。图14的时间差支持“线性快很多”;表5里线性的平均增量仍低于逻辑回归,所以更快的那一版并没有给出相同的预测乘客数。
这些预测能说到哪一步
可以稳定说的是:在抽样成约3.5比1的2012年北京公交与出租行程上,分时段并按邻近程度、兴趣点构成加权的逻辑回归,比不分时段的逻辑回归有更高的AUC;按潜力排序后,前100对的模型预测增量高于最短距离和最短时间。9月21日的8条线变更,只检验了方式选择模型在86个点对上的排序,没有检验优化器。
还不能说的是:731.2已经在路上发生;5%是相对原有公交概率的增幅;工作日每一段都比周末每一段更好预测;93路证明了最优线路被采纳。预算C、权重尺度hα和hβ、ROC的样本单位,正文都没有给出。兴趣点只按10类计数,区域功能因此是设施构成,不是实测的用地或岗位。公交速度系数0.7、停站1.5分钟和发车间隔15分钟是设定。总行程量被固定,诱增的新出行没有另估。
一句话总结
把出租车路线当作公交上限后,模型预测2012年北京少数不便的起讫点对可以增加公交乘客;这个增加量是抽样行程、固定总行程和固定票价、15分钟间隔下的概率推算,还不是改线之后重新数到的人。
核心来源
- IEEE Xplore会议论文页面,DOI为10.1109/ICDM.2014.138,与PDF首页一致。会议为2014 IEEE International Conference on Data Mining,PDF页码360–369。
- 正文图1–14、表I–V均来自这份会议论文。资助说明为国家高技术研究发展计划(863)课题SS2014AA012303。论文没有单独的作者贡献声明。
作者介绍
署名单位以论文首页和邮箱为准。论文没有提供个人履历,下面只写可核对的署名身份。
- Yanchi Liu:第一作者,署名为新泽西理工学院,邮箱域名为njit.edu。
- Chuanren Liu:署名为罗格斯大学,邮箱域名为rutgers.edu。
- Nicholas Jing Yuan:署名为微软研究院,邮箱域名为microsoft.com。
- Lian Duan:署名为新泽西理工学院,邮箱域名为njit.edu。
- Yanjie Fu:署名为罗格斯大学,邮箱域名为rutgers.edu。
- Hui Xiong:署名为罗格斯大学,邮箱域名为rutgers.edu。
- Songhua Xu:署名为新泽西理工学院,邮箱域名为njit.edu。
- Junjie Wu:署名为北京航空航天大学,邮箱域名为buaa.edu.cn。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
规划若只报告抽样后的增量,容易把3.5:1分析集上的概率变化当成城市原始出行结构上的变化。原始出租行程是1,900万、公交是1,000万,和3.5:1方向相反。同一条新线至少可以并列给出两套数:一套按论文的抽样比,一套按表3的原始行程比重新加权。若两套数排序不同,先改哪一对就会变。
另一个可检验的缺口是票价和发车间隔都被冻住了。表5里同一批点对的票价几乎不随最短距离、最短时间或最大乘客而变,15分钟间隔也适用于所有候选线。若允许票价或间隔随线路改变,前100对里里程更短的那条线未必仍然预测出731.2的平均增量。把票价或间隔放进随线路变化的特征后,再比较表5的四种方法,才能看出乘客增量有多少来自走线,有多少来自这两个被固定的运营选择。