市中心基站更挤,每个用户就更耗流量吗?
论文名片|Jingtao Ding、Rui Xu、Yong Li、Pan Hui、Depeng Jin,Measurement-Driven Modeling for Connection Density and Traffic Distribution in Large-Scale Urban Mobile Networks,IEEE Transactions on Mobile Computing,2018,17(5):1105–1118。稿件 2016 年 12 月 17 日收到,2017 年 6 月 1 日修回,2017 年 8 月 2 日接收;网络发表日期 2017 年 9 月 14 日,本刊版本日期 2018 年 4 月 2 日,刊期为 2018 年 5 月。DOI:10.1109/TMC.2017.2752159。
晚高峰可以有两种忙法。地铁站口挤满人,每个人只刷新几页;城郊一排住宅人少得多,留下的人却在看视频。两种基站的总流量都可能很高。若规划只看总流量,这两种忙会被加成同一种负荷。
这篇论文把一个基站在一小时里的负荷拆成两个数:每平方公里有多少接入用户,以及每个用户消耗多少字节。上海 2014 年 8 月的 3G 记录显示,前一个数堆在市中心,后一个数从市中心铺到外围。流量密度的地图更像人数地图。两个数的相关很弱,所以“人多”不能直接换成“每个人更耗流量”。
先说结论
- 上海每小时的用户密度、人均需求和二者相乘得到的流量密度,都可以用对数正态混合分布描述。在 5% 显著性水平下,K-S 检验没有拒绝这些拟合。用户密度的中位数约每平方公里 300 人,最高约 10^4 人;流量密度的中位数为 10^9 字节/(小时·平方公里),最高约 10^12。
- 流量密度与用户密度的相关系数大于 0.9。人均需求与这两者的相关系数绝对值都小于 0.1。图上一个月的人均需求大约落在 36 到 180 MB。
- 按高峰时段的两个数,上海交叉表里的 2,671 个基站分成 6 类,其中稀疏低需求占 1,312/2,671。昆明用同一套聚类得到 4 类。稀疏的界限是每平方公里 4,100 人以下,低需求是每小时 1.5 MB 以下,中需求和高需求大约以 4 MB 分开。
- 输入功能区比例后,分类模型在上海同一批数据上的全城平均归一化 RMSE,用户密度、人均需求、流量密度分别为 0.0757、0.0579、0.0655。不分类时流量密度的 RMSE 为 0.1528,分类把它降低 57.1%。这个误差是拟合比较,个体误差还要按能力排序对齐后才计算。
总流量几乎贴着每平方公里有多少人
要分开两种忙,先得把“连接有多密”和“流量堆在哪”写成可以相乘的两个量。论文用的是基站一小时的汇总,分析单位是基站,不是一条可以跟出去的个人路径。
上海数据来自一家主要运营商商用 3G 网络的计费网关,2014 年 8 月共 31 天。记录超过 6.92×10^8 条,覆盖 70 万用户和 9,181 个基站。全月消耗 2.8×10^15 字节。按 31 天和 9,181 个基站平均,每个基站每天约 9.8×10^9 字节,与 2.8×10^15÷(31×9,181)一致。昆明是同一运营商、格式相近的另一个月记录,约 6,000 个基站、约 40 万用户;正文没有写出具体月份。
记录里有匿名设备号、起止时间、基站编号、基站位置和字节数。后面的计算把这些记录收成每个基站、每个小时的用户数和字节数。本文沿这条汇总口径讲空间分布,不重建个人全天路径。
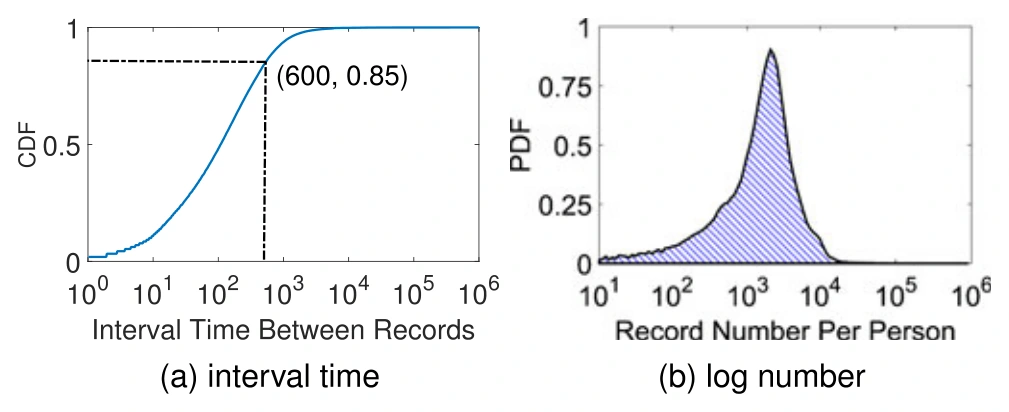
图 1|这批记录密不密、一个人一个月留下多少条?
(a)横轴是相邻两条记录的间隔秒数,对数刻度;纵轴是累积分布。标出的点是(600,0.85):间隔短于 600 秒的相邻记录占 85%。分母是相邻记录对,不是用户人数。(b)横轴是每个用户一个月的记录条数,对数刻度;纵轴是概率密度。分布集中在一千条附近,正文说大多数用户超过 1,000 条,没有给出精确百分数。6.92×10^8 条除以 70 万用户,平均约 989 条/人。来源:原论文 Fig. 1。
基站的覆盖面积很难直接量。论文用基站位置画泰森多边形(Voronoi cell):一个点归给离它最近的基站,该多边形的面积当作这小时的覆盖面积。用户密度等于这一小时的接入用户数除以这块面积,单位是人/平方公里。人均需求等于这一小时的字节数除以接入用户数。流量密度等于二者相乘,单位是字节/平方公里。31 天有 744 个小时,因为 24×31=744。
这套面积是几何近似。正文指出,多层网络里泰森多边形的边界会偏,模型按 3G 单层网络来做。可靠性讨论写在在线附录 A,正文没有另给一组实测覆盖面积作对照。
基站有多密,和用户有多密,是两个密度。表 1 量的是基站。
| 城市 | 相邻基站距离均值 | 距离偏差 | 全市基站密度 | 市中心基站密度 |
|---|---|---|---|---|
| 上海 | 0.88 km | 1.20 km | 0.65 个/km² | 17.65 个/km² |
| 昆明 | 0.98 km | 0.70 km | 0.12 个/km² | 7.90 个/km² |
上海市中心的基站密度是全市的 17.65÷0.65=27.2 倍。表中的偏差一列没有说明是标准差还是别的离差,这里只保留原表口径。后面的用户密度中位数约 300 人/平方公里,分母是人和面积,不能和这张表的“基站个数/平方公里”比大小。
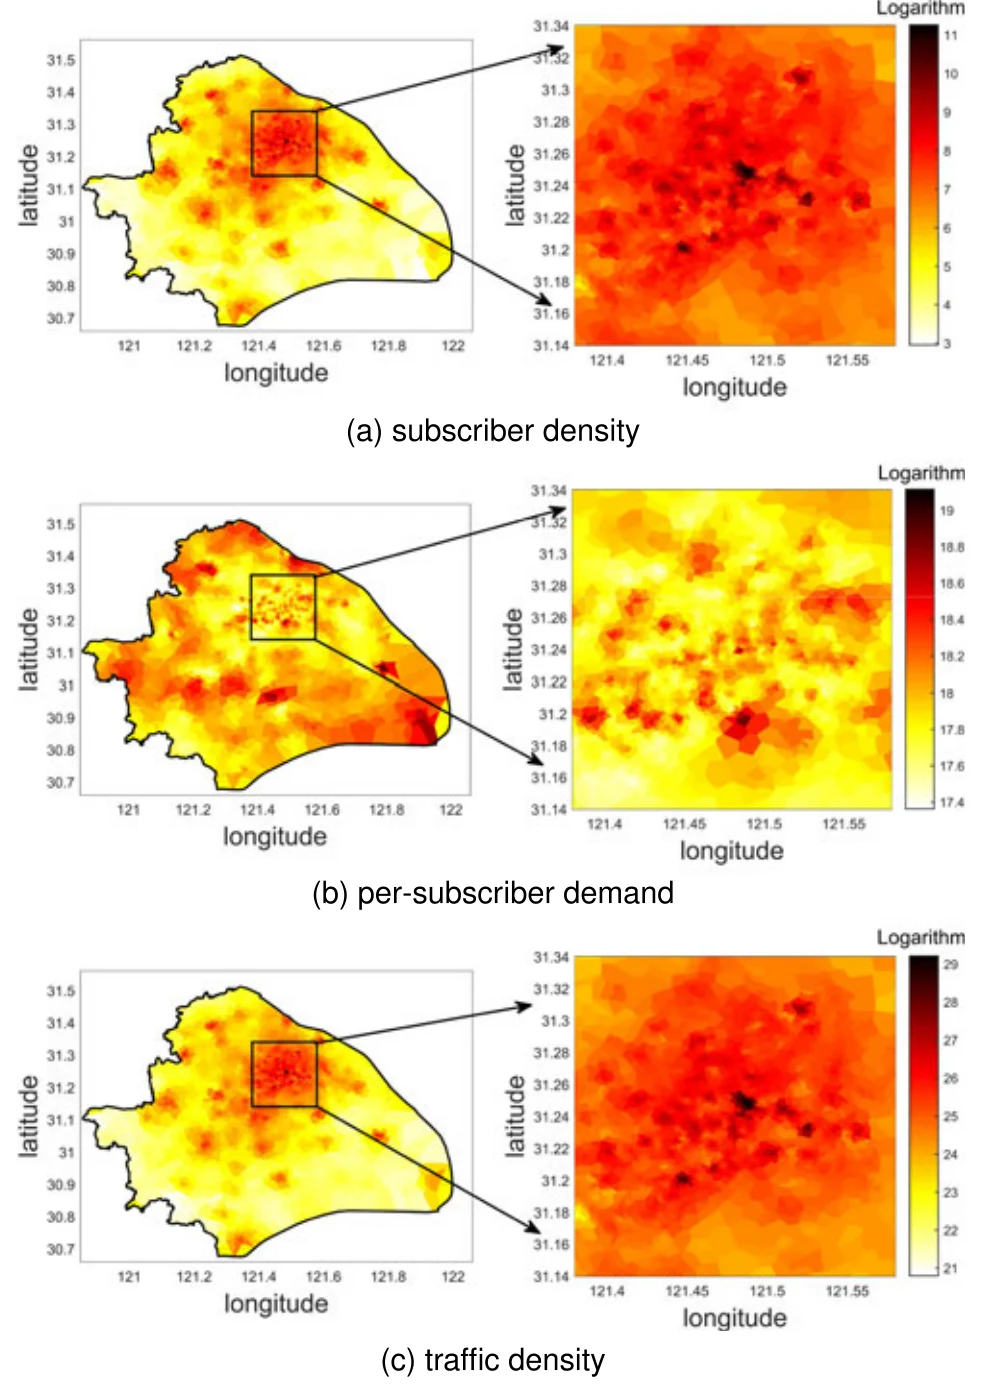
图 2|人数、每人用多少、总流量,在上海地图上各长什么样?
三行都是一个月的平均值,颜色是对数。左图是全市,右图放大市中心一小块;经纬度落在上海,正文没有给这块放大区域命名。
(a)用户密度。市中心一块明显更深,外围更浅。色标大约从 3 画到 11,高于正文所说的最高约 10^4 人/平方公里,色标上限不等于观测最大值。(b)人均需求。色标大约从 17.4 到 19,正文对应每月约 36 到 180 MB。深色从市中心一直铺到外围,和(a)的单中心不一样。(c)流量密度。深色再次集中在市中心,空间形态更接近(a)。来源:原论文 Fig. 2。
三个量之间的相关系数把这种眼缘变成了数字。流量密度和用户密度的相关大于 0.9。人均需求与用户密度、与流量密度的相关系数绝对值都小于 0.1。论文没有给出更细的小数,也没有写明是哪一种相关系数。相关大于 0.9 说明流量的空间起伏大部分跟着人数走;绝对值小于 0.1 说明每人用多少几乎不随人数同步升降。这是基站层面的同时变化,不是“多来一个人导致每个人少用一点”的因果。
图 2 的 36 到 180 MB 是一个月的人均量。后面的分布拟合改到每一小时,两个时间尺度不能直接除成同一个“典型小时”。
三个对数正态叠起来,基站之间差在哪一档?
既有研究已经用对数正态混合拟合过小区流量密度。这篇论文追问的是,混合从哪两个因素来。它先分别拟合每小时的用户密度和人均需求,再看乘积。
对数正态混合是若干个对数正态按权重相加,权重合计为 1。每个成分有位置参数 μ 和尺度参数 σ。取了三个成分,用期望最大化估计参数。选择三个,是正文所说的精度和复杂度折中,不是检验出来的唯一成分数。
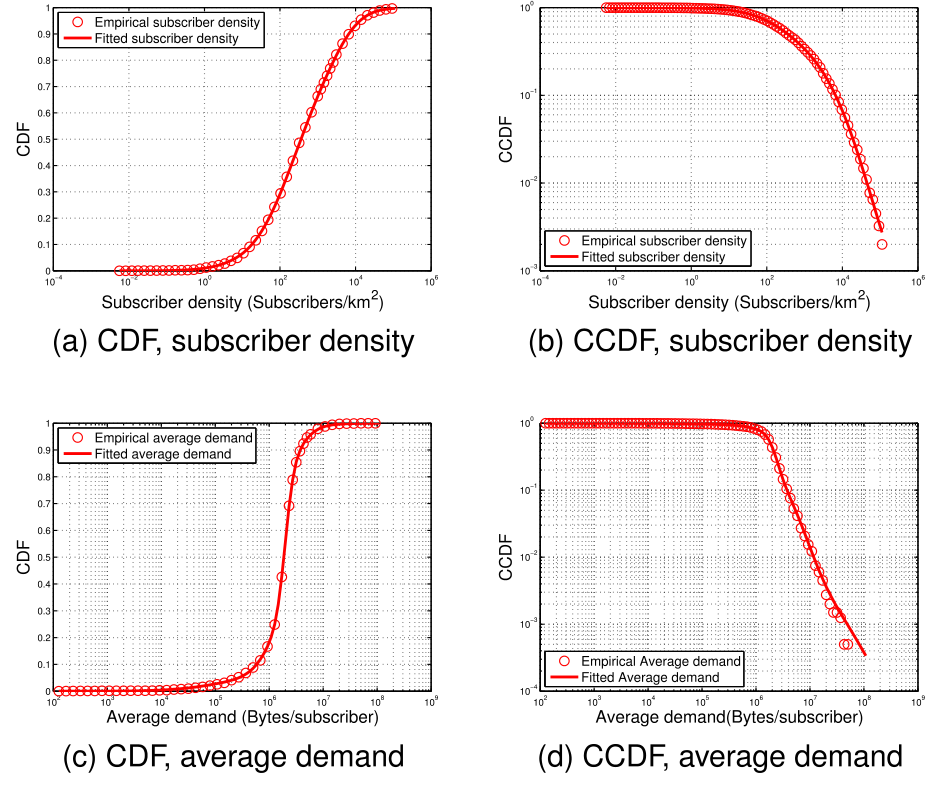
图 3|上海每小时的用户密度和人均需求,三条对数正态够不够贴住?
红圈是经验分布,红线是三成分拟合。横轴都是对数刻度。
(a)用户密度的累积分布,纵轴从 0 到 1。曲线在每平方公里大约数十人之前几乎贴着 0,然后在 10^2 到 10^4 之间爬升。(b)同一指标的互补累积分布,纵轴从 1 降到 10^-4,用来看右尾。拟合线跟着经验点走到 10^4 以上。(c)人均需求的累积分布,单位是字节/用户。上升集中在 10^6 字节附近,也就是约 1 MB 这一档。(d)人均需求的互补累积分布。右尾降到 10^-4 时,拟合仍贴着经验点。来源:原论文 Fig. 3。
正文给出的中位数约每平方公里 300 人,最高约 10^4 人。表 2 的位置参数取 e^μ 之后,用户密度三个成分中心约是 165、224 和 3,714 人/平方公里,对应 μ 为 5.1033、5.4094 和 8.2199。人均需求三个中心约是 0.36、1.76 和 1.98 MB/用户·小时,与正文写的 {0.36, 1.76, 1.98} 一致;这里的 MB 按 10^6 字节理解,因为 e^14.5001÷10^6≈1.98。
正文另把用户密度中心写成 {164, 221, 4,447}。164 接近 e^5.1033,221 与 e^5.4094≈223.5 只差约 2.5,4,447 则对不上 e^8.2199≈3,714。后文引用成分中心时用表 2。4,447 留在正文原句里,不把它当成已经由表算出的结果。
权重也说明成分叠在一起。用户密度上,两个低中心的权重是 0.4075 和 0.3950,合计 0.8025;高中心权重 0.1975。低中心的 σ 分别是 1.5761 和 2.6085,散布很宽,所以中位数约 300 可以高于 165 和 224 这两个中心。人均需求上,1.76 MB 和 1.98 MB 的权重合计 0.4543+0.4457=0.9000,0.36 MB 的权重是 0.1000。权重是重叠成分的混合比例,不是互不重叠的基站份额。
K-S 检验在 5% 显著性水平下,对一天中每个小时的拟合都没有拒绝对数正态混合。检验统计量和具体 p 值没有印在正文里。“没有拒绝”只说明这组数据和这个分布不冲突,并不证明它是唯一能拟合的分布。
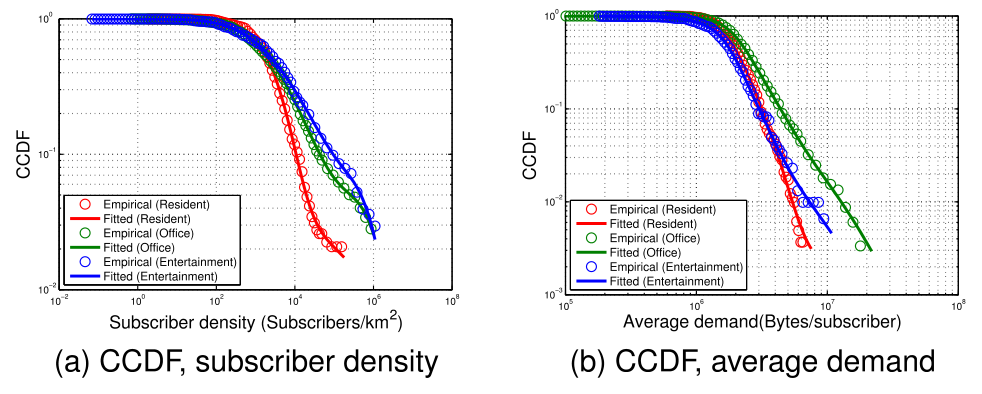
图 4|居住、办公、娱乐三个功能区,还是同一类分布吗?
只画了互补累积分布,红为居住、绿为办公、蓝为娱乐。交通区和综合区没有出现在这张图里。
(a)用户密度。居住区的尾巴下降更快,办公和娱乐在高密度一端留有更高的比例。(b)人均需求。办公区的右尾更长,同样的高需求水平上,办公区剩下的比例高于居住区。三条线都能被各自的三成分混合跟上。正文没有按功能区分列 K-S 统计量。来源:原论文 Fig. 4。
两个量还可以放进一个联合分布。表 3 用三个二维成分:权重 0.60、0.33、0.07。第二个成分的位置是(7.70,14.43),e^7.70≈2,208 人/平方公里,e^14.43÷10^6≈1.85 MB/用户·小时。这就是正文说的“接近 2,200 人、每小时接近 2 MB”。第一个成分的用户密度中心 e^4.74≈114 人/平方公里。第三个成分的需求中心 e^12.93÷10^6≈0.41 MB/用户·小时,权重只有 0.07;它的用户密度中心 e^1.59≈4.9 人/平方公里,尺度很大,不宜看成一团挤在 5 人附近的基站。
因为人均需求和用户密度的相关很弱,正文假定二者独立,于是乘积仍是对数正态混合,成分数是 3×3=9。命题 1 写在正文:两个独立的对数正态混合相乘,第 i 个和第 j 个成分的权重相乘,对数均值相加,对数方差相加。证明放在在线附录 B。这里的“独立”是相关绝对值小于 0.1 之后采用的模型假设。表 3 的联合成分本身带有非零协方差,后面的生成模型改用二维混合,就是为了把这点相关留住。弱相关支持“乘积大致可拆”,并不表示协方差在每个成分里都是 0。
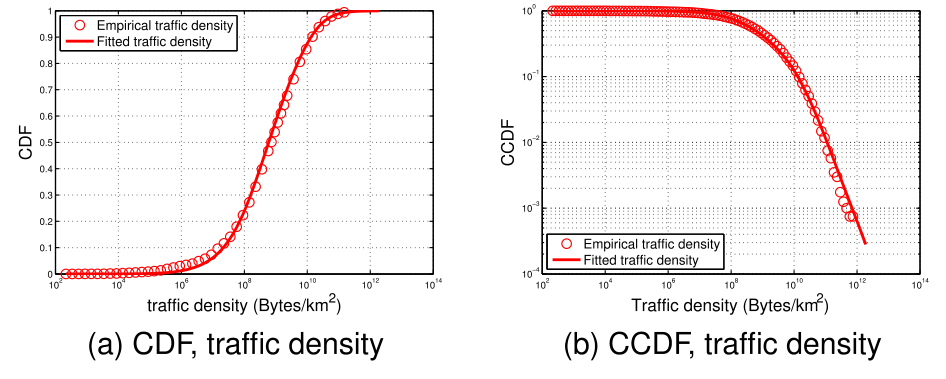
图 5|流量密度的九成分曲线,是算出来的还是重新拟合的?
圆点是上海每小时流量密度的经验分布,实线是用命题 1 和表 2 的参数算出的九成分混合,不是对流量密度单独再估一套参数。
(a)累积分布。中位数在 10^9 字节/(小时·平方公里)附近,与正文一致;曲线在 10^8 到 10^11 之间完成大部分上升。(b)互补累积分布。右尾延伸到 10^12 以上,正文说最高约 10^12。5% 水平的 K-S 检验同样没有拒绝这条算出的分布。来源:原论文 Fig. 5。
表 4 的九个权重从 0.1851 降到 0.0198,合计约 1。最大的四个成分权重合计 0.7223,位置参数在 19.49 到 19.91。e^19.8 约是 4×10^8 字节/(小时·平方公里),低于经验中位数 10^9,因为右尾把中位数往上推。成分中心和样本中位数回答的是不同的问题。
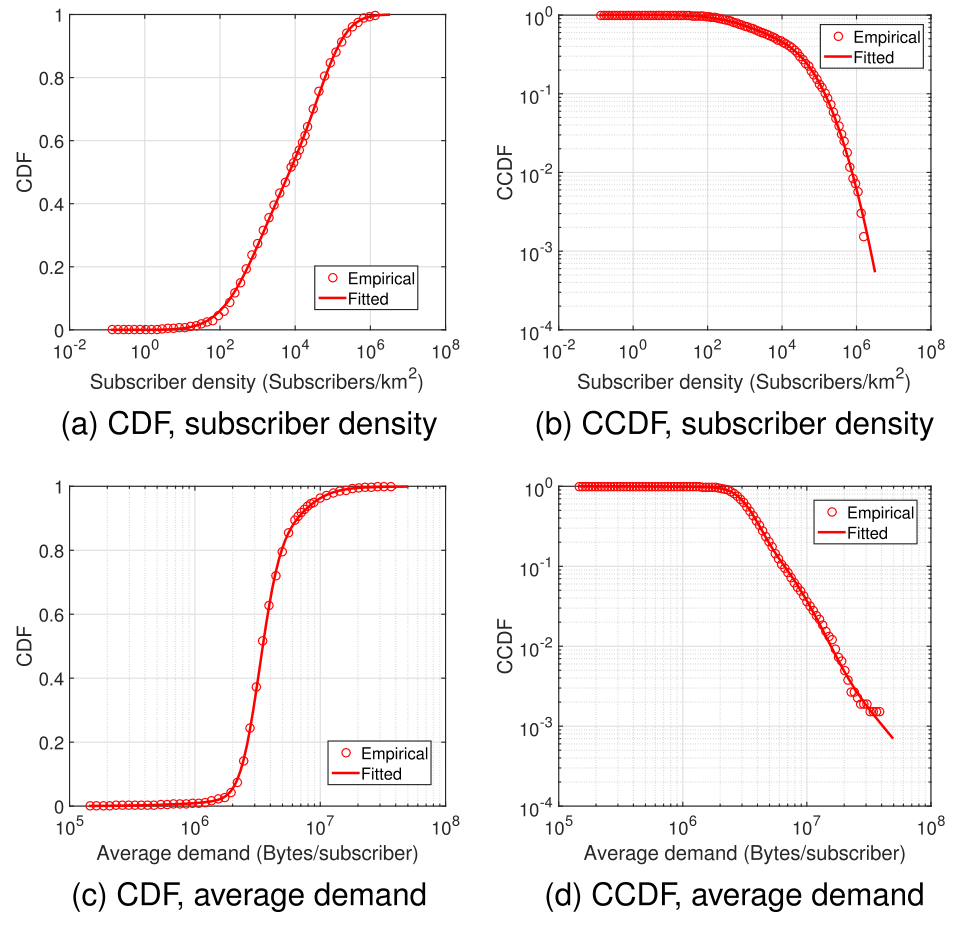
图 6|换到昆明,对数正态混合还成立吗?
红圈对红线仍贴合。参数和上海不同,图里没有印出昆明的 μ、σ 和权重。
(a)(b)是用户密度的累积分布和互补累积分布。横轴从 10^-2 画到 10^8 人/平方公里,上升主要发生在 10^2 到 10^5。(c)(d)是人均需求,单位字节/用户,累积曲线在 10^6 到 10^7 字节之间变陡。来源:原论文 Fig. 6。
正文给出一个跨城的范围比较:用户密度落在每平方公里 1 到 10^4 人之间的,上海约 90%,昆明约 60%。分母是各自城市的用户密度取值,不是基站个数的同一张表。5% 水平的 K-S 检验对昆明这两个分布在每个小时也都没有拒绝。分布族可以沿用,具体参数要按城市重估。
高峰上的六个类型,分的是人数和每人用多少
分布说明基站之间差得很开。要做生成模型,还得知道差开之后有哪几档。聚类用的不是全部 744 个小时,而是各功能区的高峰小时。
功能区来自作者此前的流量形态聚类,分成居住、交通、办公、娱乐和综合。本文直接使用这些标签,没有在正文里重做分类。一个功能区的高峰小时,定义成该区平均流量密度超过自身峰值 50% 的那些小时。每个基站再在自己的高峰小时上,对用户密度和人均需求取平均。
两个轴的单位不同,正文没有先规定一个二维距离,而是分两轮做层次聚类,联结方式是类间平均距离。第一轮只按用户密度,分成低、高两类,最大轮廓系数 0.50。第二轮在每一类内部只按人均需求,各分成低、中、高三档,最大轮廓系数 0.55 和 0.52。轮廓系数的范围是 −1 到 1,0.5 上下表示分开了,离“类内很紧、类间很远”还有距离。阈值怎么扫描,写在在线附录 C。Calinski–Harabasz 和 Davies–Bouldin 两个指标也选出 6 类,正文没有列出这两个指标的数值。一次同时用两个轴聚类的对照同样在附录 C,正文没有给出那次对照的误差。
合并两轮之后是六类:稀疏低需求 SL、稀疏中需求 SM、稀疏高需求 SH、密集低需求 DL、密集中需求 DM、密集高需求 DH。稀疏指高峰用户密度低于每平方公里 4,100 人。低需求指低于每小时 1.5 MB,中需求和高需求的分界约每小时 4 MB。
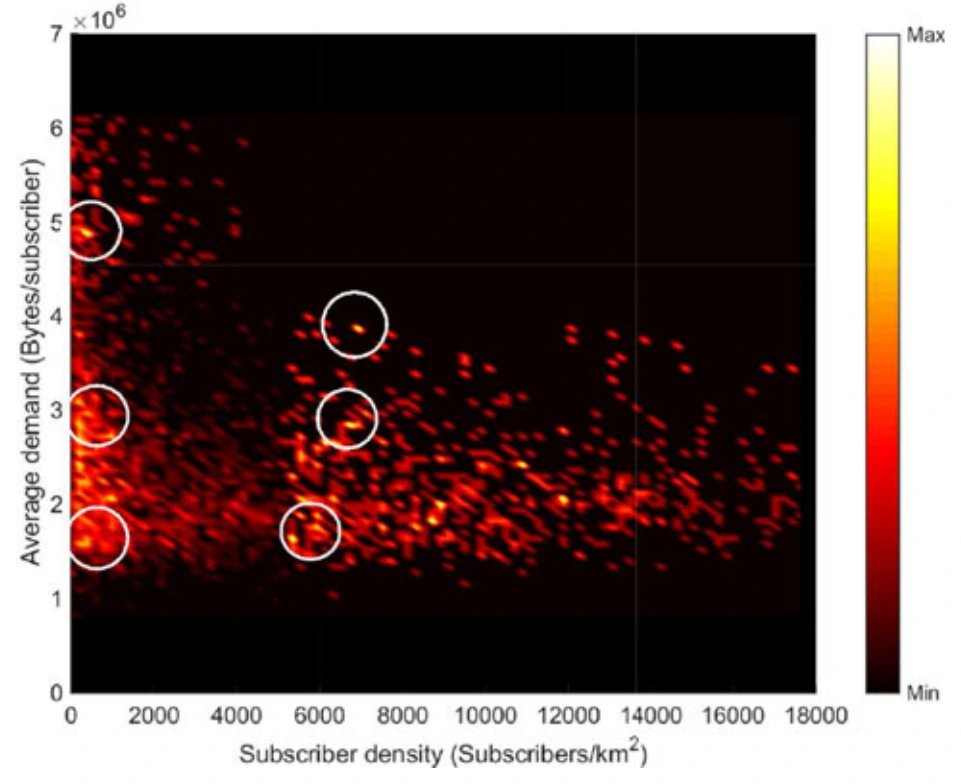
图 7|六类中心落在人数–需求平面的哪里?
无字母子图。横轴是用户密度,人/平方公里;纵轴是人均需求,字节/用户,上方标着 7×10^6,所以刻度 2 约是 2×10^6 字节,也就是约 2 MB。颜色从深色到亮黄,表示该小格里的基站样本由少到多。白圈是六类中心:左侧大约在一两千人的位置上有三团,右侧大约在 6,000 到 7,000 人的位置上有三团。中心位置和“稀疏低于 4,100 人”这条边界不是同一个数。正文还提到(9000,2)附近有一块偏亮的区域,并说若有更多基站超过每平方公里 10,000 人,那里可能再分出一类。来源:原论文 Fig. 7。
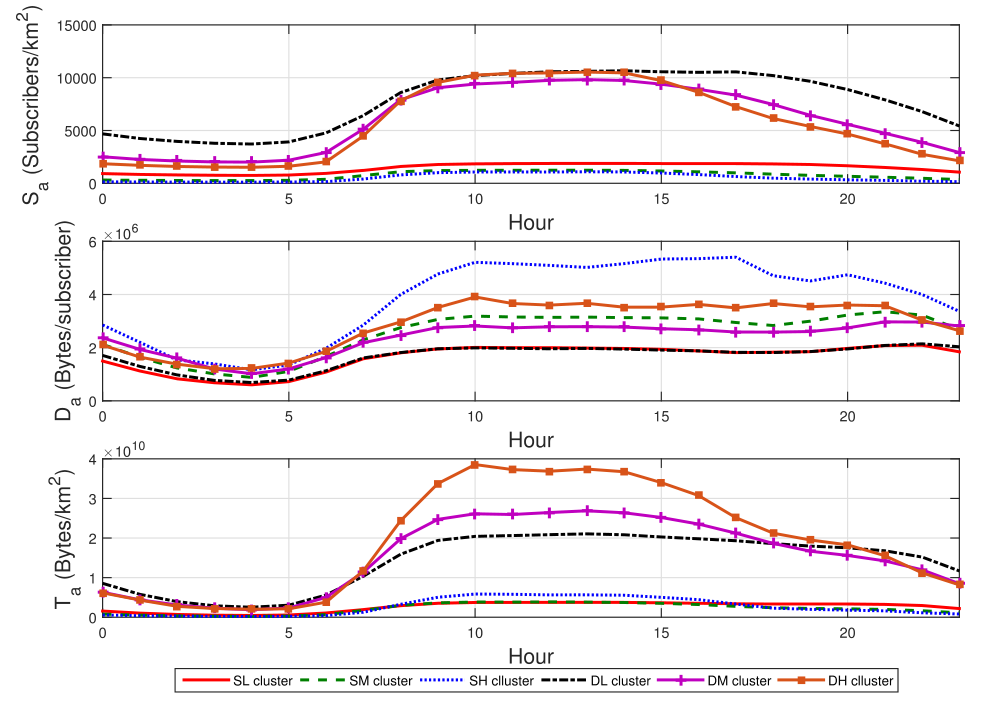
图 8|上海六类在一天 24 小时里怎样升降?
无字母子图,上中下三行分别是类内平均的用户密度、人均需求和流量密度。图例:SL 红实线,SM 绿虚线,SH 蓝点线,DL 黑虚线,DM 紫线,DH 橙线。横轴是小时,0 到 23。
上图的三条密集类在大约 10 时到 15 时升到约 10,000 人/平方公里,纵轴画到 15,000。三条稀疏类留在低位,其中蓝点线的 SH 最低。中图里 SH 的人均需求白天升到约 5×10^6 字节/用户,约 5 MB/小时,高于约 4 MB 的中高分界;DH 大约在 4×10^6。这些曲线到了晚上仍维持在较高位置,不像用户密度那样在日落后明显回落。下图的流量密度由 DH 在大约 10 时到 14 时形成接近 4×10^10 字节/平方公里的高台,DM、DL 次之,稀疏三类贴近底部。来源:原论文 Fig. 8。
正文写上海的流量高峰大约出现在 12AM,昆明则出现在夜间。图 8 的高台落在白天中段,不落在 0 时。若把 12AM 理解成午夜,就和图上的小时对不上。下面按图的小时轴说,正文原句仍保留为作者的概括。
用户密度白天高、夜里低,人均需求升高后要到午夜前后才下来。于是夜里人数已经减少,每个还在线的用户仍消耗不少字节。流量密度是二者的乘积,它的回落会慢于人数的回落。这是类内平均曲线,不是每个基站都重复同一条轨迹。
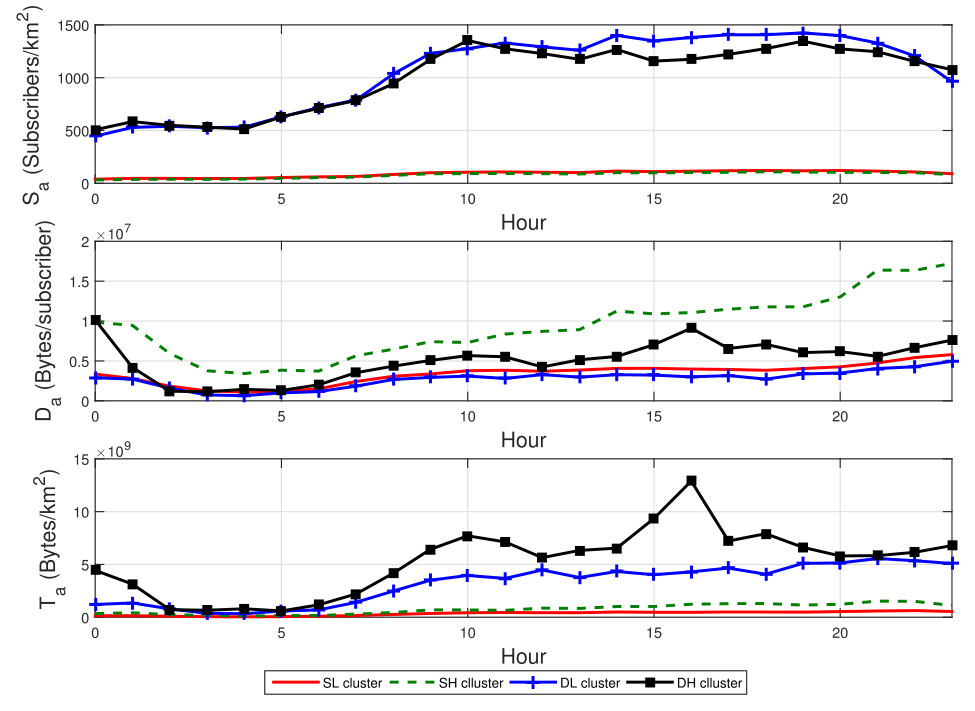
图 9|昆明为什么只有四类,高峰又落在什么时候?
无字母子图。图例只有 SL 红实线、SH 绿虚线、DL 蓝线、DH 黑线,没有中需求的 SM 和 DM。
上图的密集两类从夜间约 500 人/平方公里升到白天约 1,400 到 1,500,并维持到傍晚;稀疏两类贴近底部。这与正文“昆明约 1,500、上海约 10,000”一致,分母都是类内平均的人/平方公里。中图的 SH 从清晨的低点一路升到一天的末尾,纵轴画到 2×10^7 字节/用户,明显高于另外三类。下图的 DH 在 16 时附近出现一个尖峰,DL 白天维持在较低的平台,SL 和 SH 的流量密度贴近底部。尖峰在 16 时,SH 的人均需求高点在一天后段。正文用“夜间”概括昆明高峰,图上可以同时看到傍晚的流量尖峰和后半夜仍在上升的人均需求。来源:原论文 Fig. 9。
类型个数不能从上海搬到昆明。能搬的是“先按人数分,再按每人需求分”这套做法。昆明密集类的人数大约只有上海密集类的 1,500/10,000。把上海的 4,100 人直接当作昆明的稀疏界限,会把当地的密集基站划进稀疏。
功能区和类型的交叉计数合计 2,671 个基站。摘要说约 9,000 个基站里存在六种基本能力形态,原始上海记录是 9,181 个基站。正文没有说明 9,181 与 2,671 的差额来自哪一步筛选。下面的比例一律以表中的 2,671 为分母。
| 功能区 | SL | SM | SH | DL | DM | DH | 合计 |
|---|---|---|---|---|---|---|---|
| 居住 | 381 | 40 | 3 | 106 | 3 | 1 | 534 |
| 交通 | 9 | 46 | 1 | 1 | 9 | 1 | 67 |
| 办公 | 481 | 340 | 103 | 145 | 85 | 23 | 1,177 |
| 娱乐 | 82 | 48 | 11 | 45 | 18 | 4 | 208 |
| 综合 | 359 | 109 | 13 | 170 | 30 | 4 | 685 |
| 合计 | 1,312 | 583 | 131 | 467 | 145 | 33 | 2,671 |
SL 有 1,312/2,671=49.1%,接近正文说的几乎一半。DH 只有 33/2,671=1.2%。办公区占 1,177/2,671=44.1%,交通区只有 67 个基站。
表 6 是每个功能区内部的类型份额,一行加总为 100%。居住区里 SL 占 381/534=71.3%。交通区里 SM 占 46/67=68.7%,这是六类里唯一由中需求稀疏类占多数的功能区;分母只有 67,少几个基站,百分比就会动。娱乐区里 SL 仍是 82/208=39.4%,DL 是 45/208=21.6%。所以“娱乐区人更密”不能读成“娱乐区大多数基站属于密集类”。
另一套相对比例先问:某一类基站有多大比例落在这个功能区,再在该功能区的六个“类占比”之间重新归一。它扣掉了“SL 本来就占一半”这件事实。办公区的 SH 相对比例最高。算法很具体:SH 共 131 个,其中 103 个在办公区,103/131=78.6%;这 78.6% 再和办公区在其他五类里的占比一起归一,得到表 7 的 23.61%。同一 103 个基站只占办公区 1,177 个基站的 8.75%。两句都对,问的问题不同。前一句是“高需求且人少的基站大多部署在办公区”,后一句是“办公区内部仍以 SL 和 SM 居多,481+340=821 个,占 821/1,177=69.8%”。
按这套相对比例,办公区更偏向 SH,其次是 DH;娱乐区更偏向 DL,其次是 DH;综合区更偏向 DM,其次是 SL。这些是扣除类型基数之后的偏向。功能区内部的人头份额仍以表 6 和上面的计数为准。
只给功能区比例,合成基站能像到哪一步?
生成模型要同时凑对两件事:每一类有多少个基站,以及这一类在 24 小时里的两个能力数长什么样。输入是五个功能区的基站比例。某一类的比例,等于各功能区比例乘上该功能区里这一类的份额,再对五个功能区求和。份额用的就是表 6。
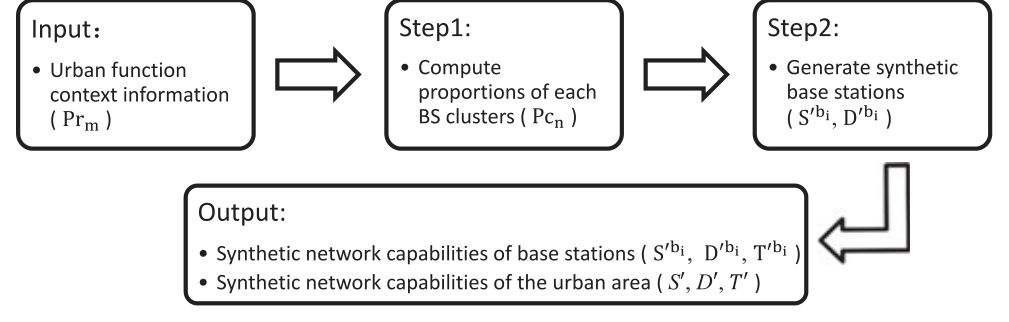
图 10|模型从功能区比例走到合成基站,中间经过什么?
无字母子图,是流程图。输入是功能区比例。第一步算出六类基站的比例。第二步按类生成合成基站的用户密度和人均需求。输出有两层:每个合成基站的三个能力数,以及全城合计的三个能力数。流量密度由前两个数相乘得到。图本身没有误差。来源:原论文 Fig. 10。
一天的曲线先对 31 天的同一小时取平均。再把 24 小时切成三段,阈值和前面的高峰定义不同:用户密度用该类平均曲线最大值的 80%,人均需求用最大值的 60%。两人都低于阈值的小时是空闲,两人都高于阈值的是繁忙。用户密度已经低于阈值、人均需求仍高于阈值的是拖尾。第四种组合在数据里没有出现,因为人均需求高于阈值的时段盖住了用户密度高于阈值的时段。拖尾正好对应图 8 里“人已经少了、每人仍用得不少”的那些小时。
每一类、每一段用二维对数正态混合同时拟合两个数,以便留下它们的相关。合成时,每个小时先按该段的分布抽出许多对(用户密度,人均需求),乘出流量密度,再按流量密度排序。24 个小时都排好后,把同一名次连成一个合成基站。这样做是为了让能力高的合成基站在各小时都偏高。它构造的是排序上的时间相关,不是把一座真实基站的地址或一天里的偶然起伏复制下来。
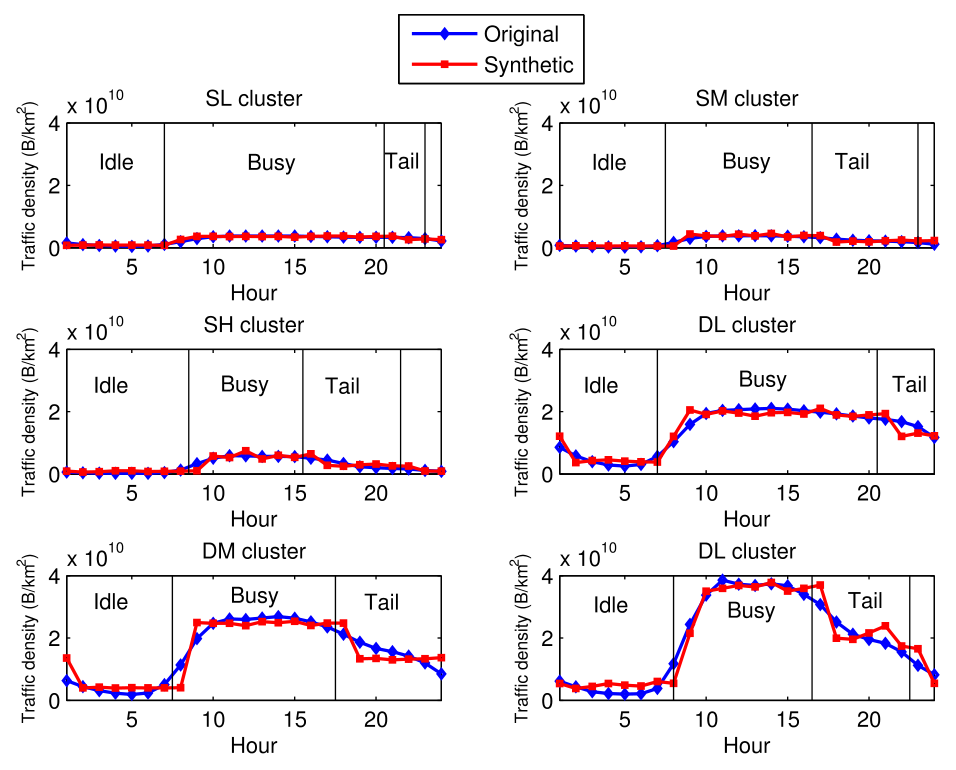
图 11|分类之后,每类的平均流量密度曲线贴得住吗?
无字母子图,六个面板共用纵轴数量级 10^10 字节/平方公里。蓝线是原始类内平均,红线是合成。竖线把一天分成空闲、繁忙、拖尾。每一类各生成 10,000 个合成基站来画这些平均曲线。
左上 SL、右上 SM、左中 SH 在这个纵轴上几乎贴着 0,红蓝都如此。右中标题为 DL,繁忙段升到约 2×10^10。左下 DM 的繁忙段大约在 2×10^10 到 3×10^10。右下标题再次印成 DL,繁忙段接近 4×10^10,和上海日变化里密集高需求类的量级同一档。六个印刷标题里没有 DH。阅读时保留图上的标题,不用另一张图的曲线去改写它。来源:原论文 Fig. 11。
平均曲线像,还要看分布像不像。论文用巴氏距离比较两个分布,距离为 0 表示两个分布相同。参照物是 31 天平均后的流量密度分布。合成日到这个平均的距离,去和 8 月每一天到这个平均的距离比。6 类、3 个时段、31 天,一共 558 组比较。合成日更近的比例超过 0.95。正文没有给出 0.95 之后的更多小数。
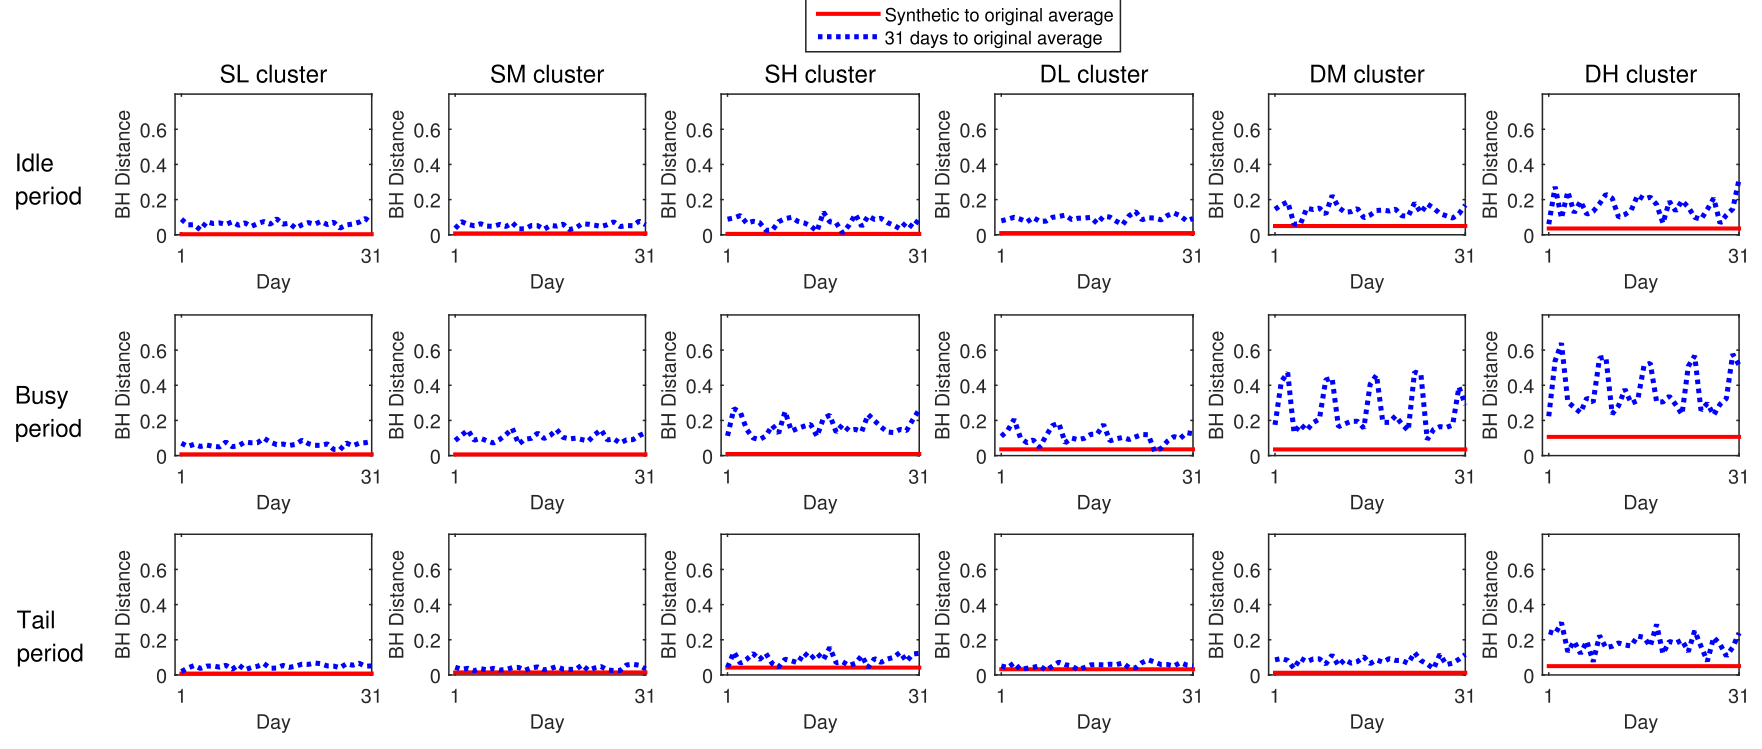
图 12|合成分布比“随便拿一天”更接近月均吗?
18 个面板没有另加字母。行是空闲、繁忙、拖尾,列从左到右是 SL、SM、SH、DL、DM、DH。纵轴是巴氏距离,大约画到 0.6;横轴是 8 月的 31 天。红线是合成日相对月均的距离,蓝点是每一天相对月均的距离。
SL、SM、SH 三列的蓝点大多低于 0.2,红线更低。繁忙行的 DM、DH 两列,蓝点可以升到 0.4 甚至 0.6 附近,红线仍留在大约 0.1。红线低于多数蓝点,和“558 组里超过 95%”一致;繁忙且密集的类型,单日之间的起伏本来就更大。距离小表示分布接近月均,不是每个基站、每个小时的字节数都预测对了。来源:原论文 Fig. 12。
全城曲线是另一层检验。输入表 8 的功能区比例:居住 17.55%,交通 2.58%,办公 45.72%,娱乐 9.35%,综合 24.81%,合计 100.01%,应是四舍五入。这些百分比和表 5 的行合计对不上。表 5 里居住是 534/2,671=20.0%,办公是 44.1%,娱乐是 7.8%。表 8 没有给出对应的基站个数。模型评价使用的是表 8 印刷的比例,不能反推成表 5 的 2,671。
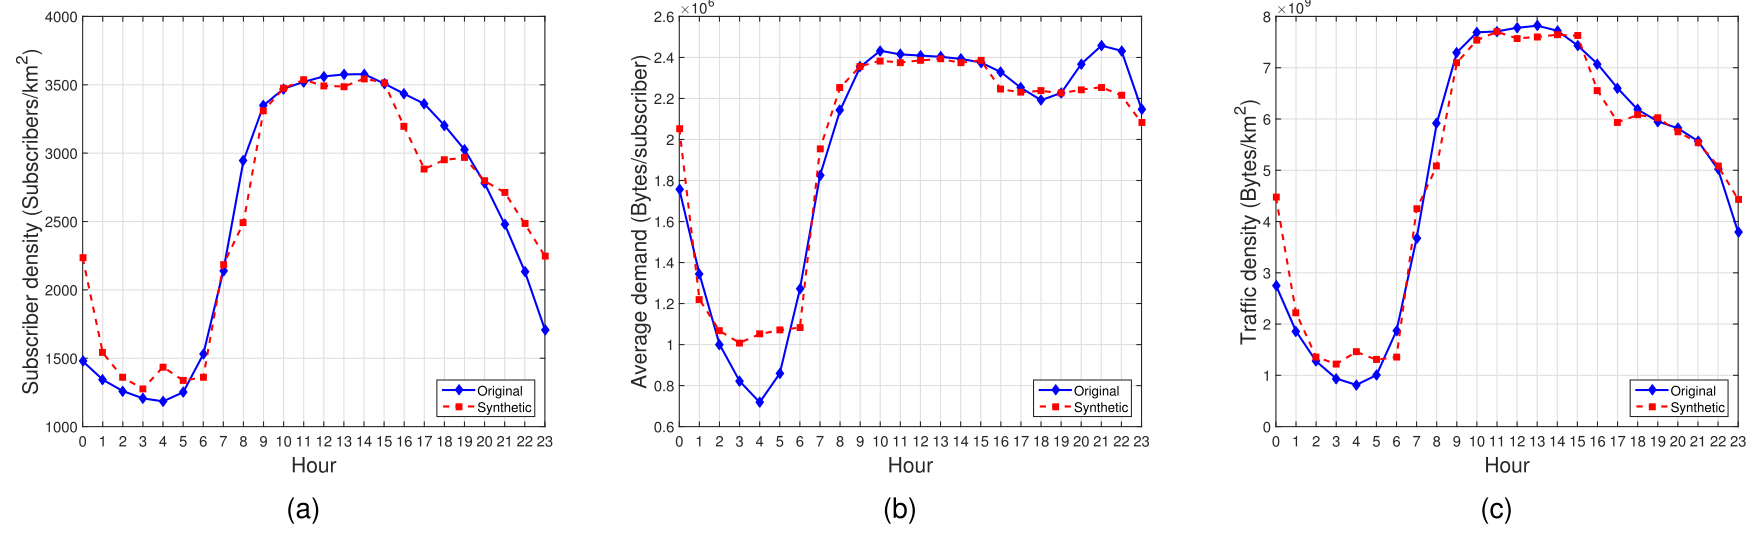
图 13|把所有基站平均起来,一天的三条曲线还像吗?
蓝实线是原始基站集合的全城平均,红虚线是合成集合。这是基站之间的平均,所以用户密度会远低于图 8 里密集类的约 10,000。
(a)用户密度,人/平方公里。原始曲线夜间降到约 1,200,白天约 10 时到 15 时停在 3,500 上下,然后下降。合成曲线整体跟上,17 时前后掉得更深,深夜又高于原始曲线。(b)人均需求,字节/用户。两者都在清晨降到约 10^6 字节以下,上午升到约 2.3×10^6。原始曲线在 20 时到 21 时还有一处回升,合成曲线这段更平。(c)流量密度,字节/平方公里。夜间约 10^9,白天高台约 8×10^9,红线和蓝线最接近。来源:原论文 Fig. 13。
个体误差的算法写在正文里:合成基站已经按能力排序,原始基站也按同样方式排序后再一对一对齐。比的是“从高到低排好的能力曲线是否接近”,不是“地图上这座基站和它的合成替身”。归一化时,三个指标都除以各自原始数据的最大值。因此 0.07 量级的 RMSE 是相对最大值的偏差,不是相对均值的百分比,小基站上的相对误差可以大得多。
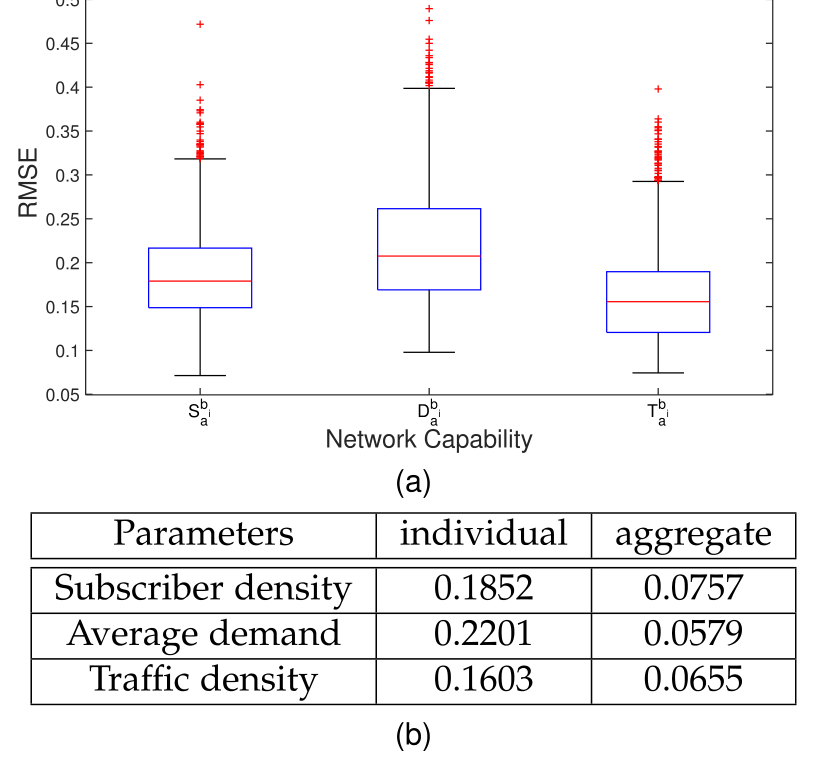
图 14|排序对齐之后,单个基站的误差有多大?
(a)箱线图。三列是归一化后的用户密度、人均需求和流量密度。箱体大约落在 0.12 到 0.26,中位线约 0.16 到 0.21,上方有延伸到 0.4 甚至 0.5 的离群点。正文给出下四分位数:三个指标分别有 25% 的基站,RMSE 低于 0.1487、0.1690 和 0.1205。分母是排序对齐后的基站,不是全城平均那一条曲线。(b)均值表。个体均值是 0.1852、0.2201、0.1603,聚合均值是 0.0757、0.0579、0.0655。三个聚合值的平均是 0.0664,三个个体值的平均是 0.1885。引言里的“聚合约 7%、个体约 19%”与这两个平均数对应。来源:原论文 Fig. 14。
分类有没有用,要和不分类比。对照模型把所有基站的样本放进同一个分布,不再按六类分别拟合。
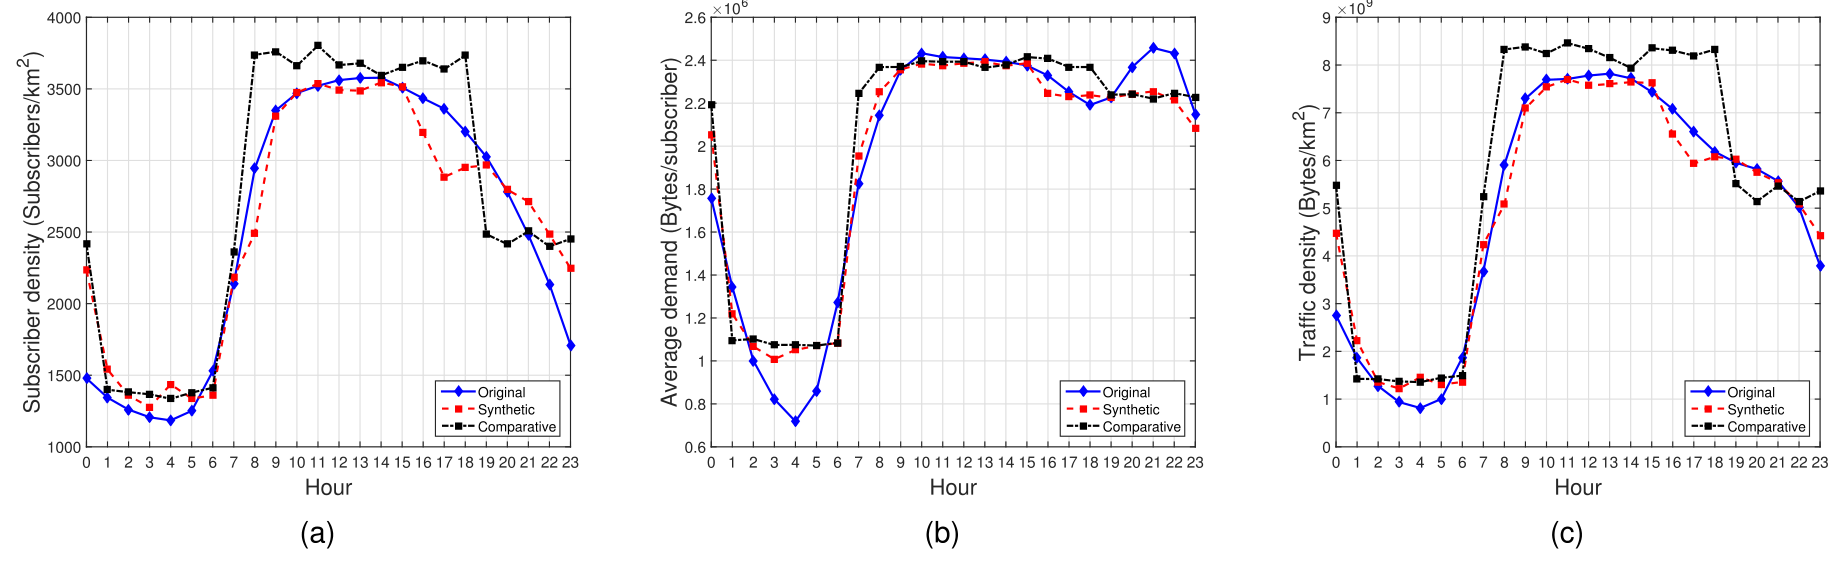
图 15|不分类时,全城平均曲线偏在哪里?
蓝实线是原始全城平均,红虚线是分类后的合成,黑色点划线是不分类对照。纵轴与图 13 同一组量。
(a)不分类的用户密度在大约 9 时到 17 时停在 3,700 上下,高于原始曲线的白天高台,18 时前后又掉得更陡。(b)不分类的人均需求在清晨没有降到原始曲线大约 0.8×10^6 字节的低谷,下午也保持更高。(c)不分类的流量密度白天抬到约 8×10^9 以上,并在下午保持平台,原始曲线则从大约 14 时开始下降。来源:原论文 Fig. 15。
表 9 把这三张图收成归一化 RMSE。分类模型相对不分类模型的下降幅度,分母是不分类模型自己的 RMSE。
| 指标 | 分类模型 | 不分类模型 | 下降 |
|---|---|---|---|
| 用户密度 | 0.0757 | 0.1176 | 35.6% |
| 人均需求 | 0.0579 | 0.0838 | 30.9% |
| 流量密度 | 0.0655 | 0.1528 | 57.1% |
(0.1528-0.0655)÷0.1528=57.1%。引言里的 57% 指的是流量密度这一行,不是三行的平均。35.6% 和 30.9% 同样可以由表内两列相减再除以对照列得到。分类带来的增益,主要是少把下午的全城流量密度抬高。
这些数可以带到下一座城市的哪一层
误差数字来自上海同一批 2014 年 8 月的数据:分布在这批数据上估计,合成样本再和这批数据比。昆明检验的是对数正态混合还能不能拟合、聚类流程还能不能跑完,以及密集类的人数大约差一个数量级。昆明没有做表 9 那种 RMSE。因此“降低 57.1%”是上海样本内、相对于不分类模型的拟合改进。
个体层面的 19% 发生在按能力排序对齐之后。它说明高能力曲线和低能力曲线的形状可以被分层分布复现。它没有回答某一座指定基站下一小时的字节数。功能区比例本身也是输入。表 8 和表 5 的功能区构成并不相同,模型评价走的是表 8。
人均需求是消耗字节除以用户数,用来近似用户体验到的数据速率。记录里没有无线电侧的瞬时速率,所以这个近似随“消耗了多少”变化,不随“信道当时给了多快”变化。连接密度在这里是每小时、每平方公里的接入用户数。引言引用的物联网场景“一个宏小区支持一万台低速率设备”,是文献里的需求设想,不是这套 3G 记录量到的并发连接数。图 7 里超过每平方公里 10,000 人的区域,只被描述成可能出现的新一类。
泰森多边形把最近基站的几何范围当成覆盖。单层 3G 下,正文用它计算密度;多层网络里,同一地点可能由不同层的基站服务,面积会被划错。附录 A 讨论了这一点,正文的模型没有改成多层覆盖。
独立性只用于解释流量密度为什么也是对数正态混合。生成步骤改用二维联合分布。两步的假设强度不同,不能用命题 1 的公式反过来宣称用户密度和人均需求在每个基站上都互不影响。
K-S 检验没有拒绝,是在 5% 水平上对每个小时分别做的。混合成分数固定为 3,流量密度的 9 个成分是相乘规则带出来的。换一个成分数,或者换一个同样灵活的分布,正文没有做系统比较。
一句话总结
一座城市的移动流量在空间上堆在哪里,主要由每平方公里有多少接入用户决定;每个用户用多少是另一张铺得更开的图,两类差别都算进去,基站能力才分得开。
核心来源
- IEEE Xplore 正式版本,IEEE Transactions on Mobile Computing,2018,17(5):1105–1118。本文图 1–15 与表 1–9 的数字都来自这一版本。
- 在线附录 A、B、C 由论文指向计算机学会数字图书馆上的同一 DOI。附录 A 讨论泰森多边形,附录 B 是命题 1 的证明,附录 C 是聚类阈值和一次聚类的对照。正文已经给出命题公式、轮廓系数 0.50、0.55、0.52,以及六类边界。
- 作者此前的会议版本见论文参考文献 [21]:Ding 等,IEEE MASS 2016。期刊版写明新增了另一座城市的数据,并补充了基站个体层面的检验。本文数字以 2018 年期刊版为准。
作者介绍
以下身份取自论文首页单位和末页作者说明,对应这篇 2018 年文章发表时的情况。
- Jingtao Ding:2015 年获清华大学电子工程学士,发表时在清华大学电子工程系攻读博士。作者说明中的研究方向为移动计算、移动数据挖掘和用户行为建模。
- Rui Xu:发表时在清华大学电子工程系攻读本科。作者说明中的研究方向为移动大数据挖掘和用户行为建模。
- Yong Li:本文通讯作者。2007 年获华中科技大学电子与信息工程学士,2012 年获清华大学电子工程博士,发表时在清华大学电子工程系任教,IEEE 高级会员。
- Pan Hui:香港大学电机电子工程学士与哲学硕士,剑桥大学计算机实验室博士。发表时任香港科技大学计算机科学及工程系教师、系统与媒体实验室负责人,同时任德国电信创新实验室杰出科学家和阿尔托大学兼职教授,IEEE 高级会员。
- Depeng Jin:1995 年、1999 年在清华大学分获电子工程学士和博士。发表时为清华大学副教授、电子工程系副主任,IEEE 会员。作者说明中的研究领域包括电信、高速网络和未来互联网体系结构。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
容量规划可以把两个高峰错开记账。人数的高峰在白天中段,每人需求的高位会留到人数已经下降的拖尾时段。若只在总流量最高的小时加资源,拖尾时段“人少但每人仍在传大文件”的压力会被总流量的回落掩盖。一个可检验的做法,是分别给每平方公里接入人数和每人每小时字节数设容量,再看拖尾时段哪一个先碰到上限。论文没有做这样的资源分配实验。
19% 的个体误差回答的是排序后的曲线像不像。若运营者想知道某条道路旁那座基站明天的负荷,还需要把类型放回地图坐标。现在的输入是功能区比例,而功能区又来自先前的流量形态。换用规划图纸上的用地分类之后,表 6 的份额是否还在,是另一项检验。如果份额变了,合成曲线会先在“每类有多少座基站”这一步就偏掉。
上海密集类约 10,000 人/平方公里、六类,昆明密集类约 1,500 人/平方公里、四类。全国模型若固定 4,100 人和 1.5 MB 这两条上海界限,中等城市的相对密集区会被划进稀疏。更值得保留的是测量本身:每小时、每平方公里的接入人数,以及每人消耗的字节。界限和类型个数可以在当地高峰小时上重估,再看对数正态混合是否仍不被拒绝。