常去的地点、重复的钟点和要见的人,现有模型为什么总是只写进一块?
论文名片|Dmytro Karamshuk、Chiara Boldrini、Marco Conti、Andrea Passarella,Human Mobility Models for Opportunistic Networks,IEEE Communications Magazine,2011年12月,第157–165页。栏目为 Topics in Ad Hoc and Sensor Networks。这是一篇人类移动模型综述,对照的是已发表的统计结果和模型设计。
工作日从家到办公室,傍晚再去见朋友,隔几周才插入一次更远的行程。这个日程只用来看机制,不是论文追踪的某一个人;综述自己也用家、办公室,以及学生在校园里从自习室转到体育馆,来说明什么叫有钟点的重复。人带着手机和类似设备走动时,两台设备进入彼此的无线电范围,才形成一次接触。机会网络(opportunistic networks,文中也称 OppNets)不假设发送端和接收端之间始终有一条连通路径,数据要等下一次这样的相遇再交出去。要在仿真或解析里看这种传递,得先有一个像日常出行的移动模型。
Karamshuk、Boldrini、Conti 和 Passarella 没有在这篇里测量新的轨迹。他们把文献中的规律收成空间、时间和连接三类统计,说明只靠访问频率还看不出顺序,再按地点偏好、日程和社交图给已有模型分类。方向是:日常移动同时带着短距居多的行程、按天返回的钟点,以及由社会关系拉动的目的地。表 1 里的模型各自覆盖其中一截。接触间隔的重尾,在不少模型里是这些机制跑出来的现象,公式里不必先指定一条接触间隔分布。
先说结论
- 综述转述的行程距离是重尾的。Brockmann 等把跳跃长度写成 P(Δr) ~ Δr 的 −(1+β) 次方,且 β 小于 2。Gonzalez 等加上指数截断,印刷的指数为 β = 1.75 ± 0.15,距离偏移 Δr₀ = 1.5 km;人群回转半径分布的指数 βᵣ = 1.65 ± 0.15,偏移 5.8 km,截断尺度 350 km。这些是分布参数,不是某一个人的典型里程。
- 返回时刻在 24、48、72 小时出现峰。停留时间用截断幂律近似,指数 β = 0.8 ± 0.1,截断落在 17 小时。一个人访问第 k 常去地点的频率近似齐夫定律,ζ ≈ 1.2 ± 0.1。
- 只用地点热门程度时,全人群的可预测性很低,而且人与人差得很大。把按时间排列的历史模式也算进去之后,潜在可预测性达到 93%,经常出远门的人和只在家附近活动的人差不多。93% 来自 Song 等,这篇综述没有印出人数分母,也没有给出一个可直接运行的预测器。
- 作者把重复模式分成时间上的周期、非周期和偶发,社会上的会面、结伴和独自出行,空间上的向心、环状和随机,并分开建筑、城市和全球三档尺度。
- 表 1 比较 12 个模型。城市尺度上 11 行打勾,全球尺度上只有 Sociological Orbit 打勾。接触间隔一列 9 个勾、3 个含糊。地点图、日程和社交图各补不同的列,没有一行把尺度和模式全部勾满。
这条链停在模型,后面才是传递过程
综述把目标画成四步。收集轨迹,分析出统计性质和模式,写成一个人的移动规则,再用这套规则去看动态过程。对机会网络来说,最后一步的例子是机会转发:消息在相遇时交给下一个人。图 1 把前三步的产物分别标成轨迹、关于移动的知识,以及移动模型。第四步没有再指向新的统计产物。
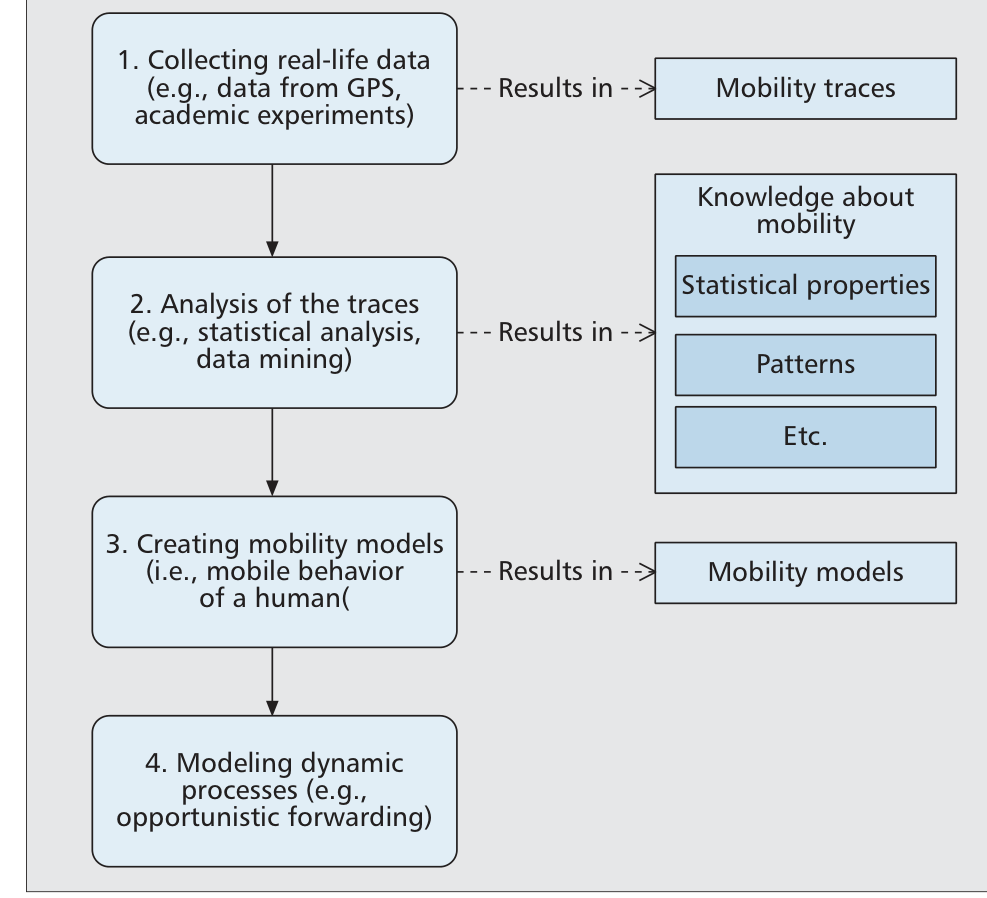
图 1|移动模型处在实测记录和动态过程之间的哪一步?
图中没有 (a)(b) 分栏。左侧四框依次是:收集实测数据,例如 GPS 和学术实验;分析轨迹,例如统计和数据挖掘;建立移动模型,也就是一个人的移动行为;用模型考察动态过程,框内例子是机会转发。右侧虚线箭头只从第一框指向移动轨迹,从第二框指向统计性质、模式等知识,从第三框指向移动模型。第三框原文印成 of a human(,右括号在图中没有闭合。来源:原论文 Fig. 1。
这里要先分开两类做法。轨迹驱动模型直接拟合某批轨迹里抽出的分布,模型和原轨迹的统计往往贴得很近,换一个环境是否还成立,综述认为并不清楚。合成模型则试图写下社会倾向、地点偏好和固定日程这些驱动力,轨迹用来检验。随机路点(random waypoint)、高斯–马尔可夫(Gauss-Markov)和随机方向(random direction)这一类模型被放在讨论之外,因为它们表现不出人类移动的那些典型性质。
尺度也决定模型要细到哪一步。若关心的是城市人群或道路上的微观移动,就要地图、静态障碍和动态障碍。若只关心人待在同一处时是否相遇,两地之间可以近似成匀速直线。综述把战场、疏散等场景放在一边,也不展开微观动作,只讨论日常的、有规律的人类移动。文中设想过 1000 个智能体在二维地图上各自走动,这是对多智能体仿真的说明,不是一次实验的样本量。
三条轴接到的,是行程、钟点,还是两人靠近?
统计性质被画成空间、时间、社会三条轴。空间轴接轨迹本身:跳了多远,活动范围有多大。时间轴接人在地点上的时间:返回、停留、访问有多频繁。社会轴在这张图里向上接到连接性质,也就是两台设备靠近多久、隔多久再靠近。它和后文的会面、结伴、独自出行不是同一组分类。
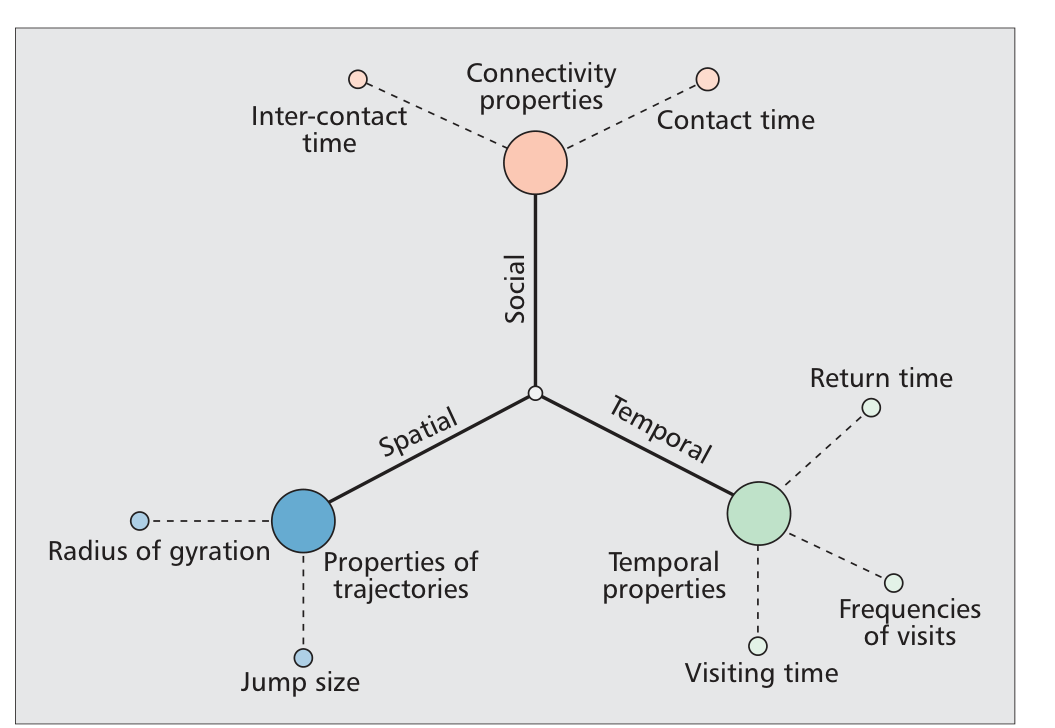
图 2|空间、时间和社会三条轴,各自连着哪些统计量?
图中没有子图字母。蓝色圆是轨迹的空间性质,虚线连到跳跃长度和回转半径。绿色圆是时间性质,虚线连到返回时间、停留时间和访问频率。橙色圆写的是连接性质,虚线连到接触间隔和接触时长;从中心白点伸向橙色圆的轴被标成 Social。来源:原论文 Fig. 2。
接触时长(contact time)是两台设备处于无线电范围内的那些时段。接触间隔(intercontact time)是同两台设备从一次接触结束到下一次接触开始的时长。设备由人携带,所以一次接触被看成两人当时靠得很近。Chaintreau 等发现接触间隔在从几分钟到半天的范围内呈幂律;Karagiannis 等认为这段幂律后面还应接上指数截断。Hui 等报告接触时长也近似幂律,综述说这方面得到的注意较少。幂律的具体指数,这篇没有重印。重尾接触间隔会让消息等待下一次相遇的期望时间发散,这是综述转述 Chaintreau 等的理论后果,用来说明连接统计为什么会影响传递,本文没有重新推导。
数据从哪来,综述只给了渠道,没有给人数和天数。手机运营商的轨迹、学术实验、网络社区、GPS、无线电信标、GSM 基站或无线局域网接入点、蓝牙或 Wi-Fi 的一跳接触,以及钞票在人与人之间的流转,都被当作材料。基站坐标只是当时连在该基站上的人的近似位置。钞票路径是人移动的代理,不是人的定位轨迹。
幂律参数量的是分布形状,不是一个人的平均行程
Brockmann 等用大量钞票流转记录做代理,认为个体跳跃长度 Δr 服从 P(Δr) ~ Δr^−(1+β),其中 β 小于 2。跳跃长度是轨迹里每一段的长度。多数段很短,偶尔一段很长。综述把这种随机模型称为莱维飞行(Lévy flight),并提到它早先被用来近似多种动物的迁移轨迹。β 是这条幂律写法里的指数,小于 2 是他们给出的范围,不是这篇新拟合出来的一个点估计。
Gonzalez 等用手机用户轨迹补上指数截断,并指出个体的截断莱维轨迹和人群之间的差异同时存在。杂志印出的跳跃长度公式是:
P(Δr) = (Δr + Δr₀)^−β exp(Δr/κ),β = 1.75 ± 0.15,Δr₀ = 1.5 km。
κ 是截断尺度,综述写明它随实验变化,没有给出每一次实验的数值。Δr₀ 是加在距离上的偏移,避免距离靠近 0 时公式爆掉,不是“典型一跳等于 1.5 公里”。同一页的正文把这个修正叫作指数截断,意思是纯幂律的长尾被压住,长距离仍然少。可是跳跃公式里指数函数印成了 exp(Δr/κ),负号没有出现;紧挨着的回转半径公式却印成 exp(−r_g/κ)。按正指数直接读,概率会随距离变大,这和“截断”“短途居多”对不上。读跳跃公式时按正文的截断来理解。
人群差异用回转半径(radius of gyration,r_g)概括,它表示一个人出行的特征距离。分布被近似成截断幂律:
P(r_g) = (r_g + r_g⁰)^−βᵣ exp(−r_g/κ),βᵣ = 1.65 ± 0.15,r_g⁰ = 5.8 km,κ = 350 km。
5.8 km 是公式里的偏移 r_g⁰,350 km 是这条人群分布的截断尺度。综述的文字结论是:多数人通常在家附近活动,少数人经常做长途。它没有给出中位数、平均数,也没有给出“多数人”占样本的百分比。个体轨迹的重尾和人与人之间的重尾是两件事,同时出现,不能把 350 km 读成大多数人的活动半径。
时间上,Gonzalez 等看到人返回已去过地点的频率与该地点的热门名次成比例,返回时间概率在 24、48、72 小时有明显的峰,对应按天重复。Song 等换了更大的数据集,把停留时间 Δt,也就是人在一个地点度过的时长,拟合成截断幂律,指数 β = 0.8 ± 0.1,截断为 Δt = 17 小时,并把它和人通常醒着的时间联系起来。17 小时是分布的截断位置,不是测得的平均停留。
Song 等还把第 k 常去地点的访问频率写成齐夫定律(Zipf’s law)f_k ~ k^−ζ,ζ ≈ 1.2 ± 0.1。由此他们推出,一个地点被访问 f 次的概率满足 P(f) ~ f^−(1+1/ζ)。f_k 是名次上的频率,P(f) 是访问次数的分布,后者由前者推得。ζ ≈ 1.2 ± 0.1 同时带有约等号和误差。上述指数、偏移和截断都印在本篇里;原始研究的行程数、人数和拟合区间没有重印。
93% 用上了顺序,热门地点本身不够
访问频率、返回时间和跳跃长度都描述规律,却分不开两种行程:每天固定钟点回到同一处,以及常常去、但没有严格周期。Song 等用信息论里的熵衡量轨迹有多不确定。一端只依赖各地点的访问频率,另一端还看轨迹里按时间排列的特定片段有多常见。综述没有印出中间那些熵的公式。
只靠不均匀的空间分布,也就是第一种熵,全人群的可预测性很低,而且个体之间差得很开。把日常移动的历史顺序也放进去,潜在可预测性达到 93%,并且在人群里变化不大:经常长途旅行的人,和活动范围窄、只在家附近走动的人,一样可预测。综述据此说,知道一个人的移动历史,就有可能以很高的成功概率预见到他当前的位置。这里的 93% 是这种潜在上限意义上的比例,分母是 Song 等研究中的人群;本篇没有写出人数,也没有报告一个预测算法在留出数据上的命中率。频率对了、顺序不对,仍然可以落在第一种熵所描述的那种低可预测性里。
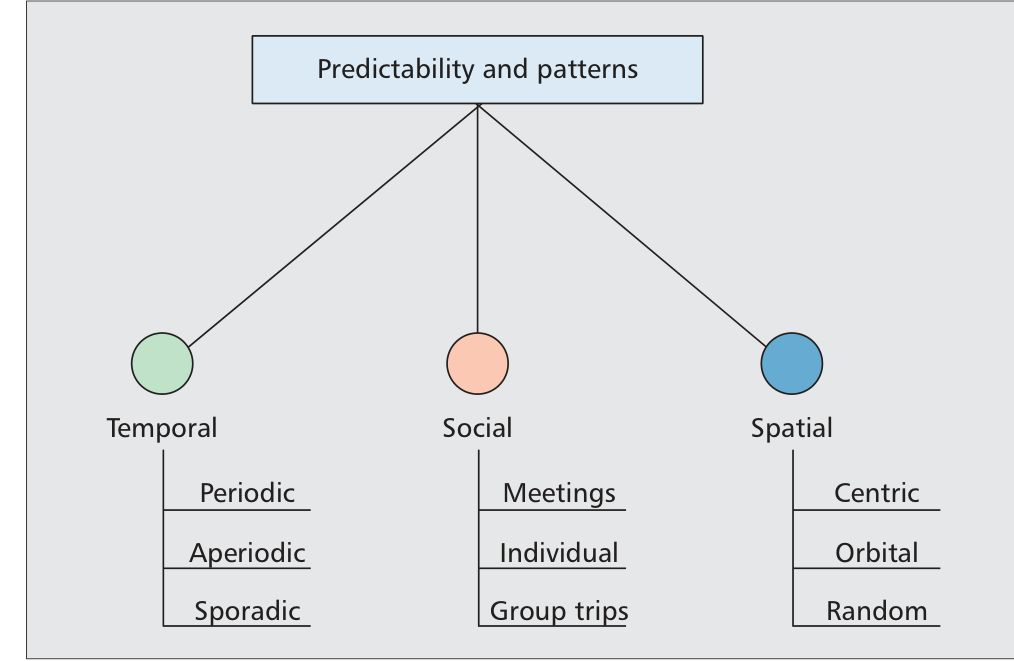
图 3|可预测性被拆成哪三类重复模式?
图中没有 (a)(b)。顶端是可预测性与模式。绿色时间支分成周期、非周期和偶发。橙色社会支分成会面、独自出行和结伴。蓝色空间支分成向心、环状和随机。来源:原论文 Fig. 3。
时间模式对应访问有多勤。周期是按日、按周回到同一处,例如每个工作日在相近时刻从家到办公室。非周期是重复、但没有严格节拍,例如每隔几周回老家看亲友。偶发是可能不再重复的行程,综述举的例子是去荒岛度假。这三类都和地点访问的频率有关,节拍的强弱不同。
空间模式看的是轨迹形状,综述认为这方面仍然缺少系统知识。把一座城缩成一个点、只看城与城之间、时间拉到年的尺度,普通人的轨迹会像一颗星:家乡是中心,其他城市是来回的射线,这是向心。把尺度收到校园里的一个工作周,就会出现环:早上去自习室,晚上去体育馆,夜里回家。完全对不上这两种形状的,被标成随机。星形和环形是作者用来命名的想象结构,不是他们在这篇文章里数出来的轨迹张数。
社会模式不绑定某一个坐标。空闲时间常和朋友一起过,见面的地点可以换,预测靠的是和谁互动。三类是:为了见社会联系人而走的会面,一群有社会关系的人一起走的结伴,以及独自出行。
尺度再叠上去,而且不只有空间。建筑尺度是几小时到一天,社会圈限于同时在场的人,例如上班时的同事。城市尺度是两次出城之间的较长停留,社会圈更宽。全球尺度是数月到数年,联系人铺到整个社交网。驱动力也跟着变。全球移动会碰到国界,以及随距离上升的旅行成本。综述用一个例子说明停留长短可以反过来依赖这次行程本身:付出从欧洲到美国的成本之后,人多半会待上至少几天;去附近城镇的商务行程则可以当天往返。校园里在图书馆、自习室和体育馆之间走动,更由建筑的功能决定,步行成本可以忽略。这是尺度论证里的例子,不是测量结果。作者由此设想一个分层模型:先把每座城市收成全球地图上的一个点,需要时再放大到城市内部和建筑内部,连同社会和时间尺度一起放大。分层模型在后文是分类视角,不是一个已经估出参数的新模型。
地点、日程和社交图,各自强制了哪一种选择?
随机模型已经被排除。剩下的模型按主机制分成三路:保存每人偏爱的地点,显式写下重复日程,以及用社交图决定下一个目的地。一条路线内部的模型,也只是把这一路的想法做得更完整,并没有同时解决另外两路。
地点偏好针对的是:人会反复出现在一组偏好地点,返回概率和访问频率相关,跳跃长度也不是均匀的。做法是先存下每个人的偏好地点,再据此选下一站。ORBIT 在仿真开始时生成一组地点,每个节点选一个子集,并按可配置的规则在子集里移动;地点集合还可以有层次。更一般地,地点可以做成马尔可夫链的状态,用转移概率间接得到重返频率。正文称这个模型为 ORBIT,对照表写成 Sociological Orbit,文献条目的题目是 SOLAR。Time-Variant Community 把时间分成段,每段给节点指定参考地点;在一段之内,节点或者待在参考地点附近,或者在整个区域里自由移动,从而同时有返回和随机走动。
SLAW 额外照顾短途偏好。会面点在平面上的相互距离呈重尾;每天的路线是这些点的一个随机子集,再按最小行动原则串起来,也就是让总路程尽量短。子集里有一部分对同一个人保持固定,所以也会定期回到同一处。
Song 等的模型不预先钉死偏好地点,让地点在过程中长出来。探索是一次跳跃长度服从截断幂律的随机游走。偏好返回则回到已经常去的地方,例如家和工作地。主体在两种方式之间选择:以概率
P_new = ρ S^−γ
去一个新地点。S 是到目前为止访问过的地点数,ρ 和 γ 是参数,这篇没有给出数值。回到已访问地点的概率是 1 − ρ S^−γ,并且更倾向访问次数更高的地点。杂志把这个互补概率也写成 P_new。两个式子里,只有带 ρ S^−γ 的那个是去新地点的概率。结果是开头有一段贪婪探索,时间一长,移动主要绕着已经去过的地点。
SWIM 给每个主体一个家,家是平面上均匀随机的一个点。下一站的权重随该地热门程度增加,并随离家距离下降,用来得到跳跃长度的幂律。热门程度不是个人偏好,而是这个主体上次去该地时遇到的其他人数。地点偏好这一路能对上轨迹的主要空间性质;社会和时间,留给后面两路。
日程这一路把重复的日常活动直接写进人的时间表。Zheng 等的模型最全:用美国交通部全国家庭出行调查抽出地址类型、活动类型和停留时间的分布,把街道画成水平和垂直线,长度和间距随机选取。地址类型有数十种,活动类型在数据库里超过 30 种,活动决定停留时间,也影响路程时间。两点之间用 Dijkstra 算法找最短路径,街道还有随一天中的时刻变化的限速。职业不同,轨迹也不同,例如办公室职员和邮递员。模型可以很细地再现某一种场景,换一套人口条件是否还适用则难以判断;它依赖庞大的统计库,并不解释出行的主要驱动力,形式分析也太复杂。
Working Day Movement 更轻,按活动类型做成可扩展的框架,并区分楼与楼之间、楼内两种移动。子模型包括家、办公室、晚间活动和步行、汽车、公交等交通方式。办公室是绕着选定工位的星形轨迹,家是在家里某个点停留。晚间活动让一群人沿街道随机走,用来表示下班后见朋友。它比 Zheng 等更容易换场景,复杂、难解析的问题仍然在。
社交图是当时最新、变化也最快的一路。人是节点,加权边表示社会关系的强弱。综述转述复杂网络里的两个既有认识:每人的连边数呈幂律,两人之间的平均距离被一个小数字限制,大约是 6。大约 6 不是这篇新测的网络直径。直觉是,下一站受有社会关系的人现在在哪里的影响。
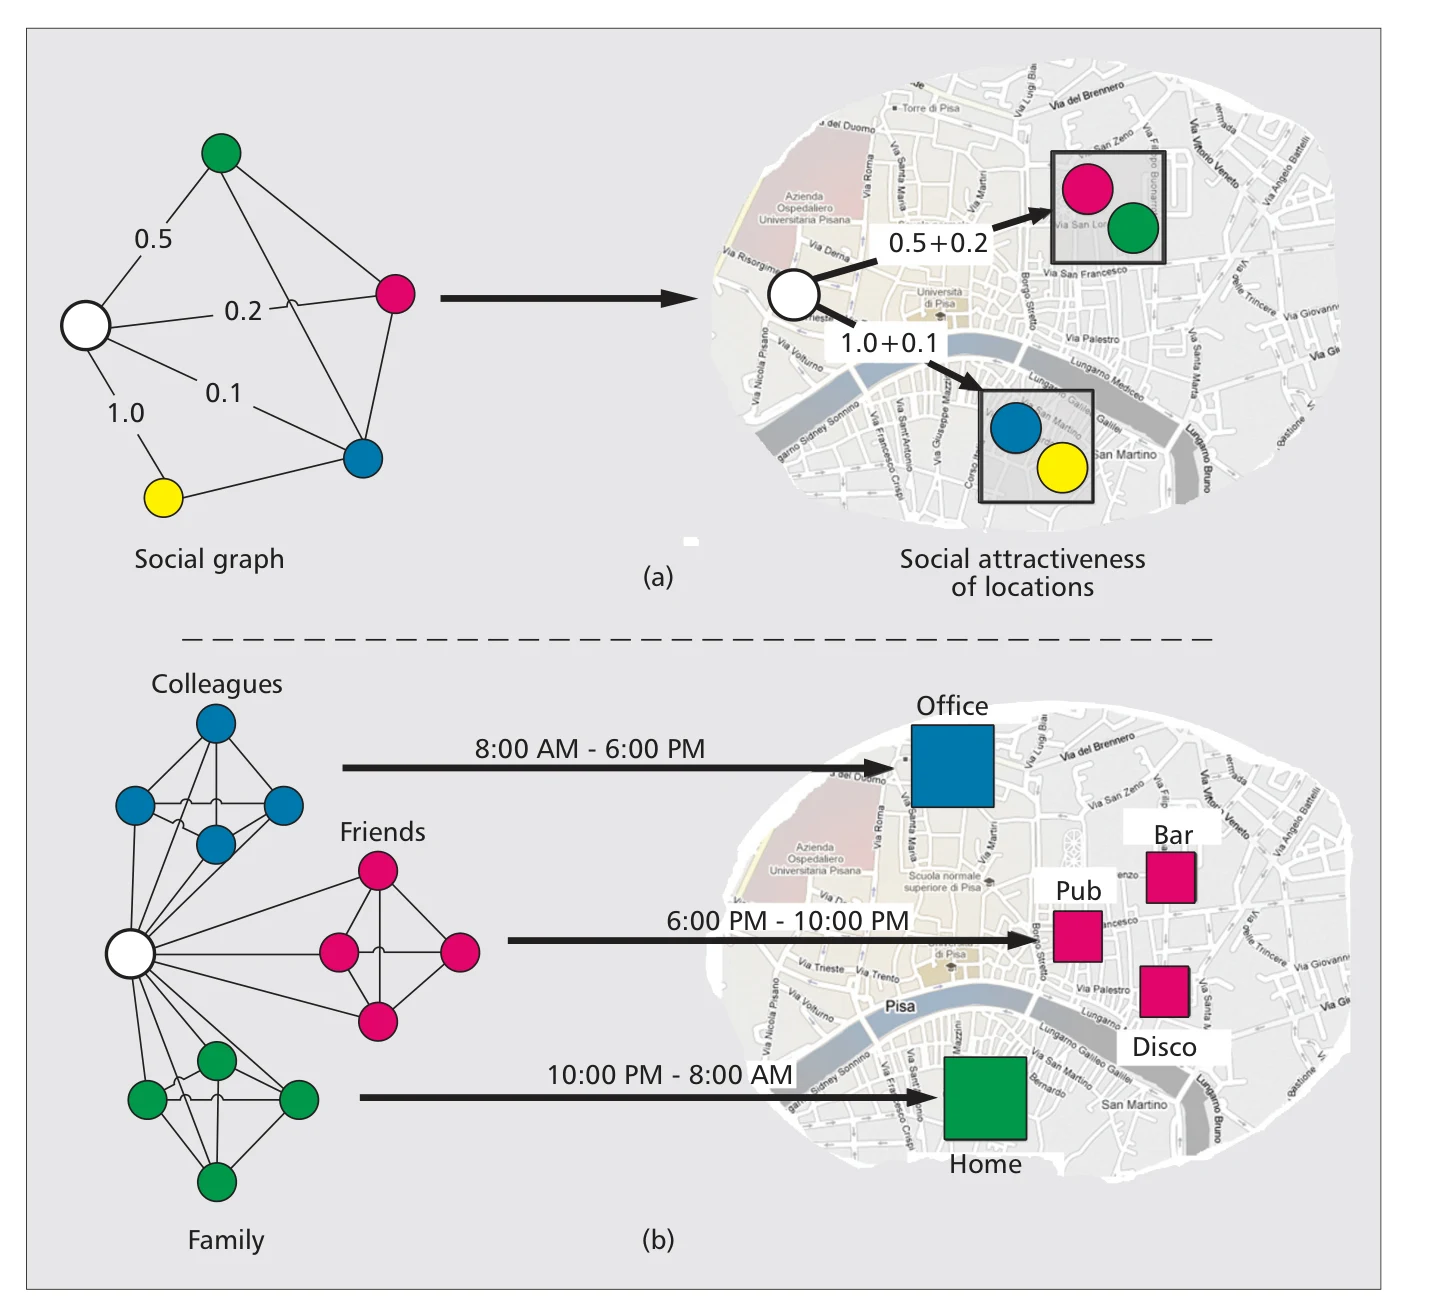
图 4|社会关系怎样变成地点的吸引力,钟点又怎样改写当天要去的群体?
(a)白点是要选目的地的人,四条边标着 0.5、0.2、0.1 和 1.0。右侧城市街道底图上有两个框,框旁写成 0.5+0.2 和 1.0+0.1,即把正好在该处的人的关系权重加起来。同色的人对应同一地点。这些权重是示意图上的数,不是一份实测网络的边权,底图也不是这篇采集的轨迹。
(b)同事、朋友、家人三组关系在一天里轮流起作用。8:00 AM–6:00 PM 指向办公室,6:00 PM–10:00 PM 指向图上的 Pub、Bar 和 Disco,10:00 PM–8:00 AM 指向家。时段和颜色说明时变社交图这一概念,综述没有报告这些时段的实际停留人数。来源:原论文 Fig. 4。
CMM 让相连的人按关系权重影响目的地。HCMM 在此之上加入空间吸引,并纳入跳跃长度的幂律。为了做出周期性,后来的工作使用随时间变化的社交图:上班时段主要和同事联系,人会离开家去办公室;晚间转向家人或朋友,于是回家或去酒吧。边权随时间改变,调好权重就能再现重复行为。时刻 t 的决策是,在该时刻相关的群体里选一个,再走向这个群体所关联的地点。这个想法在 CMM 和 HCMM 里已经提到,在 HHW 和 GeSoMo 里展开得更完整。
社会关系也会把人推开。SIMPS 和 GeSoMo 加入排斥,于是节点会有一段时间独自待着,对应独自出行。GeSoMo 还让节点组成临时小组,选一个共同的下一站,从而有结伴。
表里的勾,是文献判断,不是一轮新仿真
三路模型的差别被收进表 1。记号要先说清楚,否则勾会被读成实验通过。√ 表示作者认为模型具备该性质,横线 — 表示不具备,o 表示含糊。会面列上的 f 表示人会在共同偏好的地点碰上,模型并不知道谁和谁有社会关系。周期安排列上的 s 表示周期来自时变社交图。偏好地点列上的 s 表示地点挂在社交图的节点或群体上。表下没有节点数、无线电范围、仿真时长或拟合误差。因此每一格是综述对文献的定性判断。
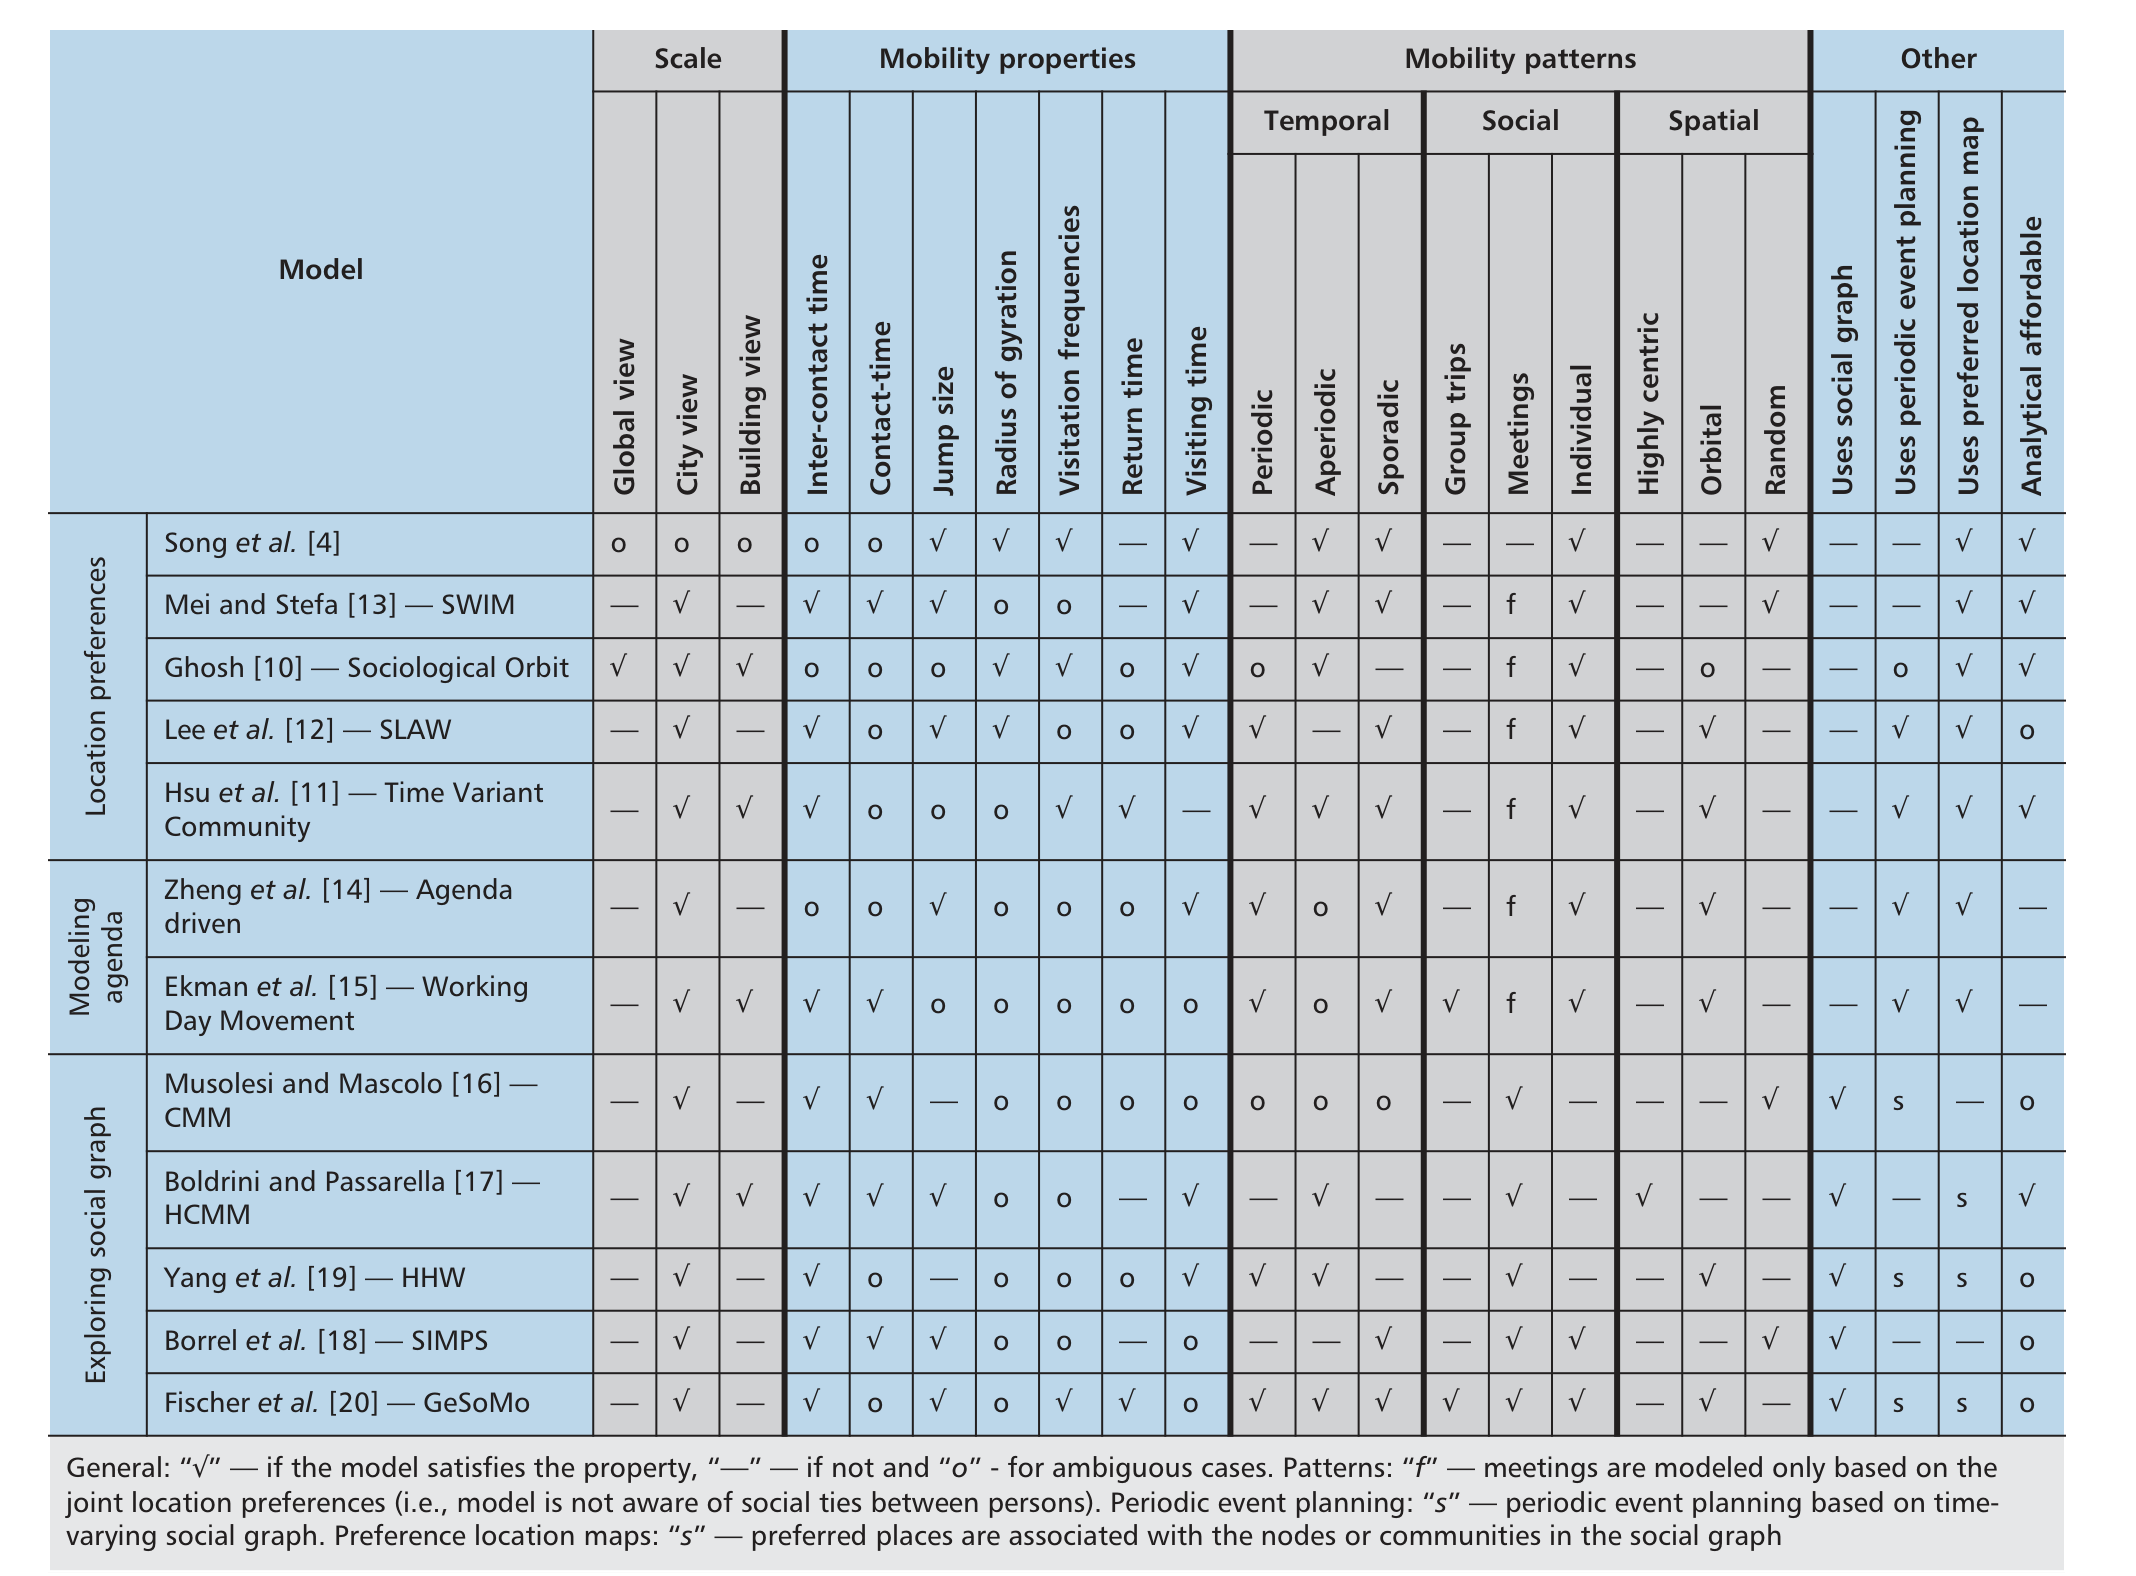
表 1|12 个模型在尺度、统计性质和模式上,哪些被判为具备?
行按地点偏好、日程、社交图分组。列从左到右是全球、城市、建筑三档尺度,接触间隔、接触时长、跳跃长度、回转半径、访问频率、返回时间和停留时间,然后是时间模式(周期、非周期、偶发)、社会模式(结伴、会面、独自)、空间模式(高度向心、环状、随机),最后是是否使用社交图、周期安排、偏好地图,以及是否便于解析。√、—、o、f、s 的含义见上一段。来源:原论文 Table 1。
按表中记号数:12 行里,城市尺度有 11 行是 √,Song 等那一行三档尺度都是 o。全球尺度只有 Ghosh 的 Sociological Orbit 为 √,它在建筑尺度上也是 √。建筑尺度上另外打勾的是 Time Variant Community、Working Day 和 HCMM。这和正文的判断一致:多数模型集中在城市,建筑内部常常被做成很简化的随机走动,城外几乎没人做。正文这句比表更强,表上仍有四行在建筑尺度打勾。
接触间隔列有 9 个 √,Song 等、Ghosh、Zheng 等 3 行是 o,没有 —。地点偏好和日程这 7 行都使用偏好地图(√)。社交图只在最后 5 行打勾。CMM 的偏好地图是 —,吸引力来自人的位置,不是一张存好的地点图;HCMM、HHW 和 GeSoMo 在这一列是 s。周期安排上,SLAW、Time Variant Community 和两个日程模型是 √;CMM、HHW、GeSoMo 是 s。正文说时变社交图在 CMM 和 HCMM 都提到过,表却把 HCMM 的 s 放在偏好地图,周期安排列是 —。两处要一起读,不能把“提到过”写成 HCMM 已经用时变社交图安排了周期。
社会模式也和正文对得上。地点偏好和日程模型的会面大多是 f。CMM、HCMM、HHW 的会面是 √,独自出行是 —。SIMPS 同时有会面和独自出行。结伴只有两行打勾:Working Day,以及 GeSoMo。Working Day 的会面仍是 f。空间上,高度向心只有 HCMM 一行是 √,对应它加入的空间吸引。两个日程模型在“便于解析”一列是 —,和正文说它们难以做形式分析一致。
这些勾不能换成“模型已在同一套数据上复现了该分布”。o 也不是“效果为零”,而是作者认为证据或模型定义含糊。
重尾的接触间隔,可能是别的驱动力带出来的
综述从这张表引出三件还没做完的事。
第一,人的移动有空间、时间、社会三个面,而地点图、日程、社交图各自只再现其中一部分,更现实的模型要把技术合起来。他们认为较有希望的底子是时变社交图:时间和社会已经在里面,复杂网络的结果也可以借来用。下一步是把空间放进去。在此之前,移动和社会性的关系需要用真实轨迹再查。综述写道,文献已经表明网络的社交结构会影响人的移动,但这种关系在定性和定量上如何变化还不清楚;他们把尚未弄清的部分称作这种因果关系的动态。本篇没有新的识别设计,不能把“文献里看到过影响”写成已经量出的因果效应。
第二,尺度会改变人对同一种驱动力的敏感程度。综述的例子是:朋友住得近,关系即使不强也愿意去见;几乎不会为了这段不强的关系环游世界。城市模型占了表的大多数,表达不了这件随距离改变的事。建筑层若只是简化的随机走动,也接不上全球层的成本和边界。
第三,不同统计量都呈现尺度律,它们之间可能还有没被写明的依赖。若是这样,有些性质是生成性的,应该直接写进模型;另一些会在生成性质正确时自己出现。例子正是接触间隔:多数模型并没有强行指定它的分布,重尾仍然出现。一种可能的机制是社会性本身。和关系近的人经常见面,接触间隔就短;和点头之交很少见面,接触间隔就长。这是讨论里的机制猜想。表上 9 个 √ 说明作者认为这些模型表现出了该性质,并没有在本篇里报告一条共同的拟合指数。
因此,把一条接触间隔分布抄进仿真,和让社会关系、地点、钟点跑出这条分布,是两种不同的建模。前者可以对上间隔的边际形状,仍然可能让不该见面的人见面。综述把这种区分留成了研究方向。
一句话总结
日常出行要同时有常去的地点、重复的钟点和由谁在场决定的目的地;现有模型各自写下其中一块,而接触间隔的重尾往往是这些驱动力的副产品。
核心来源
Karamshuk、Boldrini、Conti、Passarella,Human Mobility Models for Opportunistic Networks,IEEE Communications Magazine,2011年12月,第157–165页。
文中的关键数字来自综述引用的这些工作,样本量写在原研究中,本篇没有重印。Brockmann、Hufnagel、Geisel,The Scaling Laws of Human Travel,Nature,2006,439:462–465,跳跃长度的幂律。Gonzalez、Hidalgo、Barabasi,Understanding Individual Human Mobility Patterns,Nature,2008,453:779–782,截断、回转半径和返回时间的日周期峰。Song 等,Modeling the Scaling Properties of Human Mobility,Nature Physics,2010,6:818–823,停留时间、齐夫访问频率,以及探索与偏好返回。Song 等,Limits of Predictability in Human Mobility,Science,2010,327:1018–1021,93% 的潜在可预测性。Chaintreau 等,IEEE Transactions on Mobile Computing,2007,6:606–620,以及 Karagiannis 等,同一期刊,2010,9:1377–1390,接触间隔的幂律与指数截断。Hui 等,2005 年 ACM SIGCOMM 延迟容忍网络研讨会,接触时长的近似幂律。
Dmytro Karamshuk 在文末简介里是意大利卢卡 IMT 高等研究院的博士生,同时是意大利国家研究委员会 IIT 的研究助理,计算机科学硕士来自乌克兰国立技术大学 KPI。列出的方向是复杂网络、人类移动建模和机会网络。
Chiara Boldrini 是 IIT-CNR 的研究人员,比萨大学计算机工程硕士、信息工程博士。工作集中在人类移动模型,以及机会网络的设计、建模和性能评估,包括利用社会关系做数据分发和路由。
Marco Conti 是意大利国家研究委员会的研究主任,并担任 IIT-CNR 普适互联网组负责人。简介写他发表了 250 篇以上与计算机网络有关的论文和三本书,并任 Computer Communications 主编。
Andrea Passarella 持有计算机工程博士学位,在 IIT-CNR 工作,曾在剑桥大学计算机实验室做研究。方向是机会网络,侧重以内容为中心的架构、服务、路由协议和移动模型。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果接触间隔的重尾真是社会远近带出来的,检验模型时只比较“所有设备对的间隔直方图”会放过一种错误:直方图的尾巴对了,短间隔却没有集中在关系强的人身上。和表 1 的读法一致的检查是配对的,短间隔应更多出现在强关系上,长间隔更多出现在点头之交上。综述提出了这个机制,没有做这个分组检验。
93% 依赖历史顺序,访问频率单独使用时可预测性又低又因人而异。一个只按齐夫名次抽取下一地点的仿真器,可以让 f_k 对上 ζ ≈ 1.2,同时仍然缺少家、办公室、体育馆这个重复序列。该对上的是顺序熵所要求的片段,而不是地点热度的边际。
表上大多数行停在城市尺度。同一段不强的社会关系,住在附近时会促成见面,远在另一国时不会。把校园里蓝牙接触的参数和钞票长途流转的参数合成一个数,就混用了综述已经分开的两种代理:一跳无线电接触量的是靠近,钞票路径量的是物品换手。尺度一变,该写进模型的驱动力也变了。