一座没有通勤表的城市,能不能只凭区域功能和空间结构生成出发地—目的地矩阵?
论文名片|Bin Chen、Zhuoya Meng、Fang Yang、Runkang Guo、Jingtao Ding、Yin Zhang、Chuan Ai、Zhengqiu Zhu,Fusing Urban Structure and Semantics: A Conditional Diffusion Model for Cross-City OD Matrix Generation,arXiv 预印本,2026年5月1日,arXiv:2605.00938v1。arXiv:2605.00938。本文依据这一版预印本解读。PDF 首页和文末没有印出 DOI。研究类型是跨城市的通勤出发地—目的地矩阵生成。
设想一座美国城市已经划好区域。每个区域有人口和兴趣点,也能知道哪些区域接壤、质心之间的直线距离有多远,只是没有居住地到工作地的人数表。规划仍然想填出这张表:从哪一片出发,到哪一片上班,各有多少人。
引力模型会把这个问题写成两端规模越大、距离越近,流量越大。城市之间的人口、用地和通勤组织并不相似,在一座城市里贴合的公式或网络,换到另一座城市常常对不齐。这篇论文同时强调另一件反复出现的事:语义可以很不一样,距离衰减和相邻区域之间更高的流量却比较稳定。SEDAN 是一个以带属性节点为条件、并加强空间结构的扩散模型(Structure-Enhanced Diffusion model conditioned on Attributed Nodes)。它用人口和兴趣点表示潜在通勤需求,把邻接和距离放进生成过程,作为显式的空间约束。
在论文使用的美国通勤数据上,SEDAN 相对较强的扩散基线 WEDAN,流量重叠和均方根误差更好,流入、流出和流量分布也更接近记录;按真实矩阵波动归一化之后的误差略高。这些数字描述的是区域对上的生成结果。它们还没有证明某个人为什么选择某个工作地,也还没有覆盖美国以外的城市。
先说结论
- 相对 WEDAN,城市平均的通勤者重叠指标 CPC 从 0.59 到 0.61。以 0.59 为分母,相对提高 3.39%,绝对差是 0.02。均方根误差 RMSE 从 68.60 降到 63.54,相对下降 7.38%。流入、流出和 OD 流量的詹森–香农散度 JSD 从 0.29、0.27、0.15 降到 0.26、0.21、0.11,相对下降 10.34%、22.22% 和 26.67%。归一化均方根误差 NRMSE 从 0.88 升到 0.93。表中是五次独立实验的平均,没有给出标准差。
- 只测试小城市时,SEDAN 的流入 JSD 是 0.35,WEDAN 是 0.34。把中等城市和大型城市逐步加进测试后,高异质一组里 SEDAN 的 RMSE 是 63.47,WEDAN 是 72.96。这三组是不同的城市组合,不是同一批城市前后比较。
- 综合结构分类下的多中心城市,SEDAN 的 CPC 比 WEDAN 高 13.9%,RMSE 从 86.90 降到 38.03,OD 流量 JSD 从 0.146 降到 0.114。按 OD 流量划分结构时,单中心城市的 CPC 提高 8.0%,多中心提高 12.0%,正文没有给出这两组的绝对 CPC。人口分类下的均匀城市,CPC 略降,降幅没有写出。
- 在消融图内部,邻接和距离一起去掉后,CPC 为 0.41,RMSE 为 81.02;同一张图上的完整模型是 0.62 和 63.40。去掉兴趣点后,RMSE 从 63.40 升到 75.29。去掉扩散后,RMSE 只升到 65.19,流入 JSD 从 0.26 升到 0.29。
- 全数据中,距离与对数流量的相关为 −0.47。相邻区域对的平均流量是 80.00,非相邻区域对是 36.28。前者约为后者的 2.21 倍。这是每一对区域的平均强度。论文没有给出相邻对占全部区域对的比例,因此不能把这个倍数读成总通勤人数的份额。
要填的是哪一张表?
这里的出发地—目的地矩阵(origin–destination matrix,OD 矩阵)记录区域之间的通勤人数。一行是出发区域,一列是到达区域,格子里是人数。分析单位是区域对,不是一次个人出行,也不是一个人的全天行程。
数据来自论文所称的 LargeCommuingOD,对应 Rong、Ding、Liu 与 Li 在 ICLR 2025 发表的通勤 OD 生成基准。论文写它覆盖美国 3233 个空间单元,单元类型包括县和普查区。区域特征来自美国社区调查(American Community Survey,ACS)、雇主—雇员纵向动态数据(Longitudinal Employer-Household Dynamics,LODES)和 OpenStreetMap。ACS 提供 97 个人口与社会经济指标。LODES 提供 2018 年居住地到工作地的通勤量,依据是雇主与雇员关系在区域上的汇总。距离矩阵用区域质心计算欧氏距离,也就是地图上的直线距离,不是沿路里程、时间或费用。邻接矩阵由地理边界是否相接决定:相接为 1,否则为 0。
论文没有写城市一共有多少座,也没有写同一座城市内部会不会混用县和普查区。后文的小城市、中等城市和大型城市,按区域个数划分,分别是 0–10、11–50 和 51–100 个区域。
任务定义是跨城市生成。来源城市有观测到的通勤矩阵和城市特征;目标城市在生成时不提供自己的通勤矩阵,只提供区域特征、距离和邻接。模型要从噪声里生成整张矩阵。论文把数据按 8:1:1 分成训练、验证和测试,指标先在城市内的区域对上计算,再对城市取平均。它没有写明这个划分是整座城市留出,还是把同一座城市里的区域对拆开。问题定义写的是未见城市;划分句子本身没有再证实这一点。下文把结果理解为跨城市生成,依据的是问题定义。测试城市的座数,正文没有单独列出。平均时有没有按区域数或总流量给大城市加权,也没有写明。
每次实验独立重复 5 次,报告平均值。SEDAN、DiffODGen 和 WEDAN 各自做 10 次随机采样,用样本均值作为最终输出。
城市可以很不一样,空间上还有什么是反复出现的?
若每座城市的通勤都只由本地语义决定,把邻接和距离单独做成约束就缺少理由。论文先在全部城市的 OD 数据上检查两件空间规律。
距离和对数流量的相关,表 A.6 记为 −0.47,正文一处写作 −0.472。相关为负,表示距离变远时,对数流量整体变低。这是全部纳入统计的区域对上的相关,不是某一座城市、某一个人的衰减指数。图 9 把平均 OD 流量画成距离的函数。横轴刻度标到 50000,纵轴是平均 OD 流量。曲线随距离下降。图上没有印出每个点的流量,也没有写出距离单位,所以这里不把曲线上的某一点读成精确人数或公里数。
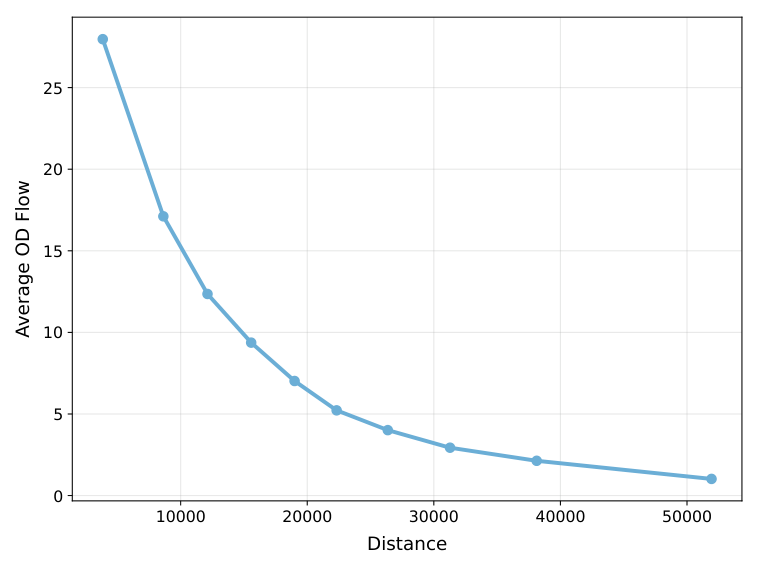
图 1|平均通勤流量是否随距离下降?
无字母子图。横轴为距离,刻度标到 50000,单位未在图中写出;纵轴为平均 OD 流量。曲线随距离下降,和表 A.6 的负相关方向一致。图上没有逐点数值,不能从曲线读出某个距离上的精确人数。来源:原论文 Fig. A.9。
相邻与否的差别写在表 A.6 里。相邻区域对的平均流量是 80.00,非相邻区域对是 36.28,前者约为后者的 2.21 倍,分母是非相邻区域对的平均流量。相邻区域对的非零率为 96.79%,非相邻为 88.31%。平均流量和非零率分列,论文没有写明平均流量是否先去掉了零流量对。
图 10 把流量分成四档:0、低(1–3)、中(4–10)、高(11 及以上)。分母是该组内部的区域对。相邻组里,高流量占 72.09%,零流量占 5.10%,低流量 8.01%,中流量 14.81%,四档相加为 100.01%,差在四舍五入。非相邻组里,零流量 27.03%,低流量 28.19%,中流量 23.88%,高流量 20.90%。
这张图和表 A.6 不能直接换算。表中相邻非零率 96.79%,对应的零流量份额约为 3.21%,图上的零流量柱却是 5.10%。非相邻非零率 88.31% 对应的零流量份额约为 11.69%,图上是 27.03%。论文没有解释两套分母为何不同。后面只用各自写明的口径,不把 5.10% 当成 96.79% 的余数。
还有一个更容易读过头的地方。72.09% 是相邻区域对里的高流量比例,不是全部通勤人数里有 72.09% 发生在相邻区域。相邻对通常比非相邻对少得多。总人数等于平均流量乘以区域对数量。论文没有给出相邻对占全部区域对的比例,因此平均流量更高,仍然可能只占通勤总人数的一部分。
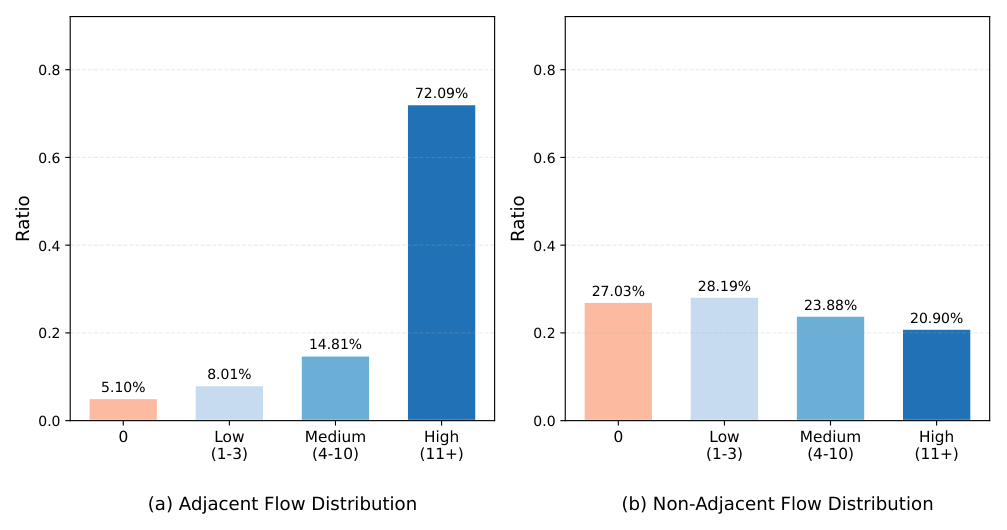
图 2|相邻区域对是不是更常出现高流量?
(a)相邻区域对:零流量 5.10%,低流量 8.01%,中流量 14.81%,高流量(11 及以上)72.09%。分母是相邻区域对。(b)非相邻区域对:四档依次为 27.03%、28.19%、23.88%、20.90%,分母是非相邻区域对。纵轴是组内比例。它不表示通勤总人数的份额,也和表 A.6 的非零率不是同一口径。来源:原论文 Fig. A.10。
这两项规律给模型一个可以跨城市使用的约束:近处和相邻处的流量通常更强。城市特有的人口和设施,则用来决定需求落在哪些功能之间。SEDAN 把这两类信息分开送进生成过程。
语义和空间在生成时各进哪一步?
一座城市被写成有向加权图。节点是区域,边是通勤方向,边权是人数。城市上下文有三块:节点特征、距离矩阵、邻接矩阵。节点特征分成人口和兴趣点。论文没有写出兴趣点一共有多少类,只在后文给出解释分析里排序靠前的类别。
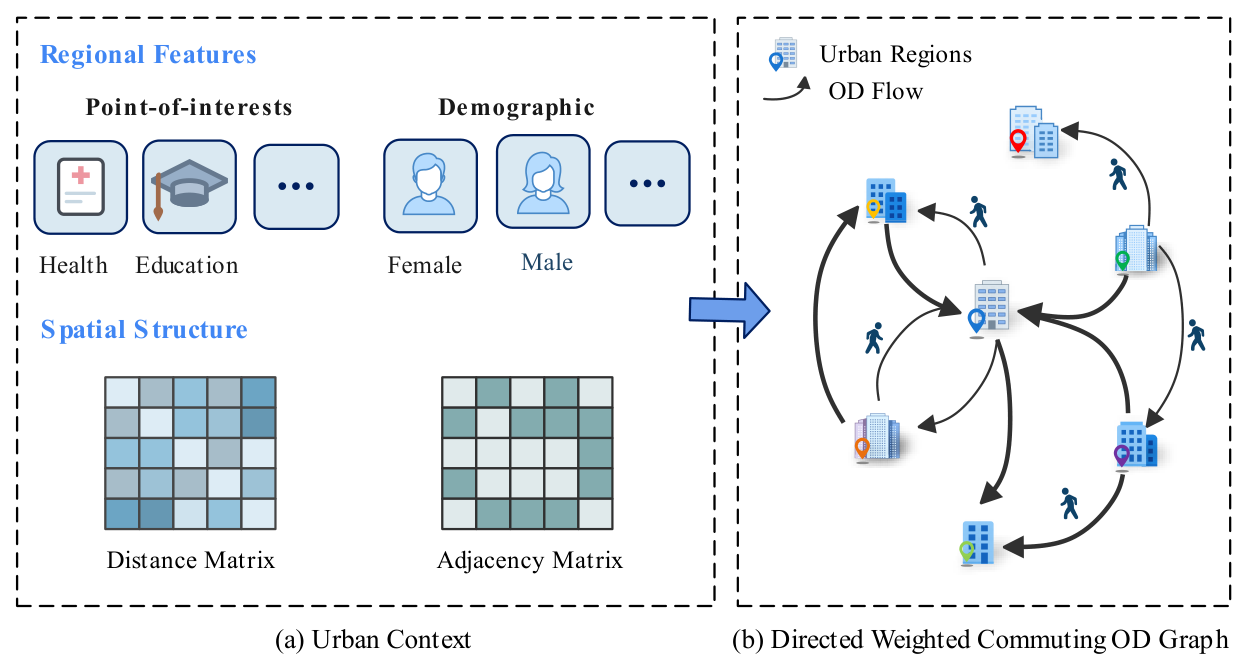
图 3|生成一张通勤矩阵之前,城市被表示成什么?
(a)城市上下文:兴趣点以医疗、教育示意,人口以女性和男性示意,下面是距离矩阵和邻接矩阵。(b)有向加权通勤图:节点是城市区域,箭头是通勤方向。这是任务示意,不是某一座真实城市的流量。来源:原论文 Fig. 1。
扩散分两段。前向过程给每条边的流量独立加上高斯噪声,噪声强度由日程 βₜ 控制,步数增加后矩阵趋近标准正态分布。反向过程一次还原整张矩阵,条件是目标城市的上下文。网络预测的是这一步混入的噪声,训练损失是预测噪声和实际噪声的均方误差。这样比较的是“当前这张带噪声的矩阵里,噪声长什么样”,不是直接比较两座城市的总人口。
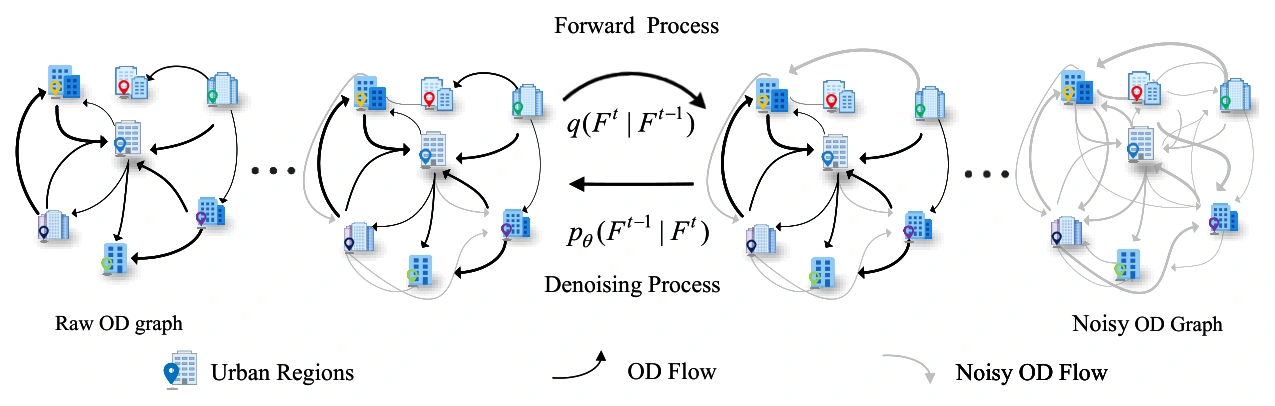
图 4|通勤图怎样被噪声打散,再被条件还原?
无字母子图。从左到右,清晰的通勤图逐步变成带噪声的图。中间标出前向加噪 q(Fᵗ | Fᵗ⁻¹) 和反向去噪 pθ(Fᵗ⁻¹ | Fᵗ)。蓝色建筑表示城市区域,黑色箭头表示通勤流,灰色箭头表示带噪声的流。来源:原论文 Fig. 2。
流量数值很不均衡。论文在训练时使用 log(流量 + 1),生成后再做指数并减 1,把长尾大流量拉回更容易训练的范围。评价指标写在原始通勤人数上。表 2 里引力模型的 RMSE 达到 174.00,和 SEDAN 的 63.54 放在同一张表,说明比较的是人数尺度上的误差。
去噪网络接收区域特征、当前的噪声矩阵、邻接和距离。区域特征和噪声矩阵先各自经过多层感知机,变成节点表示和边表示。邻接和距离各自做一次线性映射。
注意力分数有两项。第一项是节点特征之间的普通注意力,用来表示区域功能之间的相互需求。第二项把邻接先验送进边表示,让地理上相邻的区域更容易得到更大的注意力。节点表示按相连邻居聚合。距离先验加到更新后的边表示上,用来保持远近关系。堆叠若干层之后,全连接层输出每条边上的噪声。默认结构是四层图变换器,每层 32 个隐藏单元。
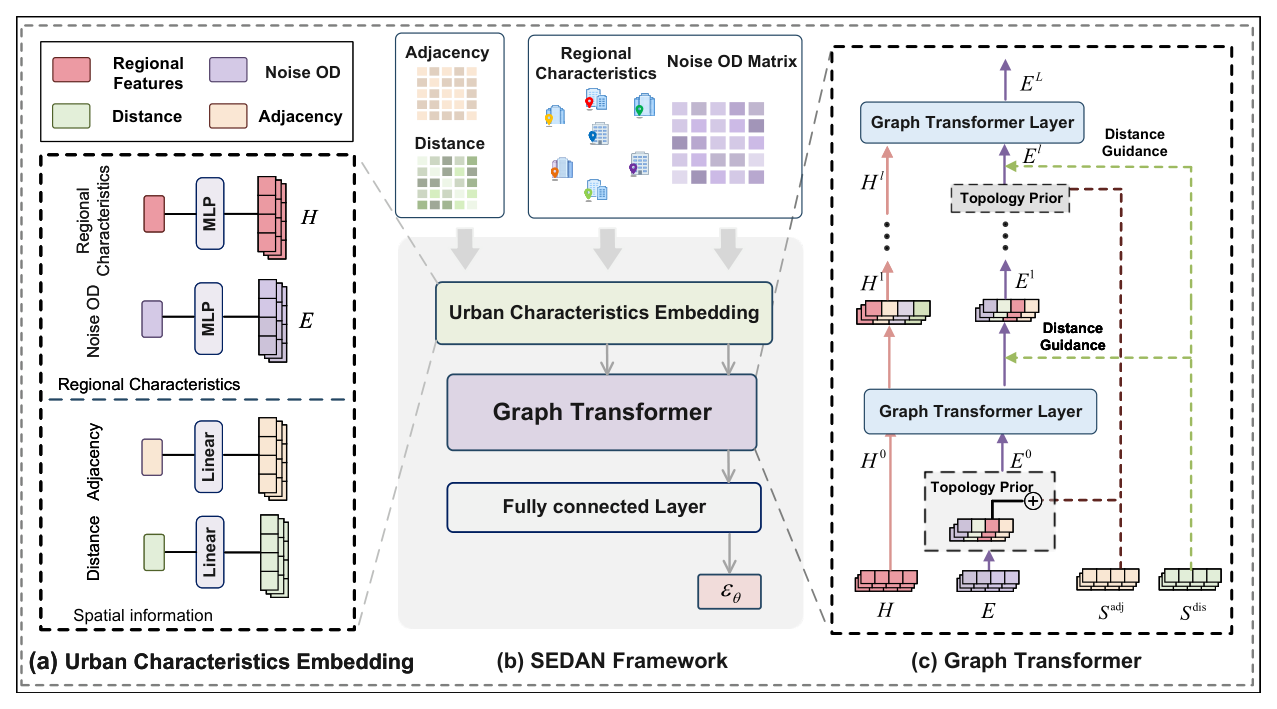
图 5|人口、兴趣点、邻接和距离在网络里从哪里进入?
(a)城市特征嵌入:区域特征和噪声 OD 分别经多层感知机变成节点表示 H 与边表示 E;邻接和距离经线性层进入。(b)整体框架:嵌入之后经过堆叠的图变换器和全连接层,输出噪声。(c)图变换器一层之内同时更新节点和边;拓扑先验对应邻接,距离引导对应距离。颜色:区域特征为红,噪声 OD 为紫,距离为绿,邻接为橙。来源:原论文 Fig. 3。
公式把节点更新写成对相连邻居求和。后面的注意力案例却画出了较完整的区域对热图。论文没有说明那张案例里的图只连接相邻区域,还是所有区域两两都有边。读架构图时,可以把邻接理解成注意力上的结构偏置,把距离理解成边上的条件;不要默认每一个实现细节都已经由案例热图证明。
采样使用去噪扩散隐式模型(Denoising Diffusion Implicit Models,DDIM),用来减少逐步去噪的次数。训练采用 1000 步余弦噪声日程和 AdamW,学习率 1e-4。超参按验证集选择。附录计时另把 DDIM 采样步数设为 100,和训练用的 1000 步不是同一个数字。
相对谁,好了多少?
对照分四类,一共十个基线。物理模型是幂律衰减的引力模型 GM-P 和指数衰减的 GM-E。统计学习是支持向量回归 SVR、随机森林、梯度提升树和深度引力模型 DGM。逐对预测是 GMEL,它用图网络学习区域表示,再一对一对地预测。整张矩阵一起生成的有 NetGAN、级联扩散模型 DiffODGen,以及 WEDAN。WEDAN 也是扩散模型,输入包含人口、兴趣点和距离。SEDAN 在此之外把邻接一并作为结构约束。论文的表 1 还标明,这些模型都不建模时间。
四个指标各有自己的分母。
RMSE 先在一座城市里,对区域对上的人数误差平方取平均,再开方。分母是该矩阵的元素个数。然后对城市取平均。63.54 的对照是 WEDAN 的 68.60,单位与通勤人数相同,不是某座城市的通勤总人数。
NRMSE 用这个 RMSE 除以真实矩阵相对自身均值的均方根偏离。分母是真实流量的起伏,不是平均流量。NRMSE 变高,表示误差相对于真实矩阵的起伏变大。
CPC 等于两倍的“每个区域对上真实人数与生成人数的较小值之和”,再除以“真实人数之和加生成人数之和”。它衡量两张表重叠多少,范围在 0 到 1。SEDAN 的 0.61 相对 WEDAN 的 0.59,绝对差是 0.02;论文所说的提高 3.39%,分母是 WEDAN 的 0.59。
JSD 把流入、流出和 OD 流量各自看成分布,衡量生成分布与记录分布的对称差异。流入是一个区域从其他区域收到的人数之和,流出是它发出的人数之和。JSD 越小越接近。它不是人数误差本身。流入 JSD 从 0.29 到 0.26,相对下降 10.34%,分母是 WEDAN 的 0.29。
| 模型 | CPC↑ | RMSE↓ | NRMSE↓ | 流入 JSD↓ | 流出 JSD↓ | OD 流量 JSD↓ |
|---|---|---|---|---|---|---|
| GM-P | 0.32 | 174.00 | 2.22 | 0.67 | 0.66 | 0.41 |
| GM-E | 0.33 | 162.90 | 2.08 | 0.65 | 0.64 | 0.42 |
| SVR | 0.42 | 95.40 | 1.22 | 0.42 | 0.56 | 0.41 |
| 随机森林 | 0.46 | 100.40 | 1.28 | 0.42 | 0.50 | 0.22 |
| 梯度提升树 | 0.46 | 91.00 | 1.62 | 0.42 | 0.49 | 0.23 |
| DGM | 0.43 | 92.90 | 1.19 | 0.47 | 0.56 | 0.23 |
| GMEL | 0.44 | 94.30 | 1.20 | 0.45 | 0.36 | 0.21 |
| NetGAN | 0.49 | 89.10 | 1.14 | 0.43 | 0.35 | 0.19 |
| DiffODGen | 0.53 | 74.60 | 0.95 | 0.32 | 0.27 | 0.15 |
| WEDAN | 0.59 | 68.60 | 0.88 | 0.29 | 0.27 | 0.15 |
| SEDAN | 0.61 | 63.54 | 0.93 | 0.26 | 0.21 | 0.11 |
表中数字来自原论文表 2,是五次实验的平均。SEDAN 在 CPC、RMSE 和三项 JSD 上最好。NRMSE 最好的是 WEDAN 的 0.88,SEDAN 为 0.93。作者认为 NRMSE 上升,是因为模型更强调大流量区域对。表 2 直接显示的是归一化误差变大;按流量分位拆开的误差表,论文没有给出。
从 GM-E 的 RMSE 162.90 到 SEDAN 的 63.54,下降幅度大于从 WEDAN 的 68.60 到 63.54。论文把 7.38% 作为相对当前强基线的改进。前一段更大的差距,混有模型家族、特征和训练目标的差别,不能单独记成“加上邻接”的效果。邻接、距离和扩散各自贡献多少,要看后面同一骨架下的消融。
整张矩阵一起生成的三个扩散或生成模型,CPC 为 0.49、0.53、0.59 和 SEDAN 的 0.61,高于逐对回归的 SVR、随机森林和 GMEL。这支持“一起学习整张表”在这套指标上更接近记录。它还不是把 SEDAN 改成逐对预测后的对照实验。
城市大小混在一起时,优势还在吗?
论文按区域数把城市分成小、中、大三档,再做三组嵌套测试。低异质只有小城市。中异质包含小城市和中等城市。高异质三种都有。比较对象是 WEDAN。
| 测试组合 | 指标 | WEDAN | SEDAN |
|---|---|---|---|
| 低异质,只有小城市 | CPC↑ | 0.62 | 0.65 |
| 低异质,只有小城市 | RMSE↓ | 83.16 | 74.40 |
| 低异质,只有小城市 | NRMSE↓ | 1.03 | 0.96 |
| 低异质,只有小城市 | 流入 / 流出 / OD 流量 JSD↓ | 0.34 / 0.29 / 0.15 | 0.35 / 0.24 / 0.13 |
| 中异质,小加中 | CPC↑ | 0.57 | 0.62 |
| 中异质,小加中 | RMSE↓ | 71.48 | 66.79 |
| 中异质,小加中 | NRMSE↓ | 1.04 | 0.97 |
| 中异质,小加中 | 流入 / 流出 / OD 流量 JSD↓ | 0.30 / 0.26 / 0.13 | 0.28 / 0.23 / 0.11 |
| 高异质,三档都有 | CPC↑ | 0.59 | 0.62 |
| 高异质,三档都有 | RMSE↓ | 72.96 | 63.47 |
| 高异质,三档都有 | NRMSE↓ | 1.04 | 0.93 |
| 高异质,三档都有 | 流入 / 流出 / OD 流量 JSD↓ | 0.31 / 0.26 / 0.14 | 0.26 / 0.22 / 0.11 |
同一组内部,SEDAN 的 CPC、RMSE 和 NRMSE 都好于 WEDAN。低异质的流入 JSD 是例外:SEDAN 0.35,WEDAN 0.34。作者认为小城市的空间结构有限,结构引导能发挥的余地较小。这个说法对得上“流入分布这一项略差”。它对不上“SEDAN 在小城市上整体更差”,因为 CPC 仍是 0.65 对 0.62,RMSE 仍是 74.40 对 83.16。
从低异质到中异质,两个模型的 RMSE 都下降。从中异质到高异质,WEDAN 的 RMSE 从 71.48 升到 72.96,SEDAN 从 66.79 降到 63.47。因为三组包含的城市类型不同,平均 RMSE 下降可以来自新加入的城市本来就更容易或更难,不一定是同一批城市被学得更好。高异质一组的 63.47 也和主表的 63.54 不完全相同,不宜当成同一次测试。
单中心、均匀和多中心,提升出现在哪里?
论文从人口分布、OD 流量、通勤距离三个视角描述城市结构,再合成一个综合分类。每个视角先把基尼系数、赫芬达尔指数等指标标准化,用主成分分析得到分数,加权后做 K 均值聚类,分成单中心、均匀和多中心。OD 流量和通勤距离还使用最大份额、最大中介中心性;人口视角还使用帕累托指数和首位度。这是为了比较模型而做的描述性分类。类别边界依赖这套指标和聚类,不是行政区划上的法定城市类型。
| 分类视角 | 单中心 | 均匀 | 多中心 |
|---|---|---|---|
| 人口分布 | 23.80% | 34.39% | 41.81% |
| OD 流量分布 | 29.00% | 45.30% | 25.70% |
| 通勤距离 | 45.12% | 24.15% | 30.73% |
| 综合分类 | 27.99% | 30.73% | 41.28% |
四行各自相加为 100%。人口和 OD 流量上,均匀与多中心合计都超过一半。通勤距离上,单中心占 45.12%,是三种里最高的一类。同一批城市换一个视角,会进入不同类别。说多中心上提升更大时,要说明用的是哪一种分类。
按 OD 流量分类,相对 WEDAN,单中心城市的 CPC 提高 8.0%,多中心提高 12.0%。正文没有给出这两组 WEDAN 的绝对 CPC,因此这里只保留相对数。按距离分类,论文说 SEDAN 在 CPC 和 RMSE 上更好,没有给出分类型的绝对数。按人口分类,均匀城市的 CPC 略降,降幅未写;单中心和多中心仍然较好。作者把均匀城市的下降联系到缺少明确中心和主导通勤流。这是对结果的解释。均匀城市的绝对 CPC,正文没有列出。
综合分类把三种视角合在一起。多中心城市上,SEDAN 的 CPC 比 WEDAN 高 13.9%,RMSE 从 86.90 降到 38.03,OD 流量 JSD 从 0.146 降到 0.114。以 86.90 为分母,RMSE 下降 48.87,相对下降 56.2%。以 0.146 为分母,JSD 相对下降 21.9%。13.9% 的 CPC 提高没有配上绝对 CPC。这个降幅远大于主表里从 68.60 到 63.54 的全样本差距,只适用于综合分类下的多中心子集。
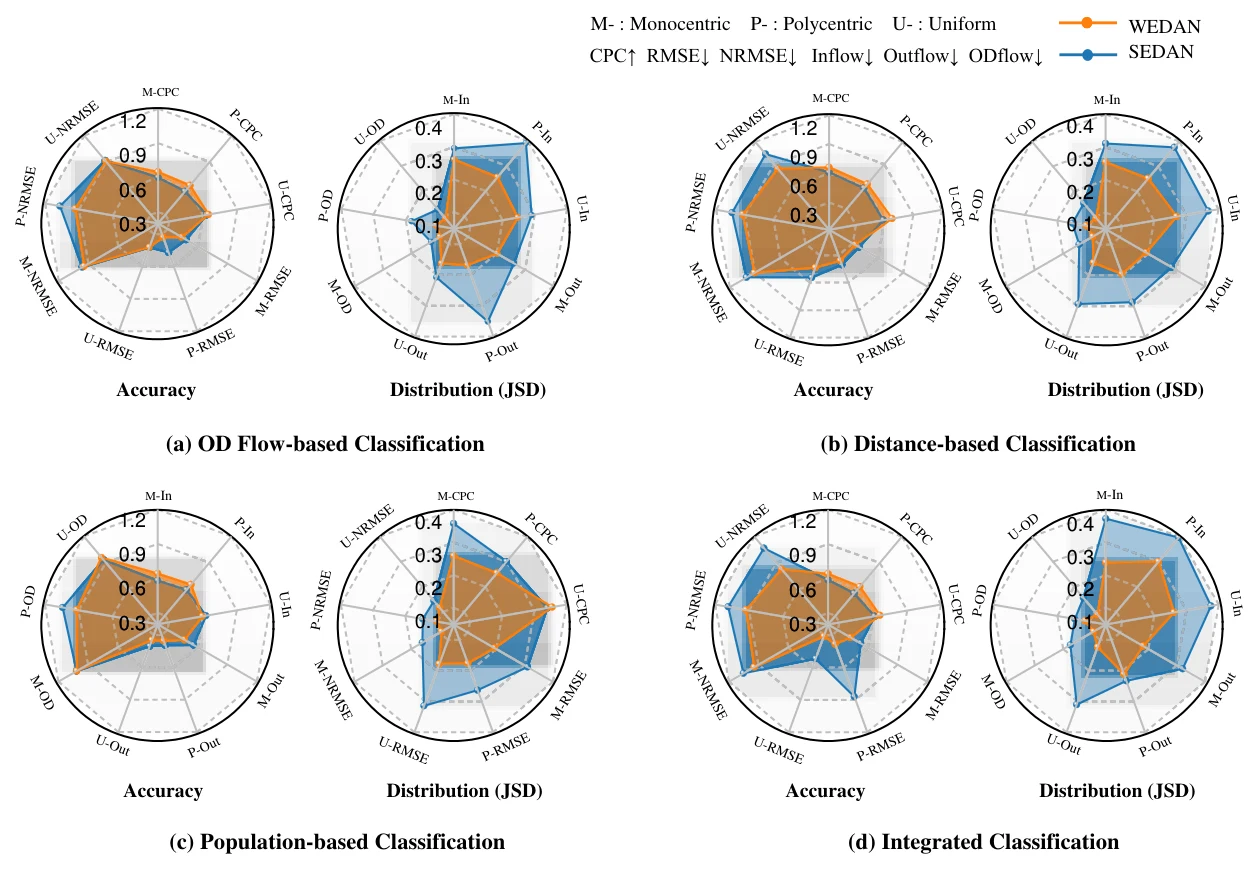
图 6|不同城市结构下,SEDAN 和 WEDAN 差在哪里?
(a)按 OD 流量分类,(b)按距离分类,(c)按人口分类,(d)综合分类。每组左边是精度雷达,右边是分布雷达。M、P、U 分别是单中心、多中心、均匀。橙色是 WEDAN,蓝色是 SEDAN。精度雷达上的 RMSE 已除以 100,读半径时要乘回 100。分布雷达的半径越大,JSD 越大。正文给出绝对数的是综合分类多中心:RMSE 86.90 对 38.03,OD 流量 JSD 0.146 对 0.114。雷达顶点没有逐一印出读数。来源:原论文 Fig. 4。
区域特征缺了一半,结构约束还能补上多少?
目标城市可能缺少细的兴趣点或人口指标。论文随机遮住 10%、30%、50% 的节点特征,再用该城市该特征的均值填上。这是随机缺失后的均值填补,不是某类设施整类消失。
| 遮挡比例 | 指标 | WEDAN | SEDAN |
|---|---|---|---|
| 10% | CPC↑ | 0.56 | 0.61 |
| 10% | RMSE↓ | 72.37 | 64.69 |
| 10% | NRMSE↓ | 1.05 | 0.95 |
| 10% | 流入 / 流出 / OD 流量 JSD↓ | 0.33 / 0.28 / 0.16 | 0.31 / 0.22 / 0.12 |
| 30% | CPC↑ | 0.55 | 0.59 |
| 30% | RMSE↓ | 74.14 | 67.24 |
| 30% | NRMSE↓ | 1.14 | 0.98 |
| 30% | 流入 / 流出 / OD 流量 JSD↓ | 0.34 / 0.31 / 0.17 | 0.32 / 0.24 / 0.13 |
| 50% | CPC↑ | 0.53 | 0.56 |
| 50% | RMSE↓ | 76.19 | 69.45 |
| 50% | NRMSE↓ | 1.15 | 1.01 |
| 50% | 流入 / 流出 / OD 流量 JSD↓ | 0.37 / 0.32 / 0.19 | 0.33 / 0.27 / 0.14 |
遮挡加重后,两个模型都变差。50% 时 SEDAN 的 CPC 是 0.56,RMSE 是 69.45,OD 流量 JSD 是 0.14;WEDAN 是 0.53、76.19 和 0.19。以 WEDAN 的 76.19 为分母,RMSE 相对低 8.8%。论文写 SEDAN 的 CPC 在各遮挡比例下保持在 0.56 以上;表 5 在 50% 处的数值就是 0.56。
10% 遮挡时 SEDAN 的 CPC 也是 0.61,RMSE 是 64.69,和主表的 0.61、63.54 接近。遮挡实验和主实验是否使用同一批城市,论文没有说明,两个 0.61 不宜记成同一次运行。
作者认为邻接和距离在语义损坏时仍提供结构约束。消融确实显示空间先验有贡献。这次实验同时改变了被填补的特征,不能单独证明性能差距就是邻接补回来的那一部分。
去掉邻接、距离、兴趣点或扩散,各自掉在哪里?
消融有六个变体:去掉邻接、去掉距离、两者都去掉、去掉兴趣点、去掉扩散并改为图变换器直接预测、以及保留空间输入但去掉论文的融合方式、只把空间先验当作边特征。图 7 上完整模型的 CPC 是 0.62,RMSE 是 63.40。主表是 0.61 和 63.54,流出 JSD 也是主表 0.21、消融图 0.22。下面的比较都用图 7 自己的完整模型做分母。
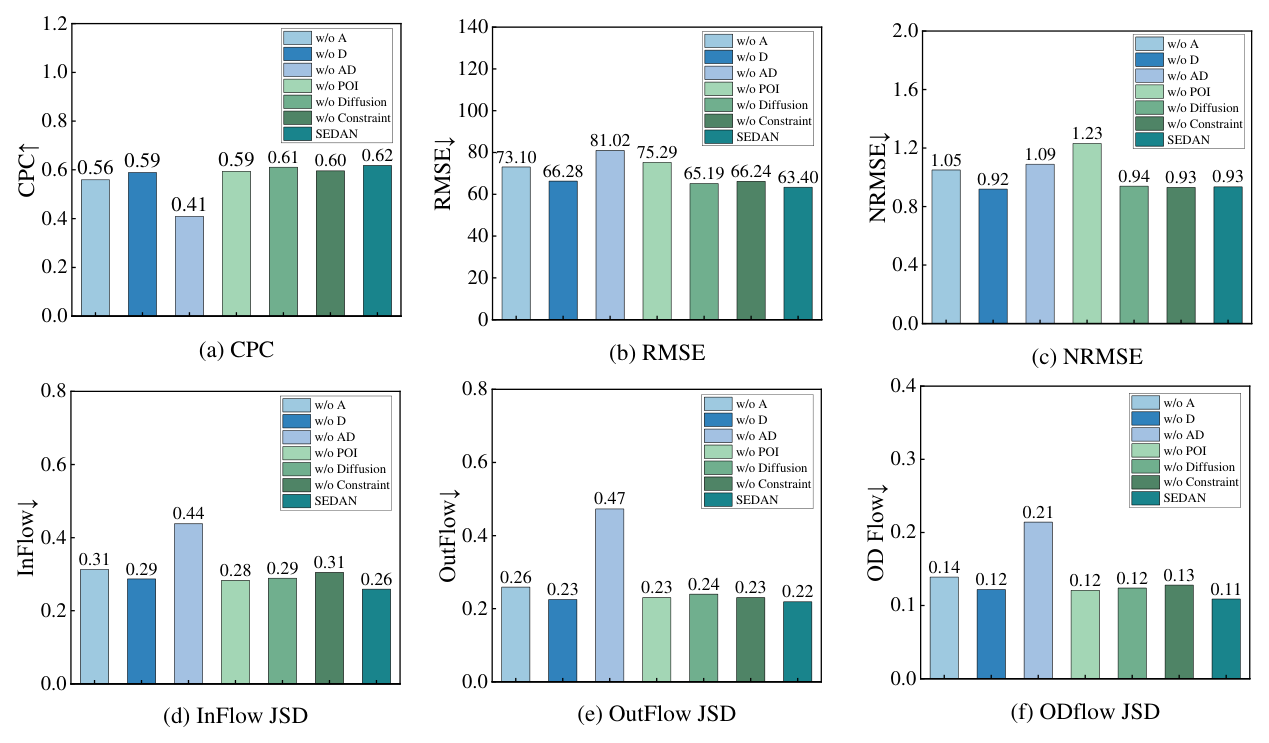
图 7|哪一种信息拿掉以后,生成质量掉得最明显?
(a)CPC,越高越好。(b)RMSE,越低越好。(c)NRMSE。(d)流入 JSD。(e)流出 JSD。(f)OD 流量 JSD。每组从左到右是去掉邻接、去掉距离、两者都去掉、去掉兴趣点、去掉扩散、去掉融合约束、完整 SEDAN。两者都去掉时 CPC 为 0.41、RMSE 为 81.02。完整模型是 0.62 和 63.40。去掉距离后的 NRMSE 是 0.92,略低于完整模型的 0.93。来源:原论文 Fig. 5。
只去掉邻接,CPC 0.56,RMSE 73.10,流入 JSD 0.31。只去掉距离,CPC 0.59,RMSE 66.28,流出 JSD 0.23,NRMSE 0.92。两者都去掉,CPC 0.41,RMSE 81.02,流入 JSD 0.44,流出 JSD 0.47,OD 流量 JSD 0.21。一起去掉的伤害大于只去掉其中一项,说明在这个网络里,邻接和距离承担的是互补的约束。只去掉距离时 NRMSE 略好于完整模型,所以并不是六项指标同时变差。
去掉兴趣点,CPC 0.59,RMSE 75.29,NRMSE 1.23。以完整模型的 63.40 为分母,RMSE 相对上升 18.8%。兴趣点对人数误差的影响,大于去掉扩散带来的影响。
去掉扩散、直接预测时,CPC 0.61,RMSE 65.19,流入 JSD 0.29,流出 JSD 0.24,OD 流量 JSD 0.12。人数误差仍接近完整模型,分布散度更大。扩散在这里多恢复的是流量分布,幅度是流入 JSD 从 0.29 到 0.26 这一档,不是把 RMSE 砍掉一半。论文认为离线的交通规划和公共卫生建模可以承受额外计算。它可以接受的时间上限,正文没有给出。
去掉融合、只把空间先验当作边特征时,CPC 0.60,RMSE 66.24,流入 JSD 0.31。完整输入还在,结果仍差于按注意力偏置和距离条件注入的完整模型。这支持“怎样接入空间信息”会影响结果。论文只比较了这一种去掉融合的做法。
模型在解释平均流出时,看重哪些区域属性?
SHAP 用来分解特征对模型输出的贡献。解释目标是一个目标区域的预测平均流出。特征被拿掉时,用从多座城市节点属性中抽到的背景值替换,避免直接填 0。图上的数是平均绝对 SHAP。越大,表示该特征对这个输出的贡献越大。它解释的是模型输出。论文没有写明平均流出处在对数尺度还是还原后的人数,因此 4.6974 不能读成 4.70 个通勤者,也不能读成因果效应。
人口特征取贡献最高的 20 个,分成年龄、教育、交通资源、经济与家庭四组,个数是 7、5、4、4。
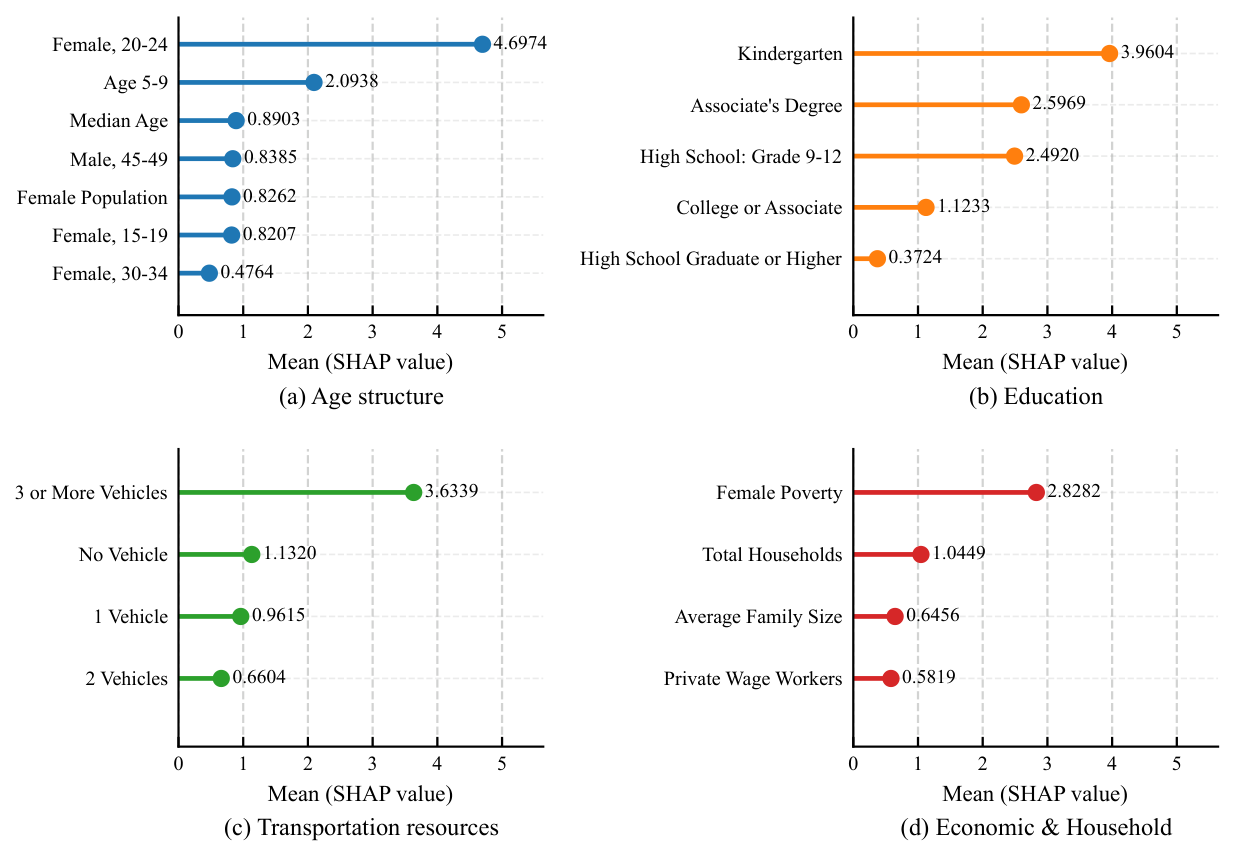
图 8|预测平均流出时,哪些人口属性贡献较大?
(a)年龄:20–24 岁女性 4.6974,5–9 岁 2.0938,中位年龄 0.8903,45–49 岁男性 0.8385。(b)教育:幼儿园 3.9604,副学士学位 2.5969,9–12 年级高中 2.4920。(c)交通资源:3 辆及以上车 3.6339,无车 1.1320,1 辆车 0.9615,2 辆车 0.6604。(d)经济与家庭:女性贫困 2.8282,家庭总数 1.0449,平均家庭规模 0.6456,私营部门受雇者 0.5819。横轴是平均绝对 SHAP。来源:原论文 Fig. 6。
作者认为 20–24 岁女性的高贡献,可能对应年轻人口的通勤,以及女性较多从事教育、医疗等通勤较规律的行业。5–9 岁和 15–19 岁女性,被他们读成年轻家庭的间接信号。中位年龄、45–49 岁男性和 30–34 岁女性,被读成中年劳动力的稳定通勤。这些是对 SHAP 排序的解释。模型没有把年龄、行业和家庭规模拆开做对照,相关的区域属性会一起变化。
交通资源里,3 辆及以上车最高,无车也高于 1 辆和 2 辆。作者把前者联系到出行更灵活,把后者联系到更依赖公共交通。经济与家庭里,女性贫困最高,家庭总数和平均家庭规模被用来表示通勤需求的规模。这些同样是解释,不是分组实验的结果。
兴趣点另画一张图,取前 10 个。横轴尺度大约到 1.75,和人口图大约到 5 的尺度不同。1.8169 和 4.6974 不能直接比成“兴趣点不如年龄”。
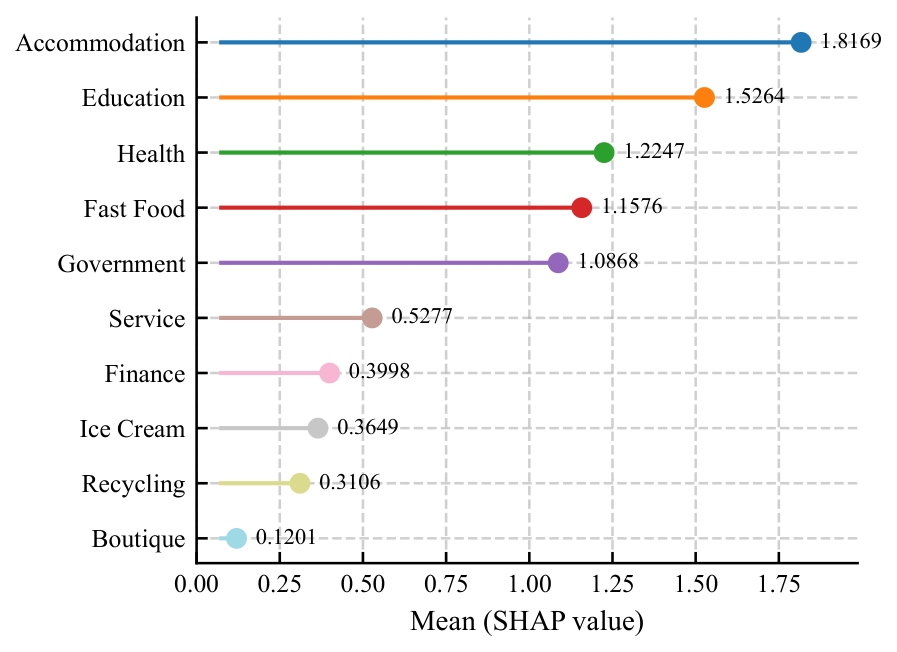
图 9|哪些兴趣点类别对预测平均流出贡献较大?
无字母子图。前五位是住宿 1.8169、教育 1.5264、医疗 1.2247、快餐 1.1576、政府 1.0868。其后是服务 0.5277、金融 0.3998、冰淇淋 0.3649、回收 0.3106、精品店 0.1201。横轴是平均绝对 SHAP。来源:原论文 Fig. 7。
作者把住宿读成居住区,并认为居住区是通勤的主要起点;教育、医疗和政府被联系到城市中心;快餐被联系到繁忙地区;冰淇淋、回收和精品店被看作非核心设施。图上的类别名是 Accommodation。正文没有列出这个类别在数据里包含哪些设施,所以“居住区份额”还不是这张图测到的量。
浅层注意力贴着邻居,深层还贴吗?
案例比较各层注意力、邻接矩阵,以及由直线距离得到的相似度。距离越近,相似度越高。相关在非对角元素上计算,论文把皮尔逊相关记为 P。区域索引从 0 标到 16。论文没有给出城市名称,也没有说明为什么选这个例子。热图画在对角线的一侧。
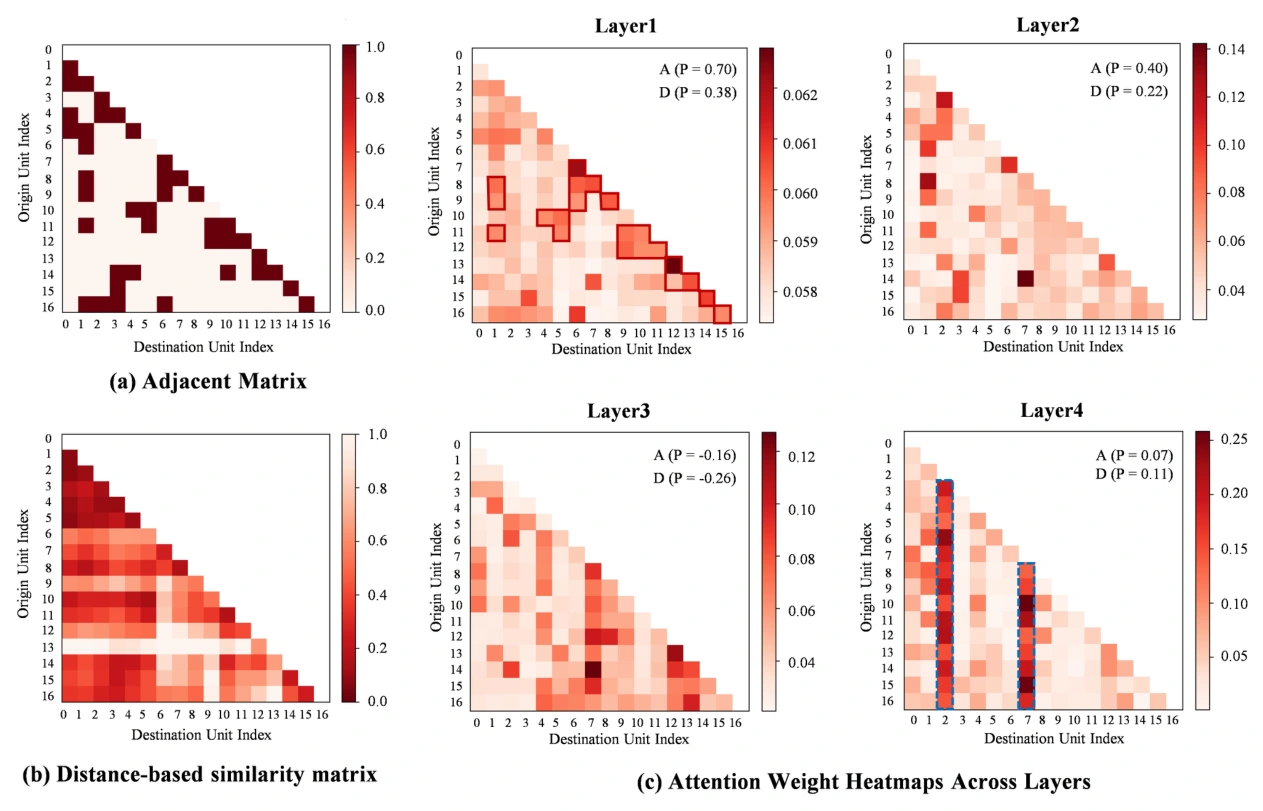
图 10|注意力是否先贴近邻接,再离开邻接?
(a)二值邻接矩阵,深色表示相邻。(b)距离相似度,颜色越深表示越近。(c)四层注意力。第 1 层与邻接的相关 P = 0.70,与距离相似度 P = 0.38。第 2 层是 0.40 和 0.22。第 3 层是 −0.16 和 −0.26。第 4 层是 0.07 和 0.11,蓝色虚线框标出两个被多个起点关注的目的地区域。颜色深浅是注意力或相似度,不是通勤人数。来源:原论文 Fig. 8。
第 1 层与邻接的相关最高。正文说若干高注意力区域与邻接矩阵吻合,并用红色实线框标出。第 2 层两项相关都下降。第 3 层转为负相关,模型不再主要沿邻近关系分配注意力。第 4 层的相关接近 0,多个起点的注意力汇到两个目的地区域。
这是一个例子里的模型内部注意力。它支持“浅层更受空间先验引导,深层出现少数被反复关注的目的地”这一读法。它没有证明这座城市有两个就业中心,也不能代表 3233 个空间单元上的普遍层级。
更慢的采样,换来的层数和步数是否稳定?
附录用 DDIM 的 100 步,比较 SEDAN、WEDAN 和回归模型 GMEL 的平均推理时间。横轴是节点数,纵轴是秒。图上没有逐点标出秒数。能看清的是节点增多以后,SEDAN 和 WEDAN 一起上升,并且高于 GMEL;两条扩散曲线彼此接近。横轴延伸到约 900 个节点。正文定义的大型城市是 51–100 个区域,和这张图的横轴不是同一份城市名单。作者认为对离线生成,增加的计算可以接受。图支持扩散模型比这个回归基线更慢,没有给出业务上可接受的秒数。
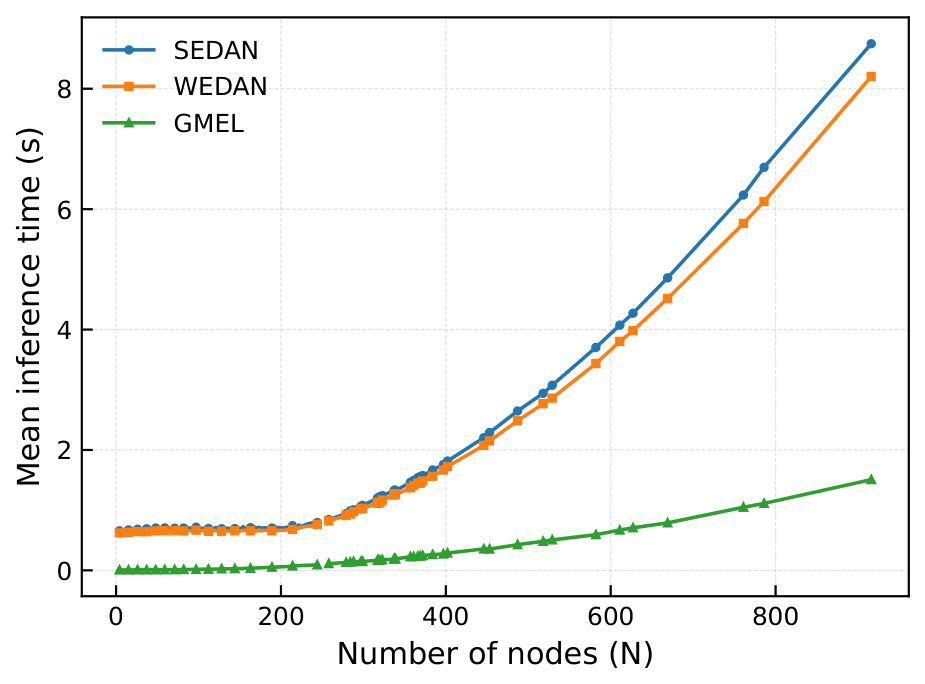
图 11|城市节点变多时,生成要多花多少时间?
无字母子图。蓝线 SEDAN,橙线 WEDAN,绿线 GMEL。横轴为节点数,纵轴为平均推理时间,单位是秒。扩散模型随节点数上升更快。图中没有逐点秒数。来源:原论文 Fig. C.11。
层数试了 2 到 6。正文说从 2 层增到 4 层时,CPC、RMSE 和 OD 流量 JSD 都改善;增到 5 层或 6 层后不再提升,并略有波动,因此默认 4 层。扩散步数试了 200、500、1000 和 1500。正文说 1000 步的 CPC 最高,RMSE 和 OD 流量 JSD 最低;1500 步没有继续变好。两张折线都没有印出每个点的精确读数,纵轴也不是从 0 起绘,视觉斜率不宜代替正文的选择结论。
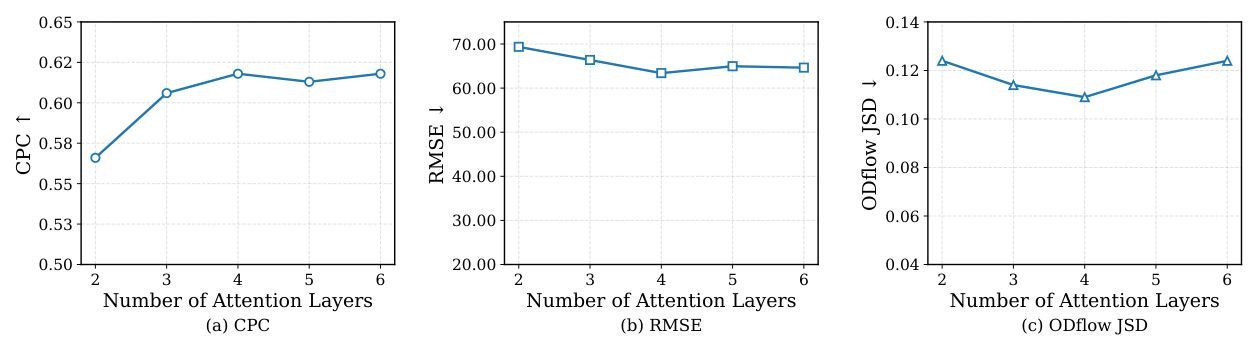
图 12|图变换器叠到几层比较合适?
(a)CPC,越高越好。(b)RMSE,越低越好。(c)OD 流量 JSD,越低越好。横轴是 2 到 6 层。折线没有逐点读数。正文的结论是 4 层之后不再稳定变好。来源:原论文 Fig. D.12。
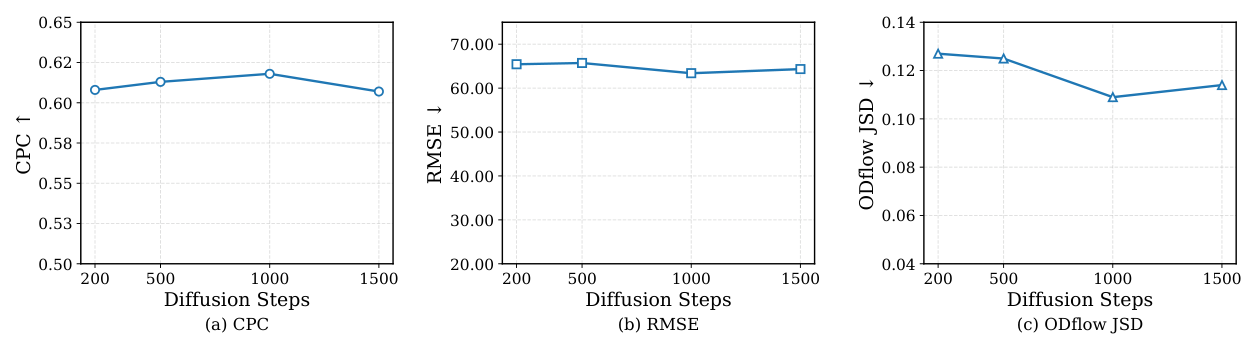
图 13|扩散步数增加到 1000 以后还有没有收益?
(a)CPC。(b)RMSE。(c)OD 流量 JSD。横轴为 200、500、1000、1500 步。折线没有逐点读数。正文的结论是 1000 步最好,1500 步没有进一步收益。来源:原论文 Fig. D.13。
这些比较还能支持到哪里?
SEDAN 在这套美国通勤矩阵上,相对 WEDAN 降低了人数误差,并让流入、流出和流量分布更接近记录。优势在综合分类的多中心子集里更大,在只含小城市时并非每一项分布指标都更好。邻接和距离一起去掉时,同一张消融图上的重叠和误差明显变差。兴趣点主要影响人数误差,扩散主要影响分布散度,而且后者的幅度有限。
证据停在区域对的生成质量。2018 年的矩阵是静态的,没有节假日、事件和日内变化。空间约束只有邻接和直线距离,路网、公交和过河都没有进入模型。论文假设人口和设施等特征在城市之间语义一致;统计口径不同时,这个假设会松动。数据只来自美国城市。多中心子集上从 86.90 到 38.03 的 RMSE 变化,发生在这套分类内部。
8:1:1 的划分没有写明是否整座城市留出。主表和消融图的完整模型数字不完全相同。五次实验只报告平均,0.02 的 CPC 差距没有配上标准差。表 A.6 和图 10 的零流量比例对不上,相邻高流量比例也不是通勤总人数的份额。SHAP 排序和一层注意力热图解释的是模型内部,不是居民的选择机制。
一句话总结
只把区域功能和邻接、距离交给模型,可以在这套美国通勤数据上生成比强扩散基线更接近记录的出发地—目的地矩阵;这种接近是区域对上的重叠、误差和分布,并且还停在美国城市与论文自己的结构分类之内。
核心来源
- arXiv:2605.00938v1,2026年5月1日预印本。题目、作者、机构和全部数值以这一版 PDF 为准。首页与文末没有印 DOI。
- 数据基准的论文条目:Can Rong、Jingtao Ding、Yan Liu、Yong Li,A large-scale dataset and benchmark for commuting origin-destination flow generation,ICLR 2025。本文将其写作 LargeCommuingOD,并引用为 [21]。
- 本文图 1、图 2 对应附录 Fig. A.9、Fig. A.10;图 3–10 对应正文 Fig. 1–8;图 11–13 对应 Fig. C.11、Fig. D.12、Fig. D.13。附录 A–E 都在同一份预印本里。
- 论文给出的代码地址为 https://anonymous.4open.science/r/SEDAN。
作者介绍
- Bin Chen:共同第一作者。论文署名为电子科技大学智能计算研究所。
- Zhuoya Meng:共同第一作者。论文署名为电子科技大学智能计算研究所。
- Fang Yang:论文署名为国防科技大学系统工程学院。
- Runkang Guo:论文署名为国防科技大学系统工程学院。
- Jingtao Ding:论文署名为清华大学电子工程系、北京信息科学与技术国家研究中心。他是本文数据基准论文的作者之一。其公开主页把研究方向写为时空数据挖掘、复杂网络与用户行为。
- Yin Zhang:论文署名为电子科技大学信息与通信工程学院。
- Chuan Ai:论文署名为国防科技大学系统工程学院,并标为通讯作者。
- Zhengqiu Zhu:论文署名为国防科技大学系统工程学院,并标为通讯作者。首页脚注给出的邮箱是 zhuzhengqiu12@nudt.edu.cn。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
综合分类的多中心子集里,RMSE 从 86.90 降到 38.03;全测试平均只是从 68.60 降到 63.54。若多中心城市的真实矩阵更不均匀,少数大流量区域对就会主导平方误差,一个更会对准大流量的模型会在 RMSE 上显得进步很大。NRMSE 在主表里反而从 0.88 升到 0.93,已经提示人数误差和相对起伏不是同一件事。下一步应在同一结构类型里,按流量分位分别计算 CPC 和 RMSE。如果大流量对的误差下降,小流量和长距离对的重叠没有上升,规划上更该关心的走廊并没有一起变准。
另一件可以单独检验的事是缺失值的填法。实验用城市均值填上被遮住的特征。就业中心若正好缺少兴趣点,填成全市平均,会把中心抹成普通区域。人口分类下的均匀城市,SEDAN 的 CPC 已经略降。对数据稀缺的城市,均值填补可能先制造一种更均匀的输入,再让结构约束去生成流量。部署前应比较三种输入:真实特征、均值填补,以及明确标记缺失、不把缺失伪装成平均水平。这三套输入的差别,论文没有报告。