人不走同一条路,为什么还会过同一种日子?
论文名片|Fengli Xu、Tong Xia、Hancheng Cao、Yong Li、Funing Sun、Fanchao Meng,Detecting Popular Temporal Modes in Population-scale Unlabelled Trajectory Data,Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies,2018,2(1),Article 46(2018年3月,25页)。DOI:10.1145/3191778。本文依据这一正式发表版。
工作日大约八点半离开一处、十八点半回到另一处,周末几乎不动。这样的一天在北京和上海都大量出现,两条轨迹却可以完全没有重合的地点。按路线是否挨在一起来分组,这些日子会被拆开。
这篇论文改问另一件事:不计人在哪条路、哪栋楼,只看一天里哪些时段待在同一处。这样切出来的群体时间模式(temporal mode),在两座城市里都能找到少数几种反复出现的切法。最常见的一种都超过四分之一。它和兴趣点、手机应用、自报职业有统计上的对应,但对应停在群体比例,到不了给一个人判定职业。
先说结论
- 北京和上海的各10万名用户里,各得到8种主要时间模式,其中6种两边相似。人数图上,北京模式1占28%,上海模式1占28.6%,都超过四分之一;这些百分比在各自城市内加总为100%。
- 北京模式1在工作日8:30–18:30的公司、政府平均到访次数,分别是全体用户平均次数的2.52倍和2.84倍(p≤0.01)。检验用的是每类与该类最相似的2,500人,不是全城普查。
- 美国住户出行调查的11,712人里,早开工模式中,制造、建筑、维修和农业占该模式的79.3%;朝九晚五模式里,专业、管理和技术占47.7%,文职支持占45.6%。分母都是该模式内的人数。
- 用时间模式对照职业时,归一化互信息从基线的0.129升到0.292,相对基线提高126.4%;对照兴趣点时从0.008升到0.017,提高112.5%。分数本身仍远离1。
为什么路线重合会把相似的日子拆开?
既有轨迹聚类多按时空点是否叠在一起、子轨迹是否重合来分组。两条日程相同、但分别发生在城市两端的轨迹,几乎不会共享坐标,于是被当成不同的移动。反过来,同一家餐馆对顾客是吃饭、对厨师是上班,只看兴趣点类型也会把不同的日子并在一起。
时间模式要保留的是:一个人如何把时间分配到自己的不同地点。同一地点对同一个人通常意味着相近的情境,对不同的人则不必相同。因此表示方法先丢掉具体坐标,只保留“哪些时段属于同一处”。
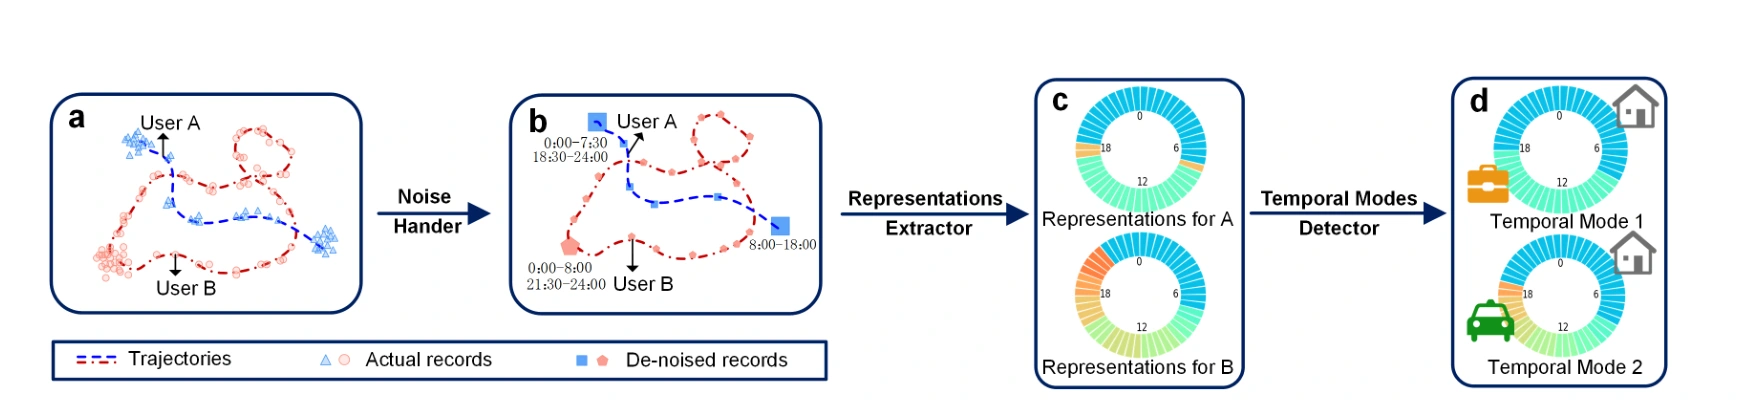
图 1|从原始点到群体时间模式,中间丢掉了什么?
(a)两人的原始轨迹可以在空间上分开,蓝、红只区分人。(b)靠近的原始点被收成少数几处停留;图上的钟点是示意,不是后文检测出的模式边界。(c)颜色相同的时间片被放进同一子集,地点坐标不再进入表示。(d)右端的房子、公文包和汽车是示意图标,用来表示检测之后人们可能怎样理解这些切法,不是数据里自带的地点类型。来源:原论文 Fig. 1。
定位误差会让同一次停留散成一簇略有差别的坐标。若把每个坐标都当成新地点,一天会被切得过碎。系统先把空间上靠在一起、属于同一次停留的记录收成同一处,再做时间划分。图2只说明这件事的前后差别,不涉及如何从匿名数据追回某一个人。
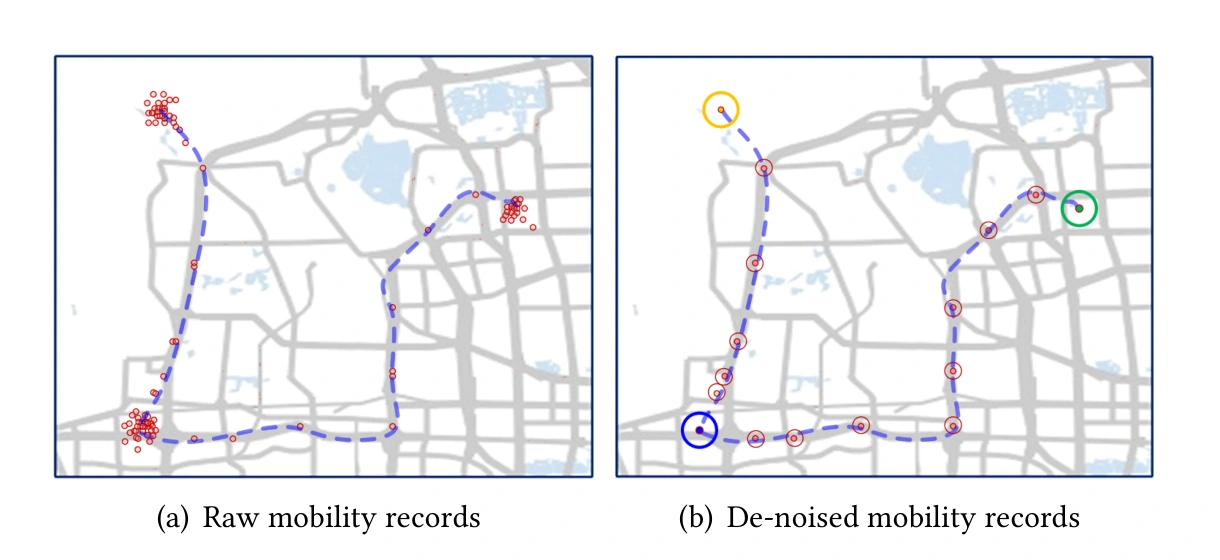
图 2|同一处停留,为什么不能按每个坐标分开?
(a)原始记录在三个停留附近散成点云,虚线连接时间顺序。(b)每处停留收成一个位置后,沿途的过渡点也更清楚。颜色区分不同停留,不是人口密度。来源:原论文 Fig. 2。
三套数据量的不是同一种地点
三套数据都用来找群体时间模式,但地点的含义不同。
| 数据 | 地点从哪来 | 时间 | 人数 | 其中有职业记录的人数 |
|---|---|---|---|---|
| 北京手机应用 | 手机定位,主要是GPS,可关联兴趣点 | 2016年9月17日–10月31日 | 100,000 | 103名志愿者自报 |
| 上海蜂窝网络 | 基站;上网请求可关联应用类型 | 2016年4月1日–7日 | 100,000 | 0 |
| 美国住户出行调查 | 受访者自己填写的地点标签,如家、办公室 | 2008年3月–2009年3月,每人一天 | 11,712 | 11,712 |
北京兴趣点有10类:居住、学校、生活服务、景点、公司、酒店、医院、政府、休闲、餐饮。上海应用有9类:新闻、休闲、社交、生活服务、交通、电商、金融、商务、旅行。图5的纵轴是记录条数的对数坐标,柱顶没有印出精确数字,正文也没有列表,因此这里不把柱高写成精确次数。可以看出的是排序:北京居住类记录最高、餐饮类最低;上海新闻、休闲、社交高于金融、商务和旅行。
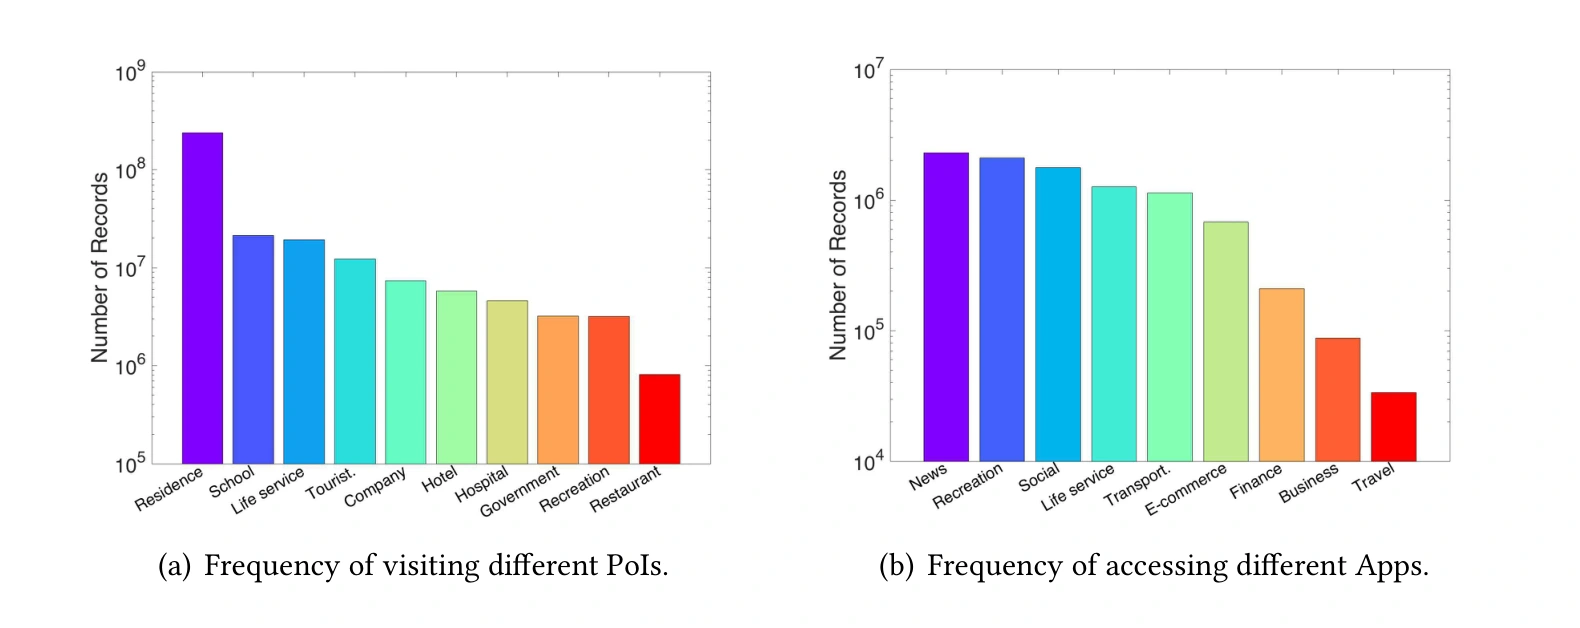
图 5|兴趣点和应用,各有多少条记录挂在轨迹上?
(a)北京10类兴趣点,纵轴为记录条数的对数。(b)上海9类应用,同样是对数坐标。柱高不能直接相减得到倍数,因为刻度不是线性的,而且没有标出精确值。来源:原论文 Fig. 5。
职业分布也只在图6里以柱高呈现。北京这103人中,白领那根柱子最高,落在30与40之间,图上没有标出确切整数。美国五类职业画在对数坐标上,柱顶同样没有数字;正文只确认总人数是11,712,以及类别为销售服务、文职行政支持、制造建筑维修农业、专业管理技术和其他。
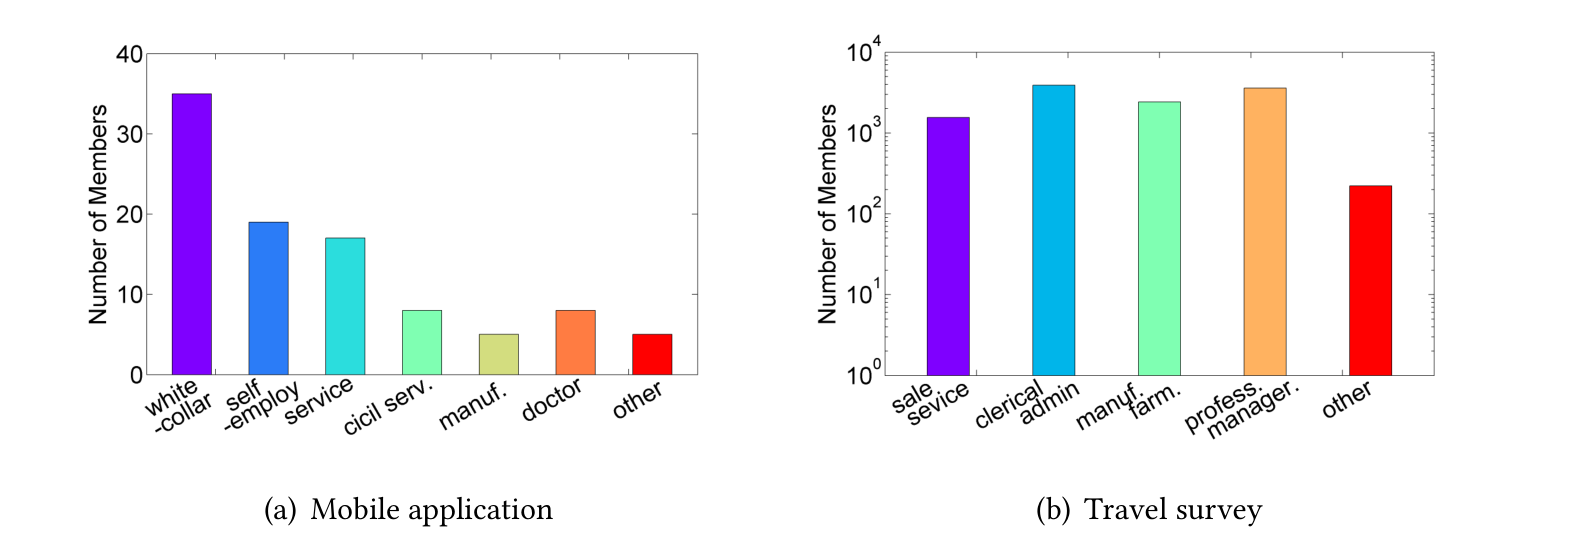
图 6|自报职业在两个样本里各有多少人?
(a)北京103名志愿者,纵轴是人数的线性坐标。(b)美国11,712人,纵轴是对数坐标。两图都没有在柱顶标出整数,不能把柱高读成精确职业人数。来源:原论文 Fig. 6。
手机应用和蜂窝数据里,工作日与非工作日被合成两个典型日。非工作日包括周末和假日。每个典型日切成48个30分钟时间片,每片取该人在这个时段最常出现的地点。时间片为空的人被去掉,正文说这样的人数可以忽略。美国调查每人只有一天,而且是自报的一个工作日,所以没有周末钟面,也不需要把散开的坐标收成停留点。
标识符在提供给研究之前已被替换成随机序列,使用受到应用厂商和运营商的授权与保密约束。下面的结果都是群体比例,不是对某条轨迹的还原。
相似度只看时间怎么切,不看人在哪
一个人的时间模式,是把48个或96个时间片分成若干组:待在同一处的时间片进同一组。两人的分区距离,是至少要拿掉多少个时间片,剩下的分组才完全一样。距离小,表示两人把一天分给不同地点的方式接近,即使这些地点相距很远。
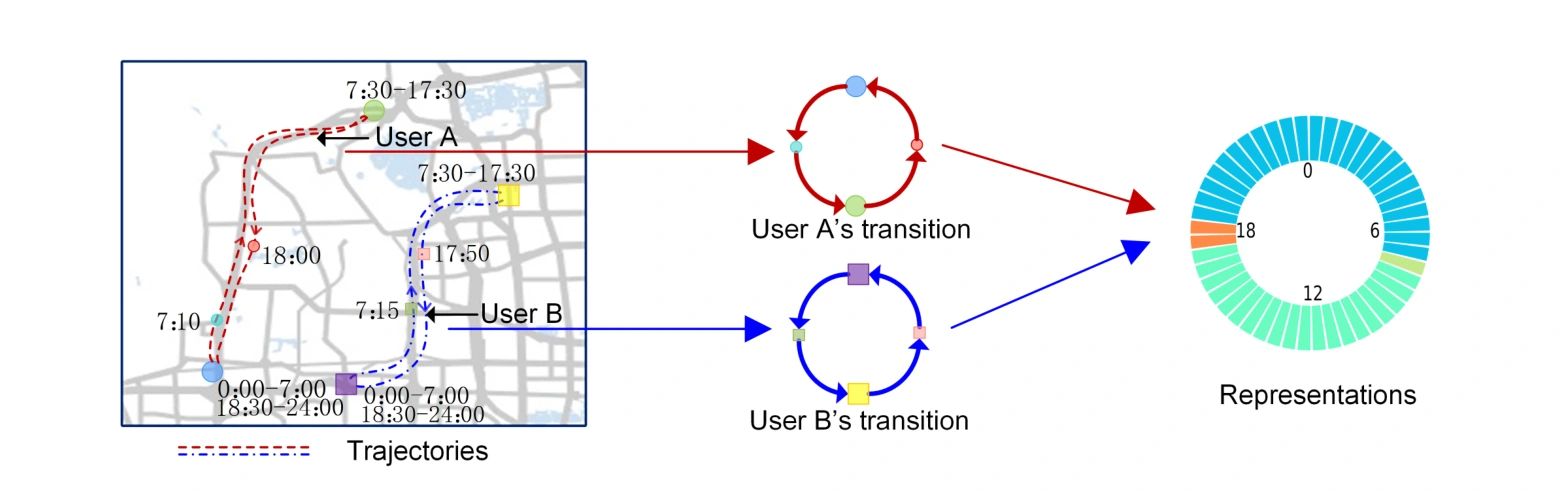
图 3|两条不相交的路线,怎样变成同一种时间切法?
左图是示意轨迹,上面的钟点是例子,不是实测统计。中间把停留连成转移。右图用颜色表示哪些时间片属于同一处;A与B的具体地点不同,时间切法可以相同。来源:原论文 Fig. 3。
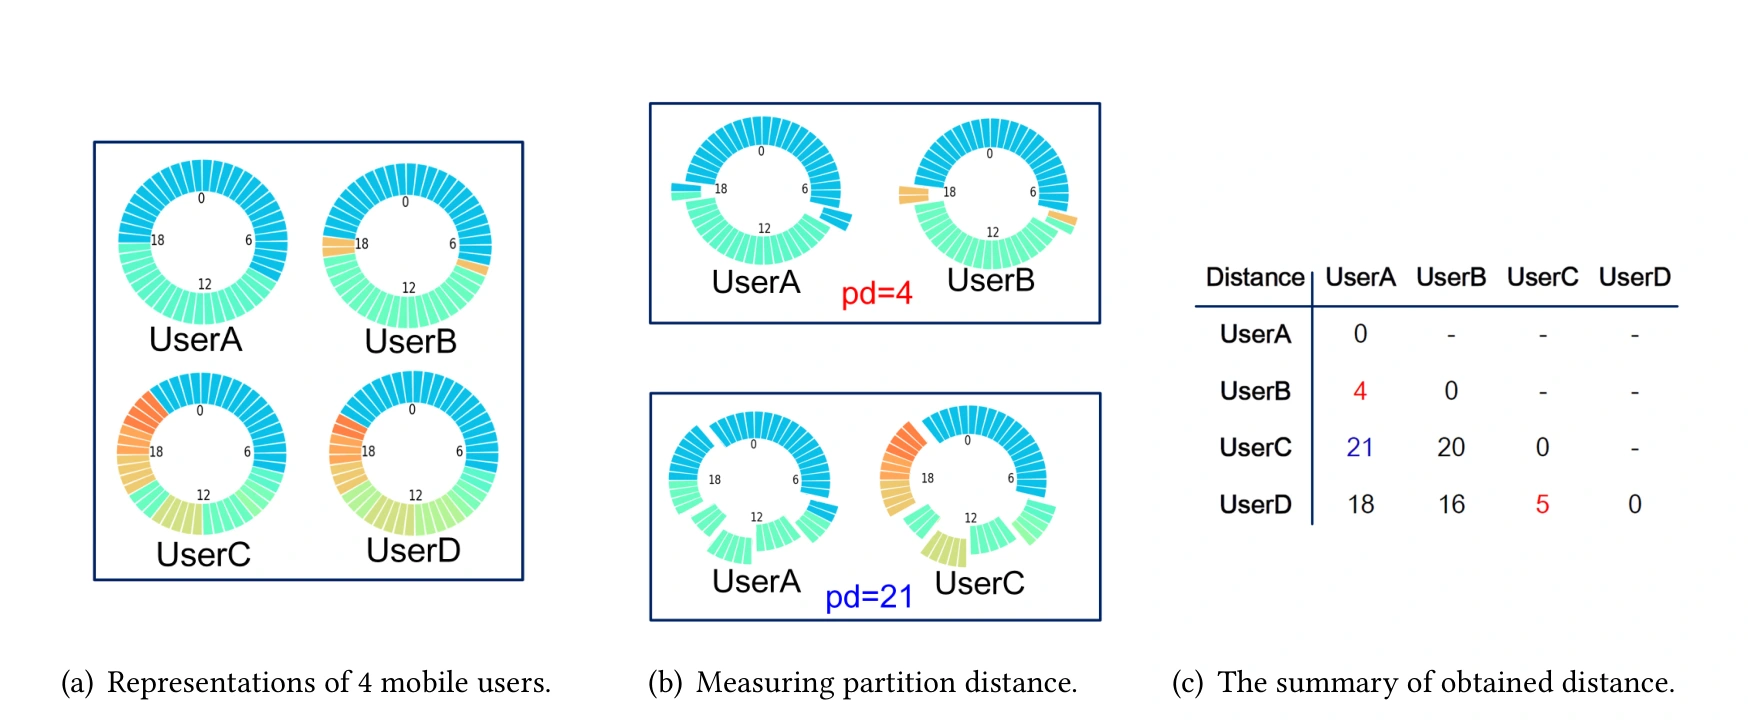
图 4|时间切法的距离,在例子里是多少?
(a)四个示意用户的钟面。(b)A与B只差很少几片,距离标为4;A与C差得更多,距离标为21。(c)距离表是这个例子的结果:A–B为4,B–C为20,A–C为21,A–D为18,B–D为16,C–D为5。正文没有写明这张示意图的时间片总数,所以21不是21%。这些数字也不是北京或上海样本的统计。来源:原论文 Fig. 4。
因为时间划分不能做算术平均,每一类的代表是类里某一个真实的切法:它到同类其他人的距离之和最小。类数取仍然能分出稳定、彼此可区分模式的最大个数。正文没有给出试过的类数列表,也没有给出稳定性的数值标准。北京和上海各保留8类,美国调查保留5类。
两座城市各有八种主要切法,六种两边都有
钟面每一小格是30分钟。同色表示这些时段待在同一处,不表示家、公司或任何兴趣点类型。北京8种见图7。表4把它们收成用于后续检验的时间块,比“大约八点”更明确。
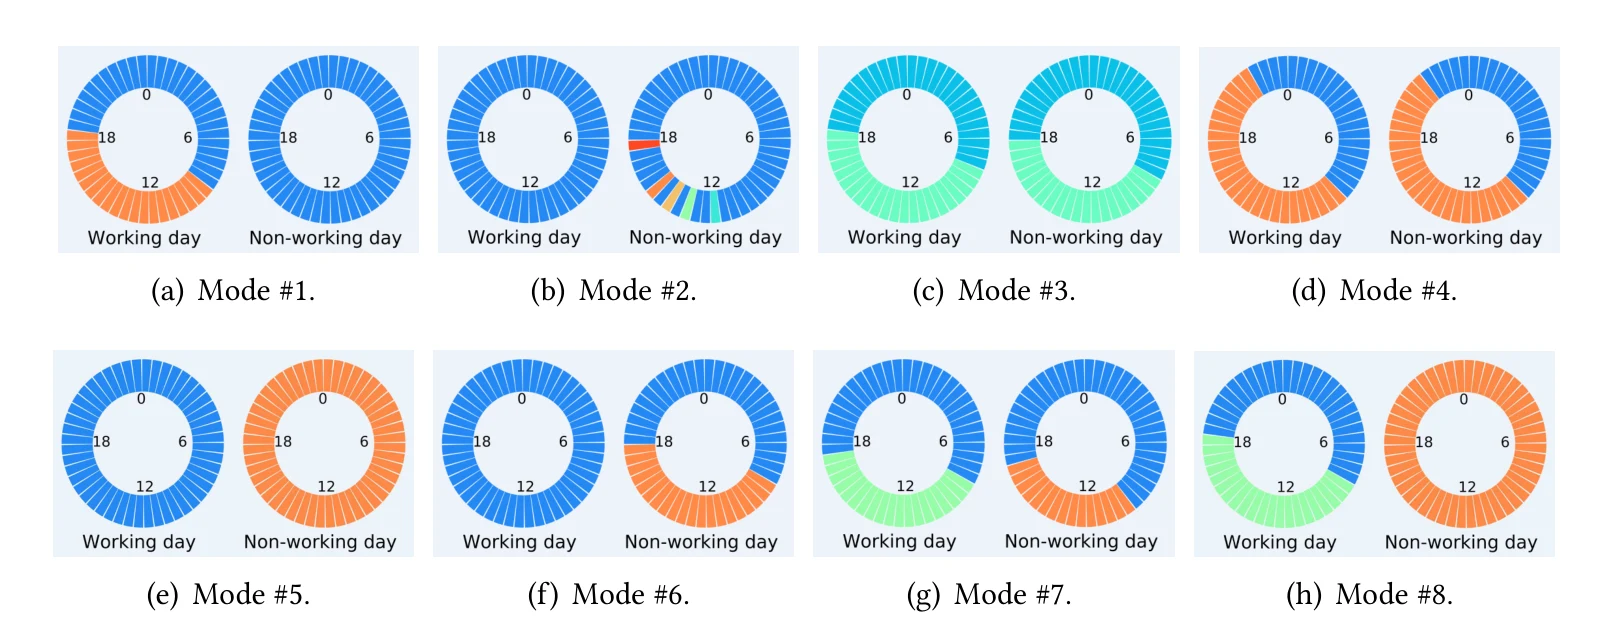
图 7|北京的八种主要时间切法长什么样?
(a)模式1:工作日8:30–18:30为一处,工作日夜间与整个非工作日为另一处。(b)模式2:工作日几乎不换地方;非工作日18:00–11:30为一处,11:30–18:00为另一处。(c)模式3:工作日和非工作日都有白天外出、夜间返回,白天大约从7:30或8:00到18:00或18:30。(d)模式4:两天都是长白天,约9:00到21:30或22:00。(e)模式5:工作日一整圈同色,非工作日换成另一种颜色。(f)模式6:工作日不动,非工作日8:00–18:00外出。(g)模式7:工作日8:00–17:30与非工作日9:30–17:30颜色不同。(h)模式8:工作日白天外出,整个非工作日换成另一处。来源:原论文 Fig. 7。
上海的钟面见图8。前六种与北京相似。后两种在钟面图里编号为9和10,不在北京出现。模式9夜间留在一处,白天不断换地点,工作日和非工作日都如此。模式10则是工作日与非工作日的夜间地点不同,白天地点也不同。
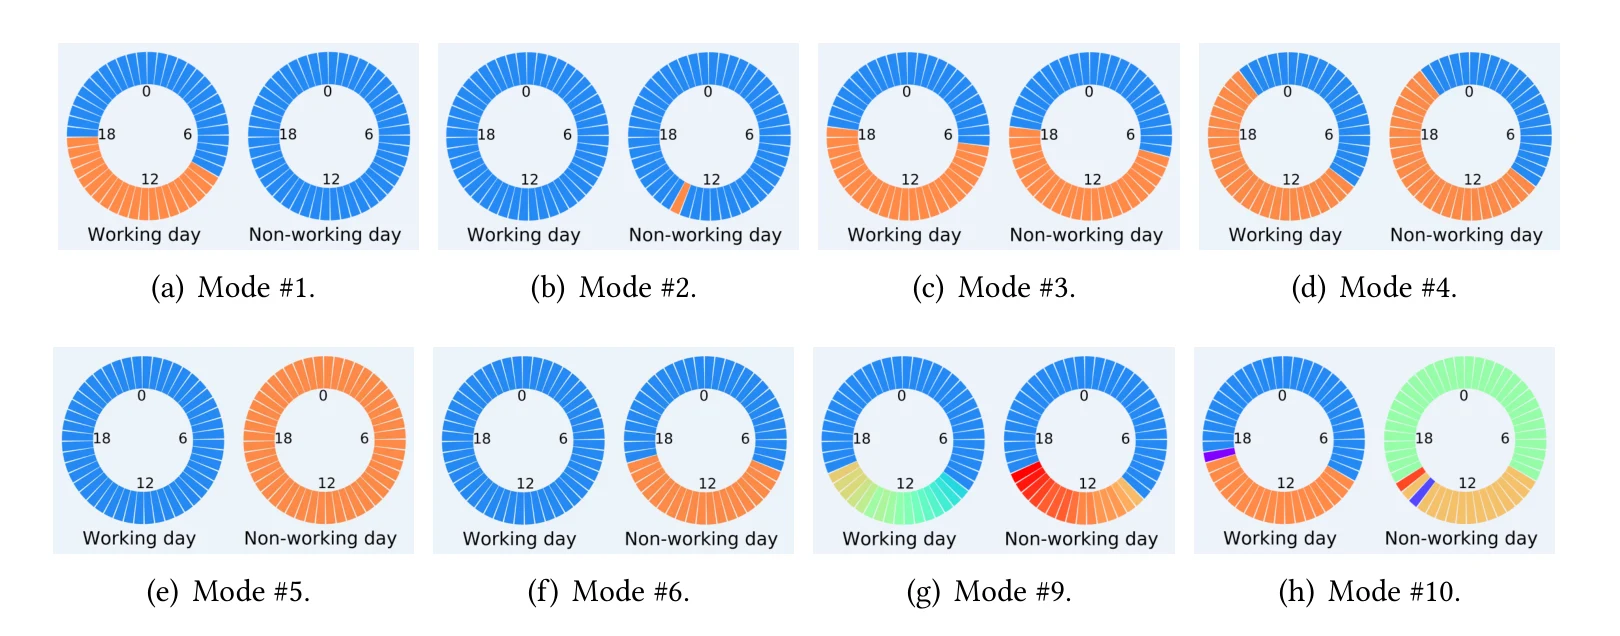
图 8|上海哪些切法与北京相同,哪些只在一边出现?
(a–f)模式1至6,分别对应通勤日与静止周末、两天都少移动、两天都按白班外出、两天都是长白天、工作日与非工作日各待一处、只在非工作日白天外出。(g)模式9:夜间同色,白天被切成许多短片。(h)模式10:两个钟面的夜间和白天都换成不同颜色。来源:原论文 Fig. 8。
人数见图9。纵轴是人数,单位为10^4人;柱顶印的是百分比。两组百分比各自加总为100%。样本各为10万名用户,正文说因空时间片被滤掉的人数可以忽略。按这个口径换算,北京模式1的28%约为2.8万人,上海模式1的28.6%约为2.86万人。
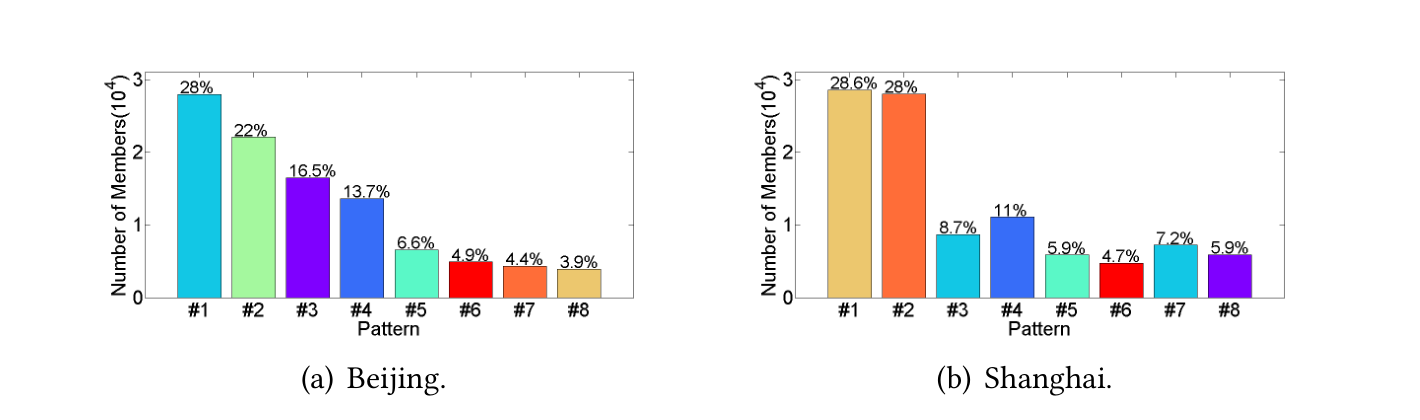
图 9|八种切法各占多少人?
(a)北京,自左至右为28%、22%、16.5%、13.7%、6.6%、4.9%、4.4%、3.9%。(b)上海,自左至右为28.6%、28%、8.7%、11%、5.9%、4.7%、7.2%、5.9%。上海第三高的是图中的模式4(11%),不是模式3(8.7%)。这张图的横轴两城都写成模式1至8;钟面图却把上海后两种写成模式9和10。正文没有给出两套编号的对照,读人数时以这张图自己的编号为准,不要把上海横轴上的模式7当成北京的模式7。来源:原论文 Fig. 9。
上海模式2占28%,和模式1的28.6%几乎一样多。模式2是两天都很少换地方。只记住“超过四分之一的人过朝九晚五”,会漏掉另一群同样规模、白天基本不移动的人。
人多的模式,白天会聚到哪些地方?
时间切法本身不含坐标。作者再用原始位置,看某一类人在0:00、10:00、20:00等时刻的空间分布。颜色从蓝到绿到红表示相对密度升高,图上没有给出人数或密度的数值刻度。下面读到的地名来自图中标注和正文解释,是分布上的集中,不是职业鉴定。
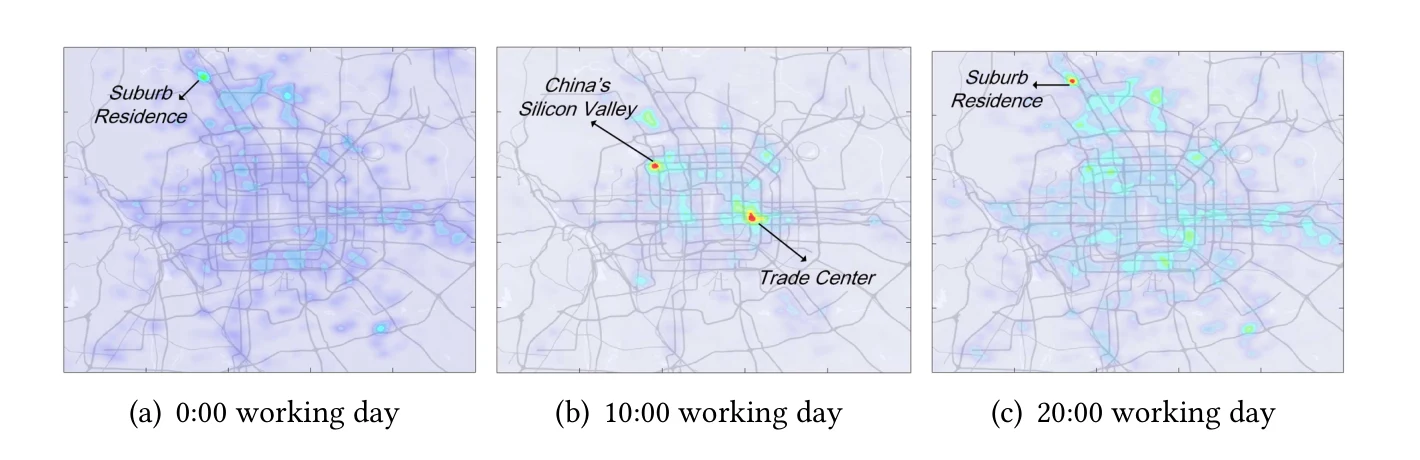
图 10|北京模式1的人,工作日从哪到哪?
(a)0:00密度多在外围居住方向。(b)10:00转向中关村一带和国贸一带,图中标为中国硅谷和贸易中心。(c)20:00再次散向郊区。这只说明这一类人的聚集位置随时间变化,不能由此推出他们的职业。来源:原论文 Fig. 10。
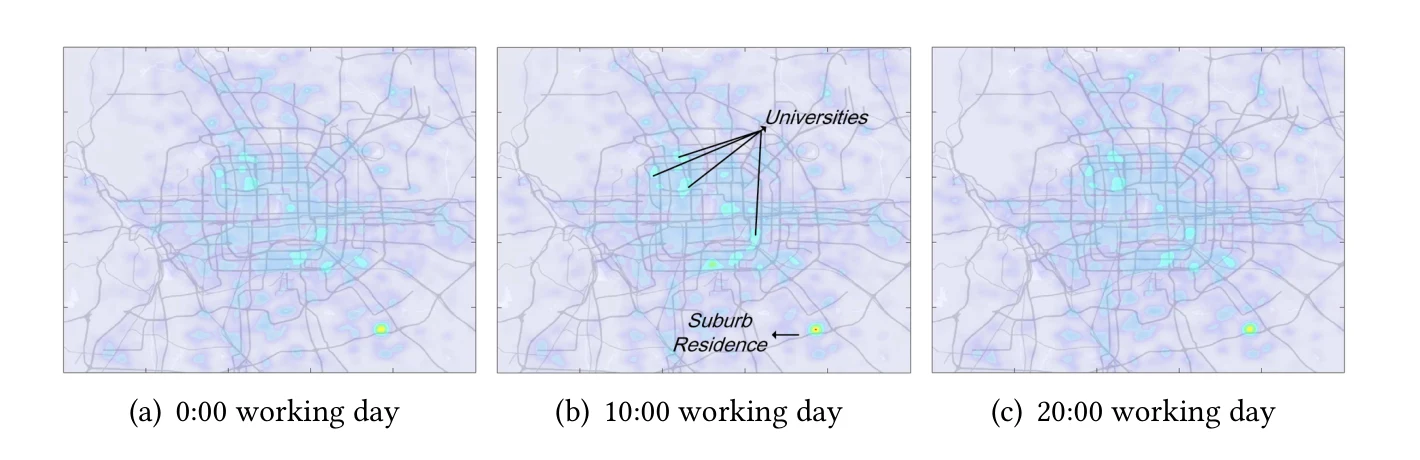
图 11|北京模式2为什么像几乎不换地方?
(a)0:00、(b)10:00、(c)20:00的工作日分布都接近,主要落在居住区和高校一带。三个时刻没有出现模式1那种进城再散开。正文据此推测可能与住校或居家有关,这是解释,不是直接观测到的身份。来源:原论文 Fig. 11。
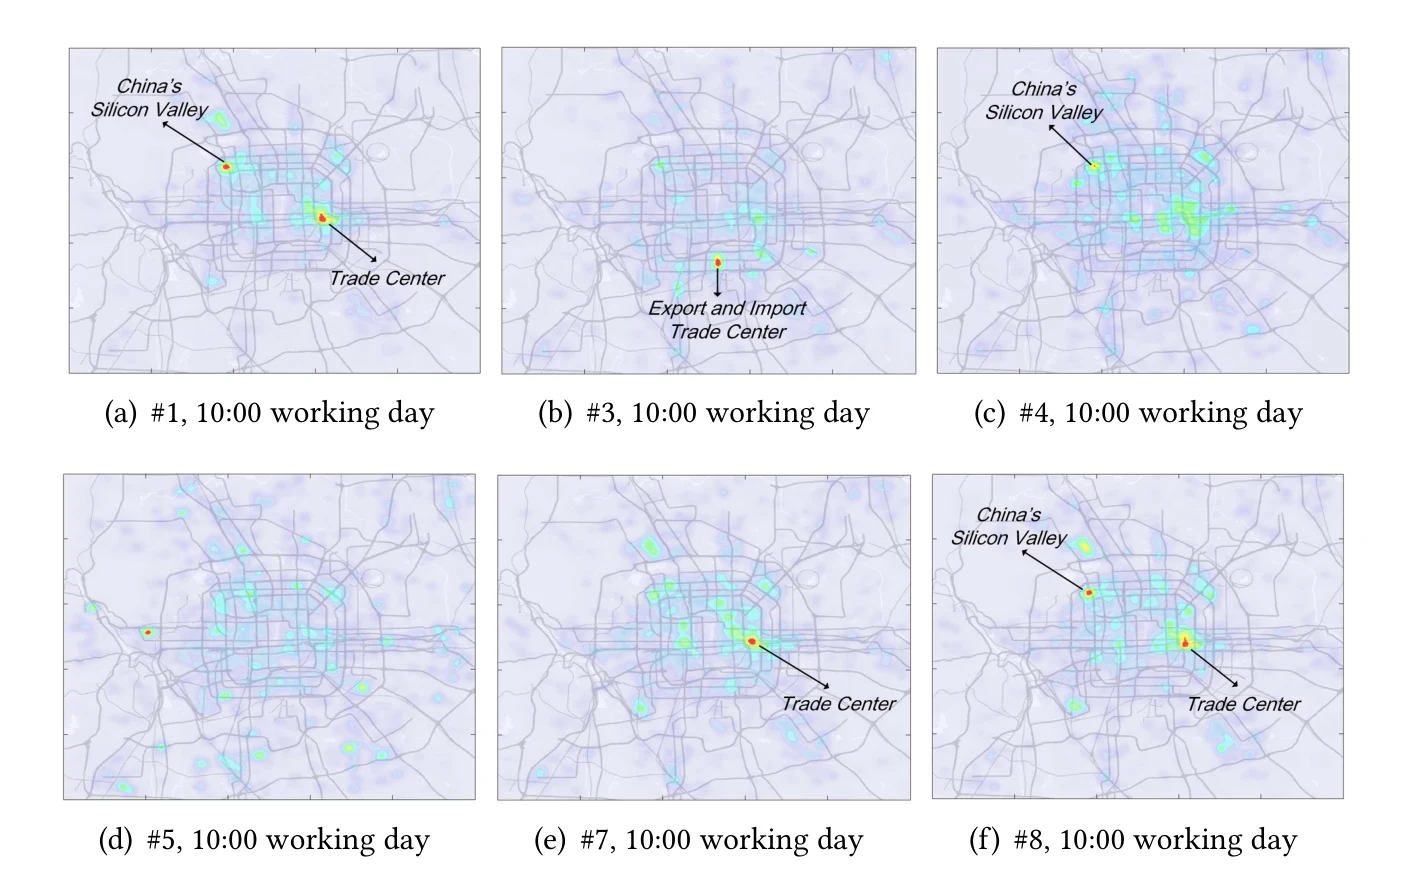
图 12|同一个工作日上午十点,北京不同模式聚在哪里?
(a)模式1集中在中关村与国贸方向。(b)模式3更偏向进出口贸易中心一带。(c)模式4更偏向中关村。(d)模式5在医院和中小学一带密度较高,这是正文的读图,图上没有逐点标出医院名称。(e)模式7多在贸易中心。(f)模式8的工作日分布接近模式1,中关村与国贸都出现。同一时刻的不同聚集,说明“白天外出”不是同一种目的地。来源:原论文 Fig. 12。
上海模式1也有早晚移动。10:00时陆家嘴一带密度明显高于别处。
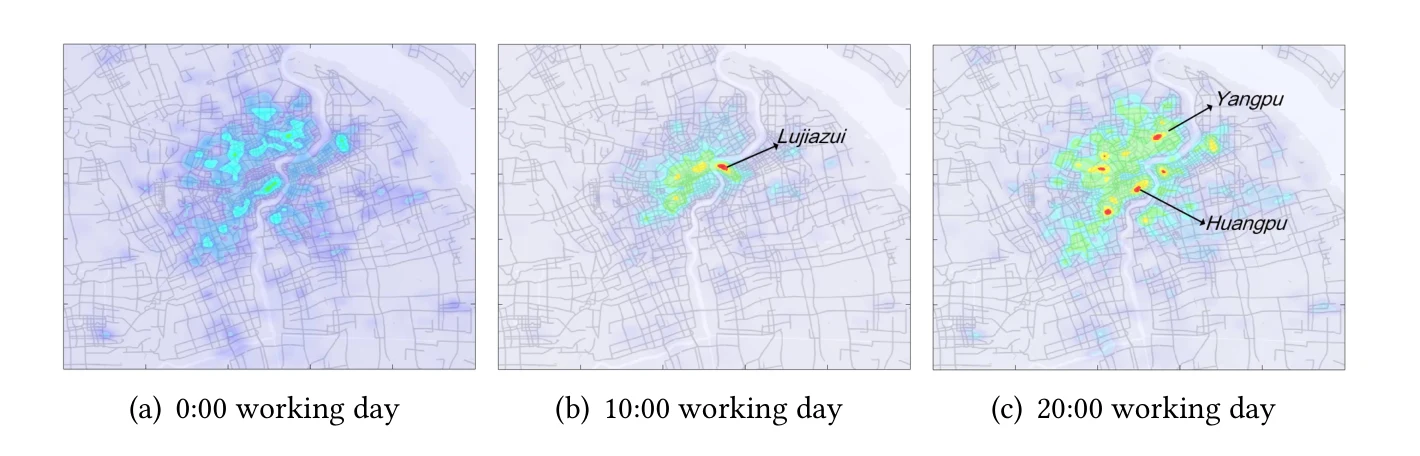
图 13|上海模式1是否也在工作日进城?
(a)0:00相对分散。(b)10:00密度升到中心,陆家嘴高于周围。(c)20:00再度散开。现象与北京模式1同类,地点换成上海的金融聚集区。来源:原论文 Fig. 13。
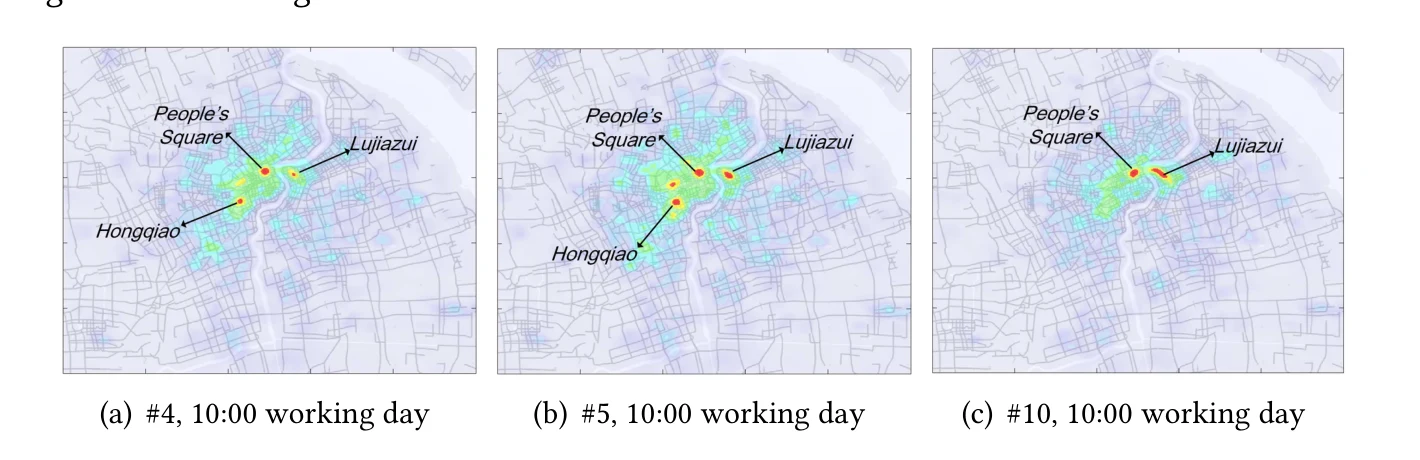
图 14|上海另外三种工作日模式,上午十点是否去同一批地方?
(a)模式4、(b)模式5、(c)模式10在10:00都集中于陆家嘴、人民广场和虹桥。正文指出虹桥近年聚集多家企业,因此不同切法的人可以出现在同一片就业区。空间重叠不等于时间切法相同。来源:原论文 Fig. 14。
模式9是上海钟面里白天被切成许多短片的那一种。它的位置从早高峰开始由外围移向中心,上午十点以后在中心铺得更匀,18:00以后只有一部分回到外围。
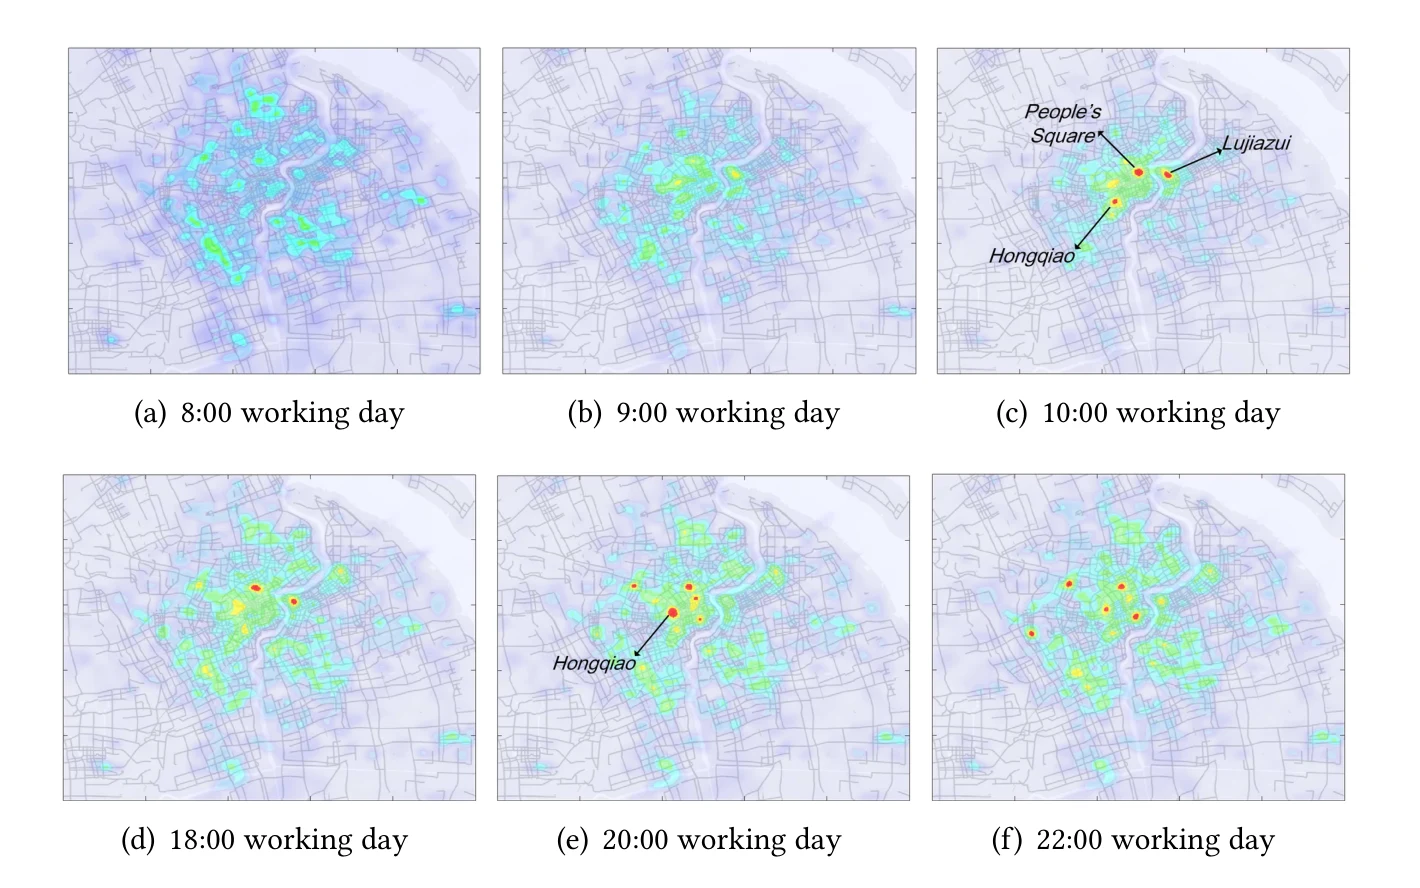
图 15|上海模式9的人,工作日如何在城里移动?
(a)8:00密度仍偏外围。(b)9:00向中心聚拢。(c)10:00中心多处变亮,图中标出人民广场、陆家嘴和虹桥。(d)18:00仍有中心密度,只有一部分向外。(e)20:00与(f)22:00继续分散,但不是全体同时回到同一外围。正文推测这像出租车或巡逻一类的全天移动,推测本身还要靠后面的应用使用来对照。来源:原论文 Fig. 15。
低维投影把分区距离近的人画得近,不是城市地图。同色的点挤在一起,不同模式之间留出空隙,说明每一类的代表钟面确实靠近该类里的人,而不是把互不相似的切法硬塞进同一类。
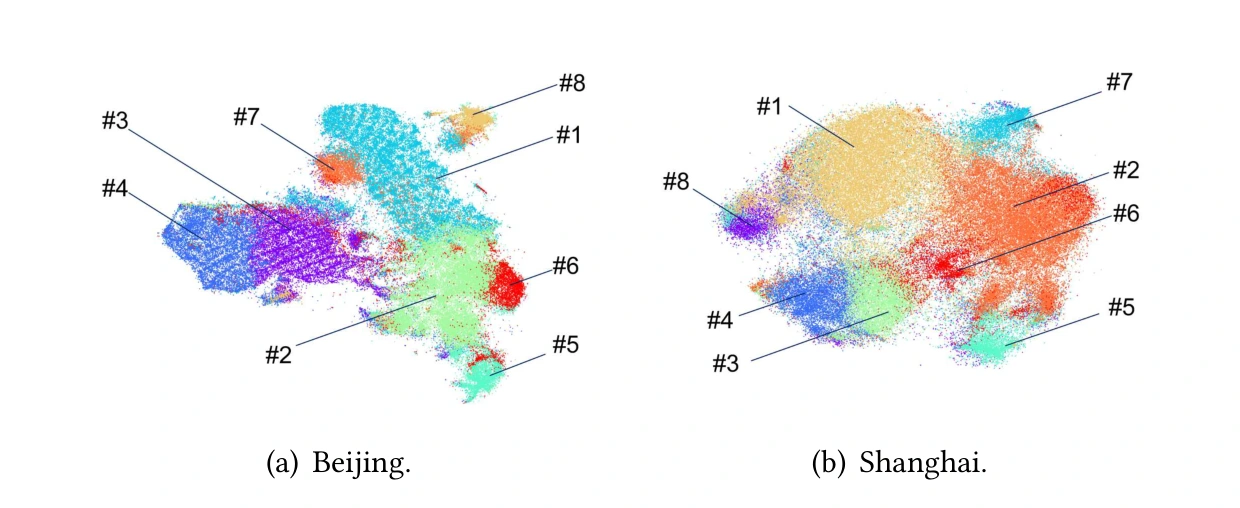
图 16|同一类人的时间切法,在距离图上是否靠在一起?
(a)北京八个颜色各自成团。(b)上海同样八个颜色成团。这里的模式7、模式8是各城投影图自己的标签;上海钟面图的特有模式仍编号为9和10。坐标没有地理单位,不能在这张图上量公里。来源:原论文 Fig. 16。
到访次数是全体的几倍,才算得上不一样?
语义对照用的是比值:某一组的平均到访或使用次数,除以全体用户的平均次数。1表示与全体相同,大于1表示更频繁。每组取的是与该模式最相似的2,500人,用来代表该类的核心,不是从该类随机抽取,也不是该类的全部人。比较用t检验。p≤0.05标一颗星,p≤0.01标两颗星。全体包含这2,500人,所以这不是两组完全分开的样本;2,500人只占10万人的2.5%,对全体平均的拉动有限。
北京模式1至8用兴趣点,上海模式9和10用应用。下面只写正文用来解释模式、并且能在表2、表3里对上的比值。
模式1在工作日8:30–18:30:公司2.52倍、政府2.84倍、居住2.10倍、生活服务1.94倍,均为p≤0.01;学校是全体的0.73倍,同样p≤0.01。餐饮1.50倍没有标显著。夜间加整个非工作日,居住为2.43倍(p≤0.01)。这和“工作日白天去办公区、其余时间留在另一处”相符,但不能把每个该模式的人都写成白领。
模式2在工作日全天加非工作日18:00–11:30:学校1.32倍,公司只有0.36倍,居住0.73倍,三者均为p≤0.01。模式5在工作日全天:学校4.41倍(p≤0.01),医院1.54倍(p≤0.05)。模式6在非工作日8:00–18:00:景点1.57倍(p≤0.01);其余时间学校为1.93倍(p≤0.01)。
模式3在两天的白天时段:生活服务2.81倍(p≤0.01),政府0.33倍、学校0.40倍(均p≤0.01)。模式4的长白天:餐饮3.46倍、生活服务3.11倍、酒店2.28倍(均p≤0.01),公司只有0.73倍(p≤0.05)。正文把模式3、4解释成更可能从事生活服务或轮班,这是和比值相容的读法。
模式8在工作日8:00–18:30:政府3.71倍、公司1.63倍(均p≤0.01)。同一模式在工作日夜间的政府比值是3.20,但没有星号。比值大而不显著,就不能当成已经确认的差异。
模式7更需要把表4和检验分开看。表4把它和公务员、白领放在一起,可工作日8:00–17:30的公司比值是1.47、政府是1.27,都没有星号。标了两颗星的是非工作日9:30–17:30的景点,1.28倍。这一类的兴趣点证据弱于模式1。
模式9的交通类应用,在三个时段分别是全体的5.14倍、5.63倍和4.15倍,均为p≤0.01。金融类是0.14倍、0.17倍,非工作日白天为0.00倍,均为p≤0.01。0.00表示这一组在该时段的平均使用次数是0,不是全体都不使用金融应用。模式10的应用比值表里没有星号,不能用应用使用来支撑它的职业解释。
表4把上述特征收成“可能的社会群体”。那一列是作者的归纳。除了后面有自报职业的小样本和美国调查,这些群体名称没有在北京10万人或上海10万人上逐人核对。
职业对得上的,是模式内部的比例
北京有职业记录的只有103名志愿者。表5的每个数,是该模式志愿者里某一职业所占的比例,分母是该模式的人数,不是103,也不是10万。正文没有给出每一列有多少人,所以0.333可能来自很少的几个人。
模式1中白领占78.1%,公务员占15.6%,医生占6.2%,三者合计约100%。模式3中服务占55.5%。模式2中自雇占48.1%,是该列最高,但不到一半。模式8中白领占60.0%。这些方向与“工作日白班对应办公职业、少移动或不分周末的日程更常落到服务和自雇”大致同向,样本却是自选志愿者。论文自己写明这里有自我选择偏差。
美国调查换了一个完全不同的人群,每人只有一个自报工作日,共五种切法。
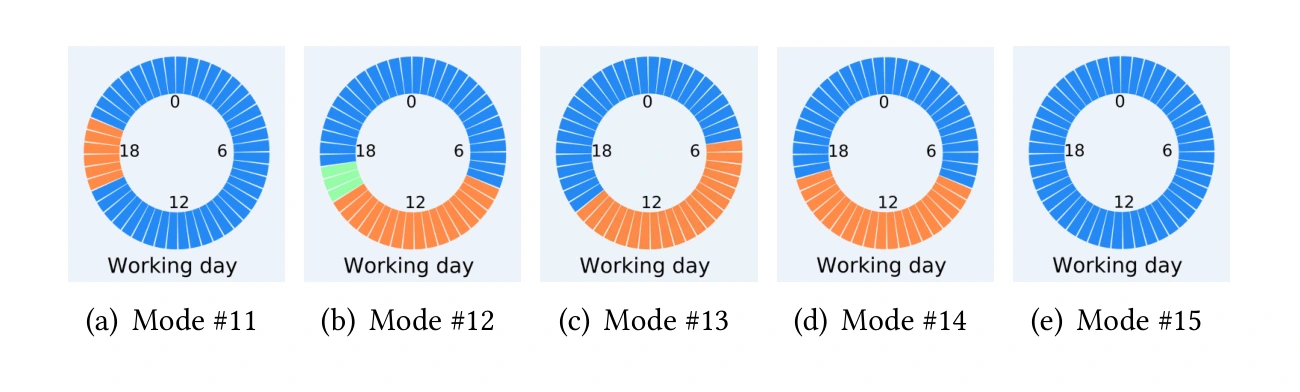
图 17|美国调查里的五种切法,为什么只有工作日?
(a)模式11白天大部分同色,傍晚有另一小段。(b)模式12在日间末尾换成另一处,上午也有一小段不同颜色。(c)模式13白天开始得更早。(d)模式14接近朝九晚五的白天一块。(e)模式15几乎全天同色。数据每人只有一天,所以没有非工作日钟面。来源:原论文 Fig. 17。
表6同样按模式内人数归一,不是11,712的全体比例,正文也没有给出每个模式的人数。
模式11里销售和服务占93.9%,其他占5.6%,专业、管理和技术占0.5%。模式15里销售和服务占82.1%,其他占14.1%。这两种都是工作日少换地方的切法。模式13里,制造、建筑、维修和农业占79.3%,文职支持占17.3%,专业、管理和技术只占3.4%。模式12里文职支持占52.0%,专业、管理和技术占40.4%。模式14里专业、管理和技术占47.7%,文职支持占45.6%,只差2.1个百分点。正文说朝九晚五更倾向专业、管理和技术,按最高项成立;它并不是压倒性的单一职业。
因此,能比较稳地说的是:少移动的工作日在这套美国编码里大量落在销售和服务,更早的白班大量落在制造、建筑、维修和农业,标准白班则是专业管理与文职几乎对半。不能把某一模式写成某一种职业的充分条件。
比轨迹聚类更高的互信息,绝对分数仍然很低
对照方法把移动记录当成词、把轨迹当成文档,用隐含狄利克雷分配抽出潜在特征,再做k均值。为了和本文对齐,潜在特征数设为18,轨迹簇数设为8,移动记录簇数设为18。18来自表4里北京各模式的时间块个数,8来自北京的模式数。
归一化互信息把“簇”和“职业或兴趣点类别”的重叠收成0到1。1表示同一类别的对象全部进入同一簇。图18的柱顶就是这个分数。
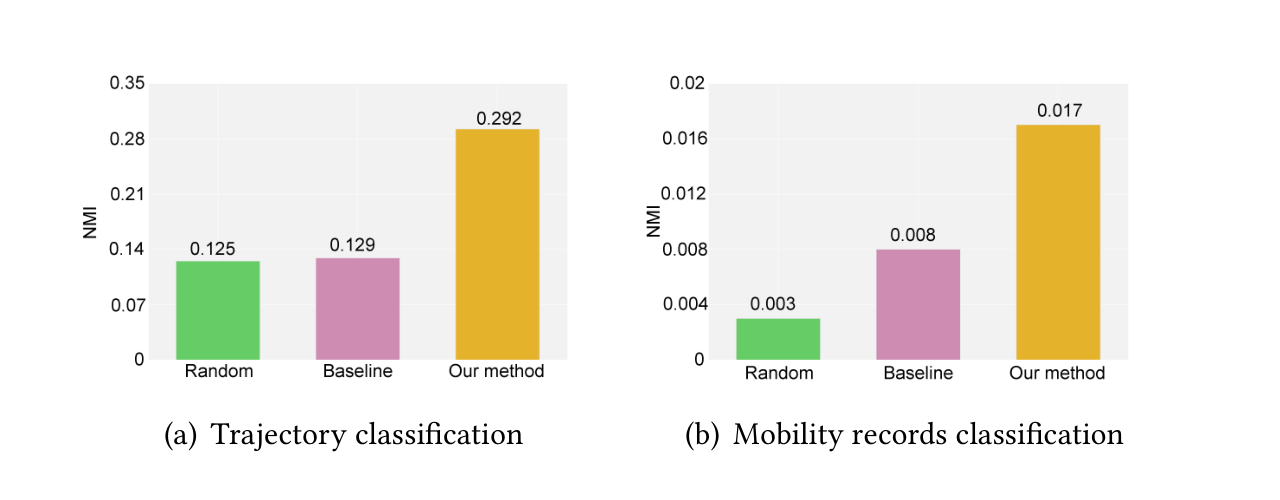
图 18|相对基线升高的百分比,对应的绝对分数是多少?
(a)轨迹对职业:随机分配0.125,基线0.129,本文0.292。(b)移动记录对兴趣点:随机0.003,基线0.008,本文0.017。纵轴都是归一化互信息,不是准确率。来源:原论文 Fig. 18。
职业一项的提高是 (0.292−0.129)/0.129 = 126.4%,分母是基线的0.129,不是随机分配的0.125,也不是满分1。兴趣点一项是 (0.017−0.008)/0.008 = 112.5%,分母是基线的0.008。基线只比随机略高:职业从0.125到0.129,兴趣点从0.003到0.008。本文的0.292和0.017都说明簇与标签有超出基线的重叠,也说明大部分信息仍然没有被簇抓住。职业这一项能够用上的标签只有103人;兴趣点一项的记录总数,正文没有给出。
这些对应停在哪里
相关的是群体比例,不是个人因果。时间切法相似,可以来自家住校、居家、轮班或数据在某一天恰好没出门,图本身分不开这些原因。兴趣点来自签到和兴趣点的空间范围,基站位置也比GPS粗,同一颜色在三套数据里不是同一种地点。
类数是作者选到“还能分开”的最大个数,换一个稳定性标准,8这个数字可以变。检验用的2,500人是最靠近代表钟面的核心,模式边缘没有进入表2和表3。103名志愿者是自选样本;美国结果来自2008–2009年的单日自报,只能为“时间切法和职业有关”提供另一人群的对照,不能外推成2016年北京10万人的职业结构。
数据太稀时这套切法会不可靠。正文明确说,签到这类稀疏记录仍然做不好,因为很多30分钟时间片是空的。论文也没有访谈来核对表4里的群体名称。
一句话总结
把每个人的一天看成哪些时段待在同一处,北京和上海各出现八种主要切法,最常见的一种都超过四分之一;它与到访、应用和职业的关系是群体比例上的对应,不是对一个人的身份判定。
核心来源
- ACM Digital Library 正式版,Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies,2018,2(1),Article 46,2018年3月,25页。题目、作者、DOI与页数均以PDF首页为准。
- 图表、表1至表6和算法说明都在这25页正文内。文中没有指向独立补充材料。密度聚类的距离阈值、类数搜索的具体稳定性数值,正文没有给出。
作者介绍
论文署名中的单位和通讯关系如下,不补充论文未写明的职务。
- Fengli Xu、Tong Xia、Hancheng Cao:署名为清华大学。
- Yong Li:署名为清华大学,通讯作者,论文所列邮箱为 liyong07@tsinghua.edu.cn。
- Funing Sun、Fanchao Meng:署名为腾讯公司,北京。
- 资助说明写明国家自然科学基金61621091、61673237,以及清华大学—腾讯互联网创新技术联合实验室。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
上海人数图里,几乎不换地方的模式2占28%,只比通勤式的模式1少0.6个百分点。若公交班次、商业开门时间只按“最多的人要在十点前进城”来排,另一群同样规模的人不会出现在这套高峰里。要检验这件事,需要把模式2的人单独拿出来看他们的基站是否真的全天稳定,而不是只看全城平均的早高峰。
美国模式14内部,专业管理技术与文职支持只差2.1个百分点。若把“朝九晚五”直接映射成一种职业去做分类,仅在这一模式里就会把将近一半的人分到相邻类别。表6已经给出这个上限:最高项也只有47.7%。北京103人的78.1%看起来更干净,但那是志愿者模式内的比例,而且不知道该列有多少人。
表2的2.52倍来自最相似的2,500人,不是北京模式1那约2.8万人的平均。模式边缘的人若被算进同一职业画像,差距会缩小还是扩大,这篇论文没有再做一次检验。