猜你还在原地,为什么比猜下一站容易得多?
论文名片|Andrea Cuttone、Sune Lehmann、Marta C. González,Understanding predictability and exploration in human mobility,EPJ Data Science,2018,7:2。2017年8月3日收稿,2017年12月26日接收。DOI:10.1140/epjds/s13688-017-0129-1。本文依据这一开放获取正式版解读。
可以先把问题想成一件具体的事。手机大约每15分钟记下一个位置。若要猜的是下一个15分钟还在不在同一小格里,人往往还坐在教室、图书馆或家里,猜“还在这儿”就会经常猜对。若要猜的是下一次真正离开之后去哪一处地点,原地停留不再算一次成功,而且下一次可能根本不在过去去过的名单里。
文献里的人类移动性(human mobility,人在空间中的移动)预测成绩从90%以上排到40%以下。这篇论文用同一批高精度轨迹说明,跨度主要来自题目本身:猜的是可预测性上限还是实际下一地点,猜的是下一个时间片还是下一次地点切换,以及空间格子和时间片有多细。去掉停留之后,下一地点很难;大约每4到5次停留就有一次走向没去过的地点,只在旧名单里挑答案的模型会在这里失败。
先说结论
- 哥本哈根网络研究里,800多名丹麦技术大学学生中,有454人留下至少3个月、15分钟时间片覆盖率达到90%的轨迹。下一格网的可预测性上限峰在约0.95,下一地点的上限峰在0.68。
- 在50米格网、15分钟一步的设定下,马尔可夫链的用户准确率分布峰在约0.7;它和“预测人还留在当前格”的策略相关为0.993。格子放到5000米,准确率分布明显右移;时间片放到60分钟,分布向左移。
- 只预测下一次换到的地点时,最常地点策略的分布峰约0.3,马尔可夫约0.4。加入当前位置和时间后,逻辑回归高于马尔可夫;用上全部特征后,成绩与“当前位置+一周中的小时”几乎相同,按用户平均的准确率仍低于45%。
- 每个用户只去过一次的地点,平均约占该用户地点数的70%。探索占停留次数的20%–25%。53周里,平均每人大约积累200个不重复地点,每周新地点维持在4个左右。
- 判断下一次停留是探索还是返回,最佳模型的平均精确率是0.3、平均召回率是0.65。引言里的41%与这两个数的调和平均同量级,图上对应的是F1,不宜和“猜对次数除以预测次数”直接并列。
文献里的高准确率,问的是哪一道题?
Song等人2010年用通话详单,把位置排成符号序列,再用时间熵和Fano不等式估计可预测性上限,多数用户的上限是93%。这是信息论上还可能达到的最高猜对比例,不是某个模型已经交出来的成绩。Smith等人把下一地点必须在空间上够得着算进去,上限收到81%–85%。Lu等人估计2010年海地地震后的人口移动上限约为85%。
一旦改成实际预测,数字跟着任务走。Lu等人在科特迪瓦用马尔可夫链预测县一级的当天最后位置,准确率可以超过90%。Song等人在达特茅斯校园WiFi上比较下一格网预测器,表现最好的二阶马尔可夫链,中位准确率约65%–72%。Gao等人在诺基亚数据上用时间和地点做朴素贝叶斯,准确率约50%;Do等人再加入短信、通话和蓝牙邻近,约60%。
这些百分比的分母并不相同。有的分母是熵方法允许的理论上限,有的是县这么大的区域里“当天最后出现在哪”,有的是校园WiFi格网的中位用户,有的是加入情境特征后的下一地点。把它们排成一条“模型从90%退到40%”的成绩单,会把题目差异写成模型优劣。
454名学生的轨迹,细到什么程度?
数据来自哥本哈根网络研究。项目用智能手机收集800多名丹麦技术大学学生的GPS或WiFi位置、蓝牙、短信、通话、WiFi和Facebook好友关系。采集经过丹麦数据保护局批准,参与者都有书面知情同意。位置由当时最好的来源确定,中位精度约20米;超过90%的位置样本,报告精度好于40米。采样大约每15分钟一次。
缺电、手机关机、定位被关掉或软件故障都会留下空档。作者对每个人保留最长的一段连续记录,要求这段记录里90%的15分钟时间片至少有一个样本,并且这段至少有3个月。筛完剩下454人,长度从3个月到1年。轨迹主要在丹麦,学生旅行时也会记到其他国家。原始位置数据因隐私不能公开。
分析单位先是人,再是这个人的位置序列。下一格网里,一步是一个时间片;下一地点里,一步是一次停留。后文的准确率都是每个人分开算的:猜对的步数除以这个人的全部预测步数。模型按在线方式更新,用到第t步为止的历史预测下一步,没有拿未来数据回头训练。
下一格网的上限很高,模型实际猜到了多少?
下一格网预测(next-cell)把地图切成均匀格子。格子编号是经纬度各自除以格子边长后向下取整。默认格子是50米乘50米,时间步长15分钟。问题是:已知到时刻t为止的格子序列,t之后15分钟会在哪一格。
可预测性上限仍沿用Song等人的熵方法。它回答的是这条符号序列在信息论上有多可压缩,不回答马尔可夫链实际猜对了多少。图1把两种题目放在同一张用户分布上。蓝色的下一格网上限集中在0.9以上,峰约0.95;绿色的下一地点上限整体更低,峰在0.68。纵轴是用户数。两条分布几乎不重叠,说明“序列有多可预测”已经随题目改变,后面的模型差距不是偶然。
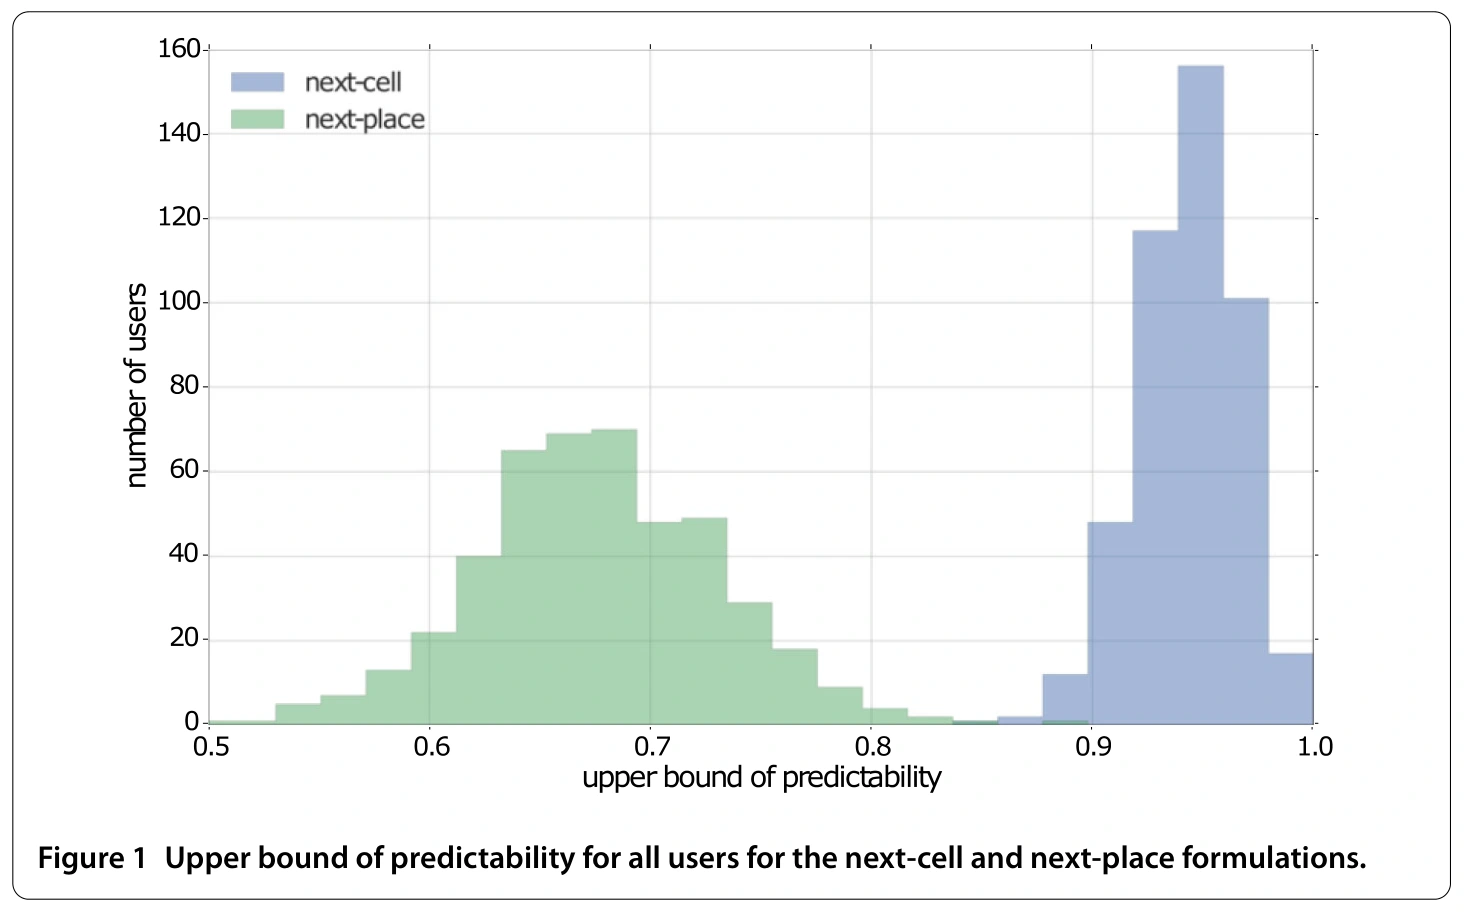
图 1|同一批用户,两种题目的可预测性上限差多远?
蓝色是下一格网,峰约0.95;绿色是下一地点,峰在0.68。横轴是上限,纵轴是用户数。来源:原论文 Fig. 1。
实际预测先用三个很简单的策略,方便看出分数从哪里来。最常地点(toploc)每次都猜到目前为止出现最多的格子。马尔可夫链只看当前格子,选历史上从这里出发最常见的下一格;当前格子没见过时,退回最常地点。停留策略更简单:预测下一时间片仍在当前格。
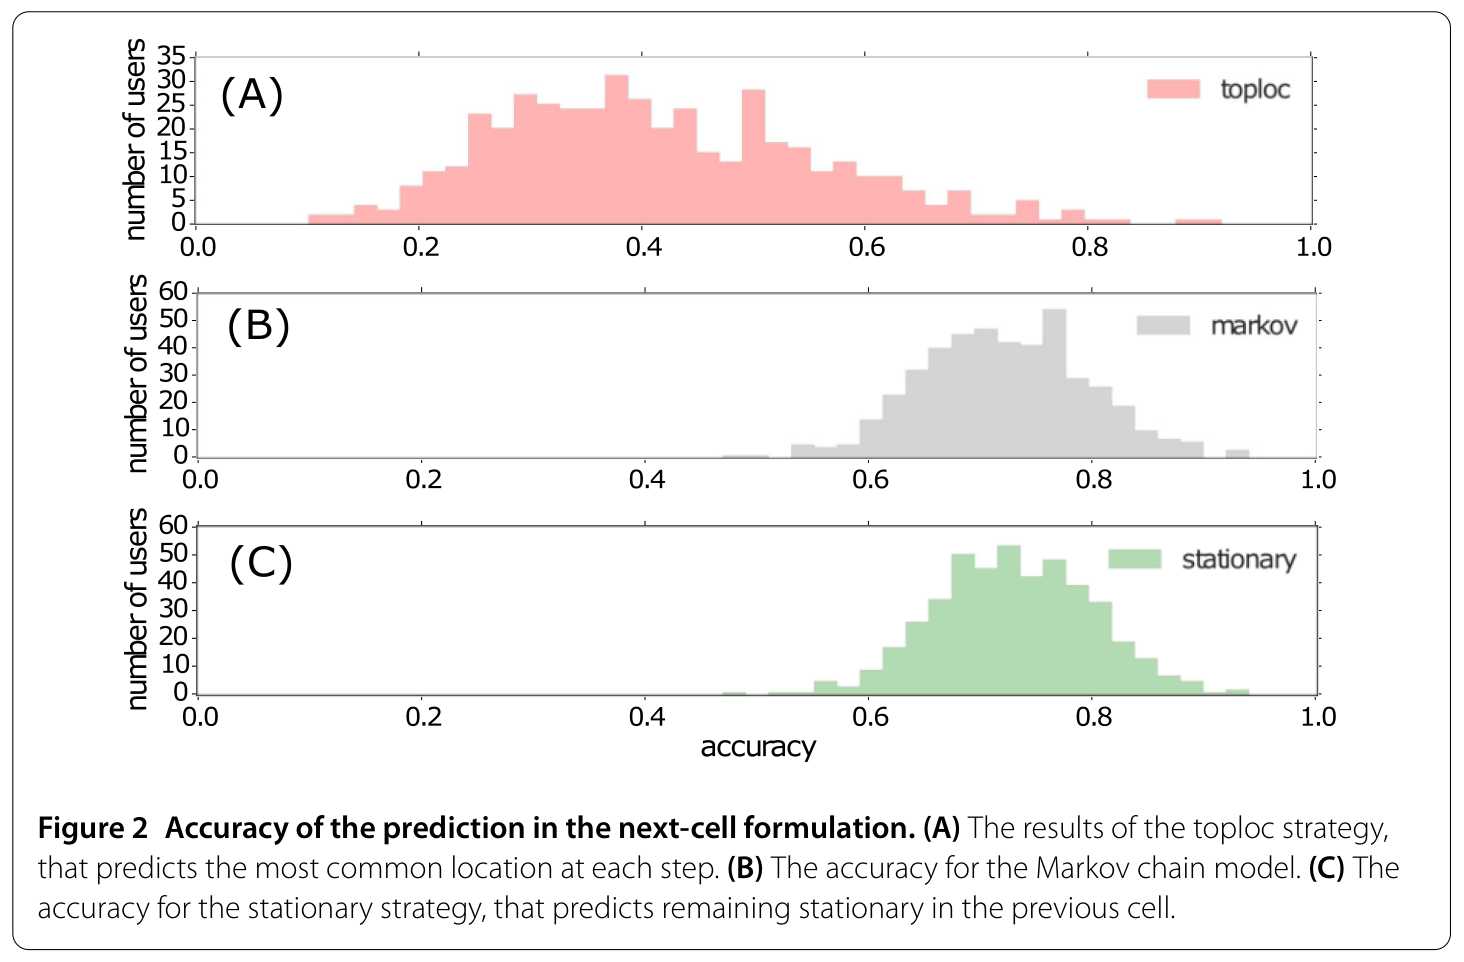
图 2|下一格网里,三种策略的用户准确率分布在哪里?
横轴都是准确率,定义为猜对步数除以该用户的预测步数;纵轴是用户数。(A)最常地点,分布峰约0.4。(B)马尔可夫链,分布峰约0.7,主体在0.6以上。(C)停留策略,分布形状与马尔可夫接近。来源:原论文 Fig. 2。
马尔可夫多猜对的部分,是不是人还没离开?
很多15分钟片里,下一格就是当前格,这叫自转移。停留策略专门预测这种原地不动。它的准确率分布和马尔可夫几乎重合。正文给出二者的皮尔逊相关 r=0.993,p<0.001,并指向补充材料图3。相关高说明,在预测下一个时间片的格子时,马尔可夫相对最常地点多出来的成绩,主要来自预测人还留在当前格。换格子的步骤仍可能被用到,只是准确率的分母里包含大量原地不动的时间片,停留对总分的权重更大。一个几乎只会说“留下”的模型,也可以把分布推到0.7附近。
格子放大、时间放长,准确率怎样变?
格子越大,人越不容易跨出去,自转移越多。作者把马尔可夫模型改到500米和5000米,时间片仍是原来的步长。图3的横轴从0.5画到1.0。50米时分布还铺在大约0.6到0.85;500米时主体移到0.85以上;5000米时主体挤在0.9到1.0之间。正文只概括为格子变大、准确率明显升高,没有给出三个峰的精确坐标。这里的右移是读图,不是另一组印刷好的平均数。
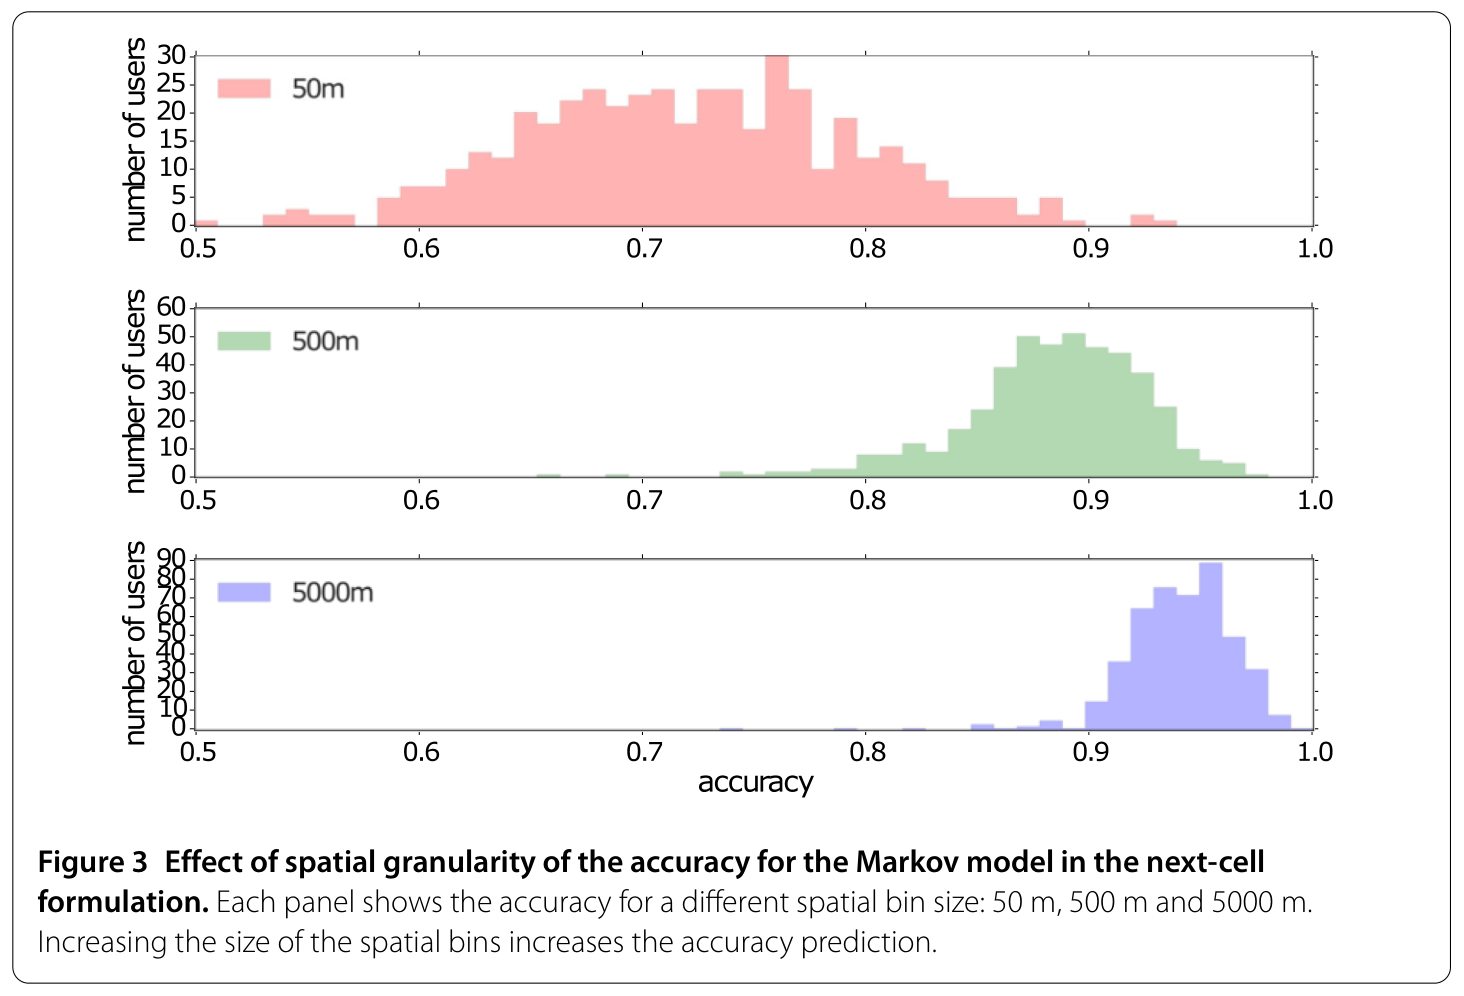
图 3|下一格网的马尔可夫准确率,如何随格子变大而升高?
三块面板没有子图字母,图例分别是50米、500米、5000米。横轴是准确率,纵轴是用户数。格子从50米增到5000米,分布从0.7附近移到0.9以上。来源:原论文 Fig. 3。
时间片的方向相反。格子固定在50米,时间片改成15分钟、30分钟、60分钟,也就是900秒、1800秒、3600秒。时间片越长,一个人在一步之内离开当前格的机会越大,自转移越少。图4里,900秒的分布更靠右,3600秒的分布更靠左,左尾也更长。正文写明:时间片变大,准确率下降。
图注最后一句写成“降低时间分辨率会提高准确率”。这句话和正文、也和三张分布的左右位置相反。读这张图时,以正文和分布位置为准:15分钟一步比60分钟一步更容易得到高准确率,原因是自转移更多。
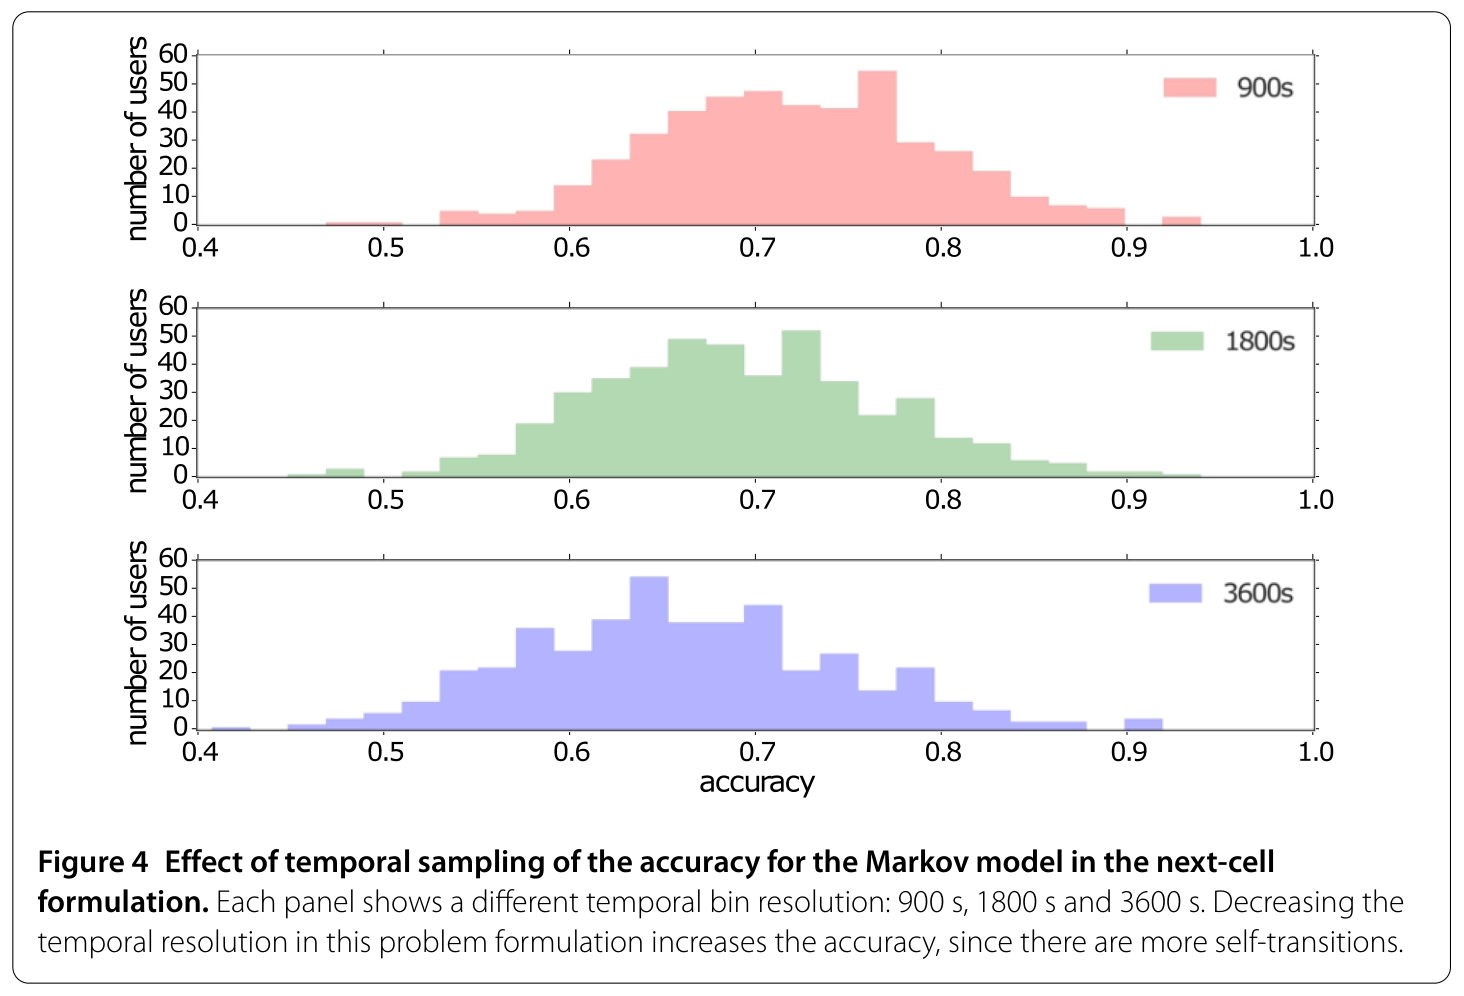
图 4|时间片变长之后,下一格网准确率往哪边移动?
三块面板对应900秒、1800秒、3600秒,格子都是50米。横轴准确率从0.4到1.0,纵轴是用户数。15分钟的分布最高,60分钟的分布整体偏左。来源:原论文 Fig. 4。
正文还报告,准确率对训练长度的曲线在50到100个样本后趋于平稳,图放在补充材料图6。样本在下一格网里是时间片,在下一地点里是停留,正文没有把它换算成天数。
只预测换地点,准确率掉到哪里?
下一地点预测先要把原始点收成停留,再把停留收成地点。一个人的位置按时间排列,相邻两点相距小于δ=50米,就还算同一次停留;这个阈值大致对应定位精度。短于15分钟的停留被去掉,用来滤掉通勤途中的短暂停留。停留再做DBSCAN聚类,距离用半正矢公式,邻域ε=50米,最少点数min_pts=2,目的是把大约一栋大建筑范围内的停留合成一个地点。同一地点上连着的多次停留再合并。作者说结果对这个距离的合理变动稳健,正文没有给出试过的具体范围。
预测因此变成:已知前n次停留,第n+1次去哪个地点。按构造,序列里没有自转移,停留策略无法使用。图1里的绿色分布就是这道题的上限,峰在0.68,低于下一格网的约0.95。
最常地点和马尔可夫的定义不变,只是符号从格子换成地点,每人单独、在线预测。分布峰大约分别在0.3和0.4,都远低于图2里的下一格网。0.3和0.4是用户准确率分布的峰,不是把所有人的预测步混在一起后的总猜对率。Ikanovic与Mollgaard在2017年用同一套哥本哈根网络研究数据独立讨论过可预测性,结论与本文相近。本文额外考察的是情境特征,以及把探索单独拿出来预测。
加上时间、通话和蓝牙,能高出马尔可夫多少?
作者接着问:知道现在在哪、几点、是否周末、是不是在家、离家里多远,以及停留前30分钟的短信、通话和蓝牙,能把下一地点再抬高多少。家定义为这个人访问最多的地点。模型是多项逻辑回归。它先把特征线性相加得到φ,再写成
P=1÷(1+e的−φ次方)。
类别只包括到目前为止见过的地点,所以一次真正的新地点不可能被它报出正确编号。每个人单独拟合,L2正则,优化目标是分类准确率。作者比较单一特征、当前位置加时间,以及全部特征。这组模型不是为了刷新预测纪录,而是为了看哪些信息有用。
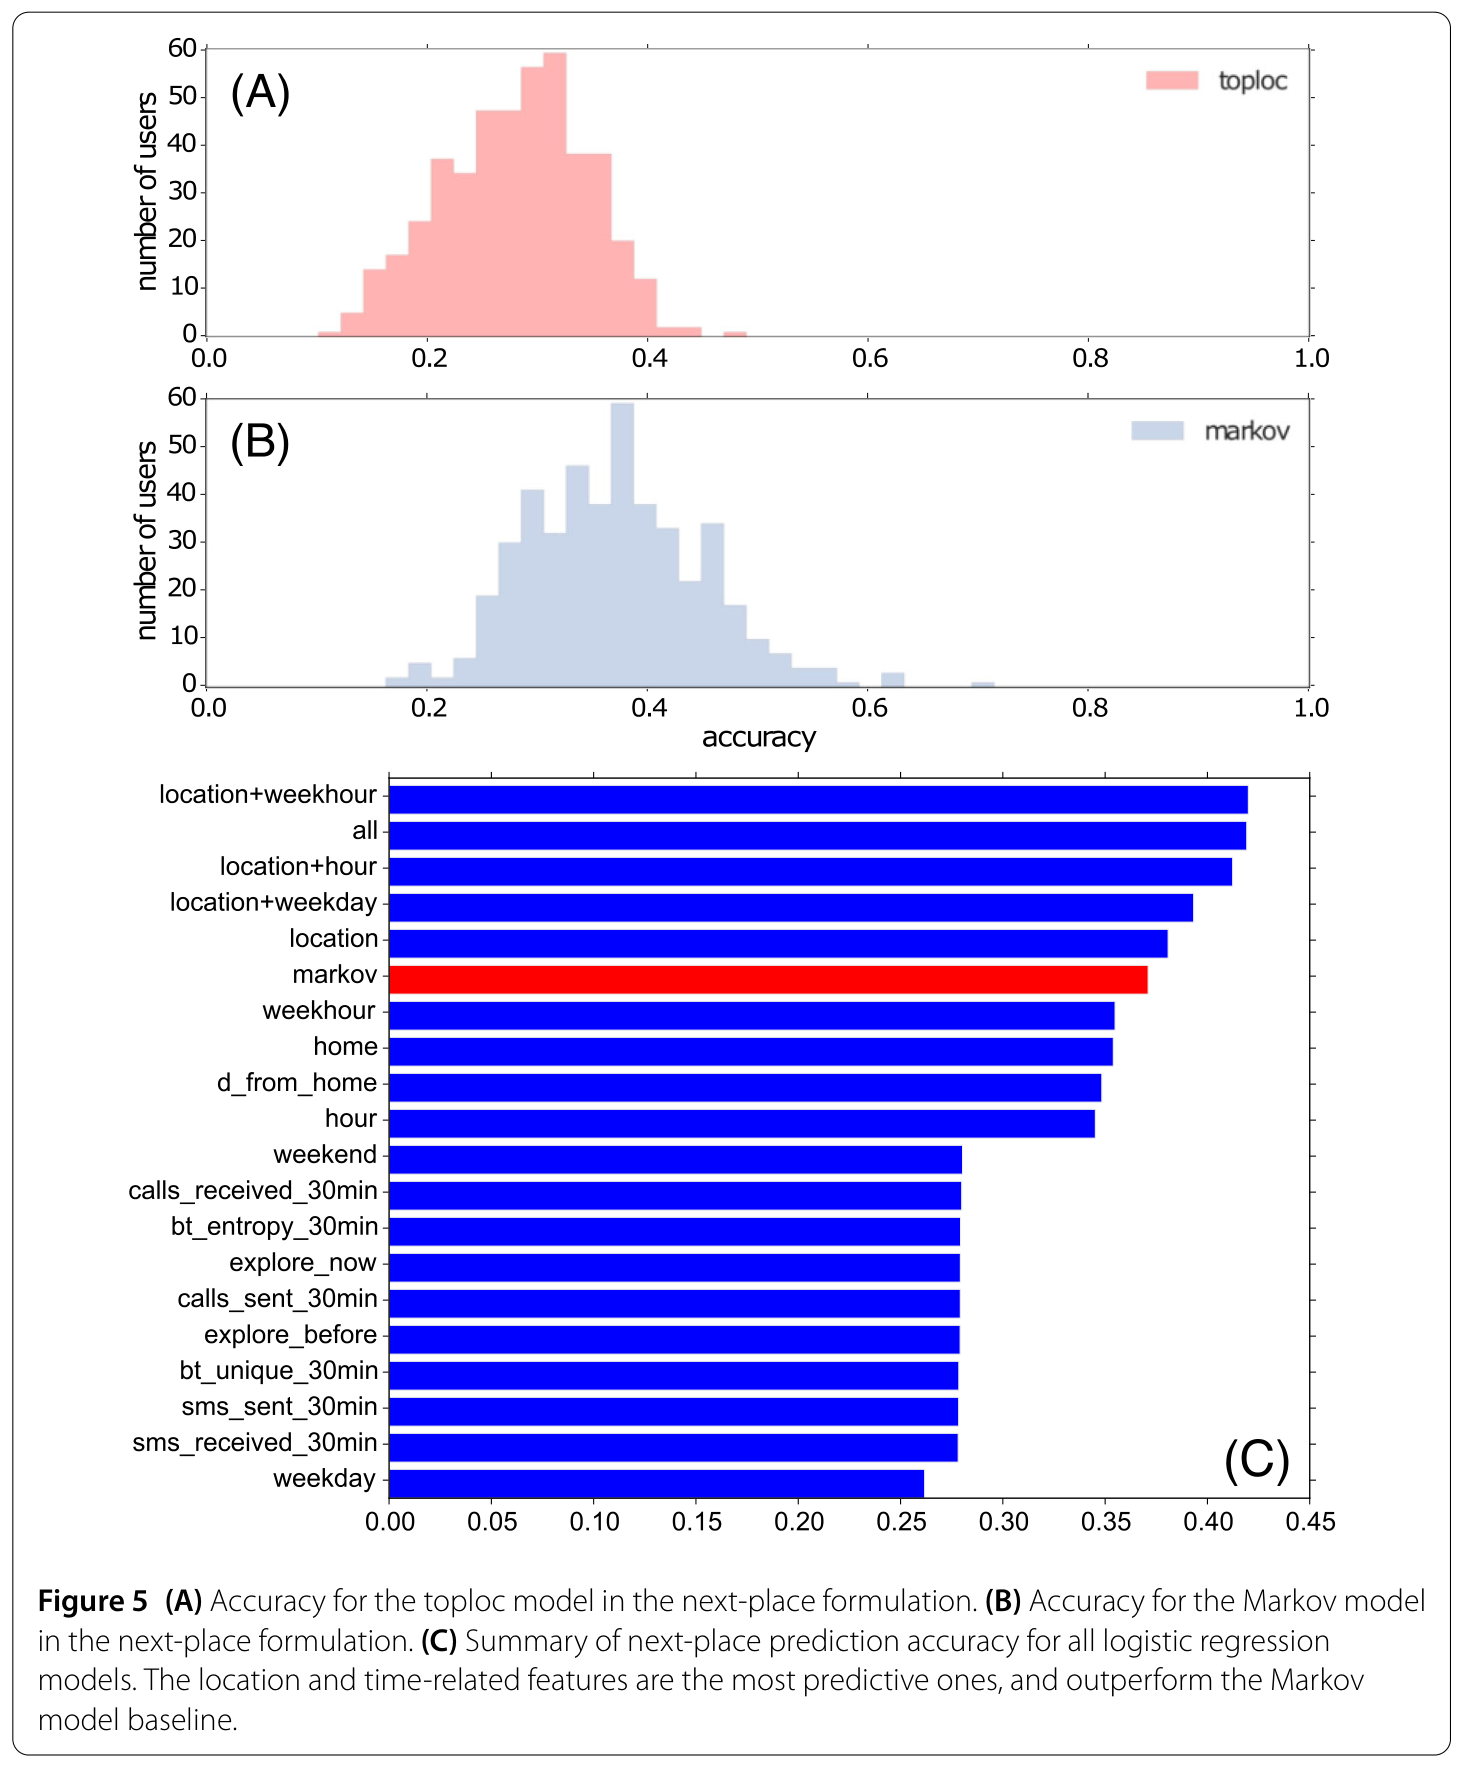
图 5|下一地点预测里,谁比马尔可夫更高,高出来多少?
(A)最常地点的用户准确率分布,峰约0.3。(B)马尔可夫的分布,峰约0.4,右尾零星超过0.6。(C)各模型按用户平均的准确率,横轴到0.45。红色是马尔可夫。当前位置加上一周中的小时、全部特征、当前位置加一天中的小时,三条最长且彼此接近;单独的星期几最短。通话、短信和蓝牙明显短于地点与时间。来源:原论文 Fig. 5。
图5(C)的条是用户平均,和(A)(B)的分布峰不是同一个汇总。正文给出的硬数字是:当前位置加时间特征超过马尔可夫;即便只用当前位置,逻辑回归也高于马尔可夫,作者认为原因是它直接优化了准确率。通话和短信的预测力很弱。全部特征与“当前位置+一周中的小时”几乎相同。绝对准确率仍低于45%。
用户之间,不重复地点越多,最佳逻辑回归越差,皮尔逊相关 r=−0.478,p<0.001。记录有多长、停留有多少,与准确率没有显著相关;正文没有给出这两个相关的r或p。未显著只说明这份数据里没检出稳定线性关系,不能写成“时长完全不起作用”。
新地点为什么让名单越来越长?
人确实会反复回到少数地点。偏好返回是已有文献里的机制;这篇论文要量的是,反复返回之外还剩多少第一次。一个地点若在这个人过去的停留里没出现过,当前这次停留就是探索,否则是返回。序列A、B、A、C、B、C对应的探索标记是1、1、0、1、0、0。
探索概率等于探索次数除以该用户的停留次数。摘要说平均20%–25%的转移去往新地点,正文把图6(B)的这个比例写成0.2到0.25,并解释为大约每4到5次停留发现一个新地点。分母是停留,不是15分钟时间片。
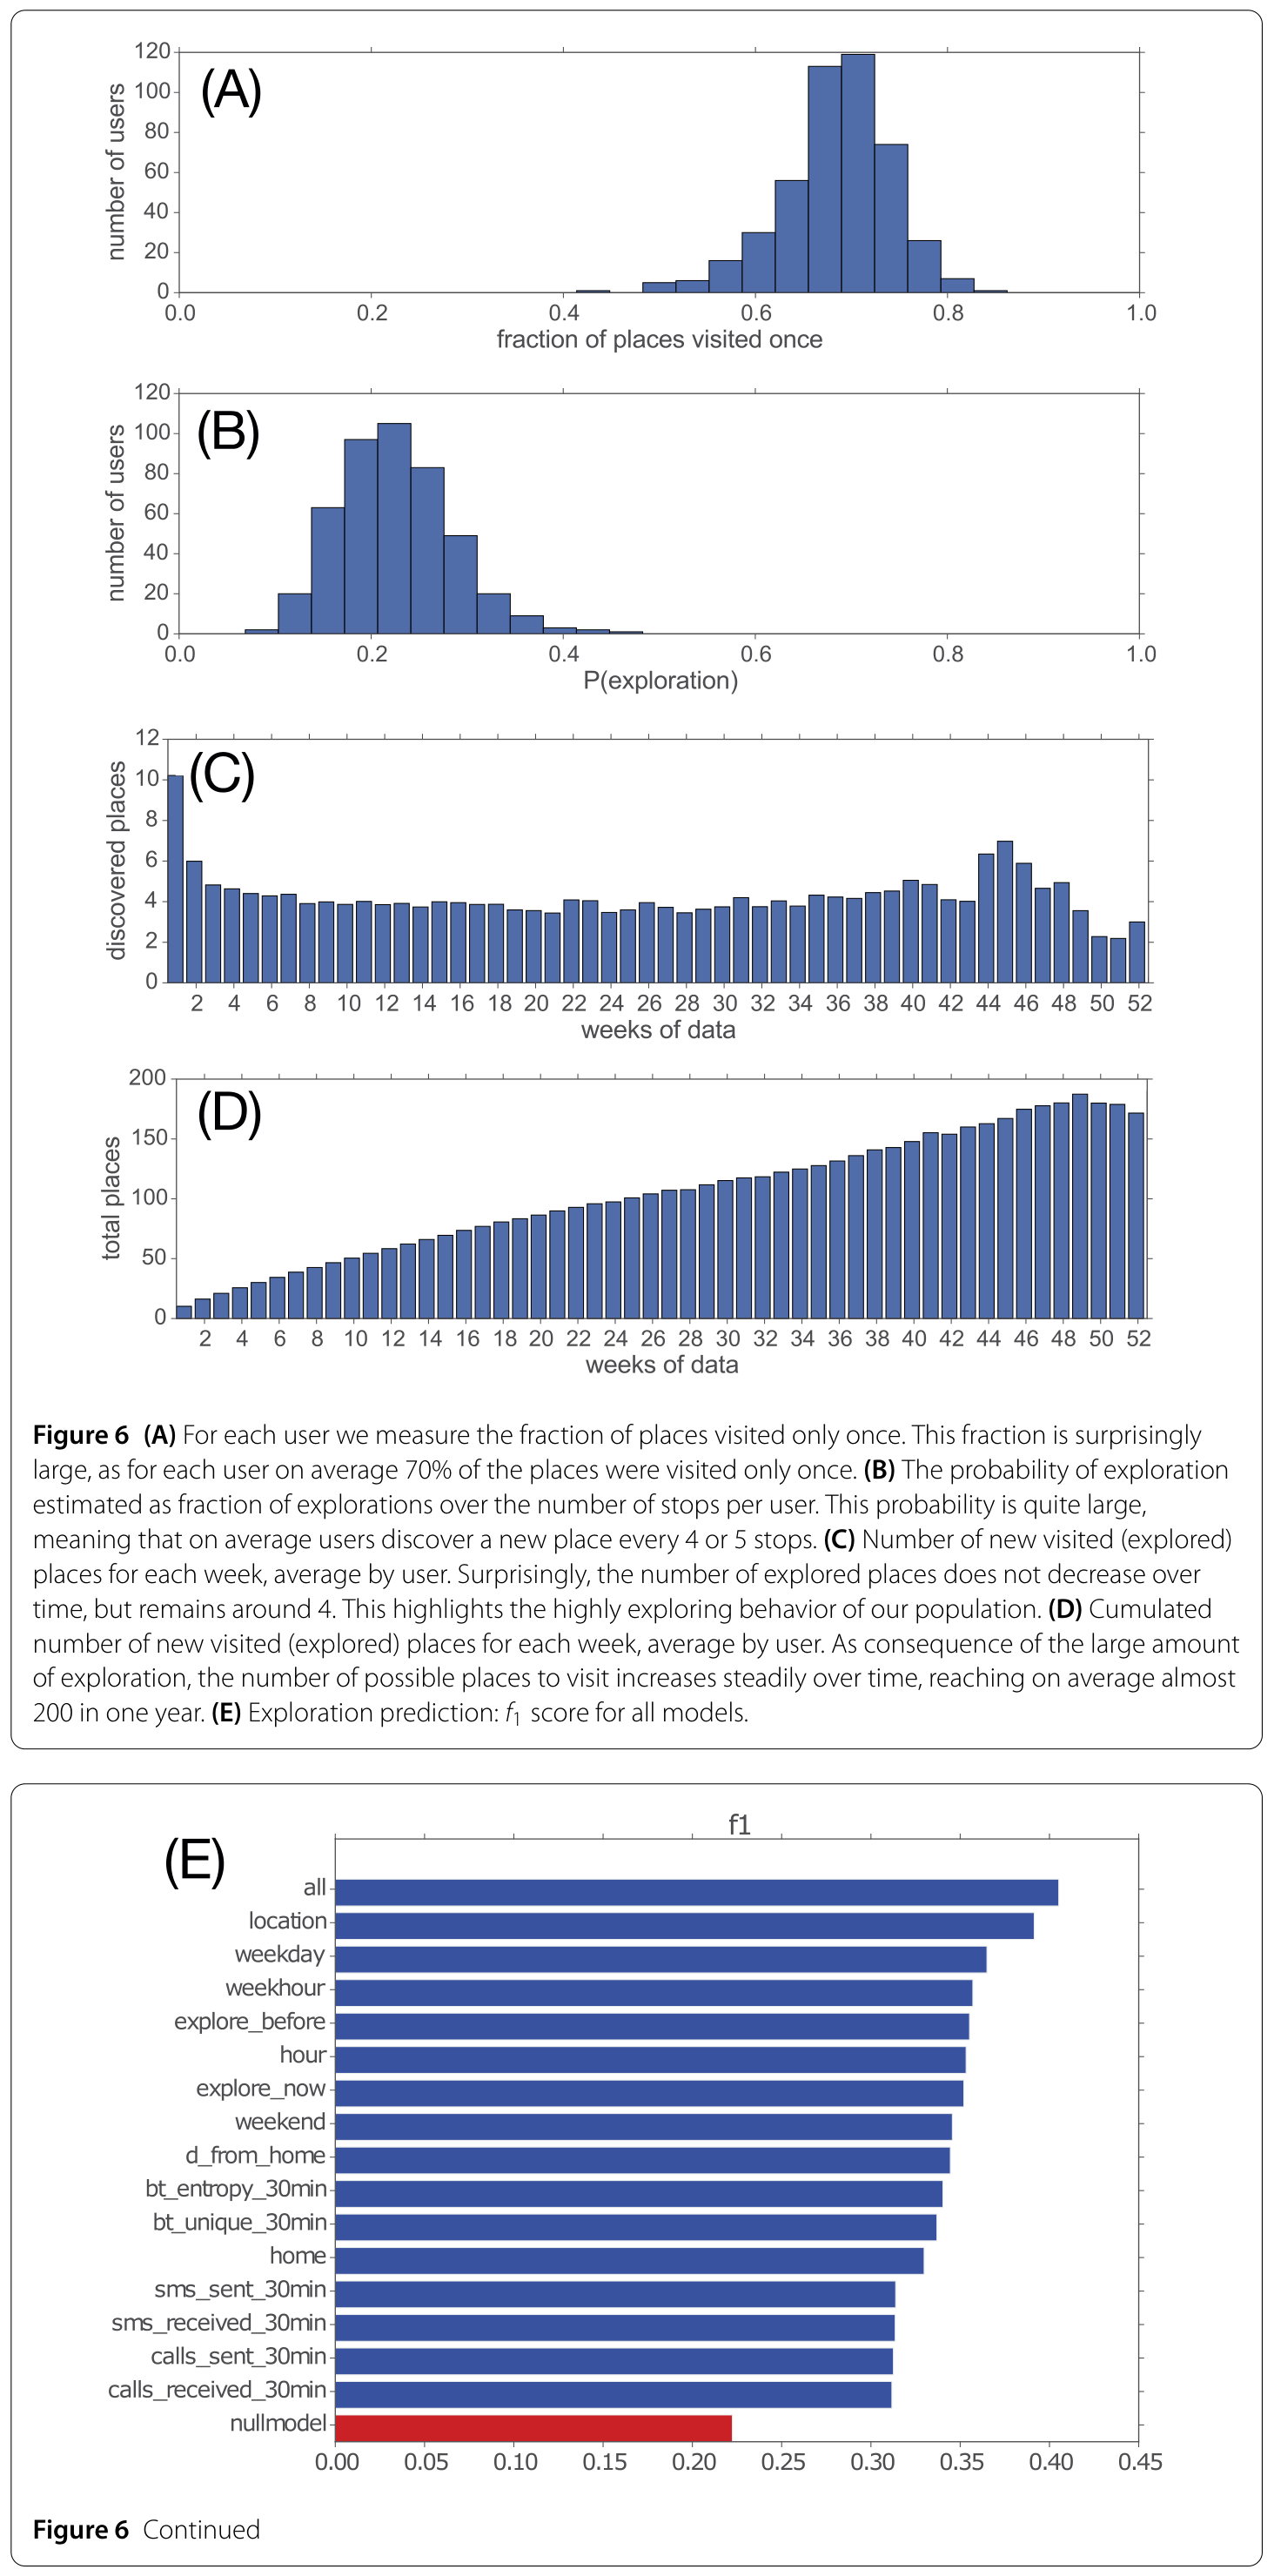
图 6|新地点有多常见,能不能提前判断下一次是探索?
(A)每个用户“只去过一次的地点÷该用户地点数”,分布集中在0.7附近,用户平均为70%。(B)探索次数÷停留次数,分布中心约在0.2,正文概括为0.2–0.25。(C)按用户平均的每周新地点,横轴到52周;多数周在4附近,开头更高,后段有起伏,没有掉到0。(D)累计地点数大致上升,一年平均接近200。(E)探索预测的F1,横轴到0.45;全特征最长,当前位置次之,红色随机基线最短。来源:原论文 Fig. 6。
图6(A)的70%是地点数里的比例。只去过一次的地点占地点数的七成,其余约三成至少出现过两次。作者同时说,大多数出行发生在这些会再访的地点之间。正文没有给出“再访地点承担了百分之多少停留”的数字,所以不能把70%理解成70%的停留都是一次性的。一次性地点很多,和大多数停留仍回到旧地点,可以同时成立。
每周新地点按用户平均后维持在4个左右,并没有随着观察变长而消失。累计曲线因此继续上升。正文写,超过53周时平均约200个不重复地点;图6(D)横轴画到52周,平均接近200。候选类别不断变多,分类器要在越来越长的名单里做选择。
由定义还可以推出一条论文没有单独印出的上界。若20%–25%的停留是第一次去某地,而模型只能输出已经见过的地点编号,这些步必然猜错,准确率至多约0.75–0.80。实际马尔可夫的分布峰只有约0.4,熵方法的上限峰是0.68。新地点解释了为什么100%不可能,解释不了从0.75再到0.40的那一段;已知地点之间的选择仍然不确定。
先判断下一次是不是探索,能判断到什么程度?
地点编号猜不准,还可以先问一个更窄的问题:下一步是探索还是返回。作者提出的基线是按先验随机猜,P(探索)≈0.2。逻辑回归沿用上一节的特征,并加上两个指示:当前停留是不是探索,上一次停留是不是探索。直觉是探索可能连着发生。
探索远少于返回。若模型永远猜返回,准确率会看起来不错,召回率却是0。所以这里不用准确率,而用F1,即精确率与召回率的调和平均。精确率是猜对的探索除以所有被猜成探索的次数;召回率是猜对的探索除以全部真正的探索。
全特征模型最好。单一特征里,当前位置最高;作者解释为某些地点像探索的门口,例如火车站。这是解释,不是一张把车站识别出来的结果。时间特征也不错。当前或上一次是否为探索也有用,作者据此认为探索有成串出现的成分。短信和通话的F1条更短,但仍高于红色的随机基线。
最佳模型的平均精确率是0.3,平均召回率是0.65。也就是说,它报出的探索里大约三成是真的,同时抓住了大约三分之二的真探索。把这两个平均数代入2PR÷(P+R),得到约0.41。正文没有把0.41印成“平均F1”,而引言把探索是否发生的最好成绩写成41%的准确率。图6(E)的横轴是F1,全特征条最长,并超过0.40。因此这个41%应和F1放在一起理解。它和下一地点里“猜对步数÷预测步数”的约0.4使用的是两种不同的分数。
更关键的边界是:这道题只判断会不会去一个没去过的地方,不预测那个新地方在地图上的坐标。作者明确说,预测下一次新地点本身超出了本文范围。
这些数字不能推出什么?
454人是连续记录足够长的学生,不是800多名参与者的随机子样本,也不是城市居民的概率样本。作者自己写道,学生往往没有单一工作地,一周甚至一天里要换多门课,年轻人群的日程可能更不规律、更爱探索。文中没有另一组上班族做对照,所以20%–25%的探索比例不能写成所有成年人的出行规律。
高相关也停在预测成绩上。马尔可夫与停留策略的r=0.993,说明两种预测分数几乎一起变化;它不说明人的移动机制就是马尔可夫链。逻辑回归拟合的是下一地点编号,类别里没有未见地点,拟合好也不等于找到了人决定去哪的原因。
空间分辨率把任务变容易之后,高准确率不能搬回50米的下一地点。5000米格子上的分布挤在0.9以上,回答的仍是“下一个时间片还在不在这5公里里”。可预测性上限同样不能当成模型成绩:下一地点的上限峰是0.68,马尔可夫的实际分布峰约0.4。
数据不能公开复算。欧洲与丹麦的隐私规则下,作者只接受符合条件、签署保密协议并在哥本哈根接受监督的研究者申请。
一句话总结
同一批轨迹上,下一个15分钟的格子之所以好猜,很大程度是因为人还停在原地;一旦只看下一次地点切换,大约每4到5次停留就有一次是新地点,只在旧名单里挑答案的模型会在这里碰到天花板。
核心来源
Cuttone A, Lehmann S, González MC. Understanding predictability and exploration in human mobility. EPJ Data Science. 2018;7:2. doi:10.1140/epjds/s13688-017-0129-1
Andrea Cuttone是通讯作者。论文署名单位是丹麦技术大学计算系,以及麻省理工学院土木与环境工程及工程系统系。文末贡献说明里,他参与设计研究、分析数据并撰写论文。本文引用的哥本哈根网络研究测量论文也列有他的作者身份。
Sune Lehmann的署名单位是丹麦技术大学计算系,以及哥本哈根大学尼尔斯·玻尔研究所。论文写明他是哥本哈根网络研究的负责人。贡献为设计研究并撰写论文。
Marta C. González的署名单位是麻省理工学院土木与环境工程及工程系统系、加州大学伯克利分校城市与区域规划系,以及劳伦斯伯克利国家实验室。贡献为设计研究并撰写论文。本文参考文献中的个体移动模式和辐射模型论文,列有她的共同作者身份。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
校园应用如果把“15分钟后还在不在这50米里”当成预测成功,停留策略就能交出接近马尔可夫的分数。这个分数对提醒“你还在图书馆”有用,对“下一节课后去哪栋楼”几乎没有用。评价一个出行产品时,要先写清成功的一步是时间片、地点切换,还是新地点的坐标。
探索预测若按准确率排名,永远猜“返回”的模型会因为返回占了大多数停留而显得很好,同时一次探索也抓不到。论文改用F1,就是为了让这种空模型显出召回率为0。一个只公布准确率的榜单,会把这个空模型排到前面;精确率0.3、召回率0.65才说明全特征模型报出的探索里仍有约七成是误报。
把格子放到5公里,可以让下一时间片的分布挤到0.9以上。用这个数字去比较另一篇50米、且不计自转移的论文,会重新制造“90%对40%”的错觉。比较之前至少要对齐三件事:上限还是实际准确率,时间片还是地点切换,以及一格有多大。
这组人是课表经常变化的学生。若一位上班族的地点几乎只有家和公司,探索比例可能低得多,本文的20%–25%就会高估他的新地点频率。反过来,一个人每天走不同的路、但仍在同一组建筑之间切换,地点级探索可以是0,路线却是新的。本文的探索只认DBSCAN之后的新地点编号,不认新路径。