家里的房间转换,为什么收不成一条出门那种幂律?
论文名片|Daniel Austin、Robin M. Cross、Tamara Hayes、Jeffrey Kaye,Regularity and Predictability of Human Mobility in Personal Space,PLoS ONE,2014,9(2):e90256,2014年2月27日发表。DOI:10.1371/journal.pone.0090256。本文依据这一期正式版解读。这是一项观察研究:用居家传感器记录房间之间的转换次数,再用负二项回归描述情境与次数的关系,不是随机实验。
夜里,客厅的红外传感器常常一整段时间都不亮。早上,同一个人可能在两分钟里接连走过走廊、厨房和卫生间。把这些转换按天加总,有的日子会比前后高出一倍。家以外的人类移动性(human mobility)研究里,出行距离常常收成一条与时刻无关的幂律;换一批人,归一化之后还可能落到相近的标度上。家里如果也是这样,不同老人的房间转换在做同样的归一化之后,应该叠成同一条线。
它们没有叠上。日尺度上,多数人各自还能配一条截断幂律,人与人的参数对不齐;两分钟尺度上,幂律对所有人都不成立。把钟点、天气、步速和此前的活动写进模型之后,次数呈现出另一种结构:在允许少数几次误差时,估计值贴近观测。这种贴近要先越过一条很硬的基线,即绝大多数两分钟本来就是零次转换。它描述的是情境已知时的次数,不是疾病是否会发生。
先说结论
- 按每人自己的中位日转换次数和家中传感器数量归一化后,19人里有17人的日转换次数可以用双侧截断幂律描述。下限、上限和指数三项在人与人之间都不同,合不成一条通用曲线。两分钟尺度上,19人全部与幂律不符。
- 全部14,920,560个两分钟观测里,91.4%是0次转换,观测到的次数从0到41。在这个多数类基线上,模型估计与观测相差不超过1次的样本占95.8%,不超过3次的超过99%。3次是0到41这一范围的3/41,论文称之为相对于数据范围的7%误差。
- 按每种次数占全部两分钟样本的概率来比,模型把0次高估1个百分点,把1次低估1.2个百分点,其余次数的概率差不超过0.2个百分点。
- 其余变量固定时,年龄从71岁到97岁,两分钟期望转换次数变为0.83倍,完全不动的条件概率变为1.7倍。同伴参照步速、日最高气温和社会经济地位分数朝高处走时,期望次数上升、不动概率下降。这是回归里的条件关联,不是把年龄或天气单独操纵后的因果效应。本文没有报告任何疾病或功能评分的预测结果。
这里数的是房间之间转换了几次
分析单位是一个人在一个时间窗里的移动性 mᵢ:在第 i 个间隔中,从一间房间走到另一间房间的次数。它是计数,不是公里,也不是停留了哪一间房。日尺度把两分钟计数加总成24小时;细尺度直接使用两分钟。
数据来自评估老化变化的智能系统研究(Intelligent Systems for Assessing Aging Changes,ISAAC)。本文使用其中19名老年人在自己家中、最长5年的被动监测,合计14,920,560条两分钟记录。参与者提供了书面知情同意,队列由俄勒冈健康与科学大学机构审查委员会批准(IRB# 2353)。Kaye 等人2011年的队列论文报告,该研究最初入组265人;本文没有说明这19人如何选出,因此结果不能写成全体入组者的规律。
平均每户用于日尺度幂律拟合的样本是1,090天。两分钟分析平均每户785,292个间隔,其中非零67,535个。1,090天约合3年,短于“最长5年”的上限,说明各户监测时长并不一样。14,920,560除以19约为785,292.6,与“平均每户785,292个间隔”一致,总次数不是19个完全相同的整数相加。
家里没有像手机基站那样人人共用的坐标系。户型、家具和传感器个数都不同,计算机房或第二卧室也不能在人与人之间对齐。所以本文比较的是时间上的次数,而不是谁更常去某一个具名房间。传感器数量和个人中位活动水平会在幂律归一化里被用到;房间平面图的例子放在补充图 S1,这份正文没有附上该图。
日尺度能各自配上幂律,为什么仍然没有通用指数?
出门研究促使作者先检验一条双侧截断幂律:在下限 mₘᵢₙ 和上限 mₘₐₓ 之间,P(m) 正比于 m 的 −α 次方。上限对应一段固定时间里生理上走不了无限次,下限对应经验分布往往只在尾部像幂律。α 在这一节是幂律指数。
日转换次数先除以该人自己的中位日转换,并考虑家中传感器数量,再做拟合。归一化的具体公式在补充材料 S1,正文没有写出算式。这样处理后,19人中有17人可以用截断幂律合理描述。补充图表说明,不符合的是第6户和第18户。归一化之后,各户并没有塌缩成同一条幂律。mₘᵢₙ、mₘₐₓ 和 α 三项都存在显著的个体差异。正文据此认为,家里不存在一个通用的标度指数,但每个人自己仍可以很有结构。各户的参数估计、标准误和拟合 p 值在表 S1,正文没有列出数字,所以这里不能比较谁的指数更大。
两分钟数据则全部拒绝幂律。突发的走动夹着长时间的静止,不能用一条不随时间改变、只属于个人的幂律密度来概括。作者同时提醒检验的方向:Clauset 等人的常规做法把“数据来自幂律”当作原假设,样本越少越不容易拒绝。日尺度平均只有1,090天,两分钟平均有785,292个间隔。因此作者认为,两分钟上“没有合理的幂律”比日尺度上“可以拟合”更值得相信。这只说明两种时间粒度的分布形状不同,还不能单独证明家里和家外是两种机制。
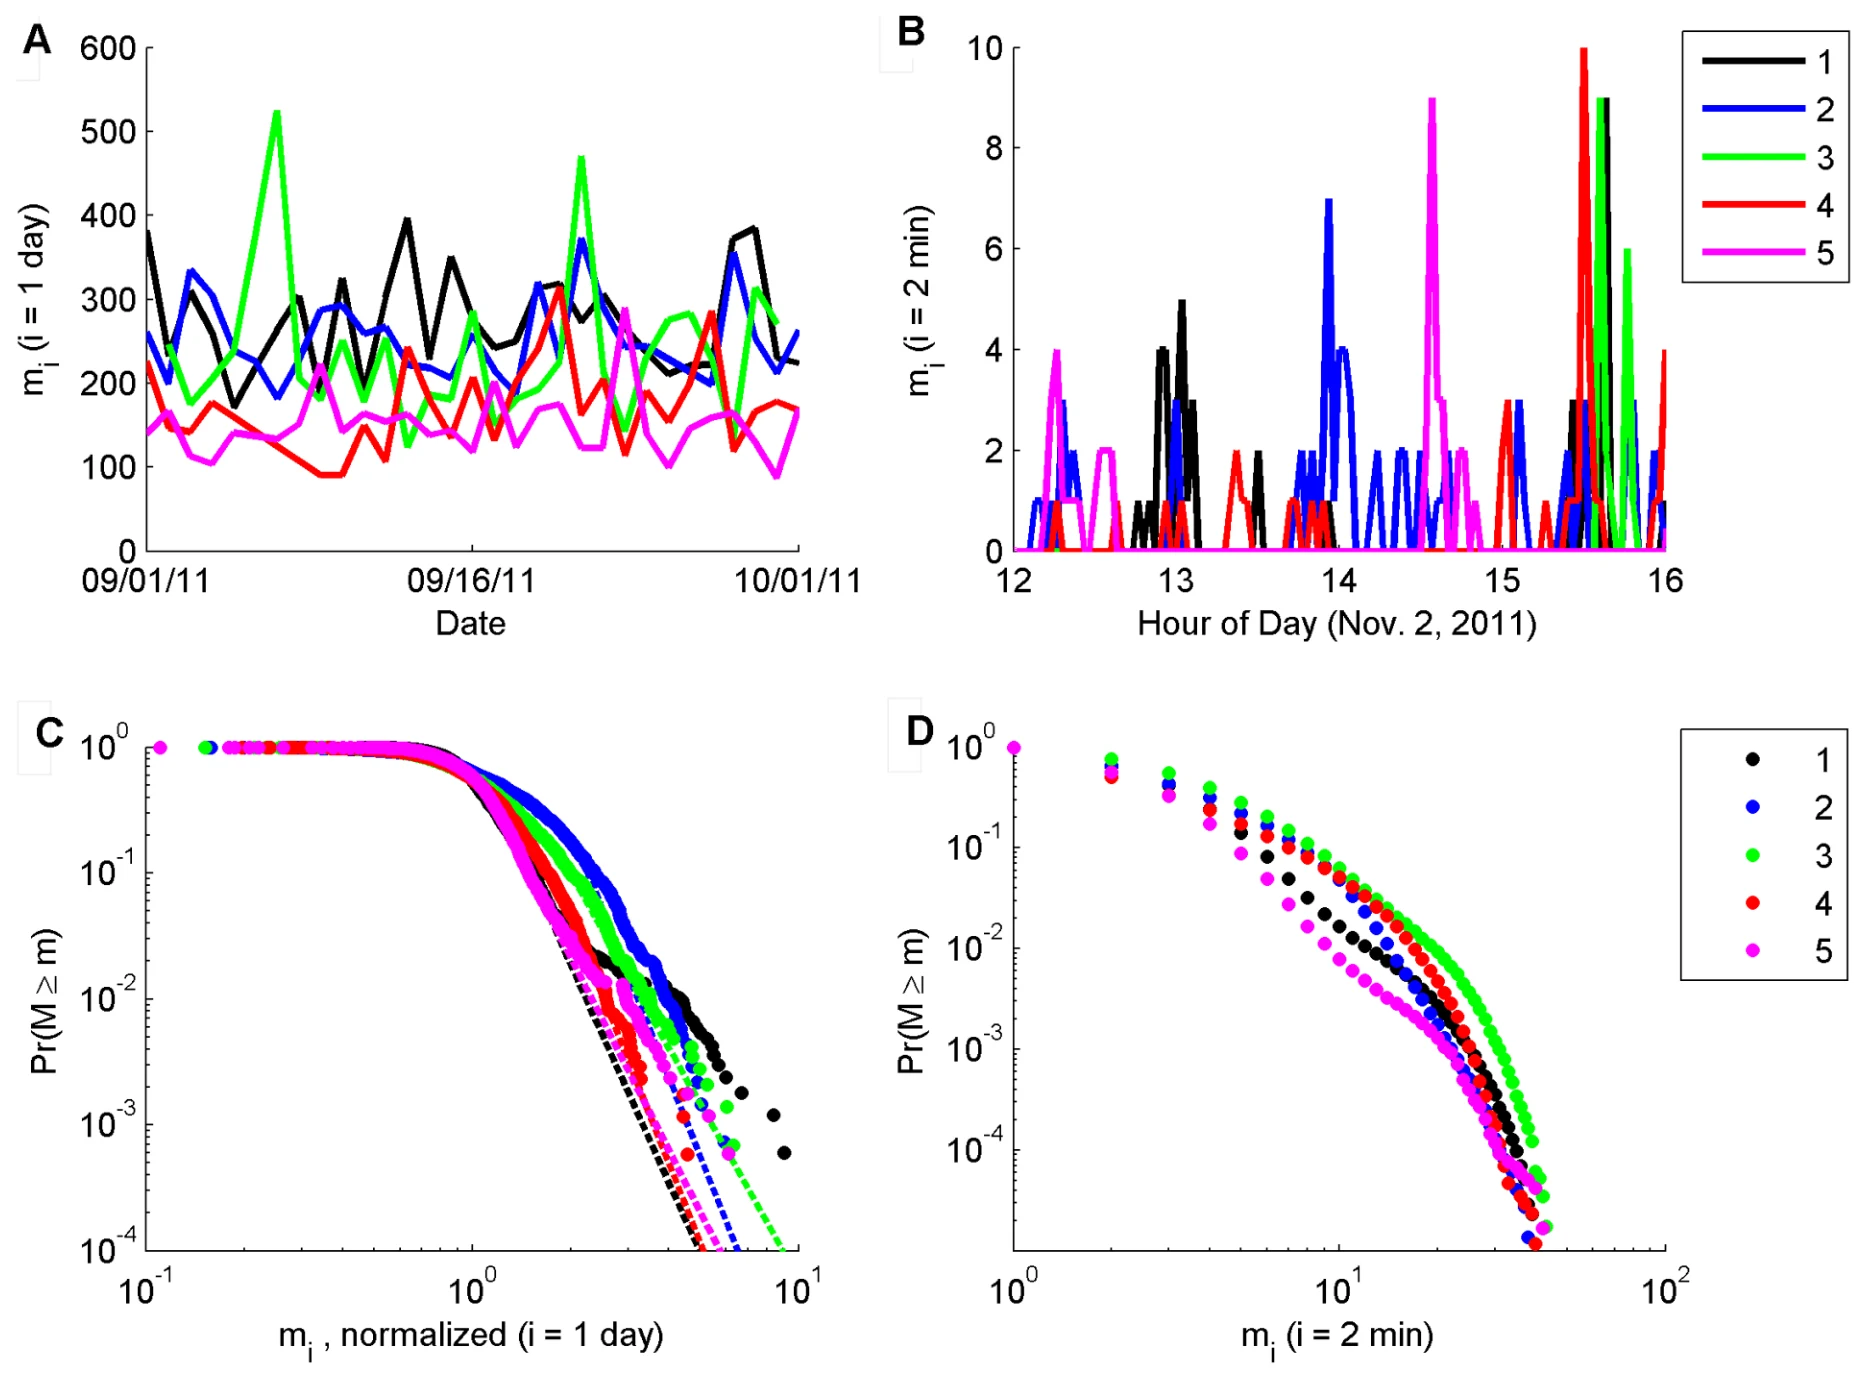
图 1|一天和两分钟的房间转换长什么样,幂律能不能套上?
(a)5位参与者从2011年11月1日起31天的日转换次数。纵轴 mᵢ 是一天内的房间转换次数,横轴是日期。各人维持在各自的水平上,并会出现论文所说的翻倍式起伏。(b)2011年11月2日12时至16时、每两分钟的转换次数。纵轴是两分钟次数。大部分间隔贴近零,中间夹着突然升高的尖峰,说明(a)里的日总量是由这些爆发累加而成的。(c)日次数经个人归一化后的互补累积分布,圆点为5户,虚线为各自的幂律。曲线分得开。因为画的是累积分布而不是密度,图上斜率对应 −α+1。(d)两分钟次数的互补累积分布,尾部很重,但与幂律不一致,所以没有拟合虚线。颜色1至5对应同一批参与者。来源:原论文 Fig. 1。其余14户的同类图在补充图 S2–S4;图注写明第6户和第18户在日尺度上也不符合幂律。
次数是计数,为什么改用负二项而不是再换一条幂律?
幂律密度配不上这些计数,而 mᵢ 又是非负整数,作者改用负二项回归。给定情境向量 xᵢ,两分钟次数服从负二项分布。期望 μᵢ 满足 ln(μᵢ) = xᵢβ。β 的每一项表示:其他变量不变时,对应解释变量增加一个单位,期望次数按乘法改变多少。条件方差是 μᵢ + αμᵢ²。多出来的 αμᵢ² 用来容纳“有时完全不动、有时突然连走几间房”。这里的 α 是负二项的离散参数,和上一节的幂律指数不是同一个数。
解释变量共88个,分成七类:行为,例如步行速度;天气,例如气温和降水;自我报告,例如年龄和健康状况;同伴参照,例如同伴组的步行速度;时间依赖,例如时刻和滞后活动;缺失数据;物理环境,例如住宅大小。前五类用来连接可观测情境和次数,后两类用来处理缺失以及人和住宅的差别。88个变量看起来很多。作者的理由是观测条数很大,并指出补充材料讨论了过拟合。需要分开看的是:条数大,是因为同一个人被每两分钟记一次;独立的住宅只有19户。年龄、社会经济地位这类变化很慢的变量,跨人的信息主要来自这19户之间的差别,不能把1,492万理解成1,492万个独立的人。
正文称,拟合后的模型在统计上显著,并且能准确代表数据。显著性检验、替代模型和88个系数的估计写在补充材料 S1 与表 S2,正文没有给出系数表。下面只用正文和图注已经写明的准确率与变化倍数。
准确率必须超过“永远猜零”
可预测性可以定义成熵,那条路不需要先做出一个能输出次数的模型。Song 等人2010年对家以外移动使用的就是这种理论上限。本文走另一条路:模型对每一个两分钟样本给出次数,再直接数估计对了多少。因此这里的百分比不能和那篇论文里的可预测性上限对照。
第一种指标是估计被算作正确的样本比例,并且允许一定的绝对误差。全数据有91.4%的观测是0,次数范围是0到41。若一个模型永远输出0,精确命中率就是91.4%。作者因此要求,有意义的可预测性必须明显高于91.4%。允许误差不超过1次时,95.8%的估计落在观测旁边;不超过3次时超过99%。3次是0到41这一范围的3/41。相对91.4%的精确命中基线,95.8%只高出4.4个百分点;超过99%对应的是更宽的误差带,不是精确猜中每一次。正文描述的是把模型拟合到这批观测之后的估计准确率,没有另行报告留出样本上的成绩。
第二种指标比较每一种次数的概率:模型给出的概率减去数据里真正出现的比例。0次被高估1个百分点,1次被低估1.2个百分点,其余次数的概率差不超过0.2个百分点。这里的分母是全部两分钟样本,不是“在已经发生移动的样本里”。图上的置信区间窄到与曲线分不开,分档数字和区间在表 S3、S4,正文没有列出。
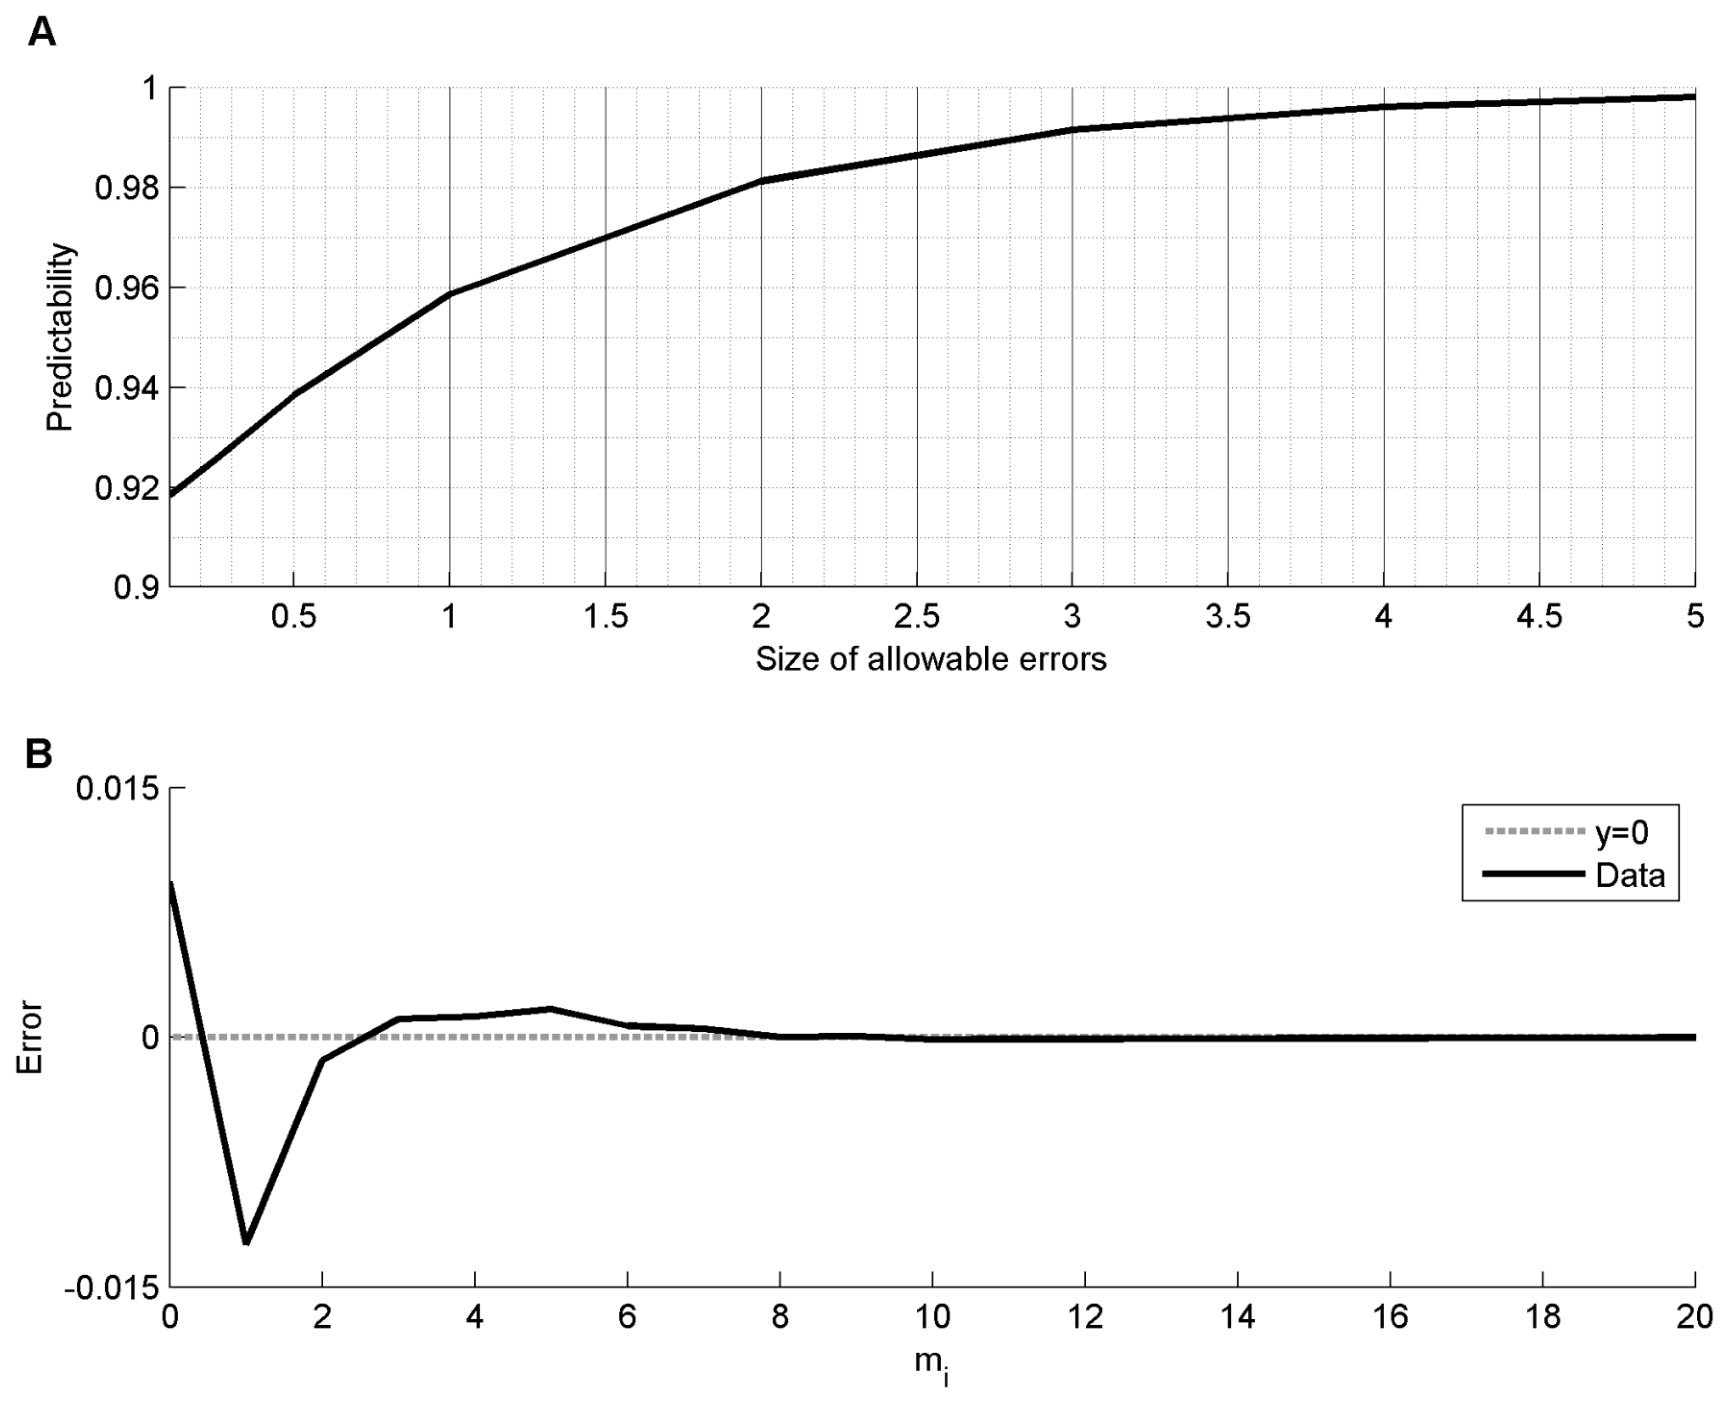
图 2|允许差几次时,估计有多接近观测?
(a)纵轴是被算作正确的两分钟样本比例,横轴是允许的绝对误差,单位是房间转换次数。误差不超过1次时为95.8%,不超过3次时超过99%。纵轴从0.9画起,因为全数据已有91.4%的样本是0次。(b)纵轴是估计概率减去观测概率,横轴是该间隔的转换次数 mᵢ。0次的概率比观测比例高1个百分点,1次低1.2个百分点,更大的次数贴近灰色虚线 y = 0。来源:原论文 Fig. 2。
规律指的是时间节奏,不是回到同一间房
常见的移动规律用回访概率或待在高频地点的时间来衡量。本文没有把地点放进模型,所以不能回答“会不会回到客厅”。作者改看时间上的节奏,以及多个时间尺度上的相关。
模型里放入一天中的钟点,也放入从两分钟前到一个月前的滞后活动。一个月是模型包含的最长滞后。全部行为变量在这些滞后上都表现出某种影响,钟点、月份和年份也会改变观察到的次数。作者把这解读为昼夜、长于一天和短于一天的周期,以及多尺度自相关:若没有模型里的其他突发情境,人会在夜里动得少、早晨动得多。各钟点、各滞后的系数大小仍在补充材料,正文没有给出“早晨比夜里多几次”的数字。因此可以确认时间结构被放进了模型并具有作用,不能从正文读出一张24小时时间表。
四个情境变量各自把期望挪动多少?
回归系数还能回答:其他量不动时,某一个情境改变,次数的分布怎样移动。图3和图4挑选了四个变化速度不同的变量。年龄对每个人都随时间线性增加;日最高气温可以逐日变化;同伴参照步速可以在相邻的两分钟之间变化;社会经济地位在这些参与者当时的生活里相对固定。其余变量都固定在一组指定值上,图注写明性别取女性。那组参照值的清单在补充材料,正文没有列出,所以纵轴的绝对高度不能脱离这组参照来读。
年龄升高伴随期望次数下降;气温、同伴步速和社会经济地位升高伴随期望次数上升。同一方向上,期望次数变高时,完全不动的条件概率变低。图4的纵轴是模型在该参照点上的 P(mᵢ = 0)。图中曲线落在 0.2 以下,而 91.4% 是全部两分钟间隔的无条件零次比例,两者分母不同:后者把所有时刻和所有人合在一起,前者是其余变量固定之后的条件概率。
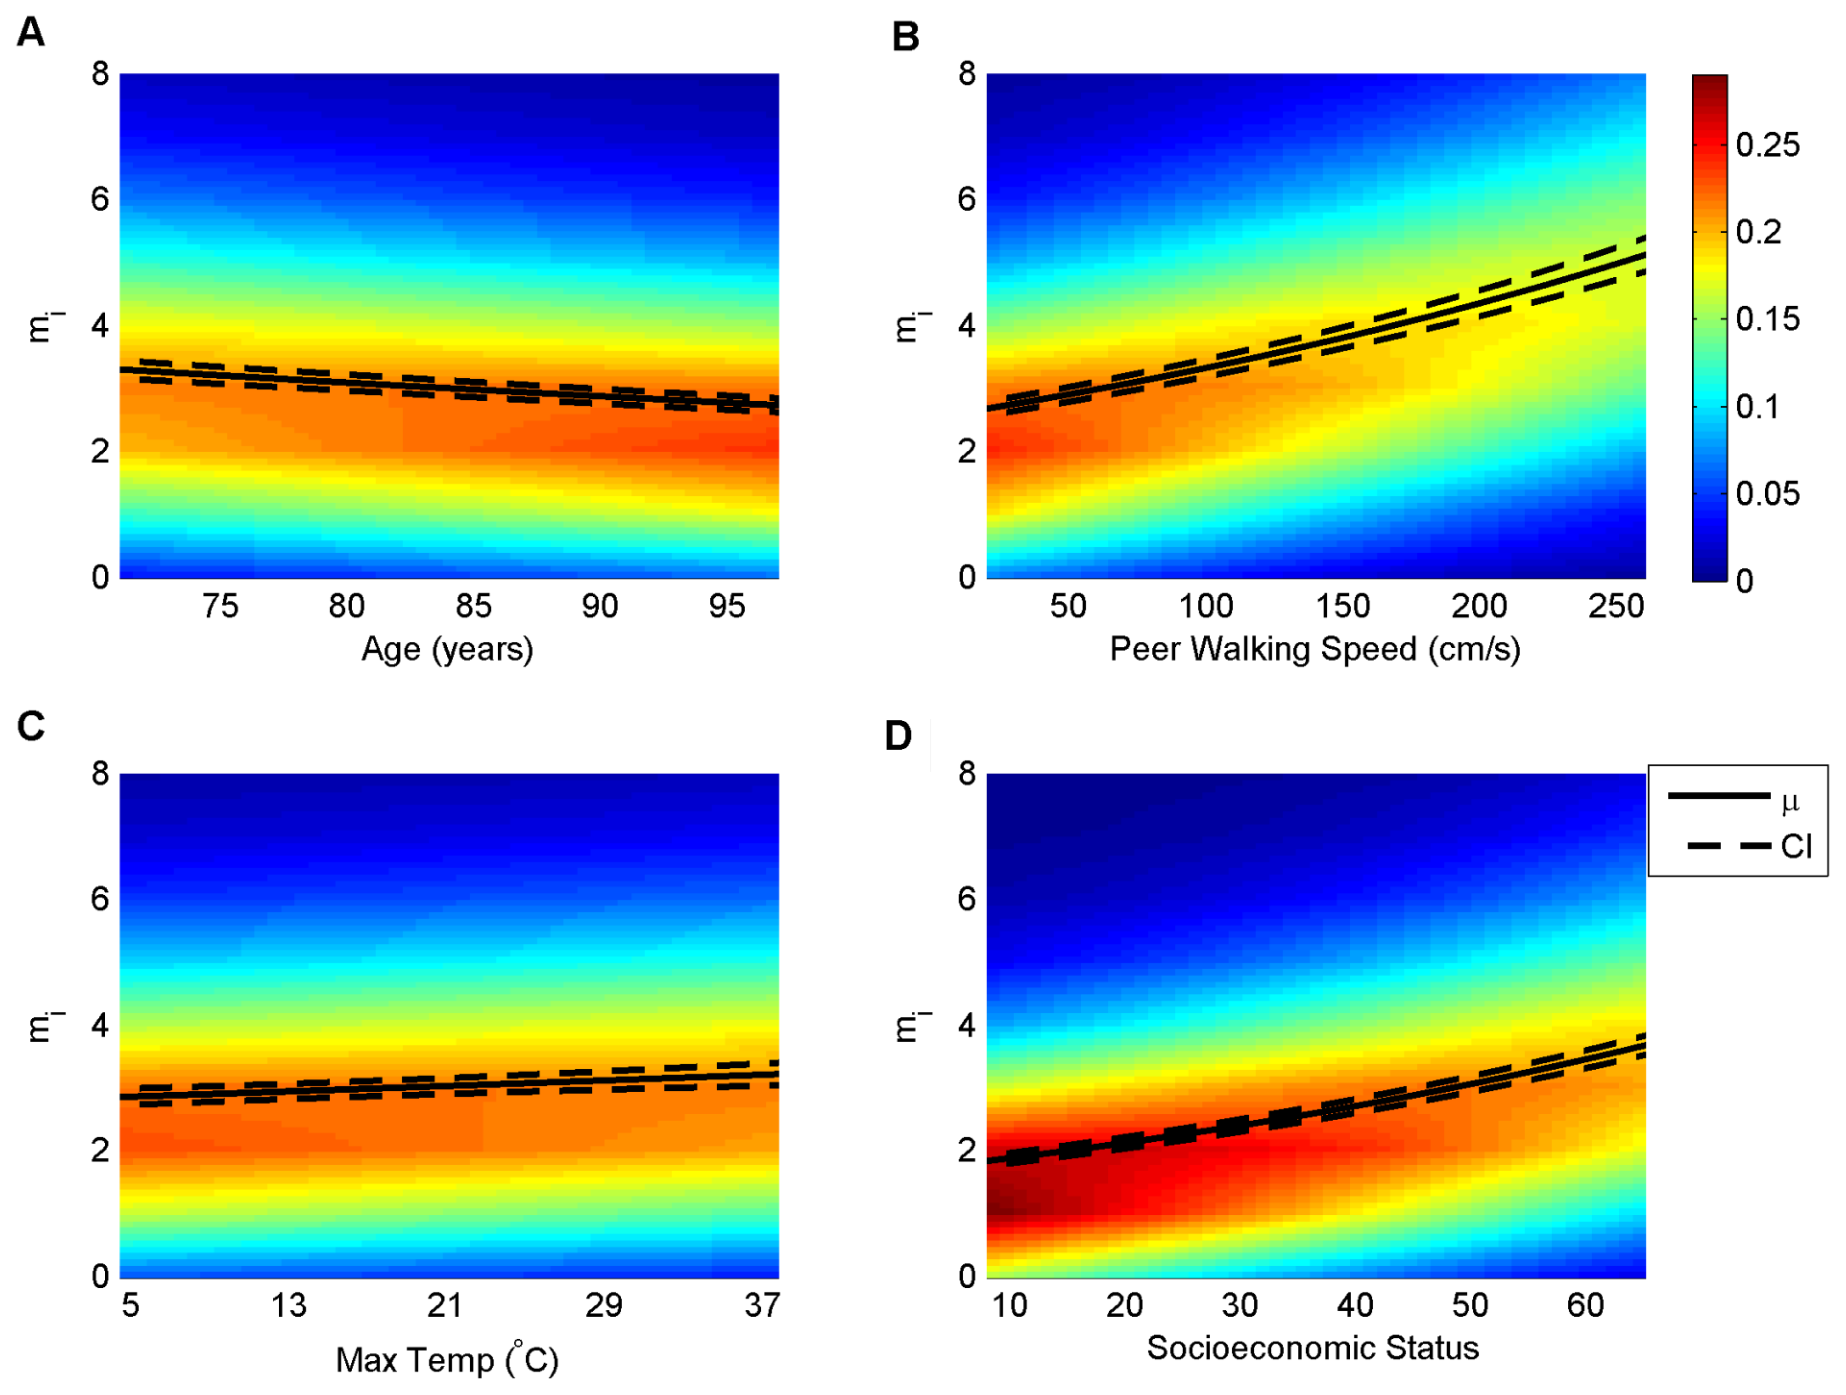
图 3|其余变量固定后,期望转换次数怎样变化?
颜色是负二项概率密度,离散概率为了作图做了线性插值,色标从蓝到红表示密度升高。黑实线是期望 μ,黑色虚线是95%置信区间。纵轴是一个两分钟间隔的期望转换次数。四张图都不是19人的原始散点。(a)年龄从71岁到97岁,期望次数变为0.83倍。(b)同伴参照步行速度从20厘米/秒到260厘米/秒,期望次数变为1.9倍。(c)日最高室外气温从5°C到37°C,期望次数变为1.12倍。(d)社会经济地位分数从8到65,期望次数变为2倍。正文没有定义这个分数对应的收入、教育或职业。来源:原论文 Fig. 3。
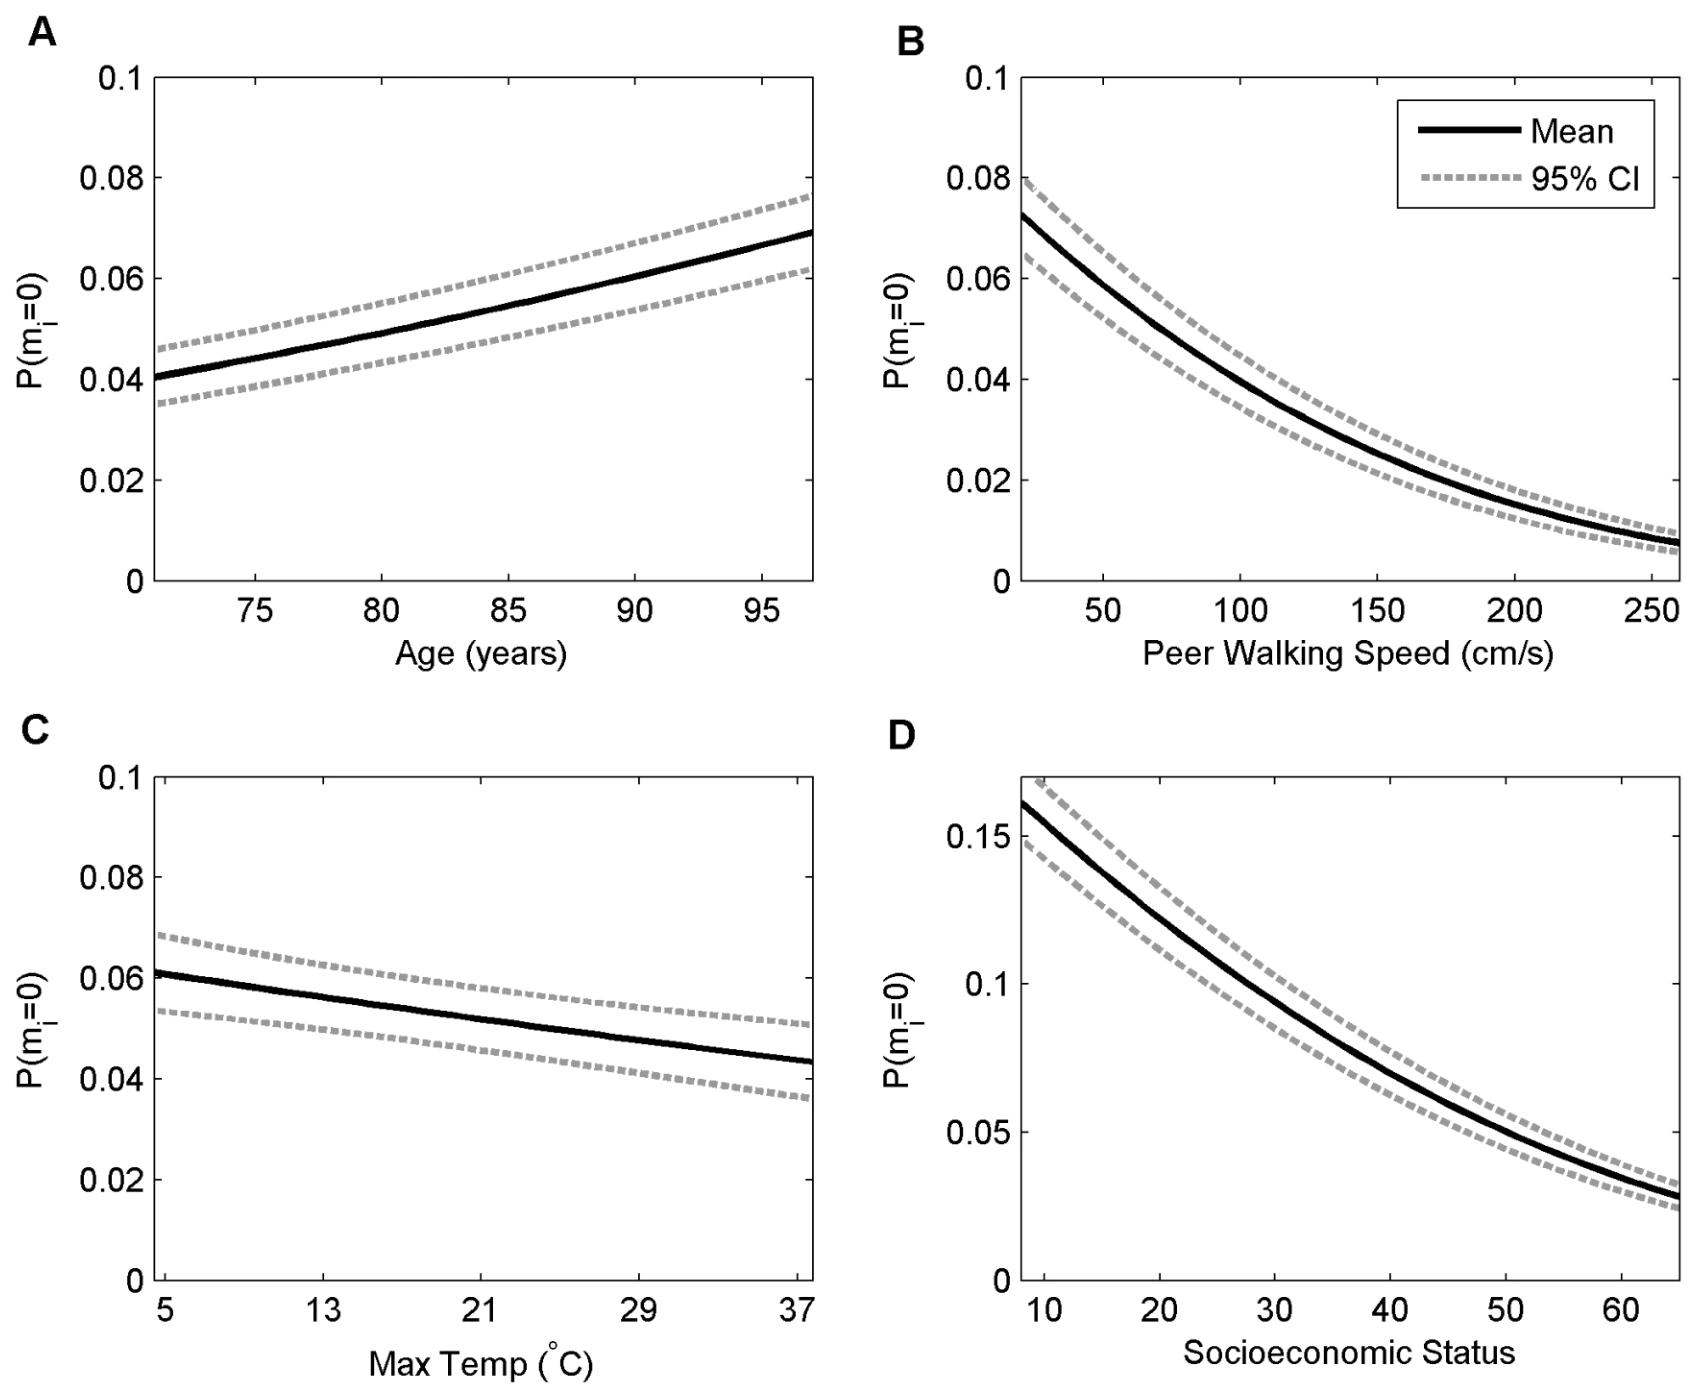
图 4|同一组固定情境下,完全不动的概率怎样变化?
纵轴是条件概率 P(mᵢ = 0),黑线为均值,灰线为95%置信区间。性别固定为女性,其余参照与图3相同。(a)年龄从71岁到97岁,不动概率变为1.7倍。(b)同伴参照步速从20厘米/秒到260厘米/秒,不动概率变为0.1倍。(c)日最高气温从5°C到37°C,不动概率变为0.71倍。(d)社会经济地位分数从8到65,不动概率变为0.17倍;这一面板的纵轴范围更大。图注里的 factor 与(a)的1.7倍同一用法,这里都按终点相对起点的倍数来读。来源:原论文 Fig. 4。
这些倍数都是“其他解释变量保持不变”时的模型比较。年龄从71岁到97岁横跨26岁,但样本只有19名老年人,年龄效应同时混有人与人的差别和同一个人变老。同伴步速升高与本人次数升高一起出现,并不能区分共享的作息、同一住宅里的另一位居民,或仅仅是白天大家都在走。260厘米/秒是图中该变量的高端,不是声称每位参与者都以这个速度走路。
这些结果能说到哪一步
家里的移动在这份数据里是高度刻板的,含义是:情境写进模型之后,次数在样本内可以被估计得很近,并且时间上有多尺度相关。它不是一条人人共享、与时间无关的幂律,也不是已经证明常规一旦打断就会生病。摘要和讨论提到,监测房间级常规的中断,也许有助于预判健康、功能状态或不良趋势,并让临床试验更有意义。本文没有把住院、认知分数或任何健康结局放进结果。
另外两条边界跟着数据走。第一,房间转换取决于传感器摆在哪里、住宅被分成几块。一个人在同一房间里来回走,可能记成0次。未经归一化就比较各户的原始次数,会把户型和走动混在一起。第二,部分采集电脑由英特尔公司出资购买;Hayes 曾持有该公司的重大经济利益,论文写明这一利益已经由俄勒冈健康与科学大学审查管理,资助方不参与研究设计、分析和发表决定。
一句话总结
这19位老人的居家房间转换收不成一条通用、且与时间无关的幂律;把情境放进负二项模型后,估计值落在观测值3次以内的两分钟样本超过99%,但全部样本里已有91.4%本来就是0次,而且本文没有证明偏离常规等于健康发生变化。
核心来源
- PLoS ONE 正式版,核对题目、作者、2014年2月27日发表日期与 DOI:10.1371/journal.pone.0090256。正文图为 Fig. 1–4。各户幂律参数、88个系数和分档准确率分别在表 S1–S4,变量定义与参照值在 Supporting Information S1。
- Kaye 等(2011)对 ISAAC 队列的方法学描述,见该文引用文献20。本文分析样本是其中19人,不是该文报告的全体入组者。
作者介绍
- Daniel Austin:通讯作者,署名机构为俄勒冈健康与科学大学生物医学工程系,邮箱 austidan@ohsu.edu。论文贡献说明中,他参与设计、与 Cross 共同分析数据,并参与写作。
- Robin M. Cross:署名机构为俄勒冈州立大学农业与资源经济系。他参与设计、与 Austin 共同分析数据并参与写作。俄勒冈州立大学应用经济系教师页列出他的职称为 Assistant Professor (Sr Res),研究方向包括计量经济与机器学习。
- Tamara Hayes:署名机构为俄勒冈健康与科学大学生物医学工程系。她参与设计、写作,并与 Kaye 一起开展提供数据的居家监测。论文利益声明写明她已经去世。俄勒冈衰老与技术中心官网称她是该中心创始成员之一,研究方向是支持老年人居家生活的技术,于2013年去世。
- Jeffrey Kaye:署名机构为俄勒冈健康与科学大学生物医学工程系和神经内科。他参与设计、写作,并与 Hayes 开展居家监测。该中心官网称他为神经内科与生物医学工程讲席教授、中心主任,研究包括用连续活动监测理解健康老化。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若要用“家里突然不动了”做健康提示,不能把所有零次两分钟都当成异常。全数据里91.4%的间隔本来就是零,夜里安静是模型所描述的常规的一部分。更可检验的信号是条件残差:在同样的钟点、天气和近期活动下,估计应有的次数与实际次数差多少,并且这种偏差是否连续出现。本文只说明情境模型能在样本内贴近次数,没有检验残差能否预测疾病。要把提示做成监测规则,还需要留出时间和留出的人,单独看残差与健康结局的关系。
另一个容易误用的地方是把房间转换直接当成活动量,拿到另一所住宅里比较。传感器少一圈、客厅和餐厅没有被分成两个探测区,同样的踱步会少记一次转换。本文已经用个人中位数和传感器数量处理幂律比较,并在回归里放入住宅环境变量。若新的住宅不在原来的传感器布设和这19户的情境范围之内,图3里那些倍数不能直接当成这户人家应有的期望。