郊区已经立起新中心,上班的人流为什么仍被市中心吸住?
论文名片|Zhimin Xie、Bo Huang、Jixuan Cai、Harry F. Lee,Commuting flow patterns across a triad of Chinese megacities: Evidence from Poisson gravity modeling using mobile device data,Journal of Transport Geography,128(2025):104380,2025年7月29日在线发表。DOI:10.1016/j.jtrangeo.2025.104380。本文依据该正式版及文内附录表 A.1–A.4 解读。
想象北京五环外的一个居住小区:夜里灯火很多,地图上也标得出郊区组团。若岗位也在当地配齐,早高峰应更多留在附近。三座超大城市的手机定位请求却给出另一种格局。居住可以铺到外围,就业对通勤流的拉动仍指向市中心;高密度地区的距离衰减更弱,加密本身并没有在模型里表现为更短的跨网格通勤。
这项研究用 2023 年 5 月的腾讯移动设备定位请求,在北京、上海、深圳的建成区 1 公里网格上,估计从家到工作地的单向通勤流,再用泊松伪极大似然(Poisson pseudo-maximum likelihood,PPML)引力模型比较土地利用、路网距离、公交覆盖和房价差。全市一个模型之外,再按每个起点、每个终点分开拟合。下面的数字都落在网格对上,分母会随结果一起写明。
先说结论
- 建模对象是建成区内不同 1 公里网格之间的全部有向起讫对。北京 43,797,931 对、上海 32,838,626 对、深圳 2,458,624 对;其中流量为正的只有 663,861、624,303 和 336,796 对。表 1 的平均流量 0.29、0.46、4.40 人,分母是这些起讫对,被大量零流量拉低。
- 解释变量先取必要的对数,再做 z 分数标准化。路网距离的标准化系数最大:北京 −1.331、上海 −1.559、深圳 −1.169。商业兴趣点、房价差和到市中心的距离是其余三个主要项。
- 工业兴趣点在北京、上海为负,在深圳为正,但深圳起点系数只有 0.003。公共管理与服务兴趣点则是北京、上海为正,深圳为负。符号差异成立,效应大小远小于商业兴趣点。
- 起点离市中心越远,期望通勤流越高;终点离市中心越远,期望通勤流越低。深圳起点系数 0.074,低于北京 0.130 和上海 0.170。作者据此描述形态上的多中心与功能上的单中心。
- 起点模型把共同通勤者比例(CPC)从 0.559、0.595、0.641 提高到 0.750、0.767、0.802。居住在距市中心 10–30 公里的人,工作地选择最受市中心吸引;高密度地区的距离衰减更弱。这是系数的空间格局,尚未证明密度导致通勤变长。
比的是建成区里的网格对,不是全市每辆车
研究区选北京、上海、深圳,是因为三城的形态不一样:北京同心环状扩展,上海受长江和海岸线约束、主要向西南伸展,深圳沿海岸呈带状。2022 年常住人口分别为 2184 万、2476 万和 1766 万,行政区面积为 16,410、6340.50 和 1997.47 平方公里,区数 16、16 和 10。这些是全市行政口径。实际进入模型的,是 Li 等(2020)全球城市边界以内的建成区通勤,外围农村不在分析范围内。
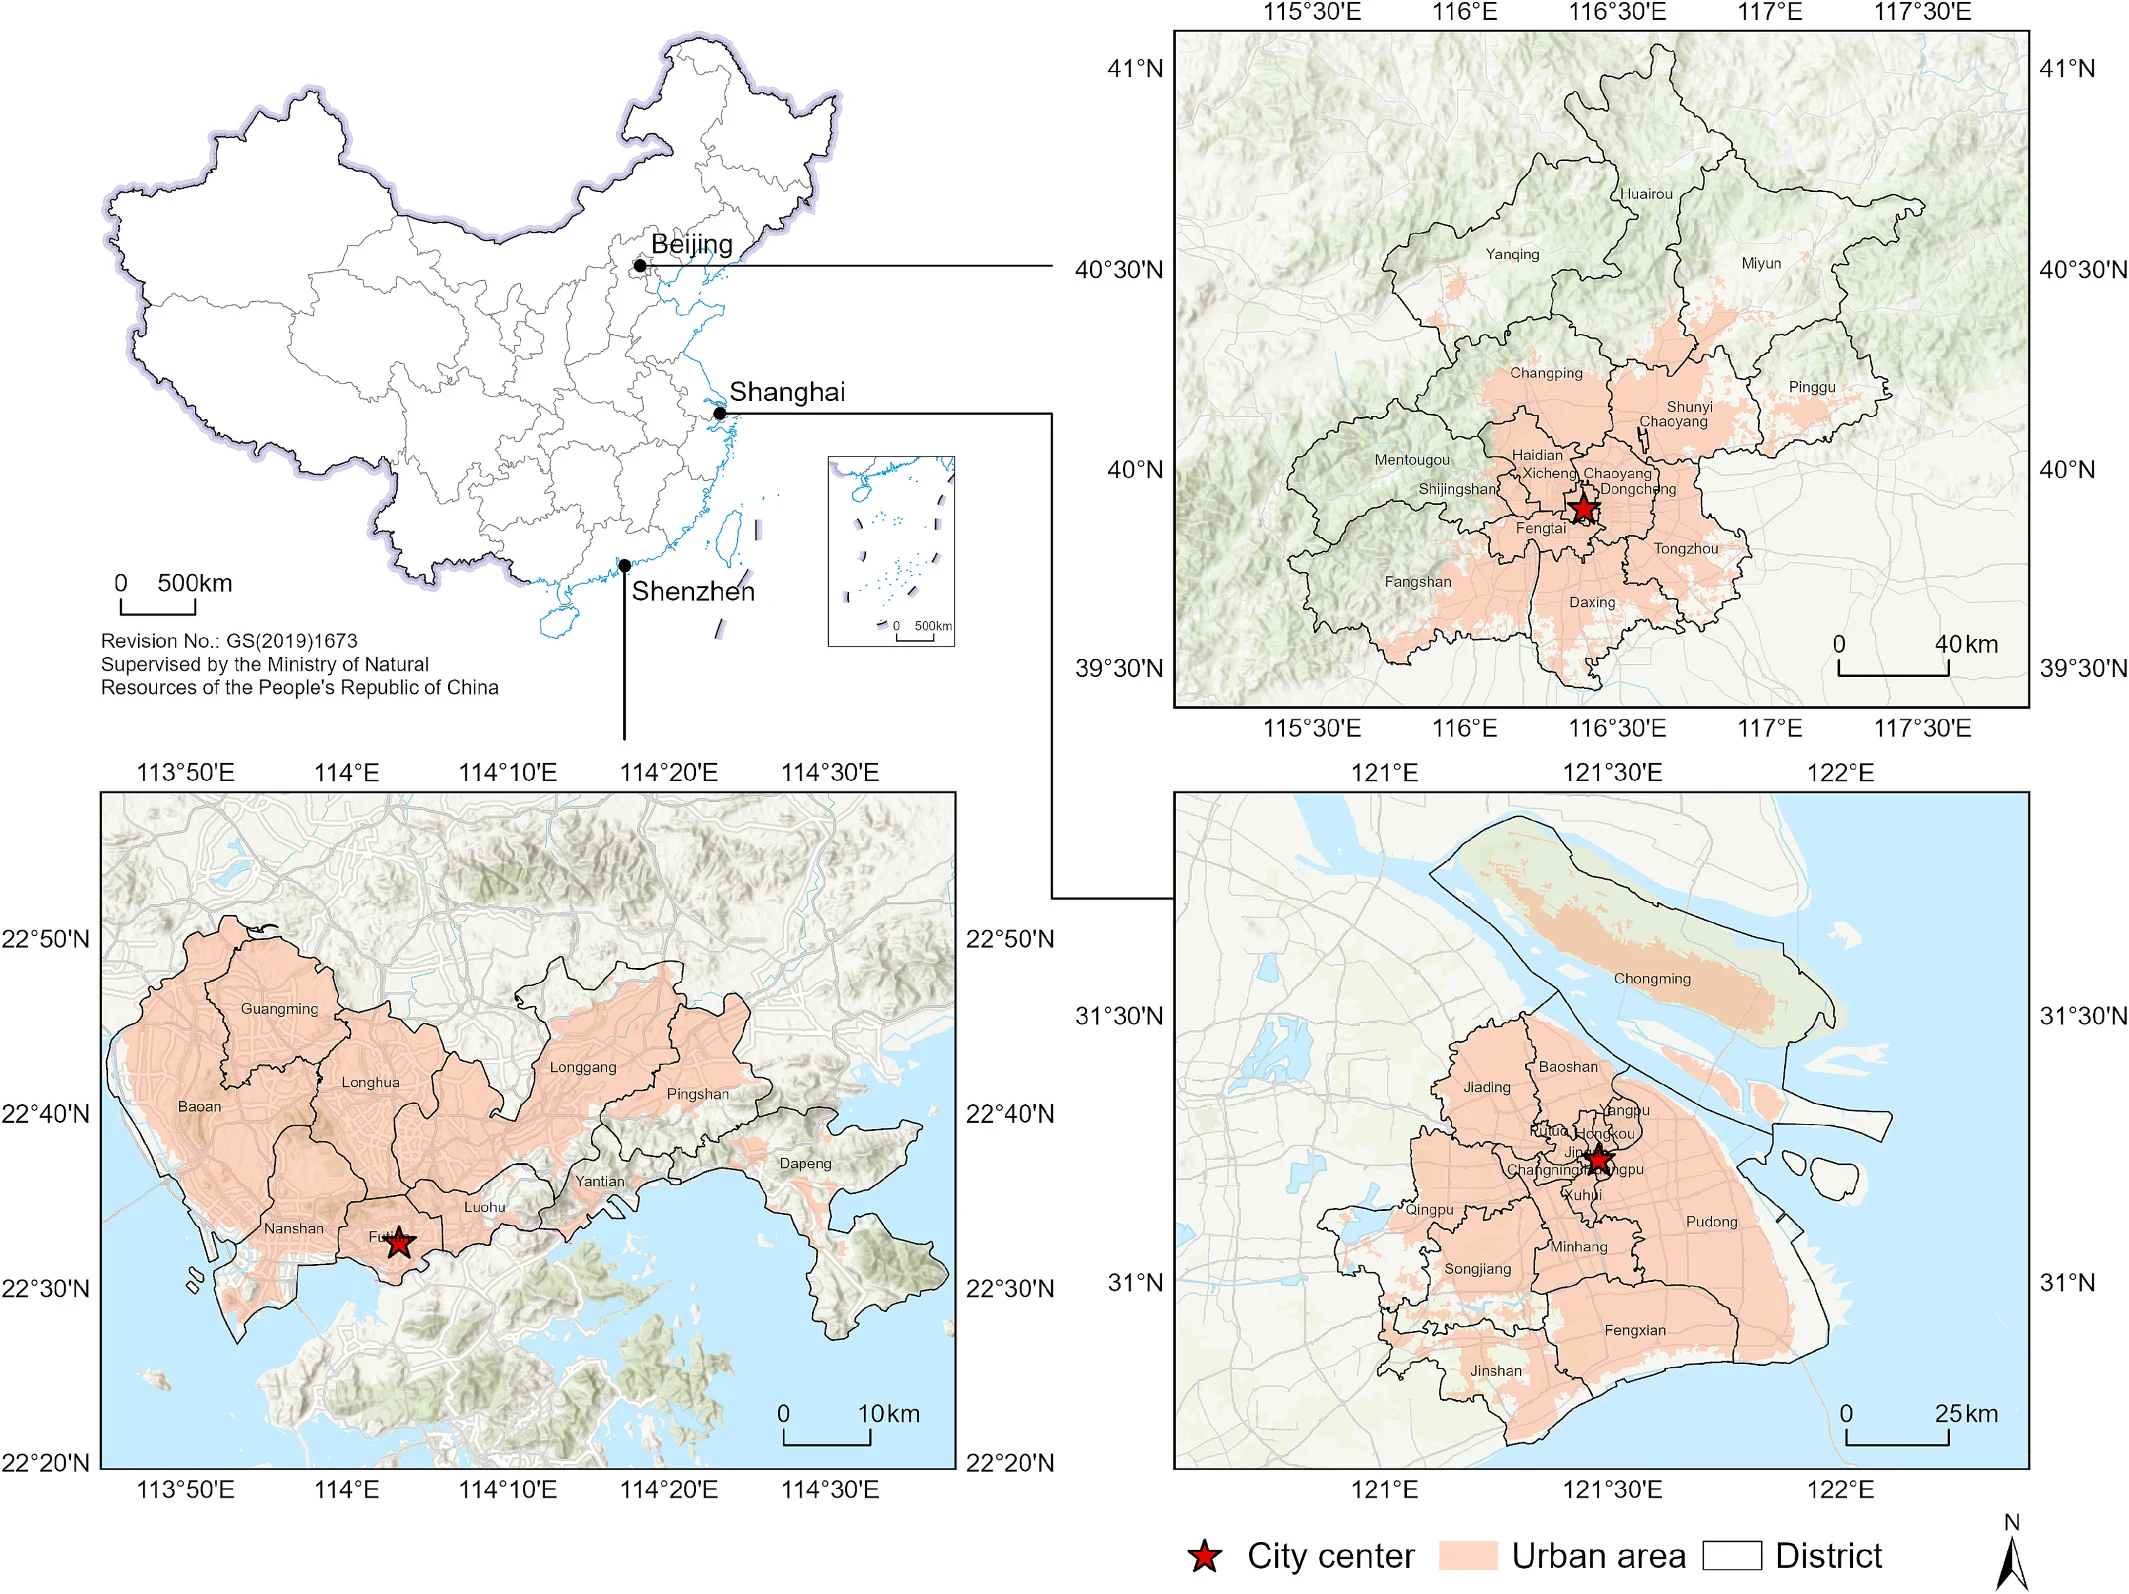
图 1|三座城市的建成区边界和市中心定在哪里?
无字母子图。左上为中国位置示意,右上为北京,左下为深圳,右下为上海。绿星是作者规定的市中心:天安门广场、人民广场、市民广场(Civic Square)。浅色填充为建成区,线框为区界。比例尺分别为全国 500 公里、北京 40 公里、深圳 10 公里、上海 25 公里。这张图确定后文距离的参照点,本身不包含通勤人数。来源:原论文 Fig. 1。
通勤流量来自腾讯定位请求。用户在相关应用中请求定位时,产生匿名设备标识和坐标。论文给出的约 12 亿是腾讯在中国的用户规模,不是这三座城市的通勤样本人数;三城设备数没有单独报告。停留点定义为 10 分钟内移动少于 200 米的位置,再用 DBSCAN 聚成停留地点。只有一个停留点的地点被剔除。家和单位的分类使用过自我报告数据,但因隐私限制,识别过程留在数据提供方,作者只收到汇总结果。居家办公会使单位与住处重合、通勤距离为零;出租车司机等没有固定单位的人,单位可能为空并被排除。作者认为后一类人占比有限。论文没有给出家、单位分类的准确率。
空间单元是 1×1 公里网格。同一网格内部的通勤不进入模型,因此结果只涉及发生了跨网格移动的家—单位联系。流量再按各区统计人口与移动设备用户数之比做了放大,所以表 1 会出现 10,253.20 这样的小数,单位仍写为人数,但已不是原始设备计数。
区级核对用的是 2022 年统计年鉴常住人口,对数值做对数线性回归:log(统计人口) = α log(手机估计) + ε。北京、上海、深圳的 R² 为 0.979、0.977、0.998。这只说明区级居住人口估计与年鉴高度同向,不能证明每条通勤流或每个人的家、单位都被正确识别。
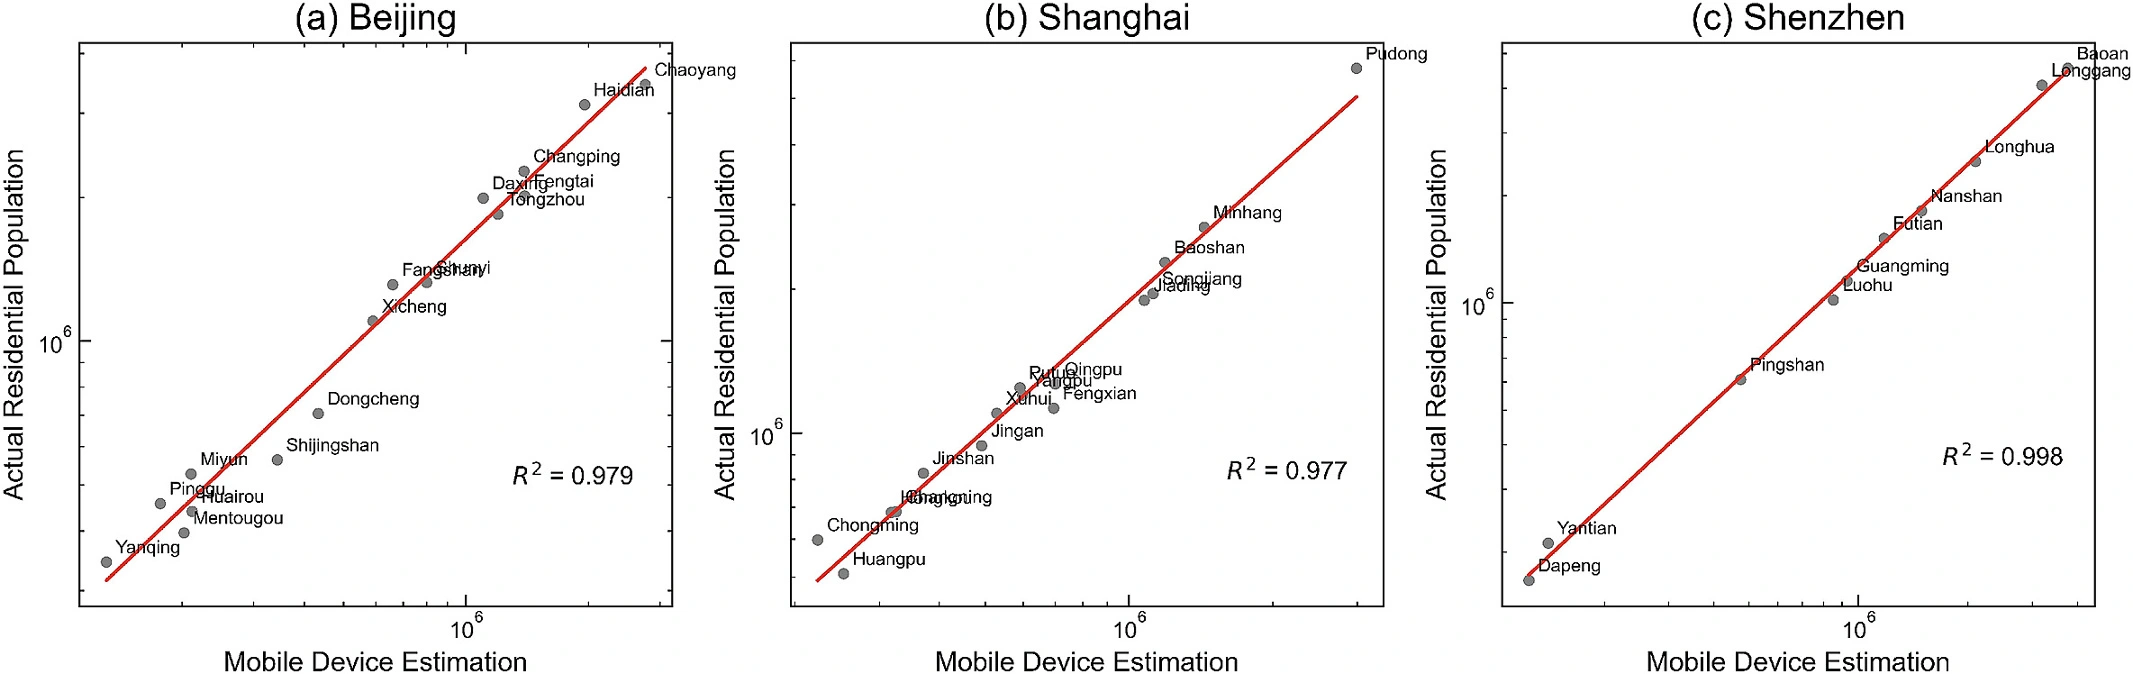
图 2|手机估计的居住人口,在区级上和年鉴差多远?
(a)北京,(b)上海,(c)深圳。横轴为移动设备估计的居住人口,纵轴为统计年鉴常住人口,两轴均为对数坐标,每个点是一个区。拟合线旁的 R² 依次为 0.979、0.977、0.998。点贴近直线,说明区级总量大体对齐;它没有给出网格级或个人级误差。来源:原论文 Fig. 2。
零流量占绝大多数,为什么还要留在模型里?
传统引力模型把两地流量写成规模相乘、再随距离衰减。若先对流量取对数,零流量无法直接进入,长距离的“没有人走”会被丢掉。通勤网格对里,零恰恰是主体。
| 城市 | 全部起讫对 | 流量大于 0 的起讫对 | 流量为 0 的起讫对 |
|---|---|---|---|
| 北京 | 43,797,931 | 663,861 | 43,134,070 |
| 上海 | 32,838,626 | 624,303 | 32,214,323 |
| 深圳 | 2,458,624 | 336,796 | 2,121,828 |
非零对来自附录表 A.4 的样本量,全部起讫对来自表 2。零流量占比约为 98.5%、98.1% 和 86.3%。深圳非零比例更高,平均流量也更高(4.40 人,对照北京 0.29 人、上海 0.46 人)。平均流量的分母是全部起讫对,不能读成通勤者的平均出行次数。
PPML 直接以人数 Tᵢⱼ 为因变量。期望流量写成解释变量的指数函数,零值可以留下。它还允许条件方差等于离散参数 ϕ 乘以条件均值。ϕ 接近 1 时过度离散不严重;ϕ 远大于 1 时,方差比泊松分布假设的更大。三城 ϕ 为 1.461、2.771、9.716,深圳的过度离散最强。PPML 因此用来估计均值参数,不要求真实分布恰好是泊松分布。由于没有标准对数似然,论文不用 AIC、BIC,而用 CPC、均方根误差(RMSE)和皮尔逊相关系数 r。
CPC = 2 × Σ min(观测流量, 预测流量) / (观测流量合计 + 预测流量合计)。它衡量两组流量重叠多少,分母是观测与预测的总和,不是人数准确率,也不是起讫对的命中率。
解释变量分三组。土地利用用高德兴趣点,按 Gao 等(2021)分成居住、商业、公共管理与服务、公园广场、工业五类;每格点数加 1 后取对数,避免零。到市中心的距离是网格中心到规定市中心的最短路网距离,并计入位置到最近道路的距离。交通阻抗用起讫网格中心之间的最短路网距离,不用直线距离。作者的预分析认为通勤距离更接近幂律而不是指数分布,因此模型放入路网距离的对数;该预分析的拟合统计量没有在正文列出。公交覆盖是公交站 300 米缓冲区占网格面积的百分比,地铁是 800 米,依据住建部 2018 年的相关规定。房价来自安居客点位,用搜索 12 个点的普通克里金插成栅格,再取网格平均。房价差是终点房价减去起点房价,表头单位为万元,没有写明是单价还是总价。相邻网格虚拟变量用来吸收网格边界把一趟短通勤切开的影响。方差膨胀因子都小于 10,最接近 10 的是深圳商业兴趣点,约 8.6。
进入回归前,解释变量做 z 分数标准化,以便比较谁更重要。表 2 的系数因此是:其他标准化变量保持不变时,该变量升高 1 个标准差,对数期望流量变化多少。它不是每公里、每个兴趣点的原始斜率。路网距离、五类兴趣点在表 1 中已经取过对数,1 个标准差也不是 1 公里。
表 1 里北京路网距离对数的均值是 3.89,标准差 0.62,最大 5.34。因为最大值只有 5.34,这个对数只能是自然对数;若是以 10 为底,会对应数千公里。e^3.89 ≈ 48.9 公里,是全部网格对路网距离的几何平均。上海、深圳的对数均值 3.86 和 3.30,对应约 47.5 公里和 27.1 公里。分母仍是全部起讫对,长距离的零流量对把这个几何平均拉长,它不是通勤者实际走过的平均距离。
同一套系数里,三座城市哪里同向、哪里翻了符号?
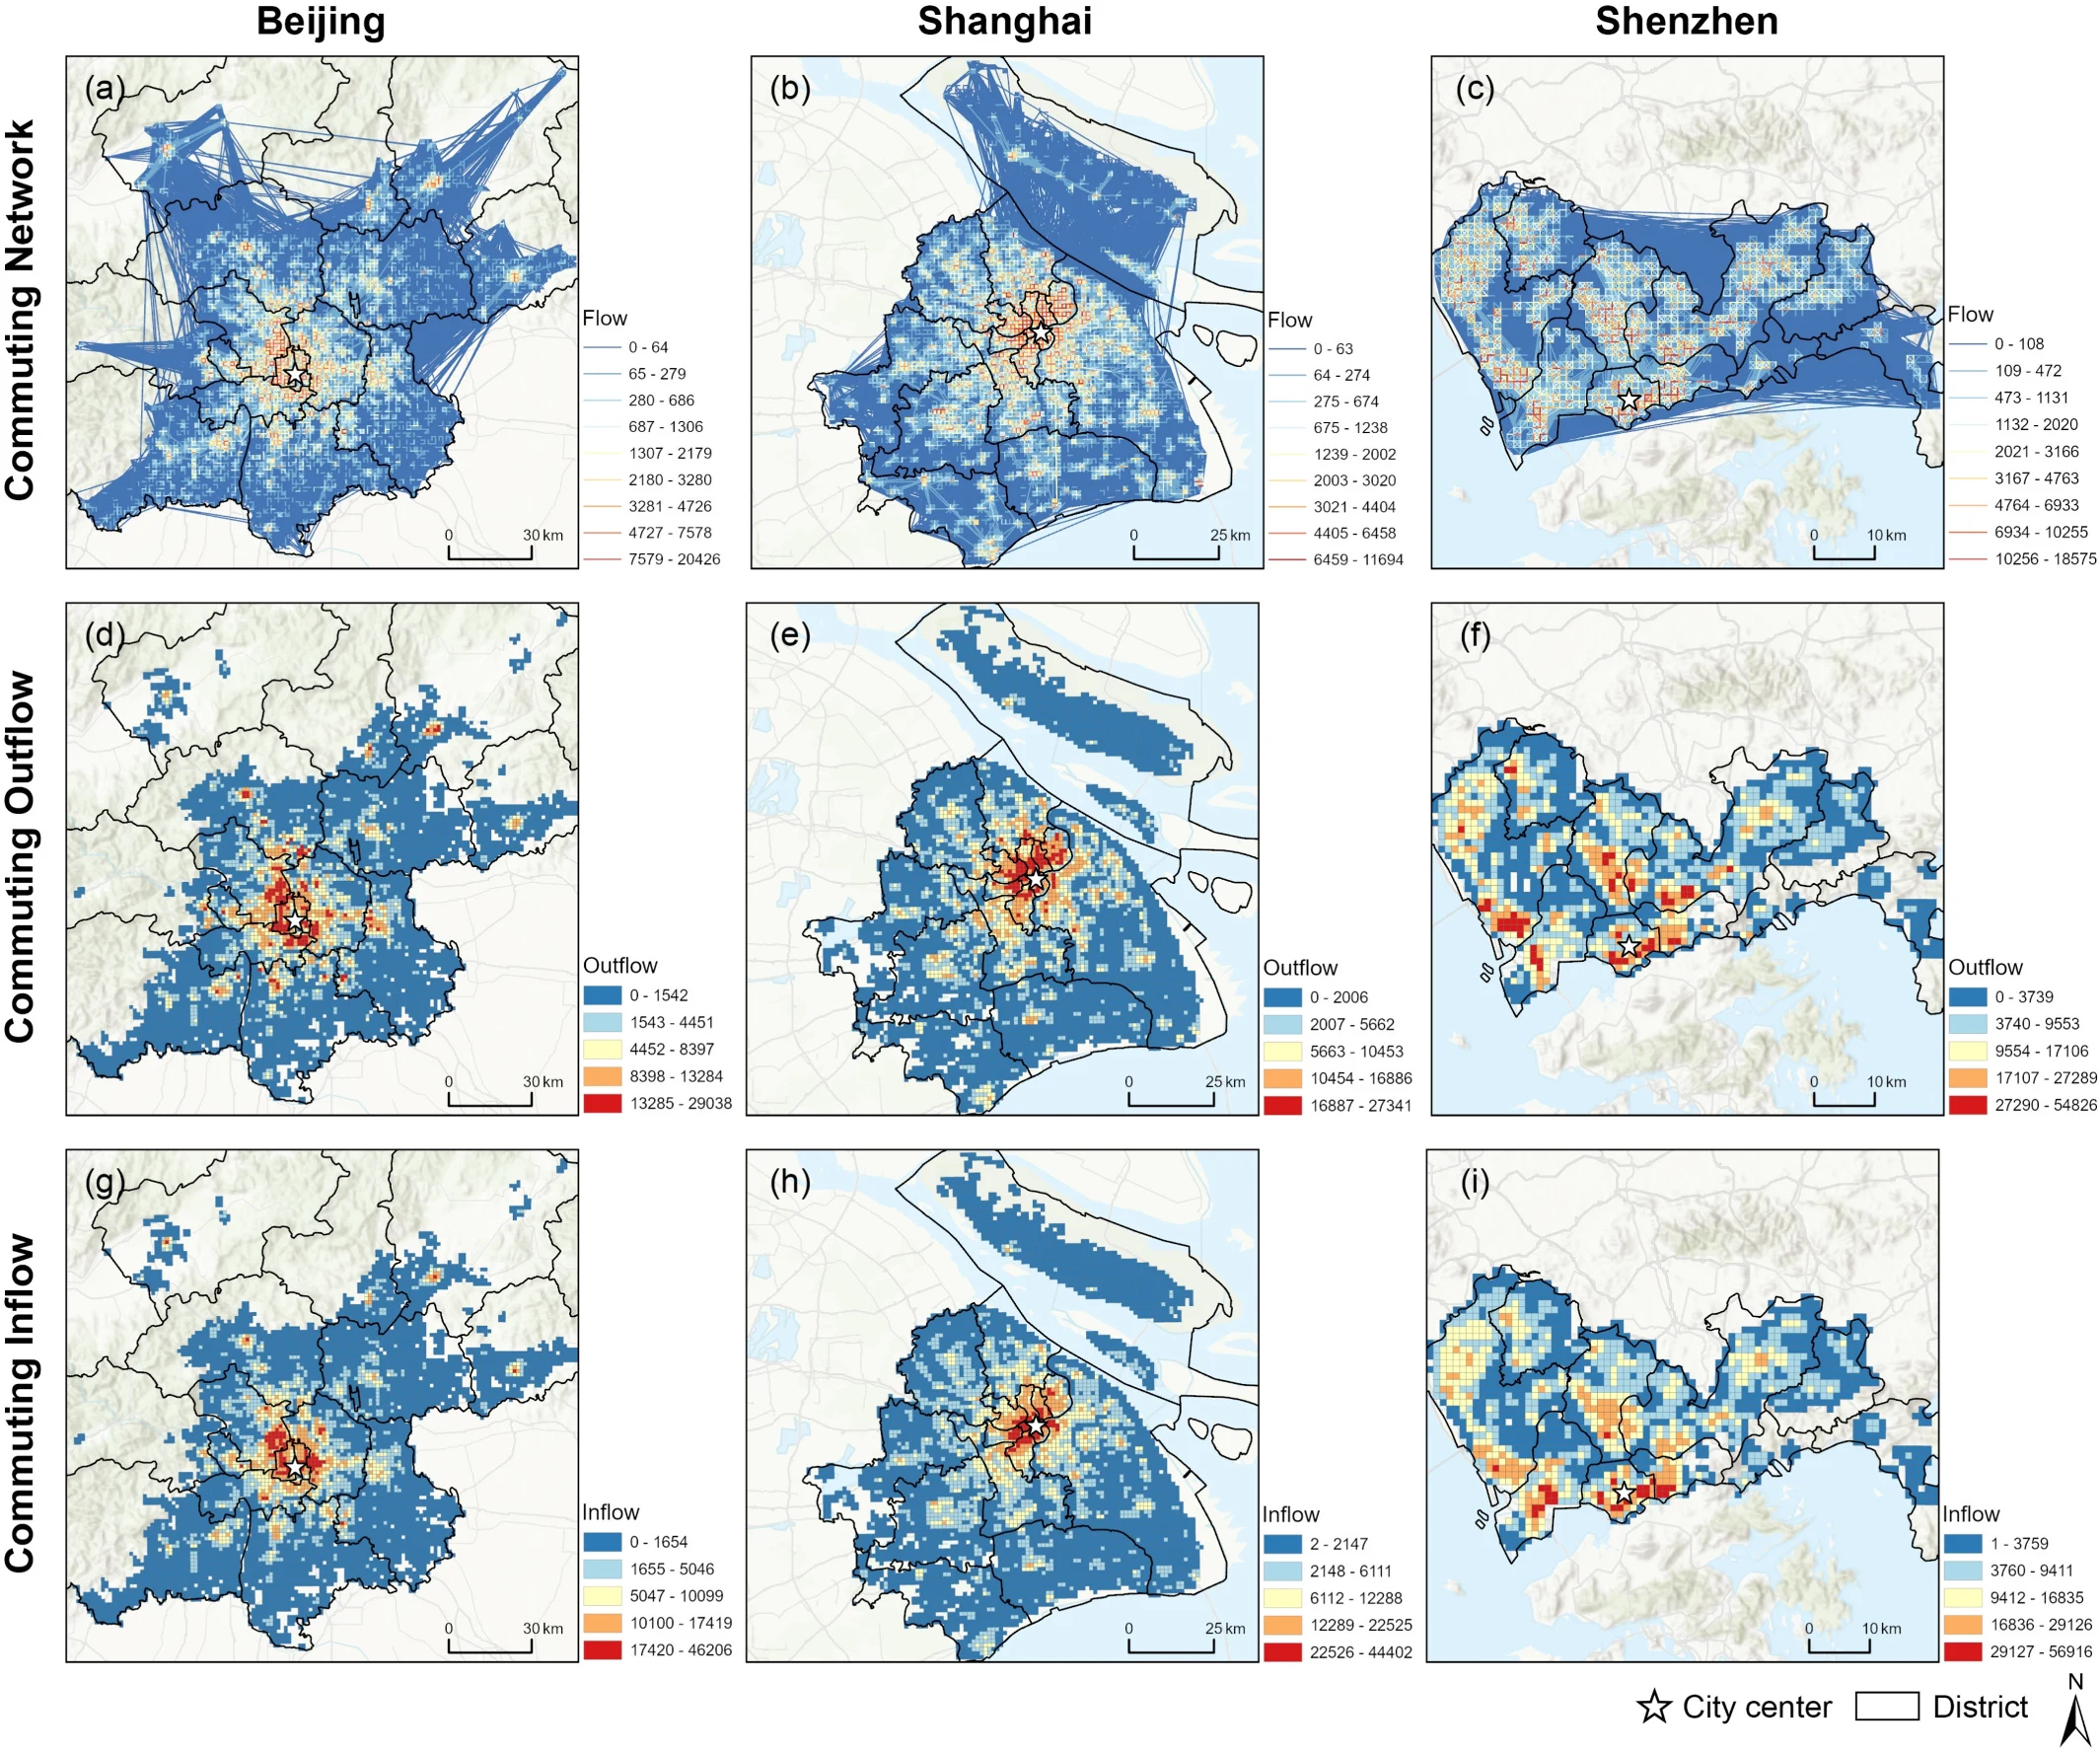
图 3|通勤网络、居住端流出和工作端流入各自集中在哪里?
列依次为北京、上海、深圳。颜色用自然断点分级,各图图例范围不同,不能只凭颜色深浅跨城比较。(a–c)把双向通勤相加后的无向联系;北京、上海呈圈层加外围组团,深圳沿海岸的多个组团强度更接近。(d–f)各网格作为居住地的流出。(g–i)各网格作为工作地的流入。郊区组团可以有中高流出,流入却往往只到中低。星号为市中心。图是展示分布,回归用的仍是单向的家到单位流量。来源:原论文 Fig. 3。
全市模型在三城分别使用上面的全部起讫对。截距是所有标准化变量取 0、也就是各自处于样本均值时的对数期望流量:北京 −4.711、上海 −4.620、深圳 −1.317,换算成期望流量约 0.009、0.010 和 0.268 人/起讫对。它们低于表 1 的平均流量,因为无条件平均会被少数短距离、高流量对拉高;截距不是平均通勤人数。
下表只列主要标准化系数。论文用三颗星表示 p < 0.01、两颗星表示 p < 0.05。样本量是百万级,很小的系数也会显著,读的时候要同时看绝对值。
| 变量 | 北京 | 上海 | 深圳 |
|---|---|---|---|
| 起点居住兴趣点 | 0.170 | 0.157 | 0.291 |
| 终点商业兴趣点 | 0.619 | 0.731 | 0.918 |
| 起点商业兴趣点 | 0.439 | 0.319 | 0.643 |
| 起点工业兴趣点 | −0.025 | −0.064 | 0.003(p < 0.05) |
| 终点工业兴趣点 | −0.018 | −0.006 | 0.016 |
| 起点公共兴趣点 | 0.054 | 0.169 | −0.008 |
| 终点公共兴趣点 | 0.047 | 0.094 | −0.094 |
| 起点到市中心 | 0.130 | 0.170 | 0.074 |
| 终点到市中心 | −0.138 | −0.265 | −0.193 |
| 路网距离对数 | −1.331 | −1.559 | −1.169 |
| 房价差 | 0.265 | 0.273 | 0.303 |
| 起点地铁覆盖 | −0.085 | −0.073 | −0.007 |
除深圳起点工业兴趣点为 p < 0.05 外,表中其余系数均为 p < 0.01。路网距离每升高 1 个标准差,期望流量乘以 e 的相应次方:北京 e^(−1.331) ≈ 0.264,上海 ≈ 0.210,深圳 ≈ 0.311。也就是期望流量降到原水平的大约 26%、21% 和 31%。这里的 1 个标准差是对数距离的标准差,北京表 1 中为 0.62,不是 1 公里。
终点商业兴趣点每升高 1 个标准差,期望流量约变为 1.86、2.08 和 2.50 倍。起点商业兴趣点约为 1.55、1.38 和 1.90 倍。房价差的系数 0.265、0.273、0.303,对应约 1.30、1.31 和 1.35 倍。北京房价差的 1 个标准差是 3.25 万元。终点房价高于起点时,家到单位的期望流量更高。这与“人住在房价较低一侧、工作在房价较高一侧”的方向一致,但仍是控制其他变量后的条件关联。
工业兴趣点的符号在深圳转为正。起点系数 0.003 相对商业兴趣点的 0.643 很小,不能把深圳工业用地读成和商业用地同等强度的通勤发生器。公共兴趣点则是深圳为负、京沪为正。作者把深圳的工业系数理解为工业与居住、商业混合更高,并提到更高的工业产出占比和更密的工业园;本文没有报告混合指数或工业产出占比的具体数字。居住兴趣点在起点三城都为正,在终点只有北京为正(0.064),上海 −0.057、深圳 −0.044。模型用兴趣点数量代表规模,没有把网格人口本身放进回归。
起点地铁覆盖在三城都为负。作者用逐步检验,把起点商业兴趣点当作中介(附录表 A.2)。那里的总效应是正的:北京和上海都是 0.565,深圳 0.478;放入商业兴趣点后的直接效应仍为正,0.080、0.125、0.080。这和表 2 里控制整套变量后的负系数不是同一次回归。正文写“负向直接效应”时,和附录表 A.2 的正号对不上。按距离再分组后,方向更清楚:0–5 公里的起点地铁系数为 −0.081、−0.069、−0.021;超过 20 公里为 0.179、0.224、0.206。5–20 公里仍分化,北京 −0.054、上海 −0.047、深圳 0.074。短距离通勤对上地铁覆盖为负,长距离为正;中间档不能概括成三城一致。
这三档的样本量也是起讫对,不是人数:0–5 公里为 194,997、177,801、40,544 对;5–20 公里为 3,668,204、3,158,233、644,498 对;20 公里以上为 39,934,730、29,502,592、1,773,582 对。北京 20 公里以上的对占全部 43,797,931 对的 91.2%。分组回归是否在组内重新做标准化,正文没有说明,所以组间系数不宜再换算成每公里衰减。
若丢掉零流量,样本量降到 663,861、624,303、336,796,路网距离系数变为 −0.769、−0.922、−0.865,绝对值都小于保留零值时的 −1.331、−1.559、−1.169。作者指出,用这组系数做预测,可能明显高估长距离通勤。此时 CPC 升到 0.644、0.668、0.676,但分母已经换成非零起讫对,不能和全体起讫对上的 0.559、0.595、0.641 直接比高低。
市中心系数一正一负,能说明功能仍是单中心吗?
起点到市中心的系数为 0.130、0.170、0.074,终点为 −0.138、−0.265、−0.193,全部 p < 0.01。在兴趣点数量和路网距离已经被控制的条件下,家离市中心更远的网格对仍有更高期望流量,工作地离市中心更远则更低。作者把已有研究中人口和就业的多中心形态,与这一对符号放在一起:建成区和郊区组团在形态上可以是多中心,通勤所体现的就业功能仍偏向一个市中心。
深圳起点系数 0.074 确实最小。终点系数的绝对值则是上海 0.265 最大,深圳 0.193 居中,北京 0.138 最小。说深圳市中心影响更弱,主要贴合起点系数,以及作者对局部图的综合判断;终点系数本身并不是三城中最小的。
这一对符号来自横截面回归。它与首尔都市圈、英国大东南地区的既有通勤研究方向相似,但没有追踪这些网格是如何变成现在的居住地和工作地的,也不能单独证明郊区岗位质量不足。
每个居住地单独拟合之后,全市一条衰减还够用吗?
起点模型只保留终点特征和起讫之间的变量,对每个居住网格单独估计;终点模型反过来。拟合都比全市模型好。终点模型的 RMSE 三城都更低,r 都略高。CPC 上北京 0.753 对 0.750、深圳 0.808 对 0.802,终点模型略高;上海是起点模型 0.767、终点模型 0.765。优势很小。
| 模型 | 城市 | CPC | RMSE | r |
|---|---|---|---|---|
| 全市 | 北京 | 0.559 | 11.268 | 0.736 |
| 全市 | 上海 | 0.595 | 13.525 | 0.773 |
| 全市 | 深圳 | 0.641 | 54.710 | 0.786 |
| 起点 | 北京 | 0.750 | 4.747 | 0.952 |
| 起点 | 上海 | 0.767 | 6.175 | 0.952 |
| 起点 | 深圳 | 0.802 | 25.848 | 0.953 |
| 终点 | 北京 | 0.753 | 4.678 | 0.954 |
| 终点 | 上海 | 0.765 | 6.039 | 0.954 |
| 终点 | 深圳 | 0.808 | 23.289 | 0.962 |
RMSE 的单位是人/起讫对。深圳全市 RMSE 54.710 大于北京 11.268,同时深圳流量的标准差是 85.34、北京是 15.33,城市之间的 RMSE 不在同一流量尺度上。CPC 和 r 更适合并排看。
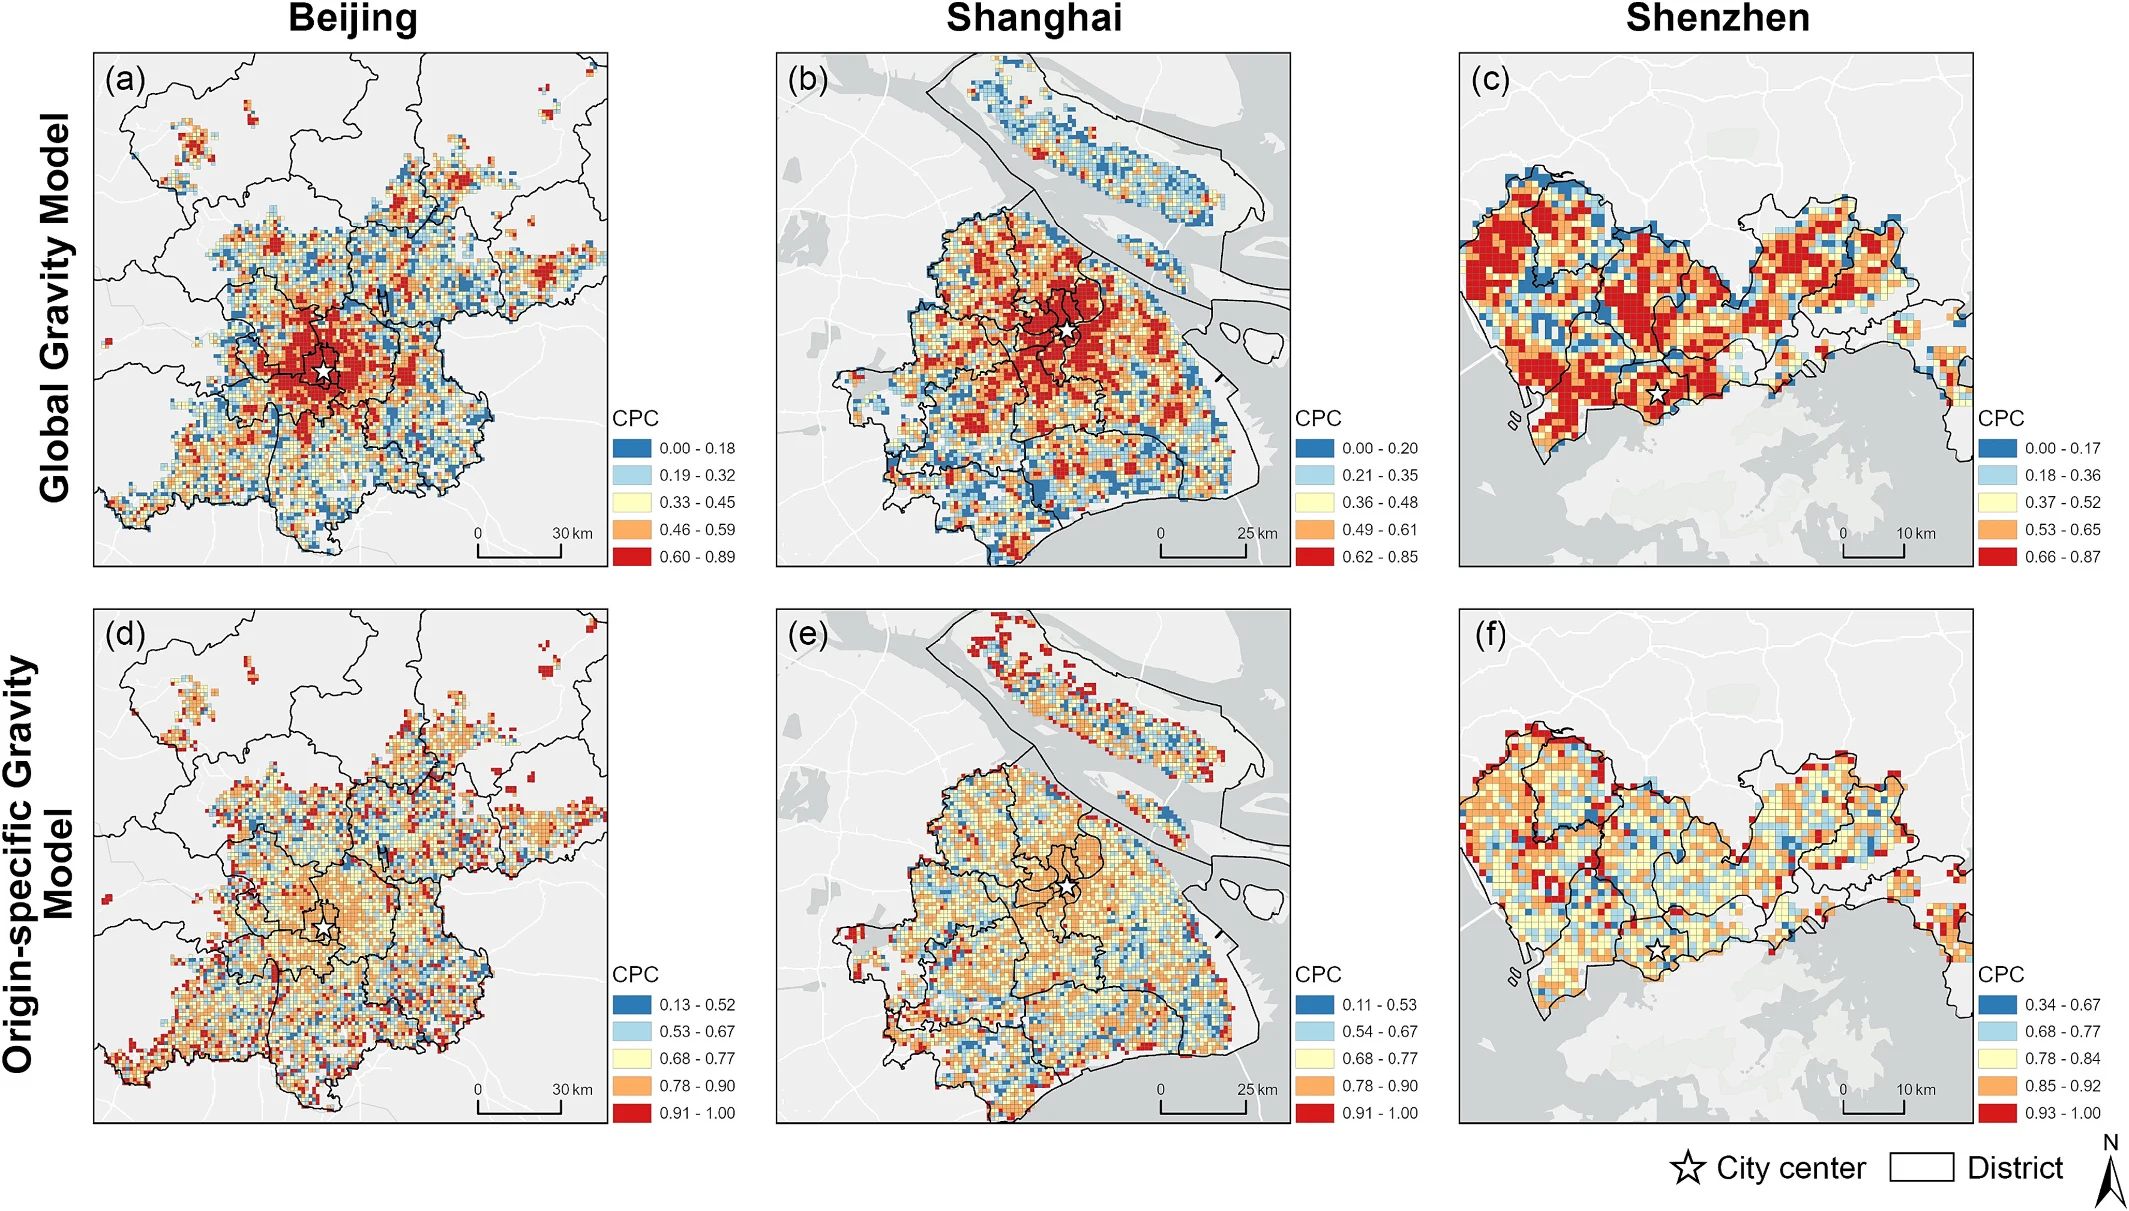
图 4|全市模型的拟合优势是不是集中在高密度居住地?
列依次为北京、上海、深圳,颜色为各起点的 CPC,各面板色标范围不同。(a–c)全市模型:高值更多集中在建成密集的中心一带。(d–f)起点模型:各起点的 CPC 更整齐,外围不再系统性地更差。图比较的是同一批起点上两种模型的空间格局;终点模型的城市合计见上表,没有对应地图。来源:原论文 Fig. 4。
局部系数图只保留统计显著(p < 0.05)且未被四分位距法判为异常值的系数。空白不等于系数精确为零。各面板色标各自划分,绿色表示更高的系数,深色表示更低。
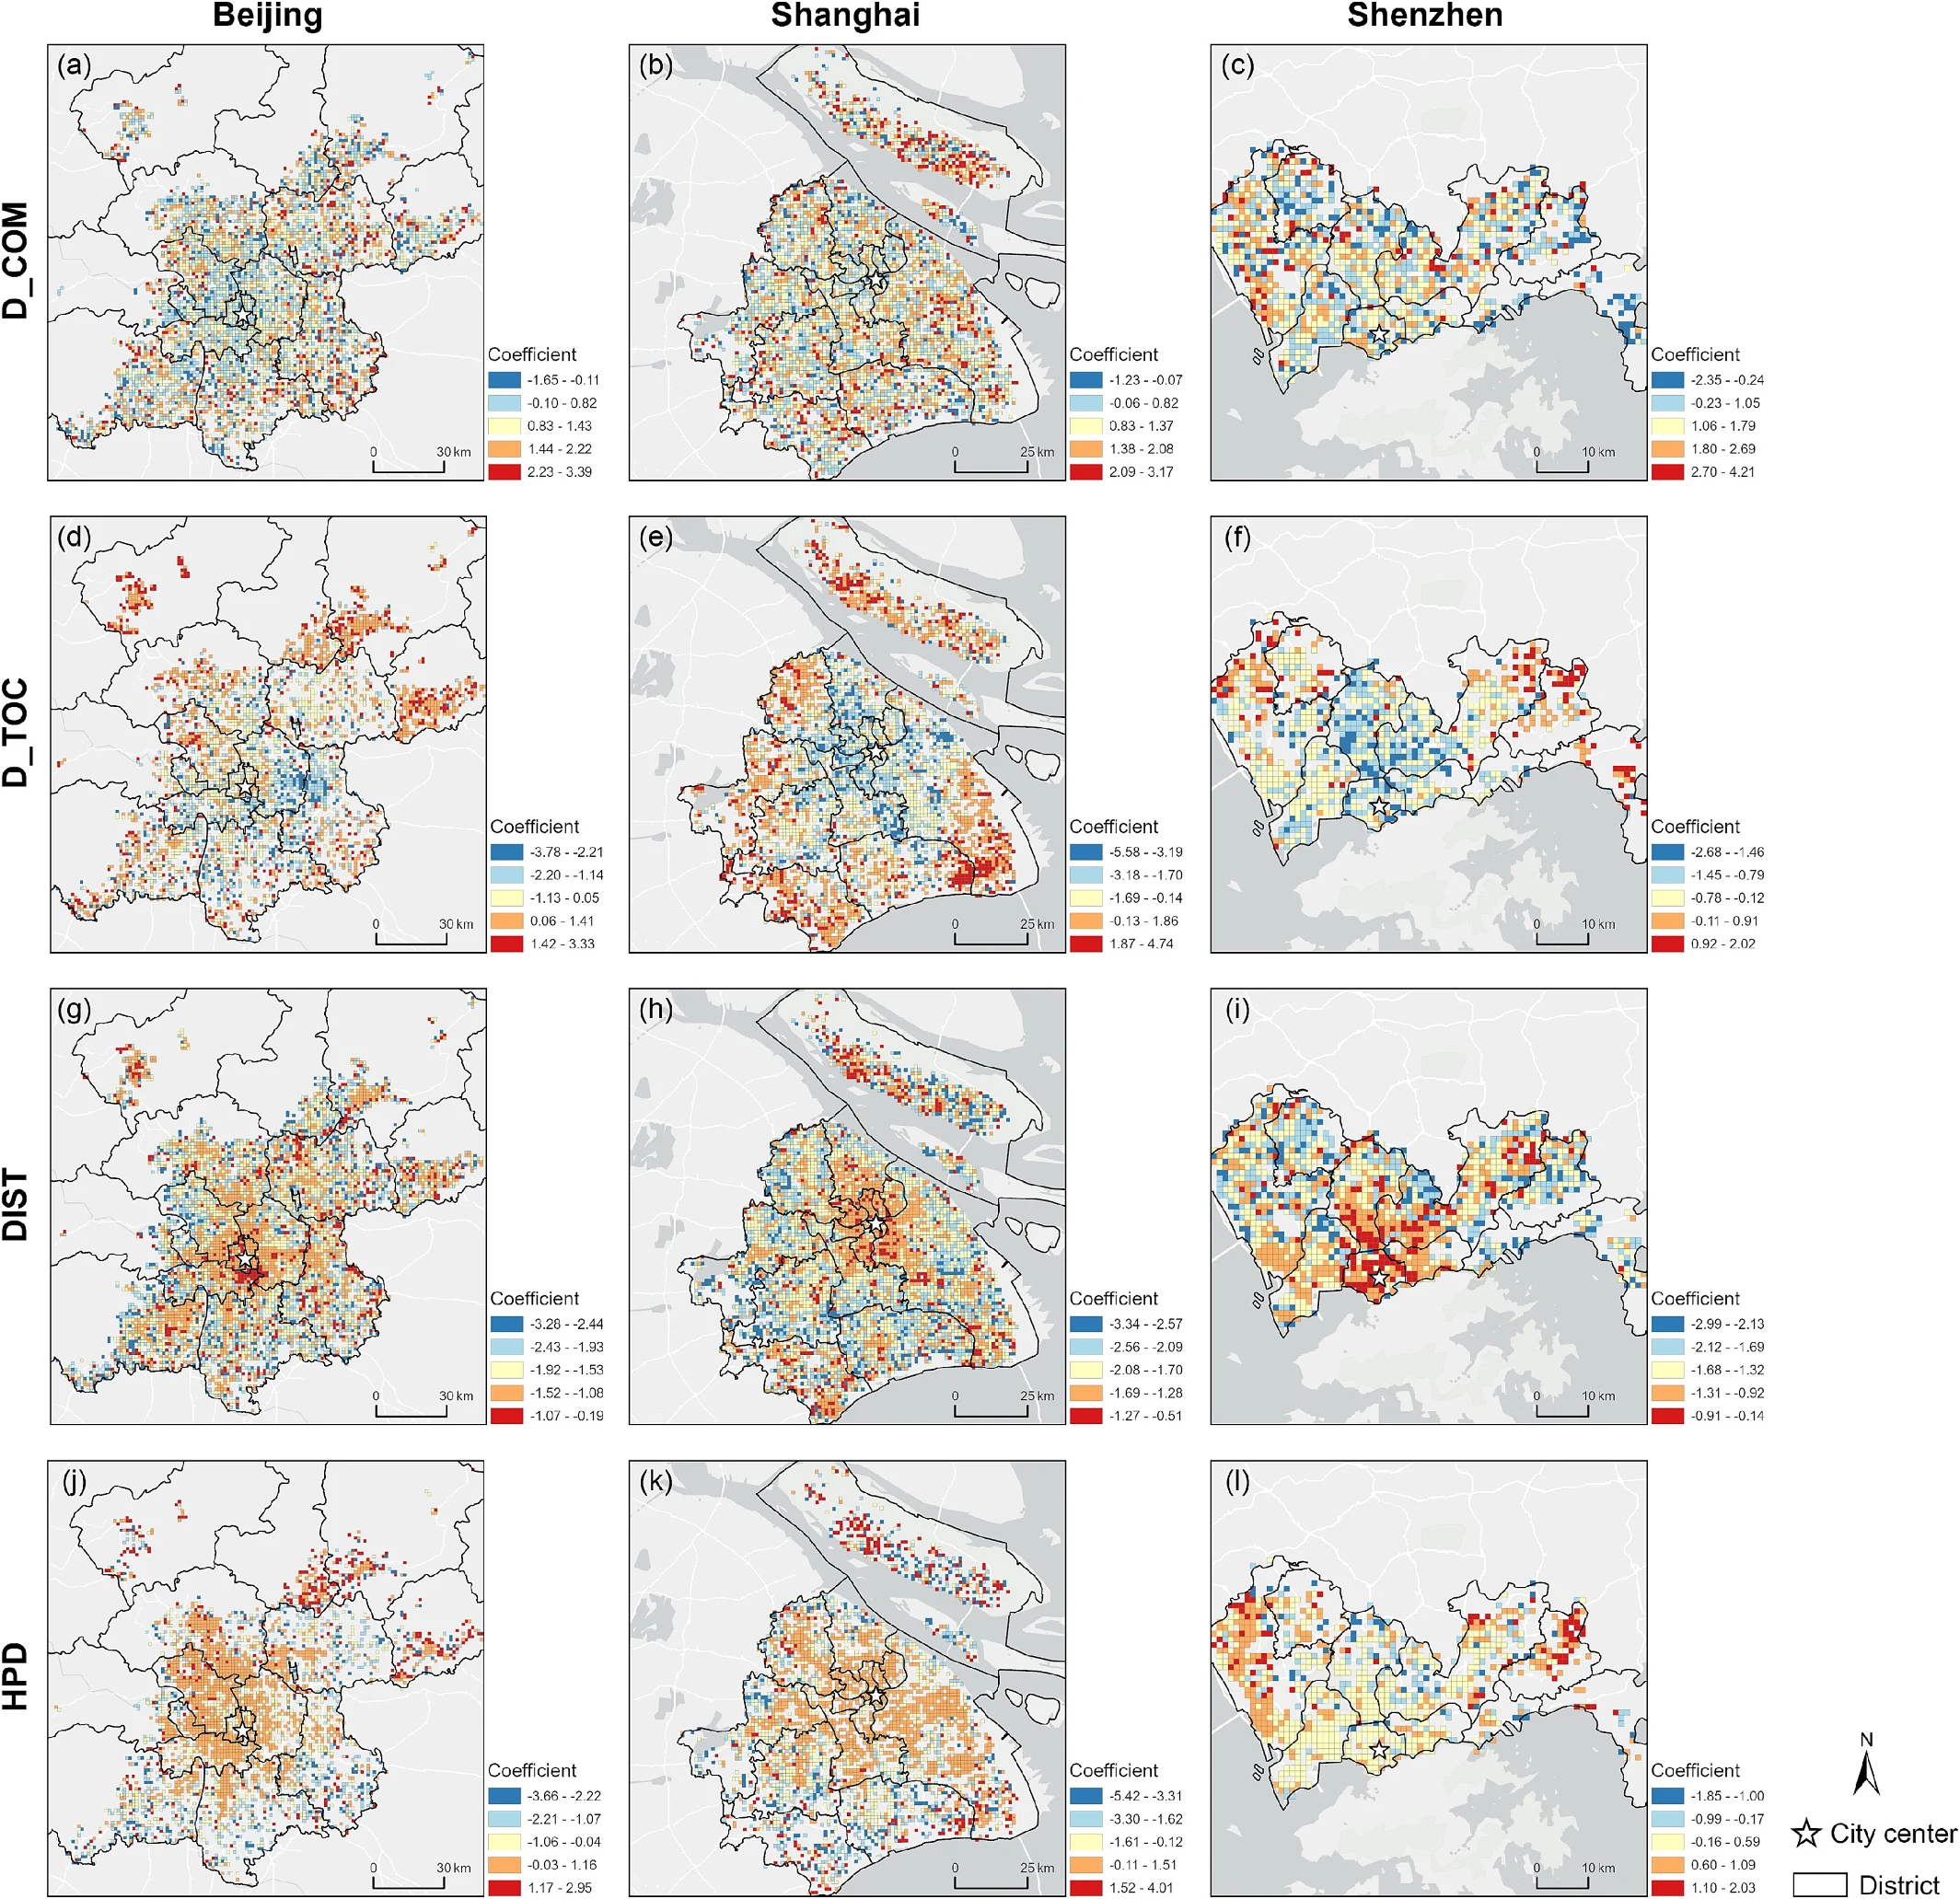
图 5|从居住地看,四个主要系数怎样随位置变化?
列依次为北京、上海、深圳。(a–c)终点商业兴趣点:高密度居住地的系数相对更低,岗位数量对当地居民工作地选择的边际关联更弱。(d–f)终点到市中心的距离:距市中心 10–30 公里的居住地,负向吸引最明显;再向外,市中心的吸引减弱直至消失。(g–i)路网距离:高密度居住地的负系数更弱,衰减没有全市系数 −1.331、−1.559、−1.169 那样整齐。(j–l)房价差:从中心到边缘大体维持正向推动,郊区还有局部更强的组团,论文点名北京怀柔、上海普陀和深圳宝安。来源:原论文 Fig. 5。
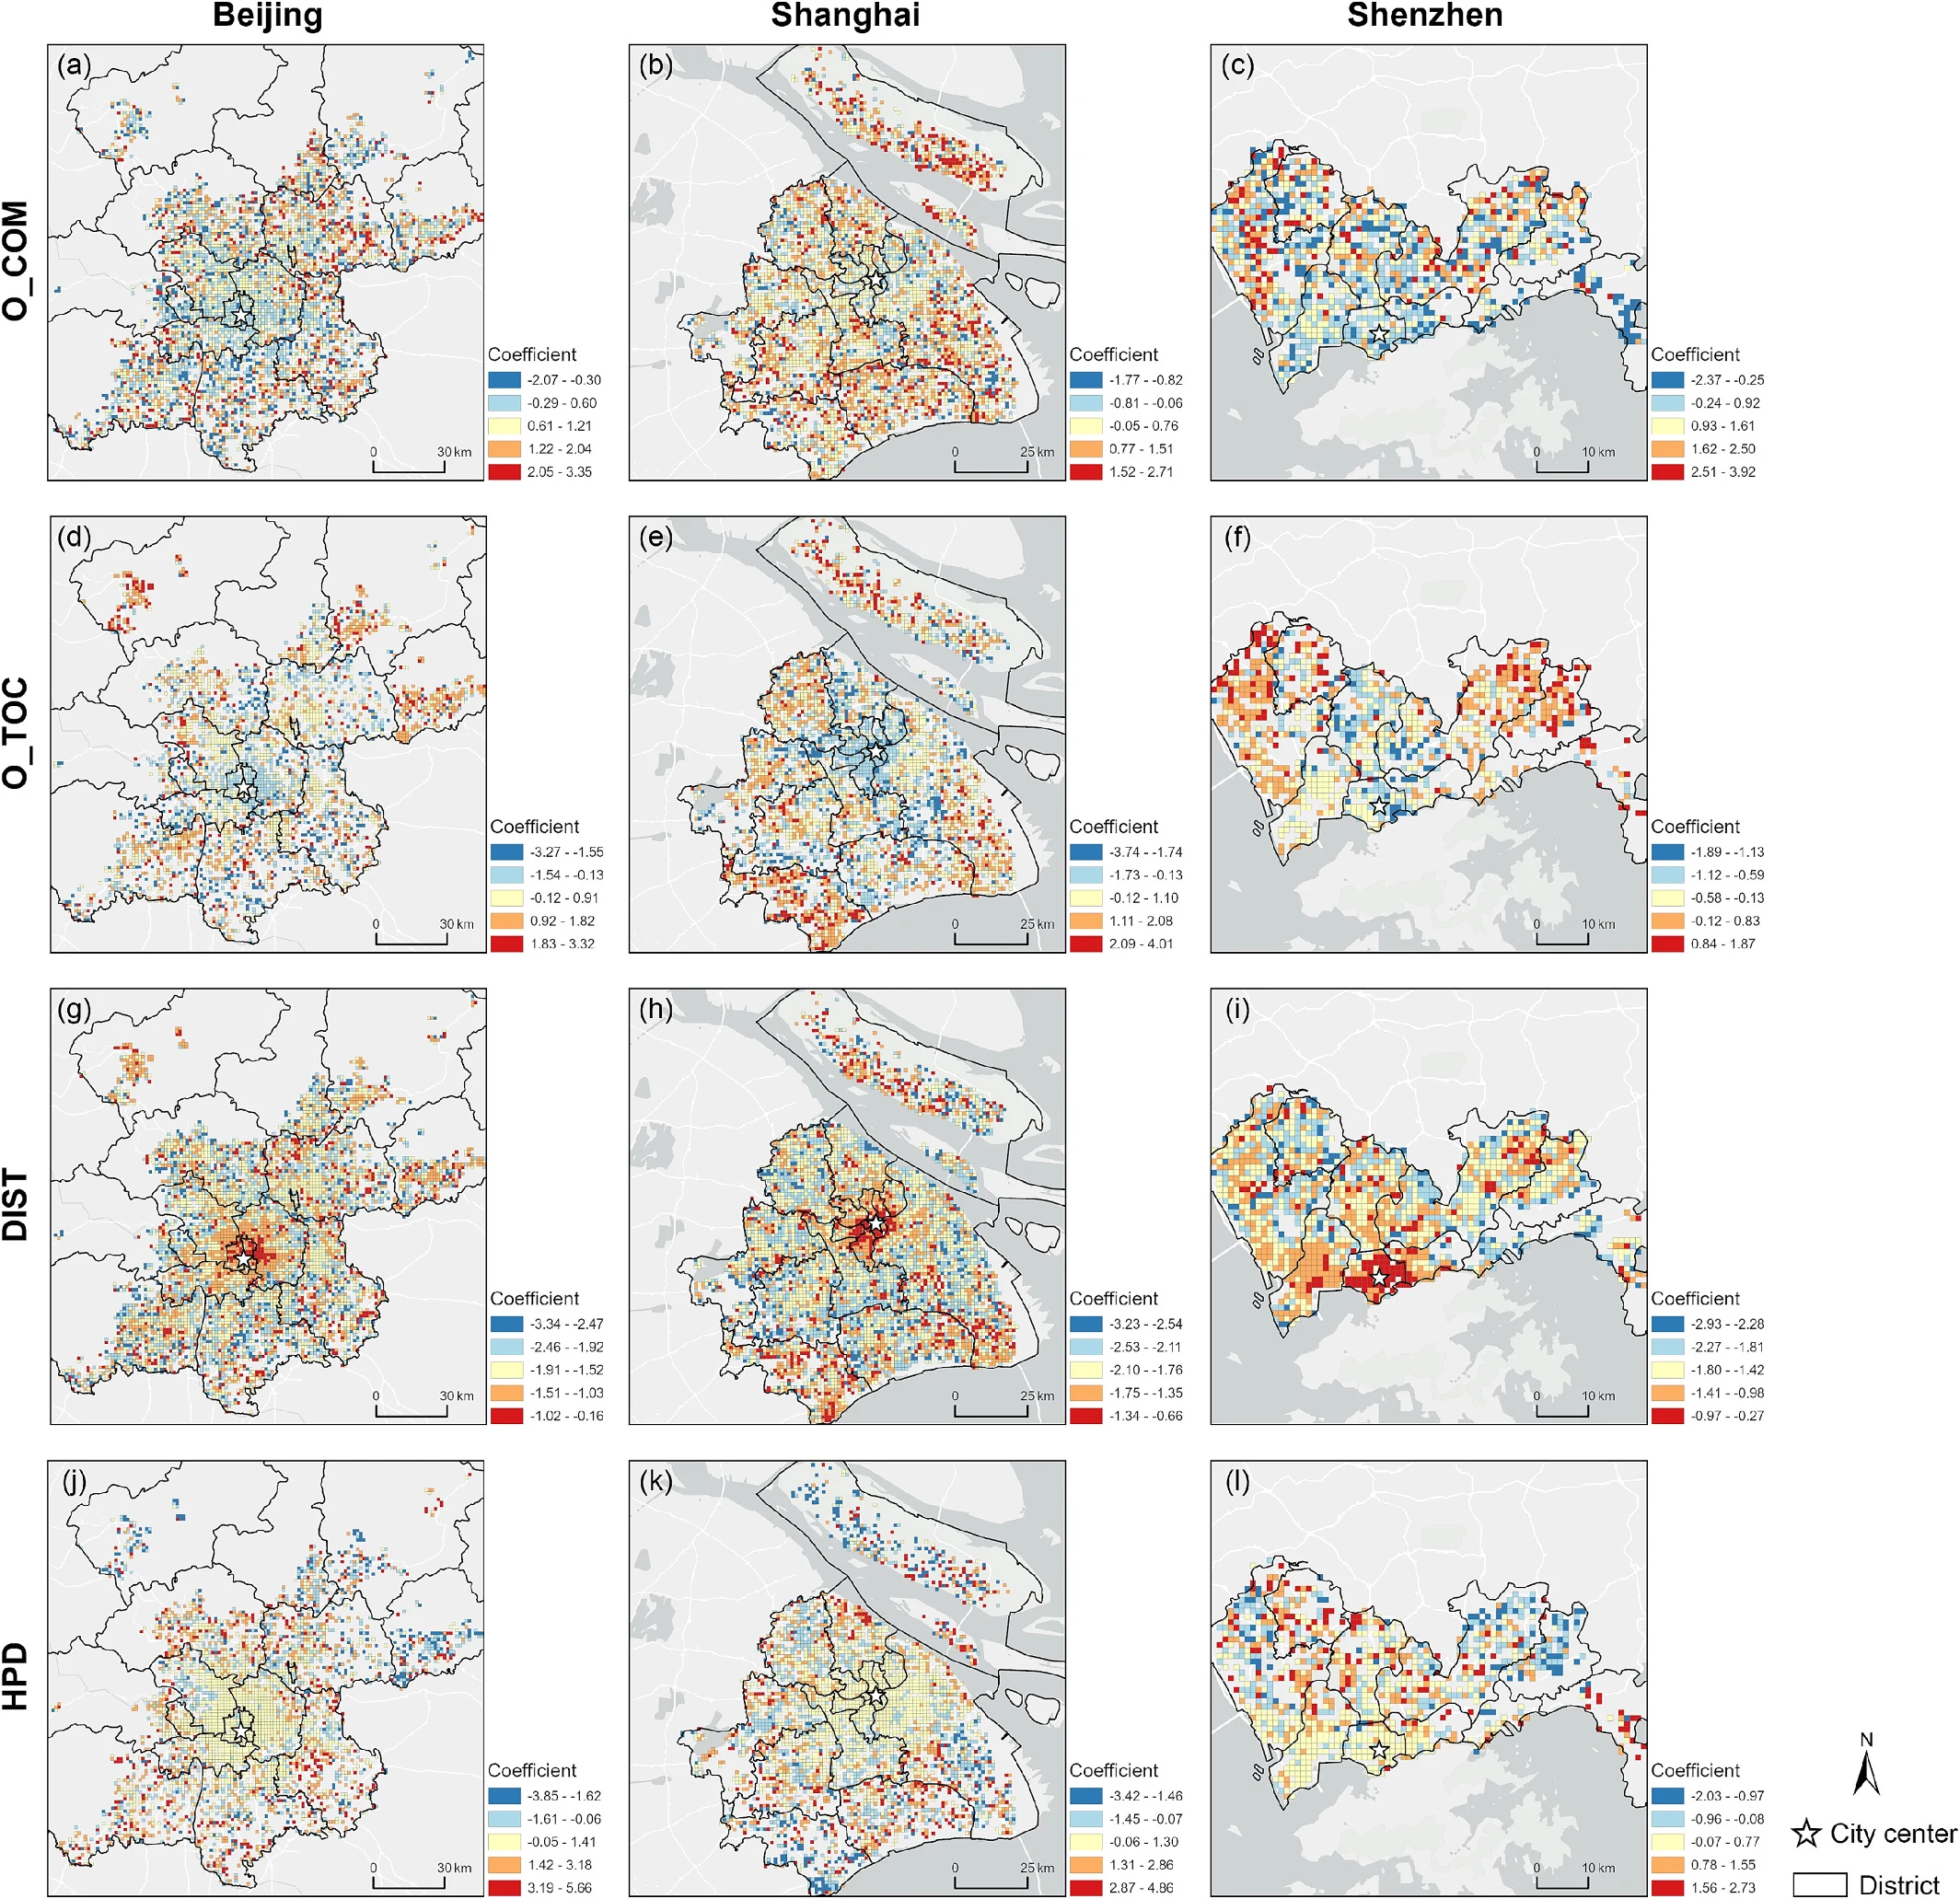
图 6|从工作地看,居住选择和距离衰减哪里不同?
列顺序与图 5 相同。(a–c)起点商业兴趣点:高密度工作地的就业者,对居住端商业兴趣点数量同样更不敏感。(d–f)起点到市中心的距离:市中心就业者更倾向于住得离市中心近;工作地离市中心超过 10 公里后,居住选择转向更远的位置。(g–i)路网距离:流向市中心工作地的衰减弱于流向边缘工作地。(j–l)房价差:市中心 20 公里以内的就业者,居住选择总体上受更低房价推动。来源:原论文 Fig. 6。
“高密度”是作者对图中高流量、建成密集区域的概括,正文没有给出人口密度阈值。10–30 公里、10 公里和 20 公里也是对局部系数地图的区间概括,不是另一张表里的回归虚拟变量。
这些结果停在哪一层证据
模型回答的是:在其他观测变量保持在均值附近时,某一变量升高 1 个标准差,家到单位的期望流量会乘以多少。它没有随机改变土地利用、地铁或房价,也没有个人的性别、职业和家庭约束。手机数据缺少这些属性,作者把这一点列为微观机制上的限制。
家和单位由数据提供方识别,作者不能复核算法。区级 R² 接近 1,只保护了居住人口总量。交通方式没有分开,路网距离代表道路网络下的空间成本,不代表票价或通勤时间。房价差的单位写成万元,没有说明每平方米还是一套房的总价。
高密度地区距离衰减更弱,与“高密度会缩短居住地和岗位之间的物理距离”可以同时成立:个人搜索范围变大之后,汇总到网格对上的衰减变缓。论文据此提醒,只用全市一条衰减,可能低估中长距离流量。这仍是系数格局。本文没有直接测量同一批人在密度变化前后的通勤公里数。
样本是 2023 年 5 月的截面,人口对照是 2022 年年鉴。三座都是超大城市,市中心对中小城市通勤的影响,论文明确留给后续研究。附录只有表 A.1–A.4,没有另附系数的逐网格数值;局部结论中的公里区间来自作者对图 5、图 6 的阅读。
一句话总结
在保留大量零流量的网格对上,路网距离、商业兴趣点、房价差和市中心位置共同塑造三城通勤;郊区可以在地图上成为中心,就业功能仍把 10–30 公里圈层的居住地拉向市中心,而高密度只是减弱了距离衰减,并没有在这个模型里证明通勤因此变短。
核心来源
- Journal of Transport Geography 正式版,128(2025)104380,2025年7月29日在线。收稿日期 2024年11月6日,修回 2025年5月3日,接收 2025年7月24日。
- 正文图 1–6,表 1–3,附录表 A.1–A.4。A.1 为兴趣点与用地类别的对应,A.2 为地铁覆盖的逐步中介检验,A.3 为 0–5、5–20、20 公里以上的分组回归,A.4 为去掉零流量后的全市模型。
- 汇总通勤起讫数据可向通讯作者 Bo Huang 合理申请。论文没有给出公开下载链接。致谢写明香港研究资助局项目 SRFS2324-4H02,未把该编号记到某一位作者名下。
作者介绍
- Zhimin Xie:论文署名为香港中文大学地理与资源管理学系,贡献包括概念、方法、软件与初稿。
- Bo Huang:通讯作者,署名为香港大学地理学系,贡献包括概念、方法与审阅修改。香港大学地理系页面介绍其为讲席教授,研究方向包括土地利用的空间统计、环境监测中的影像融合,以及可持续规划中的空间优化。
- Jixuan Cai:署名为腾讯公司(深圳),贡献为数据整理与方法。他与 Bo Huang、Yimeng Song 曾在 Remote Sensing of Environment(2017)发表用多源地理大数据识别多中心城市结构的研究。
- Harry F. Lee(李峯):署名为香港中文大学地理与资源管理学系,贡献包括概念与方法。学系页面列其为副教授,研究兴趣包括气候变化的社会经济与人口影响、历史人口与历史流行病学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若规划目标是减弱 10–30 公里圈层对市中心的通勤吸引,只在该圈层增加岗位数量,和增加可与市中心岗位相比的岗位质量,模型里会是两件不同的事。图 5 已经显示,高密度居住地对终点商业兴趣点数量更不敏感。一个可检验的后续设计,是把新增岗位按工资或行业与市中心岗位匹配之后,再看这一圈层的终点到市中心系数是否变小。本文的系数地图还不能代替这个比较。
另一个容易误用的数字是深圳工业兴趣点的正号。0.003 和 0.016 说明方向与京沪相反,也说明标准化后的关联很弱。若把“深圳工业混合”当成北京产业园的通勤处方,需要先有分行业的职住自含率;那不是表 2 里的这个系数。
全市 CPC 在 0.56–0.64,而北京 20 公里以上的起讫对就占 91.2%。一条为了拟合海量零流量而估计的衰减,可能仍然漏掉少数长距离、高流量的对。交通模型若只汇报全体起讫对的 CPC,最好同时汇报按距离档的 CPC,并写明每一档的分母是网格对还是人。