离公交站更近、街区更密,兴趣点就会更常被拜访吗?
论文名片|Sangwan Lee、Sugie Lee、Devina Widya Putri,Multifaceted associations between built environments and POI visit patterns by trip purposes,Cities,2025,161:105903,2025年3月18日在线发表。DOI:10.1016/j.cities.2025.105903。2024年7月30日收稿,2025年1月27日修回,2025年3月16日接收。本文依据这一正式版;它是横截面观察研究,用空间误差模型和普通最小二乘回归,描述亚利桑那州菲尼克斯普查街区组的建成环境与兴趣点到访密度之间的关联。
设想同一条凤凰城的宽马路。早晨,有人把车停进仓储区;傍晚,另一批人坐进几个街区外的餐馆。两次停留都会在手机定位里留下一个兴趣点到访。若只问这个街区热不热闹,仓库上班和晚上吃饭会被加成同一个数字。上面这个人是帮助想象的例子,论文没有追踪任何一位具名出行者。
论文把2019年的兴趣点到访按目的拆开。人口密度更高的街区,六类到访密度都更高。到家距离、半英里内有没有公交站、紧凑度则会随目的改变方向,或者变得看不出与零有别。这些是街区尺度上的条件关联,还不是把路网或车站改了以后的实验结果。
先说结论
- 人口密度在六个空间误差模型里都为正。系数从购物的0.243(标准误0.030,观测5,480)到个人事务的0.967(标准误0.052,观测2,714)。在普通最小二乘的绝对标准化系数之和里,它的份额从社交的20.57%(0.391/1.900)到个人事务的40.78%(0.564/1.383),六列都是最大的一项。
- 到家距离取对数之后,通勤系数为−0.046(标准误0.012,观测9,880),非通勤为0.065(标准误0.017,观测13,839),购物、个人事务和社交也为正。按自然对数换算,距离变为原来的2倍时,通勤到访密度大约低3%,个人事务大约高14%。
- 人口加权中心半英里内有公交站时,全部到访的系数是−0.071(标准误0.029,观测23,719),个人事务是−0.381(标准误0.089,观测2,714),社交是0.202(标准误0.043,观测4,474)。通勤的−0.011(标准误0.030)看不出与零有别。
- 紧凑度指数在全部模型中为0.039(标准误0.012),在非通勤中为0.047(标准误0.018),在个人事务中为−0.061(标准误0.034)。个人事务这一列只到论文使用的较宽显著水平。
- 活动密度的点估计六列都为正,但个人事务是0.036(标准误0.055,观测2,714),标准误大于系数。购物的活动密度弹性最大,为0.391(标准误0.031,观测5,480)。
到访密度在数什么?
研究对象是兴趣点(point of interest,POI)的到访,不是一个人全天的轨迹,也不是问卷里填写的出行目的。数据来自 SafeGraph,经 Dewey 获取,论文写明访问日期为2023年5月1日,范围是亚利桑那州2019年1月至2021年12月。作者去掉2020年和2021年,以避开疫情对出行的影响,分析年是2019。再筛到菲尼克斯,按目的分类,汇总到普查街区组(Census Block Group,CBG),并计算每个街区组的月平均。
SafeGraph 从手机应用的第三方合作方获得设备位置。论文写道,该县有超过85万台设备,大约相当于人口的8.5%。这句话没有写出县名,也没有给出与人口相关性的具体系数;代表性靠引用既有研究来说明。因此,下面的数字描述的是这套定位样本在街区组上的到访,不能直接当成全体居民的出行。
目的由目的地的北美行业分类系统(NAICS)代码推断,沿用 Lu 与 Giuliano(2023)的做法。数据里有目的地,没有出行者自己说的动机。表1的对应关系是:
- 通勤:农业、采矿、公用事业、建筑、制造、运输仓储、行政支持与废物处理、批发贸易。
- 非通勤:除上述通勤行业以外的全部行业。
- 购物:零售,以及房地产租赁。
- 个人事务:信息、金融保险、专业与科技服务、公共管理以外的其他服务、公共管理。
- 社交:文体娱乐,以及住宿餐饮。
医院、学校等行业没有出现在通勤、购物、个人事务或社交的名单里。它们若被算进“通勤以外的全部行业”,就会留在非通勤大类中。购物、个人事务、社交的观测数相加是5,480+2,714+4,474=12,668,比非通勤的13,839少1,171。论文没有点名这1,171条属于哪些行业。
因变量有六个。表2的定义是:街区组内、该目的兴趣点的平均到访次数,除以街区组面积(英亩),再取对数进入回归。1英亩大约4,047平方米。后文把面积标准化后的水平值叫作到访密度,把回归里的对数结果与它分开。表2的最小值都大于0,所以样本是有该类到访记录的观测,不是菲尼克斯每一个街区组。
| 到访密度 | 观测数 | 算术平均(次/英亩) | 标准差 | 最小 | 最大 | 对数均值 |
|---|---|---|---|---|---|---|
| 全部 | 23,719 | 2.3 | 4.1 | 0.006 | 92 | 0.014 |
| 通勤 | 9,880 | 1.9 | 4.0 | 0.005 | 92 | −0.073 |
| 非通勤 | 13,839 | 2.6 | 4.2 | 0.001 | 73 | 0.077 |
| 购物 | 5,480 | 3.5 | 5.2 | 0.001 | 73 | 0.630 |
| 个人事务 | 2,714 | 0.52 | 1.1 | 0.001 | 20 | −1.6 |
| 社交 | 4,474 | 3.1 | 3.5 | 0.007 | 58 | 0.63 |
通勤加非通勤等于全部:9,880+13,839=23,719。算术平均不能跨行比较成“个人事务只有购物的一成”,因为两组观测不是同一批街区组。分布右偏:购物的对数均值0.630,若这是自然对数,对应的几何平均大约是 e^0.630≈1.9 次/英亩,低于算术平均3.5。个人事务的对数均值−1.6,e^(−1.6)≈0.20,也低于算术平均0.52。回归使用的是每条观测取对数后的值。
论文还写,最初1,956,772条兴趣点记录经过处理后变成73,281个普查街区组,表3的自变量描述也用这个样本量。六个回归的观测数却小得多。回归行数远大于一座城市通常的街区组个数,模型里又有月份虚拟变量,一行更接近某个街区组的某一个月。论文没有给出街区组个数,也没有解释73,281与23,719之间的差额。下文每个系数都带上该模型自己的观测数。
菲尼克斯先提供了什么样的城市背景?
既有研究常用密度、多样性、设计、到公交的距离和目的地可达性这组 D 变量解释出行。很多工作要么只看通勤,要么把所有非通勤捆在一起。这篇论文的问题是:在一座依赖汽车的大城市里,这些变量和兴趣点到访密度的关系,会不会因目的而不同。
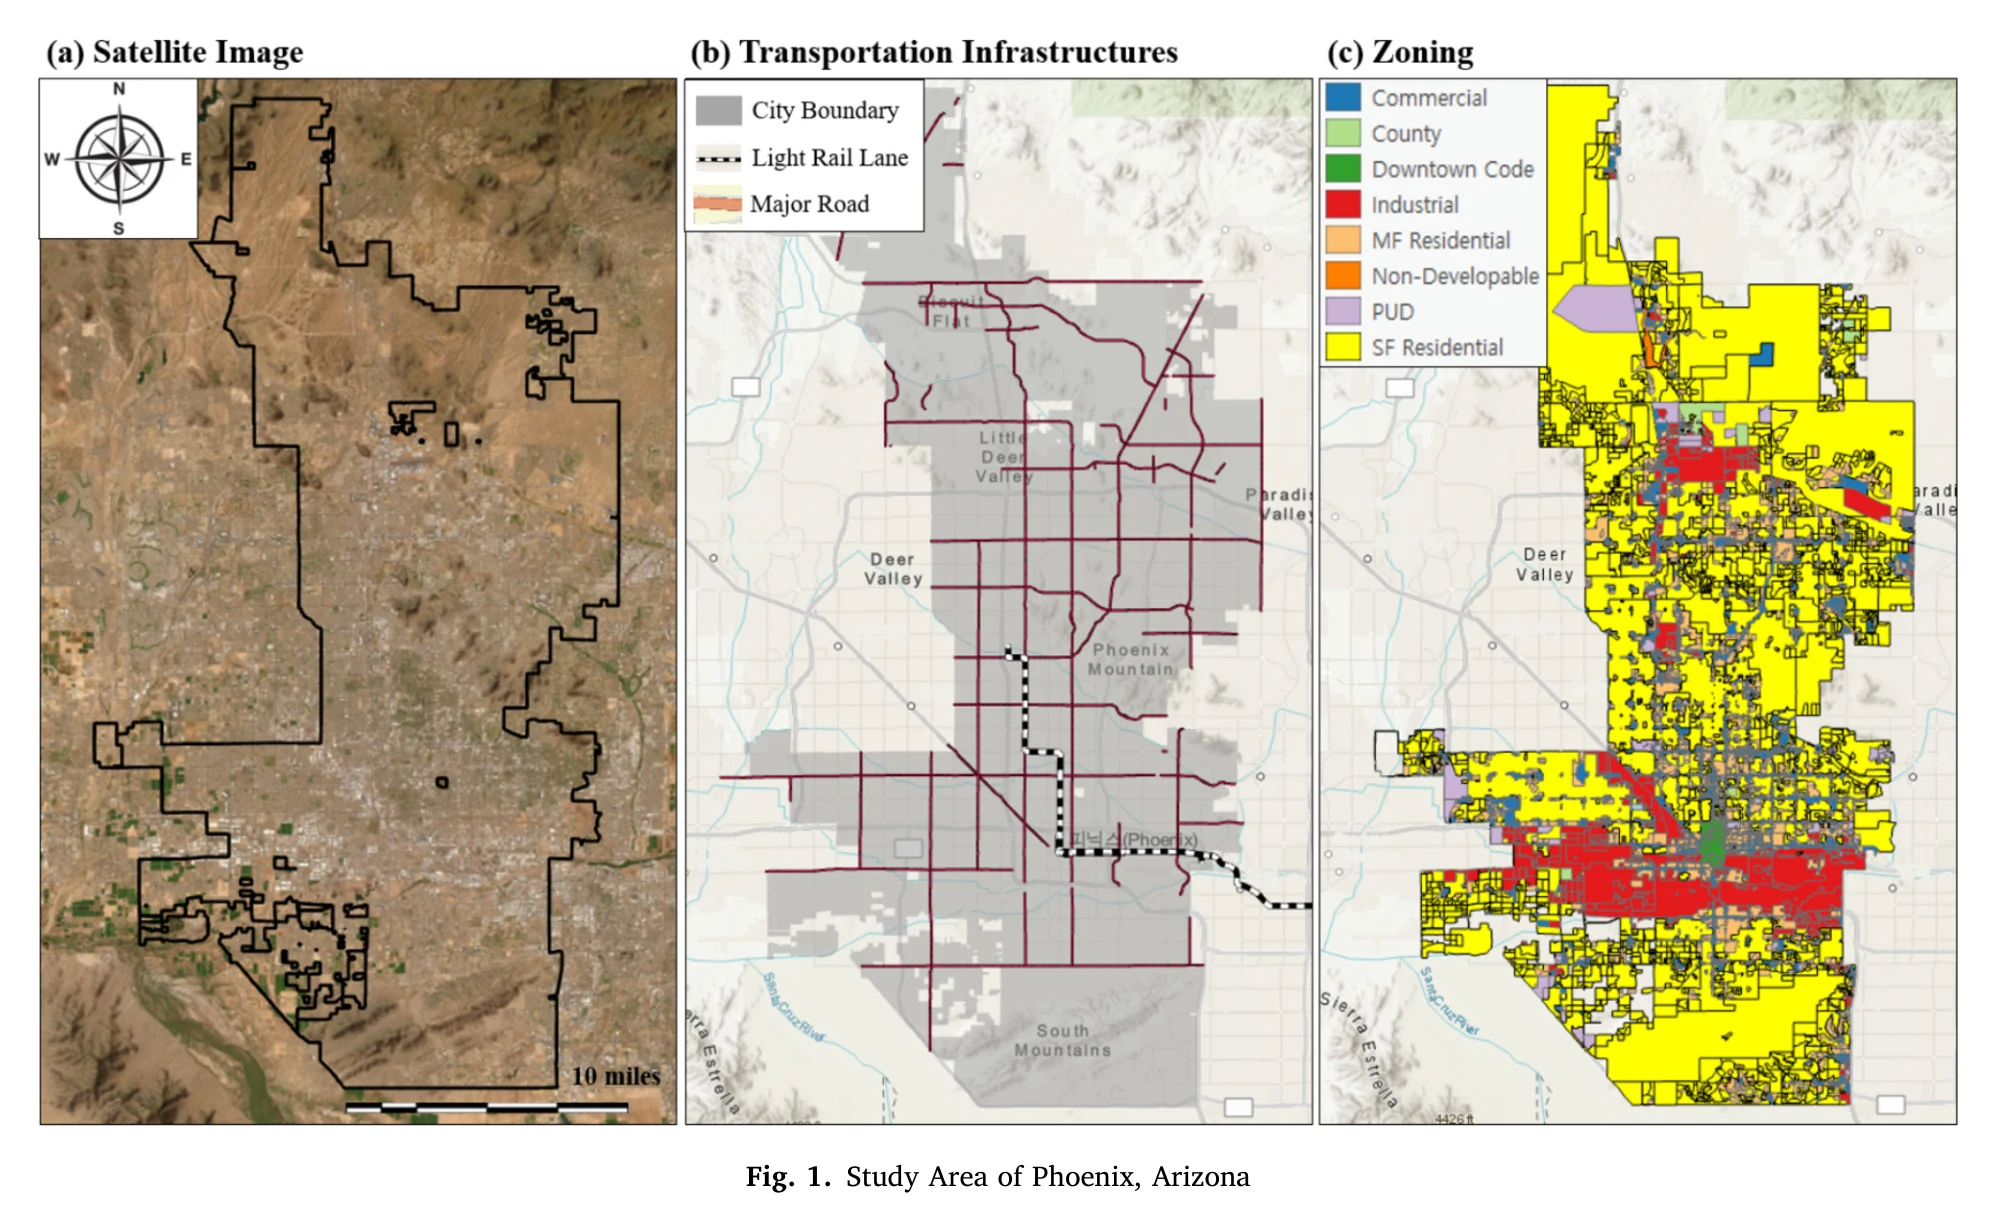
图 1|菲尼克斯的城市范围、轨道和用地,为什么适合把目的拆开?
(a)卫星影像画出城市边界,比例尺为10英里。(b)灰色为城市边界,橙色为主要道路,黑色虚线为轻轨。地图上能看出一条穿过中部再向东的轻轨走廊,道路网则铺满大部分城区。(c)用地分区以黄色独户住宅为主,红色工业用地沿走廊分布,蓝色商业所占面积较小;橙色为不可开发用地,紫色为规划单元开发。来源:原论文 Fig. 1。
图1说明比较发生在什么城市里。道路网覆盖广,独户住宅连片,轨道只有一条走廊。讨论部分把菲尼克斯轻轨写成以单线运营为主,并指出这限制了核心区以外的到达。图上能核对的是走廊稀少;单线运营的班次和可靠性,图本身没有给出。
到访的高值集中在城市南半部吗?
在进入回归之前,需要先看六类到访是不是同一个空间图案。若图案完全一样,拆目的就只是把同一个地图重复六遍。
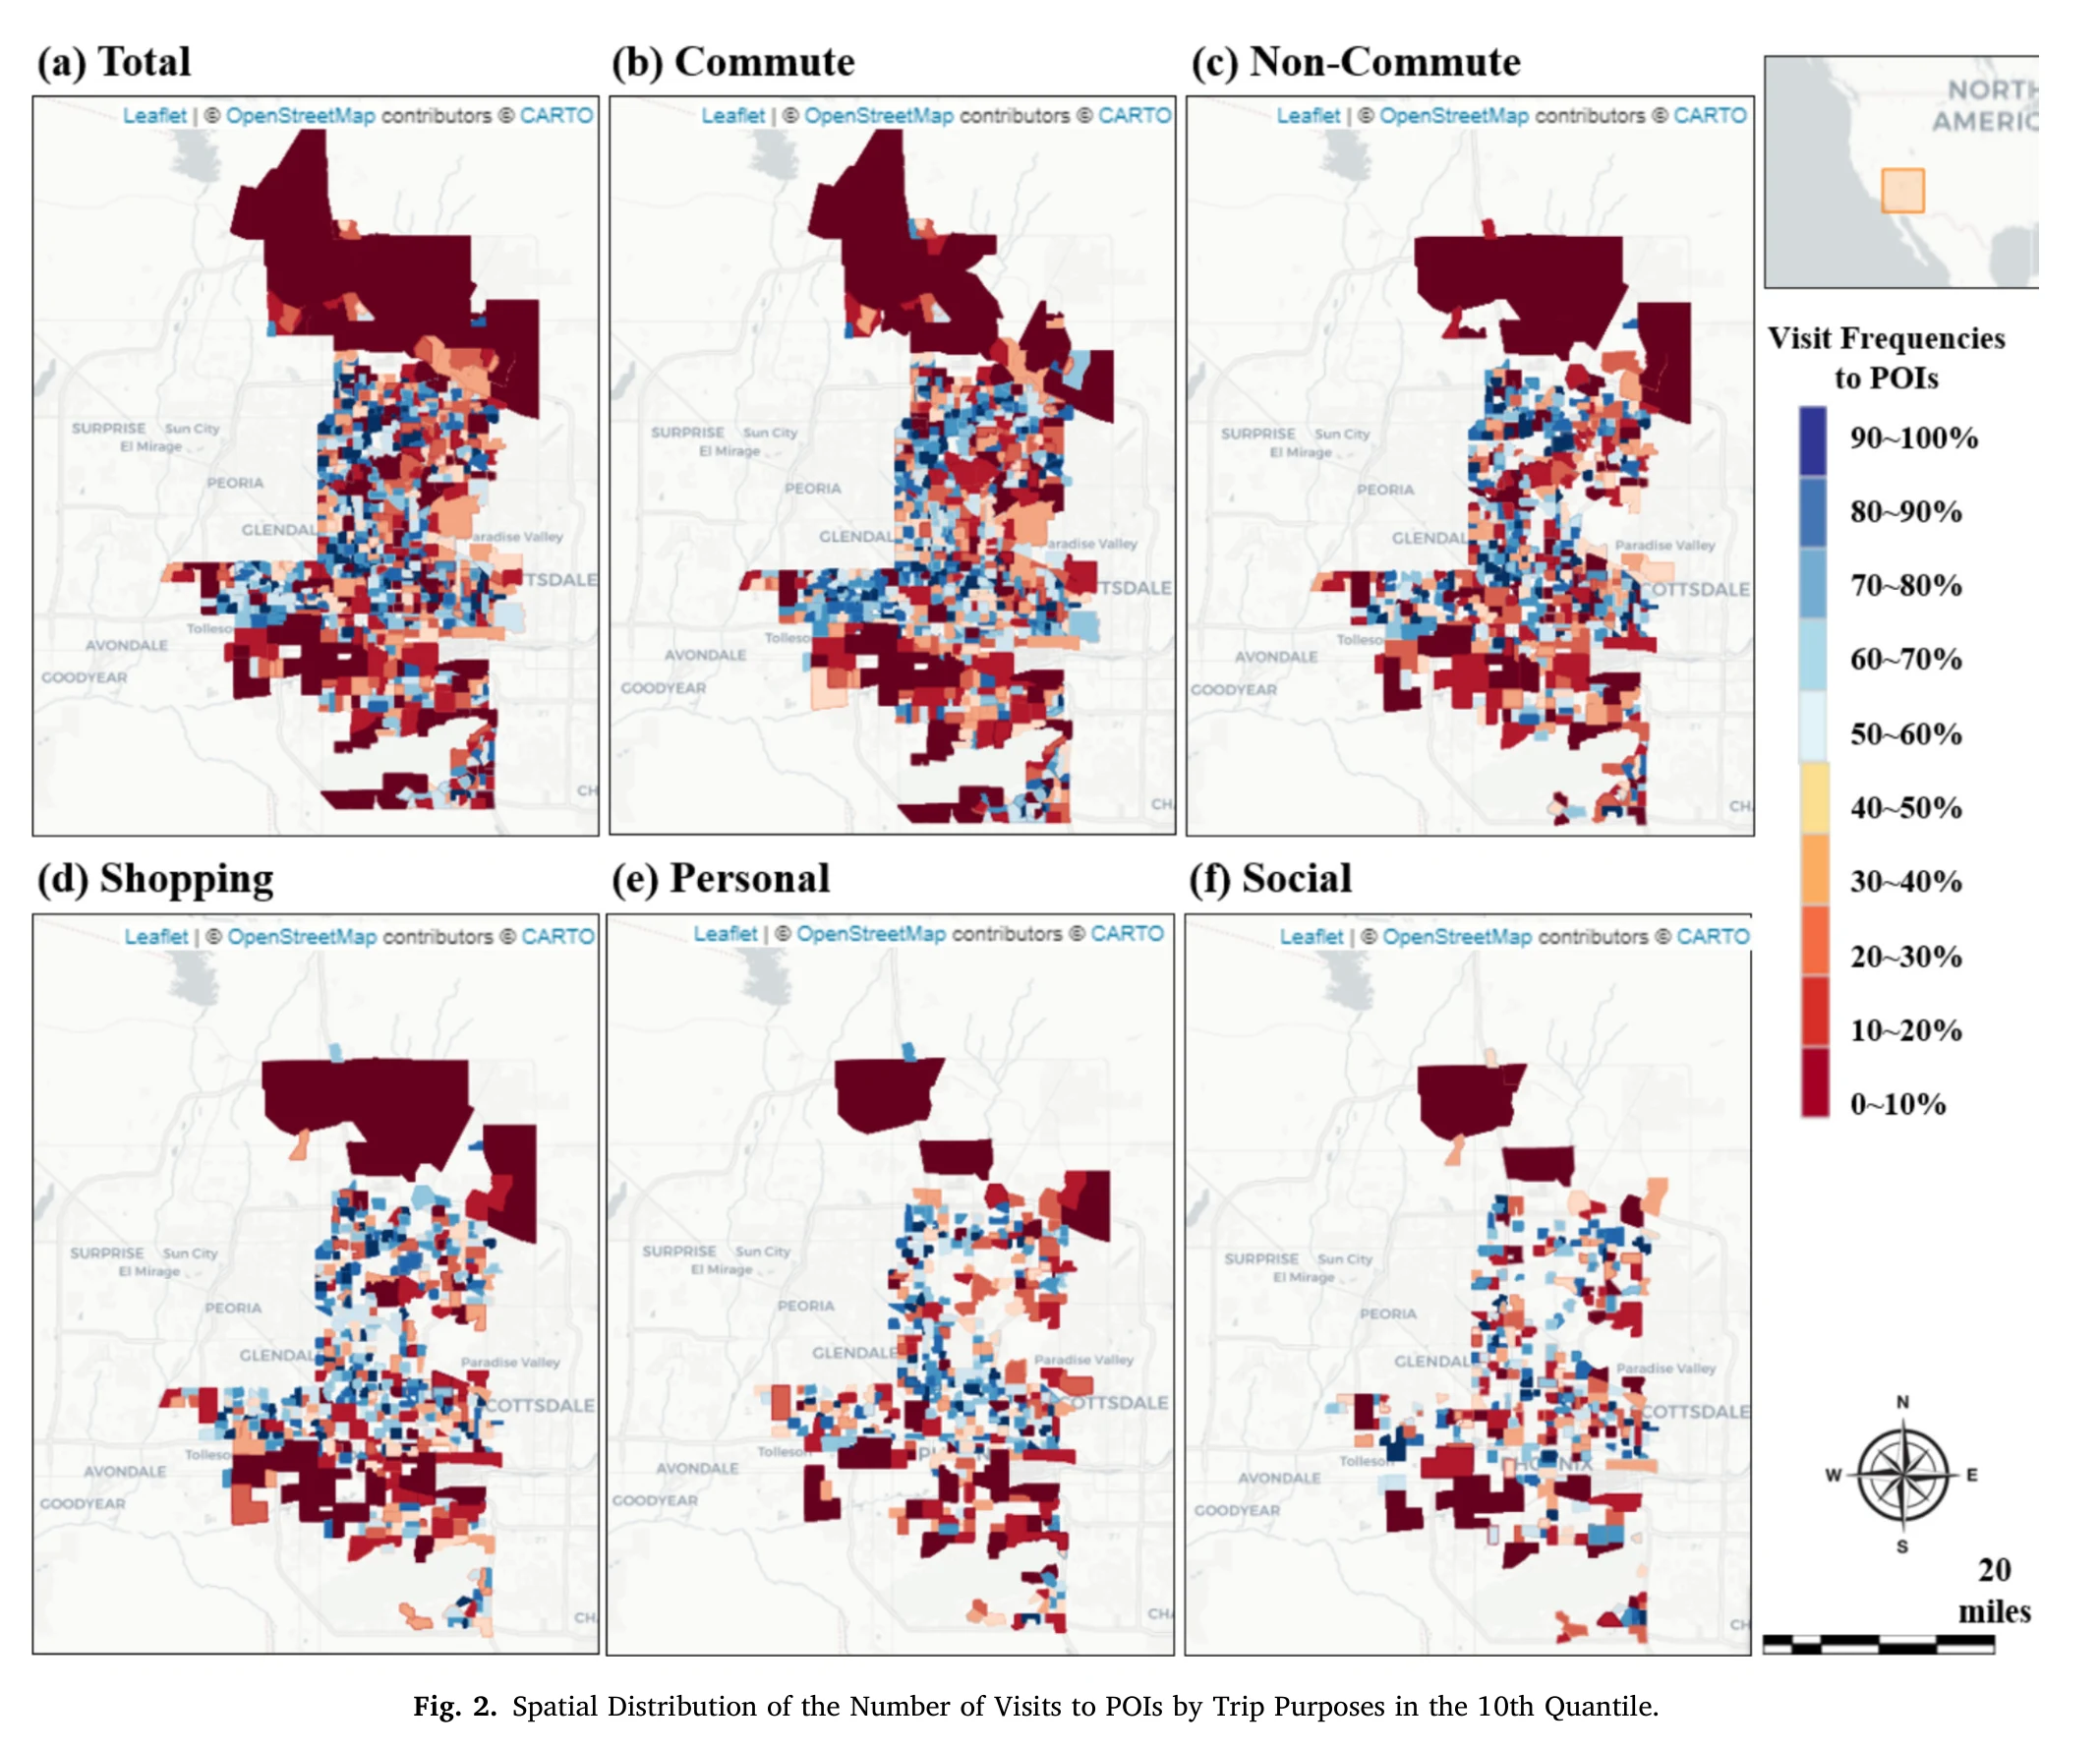
图 2|六类到访密度的高分位,是否落在同一片城区?
颜色是十分位,不是每英亩的原始次数。暗红为0–10%,深蓝为90–100%,比例尺20英里。(a)全部到访:城市北侧大片处于最低一档,较高分位分散在南侧已建成的城区。(b)通勤与(c)非通勤保留这一南北差别,高分位的具体街区并不重合。(d)购物的高分位同样偏南,北侧大片仍为最低档。(e)个人事务和(f)社交的着色单元更少,与表2中2,714和4,474的较小观测数相符。空白处论文没有逐格解释。来源:原论文 Fig. 2。
图2支持“到访在空间上不均匀”,也支持个人事务和社交覆盖的街区更少。它不能告诉读者,高分位是人口密度造成的,还是用地、路网或车站造成的。北侧最低档既可能是活动少,也可能是街区组面积大。因变量已经除以英亩,所以颜色是密度的相对位次,仍然不是每位居民的到访次数。
回归在控制什么,又故意留下什么?
自变量是2019年街区组上的建成环境、出行行为和经济社会变量。建成环境来自美国社区调查五年估计、Smart Location Database、住房与交通负担指数,到家距离来自 SafeGraph。所有自变量的方差膨胀因子都小于5,论文据此认为共线性不构成问题,但没有列出每个变量的膨胀因子。
人口密度、活动密度、交叉口密度、路网密度和到家距离进入模型时已经取自然对数。活动密度是住房与就业机会等总活动量的密度。就业混合指数的刻度是0–100,表3均值78.0,标准差只有3.1,范围66–84,多数街区都挤在较高的一段。职住比是就业地点数除以家庭户数,均值0.003,标准差0.01。紧凑度指数是0–10的分数,均值7.0,标准差1.7。公交可达性是0/1变量:街区组人口加权中心到最近公交站小于半英里则为1。它在73,281条记录上的均值是0.8,大约八成记录被标成1。这是描述统计的分母,论文没有另给23,719条回归样本中的比例。半英里站点和轻轨站不是同一个变量。
表3里还有几列“比例”取对数后均值仍为正,例如公交通勤比例2.9、非西班牙裔白人比例4.3。比例若在0到1之间,自然对数应为负数。家庭收入中位数写成美元的自然对数,均值却是1.9。论文没有说明缩放。这些变量只作为控制项,下文不把均值换算成百分比或美元。车辆行驶里程(vehicle miles traveled,VMT)是每户年车辆英里数的自然对数,均值9.6,对应的几何平均大约是 e^9.6≈1.5万英里/户·年;对数标准差只有0.1,街区之间的里程差别不大。
月份在73,281条记录里被写成各约8%。回归从2月列到12月,1月没有单独系数。按常规的虚拟变量设定,其他月份是相对1月的差别;若参照月不是1月,表里看不出来。
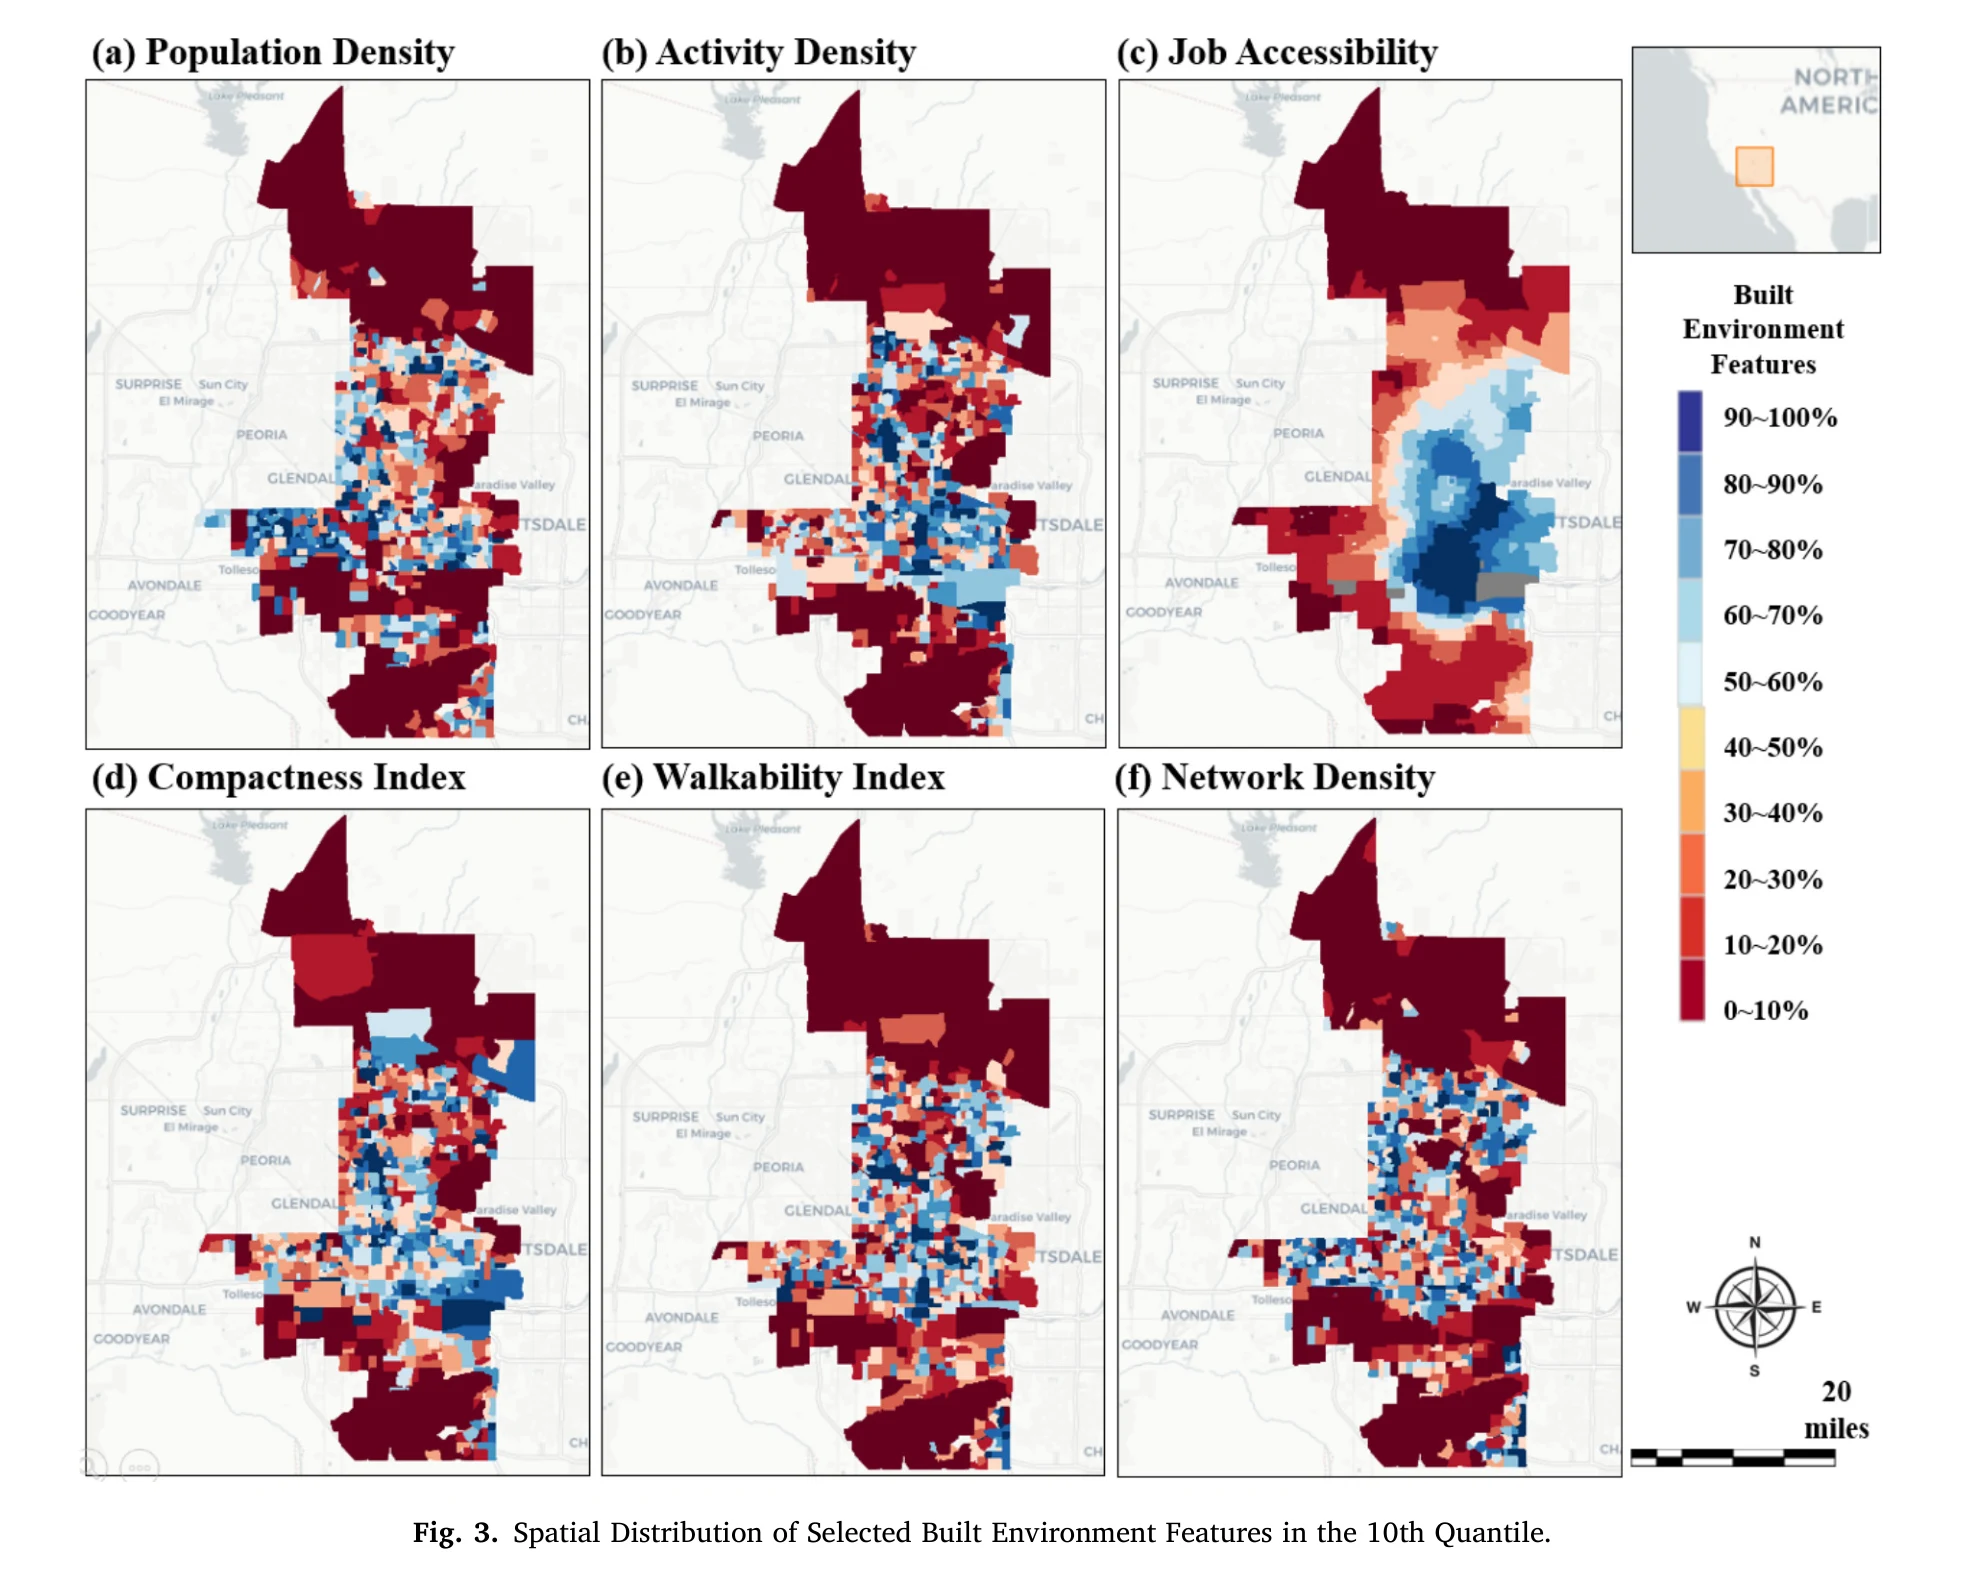
图 3|进入回归之前,建成环境本身是否也挤在市中心?
颜色仍是十分位,暗红为最低10%,深蓝为最高10%。(a)人口密度在北侧大片最低,高值分布比(b)活动密度更散;论文据此说活动密度更紧地集中在市中心一带。(c)就业可达性在中部形成高值,并向外降低。(d)紧凑度、(e)步行指数、(f)路网密度的高值也都避开北侧大片低值区,但高值街区并不重叠。来源:原论文 Fig. 3。
图3(c)的就业可达性和(e)的步行指数出现在地图上,表3的回归名单里没有这两个名字。回归使用的是职住比、到家距离和半英里公交站指示。不能把图3(c)或(e)的蓝色区块直接读成后面的回归系数。
普通最小二乘的残差存在空间自相关。莫兰指数从全部模型的0.093到个人事务的0.493,论文均标为 p<0.01。稳健的误差检验统计量高于稳健的滞后检验,空间误差模型的赤池信息量也低于空间滞后模型和普通最小二乘。作者因此用邻接权重的空间误差模型回答“关联是否因目的而不同”。空间误差系数 λ 表示相邻街区的残差有多相似。它处理的是误差里的空间结构。密度、车站和到访本来就叠在同一张地图上,模型没有使用外生的改造冲击,系数仍是控制了表中变量之后的关联。
相对重要性是另一个问题。作者改用普通最小二乘的标准化系数,因为这种系数便于比较单位不同的变量。他们同时写明,普通最小二乘忽略空间相关,残差若存在空间自相关,估计可能有偏。因此,方向和斜率以空间误差模型为准;谁的份额更大,只是这套可能有偏的标准化系数给出的排序。
| 模型 | 观测数 | 残差莫兰指数 | 空间误差 λ | 普通最小二乘调整后 R² |
|---|---|---|---|---|
| 全部 | 23,719 | 0.093 | 0.781 | 0.307 |
| 通勤 | 9,880 | 0.241 | 0.805 | 0.442 |
| 非通勤 | 13,839 | 0.106 | 0.742 | 0.254 |
| 购物 | 5,480 | 0.339 | 0.805 | 0.419 |
| 个人事务 | 2,714 | 0.493 | 0.809 | 0.331 |
| 社交 | 4,474 | 0.393 | 0.847 | 0.422 |
调整后 R² 属于普通最小二乘,不是空间误差模型的拟合。六个数里最低的是非通勤0.254,最高的是通勤0.442。正文写“0.307到0.443”,没有把非通勤的0.254算进区间。λ 全部标为 p<0.01,最小0.742,最大0.847。相邻街区未解释的部分高度相关,尤其是观测最少的个人事务和社交。
7月相对1月,六个模型的系数都为正。全部模型是0.139(标准误0.024,观测23,719);通勤是0.206(标准误0.026,观测9,880)。若因变量为自然对数,前者大约相当于到访密度高15%,后者大约高23%。月份系数只说明2019年年内有起伏,没有分离暑期、气候和旅游。
哪些关联在六类目的里方向一致?
人口密度是最稳定的一行。六个系数依次为0.538、0.552、0.571、0.243、0.967、0.565,标准误依次为0.021、0.023、0.030、0.030、0.052、0.030。因为两边都取了对数,系数可以读成弹性:全部模型中,人口密度高10%,对数到访密度大约增加0.051,到访密度大约高5%。购物的弹性只有0.243,同样的10%大约对应高2%。个人事务的弹性是0.967,10%大约对应高10%。这是其他协变量保持不变、并允许残差空间相关时的关联幅度。
活动密度同样全部为正:0.184(0.020)、0.121(0.022)、0.207(0.031)、0.391(0.031)、0.036(0.055)、0.244(0.030)。购物的0.391最清楚,和个人事务那一列形成对照。个人事务的0.036小于自己的标准误0.055,表6仍标了三星。按括号里的标准误,这一列看不出与零有别。摘要说人口和活动密度在所有出行类型上都为正关联;点估计确实都为正,但活动密度的个人事务一列不能再说成统计上清楚。
就业混合指数的清楚正关联出现在全部(0.029,标准误0.009)、通勤(0.050,标准误0.011)、购物(0.044,标准误0.014)和社交(0.035,标准误0.015)。非通勤是0.017(标准误0.013)。个人事务是−0.043(标准误0.023),大约是标准误的1.9倍,只到论文使用的 p<0.1。指数本身只在66到84之间摆动,0.050表示的是0–100刻度上的1分,不是“多样性翻倍”。
交叉口密度和路网密度并不是同一件事。交叉口密度的对数在全部、通勤和购物上为正,系数0.250(0.060)、0.754(0.067)、0.474(0.088)。非通勤和社交看不出与零有别。个人事务为−0.296(0.157),同样只到 p<0.1。路网密度的对数则在全部、非通勤、购物和社交上为正,系数1.950(0.335)、3.151(0.502)、2.830(0.483)、1.824(0.474);通勤和个人事务看不出与零有别。1.950远大于人口密度的0.538,只说明两个对数变量的单位不同。表3里人口密度对数的标准差是0.7,路网密度对数的标准差只有0.05。样本里路网密度几乎不动,原始斜率大,并不自动等于它在样本变异中更重要。
换一个目的,符号会在哪里变?
到家距离是对数。全部模型的系数是0.009(标准误0.011),看不出与零有别。一旦拆开,通勤为−0.046(0.012),非通勤为0.065(0.017),购物为0.054(0.023),个人事务为0.194(0.025),社交为0.133(0.017)。距离变为2倍时,对数距离增加约0.693。乘上这些系数,通勤到访密度大约低3%,非通勤大约高5%,购物大约高4%,个人事务大约高14%,社交大约高10%。表3没有写距离的单位,均值8.9是取对数之后的数,不能读成8.9英里或8.9公里。
这个符号和讨论部分的措辞需要分开。表3的变量是兴趣点到访问者家的平均距离,距离更大,系数为正就表示到访密度更高。讨论把同一结果说成“离家近促进了非通勤”。摘要写的是距离更大与非通勤到访正相关、与通勤负相关,和表6的符号一致。讨论中的“更近所以更多”与这一定义下的正系数对不上。一种与表6符号相容的读法是:被标成通勤的生产、仓储类兴趣点,到访密度更高的地方,访问者的家也更近;购物和社交目的地则可能吸引更远的来访者。这只是和符号相容的理解,论文没有把访问者拆成附近居民和远距离顾客。
半英里公交站指示也随目的变号。全部−0.071(0.029),非通勤−0.093(0.046),个人事务−0.381(0.089),社交0.202(0.043)。购物−0.063(0.044),系数约为标准误的1.4倍,论文未标显著。通勤−0.011(0.030),系数远小于标准误,论文却标了三星。按标准误,通勤这一列不能算作负关联。个人事务若按自然对数换算,从0到1大约对应到访密度低32%;社交大约高22%。描述统计里这个指示的均值已经是0.8,比较的是少数半英里以外的记录和大多数半英里以内的记录。讨论用轻轨覆盖有限、班次和安全顾虑来解释负号。回归变量是最近的公交站,包含公共汽车站点。轻轨只是讨论里的城市背景,不是这一列的测量。
紧凑度也不是单一方向。全部0.039(0.012),非通勤0.047(0.018),这两列为正。通勤−0.011(0.013)、购物0.013(0.017)、社交0.011(0.018)都看不出与零有别。个人事务−0.061(0.034),证据弱于人口密度那一行。摘要和结果文字说紧凑度总体不显著、只在个人事务上为负。表6的全部模型和非通勤模型与这句概括不同。个人事务上的负号,论文解释为拥挤和停车不便。模型没有放入停车供给或拥堵测量,这个机制是作者的推测。
职住比的单位很小,原始系数却很大。通勤为4.954(标准误1.140),购物为−10.430(标准误1.597),其余四列看不出与零有别。表3的标准差是0.01。若用这个描述统计的离散程度感受尺度,通勤系数乘以0.01大约是0.05个对数点,购物大约是−0.10个对数点。一个“职住比增加1”的变化远大于样本里的实际起伏。
车辆里程和公交通勤比例被放在解释变量一侧,它们本身也是出行结果。车辆里程的对数在全部模型为−0.696(0.172),通勤为−1.974(0.182),购物为−0.453(0.252)。购物这一列大约是标准误的1.8倍,论文标了两星,按常见的双侧5%标准,证据偏弱。非通勤、个人事务和社交看不出与零有别。负号表示,每户车辆里程更高的街区,全部、通勤和购物的到访密度更低。它不能被读成“把里程降下来,到访就会上升”。
公交通勤比例的对数,在全部、通勤、非通勤、购物和社交上为负:−0.298(0.055)、−0.281(0.062)、−0.271(0.080)、−0.213(0.080)、−0.476(0.086)。个人事务为正,0.351(0.133)。结果文字写社交出行的系数是0.476,并把正号放在社交上。表6的社交列是−0.476,正号出现在个人事务。
经济社会控制变量也随目的变化,而且有的星号与标准误不符。例如全部模型中,非西班牙裔白人比例的系数为0.047、标准误0.044,却标了三星;大学及以上学历为−0.150、标准误0.024,反而没有星。家庭规模在六个模型里都为负,其中全部模型是−0.110(标准误0.021)。下文的建成环境结论不依赖这些对不上的星号。
相对重要性用的是另一把尺子
表7把每个普通最小二乘标准化系数写成正数,括号里是它占该列绝对值之和的百分比。和为100%的分母包括建成环境、车辆里程、公交通勤比例和社会经济变量,不包括月份虚拟变量。负数在这张表里被抹掉了,方向必须回到表6。
人口密度的份额是33.64%(0.360/1.070)、26.12%(0.372/1.424)、36.40%(0.371/1.019)、21.67%(0.321/1.481)、40.78%(0.564/1.383)、20.57%(0.391/1.900)。正文说标准化系数范围为0.360到0.564;表中购物是0.321,低于0.360。六列的最大项都是人口密度。活动密度的份额是7.66%、2.80%、9.71%、15.46%、1.95%、11.47%。它在购物和社交上较高,在通勤和个人事务上很低。摘要把人口和活动密度并列为始终最有影响的因素;表7支持的是人口密度,活动密度的份额随目的差得很大。
通勤模型里,车辆里程占20.78%(0.296/1.424),就业混合占12.64%(0.180/1.424),活动密度只占2.80%(0.040/1.424)。非通勤模型里,路网密度占12.16%(0.124/1.019),家庭规模占10.50%(0.107/1.019)。购物模型里,活动密度15.46%(0.229/1.481),就业混合14.38%(0.213/1.481),路网密度12.42%(0.184/1.481)。个人事务模型里,家庭规模占12.72%(0.176/1.383),高于活动密度的1.95%(0.027/1.383)。社交模型里,活动密度、就业混合和路网密度分别占11.47%、11.42%和10.10%。
到家距离的份额是1.12%、4.91%、2.84%、2.56%、5.06%、6.10%。半英里公交站的份额是0.65%、1.19%、0.39%、3.03%、3.54%、2.36%。正文说公交可达性的相对重要性在所有目的上都低于到家距离。购物一列相反:公交站占3.03%,到家距离占2.56%。个人事务的空间误差斜率虽然大,标准化之后也只占3.54%(0.049/1.383)。0到1的落差可以很大,而这个变量在样本里的变异有限,两句话同时成立。
非通勤的公交通勤比例占5.29%(0.054/1.019)。正文用这个份额说明公交更多被用于非通勤。表6里这一列的符号是负的。份额只表示绝对值的大小,不表示公交分担率越高、到访密度越高。
这些关联能说到哪一步?
可以比较有把握地说的是:在2019年菲尼克斯这套 SafeGraph 样本中,控制表内变量并允许残差空间相关之后,人口密度与六类对数到访密度同向;到家距离、半英里公交站、紧凑度、交叉口和路网的关系随目的变化。个人事务的样本只有2,714条,残差的空间聚集也最强,这一列的弱星号尤其不宜说成稳定规律。
不能说的也同样明确。横截面不能建立因果,作者在局限里写了这一点。目的来自目的地行业,一次出行可以兼有买菜和办事,数据却要求一个目的地对应一个目的。定位样本来自智能手机,老年人和较少使用定位服务的人可能被低代表。分析只在菲尼克斯,而且只看目的地一端的到访密度,没有同时建模起点。到访密度被当作城市活力的代理,社交互动、消费和文化活动并没有直接测量。2019年去掉了疫情年份,也没有更长的时间序列。数据声明写的是可应要求提供,正文没有补充图表。
政策段落建议提高密度、混合用途、改善公交首末公里,并提到15分钟城市。这些是作者从关联出发的规划建议。模型没有估计“提高密度”或“新建车站”之后到访密度会变化多少。
一句话总结
在2019年的菲尼克斯,街区人口密度越高,六类兴趣点的每英亩到访都越多;到家距离、半英里内的公交站和紧凑度则随出行目的改变方向,而且这些仍是街区尺度上的横截面关联。
核心来源
- Cities 正式版,Cities,161(2025),105903。正文图1–3、表1–7的数字均来自这一版。
- 数据说明见论文方法:SafeGraph 兴趣点到访,经 Dewey 于2023年5月1日获取;建成环境来自2019年美国社区调查五年估计、Smart Location Database 和住房与交通负担指数。论文写明数据可应要求提供。
- 出行目的的行业归类沿用 Lu 与 Giuliano(2023),Travel Behaviour and Society,31:189–201。DOI:10.1016/j.tbs.2022.11.011。
作者介绍
- Sangwan Lee:论文署名为韩国土地与地理空间信息公社下属 LX 空间信息研究院。贡献包括初稿、可视化、软件、方法、形式分析与数据整理。波特兰州立大学交通研究与教育中心的报道写明,他2022年在该校城市研究与规划学院获得博士学位,研究出行方式选择,随后在该研究院从事研究。
- Sugie Lee:通讯作者,论文署名为汉阳大学城市工程系。贡献包括初稿、监督和方法。汉阳大学城市工程系介绍及 ORCID(0000-0002-0940-4488)可核对他自2012年起在该系任教,研究方向包括城市形态、土地利用与出行。
- Devina Widya Putri:论文署名为汉阳大学城市工程系。贡献包括可视化、验证和方法。该校城市设计与空间分析实验室的成员页列她自2022年9月起攻读博士,研究兴趣为城市地理、移动与公平,联系邮箱与论文一致。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
到家距离的符号可以做成一次更严格的核对。若通勤类兴趣点的高到访密度确实来自“职工住得近”,就应该在家到工作地的真实起讫对上看到负的距离关系;若购物和社交的正系数来自“热闹的店吸引远客”,把到访拆成街区内部居民和外部访客之后,正系数应主要留在外部访客上。现在的平均距离把两种人合成了一个数,两种机制会叠在同一个符号里。
半英里指示也值得换一把尺子。描述统计里大约八成记录已经落在半英里以内,而图1只有一条轻轨走廊。若负号主要来自公共汽车站点沿线的用地,把轻轨站、高频公交和普通公交站分开后,社交出行上的正号和个人事务上的负号不一定还在。这个检验仍然是关联检验,但至少能把“附近有一个站”和“附近有一条能替代开车的轨道”区分开。