把时间窗拉长、把圈子放到更远,人数起伏还守得住同一条规律吗?
论文名片|Xingye Tan、Bo Huang、Michael Batty、Weiyu Li、Qi Ryan Wang、Yulun Zhou、Peng Gong,The spatiotemporal scaling laws of urban population dynamics,Nature Communications,2025,16:2881。2024年7月10日收稿,2025年3月17日接收。DOI:10.1038/s41467-025-58286-4。
图1里的北京是整篇论文的入口。绿色小方块覆盖16个网格,九个时刻的颜色深浅并不一样;紫框里的四条曲线,纵轴都标到1000,有的上下跳动,有的几乎贴着底部。只看某一个钟点,各地像是各有各的高峰。
论文改问尺度。时间窗从1小时放到1天,距离从主要中心放到外围,平均起伏还会不会落在同一类幂律上。北京、上海、广州、深圳、米兰和大波士顿这六个工作日样本给出的方向是:时间和距离两边都接近幂律;指数再随距离和时间窗按对数滑动,并与城市密度连成异速关系。下文的 F 是去掉局部趋势之后的统计起伏。窗口变长,读到的是这条统计量变大,不能把幂次直接换成人数的倍数。
先说结论
- 在离最近主中心的距离 r 上,平均起伏随时间窗 s 按幂增长。六个案例的时间拟合,城市平均 R² 在 0.992 到 0.997 之间;论文给出的总体平均大约是 0.994。
- 在固定的时间窗里,平均起伏随距离按幂下降,空间指数为负。城市平均 R² 在 0.893 到 0.956 之间,总体平均大约是 0.921。深圳在大约 25.5 公里处有一次明显折点,折点两侧各自仍接近一条直线。
- 单个网格也有自己的时间指数 αᵢ。六城估计值的下限都高于 0.5,上限从米兰的 1.293 到大波士顿的 1.805。高值集中在规划中的主城、新城核心和交通廊道,低值更多出现在外围。
- 环带上的时间指数对距离的对数近似直线下降。六城 R² 从深圳的 0.884 到米兰的 0.961。用同一套参数回放对数起伏,六城斜率在 0.980 到 0.998 之间,R² 在 0.978 到 0.999 之间。
- 若密度本身随距离按幂下降,起伏就与密度成异速关系。兴趣点密度的平均拟合优度高于 0.87,高于人口密度那一组。正文举例,四个中国城市大约在每平方公里 5000 人附近,时间指数跨过 1。
20分钟里累计的,是哪一种人数?
研究对象是一个地点的人数怎样随时间起伏,分析单位是网格上的时间序列,以及离主要中心某一距离的环带。它不统计某个人的轨迹,也不统计从甲地到乙地的流量。
六个案例来自三套设备数据,都收成连续10个工作日,再统一到20分钟一档。一天因此有72个时点,十条序列共720个时点。20分钟以内的记录被累计起来,当作该格的名义人数。
| 案例 | 设备记录 | 日期 | 分析网格 | 环带宽度 |
|---|---|---|---|---|
| 北京、上海、广州、深圳 | 腾讯位置服务的定位请求;四城爬取数据合计 33.6 GB | 2018年4月16–27日,无公共假期的10个连续工作日 | 约 1.15 公里 × 1.15 公里;原始定位分辨率 0.01 度,平均约 6 分钟爬取一次 | 3 公里 |
| 米兰 | 电信网络连接,约 5740 万条;数值与网格内互联网连接量成比例 | 2013年11月4–15日的10个连续工作日 | 约 235 米 × 235 米;原始时间间隔 10 分钟 | 0.5 公里 |
| 大波士顿 | SafeGraph 的 GPS 定位,最初记在人口普查街区组 | 2020年2月3–14日的两个工作周 | 约 1 公里 × 1 公里 | 3 公里 |
33.6 GB 是四座中国城市爬取文件的合计体积,不是四城各自的体积,也不是记录条数。约 5740 万是米兰的记录条数。讨论里把所分析的移动设备数据概括为超过 8 亿条;主文没有给出中国城市和大波士顿的记录条数,这 8 亿不能由上面两项相加得到。
四个中国城市和大波士顿的说明里,城市半径写为超过 50 公里。米兰的城市半径大约 10 公里。同心环的中心来自城市或区域总体规划:深圳有多个主中心,距离取到最近的一个;其余五个案例各有一个主中心。环带距离取环宽中点到该中心的距离。一个网格若被环切开,只按落在环内的面积参加加权。
人口密度用 WorldPop,分辨率约 3 角秒,在赤道附近大约 100 米,年份与设备数据对齐:中国 2018、意大利 2013、美国 2020。兴趣点(points of interest,POI)在四座中国城市来自高德地图,米兰和大波士顿来自 OpenStreetMap,年份同样对齐。POI 密度在这里代表功能聚集的程度,密度更高被当作功能吸引力更高的一种近似。
为什么先做去趋势,再谈幂律?
人数序列常常带着早晚高峰这样的局部趋势。直接计算标准差,长趋势会混进取伏。论文使用去趋势波动分析(detrended fluctuation analysis,DFA),并采用按时间加权的改进,以便在较长窗口里把局部直线拟合得更稳。
做法可以收成三步。先把网格 i 的名义人数累加,得到一条走势。再按时间窗 s 把走势切成等长小段,并从两端各切一次,使尾部不被漏掉;每一段减去自己的直线。最后把各段剩余偏离的方差平均后再开方,得到该网格的平均起伏 Fᵢ(s)。s 从 1 小时取到 1 天,步长 20 分钟。
对呈长程相关的序列,这个统计量随窗口按幂增长:
Fᵢ(s) ∝ s^αᵢ
αᵢ 是该网格的时间标度指数。环带上的 F(s, r) 则是与该环相交的各网格 Fᵢ(s) 的面积加权平均。图1先说明一条网格序列从哪里来,图2再说明 r 和 s 怎样进入平均。
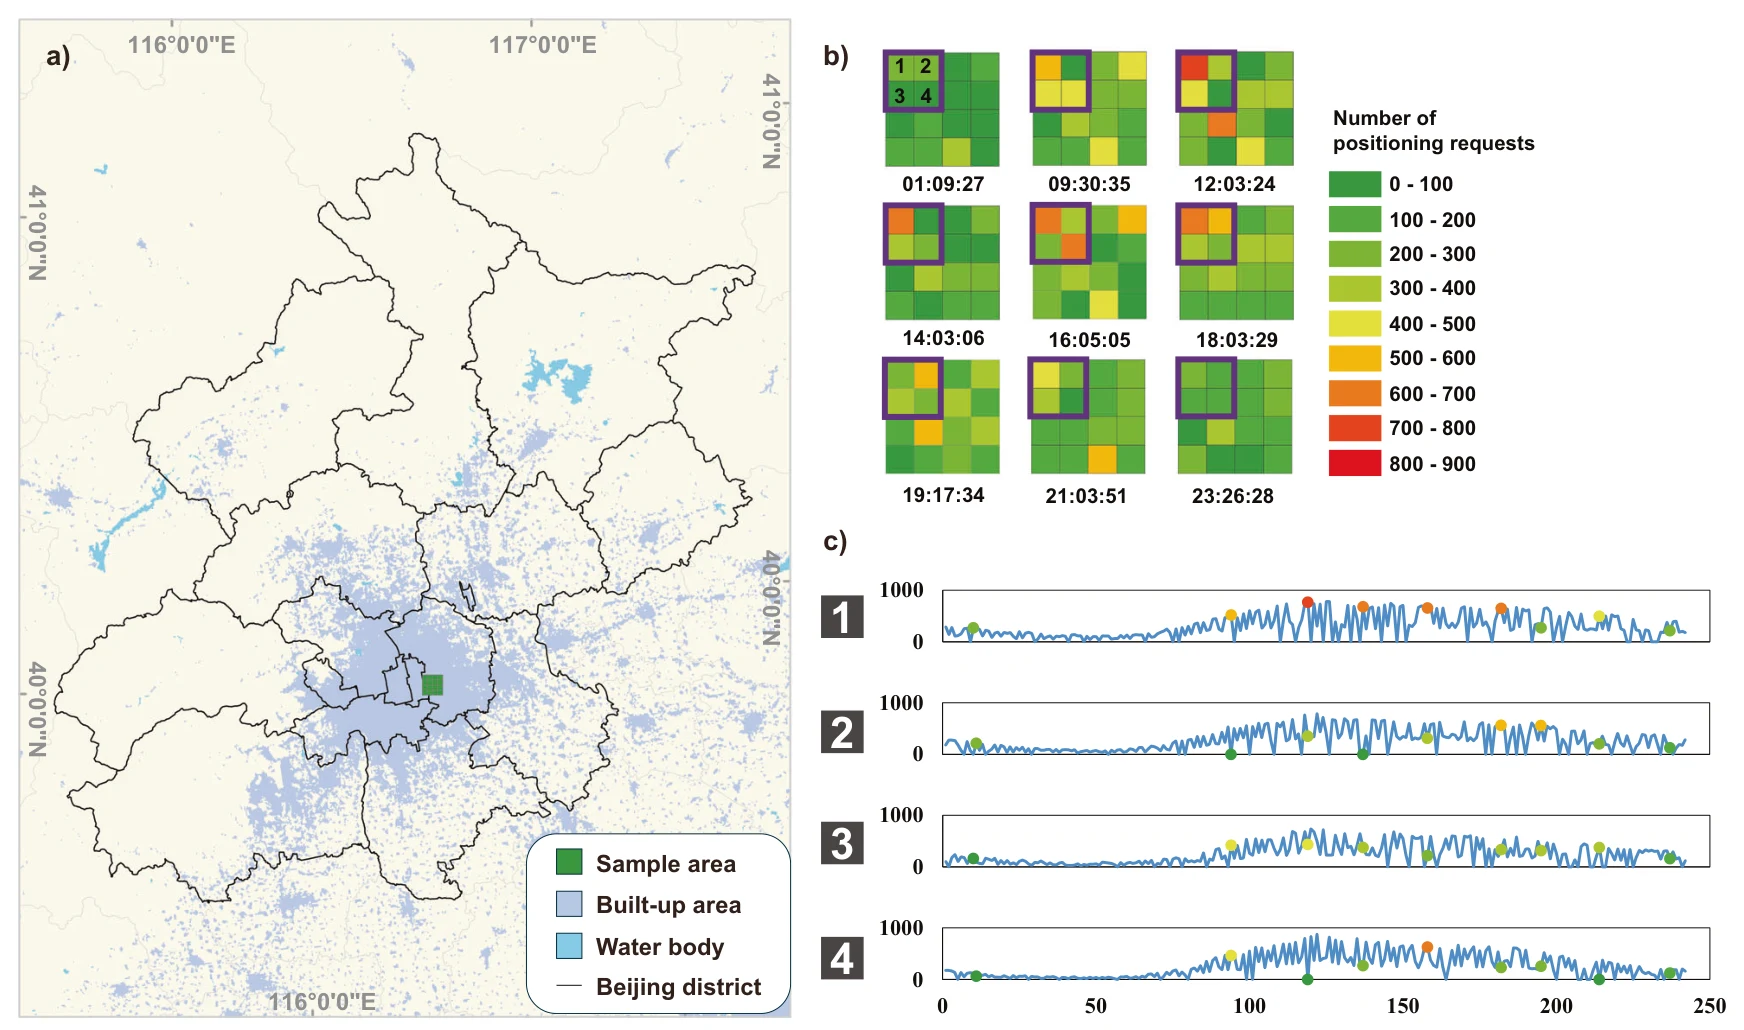
图 1|一个地点的人数起伏,在进入标度分析之前长什么样?
(a)北京范围示意。绿色为样本区,浅蓝为建成区,蓝色为水体,灰线为市辖区边界。(b)样本区 16 个网格在九个时刻的定位请求数。颜色按每 100 次一档,从 0–100 到 800–900;紫框标出后面要画曲线的 4 个网格。(c)这 4 个网格的时间序列,纵轴标度为 0 和 1000,彩色点与(b)中相同时刻的颜色对应。来源:原论文 Fig. 1。
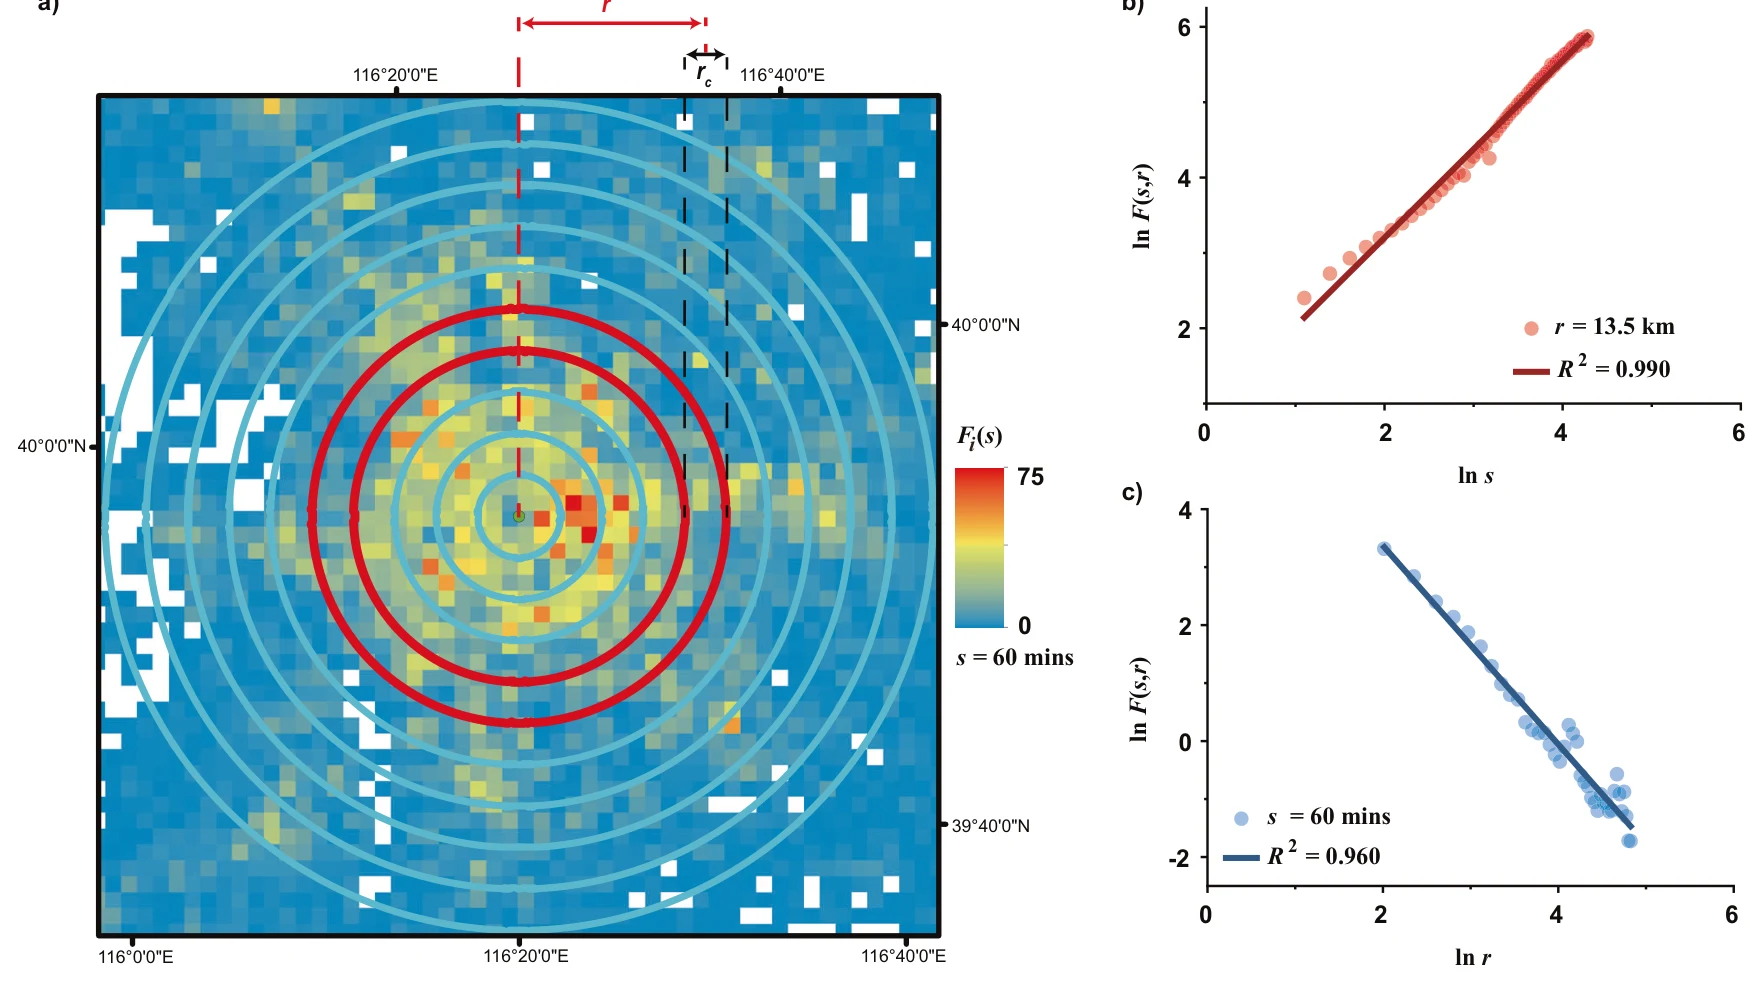
图 2|平均起伏是在哪一圈、哪一个时间窗上测量的?
(a)北京的同心环。红圈是示例环,r 为环带中线到中心的距离,r_c 标出环宽。颜色是 s=60 分钟时各网格的起伏,色标从 0 到 75。(b)红圈所在距离 r=13.5 公里的时间标度。横轴 ln s,纵轴 ln F(s, r),直线的 R²=0.990。(c)同一城市在 s=60 分钟时的空间标度。横轴 ln r,纵轴 ln F(s, r),R²=0.960。来源:原论文 Fig. 2。
(b)和(c)都是北京的一个例子。0.990 的分母是这一条距离上、各个时间窗的双对数拟合;0.960 的分母是这一个 60 分钟窗口上、各个距离环的双对数拟合。它们还不是六城的汇总。
六个城市的平均起伏,时间和距离两边都成直线吗?
环带平均之后,论文写出一对标度关系:
F(s, r) ∝ s^α(r),且 α(r) > 0
F(s, r) ∝ r^d(s),且 d(s) < 0
第一式说,站在离最近主中心某一距离上,时间窗越长,去趋势后的平均起伏越大。第二式说,站在某一个时间窗里,离最近主中心越远,这个平均起伏越小。两式合在一起,就是论文所说的时空尺度不变:在所测的小时到一天、以及各城的城市半径之内,起伏不靠某一个特征小时或特征公里数来刻画。指数却可以随 r 和 s 改变,所以不变的是幂律形式,固定的不是那一个斜率。
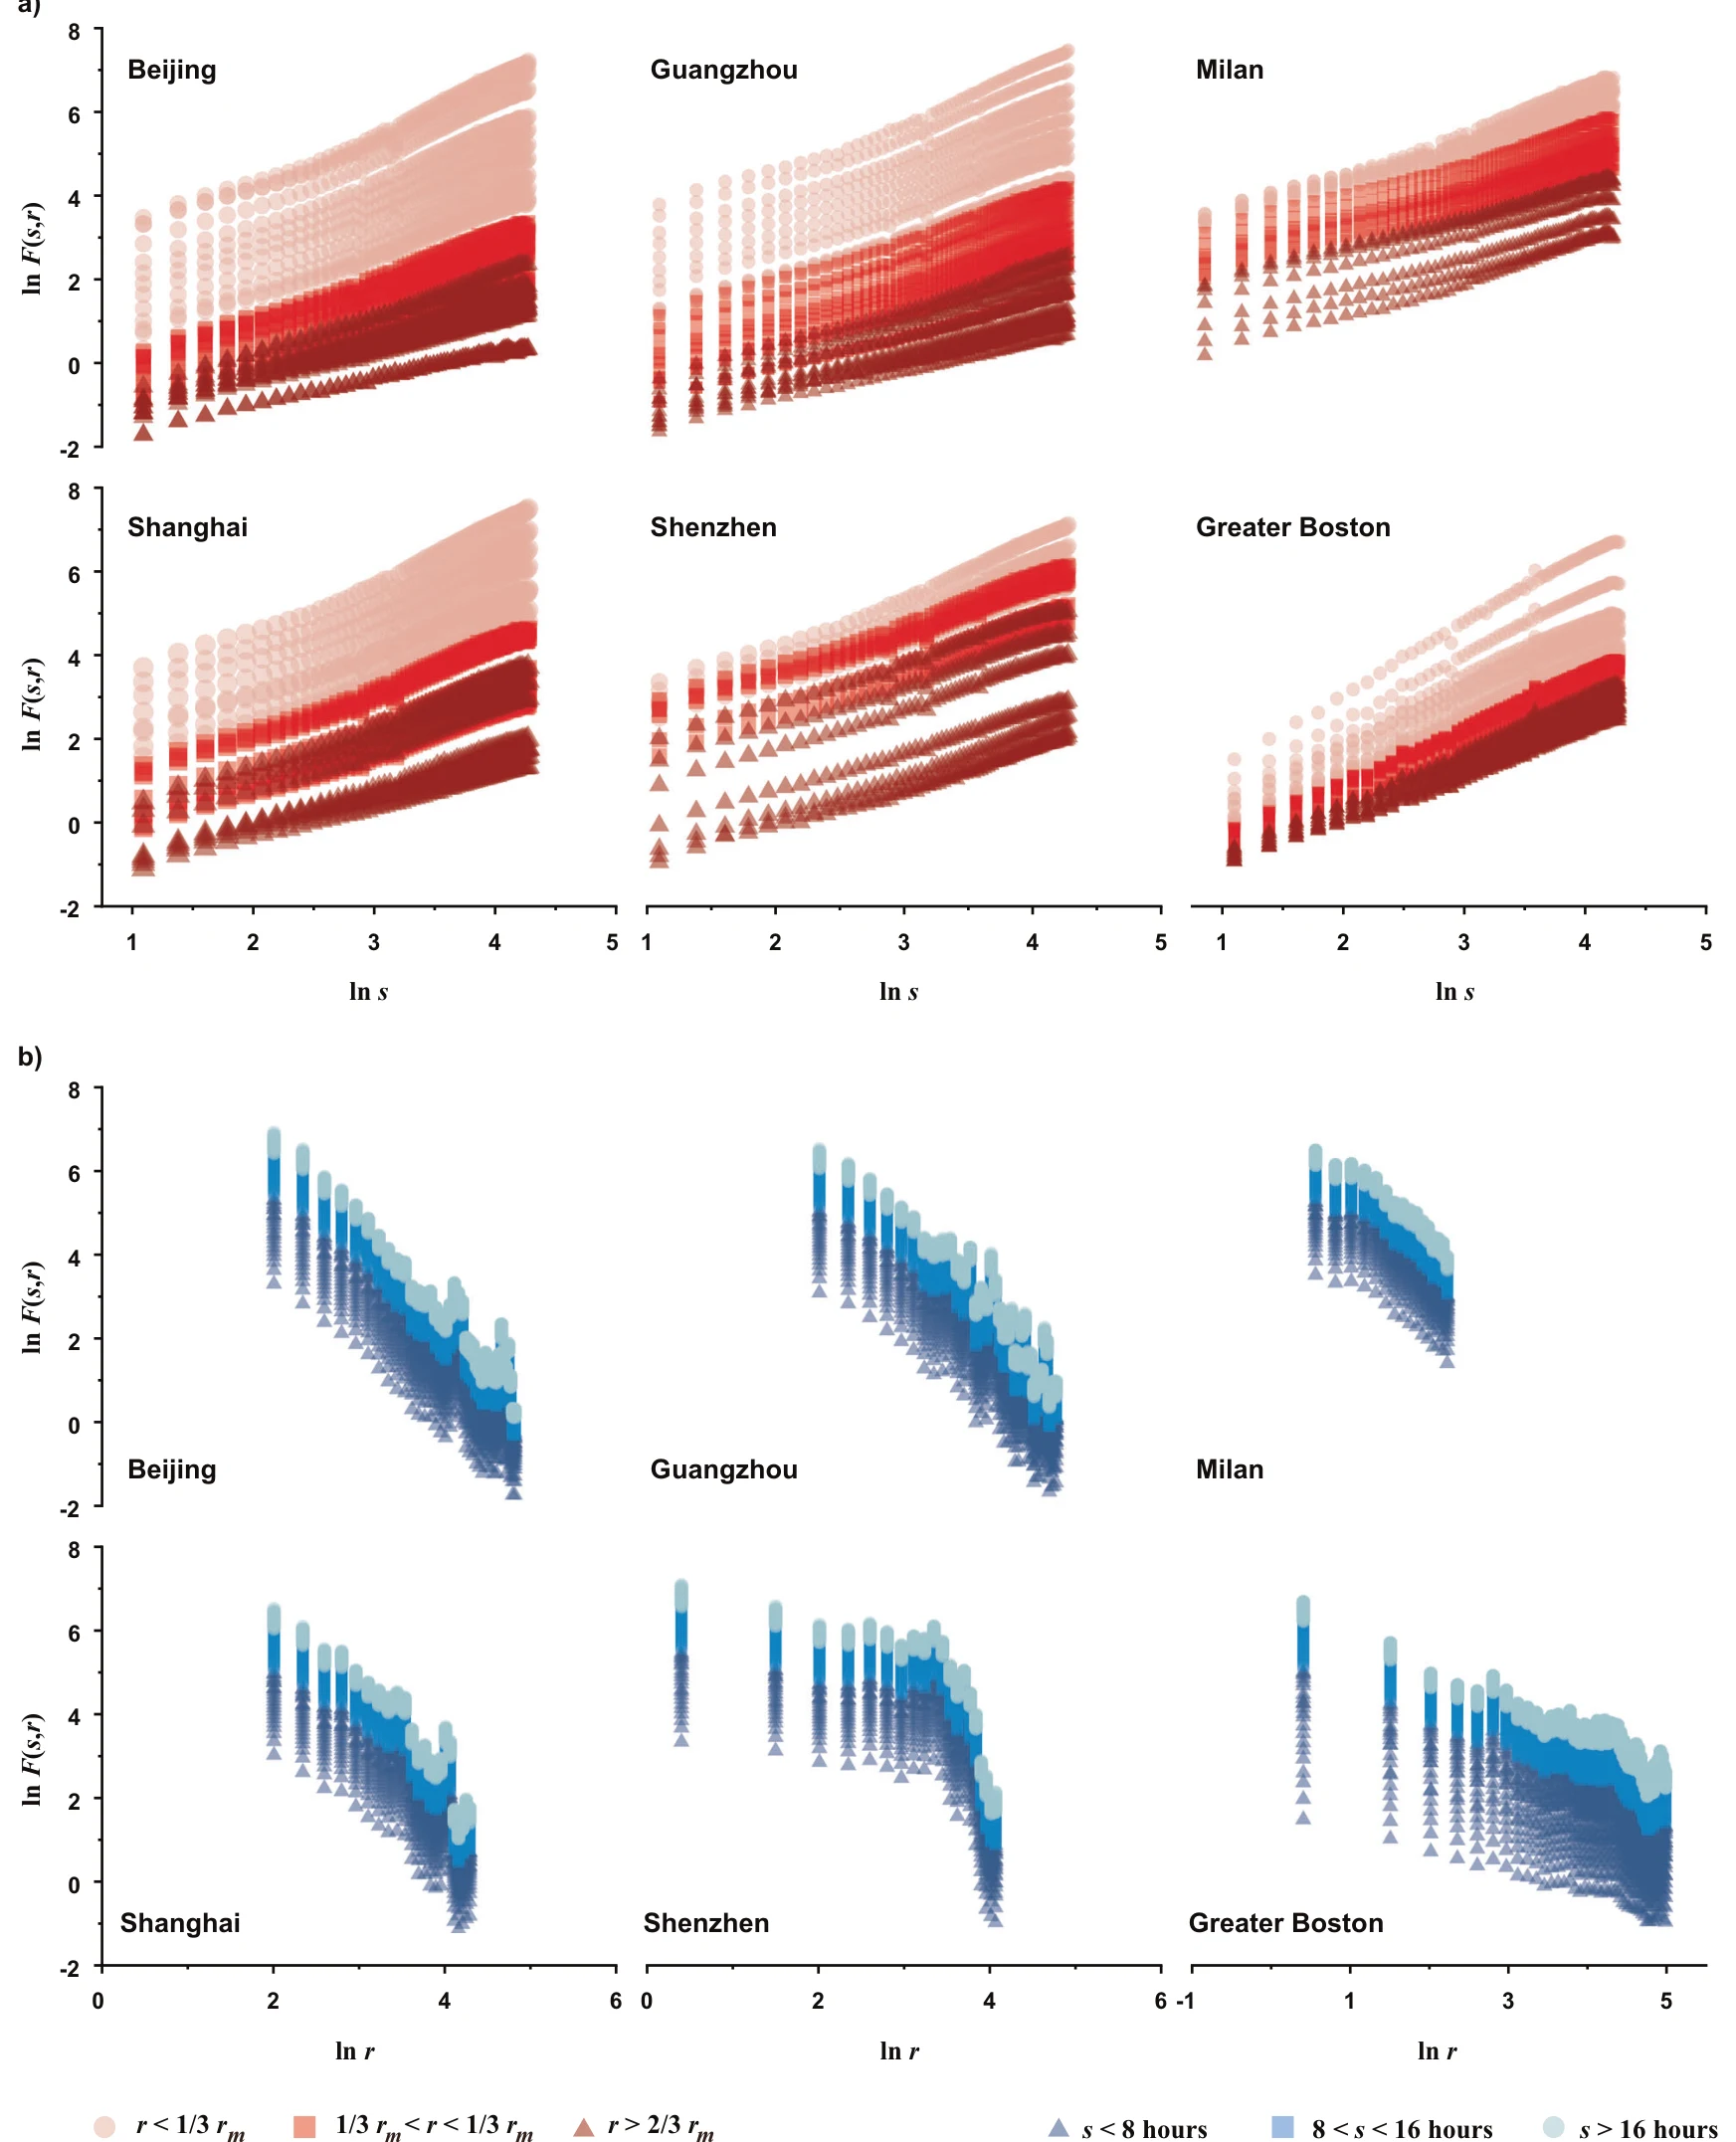
图 3|六个案例的平均起伏,是否同时沿时间和距离排成幂律?
(a)横轴 ln s,纵轴 ln F(s, r)。浅色圆、中等红色方块和深色三角,依次对应距离小于最大半径的三分之一、介于三分之一与三分之二之间、大于三分之二。六个案例的点都随时间窗上升。(b)横轴 ln r,纵轴仍是 ln F(s, r)。深蓝三角、中蓝方块和浅蓝圆,依次对应短于 8 小时、8 小时到 16 小时、长于 16 小时。点随距离下降;深圳中途出现一次明显弯折。r_m 是到最近主中心的最大半径。来源:原论文 Fig. 3。
六张图里,主文指出只有深圳有一处清楚的线性折点,大约在 r=25.5 公里,对应 ln r ≈ 3.23。25.5 公里以内斜率较低,空间上相对均匀;25.5 公里以外斜率更高。分开看,两段各自仍符合距离上的幂律。主文把这种现象称作同一城市里的多标度,并说明敏感性分析里也出现过类似折点。
表1把每一座城市在全部距离、全部时间窗上的直线拟合收成 R² 的范围和平均。平均的分母是该城各条标度直线的拟合优度,时间指数按不同距离分别拟合,空间指数按不同时间窗分别拟合。
| 城市 | 时间指数 α(r) 的 R² | 平均 | 空间指数 d(s) 的 R² | 平均 |
|---|---|---|---|---|
| 北京 | 0.973–0.999 | 0.994 | 0.943–0.963 | 0.947 |
| 上海 | 0.985–0.998 | 0.992 | 0.888–0.923 | 0.900 |
| 广州 | 0.985–0.998 | 0.994 | 0.918–0.945 | 0.918 |
| 深圳 | 0.988–0.997 | 0.992 | 0.834–0.922 | 0.893 |
| 米兰 | 0.988–0.996 | 0.992 | 0.943–0.961 | 0.956 |
| 大波士顿 | 0.994–0.998 | 0.997 | 0.915–0.944 | 0.926 |
时间方向最弱的城市平均仍有 0.992,单条拟合的下限是北京的 0.973。空间方向更松:深圳的城市平均只有 0.893,单条拟合可以低到 0.834。论文据此把总体平均写成大约 0.994 和 0.921。高 R² 支持这些样本里存在所写的幂律;空间一侧的离散说明,距离上的直线并没有时间一侧那么整齐。广州空间指数的平均被印成 0.918,与该范围的下限相同,这里照表1原样列出。
每个网格的时间指数,会铺成什么样的城市?
环带已经把一圈方向平均掉了。下一个问题是,不先画环,每一个有效网格自己的时间幂律是否还在,高指数会落在哪里。
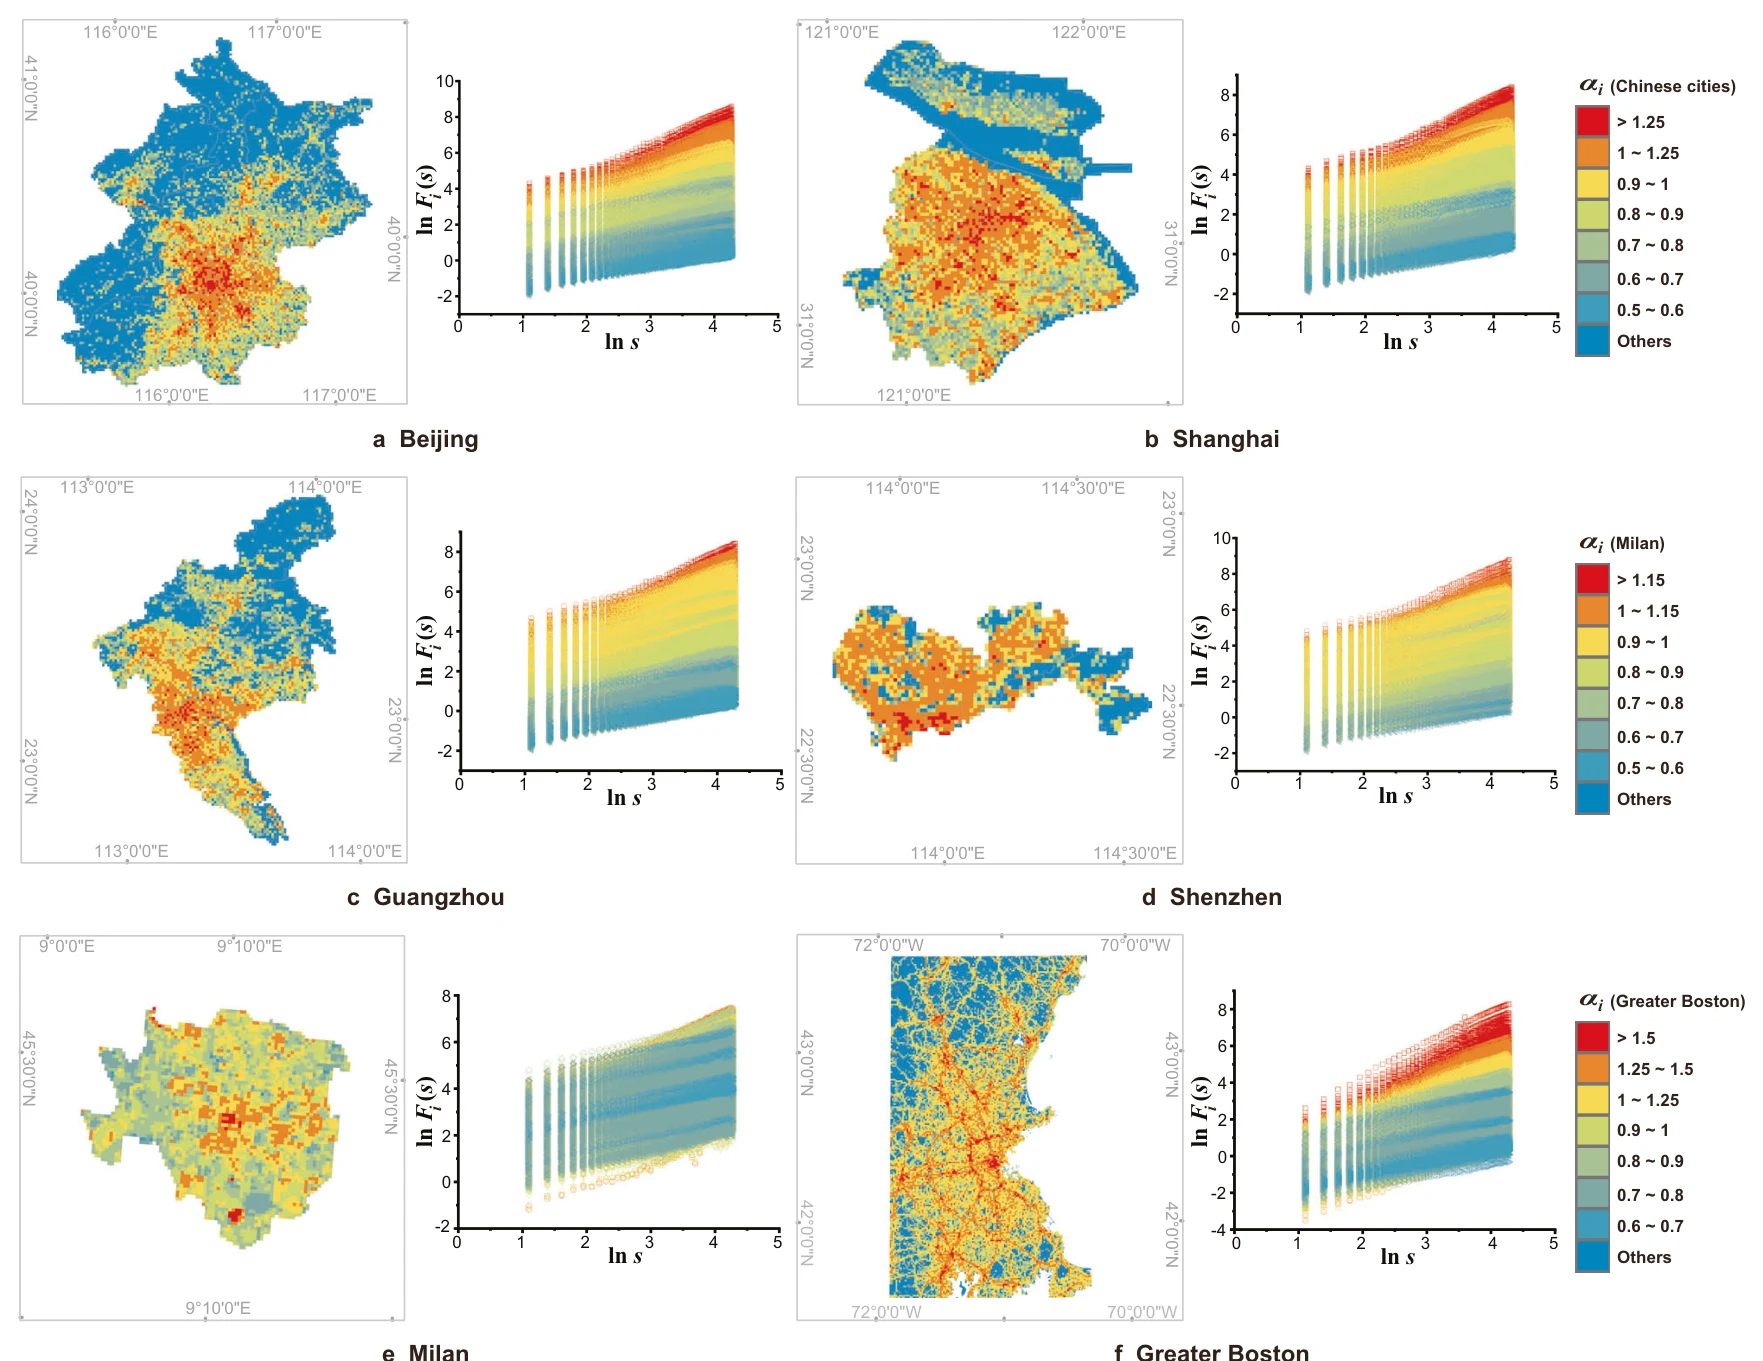
图 4|网格尺度的时间幂律,以及指数在地图上怎样分布?
(a)北京、(b)上海、(c)广州、(d)深圳:左侧是 αᵢ 的网格地图,右侧是每个有效网格的 ln Fᵢ(s) 对 ln s。四城共用中国城市色标,1.25 以上为最暖的一档,向下依次到 0.5–0.6。(e)米兰使用另一套色标,最暖一档从 1.15 起。(f)大波士顿的指数范围超过 1.5,最暖一档从 1.5 起,并在 1.25 与 1 之间再分一档;纵轴下沿标到 −4。右侧曲线的斜率就是各地图的 αᵢ。来源:原论文 Fig. 4。
网格上的关系写成 Fᵢ(s) ∝ s^αᵢ,αᵢ 的取值范围在 0 到 2 之间。小于 1 时,平均起伏随时窗次线性增加;等于 1 时为线性;大于 1 时为超线性。论文把 1 当作两类分形序列的分界:低于 1 更接近平稳的分数高斯噪声(fractional Gaussian noise,fGn),高于 1 更接近非平稳的分数布朗运动(fractional Brownian motion,fBm)。另一条界在 0.5:高于 0.5 表示长程相关,序列的起伏有持续性;低于 0.5 表示长程反相关。图4给大波士顿上色时还使用 1.5 这条界,主文把它指向补充说明中的持续性讨论。
表2是六城全部有效网格的估计范围。平均 R² 的分母是该城各网格双对数拟合的拟合优度。
| 城市 | αᵢ | 单网格 R² | 平均 R² |
|---|---|---|---|
| 北京 | 0.530–1.519 | 0.913–0.998 | 0.991 |
| 上海 | 0.523–1.491 | 0.935–0.999 | 0.990 |
| 广州 | 0.526–1.445 | 0.929–0.998 | 0.990 |
| 深圳 | 0.592–1.463 | 0.969–0.996 | 0.990 |
| 米兰 | 0.549–1.293 | 0.948–0.997 | 0.989 |
| 大波士顿 | 0.624–1.805 | 0.933–0.999 | 0.994 |
六个下限都高于 0.5,其中最低的是上海 0.523,最高的下限是大波士顿 0.624。上限最高的是大波士顿 1.805,最低的是米兰 1.293。北京上限 1.519,是四座中国城市里唯一超过 1.5 的上界;图4仍按中国城市的 1.25 分档。城市平均 R² 都在 0.989 以上,但北京单个网格可以低到 0.913。平均接近 0.99,只说明多数网格的幂律拟合很直,不能代表每一个网格。
地图上的高值主要位于规划主城区、新城和县城核心,以及重要交通廊道。论文进一步把中国城市 1.25 以上、米兰 1.15 以上、大波士顿 1.5 以上的格子,对应到中心商务区、历史或发展核心,以及经济、科技和产业节点。这是指数地图与规划结构的空间对照。
作者给出的解释是可能性,而不是单独检验过的因果。中心、功能节点和开发热点的人口密度更高,通勤和混合用地带来更频繁的到访,长窗口上的整体变化更大;短时变化相对这块很大的活动基数显得较平滑,于是 αᵢ 较高。外围若密度低、公共交通覆盖有限、功能单一,人数缺少明显的涨落,αᵢ 就较低。
指数沿半径滑动之后,模型还能回放起伏吗?
图4的高值向内、低值向外,提示环带指数 α(r) 会随距离下降。论文把它写成对数梯度:
α(r) = −b ln r + α₁
b 是下降有多快。α₁ 是 r=1 时的理论时间指数,论文用来代表靠近中心的参考位置;对数在距离为 0 时没有定义,所以 α₁ 不是几何中心点上的实测人数。把这条梯度代回时间幂律,空间指数也得到一条对数梯度,而且用的是同一个 b:
d(s) = −b ln s + d₁
d₁ 是 s=1 个时间单位时的理论空间指数。合在一起,对数起伏可以写成:
ln F(s, r) = −b ln s · ln r + d₁ ln r + α₁ ln s + 常数
只有先指定时间窗或距离,才能得到一条具体的空间幂律或时间幂律。常数是积分常数,不是人数。
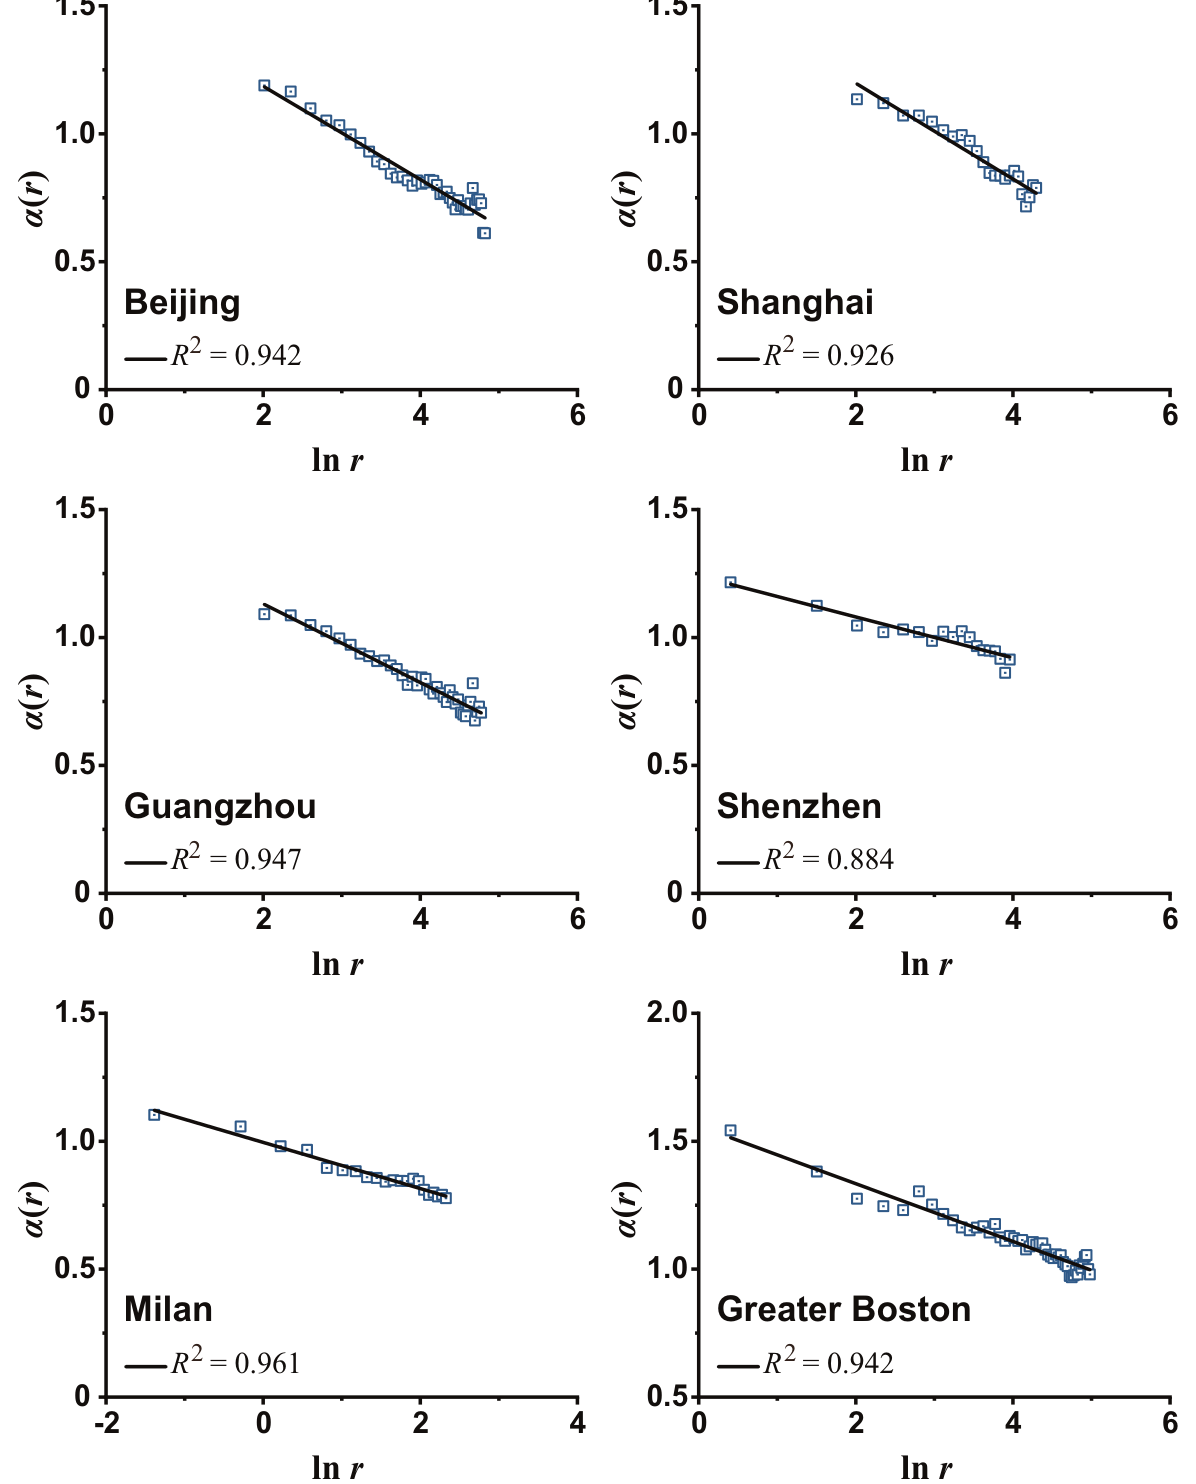
图 5|时间指数是否随离主中心的距离按对数下降?
图中六个面板没有子图字母。上排是北京和上海,中排是广州和深圳,下排是米兰和大波士顿。横轴 ln r,纵轴 α(r),直线对应上面的对数梯度。R² 分别为北京 0.942、上海 0.926、广州 0.947、深圳 0.884、米兰 0.961、大波士顿 0.942。米兰的横轴延伸到 0 以下,与它较小的城市半径相符。来源:原论文 Fig. 5。
深圳这一张单直线的 R² 只有 0.884,是六城最低。它的空间起伏在 25.5 公里处已经分成两段,一条直线的梯度自然更松。表3因此给深圳两套参数:括号中前一个数对应 r ≤ 25.5 公里,后一个数对应 r > 25.5 公里。其余城市各用一套。这些数来自补充图中的线性关系,主文表3印出了估计结果。
| 城市 | b | α₁ | d₁ | 常数 |
|---|---|---|---|---|
| 北京 | 0.203 | 1.717 | −1.317 | 4.180 |
| 上海 | 0.156 | 1.559 | −1.532 | 4.843 |
| 广州 | 0.165 | 1.566 | −1.486 | 4.943 |
| 深圳 | 0.077,0.203 | 1.277,1.764 | −0.099,−5.190 | 1.692,19.264 |
| 米兰 | 0.091 | 1.005 | −1.095 | 3.260 |
| 大波士顿 | 0.085 | 1.605 | −0.508 | 0.342 |
单中心案例里,北京的 b=0.203 最大,大波士顿的 b=0.085 最小。b 同时是 α 对 ln r、d 对 ln s 的下降速率,比较的是对数梯度。d₁ 都是负数,所以在参考时间单位上,起伏仍随距离下降;大波士顿的 −0.508 最接近 0,深圳外圈的 −5.190 属于另一套分段拟合。α₁ 最高的是深圳外圈的 1.764,最低的是米兰的 1.005。
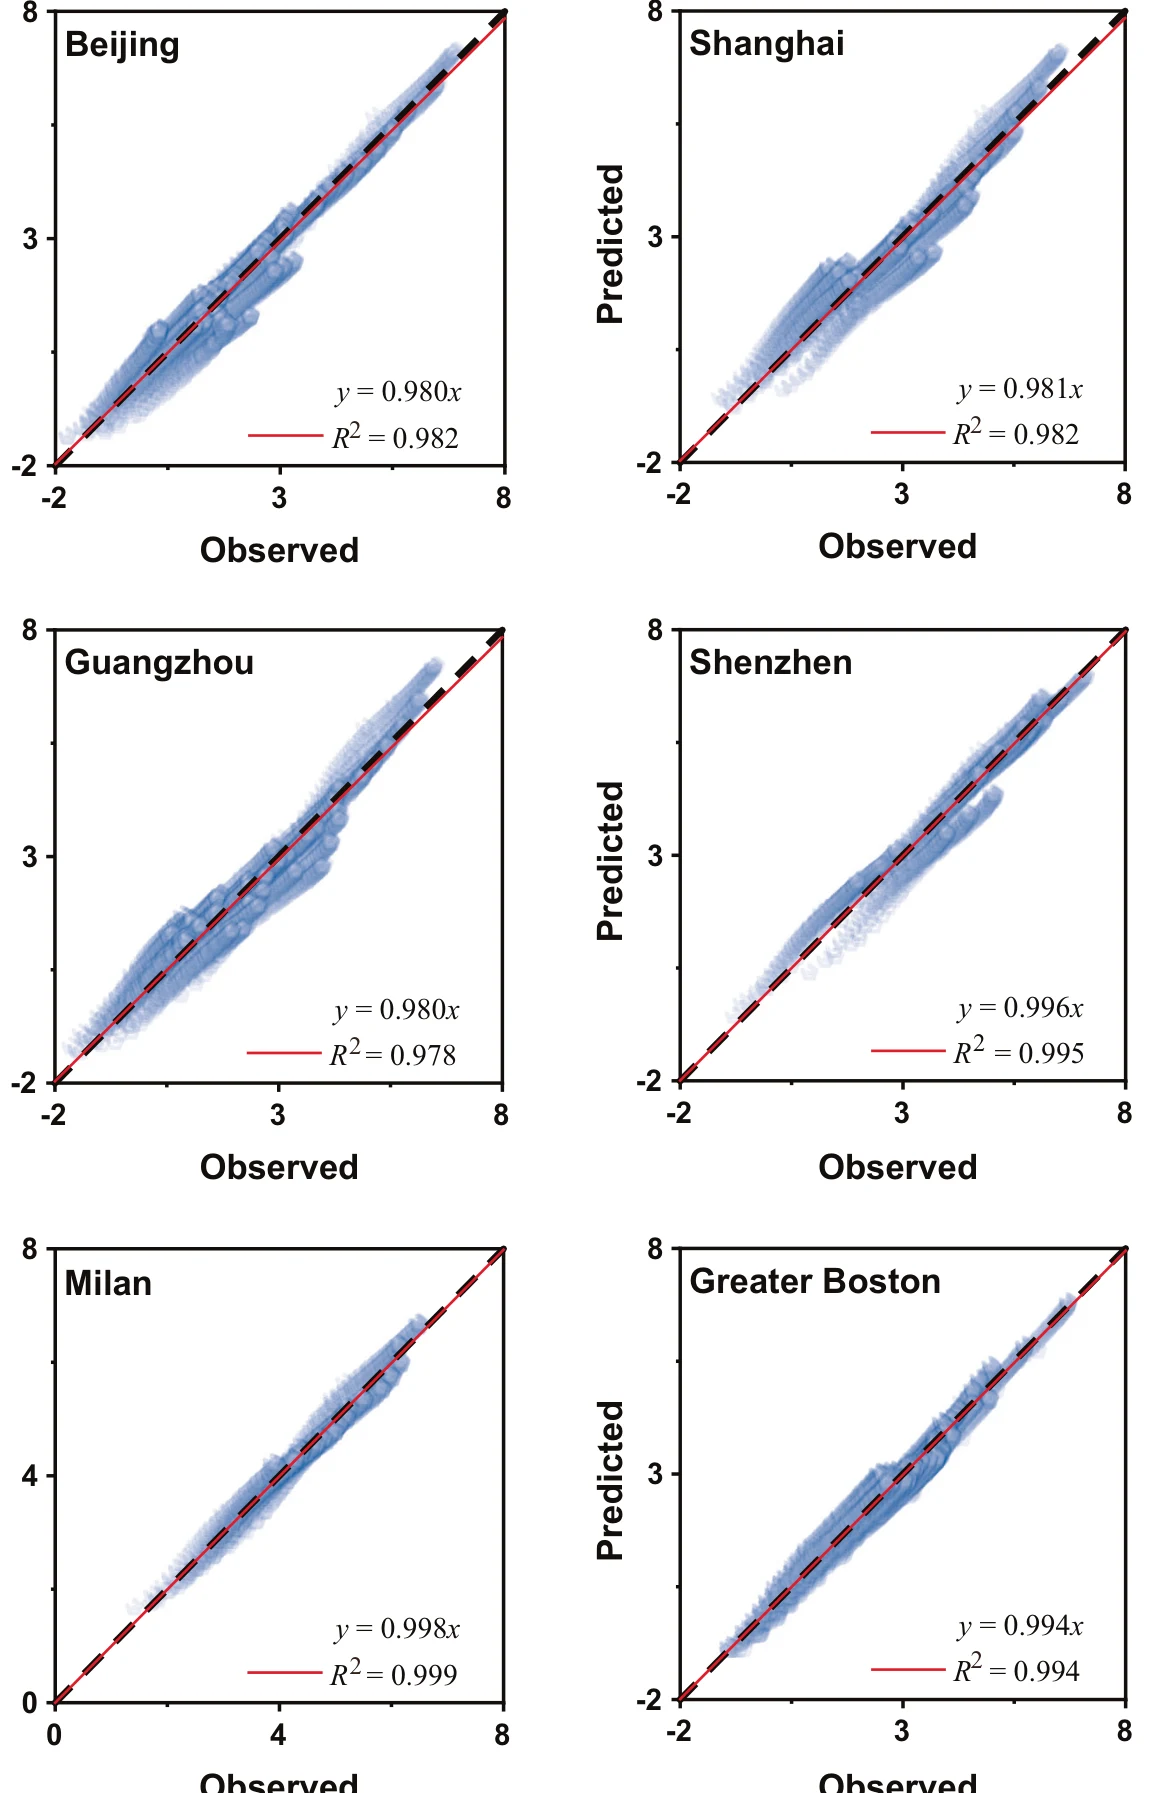
图 6|用估计出的参数回放,对数起伏离观测有多近?
六个面板没有子图字母,排列与图5相同。横轴是观测到的 ln F(s, r),纵轴是模型给出的值。黑色虚线是 y=x,红色实线是图中印出的比例式。北京 y=0.980x、R²=0.982;上海 y=0.981x、R²=0.982;广州 y=0.980x、R²=0.978;深圳 y=0.996x、R²=0.995;米兰 y=0.998x、R²=0.999;大波士顿 y=0.994x、R²=0.994。米兰的坐标从 0 起画,其余五城从 −2 画到 8。来源:原论文 Fig. 6。
斜率越接近 1,回放的对数起伏越接近观测。六城都在 0.980 以上,最松的是广州,R²=0.978;最紧的是米兰,斜率 0.998、R²=0.999。深圳的回放使用表3里按 25.5 公里分开的两套参数,斜率 0.996、R²=0.995。图6是这六个案例上的再现。主文另外把四个未参与参数估计的情形放进补充材料,正文没有印出那一项的精度。
密度更高,起伏就按比例更大吗?
到这里,幂律仍然只描述起伏自己。论文接着问,它是否跟城市密度的径向结构接得上。人口密度和 POI 密度都可以写成随距离衰减的曲线。Clark 的负指数模型带有一个特征半径;Smeed 的逆幂模型写成 ρ(r) = ρ₁ r^β,β < 0,没有把某一个公里数当成特征尺度。论文沿用 Batty 与 Kim 的论点,认为从可开发空间看,逆幂更合适,同时也写明两种模型的选择仍有争议。
若密度服从逆幂,而起伏又服从 F(s, r) ∝ r^d(s),两式通过同一个 r 相连,就得到:
F(s, r) ∝ ρ(r)^A(s)
A(s) = d(s) / β = (−b ln s + d₁) / β
A(s) 是异速指数(allometric exponent):在时间窗 s 上,密度变化一个比例时,起伏按哪个比例跟着变化。d(s) 与 β 都是负数,所以 A(s) 为正,密度更高的环带对应更大的 F。这是两条幂律拼出来的关系。它成立的前提,是密度确实接近逆幂,并且空间标度本身成立。
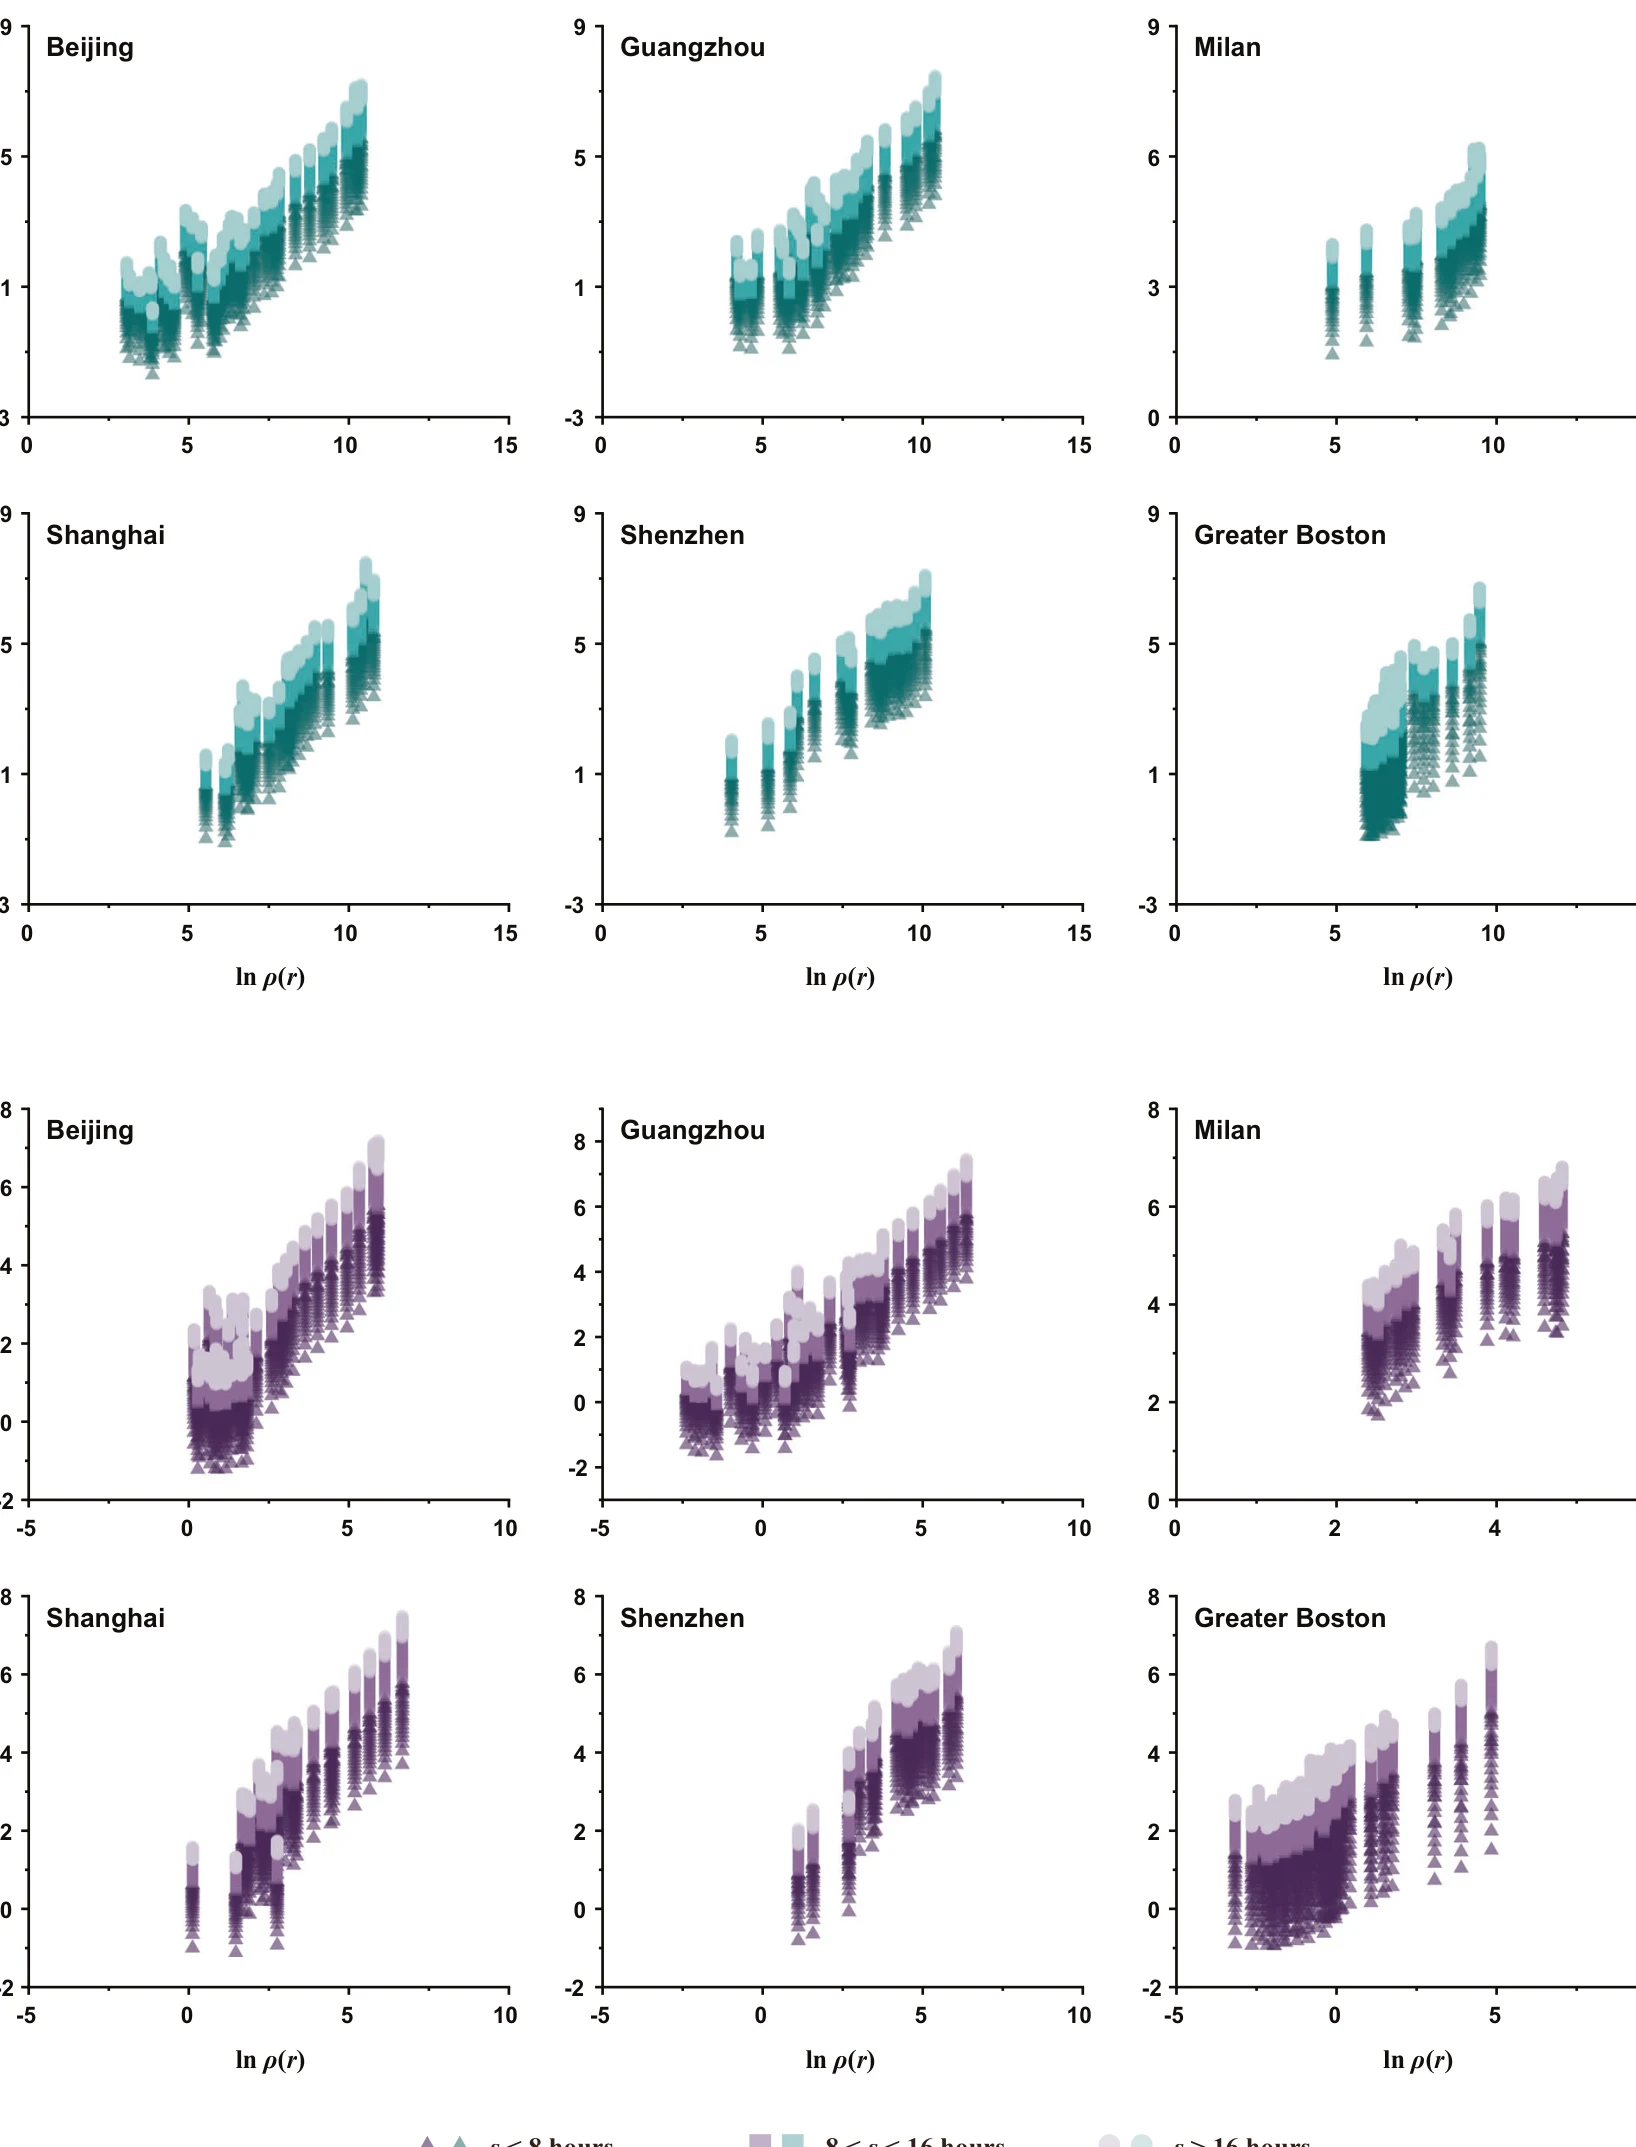
图 7|平均起伏与两种城市密度,在双对数图上是否成直线?
(a)横轴是人口密度的对数 ln ρ(r),纵轴是 ln F(s, r)。人口来自 WorldPop。六城的点总体向右上倾斜,颜色区分时间窗。(b)横轴改为 POI 密度的对数。四座中国城市的 POI 来自高德,米兰和大波士顿来自 OpenStreetMap。图例中的三角、方块和圆分别对应短于 8 小时、8 小时到 16 小时、长于 16 小时。各城斜率的具体数值在补充表中,图内没有逐城印出。来源:原论文 Fig. 7。
主文给出的比较是:相对人口密度,起伏与 POI 密度的异速关系更好,六个案例的平均拟合优度高于 0.87。四座中国城市里,两种密度的异速关系更一致。米兰和波士顿市中心附近的人口密度空间变化较小,偏离逆幂,因此人口密度这条异速关系会偏开。深圳的两种密度也都呈现出两段标度,与图3里起伏的折点相呼应。作者还用另外四套观测检查测量方案,主文的结论是关系仍近似成直线;各套方案的系数没有印在正文。
异速指数还会随时间窗变化,主文称它具有正的对数时间梯度。由此可以得到一个门槛例子:四个中国城市的人口密度大约在每平方公里 5000 人附近时,充分的人口和可到达的城市功能对应非平稳、超线性的起伏,也就是 α(r) > 1 的 fBm;密度或功能不足时,出行需求较低,对应 α(r) < 1 的 fGn。5000 的分母是每平方公里人数,范围是正文所举的四个中国城市,不是六城共用的一条截断值。
这条规律目前能说到哪一步
三套数据的用户覆盖、采集方式和年份都不同。主文把规律在这些差异之下仍然出现,当作采样偏差影响有限的证据。设备数据缺少可直接对照的地面真值,跨来源一致提供的是稳健性,尚未取消偏差。
样本是 10 个工作日、720 个时点。周末、公共假期,以及按月或按年的城际迁移,都不在这条日尺度规律里。环带把同一半径上的各个方向合在一起,所以图4里沿交通廊道伸出的高值斑块,到了图3会进入同一个距离。深圳以外的多中心,在统计上仍被放到一个主中心周围。
图6的斜率接近 1,说明对数模型能够重现用于估计的六个案例。它不能单独证明密度造成了起伏,也不能把斜率当成下一周或其他城市的预测误差。高 αᵢ 与功能区的对应,建立在规划图和活动热点的空间吻合上;通勤、混合用地和外围产业为什么造成这种指数,仍是作者给出的机制解释。
讨论还把这套时空谱接到设施选址、蔓延评估、疫情重点区域和交通设施需求。这些是作者提出的用途。论文没有在这六个样本里报告一项相应的政策试验。
一句话总结
在这六个工作日样本里,去趋势后的人数起伏随时间窗按幂变大,随离最近主中心的距离按幂变小;指数沿对数梯度变化,并与城市密度连成异速关系。它刻画的是网格和环带上的统计尺度,直接适用范围就是文中的 20 分钟序列、规划中心和这 10 个工作日。
核心来源
- Nature Communications 正式论文,核对题目、作者、卷期、收稿与接收日期。正文图1–7与表1–3都来自这一版本。
- 作者的数据处理、加权 DFA 与起伏预测代码。
- 米兰记录来自 Barlacchi 等整理的开放数据,DOI:10.1038/sdata.2015.55。人口密度来自 WorldPop。中国城市 POI 来自高德地图,米兰与大波士顿 POI 来自 OpenStreetMap。腾讯与 SafeGraph 的原始数据因许可和隐私未公开;作者整理后的地理时间序列若要有限共享,仍需数据提供方许可。
作者介绍
以下只采用论文署名、机构和作者贡献说明。七位作者都参与了分析。
- Xingye Tan:香港大学地理系。与 Bo Huang 同等贡献;与 Huang 共同构思并设计研究,与 Li 整理数据,与 Huang 建立模型,并与 Huang 撰写论文。
- Bo Huang:通讯作者。署名香港大学地理系、社会科学学院计算社会科学实验室、城市系统研究所,以及城市规划与设计系。与 Tan 同等贡献,共同设计研究、建立模型并撰写论文。
- Michael Batty:伦敦大学学院巴特利特高级空间分析中心。参与解释结果,并对文稿提出意见。
- Weiyu Li:苏州科技大学数理学院。与 Tan 整理数据,参与解释结果并对文稿提出意见。
- Qi Ryan Wang:美国东北大学土木与环境工程系。参与解释结果并对文稿提出意见。
- Yulun Zhou:香港大学城市规划与设计系。参与解释结果并对文稿提出意见。
- Peng Gong:香港大学地理系与城市系统研究所。参与解释结果并对文稿提出意见。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
环带规律和网格地图回答的不是同一个选址问题。若只使用随半径下降的平均起伏,新的公共服务会被放到“某一公里的圈子”上;图4却显示高指数沿廊道和节点成团。把环带预测与分方向的指数并排之后,才能看出一条地铁或一条产业带是否被同心平均藏了起来。论文已经同时给出这两种图,还没有报告这种方向拆分会让设施落点移动多少。
每平方公里 5000 人这个例子也还不能直接当成城区边界。设备记录把居住、通勤和过路混在同一个 20 分钟计数里,交通枢纽可以在人口密度并不高时得到很大的 F。若把夜间长期停留的设备与只在高峰出现的设备分开,α(r) 跨过 1 的密度门槛可能会移动。这需要论文没有做的停留时长划分。
同一个 b 把时间和距离绑在一起,意味着主中心一旦改变,整条梯度都要重估。新城区、新的轨道枢纽或总体规划改写中心之后,旧的 α₁ 与 b 是否还适用,十个工作日无法回答。一组跨越中心迁移的前后观测,才能区分对数梯度是城市的稳定属性,还是某一版规划中心下的快照。