上一站只知道一个粗类别,下一站能从整座城市的地点里排出来吗?
论文名片|Huandong Wang、Qiaohong Yu、Yu Liu、Depeng Jin、Yong Li,Spatio-Temporal Urban Knowledge Graph Enabled Mobility Prediction,Proc. ACM Interact. Mob. Wearable Ubiquitous Technol.,2021,5(4),Article 184(2021年12月),24页。DOI:10.1145/3494993。本文依据这一正式版解读。方法论文:把下一兴趣点预测写成时空城市知识图谱上的事实补全,再在三套数据上比较排序命中率。
工作日早上,一个人刚离开地铁站。城市里同时有餐馆、写字楼、医院和公园。要回答的问题是:在这一整张地点名单里,下一处会排到第几名。感觉某人出行很有规律,和把上万个地点逐个打分,是两种不同的比较。
Wang 等人把后一种比较写成图谱补全。用户、时间片、兴趣点和兴趣点类别都是实体。到访写成“某用户在某时间片到过某地点”,类别写成“某地点属于某一类”。预测时,给目标时间上的每条候选到访打一个合理程度分数,分数最高的地点作为预测。
在三套已经见过的用户的后段记录上,这种打分比五种深度序列模型更常把真实地点排到前面。轨迹更密的北京,前一名的抬升更大;只有细类、签到更稀的纽约 Foursquare,前一名仍然低很多。地点类别有帮助,较粗的城市功能比切得很细的类别更有用。读数是排序命中率。类别与更高命中率一同出现;要证明人因为类别才移动,还需要别的实验设计。
先说结论
- 主模型的用户平均前一名命中率 Acc@1,北京为 53.09%,上海为 42.91%,Foursquare 为 17.71%。五组对照里最强的 ARNN 分别是 44.18%、37.87% 和 12.59%。摘要中的 5.04% 等于上海这一对的百分点差:42.91% − 37.87%。
- 排名的候选集是该数据集的全部兴趣点。北京 12,597 个,上海 22,627 个,Foursquare 38,333 个。表中的百分数先在每名用户内部计算,再对用户取平均。
- 在有三级类别的北京和上海,类别沿两条路进入模型:训练时的地点—类别归属,以及预测时上一站的类别提示。摘要中的 3.85% 与表 8 的一格相同,即上海 Acc@1 从 39.06% 到 42.91%。两条路一起用时,比只用其中一条再高出的部分更小。Foursquare 只有细类,不能套用这三级结构。
- 嵌入维度里有一半随时间片变化时,北京的曲线处在高位。把时间片从 2 小时改到 30 分钟,北京 Acc@1 从 52.22% 升到 53.09%,只多 0.87 个百分点。
- 历史到访次数更高的地点,四项排序指标都更高。总计算时间低于五个对照。相对北京 LSTM 的 11,503 秒,本文模型的 6,542 秒少 43.13%。相对用时较少的对照 ROI(北京 9,000 秒),只少 27.31%。
一次到访,在这三套数据里是什么?
兴趣点(point of interest,PoI)是带有城市功能的地点,例如餐馆或写字楼。一条移动记录是三元组:用户或设备、时间、当时所在的兴趣点。一天先切成 48 个半小时,再把工作日和非工作日分开,一共 96 个时间片。后文的下一站,指这条记录里的下一个兴趣点。
三套数据的采集方式不同。纽约 Foursquare 是公开签到,时间从 2012 年 4 月 12 日到 2013 年 2 月 16 日,表 3 记为 11 个月,类别只有 251 个细类。北京和上海来自微信位置服务:用户在签到、共享位置等操作中留下 GPS,坐标落在兴趣点覆盖范围内时,再映射成兴趣点。北京覆盖 2016 年 9 月 17 日至 10 月 31 日全市城区,表 3 记为 45 天;上海为 2018 年 8 月 17 日至 11 月 8 日,表 3 记为 82 天。后两套数据记录的是位置服务被调用、且坐标落在兴趣点范围内的地点。
记录少于 30 条、到访地点少于 5 处的用户被去掉。北京、上海和 Foursquare 分别去掉原始用户的 15%、13% 和 5%。论文说明,记录少的用户很少外出、规律很强,预测会容易得异常高,并影响训练。表 3 紧接在这段筛选之后,给出的是实验使用的规模;原文没有再给筛选前的总人数。
| 数据 | 用户 | 兴趣点 | 记录 | 细类 / 中类 / 粗类 | 时长 |
|---|---|---|---|---|---|
| 北京 | 3,083 | 12,597 | 650,578 | 204 / 49 / 14 | 45 天 |
| 上海 | 926 | 22,627 | 114,811 | 281 / 55 / 14 | 82 天 |
| Foursquare | 1,083 | 38,333 | 227,428 | 251 / — / — | 11 个月 |
按表 3 相除,三套数据平均每名用户约 211、124 和 210 条记录。再除以兴趣点数,北京约 51.6 条/兴趣点,上海约 5.1 条,Foursquare 约 5.9 条。北京再除以表中的 45 天,约每人每天 4.7 条;上海除以 82 天,约 1.5 条。Foursquare 的条数接近北京,却摊在 11 个月的签到上,而且每名用户面对的地点名单长得多。
每名用户的记录按时间排序,前 70% 训练,中间 10% 验证,最后 20% 测试。测试集是同一批用户更晚的记录,训练阶段已经见过这些人更早的到访。最终指标先在每名用户内部计算,再对用户取平均,所以记录很长的用户不会自动占更大权重。
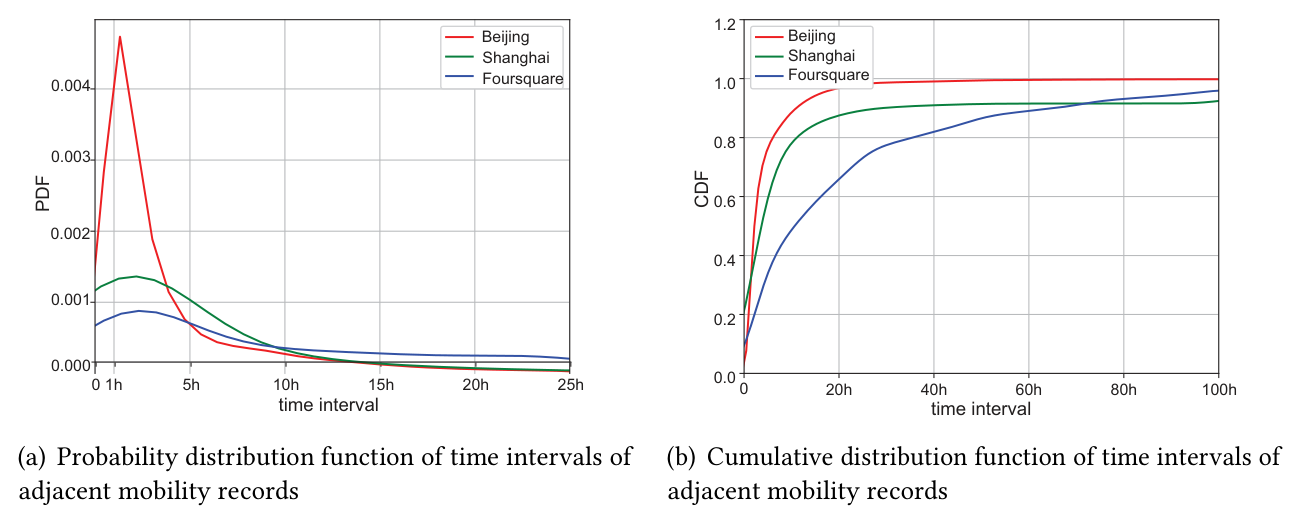
图 3|三套数据相邻两次记录,间隔有多密?
(a)间隔的概率密度,横轴到 25 小时,纵轴为密度。红、绿、蓝分别为北京、上海和 Foursquare。北京在约 1 小时处有尖峰,另外两条更平。(b)同一间隔的累积分布,横轴到 100 小时,纵轴画到 1.2。北京上升最快,上海次之,Foursquare 在 100 小时处仍留有间隙。正文写道,北京有 70% 的相邻间隔短于 4 小时,三套数据都呈长尾。来源:原论文 Fig. 3。
下一站怎样变成图谱里的一条事实?
时空城市知识图谱(spatio-temporal urban knowledge graph,STKG)里有两类关系。时空移动模式关系表示用户在某时间片到过某兴趣点,并可以附上辅助信息。归属关系表示兴趣点属于细类、中类或粗类。类别和类别之间还有一层上下位关系,论文把它放在主图谱之外,后面单独检验。
辅助信息有五种。空辅助什么都不加;其余四种分别使用上一处兴趣点,或该地点的细类、中类、粗类。表 8 最后一行与表 5 里北京、上海的本文模型数字相同:上一站用粗类,训练图包含全部三级归属。Foursquare 只有细类,表 6 的 17.71% 是在这一限制下得到的。
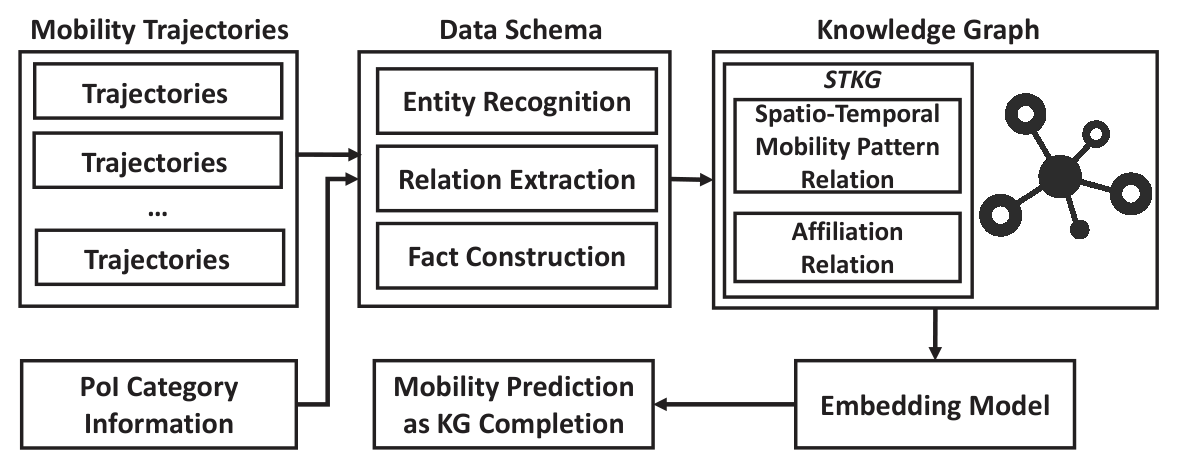
图 1|轨迹和类别怎样进入同一张图?
无字母子图。左侧轨迹与兴趣点类别进入中间的数据模式,抽出实体、关系和事实,建成含移动模式关系与归属关系的 STKG;嵌入模型给事实打分,再把移动预测当作图谱补全。来源:原论文 Fig. 1。
每个实体和关系放进 100 维复数向量。一条到访事实的分数,是用户、关系、地点在各维上乘积之和的实部。关系向量里,比例 α 的维度先乘上时间片,其余维度不乘;然后再乘辅助信息。α 的默认值是 0.5,也就是一半维度显式随时间变化。作者用通勤者强烈依赖钟点、出租车司机可能更依赖上一站来解释这个设计。实验数据没有通勤者或司机标签,这个对照停留在设计动机。
归属关系用另一条同类分数,损失按类别的交叉熵计算。移动关系的训练损失用负采样近似全部地点上的交叉熵。总损失是移动损失加上 β 倍的三级归属损失。β 在北京、上海、Foursquare 分别取 20、5、10。三座城市的命中率差异里,同时含有数据疏密和这个权重。
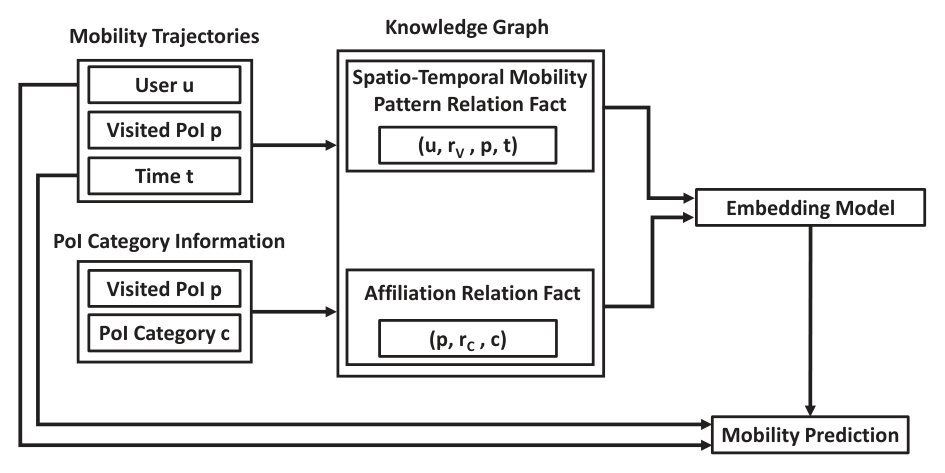
图 2|一条到访事实和一条归属事实各长什么样?
无字母子图。轨迹抽出用户、地点和时间,写成 (u, r_V, p, t);类别信息写成 (p, r_C, c)。两类事实一起进入嵌入模型,预测阶段再回到候选地点。来源:原论文 Fig. 2。
预测时,对一名用户的目标时间片,给数据集中每一个兴趣点算分数,取得分最高者;也可以保留前 k 名。Acc@k 是一名用户的测试记录里,真实地点排进前 k 名的比例。平均倒数排名(mean reciprocal rank,MRR)是这些记录上 1/排名 的平均。两者都在 0 到 1 之间,再对用户取平均。Acc@10 衡量真实地点是否进入短名单,Acc@1 衡量真实地点是否排在第一名。
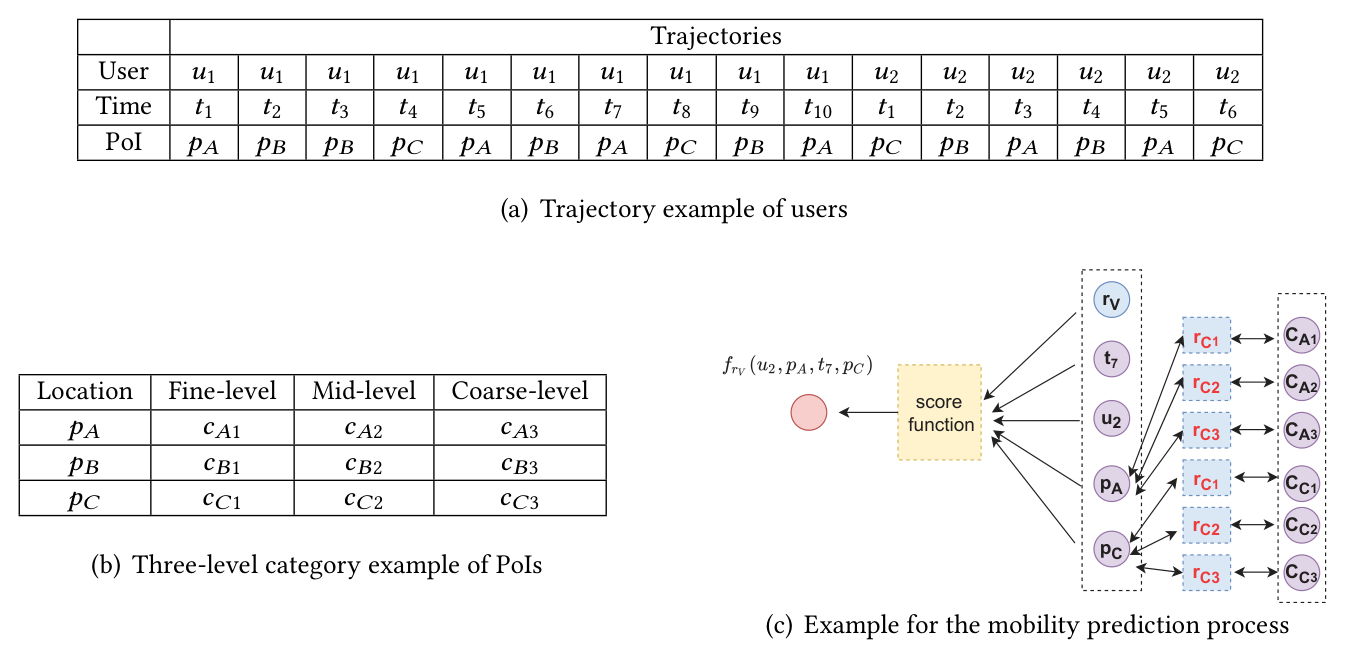
图 4|用三个假想地点,打分时要连上哪些关系?
(a)格式示意:用户 u1 有 10 条记录,u2 有 6 条,地点只使用 pA、pB、pC。(b)每个地点各有细、中、粗三级类别。(c)要给 u2 在 t7 是否到过 pA 打分时,分数同时看到用户、时间、地点,以及这些地点和三级类别之间的归属。来源:原论文 Fig. 4。
同样的后 20% 记录,前一名差多少?
对照有五个。DeepMove 用论文给出的公开代码,学习率 0.0005,并选用序列注意力和平均采样。LSTM 的学习率和 dropout 设为 0.001 与 0.5。ROI 把原文的兴趣区域当作这里的兴趣点。APHMP 去掉了去中心化学习模块。ARNN 也使用兴趣点类别建图,再把嵌入送进带注意力的 LSTM。除 DeepMove 外,其余对照由作者重新实现,超参数也与原论文有差别。因此,下面的差距同时包含任务设定、模型结构和实现细节。
隐马尔可夫等概率模型留在了这张表之外。作者依据已有文献认为深度序列模型更强,比较就停在这五个对照上。摘要的 5.04% 也停在这五个对照上。
| 模型 | 北京 Acc@1 | 北京 MRR | 上海 Acc@1 | 上海 MRR | Foursquare Acc@1 | Foursquare MRR |
|---|---|---|---|---|---|---|
| LSTM | 38.17% | 44.96% | 34.01% | 40.66% | 8.20% | 12.33% |
| ROI | 35.25% | 41.10% | 32.12% | 38.47% | 6.69% | 10.35% |
| APHMP | 40.46% | 48.14% | 35.03% | 43.18% | 8.29% | 12.88% |
| DeepMove | 41.04% | 48.61% | 35.74% | 44.51% | 10.13% | 14.73% |
| ARNN | 44.18% | 53.19% | 37.87% | 46.92% | 12.59% | 17.21% |
| 本文 | 53.09% | 63.66% | 42.91% | 52.75% | 17.71% | 24.34% |
ARNN 在三套数据上都是对照里的前一名。北京 Acc@1 的差是 53.09% − 44.18% = 8.91 个百分点,论文在正文里单独写出了这个 8.91%。上海的差是 5.04 个百分点,Foursquare 是 17.71% − 12.59% = 5.12 个百分点。若改用相对增幅,分母分别是 ARNN 的 44.18%、37.87% 和 12.59%,约为 20.2%、13.3% 和 40.7%。摘要选用的是最小的那一个绝对差。
前 10 名同样按用户平均。本文模型的 Acc@10 在北京、上海、Foursquare 为 79.97%、69.62%、37.22%,ARNN 为 68.47%、60.48%、26.43%。北京的用户平均 Acc@10 为 79.97%,Acc@1 为 53.09%。Foursquare 的 Acc@10 为 37.22%,候选名单有 38,333 个地点,而且没有中类和粗类归属。
北京高于上海,上海高于 Foursquare。这与每人每天的记录数,以及 Foursquare 缺少中类和粗类相一致。按兴趣点平均,上海约 5.1 条,Foursquare 约 5.9 条,每地点记录数并不跟着同一顺序。β、地点总数和签到定义也各自不同。把这个顺序读成“北京居民更容易被预测”,已经超出表中的比较。
类别是背景知识,还是上一站的提示?
表 8 把两件事分开。一种是预测时附带的上一站信息,从空辅助到粗类。另一种是训练图里有没有地点与三级类别的归属关系。主模型是粗类辅助加上全部归属,北京 Acc@1 为 53.09%,上海为 42.91%。
只看移动关系、辅助为空时,北京 Acc@1 是 49.85%,上海是 36.57%。只把上一站换成粗类、仍不加归属图,北京升到 52.56%,上海升到 41.41%,分别多 2.71 和 4.84 个百分点。只加归属图、辅助仍为空,北京到 52.59%,上海到 41.78%,多 2.74 和 5.21 个百分点。两者一起使用时,北京比“只有归属图”再多 0.50 个百分点,上海再多 1.13 个百分点。两类类别信息都会抬高命中率,叠在一起的新增部分明显更小。
摘要的 3.85% 可以在表 8 里对准一格:上海 Acc@1 从“上一站是具体地点、图中只有移动关系”的 39.06%,到主模型的 42.91%。北京的对应差是 53.09% − 50.81% = 2.28 个百分点。3.85 是上海这一对的差。
论文还报告,在只有移动关系的北京图上,最近地点相对空辅助使 MRR 从 60.09% 到 61.15%,多 1.06 个百分点;上海从 48.15% 到 51.04%,多 2.89 个百分点。同一张北京图上,粗类相对最近地点的 MRR 多 2.14 个百分点,63.29% − 61.15%。这些比较的分母都是表 8 的 MRR,而且只针对写明的那一张图。
个别指标的方向相反。北京在只有移动关系时,空辅助的 Acc@5 是 74.67%,换成最近地点后是 74.55%。全部归属加上中类辅助时,北京 Acc@1 为 53.11%,比主表采用的粗类方案 53.09% 高 0.02 个百分点。
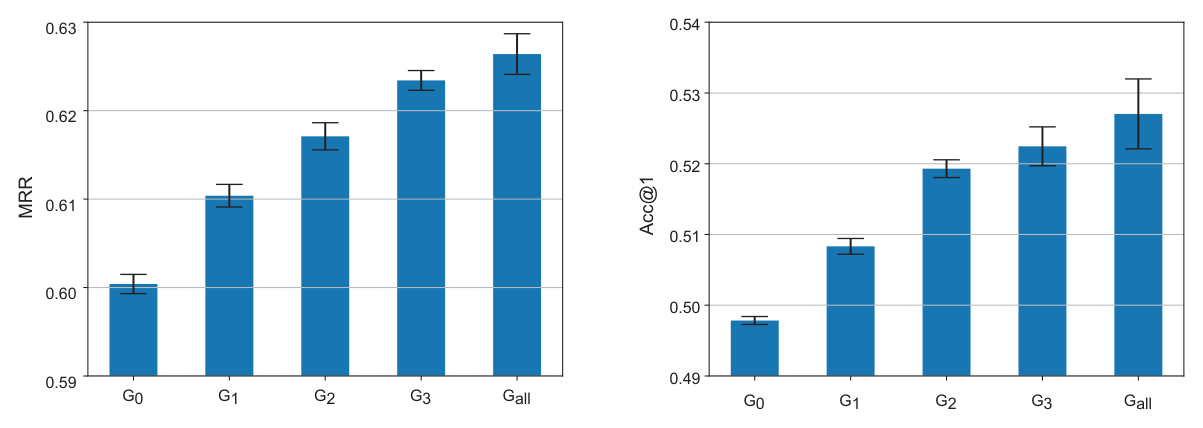
图 6|北京逐级加入类别归属后,排序有没有升高?
无面板字母。左图 MRR,纵轴 0.59 到 0.63;右图 Acc@1,纵轴 0.49 到 0.54。G0 只用移动关系图,G1、G2、G3 分别再并入细类、中类、粗类归属,Gall 并入全部三级。柱子从左到右升高,粗类高于细类;误差线较长,相邻柱有重叠。正文没有写明误差线的定义。来源:原论文 Fig. 6。
图 6 与正文的解释一致:细类噪声更多,粗类更有用。表 4 列出北京 14 个粗类及部分中类例子,例如餐饮下面有中餐、西餐和甜品。居住这一粗类的例子同时包括办公楼和住宅区。粗类更好,可能来自功能被合并后的稳定性,也可能来自这套分类本身把不同活动放进了同一格。
再把类别和类别之间的上下位关系加进去,Acc@1 与 MRR 略升,Acc@5 略降。北京 Acc@1 从 53.09% 到 53.19%,MRR 从 63.66% 到 63.72%,Acc@5 从 76.75% 到 76.73%。上海 Acc@1 从 42.91% 到 43.12%,MRR 从 52.75% 到 52.97%,Acc@5 从 66.10% 到 66.07%。论文因此仍以到访关系和地点—类别归属为主。用户属性和社交关系留在后续工作里。
时间片和 α 改变的是哪一种规律?
α 从 0 到 1,表示有多大部分维度必须乘上时间片。α = 0 时,关系向量不随时间片改写。图 7 左列是北京,右列是上海,都没有面板字母。
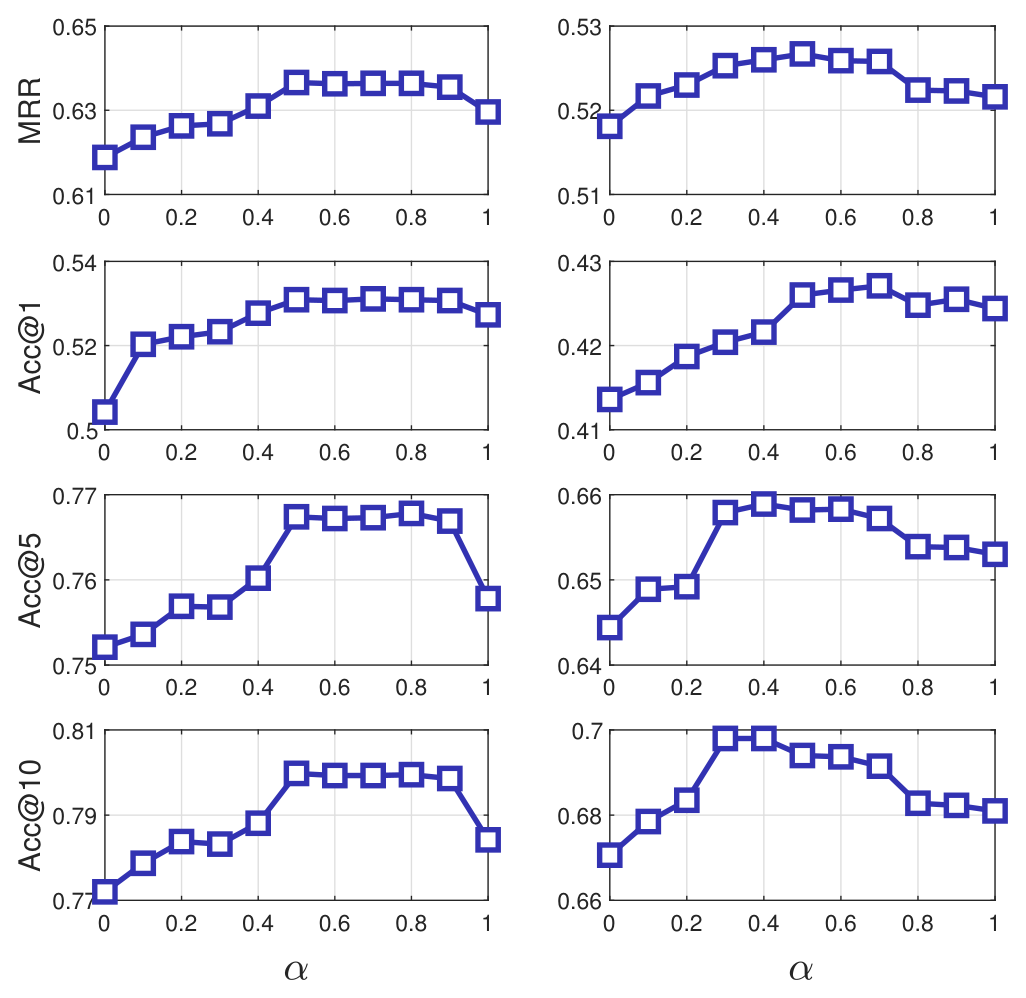
图 7|时间调制的维度占比,从完全不用到全部使用,曲线往哪里走?
无面板字母。左列北京,右列上海;自上而下为 MRR、Acc@1、Acc@5、Acc@10,横轴都是 α。北京在 α = 0 处较低,随后上升,正文写大约在 0.5 附近达到高点,再到 1 时回落。上海同样先升后降,高点位于中段。默认实验取 α = 0.5,与表 5 的主结果同一设置。来源:原论文 Fig. 7。
时间片本身也可以变粗。仍区分工作日和非工作日时,2 小时、1 小时、30 分钟分别得到 24、48、96 个时间片。北京 Acc@1 依次为 52.22%、52.81%、53.09%,MRR 为 62.88%、63.38%、63.66%。从最粗到最细,Acc@1 多 0.87 个百分点,MRR 多 0.78 个百分点。半小时最好,优势很小。更细的时间没有在正文里继续比较。
地点被访问得越勤,排序越靠前吗?
图 8 把北京的兴趣点按历史被访问次数分组。论文举例,30 到 60 这一档,是历史记录中被访问 30 到 60 次的那些地点的平均预测表现。横轴从 0–30 直到 240–270,共九档。
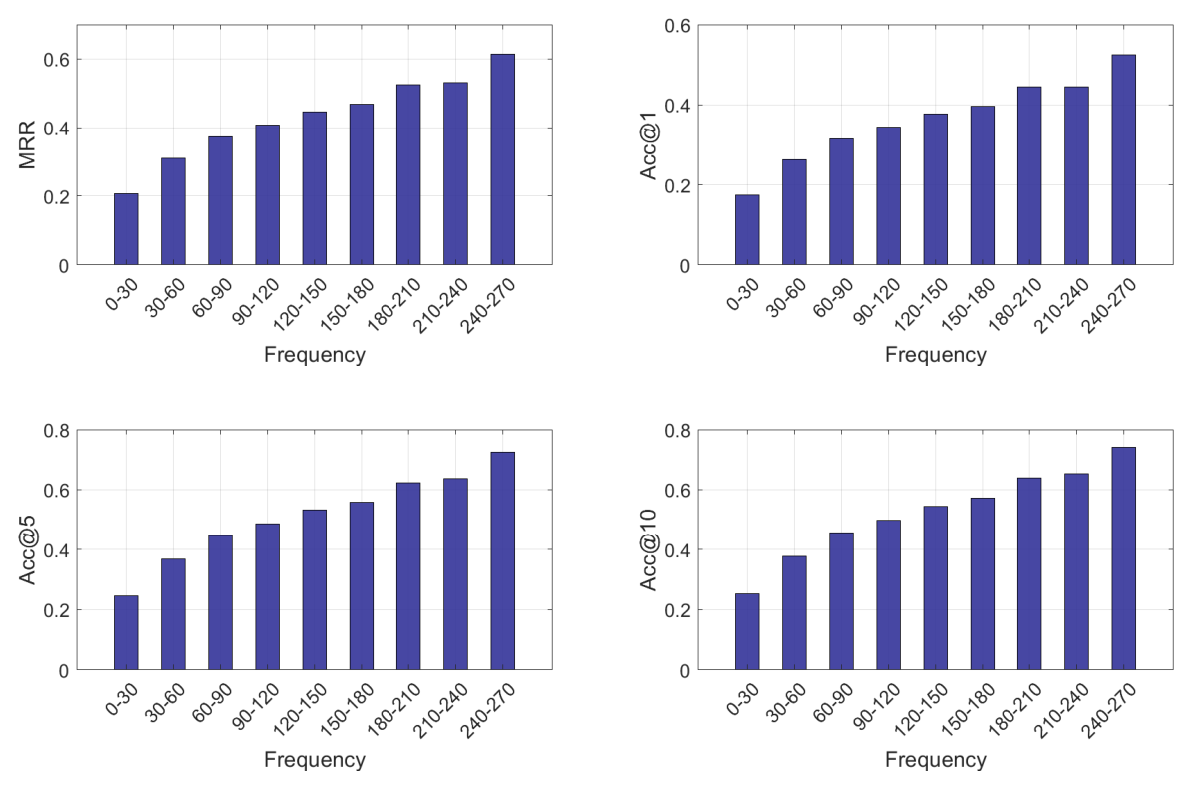
图 8|北京哪些地点更容易被排到前面?
无面板字母。左上 MRR,右上 Acc@1,左下 Acc@5,右下 Acc@10。横轴都是地点的历史访问次数,纵轴为该项指标。九档从低频到高频整体升高,240–270 一档最高。正文据此认为,同一地点被访问得越频繁,预测越容易。来源:原论文 Fig. 8。
这张图的分析单位是按访问次数分组的地点。0–30 一档低于 240–270 一档。城市尺度的 53.09% 是各组混在一起之后、再按用户平均的结果。
计算时间少在哪一段?
训练和测试的计时实验在一台 48 核、2.20 GHz 的 Linux 服务器上完成,机器有 8 块 Titan Xp。图 5 只画北京。
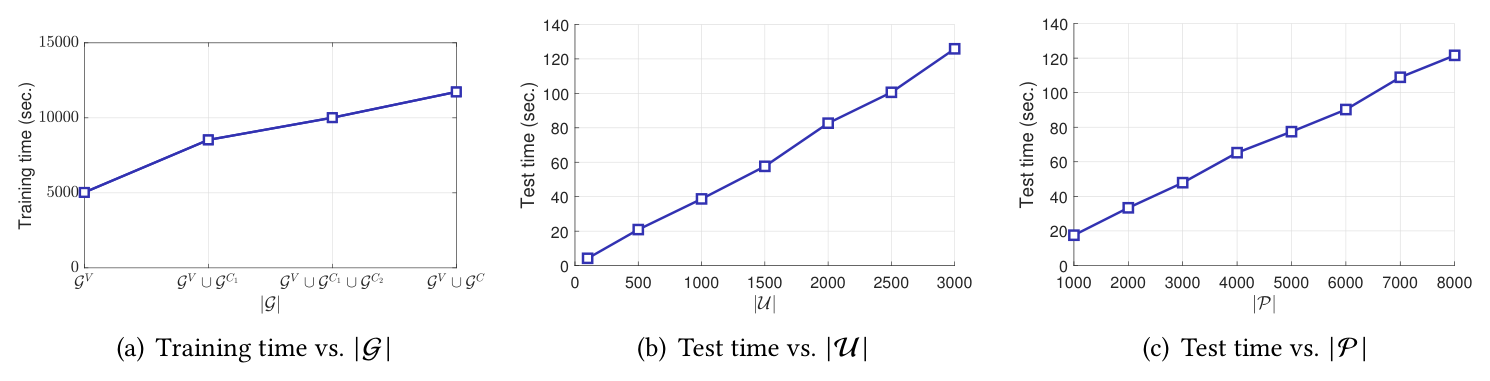
图 5|北京的训练和测试时间,随着图、用户和地点怎样增加?
(a)训练时间,纵轴刻度到 15,000 秒。横轴从左到右是:只有移动关系;并入细类归属;再并入中类归属;再并入全部类别归属。曲线上升。正文说这与训练复杂度随事实数增长一致。(b)测试时间对用户数,横轴到 3,000 人,纵轴到 140 秒,近似一条上升直线。(c)测试时间对兴趣点数,横轴从 1,000 到 8,000,纵轴同样到 140 秒,也近似直线。横轴停在 8,000,北京全部兴趣点是 12,597 个。来源:原论文 Fig. 5。
表 7 给出三套数据上各方法的总计算时间,单位为秒。它统计的是完整实验,和图 5 的缩放曲线分开阅读。
| 模型 | 北京 | 上海 | Foursquare |
|---|---|---|---|
| LSTM | 11,503 | 2,464 | 9,784 |
| ROI | 9,000 | 2,062 | 9,628 |
| APHMP | 12,946 | 3,041 | 11,601 |
| DeepMove | 13,129 | 3,796 | 12,190 |
| ARNN | 13,921 | 5,219 | 13,049 |
| 本文 | 6,542 | 1,494 | 4,131 |
本文模型在三列都是最短的一格。北京相对 LSTM 少 4,961 秒,4,961 / 11,503 = 43.13%。摘要写的“超过 43.12%”与这一格最接近。上海相对 LSTM 少 970 / 2,464 = 39.37%。每套数据里用时最短的对照都是 ROI:北京相对它少 2,458 / 9,000 = 27.31%,上海少 568 / 2,062 = 27.55%,Foursquare 少 5,497 / 9,628 = 57.09%。43.13% 对应北京对 LSTM 这一格。
作者把注意力模型的耗时与历史轨迹长度的二次增长联系起来,而 LSTM、ROI 和本文模型按记录遍历。表 7 比较的是这台机器上三套完整实验的总时间。
命中率停在什么问题上?
这批比较回答的是:对已经出现过的用户,用其较早记录训练,较晚记录中的兴趣点会排到第几名。微信记录来自用户调用位置服务,Foursquare 来自主动签到。落在兴趣点覆盖范围以外的坐标如何处理,正文没有报告比例。
筛选去掉了记录少、地点少、规律很强的用户,表中的命中率属于留下的人。论文认为把这些用户加回来会抬高准确率,同时影响训练。正文没有给出筛选前后的对照表。
类别提升来自同一模型内部的替换,比跨模型的 8.91 个百分点更靠近“类别有没有用”。粗类与更高命中率一同出现,居住类同时容纳办公楼和住宅区,分类体系本身会进入这个相关。上下位关系使 Acc@1 和 MRR 略升,Acc@5 略降。图 6 的误差线没有定义,表 5 到表 10 也没有给出重复实验的波动。0.02 个百分点这类相邻差距,还停留在单次运行的表内差别。
时间以离散时间片进入模型。作者把连续时间的嵌入留作后续工作,也写明目前的背景知识主要是地图服务里容易得到的类别。社交关系、地点的更细属性和城市事件留在后续工作里。
用户编号经过匿名化,研究者受保密协议约束,数据使用得到提供方批准。文中的命中率,是这些匿名编号在兴趣点名单上的排序结果。
一句话总结
把到访和地点类别写成同一张时空城市图谱后,下一兴趣点的排序确实更靠前;粗类别和更密的记录贡献了大部分可见提升,而前一名命中率仍然随城市、签到方式和地点冷热程度明显变化。
核心来源
- ACM 正式版 DOI:10.1145/3494993。题目、作者、卷期和 2021 年 12 月出版信息以 PDF 首页与文末引用格式为准。正文 24 页,图 1 至图 8,表 1 至表 10。
- Foursquare 纽约签到来自论文引用的 Yang 等,2014。微信北京与上海数据在文中没有作为公开下载数据描述。
- DeepMove 对照使用论文脚注给出的代码:vonfeng/DeepMove。
作者介绍
五位作者都署名清华大学电子工程系、北京信息科学与技术国家研究中心(BNRist)。论文脚注写明前两位贡献相同。全文没有单独的贡献声明,以下只记录论文上的身份。
- Huandong Wang:共同第一作者,署名上述机构。
- Qiaohong Yu:共同第一作者,署名上述机构。
- Yu Liu:署名上述机构。
- Depeng Jin:署名上述机构。
- Yong Li:署名上述机构。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果服务面对的是没有历史的新用户,表 5 的 53.09% 还没有直接对应的实验。训练和测试来自同一批人,用户向量已经见过这个人较早的到访。新居民或短期访客没有这条向量。可以单独留出一批用户,训练时完全不出现他们的记录,再看 Acc@1 会落到多靠近“只靠时间片和上一站粗类”的那一格。表 8 里,上海在空辅助且只有移动关系时 Acc@1 为 36.57%。历史一变薄,前一名会先掉下来。
前一名和前十名面向的决策也不同。北京用户平均 Acc@1 为 53.09%,Acc@10 为 79.97%。按同一口径,前一名未命中的比例是 46.91%。要从 12,597 个地点里预留唯一资源,这 46.91% 会预留到别的地点;若决策只需要十个地点的短名单,同一模型覆盖的用户平均比例是 79.97%。图 8 把这个差别推到冷门地点:0–30 次到访的那一档低于 240–270 次。医院、新办公室这类低频目的地,和高频地点可以分成两列目标。图 8 已经把这两列的高低分开了。
粗类优于细类,还绑在现有分类表上:居住下面同时有办公楼和住宅区。若把办公楼移回商务、住宅区留在居住,粗类优势可能缩小,也可能仍然存在。在重做这张表之前,粗类优势仍属于这一套类别,还不宜写成采集地点标签时的一般规则。