一座没有单车轨迹的新城,能不能借用别的城市的短距离出行?
论文名片|Tianfu He、Jie Bao、Ruiyuan Li、Sijie Ruan、Yanhua Li、Li Song、Hui He、Yu Zheng,What is the Human Mobility in a New City: Transfer Mobility Knowledge Across Cities,Proceedings of The Web Conference 2020(WWW ’20),2020年4月20–24日,台北,页码 1355–1365。DOI:10.1145/3366423.3380210。
雄安的路上已经有店铺、车站和新建居住区,共享单车却还没有攒下几个月的轨迹。自行车道铺在哪、小店开在哪,要看人从哪段路出发、到哪段路停下、中间挑哪几条路。把北京朝阳的骑行热力按坐标贴过去,街对不上,骑车的人也不是同一批。
这篇论文把问题收成一次知识迁移:有轨迹的城市提供“什么样的起终点环境会带出短距离出行,以及人们在起终点之间怎样挑路”;目标城市只交出兴趣点、公交站和路网。生成的是一批已经匹配到路段上的轨迹,用来接近真实轨迹在空间上的整体分布。比较的是一批行程的分布,不是认出某一位骑车人。
在北京朝阳、北京海淀、成都、合肥四块局部区域的摩拜数据上,迁移能缩小起讫点分布的差距,三座城市的选路偏好也相当接近。它覆盖的是大约三个月、6 公里以内的骑行空间分布。一天中的哪个小时、公交和出租那样的长距离出行,都不在这次实验里。雄安只有生成图和一次实地观察,没有轨迹可以逐条对照。
先说结论
- 短距离出行被分成三步:周围环境所代表的出行意图、据此挑选的起讫点、再在起讫点之间挑路。意图是潜空间里的向量,论文明确说它并不保证按购物、通勤这类明文目的聚成团。
- 以北京和合肥为源、成都为目标时,适配后三对城市的 n·MMD² 从 17.55、13.31、15.84 降到 1.41、3.94、4.49。分母是适配前的同一指标,相对降幅为 91.97%、70.4% 和 71.65%。这是特征分布的距离,而且画成都的点时用到了成都真实起讫点的环境特征。
- 真正不使用目标城市轨迹来生成起讫点时,结论把相对“不做适配”的 n·MMD² 下降概括为至少 75%。图 11 的柱没有逐根标数。从小城市迁到朝阳比其他方向更难。
- 北京、成都、合肥都有超过 70% 的骑行长度接近最短路。候选路径数 m=5、重叠阈值 0.7 时,正文写超过 90% 的轨迹能对上其中一条。用目标城市自己的轨迹再训练选路模型,KL 散度没有明显更好。
- 朝阳和合肥的生成热力与真实热力在图上相近,但没有配数值。雄安的街景只能说明生成热力与当天看到的人流大致同向,不能代替留出轨迹的误差。
直接把一座城市的骑行贴到另一座,错在哪一步?
共享单车在这里是摩拜的无桩车辆。车上有定位,一次行程从开锁到还车被记成一条轨迹,反映的是较短距离的移动。论文认为,相对出租、公交和地铁,这种短途轨迹更贴近自行车道、人行道、沿街店铺和电动车充电桩要服务的人。长距离通勤不是本文的对象。
同一座城市里用深度学习续写轨迹,或者把一座城市的自行车堆积热点迁到另一座城市,都解决不了“目标城市完全没有出行记录”。最接近的既有工作在新城生成异常出行时,仍使用这座城市平时的大规模轨迹。本文要的是:目标城市的轨迹一条都不用来训练。
行程被看成三步,而且这三步在不同城市都说得通。先出现一个意图,例如想去买东西;再选一个能满足它的终点,例如某个广场;最后在起点和终点之间挑一条路。图 2 是这三步的示意图,不是某一次真实出行的记录。
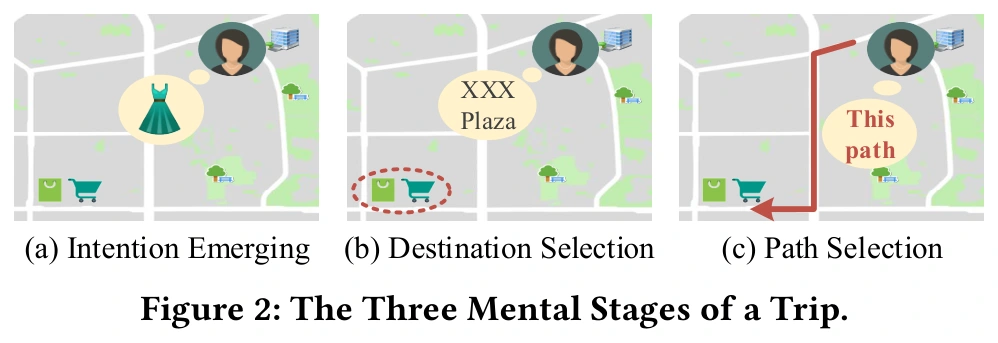
图 2|一次短途出行在概念上分成哪三步?
(a)意图出现,图中用购物的念头表示。(b)选择能满足该意图的目的地,圈出的是一处商场。(c)在起点和终点之间选定一条路。三幅都是示意,没有坐标和样本量。来源:原论文 Fig. 2。
难处有三处。城市的生活方式、公交供给不同,起终点环境的分布并不一样。路段两两搭配的起讫点数量又极大,很难用一个模型直接吐出全部起讫点。即使起讫点相同,人们仍会分走不同的路。
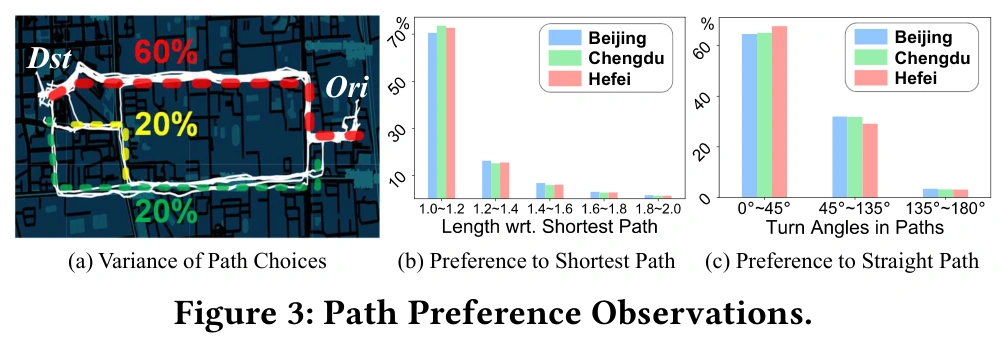
图 3|不同城市的人,选路时像不像?
(a)一对真实起终点上的示例:三条主路径在图中标为 60%、20% 和 20%。这是这一对起终点上的份额,不是三座城市的平均。(b)行程长度除以该起终点最短路长度。1.0–1.2 倍这一档在北京、成都、合肥都超过纵轴 70% 的刻度;更长的档迅速变矮。正文据此说,超过 70% 的骑行长度非常接近最短路。论文没有再列出每座城市的精确百分比。(c)路径转角分成 0°–45°、45°–135°、135°–180°。三座城市都是小转角那一档最高,接近 180° 的掉头很少,城市之间的高低形状相近。来源:原论文 Fig. 3。
所以可迁移的不是某一条轨迹的坐标,而是两件分布:起终点环境所对应的意图,以及“接近最短、少转弯”这种选路倾向。图 3 支持的是这三座城市的共享单车样本看起来相似,还不能写成所有城市、所有交通方式都如此。
每块大约 12 万条行程,是什么口径?
数据是摩拜在 2018 年 4 月 1 日至 7 月 1 日的一部分轨迹。原文写作 01/04/2018 至 01/07/2018,并说明是三个月;按日/月去读只有三天,与“三个月”不符,因此这里按月/日理解。全文数据因保密协议没有全部使用。表里的条数是抽出来的分析样本。四块区域都落在 123,188 到 128,733 条之间,说明分析时用了相近的样本量。
轨迹先匹配到路网,成为路段序列。起讫点是这条序列的第一段和最后一段路。评价起讫点分布时,又把它们写成起点、终点的纬度和经度四个数。路段序列和四个坐标是前后两种表示,计数单位是轨迹或起讫点。
| 研究区 | 面积 | 轨迹条数 | 路段数 | 兴趣点数 | 站点数 |
|---|---|---|---|---|---|
| 北京朝阳局部 | 18.8 km² | 128,546 | 3,180 | 26,030 | 1,905 |
| 北京海淀局部 | 16.1 km² | 123,188 | 3,252 | 23,751 | 1,323 |
| 成都局部 | 14.5 km² | 127,577 | 1,668 | 23,236 | 1,003 |
| 合肥局部 | 15.3 km² | 128,733 | 1,755 | 8,044 | 321 |
四块区域的面积都在 14.5 到 18.8 平方公里。论文称前两块为北京朝阳区和海淀区,但表中给出的是研究区面积,没有另给行政区总面积。朝阳研究区的路段数是成都研究区的 3180/1668 ≈ 1.91 倍。合肥 15.3 平方公里里有 8,044 个兴趣点、321 个站点,朝阳研究区 18.8 平方公里里有 26,030 个兴趣点和 1,905 个站点,分别是合肥的 26030/8044 ≈ 3.24 倍和 1905/321 ≈ 5.93 倍。面积接近,兴趣点和站点的数量差很多。后面看到“小城市迁到朝阳更难”时,两边的环境清单本来就不同。
多源数据是兴趣点、交通站点和路网,源城市和目标城市都有。轨迹只来自源城市。
系统迁的是分布,生成的是一批路段轨迹
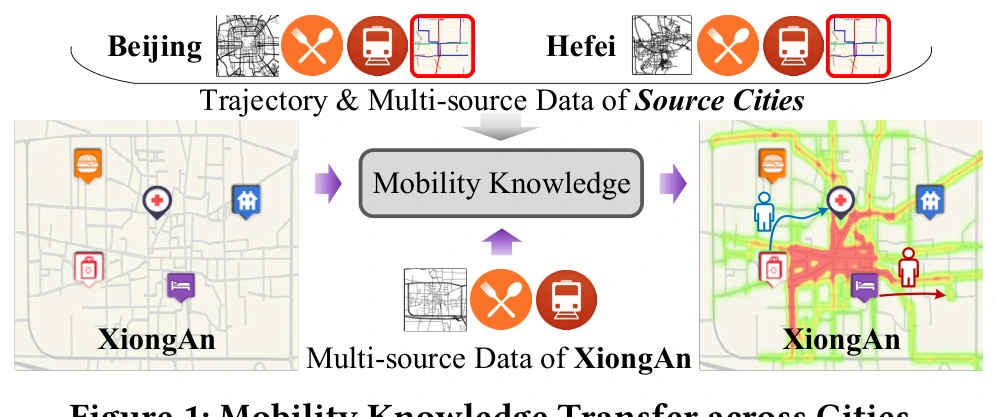
图 1|从有轨迹的城市到雄安,输入和输出各是什么?
无字母子图。上方北京、合肥提供轨迹以及兴趣点、站点和路网;下方雄安只提供多源环境数据;中间的移动知识生成右侧的轨迹热力。这是流程图,没有误差。来源:原论文 Fig. 1。
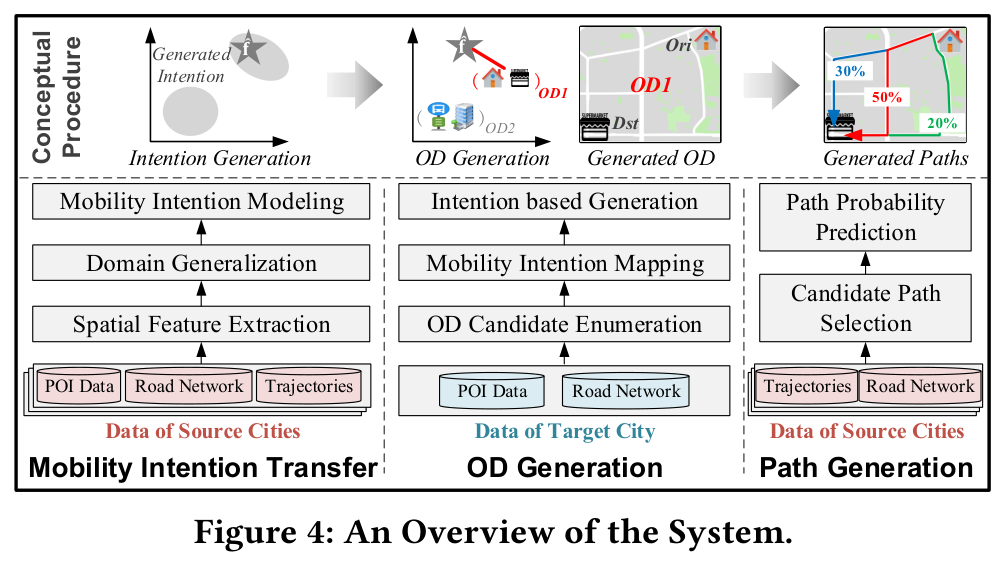
图 4|三个阶段各自吃什么数据、吐出什么?
无字母子图。上排是概念过程:先生成意图,再得到起讫点,再为该起讫点分配几条路径的概率;图中的 30%、50%、20% 是示意,不是实测份额。下排三列分别是意图迁移、起讫点生成和路径生成。意图迁移与路径生成使用源城市数据,起讫点生成使用目标城市的兴趣点和路网。来源:原论文 Fig. 4。
意图迁移把源城市起讫点的环境特征投到一个城市之间更接近的空间,并在那里拟合一个可以抽样的分布。起讫点生成在目标城市列出可能的起终点,投到同一空间,找出与抽样意图最接近的一对。路径生成再为这对起终点列出若干条不太重合的候选路,并给出选择概率。三步连起来,才是一条路段级轨迹。只完成第一步,还没有落在目标城市的街上。
300 米里的环境,怎样变成可以搬走的意图?
对起点和终点,各自在经验设定的 300 米内提取三类特征。兴趣点按类别计数。交通特征包括各类站点的数量,以及到最近站点的距离。路网特征包括起终点之间的最短路长度、该位置连接的相邻道路数、道路等级,以及该位置在路网中的图偏心度。起点和终点的特征拼在一起,成为这个起讫点的空间情境。
城市之间的麻烦是:同样是“去商场”或“去上班”,商场和车站的摆法不同,这些计数的分布就会错开。域泛化要学一个投影,让源城市在投影后的意图空间里彼此更近,以便直接用到没见过的目标城市。本文用迁移成分分析(Transfer Component Analysis,TCA)。它在核空间里寻找一组迁移成分,使城市之间的最大均值差异(Maximum Mean Discrepancy,MMD)变小。MMD 比较的是两组样本在核空间中的中心离得多远。
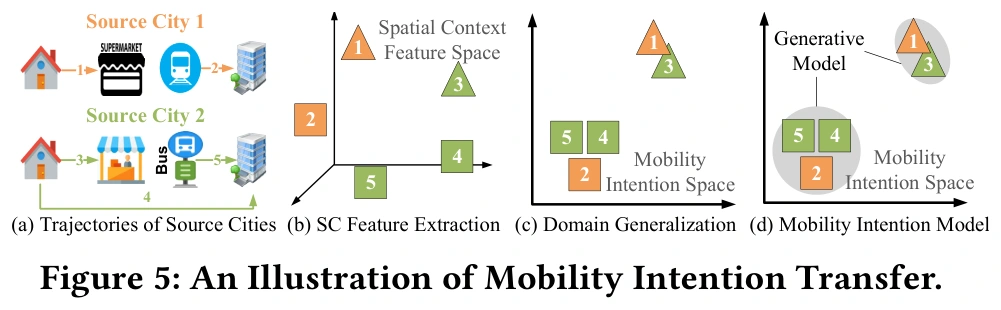
图 5|为什么环境特征不能直接当意图?
(a)两座源城市各有若干真实起讫点,购物和上班在图中画成不同图标。(b)放进空间情境特征空间后,两座城市的点分布并不重合。(c)投影到意图空间后,两座城市的同类点靠近。(d)用一块生成分布去概括投影后的点。这是机制示意图,三角形和方块不是真实类别的聚类结果。来源:原论文 Fig. 5。
图 6 把这个投影用到真实数据上。源城市是北京和合肥,目标是成都。投影只用源城市起讫点的环境特征来训练,再套到三座城市上。后文默认实验把源城市写成朝阳和合肥。两处用词不完全相同,论文没有说明图 6 的 BJ 是否只含表 1 里朝阳那 18.8 平方公里。
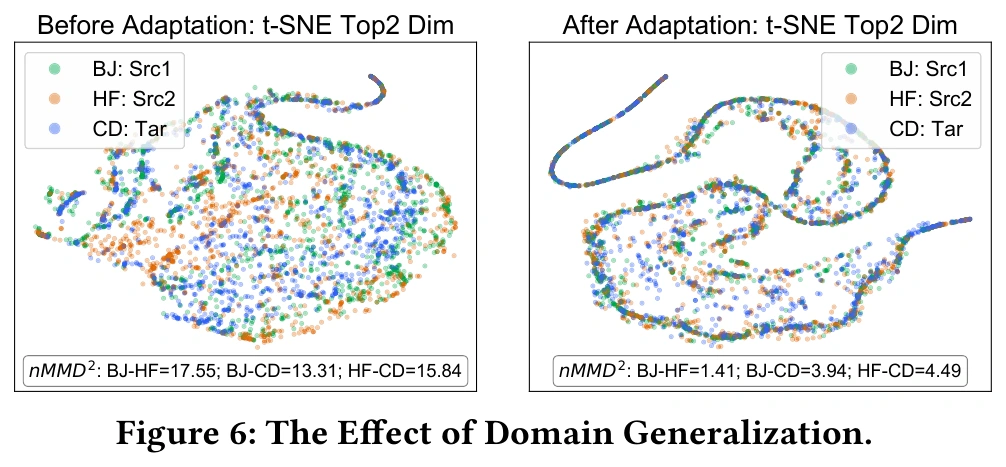
图 6|投影之后,城市之间的特征分布靠近了多少?
(a)适配前,t-SNE 前两维。绿点 BJ 为源城市 1,橙点 HF 为源城市 2,蓝点 CD 为成都。图中 n·MMD²:北京—合肥 17.55,北京—成都 13.31,合肥—成都 15.84。(b)同一投影之后,三对数值变为 1.41、3.94、4.49。点的绝对位置是降维可视化,读数以图中的 n·MMD² 为准。来源:原论文 Fig. 6。
以适配前为分母,(17.55−1.41)/17.55 = 91.97%,(13.31−3.94)/13.31 = 70.4%,(15.84−4.49)/15.84 = 71.65%。n 是起讫点数量,论文没有给出这个 n 等于多少。这三个百分数是特征分布距离的相对变化,分母是适配前的 n·MMD²。
还要分清这张图的用法。蓝点是成都真实起讫点的环境特征被投影后的位置。训练投影时没有用成都,但为了画出并计算成都的距离,评价时用到了成都真实起讫点。这是“投影能不能把未见城市的真实起讫点也拉近”的检查。下一节的生成才是在没有目标城市轨迹的情况下,从源城市的意图分布去找目标城市的路段对。
论文另外写明:这个投影不保证购物、通勤等明文语义各自成团,它对齐的是潜在表示。
源城市的意图点如果太稀,直接从已有点里抽样,会填不满想要的分布。补救办法类似少数类过采样:随机取一个意图点,再在它的 k 个近邻里随机取一个,用 0 到 1 之间的比例在两点之间插值。
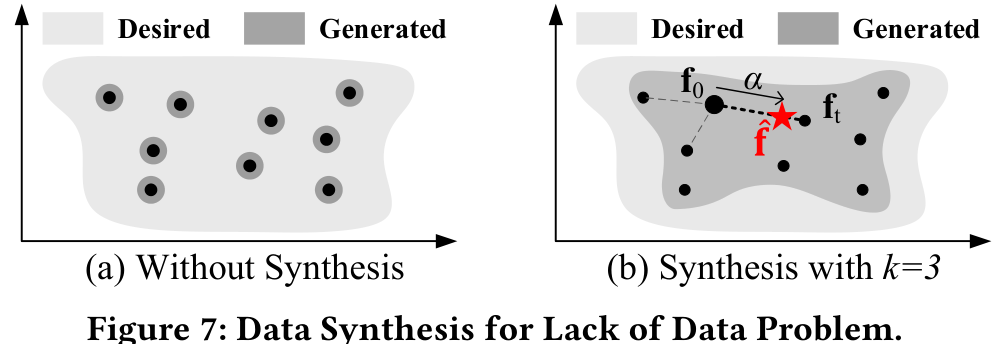
图 7|样本少的时候,怎样把意图分布补满?
(a)不合成时,抽到的点只能落在已有黑点上,盖不住浅色的目标分布。(b)k=3 的示意:在 f₀ 和近邻 fₜ 之间按比例 α 得到新点。图中的 k=3 是例子;后文默认实验把 k 设为 5。来源:原论文 Fig. 7。
目标城市那么多路段对,留下哪一些?
若路段数为 nᵣ,全部两两搭配是 nᵣ 的平方量级。论文按经验只保留最短路不超过 6.0 公里的起讫点,依据是此前自行车道研究里 91.7% 的骑行落在 6.0 公里以内。91.7% 的分母是那篇 2017 年论文中的骑行,不是表 1 这四块区域重新数出来的比例。筛选后,候选数量大约是路段数乘以“一条路 6 公里内平均能碰到的路段数”,文中说这个平均数随区域变化,大约 2000。
候选起讫点用同一套 300 米特征和已经训练好的投影,送进意图空间。每次从源城市的意图模型抽出一个点,在候选里找欧氏距离最近的一对,作为生成结果。相似度取距离的倒数,所以最近邻就是相似度最高的候选。搜索用 KD 树加速。
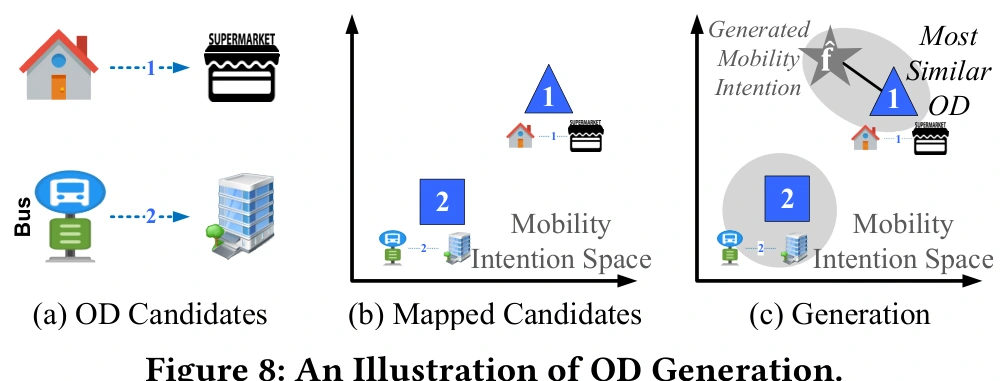
图 8|抽出一个意图之后,怎样落成目标城市的起讫点?
(a)在目标城市枚举候选起讫点,图中是去超市、去公交附近的大楼这两类例子。(b)把候选投到意图空间。(c)生成的意图落在何处,就取离它最近的那个候选。灰色区域表示从源城市迁来的意图分布。来源:原论文 Fig. 8。
这一步给出的是环境特征最接近的路段对。两对起讫点在潜空间里靠近,只说明周围的兴趣点、站点和道路指标接近,不能由此读出骑车人的真实目的,也不能读出是哪一位用户。
同一对起终点,为什么不能只留最短的几条路?
图 3b 已经显示,多数骑行贴着最短路,但仍有一部分明显更长,而且图 3a 的同一对起终点会分成几条走廊。路网里最短的前几条路常常挤在一起,只在出发点有一点差别,盖不住真实骑行扫过的街。
候选路径因此加了一条重叠约束。两条路径的加权杰卡德,等于重叠路段的总长度,除以两条路径长度之和再减去这段重叠长度。两条路各 10 公里、重叠 8 公里时,8 / (10+10−8) = 0.667。论文把大于 0.7 的看作重叠过高,不再同时放进候选集。具体做法是按长度从短到长查看不含环路的路径,只有与已有候选的加权杰卡德都低于阈值时才收录,直到收满 m 条。
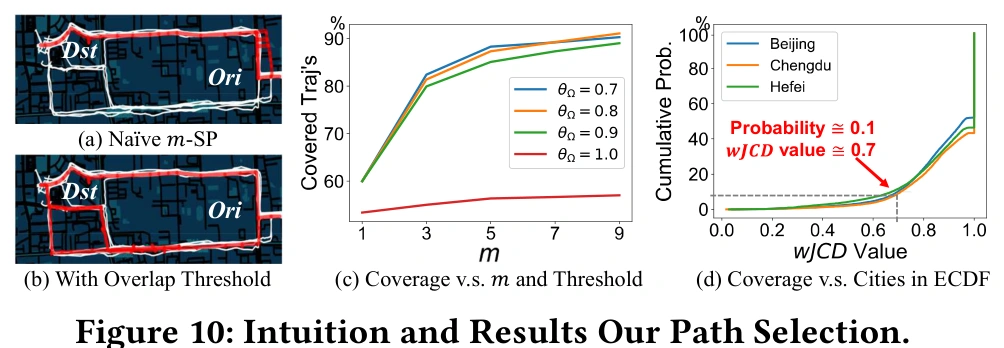
图 10|加上重叠限制后,候选路径盖住了更多真实骑行吗?
(a)只取最短的若干条时,红线几乎叠在一起,白线所代表的真实轨迹有不少落在外面。(b)重叠阈值筛过之后的前几条候选,红线分开,盖住的轨迹更多。两幅都是示意。(c)纵轴是覆盖比例,正文定义为真实出行里最常走的前 m 条路径中、有多少被候选集召回,数据来自北京的骑行,刻度从 60% 到 90%。θΩ=1.0 的红线几乎不随 m 上升,并落在 60% 刻度下方;0.7、0.8、0.9 从 m=1 时的 60% 附近上升,到 m=9 时靠近 90% 刻度。正文没有给出每条曲线的精确读数,只说明该算法高于不做重叠约束的最短 m 条路径。(d)北京、成都、合肥的加权杰卡德累积曲线彼此接近。图中在加权杰卡德约 0.7 处标注累积概率约 0.1。正文写:m=5 且 θΩ=0.7 时,三座城市都有超过 90% 的轨迹能匹配到这 m 条候选之一。这里的分母是轨迹,和(c)的“最常走的前 m 条路径”不是同一个分母。来源:原论文 Fig. 10。
(c)的覆盖率回答“真实常走的路有没有进入候选集”。(d)的累积曲线回答“一条真实轨迹和最接近的候选有多像”。m 继续加大,覆盖还会提高,但后面的计时实验说明计算会变慢。
候选集有了以后,还要决定每条被选中的概率。每条候选路径的特征包括路段数、长度、左右转次数、掉头次数、各级道路走过的次数,以及有多少次下一步偏离了从当前路段出发的最短路。一个两层全连接网络给每条路径打效用分,再用 softmax 变成概率,用交叉熵去贴近估计的选择比例。优化器是 Adam,学习率 0.01。因为图 3 里三座城市的长短路和转角分布相近,这个模型在源城市学完,直接用到目标城市。
真实轨迹很少与候选路径完全重合。选择比例按归类估计:每条轨迹归到加权杰卡德最大的那条候选上,该候选的次数就是归到它的轨迹数,再除以这一对起讫点上的全部归类次数。训练只用超过 30 条轨迹的起讫点。论文没有写出这样的起讫点还剩多少对。
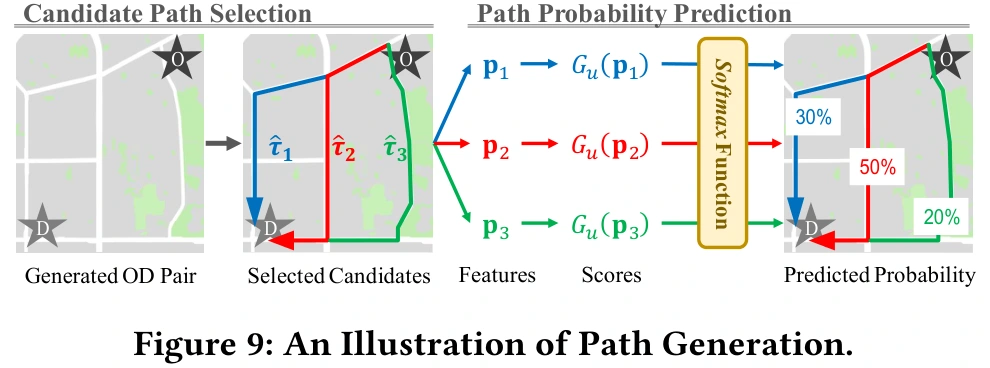
图 9|候选路径怎样变成一条被抽中的路?
无额外字母面板,从左到右是同一流程。给定生成的起讫点后选出几条候选,提取特征,经效用函数和 softmax 得到概率;图中的 30%、50%、20% 是流程示意,与图 4 一样,不是某次实验的测量值。来源:原论文 Fig. 9。
换一对城市,适配和选路还稳不稳定?
直接比较两条完整轨迹集合的分布,组合空间太大。只比较轨迹点落在地图上的位置也不够,因为不同的路径集合可以走出同一片点云。评价因此拆开。起讫点用两组四维坐标的 n·MMD²,n 是起讫点数量,越小越接近。路径部分在起讫点已经给定时,比较各路段被经过的概率,用 KL 散度,并做拉普拉斯平滑,以免出现零概率。KL 越小,两条路段使用分布越接近。它回答的是“起终点已知时路选得像不像”,不是整条轨迹从零生成的总误差。
默认起讫点实验以朝阳和合肥为源、成都为目标,合成近邻数 k=5,训练轨迹 5000 条。评价使用全部轨迹,均分成四份后取 MMD 的平均,以避免内存不够,并重复三次来缓和生成的随机性。5000 是训练规模,不是评价集的大小。
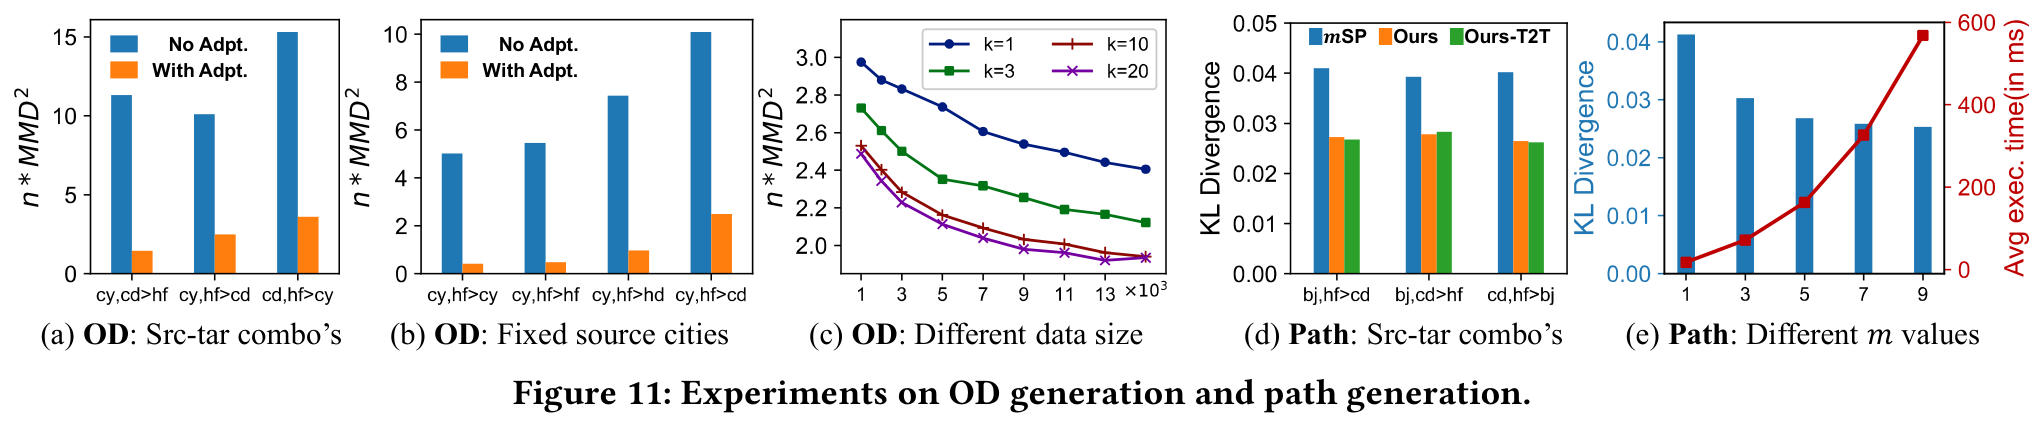
图 11|起讫点距离和选路散度,在哪些对照下变小?
(a)不同源城市到目标城市。蓝柱无适配,橙柱有适配,纵轴 n·MMD² 刻到 15。每一组橙柱都低于蓝柱;迁往朝阳的那一组蓝柱最高。正文解释,朝阳作为首都的一部分,比成都、合肥这两座较小城市更多样,从小城市迁入更难。作者的猜想是大城市包含的环境更宽,更能盖住小城市;这是解释,不是单独的机制实验。(b)源城市固定为朝阳和合肥,目标依次为朝阳、合肥、海淀、成都,纵轴刻到 10。正文写,迁回朝阳和合肥本身的自检表现较好;迁到海淀优于迁到合肥,因为海淀和朝阳同在北京。各柱没有标出精确高度。(c)横轴为训练轨迹数,以千计,刻度 1 到 13;五条线为 k=1、3、5、10、20。曲线随数据量下降,k=1 位于最上方。正文的结论是数据越多 n·MMD² 越低,合成能减少生成所需的轨迹数。纵轴没有逐点读数。(d)路径实验,m=5。蓝柱是只取最短的 m 条路径并在源城市学习效用;橙柱是本文的重叠约束加源城市模型;绿柱是同一套候选路径、但效用模型在目标城市自己的轨迹上训练再用于该城。橙柱低于蓝柱,绿柱相对橙柱没有明显再低。正文据此认为不必按每一对城市各训一个选路模型。(e)m 从 1 到 9。蓝柱为 KL 散度,红线为生成一条轨迹的平均毫秒数,右轴刻到 600。m=7 和 m=9 相对 m=5 只略好;m=9 时平均一条轨迹近 600 毫秒,生成 1000 条大约 10 分钟。生成 1000 个起讫点只要 300 毫秒。默认因此取 m=5。来源:原论文 Fig. 11。
结论中的“n·MMD² 至少下降 75%”指的是起讫点生成相对无适配基线。图 11a 能直接看到橙色低于蓝色,但柱上没有数字,因此 75% 是作者对整组比较的概括。图 6 那组 91.97%、70.4%、71.65% 是特征投影前后的距离,分母是适配前的 n·MMD²,和这句 75% 来自不同的比较。
路径一侧,同一城市训练并没有带来值得单独建模型的增益。这个结论的范围是图中的城市组合和 m=5 的 KL 散度。它说明这些城市的短距离选路偏好接近,不说明换一种交通工具或换一套更绕的路网后仍然接近。
热力看起来像,能代替上面的两项距离吗?
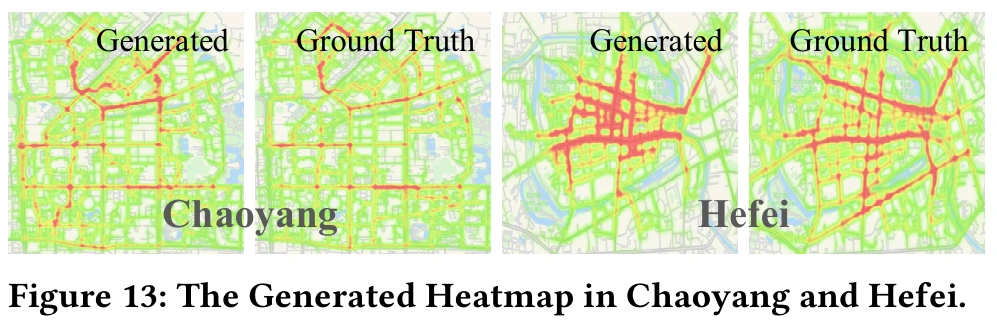
图 13|生成热力和真实热力在朝阳、合肥像不像?
无字母子图。左两幅是朝阳的生成结果与真实轨迹,右两幅是合肥,红到绿表示热力由高到低。论文说两边的空间分布非常相似。图下没有写这次生成的源城市是谁,也没有给出 MMD 或 KL。来源:原论文 Fig. 13。
热力比的是轨迹经过的位置。论文自己说过,不同轨迹集合可以共享同一片点分布,所以才把评价拆成起讫点和给定起讫点后的路径。图 13 是视觉对照。它不能填上图 11 没有印出的柱高,也不能证明每一条生成轨迹都对应一条真实行程。
雄安没有对照轨迹,实地能核对到哪一步?
雄安不在表 1 的四块区域里。系统用源城市学到的模型,加上雄安的兴趣点和路网生成轨迹,再看热力和常出现的起讫点。数据时段是 2018 年 4 月到 7 月;致谢只说实地案例在寒冬进行,没有给出访问日期。两次时间不能当成同一次观察。
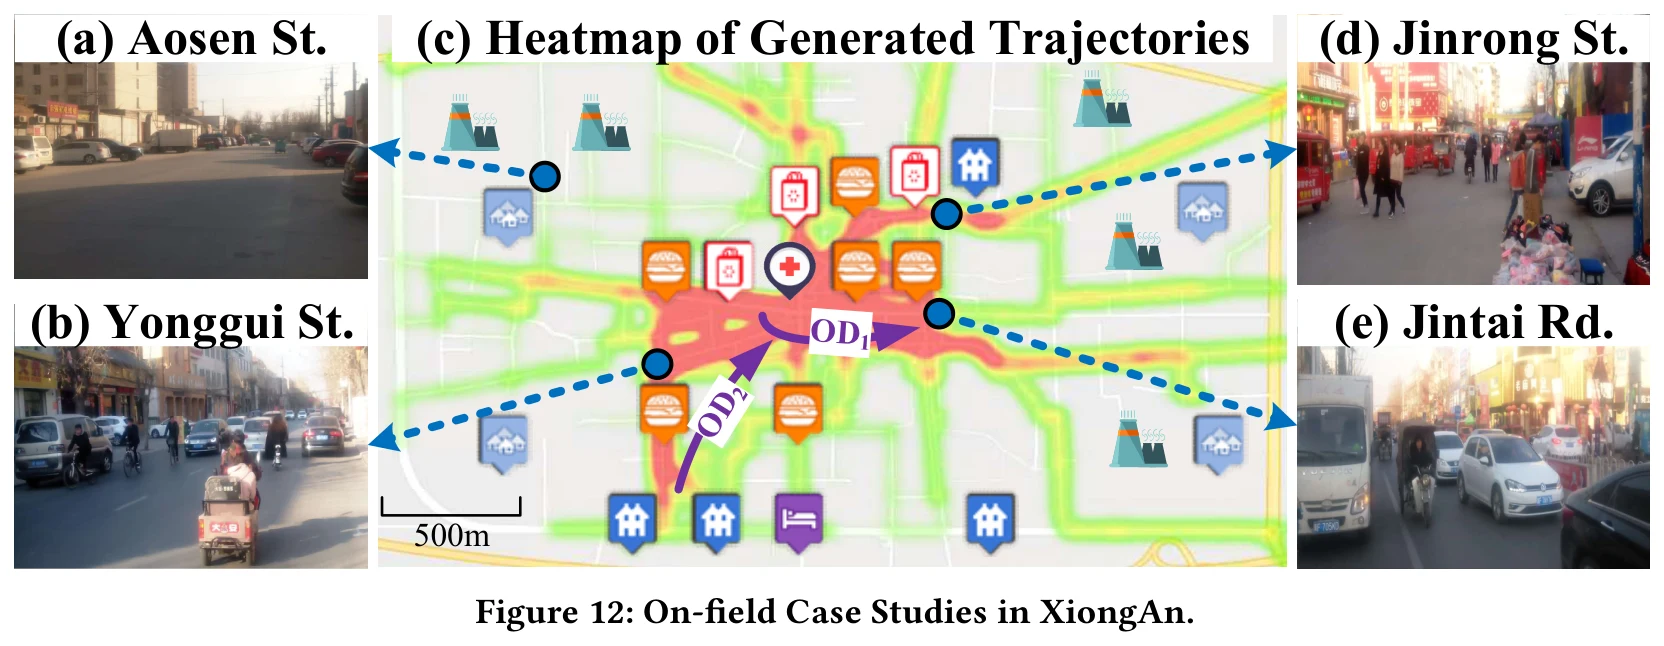
图 12|雄安的生成热力和四条街的实地画面是否同向?
(a)Aosen St.,画面中人很少,论文说与生成结果一致。(b)Yonggui St.,街上有明显的人和车,论文说它连接西南片区与市中心。(c)生成轨迹热力及兴趣点,比例尺 500 米。OD1 位于兴趣点密集的中心,OD2 从西南指向中心。蓝点标出几处端点。(d)Jinrong St.,人流较密,路边有摊位。(e)Jintai Rd.,非机动车走在路中央。照片是定性画面,没有人数统计。来源:原论文 Fig. 12。
从生成的起讫点里,论文提出两点:中心区有一批互相往来、周围兴趣点很多的起讫点;西南到中心也有一条常出现的联系,因为西南建了新居住区。实地看到 Aosen St. 所在的外围人很少,Jinrong St. 和 Jintai Rd. 作为连接中心的路人更多,Yonggui St. 上有不少人通行。这些是同一次访问的定性对照。致谢写明,实地案例由京东智能城市业务的 Hao Teng 完成。
由此引出的三条建议是:Yonggui St. 人流多而兴趣点少,适合新开餐馆和店铺;Jintai Rd. 没有自行车道,非机动车走在路中央,建议补自行车道;Jinrong St. 路边摊位吸引行人,建议附近建更多店铺,以改善购物并缓解拥挤。这是根据生成热力和一次街景作出的规划设想。论文没有测量开店或修车道之后人流是否改变,也没有雄安的留出轨迹来计算 n·MMD²。
演示界面展示的是生成结果,不是准确率
论文给出一个在线演示,意图模型用成都和合肥的轨迹训练,可选区域是朝阳或雄安。界面可以设定轨迹条数和选路算法,查看热力、单条轨迹以及起终点坐标和长度,并下载生成结果。
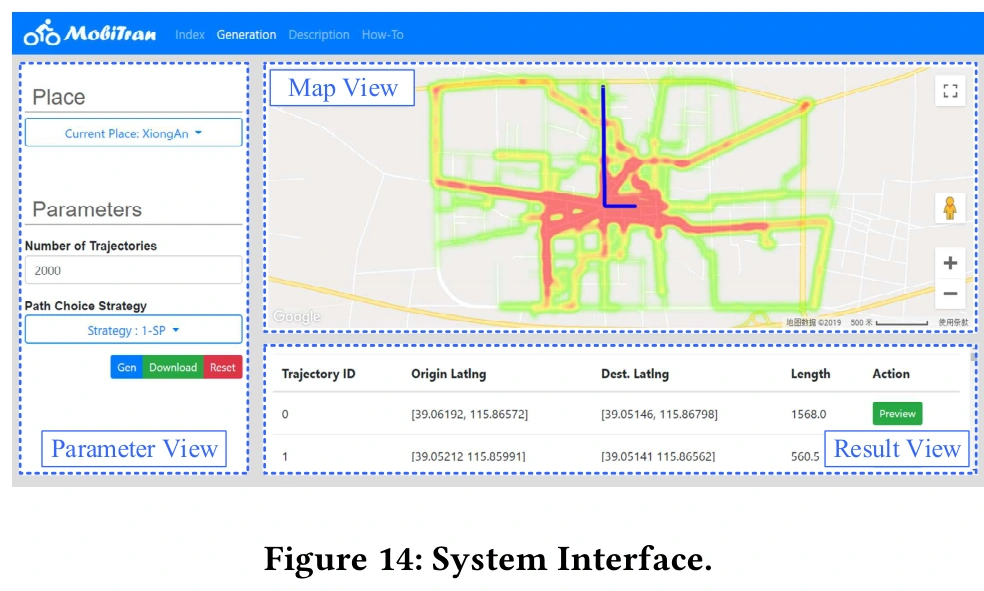
图 14|演示系统把生成结果放在哪三块界面里?
无字母子图。左侧参数区在截图中选的是雄安、2000 条轨迹、策略 1-SP。右上是热力地图。右下结果表列出轨迹编号、起终点坐标和长度。截图是界面示例,坐标属于演示输出,不是四块研究区的误差表。来源:原论文 Fig. 14。
截图上的 2000 条和 1-SP 只说明这一屏的设置。它没有报告这 2000 条相对真实轨迹的 MMD 或 KL。
这些比较成立的范围
起讫点实验的主设定是朝阳、合肥迁到成都,训练 5000 条、k=5,评价用全部轨迹分四份取平均并重复三次。路径实验把起讫点固定,只比较路段使用分布。两套数字不能相加,当成“整条轨迹有多准”。
图 6 的降幅用到了目标城市真实起讫点的环境特征,用来检查投影;图 11 的生成才把目标城市的轨迹留在评价一侧。雄安连这一侧都没有。生成分布是模型在“环境被照源城市的方式使用”时给出的情景。新区尚未入住、公交尚未开通,这个情景可以和未来的真实出行差得很远。
6.0 公里的截断来自另一篇论文的 91.7%,本文四块区域没有重算这个比例。超过 6 公里的长距离、一天中随时间变化的分布,都被放进后续问题。作者认为长距离更应先看起讫点,因为线路可以由规划来调整;这是展望,不是本次实验的结果。大城市的早晚高峰和小城市不同,深夜数据更稀,所以时间维比空间维更难直接迁移。
选路模型只在超过 30 条轨迹的起讫点上训练,稀少的起讫点没有进入这个监督样本。潜空间最近邻找的是环境特征接近的路段对,不是骑车人的身份,也不是明文的出行目的。
一句话总结
一座城市能借给另一座城市的,是短距离起终点环境所对应的意图分布,以及这些城市里相近的选路偏好;它能在有留出轨迹时缩小三个月尺度的空间分布差距,却不能代替新城尚未发生的真实出行。
核心来源
- WWW ’20 论文页面,题目、作者、会议时间和 DOI 以 PDF 首页为准:10.1145/3366423.3380210。
- 正文图 1–14 与表 1。这份 11 页 PDF 没有附带补充材料,图 11 的柱也没有逐根数值表。
- 参考文献中的演示系统条目为 Mobility Transfer System,链接写作 http://t.cn/EKKzTre ,训练数据为成都与合肥。
作者介绍
以下只写 PDF 署名、资助和文末参考文献里能够对应到的工作,不补充论文没有列出的头衔。
- Tianfu He:第一作者,署名哈尔滨工业大学与京东智能城市研究。本文的共享单车短距离轨迹即由他领衔。文末还列有他参与的自行车道规划和共享单车轨迹相关工作。
- Jie Bao:署名京东智能城市研究。论文首页把他列为第 2、第 3 单位;这两个单位在 PDF 中都印成 JD Intelligent City Research。文末自行车道规划一文亦有他的署名。
- Ruiyuan Li:署名西安电子科技大学与京东智能城市研究。文末列有他参与的城市时空数据引擎 JUST 和轨迹存储引擎 TrajMesa。
- Sijie Ruan:署名西安电子科技大学与京东智能城市研究。文末列有他参与的轨迹预处理框架,以及从轨迹学习生成地图的工作。
- Yanhua Li:署名伍斯特理工学院。致谢写明其部分经费来自 NSF CNS-1657350、CMMI-1831140,以及滴滴出行的一项研究资助。
- Li Song:署名美团点评。PDF 只给出这一机构。
- Hui He:哈尔滨工业大学,通讯作者。致谢列出国家重点研发计划 2017YFB0803304,以及国家自然科学基金 61672186、61872110。
- Yu Zheng:署名京东智能城市研究。文末引用了他与合作者 2014 年的城市计算综述,本文把跨城市轨迹生成放在这一方向下。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
图 11a 里,从成都和合肥迁到朝阳最难,作者把它归结为大城市的环境更杂。可以把这个猜想翻过来做一次留出:在源城市很少出现的兴趣点组合上,最近邻仍会返回一对路段,因为候选集里总有一个距离最小的点。那一对可能只是“最不远”,而不是这座新城真会发生的出行。若这种组合上的 n·MMD² 明显差于常见组合,就说明迁移的有效范围取决于源城市盖住了哪些环境,而不是取决于模型总能输出一条轨迹。
图 3b 的七成以上贴着最短路,来自这三座城市的共享单车。若路网被河流、铁路或长期施工切断,最短路本身就绕,1.0–1.2 倍这一档未必还能超过 70% 刻度。论文把 6 公里以上留作以后,并认为长距离应先看起讫点。一个直接的检验是:在必须绕行的桥和隧道附近,单独看行程长度与最短路之比,看三座城市是否还重合。若不再重合,选路模型就不该随意图模型一起搬进那种路网。
用 Yonggui St. 的生成热力决定开店,等于假设新区会像源城市那样使用类似的居住区和道路。西南居住区若尚未入住,OD2 是“有居住区就会出现去中心的骑行”这一关联的外推,不是已经数到的人。更稳妥的用法是把热力当成一种情景,写出它依赖哪些兴趣点和道路仍然有效;入住率、公交开通或一条新的主干道,都可能把这条情景改掉。情景和街景同向,只说明模型没有立刻与当天的画面冲突。